Stack de ranking de pesquisa: BM25, embeddings e reranking

Tradução automática
Este artigo foi traduzido automaticamente a partir da versão original em inglês.
Este guia destina-se a engenheiros Python que constroem ou melhoram um pipeline de ranking de pesquisa. Explica como o BM25, os embeddings densos, a fusão de rankings e os rerankers funcionam em conjunto, e como medir se a pesquisa precisa de melhores candidatos ou de uma melhor ordenação.
Uma pesquisa por “cheap laptop” pode não encontrar um produto descrito como “budget notebook computer”. Outra falha coloca um estojo de transporte para auscultadores acima dos próprios auscultadores. O primeiro problema exige melhores candidatos; o segundo exige uma melhor ordenação.
O repositório de demonstração ilustra a recuperação e o reranking numa amostra de dados de pesquisa de produtos do Amazon ESCI.
Para um guia compacto de escolha de fases, consulte BM25 vs Embeddings vs Rerankers. A sequência de experiências mais adiante neste artigo liga cada fase a uma medição.
Modelos lexicais, densos e cross-encoders
O stack é mais fácil de compreender em três camadas. A recuperação lexical encontra termos exatos, a recuperação densa reduz as lacunas de vocabulário e os rerankers comparam em detalhe os candidatos mais fortes.
BM25 e recuperação lexical
Durante décadas, o BM25 foi a opção predefinida. É um modelo probabilístico que pontua os documentos pela frequência dos termos da query no documento, normalizada pelo comprimento do documento e pela frequência inversa de documentos (IDF).
O BM25 é forte quando os termos literais carregam a intenção: códigos de erro, SKUs de produtos, nomes e identificadores de API. A sua principal limitação é o desfasamento de vocabulário. Uma query por “cheap laptop” pode não encontrar um documento sobre um “budget notebook computer” quando o texto indexado não oferece nenhuma ponte entre as duas expressões.
Ainda assim, o estudo BEIR concluiu que o BM25 é uma baseline zero-shot forte nas suas tarefas heterogéneas de recuperação. Os valores de BM25 do BEIR provêm do Lucene através do Pyserini, e não do rank_bm25 com tokenização por espaços usado nesta demonstração. O BM25 também supera alguns modelos neuronais em tarefas de recuperação argumentativa, como a Touche-2020.
Recuperação densa e embeddings
Os encoders ao estilo BERT tornaram prática a recuperação densa. Mapeiam queries e documentos para um espaço vetorial partilhado e ordenam os candidatos com uma função de similaridade, como a similaridade de cosseno ou o produto escalar.
A arquitetura bi-encoder (ou “two-tower”) codifica a query e o documento separadamente, produzindo embeddings de comprimento fixo. Os vetores dos documentos podem ser pré-calculados e indexados offline, e depois recuperados rapidamente com algoritmos de vizinhos mais próximos aproximados (ANN). Assim, “cheap laptop” e “budget notebook” ficam próximos no espaço vetorial.
Alguns bi-encoders usam uma arquitetura siamesa, como o Sentence-BERT, em que os dois lados partilham pesos. Outros usam torres separadas para a query e para o documento. O pooling, a dimensão do vetor, a função de similaridade e o objetivo de treino são escolhas do modelo, e não propriedades de todos os recuperadores densos.
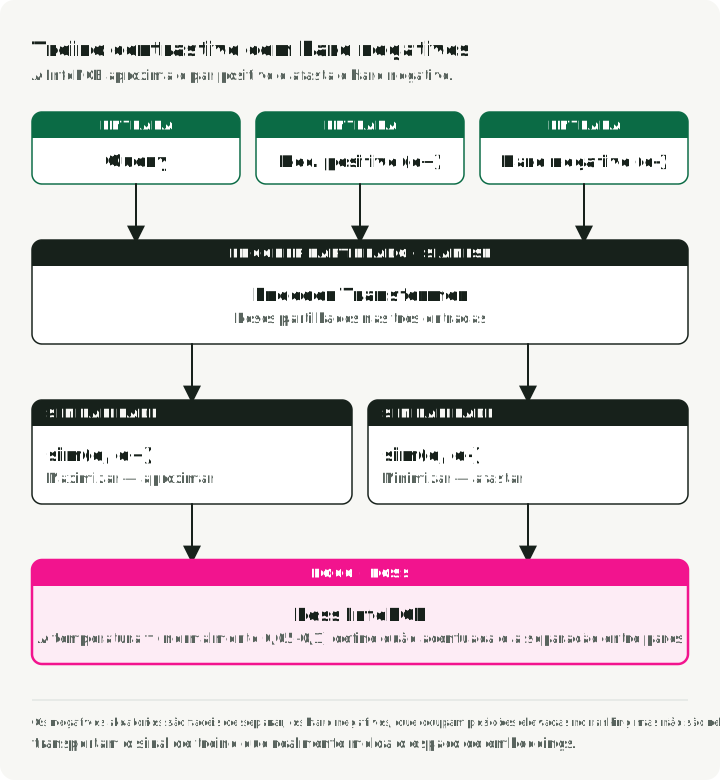
Estes modelos são treinados com aprendizagem contrastiva, normalmente com a loss InfoNCE. Dado um batch de pares (query, positive_document), o objetivo maximiza sim(query, positive_doc) e minimiza sim(query, negative_docs). Os negativos vêm dos positivos de outras queries no mesmo batch (in-batch negatives). Um parâmetro de temperatura controla com que nitidez o modelo tem de separar os dois.
Os dados de treino contam muitas vezes mais do que a dimensão do embedding. Os modelos de recuperação aprendem com pares query-positivo e com hard negatives escolhidos com cuidado: documentos plausíveis, mas não relevantes. A secção de treino mais adiante mostra como o SimANS evita tanto os negativos triviais como os prováveis falsos negativos.
O custo é o estrangulamento da representação. Os bi-encoders comprimem toda a nuance semântica num único vetor de tamanho fixo, por isso falham muitas vezes as interações finas entre termos concretos da query e conteúdo concreto do documento.
Cross-encoders e LLMs
Os cross-encoders (Nogueira & Cho, 2019) passam a query e o documento em conjunto a um Transformer, como uma sequência concatenada ([CLS] Query [SEP] Document), de modo que cada token da query pode atender a cada token do documento através de self-attention completa. Essa interação profunda capta nuances que a codificação independente perde.
O reranking com LLM usa um modelo guiado por prompt para comparar vários candidatos de uma só vez. O RankGPT mostrou bons resultados listwise zero-shot com o GPT-4 nos benchmarks avaliados, mas a estabilidade das respostas, o custo e a adequação ao domínio continuam a exigir testes próprios.
Estas pontuações não podem ser pré-calculadas para queries arbitrárias, por isso o reranking vem depois da recuperação. Essa assimetria de custo motiva o funil de várias fases.
O funil de várias fases
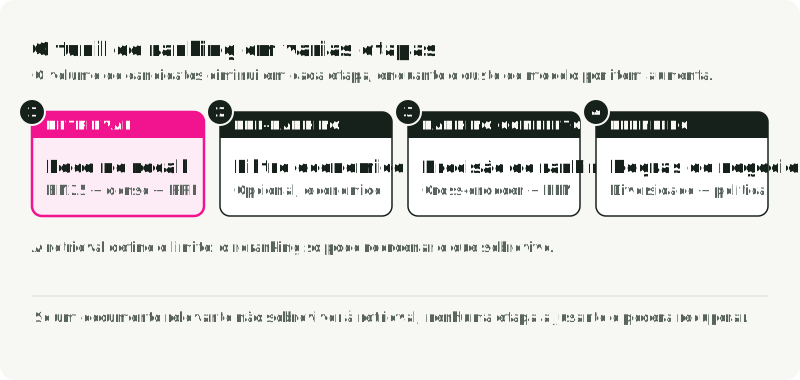
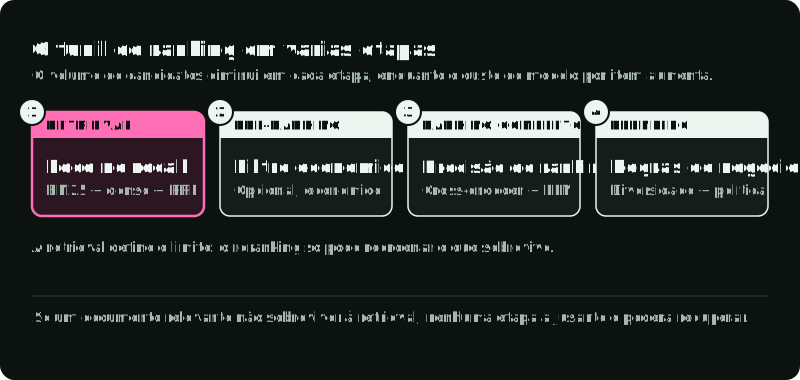
Executar um cross-encoder ou um LLM dispendioso sobre milhões de documentos não é viável, por isso os stacks de pesquisa modernos usam um funil. A recuperação e o pré-ranking reduzem o conjunto de candidatos para que o ranking completo possa usar modelos mais caros numa lista curta. A mistura final aplica depois regras ou uma política de ranking; o seu custo depende dessa política.
Um recuperador barato também não tem precisão final, pelo que o funil usa cada modelo apenas onde o seu custo é razoável. A figura mostra o volume de entrada de cada fase e o custo esquemático dos modelos, e assinala que as fases posteriores não podem recuperar documentos omitidos:
| Fase | Escala de entrada | Objetivo principal | Métodos típicos | Medição de saída |
|---|---|---|---|---|
| Recuperação | Corpus ou índice | Recall de candidatos | BM25, bi-encoders | Recall no limite de candidatos |
| Pré-ranking | Grande conjunto de candidatos | Filtragem barata | Modelos leves, regras | Recall mantido por milissegundo |
| Ranking completo | Lista curta | Qualidade no topo | Cross-encoders, LLMs | NDCG/MRR, latência, custo |
| Mistura final | Listas ou posições finais | Restrições e mistura | Regras, ranking multiobjetivo | Política, diversidade, limites de negócio |
Um reranker reordena os candidatos que a recuperação devolve; não consegue acrescentar nenhum. A cobertura dos candidatos recuperados limita, por isso, o que as fases posteriores podem recuperar. Com mais de 100 candidatos, o reranking pode colocar um documento relevante nos 100 primeiros e melhorar o Recall@100. Nesta demonstração, mantêm-se todos os 100 candidatos, pelo que o reranking não pode alterar o Recall@100.
Ferramentas para cada fase
A demonstração usa pequenas bibliotecas em memória. Fora de um portátil, cada fase tem algumas implementações comuns:
| Fase | Ferramenta | Usar quando |
|---|---|---|
| BM25 | rank_bm25 | O corpus cabe em memória e quer uma baseline rápida |
| Elasticsearch, OpenSearch ou Lucene através do Pyserini | O corpus precisa de um índice invertido, analisadores e filtros | |
| Recuperação densa | FAISS | Quer uma biblioteca ANN dentro do seu próprio serviço |
| pgvector | Os dados já estão no Postgres | |
| Qdrant, Weaviate, Vespa ou Elasticsearch kNN | Precisa de filtros de metadados, atualizações frequentes e um índice gerido | |
| Fusão | Elasticsearch RRF retriever, Qdrant Query API com rrf | Quer fusão de rankings dentro do motor de pesquisa |
| Weaviate hybrid search | Usa o Weaviate; oferece fusão por ranking e fusão por pontuação relativa | |
| Modelos de embeddings | O separador de recuperação do MTEB e depois as suas próprias queries avaliadas | Está a escolher um modelo; o leaderboard reduz a lista, as suas queries decidem |
| Reranker | ms-marco-MiniLM-L12-v2 | Texto em inglês, orçamento de CPU |
bge-reranker-v2-m3 | Texto multilingue | |
| Elastic Rerank | Texto em inglês já no Elasticsearch; exige uma subscrição elegível ou um período experimental |
A demonstração: um pipeline de cinco fases
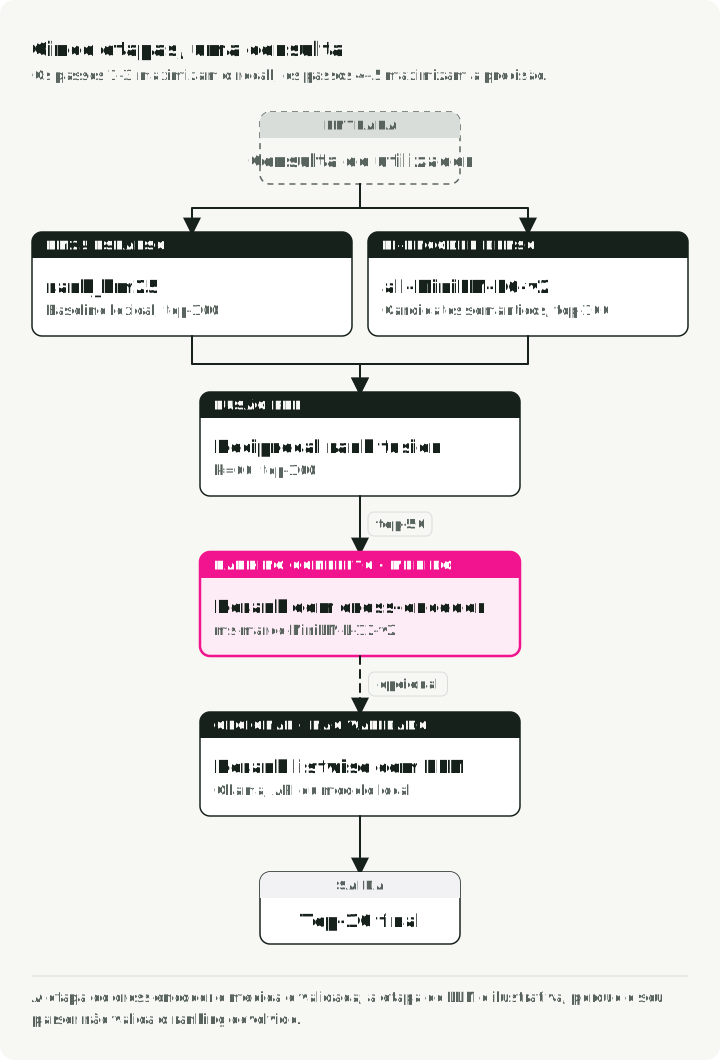
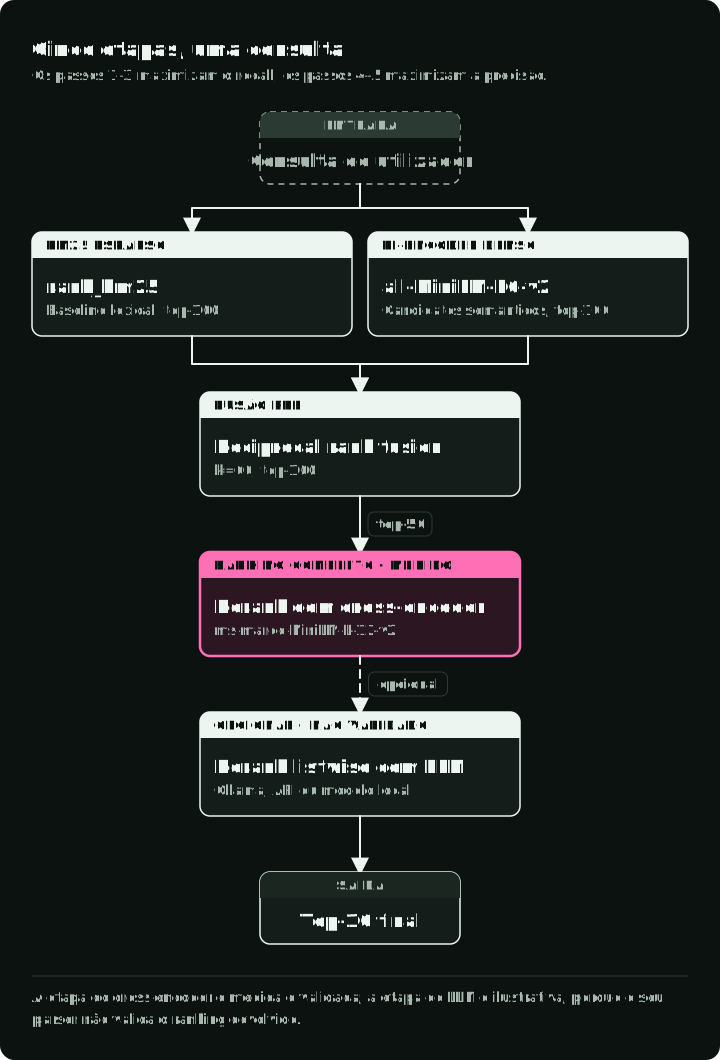
Para tornar isto concreto, criei uma demonstração, search-ranking-stack, que executa um pipeline de cinco fases sobre o benchmark de pesquisa de produtos Amazon ESCI. Cada fase escreve métricas.
O pipeline:
- Recuperação esparsa com BM25 — baseline lexical (
rank_bm25) - Recuperação densa com bi-encoder — geração semântica de candidatos (
all-MiniLM-L6-v2) - Fusão híbrida RRF — fusão por ranking dos resultados esparsos e densos
- Reranking com cross-encoder — pontuações de relevância por par (
ms-marco-MiniLM-L12-v2) - Reranking listwise com LLM — comparação, guiada por prompt, da lista curta final (Ollama, API ou modelo local)
Os passos 1—3 são a fase de recuperação do funil (maximizar o recall); os passos 4—5 são a fase de ranking completo (maximizar a precisão). A demonstração dispensa o pré-ranking e a mistura final. O diagrama mostra o número de candidatos em cada passo: o cross-encoder pontua os primeiros 50 dos 100 candidatos híbridos e mantém os restantes na ordem híbrida, e o LLM vê os primeiros 10.
Início rápido
O passo de download obtém o dataset uma vez e escreve uma pequena amostra. Depois, run-all executa todas as fases, imprime uma linha de métricas por fase e grava as linhas em results/metrics.json e um gráfico em results/metrics_comparison.png. Acrescente --llm-mode para incluir a fase do LLM.
git clone https://github.com/slavadubrov/search-ranking-stack.git
cd search-ranking-stack
uv sync

# Download and sample ESCI dataset (~2.5GB download, ~5MB sample)
uv run download-data

# Run BM25, dense, hybrid RRF, and the cross-encoder
uv run run-all

# Add LLM reranking with a local Ollama model (ollama pull llama3.2:3b first)
uv run run-all --llm-mode ollama
Dataset e amostragem: Amazon ESCI
A demonstração usa o Amazon Shopping Queries Dataset (ESCI) da KDD Cup 2022 — um benchmark real de pesquisa de produtos com etiquetas de relevância graduada em quatro níveis:
| Etiqueta | Ganho | Significado | Exemplo (query: “wireless headphones”) |
|---|---|---|---|
| Exact (E) | 3 | Satisfaz todos os requisitos | Sony WH-1000XM5 Wireless Headphones |
| Substitute (S) | 2 | Alternativa funcional | Auscultadores com fio e adaptador Bluetooth |
| Complement (C) | 1 | Artigo útil relacionado | Estojo de transporte para auscultadores |
| Irrelevant (I) | 0 | Sem relação significativa | Cabo de carregamento USB |
A relevância graduada importa porque permite usar o NDCG (Normalized Discounted Cumulative Gain), que separa um ranking “perfeito” de um ranking “apenas adequado”. As métricas binárias atribuem a ambos a mesma pontuação.
Usei a amostra small_version da demonstração: 500 queries, 9870 produtos e 9984 avaliações. O seu downloader lê a única divisão train de tasksource/esci, filtra o locale inglês us e small_version == 1, e depois usa a seed 42 para amostrar até 500 IDs de query únicos, sem reposição. O corpus contém os produtos únicos dessas linhas de avaliação selecionadas. Isto não é uma divisão hold-out nem um corpus independente. A amostra é pequena o suficiente para correr num portátil, mas demasiado pequena e específica de um domínio para estabelecer um ranking de produção. Use-a para reproduzir as fases e inspecionar modos de falha; use queries representativas e retidas (hold-out) para decidir a colocação em produção.
Avaliação: medir o que importa
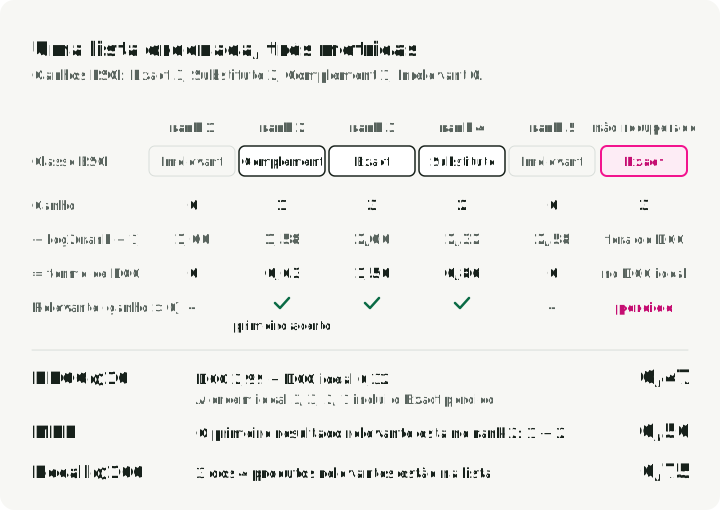
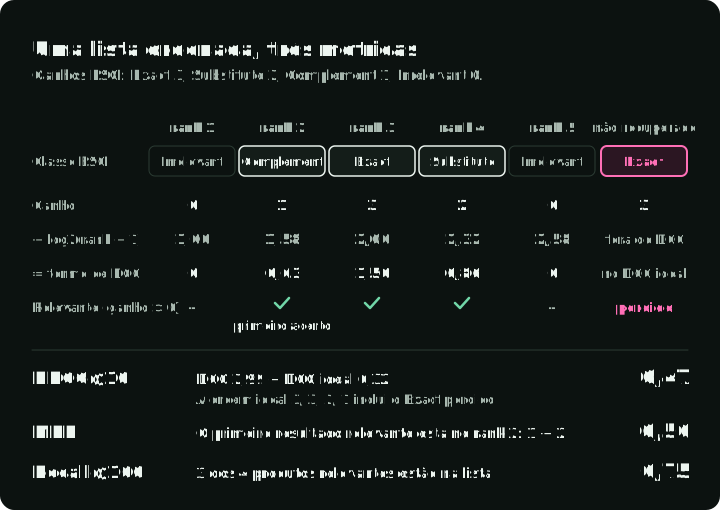
A demonstração usa três métricas, e cada uma olha para o ranking de um ângulo diferente. A figura aplica as três aos resultados de uma query, usando os ganhos do ESCI acima:
NDCG@10 (métrica principal)
O Normalized Discounted Cumulative Gain mede a qualidade do ranking dos 10 primeiros resultados com relevância graduada. Recompensa a colocação de documentos muito relevantes perto do topo com um desconto logarítmico:
Isto corresponde aos ganhos lineares usados pelo ndcg_cut do trec_eval, selecionado através do pytrec_eval como ndcg_cut_10. O IDCG é o DCG da ordenação ideal das classes avaliadas; uma query sem ganho positivo recebe zero. Ganhos exponenciais, como , definem outra convenção e alterariam estes números.
Das três, o NDCG é a única métrica que usa por completo a relevância graduada de quatro níveis do ESCI. Um sistema que coloca um resultado Exact na posição 1 pontua mais do que um que ali coloca um Substitute. Por isso é a métrica principal aqui.
MRR (primeiro resultado Complement ou superior)
O Mean Reciprocal Rank usa a posição do primeiro resultado contado como relevante. Nesta demonstração, o avaliador passa as avaliações de relevância do ESCI ao pytrec_eval e usa recip_rank sobre cada lista devolvida de até 100 candidatos. O seu limiar binário é relevance > 0: Complement (1), Substitute (2) e Exact (3) contam como relevantes. Irrelevant (0) não conta. Um resultado relevante na posição 1 dá um rank recíproco de 1,0; na posição 3, dá 0,333. Isto é o MRR sobre as listas de candidatos devolvidas, e não o MRR@10.
Recall@100 (cobertura da recuperação)
O Recall@100 mede que fração dos documentos relevantes avaliados aparece nos 100 primeiros. Mantém-se fixo ao fazer reranking dos mesmos 100 candidatos, como nesta demonstração. Com um conjunto maior de candidatos, o reranking pode colocar um documento relevante nos 100 primeiros e aumentar a métrica, mas não pode recuperar um documento omitido pela recuperação.
O denominador inclui apenas documentos relevantes avaliados, como na implementação de recall do trec_eval. Um produto não avaliado não contribui com relevância positiva e não consta desse denominador. Avaliações incompletas podem, por isso, fazer com que o recall medido difira da cobertura de todos os produtos realmente relevantes.
Recuperação: pesquisa híbrida
A tarefa da camada de recuperação é maximizar o recall: pôr o maior número possível de documentos relevantes no conjunto de candidatos.
BM25: a baseline lexical
O BM25 pontua os documentos pela sobreposição de termos com a query, com saturação da frequência dos termos e normalização do comprimento do documento:
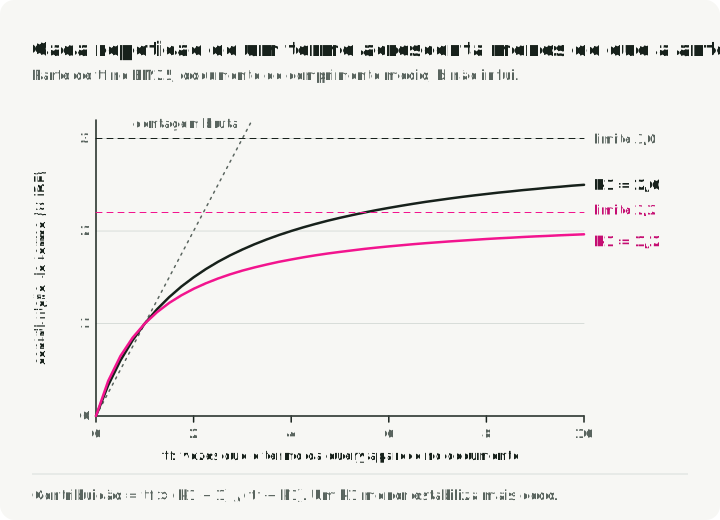
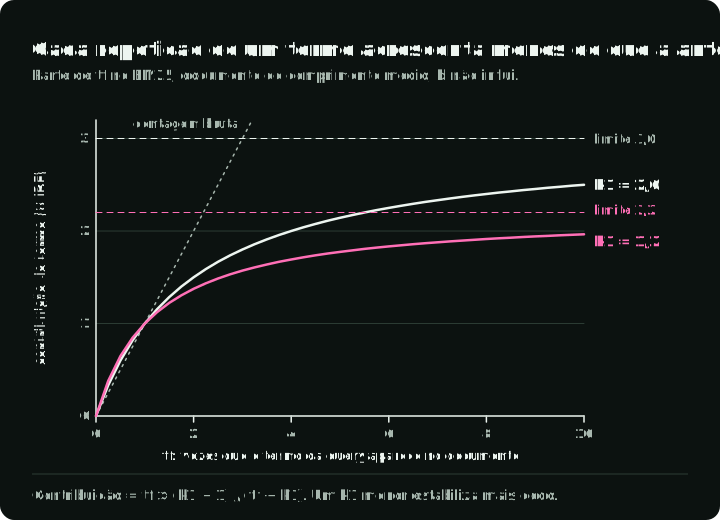
Aqui, é a frequência inversa de documentos do termo , é a frequência do termo no documento , é o comprimento do documento e é o comprimento médio dos documentos no corpus. Dois parâmetros importam: (tipicamente 1,2—2,0) controla a saturação da TF — a rapidez com que os termos repetidos deixam de acrescentar valor — e (tipicamente 0,75) controla a normalização do comprimento do documento.
O gráfico representa a parte da fórmula que depende da frequência do termo, para os dois extremos do intervalo habitual de :
A implementação é curta. Tokenização simples por espaços com rank_bm25:
# src/search_ranking_stack/stages/s01_bm25.py

from rank_bm25 import BM25Okapi

def run_bm25(data: ESCIData, top_k: int = 100):
    doc_ids = list(data.corpus.keys())
    tokenized_corpus = [text.lower().split() for text in data.corpus.values()]

    bm25 = BM25Okapi(tokenized_corpus)

    results = {}
    for query_id, query_text in data.queries.items():
        scores = bm25.get_scores(query_text.lower().split())
        top_indices = np.argsort(scores)[::-1][:top_k]
        results[query_id] = {doc_ids[idx]: float(scores[idx]) for idx in top_indices}

    return results
O BM25 atinge um Recall@100 de 0,741 — 74% dos produtos relevantes avaliados aparecem algures nos 100 primeiros. Um reranker que recebe apenas essa lista BM25 não consegue recuperar os 26% de produtos relevantes avaliados em falta.
Recuperação densa com bi-encoder
O bi-encoder mapeia queries e documentos, de forma independente, para um espaço de embeddings partilhado:
# Simplified from src/search_ranking_stack/stages/s02_dense.py

import numpy as np
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("sentence-transformers/all-MiniLM-L6-v2")
doc_texts = ["Sony WH-1000XM5 Wireless Headphones", "Headphone carrying case"]
query_texts = ["wireless headphones"]

# Encode corpus once, cache to disk
corpus_embeddings = model.encode(
    doc_texts,
    batch_size=128,
    normalize_embeddings=True,  # Cosine sim = dot product
    convert_to_numpy=True,
)

# At query time: encode query, compute dot product
query_embeddings = model.encode(query_texts, normalize_embeddings=True)
similarity_matrix = np.dot(query_embeddings, corpus_embeddings.T)
Com embeddings normalizados, a similaridade de cosseno reduz-se a um produto escalar. A demonstração calcula a matriz completa query por corpus porque 9870 documentos cabem confortavelmente em memória; um corpus de produção usaria normalmente um índice de vizinhos mais próximos aproximados. Nesta amostra, o all-MiniLM-L6-v2 aumenta o Recall@100 de 0,741 para 0,825.
Como os bi-encoders aprendem boas representações
O pré-treino do encoder e o fine-tuning de embeddings resolvem problemas diferentes. Um Transformer pré-treinado fornece representações de tokens; o fine-tuning contrastivo ensina um vetor agregado (pooled) quais os textos que devem ficar próximos. Dados de NLI, de similaridade de frases e de pares query-passagem são ingredientes possíveis, e não uma sequência universal. O model card do all-MiniLM-L6-v2, usado na demonstração, descreve um encoder MiniLM pré-treinado e ajustado (fine-tuned) com mais de mil milhões de pares de frases heterogéneos.
O fine-tuning de recuperação pode usar hard negative mining. Negativos aleatórios, como um documento de culinária emparelhado com uma query sobre auscultadores, podem ser fáceis demais para ensinar muito. Um recuperador pode, em vez disso, fornecer candidatos plausíveis que as avaliações identificam como não relevantes. Os documentos não avaliados com pontuação alta exigem cuidado: alguns podem ser positivos em falta.
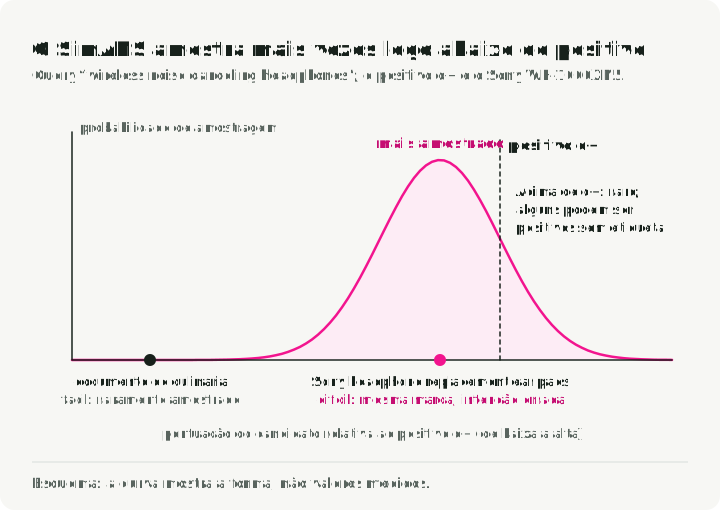
O SimANS amostra negativos com uma distribuição de probabilidade concentrada perto da pontuação de relevância do documento positivo. Reduz a ênfase tanto nos negativos fáceis como nos candidatos de pontuação mais alta que podem ser falsos negativos. Trata-se de amostragem enviesada a partir de candidatos recuperados, e não de uma regra rígida que exclui todos os documentos acima ou abaixo de um limite de posição. A curva mostra com que frequência um candidato recuperado é amostrado, em função da sua pontuação relativa ao positivo:
# What a training triplet looks like after hard negative mining
training_triplet = {
    "query": "wireless noise canceling headphones",
    "positive": "Sony WH-1000XM5 Wireless Noise Cancelling Headphones",
    "negative": "Sony headphone replacement ear pads",  # Hard negative: same brand, related product, but wrong intent
}
# The bi-encoder must learn that "ear pads" is NOT what the user wants,
# even though it shares many tokens with the positive document.
A função de loss contrastiva (InfoNCE) liga tudo isto. Para cada query com documento positivo e um conjunto de documentos negativos :
Aqui, é a similaridade de cosseno entre os embeddings da query e do documento, e é o parâmetro de temperatura (tipicamente 0,05—0,1). Valores mais baixos tornam a loss mais sensível aos hard negatives. É uma cross-entropy softmax: aumenta a similaridade do par positivo em relação a todos os negativos. Quando é pequeno, mesmo pequenas diferenças de similaridade produzem gradientes grandes, o que obriga o modelo a fazer distinções mais finas.
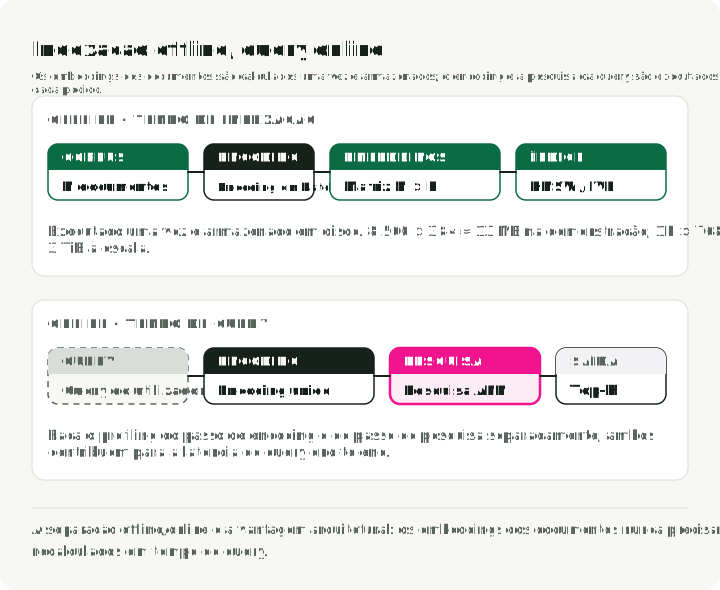
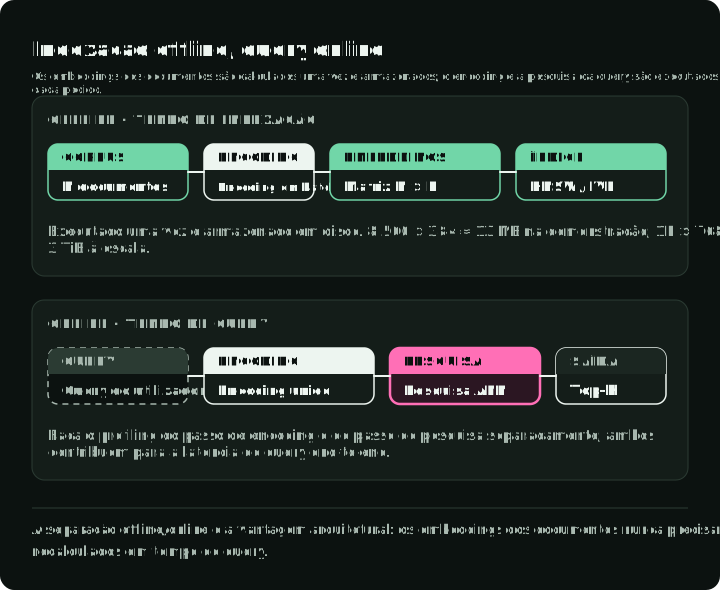
Servir embeddings de bi-encoder em escala
A vantagem arquitetural de um bi-encoder é a separação offline/online. Os embeddings dos documentos são calculados na altura da indexação e guardados num índice vetorial. Na altura da query, o sistema codifica a query e pesquisa esses vetores guardados. A latência depende do encoder, do hardware, do índice, dos filtros e do recall pretendido, por isso meça os dois passos em separado.
Na demonstração, as contas são modestas: 9870 documentos 384 dimensões 4 bytes por float = ~15 MB de embeddings. À escala de produção, os números deixam de ser modestos: 1000 milhões de documentos com embeddings de 768 dimensões precisam de ~3 TiB de armazenamento. É aqui que entram a quantização (comprimir floats de 32 bits em inteiros de 8 bits), a quantização de produto (decompor os vetores em subespaços) e os índices apoiados em SSD, como o DiskANN. A secção sobre indexação de vetores densos trata dos algoritmos de índice.
Porquê testar a recuperação híbrida
Os dois métodos falham muitas vezes de forma diferente. O BM25 adequa-se bem a nomes próprios, SKUs de produtos e códigos de erro. A recuperação densa consegue resolver o desfasamento de vocabulário, como “cheap laptop” contra “budget notebook computer”. Saber se a fusão ajuda depende da frequência com que esses casos complementares ocorrem no conjunto de queries de destino.
Uma experiência seguinte comum é a pesquisa híbrida: executar os dois métodos de recuperação e depois fundir as suas listas ordenadas.
Reciprocal rank fusion (RRF)
O BM25 e a recuperação densa produzem pontuações com significados e escalas diferentes. Uma combinação linear exige, por isso, calibração e validação sempre que os recuperadores ou o corpus mudam.
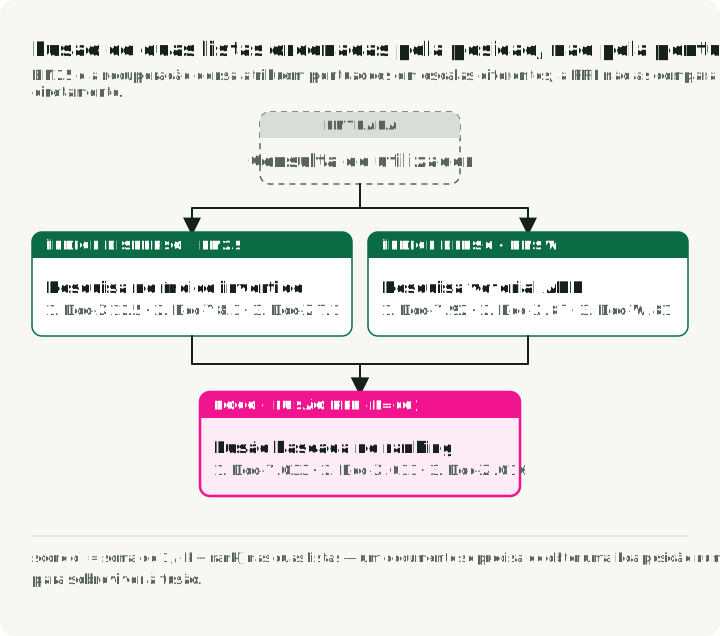
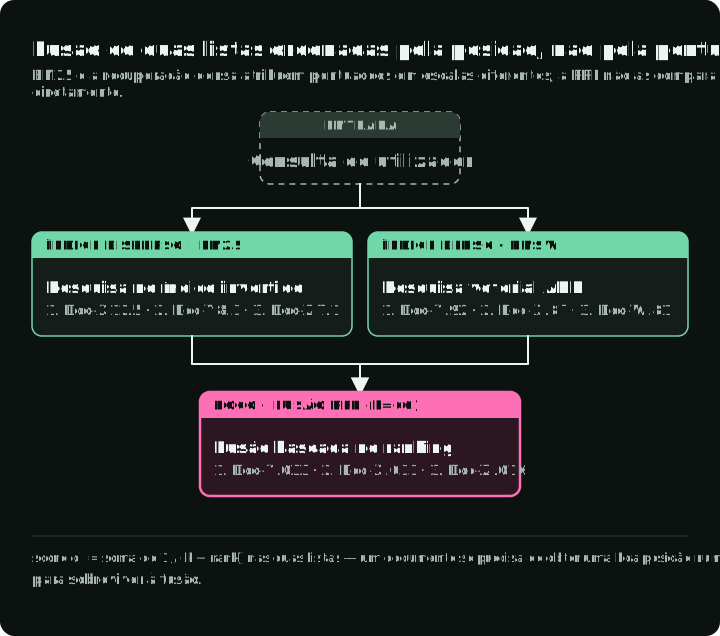
O Reciprocal Rank Fusion (Cormack et al., 2009) abandona por completo as pontuações brutas e usa apenas a posição no ranking:
Aqui, é uma constante de suavização; 60 é um valor inicial comum. O RRF recompensa os itens que ficam perto do topo em várias listas de entrada sem comparar as suas pontuações brutas. Evita a calibração da escala das pontuações, mas os limites da recuperação, os pesos e o continuam a exigir avaliação.
A implementação:
# src/search_ranking_stack/stages/s03_hybrid_rrf.py

from collections import defaultdict

def reciprocal_rank_fusion(ranked_lists, k=60, top_k=100):
    all_query_ids = set().union(*(results.keys() for results in ranked_lists))
    fused_results = {}

    for query_id in all_query_ids:
        rrf_scores = defaultdict(float)

        for results in ranked_lists:
            sorted_docs = sorted(results.get(query_id, {}).items(),
                                 key=lambda x: x[1], reverse=True)

            for rank, (doc_id, _score) in enumerate(sorted_docs, start=1):
                rrf_scores[doc_id] += 1.0 / (k + rank)

        sorted_rrf = sorted(rrf_scores.items(),
                            key=lambda x: x[1], reverse=True)[:top_k]
        fused_results[query_id] = dict(sorted_rrf)

    return fused_results
O RRF híbrido chega a um Recall@100 de 0,842 e a um NDCG@10 de 0,628 — superando o BM25 (0,585) e o denso (0,611) isoladamente. Um documento encontrado por apenas um recuperador também recebe uma pontuação RRF, mas pode ficar abaixo do limite dos 100 primeiros. Com , o rank 1 numa lista vale , menos do que o rank 50 nas duas listas (). A sobreposição pode pesar mais do que um rank forte numa única lista.
Reranking com cross-encoder
Com 100 candidatos híbridos por query, pode dar-se ao luxo de usar um modelo mais dispendioso. O cross-encoder processa a query e o documento em conjunto num único Transformer, com self-attention sobre a query e o documento combinados.
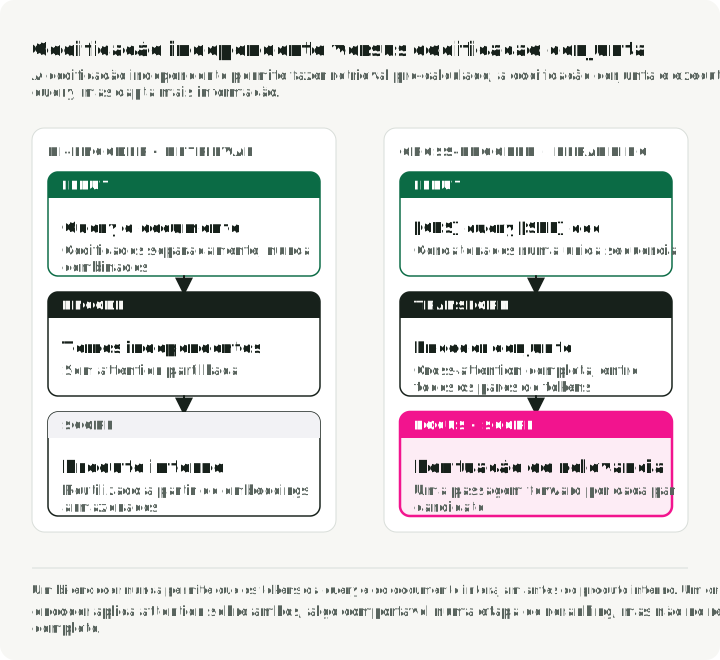
Interação ao nível dos tokens
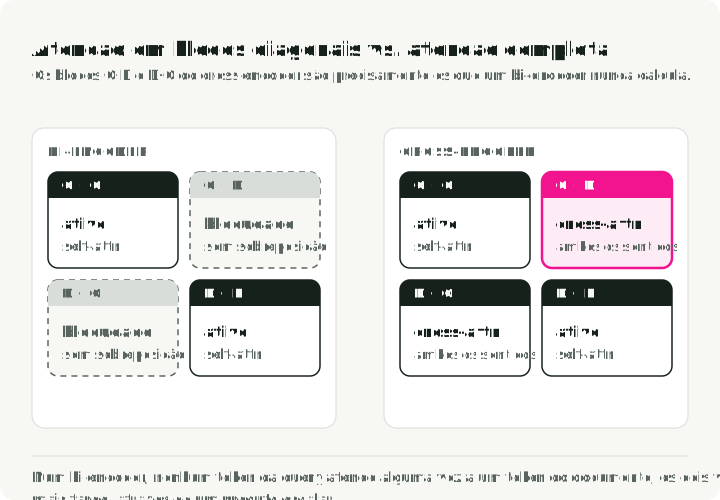
A diferença está na matriz de atenção. Num bi-encoder, a atenção é diagonal por blocos: os tokens da query só atendem a outros tokens da query, e os tokens do documento só atendem a outros tokens do documento. As duas representações nunca se encontram ao nível dos tokens — só se cruzam no fim, através de um produto escalar. Um cross-encoder calcula a matriz de atenção completa, em que cada token da query atende a cada token do documento e vice-versa. Essa self-attention conjunta permite ao modelo comparar diretamente os tokens da query e do documento.
Num bi-encoder, a query é codificada antes de qualquer documento ser visto. Um cross-encoder vê a query e o candidato em conjunto, pelo que pode usar a relação entre os seus tokens. Isto pode ajudar em casos como:
- Negação: “headphones that are not wireless.” Um embedding agregado (pooled) pode atribuir pouco peso à negação, enquanto a codificação conjunta dá ao modelo uma interação direta entre query e documento. Esta é uma hipótese a verificar com uma fatia dirigida, e não uma garantia.
- Qualificação: “laptop under $500.” A codificação conjunta pode relacionar a restrição com um preço no texto do produto, embora os filtros estruturados de preço sejam mais seguros quando o campo existe.
A entrada do cross-encoder é formatada como [CLS] query tokens [SEP] document tokens [SEP]. O [CLS] é um token de classificação cujo estado oculto final passa por uma cabeça linear para produzir uma única pontuação de relevância. Os embeddings de segmento distinguem os tokens da query dos tokens do documento, e o [SEP] marca a fronteira entre segmentos.
Como os cross-encoders são treinados
Os cross-encoders podem aprender a partir de exemplos (query, document, relevance_label) com objetivos pointwise, pairwise ou listwise. Um exemplo pointwise emparelha “wireless headphones” com “Sony WH-1000XM5 Wireless Headphones” e a etiqueta 1,0.
Um classificador comum mapeia a representação final do [CLS] para uma pontuação. As etiquetas binárias podem usar a binary cross-entropy; a relevância graduada pode usar losses de regressão, ordinais, pairwise ou listwise. Escolha com métricas de ranking em dados retidos (hold-out) em vez de assumir que um objetivo é universalmente melhor.
O hard negative mining também ajuda a treinar cross-encoders. Os cross-encoders são caros de treinar — cada exemplo de treino exige uma passagem forward completa pela sequência concatenada — por isso não se pode desperdiçar computação em negativos trivialmente fáceis. A receita prática: usar um bi-encoder para recuperar os top-K candidatos de cada query de treino e depois extrair hard negatives de intervalos de rank específicos (por exemplo, ranks 10–100). Isso dá ao cross-encoder exemplos em que distinguir o relevante do irrelevante exige uma interação profunda entre tokens.
Reranking dos candidatos recuperados
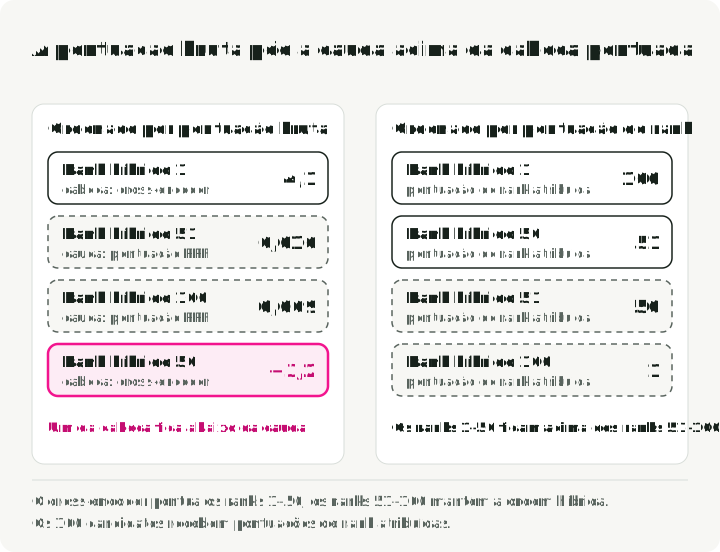
A fase envia pares (query, document) dos primeiros 50 candidatos híbridos para CrossEncoder.predict, coloca esses candidatos por ordem de pontuação e depois acrescenta os candidatos sem pontuação na sua ordem anterior. A figura ordena quatro dos 100 candidatos das duas formas e mostra porque é que a fusão atribui novas pontuações de rank em vez de manter as pontuações brutas:
# From src/search_ranking_stack/stages/s04_cross_encoder.py

def rank_scores(ordered_ids):
    return {doc_id: float(len(ordered_ids) - rank) for rank, doc_id in enumerate(ordered_ids)}

def merge_head_and_tail(original, scored_head):
    """original: hybrid (doc_id, rrf_score) pairs in rank order.
    scored_head: (doc_id, cross_encoder_score) pairs for the first len(scored_head)."""
    head = sorted(scored_head, key=lambda item: (-item[1], item[0]))
    tail = original[len(scored_head) :]
    return rank_scores([doc_id for doc_id, _ in head + tail])
A fase completa acrescenta o carregamento do modelo, o corte de documentos aos 2048 carateres e uma verificação de que todas as pontuações são finitas.
O model card mostra que as pontuações do cross-encoder podem ser negativas. Não as misture com as pontuações RRF da cauda sem pontuação: uma pontuação RRF positiva pode colocar um documento da cauda sem pontuação acima de um documento da cabeça com pontuação negativa. Atribua pontuações de rank estritamente decrescentes, como faz rank_scores. São pontuações de rank para avaliação, e não estimativas calibradas de relevância.
O compromisso entre velocidade e qualidade
Porque não usar cross-encoders para tudo? Porque não se pode pré-calcular as pontuações. Os embeddings dos documentos de um bi-encoder não dependem da query, por isso calculam-se uma vez e guardam-se. A saída de um cross-encoder depende da query e do documento em conjunto. A pontuação de relevância de “wireless headphones” emparelhado com um produto Sony resulta da self-attention conjunta entre esses tokens concretos. Pode guardar em cache um par query-documento repetido, mas a sua pontuação não pode ser reutilizada para outra query.
Um bi-encoder precisa de uma codificação da query mais uma pesquisa vetorial sobre embeddings de documentos pré-calculados. Um cross-encoder pontua todos os pares query-documento da lista curta, com um custo que cresce com o número de candidatos e com o comprimento da sequência. O batching ajuda, mas pontuar 100 000 candidatos continua a ser o ponto de operação errado; recupere primeiro e meça (benchmark) a maior lista curta que cumpra os objetivos de qualidade e de latência.
Reranking listwise com LLM
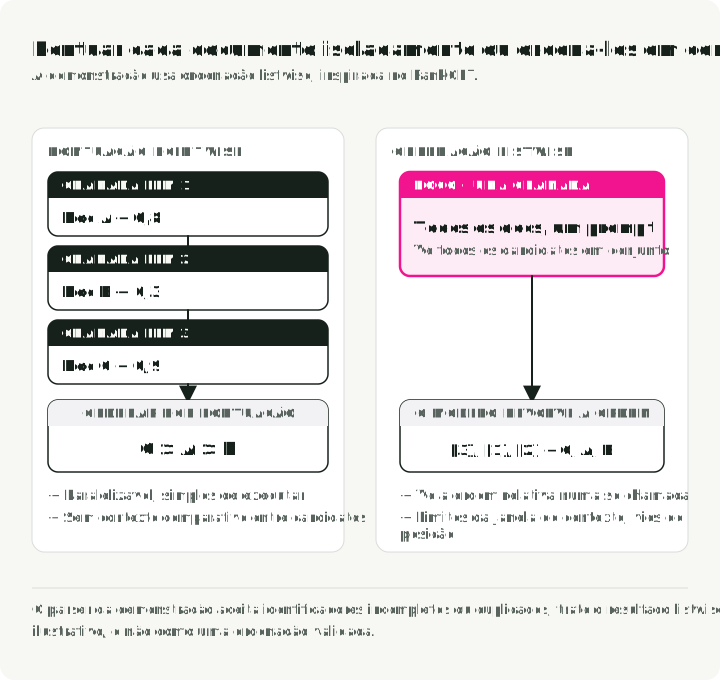
A fase final da demonstração usa um LLM para reranking listwise. Em vez de pontuar cada documento de forma independente, o modelo vê os 10 primeiros e devolve uma ordenação. Inspirado no RankGPT, o prompt torna explícita a comparação relativa, mas também introduz limites de contexto, enviesamento de posição, falhas de parsing e variação entre execuções.
O prompt listwise
O modelo de prompt pede ao LLM que considere a hierarquia de relevância do ESCI:
# src/search_ranking_stack/stages/s05_llm_rerank.py

def _create_listwise_prompt(query, documents, max_words=200):
    n = len(documents)

    doc_texts = []
    for i, (_doc_id, doc_text) in enumerate(documents, start=1):
        words = doc_text.split()[:max_words]
        doc_texts.append(f"[{i}] {' '.join(words)}")

    docs_formatted = "\n\n".join(doc_texts)

    return (
        f"I will provide you with {n} product listings, each indicated by a numerical "
        f"identifier [1] to [{n}]. Rank the products based on their relevance to the "
        f'search query: "{query}"\n\n'
        "Consider:\n"
        "- Exact matches (product satisfies all query requirements) should rank highest\n"
        "- Substitutes (functional alternatives) should rank above complements\n"
        "- Completely irrelevant products should rank lowest\n\n"
        f"{docs_formatted}\n\n"
        "Rank the products from most relevant to least relevant.\n"
        "Output ONLY a comma-separated list of product identifiers, e.g.: [3], [1], [2], ...\n"
        "Do not explain your reasoning. Only output the ranking."
    )
Três modos de execução
A demonstração suporta três backends para o reranking com LLM:
| Modo | Modelo | Como corre |
|---|---|---|
ollama | llama3.2:3b (defina OLLAMA_MODEL para o alterar) | Localmente, através da API do Ollama |
api | Claude Haiku (defina LLM_MODEL_API em config.py) | API da Anthropic; execute primeiro uv sync --extra api |
local | Qwen/Qwen2.5-1.5B-Instruct | HuggingFace Transformers; execute primeiro uv sync --extra llm |
Parsing e fallback
O parser extrai os identificadores numerados da resposta do modelo. Só aceita um ranking se este listar cada candidato exatamente uma vez:
# src/search_ranking_stack/stages/s05_llm_rerank.py

def _parse_ranking(output: str, n: int) -> list[int] | None:
    """Return 0-based positions if the output ranks IDs 1..n exactly once."""
    positions = [int(m) - 1 for m in re.findall(r"\[(\d+)\]", output)]

    # Reject missing, duplicate, and out-of-range IDs.
    if sorted(positions) != list(range(n)):
        return None

    return positions
Quando o parser devolve None, a demonstração mantém toda a ordem do cross-encoder para essa query e conta um fallback. Um erro do backend também conta como fallback. O run-all imprime a taxa de fallback e grava-a junto das métricas. Por exemplo, [3] > [1] > [3] é rejeitado: o ID 3 está repetido e faltam os IDs 2 e 4 a 10.
Resultados desta amostra ESCI
Os resultados usam a amostra small_version descrita acima; não é uma amostra retida (hold-out). As linhas vêm de uma execução de uv run run-all --llm-mode ollama com llama3.2:3b como LLM.
| Fase | NDCG@10 | MRR | Recall@100 | Delta NDCG |
|---|---|---|---|---|
| BM25 | 0,585 | 0,812 | 0,741 | — |
| Bi-encoder denso | 0,611 | 0,808 | 0,825 | +0,026 |
| Híbrido (RRF) | 0,628 | 0,834 | 0,842 | +0,017 |
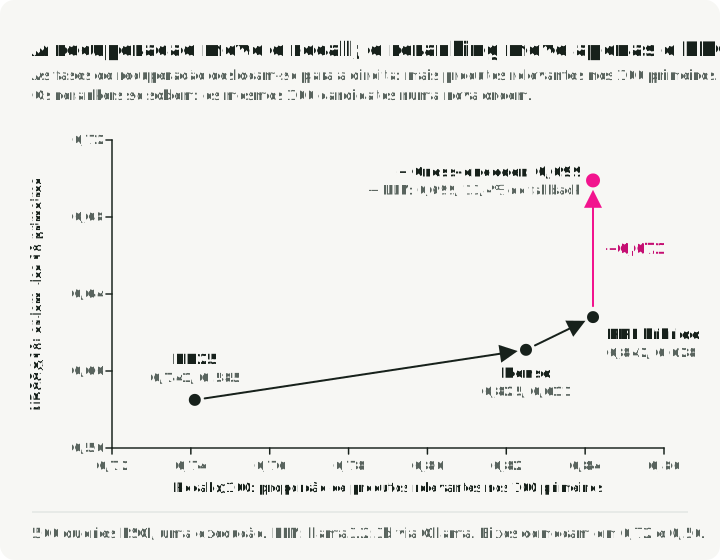
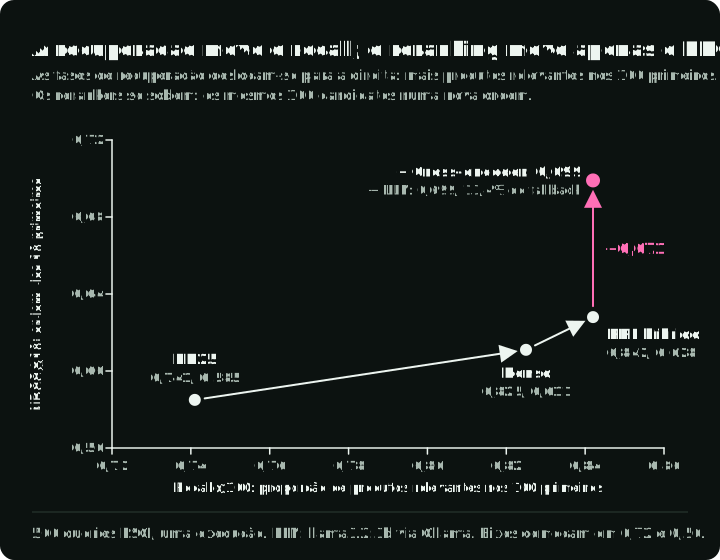
| + Cross-encoder | 0,699 | 0,886 | 0,842 | +0,071 |
| + Reranker LLM (13,4% de fallback) | 0,699 | 0,884 | 0,842 | +0,000 |
O gráfico representa o Recall@100 de cada linha em relação ao seu NDCG@10:
O que os resultados registados sustentam
A pesquisa híbrida supera cada método isolado. O RRF híbrido atinge um NDCG@10 de 0,628, acima do BM25 (0,585) e do denso (0,611). Tem também o Recall@100 mais alto das três linhas de recuperação (0,842). Os dois métodos podem falhar em queries diferentes, e a fusão recupera documentos que cada um, sozinho, perde.
O cross-encoder dá o maior ganho. Aumenta o NDCG@10 de 0,628 para 0,699 e o MRR de 0,834 para 0,886, pontuando apenas 50 candidatos por query. Nos 10 primeiros, a proporção de produtos Exact sobe de 36,0% (híbrido) para 41,4%.
Nesta demonstração, o recall é definido na recuperação. Ambos os rerankers mantêm os 100 candidatos híbridos, pelo que o Recall@100 permanece em 0,842. Para o aumentar, altere quais são os 100 candidatos devolvidos pela recuperação.
Um LLM local pequeno não acrescenta nada nesta amostra. O llama3.2:3b deixa o NDCG@10 em 0,699 e baixa ligeiramente o MRR. 67 das 500 respostas (13,4%) falharam no parser e mantiveram a ordem do cross-encoder, pelo que a ordem do LLM foi aplicada em 433 queries. Um modelo maior ou o modo API podem comportar-se de forma diferente; meça-os da mesma maneira, com a taxa de fallback ao lado da pontuação.
A recuperação densa supera o BM25 nesta amostra. Inspecione fatias de queries antes de atribuir a causa. O desfasamento de vocabulário é uma causa plausível, mas a construção da amostra, o tokenizador, o domínio de treino do modelo e os campos do corpus também afetam a comparação.
Indexar vetores densos para além da demonstração
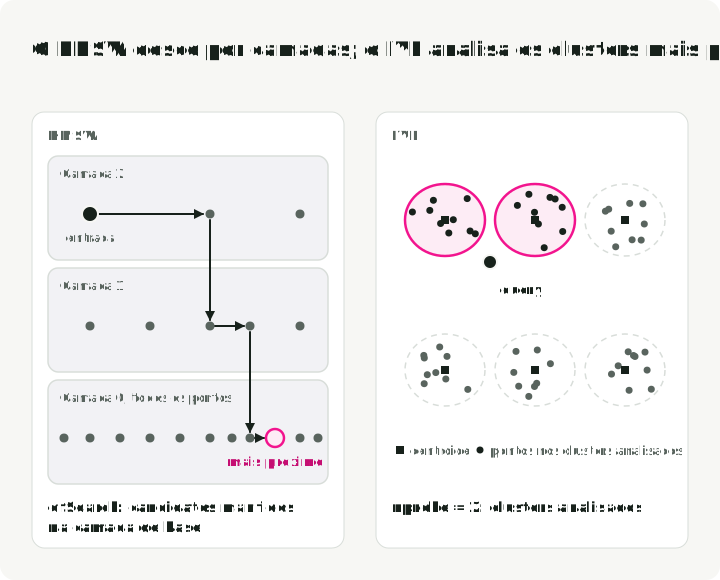
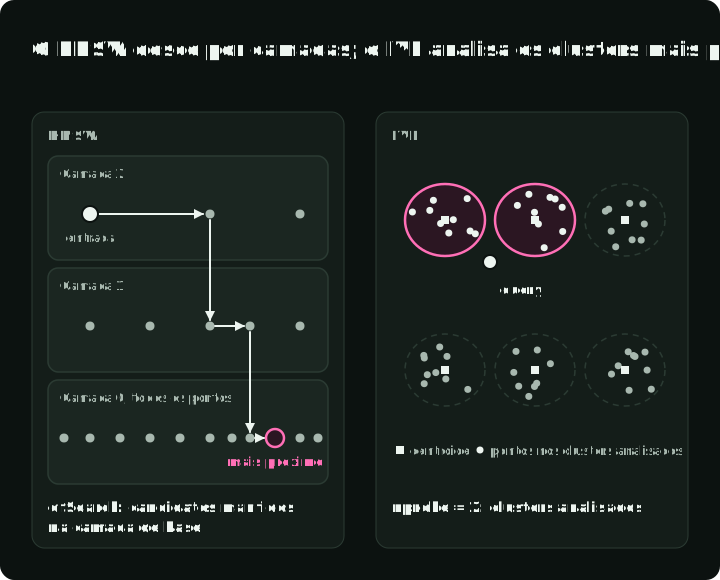
Os embeddings densos só se tornam úteis em escala quando existe um índice de vizinhos mais próximos aproximados (ANN). A demonstração usa similaridade de cosseno por força bruta (o que serve com 9870 documentos), mas os sistemas de produção precisam de índices especializados. As duas famílias comuns pesquisam de formas diferentes, e cada uma tem um parâmetro de tempo de pesquisa que troca recall por trabalho de query. A figura mostra o caminho que o HNSW segue e os clusters que o IVF analisa:
HNSW (hierarchical navigable small world)
O HNSW constrói um grafo de várias camadas: as camadas superiores, esparsas, navegam em largura, e as camadas inferiores, mais densas, refinam a vizinhança. O M controla a conectividade do grafo, enquanto o efSearch troca trabalho de query por recall. Os valores úteis dependem da dimensão, da distribuição das distâncias, dos filtros, da implementação e do recall pretendido.
Os índices em grafo podem perder recall com muitas atualizações ou filtros restritivos; um issue do Qdrant mostra o recall filtrado a recuperar apenas depois de uma reconstrução. Teste o seu padrão de atualizações e de filtros, incluindo o tempo de reconstrução.
IVF (inverted file)
Os índices IVF dividem o espaço vetorial em clusters e depois analisam os nprobe clusters mais próximos da query. Podem oferecer um bom compromisso entre memória, tempo de construção e recall, sobretudo quando combinados com compressão. A semântica e o desempenho das atualizações dependem da implementação, e não apenas da família do índice.
O RaBitQ (Gao & Long, SIGMOD 2024) é um quantizador aleatório que pode ser combinado com o IVF. Normaliza vetores centrados, usa uma rotação ortogonal aleatória e codifica os sinais com um bit por dimensão. A estimativa de distâncias usa também fatores de correção e normas dos vetores; os limites de erro do artigo aplicam-se a esse estimador e aos seus pressupostos. Use-o quando a memória for o limite e as estimativas de distância quantizadas ainda cumprirem o seu objetivo de recall.
| Dimensão | Grafo HNSW | Clusters IVF |
|---|---|---|
| Controlo da query | efSearch | nprobe |
| Controlo da construção | Conectividade e feixe de construção | Número de clusters e amostra de treino |
| Perfil de memória | Arestas do grafo mais vetores | Centroides, listas e vetores guardados |
| Comportamento nas atualizações | Reparação/limpeza específica da base de dados | Manutenção das listas específica da base de dados |
| Normalmente escolhido quando | Os vetores cabem em RAM e precisa de baixa latência com recall alto | A memória ou o tamanho do corpus é o limite; combine com PQ ou RaBitQ |
Para qualquer dos índices, meça a curva de recall, latência e memória nos seus próprios dados e na sua própria carga de queries.
A Uber reduziu a latência e o CPU ao diminuir o número de candidatos por shard, com pouca perda de recall; ajuste esse número com tráfego semelhante ao de produção.
Extensões opcionais depois do pipeline principal
Quando a recuperação e o reranking têm medições separadas, várias extensões ficam mais fáceis de avaliar sem obscurecer o pipeline principal.
Compreensão de queries
A expansão e a reescrita de queries podem resolver o desfasamento de vocabulário antes da recuperação. O Query2doc gerou pseudodocumentos e reportou ganhos de BM25 nas suas experiências com o MS MARCO. A expansão também pode introduzir a intenção errada, por isso compare o recall e a precisão em fatias de queries ambíguas, de navegação e de identificadores exatos.
Padrões práticos: expansão de abreviaturas, enriquecimento de entidades, decomposição em subqueries para raciocínio em vários passos e o RAG-Fusion — gerar várias variantes da query e combinar os resultados através do RRF.
Etiquetagem de relevância assistida por LLM
Os LLMs podem redigir etiquetas de relevância quando as avaliações humanas são escassas. O trabalho de etiquetagem de relevância do Pinterest descreve a expansão dos dados de treino para além das etiquetas humanas e a destilação de um modelo de relevância baseado em LLM para servir em produção. Uma etiqueta de LLM continua a ser saída de um modelo: calibre-a com avaliações humanas cegas, inspecione as fatias de desacordo e mantenha um conjunto de referência humano para testes de regressão.
Os controlos úteis incluem:
- um guia de avaliação com limites de relevância concretos e exemplos;
- calibração humana cega e reverificações periódicas;
- aleatorização da ordem e avaliações repetidas para os casos instáveis;
- painéis de modelos, quando o custo adicional melhora a concordância; e
- verificações explícitas de enviesamento de posição e de tendência central.
Destilação de conhecimento
Quando um LLM professor acrescenta valor mas não cumpre as restrições de serving, a destilação é uma opção:
- Usar um LLM poderoso (o professor) para fazer o reranking de milhares de queries de treino offline; só o aluno, pequeno, corre a cada pedido
- Treinar um cross-encoder pequeno e rápido (o aluno, ~100M–200M parâmetros) para imitar a distribuição de ranking do LLM
- Comparar o aluno com o professor e com a baseline em qualidade, calibração e custo de serving
O InRanker destila o MonoT5-3B em modelos de 60M e 220M de parâmetros, respetivamente 50x e cerca de 13x mais pequenos, com melhor eficácia fora do domínio do que as versões não destiladas. A abordagem Rank-Without-GPT produz rerankers listwise open source de 7B que atingem 97% da eficácia do reranker GPT-4 comparado, medida por nDCG@10 no TREC-DL-19 e no TREC-DL-20, com fine-tuning QLoRA.
Os resultados de compressão publicados são pontos de partida, e não rácios esperados em produção. A destilação pode herdar os enviesamentos do professor e perder qualidade em fatias raras de queries, por isso mantenha as avaliações de relevância originais no ciclo de avaliação.
Personalização e enviesamento de posição
Uma pesquisa por “apple” deve devolver iPhones a um entusiasta de tecnologia e receitas com maçã a quem tem andado a ver conteúdo de culinária.
Uma arquitetura de recuperação comum para personalização usa um modelo de embeddings two-tower: a torre de query codifica a query e o contexto do utilizador, enquanto a torre de itens codifica os itens e os metadados. A figura mostra que lado corre por pedido, que lado é calculado offline e onde cai a query “apple” para dois utilizadores:
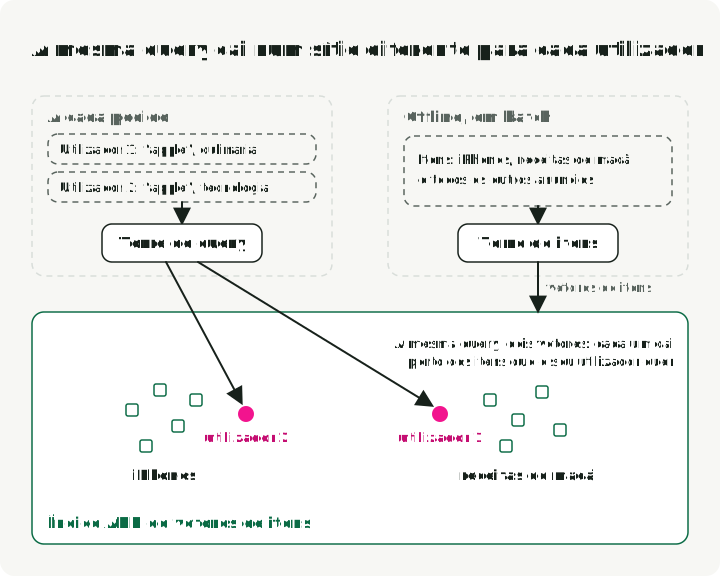
A separação offline/online permite a recuperação por vizinhos mais próximos aproximados; a sua latência continua a depender do encoder, do índice, dos filtros e do sistema de serving. Três designs de produção usam embeddings aprendidos em sítios diferentes. A Airbnb aprende embeddings de anúncios a partir das sessões de cliques dos utilizadores e usa a similaridade com anúncios clicados recentemente como features do ranking de pesquisa. O OmniSearchSage do Pinterest aprende um embedding de query em conjunto com embeddings de pins e de produtos. A Uber usa um modelo two-tower para recuperar algumas centenas de lojas para o feed inicial do Uber Eats.
Os dados de cliques trazem enviesamento de posição e de exposição. O PAL é uma abordagem de remoção desse enviesamento: treina em conjunto um módulo de exposição e um módulo de clique dada a exposição, e depois serve o segundo sem entrada de posição. Não é uma solução universal; intervenções aleatorizadas, métodos de propensão inversa e avaliação contrafactual podem ser mais adequados para outro produto.
Adaptação ao domínio com queries sintéticas
Um erro comum de estratégia de pesquisa é assumir que um modelo treinado em dados gerais da web (como o MS MARCO) funcionará bem num domínio especializado. Este é o problema fora do domínio (OOD).
A geração sintética de queries pode reduzir o estrangulamento de dados etiquetados. O InPars gera queries para documentos e filtra pares para treino. O Generative Pseudo-Labeling (GPL) acrescenta um passo de etiquetagem pelo professor:
- Gerar queries a partir do corpus de documentos de destino.
- Recuperar documentos negativos para cada query gerada.
- Usar um cross-encoder professor para pontuar pares positivos e negativos, produzindo uma margem de pontuação de relevância.
- Treinar o recuperador denso para reproduzir essas margens.
Os pares sintéticos podem ajudar quando as queries reais são escassas, mas refletem o gerador e o prompt. Elimine duplicados, filtre queries implausíveis e valide com tráfego real retido (hold-out).
Uma sequência de experiências
Acrescente complexidade apenas quando a fase anterior expuser uma falha medida. Cada passo indica a falha que o justifica:
- Estabeleça uma baseline. Execute o BM25 ou o sistema lexical atual sobre um conjunto de queries avaliadas. Registe o recall, o NDCG, a latência e os grupos de queries em que falha.
- Recupere os candidatos em falta. Teste a recuperação densa e a fusão quando a baseline perde documentos relevantes. Ajuste o limite de candidatos em função do recall e do custo.
- Melhore a ordem. Acrescente um cross-encoder quando os candidatos relevantes estão presentes mas ficam classificados demasiado abaixo. Escolha o tamanho da lista curta medindo a qualidade e a latência em vários limites. Na demonstração, este passo aumentou o NDCG@10 de 0,628 para 0,699.
- Adapte ao domínio. Faça fine-tuning ou destilação depois de os modelos genéricos mostrarem falhas estáveis específicas do domínio. Mantenha as avaliações reais retidas (hold-out) separadas dos dados de treino sintéticos.
- Teste o reranking dispendioso. Experimente o reranking listwise ou baseado em raciocínio apenas quando a qualidade acrescentada sobreviver a execuções repetidas e justificar a latência, o custo, os requisitos de privacidade e a complexidade do fallback. Na demonstração, o
llama3.2:3bnão passou neste teste.
O stack inicial e as avaliações a recolher dependem do produto:
| Caso de uso | Stack inicial candidato | Validar |
|---|---|---|
| Pesquisa de produtos | BM25 + recuperação densa + RRF + cross-encoder | Recall de atributos, substituições, latência, restrições de negócio |
| Pesquisa de documentação | Recuperação híbrida + cross-encoder | Identificadores exatos, perguntas semânticas, filtros de versão |
| Redução de pedidos de suporte | Recuperação híbrida + verificação de citações | Recall da recuperação, fundamentação, abstenção |
| Marketplace ou anúncios | Filtros lexicais + recuperação densa + reranker de negócio | Disponibilidade, atualidade, política, diversidade de vendedores |
| Pequeno corpus interno | Baseline BM25 e depois um reranker | Se o desfasamento de vocabulário justifica um índice denso |
| Pesquisa jurídica ou médica de alto risco | Recuperação focada no recall mais revisão por especialistas | Cobertura, proveniência, abstenção calibrada |
Em todas as comparações, mantenha um conjunto real de avaliações retidas (hold-out) separado dos dados de treino. Registe os rankings por query, as falhas, a latência e o custo, para que um ganho agregado possa ser rastreado até à fase alterada. As camadas dispendiosas precisam também de políticas explícitas de privacidade e de fallback.
Direções de investigação a avaliar em separado
Os rerankers com raciocínio e os agentes que usam pesquisa são promissores, mas respondem a perguntas diferentes das da demonstração de pesquisa de produtos em cinco fases.
Rerankers baseados em raciocínio
O Rank1 treina rerankers com traços de raciocínio e reporta bons resultados no benchmark BRIGHT. Essa evidência é relevante para a recuperação que exige muito raciocínio, e não uma previsão direta para a pesquisa de produtos do ESCI.
Para pesquisa jurídica ou científica, compare os rerankers com raciocínio com baselines fortes de cross-encoder e listwise, em avaliações de especialistas, citações, latência e consistência das falhas.
Pesquisa agentic
O Search-o1 estuda um modelo que emite pesquisas adicionais durante a resposta a perguntas em vários passos. Este é um problema de orquestração — geração de queries, paragem, uso de evidências e avaliação das respostas — e não mais uma fase de reranking. Avalie-o pela correção na tarefa final e pelo suporte de citações, e não apenas por métricas de recuperação.
Referências
Artigos
- Reciprocal Rank Fusion — Cormack et al., 2009
- RankGPT: LLMs as Zero-Shot Listwise Rerankers — Sun et al., EMNLP 2023 Outstanding Paper
- Rank1: Reasoning-Based Reranking — Weller et al., COLM 2025
- Query2doc: LLM Query Expansion — Wang et al., EMNLP 2023
- GPL: Generative Pseudo Labeling — Adaptação ao domínio para recuperação densa
- InRanker: Distilled Reranker — Redução de tamanho de 50x com desempenho competitivo
- Search-o1: Agentic Retrieval — Li et al., 2025
- BEIR Benchmark — Thakur et al., NeurIPS 2021
- Sentence-BERT — Reimers & Gurevych, EMNLP 2019
- InfoNCE / CPC — van den Oord et al., 2018
- SimANS: Hard Negative Sampling — Zhou et al., EMNLP 2022
- Passage Reranking with BERT — Nogueira & Cho, 2019
- HNSW — Malkov & Yashunin, 2016
- DiskANN — Subramanya et al., NeurIPS 2019
- RaBitQ — Gao & Long, SIGMOD 2024
- Replacing Judges with Juries — Verga et al., 2024
- RAG-Fusion — Rackauckas, 2024
- InPars — Bonifacio et al., SIGIR 2022
- BRIGHT Benchmark — Su et al., ICLR 2025
- Rank-without-GPT — Zhang et al., ECIR 2025
- Pinterest LLM Search Relevance — Wang et al., 2024
- OmniSearchSage — Agarwal et al., WWW 2024
- PAL: Position-bias Aware Learning — Guo et al., RecSys 2019
Datasets e benchmarks
- Amazon ESCI: Shopping Queries Dataset — KDD Cup 2022
- BEIR: Benchmarking IR — Benchmark heterogéneo para avaliação zero-shot
- MTEB: Massive Text Embedding Benchmark — Leaderboard de modelos de embeddings
- ESCI Paper — Reddy et al., 2022
Modelos usados na demonstração
- all-MiniLM-L6-v2 — bi-encoder de 22M parâmetros
- ms-marco-MiniLM-L12-v2 — cross-encoder de 33M parâmetros
- Sentence-Transformers — framework de modelos de recuperação neuronal
Ferramentas e plataformas
- rank_bm25 — Implementação de BM25 em Python
- Pyserini BEIR Reproductions — Baselines BM25 do Lucene para o BEIR
- pytrec_eval — Kit de avaliação TREC
- Elasticsearch — Pesquisa híbrida com a Retrievers API
- Vespa — Motor unificado de pesquisa e recomendação
- Weaviate — Base de dados vetorial com pesquisa híbrida
- Qdrant — Base de dados vetorial com queries em várias fases
Referências da indústria
- Airbnb Listing Embeddings — Grbovic & Cheng, KDD 2018
- Uber Delivery Search — Uber Engineering, 2025
- Uber Two-Tower Embeddings — Uber Engineering, 2023
- Elastic Rerank — Elastic, 2024
Projeto de demonstração
- search-ranking-stack — Demonstração funcional do pipeline deste artigo