Stack rankingowy wyszukiwania: BM25, embeddings i reranking

Tłumaczenie automatyczne
Ten artykuł został automatycznie przetłumaczony z angielskiego oryginału.
Ten przewodnik jest dla inżynierów Pythona, którzy budują lub ulepszają pipeline rankingowy wyszukiwania. Wyjaśnia, jak BM25, gęste embeddings, fuzja rankingów i rerankery działają razem oraz jak zmierzyć, czy wyszukiwanie potrzebuje lepszych kandydatów, czy lepszej kolejności.
Wyszukiwanie „cheap laptop” może pominąć produkt opisany jako „budget notebook computer”. Inny błąd stawia etui na słuchawki wyżej niż same słuchawki. Pierwszy problem wymaga lepszych kandydatów, drugi lepszej kolejności.
Towarzyszące repozytorium demonstracyjne pokazuje wyszukiwanie i reranking na próbce danych Amazon ESCI z wyszukiwania produktów.
Zwięzły przewodnik wyboru etapów znajdziesz w BM25 vs Embeddings vs Rerankers. Sekwencja eksperymentów w dalszej części artykułu łączy każdy etap z pomiarem.
Modele leksykalne, gęste i modele cross-encoder
Stack łatwiej zrozumieć jako trzy warstwy. Wyszukiwanie leksykalne znajduje dokładne terminy, wyszukiwanie gęste zmniejsza lukę słownikową, a rerankery szczegółowo porównują najlepszych kandydatów.
BM25 i wyszukiwanie leksykalne
Przez dziesięciolecia domyślnym wyborem był BM25. To model probabilistyczny, który ocenia dokumenty według częstości terminów zapytania w dokumencie, znormalizowanej długością dokumentu i odwrotną częstością dokumentową (IDF).
BM25 działa dobrze, gdy intencję niosą dosłowne terminy: kody błędów, SKU produktów, nazwy i identyfikatory API. Jego główne ograniczenie to niedopasowanie słownictwa. Zapytanie „cheap laptop” może pominąć dokument o „budget notebook computer”, jeśli indeksowany tekst nie łączy tych wyrażeń.
Mimo to badanie BEIR uznało BM25 za mocny baseline zero-shot w zróżnicowanych zadaniach wyszukiwania. Wyniki BM25 w BEIR pochodzą z Lucene przez Pyserini, a nie z rank_bm25 z tokenizacją po białych znakach, którego używa to demo. BM25 pokonuje też niektóre modele neuronowe w zadaniach wyszukiwania argumentów, takich jak Touche-2020.
Wyszukiwanie gęste i embeddings
Enkodery w stylu BERT uczyniły wyszukiwanie gęste praktycznym. Odwzorowują zapytania i dokumenty we wspólnej przestrzeni wektorowej, a potem szeregują kandydatów funkcją podobieństwa, taką jak podobieństwo cosinusowe lub iloczyn skalarny.
Architektura bi-encodera (inaczej „two-tower”) koduje zapytanie i dokument osobno i tworzy embeddings o stałej długości. Wektory dokumentów można obliczyć wcześniej i zindeksować offline, a potem szybko wyszukiwać algorytmami Approximate Nearest Neighbor (ANN). Dzięki temu „cheap laptop” i „budget notebook” lądują blisko siebie w przestrzeni wektorowej.
Niektóre bi-encodery używają architektury syjamskiej, jak Sentence-BERT, w której obie strony współdzielą wagi. Inne mają osobne wieże zapytania i dokumentu. Pooling, rozmiar wektora, funkcja podobieństwa i cel treningu to wybory modelu, a nie cechy każdego gęstego retrievera.
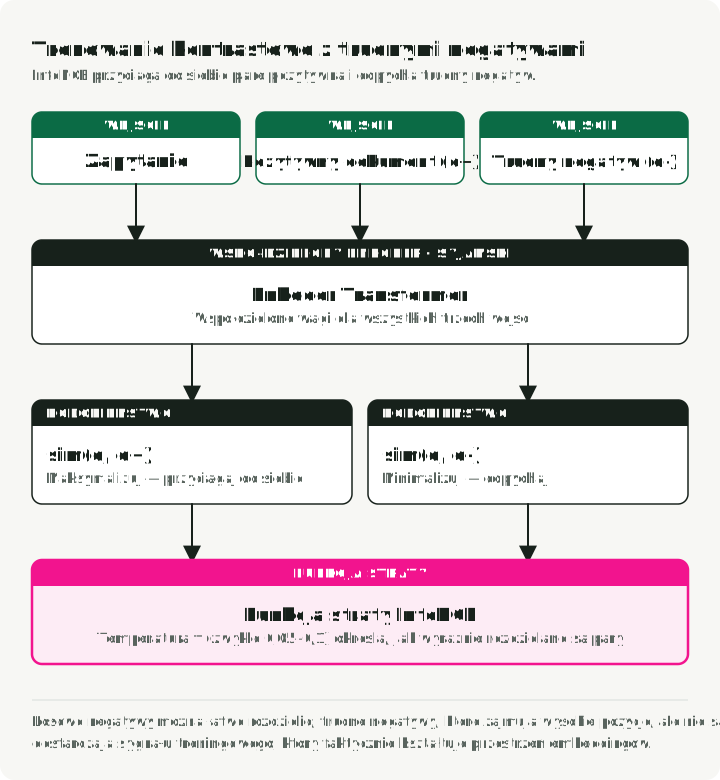
Te modele trenuje się przez uczenie kontrastowe, zwykle ze stratą InfoNCE. Dla batcha par (query, positive_document) cel maksymalizuje sim(query, positive_doc) i minimalizuje sim(query, negative_docs). Negatywy pochodzą z pozytywów innych zapytań w tym samym batchu (in-batch negatives). Parametr temperatury określa, jak ostro model musi rozdzielić te dwie wartości.
Dane treningowe często mają większe znaczenie niż wymiar embeddings. Modele wyszukiwania uczą się z par zapytanie-pozytyw oraz starannie wybranych trudnych negatywów: wiarygodnych, lecz nietrafnych dokumentów. Dalsza sekcja o treningu pokazuje, jak SimANS unika zarówno trywialnych negatywów, jak i prawdopodobnych fałszywych negatywów.
Kosztem jest wąskie gardło reprezentacji. Bi-encodery ściskają całe niuanse semantyczne w jeden wektor o stałym rozmiarze, więc często pomijają drobne interakcje między konkretnymi terminami zapytania a konkretną treścią dokumentu.
Modele cross-encoder i LLMs
Modele cross-encoder (Nogueira & Cho, 2019) podają zapytanie i dokument razem do Transformera jako jedną połączoną sekwencję ([CLS] Query [SEP] Document), więc każdy token zapytania może zwracać uwagę na każdy token dokumentu dzięki pełnemu self-attention. Ta głęboka interakcja wychwytuje niuanse, które umykają przy niezależnym kodowaniu.
Reranking LLM używa modelu sterowanego przez prompt, który porównuje kilku kandydatów naraz. RankGPT pokazał mocne wyniki zero-shot w trybie listwise z GPT-4 na ocenianych benchmarkach, ale stabilność wyników, koszt i dopasowanie do domeny nadal trzeba testować osobno.
Tych wyników nie da się obliczyć z góry dla dowolnych zapytań, więc reranking następuje po wyszukiwaniu. Ta asymetria kosztów uzasadnia wieloetapowy lejek.
Wieloetapowy lejek
Uruchamianie drogiego modelu cross-encoder lub LLM na milionach dokumentów jest nieopłacalne, więc współczesne stacki wyszukiwania używają lejka. Wyszukiwanie i pre-ranking zmniejszają zbiór kandydatów, aby pełny ranking mógł używać droższych modeli na krótkiej liście. Blending następnie stosuje reguły lub politykę rankingową; jego koszt zależy od tej polityki.
Tani retriever nie zapewnia też końcowej precyzji, więc lejek używa każdego modelu tylko tam, gdzie jego koszt jest uzasadniony. Rysunek pokazuje liczbę elementów na wejściu każdego etapu i schematyczny koszt modelu oraz zaznacza, że późniejsze etapy nie mogą odzyskać pominiętych dokumentów:
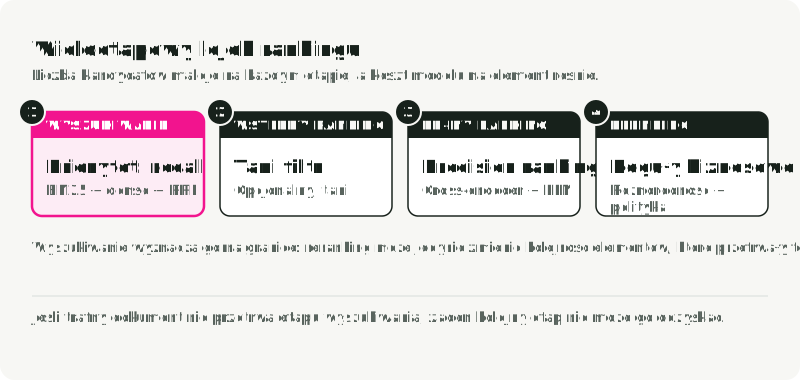
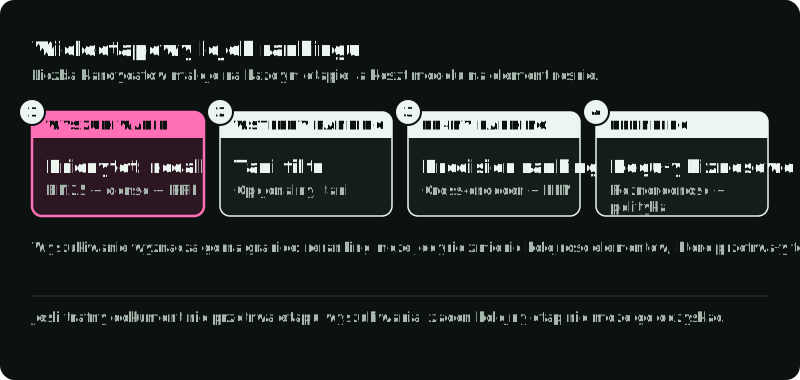
| Etap | Skala wejścia | Główny cel | Typowe metody | Miara wyjścia |
|---|---|---|---|---|
| Wyszukiwanie | Korpus lub indeks | Recall kandydatów | BM25, bi-encodery | Recall przy progu liczby kandydatów |
| Pre-ranking | Duży zbiór kandydatów | Tanie filtrowanie | Lekkie modele, reguły | Zachowany recall na milisekundę |
| Pełny ranking | Krótka lista | Jakość czołówki rankingu | Modele cross-encoder, LLMs | NDCG/MRR, opóźnienie, koszt |
| Blending | Końcowe listy lub sloty | Ograniczenia i miks | Reguły, ranking wielokryterialny | Polityka, różnorodność, guardrails biznesowe |
Reranker zmienia kolejność kandydatów zwróconych przez wyszukiwanie, ale nie może dodać nowego. Pokrycie zapewniane przez pobranych kandydatów ogranicza więc to, co późniejsze etapy mogą odzyskać. Przy ponad 100 kandydatach reranking może przenieść trafny dokument do pierwszej setki i poprawić Recall@100. W tym demie pozostaje wszystkich 100 kandydatów, więc reranking nie może zmienić Recall@100.
Narzędzia dla każdego etapu
Demo używa małych bibliotek w pamięci. Poza laptopem każdy etap ma kilka popularnych implementacji:
| Etap | Narzędzie | Kiedy użyć |
|---|---|---|
| BM25 | rank_bm25 | Korpus mieści się w pamięci i chcesz szybki baseline |
| Elasticsearch, OpenSearch lub Lucene przez Pyserini | Korpus wymaga indeksu odwróconego, analizatorów i filtrów | |
| Wyszukiwanie gęste | FAISS | Chcesz biblioteki ANN wewnątrz własnej usługi |
| pgvector | Dane już leżą w Postgresie | |
| Qdrant, Weaviate, Vespa lub Elasticsearch kNN | Potrzebujesz filtrów metadanych, częstych aktualizacji i zarządzanego indeksu | |
| Fuzja | Elasticsearch RRF retriever, Qdrant Query API z rrf | Chcesz fuzji rankingów wewnątrz silnika wyszukiwania |
| Weaviate hybrid search | Używasz Weaviate; oferuje fuzję rankingową i fuzję względnych wyników | |
| Modele embeddings | Zakładka retrieval w MTEB, a potem własne ocenione zapytania | Wybierasz model; leaderboard zawęża listę, decydują twoje zapytania |
| Reranker | ms-marco-MiniLM-L12-v2 | Tekst angielski, budżet CPU |
bge-reranker-v2-m3 | Tekst wielojęzyczny | |
| Elastic Rerank | Tekst angielski już w Elasticsearch; wymaga odpowiedniej subskrypcji lub wersji próbnej |
Demo: pipeline z pięcioma etapami
Aby to uczynić konkretnym, zbudowałem demo search-ranking-stack, które uruchamia pipeline z pięcioma etapami na benchmarku wyszukiwania produktów Amazon ESCI. Każdy etap zapisuje metryki.
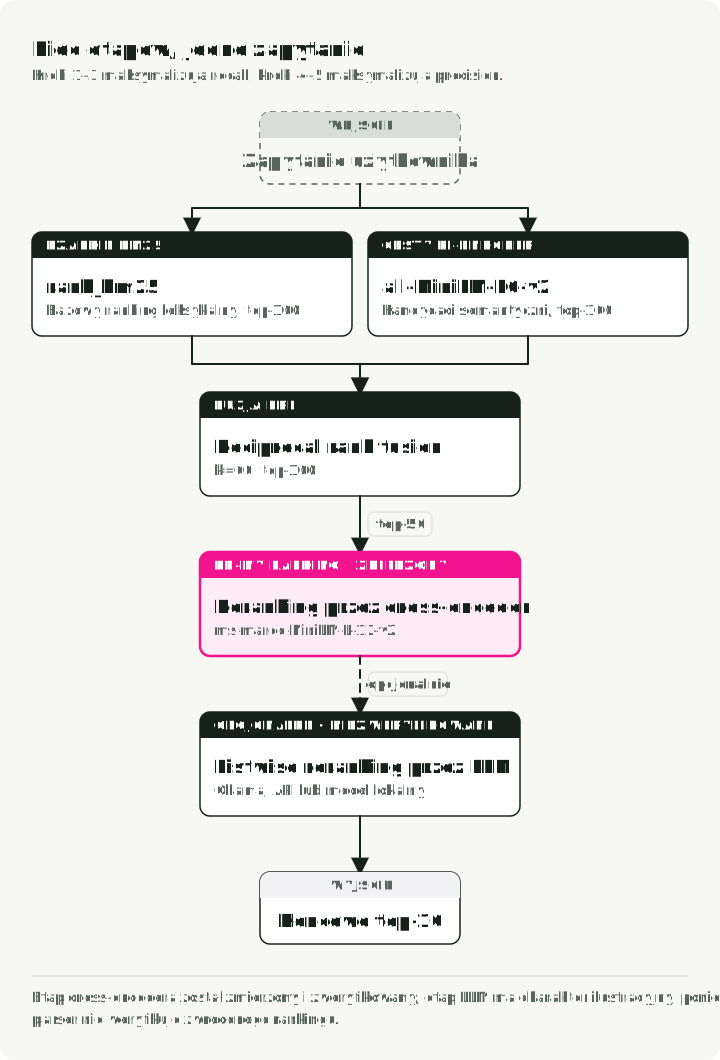
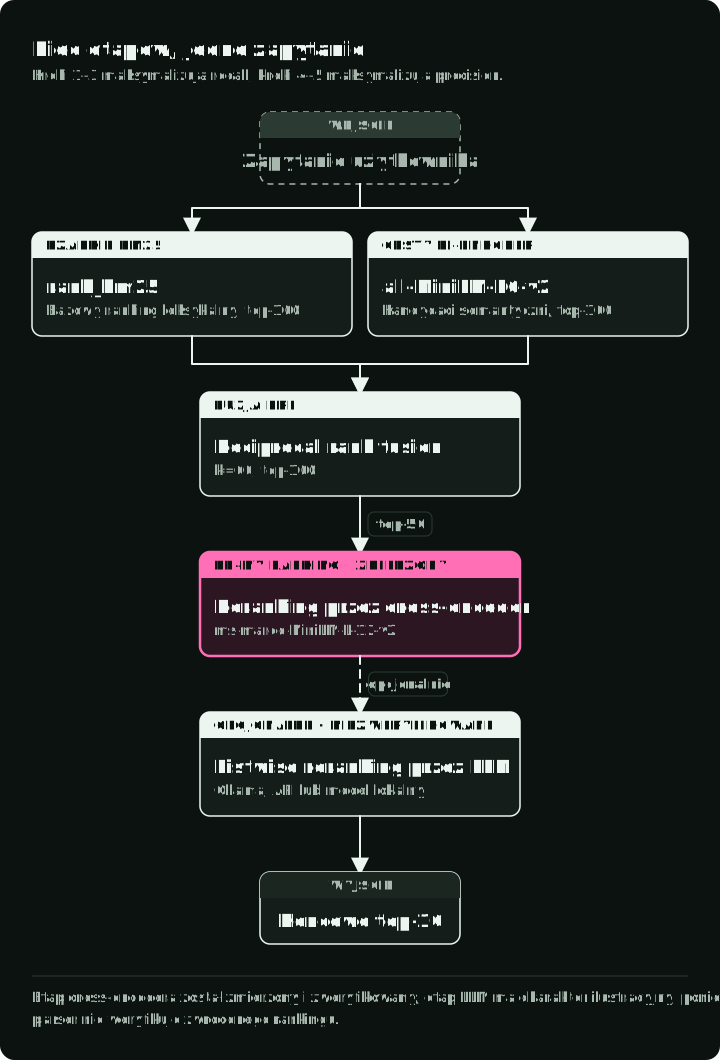
Pipeline:
- Rzadkie wyszukiwanie BM25 — baseline leksykalny (
rank_bm25) - Wyszukiwanie gęste bi-encoderem — semantyczne generowanie kandydatów (
all-MiniLM-L6-v2) - Hybrydowa fuzja RRF — fuzja wyników rzadkich i gęstych na podstawie pozycji
- Reranking z modelem cross-encoder — wyniki trafności dla par (
ms-marco-MiniLM-L12-v2) - Listwise reranking LLM — porównanie końcowej krótkiej listy przez model sterowany przez prompt (Ollama, API lub model lokalny)
Kroki 1—3 to etap wyszukiwania w lejku (maksymalizacja recall); kroki 4—5 to etap pełnego rankingu (maksymalizacja precyzji). Demo pomija pre-ranking i blending. Diagram pokazuje liczbę kandydatów w każdym kroku: cross-encoder ocenia pierwszych 50 ze 100 kandydatów hybrydowych i zostawia resztę w kolejności hybrydowej, a LLM widzi pierwszych 10.
Szybki start
Krok pobierania ściąga zbiór danych raz i zapisuje małą próbkę. run-all uruchamia potem każdy etap, wypisuje jeden wiersz metryk na etap oraz zapisuje wiersze do results/metrics.json i wykres do results/metrics_comparison.png. Dodaj --llm-mode, aby uwzględnić etap LLM.
git clone https://github.com/slavadubrov/search-ranking-stack.git
cd search-ranking-stack
uv sync

# Download and sample ESCI dataset (~2.5GB download, ~5MB sample)
uv run download-data

# Run BM25, dense, hybrid RRF, and the cross-encoder
uv run run-all

# Add LLM reranking with a local Ollama model (ollama pull llama3.2:3b first)
uv run run-all --llm-mode ollama
Zbiór danych i próbkowanie: Amazon ESCI
Demo używa Amazon Shopping Queries Dataset (ESCI) z KDD Cup 2022 — prawdziwego benchmarku wyszukiwania produktów z czterostopniowymi etykietami trafności:
| Etykieta | Zysk | Znaczenie | Przykład (zapytanie: „wireless headphones”) |
|---|---|---|---|
| Exact (E) | 3 | Spełnia wszystkie wymagania zapytania | Sony WH-1000XM5 Wireless Headphones |
| Substitute (S) | 2 | Funkcjonalny zamiennik | Słuchawki przewodowe z adapterem Bluetooth |
| Complement (C) | 1 | Powiązany, przydatny produkt | Etui na słuchawki |
| Irrelevant (I) | 0 | Brak istotnego związku | Kabel USB do ładowania |
Stopniowana trafność ma znaczenie, bo pozwala użyć NDCG (Normalized Discounted Cumulative Gain), która odróżnia „idealny” ranking od „tylko wystarczającego”. Metryki binarne oceniają oba tak samo.
Użyłem próbki small_version z demo: 500 zapytań, 9 870 produktów i 9 984 oceny. Skrypt pobierania czyta jedyny podział train z tasksource/esci, filtruje angielską lokalizację us oraz small_version == 1, a potem z ziarnem 42 losuje bez zwracania do 500 unikalnych identyfikatorów zapytań. Korpus zawiera unikalne produkty z wybranych wierszy ocen. To nie jest podział wydzielony do testów ani niezależny korpus. Próbka jest dość mała, by działać na laptopie, ale zbyt mała i zbyt specyficzna dla domeny, by ustalić ranking produkcyjny. Użyj jej do odtworzenia etapów i analizy błędów; decyzje o wdrożeniu opieraj na wydzielonych, reprezentatywnych zapytaniach.
Ewaluacja: mierzenie tego, co ważne
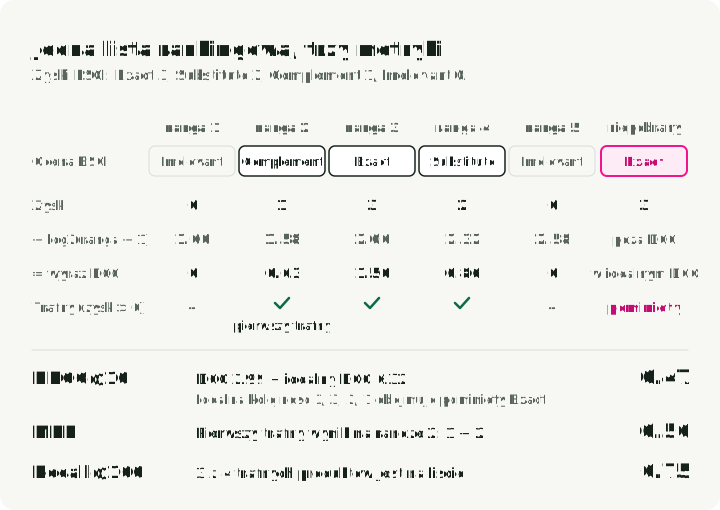
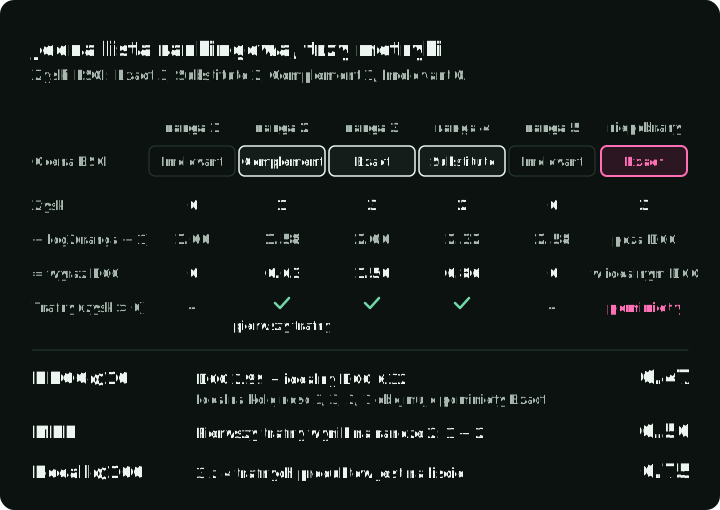
Demo używa trzech metryk, a każda patrzy na ranking z innej strony. Rysunek stosuje wszystkie trzy do wyników jednego zapytania, z użyciem powyższych zysków ESCI:
NDCG@10 (metryka główna)
Normalized Discounted Cumulative Gain mierzy jakość rankingu top 10 na podstawie stopniowanej trafności. Nagradza umieszczanie bardzo trafnych dokumentów blisko szczytu dzięki logarytmicznemu dyskontowaniu:
Odpowiada to liniowym zyskom używanym przez ndcg_cut z trec_eval, wybierane w pytrec_eval jako ndcg_cut_10. IDCG to DCG idealnego uporządkowania ocenionych stopni; zapytanie bez dodatniego zysku dostaje zero. Zyski wykładnicze, takie jak , to inna konwencja i zmieniłyby te liczby.
Spośród trzech metryk tylko NDCG w pełni wykorzystuje czterostopniową trafność ESCI. System, który umieszcza trafienie Exact na pozycji 1, dostaje wyższy wynik niż taki, który umieszcza tam Substitute. Dlatego to metryka główna.
MRR (pierwszy wynik Complement lub wyższy)
Mean Reciprocal Rank używa pozycji pierwszego wyniku uznanego za trafny. W tym demie ewaluator przekazuje oceny trafności ESCI do pytrec_eval i stosuje recip_rank do każdej zwróconej listy do 100 kandydatów. Próg binarny to relevance > 0: Complement (1), Substitute (2) i Exact (3) liczą się jako trafne. Irrelevant (0) nie. Trafny wynik na pozycji 1 daje odwrotność rangi 1.0; na pozycji 3 jest to 0.333. To MRR liczone na zwróconych listach kandydatów, a nie MRR@10.
Recall@100 (pokrycie wyszukiwania)
Recall@100 mierzy, jaka część dokumentów ocenionych jako trafne znajduje się w pierwszej setce. Nie zmienia się, gdy reranking porządkuje tych samych 100 kandydatów, jak w tym demie. Przy większym zbiorze kandydatów reranking może przenieść trafny dokument do pierwszej setki i zwiększyć wartość metryki, ale nie może odzyskać dokumentu pominiętego przez wyszukiwanie.
Mianownik obejmuje tylko dokumenty ocenione jako trafne, tak jak w implementacji recall w trec_eval. Nieoceniony produkt nie wnosi dodatniej trafności i nie znajduje się w tym mianowniku. Niepełne oceny mogą więc sprawić, że zmierzony recall różni się od pokrycia wszystkich rzeczywiście trafnych produktów.
Wyszukiwanie hybrydowe
Zadaniem warstwy wyszukiwania jest maksymalizacja recall: umieszczenie w zbiorze kandydatów jak największej liczby trafnych dokumentów.
BM25: baseline leksykalny
BM25 ocenia dokumenty według nakładania się terminów z zapytaniem, z nasyceniem częstości terminów i normalizacją długości dokumentu:
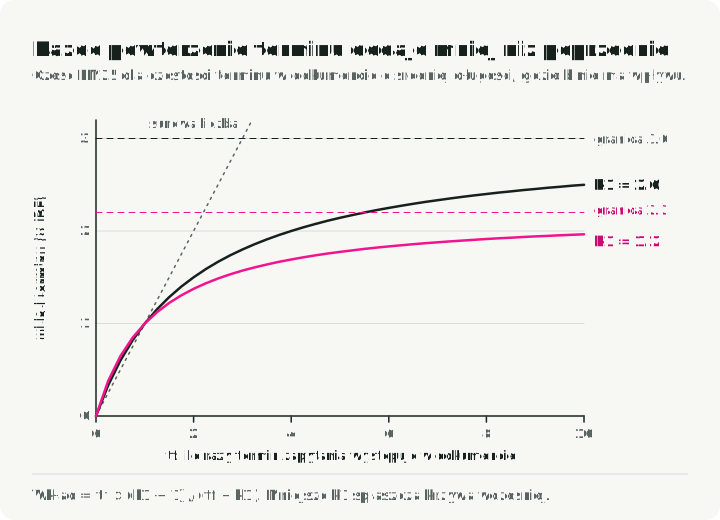
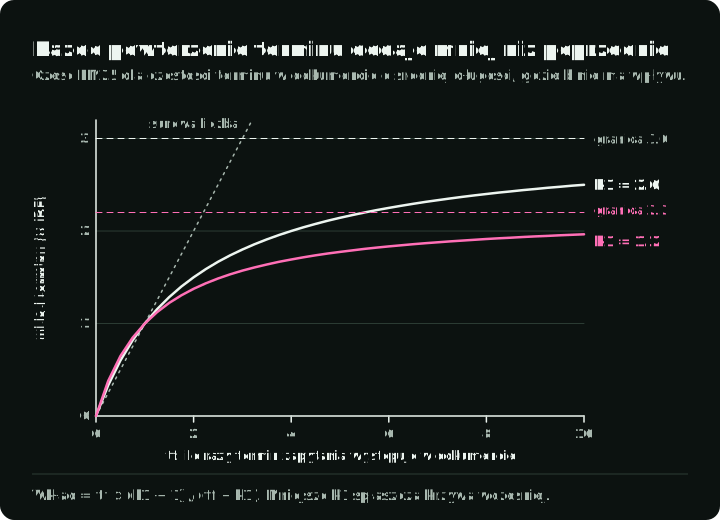
Gdzie to odwrotna częstość dokumentowa terminu , to częstość terminu w dokumencie , to długość dokumentu, a to średnia długość dokumentu w korpusie. Znaczenie mają dwa parametry: (zwykle 1.2—2.0) steruje nasyceniem TF — tym, jak szybko powtórzenia terminu przestają dodawać wartość — a (zwykle 0.75) steruje normalizacją długości dokumentu.
Wykres pokazuje część wzoru odpowiadającą częstości terminu dla obu końców typowego zakresu :
Implementacja jest krótka. Zwykła tokenizacja po białych znakach z rank_bm25:
# src/search_ranking_stack/stages/s01_bm25.py

from rank_bm25 import BM25Okapi

def run_bm25(data: ESCIData, top_k: int = 100):
    doc_ids = list(data.corpus.keys())
    tokenized_corpus = [text.lower().split() for text in data.corpus.values()]

    bm25 = BM25Okapi(tokenized_corpus)

    results = {}
    for query_id, query_text in data.queries.items():
        scores = bm25.get_scores(query_text.lower().split())
        top_indices = np.argsort(scores)[::-1][:top_k]
        results[query_id] = {doc_ids[idx]: float(scores[idx]) for idx in top_indices}

    return results
BM25 osiąga Recall@100 równy 0.741 — 74% produktów ocenionych jako trafne pojawia się gdzieś w pierwszej setce. Reranker, który otrzymał tylko tę listę BM25, nie może odzyskać brakujących 26% produktów ocenionych jako trafne.
Wyszukiwanie gęste bi-encoderem
Bi-encoder odwzorowuje zapytania i dokumenty niezależnie we wspólnej przestrzeni embeddings:
# Simplified from src/search_ranking_stack/stages/s02_dense.py

import numpy as np
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("sentence-transformers/all-MiniLM-L6-v2")
doc_texts = ["Sony WH-1000XM5 Wireless Headphones", "Headphone carrying case"]
query_texts = ["wireless headphones"]

# Encode corpus once, cache to disk
corpus_embeddings = model.encode(
    doc_texts,
    batch_size=128,
    normalize_embeddings=True,  # Cosine sim = dot product
    convert_to_numpy=True,
)

# At query time: encode query, compute dot product
query_embeddings = model.encode(query_texts, normalize_embeddings=True)
similarity_matrix = np.dot(query_embeddings, corpus_embeddings.T)
Przy znormalizowanych embeddings podobieństwo cosinusowe sprowadza się do iloczynu skalarnego. Demo oblicza pełną macierz zapytanie-korpus, bo 9 870 dokumentów swobodnie mieści się w pamięci; korpus produkcyjny zwykle używałby indeksu przybliżonych najbliższych sąsiadów. W tej próbce all-MiniLM-L6-v2 podnosi Recall@100 z 0.741 do 0.825.
Jak bi-encodery uczą się dobrych reprezentacji
Pretrening enkodera i fine-tuning embeddings rozwiązują różne problemy. Wstępnie wytrenowany Transformer dostarcza reprezentacje jednostek token; kontrastowy fine-tuning uczy zagregowany wektor, które teksty mają być blisko siebie. Dane NLI, podobieństwa zdań i par zapytanie-fragment to możliwe składniki, a nie uniwersalna sekwencja. Karta modelu all-MiniLM-L6-v2 z demo opisuje wstępnie wytrenowany enkoder MiniLM, poddany etapowi fine-tuning na ponad miliardzie zróżnicowanych par zdań.
Fine-tuning wyszukiwania może używać doboru trudnych negatywów (hard negative mining). Losowe negatywy, na przykład dokument kulinarny sparowany z zapytaniem o słuchawki, mogą być zbyt łatwe, by czegoś nauczyć. Retriever może zamiast tego dostarczyć wiarygodnych kandydatów, które oceny wskazują jako nietrafne. Nieocenione dokumenty z wysokim wynikiem wymagają ostrożności: niektóre mogą być brakującymi pozytywami.
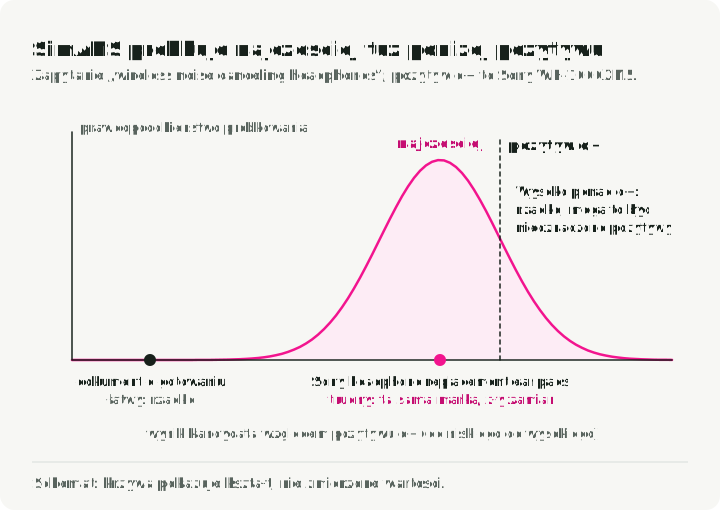
SimANS próbkuje negatywy z rozkładem prawdopodobieństwa skupionym blisko wyniku trafności dokumentu pozytywnego. Zmniejsza nacisk zarówno na łatwe negatywy, jak i na kandydatów z najwyższym wynikiem, którzy mogą być fałszywymi negatywami. To stronnicze próbkowanie spośród pobranych kandydatów, a nie sztywna reguła wykluczająca każdy dokument powyżej lub poniżej granicy rangi. Krzywa pokazuje, jak często próbkowany jest pobrany kandydat, w zależności od jego wyniku względem pozytywu:
# What a training triplet looks like after hard negative mining
training_triplet = {
    "query": "wireless noise canceling headphones",
    "positive": "Sony WH-1000XM5 Wireless Noise Cancelling Headphones",
    "negative": "Sony headphone replacement ear pads",  # Hard negative: same brand, related product, but wrong intent
}
# The bi-encoder must learn that "ear pads" is NOT what the user wants,
# even though it shares many tokens with the positive document.
Funkcja straty kontrastowej (InfoNCE) wiąże to wszystko razem. Dla każdego zapytania z dokumentem pozytywnym i zbiorem dokumentów negatywnych :
Gdzie to podobieństwo cosinusowe między embeddings zapytania i dokumentu, a to parametr temperatury (zwykle 0.05—0.1). Niższe wartości sprawiają, że strata jest bardziej wrażliwa na trudne negatywy. To softmax cross-entropy: podnosi podobieństwo pary pozytywnej względem wszystkich negatywów. Gdy jest małe, nawet niewielkie różnice podobieństwa dają duże gradienty, co zmusza model do dokładniejszych rozróżnień.
Udostępnianie embeddings bi-encodera na dużą skalę
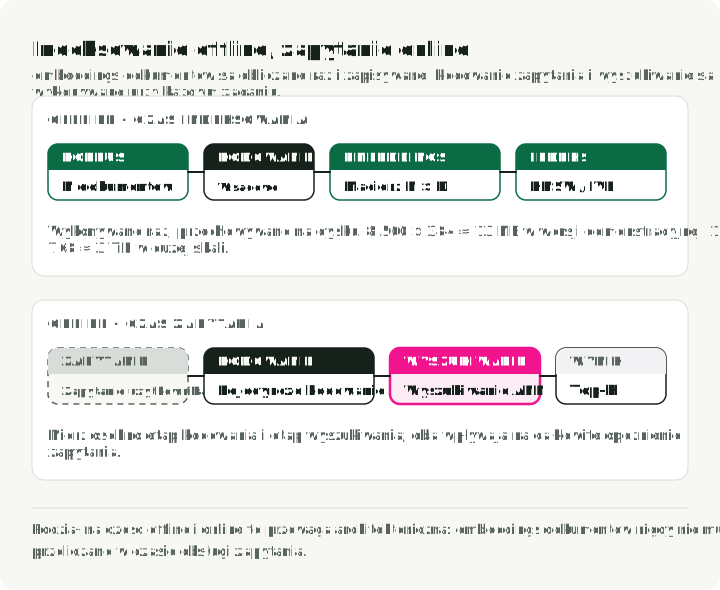
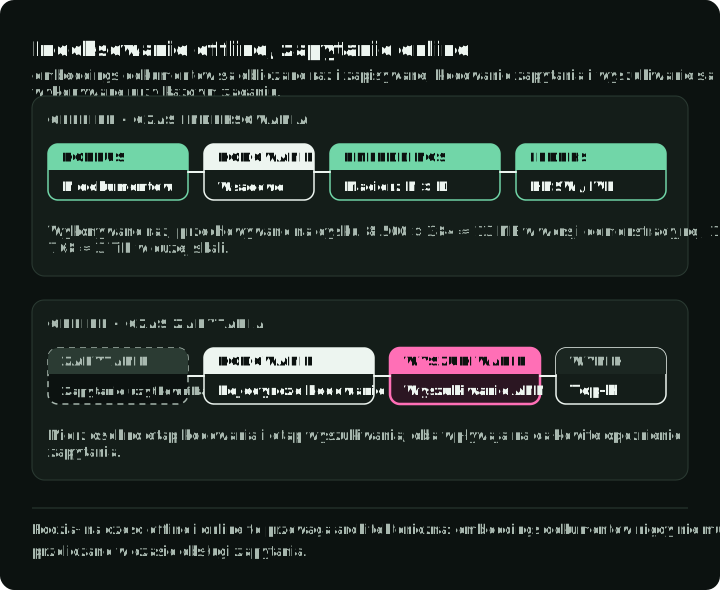
Architektoniczną zaletą bi-encodera jest podział na offline i online. Embeddings dokumentów oblicza się w czasie indeksowania i zapisuje w indeksie wektorowym. W czasie zapytania system koduje zapytanie i przeszukuje zapisane wektory. Opóźnienie zależy od enkodera, sprzętu, indeksu, filtrów i docelowego recall, więc oba kroki warto profilować osobno.
W demo rachunek jest skromny: 9 870 dokumentów 384 wymiary 4 bajty na liczbę zmiennoprzecinkową = ~15 MB embeddings. W skali produkcyjnej liczby przestają być skromne: 1 miliard dokumentów z 768-wymiarowymi embeddings wymaga ~3 TiB miejsca. Tu pojawiają się kwantyzacja (kompresja 32-bitowych liczb zmiennoprzecinkowych do 8-bitowych liczb całkowitych), kwantyzacja produktowa (rozkład wektorów na podprzestrzenie) oraz indeksy na SSD, takie jak DiskANN. Algorytmy indeksów opisuje sekcja o indeksowaniu wektorów gęstych.
Dlaczego testować wyszukiwanie hybrydowe
Obie metody często zawodzą w różnych miejscach. BM25 dobrze radzi sobie z nazwami własnymi, SKU produktów i kodami błędów. Wyszukiwanie gęste potrafi ograniczyć skutki niedopasowania słownictwa, takie jak „cheap laptop” kontra „budget notebook computer”. To, czy fuzja pomaga, zależy od tego, jak często te komplementarne przypadki występują w docelowym zbiorze zapytań.
Typowym następnym eksperymentem jest wyszukiwanie hybrydowe: uruchomienie obu metod i fuzja ich list rankingowych.
Reciprocal rank fusion (RRF)
BM25 i wyszukiwanie gęste dają wyniki o różnym znaczeniu i skali. Kombinacja liniowa wymaga więc kalibracji i walidacji za każdym razem, gdy zmieniają się retrievery lub korpus.
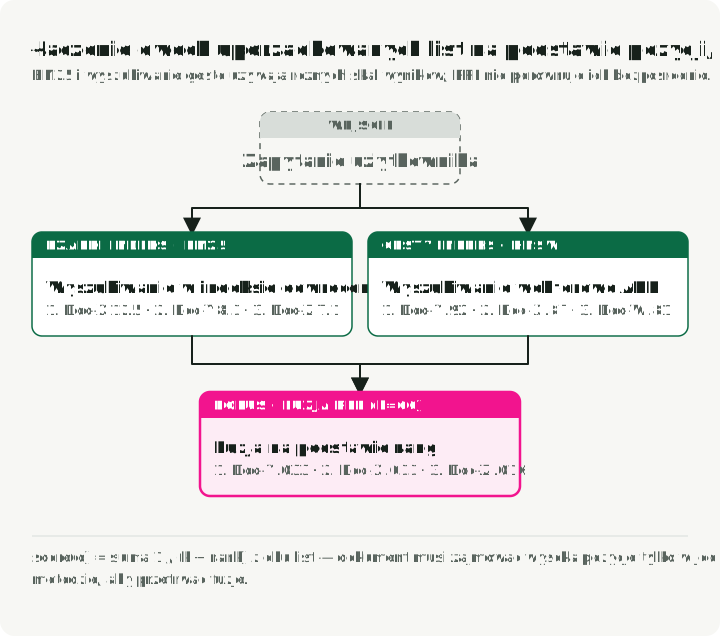
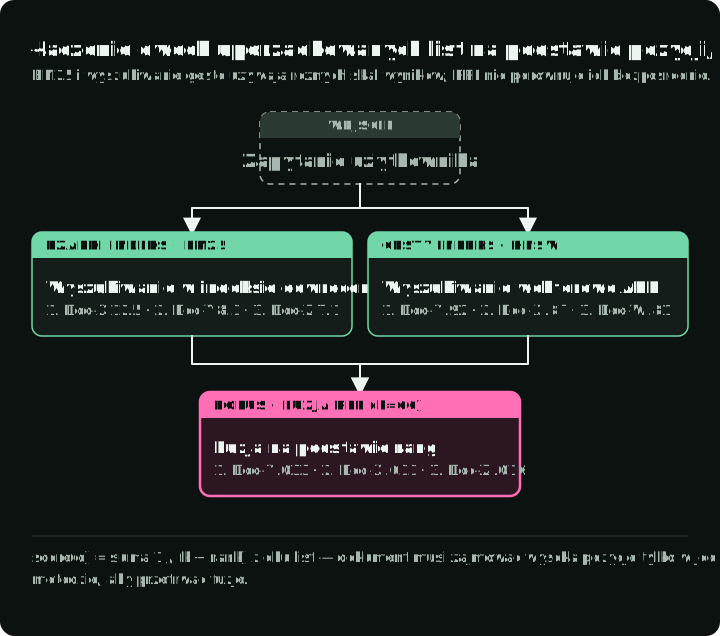
Reciprocal Rank Fusion (Cormack i in., 2009) w ogóle porzuca surowe wyniki i używa tylko pozycji w rankingu:
Tutaj to stała wygładzająca; 60 to częsta wartość początkowa. RRF nagradza pozycje, które są blisko szczytu na wielu listach wejściowych, bez porównywania ich surowych wyników. Unika kalibracji skali wyników, ale progi wyszukiwania, wagi i nadal wymagają ewaluacji.
Implementacja:
# src/search_ranking_stack/stages/s03_hybrid_rrf.py

from collections import defaultdict

def reciprocal_rank_fusion(ranked_lists, k=60, top_k=100):
    all_query_ids = set().union(*(results.keys() for results in ranked_lists))
    fused_results = {}

    for query_id in all_query_ids:
        rrf_scores = defaultdict(float)

        for results in ranked_lists:
            sorted_docs = sorted(results.get(query_id, {}).items(),
                                 key=lambda x: x[1], reverse=True)

            for rank, (doc_id, _score) in enumerate(sorted_docs, start=1):
                rrf_scores[doc_id] += 1.0 / (k + rank)

        sorted_rrf = sorted(rrf_scores.items(),
                            key=lambda x: x[1], reverse=True)[:top_k]
        fused_results[query_id] = dict(sorted_rrf)

    return fused_results
Hybrydowy RRF osiąga Recall@100 równy 0.842 i NDCG@10 równy 0.628 — wyżej niż BM25 (0.585) i wyszukiwanie gęste (0.611) osobno. Dokument znaleziony tylko przez jeden retriever nadal dostaje wynik RRF, ale może wypaść poniżej progu pierwszej setki. Przy pozycja 1 na jednej liście daje , czyli mniej niż pozycja 50 na obu listach (). Pokrycie się list może przeważyć nad wysoką pozycją na jednej liście.
Reranking z modelem cross-encoder
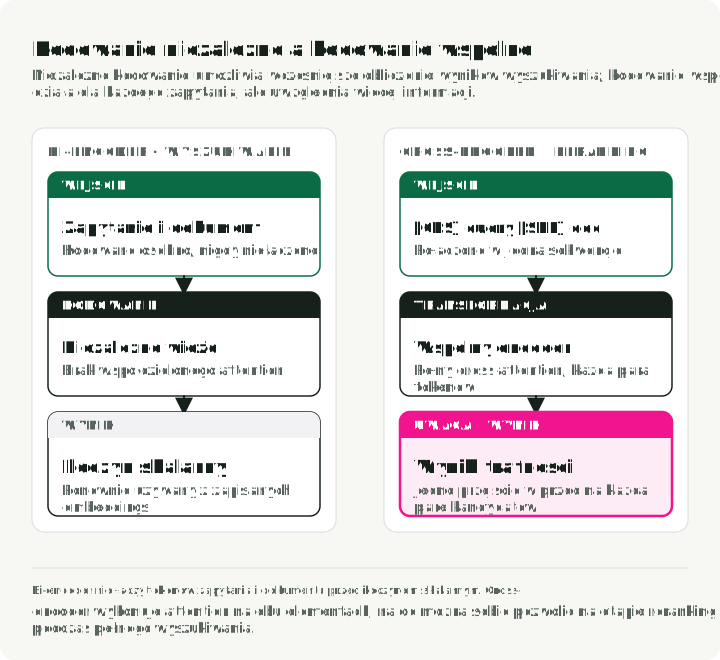
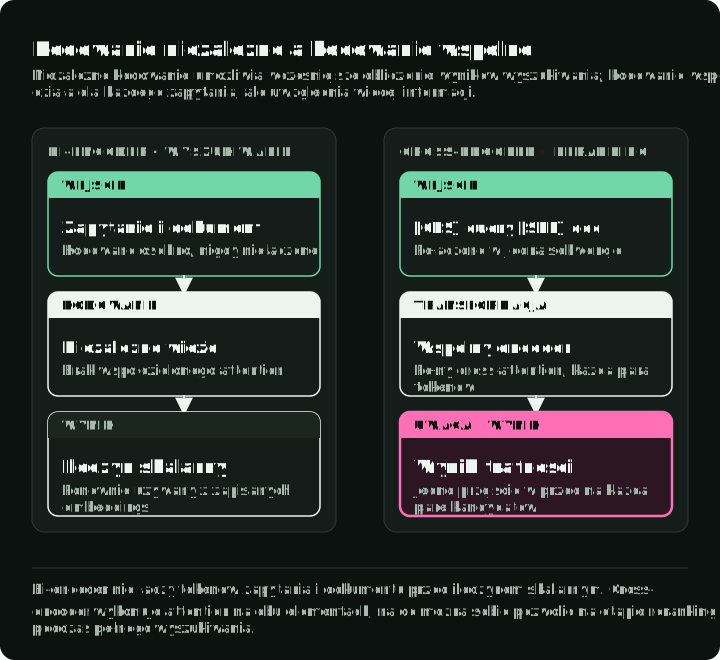
Przy 100 kandydatach hybrydowych na zapytanie możesz sobie pozwolić na droższy model. Cross-encoder przetwarza zapytanie i dokument razem w jednym Transformerze, ze self-attention obejmującym połączone zapytanie i dokument.
Interakcja na poziomie jednostek token
Różnica tkwi w macierzy uwagi. W bi-encoderze uwaga jest blokowo diagonalna: jednostki token zapytania uwzględniają tylko inne jednostki token zapytania, a jednostki token dokumentu tylko inne jednostki token dokumentu. Obie reprezentacje nigdy nie spotykają się na poziomie jednostek token — łączy je dopiero iloczyn skalarny na końcu. Cross-encoder oblicza pełną macierz uwagi, w której każda jednostka token zapytania uwzględnia każdą jednostkę token dokumentu i odwrotnie. To wspólne self-attention pozwala modelowi porównywać jednostki token zapytania i dokumentu bezpośrednio.
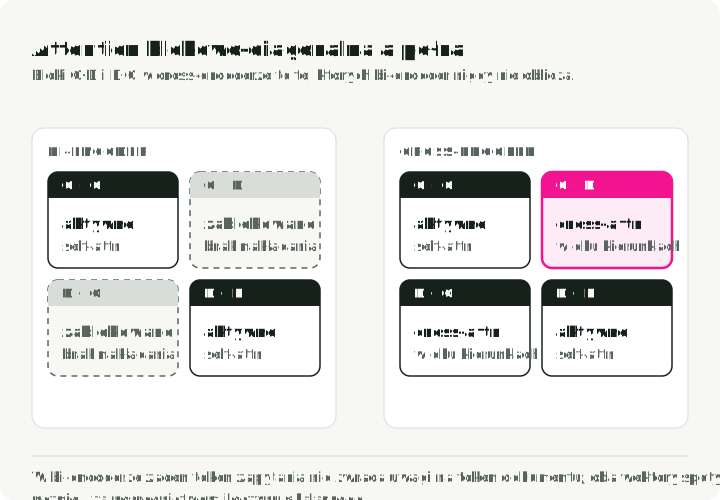
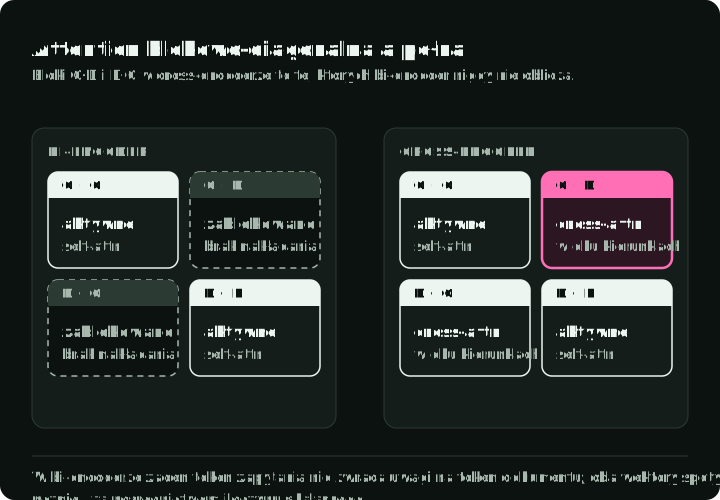
W bi-encoderze zapytanie jest kodowane, zanim zobaczy jakikolwiek dokument. Cross-encoder widzi zapytanie i kandydata razem, więc może wykorzystać zależność między ich jednostkami token. Może to pomóc w takich przypadkach jak:
- Negacja: „headphones that are not wireless”. Zagregowany embedding może niedoważyć negację, a wspólne kodowanie daje modelowi bezpośrednią interakcję zapytanie-dokument. To hipoteza do sprawdzenia na wyspecjalizowanym wycinku danych, a nie gwarancja.
- Kwalifikacja: „laptop under $500”. Wspólne kodowanie może powiązać ograniczenie z ceną w tekście produktu, choć strukturalne filtry cenowe są bezpieczniejsze, gdy pole jest dostępne.
Wejście modelu cross-encoder ma format [CLS] query tokens [SEP] document tokens [SEP]. [CLS] to klasyfikacyjna jednostka token, której końcowy stan ukryty trafia do liniowej głowicy, by dać jeden wynik trafności. Embeddings segmentów odróżniają jednostki token zapytania od jednostek token dokumentu, a [SEP] oznacza granicę między segmentami.
Jak trenowane są modele cross-encoder
Modele cross-encoder mogą uczyć się z przykładów (query, document, relevance_label) z celami pointwise, pairwise lub listwise. Przykład pointwise łączy „wireless headphones” z „Sony WH-1000XM5 Wireless Headphones” i etykietą 1.0.
Typowy klasyfikator odwzorowuje końcową reprezentację [CLS] na wynik. Dla etykiet binarnych można użyć binary cross-entropy; dla stopniowanej trafności można użyć regresji, strat porządkowych, pairwise lub listwise. Wybieraj na podstawie metryk rankingowych na danych wydzielonych, zamiast zakładać, że jeden cel jest zawsze lepszy.
Dobór trudnych negatywów pomaga też trenować modele cross-encoder. Trening modeli cross-encoder jest drogi — każdy przykład wymaga pełnego przejścia przez połączoną sekwencję — więc nie można marnować obliczeń na trywialnie łatwe negatywy. Praktyczny przepis: użyj bi-encodera, by pobrać top-K kandydatów dla każdego zapytania treningowego, a potem weź trudne negatywy z wybranych przedziałów rang (np. rangi 10–100). Dzięki temu cross-encoder dostaje przykłady, w których odróżnienie trafnego od nietrafnego wymaga głębokiej interakcji jednostek token.
Reranking pobranych kandydatów
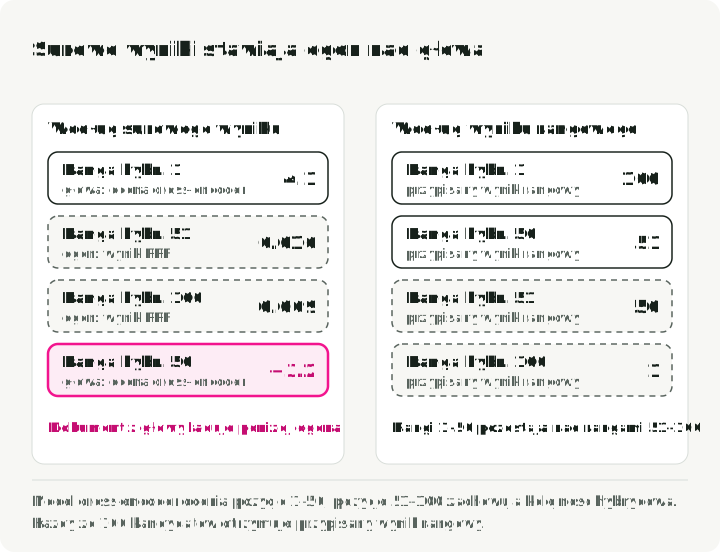
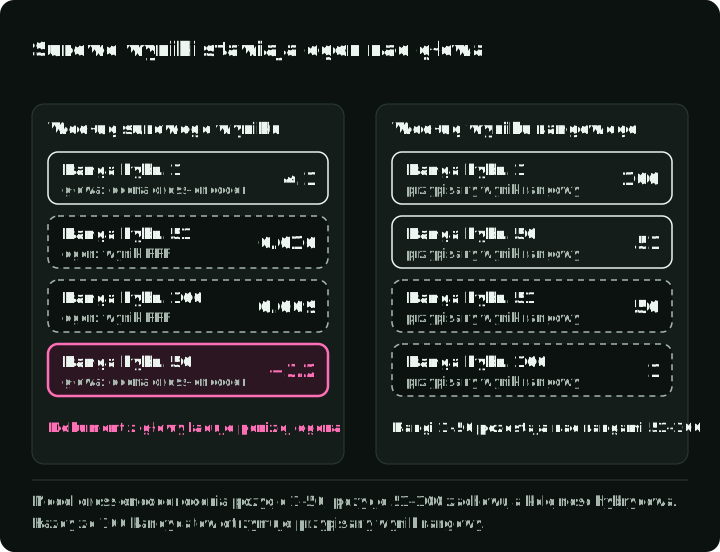
Etap wysyła pary (query, document) dla pierwszych 50 kandydatów hybrydowych do CrossEncoder.predict, układa tych kandydatów według wyniku, a potem dołącza nieocenionych kandydatów w ich poprzedniej kolejności. Rysunek sortuje czterech ze 100 kandydatów na oba sposoby i pokazuje, dlaczego scalanie przypisuje nowe wyniki rangowe zamiast zachowywać surowe wyniki:
# From src/search_ranking_stack/stages/s04_cross_encoder.py

def rank_scores(ordered_ids):
    return {doc_id: float(len(ordered_ids) - rank) for rank, doc_id in enumerate(ordered_ids)}

def merge_head_and_tail(original, scored_head):
    """original: hybrid (doc_id, rrf_score) pairs in rank order.
    scored_head: (doc_id, cross_encoder_score) pairs for the first len(scored_head)."""
    head = sorted(scored_head, key=lambda item: (-item[1], item[0]))
    tail = original[len(scored_head) :]
    return rank_scores([doc_id for doc_id, _ in head + tail])
Pełny etap dodaje ładowanie modelu, obcięcie dokumentu do 2 048 znaków i sprawdzenie, czy każdy wynik jest skończony.
Karta modelu pokazuje, że wyniki modelu cross-encoder mogą być ujemne. Nie mieszaj ich z wynikami RRF nieocenionego ogona: dodatni wynik RRF może posortować nieocenionego kandydata z ogona nad kandydata z głowy z ujemnym wynikiem. Przypisz ściśle malejące wyniki rangowe, tak jak robi to rank_scores. To wyniki rangowe na potrzeby ewaluacji, a nie skalibrowane oszacowania trafności.
Kompromis między szybkością a jakością
Dlaczego nie używać modeli cross-encoder do wszystkiego? Bo nie można z góry obliczyć wyników. Embeddings dokumentów z bi-encodera nie zależą od zapytania, więc oblicza się je raz i zapisuje. Wynik modelu cross-encoder zależy jednocześnie od zapytania i dokumentu. Wynik trafności dla „wireless headphones” w parze z produktem Sony wynika ze wspólnego self-attention między tymi konkretnymi jednostkami token. Powtarzającą się parę zapytanie-dokument można zapisać w cache, ale jej wyniku nie da się użyć dla innego zapytania.
Bi-encoder potrzebuje jednego kodowania zapytania i wyszukiwania wektorowego wśród obliczonych wcześniej embeddings dokumentów. Cross-encoder ocenia każdą parę zapytanie-dokument z krótkiej listy, a koszt rośnie zarówno z liczbą kandydatów, jak i z długością sekwencji. Batching pomaga, ale ocenianie 100 000 kandydatów to nadal zły punkt pracy; najpierw wyszukaj, a potem zmierz największą krótką listę, która spełnia cele jakości i opóźnienia.
Listwise reranking LLM
Końcowy etap demo używa LLM do etapu reranking listwise. Zamiast oceniać każdy dokument niezależnie, model widzi top 10 i zwraca uporządkowanie. Prompt, zainspirowany RankGPT, wprost wymusza porównanie względne, ale wprowadza też limity kontekstu, stronniczość pozycji, błędy parsowania i zmienność między uruchomieniami.
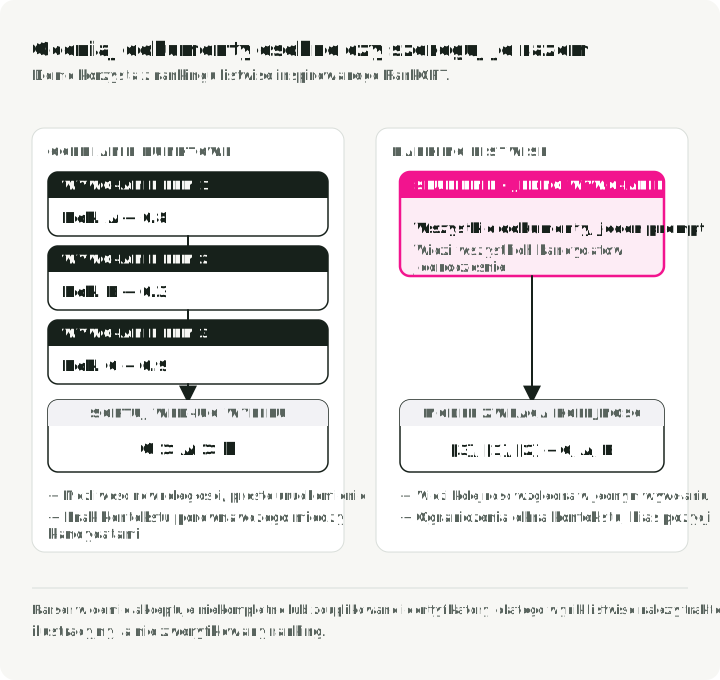
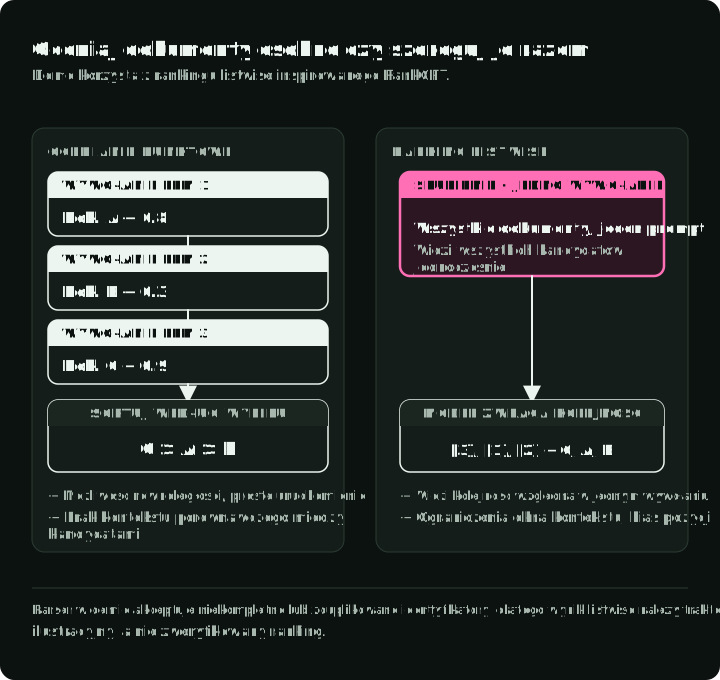
Prompt listwise
Szablon instrukcji prompt prosi LLM o uwzględnienie hierarchii trafności ESCI:
# src/search_ranking_stack/stages/s05_llm_rerank.py

def _create_listwise_prompt(query, documents, max_words=200):
    n = len(documents)

    doc_texts = []
    for i, (_doc_id, doc_text) in enumerate(documents, start=1):
        words = doc_text.split()[:max_words]
        doc_texts.append(f"[{i}] {' '.join(words)}")

    docs_formatted = "\n\n".join(doc_texts)

    return (
        f"I will provide you with {n} product listings, each indicated by a numerical "
        f"identifier [1] to [{n}]. Rank the products based on their relevance to the "
        f'search query: "{query}"\n\n'
        "Consider:\n"
        "- Exact matches (product satisfies all query requirements) should rank highest\n"
        "- Substitutes (functional alternatives) should rank above complements\n"
        "- Completely irrelevant products should rank lowest\n\n"
        f"{docs_formatted}\n\n"
        "Rank the products from most relevant to least relevant.\n"
        "Output ONLY a comma-separated list of product identifiers, e.g.: [3], [1], [2], ...\n"
        "Do not explain your reasoning. Only output the ranking."
    )
Trzy tryby uruchamiania
Demo obsługuje trzy backendy etapu reranking z LLM:
| Tryb | Model | Jak działa |
|---|---|---|
ollama | llama3.2:3b (zmień przez OLLAMA_MODEL) | Lokalnie przez API Ollama |
api | Claude Haiku (ustaw LLM_MODEL_API w config.py) | API Anthropic; najpierw uv sync --extra api |
local | Qwen/Qwen2.5-1.5B-Instruct | HuggingFace Transformers; najpierw uv sync --extra llm |
Parsowanie i fallback
Parser wyodrębnia numerowane identyfikatory z odpowiedzi modelu. Akceptuje ranking tylko wtedy, gdy wymienia każdego kandydata dokładnie raz:
# src/search_ranking_stack/stages/s05_llm_rerank.py

def _parse_ranking(output: str, n: int) -> list[int] | None:
    """Return 0-based positions if the output ranks IDs 1..n exactly once."""
    positions = [int(m) - 1 for m in re.findall(r"\[(\d+)\]", output)]

    # Reject missing, duplicate, and out-of-range IDs.
    if sorted(positions) != list(range(n)):
        return None

    return positions
Gdy parser zwraca None, demo zachowuje dla tego zapytania całą kolejność modelu cross-encoder i liczy fallback. Błąd backendu również liczy się jako fallback. run-all wypisuje odsetek fallbacków i zapisuje go obok metryk. Na przykład [3] > [1] > [3] zostaje odrzucone: identyfikator 3 się powtarza, a identyfikatorów 2 i 4–10 brakuje.
Wyniki z tej próbki ESCI
Wyniki dotyczą opisanej wyżej próbki small_version; nie jest ona wydzielona do testów. Wiersze pochodzą z jednego uruchomienia uv run run-all --llm-mode ollama z llama3.2:3b jako LLM.
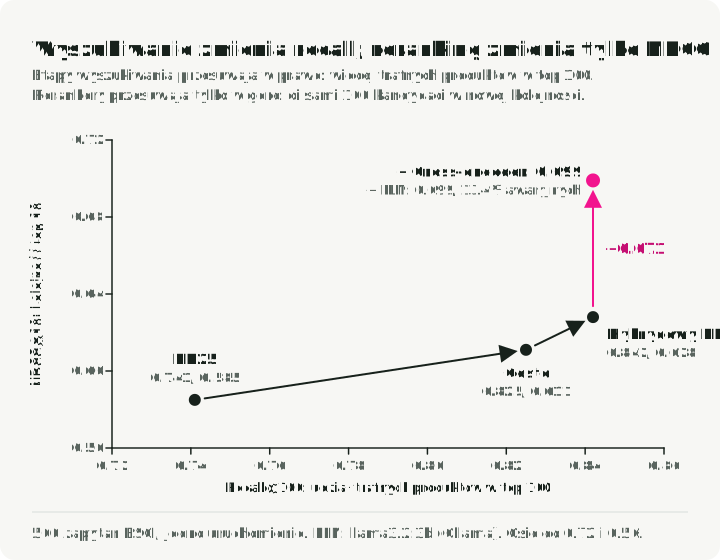
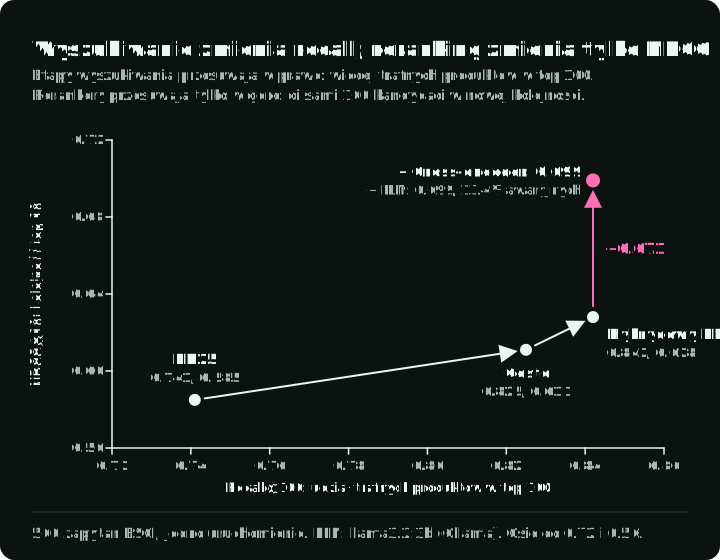
| Etap | NDCG@10 | MRR | Recall@100 | Różnica NDCG |
|---|---|---|---|---|
| BM25 | 0.585 | 0.812 | 0.741 | — |
| Dense Bi-Encoder | 0.611 | 0.808 | 0.825 | +0.026 |
| Hybrid (RRF) | 0.628 | 0.834 | 0.842 | +0.017 |
| + Cross-Encoder | 0.699 | 0.886 | 0.842 | +0.071 |
| + LLM Reranker (13.4% fallbacków) | 0.699 | 0.884 | 0.842 | +0.000 |
Wykres pokazuje Recall@100 każdego wiersza względem jego NDCG@10:
Co potwierdzają zapisane wyniki
Wyszukiwanie hybrydowe pokonuje każdą z metod osobno. Hybrydowy RRF osiąga NDCG@10 0.628, powyżej BM25 (0.585) i wyszukiwania gęstego (0.611). Ma też najwyższy Recall@100 spośród trzech wierszy wyszukiwania (0.842). Obie metody mogą zawodzić na różnych zapytaniach, a fuzja odzyskuje dokumenty, które każda z nich osobno pomija.
Cross-encoder daje największy zysk. Podnosi NDCG@10 z 0.628 do 0.699, a MRR z 0.834 do 0.886, oceniając tylko 50 kandydatów na zapytanie. W top 10 udział produktów Exact rośnie z 36.0% (hybryda) do 41.4%.
W tym demie recall jest ustalany podczas wyszukiwania. Oba rerankery zachowują wszystkich 100 kandydatów hybrydowych, więc Recall@100 pozostaje na poziomie 0.842. Aby go zwiększyć, zmień to, których 100 kandydatów zwraca wyszukiwanie.
Mały lokalny LLM nic nie dodaje w tej próbce. llama3.2:3b zostawia NDCG@10 na poziomie 0.699 i nieznacznie obniża MRR. 67 z 500 odpowiedzi (13.4%) nie przeszło parsera i zachowało kolejność modelu cross-encoder, więc kolejność LLM zastosowano dla 433 zapytań. Większy model lub tryb API mogą zachować się inaczej; zmierz je tak samo, z odsetkiem fallbacków obok wyniku.
Wyszukiwanie gęste pokonuje BM25 w tej próbce. Przed wskazaniem przyczyny przejrzyj wycinki zapytań. Niedopasowanie słownictwa to jeden prawdopodobny czynnik, ale na porównanie wpływają też sposób zbudowania próbki, tokenizer, domena treningowa modelu i pola korpusu.
Indeksowanie wektorów gęstych poza demem
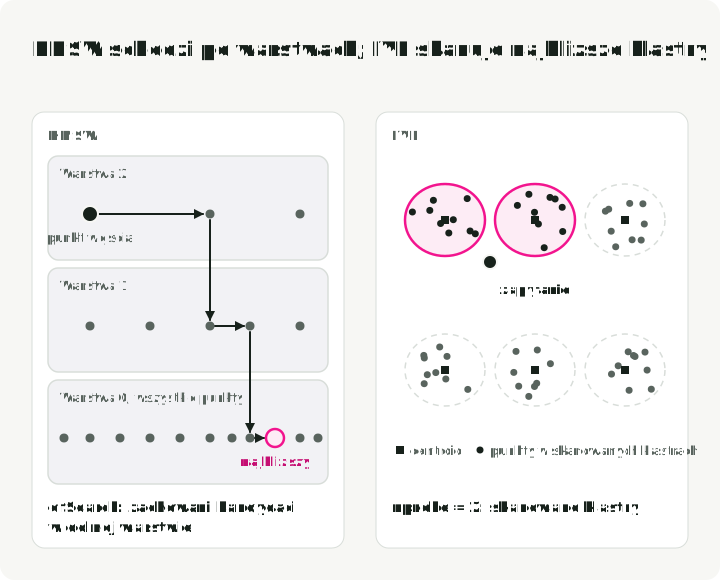
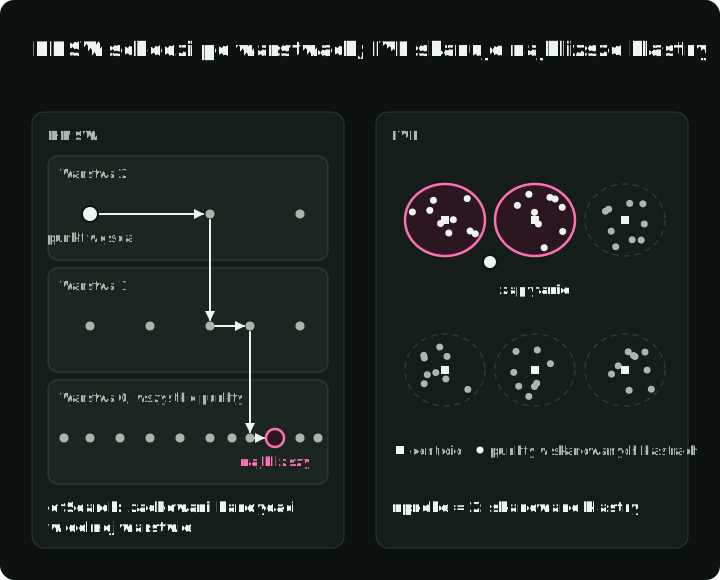
Gęste embeddings stają się użyteczne na dużą skalę dopiero z indeksem Approximate Nearest Neighbor (ANN). Demo używa brute-force z podobieństwem cosinusowym (co jest w porządku przy 9 870 dokumentach), ale systemy produkcyjne potrzebują wyspecjalizowanych indeksów. Dwie popularne rodziny przeszukują na różne sposoby, a każda ma jedno ustawienie czasu zapytania, które wymienia recall na pracę zapytania. Rysunek pokazuje ścieżkę, którą podąża HNSW, i klastry, które skanuje IVF:
HNSW (hierarchical navigable small world)
HNSW buduje wielowarstwowy graf: rzadkie górne warstwy nawigują z grubsza, a gęstsze dolne doprecyzowują sąsiedztwo. M kontroluje łączność grafu, a efSearch wymienia pracę zapytania na recall. Przydatne wartości zależą od wymiaru, rozkładu odległości, filtrów, implementacji i docelowego recall.
Indeksy grafowe mogą tracić recall przy intensywnych aktualizacjach lub restrykcyjnych filtrach; jedno zgłoszenie w Qdrant pokazuje, że recall z filtrem wraca dopiero po przebudowie. Przetestuj własny wzorzec aktualizacji i filtrów, wraz z czasem przebudowy.
IVF (inverted file)
Indeksy IVF dzielą przestrzeń wektorową na klastry, a potem skanują nprobe klastrów najbliższych zapytaniu. Mogą dawać użyteczny kompromis między pamięcią, czasem budowy i recall, zwłaszcza w połączeniu z kompresją. Semantyka i wydajność aktualizacji zależą od implementacji, a nie tylko od rodziny indeksu.
RaBitQ (Gao & Long, SIGMOD 2024) to losowy kwantyzator, który można połączyć z IVF. Normalizuje wyśrodkowane wektory, stosuje losową rotację ortogonalną i koduje znaki jednym bitem na wymiar. Szacowanie odległości używa też współczynników korekcyjnych i norm wektorów; granice błędu z artykułu dotyczą tego estymatora i jego założeń. Użyj go, gdy ograniczeniem jest pamięć, a skwantyzowane oszacowania odległości nadal spełniają docelowy recall.
| Wymiar | Graf HNSW | Klastry IVF |
|---|---|---|
| Kontrola zapytania | efSearch | nprobe |
| Kontrola budowy | Łączność i szerokość wiązki budowy | Liczba klastrów i próbka treningowa |
| Profil pamięci | Krawędzie grafu plus wektory | Centroidy, listy i zapisane wektory |
| Zachowanie przy aktualizacji | Naprawa/czyszczenie zależne od bazy | Utrzymanie list zależne od bazy |
| Zwykle wybierany, gdy | Wektory mieszczą się w RAM i potrzebujesz niskiego opóźnienia przy wysokim recall | Ograniczeniem jest pamięć lub rozmiar korpusu; połącz z PQ lub RaBitQ |
Dla każdego indeksu zmierz krzywą recall-opóźnienie-pamięć na własnych danych i obciążeniu zapytaniami.
Uber skrócił opóźnienie i zużycie CPU, obniżając liczbę kandydatów na shard przy niewielkiej utracie recall; dobierz tę liczbę na ruchu zbliżonym do produkcyjnego.
Opcjonalne rozszerzenia po podstawowym pipeline
Gdy wyszukiwanie i reranking mają osobne pomiary, kilka rozszerzeń łatwiej ocenić, nie zaciemniając podstawowego pipeline.
Rozumienie zapytań
Rozszerzanie i przepisywanie zapytań może zaradzić niedopasowaniu słownictwa przed wyszukiwaniem. Query2doc generował pseudodokumenty i raportował poprawę BM25 w eksperymentach na MS MARCO. Rozszerzenie może też wprowadzić błędną intencję, więc porównaj recall i precyzję na wycinkach zapytań niejednoznacznych, nawigacyjnych i z dokładnymi identyfikatorami.
Praktyczne wzorce: rozwijanie skrótów, wzbogacanie o encje, rozbijanie na podzapytania dla rozumowania wieloetapowego oraz RAG-Fusion — generowanie wielu wariantów zapytania i łączenie wyników przez RRF.
Etykietowanie trafności wspierane przez LLM
LLM mogą przygotować wstępne etykiety trafności, gdy ocen ludzkich brakuje. Praca Pinteresta o etykietowaniu trafności opisuje rozszerzenie danych treningowych poza etykiety ludzkie i destylację modelu trafności opartego na LLM do serwowania. Etykieta LLM to nadal wyjście modelu: skalibruj ją względem ślepych ocen ludzkich, przeglądaj wycinki, w których się nie zgadzają, i trzymaj ludzki zbiór wzorcowy do testów regresji.
Przydatne zabezpieczenia:
- rubryka z konkretnymi granicami trafności i przykładami;
- ślepa kalibracja ludzka i okresowe ponowne sprawdzenia;
- losowanie kolejności i powtarzane oceny dla niestabilnych przypadków;
- panele modeli, gdy ich dodatkowy koszt poprawia zgodność; oraz
- jawne sprawdzanie stronniczości pozycji i tendencji do środka skali.
Destylacja wiedzy
Gdy nauczyciel LLM wnosi wartość, ale nie spełnia ograniczeń serwowania, jedną z opcji jest destylacja:
- Użyj mocnego LLM (nauczyciela), aby przeranżować tysiące zapytań treningowych offline; tylko mały uczeń działa przy każdym żądaniu
- Wytrenuj mały, szybki cross-encoder (ucznia, ~100M–200M parametrów), który naśladuje rozkład rankingu LLM
- Porównaj ucznia zarówno z nauczycielem, jak i z baseline pod względem jakości, kalibracji i kosztu serwowania
InRanker destyluje MonoT5-3B do modeli z 60M i 220M parametrów, odpowiednio 50 razy i około 13 razy mniejszych, z lepszą skutecznością poza domeną niż ich niedestylowane wersje. Podejście Rank-Without-GPT daje otwarte rerankery listwise o 7B parametrów, które osiągają 97% skuteczności porównywanego rerankera GPT-4 według nDCG@10 na TREC-DL-19 i TREC-DL-20, z etapem fine-tuning QLoRA.
Opublikowane wyniki kompresji to punkty wyjścia, a nie oczekiwane współczynniki produkcyjne. Destylacja może odziedziczyć stronniczość nauczyciela i tracić jakość na rzadkich wycinkach zapytań, więc zachowaj oryginalne oceny trafności w pętli ewaluacji.
Personalizacja i stronniczość pozycji
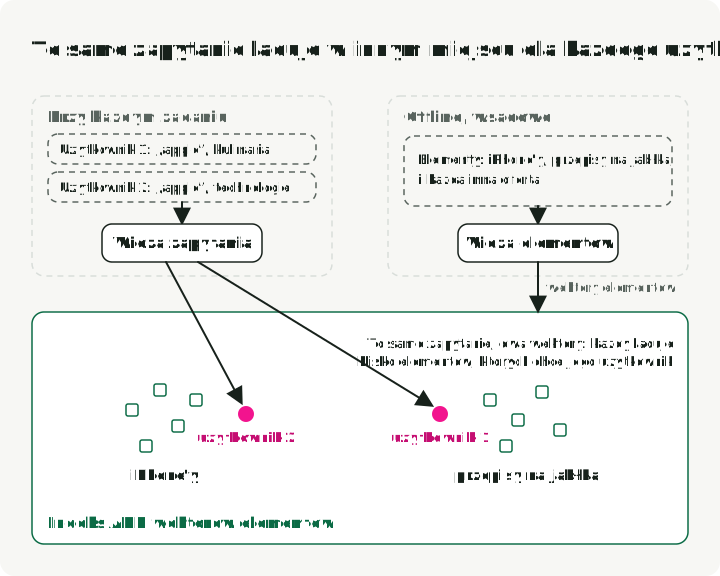
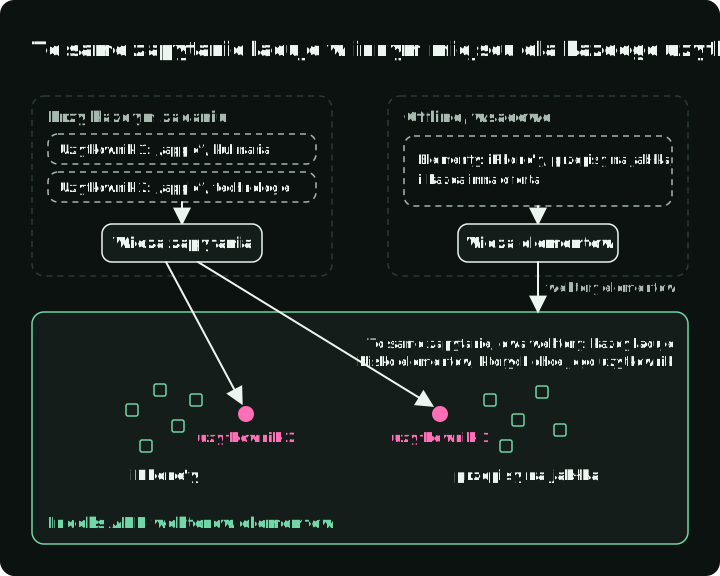
Wyszukiwanie „apple” powinno zwrócić iPhone’y entuzjaście technologii i przepisy z jabłkami komuś, kto przeglądał treści kulinarne.
Częsta architektura wyszukiwania dla personalizacji używa modelu embeddings two-tower: wieża zapytania koduje zapytanie i kontekst użytkownika, a wieża elementów koduje elementy i metadane. Rysunek pokazuje, która strona działa przy każdym żądaniu, która jest obliczana offline i gdzie zapytanie „apple” ląduje dla dwóch użytkowników:
Podział na offline i online umożliwia wyszukiwanie przybliżonych najbliższych sąsiadów; jego opóźnienie nadal zależy od enkodera, indeksu, filtrów i systemu serwowania. Trzy projekty produkcyjne używają wyuczonych embeddings w różnych miejscach. Airbnb uczy embeddings ofert z sesji kliknięć użytkowników i używa podobieństwa do ostatnio klikniętych ofert jako cech rankingu wyszukiwania. OmniSearchSage Pinteresta uczy jeden embedding zapytania razem z embeddings pinów i produktów. Uber używa modelu two-tower, by pobrać kilkaset sklepów do strony głównej Uber Eats.
Dane o kliknięciach niosą stronniczość pozycji i ekspozycji. PAL to jedno z podejść do usuwania tej stronniczości: wspólnie trenuje moduł ekspozycji i moduł kliknięcia przy danej ekspozycji, a potem serwuje drugi bez wejścia z pozycją. To nie jest uniwersalne rozwiązanie; w innym produkcie lepsze mogą być interwencje losowe, metody inverse-propensity i ewaluacja kontrfaktyczna.
Adaptacja do domeny za pomocą zapytań syntetycznych
Częsty błąd w strategii wyszukiwania to założenie, że model wytrenowany na ogólnych danych z internetu (jak MS MARCO) będzie dobrze działał w wyspecjalizowanej domenie. To problem poza domeną (OOD).
Generowanie zapytań syntetycznych może zmniejszyć niedobór danych z etykietami. InPars generuje zapytania dla dokumentów i filtruje pary do treningu. Generative Pseudo-Labeling (GPL) dodaje krok etykietowania przez nauczyciela:
- Wygeneruj zapytania z docelowego korpusu dokumentów.
- Pobierz dokumenty negatywne dla każdego wygenerowanego zapytania.
- Użyj nauczyciela w postaci modelu cross-encoder, aby ocenić pary pozytywne i negatywne, uzyskując margines wyników trafności.
- Wytrenuj gęsty retriever, aby odtwarzał te marginesy.
Pary syntetyczne mogą pomóc, gdy prawdziwych zapytań brakuje, ale odzwierciedlają generator i prompt. Deduplikuj je, odfiltruj nieprawdopodobne zapytania i waliduj na prawdziwym, wydzielonym ruchu.
Sekwencja eksperymentów
Dodawaj złożoność tylko wtedy, gdy poprzedni etap ujawnia zmierzony błąd. Każdy krok nazywa błąd, który go uzasadnia:
- Ustal baseline. Uruchom BM25 lub obecny system leksykalny na ocenionym zbiorze zapytań. Zapisz recall, NDCG, opóźnienie i grupy zapytań, na których zawodzi.
- Odzyskaj brakujących kandydatów. Przetestuj wyszukiwanie gęste i fuzję, gdy baseline pomija trafne dokumenty. Dobierz próg liczby kandydatów do recall i kosztu.
- Popraw kolejność. Dodaj cross-encoder, gdy trafni kandydaci są obecni, ale zbyt nisko. Rozmiar jego krótkiej listy wybierz, mierząc jakość i opóźnienie przy kilku progach. W demo ten krok podniósł NDCG@10 z 0.628 do 0.699.
- Dostosuj do domeny. Zrób fine-tuning lub destylację, gdy modele ogólne wykazują stabilne błędy specyficzne dla domeny. Trzymaj prawdziwe wydzielone oceny osobno od danych syntetycznych do treningu.
- Przetestuj drogi reranking. Wypróbuj reranking listwise lub oparty na rozumowaniu tylko wtedy, gdy dodatkowa jakość utrzymuje się w powtarzanych uruchomieniach i uzasadnia opóźnienie, koszt, wymagania prywatności i złożoność fallbacku. W demo
llama3.2:3bnie przeszedł tego testu.
Stack początkowy i oceny do zebrania zależą od produktu:
| Przypadek użycia | Kandydat na stack początkowy | Co zwalidować |
|---|---|---|
| Wyszukiwanie produktów | BM25 + wyszukiwanie gęste + RRF + cross-encoder | Recall atrybutów, zamienniki, opóźnienie, ograniczenia biznesowe |
| Wyszukiwanie w dokumentacji | Wyszukiwanie hybrydowe + cross-encoder | Dokładne identyfikatory, pytania semantyczne, filtry wersji |
| Odciążanie wsparcia | Wyszukiwanie hybrydowe + sprawdzanie cytowań | Recall wyszukiwania, ugruntowanie, powstrzymanie się od odpowiedzi |
| Marketplace lub oferty | Filtry leksykalne + wyszukiwanie gęste + reranker biznesowy | Dostępność, świeżość, polityka, różnorodność sprzedawców |
| Mały korpus wewnętrzny | Baseline BM25, potem reranker | Czy niedopasowanie słownictwa uzasadnia indeks gęsty |
| Wyszukiwanie prawnicze lub medyczne o wysokiej stawce | Wyszukiwanie nastawione na recall plus przegląd eksperta | Pokrycie, pochodzenie, skalibrowane powstrzymanie się od odpowiedzi |
W każdym porównaniu trzymaj prawdziwy wydzielony zbiór ocen osobno od danych treningowych. Zapisuj rankingi na poziomie zapytań, błędy, opóźnienie i koszt, aby zagregowany zysk dało się przypisać zmienionemu etapowi. Drogie warstwy wymagają też jawnych polityk prywatności i fallbacku.
Kierunki badań do osobnej oceny
Rerankery oparte na rozumowaniu i agenci korzystający z wyszukiwania są obiecujące, ale odpowiadają na inne pytania niż demo wyszukiwania produktów z pięcioma etapami.
Rerankery oparte na rozumowaniu
Rank1 trenuje rerankery na śladach rozumowania i raportuje mocne wyniki na benchmarku BRIGHT. Te dowody dotyczą wyszukiwania wymagającego rozumowania, a nie bezpośredniej prognozy dla wyszukiwania produktów w ESCI.
W wyszukiwaniu prawniczym lub naukowym porównaj rerankery oparte na rozumowaniu z mocnymi baseline z modelami cross-encoder i listwise na ocenach ekspertów, cytowaniach, opóźnieniu i spójności błędów.
Wyszukiwanie agentowe
Search-o1 bada model, który wykonuje dodatkowe wyszukiwania podczas wieloetapowego odpowiadania na pytania. To problem orkiestracji — generowania zapytań, zatrzymywania, wykorzystania dowodów i ewaluacji odpowiedzi — a nie kolejny etap reranking. Oceniaj go poprawnością końcowego zadania i wsparciem cytowań, a nie tylko metrykami wyszukiwania.
Źródła
Artykuły
- Reciprocal Rank Fusion — Cormack i in., 2009
- RankGPT: LLMs as Zero-Shot Listwise Rerankers — Sun i in., EMNLP 2023 Outstanding Paper
- Rank1: Reasoning-Based Reranking — Weller i in., COLM 2025
- Query2doc: LLM Query Expansion — Wang i in., EMNLP 2023
- GPL: Generative Pseudo Labeling — adaptacja do domeny dla wyszukiwania gęstego
- InRanker: Distilled Reranker — 50-krotne zmniejszenie rozmiaru przy konkurencyjnej skuteczności
- Search-o1: Agentic Retrieval — Li i in., 2025
- BEIR Benchmark — Thakur i in., NeurIPS 2021
- Sentence-BERT — Reimers & Gurevych, EMNLP 2019
- InfoNCE / CPC — van den Oord i in., 2018
- SimANS: Hard Negative Sampling — Zhou i in., EMNLP 2022
- Passage Reranking with BERT — Nogueira & Cho, 2019
- HNSW — Malkov & Yashunin, 2016
- DiskANN — Subramanya i in., NeurIPS 2019
- RaBitQ — Gao & Long, SIGMOD 2024
- Replacing Judges with Juries — Verga i in., 2024
- RAG-Fusion — Rackauckas, 2024
- InPars — Bonifacio i in., SIGIR 2022
- BRIGHT Benchmark — Su i in., ICLR 2025
- Rank-without-GPT — Zhang i in., ECIR 2025
- Pinterest LLM Search Relevance — Wang i in., 2024
- OmniSearchSage — Agarwal i in., WWW 2024
- PAL: Position-bias Aware Learning — Guo i in., RecSys 2019
Zbiory danych i benchmarki
- Amazon ESCI: Shopping Queries Dataset — KDD Cup 2022
- BEIR: Benchmarking IR — heterogeniczny benchmark do ewaluacji zero-shot
- MTEB: Massive Text Embedding Benchmark — leaderboard modeli embeddings
- ESCI Paper — Reddy i in., 2022
Modele użyte w demo
- all-MiniLM-L6-v2 — bi-encoder z 22M parametrów
- ms-marco-MiniLM-L12-v2 — cross-encoder z 33M parametrów
- Sentence-Transformers — framework neuronowych modeli wyszukiwania
Narzędzia i platformy
- rank_bm25 — implementacja BM25 w Pythonie
- Pyserini BEIR Reproductions — baseline BM25 z Lucene dla BEIR
- pytrec_eval — zestaw narzędzi do ewaluacji TREC
- Elasticsearch — wyszukiwanie hybrydowe z Retrievers API
- Vespa — ujednolicony silnik wyszukiwania i rekomendacji
- Weaviate — baza wektorowa z wyszukiwaniem hybrydowym
- Qdrant — baza wektorowa z zapytaniami wieloetapowymi
Odniesienia branżowe
- Airbnb Listing Embeddings — Grbovic & Cheng, KDD 2018
- Uber Delivery Search — Uber Engineering, 2025
- Uber Two-Tower Embeddings — Uber Engineering, 2023
- Elastic Rerank — Elastic, 2024
Projekt demo
- search-ranking-stack — działające demo pipeline z tego wpisu