MLOps versus LLMOps: infrastructuur voor foundation models

Automatische vertaling
Dit artikel is automatisch vertaald vanuit de oorspronkelijke Engelse versie.
Dit artikel is bedoeld voor ML- en platformengineers die al MLOps draaien en nu een systeem beheren dat op een foundation model is gebouwd. In zo’n systeem kan een regressie komen van een gewijzigde prompt, index, tool-permissie of route, terwijl de model weights gelijk blijven. Het artikel behandelt welke MLOps-praktijken nog gelden, wat je nog meer moet versioneren wanneer prompts, retrieval, tools en routing het gedrag kunnen veranderen, hoe je zo’n systeem evalueert en tracet, en welke tools elke taak uitvoeren.
Wat MLOps al heeft opgelost
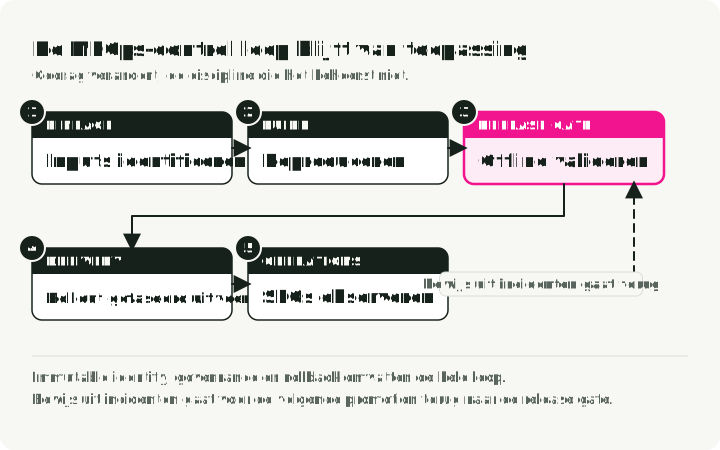
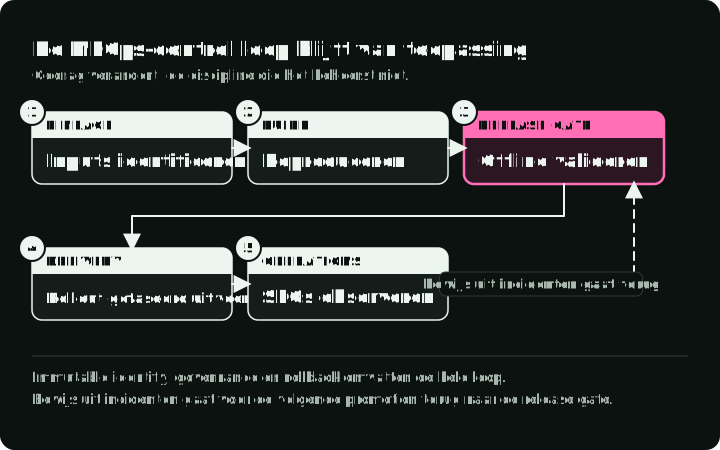
Elke rij van het diagram is één stap van de MLOps-lus: wat MLOps daar al doet en wat een systeem op basis van een foundation model toevoegt. De gestippelde lijn brengt beoordeelde productiefouten als tests terug naar de offline controle. MLOps heeft deze praktijken gevestigd, en ze gelden nog steeds wanneer het model tekst genereert:
- lineage van data, code, configuratie en model naar een release
- herhaalbare training- of build-pipelines
- offline validatie vóór promotie
- registries en onveranderlijke artifact-identiteit
- gefaseerde uitrol, service-level objectives, rollback en incidentrespons
- infrastructuurtelemetrie en capaciteitsplanning
- toegangsbeheer, bewaartermijnen en auditbeleid voor data
De meeste orchestration-tools die je al draait, passen nog steeds, maar niet op elk pad:
| Taak | Tool | Gebruik wanneer |
|---|---|---|
| Batch fine-tuning, geplande index-rebuilds, evaluatieruns | Airflow, Kubeflow Pipelines | Je draait ze al voor MLOps en de taak loopt volgens een schema of op een trigger. |
| Python-native workflows | Metaflow, Flyte, ZenML | Het team schrijft pipelines in Python en wil stappen die ML-bibliotheken rechtstreeks aanroepen. |
| Het requestpad: ophalen, het model aanroepen, tools aanroepen | Applicatiecode | De stap draait één keer per request en moet binnen seconden antwoorden. Workflow-schedulers zijn gebouwd voor batchtaken. |
Foundation models halen deze behoeften niet weg. Ze maken de oude term “modelversie” te klein.
De release-eenheid werd een systeemmanifest
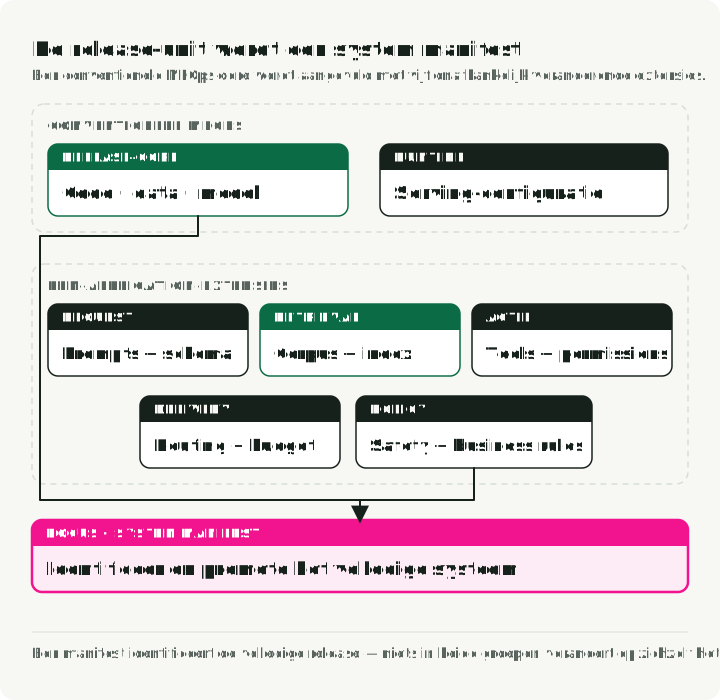
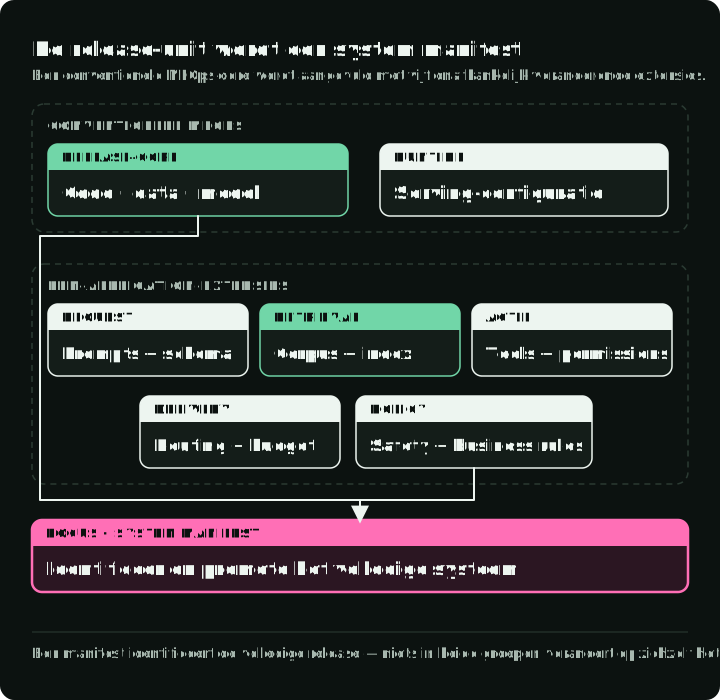
Het diagram toont het manifest van een supportassistent in twee releases. De bovenste rijen tonen wat MLOps al versioneert, de onderste wat een systeem op basis van een foundation model toevoegt, en alleen de gemarkeerde rijen zijn veranderd.
Voor een systeem op basis van een foundation model raad ik een manifest aan dat minstens het volgende vastlegt:
application code revision
model provider + model/revision + serving configuration
system and task prompts
response schema + decoding parameters
retrieval corpus snapshot + parser + chunker + embedding model + index
tool definitions + implementation revisions + permission policy
routing, fallback, caching, and budget policy
safety and business-rule revisions
evaluation dataset + scorer revisions
De exacte lijst hangt af van het systeem. De regel is: benoem elke component die zelfstandig verandert en het gedrag voor de gebruiker kan wijzigen.
Behandel de modelnaam van een provider als wijzigbaar, tenzij de provider een onveranderlijke revisie documenteert. Een checkpoint-hash helpt om zelf gehoste weights te identificeren, maar ik zou toch de runtime, quantization, chat template en parallelisme-configuratie vastleggen. Het modelitem komt uit een registry: gebruik MLflow Model Registry voor weights en adapters die je zelf traint, en de Hugging Face Hub voor open weights, vastgezet op een commit met het argument revision in plaats van een branchnaam.
Bewaar het manifest als bestand naast elke release. Als een release achteruitgaat, vergelijk je het met het vorige. In dit voorbeeld voor een support-assistent zijn alleen de antwoordprompt en de retrieval-snapshot veranderd:
-    answer: prompts/answer.md@v9
+    answer: prompts/answer.md@v10
-    corpus: kb-snapshot-2026-09-28
-    index: kb-idx-2026-09-28-01
+    corpus: kb-snapshot-2026-10-01
+    index: kb-idx-2026-10-01-01
De diff wijst de componenten aan die je eerst controleert: de antwoordprompt en de nieuwe index. De weights, tools en routing zijn niet veranderd.
Welke component je eerst inspecteert
De manifest-diff laat zien wat er is veranderd. Het soort fout vertelt je waar je moet zoeken wanneer de diff alleen het probleem niet verklaart:
| Fout | Eerste component om te inspecteren |
|---|---|
| Ontbrekende actuele of privéfeiten | retrieval en bronsynchronisatie |
| Verkeerd formaat of ongeldige argumenten | schema, constrained output, validatie |
| Inconsistent taakgedrag | prompt, voorbeelden, modelkeuze, daarna adaptatiedata |
| Te hoge latency of kosten | route, context, cache, batching, quantization |
| Ongeautoriseerde of onveilige actie | tool-permissies en deterministisch beleid |
| Domeingedrag dat niet uit context te halen is | fine-tuning of een ander gespecialiseerd model |
Voor de keuze tussen de prompt aanpassen, retrieval toevoegen en fine-tuning, zie fine-tuning vs RAG vs prompting.
Vijf componenten die het gedrag kunnen veranderen
De onderstaande secties behandelen vijf componenten uit het manifestdiagram in volgorde: het model en de serving, dan prompts en schema, het retrieval-corpus en de index, tools en permissies, en veiligheids- en bedrijfsregels. Elke sectie zegt wat je vastlegt, wat je test en welke tools de taak uitvoeren. Routing en fallback krijgen samen met de gateway een eigen sectie.
1. Model en serving
De eerste beslissing is of een provider het model host of dat je het zelf serveert. Een gehoste API neemt het GPU-werk weg. Elke request gaat over het netwerk, je betaalt per token, de data die je verstuurt verlaat je netwerk, en de provider bepaalt de weights, revisies, quota en prijs. Zelf hosten geeft je controle over revisie, quantization, batching, regio en cache. Je beheert dan ook zelf de GPU-capaciteit, en je betaalt ervoor, of die nu bezig is of stilstaat.
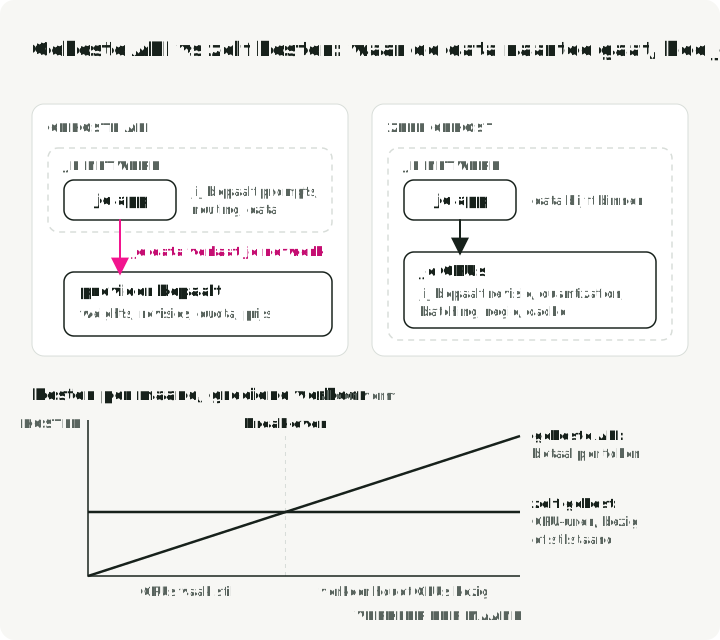
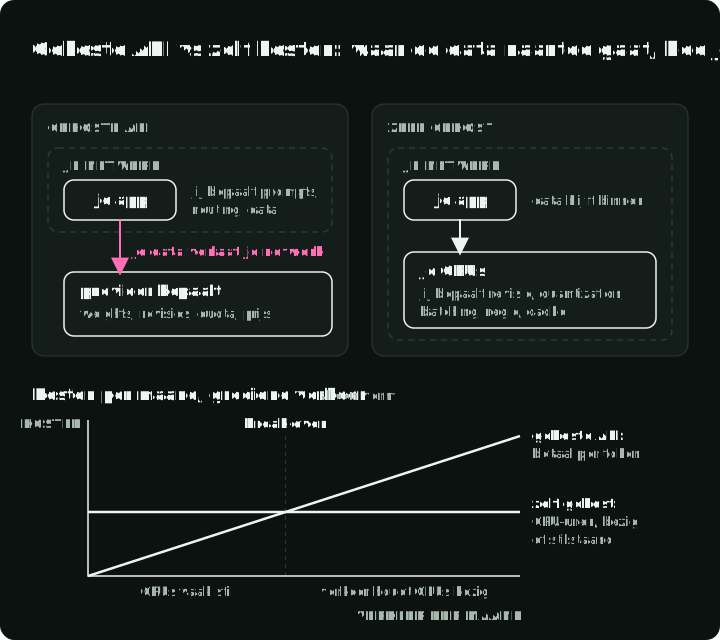
Het bovenste deel van het diagram toont waar de data naartoe gaat en wie in elke modus wat controleert. De grafiek eronder toont hoe de kosten van elke modus met het verkeer groeien. De lijnen kruisen bij het break-evenverkeer, waar de maandelijkse GPU-rekening gelijk is aan de API-rekening voor dezelfde tokens. In beide modi legt het manifest de route vast en draait dezelfde takensuite.
Om het break-evenpunt te vinden, deel je de GPU-kosten per maand door de API-prijs per token. Een voorbeeld met lijstprijzen op 7 oktober 2026 voor Llama 3.3 70B:
- Together AI rekent $1.04 per miljoen tokens, voor input of output.
- In FP8 nemen de 70 miljard weights ongeveer 70 GB in, dus het model past op twee H100 GPUs van 80 GB met ruimte voor de KV cache. Lambda verhuurt een H100 SXM-instance met twee GPUs voor $4.19 per GPU per uur.
- Twee GPUs gedurende 730 uur (een maand) kosten 2 × 730 × $4.19 = $6,117.
- $6,117 ÷ $1.04 per miljoen tokens = ongeveer 5,9 miljard tokens per maand, oftewel ongeveer 2.240 tokens per seconde, elke seconde van de maand.
Onder dat verkeer is de API goedkoper. Erboven is zelf hosten alleen goedkoper als de twee GPUs die snelheid aankunnen, dus meet eerst de throughput met je eigen prompts. Het voorbeeld telt alleen GPU-huur mee. Engineeringtijd, een tweede replica voor beschikbaarheid en opslag verschuiven het break-evenpunt omhoog.
Als je zelf host, kies je de serving-engine op basis van de deployment-vorm:
| Optie | Gebruik wanneer |
|---|---|
| vLLM | Je serveert open-weight models op je eigen GPUs en hebt throughput nodig. Het biedt continuous batching, gequantiseerde weights, veel gefinetunede adapters op één basismodel (zie de LoRA-sectie hieronder) en een OpenAI-compatibele server. |
| Ollama | Je draait models op een laptop voor lokale ontwikkeling en tests. |
| NVIDIA Dynamo-Triton met de TensorRT-LLM backend | Je draait NVIDIA GPUs en wilt engines die voor die hardware zijn gecompileerd, of één server voor LLM- en niet-LLM-models. Vóór 2025 heette het Triton Inference Server. |
| Serverless GPU-platforms zoals Modal | Het verkeer is onregelmatig. Containers kunnen naar nul schalen; de volgende request wacht dan op een cold start. Warme containers hergebruiken geladen models en caches. Bewaar duurzame requeststatus in persistente opslag. |
Models die te groot zijn voor één GPU hebben tijdens het serveren tensor- of pipeline-parallelisme nodig; LLMs schalen met meerdere GPUs en nodes legt elke methode uit. Om een weight-formaat te kiezen voor de runtime en hardware, zie Quantization-formaten voor LLMs.
Neem in beide modi latency, fouten, throughput, verzadiging, kosten en kwaliteitscontroles van de taak mee in de releasebeslissing.
2. Prompts en schema
Versioneer bij een systeem dat requests tijdens runtime samenstelt de samengestelde request, niet alleen de prompttekst: de volgorde van berichten, tool-beschrijvingen, responseschema, decoding, retries, truncatie en omliggende code kunnen elk het gedrag veranderen.
Een kleine promptwijziging kan het uitvoerformaat veranderen. Hier zijn drie versies van een sentiment-prompt:
v1: "Classify this text as positive or negative: {text}"
v2: "You are a sentiment analyzer. Classify: {text}"
v3: "Analyze sentiment. Return only 'positive' or 'negative': {text}"
v1 en v2 kunnen een zin teruggeven zoals “The sentiment is positive.” v3 vraagt om één woord. De code die het antwoord verwerkt moet met de prompt meeveranderen, dus de prompt, het schema en de parser horen samen in het manifest.
Behandel parseerbare JSON als een transportcontrole en test de bedrijfsinvarianten van de taak apart.
3. Retrieval-corpus en index
Retrieval voegt een zelfstandig dataproduct toe tussen de bron van waarheid en het model:
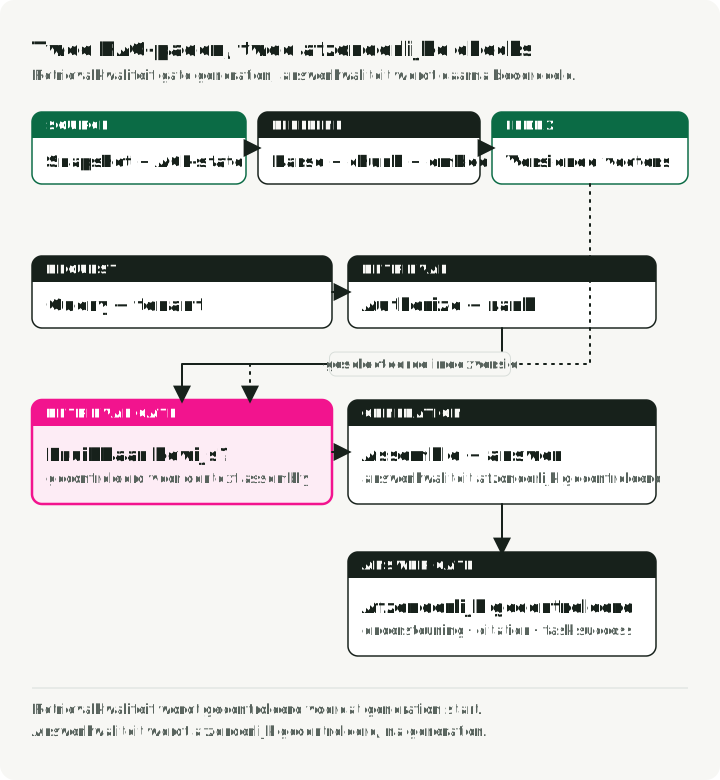
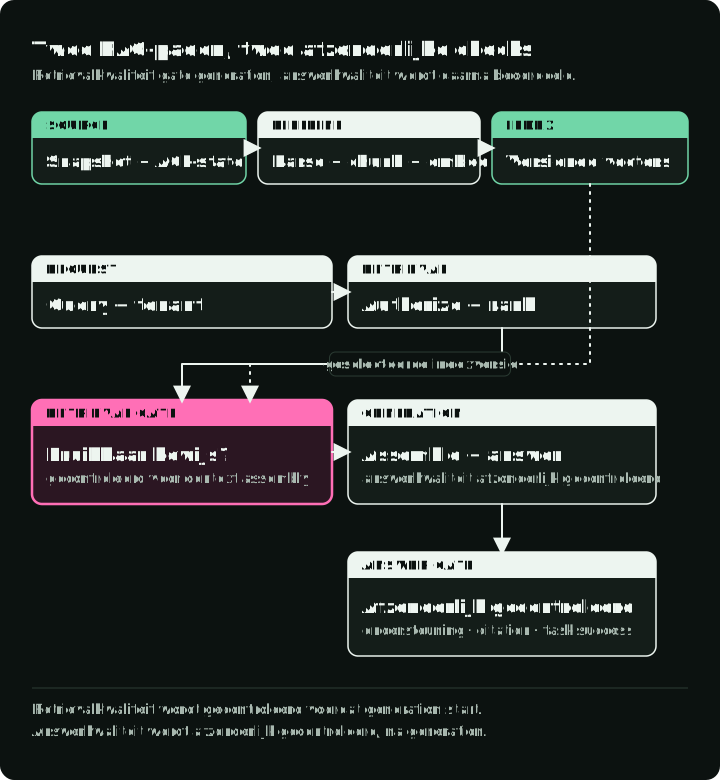
De bovenste rij wordt vóór de requests opgebouwd, en elke stap legt een versie vast. De onderste rij volgt één request, en de genummerde markeringen tonen de drie afzonderlijke tests: de autorisatie, het opgehaalde bewijs en het antwoord.
Leg voor een systeem met retrieval-augmented generation de bronrevisie, de versies van parser en chunker, de embedding-identiteit, de index-build, de toegangsmetadata en de verwijderstatus vast. Het oorspronkelijke RAG-ontwerp scheidt retrieval van generatie; gebruik die scheiding om het ophalen van bewijs, autorisatiefiltering en het gebruik van bewijs onafhankelijk van elkaar te testen. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks beschrijft de retrieve-then-generate-architectuur. Metrics voor RAG-evaluatie behandelt de metrics voor elke controle, en Tools voor RAG-evaluatie vergelijkt de bibliotheken die ze berekenen.
Kies de indexopslag op basis van wie hem gebruikt. Een in-process bibliotheek zoals FAISS is genoeg wanneer één service de index beheert en die in het geheugen van die service past. Gebruik een vector database-server zoals Pinecone, Weaviate of Milvus wanneer meerdere services de index delen, wanneer je tijdens de query metadatafilters nodig hebt, of wanneer de index één machine ontgroeit. Voor het retrieval-ontwerp zelf (één ronde, iteratief zoeken of GraphRAG), zie RAG-architectuur.
Kies de updatemethode op basis van hoe verouderd een antwoord mag zijn. Een geplande rebuild werkt wanneer een antwoord van een dag oud acceptabel is. Moet een wijziging binnen enkele minuten zichtbaar zijn, stream dan de updates, bijvoorbeeld Kafka-events naar een embedding-job die naar de index schrijft. Leg bij een onveranderlijke snapshot vast welke index-build elk antwoord leverde. Leg bij een veranderlijke index ook de voor de query zichtbare ingestierevisie of voortgangsmarkering (watermark) vast, indien beschikbaar, en de revisies van opgehaalde documenten voor elke request. De logvolgnummers in queryantwoorden van Pinecone laten zien waarom een schrijfbevestiging alleen niet aangeeft wat een query zag. Bewaar onveranderlijke snapshots of een opnieuw afspeelbare bronhistorie als exacte datareproductie nodig is; alleen een watermark kan overschreven inhoud niet herstellen.
Gebruik een vectorindex niet als vervanging van een feature store of warehouse: retrieval op basis van gelijkenis, point-in-time features en analytische feiten hebben verschillende eisen aan queries en consistentie.
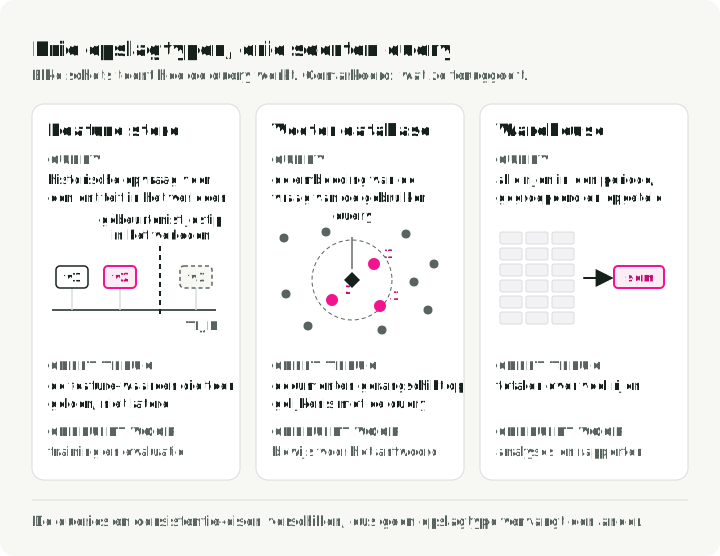
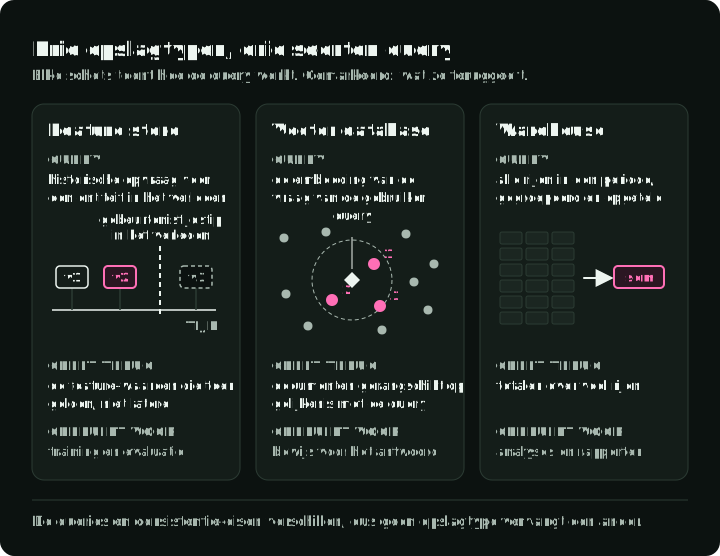
De drie kaarten vergelijken een historische feature-opvraag, retrieval op basis van gelijkenis en aggregatie. De historische opvraag geeft waarden terug die op het eerdere gebeurtenistijdstip golden, een vector database rangschikt documenten op gelijkenis met de query, en een warehouse geeft totalen over veel rijen terug. Houd het warehouse voor analyses.
In Feast maken historische joins trainings- en evaluatiedata voor eerdere gebeurtenistijdstippen. De online store levert de nieuwste gematerialiseerde featurewaarden per entiteit met lage latency.
4. Tools en permissies
Wanneer een model API’s kan aanroepen, zet je deze controles rond elke tool call: tool-authenticatie, least privilege, argumentvalidatie, timeouts, idempotentie, goedkeuringsbeleid en postconditiecontroles. Het Generative AI Profile van NIST benoemt risico’s van schadelijke inhoud, privacy en beveiliging.
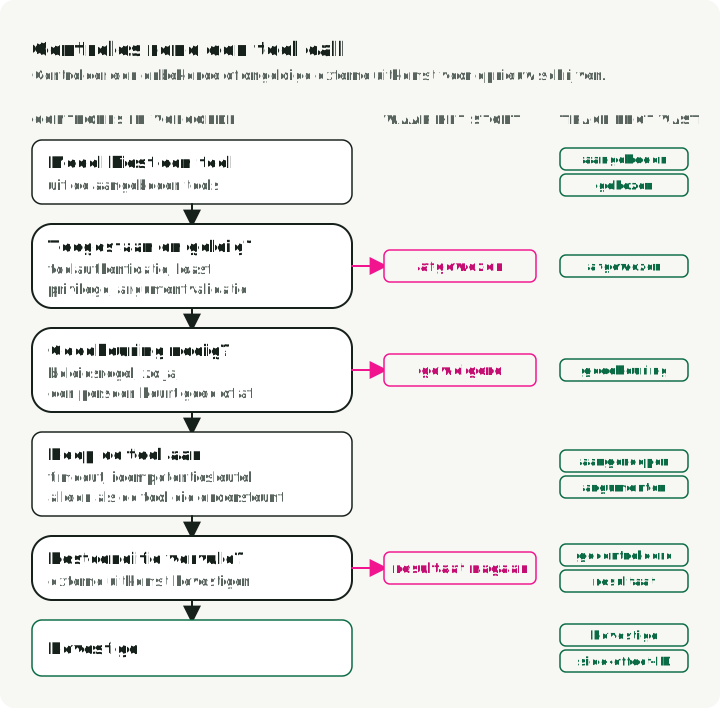
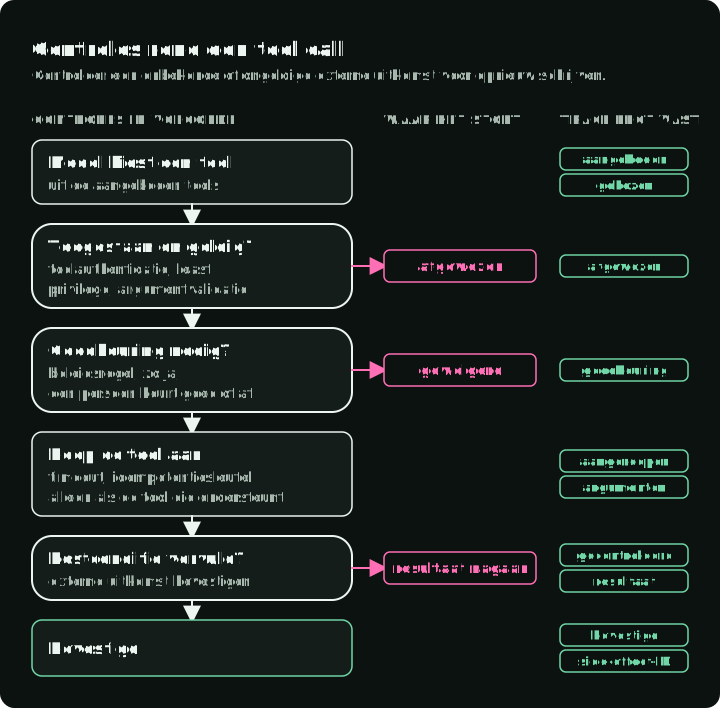
Het diagram toont deze controles in volgorde, waar een aanroep stopt (een afgewezen permissie of argument, een geweigerde goedkeuring, of een resultaat dat niet overeenkomt met de verwachte postconditie) en welk trace-event elke stap vastlegt.
Een timeout kan de uitkomst van een schrijfactie onbekend laten, ook nadat de externe dienst die heeft vastgelegd. Controleer de uitkomst vóór een volgende schrijfactie: controleer de operatie of resource, of gebruik een gedocumenteerde idempotente herhaling. Probeer alleen opnieuw onder een ondersteund idempotentiecontract of met een andere aantoonbaar veilige herstelmethode; AWS beschrijft de benodigde serverondersteuning. Een herhaalde sleutel kan de oorspronkelijke fout teruggeven, zoals het idempotentiecontract van Stripe beschrijft. Gebruik een ondersteunde compensatieactie indien beschikbaar en stuur onopgeloste uitkomsten ter beoordeling door.
Trace welke tool is aangeboden, gekozen, aangeroepen, afgewezen, opnieuw geprobeerd, gecontroleerd en bevestigd. Een vloeiend eindantwoord bewijst niet dat het actiepad correct was.
5. Veiligheids- en bedrijfsregels
Contentfilters zijn één maatregel, geen volledige guardrail-laag. Bedreigingen omvatten ook prompt injection, cross-tenant retrieval, het lekken van secrets, excessive agency (een item in de OWASP Top 10 for LLM Applications), niet-vertrouwde modelbestanden of aangepaste code die tijdens runtime wordt geladen, en onveilige tool-argumenten.
Druk deterministische bedrijfsregels waar mogelijk buiten het model uit. Definieer restrisico’s, test adversariële gevallen en wijs een eigenaar aan voor beleidswijzigingen. Het Generative AI Profile van NIST is een bruikbare risico-inventaris, geen kant-en-klare acceptatietest.
Evaluatie beslist over de release
Vertrouw voor releasebeslissingen over vrije uitvoer niet op één geaggregeerd nauwkeurigheidsgetal. Gebruik meerdere soorten bewijs en bepaal per faaltype welk bewijs doorslaggevend is.
Een evaluatiestack voor een systeem op basis van een foundation model heeft zes lagen:
- Deterministische controles: geldigheid van het schema, aanwezige citaties, toegestane tools, argumentbeperkingen, beleidsregels, latency en budget.
- Componentmetrics: retrieval-recall en rangschikking, nauwkeurigheid van toolselectie, juistheid van tool-argumenten en routeselectie.
- End-to-end taken: representatieve invoer met expliciete succescriteria en slice-labels.
- Modelgebaseerde scoring: rubricgestuurde oordelen, gekalibreerd tegen expertlabels en gemonitord op judge-drift.
- Menselijke beoordeling: dubbelzinnige, ingrijpende, nieuwe of gesamplede gevallen waarin automatisering niet doorslaggevend is.
- Adversariële tests: gevallen van injectie, datagrenzen, misbruik, weigering en neveneffecten, gekoppeld aan het threat model.
Bewaar resultaten per voorbeeld, niet alleen gemiddelden, zodat de releasebeoordeling regressies kan inspecteren per taal, tenant, documenttype of actieklasse.
Vergelijk voor een deploymentbeslissing een kandidaat-manifest met de huidige release op dezelfde geversioneerde suite. Stel drempels voor kwaliteit, veiligheid, latency en kosten samen vast en wijs een goedkopere route af die de takensuite niet haalt.
Valt elk resultaat binnen zijn drempel, start dan een gefaseerde uitrol. Faalt er één, wijs de kandidaat dan af. Is het resultaat van een slice onduidelijk, stuur het dan naar menselijke beoordeling.
Om een evaluatietool te kiezen voor traces, datasets en CI-controles, zie Evaluatietools voor AI agents.
Traces verbinden productie met evaluatie
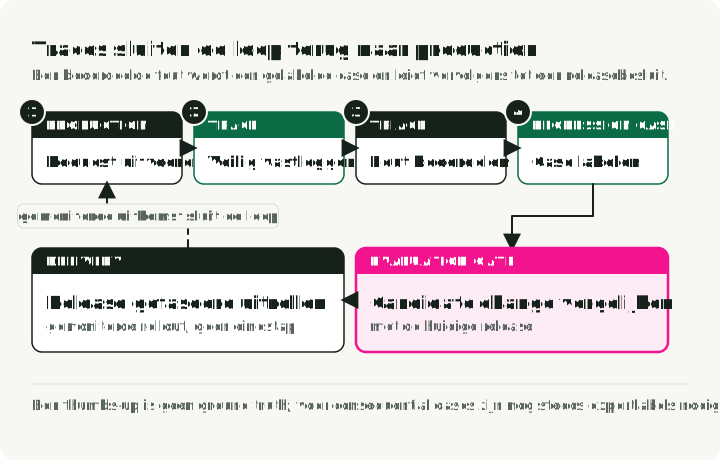
De bovenkant van het diagram is de trace van één request. Metrics zien de trage modelaanroep; alleen de trace toont het ongeautoriseerde document en het verkeerde account. De onderste rij is wat daarna gebeurt: de beoordeelde fout wordt een gelabeld regressiegeval, evaluatie vergelijkt een kandidaatwijziging met de huidige release, en de gestippelde lijn brengt de gefaseerde release terug naar productie.
Infrastructuurmetrics kunnen een trage modelaanroep tonen. Ze kunnen niet tonen dat retrieval een ongeautoriseerd document teruggaf of dat een tool met het verkeerde account werd aangeroepen. De tracing-documentatie van MLflow beschrijft traces die tussenstappen en metadata vastleggen die nodig zijn om dit pad te inspecteren.
Leg een trace vast over het hele beslispad:
- identiteit van het release manifest en request-correlatie
- aanroepen van model en provider, latency, gebruik en eindstatus
- retrieval-query, voor de query zichtbare indexrevisie of watermark, document-ID’s en revisies, scores en filterbeslissingen
- prompt- en templaterevisie, zonder gevoelige inhoud lukraak op te slaan
- tool-aanbiedingen, argumenten, goedkeuringen, resultaten en ID’s van neveneffecten
- beleidsbeslissingen, retries, fallbacks en eindresultaat
Traces zijn een nieuwe opslag van gevoelige data. Pas minimalisatie, afscherming van gevoelige gegevens, tenant-isolatie, versleuteling, sampling, bewaartermijnen en toegangsreview toe voordat je volledige prompts of documenten verzamelt. De GenAI semantic conventions van OpenTelemetry kunnen helpen bij interoperabiliteit, maar ze zijn nog in ontwikkeling. Zet de versie van de conventie of het schema vast, evenals de versies van instrumentatie en collector.
Gebruikersfeedback kan onderzoek prioriteit geven, maar een duim omhoog is geen ground truth. Bewaar de omliggende trace en laat experts gevallen met gevolgen labelen. Label Studio verzamelt labels voor tekst, afbeeldingen en andere datatypen; Argilla verzamelt feedback op tekst en LLM-uitvoer en kan de datasets naar de Hugging Face Hub pushen. AI agents evalueren in productie laat zien hoe je gelabelde traces omzet in een geversioneerde regressiesuite.
De serving-gateway beheert routing en beleid
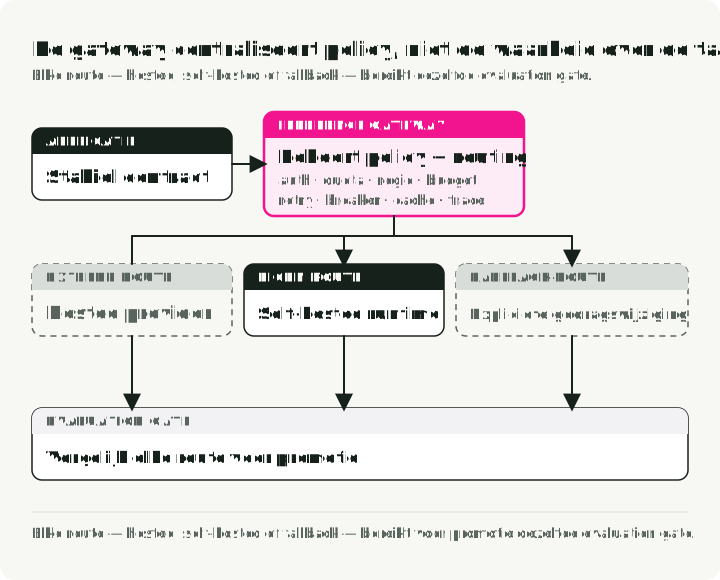
In het diagram neemt elke request één route door de gateway: op basis van het abonnement, via een klein deel van het verkeer voor een nieuw model, of naar een fallback wanneer de provider uitvalt. Elke route geeft hetzelfde responscontract terug, en de takensuite evalueert elke route offline vóór promotie.
Een gateway kan applicatieclients loskoppelen van providers of zelf gehoste engines. Verantwoordelijkheden die je er verstandig neerlegt:
- authenticatie, tenantbudgetten, quota en rate limits
- stabiele request- en responscontracten
- routeselectie op basis van capaciteit, regio, latency of geëvalueerde kwaliteit
- routing op basis van abonnementsniveau, bijvoorbeeld een groter model voor betaalde abonnementen
- een klein deel van het verkeer naar een nieuw model sturen vóór een volledige uitrol
- begrensde retries, circuit breakers en expliciete fallback-semantiek
- cachepartitionering en beleid voor gevoelige data
- gebruikstoewijzing en doorgifte van het release manifest
LiteLLM Proxy is één open-source gateway: hij ontsluit veel providers via één OpenAI-compatibele API en stelt budgetten en rate limits in per sleutel of team.
Fallback is net zozeer een gedragsverandering als een betrouwbaarheidsmechanisme. Als een kleiner model, een andere provider of een verkleinde context de taakkwaliteit verandert, evalueer en trace die tak dan als een eigen route.
Leg niet elke orchestration-beslissing in de gateway. Houd domeinregels dicht bij de applicatie en maak het eigenaarschap zichtbaar.
Fine-tuning en LoRA
De laatste rij van de fouttabel in “Welke component je eerst inspecteert” is het geval voor fine-tuning: het gedrag dat de taak nodig heeft, is niet uit de prompt of de opgehaalde context te halen. LoRA bevriest voorgetrainde weights en voegt trainbare matrices van lage rang toe, waardoor het aantal trainbare parameters voor de downstream-taak daalt. Die optimalisatie neemt de eisen aan datasetbeheer, licenties van het basismodel, evaluatie, serving-compatibiliteit en rollback niet weg.
Leg de adapterinstellingen in het manifest vast naast de revisie van het basismodel: de rang (r), de schaalfactor (lora_alpha) en welke lagen hij wijzigt (target_modules). Elk daarvan verandert wat de adapter leert. De Gids voor fine-tuning van LLMs behandelt datasets, QLoRA en trainingstools, en de Gids voor LoRAX-serving behandelt het serveren van veel adapters op één basismodel.
Een praktische volgorde voor invoering
- Definieer de gebruikerstaak, schadegrenzen, service-doelen en kostenkader.
- Maak het release manifest voordat je een promptregister, vector database of gatewayproduct introduceert.
- Bouw een kleine, in slices verdeelde evaluatieset en deterministische componenttests.
- Instrumenteer één end-to-end trace met privacymaatregelen en stabiele releaseidentiteiten.
- Promoveer via shadow-, canary- of beperkt verkeer met een expliciete rollback-trigger.
- Zet beoordeelde fouten uit productie om in regressiegevallen en herhaal.
Voeg alleen infrastructuur toe wanneer die een taak uitvoert die het manifest benoemt of een gemeten bottleneck wegneemt.
Referenties
- MLflow: evaluating production traces - Hergebruik productietraces voor evaluatie en scoor tussentijdse trace-informatie.
- MLflow: LLM and agent tracing - Leg tussenstappen en trace-metadata vast voor onderzoek.
- OpenTelemetry GenAI semantic conventions - Huidige conventies met ontwikkelstatus voor GenAI-spans, metrics, events en providerspecifieke data.
- NIST AI 600-1: Generative AI Profile - Risicocategorieën voor prompt injection, privacy, beveiliging en aanverwante zorgen rond generatieve AI.
- OWASP Top 10 for LLM Applications - Bevat excessive agency (LLM06:2025) en prompt injection (LLM01:2025).
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks - Oorspronkelijke retrieve-then-generate-architectuur.
- LoRA: Low-Rank Adaptation of Large Language Models - Bevroren voorgetrainde weights plus trainbare matrices van lage rang voor downstream-adaptatie.
- PEFT LoRA reference -
LoraConfig-parameters enget_peft_model. - vLLM documentation - Serving-engine met continuous batching, quantization, multi-LoRA en een OpenAI-compatibele server.
- NVIDIA Dynamo-Triton - Inference-server die voorheen Triton Inference Server heette, met een TensorRT-LLM backend.
- LiteLLM Proxy - Open-source gateway met één API voor alle providers, budgetten, rate limits en fallbacks.