MLOps vs LLMOps: инфраструктура для базовых моделей

Автоматический перевод
Эта статья была автоматически переведена с оригинальной английской версии.
Эта статья для ML-инженеров и платформенных инженеров, которые уже ведут MLOps и теперь эксплуатируют систему на основе фундаментальной модели. В такой системе регрессия может возникнуть из-за изменившегося промпта, индекса, прав инструмента или маршрута, пока веса модели остаются прежними. В статье разобрано, какие практики MLOps остаются в силе, что ещё нужно версионировать, когда поведение меняют промпты, retrieval, инструменты и роутинг, как оценивать и трейсить такую систему и какие инструменты решают каждую задачу.
Что MLOps уже решил
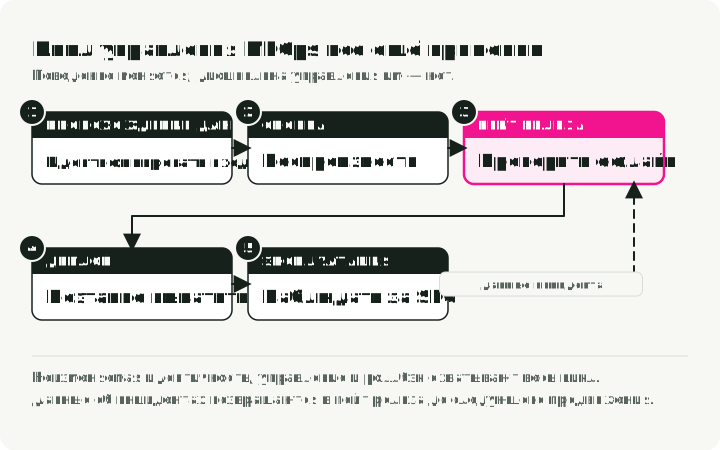
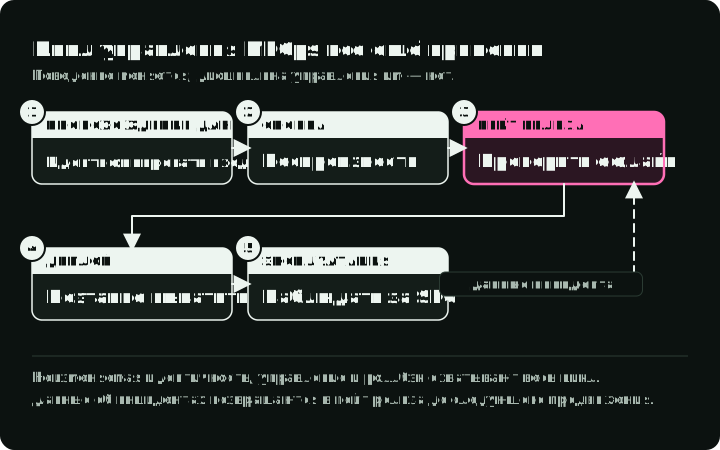
Каждая строка диаграммы — один шаг цикла MLOps: что MLOps уже делает на этом шаге и что добавляет система на фундаментальной модели. Пунктирная связь возвращает проверенные сбои из прода к офлайн-проверке в виде тестов. Эти практики появились в MLOps и остаются в силе, даже когда модель генерирует текст:
- lineage от данных, кода, конфигурации и модели до релиза
- воспроизводимые пайплайны обучения или сборки
- офлайн-валидация перед продвижением
- реестры и неизменяемая идентичность артефактов
- поэтапная выкатка, SLO, откат и реагирование на инциденты
- инфраструктурная телеметрия и планирование мощностей
- контроль доступа, хранение и аудит данных
Большинство инструментов оркестрации, которые вы уже используете, по-прежнему подходят, но не на каждом участке:
| Задача | Инструмент | Когда использовать |
|---|---|---|
| Пакетный файн-тюнинг, плановая пересборка индексов, запуск эвалов | Airflow, Kubeflow Pipelines | Вы уже используете их для MLOps, а задача запускается по расписанию или по триггеру. |
| Пайплайны на Python | Metaflow, Flyte, ZenML | Команда пишет пайплайны на Python и хочет шаги, которые напрямую вызывают ML-библиотеки. |
| Путь запроса: retrieval, вызов модели, вызов инструментов | Код приложения | Шаг выполняется один раз на запрос и должен ответить за секунды. Планировщики рабочих процессов рассчитаны на батчи. |
Фундаментальные модели не отменяют эти потребности. Они делают прежнее понятие «версия модели» слишком узким.
Единицей релиза стал манифест системы
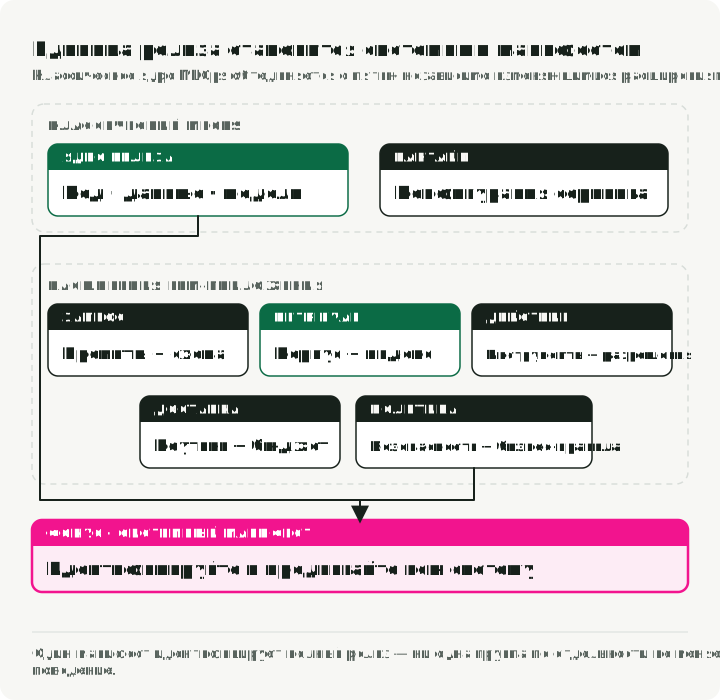
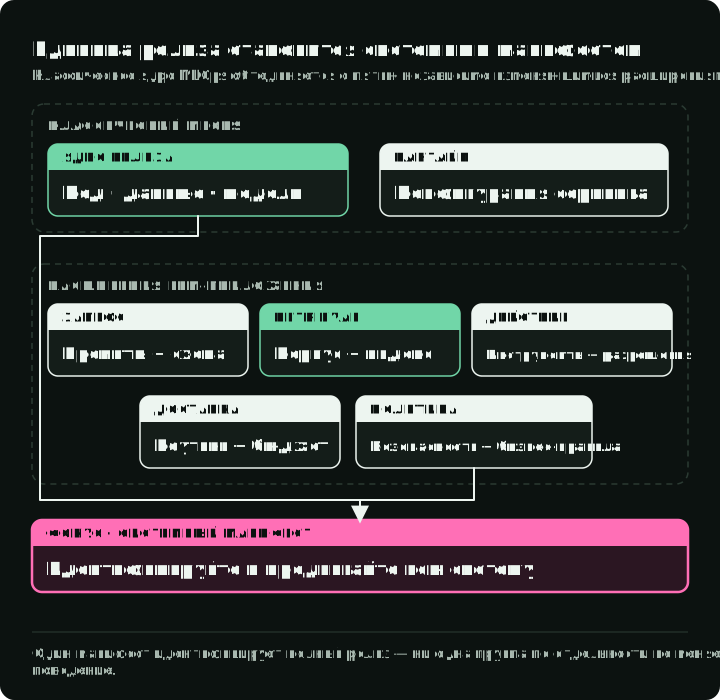
На диаграмме показан манифест ассистента поддержки в двух релизах. Верхние строки — то, что MLOps уже версионирует, нижние — то, что добавляет система на фундаментальной модели, а выделены единственные записи, которые изменились.
Для системы на фундаментальной модели я рекомендую манифест, в котором записано как минимум следующее:
application code revision
model provider + model/revision + serving configuration
system and task prompts
response schema + decoding parameters
retrieval corpus snapshot + parser + chunker + embedding model + index
tool definitions + implementation revisions + permission policy
routing, fallback, caching, and budget policy
safety and business-rule revisions
evaluation dataset + scorer revisions
Точный список зависит от системы. Правило такое: определите каждый независимо меняющийся компонент, который может изменить поведение, видимое пользователю.
Считайте имя модели у провайдера изменяемым, пока провайдер не документирует неизменяемую ревизию. Хеш чекпоинта помогает идентифицировать самостоятельно размещённые веса, но я всё равно записал бы рантайм, квантизацию, шаблон чата и конфигурацию параллелизма. Запись о модели берётся из реестра: используйте MLflow Model Registry для весов и адаптеров, которые вы обучаете, и Hugging Face Hub для открытых весов, зафиксированных на коммите через аргумент revision, а не на имени ветки.
Храните манифест файлом рядом с каждым релизом. Когда релиз ухудшает качество, сравните его с предыдущим. В этом примере для ассистента поддержки изменились только промпт ответа и снапшот retrieval:
-    answer: prompts/answer.md@v9
+    answer: prompts/answer.md@v10
-    corpus: kb-snapshot-2026-09-28
-    index: kb-idx-2026-09-28-01
+    corpus: kb-snapshot-2026-10-01
+    index: kb-idx-2026-10-01-01
Дифф называет компоненты, которые надо проверить первыми: промпт ответа и новый индекс. Веса, инструменты и роутинг не менялись.
Какой компонент проверять первым
Дифф манифеста показывает, что изменилось. Если дифф сам не объясняет сбой, тип сбоя подсказывает, куда смотреть:
| Сбой | Первый компонент для проверки |
|---|---|
| Нет актуальных или приватных фактов | retrieval и синхронизация источников |
| Неверный формат или некорректные аргументы | схема, constrained decoding, валидация |
| Нестабильное поведение на задаче | промпт, примеры, выбор модели, затем данные для адаптации |
| Лишняя латентность или стоимость | маршрут, контекст, кэш, батчинг, квантизация |
| Несанкционированное или небезопасное действие | права инструментов и детерминированная политика |
| Доменное поведение не восстановить из контекста | файн-тюнинг или другая специализированная модель |
О выборе между изменением промпта, добавлением retrieval и файн-тюнингом см. файн-тюнинг, RAG и промптинг.
Пять компонентов, которые могут изменить поведение
Следующие разделы по порядку разбирают пять компонентов с диаграммы манифеста: модель и её сервинг, затем промпты и схему, корпус и индекс retrieval, инструменты и права, безопасность и бизнес-правила. Каждый раздел говорит, что записывать, что тестировать и какие инструменты решают задачу. Роутинг и fallback вынесены в отдельный раздел вместе со шлюзом.
1. Модель и сервинг
Первое решение: модель хостит провайдер или вы обслуживаете её сами. Хостируемый API избавляет от работы с GPU. Каждый запрос идёт по сети, вы платите за токены, отправляемые данные покидают вашу сеть, а провайдер контролирует веса, ревизии, квоты и цену. Самостоятельный хостинг даёт контроль над ревизией, квантизацией, батчингом, регионом и кэшем. Зато вы сами отвечаете за мощности GPU и платите за них независимо от того, заняты они или простаивают.
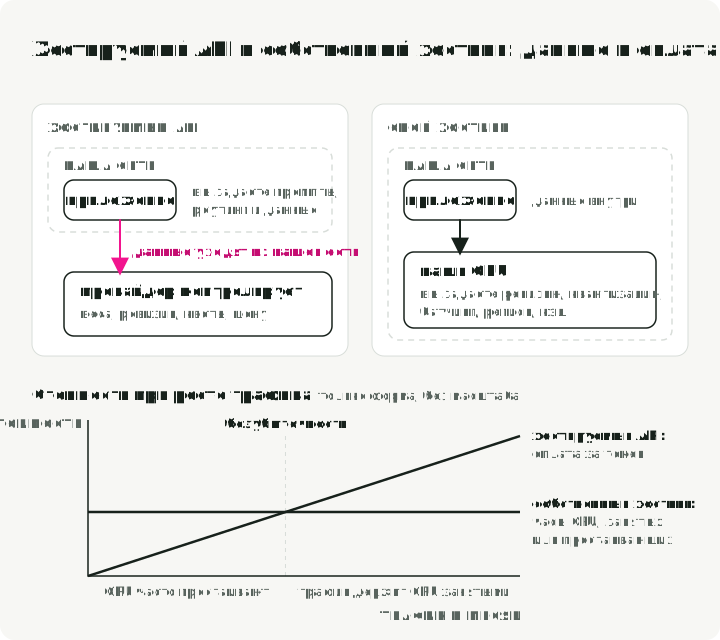
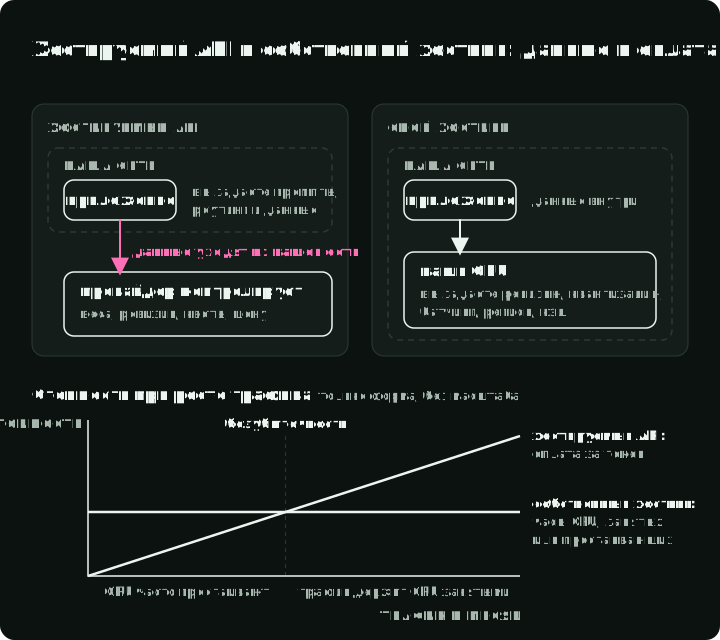
Верхняя часть диаграммы показывает, куда уходят данные и кто что контролирует в каждом режиме. График под ней показывает, как стоимость каждого режима растёт с трафиком. Линии пересекаются в точке безубыточности: при таком трафике месячный счёт за GPU равен счёту за API для тех же токенов. В обоих режимах манифест записывает маршрут, и запускается один и тот же набор задач.
Чтобы найти точку безубыточности, разделите стоимость GPU за месяц на цену API за токен. Пример по прайс-листам на 7 октября 2026 года для Llama 3.3 70B:
- Together AI берёт $1.04 за миллион токенов, входных или выходных.
- В FP8 70 миллиардов весов занимают около 70 ГБ, поэтому модель помещается на два GPU H100 по 80 ГБ с запасом под KV cache. Lambda сдаёт в аренду инстанс с двумя H100 SXM по $4.19 за GPU в час.
- Два GPU за 730 часов (один месяц) стоят 2 × 730 × $4.19 = $6,117.
- $6,117 ÷ $1.04 за миллион токенов = около 5.9 миллиарда токенов в месяц, или около 2,240 токенов в секунду, каждую секунду месяца.
Ниже этого трафика дешевле API. Выше него самостоятельный хостинг дешевле, только если два GPU способны обслужить такой темп, поэтому сначала измерьте пропускную способность на своих промптах. В примере учтена только аренда GPU. Время инженеров, вторая реплика для доступности и хранилище сдвигают точку безубыточности выше.
Если вы обслуживаете модель сами, выбирайте движок сервинга по форме деплоя:
| Вариант | Когда использовать |
|---|---|
| vLLM | Вы обслуживаете модели с открытыми весами на своих GPU и вам нужна пропускная способность. Есть continuous batching, квантизованные веса, много файн-тюненных адаптеров на одной базовой модели (см. раздел о LoRA ниже) и OpenAI-совместимый сервер. |
| Ollama | Вы запускаете модели на ноутбуке для локальной разработки и тестов. |
| NVIDIA Dynamo-Triton с бэкендом TensorRT-LLM | Вы работаете на GPU NVIDIA и хотите движки, скомпилированные под это железо, или один сервер для LLM и не-LLM моделей. До 2025 года назывался Triton Inference Server. |
| Serverless-платформы с GPU, например Modal | Трафик нерегулярный. Контейнеры могут масштабироваться до нуля, и следующий запрос тогда ждёт холодного старта. Прогретые контейнеры повторно используют загруженные модели и кэши. Храните долговременное состояние запросов в постоянном хранилище. |
Модели, которые не помещаются на один GPU, требуют тензорного или конвейерного параллелизма при сервинге; каждый метод объясняет статья Масштабирование LLM с несколькими GPU и узлами. Как выбрать формат весов под рантайм и железо, см. форматы квантизации LLM.
В любом режиме включайте в решение о релизе проверки латентности, ошибок, пропускной способности, насыщения, стоимости и качества на задачах.
2. Промпты и схема
Если система собирает запросы во время работы, версионируйте собранный запрос, а не только текст промпта: порядок сообщений, описания инструментов, схема ответа, параметры декодирования, ретраи, усечение и окружающий код могут по отдельности менять поведение.
Небольшое изменение промпта может изменить формат вывода. Вот три версии промпта для анализа тональности:
v1: "Classify this text as positive or negative: {text}"
v2: "You are a sentiment analyzer. Classify: {text}"
v3: "Analyze sentiment. Return only 'positive' or 'negative': {text}"
v1 и v2 могут вернуть предложение вроде «The sentiment is positive.». v3 просит одно слово. Код, который разбирает ответ, должен меняться вместе с промптом, поэтому промпт, схема и парсер попадают в манифест вместе.
Относитесь к JSON, который удаётся разобрать, как к проверке транспорта, а бизнес-инварианты задачи тестируйте отдельно.
3. Корпус и индекс retrieval
Retrieval добавляет между источником истины и моделью независимый продукт данных:
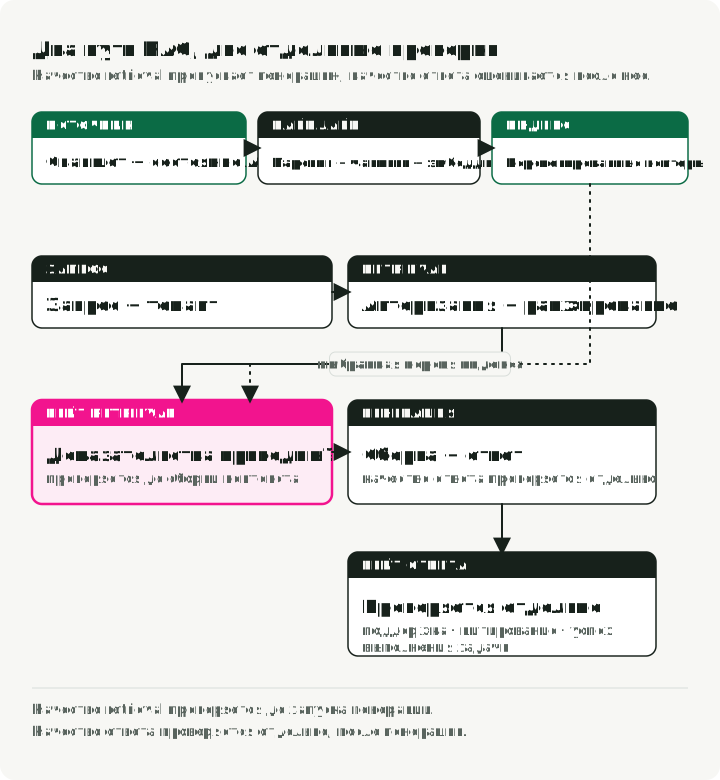
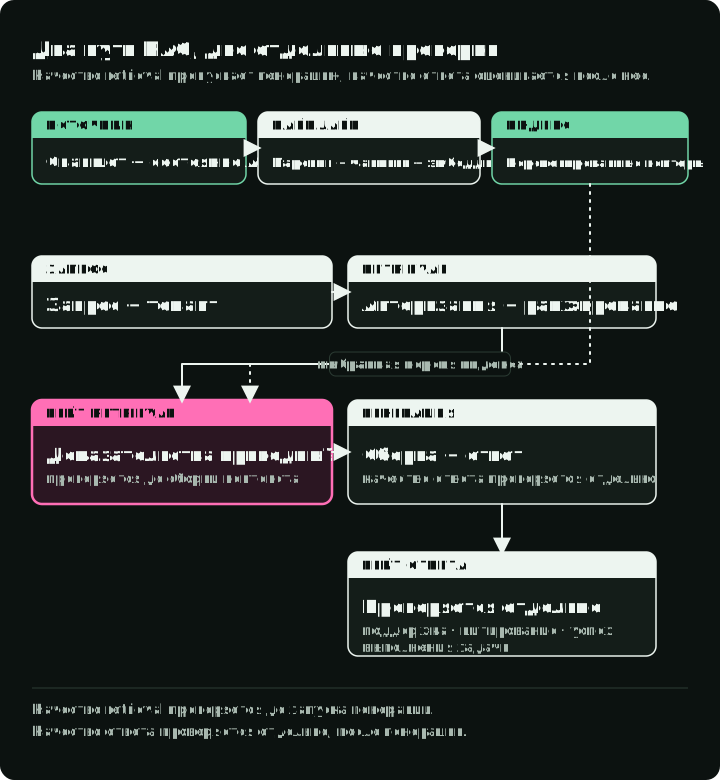
Верхний ряд собирается заранее, до запросов, и каждый шаг фиксирует версию. Нижний ряд показывает один запрос, а пронумерованные метки отмечают три отдельных теста: авторизацию, найденные свидетельства и ответ.
Для системы с retrieval сохраняйте ревизию источника, версии парсера и чанкера, идентичность эмбеддинг-модели, сборку индекса, метаданные контроля доступа и состояние удаления. Исходный дизайн RAG разделяет retrieval и генерацию; используйте это разделение, чтобы независимо тестировать поиск свидетельств, фильтрацию по авторизации и использование свидетельств. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks описывает архитектуру «сначала найти, затем сгенерировать». Метрики оценки RAG разбирают метрики для каждой проверки, а инструменты оценки RAG сравнивают библиотеки, которые их считают.
Выбирайте хранилище индекса по тому, кто им пользуется. Библиотеки внутри процесса, например FAISS, хватает, когда индекс принадлежит одному сервису и помещается в его память. Векторную базу данных в виде сервера, например Pinecone, Weaviate или Milvus, используйте, когда индекс делят несколько сервисов, когда нужны фильтры по метаданным на этапе запроса или когда индекс перерастает одну машину. Сам дизайн retrieval (один проход, итеративный поиск или GraphRAG) разобран в архитектуре RAG.
Выбирайте способ обновления по тому, насколько устаревшим может быть ответ. Плановой пересборки достаточно, если ответ суточной давности допустим. Если изменение должно появиться за минуты, стримьте обновления, например события Kafka в задачу эмбеддинга, которая пишет в индекс. Для неизменяемого снапшота записывайте, какая сборка индекса обслужила каждый ответ. Для изменяемого индекса также записывайте в трейс видимую запросу ревизию загруженных данных или отметку прогресса (watermark), если она доступна, и ревизии найденных документов для каждого запроса. Порядковые номера журнала в ответах на запросы Pinecone показывают, почему одно подтверждение записи не определяет, что увидел запрос. Если нужно точно воспроизвести данные, сохраняйте неизменяемые снапшоты или воспроизводимую историю источников; одна отметка прогресса не восстановит перезаписанный контент.
Не используйте векторный индекс вместо feature store или хранилища данных: поиск по сходству, признаки на момент времени и аналитические факты имеют разные требования к запросам и согласованности.
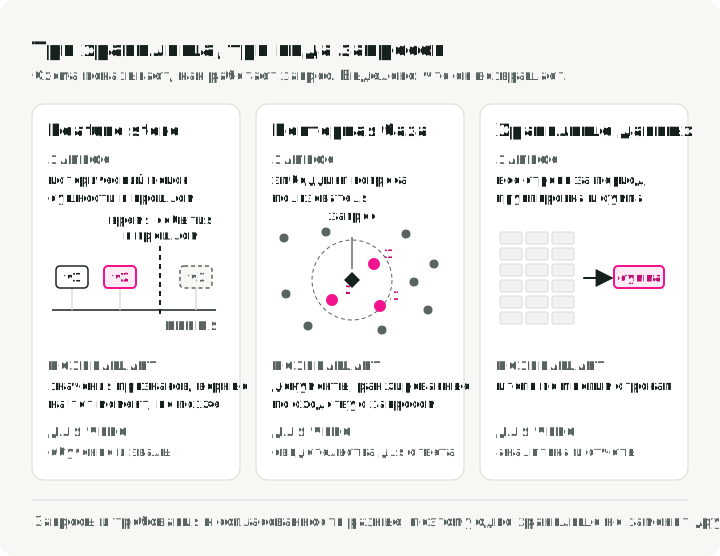
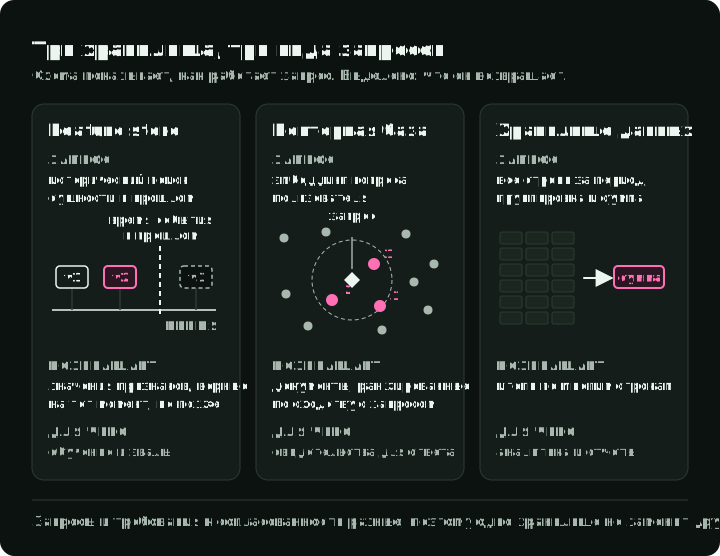
Три карточки сравнивают исторический поиск признаков, поиск по сходству и агрегацию. Исторический поиск возвращает значения, действительные в прошлый момент события, векторная база данных ранжирует документы по сходству с запросом, а хранилище данных возвращает итоги по многим строкам. Для аналитики оставьте хранилище данных.
В Feast исторические соединения собирают данные для обучения и эвалов по прошлым моментам событий. Его онлайн-хранилище отдаёт последние материализованные значения признаков каждой сущности с низкой латентностью.
4. Инструменты и права
Когда модель может вызывать API, окружите каждый вызов инструмента такими проверками: аутентификация инструмента, минимальные привилегии, валидация аргументов, таймауты, идемпотентность, политика подтверждения и проверка постусловий. Generative AI Profile от NIST выделяет риски вредного контента, приватности и безопасности.
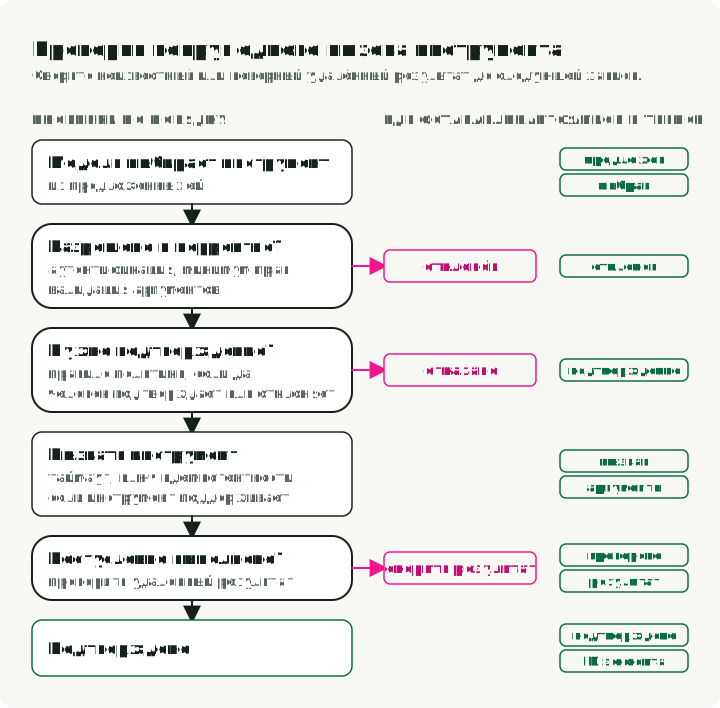
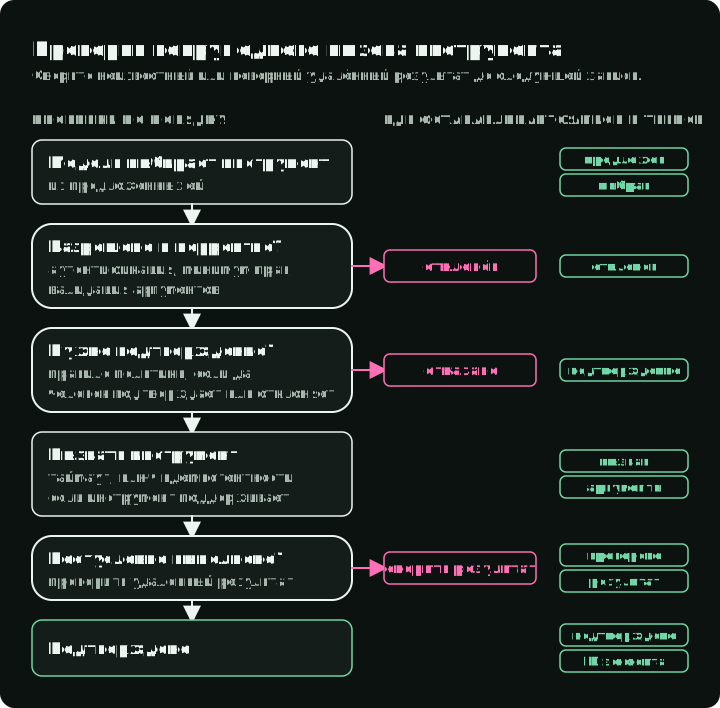
Диаграмма показывает эти проверки по порядку, места, где вызов останавливается (отклонённое право или аргумент, отказ в подтверждении или результат, не совпавший с ожидаемым постусловием), и событие трейса, которое записывает каждый шаг.
Таймаут может оставить результат записи неизвестным, даже если удалённый сервис уже выполнил её. Сверьте результат перед следующей записью: проверьте операцию или ресурс либо используйте документированный идемпотентный повтор. Повторяйте только по поддерживаемому контракту идемпотентности или с помощью другого проверенного безопасного способа восстановления; AWS объясняет, какая поддержка нужна на сервере. Повторный ключ может вернуть исходный сбой, как описано в контракте идемпотентности Stripe. Используйте поддерживаемое компенсирующее действие, если оно доступно, и отправляйте невыясненные результаты на проверку.
Трейсите, какой инструмент был предложен, выбран, вызван, отклонён, повторён, сверён и подтверждён. Связный финальный ответ не доказывает, что путь действий был верным.
5. Безопасность и бизнес-правила
Фильтры контента — это один контроль, а не полноценный слой гардрейлов. Угрозы также включают промпт-инъекции, retrieval между тенантами, раскрытие секретов, избыточную автономность (excessive agency; пункт OWASP Top 10 for LLM Applications), недоверенные файлы моделей или пользовательский код, загружаемый в рантайме, и небезопасные аргументы инструментов.
Где возможно, выражайте детерминированные бизнес-правила вне модели. Определите остаточные риски, тестируйте состязательные случаи и назначьте владельца изменений политики. Generative AI Profile от NIST — полезный перечень рисков, а не готовый приёмочный тест.
Эвалы определяют выпуск релиза
Для решений о релизе при свободной форме вывода не полагайтесь на одну агрегированную цифру точности. Используйте несколько видов свидетельств и определите, какое из них авторитетно для каждого типа сбоя.
Стек эвалов для системы на фундаментальной модели состоит из шести уровней:
- Детерминированные проверки: валидность схемы, наличие цитат, разрешённые инструменты, ограничения аргументов, правила политики, латентность и бюджет.
- Метрики компонентов: полнота и ранжирование retrieval, точность выбора инструмента, корректность аргументов инструмента и выбор маршрута.
- Сквозные задачи: репрезентативные входы с явными критериями успеха и метками срезов.
- Оценка моделью: оценки по рубрике, откалиброванные по меткам экспертов, с мониторингом дрейфа джаджа.
- Проверка человеком: неоднозначные, значимые, новые или выборочные случаи, где автоматика не авторитетна.
- Состязательные тесты: инъекции, границы данных, злоупотребления, отказы и побочные эффекты, привязанные к модели угроз.
Храните результаты по каждому примеру, а не только средние, чтобы ревью релиза могло изучать регрессии по языку, тенанту, типу документа или классу действия.
Для решения о деплое сравните манифест-кандидат с текущим релизом на одном и том же версионированном наборе. Задайте пороги для качества, безопасности, латентности и стоимости вместе и отклоняйте более дешёвый маршрут, который проваливает набор задач.
Если каждый результат в пределах порога, начните поэтапную выкатку. Если один провален, отклоните кандидата. Если результат среза неясен, отправьте его на проверку человеком.
Как выбрать инструмент эвалов для трейсов, датасетов и проверок в CI, см. инструменты оценки ИИ-агентов.
Трейсы связывают прод с эвалами
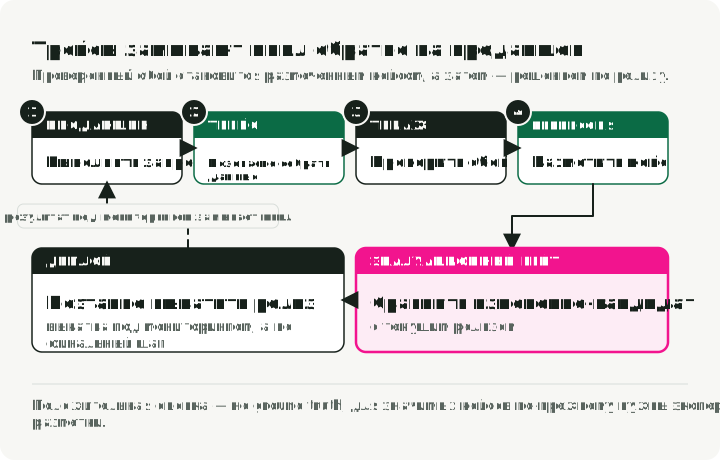
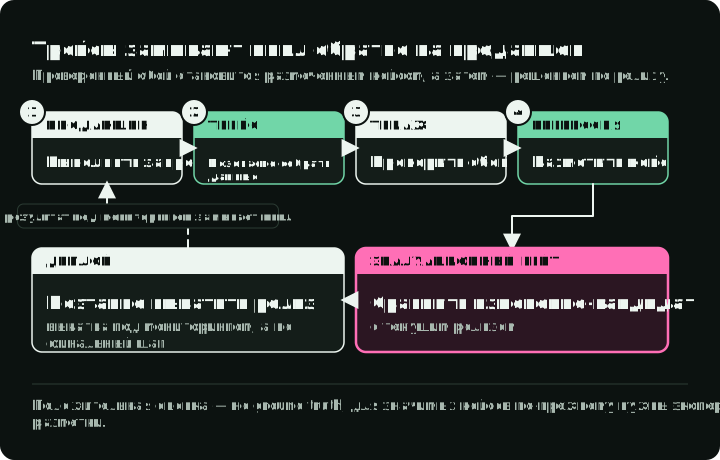
Верх диаграммы — трейс одного запроса. Метрики видят медленный вызов модели; только трейс показывает документ без разрешения на доступ и чужой аккаунт. Нижний ряд — что происходит дальше: проверенный сбой становится размеченным регрессионным случаем, эвал сравнивает изменение-кандидат с текущим релизом, а пунктирная связь возвращает поэтапный релиз в прод.
Инфраструктурные метрики могут показать медленный вызов модели. Они не покажут, что retrieval вернул документ без авторизации или что инструмент вызван с неверным аккаунтом. Документация MLflow по трейсингу описывает трейсы, которые записывают промежуточные шаги и метаданные, нужные для разбора этого пути.
Записывайте трейс по всему пути решений:
- идентичность манифеста релиза и корреляция запросов
- вызовы модели и провайдера, латентность, расход и состояние завершения
- запрос retrieval, видимая запросу ревизия индекса или отметка прогресса, идентификаторы и ревизии документов, оценки и решения фильтрации
- ревизия промпта или шаблона без неразборчивого хранения чувствительного содержимого
- предложенные инструменты, аргументы, подтверждения, результаты и идентификаторы побочных эффектов
- решения политик, ретраи, fallback и итоговый исход
Трейсы — новое хранилище чувствительных данных. Применяйте минимизацию, маскирование чувствительных данных, изоляцию тенантов, шифрование, сэмплирование, хранение и ревизию доступа до того, как собирать полные промпты или документы. Семантические конвенции OpenTelemetry для GenAI помогают с интероперабельностью, но остаются в разработке. Фиксируйте версию конвенции или схемы, инструментирования и коллекторов.
Обратная связь пользователей может расставить приоритеты расследования, но «палец вверх» не является эталоном. Сохраняйте окружающий трейс и получайте экспертные метки для значимых случаев. Label Studio собирает метки для текста, изображений и других типов данных; Argilla собирает обратную связь по тексту и выводам LLM и может отправлять датасеты в Hugging Face Hub. Оценка ИИ-агентов в проде показывает, как превратить размеченные трейсы в версионированный регрессионный набор.
Шлюз сервинга отвечает за роутинг и политики
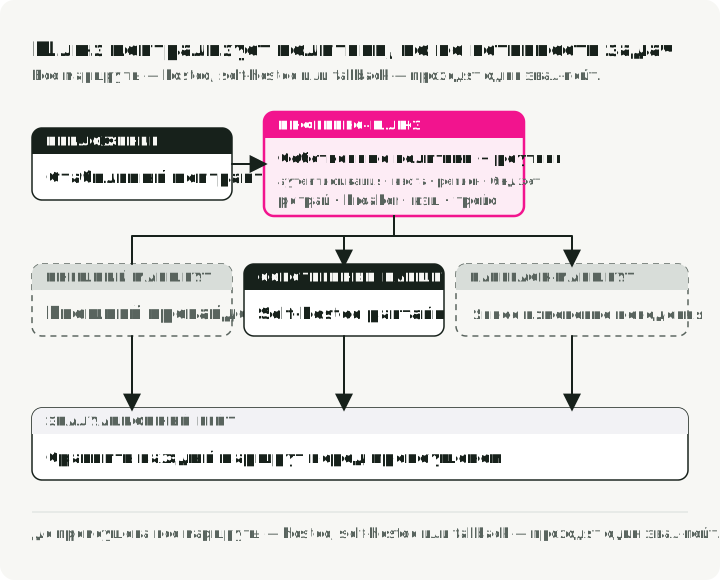
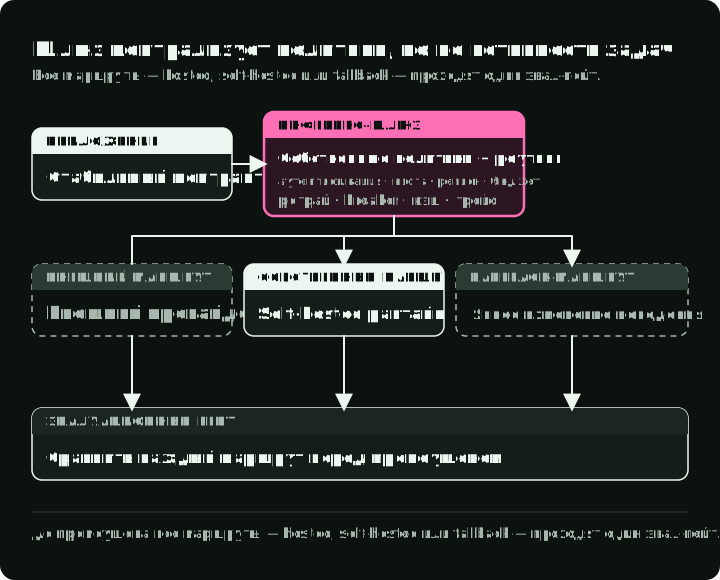
На диаграмме каждый запрос идёт через шлюз по одному маршруту: по тарифу, по небольшой доле трафика для новой модели или на запасной маршрут, когда провайдер отказывает. Каждый маршрут возвращает один и тот же контракт ответа, а набор задач оценивает каждый маршрут офлайн до продвижения.
Шлюз может отвязать клиентов приложения от провайдеров или собственных движков. Обязанности, которые стоит поручить ему:
- аутентификация, бюджеты тенантов, квоты и лимиты запросов
- стабильные контракты запроса и ответа
- выбор маршрута по возможностям, региону, латентности или оценённому качеству
- роутинг по тарифу подписки, например более крупная модель для платных планов
- отправка небольшой доли трафика на новую модель до полной выкатки
- ограниченные ретраи, circuit breaker и явная семантика fallback
- разделение кэша и политика для чувствительных данных
- учёт использования и передача манифеста релиза
LiteLLM Proxy — один из открытых шлюзов: он предоставляет доступ ко многим провайдерам через один OpenAI-совместимый API и задаёт бюджеты и лимиты запросов на ключ или команду.
Fallback — это изменение поведения не меньше, чем механизм надёжности. Если меньшая модель, другой провайдер или урезанный контекст меняют качество на задаче, оценивайте и трейсите эту ветку как отдельный маршрут.
Не переносите в шлюз все решения по оркестрации. Держите доменные правила рядом с приложением и явно указывайте ответственных.
Файн-тюнинг и LoRA
Последняя строка таблицы сбоев в разделе «Какой компонент проверять первым» — это случай для файн-тюнинга: нужное задаче поведение не восстановить из промпта или найденного контекста. LoRA замораживает предобученные веса и добавляет обучаемые матрицы низкого ранга, уменьшая число обучаемых параметров для целевой задачи. Эта оптимизация не снимает требований к управлению датасетами, лицензиям базовой модели, эвалам, совместимости сервинга и откату.
Записывайте настройки адаптера в манифест рядом с ревизией базовой модели: ранг (r), коэффициент масштабирования (lora_alpha) и изменяемые слои (target_modules). Каждый из них меняет то, чему учится адаптер. Руководство по файн-тюнингу LLM охватывает датасеты, QLoRA и инструменты обучения, а руководство по сервингу LoRAX — сервинг многих адаптеров на одной базовой модели.
Практическая последовательность внедрения
- Определите задачу пользователя, границы вреда, целевые показатели сервиса и бюджет стоимости.
- Создайте манифест релиза до того, как вводить реестр промптов, векторную базу данных или продукт-шлюз.
- Соберите небольшой набор для эвалов со срезами и детерминированные тесты компонентов.
- Инструментируйте один сквозной трейс с контролем приватности и стабильными идентичностями релиза.
- Продвигайте через shadow, canary или ограниченный трафик с явным триггером отката.
- Превращайте проверенные сбои в проде в регрессионные случаи и повторяйте.
Добавляйте инфраструктуру только тогда, когда она выполняет задачу, названную в манифесте, или устраняет измеренный боттлнек.
Источники
- MLflow: evaluating production traces - Повторное использование трейсов из прода для эвалов и оценка промежуточной информации трейса.
- MLflow: LLM and agent tracing - Захват промежуточных шагов и метаданных трейса для расследования.
- OpenTelemetry GenAI semantic conventions - Актуальные конвенции (статус development) для спанов, метрик, событий и данных конкретных провайдеров GenAI.
- NIST AI 600-1: Generative AI Profile - Категории рисков: промпт-инъекции, приватность, безопасность и связанные проблемы генеративного ИИ.
- OWASP Top 10 for LLM Applications - Включает excessive agency (LLM06:2025) и промпт-инъекции (LLM01:2025).
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks - Исходная архитектура «найти, затем сгенерировать».
- LoRA: Low-Rank Adaptation of Large Language Models - Замороженные предобученные веса плюс обучаемые матрицы низкого ранга для адаптации к задаче.
- PEFT LoRA reference - Параметры
LoraConfigиget_peft_model. - vLLM documentation - Движок сервинга с continuous batching, квантизацией, multi-LoRA и OpenAI-совместимым сервером.
- NVIDIA Dynamo-Triton - Инференс-сервер, ранее называвшийся Triton Inference Server, с бэкендом TensorRT-LLM.
- LiteLLM Proxy - Открытый шлюз с одним API для провайдеров, бюджетами, лимитами запросов и fallback.