MLOps vs LLMOps : l'infrastructure des modèles de fondation

Traduction automatique
Cet article a été traduit automatiquement depuis la version originale en anglais.
Cet article s’adresse aux ingénieurs ML et plateforme qui font déjà du MLOps et exploitent désormais un système construit sur un modèle de fondation. Dans un tel système, une régression peut venir d’un prompt, d’un index, d’une permission d’outil ou d’une route modifiés, alors que les poids du modèle restent les mêmes. L’article indique quelles pratiques MLOps restent valables, ce qu’il faut versionner en plus quand les prompts, le retrieval, les outils et le routage peuvent changer le comportement, comment évaluer et tracer ce système, et quels outils font chaque travail.
Ce que le MLOps a déjà résolu
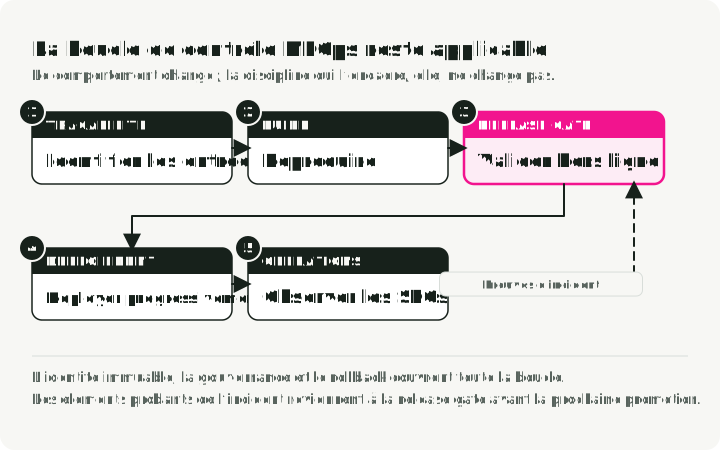
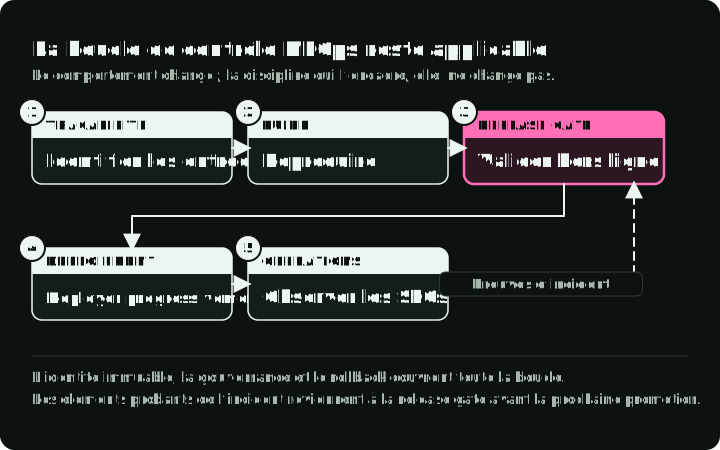
Chaque ligne du diagramme est une étape de la boucle MLOps : ce que le MLOps fait déjà à cette étape, et ce qu’un système à base de modèle de fondation ajoute. L’arête en pointillés ramène les échecs de production revus vers la vérification hors ligne, sous forme de tests. Le MLOps a établi les pratiques suivantes, et elles s’appliquent toujours quand le modèle génère du texte :
- la traçabilité des données, du code, de la configuration et du modèle jusqu’à une release
- des pipelines d’entraînement ou de build reproductibles
- une validation hors ligne avant la promotion
- des registres et une identité d’artefact immuable
- le déploiement progressif, les objectifs de niveau de service, le rollback et la réponse aux incidents
- la télémétrie d’infrastructure et la planification de capacité
- le contrôle d’accès, la rétention et la politique d’audit pour les données
La plupart des outils d’orchestration que vous exploitez déjà conviennent encore, mais pas sur tous les chemins :
| Tâche | Outil | À utiliser quand |
|---|---|---|
| Fine-tuning par lots, reconstructions planifiées d’index, runs d’évaluation | Airflow, Kubeflow Pipelines | Vous les exploitez déjà pour le MLOps et la tâche s’exécute selon un planning ou un déclencheur. |
| Workflows natifs Python | Metaflow, Flyte, ZenML | L’équipe écrit ses pipelines en Python et veut des étapes qui appellent directement les bibliothèques ML. |
| Le chemin de la requête : retrieval, appel du modèle, appel des outils | Code applicatif | L’étape s’exécute une fois par requête et doit répondre en quelques secondes. Les ordonnanceurs visent les jobs batch. |
Les modèles de fondation ne suppriment pas ces besoins. Ils rendent l’ancienne expression « version du modèle » trop étroite.
L’unité de release est devenue un manifeste du système
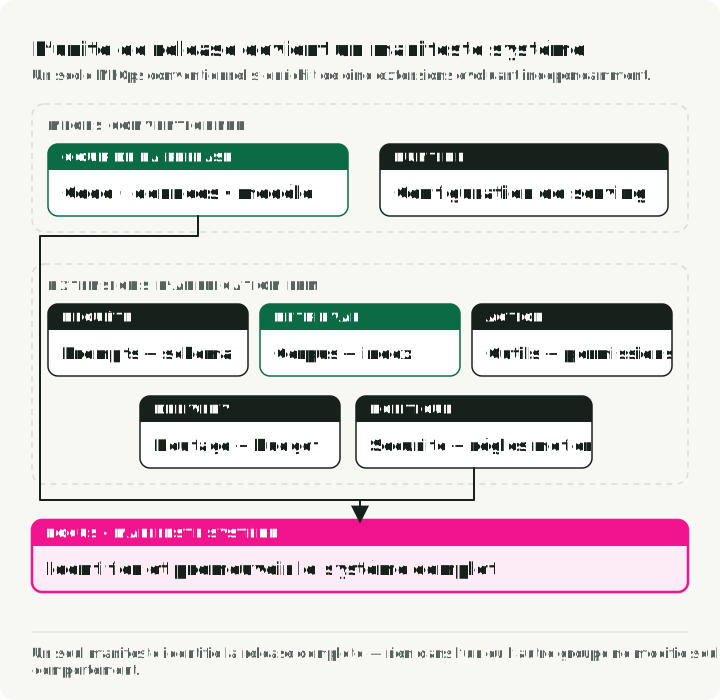
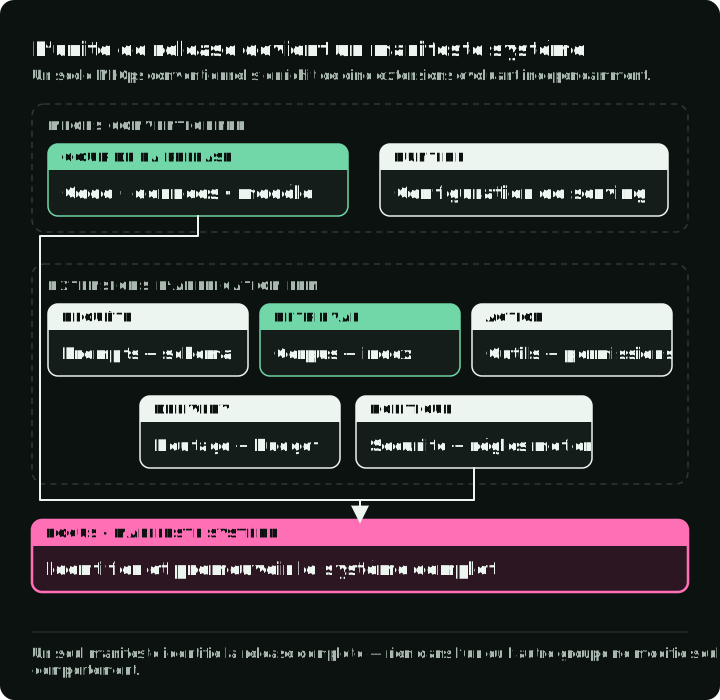
Le diagramme montre le manifeste d’un assistant de support sur deux releases. Les lignes du haut sont ce que le MLOps versionne déjà, les lignes du bas sont ce qu’un système à base de modèle de fondation ajoute, et les lignes surlignées sont les seules entrées qui ont changé.
Pour un système à base de modèle de fondation, je recommande un manifeste qui enregistre au moins :
application code revision
model provider + model/revision + serving configuration
system and task prompts
response schema + decoding parameters
retrieval corpus snapshot + parser + chunker + embedding model + index
tool definitions + implementation revisions + permission policy
routing, fallback, caching, and budget policy
safety and business-rule revisions
evaluation dataset + scorer revisions
La liste exacte dépend du système. La règle est d’identifier chaque composant qui change indépendamment et peut modifier le comportement visible par l’utilisateur.
Considérez le nom d’un modèle de fournisseur comme modifiable, sauf si le fournisseur documente une révision immuable. Un hash de checkpoint aide à identifier des poids auto-hébergés, mais j’enregistrerais quand même le runtime, la quantification, le chat template et la configuration du parallélisme. L’entrée du modèle vient d’un registre : utilisez MLflow Model Registry pour les poids et adaptateurs que vous entraînez, et le Hugging Face Hub pour les poids ouverts, épinglés à un commit avec l’argument revision plutôt qu’un nom de branche.
Stockez le manifeste dans un fichier à côté de chaque release. Quand une release régresse, comparez-la à la précédente avec un diff. Dans cet exemple d’assistant de support, seuls le prompt de réponse et le snapshot de retrieval ont changé :
-    answer: prompts/answer.md@v9
+    answer: prompts/answer.md@v10
-    corpus: kb-snapshot-2026-09-28
-    index: kb-idx-2026-09-28-01
+    corpus: kb-snapshot-2026-10-01
+    index: kb-idx-2026-10-01-01
Le diff désigne les composants à vérifier en premier : le prompt de réponse et le nouvel index. Les poids, les outils et le routage n’ont pas changé.
Quel composant inspecter en premier
Le diff du manifeste dit ce qui a changé. Le type d’échec indique où regarder quand le diff seul n’explique pas le problème :
| Échec | Premier composant à inspecter |
|---|---|
| Faits actuels ou privés manquants | retrieval et synchronisation des sources |
| Mauvais format ou arguments invalides | schéma, sortie contrainte, validation |
| Comportement incohérent sur la tâche | prompt, exemples, choix du modèle, puis données d’adaptation |
| Latence ou coût excessifs | route, contexte, cache, batching, quantification |
| Action non autorisée ou dangereuse | permissions des outils et politique déterministe |
| Comportement métier non récupérable du contexte | fine-tuning ou un autre modèle spécialisé |
Pour choisir entre modifier le prompt, ajouter du retrieval et faire du fine-tuning, voir fine-tuning vs RAG vs prompting.
Cinq composants qui peuvent changer le comportement
Les sections suivantes reprennent dans l’ordre cinq composants du diagramme du manifeste : le modèle et son serving, puis les prompts et le schéma, le corpus et l’index de retrieval, les outils et les permissions, enfin les règles de sécurité et les règles métier. Chaque section dit quoi enregistrer, quoi tester et quels outils font le travail. Le routage et le fallback ont leur propre section avec la gateway.
1. Modèle et serving
La première décision est de savoir si un fournisseur héberge le modèle ou si vous le servez vous-même. Une API hébergée supprime le travail sur les GPU. Chaque requête traverse le réseau, vous payez par token, les données que vous envoyez quittent votre réseau, et le fournisseur contrôle les poids, les révisions, les quotas et le prix. L’auto-hébergement vous donne la maîtrise de la révision, de la quantification, du batching, de la région et du cache. Vous gérez aussi la capacité GPU, et vous la payez qu’elle soit occupée ou inactive.
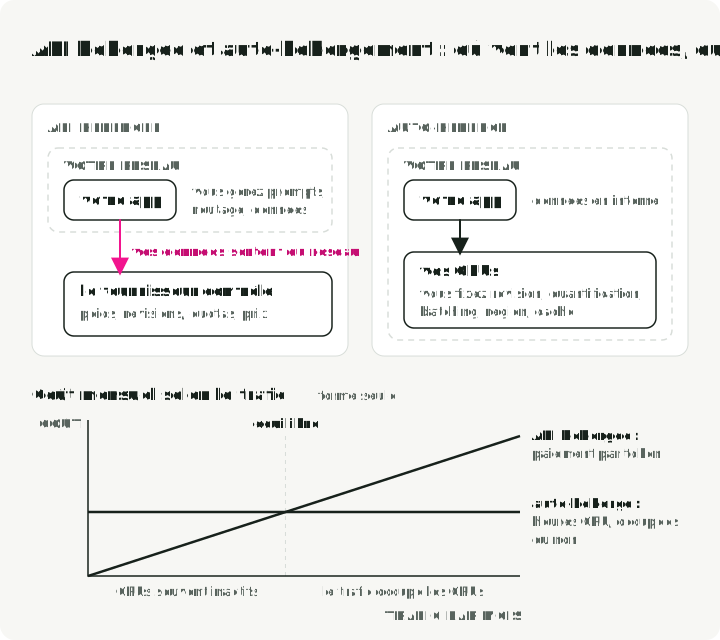
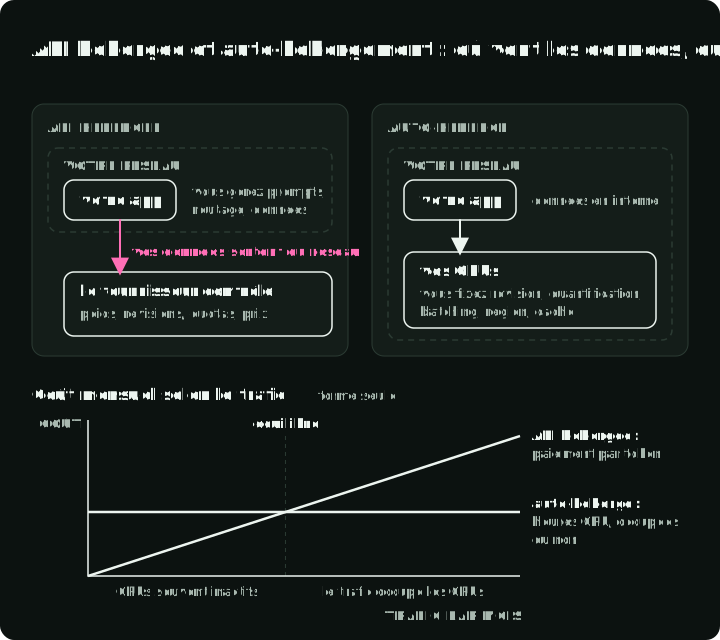
Le haut du diagramme montre où vont les données et qui contrôle quoi dans chaque mode. Le graphique en dessous montre comment le coût de chaque mode évolue avec le trafic. Les courbes se croisent au trafic d’équilibre, où la facture mensuelle des GPUs égale la facture d’API pour les mêmes tokens. Dans les deux modes, le manifeste enregistre la route et la même suite de tâches s’exécute.
Pour trouver le point d’équilibre, divisez le coût mensuel des GPUs par le prix de l’API par token. Un exemple avec les prix catalogue au 7 octobre 2026 pour Llama 3.3 70B :
- Together AI facture 1,04 $ par million de tokens, en entrée comme en sortie.
- En FP8, les 70 milliards de poids occupent environ 70 Go, donc le modèle tient sur deux GPUs H100 de 80 Go avec de la place pour le KV cache. Lambda loue une instance H100 SXM à deux GPUs à 4,19 $ par GPU et par heure.
- Deux GPUs pendant 730 heures (un mois) coûtent 2 × 730 × 4,19 $ = 6 117 $.
- 6 117 $ ÷ 1,04 $ par million de tokens = environ 5,9 milliards de tokens par mois, soit environ 2 240 tokens par seconde, à chaque seconde du mois.
En dessous de ce trafic, l’API coûte moins cher. Au-dessus, l’auto-hébergement coûte moins cher seulement si les deux GPUs peuvent servir ce débit : mesurez donc d’abord le débit avec vos propres prompts. L’exemple ne compte que la location des GPUs. Le temps d’ingénierie, un deuxième réplica pour la disponibilité et le stockage reculent le point d’équilibre vers un trafic plus élevé.
Si vous auto-hébergez, choisissez le moteur de serving selon la forme du déploiement :
| Option | À utiliser quand |
|---|---|
| vLLM | Vous servez des modèles à poids ouverts sur vos propres GPUs et avez besoin de débit. Il fournit le continuous batching, des poids quantifiés, de nombreux adaptateurs fine-tunés sur un seul modèle de base (voir la section LoRA plus bas) et un serveur compatible OpenAI. |
| Ollama | Vous exécutez des modèles sur un portable pour le développement et les tests en local. |
| NVIDIA Dynamo-Triton avec le backend TensorRT-LLM | Vous utilisez des GPUs NVIDIA et voulez des moteurs compilés pour ce matériel, ou un seul serveur pour des modèles LLM et non LLM. Il s’appelait Triton Inference Server avant 2025. |
| Plateformes GPU serverless comme Modal | Le trafic est irrégulier. Les conteneurs peuvent descendre à zéro ; la requête suivante attend alors un démarrage à froid. Les conteneurs chauds réutilisent les modèles et les caches chargés. Conservez l’état durable des requêtes dans un stockage persistant. |
Les modèles trop gros pour un seul GPU demandent du parallélisme tensoriel ou en pipeline au moment du serving ; Passage à l’échelle des LLMs avec plusieurs GPUs et nœuds explique chaque méthode. Pour choisir un format de poids adapté au runtime et au matériel, voir Formats de quantification des LLMs.
Dans les deux modes, incluez la latence, les erreurs, le débit, la saturation, le coût et les contrôles de qualité de la tâche dans la décision de release.
2. Prompts et schéma
Pour un système qui assemble les requêtes à l’exécution, versionnez la requête assemblée plutôt que le seul texte du prompt : l’ordre des messages, les descriptions des outils, le schéma de réponse, le décodage, les nouvelles tentatives, la troncature et le code environnant peuvent chacun changer le comportement.
Une petite modification du prompt peut changer le format de sortie. Voici trois versions d’un prompt d’analyse de sentiment :
v1: "Classify this text as positive or negative: {text}"
v2: "You are a sentiment analyzer. Classify: {text}"
v3: "Analyze sentiment. Return only 'positive' or 'negative': {text}"
v1 et v2 peuvent renvoyer une phrase comme « The sentiment is positive. » v3 demande un seul mot. Le code qui analyse la réponse doit changer avec le prompt : le prompt, le schéma et le parseur entrent donc ensemble dans le manifeste.
Traitez un JSON analysable comme un contrôle de transport, puis testez séparément les invariants métier de la tâche.
3. Corpus et index de retrieval
Le retrieval ajoute un produit de données indépendant entre la source de vérité et le modèle :
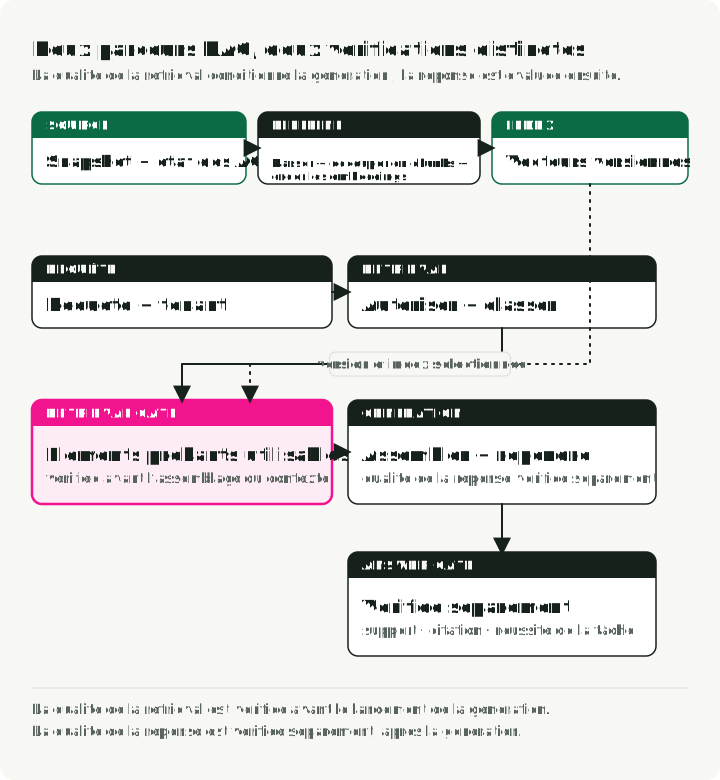
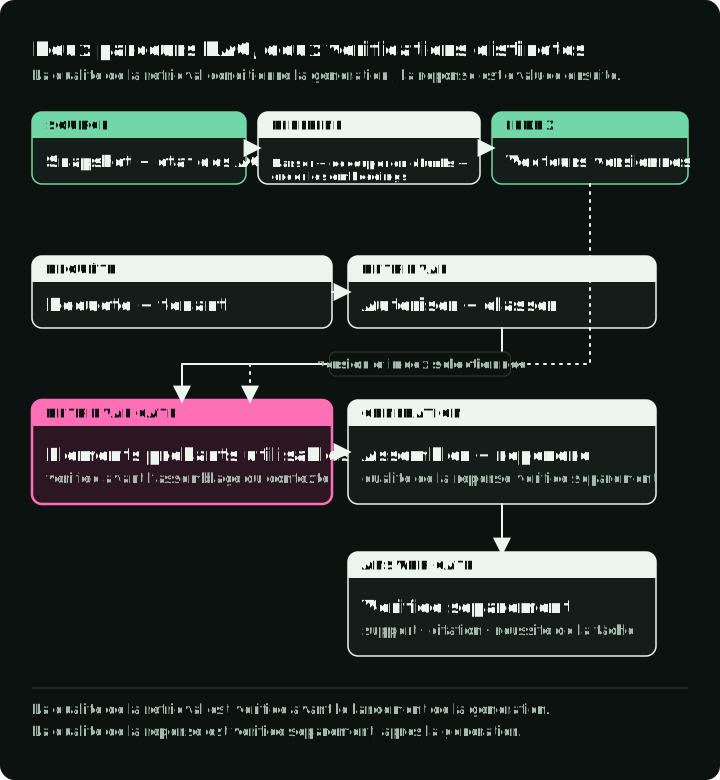
La ligne du haut est construite avant les requêtes, et chaque étape enregistre une version. La ligne du bas suit une requête, et les repères numérotés montrent les trois tests distincts : l’autorisation, les preuves récupérées et la réponse.
Pour un système à retrieval augmenté, conservez la révision de la source, les versions du parseur et du chunker, l’identité de l’embedding, le build de l’index, les métadonnées de contrôle d’accès et l’état des suppressions. La conception d’origine du RAG sépare le retrieval de la génération ; servez-vous de cette séparation pour tester indépendamment la récupération des preuves, le filtrage des autorisations et l’usage des preuves. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks décrit l’architecture « récupérer puis générer ». Métriques d’évaluation RAG présente les métriques de chaque contrôle, et Outils d’évaluation RAG compare les bibliothèques qui les calculent.
Choisissez le stockage de l’index selon qui l’utilise. Une bibliothèque en processus comme FAISS suffit quand un seul service possède l’index et qu’il tient dans la mémoire de ce service. Utilisez un serveur de base de données vectorielle comme Pinecone, Weaviate ou Milvus quand plusieurs services partagent l’index, quand vous avez besoin de filtres sur les métadonnées au moment de la requête, ou quand l’index dépasse une machine. Pour la conception du retrieval elle-même (une passe, recherche itérative ou GraphRAG), voir Architecture RAG.
Choisissez la méthode de mise à jour selon l’ancienneté acceptable d’une réponse. Une reconstruction planifiée convient quand une réponse vieille d’un jour est acceptable. Quand un changement doit apparaître en quelques minutes, diffusez les mises à jour en flux, par exemple des événements Kafka vers un job d’embedding qui écrit dans l’index. Pour un instantané immuable, enregistrez quel build de l’index a servi chaque réponse. Pour un index modifiable, tracez aussi la révision d’ingestion ou l’indicateur de progression (watermark) visible par la requête, si disponible, ainsi que les révisions des documents récupérés pour chaque requête. Les numéros de séquence du journal dans les réponses aux requêtes de Pinecone montrent pourquoi un accusé de réception d’écriture ne permet pas à lui seul d’identifier ce qu’une requête a vu. Conservez des instantanés immuables ou un historique des sources rejouable si une reproduction exacte des données est nécessaire ; un watermark seul ne permet pas de récupérer un contenu écrasé.
N’utilisez pas un index vectoriel à la place d’un feature store ou d’un entrepôt de données : la recherche par similarité, les features à un instant donné et les faits analytiques ont des besoins de requête et de cohérence différents.
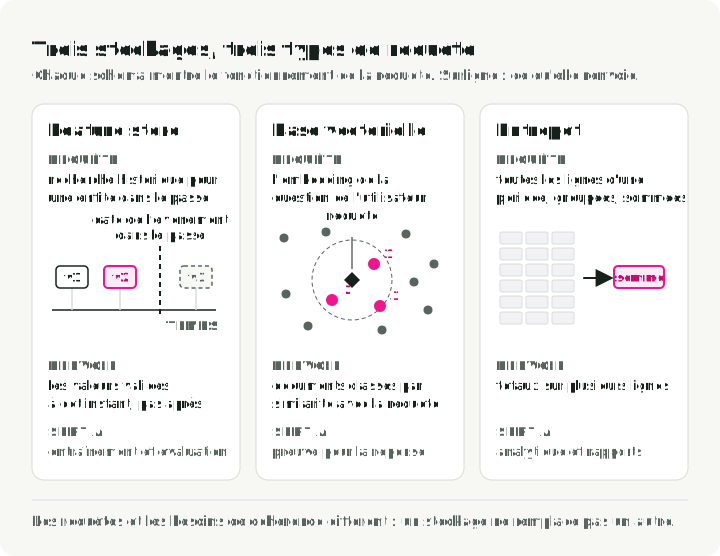
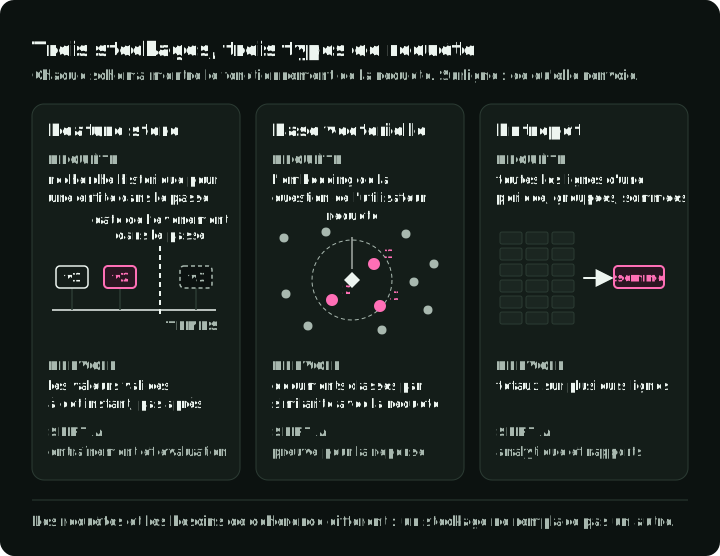
Les trois cartes comparent une recherche historique de features, la recherche par similarité et l’agrégation. La recherche historique renvoie les valeurs valides à la date passée de l’événement, une base de données vectorielle classe les documents par similarité avec la requête, et un entrepôt de données renvoie des totaux sur de nombreuses lignes. Gardez l’entrepôt de données pour l’analytique.
Dans Feast, les jointures historiques construisent les données d’entraînement et d’évaluation pour des dates d’événement passées. Son stockage en ligne sert les dernières valeurs de features matérialisées par entité avec une faible latence.
4. Outils et permissions
Quand un modèle peut appeler des APIs, placez ces contrôles autour de chaque tool call : authentification de l’outil, moindre privilège, validation des arguments, timeouts, idempotence, politique d’approbation et vérification des postconditions. Le Generative AI Profile du NIST recense les risques liés aux contenus nuisibles, à la vie privée et à la sécurité.
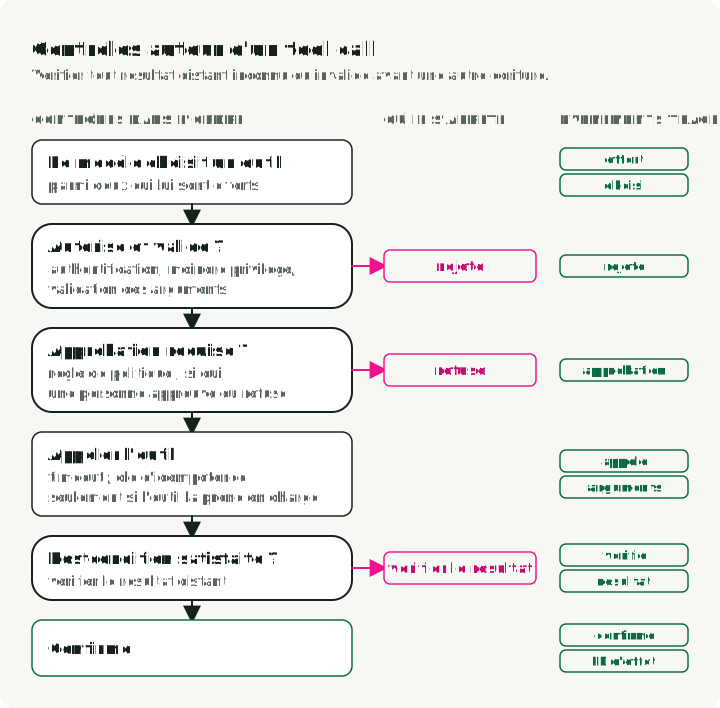
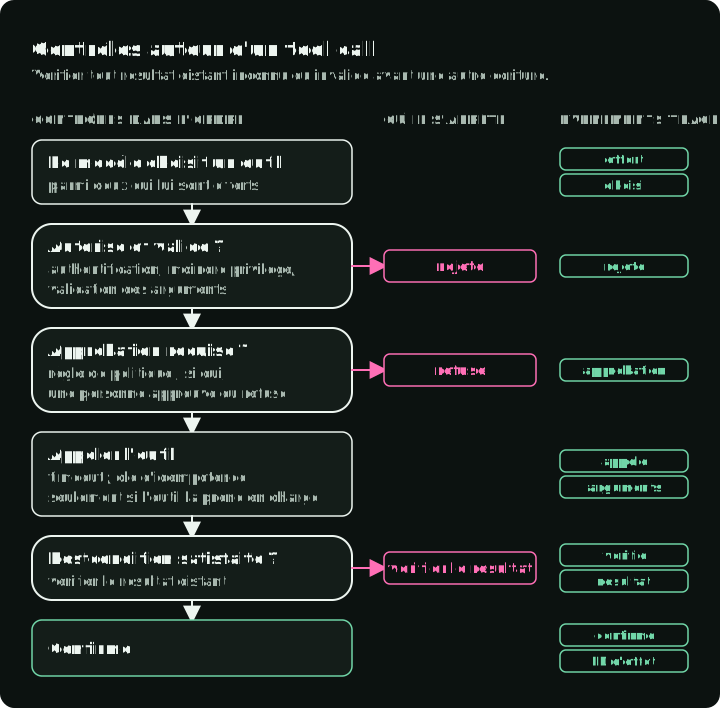
Le diagramme montre ces contrôles dans l’ordre, l’endroit où un appel s’arrête (une permission ou un argument rejeté, une approbation refusée, ou un résultat qui ne correspond pas à la postcondition attendue), et l’événement de trace que chaque étape enregistre.
Un timeout peut laisser le résultat d’une écriture inconnu même après sa validation par le service distant. Vérifiez le résultat avant une autre écriture : consultez l’opération ou la ressource, ou utilisez une répétition idempotente documentée. Ne réessayez que dans le cadre d’un contrat d’idempotence pris en charge ou d’une autre méthode de récupération dont la sécurité est vérifiée ; AWS explique la prise en charge nécessaire côté serveur. Une clé réutilisée peut renvoyer l’échec d’origine, comme le documente le contrat d’idempotence de Stripe. Utilisez une action de compensation prise en charge si elle existe et soumettez les résultats non résolus à une revue.
Tracez quel outil a été proposé, choisi, appelé, rejeté, relancé, vérifié et confirmé. Une réponse finale fluide ne prouve pas que le chemin d’action était correct.
5. Règles de sécurité et règles métier
Les filtres de contenu sont un contrôle parmi d’autres, pas une couche de garde-fous complète. Les menaces incluent aussi la prompt injection, le retrieval entre tenants, la divulgation de secrets, l’excès d’agentivité (une entrée de l’OWASP Top 10 for LLM Applications), les fichiers de modèle non fiables ou le code personnalisé chargé à l’exécution, et les arguments d’outil dangereux.
Exprimez les règles métier déterministes en dehors du modèle quand c’est possible. Définissez les risques résiduels, testez les cas adverses et désignez un responsable des changements de politique. Le Generative AI Profile du NIST est un inventaire de risques utile, pas un test d’acceptation clé en main.
L’évaluation décide de la release
Pour les décisions de release sur une sortie libre, ne vous appuyez pas sur un seul chiffre d’exactitude agrégé. Utilisez plusieurs types de preuves et définissez laquelle fait autorité pour chaque mode d’échec.
Une pile d’évaluation pour un système à base de modèle de fondation comporte six couches :
- Contrôles déterministes : validité du schéma, citations présentes, outils autorisés, contraintes sur les arguments, règles de politique, latence et budget.
- Métriques par composant : rappel et classement du retrieval, exactitude du choix d’outil, exactitude des arguments d’outil et sélection de la route.
- Tâches de bout en bout : des entrées représentatives avec des critères de succès explicites et des étiquettes de tranche.
- Notation par modèle : des jugements guidés par une grille, calibrés sur des étiquettes d’experts et surveillés pour détecter la dérive du juge.
- Revue humaine : les cas ambigus, à fort enjeu, nouveaux ou échantillonnés pour lesquels l’automatisation ne fait pas autorité.
- Tests adverses : cas d’injection, de frontière des données, d’abus, de refus et d’effets de bord liés au modèle de menace.
Stockez les résultats par exemple, pas seulement les moyennes, pour que la revue de release puisse inspecter les régressions par langue, tenant, type de document ou classe d’action.
Pour une décision de déploiement, comparez un manifeste candidat à la release actuelle sur la même suite versionnée. Fixez ensemble des seuils de qualité, de sécurité, de latence et de coût, et rejetez une route moins chère qui échoue à la suite de tâches.
Si chaque résultat respecte son seuil, lancez un déploiement progressif. Si l’un échoue, rejetez le candidat. Si le résultat d’une tranche n’est pas clair, envoyez-le en revue humaine.
Pour choisir un outil d’évaluation des traces, des datasets et des contrôles CI, voir Outils d’évaluation des agents AI.
Les traces relient la production à l’évaluation
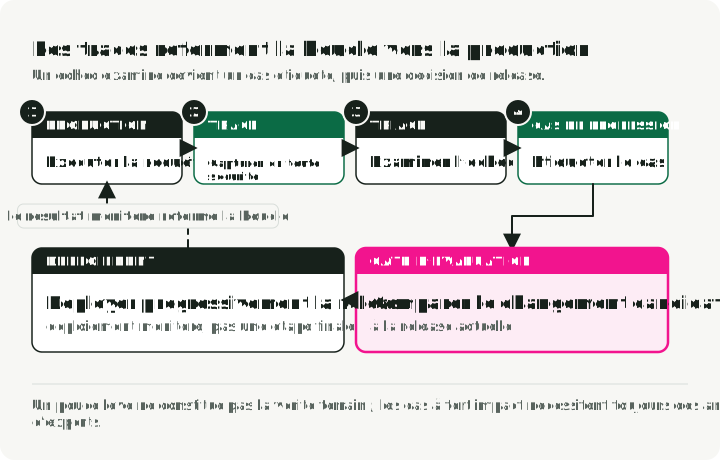
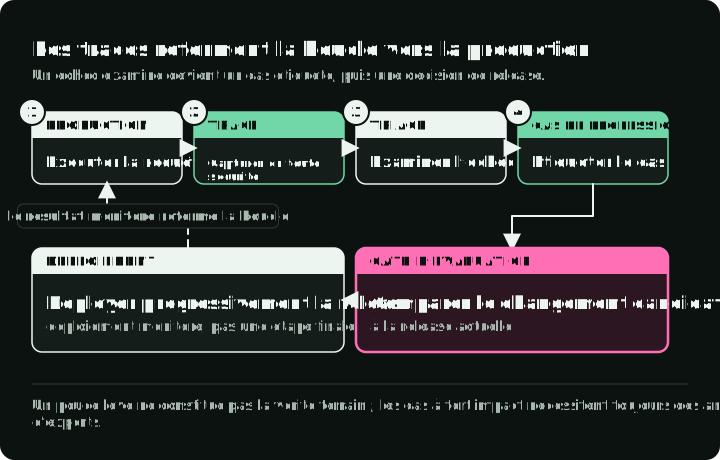
Le haut du diagramme est la trace d’une requête. Les métriques voient l’appel lent au modèle ; seule la trace montre le document non autorisé et le mauvais compte. La ligne du bas montre la suite : l’échec revu devient un cas de régression étiqueté, l’évaluation compare un changement candidat à la release actuelle, et l’arête en pointillés ramène la release progressive vers la production.
Les métriques d’infrastructure peuvent montrer un appel de modèle lent. Elles ne peuvent pas montrer que le retrieval a renvoyé un document non autorisé ou qu’un outil a été appelé avec le mauvais compte. La documentation de tracing de MLflow décrit des traces qui capturent les étapes intermédiaires et les métadonnées nécessaires pour inspecter ce chemin.
Capturez une trace sur tout le chemin de décision :
- l’identité du manifeste de release et la corrélation des requêtes
- les appels au modèle et au fournisseur, la latence, la consommation et l’état de fin
- la requête de retrieval, la révision de l’index ou le watermark visible par la requête, les identifiants et révisions des documents, les scores et les décisions de filtrage
- la révision du prompt ou du template, sans stocker sans discernement le contenu sensible
- les outils proposés, les arguments, les approbations, les résultats et les identifiants d’effets de bord
- les décisions de politique, les nouvelles tentatives, les fallbacks et le résultat final
Les traces sont un nouveau stock de données sensibles. Appliquez minimisation, masquage, isolation des tenants, chiffrement, échantillonnage, rétention et revue des accès avant de collecter des prompts ou des documents complets. Les conventions sémantiques GenAI d’OpenTelemetry peuvent aider à l’interopérabilité, mais elles restent en développement. Épinglez la version de la convention ou du schéma, de l’instrumentation et des collecteurs.
Le retour des utilisateurs peut orienter les priorités d’investigation, mais un pouce levé n’est pas une vérité de terrain. Conservez la trace environnante et obtenez des étiquettes d’experts pour les cas à fort enjeu. Label Studio collecte des étiquettes pour du texte, des images et d’autres types de données ; Argilla collecte des retours sur le texte et les sorties de LLMs et peut pousser les datasets vers le Hugging Face Hub. Évaluation des agents AI en production montre comment transformer des traces étiquetées en suite de régression versionnée.
La gateway de serving gère le routage et la politique
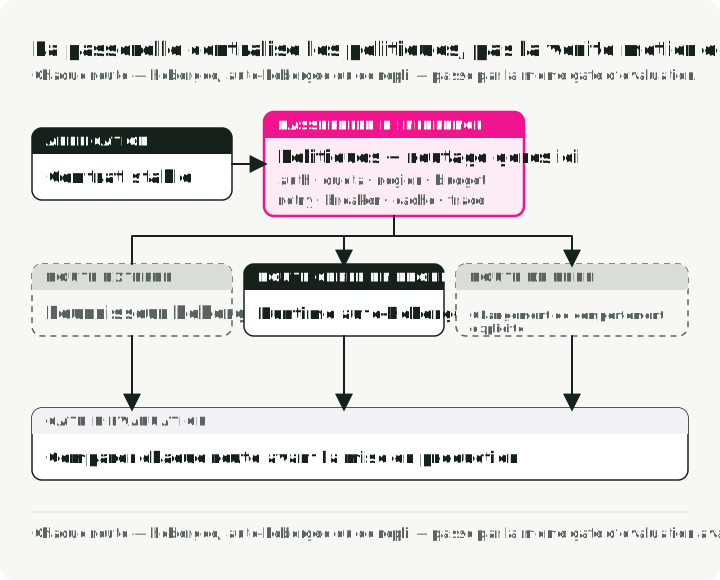
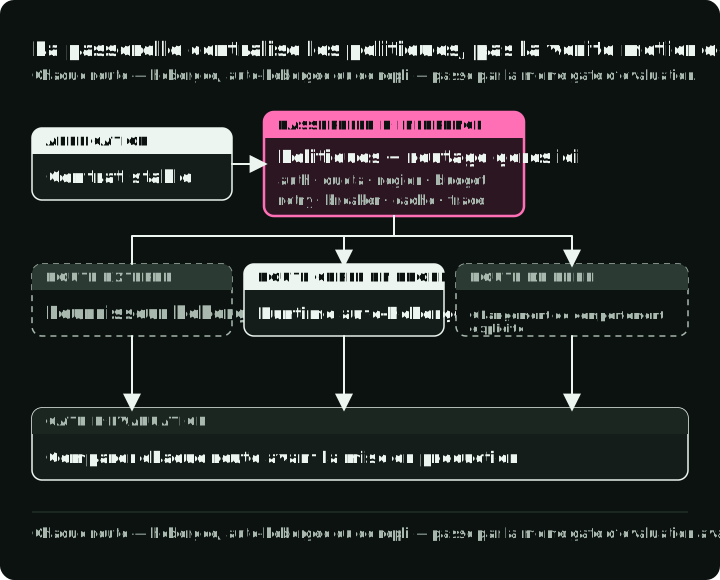
Dans le diagramme, chaque requête emprunte une route à travers la gateway : selon l’offre, selon une petite part du trafic pour un nouveau modèle, ou vers une route de repli quand le fournisseur tombe en panne. Chaque route renvoie le même contrat de réponse, et la suite de tâches évalue chaque route hors ligne avant la promotion.
Une gateway peut découpler les clients de l’application des fournisseurs ou des moteurs auto-hébergés. Voici les responsabilités qu’il vaut la peine d’y placer :
- l’authentification, les budgets par tenant, les quotas et les limites de débit
- des contrats de requête et de réponse stables
- la sélection de la route selon la capacité, la région, la latence ou la qualité évaluée
- le routage par niveau d’abonnement, par exemple un modèle plus grand pour les forfaits payants
- l’envoi d’une petite part du trafic vers un nouveau modèle avant le déploiement complet
- des nouvelles tentatives bornées, des circuit breakers et une sémantique de fallback explicite
- le partitionnement du cache et la politique pour les données sensibles
- l’attribution de l’usage et la propagation du manifeste de release
LiteLLM Proxy est une gateway open source : elle expose de nombreux fournisseurs via une seule API compatible OpenAI et fixe des budgets et des limites de débit par clé ou par équipe.
Le fallback est autant un changement de comportement qu’un mécanisme de fiabilité. Si un modèle plus petit, un autre fournisseur ou un contexte réduit change la qualité de la tâche, évaluez et tracez cette branche comme sa propre route.
Ne mettez pas toutes les décisions d’orchestration dans la gateway. Gardez les règles métier proches de l’application et rendez les responsabilités visibles.
Fine-tuning et LoRA
La dernière ligne du tableau des échecs dans « Quel composant inspecter en premier » est le cas du fine-tuning : le comportement attendu de la tâche ne peut pas être obtenu à partir du prompt ni du contexte récupéré. LoRA gèle les poids pré-entraînés et ajoute des matrices de faible rang entraînables, ce qui réduit le nombre de paramètres entraînables pour la tâche cible. Cette optimisation ne supprime pas les exigences de gouvernance des datasets, de licence du modèle de base, d’évaluation, de compatibilité de serving et de rollback.
Enregistrez les paramètres de l’adaptateur dans le manifeste à côté de la révision du modèle de base : le rang (r), le facteur d’échelle (lora_alpha) et les couches qu’il modifie (target_modules). Chacun change ce que l’adaptateur apprend. Le Guide de fine-tuning des LLMs couvre les datasets, QLoRA et les outils d’entraînement, et le Guide de serving LoRAX couvre le serving de nombreux adaptateurs sur un seul modèle de base.
Une séquence d’adoption pratique
- Définissez la tâche utilisateur, les limites de nocivité, les objectifs de service et l’enveloppe de coûts.
- Créez le manifeste de release avant d’introduire un registre de prompts, une base de données vectorielle ou un produit de gateway.
- Construisez un petit jeu d’évaluation découpé en tranches, et des tests déterministes par composant.
- Instrumentez une trace de bout en bout avec des contrôles de vie privée et des identités de release stables.
- Promouvez par shadow, canary ou trafic limité avec un déclencheur de rollback explicite.
- Transformez les échecs de production revus en cas de régression et recommencez.
N’ajoutez de l’infrastructure que si elle fait un travail que le manifeste nomme ou supprime un goulot d’étranglement mesuré.
Références
- MLflow: evaluating production traces - Réutiliser les traces de production pour l’évaluation et noter les informations intermédiaires des traces.
- MLflow: LLM and agent tracing - Capturer les étapes intermédiaires et les métadonnées des traces pour l’investigation.
- OpenTelemetry GenAI semantic conventions - Conventions actuelles, en statut de développement, pour les spans, métriques, événements et données propres aux fournisseurs GenAI.
- NIST AI 600-1: Generative AI Profile - Catégories de risques pour la prompt injection, la vie privée, la sécurité et les préoccupations connexes de l’IA générative.
- OWASP Top 10 for LLM Applications - Inclut l’excès d’agentivité (LLM06:2025) et la prompt injection (LLM01:2025).
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks - Architecture d’origine « récupérer puis générer ».
- LoRA: Low-Rank Adaptation of Large Language Models - Poids pré-entraînés gelés plus matrices de faible rang entraînables pour l’adaptation à une tâche cible.
- PEFT LoRA reference - Paramètres de
LoraConfigetget_peft_model. - vLLM documentation - Moteur de serving avec continuous batching, quantification, multi-LoRA et serveur compatible OpenAI.
- NVIDIA Dynamo-Triton - Serveur d’inférence anciennement nommé Triton Inference Server, avec un backend TensorRT-LLM.
- LiteLLM Proxy - Gateway open source avec une API unique pour tous les fournisseurs, des budgets, des limites de débit et des fallbacks.