MLOps a LLMOps: infrastruktura dla modeli foundation

Tłumaczenie automatyczne
Ten artykuł został automatycznie przetłumaczony z angielskiego oryginału.
Ten artykuł jest dla inżynierów ML i inżynierów platformowych, którzy już prowadzą MLOps, a teraz obsługują system zbudowany na modelu foundation. W takim systemie regresja może wynikać ze zmian w treści prompt, indeksie, uprawnieniu narzędzia albo trasie, podczas gdy wagi modelu zostają te same. Artykuł opisuje, które praktyki MLOps nadal obowiązują, co jeszcze trzeba wersjonować, gdy treści typu prompt, wyszukiwanie, narzędzia i routing mogą zmienić zachowanie, jak ewaluować i śledzić taki system oraz które narzędzia wykonują poszczególne zadania.
Co MLOps już rozwiązało
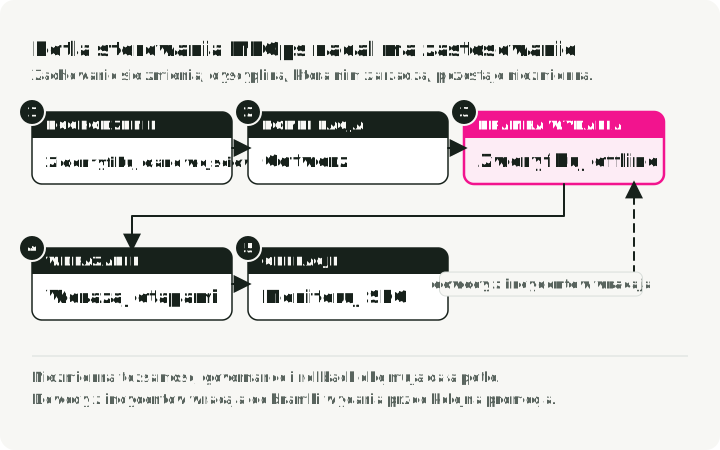
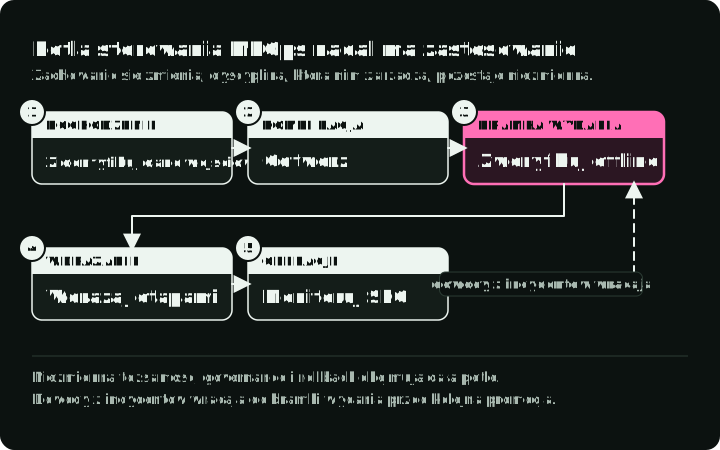
Każdy wiersz diagramu to jeden krok pętli MLOps: co MLOps już tam robi i co dodaje system oparty na modelu foundation. Przerywana krawędź wraca do kontroli offline z przejrzanymi awariami produkcyjnymi jako testami. MLOps ustanowiło te praktyki i nadal obowiązują one, gdy model generuje tekst:
- pochodzenie (lineage) od danych, kodu, konfiguracji i modelu do wydania
- powtarzalne pipeline’y trenowania lub budowania
- walidacja offline przed promocją
- rejestry i niezmienna tożsamość artefaktów
- wdrażanie etapowe, cele poziomu usług, rollback i reagowanie na incydenty
- telemetria infrastruktury i planowanie pojemności
- kontrola dostępu, retencja i polityka audytu danych
Większość narzędzi orkiestracji, które już uruchamiasz, nadal pasuje, ale nie na każdej ścieżce:
| Zadanie | Narzędzie | Kiedy używać |
|---|---|---|
| Fine-tuning wsadowy, zaplanowane przebudowy indeksu, uruchomienia ewaluacji | Airflow, Kubeflow Pipelines | Już ich używasz w MLOps, a zadanie działa według harmonogramu lub wyzwalacza. |
| Przepływy natywne dla Pythona | Metaflow, Flyte, ZenML | Zespół pisze pipeline’y w Pythonie i chce kroków, które wywołują biblioteki ML bezpośrednio. |
| Ścieżka żądania: wyszukaj, wywołaj model, wywołaj narzędzia | Kod aplikacji | Krok wykonuje się raz na żądanie i musi odpowiedzieć w ciągu sekund. Harmonogramy przepływów są zbudowane do zadań wsadowych. |
Modele foundation nie usuwają tych potrzeb. Sprawiają, że dawne określenie „wersja modelu” jest za wąskie.
Jednostka wydania stała się manifestem systemu
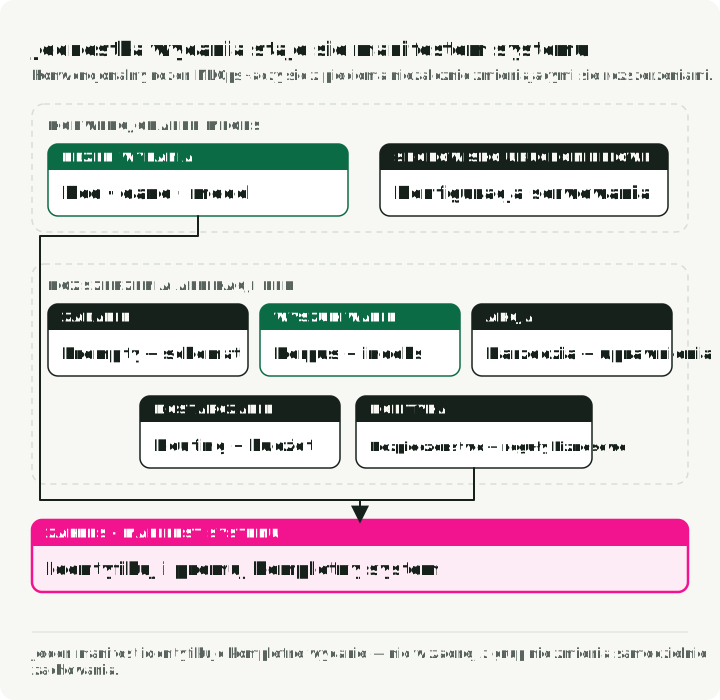
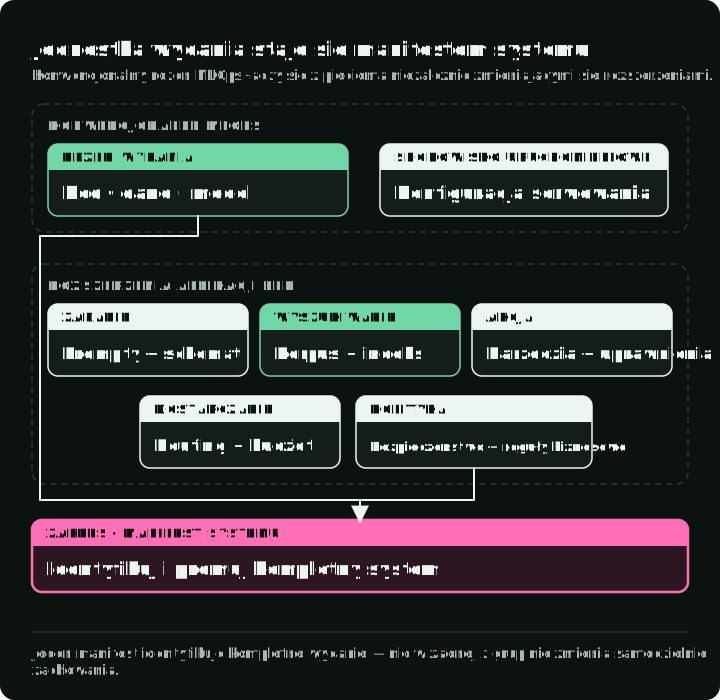
Diagram pokazuje manifest asystenta wsparcia w dwóch wydaniach. Górne wiersze to to, co MLOps już wersjonuje, dolne wiersze to to, co dodaje system oparty na modelu foundation, a wyróżnione wiersze to jedyne wpisy, które się zmieniły.
Dla systemu opartego na modelu foundation polecam manifest, który zapisuje co najmniej:
application code revision
model provider + model/revision + serving configuration
system and task prompts
response schema + decoding parameters
retrieval corpus snapshot + parser + chunker + embedding model + index
tool definitions + implementation revisions + permission policy
routing, fallback, caching, and budget policy
safety and business-rule revisions
evaluation dataset + scorer revisions
Dokładna lista zależy od systemu. Zasada brzmi: zidentyfikuj każdy niezależnie zmieniający się komponent, który może zmienić zachowanie widoczne dla użytkownika.
Nazwę modelu u dostawcy traktuj jako zmienną, chyba że dostawca dokumentuje niezmienną rewizję. Hash pliku checkpoint pomaga zidentyfikować samodzielnie hostowane wagi, ale i tak zapisałbym środowisko uruchomieniowe, kwantyzację, szablon czatu i konfigurację równoległości. Wpis o modelu pochodzi z rejestru: użyj MLflow Model Registry dla wag i adapterów, które trenujesz, oraz Hugging Face Hub dla otwartych wag, przypiętych do commita argumentem revision, a nie do nazwy gałęzi.
Przechowuj manifest jako plik obok każdego wydania. Gdy wydanie powoduje regresję, porównaj go z poprzednim. W tym przykładzie asystenta wsparcia zmieniły się tylko prompt odpowiedzi i migawka wyszukiwania:
-    answer: prompts/answer.md@v9
+    answer: prompts/answer.md@v10
-    corpus: kb-snapshot-2026-09-28
-    index: kb-idx-2026-09-28-01
+    corpus: kb-snapshot-2026-10-01
+    index: kb-idx-2026-10-01-01
Diff wskazuje komponenty do sprawdzenia w pierwszej kolejności: prompt odpowiedzi i nowy indeks. Wagi, narzędzia i routing się nie zmieniły.
Który komponent sprawdzić najpierw
Diff manifestu mówi, co się zmieniło. Rodzaj awarii podpowiada, gdzie szukać, gdy sam diff nie wyjaśnia problemu:
| Awaria | Pierwszy komponent do sprawdzenia |
|---|---|
| Brak aktualnych lub prywatnych faktów | wyszukiwanie i synchronizacja źródeł |
| Zły format lub nieprawidłowe argumenty | schemat, ograniczone dane wyjściowe, walidacja |
| Niespójne zachowanie w zadaniu | prompt, przykłady, wybór modelu, a potem dane do adaptacji |
| Nadmierne opóźnienie lub koszt | trasa, kontekst, cache, batching, kwantyzacja |
| Nieautoryzowane lub niebezpieczne działanie | uprawnienia narzędzi i deterministyczna polityka |
| Zachowanie domenowe niemożliwe do odtworzenia z kontekstu | fine-tuning lub inny wyspecjalizowany model |
Wybór między zmianą treści prompt, dodaniem wyszukiwania i zastosowaniem fine-tuning opisuje fine-tuning vs RAG vs prompting.
Pięć komponentów, które mogą zmienić zachowanie
Poniższe sekcje omawiają po kolei pięć komponentów z diagramu manifestu: model i jego serwowanie, potem teksty typu prompt i schemat, korpus wyszukiwania i indeks, narzędzia i uprawnienia oraz reguły bezpieczeństwa i biznesowe. Każda sekcja mówi, co zapisywać, co testować i które narzędzia wykonują to zadanie. Routing i fallback mają własną sekcję razem z gatewayem.
1. Model i serwowanie
Pierwsza decyzja: czy model hostuje dostawca, czy serwujesz go sam. Hostowane API zdejmuje z ciebie pracę z GPU. Każde żądanie przechodzi przez sieć, płacisz za token, dane, które wysyłasz, opuszczają twoją sieć, a dostawca kontroluje wagi, rewizje, limity i cenę. Samodzielne hostowanie daje kontrolę nad rewizją, kwantyzacją, batchingiem, regionem i cache. Jednocześnie sam odpowiadasz za moc GPU i płacisz za nią niezależnie od tego, czy jest zajęta, czy bezczynna.
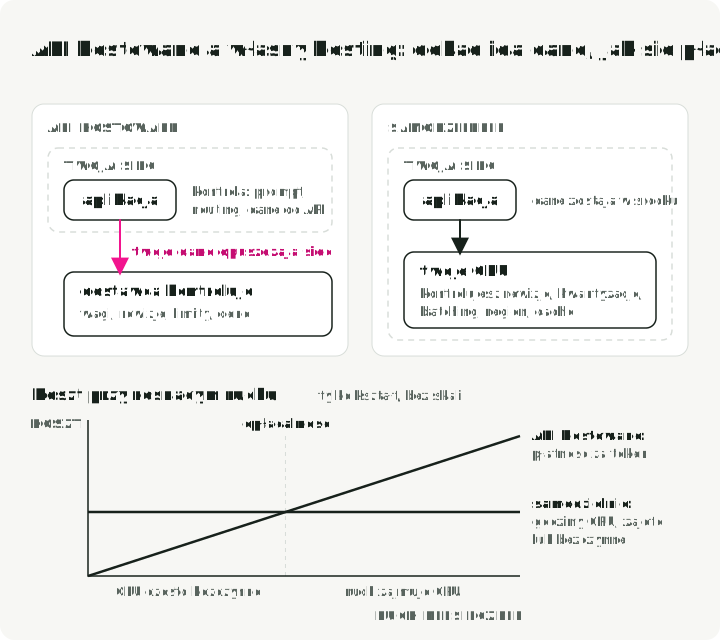
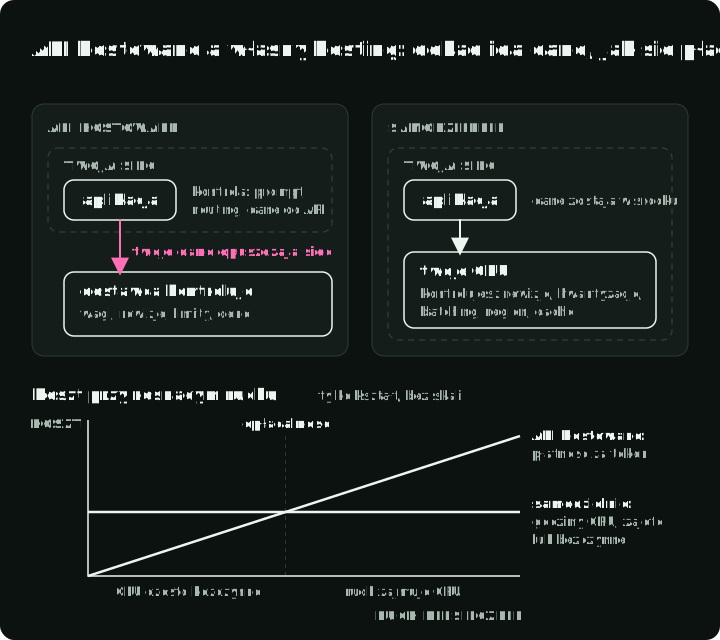
Górna część diagramu pokazuje, dokąd trafiają dane i kto co kontroluje w każdym trybie. Wykres poniżej pokazuje, jak koszt każdego trybu rośnie wraz z ruchem. Linie przecinają się przy ruchu opłacalności, gdy miesięczny rachunek za GPU równa się rachunkowi za API przy tej samej liczbie jednostek token. W obu trybach manifest zapisuje trasę i uruchamiany jest ten sam zestaw zadań.
Aby znaleźć punkt opłacalności, podziel miesięczny koszt GPU przez cenę API za token. Przykład z cenami katalogowymi z 7 października 2026 dla Llama 3.3 70B:
- Together AI pobiera $1.04 za milion jednostek token, wejściowych lub wyjściowych.
- W FP8 70 miliardów wag zajmuje około 70 GB, więc model mieści się na dwóch GPU H100 po 80 GB z zapasem na KV cache. Lambda wynajmuje instancję z dwoma H100 SXM po $4.19 za GPU za godzinę.
- Dwa GPU przez 730 godzin (jeden miesiąc) kosztują 2 × 730 × $4.19 = $6,117.
- $6,117 ÷ $1.04 za milion jednostek token = około 5,9 miliarda jednostek token miesięcznie, czyli około 2240 jednostek token na sekundę, w każdej sekundzie miesiąca.
Poniżej tego ruchu taniej wychodzi API. Powyżej samodzielne hostowanie jest tańsze tylko wtedy, gdy dwa GPU są w stanie obsłużyć taką przepustowość, więc najpierw zmierz ją używając własnych treści typu prompt. Przykład uwzględnia wyłącznie wynajem GPU. Czas inżynierów, druga replika dla dostępności i przechowywanie danych przesuwają punkt opłacalności wyżej.
Jeśli hostujesz samodzielnie, wybierz silnik serwowania według sposobu wdrożenia:
| Opcja | Kiedy używać |
|---|---|
| vLLM | Serwujesz modele z otwartymi wagami na własnych GPU i potrzebujesz przepustowości. Zapewnia ciągły batching, skwantyzowane wagi, wiele dostrojonych adapterów na jednym modelu bazowym (zobacz sekcję o LoRA poniżej) i serwer zgodny z OpenAI. |
| Ollama | Uruchamiasz modele na laptopie do lokalnego tworzenia oprogramowania i testów. |
| NVIDIA Dynamo-Triton z backendem TensorRT-LLM | Używasz GPU NVIDIA i chcesz silników skompilowanych pod ten sprzęt albo jednego serwera dla modeli LLM i innych. Przed 2025 rokiem nazywał się Triton Inference Server. |
| Platformy serverless GPU, takie jak Modal | Ruch jest nieregularny. Kontenery mogą skalować się do zera, więc kolejne żądanie czeka wtedy na zimny start. Rozgrzane kontenery ponownie wykorzystują załadowane modele i pamięci podręczne. Trwały stan żądań przechowuj w pamięci trwałej. |
Modele zbyt duże na jedno GPU wymagają na etapie serwowania równoległości tensorowej lub potokowej; Skalowanie LLM z wieloma GPU i węzłami wyjaśnia każdą z metod. Aby wybrać format wag dla środowiska i sprzętu, zobacz Formaty kwantyzacji LLM.
W obu trybach uwzględnij w decyzji o wydaniu opóźnienie, błędy, przepustowość, nasycenie, koszt i kontrole jakości zadania.
2. Teksty typu prompt i schemat
W systemie, który składa żądania w czasie działania, wersjonuj złożone żądanie, a nie sam tekst typu prompt: kolejność wiadomości, opisy narzędzi, schemat odpowiedzi, dekodowanie, ponowienia, obcinanie i otaczający kod mogą zmienić zachowanie.
Mała zmiana w treści prompt może zmienić format odpowiedzi. Oto trzy wersje instrukcji typu prompt do analizy sentymentu:
v1: "Classify this text as positive or negative: {text}"
v2: "You are a sentiment analyzer. Classify: {text}"
v3: "Analyze sentiment. Return only 'positive' or 'negative': {text}"
v1 i v2 mogą zwrócić zdanie w rodzaju „The sentiment is positive.” v3 prosi o jedno słowo. Kod parsujący odpowiedź musi zmieniać się wraz ze zmianami w treści prompt, dlatego prompt, schemat i parser trafiają do manifestu razem.
Traktuj poprawny JSON jako kontrolę transportu, a niezmienniki biznesowe zadania testuj osobno.
3. Korpus wyszukiwania i indeks
Wyszukiwanie dodaje niezależny produkt danych między źródłem prawdy a modelem:
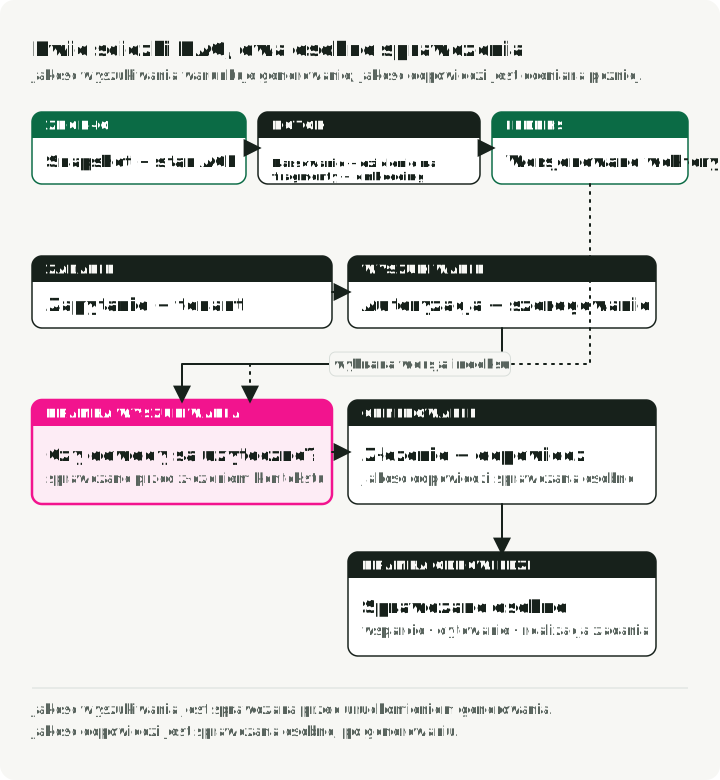
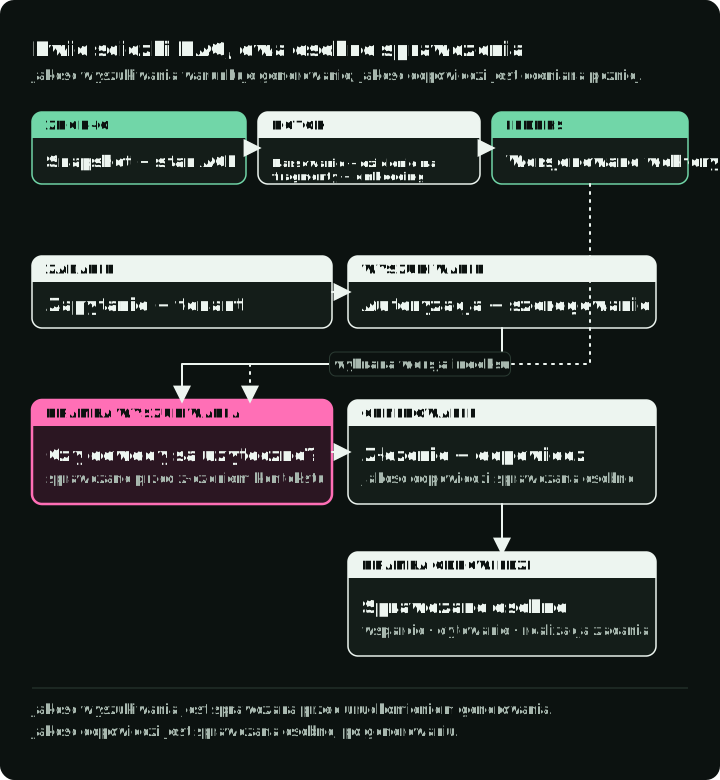
Górny wiersz jest budowany przed żądaniami, a każdy krok zapisuje wersję. Dolny wiersz śledzi jedno żądanie, a ponumerowane znaczniki pokazują trzy osobne testy: autoryzację, znalezione dowody i odpowiedź.
W systemie ze wspomaganiem wyszukiwaniem (RAG) zachowaj rewizję źródła, wersje parsera i chunkera, tożsamość reprezentacji embedding, build indeksu, metadane kontroli dostępu i stan usunięcia. Oryginalny projekt RAG oddziela wyszukiwanie od generowania; wykorzystaj to rozdzielenie, by niezależnie testować wyszukiwanie dowodów, filtrowanie autoryzacji i użycie dowodów. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks opisuje architekturę „najpierw wyszukaj, potem generuj”. Metryki ewaluacji RAG omawia metryki dla każdej kontroli, a Narzędzia ewaluacji RAG porównuje biblioteki, które je liczą.
Wybierz magazyn indeksu według tego, kto z niego korzysta. Biblioteka działająca w procesie, taka jak FAISS, wystarcza, gdy jeden serwis jest właścicielem indeksu i mieści się on w pamięci tego serwisu. Użyj serwera wektorowej bazy danych, takiego jak Pinecone, Weaviate lub Milvus, gdy kilka serwisów współdzieli indeks, gdy potrzebujesz filtrów metadanych w czasie zapytania albo gdy indeks przestaje mieścić się na jednej maszynie. Sam projekt wyszukiwania (jeden przebieg, wyszukiwanie iteracyjne lub GraphRAG) opisuje Architektura RAG.
Metodę aktualizacji wybierz według tego, jak nieaktualna może być odpowiedź. Zaplanowana przebudowa działa, gdy odpowiedź sprzed doby jest akceptowalna. Gdy zmiana musi być widoczna w ciągu minut, strumieniuj aktualizacje, na przykład zdarzenia Kafka do zadania generującego embedding, które zapisuje do indeksu. Dla niezmiennej migawki zapisuj, która kompilacja indeksu obsłużyła każdą odpowiedź. Dla zmiennego indeksu rejestruj też widoczną dla zapytania rewizję przyjętych danych lub znacznik postępu (watermark), jeśli jest dostępny, oraz rewizje pobranych dokumentów dla każdego żądania. Numery sekwencyjne dziennika w odpowiedziach na zapytania w Pinecone pokazują, dlaczego samo potwierdzenie zapisu nie wskazuje, co zobaczyło zapytanie. Zachowuj niezmienne migawki lub historię źródeł możliwą do odtworzenia, jeśli potrzebne jest dokładne odtworzenie danych; sam watermark nie odzyska nadpisanej treści.
Nie używaj indeksu wektorowego jako zamiennika feature store ani hurtowni danych: wyszukiwanie podobieństwa, cechy point-in-time i fakty analityczne mają różne wymagania dotyczące zapytań i spójności.
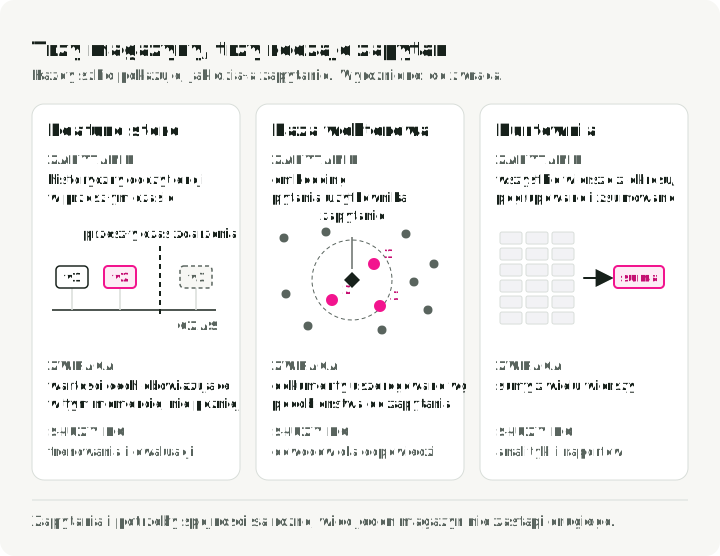
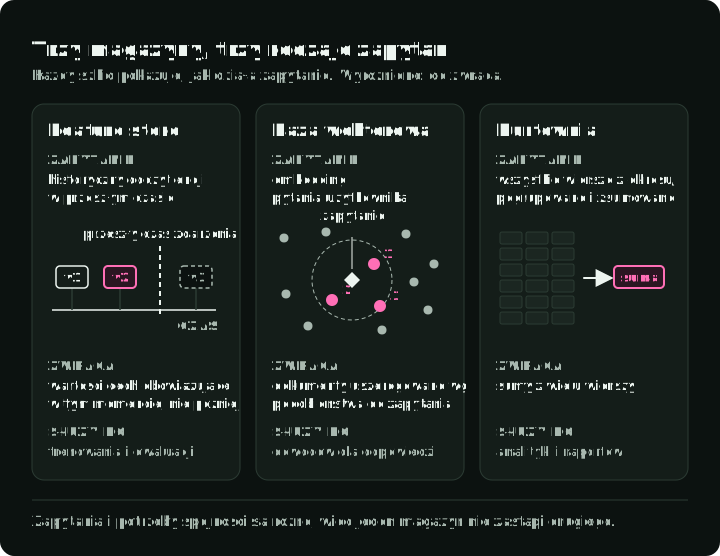
Trzy karty porównują historyczne odczytanie cech, wyszukiwanie według podobieństwa i agregację. Odczyt historyczny zwraca wartości obowiązujące w przeszłym czasie zdarzenia, wektorowa baza danych szereguje dokumenty według podobieństwa do zapytania, a hurtownia zwraca sumy z wielu wierszy. Hurtownię zachowaj do analityki.
W Feast złączenia historyczne budują dane do trenowania i ewaluacji dla przeszłych czasów zdarzeń. Jego magazyn online udostępnia najnowsze zmaterializowane wartości cech dla każdej encji z małym opóźnieniem.
4. Narzędzia i uprawnienia
Gdy model może wywoływać API, otocz każde wywołanie narzędzia tymi kontrolami: uwierzytelnianiem narzędzia, minimalnymi uprawnieniami, walidacją argumentów, limitami czasu, idempotentnością, polityką zatwierdzeń i kontrolą warunków końcowych. Generative AI Profile NIST wskazuje ryzyka związane ze szkodliwą treścią, prywatnością i bezpieczeństwem.
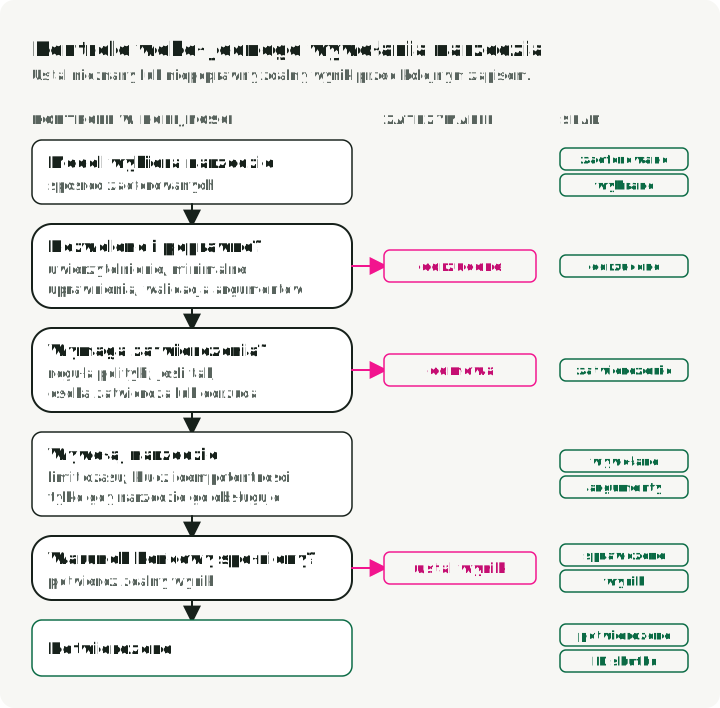
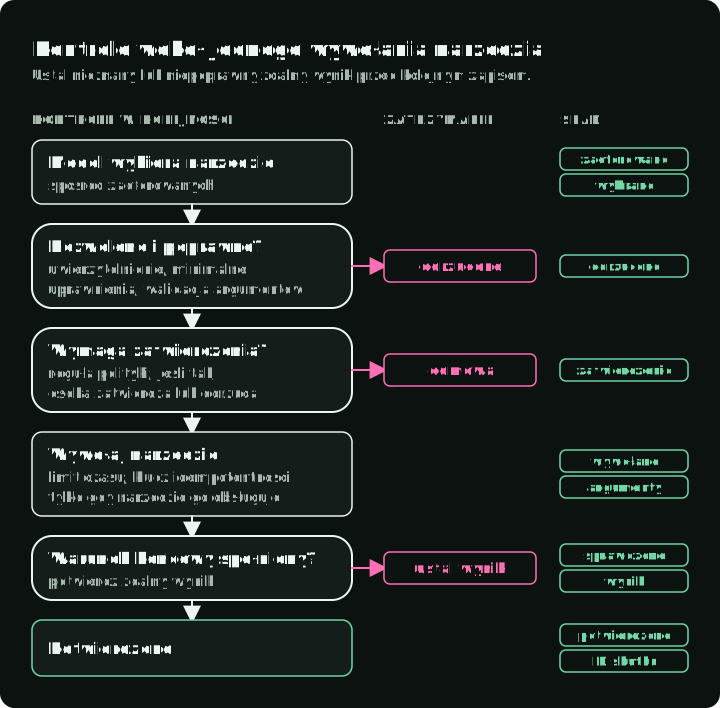
Diagram pokazuje te kontrole w kolejności, miejsca, w których wywołanie się zatrzymuje (odrzucone uprawnienie lub argument, odmowa zatwierdzenia albo wynik niezgodny z oczekiwanym warunkiem końcowym), oraz zdarzenie śladu zapisywane w każdym kroku.
Limit czasu może pozostawić wynik zapisu nieznany nawet wtedy, gdy zdalny serwis już go zatwierdził. Ustal wynik przed kolejnym zapisem: sprawdź operację lub zasób albo użyj udokumentowanego idempotentnego ponowienia. Ponawiaj tylko w ramach obsługiwanego kontraktu idempotentności lub innej zweryfikowanej bezpiecznej metody odzyskiwania; AWS wyjaśnia wymaganą obsługę po stronie serwera. Powtórzony klucz może zwrócić pierwotny błąd, jak opisuje kontrakt idempotentności Stripe. Użyj obsługiwanej akcji kompensującej, jeśli jest dostępna, a nierozstrzygnięte wyniki skieruj do przeglądu.
Śledź, które narzędzie zostało zaoferowane, wybrane, wywołane, odrzucone, ponowione, sprawdzone i potwierdzone. Płynna odpowiedź końcowa nie dowodzi, że ścieżka działań była poprawna.
5. Reguły bezpieczeństwa i biznesowe
Filtry treści to jedna kontrola, a nie kompletna warstwa guardrails. Zagrożenia obejmują też prompt injection, wyszukiwanie między tenantami, ujawnienie sekretów, nadmierną sprawczość (pozycja w OWASP Top 10 for LLM Applications), niezaufane pliki modeli lub własny kod ładowany w czasie działania oraz niebezpieczne argumenty narzędzi.
Tam, gdzie to możliwe, wyrażaj deterministyczne reguły biznesowe poza modelem. Zdefiniuj ryzyka resztkowe, testuj przypadki adversarialne i wyznacz właściciela zmian polityki. Generative AI Profile NIST to przydatny spis ryzyk, a nie gotowy test akceptacyjny.
Ewaluacja decyduje o wydaniu
Przy decyzjach o wydaniu dla danych wyjściowych w wolnej formie nie polegaj na jednej zagregowanej liczbie dokładności. Użyj kilku rodzajów dowodów i określ, który z nich jest rozstrzygający dla każdego trybu awarii.
Stos ewaluacji dla systemu opartego na modelu foundation ma sześć warstw:
- Kontrole deterministyczne: poprawność schematu, obecność cytowań, dozwolone narzędzia, ograniczenia argumentów, reguły polityki, opóźnienie i budżet.
- Metryki komponentów: recall i ranking wyszukiwania, trafność wyboru narzędzia, poprawność argumentów narzędzia i wybór trasy.
- Zadania end-to-end: reprezentatywne wejścia z jawnymi kryteriami sukcesu i etykietami wycinków.
- Ocena oparta na modelu: oceny według rubryki, skalibrowane względem etykiet ekspertów i monitorowane pod kątem dryfu sędziego.
- Przegląd przez człowieka: przypadki niejednoznaczne, istotne, nowe lub próbkowane, w których automatyka nie jest rozstrzygająca.
- Testy adversarialne: przypadki injection, granic danych, nadużyć, odmów i skutków ubocznych, powiązane z modelem zagrożeń.
Przechowuj wyniki dla poszczególnych przykładów, a nie tylko średnie, aby przegląd wydania mógł sprawdzać regresje według języka, tenanta, typu dokumentu lub klasy działania.
Przy decyzji o wdrożeniu porównaj manifest kandydata z bieżącym wydaniem na tym samym wersjonowanym zestawie. Ustaw progi jakości, bezpieczeństwa, opóźnienia i kosztu łącznie i odrzuć tańszą trasę, która nie przechodzi zestawu zadań.
Jeśli każdy wynik mieści się w progu, rozpocznij wdrożenie etapowe. Jeśli jeden zawodzi, odrzuć kandydata. Jeśli wynik dla wycinka jest niejasny, skieruj go do przeglądu przez człowieka.
Aby wybrać narzędzie ewaluacji dla śladów, zbiorów danych i kontroli w CI, zobacz Narzędzia ewaluacji agentów AI.
Ślady łączą produkcję z ewaluacją
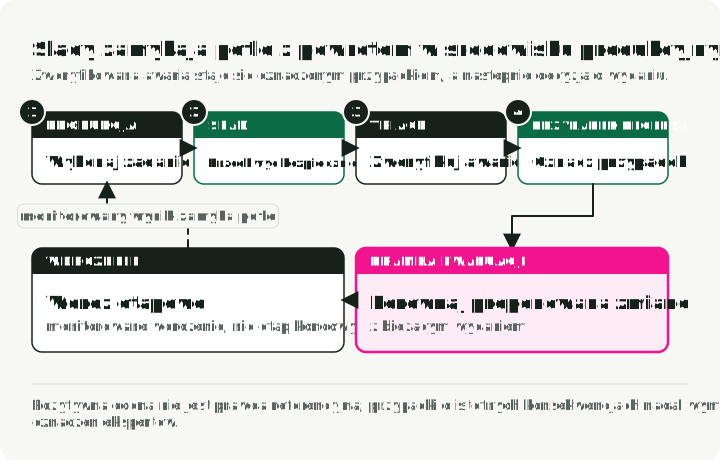
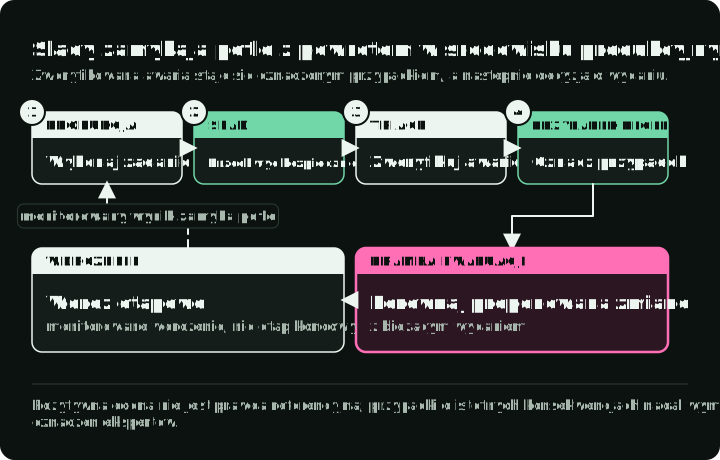
Górna część diagramu to ślad jednego żądania. Metryki widzą wolne wywołanie modelu; dopiero ślad pokazuje nieautoryzowany dokument i niewłaściwe konto. Dolny wiersz to to, co dzieje się dalej: przejrzana awaria staje się oznaczonym przypadkiem regresji. Ewaluacja porównuje zmianę kandydata z bieżącym wydaniem, a przerywana krawędź niesie wydanie etapowe z powrotem na produkcję.
Metryki infrastruktury mogą pokazać wolne wywołanie modelu. Nie pokażą, że wyszukiwanie zwróciło nieautoryzowany dokument ani że narzędzie wywołano z niewłaściwym kontem. Dokumentacja tracingu MLflow opisuje ślady, które rejestrują kroki pośrednie i metadane potrzebne do zbadania tej ścieżki.
Rejestruj ślad na całej ścieżce decyzyjnej:
- tożsamość manifestu wydania i korelacja żądań
- wywołania modelu i dostawcy, opóźnienie, zużycie i stan zakończenia
- zapytanie wyszukiwania, widoczna dla zapytania rewizja indeksu lub watermark, identyfikatory i rewizje dokumentów, oceny i decyzje filtrowania
- rewizja treści prompt lub szablonu bez bezrefleksyjnego zapisywania wrażliwej treści
- oferty narzędzi, argumenty, zatwierdzenia, wyniki i identyfikatory skutków ubocznych
- decyzje polityki, ponowienia, fallbacki i wynik końcowy
Ślady to nowy magazyn danych wrażliwych. Zastosuj minimalizację, maskowanie danych wrażliwych, izolację tenantów, szyfrowanie, próbkowanie, retencję i przegląd dostępu, zanim zaczniesz zbierać pełne treści typu prompt lub dokumenty. Konwencje semantyczne GenAI w OpenTelemetry mogą ułatwić interoperacyjność, ale nadal są w rozwoju. Przypnij wersję konwencji lub schematu oraz wersje instrumentacji i kolektora.
Opinie użytkowników mogą ustalać priorytety badania, ale kciuk w górę nie jest wartością referencyjną. Zachowaj otaczający ślad i uzyskaj etykiety ekspertów dla istotnych przypadków. Label Studio zbiera etykiety dla tekstu, obrazów i innych typów danych; Argilla zbiera opinie o tekście i danych wyjściowych LLM i może wypychać zbiory danych do Hugging Face Hub. Ewaluacja agentów AI na produkcji pokazuje, jak zamienić oznaczone ślady w wersjonowany zestaw regresji.
Gateway serwujący odpowiada za routing i politykę
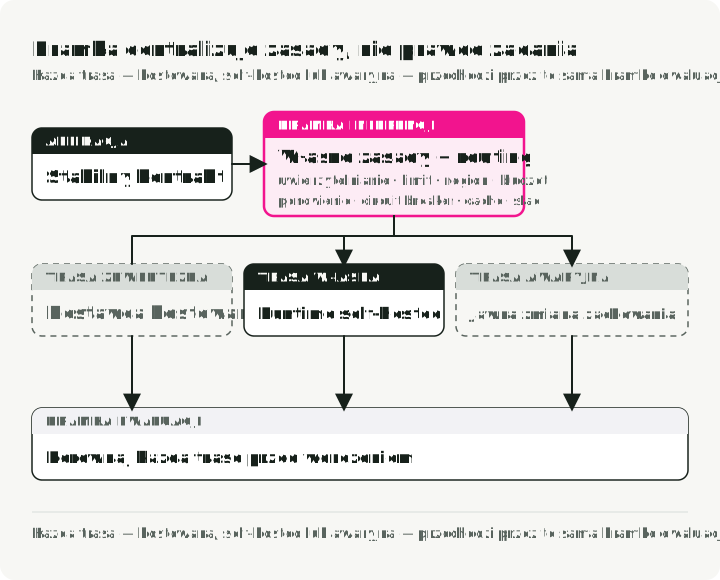
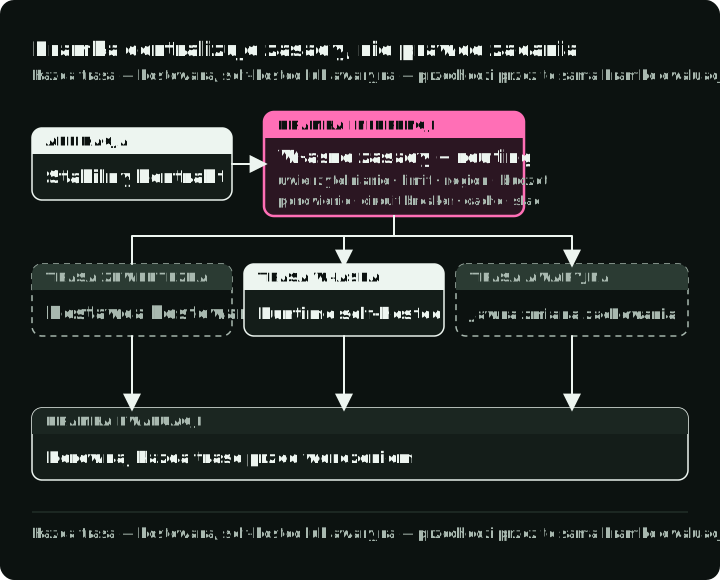
Na diagramie każde żądanie przechodzi przez gateway jedną trasą: według planu, według małego udziału ruchu dla nowego modelu albo na trasę awaryjną, gdy dostawca zawiedzie. Każda trasa zwraca ten sam kontrakt odpowiedzi, a zestaw zadań ewaluuje każdą trasę offline przed promocją.
Gateway może oddzielić klientów aplikacji od dostawców lub samodzielnie hostowanych silników. Warto umieścić w nim następujące odpowiedzialności:
- uwierzytelnianie, budżety tenantów, limity i ograniczanie szybkości
- stabilne kontrakty żądań i odpowiedzi
- wybór trasy według możliwości, regionu, opóźnienia lub ocenionej jakości
- routing według poziomu subskrypcji, na przykład większy model dla płatnych planów
- kierowanie niewielkiej części ruchu do nowego modelu przed pełnym wdrożeniem
- ograniczone ponowienia, circuit breakery i jawna semantyka fallbacku
- partycjonowanie cache i polityka danych wrażliwych
- przypisywanie użycia i propagacja manifestu wydania
LiteLLM Proxy to jeden z otwartoźródłowych gatewayów: udostępnia wielu dostawców przez jedno API zgodne z OpenAI i ustawia budżety oraz limity szybkości na klucz lub zespół.
Fallback jest zmianą zachowania w tym samym stopniu, w jakim jest mechanizmem niezawodności. Jeśli mniejszy model, alternatywny dostawca lub ograniczony kontekst zmienia jakość zadania, ewaluuj i śledź tę gałąź jako osobną trasę.
Nie umieszczaj w gatewayu każdej decyzji orkiestracyjnej. Trzymaj reguły domenowe blisko aplikacji i jasno określ odpowiedzialność.
Fine-tuning i LoRA
Ostatni wiersz tabeli awarii w sekcji „Który komponent sprawdzić najpierw” to przypadek, w którym stosuje się fine-tuning: zachowanie potrzebne zadaniu nie daje się odtworzyć z treści prompt ani z pobranego kontekstu. LoRA zamraża wstępnie wytrenowane wagi i dodaje trenowalne macierze niskiego rzędu, zmniejszając liczbę trenowalnych parametrów dla zadania docelowego. Ta optymalizacja nie usuwa wymagań dotyczących zarządzania zbiorem danych, licencji modelu bazowego, ewaluacji, zgodności serwowania i rollbacku.
Zapisz ustawienia adaptera w manifeście obok rewizji modelu bazowego: rząd (r), współczynnik skalowania (lora_alpha) i warstwy, które zmienia (target_modules). Każde z nich zmienia to, czego uczy się adapter. Przewodnik: fine-tuning LLM omawia zbiory danych, QLoRA i narzędzia do trenowania, a Przewodnik po serwowaniu LoRAX omawia serwowanie wielu adapterów na jednym modelu bazowym.
Praktyczna kolejność wdrażania
- Zdefiniuj zadanie użytkownika, granice szkód, cele poziomu usług i budżet kosztów.
- Utwórz manifest wydania, zanim wprowadzisz rejestr treści typu prompt, wektorową bazę danych lub produkt gateway.
- Zbuduj mały, podzielony na wycinki zbiór ewaluacyjny i deterministyczne testy komponentów.
- Zainstrumentuj jeden ślad end-to-end z kontrolami prywatności i stabilnymi tożsamościami wydań.
- Promuj przez ruch cieniowy, canary lub ograniczony ruch z jawnym wyzwalaczem rollbacku.
- Zamieniaj przejrzane awarie produkcyjne w przypadki regresji i powtarzaj.
Dodawaj infrastrukturę tylko wtedy, gdy wykonuje zadanie nazwane w manifeście albo usuwa zmierzone wąskie gardło.
Referencje
- MLflow: evaluating production traces - Ponowne użycie śladów produkcyjnych do ewaluacji i ocena pośrednich informacji ze śladu.
- MLflow: LLM and agent tracing - Rejestrowanie kroków pośrednich i metadanych śladu na potrzeby badania.
- OpenTelemetry GenAI semantic conventions - Bieżące konwencje o statusie „w rozwoju” dla spanów, metryk, zdarzeń i danych specyficznych dla dostawców GenAI.
- NIST AI 600-1: Generative AI Profile - Kategorie ryzyka dla prompt injection, prywatności, bezpieczeństwa i pokrewnych zagadnień generatywnej AI.
- OWASP Top 10 for LLM Applications - Obejmuje nadmierną sprawczość (LLM06:2025) i prompt injection (LLM01:2025).
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks - Oryginalna architektura „najpierw wyszukaj, potem generuj”.
- LoRA: Low-Rank Adaptation of Large Language Models - Zamrożone wstępnie wytrenowane wagi plus trenowalne macierze niskiego rzędu do adaptacji na zadanie docelowe.
- PEFT LoRA reference - Parametry
LoraConfigiget_peft_model. - vLLM documentation - Silnik serwowania z ciągłym batchingiem, kwantyzacją, multi-LoRA i serwerem zgodnym z OpenAI.
- NVIDIA Dynamo-Triton - Serwer inferencji dawniej nazywany Triton Inference Server, z backendem TensorRT-LLM.
- LiteLLM Proxy - Otwartoźródłowy gateway z jednym API dla wielu dostawców, budżetami, limitami szybkości i fallbackami.