MLOps vs LLMOps: infraestructura para modelos fundacionales

Traducción automática
Este artículo se tradujo automáticamente a partir de la versión original en inglés.
Este artículo es para ingenieros de ML y de plataforma que ya practican MLOps y ahora operan un sistema construido sobre un modelo fundacional. En un sistema así, una regresión puede venir de un prompt, un índice, un permiso de herramienta o una ruta modificados mientras los pesos del modelo siguen iguales. El artículo cubre qué prácticas de MLOps siguen vigentes, qué más hay que versionar cuando los prompts, la recuperación, las herramientas y el enrutado pueden cambiar el comportamiento, cómo evaluar y trazar ese sistema, y qué herramientas hacen cada tarea.
Qué resolvió ya MLOps
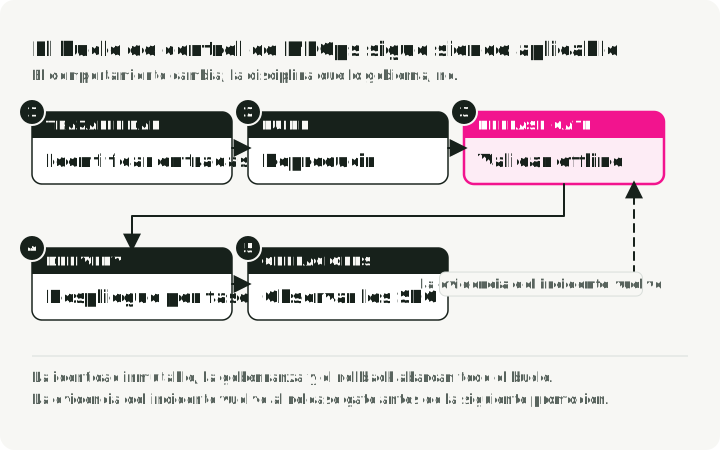
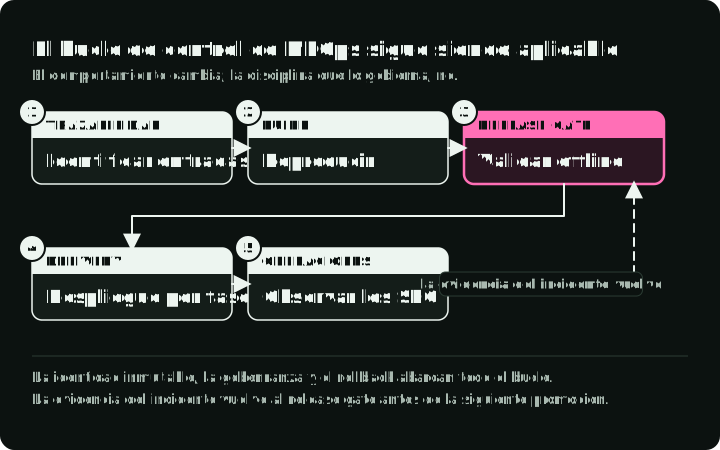
Cada fila del diagrama es un paso del bucle de MLOps: lo que MLOps ya hace ahí y lo que añade un sistema con modelo fundacional. La arista discontinua lleva los fallos de producción revisados de vuelta a la verificación offline en forma de tests. MLOps estableció estas prácticas, y siguen aplicándose cuando el modelo genera texto:
- linaje desde los datos, el código, la configuración y el modelo hasta una versión
- pipelines de entrenamiento o de build repetibles
- validación offline antes de la promoción
- registros e identidad inmutable de los artefactos
- despliegue por etapas, objetivos de nivel de servicio, rollback y respuesta a incidentes
- telemetría de infraestructura y planificación de capacidad
- control de acceso, retención y políticas de auditoría de los datos
La mayoría de las herramientas de orquestación que ya usas siguen sirviendo, pero no en todas las rutas:
| Tarea | Herramienta | Úsala cuando |
|---|---|---|
| Fine-tuning por lotes, reconstrucciones programadas de índices, evaluaciones | Airflow, Kubeflow Pipelines | Ya las usas para MLOps y la tarea se ejecuta con una programación o un disparador. |
| Flujos de trabajo nativos de Python | Metaflow, Flyte, ZenML | El equipo escribe pipelines en Python y quiere pasos que llamen directamente a las bibliotecas de ML. |
| La ruta de la petición: recuperar, llamar al modelo, llamar a herramientas | Código de la aplicación | El paso se ejecuta una vez por petición y debe responder en segundos. Los planificadores de flujos están pensados para tareas por lotes. |
Los modelos fundacionales no eliminan estas necesidades. Hacen que la vieja expresión «versión del modelo» se quede corta.
La unidad de versión pasó a ser un manifiesto del sistema
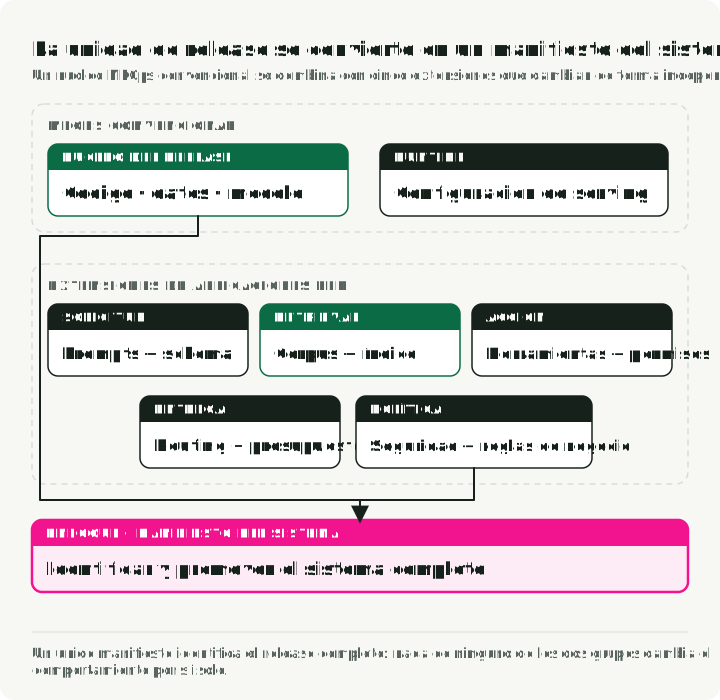
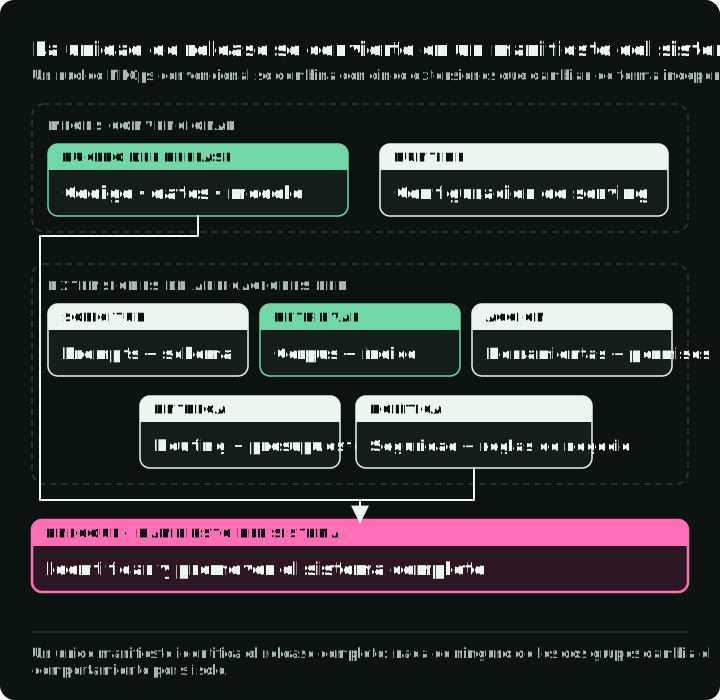
El diagrama muestra el manifiesto de un asistente de soporte en dos versiones. Las filas superiores son lo que MLOps ya versiona; las inferiores, lo que añade un sistema con modelo fundacional. Las filas destacadas son las únicas entradas que cambiaron.
Para un sistema con modelo fundacional recomiendo un manifiesto que registre al menos:
application code revision
model provider + model/revision + serving configuration
system and task prompts
response schema + decoding parameters
retrieval corpus snapshot + parser + chunker + embedding model + index
tool definitions + implementation revisions + permission policy
routing, fallback, caching, and budget policy
safety and business-rule revisions
evaluation dataset + scorer revisions
La lista exacta depende del sistema. La regla es identificar todos los componentes que cambian de forma independiente y pueden alterar el comportamiento visible para el usuario.
Trata el nombre de un modelo de proveedor como algo que puede cambiar, salvo que el proveedor documente una revisión inmutable. El hash de un checkpoint ayuda a identificar pesos autoalojados, pero yo registraría además el runtime, la cuantización, la plantilla de chat y la configuración de paralelismo. La entrada del modelo sale de un registro: usa MLflow Model Registry para los pesos y adaptadores que entrenas, y el Hugging Face Hub para pesos abiertos, fijados a un commit con el argumento revision en lugar de un nombre de rama.
Guarda el manifiesto como un archivo junto a cada versión. Cuando una versión empeora, compáralo con la anterior. En este ejemplo de un asistente de soporte, solo cambiaron el prompt de respuesta y la instantánea de recuperación:
-    answer: prompts/answer.md@v9
+    answer: prompts/answer.md@v10
-    corpus: kb-snapshot-2026-09-28
-    index: kb-idx-2026-09-28-01
+    corpus: kb-snapshot-2026-10-01
+    index: kb-idx-2026-10-01-01
El diff señala los componentes que hay que revisar primero: el prompt de respuesta y el índice nuevo. Los pesos, las herramientas y el enrutado no cambiaron.
Qué componente inspeccionar primero
El diff del manifiesto dice qué cambió. El tipo de fallo indica dónde buscar cuando el diff por sí solo no lo explica:
| Fallo | Primer componente a inspeccionar |
|---|---|
| Faltan hechos actuales o privados | recuperación y sincronización de las fuentes |
| Formato incorrecto o argumentos no válidos | esquema, salida restringida, validación |
| Comportamiento incoherente en la tarea | prompt, ejemplos, elección del modelo y luego datos de adaptación |
| Latencia o coste excesivos | ruta, contexto, caché, batching, cuantización |
| Acción no autorizada o insegura | permisos de las herramientas y política determinista |
| Comportamiento del dominio que el contexto no recupera | fine-tuning u otro modelo especializado |
Para elegir entre cambiar el prompt, añadir recuperación y hacer fine-tuning, consulta fine-tuning vs RAG vs prompting.
Cinco componentes que pueden cambiar el comportamiento
Las secciones siguientes tratan cinco de los componentes del diagrama del manifiesto, en este orden: el modelo y su serving, luego los prompts y el esquema, el corpus y el índice de recuperación, las herramientas y los permisos, y la seguridad y las reglas de negocio. Cada sección dice qué registrar, qué probar y qué herramientas hacen el trabajo. El enrutado y el fallback tienen su propia sección junto con el gateway.
1. Modelo y serving
La primera decisión es si un proveedor aloja el modelo o lo sirves tú mismo. Una API alojada te libra del trabajo con GPUs. Cada petición cruza la red, pagas por token, los datos que envías salen de tu red y el proveedor controla los pesos, las revisiones, las cuotas y el precio. El autoalojamiento te da control sobre la revisión, la cuantización, el batching, la región y la caché. También te toca operar la capacidad de GPU, y la pagas esté ocupada o libre.
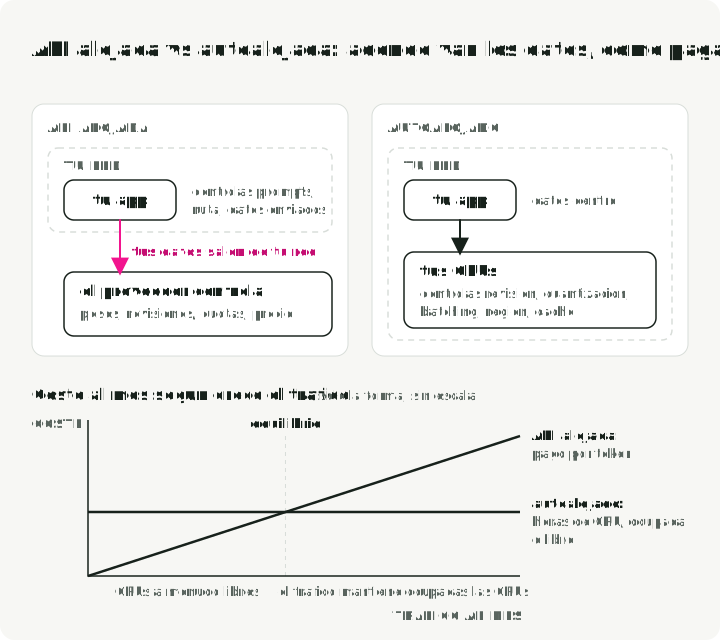
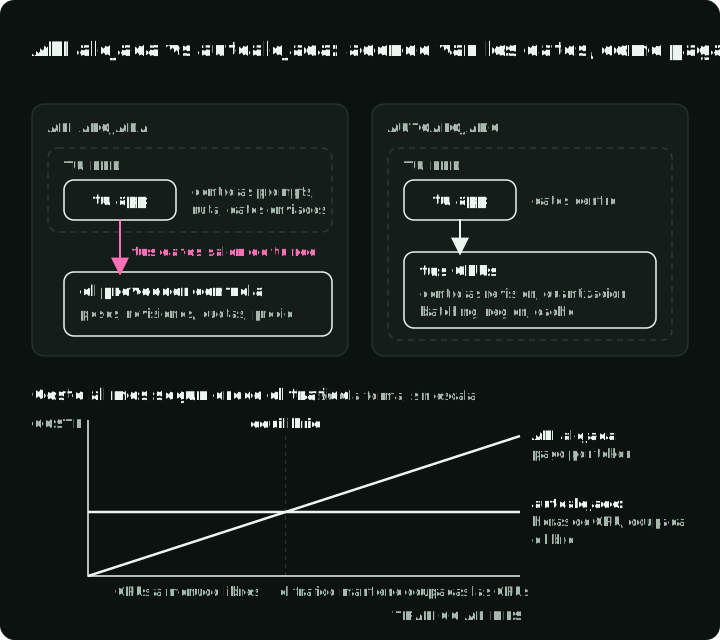
La parte superior del diagrama muestra adónde van los datos y quién controla qué en cada modo. El gráfico de debajo muestra cómo crece el coste de cada modo con el tráfico. Las líneas se cruzan en el tráfico de equilibrio, donde la factura mensual de GPU iguala la factura de la API por los mismos tokens. En ambos modos, el manifiesto registra la ruta y se ejecuta la misma suite de tareas.
Para hallar el punto de equilibrio, divide el coste de GPU al mes entre el precio de la API por token. Un ejemplo con precios de lista del 7 de octubre de 2026 para Llama 3.3 70B:
- Together AI cobra $1.04 por millón de tokens, de entrada o de salida.
- En FP8, los 70 000 millones de pesos ocupan unos 70 GB, así que el modelo cabe en dos GPUs H100 de 80 GB con espacio para la KV cache. Lambda alquila una instancia de dos H100 SXM a $4.19 por GPU y hora.
- Dos GPUs durante 730 horas (un mes) cuestan 2 × 730 × $4.19 = $6,117.
- $6,117 ÷ $1.04 por millón de tokens = unos 5.9 mil millones de tokens al mes, o unos 2,240 tokens por segundo, cada segundo del mes.
Por debajo de ese tráfico, la API cuesta menos. Por encima, autoalojar cuesta menos solo si las dos GPUs pueden servir ese ritmo, así que mide antes el throughput con tus propios prompts. El ejemplo cuenta solo el alquiler de GPU. El tiempo de ingeniería, una segunda réplica para la disponibilidad y el almacenamiento desplazan el punto de equilibrio hacia arriba.
Si lo autoalojas, elige el motor de serving según la forma del despliegue:
| Opción | Úsala cuando |
|---|---|
| vLLM | Sirves modelos de pesos abiertos en tus propias GPUs y necesitas throughput. Ofrece continuous batching, pesos cuantizados, muchos adaptadores de fine-tuning sobre un mismo modelo base (consulta la sección de LoRA más abajo) y un servidor compatible con OpenAI. |
| Ollama | Ejecutas modelos en un portátil para desarrollo y tests locales. |
| NVIDIA Dynamo-Triton con el backend TensorRT-LLM | Usas GPUs de NVIDIA y quieres motores compilados para ese hardware, o un único servidor para modelos LLM y no LLM. Antes de 2025 se llamaba Triton Inference Server. |
| Plataformas de GPU serverless como Modal | El tráfico es irregular. Los contenedores pueden escalar a cero, por lo que la siguiente petición espera entonces un arranque en frío. Los contenedores calientes reutilizan los modelos y las cachés cargados. Conserva el estado duradero de las peticiones en almacenamiento persistente. |
Los modelos demasiado grandes para una sola GPU necesitan paralelismo tensorial o de pipeline en el serving; Escalado de LLMs con paralelismo multi-GPU y multinodo explica cada método. Para elegir un formato de pesos para el runtime y el hardware, consulta formatos de cuantización de LLMs.
En cualquiera de los dos modos, incluye en la decisión de versión comprobaciones de latencia, errores, throughput, saturación, coste y calidad de la tarea.
2. Prompts y esquema
En un sistema que monta las peticiones en tiempo de ejecución, versiona la petición ya montada y no solo el texto del prompt: el orden de los mensajes, las descripciones de las herramientas, el esquema de respuesta, la decodificación, los reintentos, el truncado y el código circundante pueden cambiar el comportamiento.
Un cambio pequeño en un prompt puede cambiar el formato de la salida. Estas son tres versiones de un prompt de sentimiento:
v1: "Classify this text as positive or negative: {text}"
v2: "You are a sentiment analyzer. Classify: {text}"
v3: "Analyze sentiment. Return only 'positive' or 'negative': {text}"
v1 y v2 pueden devolver una frase como «The sentiment is positive.» v3 pide una sola palabra. El código que interpreta la respuesta tiene que cambiar junto con el prompt, así que el prompt, el esquema y el parser entran juntos en el manifiesto.
Trata el JSON interpretable como una comprobación de transporte y prueba por separado las invariantes de negocio de la tarea.
3. Corpus e índice de recuperación
La recuperación añade un producto de datos independiente entre la fuente de verdad y el modelo:
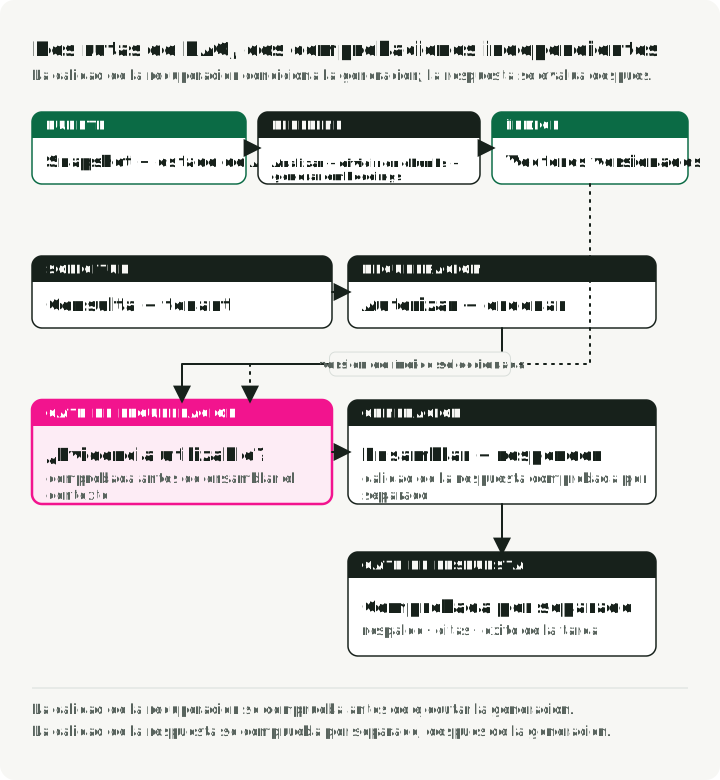
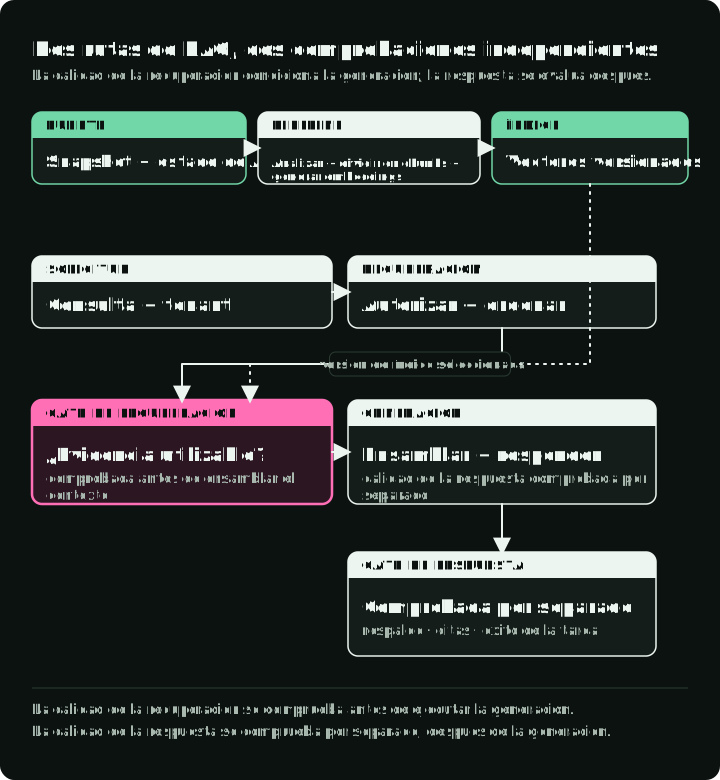
La fila superior se construye antes de las peticiones, y cada paso registra una versión. La fila inferior sigue una petición, y las marcas numeradas indican las tres pruebas independientes: la autorización, la evidencia recuperada y la respuesta.
En un sistema con recuperación aumentada, conserva la revisión de la fuente, las versiones del parser y del chunker, la identidad del embedding, el build del índice, los metadatos de control de acceso y el estado de borrado. El diseño original de RAG separa la recuperación de la generación; aprovecha esa separación para probar por separado la recuperación de evidencia, el filtrado por autorización y el uso de la evidencia. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks describe la arquitectura de recuperar y luego generar. Métricas de evaluación de RAG cubre las métricas de cada comprobación, y herramientas de evaluación de RAG compara las bibliotecas que las calculan.
Elige el almacén del índice según quién lo usa. Una biblioteca en proceso como FAISS basta cuando un solo servicio es dueño del índice y este cabe en la memoria de ese servicio. Usa un servidor de base de datos vectorial como Pinecone, Weaviate o Milvus cuando varios servicios comparten el índice, cuando necesitas filtros de metadatos en la consulta o cuando el índice supera una sola máquina. Para el diseño de la recuperación en sí (una pasada, búsqueda iterativa o GraphRAG), consulta arquitectura RAG.
Elige el método de actualización según cuánto puede quedarse obsoleta una respuesta. Una reconstrucción programada sirve cuando una respuesta de hace un día es aceptable. Cuando un cambio debe aparecer en minutos, actualiza en streaming, por ejemplo con eventos de Kafka hacia un trabajo de embeddings que escribe en el índice. Para una instantánea inmutable, registra qué build del índice sirvió cada respuesta. Para un índice mutable, registra también en la traza la revisión de ingestión o el indicador de progreso (watermark) visible para la consulta, cuando esté disponible, y las revisiones de los documentos recuperados para cada petición. Los números de secuencia del registro en las respuestas a consultas de Pinecone muestran por qué un acuse de escritura no identifica por sí solo lo que vio una consulta. Conserva instantáneas inmutables o un historial de fuentes que pueda reproducirse si necesitas reproducir los datos exactamente; un watermark no permite recuperar contenido sobrescrito.
No uses un índice vectorial como sustituto de un feature store o de un warehouse: la recuperación por similitud, las features en un instante concreto y los hechos analíticos tienen necesidades de consulta y de consistencia distintas.
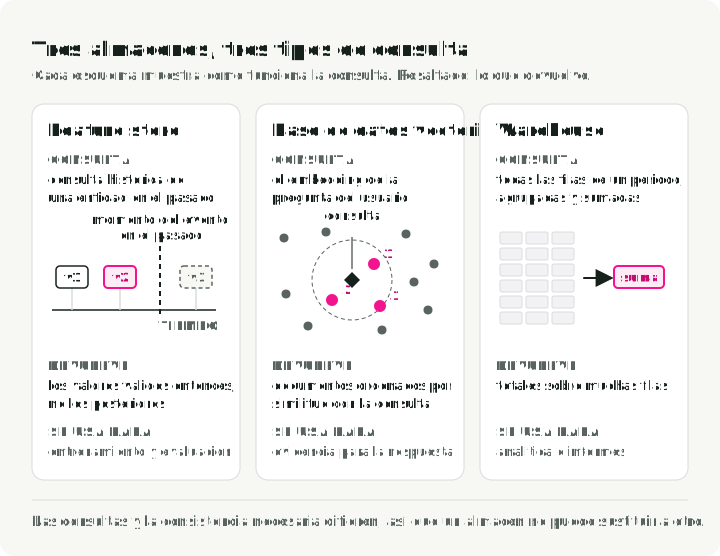
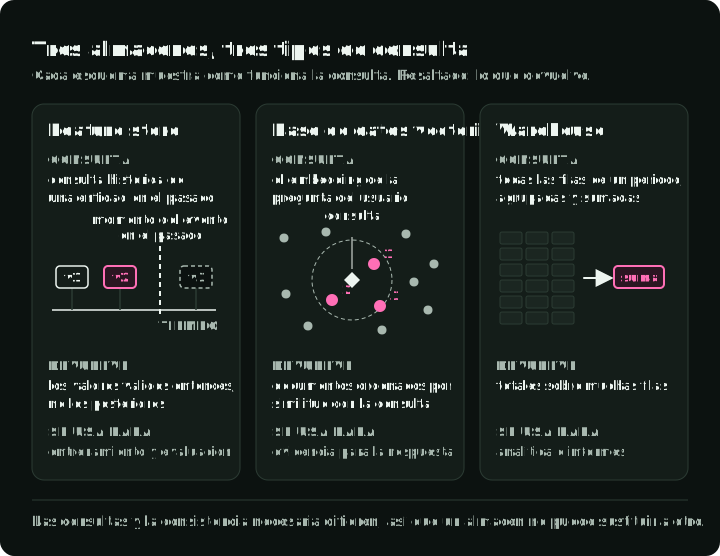
Las tres tarjetas comparan una consulta histórica de features, la recuperación por similitud y la agregación. La consulta histórica devuelve los valores válidos en el momento pasado del evento, una base de datos vectorial ordena documentos por similitud con la consulta y un warehouse devuelve totales sobre muchas filas. Deja el warehouse para la analítica.
En Feast, las uniones históricas construyen datos de entrenamiento y evaluación para momentos pasados de los eventos. Su almacén online sirve los últimos valores de features materializados por entidad con baja latencia.
4. Herramientas y permisos
Cuando un modelo puede llamar a APIs, pon estas comprobaciones alrededor de cada tool call: autenticación de la herramienta, mínimo privilegio, validación de argumentos, timeouts, idempotencia, política de aprobación y comprobación de poscondiciones. El Generative AI Profile del NIST identifica riesgos de contenido dañino, privacidad y seguridad.
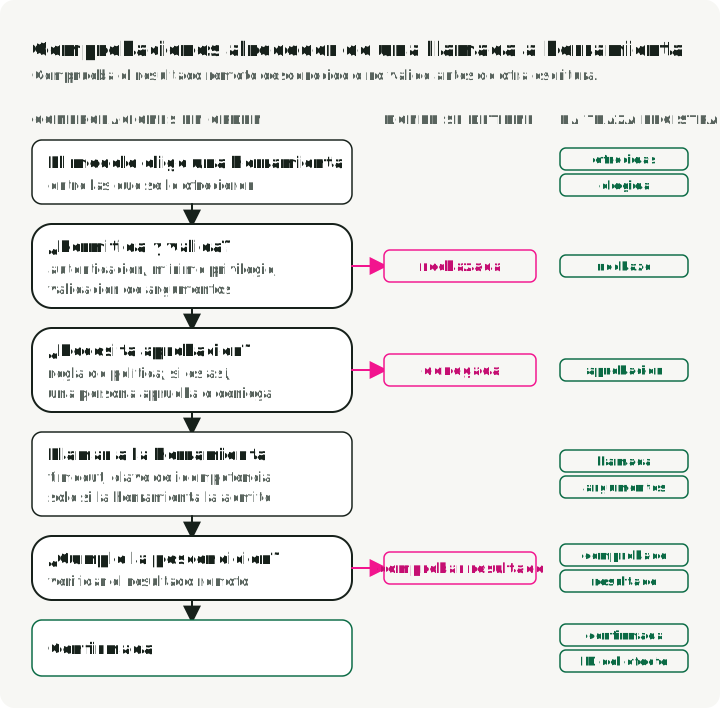
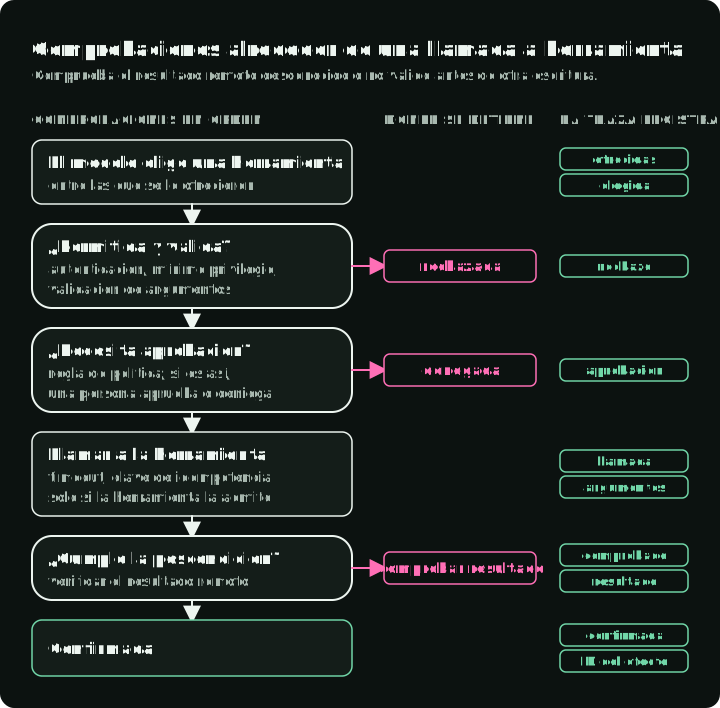
El diagrama muestra estas comprobaciones en orden, dónde se detiene una llamada (un permiso o un argumento rechazado, una aprobación denegada o un resultado que no coincide con la poscondición esperada) y el evento de traza que registra cada paso.
Un timeout puede dejar desconocido el resultado de una escritura incluso después de que el servicio remoto la haya confirmado. Comprueba el resultado antes de otra escritura: consulta la operación o el recurso, o usa una repetición idempotente documentada. Reintenta solo bajo un contrato de idempotencia admitido o con otro método de recuperación cuya seguridad se haya verificado; AWS explica el soporte necesario en el servidor. Una clave repetida puede devolver el fallo original, como documenta el contrato de idempotencia de Stripe. Usa una acción de compensación admitida cuando exista y envía los resultados sin resolver a revisión.
Traza qué herramienta se ofreció, se eligió, se llamó, se rechazó, se reintentó, se comprobó y se confirmó. Una respuesta final fluida no demuestra que la ruta de la acción fuera correcta.
5. Seguridad y reglas de negocio
Los filtros de contenido son un control, no una capa de guardrails completa. Entre las amenazas también están la prompt injection, la recuperación entre tenants, la filtración de secretos, la agencia excesiva (una entrada del OWASP Top 10 for LLM Applications), los archivos de modelo no confiables o el código personalizado cargado en tiempo de ejecución y los argumentos inseguros de las herramientas.
Siempre que sea posible, expresa las reglas de negocio deterministas fuera del modelo. Define los riesgos residuales, prueba casos adversariales y asigna un responsable de los cambios de política. El Generative AI Profile del NIST es un inventario de riesgos útil, no una prueba de aceptación lista para usar.
La evaluación decide la versión
Para decisiones de versión sobre salida de texto libre, no te fíes de una única cifra agregada de precisión. Usa varios tipos de evidencia y define cuál es la decisiva para cada modo de fallo.
Una pila de evaluación para un sistema con modelo fundacional tiene seis capas:
- Comprobaciones deterministas: validez del esquema, citas presentes, herramientas permitidas, restricciones de argumentos, reglas de política, latencia y presupuesto.
- Métricas por componente: recall y ranking de la recuperación, acierto en la elección de herramienta, corrección de los argumentos de la herramienta y elección de ruta.
- Tareas de extremo a extremo: entradas representativas con criterios de éxito explícitos y etiquetas de slice.
- Puntuación basada en modelos: juicios guiados por rúbricas, calibrados con etiquetas de expertos y vigilados por si el juez se desvía.
- Revisión humana: casos ambiguos, con consecuencias importantes, nuevos o muestreados en los que la automatización no es decisiva.
- Pruebas adversariales: casos de inyección, de límites de datos, de abuso, de rechazo y de efectos secundarios ligados al modelo de amenazas.
Guarda los resultados por ejemplo y no solo los promedios, para que la revisión de la versión pueda inspeccionar las regresiones por idioma, tenant, tipo de documento o clase de acción.
Para una decisión de despliegue, compara un manifiesto candidato con la versión actual sobre la misma suite versionada. Fija umbrales conjuntos de calidad, seguridad, latencia y coste, y rechaza una ruta más barata que falle la suite de tareas.
Si todos los resultados están dentro de su umbral, inicia un despliegue por etapas. Si uno falla, rechaza el candidato. Si el resultado de un slice no está claro, envíalo a revisión humana.
Para elegir una herramienta de evaluación de trazas, datasets y comprobaciones de CI, consulta herramientas de evaluación de agentes de IA.
Las trazas conectan la producción con la evaluación
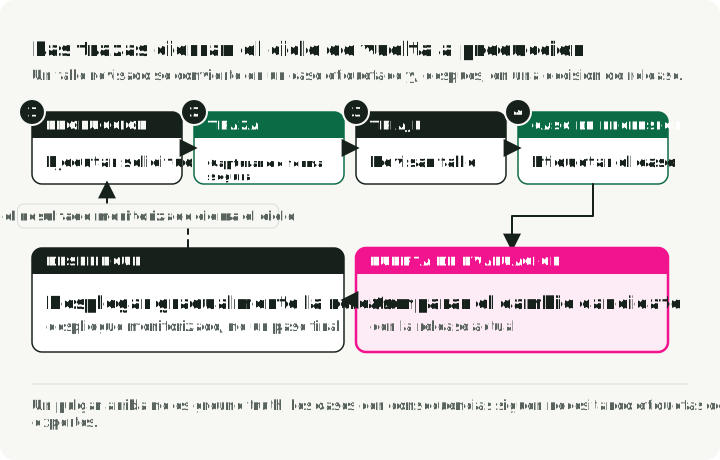
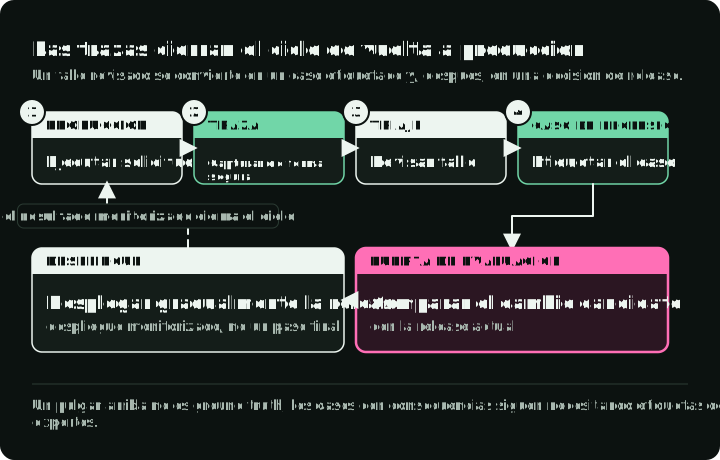
La parte superior del diagrama es la traza de una petición. Las métricas ven la llamada lenta al modelo; solo la traza muestra el documento no autorizado y la cuenta equivocada. La fila inferior es lo que ocurre después: el fallo revisado se convierte en un caso de regresión etiquetado, la evaluación compara un cambio candidato con la versión actual, y la arista discontinua lleva el despliegue por etapas de vuelta a producción.
Las métricas de infraestructura pueden mostrar una llamada lenta al modelo. No pueden mostrar que la recuperación devolvió un documento no autorizado ni que se llamó a una herramienta con la cuenta equivocada. La documentación de tracing de MLflow describe trazas que capturan los pasos intermedios y los metadatos necesarios para inspeccionar esta ruta.
Captura una traza a lo largo de la ruta de decisión:
- identidad del manifiesto de versión y correlación de la petición
- llamadas al modelo y al proveedor, latencia, uso y estado final
- consulta de recuperación, revisión del índice o watermark visible para la consulta, identificadores y revisiones de documentos, puntuaciones y decisiones de filtrado
- revisión del prompt o de la plantilla sin almacenar contenido sensible de forma indiscriminada
- herramientas ofrecidas, argumentos, aprobaciones, resultados e identificadores de efectos secundarios
- decisiones de política, reintentos, fallbacks y resultado final
Las trazas son un nuevo almacén de datos sensibles. Aplica minimización, ocultación de datos sensibles, aislamiento por tenant, cifrado, muestreo, retención y revisión de accesos antes de recoger prompts o documentos completos. Las convenciones semánticas GenAI de OpenTelemetry pueden ayudar con la interoperabilidad, pero siguen en desarrollo. Fija la versión de la convención o del esquema, de la instrumentación y de los colectores.
El feedback de los usuarios puede priorizar la investigación, pero un pulgar arriba no es verdad de referencia. Conserva la traza completa y obtén etiquetas de expertos para los casos con consecuencias importantes. Label Studio recoge etiquetas de texto, imágenes y otros tipos de datos; Argilla recoge feedback sobre texto y salidas de LLMs y puede enviar los datasets al Hugging Face Hub. Evaluación de agentes de IA en producción muestra cómo convertir trazas etiquetadas en una suite de regresión versionada.
El gateway de serving gestiona el enrutado y las políticas
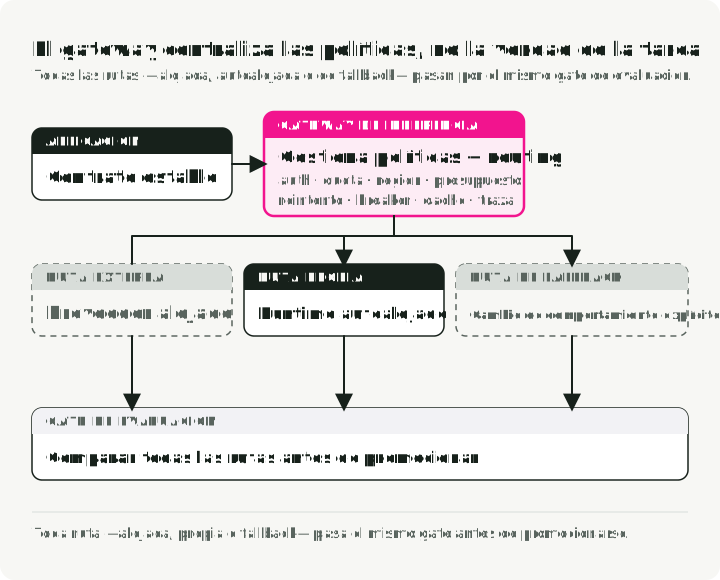
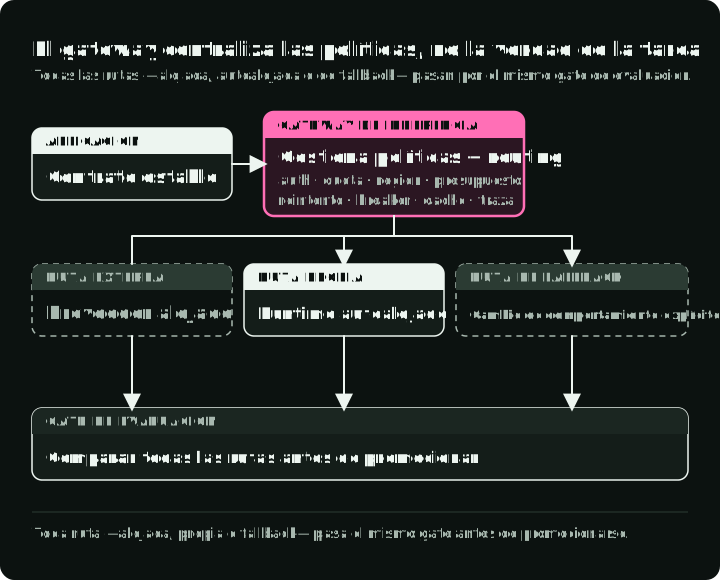
En el diagrama, cada petición toma una ruta por el gateway: según el plan, según una pequeña parte del tráfico para un modelo nuevo, o hacia un fallback cuando falla el proveedor. Todas las rutas devuelven el mismo contrato de respuesta, y la suite de tareas evalúa cada ruta offline antes de la promoción.
Un gateway puede desacoplar los clientes de la aplicación de los proveedores o de los motores autoalojados. Entre las responsabilidades que conviene poner ahí están:
- autenticación, presupuestos por tenant, cuotas y límites de tasa
- contratos estables de petición y respuesta
- elección de ruta por capacidad, región, latencia o calidad evaluada
- enrutado por nivel de suscripción, por ejemplo un modelo mayor para los planes de pago
- enviar una pequeña parte del tráfico a un modelo nuevo antes del despliegue completo
- reintentos acotados, circuit breakers y semántica de fallback explícita
- particionado de la caché y política de datos sensibles
- atribución de uso y propagación del manifiesto de versión
LiteLLM Proxy es un gateway de código abierto: expone muchos proveedores mediante una única API compatible con OpenAI y fija presupuestos y límites de tasa por clave o por equipo.
El fallback es un cambio de comportamiento tanto como un mecanismo de fiabilidad. Si un modelo menor, otro proveedor o un contexto reducido cambia la calidad de la tarea, evalúa y traza esa rama como una ruta propia.
No metas todas las decisiones de orquestación en el gateway. Mantén las reglas del dominio cerca de la aplicación y haz visible quién es responsable de cada una.
Fine-tuning y LoRA
La última fila de la tabla de fallos de «Qué componente inspeccionar primero» es el caso del fine-tuning: el comportamiento que necesita la tarea no se puede recuperar del prompt ni del contexto recuperado. LoRA congela los pesos preentrenados y añade matrices de bajo rango entrenables, lo que reduce el número de parámetros entrenables para la tarea posterior. Esa optimización no elimina los requisitos de gobernanza de datasets, de licencia del modelo base, de evaluación, de compatibilidad de serving ni de rollback.
Registra los ajustes del adaptador en el manifiesto junto a la revisión del modelo base: el rango (r), el factor de escala (lora_alpha) y las capas que modifica (target_modules). Cada uno cambia lo que aprende el adaptador. La guía de fine-tuning de LLMs cubre datasets, QLoRA y herramientas de entrenamiento, y la guía de serving con LoRAX cubre cómo servir muchos adaptadores sobre un modelo base.
Una secuencia práctica de adopción
- Define la tarea del usuario, los límites de daño, los objetivos de servicio y el margen de coste.
- Crea el manifiesto de versión antes de introducir un registro de prompts, una base de datos vectorial o un producto de gateway.
- Construye un conjunto de evaluación pequeño y dividido en slices, y tests deterministas por componente.
- Instrumenta una traza de extremo a extremo con controles de privacidad e identidades de versión estables.
- Promueve con tráfico en shadow, canary o limitado, con un disparador de rollback explícito.
- Convierte los fallos de producción revisados en casos de regresión y repite.
Añade infraestructura solo cuando haga una tarea que el manifiesto nombra o elimine un cuello de botella medido.
Referencias
- MLflow: evaluating production traces - Reutiliza trazas de producción para la evaluación y puntúa la información intermedia de la traza.
- MLflow: LLM and agent tracing - Captura los pasos intermedios y los metadatos de la traza para la investigación.
- OpenTelemetry GenAI semantic conventions - Convenciones actuales, en estado de desarrollo, para spans, métricas, eventos y datos específicos de proveedores de GenAI.
- NIST AI 600-1: Generative AI Profile - Categorías de riesgo de prompt injection, privacidad, seguridad y otras preocupaciones de la IA generativa.
- OWASP Top 10 for LLM Applications - Incluye la agencia excesiva (LLM06:2025) y la prompt injection (LLM01:2025).
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks - Arquitectura original de recuperar y luego generar.
- LoRA: Low-Rank Adaptation of Large Language Models - Pesos preentrenados congelados más matrices de bajo rango entrenables para la adaptación a tareas posteriores.
- PEFT LoRA reference - Parámetros de
LoraConfigyget_peft_model. - vLLM documentation - Motor de serving con continuous batching, cuantización, multi-LoRA y un servidor compatible con OpenAI.
- NVIDIA Dynamo-Triton - Servidor de inferencia antes llamado Triton Inference Server, con un backend TensorRT-LLM.
- LiteLLM Proxy - Gateway de código abierto con una API para todos los proveedores, presupuestos, límites de tasa y fallbacks.