MLOps vs. LLMOps: Infrastruktur für Foundation Models

Automatische Übersetzung
Dieser Artikel wurde automatisch aus der englischen Originalversion übersetzt.
Dieser Artikel richtet sich an ML- und Platform-Engineers, die bereits MLOps betreiben und nun ein System auf Basis eines Foundation Models verantworten. In einem solchen System kann eine Regression durch einen geänderten Prompt oder Index, eine geänderte Tool-Berechtigung oder eine geänderte Route entstehen, während die Model Weights gleich bleiben. Der Artikel behandelt, welche MLOps-Praktiken weiterhin gelten, was Sie zusätzlich versionieren müssen, wenn Prompts, Retrieval, Tools und Routing das Verhalten ändern können, wie Sie ein solches System evaluieren und tracen und welche Tools welche Aufgabe übernehmen.
Was MLOps bereits gelöst hat
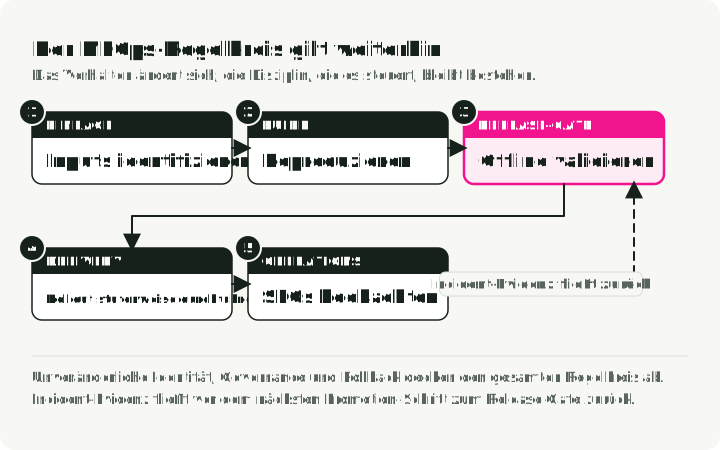
Jede Zeile des Diagramms ist ein Schritt des MLOps-Kreislaufs: was MLOps dort schon leistet und was ein Foundation-Model-System hinzufügt. Die gestrichelte Kante führt geprüfte Produktionsfehler als Tests zurück zur Offline-Prüfung. MLOps hat diese Praktiken etabliert, und sie gelten weiter, auch wenn das Model Text erzeugt:
- Lineage von Daten, Code, Konfiguration und Model bis zum Release
- reproduzierbare Training- oder Build-Pipelines
- Offline-Validierung vor der Beförderung
- Registries und unveränderliche Artefakt-Identität
- gestaffelter Rollout, Service-Level-Objectives, Rollback und Incident Response
- Infrastruktur-Telemetrie und Kapazitätsplanung
- Zugriffskontrolle, Aufbewahrung und Audit-Policy für Daten
Die meisten Orchestration-Tools, die Sie bereits betreiben, passen weiterhin, aber nicht auf jedem Pfad:
| Aufgabe | Tool | Einsatz, wenn |
|---|---|---|
| Batch-Fine-Tuning, geplante Index-Rebuilds, Evaluationsläufe | Airflow, Kubeflow Pipelines | Sie sie bereits für MLOps betreiben und der Job nach Zeitplan oder durch einen Trigger läuft. |
| Python-native Workflows | Metaflow, Flyte, ZenML | das Team Pipelines in Python schreibt und Schritte will, die ML-Bibliotheken direkt aufrufen. |
| Der Request-Pfad: Retrieval, Model aufrufen, Tools aufrufen | Anwendungscode | der Schritt einmal pro Request läuft und innerhalb von Sekunden antworten muss. Workflow-Scheduler sind für Batch-Jobs gebaut. |
Foundation Models beseitigen diese Anforderungen nicht. Sie machen aber den alten Begriff “Model-Version” zu klein.
Die Release-Einheit wurde zum System-Manifest
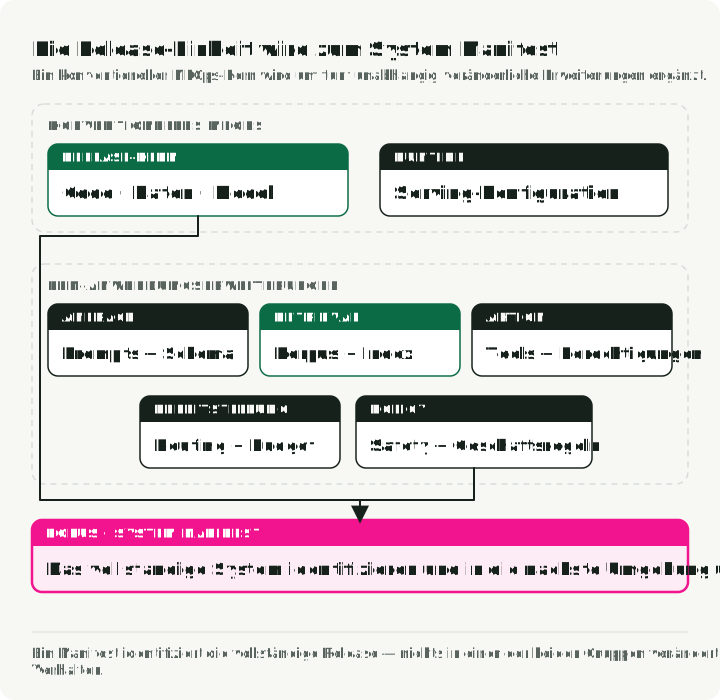
Das Diagramm zeigt das Manifest eines Support-Assistenten in zwei Releases. Die oberen Zeilen sind das, was MLOps bereits versioniert, die unteren Zeilen sind das, was ein Foundation-Model-System hinzufügt, und die hervorgehobenen Zeilen sind die einzigen Einträge, die sich geändert haben.
Für ein Foundation-Model-System empfehle ich ein Manifest, das mindestens Folgendes festhält:
application code revision
model provider + model/revision + serving configuration
system and task prompts
response schema + decoding parameters
retrieval corpus snapshot + parser + chunker + embedding model + index
tool definitions + implementation revisions + permission policy
routing, fallback, caching, and budget policy
safety and business-rule revisions
evaluation dataset + scorer revisions
Die genaue Liste hängt vom System ab. Die Regel lautet: Erfassen Sie jede unabhängig veränderliche Komponente, die das für Nutzer sichtbare Verhalten ändern kann.
Behandeln Sie den Model-Namen eines Anbieters als veränderlich, solange der Anbieter keine unveränderliche Revision dokumentiert. Ein Checkpoint-Hash hilft, selbst gehostete Weights zu identifizieren, aber ich würde trotzdem Runtime, Quantization, Chat-Template und Parallelisierungskonfiguration festhalten. Der Model-Eintrag stammt aus einer Registry: Nutzen Sie die MLflow Model Registry für Weights und Adapter, die Sie selbst trainieren, und den Hugging Face Hub für offene Weights, über das Argument revision auf einen Commit festgelegt statt auf einen Branch-Namen.
Speichern Sie das Manifest als Datei neben jedem Release. Wenn ein Release Regressionen verursacht, vergleichen Sie es mit dem vorherigen. In diesem Beispiel für einen Support-Assistenten haben sich nur der Antwort-Prompt und der Retrieval-Snapshot geändert:
-    answer: prompts/answer.md@v9
+    answer: prompts/answer.md@v10
-    corpus: kb-snapshot-2026-09-28
-    index: kb-idx-2026-09-28-01
+    corpus: kb-snapshot-2026-10-01
+    index: kb-idx-2026-10-01-01
Die Differenz nennt die Komponenten, die zuerst zu prüfen sind: den Antwort-Prompt und den neuen Index. Weights, Tools und Routing haben sich nicht geändert.
Welche Komponente zuerst prüfen
Die Manifest-Differenz zeigt, was sich geändert hat. Die Art des Fehlers zeigt, wo Sie suchen müssen, wenn die Differenz allein nichts erklärt:
| Fehler | Zuerst zu prüfende Komponente |
|---|---|
| Fehlende aktuelle oder private Fakten | Retrieval und Quellen-Synchronisierung |
| Falsches Format oder ungültige Argumente | Schema, Constrained Output, Validierung |
| Inkonsistentes Verhalten bei der Aufgabe | Prompt, Beispiele, Model-Wahl, dann Adaptationsdaten |
| Zu hohe Latency oder Kosten | Route, Kontext, Cache, Batching, Quantization |
| Nicht autorisierte oder unsichere Aktion | Tool-Berechtigungen und deterministische Policy |
| Domänenverhalten, das sich nicht aus dem Kontext ergibt | Fine-Tuning oder ein anderes spezialisiertes Model |
Für die Wahl zwischen Prompt ändern, Retrieval ergänzen und Fine-Tuning siehe Fine-Tuning vs. RAG vs. Prompting.
Fünf Komponenten, die das Verhalten ändern können
Die folgenden Abschnitte behandeln der Reihe nach fünf Komponenten aus dem Manifest-Diagramm: das Model und sein Serving, dann Prompts und Schema, den Retrieval-Korpus und Index, Tools und Berechtigungen sowie Sicherheits- und Geschäftsregeln. Jeder Abschnitt sagt, was Sie festhalten, was Sie testen und welche Tools die Aufgabe übernehmen. Routing und Fallback haben zusammen mit dem Gateway einen eigenen Abschnitt.
1. Model und Serving
Die erste Entscheidung ist, ob ein Anbieter das Model hostet oder Sie es selbst betreiben. Eine gehostete API erspart GPU-Arbeit. Jeder Request läuft über das Netzwerk, Sie zahlen pro Token, die gesendeten Daten verlassen Ihr Netzwerk, und der Anbieter kontrolliert Weights, Revisionen, Quoten und Preis. Selbst-Hosting gibt Ihnen die Kontrolle über Revision, Quantization, Batching, Region und Cache. Dafür betreiben Sie die GPU-Kapazität selbst und bezahlen sie, ob sie ausgelastet ist oder nicht.
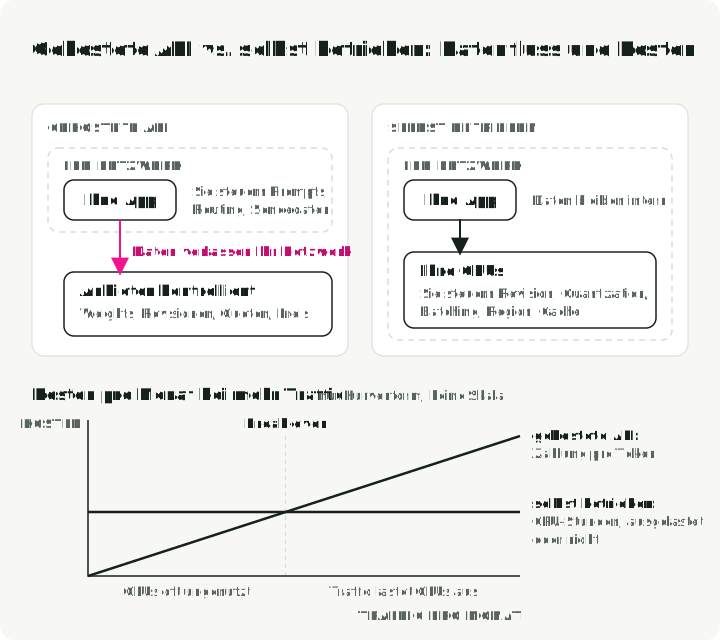
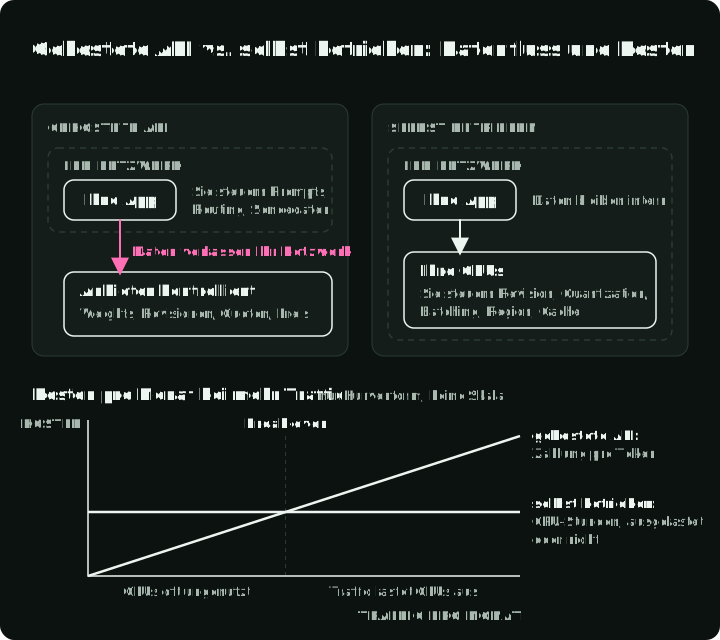
Der obere Teil des Diagramms zeigt, wohin die Daten gehen und wer in jedem Modus was kontrolliert. Das Diagramm darunter zeigt, wie die Kosten jedes Modus mit dem Traffic wachsen. Die Linien kreuzen sich beim Break-even-Traffic, an dem die monatliche GPU-Rechnung der API-Rechnung für dieselben Token entspricht. In beiden Modi hält das Manifest die Route fest, und dieselbe Task-Suite läuft.
Um den Break-even-Punkt zu finden, teilen Sie die GPU-Kosten pro Monat durch den API-Preis pro Token. Ein Beispiel mit Listenpreisen vom 7. Oktober 2026 für Llama 3.3 70B:
- Together AI berechnet $1,04 pro Million Token, für Input und Output.
- In FP8 belegen die 70 Milliarden Weights etwa 70 GB, das Model passt also auf zwei H100 GPUs mit je 80 GB, mit Platz für den KV cache. Lambda vermietet eine H100-SXM-Instanz mit zwei GPUs für $4,19 pro GPU und Stunde.
- Zwei GPUs für 730 Stunden (ein Monat) kosten 2 × 730 × $4,19 = $6.117.
- $6.117 ÷ $1,04 pro Million Token = etwa 5,9 Milliarden Token pro Monat, oder etwa 2.240 Token pro Sekunde, jede Sekunde des Monats.
Unterhalb dieses Traffics ist die API günstiger. Oberhalb ist Selbst-Hosting nur dann günstiger, wenn die zwei GPUs diese Rate bedienen können. Messen Sie den Throughput daher zuerst mit Ihren eigenen Prompts. Das Beispiel zählt nur die GPU-Miete. Engineering-Zeit, ein zweites Replikat für Verfügbarkeit und Speicher verschieben den Break-even-Punkt nach oben.
Wenn Sie selbst hosten, wählen Sie die Serving-Engine nach der Deployment-Form:
| Option | Einsatz, wenn |
|---|---|
| vLLM | Sie Open-Weight-Models auf eigenen GPUs betreiben und Throughput brauchen. Es bietet Continuous Batching, quantisierte Weights, viele feinabgestimmte Adapter auf einem Basismodel (siehe den LoRA-Abschnitt weiter unten) und einen OpenAI-kompatiblen Server. |
| Ollama | Sie Models für die lokale Entwicklung und für Tests auf einem Laptop ausführen. |
| NVIDIA Dynamo-Triton mit dem TensorRT-LLM-Backend | Sie NVIDIA-GPUs nutzen und für diese Hardware kompilierte Engines wollen oder einen Server für LLM- und Nicht-LLM-Models. Vor 2025 hieß es Triton Inference Server. |
| Serverless-GPU-Plattformen wie Modal | der Traffic unregelmäßig ist. Container können auf null skalieren; der nächste Request wartet dann auf einen Cold Start. Warme Container verwenden geladene Models und Caches weiter. Bewahren Sie dauerhaften Request-Zustand in persistentem Speicher auf. |
Models, die für eine GPU zu groß sind, brauchen beim Serving Tensor- oder Pipeline-Parallelismus; Skalierung von LLMs mit mehreren GPUs und Knoten erklärt jede Methode. Zur Wahl eines Weight-Formats für Runtime und Hardware siehe LLM-Quantisierungsformate.
Nehmen Sie in beiden Modi Latency, Fehler, Throughput, Auslastung, Kosten und Qualitätsprüfungen der Aufgabe in die Release-Entscheidung auf.
2. Prompts und Schema
Versionieren Sie bei einem System, das Requests zur Laufzeit zusammensetzt, den zusammengesetzten Request statt nur den Prompt-Text: Nachrichtenreihenfolge, Tool-Beschreibungen, Antwortschema, Decoding, Retries, Kürzung und der umgebende Code können jeweils das Verhalten ändern.
Eine kleine Prompt-Änderung kann das Ausgabeformat ändern. Hier sind drei Versionen eines Sentiment-Prompts:
v1: "Classify this text as positive or negative: {text}"
v2: "You are a sentiment analyzer. Classify: {text}"
v3: "Analyze sentiment. Return only 'positive' or 'negative': {text}"
v1 und v2 können einen Satz wie “The sentiment is positive.” zurückgeben. v3 verlangt ein einzelnes Wort. Der Code, der die Antwort parst, muss sich mit dem Prompt ändern, daher gehören Prompt, Schema und Parser gemeinsam ins Manifest.
Behandeln Sie parsbares JSON als Transportprüfung und testen Sie die Geschäftsinvarianten der Aufgabe getrennt davon.
3. Retrieval-Korpus und Index
Retrieval fügt zwischen der Quelle der Wahrheit und dem Model ein eigenständiges Datenprodukt ein:
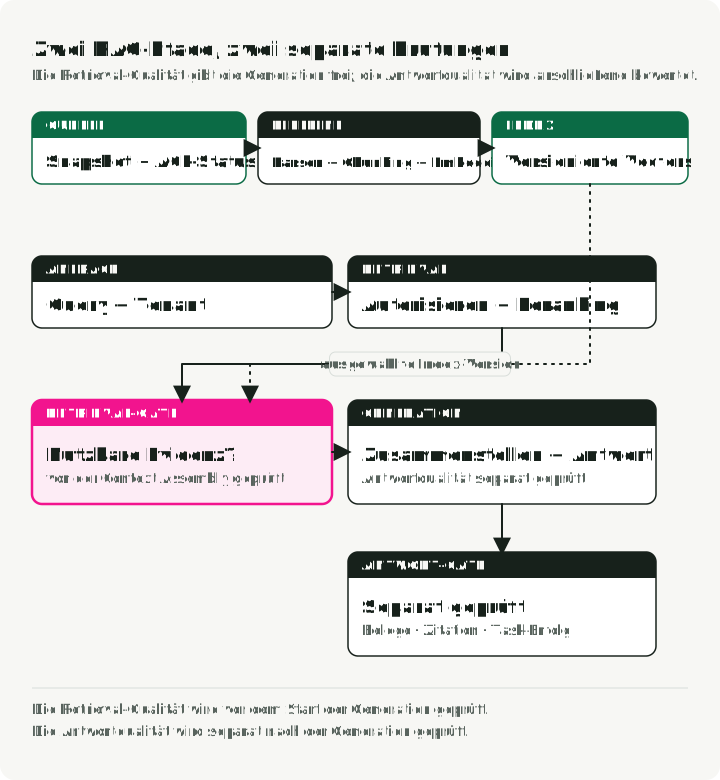
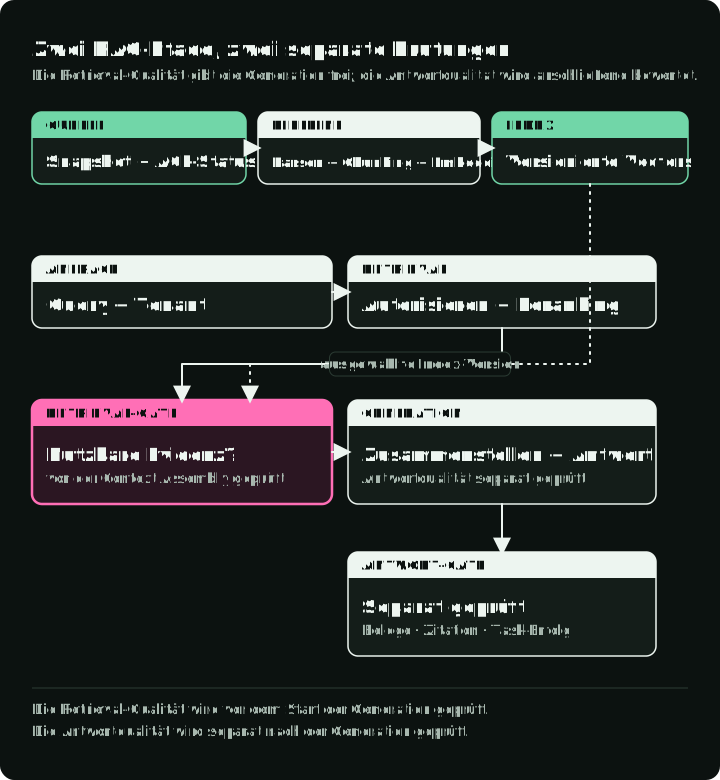
Die obere Zeile wird vor den Requests aufgebaut, und jeder Schritt hält eine Version fest. Die untere Zeile verfolgt einen Request, und die nummerierten Markierungen zeigen die drei getrennten Tests: Autorisierung, die abgerufenen Belege und die Antwort.
Halten Sie bei einem Retrieval-Augmented-System die Quellen-Revision, die Versionen von Parser und Chunker, die Embedding-Identität, den Index-Build, Metadaten zur Zugriffskontrolle und den Löschstatus fest. Das ursprüngliche RAG-Design trennt Retrieval und Generierung; nutzen Sie diese Trennung, um Belegsuche, Autorisierungsfilter und Belegnutzung unabhängig voneinander zu testen. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks beschreibt die Retrieve-then-Generate-Architektur. Metriken zur RAG-Evaluation behandelt die Metriken für jeden Check, und Tools zur RAG-Evaluation vergleicht die Bibliotheken, die sie berechnen.
Wählen Sie den Index-Speicher danach, wer ihn nutzt. Eine In-Process-Bibliothek wie FAISS reicht, wenn ein Service den Index besitzt und er in dessen Arbeitsspeicher passt. Nutzen Sie einen Vector-Database-Server wie Pinecone, Weaviate oder Milvus, wenn mehrere Services den Index teilen, wenn Sie zur Abfragezeit Metadatenfilter brauchen oder wenn der Index über eine Maschine hinauswächst. Zum Retrieval-Design selbst (ein Durchlauf, iterative Suche oder GraphRAG) siehe RAG-Architektur.
Wählen Sie die Update-Methode danach, wie veraltet eine Antwort sein darf. Ein geplanter Rebuild funktioniert, wenn eine einen Tag alte Antwort akzeptabel ist. Muss eine Änderung innerhalb von Minuten sichtbar sein, streamen Sie Updates, zum Beispiel Kafka-Events in einen Embedding-Job, der in den Index schreibt. Halten Sie bei einem unveränderlichen Snapshot fest, welcher Index-Build jede Antwort geliefert hat. Erfassen Sie bei einem veränderlichen Index außerdem die für die Abfrage sichtbare Ingestion-Revision oder, soweit verfügbar, den Fortschrittsstand (Watermark) sowie die Revisionen der abgerufenen Dokumente für jeden Request. Pinecones Log-Sequenznummern in Abfrageantworten zeigen, warum eine Schreibbestätigung allein nicht angibt, was eine Abfrage gesehen hat. Bewahren Sie unveränderliche Snapshots oder eine wiederabspielbare Quellenhistorie auf, wenn exaktes Daten-Replay nötig ist; ein Watermark allein kann überschriebene Inhalte nicht wiederherstellen.
Nutzen Sie einen Vector Index nicht als Ersatz für einen Feature Store oder ein Warehouse: Ähnlichkeitssuche, Point-in-Time-Features und analytische Fakten haben unterschiedliche Anforderungen an Abfragen und Konsistenz.
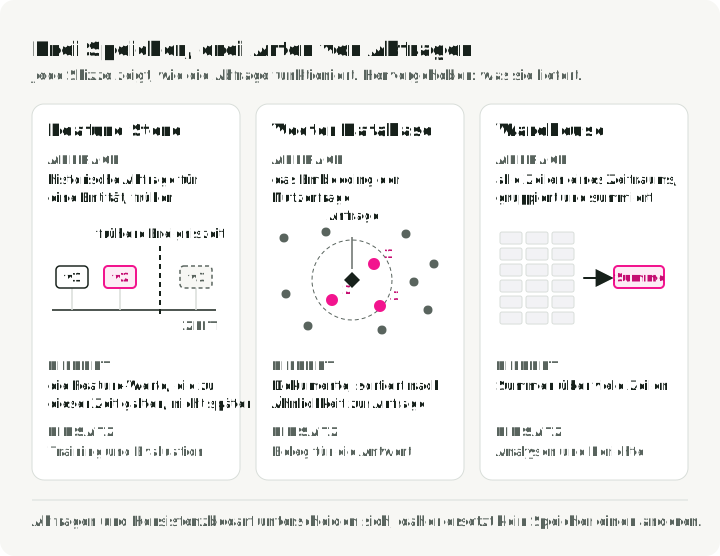
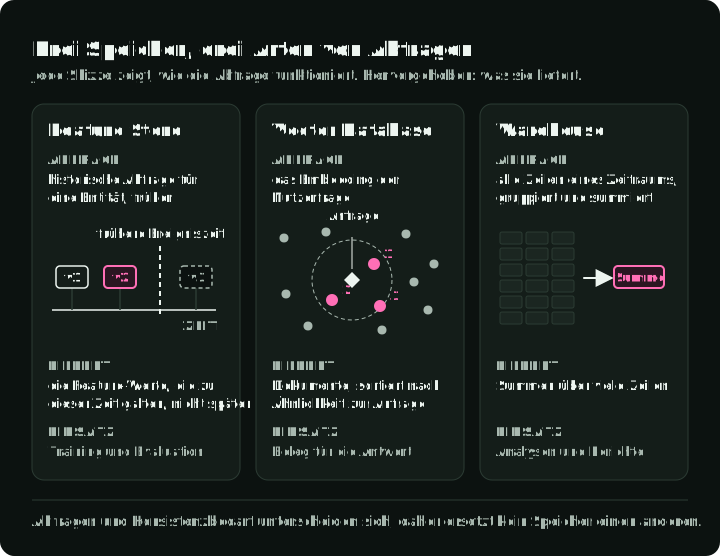
Die drei Karten vergleichen eine historische Feature-Abfrage, Ähnlichkeitssuche und Aggregation. Die historische Abfrage liefert Werte, die zum vergangenen Ereigniszeitpunkt gültig waren, eine Vector Database sortiert Dokumente nach Ähnlichkeit zur Anfrage, und ein Warehouse liefert Summen über viele Zeilen. Das Warehouse bleibt für Analysen.
In Feast erstellen historische Joins Trainings- und Evaluationsdaten für vergangene Ereigniszeitpunkte. Sein Online Store liefert die neuesten materialisierten Feature-Werte pro Entität mit niedriger Latency.
4. Tools und Berechtigungen
Wenn ein Model APIs aufrufen kann, legen Sie diese Checks um jeden Tool Call: Tool-Authentifizierung, Least Privilege, Argumentvalidierung, Timeouts, Idempotenz, Freigabe-Policy und Postcondition-Checks. Das Generative AI Profile des NIST benennt Risiken durch schädliche Inhalte, Datenschutz und Sicherheit.
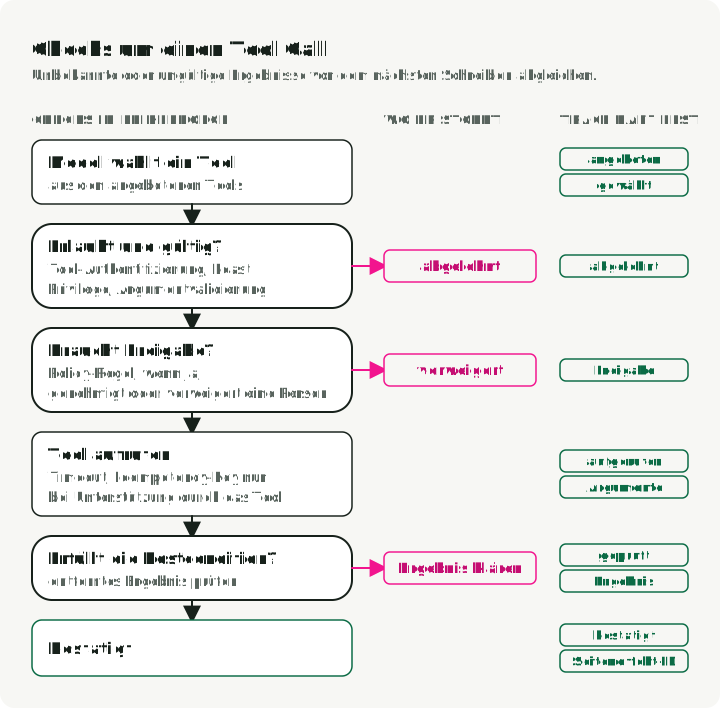
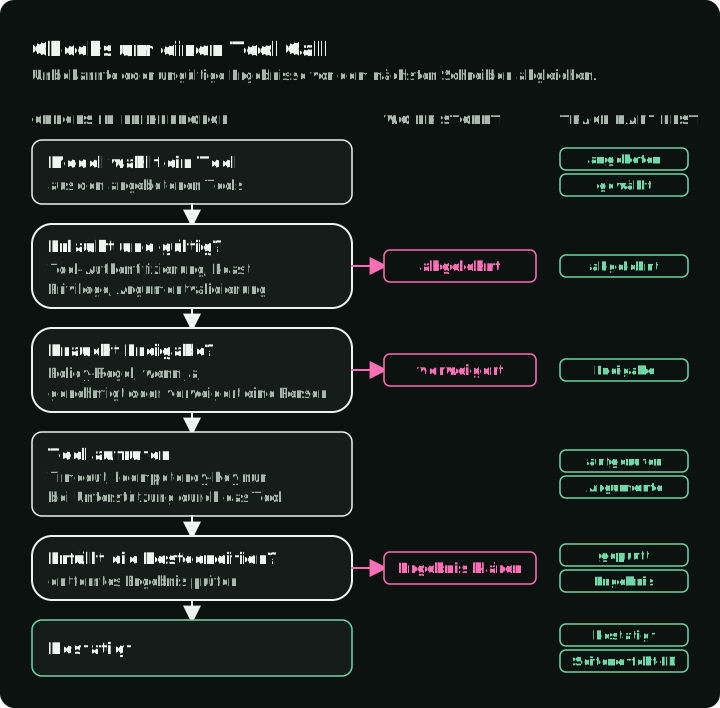
Das Diagramm zeigt diese Checks in Reihenfolge, wo ein Aufruf stoppt (bei einer abgelehnten Berechtigung oder einem abgelehnten Argument, einer verweigerten Freigabe oder einem Ergebnis, das nicht zur erwarteten Postcondition passt) und welches Trace-Event jeder Schritt festhält.
Ein Timeout kann das Ergebnis eines Schreibvorgangs offenlassen, obwohl der entfernte Dienst ihn bereits ausgeführt hat. Gleichen Sie das Ergebnis vor einem weiteren Schreibvorgang ab: Prüfen Sie die Operation oder Ressource oder verwenden Sie eine dokumentierte idempotente Wiederholung. Wiederholen Sie nur unter einem unterstützten Idempotenzvertrag oder mit einer anderen nachweislich sicheren Wiederherstellungsmethode; AWS erklärt die nötige Serverunterstützung. Ein erneut verwendeter Key kann den ursprünglichen Fehler zurückgeben, wie Stripes Idempotenzvertrag dokumentiert. Nutzen Sie eine unterstützte Kompensationsaktion, sofern verfügbar, und geben Sie ungeklärte Ergebnisse zur Prüfung weiter.
Tracen Sie, welches Tool angeboten, ausgewählt, aufgerufen, abgelehnt, wiederholt, abgeglichen und bestätigt wurde. Eine flüssige Endantwort beweist nicht, dass der Aktionspfad korrekt war.
5. Sicherheits- und Geschäftsregeln
Content-Filter sind eine Kontrolle, keine vollständige Guardrail-Schicht. Zu den Bedrohungen gehören außerdem Prompt Injection, mandantenübergreifendes Retrieval, Offenlegung von Secrets, übermäßige Handlungsfreiheit (Excessive Agency, ein Eintrag in den OWASP Top 10 for LLM Applications), nicht vertrauenswürdige Model-Dateien oder benutzerdefinierter Code, der zur Laufzeit geladen wird, und unsichere Tool-Argumente.
Formulieren Sie deterministische Geschäftsregeln wenn möglich außerhalb des Models. Definieren Sie Restrisiken, testen Sie Angriffsfälle und benennen Sie einen Verantwortlichen für Policy-Änderungen. Das Generative AI Profile des NIST ist ein nützliches Risikoinventar, kein fertiger Abnahmetest.
Evaluation entscheidet über das Release
Verlassen Sie sich bei Release-Entscheidungen für Freitext-Ausgaben nicht auf eine einzige aggregierte Accuracy-Zahl. Nutzen Sie mehrere Arten von Belegen und legen Sie fest, welche für welchen Fehlermodus maßgeblich ist.
Ein Evaluation-Stack für ein Foundation-Model-System hat sechs Schichten:
- Deterministische Checks: Schema-Gültigkeit, vorhandene Zitate, erlaubte Tools, Argument-Constraints, Policy-Regeln, Latency und Budget.
- Komponenten-Metriken: Retrieval-Recall und Ranking, Genauigkeit der Tool-Auswahl, Korrektheit der Tool-Argumente und Routenwahl.
- End-to-End-Aufgaben: repräsentative Eingaben mit expliziten Erfolgskriterien und Slice-Labels.
- Model-basiertes Scoring: rubrikgestützte Bewertungen, kalibriert an Expertenlabels und auf Judge Drift überwacht.
- Menschliche Prüfung: mehrdeutige, folgenreiche, neuartige oder stichprobenartig gezogene Fälle, in denen Automatisierung nicht maßgeblich ist.
- Adversarial Tests: Fälle zu Injection, Datengrenzen, Missbrauch, Refusal und Seiteneffekten, abgeleitet aus dem Threat Model.
Speichern Sie Ergebnisse pro Beispiel, nicht nur Durchschnitte, damit das Release-Review Regressionen nach Sprache, Mandant, Dokumenttyp oder Aktionsklasse untersuchen kann.
Vergleichen Sie für eine Deployment-Entscheidung ein Kandidaten-Manifest mit dem aktuellen Release auf derselben versionierten Suite. Legen Sie Schwellenwerte für Qualität, Sicherheit, Latency und Kosten gemeinsam fest und lehnen Sie eine günstigere Route ab, die die Task-Suite nicht besteht.
Liegt jedes Ergebnis innerhalb seines Schwellenwerts, starten Sie einen gestaffelten Rollout. Fällt eines durch, lehnen Sie den Kandidaten ab. Ist ein Slice-Ergebnis unklar, geben Sie es zur menschlichen Prüfung weiter.
Zur Wahl eines Evaluation-Tools für Traces, Datasets und CI-Checks siehe Tools zur Evaluation von AI Agents.
Traces verbinden den Produktivbetrieb mit der Evaluation
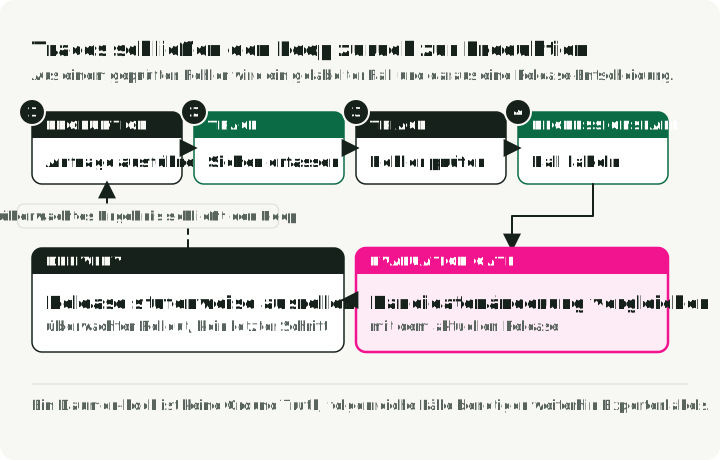
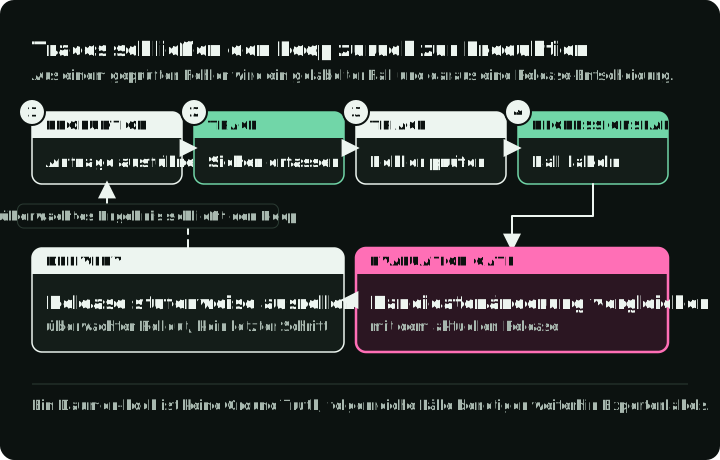
Der obere Teil des Diagramms ist der Trace eines Requests. Metriken sehen den langsamen Model-Aufruf; nur der Trace zeigt das nicht autorisierte Dokument und das falsche Konto. Die untere Zeile zeigt, was danach geschieht: Der geprüfte Fehler wird zu einem gelabelten Regressionsfall, die Evaluation vergleicht eine Kandidaten-Änderung mit dem aktuellen Release, und die gestrichelte Kante führt das gestaffelte Release zurück in die Produktion.
Infrastruktur-Metriken können einen langsamen Model-Aufruf zeigen. Sie können nicht zeigen, dass das Retrieval ein nicht autorisiertes Dokument geliefert hat oder dass ein Tool mit dem falschen Konto aufgerufen wurde. Die Tracing-Dokumentation von MLflow beschreibt Traces, die Zwischenschritte und Metadaten erfassen, die zur Untersuchung dieses Pfads nötig sind.
Erfassen Sie einen Trace entlang des Entscheidungspfads:
- Identität des Release-Manifests und Request-Korrelation
- Aufrufe an Models und Anbieter, Latency, Nutzung und Endzustand
- Retrieval-Abfrage, für die Abfrage sichtbare Index-Revision oder Watermark, Dokument-IDs und Revisionen, Scores und Filterentscheidungen
- Revision von Prompt und Template, ohne wahllos sensible Inhalte zu speichern
- Tool-Angebote, Argumente, Freigaben, Ergebnisse und IDs von Seiteneffekten
- Policy-Entscheidungen, Retries, Fallbacks und das Endergebnis
Traces sind ein neuer Speicher für sensible Daten. Wenden Sie Datenminimierung, Schwärzung, Mandantentrennung, Verschlüsselung, Sampling, Aufbewahrung und Zugriffsprüfung an, bevor Sie vollständige Prompts oder Dokumente erfassen. Die GenAI Semantic Conventions von OpenTelemetry können die Interoperabilität erleichtern, sind aber noch in Entwicklung. Legen Sie die Version der Convention oder des Schemas sowie die Versionen von Instrumentierung und Collector fest.
Nutzerfeedback kann die Untersuchung priorisieren, aber ein Daumen nach oben ist keine Ground Truth. Bewahren Sie den umgebenden Trace auf und holen Sie bei folgenreichen Fällen Expertenlabels ein. Label Studio sammelt Labels für Text, Bilder und andere Datentypen; Argilla sammelt Feedback zu Text und LLM-Ausgaben und kann die Datasets in den Hugging Face Hub pushen. Evaluation von AI Agents im Produktivbetrieb zeigt, wie Sie gelabelte Traces in eine versionierte Regressions-Suite verwandeln.
Das Serving-Gateway verantwortet Routing und Policy
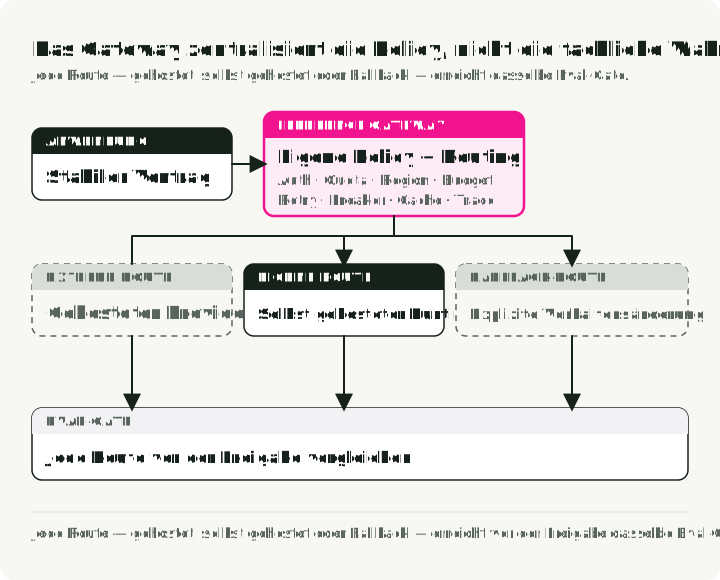
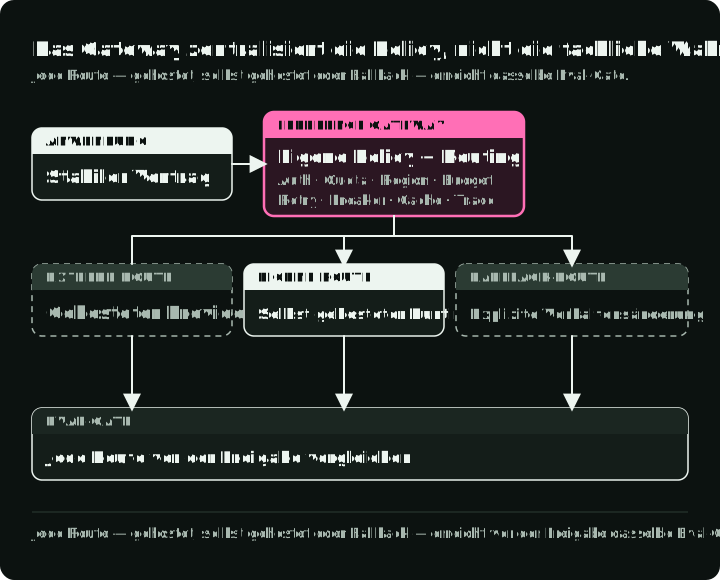
Im Diagramm nimmt jeder Request eine Route durch das Gateway: nach Tarif, nach einem kleinen Traffic-Anteil für ein neues Model oder zu einem Fallback, wenn der Anbieter ausfällt. Jede Route liefert denselben Antwortvertrag zurück, und die Task-Suite evaluiert jede Route vor der Beförderung offline.
Ein Gateway kann Anwendungs-Clients von Anbietern oder selbst betriebenen Engines entkoppeln. Zu den Aufgaben, die sich dort lohnen, gehören:
- Authentifizierung, Mandantenbudgets, Quoten und Rate Limits
- stabile Request- und Response-Verträge
- Routenwahl nach Fähigkeit, Region, Latency oder evaluierter Qualität
- Routing nach Abo-Stufe, zum Beispiel ein größeres Model für kostenpflichtige Tarife
- einen kleinen Traffic-Anteil vor dem vollständigen Rollout an ein neues Model senden
- begrenzte Retries, Circuit Breaker und explizite Fallback-Semantik
- Cache-Partitionierung und Policy für sensible Daten
- Nutzungszuordnung und Weitergabe des Release-Manifests
LiteLLM Proxy ist ein Open-Source-Gateway: Es stellt viele Anbieter über eine OpenAI-kompatible API bereit und setzt Budgets und Rate Limits pro Key oder Team.
Fallback ist ebenso eine Verhaltensänderung wie ein Zuverlässigkeitsmechanismus. Wenn ein kleineres Model, ein alternativer Anbieter oder ein reduzierter Kontext die Qualität der Aufgabe ändert, evaluieren und tracen Sie diesen Zweig als eigene Route.
Legen Sie nicht jede Orchestration-Entscheidung ins Gateway. Halten Sie Domänenregeln nah an der Anwendung und machen Sie die Zuständigkeit sichtbar.
Fine-Tuning und LoRA
Die letzte Zeile der Fehlertabelle in “Welche Komponente zuerst prüfen” ist der Fall für Fine-Tuning: Das Verhalten, das die Aufgabe braucht, lässt sich weder aus dem Prompt noch aus dem abgerufenen Kontext gewinnen. LoRA friert vortrainierte Weights ein und fügt trainierbare Low-Rank-Matrizen hinzu, wodurch die Zahl der trainierbaren Parameter für die Downstream-Aufgabe sinkt. Diese Optimierung beseitigt weder Dataset-Governance noch Lizenzfragen des Basismodels, Evaluation, Serving-Kompatibilität oder Rollback-Anforderungen.
Halten Sie die Adapter-Einstellungen im Manifest neben der Revision des Basismodels fest: den Rang (r), den Skalierungsfaktor (lora_alpha) und die Schichten, die er verändert (target_modules). Jede dieser Einstellungen ändert, was der Adapter lernt. Die Anleitung zum LLM-Fine-Tuning behandelt Datasets, QLoRA und Trainings-Tools, und die Anleitung zum LoRAX-Serving behandelt das Serving vieler Adapter auf einem Basismodel.
Eine praktische Einführungsreihenfolge
- Definieren Sie die Nutzeraufgabe, Schadensgrenzen, Service-Ziele und den Kostenrahmen.
- Erstellen Sie das Release-Manifest, bevor Sie eine Prompt-Registry, eine Vector Database oder ein Gateway-Produkt einführen.
- Bauen Sie ein kleines, nach Slices aufgeteiltes Evaluations-Set und deterministische Komponententests.
- Instrumentieren Sie einen End-to-End-Trace mit Datenschutzkontrollen und stabilen Release-Identitäten.
- Befördern Sie über Shadow-, Canary- oder Limited-Traffic mit einem expliziten Rollback-Trigger.
- Machen Sie aus geprüften Produktionsfehlern Regressionsfälle und wiederholen Sie den Ablauf.
Ergänzen Sie Infrastruktur nur, wenn sie eine Aufgabe erfüllt, die das Manifest benennt, oder einen gemessenen Bottleneck beseitigt.
Referenzen
- MLflow: evaluating production traces - Produktions-Traces für die Evaluation wiederverwenden und Zwischeninformationen aus Traces bewerten.
- MLflow: LLM and agent tracing - Zwischenschritte und Trace-Metadaten für die Untersuchung erfassen.
- OpenTelemetry GenAI semantic conventions - Aktuelle Conventions im Entwicklungsstatus für GenAI-Spans, Metriken, Events und anbieterspezifische Daten.
- NIST AI 600-1: Generative AI Profile - Risikokategorien für Prompt Injection, Datenschutz, Sicherheit und verwandte Themen der generativen AI.
- OWASP Top 10 for LLM Applications - Enthält Excessive Agency (LLM06:2025) und Prompt Injection (LLM01:2025).
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks - Ursprüngliche Retrieve-then-Generate-Architektur.
- LoRA: Low-Rank Adaptation of Large Language Models - Eingefrorene vortrainierte Weights plus trainierbare Low-Rank-Matrizen für die Downstream-Anpassung.
- PEFT LoRA reference -
LoraConfig-Parameter undget_peft_model. - vLLM documentation - Serving-Engine mit Continuous Batching, Quantization, Multi-LoRA und einem OpenAI-kompatiblen Server.
- NVIDIA Dynamo-Triton - Inference Server, früher Triton Inference Server genannt, mit einem TensorRT-LLM-Backend.
- LiteLLM Proxy - Open-Source-Gateway mit einer API für mehrere Anbieter, Budgets, Rate Limits und Fallbacks.