MLOps vs LLMOps: infraestrutura para foundation models

Tradução automática
Este artigo foi traduzido automaticamente a partir da versão original em inglês.
Este artigo destina-se a engenheiros de ML e de plataforma que já praticam MLOps e agora operam um sistema construído sobre um foundation model. Num sistema destes, uma regressão pode vir de um prompt, de um índice, de uma permissão de ferramenta ou de uma rota alterados, mesmo que os pesos do modelo não mudem. O artigo explica que práticas de MLOps continuam a aplicar-se, o que mais é preciso versionar quando prompts, retrieval, ferramentas e routing podem mudar o comportamento, como avaliar e fazer o tracing desse sistema, e que ferramentas fazem cada tarefa.
O que o MLOps já resolveu
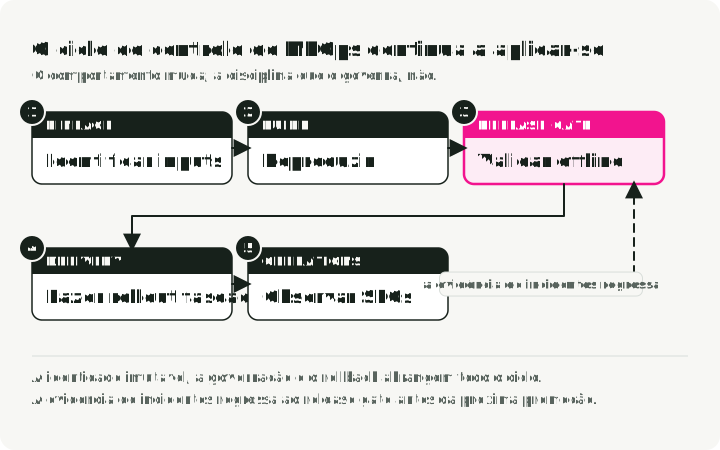
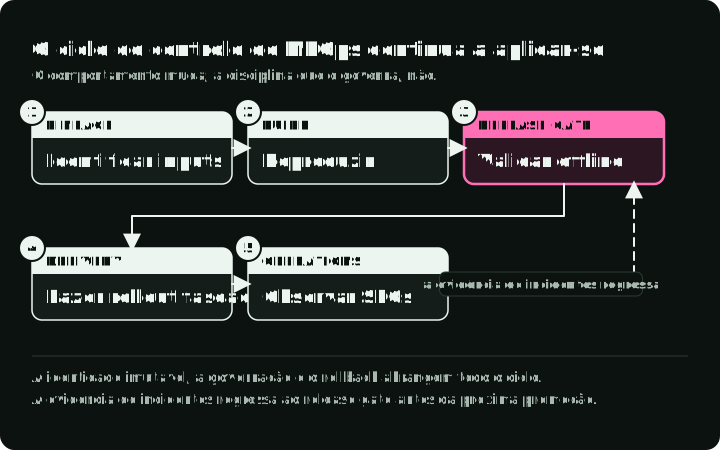
Cada linha do diagrama é um passo do ciclo de MLOps: o que o MLOps já faz nesse ponto e o que um sistema baseado em foundation model acrescenta. A aresta tracejada leva as falhas de produção revistas de volta à verificação offline, sob a forma de testes. O MLOps estabeleceu estas práticas, e elas continuam a aplicar-se quando o modelo gera texto:
- linhagem desde os dados, o código, a configuração e o modelo até um release
- pipelines de treino ou de build repetíveis
- validação offline antes da promoção
- registos e identidade imutável dos artefactos
- rollout faseado, objetivos de nível de serviço, rollback e resposta a incidentes
- telemetria de infraestrutura e planeamento de capacidade
- controlo de acesso, retenção e política de auditoria para os dados
A maior parte das ferramentas de orquestração que já usa continua a servir, mas não em todos os caminhos:
| Tarefa | Ferramenta | Use quando |
|---|---|---|
| Fine-tuning em lote, reconstruções agendadas do índice, execuções de avaliação | Airflow, Kubeflow Pipelines | Já as usa para MLOps e a tarefa corre de forma agendada ou por um gatilho. |
| Workflows nativos em Python | Metaflow, Flyte, ZenML | A equipa escreve pipelines em Python e quer passos que chamem diretamente bibliotecas de ML. |
| O caminho do pedido: fazer retrieval, chamar o modelo, chamar ferramentas | Código da aplicação | O passo corre uma vez por pedido e tem de responder em segundos. Os agendadores de workflows são feitos para tarefas em lote. |
Os foundation models não eliminam estas necessidades. Tornam a antiga expressão “versão do modelo” demasiado pequena.
A unidade de release passou a ser um manifesto do sistema
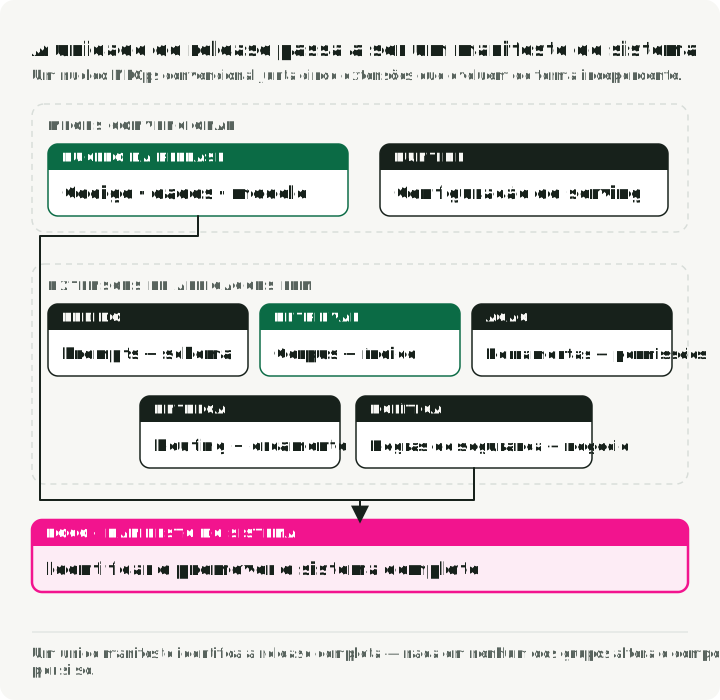
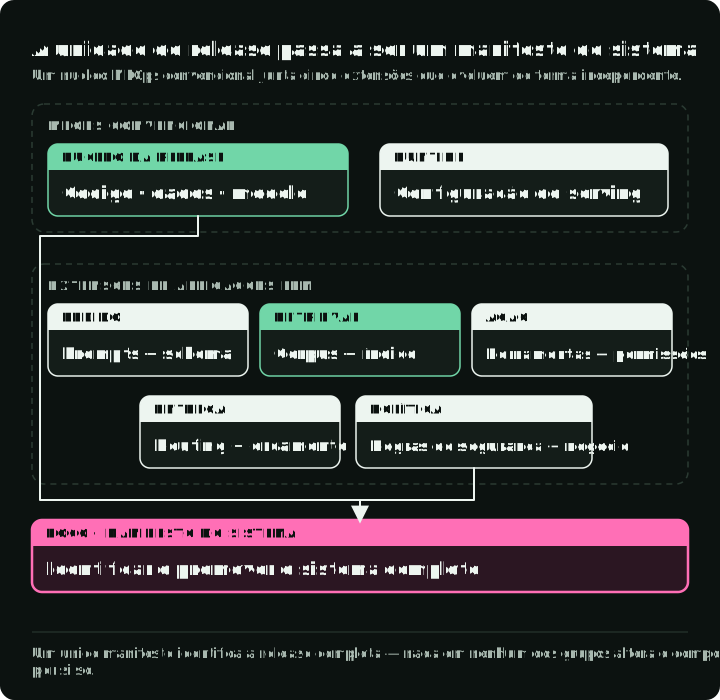
O diagrama mostra o manifesto de um assistente de suporte em dois releases. As linhas de cima são o que o MLOps já versiona, as linhas de baixo são o que um sistema baseado em foundation model acrescenta, e as linhas destacadas são as únicas entradas que mudaram.
Para um sistema baseado em foundation model, recomendo um manifesto que registe pelo menos:
application code revision
model provider + model/revision + serving configuration
system and task prompts
response schema + decoding parameters
retrieval corpus snapshot + parser + chunker + embedding model + index
tool definitions + implementation revisions + permission policy
routing, fallback, caching, and budget policy
safety and business-rule revisions
evaluation dataset + scorer revisions
A lista exata depende do sistema. A regra é identificar cada componente que muda de forma independente e que pode alterar o comportamento visível para o utilizador.
Trate o nome de um modelo de um fornecedor como mutável, a menos que o fornecedor documente uma revisão imutável. O hash de um checkpoint ajuda a identificar pesos auto-alojados, mas eu continuaria a registar o runtime, a quantização, o chat template e a configuração de paralelismo. A entrada do modelo vem de um registo: use o MLflow Model Registry para pesos e adaptadores que treina, e o Hugging Face Hub para pesos abertos, fixados a um commit com o argumento revision em vez de um nome de branch.
Guarde o manifesto como um ficheiro junto de cada release. Quando um release regride, compare-o com o anterior. Neste exemplo de um assistente de suporte, só mudaram o prompt de resposta e o snapshot do retrieval:
-    answer: prompts/answer.md@v9
+    answer: prompts/answer.md@v10
-    corpus: kb-snapshot-2026-09-28
-    index: kb-idx-2026-09-28-01
+    corpus: kb-snapshot-2026-10-01
+    index: kb-idx-2026-10-01-01
O diff indica os componentes a verificar primeiro: o prompt de resposta e o novo índice. Os pesos, as ferramentas e o routing não mudaram.
Que componente inspecionar primeiro
O diff do manifesto diz o que mudou. O tipo de falha diz onde procurar quando o diff, por si só, não explica o problema:
| Falha | Primeiro componente a inspecionar |
|---|---|
| Faltam factos atuais ou privados | retrieval e sincronização das fontes |
| Formato errado ou argumentos inválidos | schema, saída restrita, validação |
| Comportamento inconsistente na tarefa | prompt, exemplos, escolha do modelo e, depois, dados de adaptação |
| Latência ou custo excessivos | rota, contexto, cache, batching, quantização |
| Ação não autorizada ou insegura | permissões das ferramentas e política determinística |
| Comportamento de domínio não recuperável a partir do contexto | fine-tuning ou outro modelo especializado |
Para escolher entre alterar o prompt, acrescentar retrieval e fazer fine-tuning, veja fine-tuning vs RAG vs prompting.
Cinco componentes que podem alterar o comportamento
As secções seguintes tratam, por ordem, cinco componentes do diagrama do manifesto: o modelo e o seu serving, depois os prompts e o schema, o corpus e o índice de retrieval, as ferramentas e as permissões, e as regras de segurança e de negócio. Cada secção indica o que registar, o que testar e que ferramentas fazem o trabalho. O routing e o fallback têm uma secção própria, com o gateway.
1. Modelo e serving
A primeira decisão é saber se um fornecedor aloja o modelo ou se o serve você mesmo. Uma API alojada elimina o trabalho com GPUs. Cada pedido atravessa a rede, paga-se por token, os dados que envia saem da sua rede, e o fornecedor controla os pesos, as revisões, as quotas e o preço. Com o auto-alojamento, controla a revisão, a quantização, o batching, a região e a cache. Também passa a gerir a capacidade de GPU, e paga por ela esteja ocupada ou ociosa.
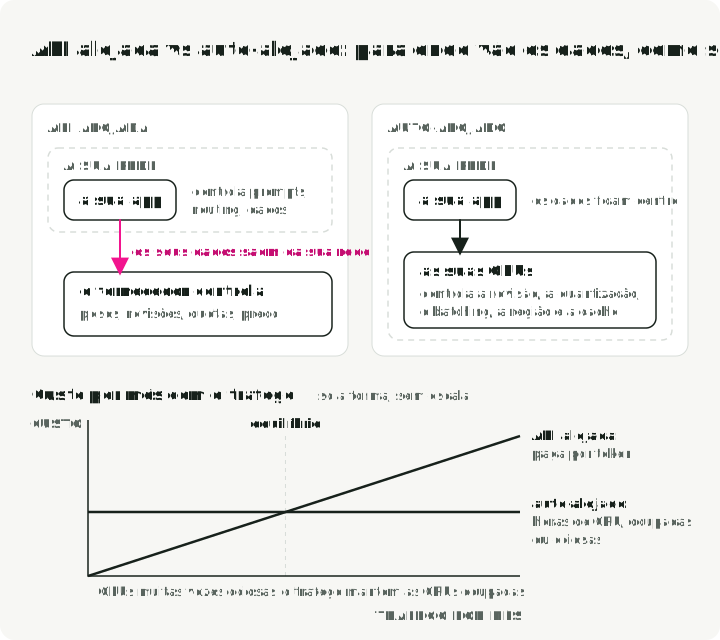
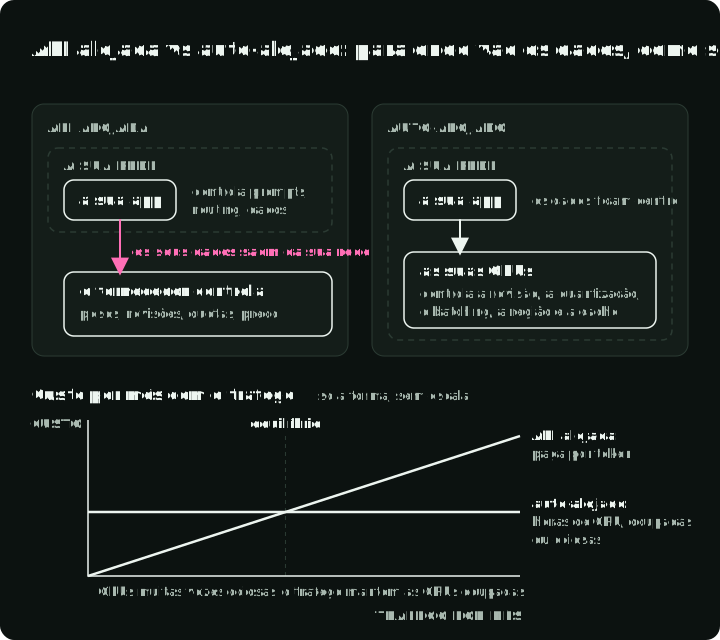
A parte de cima do diagrama mostra para onde vão os dados e quem controla o quê em cada modo. O gráfico por baixo mostra como o custo de cada modo cresce com o tráfego. As linhas cruzam-se no tráfego de equilíbrio, em que a fatura mensal das GPUs é igual à fatura da API para os mesmos tokens. Em ambos os modos, o manifesto regista a rota e corre-se o mesmo conjunto de tarefas.
Para encontrar o ponto de equilíbrio, divida o custo mensal das GPUs pelo preço da API por token. Um exemplo com preços de tabela em 7 de outubro de 2026 para o Llama 3.3 70B:
- A Together AI cobra $1.04 por milhão de tokens, de entrada ou de saída.
- Em FP8, os 70 mil milhões de pesos ocupam cerca de 70 GB, pelo que o modelo cabe em duas GPUs H100 de 80 GB, com espaço para a KV cache. A Lambda aluga uma instância com duas H100 SXM a $4.19 por GPU por hora.
- Duas GPUs durante 730 horas (um mês) custam 2 × 730 × $4.19 = $6,117.
- $6,117 ÷ $1.04 por milhão de tokens = cerca de 5,9 mil milhões de tokens por mês, ou cerca de 2240 tokens por segundo, em todos os segundos do mês.
Abaixo deste tráfego, a API sai mais barata. Acima dele, o auto-alojamento só sai mais barato se as duas GPUs conseguirem servir esse débito, por isso meça primeiro o débito com os seus próprios prompts. O exemplo conta apenas o aluguer das GPUs. O tempo de engenharia, uma segunda réplica para disponibilidade e o armazenamento deslocam o ponto de equilíbrio para cima.
Se fizer auto-alojamento, escolha o motor de serving conforme a forma do deployment:
| Opção | Use quando |
|---|---|
| vLLM | Serve modelos de pesos abertos nas suas próprias GPUs e precisa de débito. Oferece continuous batching, pesos quantizados, muitos adaptadores de fine-tuning num único modelo base (veja a secção sobre LoRA mais abaixo) e um servidor compatível com OpenAI. |
| Ollama | Corre modelos num portátil para desenvolvimento e testes locais. |
| NVIDIA Dynamo-Triton com o backend TensorRT-LLM | Usa GPUs NVIDIA e quer engines compilados para esse hardware, ou um único servidor para modelos LLM e não LLM. Antes de 2025 chamava-se Triton Inference Server. |
| Plataformas de GPU serverless, como a Modal | O tráfego é irregular. Os contentores podem escalar para zero, pelo que o pedido seguinte espera então por um arranque a frio. Os contentores ativos reutilizam os modelos e as caches carregados. Guarde o estado duradouro dos pedidos em armazenamento persistente. |
Os modelos grandes demais para uma única GPU precisam de paralelismo de tensores ou de pipeline no serving; Escalar LLMs com paralelismo em várias GPUs e vários nós explica cada método. Para escolher um formato de pesos para o runtime e o hardware, veja Formatos de quantização de LLMs.
Em qualquer dos modos, inclua verificações de latência, erros, débito, saturação, custo e qualidade da tarefa na decisão de release.
2. Prompts e schema
Num sistema que monta os pedidos em tempo de execução, versione o pedido montado e não apenas o texto do prompt: a ordem das mensagens, as descrições das ferramentas, o schema da resposta, o decoding, as repetições, o truncamento e o código envolvente podem, cada um, alterar o comportamento.
Uma pequena alteração no prompt pode mudar o formato da saída. Aqui estão três versões de um prompt de sentimento:
v1: "Classify this text as positive or negative: {text}"
v2: "You are a sentiment analyzer. Classify: {text}"
v3: "Analyze sentiment. Return only 'positive' or 'negative': {text}"
v1 e v2 podem devolver uma frase como “The sentiment is positive.” O v3 pede uma só palavra. O código que interpreta a resposta tem de mudar com o prompt, por isso o prompt, o schema e o parser entram juntos no manifesto.
Trate o JSON interpretável como uma verificação de transporte e teste as invariantes de negócio da tarefa em separado.
3. Corpus e índice de retrieval
O retrieval acrescenta um produto de dados independente entre a fonte de verdade e o modelo:
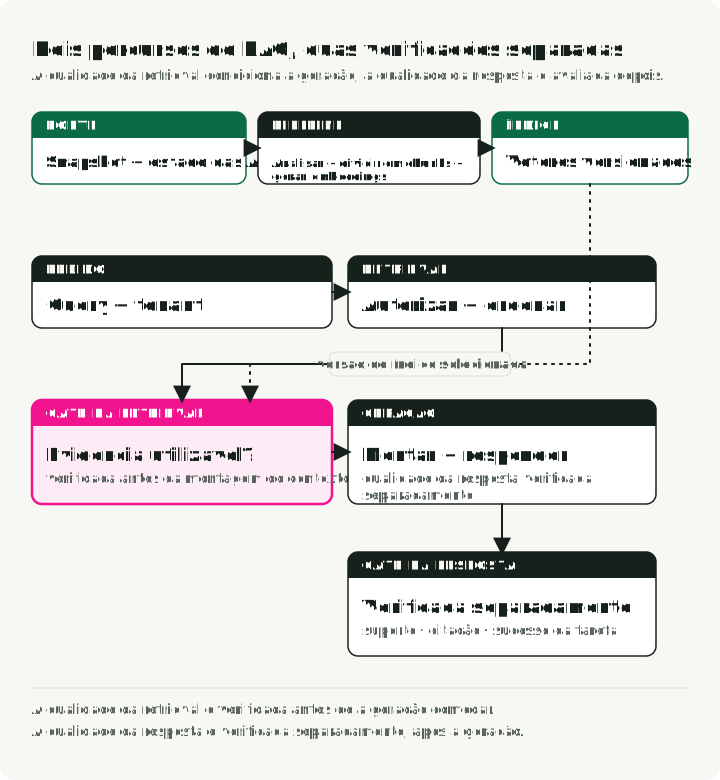
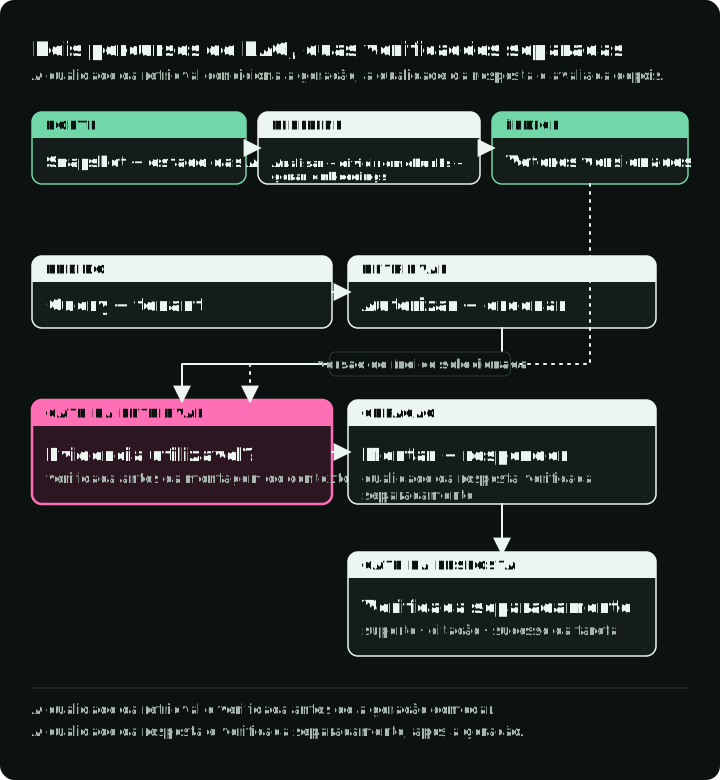
A linha de cima é construída antes dos pedidos, e cada passo regista uma versão. A linha de baixo segue um pedido, e as marcas numeradas mostram os três testes separados: a autorização, a evidência recuperada e a resposta.
Num sistema com retrieval aumentado, conserve a revisão da fonte, as versões do parser e do chunker, a identidade dos embeddings, o build do índice, os metadados de controlo de acesso e o estado de eliminação. O desenho original do RAG separa o retrieval da geração; use essa separação para testar de forma independente a recuperação da evidência, o filtro de autorização e o uso da evidência. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks descreve a arquitetura de recuperar e depois gerar. Métricas de avaliação de RAG cobre as métricas de cada verificação, e Ferramentas de avaliação de RAG compara as bibliotecas que as calculam.
Escolha o armazenamento do índice consoante quem o usa. Uma biblioteca em processo, como a FAISS, basta quando um único serviço é dono do índice e este cabe na memória desse serviço. Use um servidor de base de dados vetorial, como Pinecone, Weaviate ou Milvus, quando vários serviços partilham o índice, quando precisa de filtros de metadados no momento da consulta, ou quando o índice deixa de caber numa máquina. Para o desenho do retrieval em si (uma passagem, pesquisa iterativa ou GraphRAG), veja Arquitetura RAG.
Escolha o método de atualização conforme o quão desatualizada uma resposta pode estar. Uma reconstrução agendada serve quando uma resposta com um dia é aceitável. Quando uma alteração tem de aparecer em minutos, faça streaming das atualizações, por exemplo com eventos Kafka que alimentam um job de embeddings que escreve no índice. Para um snapshot imutável, registe que build do índice serviu cada resposta. Para um índice mutável, registe também no trace a revisão de ingestão ou o marcador de progresso (watermark) visível à consulta, quando disponível, e as revisões dos documentos recuperados em cada pedido. Os números de sequência do registo nas respostas às consultas da Pinecone mostram por que razão um comprovativo de escrita, por si só, não identifica o que uma consulta viu. Conserve snapshots imutáveis ou um histórico das fontes que possa ser reproduzido se for necessária uma reprodução exata dos dados; um watermark não permite recuperar conteúdo substituído.
Não use um índice vetorial como substituto de uma feature store ou de um data warehouse: a recuperação por semelhança, as features point-in-time e os factos analíticos têm necessidades de consulta e de consistência diferentes.
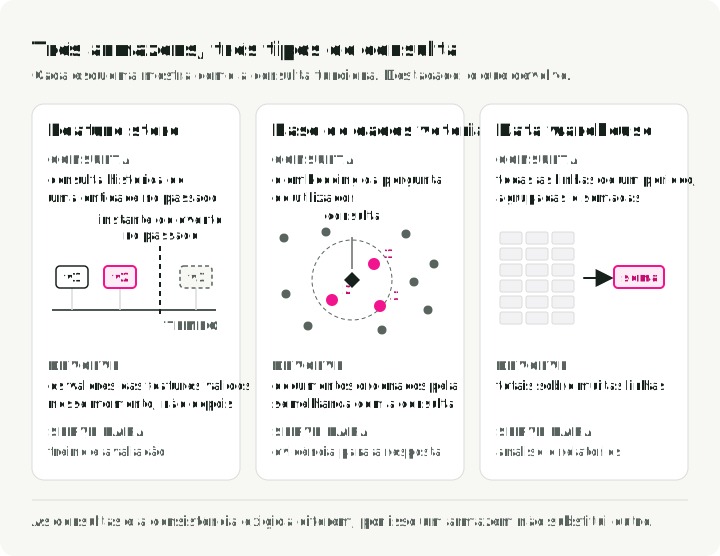
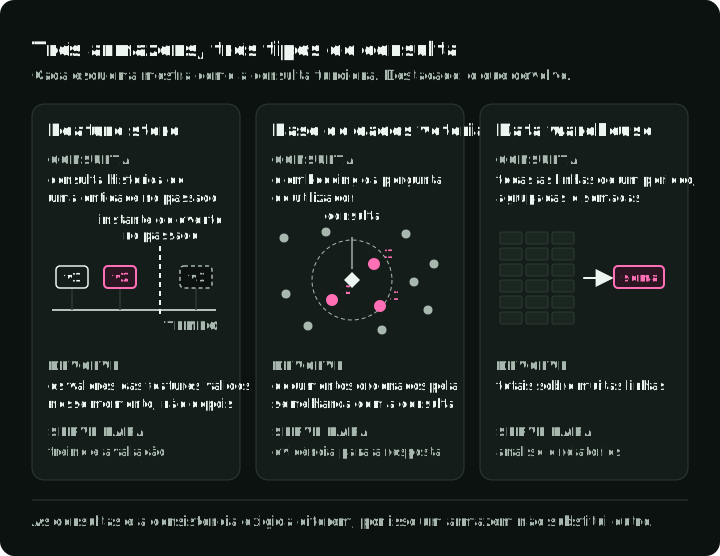
Os três cartões comparam uma consulta histórica de features, a recuperação por semelhança e a agregação. A consulta histórica devolve os valores válidos no instante passado do evento, uma base de dados vetorial ordena os documentos pela semelhança com a consulta, e um data warehouse devolve totais sobre muitas linhas. Mantenha o data warehouse para a análise.
No Feast, as junções históricas constroem dados de treino e avaliação para instantes passados dos eventos. O seu armazenamento online serve os valores de features materializados mais recentes por entidade com baixa latência.
4. Ferramentas e permissões
Quando um modelo pode chamar APIs, coloque estas verificações em torno de cada tool call: autenticação da ferramenta, privilégio mínimo, validação dos argumentos, timeouts, idempotência, política de aprovação e verificação das pós-condições. O Generative AI Profile do NIST identifica riscos de conteúdo nocivo, privacidade e segurança.
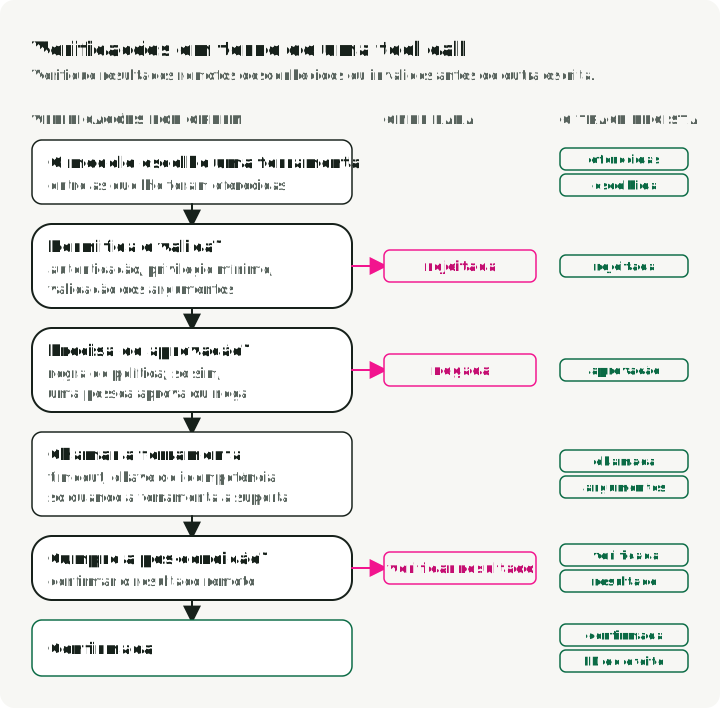
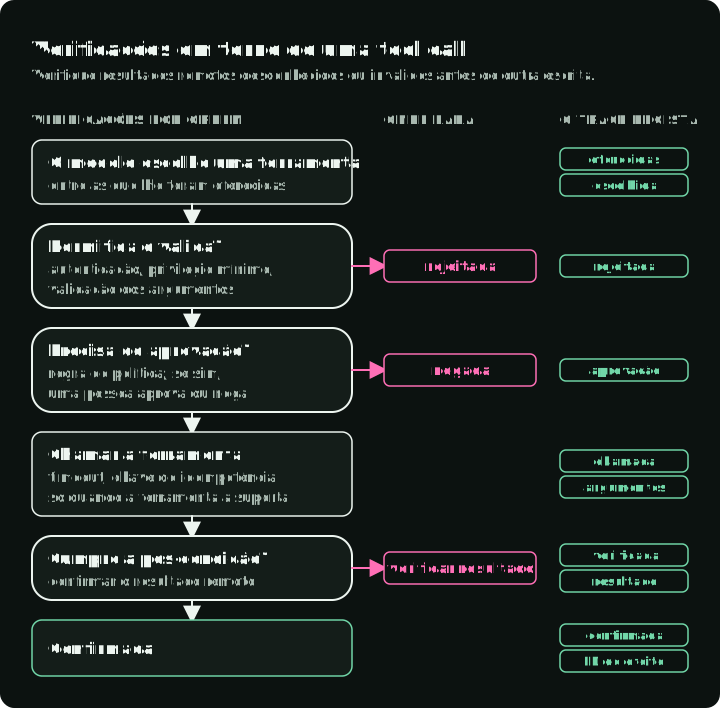
O diagrama mostra estas verificações por ordem, onde uma chamada para (uma permissão ou um argumento rejeitado, uma aprovação negada, ou um resultado que não corresponde à pós-condição esperada) e o evento de trace que cada passo regista.
Um timeout pode deixar o resultado de uma escrita desconhecido mesmo depois de o serviço remoto a confirmar. Verifique o resultado antes de outra escrita: consulte a operação ou o recurso, ou use uma repetição idempotente documentada. Repita apenas ao abrigo de um contrato de idempotência suportado ou de outro método de recuperação cuja segurança esteja verificada; a AWS explica o suporte necessário no servidor. Uma chave repetida pode devolver a falha original, como documenta o contrato de idempotência da Stripe. Use uma ação de compensação suportada quando existir e envie os resultados por resolver para revisão.
Faça o trace de que ferramenta foi oferecida, selecionada, chamada, rejeitada, repetida, verificada e confirmada. Uma resposta final fluente não prova que o caminho da ação estava correto.
5. Regras de segurança e de negócio
Os filtros de conteúdo são um controlo, não uma camada de guardrails completa. As ameaças incluem também prompt injection, retrieval entre tenants, divulgação de segredos, agência excessiva (uma entrada do OWASP Top 10 for LLM Applications), ficheiros de modelo não confiáveis ou código personalizado carregado em runtime, e argumentos de ferramentas inseguros.
Sempre que possível, expresse as regras de negócio determinísticas fora do modelo. Defina os riscos residuais, teste casos adversariais e atribua um responsável pelas alterações de política. O Generative AI Profile do NIST é um inventário de riscos útil, não um teste de aceitação pronto a usar.
A avaliação decide o release
Nas decisões de release sobre saída livre, não dependa de um único valor agregado de exatidão. Use vários tipos de evidência e defina qual é a decisiva para cada modo de falha.
Uma pilha de avaliação para um sistema baseado em foundation model tem seis camadas:
- Verificações determinísticas: validade do schema, citações presentes, ferramentas permitidas, restrições nos argumentos, regras de política, latência e orçamento.
- Métricas por componente: recall e ranking do retrieval, exatidão na seleção de ferramentas, correção dos argumentos das ferramentas e seleção de rota.
- Tarefas de ponta a ponta: entradas representativas com critérios de sucesso explícitos e etiquetas de slice.
- Pontuação baseada em modelo: juízos guiados por rubricas, calibrados com etiquetas de especialistas e monitorizados quanto à deriva do juiz.
- Revisão humana: casos ambíguos, com consequências, novos ou amostrados, em que a automação não é decisiva.
- Testes adversariais: casos de injection, de fronteira de dados, de abuso, de recusa e de efeitos secundários, ligados ao modelo de ameaças.
Guarde os resultados por exemplo, e não só as médias, para que a revisão do release possa inspecionar regressões por idioma, tenant, tipo de documento ou classe de ação.
Para uma decisão de deployment, compare um manifesto candidato com o release atual no mesmo conjunto versionado. Defina limiares para qualidade, segurança, latência e custo em conjunto, e rejeite uma rota mais barata que falhe o conjunto de tarefas.
Se todos os resultados estiverem dentro do limiar, inicie um rollout faseado. Se um falhar, rejeite o candidato. Se o resultado de um slice não for claro, envie-o para revisão humana.
Para escolher uma ferramenta de avaliação para traces, datasets e verificações de CI, veja Ferramentas de avaliação de agentes AI.
Os traces ligam a produção de volta à avaliação
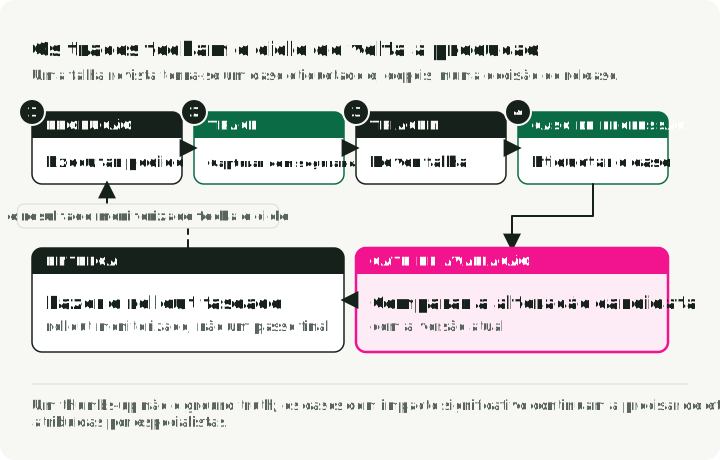
A parte de cima do diagrama é o trace de um pedido. As métricas veem a chamada lenta ao modelo; só o trace mostra o documento não autorizado e a conta errada. A linha de baixo é o que acontece a seguir: a falha revista torna-se um caso de regressão etiquetado, a avaliação compara uma alteração candidata com o release atual, e a aresta tracejada leva o release faseado de volta à produção.
As métricas de infraestrutura podem mostrar uma chamada lenta ao modelo. Não conseguem mostrar que o retrieval devolveu um documento não autorizado ou que uma ferramenta foi chamada com a conta errada. A documentação de tracing do MLflow descreve traces que capturam os passos intermédios e os metadados necessários para inspecionar este caminho.
Capture um trace ao longo do caminho de decisão:
- identidade do manifesto de release e correlação do pedido
- chamadas ao modelo e ao fornecedor, latência, utilização e estado final
- consulta de retrieval, revisão do índice ou watermark visível à consulta, identificadores e revisões dos documentos, pontuações e decisões de filtragem
- revisão do prompt/template sem guardar indiscriminadamente conteúdo sensível
- ferramentas oferecidas, argumentos, aprovações, resultados e identificadores de efeitos secundários
- decisões de política, repetições, fallbacks e resultado final
Os traces são um novo repositório de dados sensíveis. Aplique minimização, ocultação de dados sensíveis, isolamento de tenants, encriptação, amostragem, retenção e revisão de acessos antes de recolher prompts ou documentos completos. As convenções semânticas GenAI do OpenTelemetry podem ajudar na interoperabilidade, mas continuam em desenvolvimento. Fixe a versão da convenção ou do schema, da instrumentação e do collector.
O feedback dos utilizadores pode priorizar a investigação, mas um polegar para cima não é verdade de referência. Preserve o trace envolvente e obtenha etiquetas de especialistas para os casos com consequências. O Label Studio recolhe etiquetas para texto, imagens e outros tipos de dados; o Argilla recolhe feedback sobre texto e saídas de LLMs e pode enviar os datasets para o Hugging Face Hub. Avaliação de agentes AI em produção mostra como transformar traces etiquetados num conjunto de regressão versionado.
O gateway de serving é responsável pelo routing e pela política
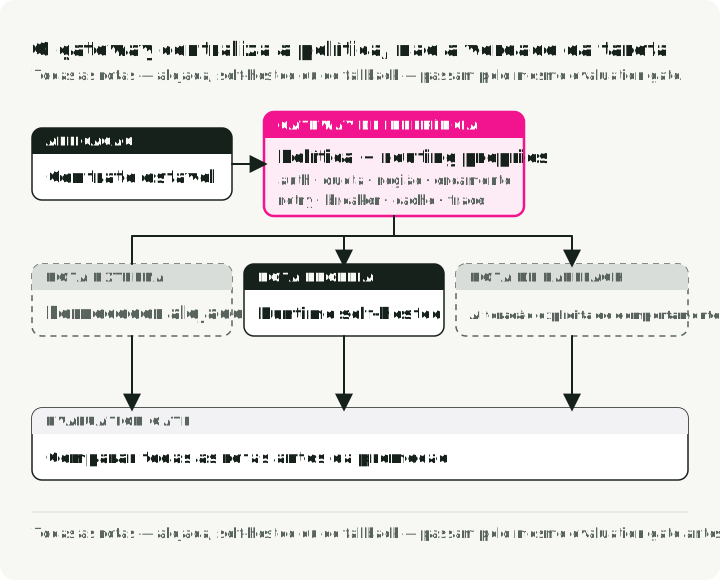
No diagrama, cada pedido segue uma rota pelo gateway: por plano, por uma pequena fração do tráfego para um modelo novo, ou para um fallback quando o fornecedor falha. Todas as rotas devolvem o mesmo contrato de resposta, e o conjunto de tarefas avalia cada rota offline antes da promoção.
Um gateway pode desacoplar os clientes da aplicação dos fornecedores ou dos motores auto-alojados. As responsabilidades que vale a pena pôr aí incluem:
- autenticação, orçamentos por tenant, quotas e limites de taxa
- contratos de pedido e de resposta estáveis
- seleção de rota por capacidade, região, latência ou qualidade avaliada
- routing por nível de subscrição, por exemplo um modelo maior para os planos pagos
- enviar uma pequena parte do tráfego para um novo modelo antes do rollout completo
- repetições limitadas, circuit breakers e semântica de fallback explícita
- partição da cache e política de dados sensíveis
- atribuição de utilização e propagação do manifesto de release
O LiteLLM Proxy é um gateway open-source: expõe muitos fornecedores através de uma única API compatível com OpenAI e define orçamentos e limites de taxa por chave ou por equipa.
O fallback é tanto uma alteração de comportamento como um mecanismo de fiabilidade. Se um modelo mais pequeno, um fornecedor alternativo ou um contexto reduzido alterar a qualidade da tarefa, avalie e faça o trace desse ramo como uma rota própria.
Não ponha todas as decisões de orquestração no gateway. Mantenha as regras de domínio perto da aplicação e torne visível quem é o responsável.
Fine-tuning e LoRA
A última linha da tabela de falhas em “Que componente inspecionar primeiro” é o caso do fine-tuning: o comportamento de que a tarefa precisa não se consegue recuperar a partir do prompt nem do contexto recuperado. A LoRA congela os pesos pré-treinados e acrescenta matrizes de baixo rank treináveis, reduzindo o número de parâmetros treináveis para a tarefa final. Essa otimização não elimina a governação dos datasets, o licenciamento do modelo base, a avaliação, a compatibilidade de serving nem os requisitos de rollback.
Registe as definições do adaptador no manifesto, junto da revisão do modelo base: o rank (r), o fator de escala (lora_alpha) e as camadas que altera (target_modules). Cada uma muda o que o adaptador aprende. O Guia de fine-tuning de LLMs cobre datasets, QLoRA e ferramentas de treino, e o Guia de serving com LoRAX cobre o serving de muitos adaptadores num único modelo base.
Uma sequência prática de adoção
- Defina a tarefa do utilizador, os limites de dano, os objetivos de serviço e o orçamento de custos.
- Crie o manifesto de release antes de introduzir um registo de prompts, uma base de dados vetorial ou um produto de gateway.
- Construa um conjunto de avaliação pequeno e com slices, e testes determinísticos por componente.
- Instrumente um trace de ponta a ponta com controlos de privacidade e identidades de release estáveis.
- Promova através de tráfego shadow, canary ou limitado, com um gatilho de rollback explícito.
- Transforme as falhas revistas em produção em casos de regressão e repita.
Acrescente infraestrutura apenas quando ela fizer uma tarefa que o manifesto nomeia ou quando eliminar uma limitação de capacidade medida.
Referências
- MLflow: evaluating production traces - Reutilize traces de produção para avaliação e pontue a informação intermédia do trace.
- MLflow: LLM and agent tracing - Capture os passos intermédios e os metadados do trace para investigação.
- OpenTelemetry GenAI semantic conventions - Convenções atuais, em estado de desenvolvimento, para spans, métricas, eventos e dados específicos de fornecedores de GenAI.
- NIST AI 600-1: Generative AI Profile - Categorias de risco para prompt injection, privacidade, segurança e outras preocupações de IA generativa.
- OWASP Top 10 for LLM Applications - Inclui agência excessiva (LLM06:2025) e prompt injection (LLM01:2025).
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks - Arquitetura original de recuperar e depois gerar.
- LoRA: Low-Rank Adaptation of Large Language Models - Pesos pré-treinados congelados mais matrizes de baixo rank treináveis para adaptação a tarefas finais.
- PEFT LoRA reference - Parâmetros de
LoraConfigeget_peft_model. - vLLM documentation - Motor de serving com continuous batching, quantização, multi-LoRA e um servidor compatível com OpenAI.
- NVIDIA Dynamo-Triton - Servidor de inferência anteriormente chamado Triton Inference Server, com um backend TensorRT-LLM.
- LiteLLM Proxy - Gateway open-source com uma API única para vários fornecedores, orçamentos, limites de taxa e fallbacks.