NER-Leitfaden 2026: GLiNER, spaCy, Transformers und LLMs

Automatische Übersetzung
Dieser Artikel wurde automatisch aus der englischen Originalversion übersetzt.
Dieser Leitfaden richtet sich an Engineers, die Named Entity Recognition (NER) für Retrieval-, Datenschutz- oder Dokumentverarbeitungs-Pipelines auswählen. Er erklärt, wie man zwischen Span-Recognizern und strukturierter LLM-Extraktion wählt, deren Fehler bewertet und Deployment-Optionen gegen die Latency und die Kosten testet, die der eigene Workload zulässt.
NER macht aus Text beschriftete Teile, die ein Programm weiterverwenden kann. Aus „Bill Gates founded Microsoft on April 4, 1975“ kann es die zusammenhängenden Text-Spans Bill Gates, Microsoft und April 4, 1975 mit den Typen Person, Organisation und Datum zurückgeben. Ein span-basierter Encoder wie GLiNER liest den Text einmal und bewertet Kandidaten-Spans gegen die Labels, die Sie vorgeben.
Für eine Retrieval- oder Datenschutz-Pipeline würde ich zuerst fragen, ob die Ausgabe eine wörtliche Erwähnung sein muss. Diese Entscheidung trennt einen Span-Recognizer von Systemen, die zusätzlich Werte normalisieren, Datensätze verknüpfen oder Fakten ableiten. LLMs bleiben nützlich, um Trainingsannotationen vorzuschlagen und Fälle zu behandeln, die Inferenz oder Normalisierung erfordern.
Companion-Repo: ner-field-guide enthält exaktes Span-Scoring, GLiNER-Beispiele, die Konvertierung geprüfter Annotationen, ONNX-FP32- und INT8-Prüfungen und eine Streaming-PII-Demo.
Den kurzen Modellvergleich finden Sie in Best NER Models in 2026.
Was ist Named Entity Recognition?
Named Entity Recognition findet Spans im Text und weist ihnen Typen zu, etwa Person, Organisation, Datum, Produkt oder domänenspezifische Labels. Ein Span ist ein zusammenhängender Abschnitt des Originaltexts. NER erkennt die Erwähnung; Entity Linking ist der getrennte Schritt, der sie einem kanonischen Datensatz oder Ontologie-Konzept zuordnet.
| Workload | Erstes Model zum Testen | Eskalieren, wenn |
|---|---|---|
| IDs oder kontrollierte Wörterbücher | Regeln oder spaCy EntityRuler | Recall außerhalb bekannter Muster wichtig ist. |
| Stabile Labels und viele Trainingsdaten | spaCy oder ein feinabgestimmter Encoder | Sich das Label-Set ändert oder der Recall bei seltenen Typen stagniert. |
| Wechselnde Labels; kleines Typ-Inventar | GLiNER Cross-Encoder | Das Inventar wächst oder Labels über viele Dokumente wiederverwendet werden. |
| Großes, wiederverwendetes Typ-Inventar | GLiNER Bi-Encoder | Das Domänen-Set eine Regression bei Qualität oder Calibration zeigt. |
| Mehrere Extraktionsaufgaben in einer Text-Pipeline | GLiNER2.5 | Die Qualität über alle Aufgaben das Ziel einer Einzelaufgabe verfehlt. |
| Implizite Fakten oder Schema-Reasoning | Strukturierte LLM-Extraktion | Latency, Kosten oder nicht belegte Aussagen das Produktbudget übersteigen. |
Ein GLiNER Cross-Encoder liest Label-Namen und Text zusammen, sodass jedes Dokument jedes Label neu encodiert. Ein Bi-Encoder encodiert Labels getrennt und kann sie cachen. GLiNER2.5 ist eine eigene Model-Familie, die Entities, Klassen, Relationen und strukturierte Felder aus einem Schema extrahiert. Jedes bekommt unten einen eigenen Abschnitt.
Es gilt der erste Treffer, wenn Sie diese Liste von oben nach unten durchgehen, in der Reihenfolge, in der ich die Fragen stellen würde:
- Die Ausgabe ist kein wörtlicher Span: Structured Output eines LLM nutzen.
- IDs oder ein festes Wörterbuch: Regeln oder einen EntityRuler nutzen.
- Feste Labels und genug Trainingsdaten: spaCy oder BERT-NER nutzen.
- Ein großes Label-Set, das über Dokumente hinweg wiederverwendet wird: den GLiNER Bi-Encoder nutzen.
- Sonst: den GLiNER Cross-Encoder nutzen und GLiNER2.5 ausprobieren, wenn Sie mehrere Aufgaben in einem Durchlauf brauchen.
Wo moderne Systeme NER einsetzen
NER findet weiterhin Textabschnitte und weist ihnen Labels zu. Geändert hat sich seine Position im System. Es liefert jetzt Filter für RAG, strukturierte Argumente für Agent-Tools und Felder für Dokumentverarbeitungs-Pipelines. Dadurch sind Latency, Kosten und Schema-Flexibilität ebenso wichtig wie die Benchmark-Genauigkeit.
RAG: besseres Retrieval durch Entity-Extraktion
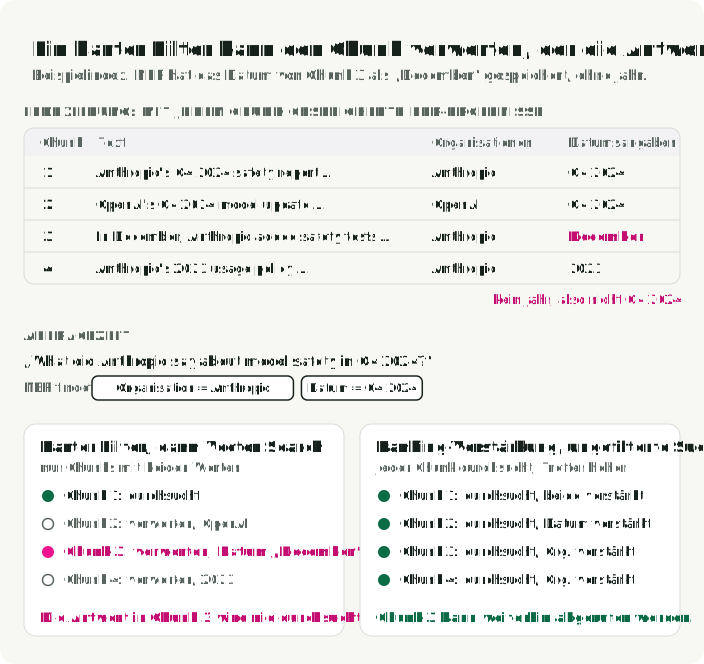
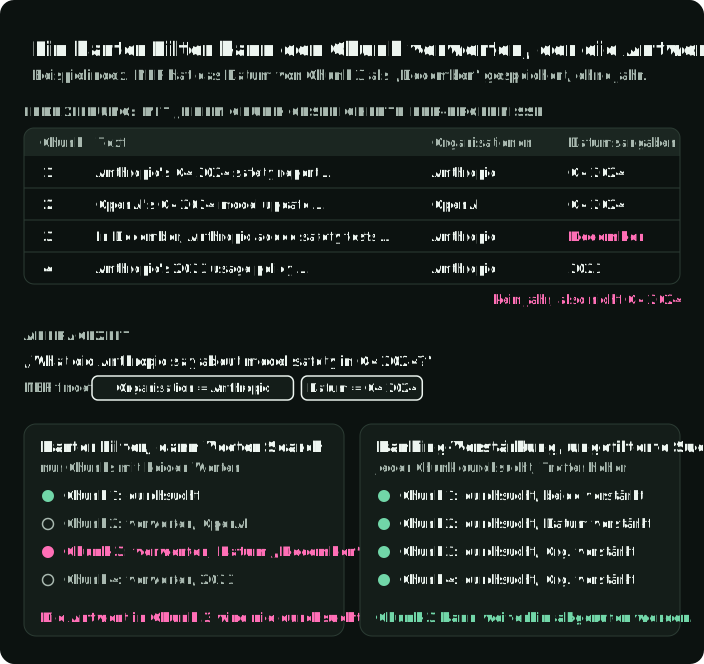
Reine Ähnlichkeitssuche tut sich schwer, wenn eine Frage exakte Entities enthält. Bei „what did Anthropic say about model safety in Q4 2024?“ kann die Entity-Extraktion „Anthropic“ und „Q4 2024“ als Filter vorschlagen. Setzen Sie einen harten Filter nur ein, wenn die indexierten Metadaten und die Datumssemantik ihn tragen; sonst nutzen Sie ihn als Ranking-Signal oder behalten einen ungefilterten Retrieval-Pfad bei. Ein übersehener Alias oder ein falsch abgeleiteter Zeitraum kann die Antwort ausschließen.
Beim Indexieren extrahieren Sie Entities aus jedem Chunk und speichern sie als Metadaten: {"organizations": ["Anthropic"], "dates": ["Q4 2024"], ...}. So können Sie vor der Vector Search nach Entity filtern. Knowledge-Graph-RAG (GraphRAG, LlamaIndex Property Graphs) ergänzt benannte Relationen, denen das Retrieval über mehrere Hops folgen kann.
Das Diagramm geht ein Beispiel mit einem Index aus vier Chunks durch. Vergleichen Sie die beiden Panels unten: Der harte Filter durchsucht den Chunk, dessen gespeichertes Datum kein Jahr hat, nie, die Ranking-Verstärkung durchsucht ihn dagegen weiterhin.
Zur Abfragezeit steuern die aus der Nutzerfrage extrahierten Entities das Routing. Eine Frage mit einem Firmennamen geht an einen Finanzindex, eine mit Wirkstoffnamen an eine klinische Wissensbasis. GLiNER ist nützlich, wenn sich das Schema oder die Entity-Typen zur Abfragezeit ändern. Unbekannte Firmen- oder Wirkstoffnamen allein erfordern kein offenes Vokabular; ein Model mit geschlossenen Labels kann neue Erwähnungen bekannter Typen trotzdem erkennen.
AI Agents: Text in strukturierte Fakten verwandeln
Agents erhalten unstrukturierten Text, etwa Webseiten, API-Antworten und Nutzernachrichten. NER wandelt diesen Text in strukturierte Fakten um, die der Agent auswerten, speichern oder an Tools weitergeben kann.
Beim Tool-Routing kann eine Anfrage wie „schedule a meeting with Sarah Chen from Accenture on Thursday at 2pm“ PERSON: Sarah Chen, ORGANIZATION: Accenture, DATE: Thursday und TIME: 2pm ergeben. Ein Kalender-Resolver fügt Datum und Uhrzeit dann zu dem Zeitstempel zusammen, den die API verlangt. Ein lokaler Encoder spart den API-Roundtrip, aber seine Latency hängt von Model, Runtime, Hardware, Batch-Größe und Anzahl der Labels ab.
NER unterstützt auch das Tracking von Entities über Gespräche hinweg. Agent-Memory-Systeme müssen wissen, dass „Sarah“ in Runde 3 und „Ms. Chen“ in Runde 12 dieselbe Person sind. NER erkennt die Spans; Koreferenzauflösung entscheidet, ob die Erwähnungen im Kontext auf dieselbe Person verweisen. Entity Linking ordnet diese Person dann einem kanonischen Datensatz zu, sofern es einen gibt.
In beiden Fällen ist die Latency die Grenze. Macht jeder von zehn aufeinanderfolgenden Schritten einen NER-Aufruf mit 200 ms, summieren sich diese Aufrufe zu 2 Sekunden wahrgenommener Verzögerung. Ein Aufruf kostet 200 ms. Encoder-Models passen meist besser in Agent Loops als LLM-basierte Extraktion.
Document Intelligence: von Bildern zu strukturierten Daten
OCR wandelt Bilder in Text um. NER wandelt diesen Text in strukturierte Felder um.
Eine Standard-Pipeline nutzt zuerst OCR, etwa Tesseract, Azure Document Intelligence oder AWS Textract, um Text und Bounding Boxes zu erzeugen. NER findet dann Spans für Felder wie invoice_number, vendor_name, total und due_date. Ein Schema- oder Relation-Extraction-Schritt muss Positionsbeschreibungen, Mengen und Preise zu line_items gruppieren. Dieselbe Abfolge gilt für Verträge, Patientenakten und behördliche Meldungen.
Jede Stufe hat ihren eigenen Score. Ein OCR-Fehler, der eine Ziffer verliert, sieht wie ein NER-Fehler aus, wenn Sie nur den fertigen Datensatz bewerten.
| Stufe | Was sie erzeugt | Score |
|---|---|---|
| OCR und Layout | Text, Lesereihenfolge, Boxen | Zeichenfehlerrate |
| NER | invoice_number, vendor_name, total | Exact-Span-F1 |
| Gruppierung | Positionen (Beschreibung, Menge, Preis pro Zeile) | Datensatz-F1 |
| Verknüpfung und Normalisierung | Lieferanten-ID, ISO-Datumsangaben, Beträge | Linking- oder Normalisierungsgenauigkeit |
Moderne Dokument-Pipelines können Layout-Verständnis, Entity-Extraktion und Relation Extraction kombinieren. OCR oder ein layoutbewusstes Dokument-Model liefert weiterhin Text, Lesereihenfolge, Tabellen und Bounding Boxes. Das aktuelle GLiNER2.5 stellt Entities, Relationen, Klassifikation und strukturierte Datensätze über eine Schema-Schnittstelle bereit; bewerten Sie jede Ausgabe einzeln.
Die Kosten entscheiden die meisten dieser Pipelines. Kalkulieren Sie sie mit dem tatsächlichen monatlichen Dokumentvolumen, einschließlich Wiederholungen und Review. Ein kompakter Encoder läuft auf der CPU, während ein API-basiertes LLM Inference-Kosten pro Dokument und zusätzliche Latency mitbringt. Ein praktischer Test: Labeln Sie ein repräsentatives Rechnungsset mit einem LLM. Stimmen Sie GLiNER auf den geprüften Datensätzen fein ab und vergleichen Sie beide Wege nach F1 auf Feldebene, Latency und Gesamtkosten.
PII-Erkennung und LLM-Guardrails
Datenschutzgesetze wie die DSGVO, HIPAA und CCPA verlangen Schutzmaßnahmen für personenbezogene Daten, schreiben aber kein NER vor. NER kann personenbezogene Daten für Schwärzung oder Datenminimierung finden; sein Recall muss auf Ihren Daten geprüft werden, bevor er als Kontrolle zählt.
De-Identifikations-Models finden PERSON-, SSN-, PHONE-, EMAIL- und ADDRESS-Spans und schwärzen sie entweder oder ersetzen sie durch synthetische Entsprechungen. Microsoft Presidio kombiniert Recognizer mit Anonymisierungs-Operatoren, und seine Beispiele enthalten GLiNER als Recognizer. Das GLiNER2-PII mit 0,3 Mrd. Parametern ist ein weiterer Kandidat: Sein Paper deckt 42 PII-Typen mit Auflösung auf Zeichen-Span-Ebene ab.
Im herstellergeführten Vergleich von John Snow Labs umfassen 48 von Experten annotierte Dokumente sechs PHI-Klassen. Die Labels der Anbieter wurden umgemappt und nicht abbildbare Vorhersagen ausgeschlossen, was die Interpretation über Anbieter hinweg einschränkt. Der Providence-Bericht beschreibt 281 durchgesickerte PHI-Ereignisse in einer Prüfung von 1.000 Notizen mit 34.701 Sätzen. Ereignisse sind nicht dasselbe wie verschiedene betroffene Sätze: Zählen Sie in einer Datenschutzbewertung sowohl durchgesickerte Instanzen als auch betroffene Dokumente.
Für LLM-Guardrails dient NER als Vorab-Prüfschicht: Nutzereingaben vor dem Senden an eine externe API auf PII scannen und dann blockieren oder anonymisieren.
Ein lokaler Detektor kann schneller sein, als das LLM sich selbst moderieren zu lassen, aber False Negatives bleiben möglich. Fügen Sie deshalb eine weitere Kontrolle für die PII-Exposition hinzu, die Ihr System nicht hinnehmen kann. GLiNER ist hier nützlich, weil PII-Kategorien je nach Rechtsraum variieren. Eine API kann ein neues Label wie „genetic information“ ohne erneutes Training akzeptieren. Der Recall für dieses neue Label ist unbekannt, bis Sie ihn an geprüften Beispielen testen.
GLiNER: Span-zu-Label-Matching für NER mit offenem Vokabular
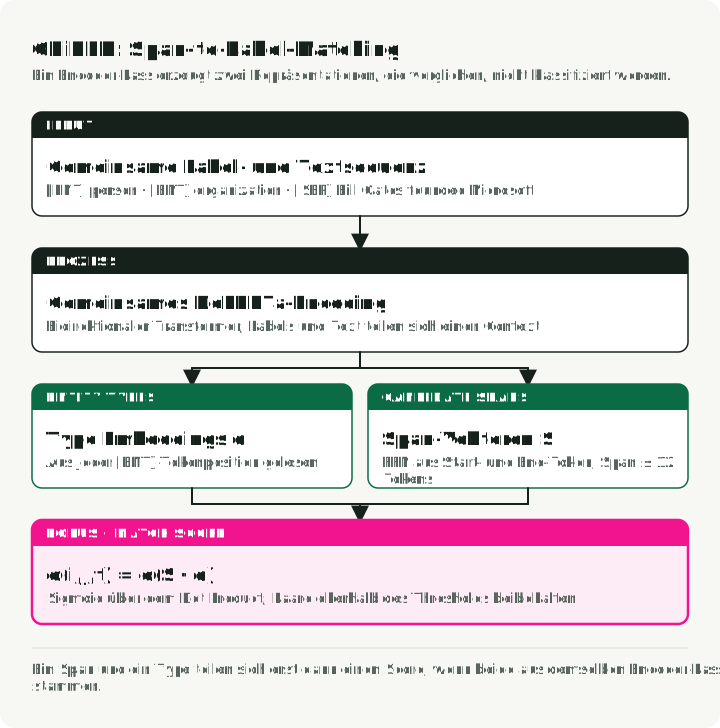
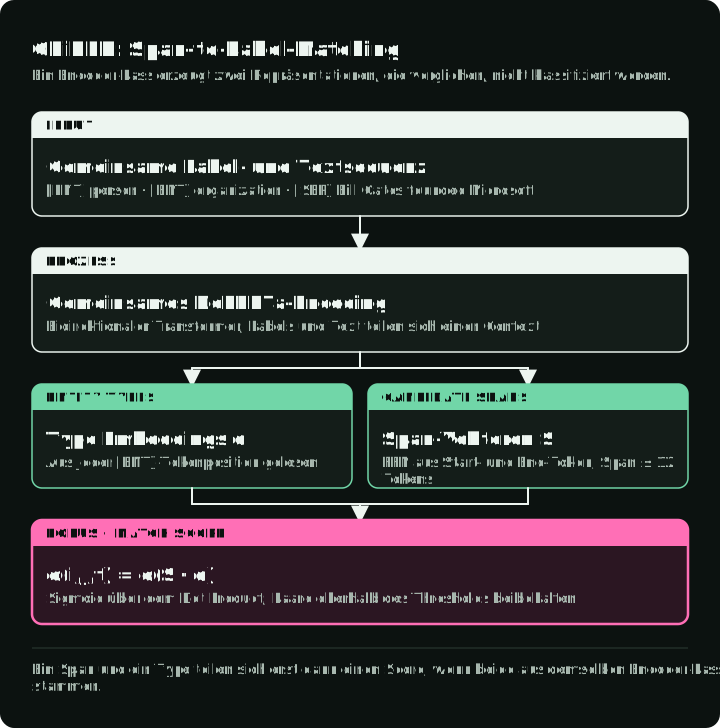
GLiNER (NAACL 2024, Zaratiana et al.) machte encoderbasiertes NER zu einem Bruchteil der Kosten mit LLMs konkurrenzfähig. Statt NER als Sequence Labeling oder Textgenerierung zu behandeln, formuliert GLiNER es als Matching-Problem. Es bewertet jeden Kandidaten-Span (jede zusammenhängende Wortfolge wie „Bill Gates“ oder „Microsoft“) gegen jedes Entity-Typ-Label und behält die Paare mit hohem Score.
Das Model nimmt Entity-Typ-Labels und Eingabetext als eine einzige Sequenz: [ENT] person [ENT] organization [ENT] date [SEP] Bill Gates founded Microsoft.... Ein bidirektionaler Transformer (DeBERTa-v3) encodiert alles gemeinsam.
Aus der Ausgabe baut das Model zwei Mengen von Repräsentationen. Die eine verfeinert die Repräsentation jedes Entity-Typs ab der Position seines [ENT]-Tokens über ein kleines Feed-Forward-Netz (FFN), das den Vektor des Encoders transformiert. Die andere repräsentiert Text-Spans, indem sie die Vektoren von Start- und Endwort über ein weiteres FFN kombiniert. Ein Skalarprodukt zwischen einer Span-Repräsentation und einer Entity-Typ-Repräsentation ergibt einen Score.
Wendet man die Sigmoid-Funktion an, erhält man die Wahrscheinlichkeit, dass der Span von Wortposition bis Wortposition zum Entity-Typ gehört: . Dabei ist der vom FFN erzeugte Span-Vektor und das vom FFN verfeinerte Entity-Typ-Embedding des zugehörigen [ENT]-Tokens (Zaratiana et al., 2024, Gl. 1–2). Kandidaten-Spans sind auf 12 Wörter begrenzt; der Tokenizer kann ein Wort in mehrere Subword-Tokens teilen.
GLiNER akzeptiert zur Inference-Zeit Label-Beschreibungen in natürlicher Sprache ohne erneutes Training, aber die Extraktionsqualität hängt von der Formulierung der Labels und der Passung zur Domäne ab. Sie übergeben Entity-Typen wie „person“, „adverse drug reaction“ oder „financial instrument“, und das Model bewertet Spans gegen sie. Die Konfigurationen mit 50M, 90M und 300M unten sind die Models des Original-Papers. Die v2.1-Model-Card nennt stattdessen die englischen Checkpoints mit 166M, 209M und 459M sowie einen mehrsprachigen Checkpoint mit 209M, alle unter Apache 2.0. Vergleichen Sie Latency oder Speicher nicht über diese Generationen hinweg, als wären die Parameternamen identisch (GLiNER v2.1 Model Card).
Für einen echten harten Zero-Shot-Test halten Sie neben den Zielbeispielen auch die Zieltypen zurück: Das Model hat keine gelabelten Beispiele für die Zielaufgabe. Eine Typbeschreibung wie „a medically confirmed adverse effect caused by a treatment“ gibt dem Model mehr Information als adverse event allein. Das garantiert keinen Transfer, aber beschreibungsgesteuertes ZeroNER schnitt auf seinen Benchmarks mit zurückgehaltenen Typen besser ab als Baselines, die nur den Namen nutzen (Cocchieri et al., 2025).
Die Trainingsdaten des Original-Models stammten aus dem Pile-NER-Dataset: 44.889 Passagen mit 240K Entity-Spans über 13K Entity-Typen, alle von ChatGPT gelabelt. Das Training von GLiNER-L dauerte etwa 5 Stunden auf einer einzelnen A100 (Zaratiana et al., 2024).
Benchmark-Ergebnisse
Zero-Shot-Ergebnisse aus Zaratiana et al. (2024), Tabellen 1 und 2. F1 fasst Precision und Recall in einem Score zusammen; ein höherer Score ist nur bei gleicher Aufgabe und gleichen Bewertungsregeln besser. Der Durchschnitt über sieben Datasets kombiniert fünf CrossNER-Datasets mit MIT Movie und MIT Restaurant:
| Model | Params | Ø F1 (CrossNER + MIT) | Ø F1 (20 Datasets) |
|---|---|---|---|
| GLiNER-L | 300M | 60,9 % | 47,8 % |
| GoLLIE | 7B | 58,0 % | — |
| UniNER-13B | 13B | 55,6 % | — |
| GLiNER-M | 90M | 55,4 % | — |
| UniNER-7B | 7B | 53,7 % | 45,7 % |
| GLiNER-S | 50M | 52,7 % | — |
| ChatGPT (GPT-3.5) | — | 47,5 % | 36,5 % |
GLiNER-M mit 90M Parametern erreicht UniNER-13B fast im Durchschnitt der sieben Datasets des Papers (55,4 % vs. 55,6 % F1) und braucht dafür etwa 140-mal weniger Parameter. Das 50M große GLiNER-S übertrifft das berichtete Ergebnis von ChatGPT (GPT-3.5) um 5 F1-Punkte. Die mehrsprachige Variante, nur mit englischen Daten trainiert, übertrifft dieselbe ChatGPT-Baseline in 8 von 10 nicht-englischen Sprachen (Zaratiana et al., 2024). Diese Vergleiche nutzen die Model-Versionen und das Evaluations-Harness des Papers; über neuere LLMs sagen sie nichts aus.
Ein minimaler GLiNER-Aufruf
Nehmen Sie in einen neuen Cross-Encoder-Vergleich die gepflegten GLiNER-v2.5-Checkpoints neben v2.1 auf. In der Prüfung des Companions an 32 Sätzen aus Few-NERD, einem öffentlichen NER-Dataset, fand gliner_small-v2.5 44 von 54 Gold-Spans und gliner_medium-v2.1 39. Diese Stichprobe ist zu klein, um die beiden zu ranken, aber sie ist ein Grund, v2.5 in Ihren eigenen Lauf aufzunehmen. GLiNER v2.5 und Fastino GLiNER2.5 (unten) sind verschiedene Model-Familien.
Der Aufruf unten lädt den v2.1-Medium-Checkpoint und gibt jeden Span mit seinem Score aus. Die Version des Companions ist ner_demo/quickstart.py.
from gliner import GLiNER

model = GLiNER.from_pretrained("urchade/gliner_medium-v2.1")
text = "Bill Gates founded Microsoft on April 4, 1975."
labels = ["person", "organization", "date"]
entities = model.predict_entities(text, labels, threshold=0.5)

for entity in entities:
    print(f"{entity['text']} => {entity['label']} ({entity['score']:.3f})")
# Bill Gates => person (0.994)
# Microsoft => organization (0.973)
# April 4, 1975 => date (0.951)Der Bi-Encoder: NER mit Millionen Labels
Das ursprüngliche GLiNER encodiert Labels und Text gemeinsam. Das gemeinsame Encodieren wird zunehmend teurer, weil der Label-Text Kontext verbraucht und mit jedem Dokument neu encodiert werden muss. Wo der Umschlagpunkt liegt, hängt von Checkpoint, Label-Beschreibungen und Hardware ab. Wird dasselbe große Typ-Inventar über viele Dokumente wiederverwendet, machen Sie den GLiNER Bi-Encoder zum Standardvergleich. Er trennt das Encodieren von Text und Labels in zwei getrennte Transformer (Stepanov et al., 2026).
Die Abbildung vergleicht die beiden Designs an drei Dokumenten. In der Cross-Encoder-Bahn gehen alle Labels mit jedem Dokument in den Encoder. In der Bi-Encoder-Bahn läuft ein Label-Encoder einmal, seine Vektoren werden gecacht, und pro Dokument läuft nur der Text-Encoder. Das Diagramm darunter zeigt die Throughput-Kosten bei 1.024 Labels.
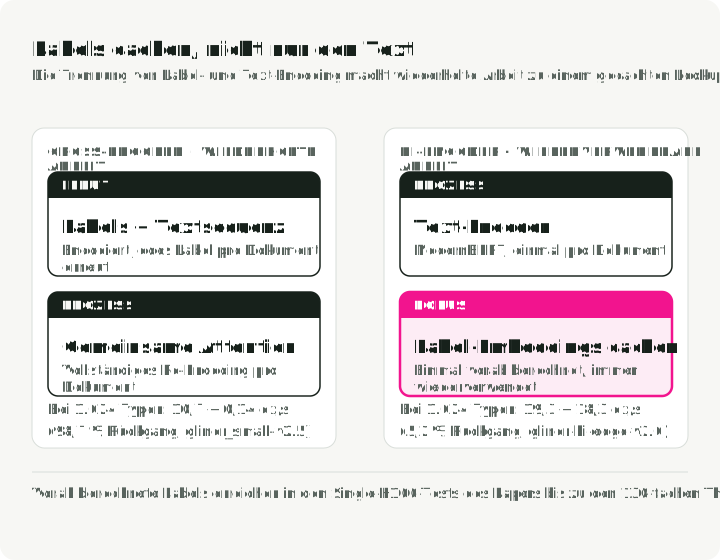
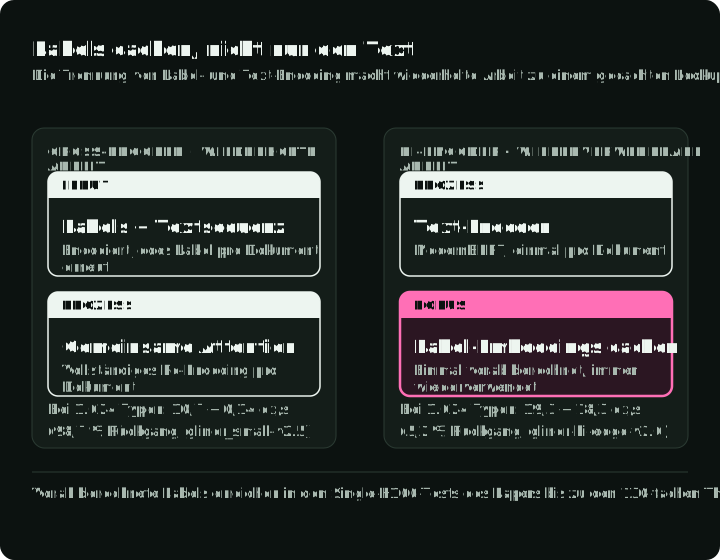
Der Text-Encoder nutzt ModernBERT (Ettin-Familie), der Label-Encoder nutzt Sentence Transformers (BGE oder MiniLM). Spans und Labels werden per Skalarprodukt bewertet. Diese Trennung bedeutet, dass Entity-Typ-Embeddings einmal vorberechnet und gecacht werden können. Bei der Inference vermeiden gecachte Labels das wiederholte Encodieren der Labels. Das Bewerten der Kandidaten-Spans gegen diese Labels braucht weiterhin Rechenleistung und Speicher; eine Anwendung mit einer Million Labels braucht außerdem eine begrenzte Kandidaten-Retrieval-Stufe oder Batching, und der Recall für Labels, die vor dem Scoring ausgeschlossen werden, muss gemessen werden.
Vier Model-Größen sind verfügbar, alle auf CrossNER gebenchmarkt (Stepanov et al., 2026, Tabelle 1):
| Model | Parameter | Ø F1 (CrossNER + MIT) | Throughput (H100) | Mit vorberechneten Labels |
|---|---|---|---|---|
| gliner-bi-edge-v2.0 | 60M | 54,0 % | 13,64 ex/s | 24,62 ex/s |
| gliner-bi-small-v2.0 | 108M | 57,2 % | 7,99 ex/s | 15,22 ex/s |
| gliner-bi-base-v2.0 | 194M | 60,3 % | 5,91 ex/s | 9,51 ex/s |
| gliner-bi-large-v2.0 | 530M | 61,5 % | 2,68 ex/s | 3,60 ex/s |
Bei 1.024 Entity-Typen verliert der Bi-Encoder gliner-bi-edge-v2.0 mit vorberechneten Labels gegenüber einem einzelnen Label nur 5,2 % Throughput (19,3 → 18,3 ex/s). Der vergleichbare Cross-Encoder gliner_small-v2.5 verliert 98,7 % (10,7 → 0,14 ex/s). In den Tests des Papers auf einer einzelnen H100 mit Batch-Größe 1 und Eingaben mit 64, 256 und 512 Tokens erreicht der Bi-Encoder mit vorberechneten Labels bis zu 130× mehr Throughput als gliner_small-v2.5. Mit 100 Entity-Typen auf einer einzelnen H100 verarbeitet der Bi-Encoder 1,96 Millionen Vorhersagen pro Tag gegenüber 368K beim Cross-Encoder (Stepanov et al., 2026).
Das Bi-Encoder-Paper nennt 61,5 % für gliner-bi-large-v2.0 gegenüber 60,9 % für gliner_large-v2.5 auf demselben CrossNER-plus-MIT-Durchschnitt; der Bi-Encoder tauscht auf diesem Benchmark also keine Genauigkeit gegen Geschwindigkeit. Die Autoren empfehlen bi-base-v2.0 (194M) als besten Kompromiss bei der Größe: 98 % der Genauigkeit des großen Models bei 2,6-facher Geschwindigkeit (Stepanov et al., 2026).
Der Timing-Sweep endet bei 1.024 Labels, auf einer H100, mit Batch-Größe eins und zehn Forward Passes pro Konfiguration. Einen produktiven Service mit einer Million Labels misst er nicht. Das Paper nennt Entity Linking über große Wissensbasen wie Wikidata als einen Einsatz; Entity Linking ist über das Framework GLiNKER von Knowledgator verfügbar.
Der Code encodiert das Label-Set einmal und verwendet die Embeddings für jeden Text wieder. Mit den drei Labels unten liefert er dieselben drei Spans wie der Cross-Encoder-Aufruf oben.
from gliner import GLiNER

model = GLiNER.from_pretrained("knowledgator/gliner-bi-base-v2.0")

# Pre-compute embeddings for a reused label set; rebuild this cache when labels or the checkpoint change.
entity_types = ["person", "organization", "date"]  # Small example; large inventories need bounded candidate selection
entity_embeddings = model.encode_labels(entity_types, batch_size=8)

# Encode text and score spans against the cached labels
texts = ["Bill Gates founded Microsoft on April 4, 1975."]
outputs = model.batch_predict_with_embeds(texts, entity_embeddings, entity_types)GLiNER2 und GLiNER2.5: ein Schema für mehrere Aufgaben
Das ursprüngliche GLiNER-Ökosystem verteilte NER, Relation Extraction, Klassifikation und Extraktion auf Dokumentebene auf getrennte Models. Das GLiNER2-Paper von der EMNLP 2025 vereinte NER, Klassifikation und hierarchische Extraktion in einem Model mit 205M Parametern; aktuelle Releases haben später die Relation Extraction in dieselbe Schema-Schnittstelle aufgenommen.
Diese Architektur von 2025 behält das Cross-Encoder-Design bei, erweitert aber den Kontext auf 2.048 Tokens (das Vierfache des Originals) und ergänzt deklarative Schemas zur Definition von Extraktionsaufgaben. Das Training nutzt 135.698 reale Dokumente, annotiert mit GPT-4o, sowie 118.636 synthetische Beispiele (Zaratiana et al., 2025).
Auf Zero-Shot-CrossNER erreicht GLiNER2 einen F1 von 0,590, nahe an den 0,599 von GPT-4o im Benchmark des Papers von Mitte 2025. Bei der Klassifikation erreicht es im Schnitt 0,72 über 7 Benchmarks, verglichen mit 0,69 für DeBERTa-v3-large. Auf der CPU nennt das Paper eine Klassifikations-Latency von 130–208 ms über die getesteten Label-Anzahlen. Die Zero-Shot-DeBERTa-Baseline braucht einen Forward Pass pro Kandidaten-Label und steigt von 1.714 ms bei 5 Labels auf 16.897 ms bei 50; das ist nicht die Laufzeit eines überwachten DeBERTa-Klassifikators (Zaratiana et al., 2025).
Das Beispiel unten lädt GLiNER2.5, einen späteren Checkpoint; die Scores von 2025 oben beschreiben ihn daher nicht. GLiNER2.5 (194M Parameter) sagt Start- und Endpositionen von Spans voraus, statt jeden Span zu bewerten. Sein Fenster umfasst 4.096 Tokens; teilen Sie längere Dokumente also mit dem Helfer der Library in überlappende Chunks und prüfen Sie, dass die zurückgegebenen Offsets auf den vollständigen Text abbilden. Laden Sie es wie unten mit AutoExtractor.
from gliner2 import AutoExtractor

# Requires `pip install gliner2[local]` and downloads the checkpoint.
extractor = AutoExtractor.from_pretrained("fastino/gliner2.5-base-v1")

# Compose tasks through the current schema interface
schema = (extractor.create_schema()
    .entities({"person": "Names of people", "company": "Organization names"})
    .classification("sentiment", ["positive", "negative", "neutral"])
    .relations(["works_for", "founded", "located_in"])
    .structure("product_info")
        .field("name", dtype="str")
        .field("price", dtype="str"))
text = "Acme launched a $19 widget in Berlin."
results = extractor.extract(text, schema)
Das EMNLP-Paper bewertet nur NER und Klassifikation. Es berichtet keinen Benchmark für hierarchische Extraktion und deckt die spätere Relations-API nicht ab. Ein Model, das vier Aufgaben ausführt, kann bei jeder einzelnen schlechter abschneiden als vier spezialisierte Models; vergleichen Sie daher jede Aufgabe mit ihrer eigenen Baseline.
Weitere GLiNER-Varianten für besondere Anforderungen
Die GLiNER-Familie umfasst inzwischen mehrere Architekturen jenseits von Cross-Encoder, Bi-Encoder und GLiNER2.5. Jede zielt auf einen Bedarf:
| Bedarf | Kandidat | Was zu prüfen ist |
|---|---|---|
| Entities und Relationen in einem Durchlauf | GLiNER-Relex | Span-F1 und Relations-F1 auf denselben Dokumenten. |
| Lokaler PII-Kandidat | GLiNER2-PII | Recall nach Sprache, Dokumentformat und PII-Typ. |
| Mehrsprachiger Kandidat mit offenem Vokabular | GLiNER-X | Qualität pro Sprache; seine Card nennt 23 Sprachen. |
| Generierte oder wechselnde Typen | GLiNER Decoder | Ob generierte Typen stabil und für die weitere Verarbeitung nützlich sind. |
| PII-Schwärzung im Streaming | GLiNER Streaming PII | Vor der Freigabe durchgesickerte Zeichen, nicht nur der Recall der End-Spans. |
Die Ergebnisse von GLiNER-Relex und GLiNER2-PII stammen aus deren eigenen Papers und Harnesses. GLiNER-X und GLiNER Decoder haben Model Cards, aber keine begutachteten Benchmarks; ihre Zahlen sind daher nicht mit denen der Papers oben vergleichbar.
Streaming-PII verändert, wann Sie Text freigeben können
GLiNER Streaming PII ergänzt inkrementelle Erkennung mit einem kausalen Qwen3-0.6B-Backbone und gecachtem Session-Zustand. Seine API gibt den gesamten aktuellen Session-Snapshot zurück, mit Offsets in den akkumulierten Text. Erhalten Sie die Chunk-Grenzen, halten Sie die Labels bis zur vollständigen Neuberechnung fest und räumen Sie beendete Sessions auf.
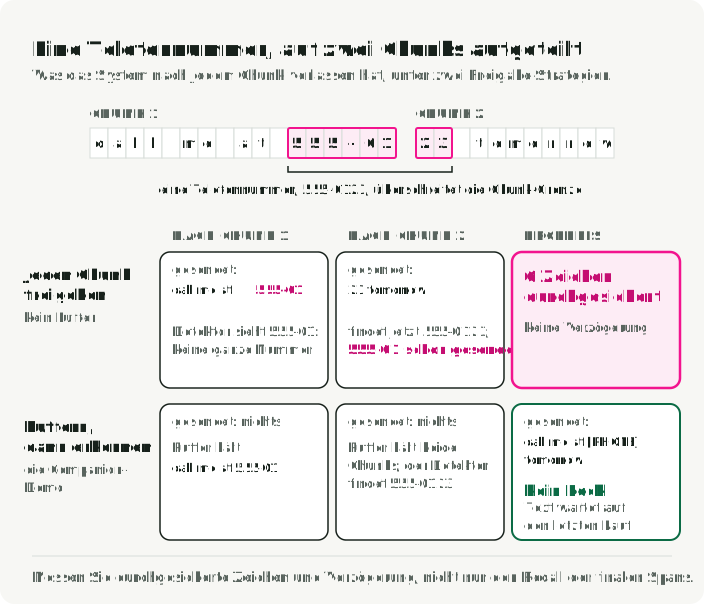
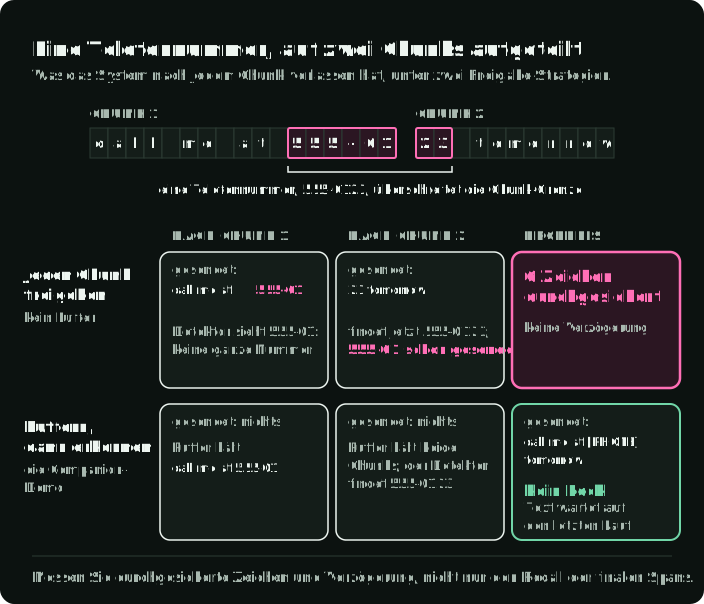
Für Streaming-Schwärzung würde ich noch nicht freigegebenen Text puffern und Entities testen, die über Chunks hinweg geteilt sind. Findet man eine Telefonnummer, nachdem ihre erste Hälfte gesendet wurde, lassen sich diese Bytes nicht zurückholen. Messen Sie neben dem Recall der End-Spans die vor der Freigabe durchgesickerten Zeichen und die zusätzliche Verzögerung. Die Model Card berichtet das PIIMB-Masking-F2 getrennt vom strikten F1 für typisierte Spans; sie beantworten unterschiedliche Fragen. Die Model Card nennt außerdem schwächere mehrsprachige Ergebnisse, der veröffentlichte Checkpoint ist also kein universeller Datenschutzfilter.
Die Abbildung teilt eine Telefonnummer auf zwei Chunks auf. Wird chunkweise freigegeben, hat die erste Hälfte das System schon verlassen, wenn die zweite eintrifft. Mit Puffer sieht der Detektor die ganze Nummer, und nur maskierter Text verlässt den Puffer. Das ner_demo.streaming des Companions hält den gesamten Text bis zu einem abschließenden Erkennungsdurchlauf zurück und gibt ihn dann mit maskierten erkannten Spans frei.
Alternativen mit geschlossenen Labels: spaCy und ein feinabgestimmter Token-Klassifikator
Ist das Label-Set stabil und haben Sie annotierte Daten, brauchen Sie die offenen Labels von GLiNER nicht. Ein auf diesem Label-Set trainiertes Model ist die Baseline, die es zu schlagen gilt.
Die trainierten Pipelines von spaCy (en_core_web_sm, en_core_web_trf) erkennen eine feste Menge von Entity-Typen (PERSON, ORG, GPE, DATE und weitere), die beim Training festgelegt wurde. Die trainierte ner-Komponente zu erweitern, erfordert gelabelte Beispiele und Training. Für Kennungen oder ein kontrolliertes Wörterbuch fügt EntityRuler per Muster eigene Labels ohne erneutes Training hinzu; sein Recall außerhalb dieser Muster ist null. Die Model Card von en_core_web_trf 3.8.0 nennt 90,19 NER-F1 auf OntoNotes 5.0, aber nur für ihre 18 vordefinierten Typen (spaCy Model Card).
Das Beispiel fügt vor der trainierten ner-Komponente ein Ticker-Muster hinzu, sodass die Regel $AAPL zuerst belegt und das Model den Rest labelt:
import spacy

nlp = spacy.load("en_core_web_trf")
ruler = nlp.add_pipe("entity_ruler", before="ner")
ruler.add_patterns([{"label": "TICKER", "pattern": [{"TEXT": "$"}, {"TEXT": {"REGEX": r"^[A-Z]{1,5}$"}}]}])

doc = nlp("Tim Cook said Apple ($AAPL) will open an office in Berlin in March 2027.")
print([(ent.text, ent.label_) for ent in doc.ents])
# [('Tim Cook', 'PERSON'), ('Apple', 'ORG'), ('$AAPL', 'TICKER'), ('Berlin', 'GPE'), ('March 2027', 'DATE')]
Für stabile Labels mit repräsentativen annotierten Spans ist ein feinabgestimmter Token-Klassifikator wie BERT, RoBERTa oder DeBERTa die überwachte Baseline. Die Hugging Face pipeline lädt einen in einer Zeile. dslim/bert-base-NER, der feste Encoder in der Evaluation des Companions, wurde auf CoNLL-2003 trainiert, seine Labels sind daher auf PER, ORG, LOC und MISC festgelegt. Das Datum im selben Satz wird nicht gefunden, weil das Model kein Datum-Label hat:
from transformers import pipeline

ner = pipeline("token-classification", model="dslim/bert-base-NER", aggregation_strategy="simple")
for ent in ner("Tim Cook said Apple will open an office in Berlin in March 2027."):
    print(ent["word"], ent["entity_group"], round(float(ent["score"]), 3))
# Tim Cook PER 1.0
# Apple ORG 0.998
# Berlin LOC 0.999
Für eigene Labels stimmen Sie ein solches Model auf Ihren annotierten Spans fein ab. Vergleichen Sie es mit spaCy und GLiNER nach Exact-Span-F1, Recall pro Label, Calibration, Latency und Kosten auf demselben Domänen-Set.
Meine Empfehlung: Nutzen Sie spaCy oder einen feinabgestimmten Token-Klassifikator für Standard- oder stabile Entity-Typen, für die Sie Trainingsdaten haben. Nutzen Sie GLiNER, wenn Sie flexible Zero-Shot-Typen brauchen oder Ihre Pipeline sich ohne erneutes Training anpassen muss. Beide können sich eine Pipeline teilen, wobei spaCy Tokenization und Satztrennung übernimmt und GLiNER die Entity-Extraktion.
Checkpoint-Lizenzen gehören zur Model-Wahl
Die Models in diesem Leitfaden haben nicht dieselbe Lizenz. Prüfen Sie vor dem Deployment die Bedingungen für Code, Weights und Dataset des konkreten Checkpoints:
| Release | Veröffentlichte Lizenz | Praktische Folge |
|---|---|---|
| GLiNER v2.1, GLiNER v2.5 und GLiNER bi | Apache 2.0 | Permissive Bedingungen laut Model Card; Abhängigkeiten und Daten trotzdem prüfen. |
| GLiNER2, GLiNER2.5 und GLiNER2-PII | Apache 2.0 | Den gewählten Checkpoint bestätigen, nicht nur die Library. |
spaCy en_core_web_trf und dslim/bert-base-NER | MIT | Permissiv; die Trainingskorpora haben eigene Bedingungen. |
| UniNER-7B-all | CC BY-NC 4.0 | Ohne gesonderte Erlaubnis nicht auf einem kommerziellen Pfad einsetzen. |
| NuNER | MIT | Das veröffentlichte Model und das Dataset nennen MIT-Bedingungen. |
Lizenzangaben sind keine Rechtsberatung. Eine Prüfung für den Produktivbetrieb muss die Bedingungen des Basismodels, der Trainingsdaten und der Anbieter umfassen.
LLMs als Lehrer: eine Fallstudie für $70 und eine einsetzbare Pipeline
Das LLM-as-Teacher-Muster trennt teure Annotation von günstigerer Inference: Ein LLM labelt die Trainingsdaten einmal, und ein kleiner Encoder, der auf diesen Labels trainiert wurde, bedient jede Anfrage. Zwei Forschungspapers haben gezeigt, dass kleine Models NER aus LLM-Labels lernen können, und zwei veröffentlichte Fallstudien zeigen, wie Teams das umgesetzt haben.
Die Forschung hinter diesem Muster: UniNER und NuNER
UniNER (ICLR 2024, Zhou et al.) und NuNER (EMNLP 2024, Bogdanov et al.) destillieren beide LLM-Annotationen in kleinere NER-Models, sind aber uneins darüber, wie klein man gehen kann.
UniNER stimmt LLaMA-7B/13B auf 45.889 Eingabe-Ausgabe-Paaren fein ab, die ChatGPT erzeugt hat. Für jeden Entity-Typ beantwortet das Model „What describes [type] in the text?“ und gibt JSON-Listen aus. Ein wichtiger Trainingstrick: Häufigkeitsbasiertes Negative Sampling hebt den F1 von 31,5 % auf 53,4 % (Zhou et al., 2024).
UniNER-7B erreicht 41,7 % Zero-Shot-F1 über 43 Datasets und schlägt die 34,9 % von ChatGPT um 7 Punkte. Die 13B-Variante kommt auf 43,4 %, nur 1,7 Punkte mehr bei fast doppelt so vielen Parametern (Zhou et al., 2024).
Der Kompromiss im Produktivbetrieb: Das besser bewertete UniNER-Setup des Papers fragt jeden Entity-Typ nacheinander ab. Seine All-in-one-Variante nutzt eine einzige Antwort, lag aber im Schnitt 3,3 % niedriger. In FP16 braucht ein 7B-Checkpoint allein für die Weights rund 14 GB; Quantization mit weniger Bits kann diesen Bedarf senken. Der UniNER-7B-all-Checkpoint ist nicht kommerziell nutzbar (siehe Lizenztabelle oben).
NuNER startet mit RoBERTa-base (125M Parameter) und nutzt kontrastives Training mit 4,38 Millionen GPT-3.5-Annotationen über 200K Konzepte. Nach dem Training wird der Konzept-Encoder verworfen; der Text-Encoder passt als RoBERTa-Ersatz in jede Standard-NER-Pipeline (Bogdanov et al., 2024).
Tabelle 3 von NuNER nennt rund 6,1–16,2 Punkte Vorsprung vor RoBERTa beim makro-gemittelten F1 der Token-Klassifikation mit eingefrorenen Encodern und linearen Köpfen, über vier Datasets und Stichproben verschiedener Trainingsgrößen (Bogdanov et al., 2024).
Beide Papers zeigen, dass ein kleineres Model aus LLM-Annotationen lernen kann. Keines zeigt, dass der Schüler seinen Lehrer in einer neuen Domäne schlägt; deshalb führt die Pipeline unten ein separat geprüftes Test-Set.
Die CFM-Fallstudie
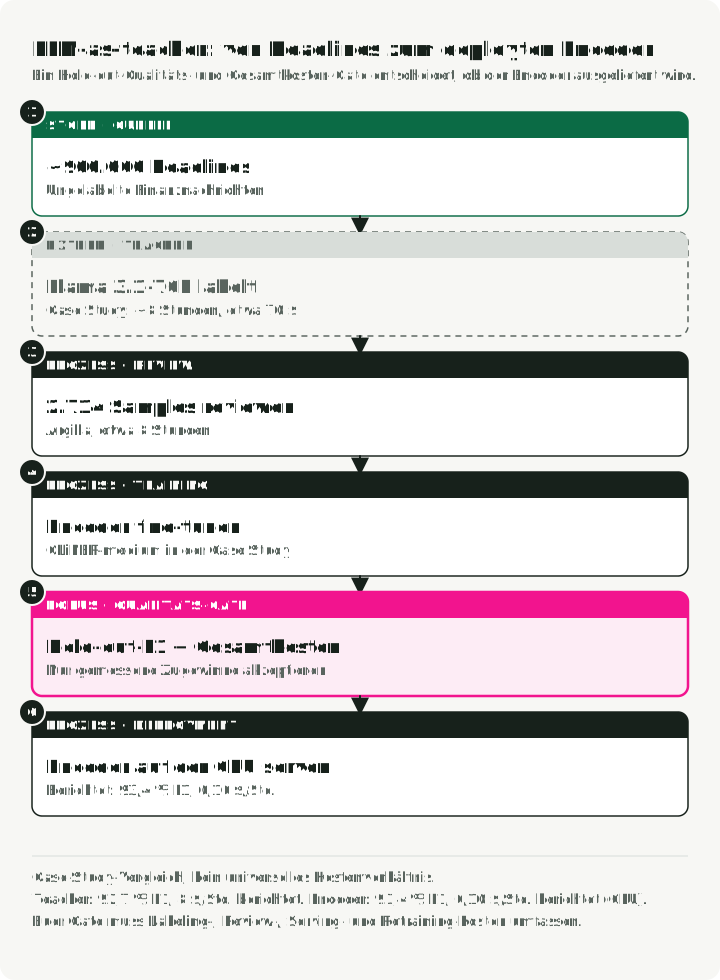
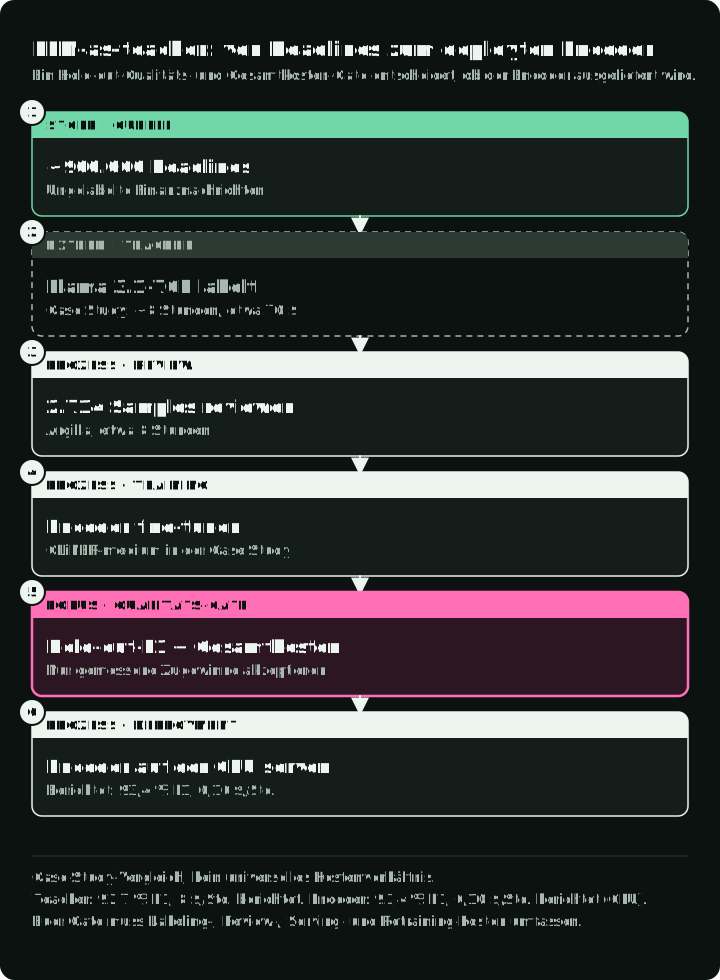
In einer Hugging-Face-Fallstudie extrahierte Capital Fund Management Firmennamen aus rund 900.000 Finanznachrichten-Schlagzeilen. Zero-Shot-GLiNER erreichte 87,0 % F1. Das Team ließ Llama 3.1-70B das Dataset in etwa 8 Stunden für rund $70 annotieren und prüfte dann 2.714 Samples über Argilla in weiteren 8 Stunden.
Das Fine-Tuning von GLiNER auf diesen Daten erreichte in der Fallstudie 93,4 % F1, verglichen mit 92,7 % beim Lehrer Llama-70B. Die Autoren nennen $0,10 pro Stunde auf der CPU für das feinabgestimmte Model und $8 pro Stunde für den Lehrer (CFM-Fallstudie). Diese Zahlen beschreiben eine Finanznachrichten-Aufgabe und ein Infrastruktur-Setup.
Die Refuel-AI-Studie
Der Technical Report von Refuel AI, einem Anbieter, bewertet das LLM-Labeling über 8 NLP-Datasets, darunter CoNLL-2003. Er nennt 88,4 % Übereinstimmung mit der Ground Truth für GPT-4 (März 2023) und 86,2 % für die menschlichen Annotatoren in seinem Setup, dazu 20-mal schnelleres und 7-mal günstigeres Labeling. Ein separates Ensemble-Experiment mit proprietären Daten überschritt 95 % Übereinstimmung, bei 89 % für das beste einzelne LLM. Konfidenzbasiertes Routing an günstigere oder stärkere Models ist ein vorgeschlagener Einsatz, nicht der gemessene Mechanismus hinter dem Ergebnis über acht Datasets (Refuel AI Technical Report).
Eine Produktiv-Pipeline
Ein praxistauglicher Produktivablauf hat sechs Schritte. Das Diagramm ordnet jeden Schritt der Bahn desjenigen zu, der ihn ausführt, mit den CFM-Zahlen und der Schleife zurück zum Review, wenn der Schüler sein Ziel verfehlt. Das Diagramm darunter vergleicht F1 und Stundenkosten von CFM für Lehrer und Schüler.
- Schreiben Sie Annotationsrichtlinien in natürlicher Sprache.
- Erstellen Sie von Menschen gelabelte Development- und zurückgehaltene Test-Sets. Der Abschnitt zur Evaluation unten beschreibt ein Verfahren, um sie zu dimensionieren.
- Lassen Sie ein LLM mit versioniertem Prompt und explizitem Ausgabeschema Trainingslabels in großer Menge vorschlagen. Behalten Sie das angeforderte und das tatsächlich genutzte Model, den Prompt und den Quelltext. Verwerfen Sie unbekannte Typen und Spans, die sich nicht am Quelltext ausrichten lassen.
- Prüfen Sie eine Teilmenge über Argilla oder Label Studio.
- Stimmen Sie einen kompakten Encoder fein ab (GLiNER, SpanMarker, RoBERTa). Für GLiNER nutzen Sie das
train.pydes Repositorys (python train.py --config configs/config.yaml) oder die Methodetrain_model()des Models, mit der geprüften Train-Datei als Trainingsdaten und der Development-Datei für die Evaluation während des Trainings. - Deployen Sie erst, nachdem der Encoder eine Prüfung auf zurückgehaltene Qualität und Gesamtkosten bestanden hat. CFM berichtete in seinem Setup 16–80-mal niedrigere stündliche Infrastrukturkosten; beziehen Sie in Ihren Vergleich Annotation, Review, Serving und erneutes Training ein.
Das LLM kann den Umfang der manuellen Annotation senken, aber das Team bleibt für das Validierungs-Set, die Annotationsrichtlinien, gezieltes Review und die Fehleranalyse verantwortlich.
Der Companion zeigt einen Vorschlag des Lehrers und konvertiert geprüfte Annotationen für Schritt 5 (README-Abschnitt). Führen Sie diese Befehle im Companion-Repository mit Python 3.11+, uv und den über uv sync --locked --all-extras installierten Abhängigkeiten aus. Setzen Sie OPENAI_API_KEY für den kostenpflichtigen Lehreraufruf. Die Konvertierung benötigt die Dateien des festgelegten GLiNER-Models und seines Backbones im Cache; uv run --all-extras python -m ner_demo.quickstart --download lädt sie einmal herunter.
-
Führen Sie die Lehrer-Demo für ein Dokument aus. Sie stellt eine kostenpflichtige Anfrage für einen festen Satz über NVIDIAs geplante Übernahme von Arm und schreibt einen ungeprüften Datensatz in
artifacts/teacher_annotations.jsonl:uv run --all-extras python -m ner_demo.teacher --allow-paid -
Prüfen Sie den Vorschlag von Hand und klären Sie abgelehnte Annotationen. Erstellen Sie
artifacts/reviewed.jsonlmit geprüften Trainingsdokumenten und den separat von Menschen gelabelten Development- und Test-Dokumenten aus dem oben beschriebenen Produktionsablauf. Alle drei Splits müssen nicht leer sein, Dokument-IDs müssen eindeutig sein, und kein Quelltext darf in mehreren Splits vorkommen. Kopieren Sie den Demo-Satz nicht zwischen Splits. Setzen Sie für jeden Datensatzreviewed: true, einenreviewer,status: "ok"und einensplit(train,developmentodertest), und halten Siesource_sha256mit dem Quelltext konsistent. Ein Demo-Datensatz kann nicht alle drei Splits liefern. -
Konvertieren Sie die vollständige geprüfte Datei. Das schreibt
train.json,development.jsonundtest.jsonunterartifacts/training/im Trainingsformat von GLiNER, nachdem jede Zeile durch den eigenen Data Collator von GLiNER gelaufen ist:uv run --all-extras python -m ner_demo.training artifacts/reviewed.jsonl
Übergeben Sie train.json und development.json an den GLiNER-Fine-Tuning-Lauf in Schritt 5 und behalten Sie test.json für die abschließende Prüfung.
Wo GLiNER scheitert und LLMs nützlich bleiben
Der Sease-Benchmark (Oktober 2025) testete GLiNER gegen GPT-4.1-mini an 30 Aufgaben zum Parsen von Suchanfragen. GPT-4.1-mini erreichte 100 % vollständig korrekt. GLiNER kam auf 53 % (16 von 30). Dafür antwortete GLiNER in 0,08 Sekunden gegenüber 1,21 Sekunden beim LLM, 15-mal schneller.
In diesem Benchmark mit 30 Aufgaben scheiterte GLiNER in drei wiederkehrenden Mustern:
- Implizite Entities: „event“ aus „Elton John performed at Madison Square Garden“ extrahieren. Nirgends steht im Text wörtlich „event“, aber das LLM schließt auf „concert“.
- Empfindlichkeit gegenüber der Label-Formulierung: „2022“ erhält 0,388 gegen „date“, aber 0,958 gegen „year“. Kleine Änderungen am Label verursachen große Schwankungen beim Score.
- Wert-Mapping: GLiNER gibt den exakten Oberflächentext zurück („family houses“) statt des kanonischen Werts („Single family house“). Ein LLM kann diese Normalisierung leisten, wenn sein Prompt und sein Schema die Zielwerte definieren.
Verschachtelte und überlappende Entities
Eine verschachtelte Entity liegt innerhalb einer anderen. In „New York University“ ist „New York“ ein Ort innerhalb eines Organisationsnamens. Biomedizinische Texte („acute myeloid leukemia“ innerhalb einer längeren Diagnose) und juristische Texte (eine Abteilung innerhalb einer benannten Behörde) haben dasselbe Muster.
GLiNER dekodiert standardmäßig flach und unterdrückt überlappende Spans. Seine API unterstützt auch flat_ner=False, was überlappende Vorhersagen erlaubt:
entities = model.predict_entities(
    "She studied at New York University.", ["organization", "location"],
    flat_ner=False, threshold=0.3)
# [{'text': 'New York University', 'label': 'organization', 'score': 0.855, ...}]
Mit urchade/gliner_medium-v2.1 lieferte dieser Aufruf nur die Organisation, selbst bei einem Threshold von 0,05. Das Abschalten des flachen Decodings erlaubt verschachtelte Ausgabe, aber der Checkpoint muss den inneren Span trotzdem über dem Threshold bewerten. Enthalten Ihre Daten verschachtelte Entities, bauen Sie ein verschachteltes Test-Set und prüfen Sie, ob die inneren Spans überhaupt erscheinen, bevor Sie GLiNER einem spezialisierten Model für verschachteltes NER vorziehen.
Nutzen Sie GLiNER für explizite Entity-Extraktion und leiten Sie Fälle, die Inferenz, Reasoning oder Mapping auf vordefinierte Ontologien verlangen, an ein LLM. Der Schwellenwert fürs Routing sollte aus einem gelabelten Domänen-Set stammen.
NER evaluieren: Metriken, Fallstricke und Test-Sets
Jede Zahl in diesem Leitfaden stammt aus dem Model, den Daten und der Hardware ihrer Quelle. Wiederholen Sie den Vergleich auf Ihrem eigenen gelabelten Set, bevor Sie sich entscheiden. Dieser Abschnitt erklärt, wie Sie dieses Set bauen und bewerten.
Ein Model kann auf einem kuratierten Test-Set 95 % F1 erreichen und trotzdem an der Dokumentmischung scheitern, die es nach dem Deployment sieht. Bauen Sie das Evaluations-Set aus der Produktionsverteilung und behalten Sie Slices für die seltenen Formate und Entity-Typen, die der aggregierte F1 verbergen kann.
Die Kernmetriken
Identifizieren Sie jedes Vorkommen über Dokument-ID, halboffene Start-/End-Offsets und Typ, und prüfen Sie, dass text[start:end] die Erwähnung wiedergibt. Zwei Vorkommen von „John“ sind zwei Ziele. Die Abbildung bewertet drei Vorhersagen für einen Satz.
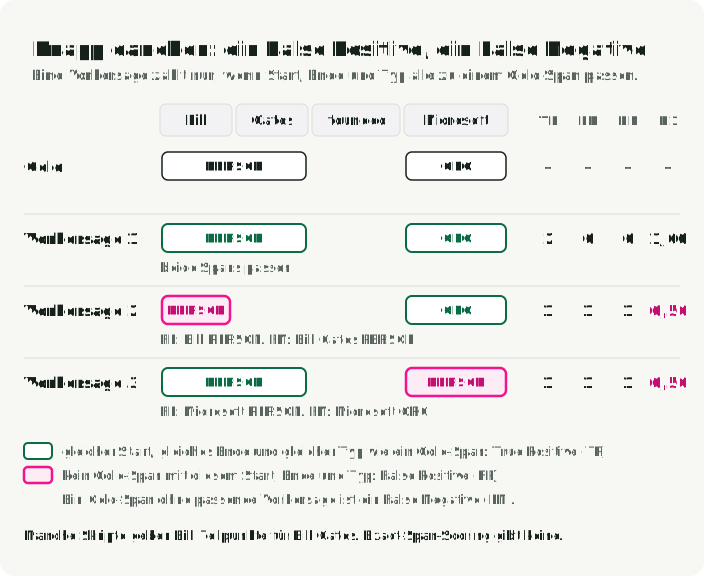
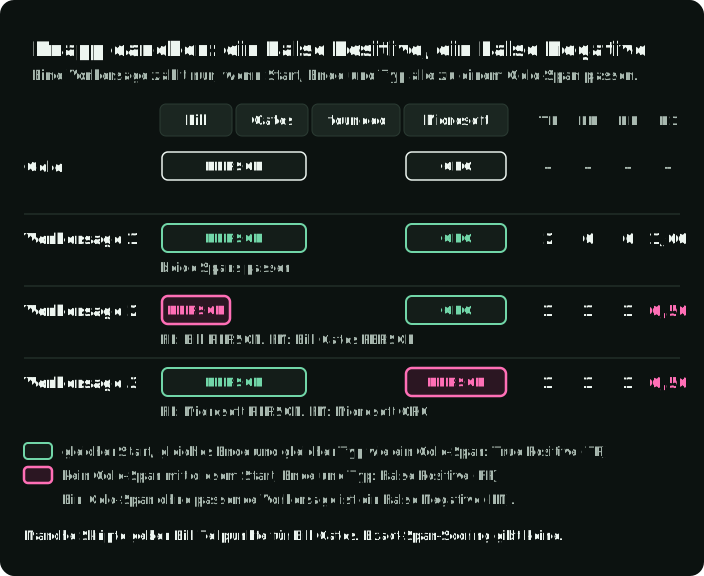
Validieren Sie die Dokumentanzahl vor dem Matching: Fehlende Vorhersagen müssen False Negatives erzeugen, nicht über zip() verschwinden. Zählen Sie falsche Typen oder Offsets als nicht zugeordnete Vorhersage und nicht zugeordneten Gold-Span. Berichten Sie Micro-Precision, -Recall und -F1, Support und Recall pro Typ, und definieren Sie die Makro-Aggregation und leere Fälle. Der exakte Evaluator des Companions setzt diese Regeln um und lässt fehlende, fehlgeschlagene und übersprungene Dokumente im Nenner der Gold-Daten.
- Entity-Level-F1: Die Standardmetrik. Eine Vorhersage ist nur dann korrekt, wenn sowohl die Span-Grenzen als auch der Typ exakt mit der Ground Truth übereinstimmen. Das berichten die meisten Papers.
- Token-Level-F1: Bewertet jedes Token unabhängig. Sie kann eine teilweise getroffene Grenze besser aussehen lassen als ein Exact-Span-Score; berichten Sie daher Exact-Span-F1, wenn die Korrektheit der Grenzen zählt, und nutzen Sie Token-Level-Metriken nur, wenn die nachgelagerte Entscheidung auf Token-Ebene fällt.
- Precision vs. Recall: Beide haben oft asymmetrische Kosten. Bei der De-Identifikation zählt der Recall mehr: Einen Namen zu übersehen ist schlimmer als zu viel zu schwärzen. Bei der Datenbank-Extraktion zählt die Precision mehr: falsche Einträge verfälschen die nachgelagerte Analyse.
Häufige Fallstricke bei der Evaluation
- Aufgeblähte Teiltreffer: „Bill“ wird extrahiert, obwohl das Gold-Label „Bill Gates“ lautet. Manche Skripte zählen das als Teiltreffer. Nutzen Sie Exact-Span-Matching, sofern nichts dagegen spricht.
- Typverwechslung: „Microsoft“, als Span korrekt erkannt, aber als PERSON statt ORG gelabelt, sollte null Punkte bekommen. Prüfen Sie, dass Ihr Evaluationscode das so handhabt.
- Leakage im Test-Set: Halten Sie doppelte und nahezu doppelte Datensätze, Dokumente und Annotationen aus dem Test-Set heraus. Für eine harte Zero-Shot-Aussage halten Sie auch die Ziel-Entity-Typen aus dem Training heraus; wiederholte Oberflächenstrings allein sind kein Leakage.
- Unkontrollierte Label-Prompts: Ein kurzer Typname und eine getestete Typbeschreibung sind verschiedene Eingaben. Versionieren Sie Label-Beschreibungen, Thresholds, Checkpoint-Revisionen und den Decoding-Modus zusammen mit dem Score.
- Zero-Shot-Aussagen für nur eine Sprache: Schließen Sie nicht vom Englischen auf mehrsprachige Qualität. OpenNER umfasst 36 Korpora und 52 Sprachen, und seine Baselines fanden kein einzelnes Model, das in jeder Sprache am besten war (Palen-Michel et al., 2025). In FiNERweb-Experimenten veränderte der Wechsel von englischen zu zielsprachigen Labels den F1 je nach Setting um 0,02–0,09 (Golde et al., 2026). Testen Sie beide Label-Sprachen, wenn das Produkt lokale Terminologie nutzt.
- Ein einzelner Lauf als Endergebnis: Berichten Sie, wo anwendbar, die Streuung über Random Seeds, Threshold-Sweeps und wiederholte Produktionsstichproben. Kleine Slice-Größen machen ein Model-Ranking instabil.
Halten Sie Normalisierung, Entity Linking, Datensatzgruppierung und Relations-Endpunkte getrennt vom extraktiven F1. Berichten Sie für den Datenschutz durchgesickerte Instanzen und betroffene automatisch akzeptierte Dokumente, falsche Schwärzungen und den Anteil im Review. Berichten Sie für das Serving die Abschlussrate, die p50/p95-Dokument-Latency, kalte und warme Läufe, Batch- und Label-Größen, den Spitzenspeicher und die Kosten pro akzeptiertem Dokument.
Ein Domänen-Test-Set bauen
Für die Evaluation im Produktivbetrieb empfehle ich:
- Stichprobe aus Produktionsdaten, nicht aus kuratierten Beispielen. Nehmen Sie die unordentlichen Dokumente auf, die Ihr Model tatsächlich sehen wird.
- Das Test-Set anhand eines Piloten dimensionieren. Labeln Sie einen Piloten mit etwa 50 Dokumenten, zählen Sie die Gold-Spans pro Label und bootstrappen Sie den Recall pro Label. Fügen Sie Dokumente hinzu, bis das 95-%-Intervall für das seltenste Label, das Ihnen wichtig ist, schmaler ist als der Unterschied, den Sie erkennen wollen.
- Mindestens zwei Annotatoren auf einer Calibration-Teilmenge einsetzen. Klären Sie Abweichungen und berichten Sie den Exact-Span-F1 zwischen den Spans beider Annotatoren. Die Übereinstimmung zeigt, wo die Richtlinien mehrdeutig sind; sie ist keine Obergrenze für die Leistung des Models.
- Nach Schwierigkeit stratifizieren: leichte Fälle (sauberer Text, Standardtypen) und schwere Fälle (mehrdeutige Entities, Fachjargon, verrauschter Text).
- Datenschutz- und Fairness-Slices führen. Berichten Sie bei PII den Recall nach PII-Typ, Sprache, Locale, Dokumentformat und relevanten demografischen Slices oder Slices nach Namensherkunft. Minimieren Sie den Zugriff der Evaluatoren auf rohen sensiblen Text, legen Sie Aufbewahrungsfristen fest und prüfen Sie False Negatives.
Kontinuierliches NER braucht ein unveränderliches Regressions-Set
Taxonomien im Produktivbetrieb ändern sich. Fügen Sie neue Typen hinzu, ohne stillschweigend zu ändern, was ein alter Typ bedeutet. Führen Sie ein versioniertes, unveränderliches Regressions-Set für bestehende Typen, ein separates Test-Set für den neuen Typ und ein Changelog für Änderungen an den Annotationsrichtlinien. Berichten Sie die Scores für alte und neue Typen getrennt, bevor Sie einen Checkpoint ersetzen. So erkennen Sie am einfachsten Vergessen und Taxonomie-Drift.
NER im Produktivbetrieb in vier Branchen
Jede Domäne extrahiert andere Dinge und hat einen anderen veröffentlichten Ausgangspunkt. Die letzte Spalte nennt den Vorbehalt, der ändert, was Sie zuerst testen.
| Domäne | Was extrahiert wird | Ausgangspunkt | Vorbehalt, der eine Wahl ändert |
|---|---|---|---|
| Gesundheitswesen | Namen, Daten, IDs und andere PHI zur De-Identifikation | Die oben genannten Evaluationen von John Snow Labs und Providence; die offenen medizinischen NER-Models von OpenMed | Berichten Sie durchgesickerte Instanzen und betroffene Dokumente, nicht nur F1. |
| Finanzwesen | Firmenerwähnungen in Nachrichten; Felder in Meldungen | Die CFM-Fallstudie für Nachrichten; FinBERT-MRC für Meldungen (92,78 F1 auf ChFinAnn, 96,80 auf AdminPunish) | Die Ergebnisse von FinBERT-MRC beziehen sich auf chinesische Meldungen; testen Sie englische SEC-Filings, lange Dokumente und verschachtelte Entities getrennt. |
| E-Commerce | Produkttyp, Marke und Attribute in Suchanfragen | Walmarts EAMT (rund 60 NER-Labels für Anfragen); Home Depots TripleLearn (F1 auf zurückgehaltenen Daten 69,5 → 93,3, seit über 9 Monaten in Produktion) | Die Methode von TripleLearn sind wiederholte Runden domänenspezifischer Überwachung; das Paper vergleicht keine aktuellen Architekturen. |
| Cybersicherheit | Malware, Bedrohungsakteure und Indicators of Compromise | CyNER (76,66 Span-Micro-F1, XLM-RoBERTa-large); CyberNER (21 STIX-2.1-Labels, RoBERTa 0,736 F1) | Nur Forschungs-Datasets; die Label-Sets unterscheiden sich, ordnen Sie sie daher vor einem Model-Vergleich STIX zu. |
Deployment-Optimierung: von Python zu Inference mit geringerer Latency
Besteht ein Model das Domänen-Test-Set, lautet die nächste Frage, wie Sie es bereitstellen. So würde ich die Runtimes ausprobieren, mit einer Prüfung nach jedem Schritt. Ändern Sie jeweils nur eine Sache, damit ein Qualitätsverlust genau eine Ursache hat.
- Mit PyTorch und Ray Serve bereitstellen.
- ONNX FP32 exportieren oder mit gline-rs ausführen. Unterscheiden sich die Spans von PyTorch, korrigieren Sie den Export.
- Auf dynamisches INT8 quantisieren und die FFN-Down-Projections in FP32 lassen.
- INT8 nur deployen, wenn der Recall pro Label im Ziel bleibt. Sonst bei FP32 bleiben.
Natives GLiNER-Serving
Testen Sie vor dem Wechsel auf eine neue Runtime den Ray-Serve-Pfad des Projekts. gliner[serve] bietet dynamisches Batching, speicherbewusste Batch-Größen, Skalierung über mehrere Replicas und einen HTTP-Client. Batching und Replicas können den Throughput steigern und den Model-Code beibehalten. Batching erzeugt aber auch Wartezeit; messen Sie daher die Queue-Latency und die Warm-Latency unter Ihrer Anfragemischung.
ONNX-Export
GLiNER hat eine native ONNX-Konvertierung, und vorkonvertierte Models gibt es auf Hugging Face (onnx-community/gliner_small-v2.1). Der Export schreibt Graph, Config und Tokenizer in ein Verzeichnis, und dieselbe GLiNER-Klasse lädt es mit demselben predict_entities-Aufruf wieder:
from gliner import GLiNER

model = GLiNER.from_pretrained("urchade/gliner_medium-v2.1")
model.export_to_onnx("onnx/fp32")

onnx_model = GLiNER.from_pretrained("onnx/fp32", load_onnx_model=True)
entities = onnx_model.predict_entities(text, labels, threshold=0.5)
Der ONNX-Vergleich des Companions führt PyTorch, ONNX FP32 und ONNX INT8 mit denselben Eingaben aus und vergleicht deren Spans. Er braucht Python 3.11+ und uv. Der Data-Befehl lädt einen festgelegten Few-NERD-Shard herunter und behält dessen erste 32 Sätze, genug, um den Export zu prüfen, nicht um Models zu ranken. Der Quickstart mit --download lädt den festgelegten Checkpoint einmal herunter:
uv sync --locked --all-extras
# Run once if the pinned model files are not cached:
uv run --all-extras python -m ner_demo.quickstart --download
uv run --all-extras python -m ner_demo.data --split test --limit 32
uv run --all-extras python -m ner_demo.onnx_check \
  --dataset artifacts/few-nerd-test.json --output artifacts/onnx-comparison
Verwenden Sie ein neues Ausgabeverzeichnis oder --reuse, um vorhandene Pakete zu prüfen. Der Befehl schlägt fehl, wenn sich FP32-Spans von PyTorch unterscheiden oder INT8 mehr als 0,02 Micro-Recall verliert. Auf einer Apple-M5-Max-CPU lieferte ONNX FP32 exakt die Spans von PyTorch mit einer p50-Latency von 16–19 ms pro Satz, gegenüber 64–66 ms bei PyTorch.
INT8-Quantization
Dynamische INT8-Quantization speichert Weights als 8-Bit-Ganzzahlen und verkleinert die ONNX-Datei. Beim DeBERTa-Encoder von GLiNER funktioniert es nicht, jede Schicht zu quantisieren. Im Companion lieferte die Quantization aller MatMul-Schichten überhaupt keine Entities. Das Quantisieren der Schichten gruppenweise zeigte die Ursache: Allein die zwölf FFN-Down-Projections (layer.N/output/dense, die zweite lineare Schicht des Feed-Forward-Netzes jedes Encoder-Blocks) drücken jeden Score unter den Threshold. Diese zwölf Schichten in FP32 zu belassen, behebt es. Der Code kopiert das FP32-Paket (wegen der Config- und Tokenizer-Dateien) und quantisiert dann alles andere:
import shutil

import onnx
from onnxruntime.quantization import QuantType, quantize_dynamic

shutil.copytree("onnx/fp32", "onnx/int8")
graph = onnx.load("onnx/fp32/model.onnx", load_external_data=False).graph
keep_fp32 = [n.name for n in graph.node if n.op_type == "MatMul" and "/output/dense/" in n.name and "/attention/" not in n.name]

quantize_dynamic("onnx/fp32/model.onnx", "onnx/int8/model.onnx",
                 weight_type=QuantType.QInt8,
                 op_types_to_quantize=["MatMul", "Gemm", "Gather"],
                 nodes_to_exclude=keep_fp32)
Laden Sie onnx/int8 wie bei FP32 mit load_onnx_model=True. Das quantize_package des Companions tut dasselbe und validiert danach das Paket. Auf den 32 Few-NERD-Sätzen (Apple M5 Max, ONNX Runtime 1.24.4) waren die gemessenen Ergebnisse:
| Pfad | Paket | p50-Latency | Micro-Precision | Micro-Recall |
|---|---|---|---|---|
| PyTorch | - | 64–66 ms | 0,506 | 0,722 |
| ONNX FP32 | 790 MB | 16–19 ms | 0,506 | 0,722 |
| ONNX INT8 | 353 MB | 13–15 ms | 0,487 | 0,722 |
INT8 verkleinerte das Paket auf weniger als die Hälfte und behielt den Recall, veränderte aber die Spans in 4 von 32 Sätzen und fügte 3 False Positives hinzu. In diesem Lauf lohnt sich INT8, wenn Speicher oder Paketgröße die Grenze sind; bei der Latency allein kam der größte Teil des Gewinns vom FP32-ONNX-Export. Prüfen Sie den Recall pro Label gegen FP32 auf Ihren eigenen Daten, bevor Sie es deployen: Eine kleinere Datei sagt nichts über die Extraktionsqualität. Aktuelle GLiNER-Empfehlungen raten zu Quantization-Aware Training, wenn INT8 die Genauigkeit von FP32 erreichen muss.
gline-rs: Rust-Reimplementierung
gline-rs (Apache 2.0) nimmt die Python-Runtime aus dem Inference-Pfad. Das Projekt nennt in seinem eigenen Benchmark etwa den vierfachen CPU-Throughput von Python. Es unterstützt Span- und Token-Models, GPU/NPU über ONNX Runtime und wird als Crate auf crates.io ausgeliefert. Es lädt einen ONNX-Export und dessen tokenizer.json, etwa das oben geschriebene Paket; das Projekt-README zeigt den Rust-Aufruf.
Das Paket fast-gliner bietet Python-Bindings über PyO3.
Welche Runtime wann
| Pfad | Einsetzen, wenn | Verfügbare Belege | Vor dem Deployment messen |
|---|---|---|---|
| Natives Ray Serve | Sie bei Python bleiben und Batching und Replicas ergänzen wollen | Projektdokumentation von GLiNER | Queue-Latency, Warm-Latency, Throughput |
| ONNX FP32 | Erster Runtime-Wechsel auf beliebiger Hardware | Companion: dieselben Spans wie PyTorch, 3,4–4× niedrigere Latency | Warm-Latency, Throughput und Exact-Span-F1 |
| ONNX INT8 | Speicher oder Paketgröße ist auf der CPU die Grenze | Companion: 353 MB vs. 790 MB, gleicher Recall, 3 zusätzliche FPs | Recall und Precision pro Label gegen FP32 |
| gline-rs | Sie die Python-Runtime entfernen müssen | Projekt-Benchmark mit dokumentierter Hardware und Setup | Ihr Model-Modus, Labels, Hardware und Batch |
Strukturierte Extraktion: native Schemas, Instructor und lokale Decoder
Brauchen Sie mehr Flexibilität, als Encoder-Models bieten (implizite Entities, Reasoning, Ontologie-Mapping), beginnen Sie mit dem nativen Schema-Mechanismus des Anbieters. OpenAI unterstützt strikte json_schema-Antwortformate, Anthropic Structured Outputs unterstützt JSON-Ausgaben und strikte Tool-Eingaben, und die Gemini API unterstützt eine Teilmenge von JSON Schema. Ein gemeinsames Pydantic- oder Zod-Model kann den Vertrag beschreiben, aber jeder Anbieter akzeptiert eine andere Schema-Teilmenge und verhält sich bei Ablehnung und Komplexität anders.
Schema-Konformität macht das Parsen verlässlich. Sie beweist nicht, dass ein extrahierter Span im Quelltext existiert oder dass ein normalisierter Wert stimmt. Validieren Sie Feldwerte, bewahren Sie wenn möglich Offsets oder Zitate auf und bewerten Sie die semantische Genauigkeit auf einem gelabelten Set.
Die drei Bibliotheken unten erzwingen Struktur auf unterschiedliche Weise. Die Abbildung lässt einen Satz durch jede laufen: Instructor validiert und wiederholt, Outlines sperrt beim Decoding ein ungültiges Label, und LangExtract liefert Zeichen-Offsets für jedes Feld.
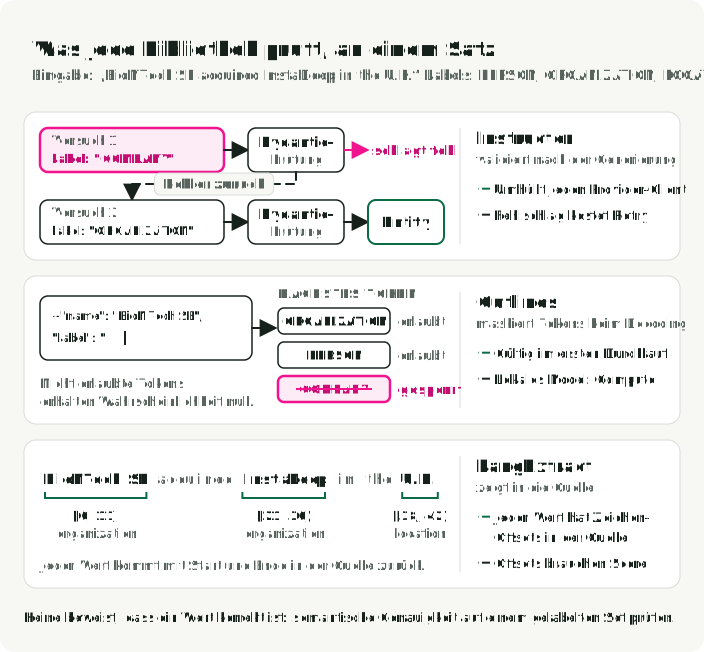
Instructor umhüllt Anbieter-Clients mit Pydantic-Validierung und optionalen Wiederholungen nach Validierungsfehlern.
Dieses eigenständige Beispiel erfordert pip install instructor openai pydantic, einen OPENAI_API_KEY und eine kostenpflichtige Anfrage beim Anbieter. Jedes Model mit Unterstützung für Structured Output funktioniert hier; das Beispiel nutzt gpt-5.4-mini, denselben Standard wie der Lehrer des Companions.
import instructor
from pydantic import BaseModel
from typing import List, Literal
from openai import OpenAI

class Entity(BaseModel):
    name: str
    label: Literal["PERSON", "ORGANIZATION", "LOCATION"]

class ExtractEntities(BaseModel):
    entities: List[Entity]

client = instructor.from_openai(OpenAI())
result = client.chat.completions.create(
    model="gpt-5.4-mini", reasoning_effort="none",
    response_model=ExtractEntities,
    messages=[{"role": "user", "content": "BioNTech SE acquired InstaDeep in the U.K."}])
# entities=[Entity(name='BioNTech SE', label='ORGANIZATION'), ...]
Outlines von dottxt wählt einen anderen Ansatz: Constrained Token Generation über endliche Automaten. Der Decoder maskiert Tokens, die die Zielgrammatik verletzen würden, statt auf einen Validierungsfehler zu warten und zu wiederholen. Ein AWS-Überblick nennt 98 % Schema-Einhaltung gegenüber 76 % bei Validierung nach der Generierung. Er wiederholt außerdem die Aussage von .txt Engineering, die Generierung sei bis zu 5-mal schneller, ohne genug Methodendetails, um beide Zahlen zu vergleichen.
In Outlines umhüllt outlines.from_transformers ein Hugging Face Model und seinen Tokenizer. Ruft man dieses Model mit einem Prompt und einer Pydantic-Klasse wie ExtractEntities oben auf, liefert es JSON, das zur Klasse passt. Nehmen Sie in einen neuen Vergleich für selbst gehostete Extraktion das aktuelle Qwen3.8-27B oder die kleineren Qwen3.5-Checkpoints auf. Laden Sie sie mit ihrem dokumentierten Model-Loader, Chat-Template und Serving-Backend; eine multimodale Architektur oder ein Reasoning-Format kann mehr erfordern als eine neue Model-ID.
LangExtract ist nützlich, wenn ein generiertes Feld im Quelltext verankert sein muss: Es gibt Zeichenintervalle zurück und unterstützt gehostete oder lokale LLM-Backends. Für selbst gehostete Dokumentextraktion wandelt NuExtract JSON-Schemas in Templates um und enthält multimodale Dokument-Models. Beides sind Systeme für strukturierte Extraktion, kein direkter Ersatz für Span-NER: Ihre Feld-, Offset- und Layout-Ausgaben brauchen eigene Scores.
Die Wahl hängt davon ab, wo Sie Ihre Models betreiben. Native Schemas sind der Weg mit der geringsten Reibung für einen unterstützten Anbieter. Instructor ergänzt eine anbieterunabhängige Schicht für Pydantic-Validierung und Wiederholung. Outlines schränkt lokale Generierung gegen ein Schema ein. LangExtract legt den Schwerpunkt auf Quellenverankerung, während NuExtract auf selbst gehostete Dokumentextraktion zielt. Alle LLM-Pfade enthalten weiterhin autoregressive Generierung und brauchen daher meist pro Dokument länger als ein Encoder auf derselben Hardware.
Die dreistufige Produktionsarchitektur
Ich würde NER im Produktivbetrieb nach Aufgabenform routen statt nach einem einzigen Model-Ranking. Jede Zeile der Abbildung zeigt eine Beispielanfrage, was zurückkommt, und die zu testenden Models. Geprüfte Fälle der Stufe 3 kehren nur als im Quelltext gefundene Spans zu Stufe 1 zurück.
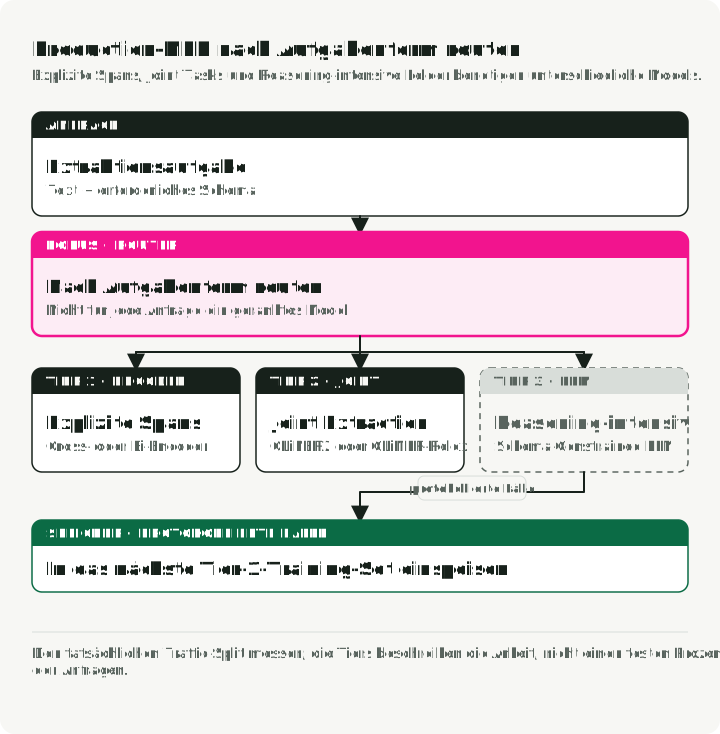
Stufe 1: Encoder-Models für explizite Spans. Nutzen Sie einen GLiNER Cross-Encoder für ein kleines Typ-Inventar. Wird ein großes Inventar wiederverwendet, vergleichen Sie den Bi-Encoder mit gecachten Typ-Embeddings. Stimmen Sie über die LLM-as-Teacher-Pipeline fein ab und deployen Sie dann mit nativem Serving, ONNX, INT8 oder gline-rs, aber nur, wenn dieser Pfad den Domänen-Benchmark besteht.
Stufe 2: Multi-Task- oder Relation-Extraktion. Braucht eine Anfrage NER, Klassifikation und hierarchische Felder, testen Sie den aktuellen GLiNER2.5-Checkpoint mit 194M Parametern gegen separate Baselines pro Aufgabe. Ist die zentrale Anforderung die gemeinsame Extraktion von Spans plus Relationen, testen Sie GLiNER-Relex. Das GLiNER2-Paper nennt 130–208 ms CPU-Klassifikations-Latency über seine getesteten Label-Anzahlen; die spätere Relations-API hat es nicht gemessen.
Stufe 3: LLMs für Extraktion mit viel Reasoning. Leiten Sie implizite Entities, kontextuelle Inferenz und Ontologie-Mapping an eine native Schema-API oder Instructor für Cloud-APIs und an Outlines für lokale eingeschränkte Ausgabe. Nutzen Sie LangExtract, wenn Quellintervalle wesentlich sind, und NuExtract, wenn das Dokument selbst die Eingabe ist. Protokollieren Sie diese Fälle für das Review. Nur explizite, am Quelltext ausgerichtete Spans können zu gewöhnlichen Trainingszielen der Stufe 1 werden; abgeleitete Fakten und normalisierte Werte brauchen eigene Ziele und eine eigene Evaluation.
Die CFM-Fallstudie liefert eine Kostenreferenz für Stufe 1: 93,4 % F1 bei berichteten $0,10 pro Stunde auf der CPU, verglichen mit 92,7 % F1 und $8 pro Stunde für den Lehrer Llama-70B. Stündliche Instanzpreise bestimmen die Kosten pro Dokument nicht ohne den Throughput. Rechnen Sie mit Ihrer Hardware, Ihrem Lehrer-Model, Ihrem Label-Set, Ihrer Auslastung und Ihren Review-Kosten neu.
Zielkonflikte und Grenzen
Fehler des LLM-Lehrers pflanzen sich fort. Verwechselt das LLM durchgängig einen bestimmten Entity-Typ (z. B. Namen von Tochtergesellschaften mit denen der Muttergesellschaft), erbt der feinabgestimmte Encoder diese Verzerrung. Prüfen Sie Typen mit niedriger Konfidenz oder inkonsistenten Labels intensiv und behalten Sie eine stratifizierte Zufallsstichprobe, um sichere systematische Fehler zu finden.
Ein gültiges Schema kann falsche Fakten enthalten. Natives Structured Output, Instructor und eingeschränkte Decoder können eine Antwort parsbar machen. Sie können nicht sicherstellen, dass jedes Feld belegt ist, dass eine Span-Grenze stimmt oder dass ein normalisierter Wert auf den richtigen Datensatz zeigt. Behalten Sie die Quellbelege und validieren Sie die Semantik getrennt.
Verluste durch Quantization hängen vom Checkpoint und den quantisierten Schichten ab. Das Quantisieren jeder MatMul-Schicht des GLiNER im Companion lieferte keine Entities; die FFN-Down-Projections in FP32 zu belassen, erhielt den Recall in der Prüfung mit 32 Sätzen. Ein anderer Checkpoint kann andere empfindliche Schichten haben. Vergleichen Sie vor dem Deployment das quantisierte und das Original-Model nach Exact-Span-F1 und Recall pro Label.
Wann die dreistufige Architektur übertrieben ist. Eine einzelne Domäne mit stabilen Entity-Typen und genug gelabelten Beispielen braucht womöglich nur ein feinabgestimmtes RoBERTa oder eine spaCy-Pipeline. Das dreistufige Muster passt zu mehreren Domänen, sich entwickelnden Entity-Typen oder einer gemessenen Mischung aus expliziter und Reasoning-lastiger Extraktion. Eine schmale Rechnungs-Pipeline, die Namen und Daten extrahiert, kann bei Stufe 1 enden.
Die Qualität von Bi-Encodern hängt von Dataset und Checkpoint-Größe ab. Auf CoNLL-2003 erreicht gliner_small-v2.5 65,4 % F1, mehr als die Bi-Encoder edge/small mit 61,6 %/64,2 %, aber weniger als bi-base/large mit 65,6 %/66,5 % (Stepanov et al., 2026, Tabellen 2–3). Wählen Sie anhand der gemessenen Exact-Span-Qualität, Calibration, Labelzahl und Throughput auf Ihrem Domänen-Set.
PII- und mehrsprachige Aussagen erfordern Slices. Ein hoher aggregierter Score kann einen gefährlichen Recall-Verlust für eine Locale, eine Namensform, ein Dokumentlayout oder eine seltene PII-Klasse verbergen. Nutzen Sie ein Datenschutz-Model als eine von mehreren Kontrollen, richten Sie einen Prozess für den Umgang mit False Negatives ein und evaluieren Sie neu, wenn sich Taxonomie, Sprachmischung oder Datenquelle ändern.
Wichtigste Erkenntnisse
- Nutzen Sie einen kompakten Encoder für explizite Spans erst, nachdem er ein Domänen-Test-Set mit Support pro Typ und Konfidenzintervallen bestanden hat.
- Nutzen Sie GLiNER für wechselnde Label-Vokabulare. Vergleichen Sie zuerst den Bi-Encoder, wenn ein großes Typ-Inventar wiederverwendet wird; aktivieren Sie
flat_ner=Falseerst, nachdem Sie geprüft haben, dass der Checkpoint die inneren Spans findet. - Nutzen Sie spaCy oder einen feinabgestimmten Token-Klassifikator, wenn die Labels stabil sind und Sie Trainingsdaten haben.
- Nutzen Sie getestete Typbeschreibungen für harte Zero-Shot-Aussagen und testen Sie bei mehrsprachigen Produkten englische und lokalisierte Label-Formulierungen getrennt.
- Halten Sie OCR, NER, Relation Extraction und Entity Linking als getrennte Evaluationsstufen auseinander, auch wenn ein Model mehrere Aufgaben bereitstellt.
- Behandeln Sie einen LLM-Lehrer als System für Annotationsvorschläge. Menschliche Richtlinien, Adjudikation, unveränderliche Regressions-Sets und ein zurückgehaltenes Test-Set bleiben erforderlich.
- Nutzen Sie native Schemas für unterstützte LLM-Anbieter, validieren Sie aber semantische Korrektheit und Quellenverankerung getrennt von der JSON-Gültigkeit.
- Ändern Sie jeweils einen Runtime-Schritt: zuerst ONNX FP32, dann INT8 mit den empfindlichen Schichten in FP32, mit einem Span-Vergleich nach jedem Schritt.
Referenzen
Papers
- GLiNER: Generalist Model for Named Entity Recognition using Bidirectional Transformer - Zaratiana et al., NAACL 2024. Die grundlegende Architektur für das Matching von Spans und Entities.
- GLiNER2: An Efficient Multi-Task Information Extraction System with Schema-Driven Interface - Zaratiana et al., EMNLP 2025 System Demonstrations. Vereint NER, Klassifikation und hierarchische Extraktion; aktuelle Releases haben später die Relation Extraction ergänzt.
- GLiNER Bi-Encoder: Scalable Named Entity Recognition with Bi-Encoder Architecture - Stepanov et al., Februar 2026. Entkoppeltes Encodieren für Skalierung auf Millionen Labels.
- GLiNER-Relex: A Unified Framework for Joint Named Entity Recognition and Relation Extraction - Stepanov et al., 2026. Gemeinsame Zero-Shot-Extraktion von Entities und Relationen.
- GLiNER2-PII: A Multilingual Model for Personally Identifiable Information Extraction - Zaratiana et al., 2026. 42 PII-Typen mit Auflösung auf Zeichen-Span-Ebene.
- ZeroNER: Fueling Zero-Shot Named Entity Recognition via Entity Type Descriptions - Cocchieri et al., ACL 2025. Harte Zero-Shot-Evaluation mit Typbeschreibungen.
- OpenNER 1.0: Standardized Open-Access Named Entity Recognition Datasets in 50+ Languages - Palen-Michel et al., EMNLP 2025. 36 Korpora, 52 Sprachen und Baselines über mehrere Ontologien.
- FiNERweb: Datasets and Artifacts for Scalable Multilingual Named Entity Recognition - Golde et al., EACL 2026. Mehrsprachige Labels und Transfer-Evaluation.
- UniversalNER: Targeted Distillation from Large Language Models for Open Named Entity Recognition - Zhou et al., ICLR 2024. LLM-basiertes universelles NER durch Destillation aus ChatGPT.
- NuNER: Entity Recognition Encoder Pre-training via LLM-Annotated Data - Bogdanov et al., EMNLP 2024. Untersucht einen 125M-Encoder, der auf LLM-Annotationen vortrainiert wurde.
Industry Papers
- EAMT: Entity-Aware Multi-Task Learning for Query Understanding - Walmart, KDD 2023. Multitask-Verständnis von Suchanfragen mit rund 60 NER-Labels.
- TripleLearn: End-to-End NER for E-Commerce Search - Home Depot, AAAI 2021. F1 von 69,5 auf 93,3.
- CyNER: A Python Library for Cybersecurity Named Entity Recognition - Neuronale Erkennung kombiniert mit anderen Extraktionsquellen.
- CyberNER: A Harmonized STIX Corpus for Cybersecurity NER - 21 an STIX 2.1 ausgerichtete Entity-Typen.
- FinBERT-MRC: Financial NER via Machine Reading Comprehension - MRC-Formulierung, evaluiert auf chinesischen Finanz-Datasets.
Fallstudien
- CFM Case Study: Fine-tuning GLiNER for Financial NER - Die LLM-Labeling-Pipeline von Capital Fund Management für $70 mit 93,4 % F1.
- Refuel AI: LLM Labeling Technical Report - GPT-4 erreicht 88,4 % Annotationsübereinstimmung und übertrifft menschliche Annotatoren.
- Sease: GLiNER as an Alternative to LLMs for Query Parsing - Wo GLiNER scheitert und LLMs weiterhin nötig sind.
- John Snow Labs: Medical Text De-Identification Benchmark - Herstellerstudie mit Label-Remapping und Ausschlüssen.
- OpenMed: Year in Review 2025 - Offene medizinische NER-Models; Rückblick vom Januar 2026.
Tools und Frameworks
- ner-field-guide demo repo - Companion-Code zu diesem Artikel: exaktes Span-Scoring, GLiNER-Beispiele, Konvertierung geprüfter Annotationen, ONNX-FP32- und INT8-Prüfungen und eine Streaming-PII-Demo.
- GLiNER - Library, Trainingsskript und Ray-Serve-Pfad mit dynamischem Batching und Deployment mit mehreren Replicas.
- gline-rs: Rust reimplementation of GLiNER - Rust-Inference über GLiNER-ONNX-Dateien; Code unter Apache 2.0.
- spaCy English pipelines - Versionierte Metriken für Pipelines mit geschlossenen Labels.
- dslim/bert-base-NER - BERT-Token-Klassifikator, auf CoNLL-2003 feinabgestimmt.
- Microsoft Presidio - PII-Analyse und Anonymisierung mit eigenen Recognizern.
- Instructor - Strukturierte LLM-Extraktion über Pydantic-Models.
- Outlines - Constrained Token Generation über FSMs, mit einem berichteten Benchmark zur Schema-Einhaltung.
- LangExtract - Quellenverankerte strukturierte Extraktion mit Zeichenintervallen.
- NuExtract - Selbst gehostete Dokumentextraktion von Schema zu Template.
- OpenAI Structured Outputs - Referenz zum strikten JSON-Schema-Antwortformat.
- Anthropic Structured Outputs - JSON-Ausgaben und strikte Tool-Eingaben.
- Gemini Structured Outputs - Teilmenge von JSON Schema für strukturierte Antworten.
- ONNX Runtime quantization - Referenz für dynamische und statische INT8-Quantization.
- AWS: Structured Output with Outlines - Benchmark mit 98 % Schema-Einhaltung.