Guia de NER 2026: GLiNER, spaCy, Transformers e LLMs

Tradução automática
Este artigo foi traduzido automaticamente a partir da versão original em inglês.
Este guia destina-se a engenheiros que escolhem o reconhecimento de entidades nomeadas (NER) para pipelines de retrieval, privacidade ou processamento de documentos. Explica como escolher entre reconhecedores de spans e extração estruturada com LLM, como avaliar os erros de cada um e como testar as opções de deployment face à latência e ao custo que a sua carga de trabalho permite.
O NER transforma texto em partes etiquetadas que um programa consegue usar. Dada a frase “Bill Gates founded Microsoft on April 4, 1975”, pode devolver os spans de texto contíguos Bill Gates, Microsoft e April 4, 1975, com os tipos pessoa, organização e data. Num encoder baseado em spans, como o GLiNER, o modelo lê o texto uma só vez e pontua os spans candidatos face às etiquetas que fornece.
Num pipeline de retrieval ou de privacidade, a primeira pergunta que eu faria é se o resultado tem de ser uma menção literal. Essa decisão separa um reconhecedor de spans dos sistemas que também normalizam valores, ligam registos ou inferem factos. Os LLMs continuam úteis para propor anotações de treino e para tratar casos que exigem inferência ou normalização.
Repositório complementar: ner-field-guide inclui pontuação por span exato, exemplos de GLiNER, conversão de anotações revistas, verificações de ONNX FP32 e INT8 e uma demonstração de PII em streaming.
Para a comparação resumida de modelos, veja Best NER Models in 2026.
O que é o reconhecimento de entidades nomeadas?
O reconhecimento de entidades nomeadas encontra spans no texto e atribui-lhes tipos como pessoa, organização, data, produto ou etiquetas específicas de um domínio. Um span é um trecho contíguo do texto original. O NER identifica a menção; a ligação de entidades (entity linking) é o passo separado que a resolve para um registo canónico ou um conceito de uma ontologia.
| Carga de trabalho | Primeiro modelo a testar | Escalar quando |
|---|---|---|
| IDs ou dicionários controlados | Regras ou spaCy EntityRuler | A cobertura (recall) fora dos padrões conhecidos importa. |
| Etiquetas estáveis e muitos dados de treino | spaCy ou um encoder com fine-tuning | O conjunto de etiquetas muda ou o recall estagna em tipos raros. |
| Etiquetas variáveis; inventário de tipos pequeno | GLiNER cross-encoder | O inventário cresce ou as etiquetas são reutilizadas em muitos documentos. |
| Inventário de tipos grande e reutilizável | GLiNER bi-encoder | O conjunto do domínio mostra uma regressão de qualidade ou de calibração. |
| Várias tarefas de extração num só pipeline de texto | GLiNER2.5 | A qualidade conjunta das tarefas não atinge o objetivo de cada tarefa. |
| Factos implícitos ou raciocínio sobre o schema | Extração estruturada com LLM | A latência, o custo ou as afirmações sem suporte excedem o orçamento do produto. |
Um GLiNER cross-encoder lê em conjunto os nomes das etiquetas e o texto, pelo que cada documento volta a codificar todas as etiquetas. Um bi-encoder codifica as etiquetas separadamente e pode guardá-las em cache. O GLiNER2.5 é uma família de modelos distinta, que extrai entidades, classes, relações e campos estruturados a partir de um único schema. Cada um tem a sua própria secção abaixo.
Percorrendo esta lista, vale a primeira correspondência, pela ordem em que eu faria as perguntas:
- O resultado não é um span literal: use structured output de um LLM.
- IDs ou um dicionário fixo: use regras ou um EntityRuler.
- Etiquetas fixas e dados de treino suficientes: use spaCy ou BERT-NER.
- Um conjunto grande de etiquetas reutilizado entre documentos: use o GLiNER bi-encoder.
- Caso contrário: use o GLiNER cross-encoder e experimente o GLiNER2.5 quando precisar de várias tarefas numa só passagem.
Onde os sistemas modernos usam NER
O NER continua a encontrar spans de texto e a atribuir-lhes etiquetas. O que mudou foi a sua posição no sistema. Agora fornece filtros para RAG, argumentos estruturados para ferramentas de agentes e campos para pipelines de processamento de documentos. Estes usos tornam a latência, o custo e a flexibilidade do schema tão importantes como a precisão nos benchmarks.
RAG: melhor retrieval através da extração de entidades
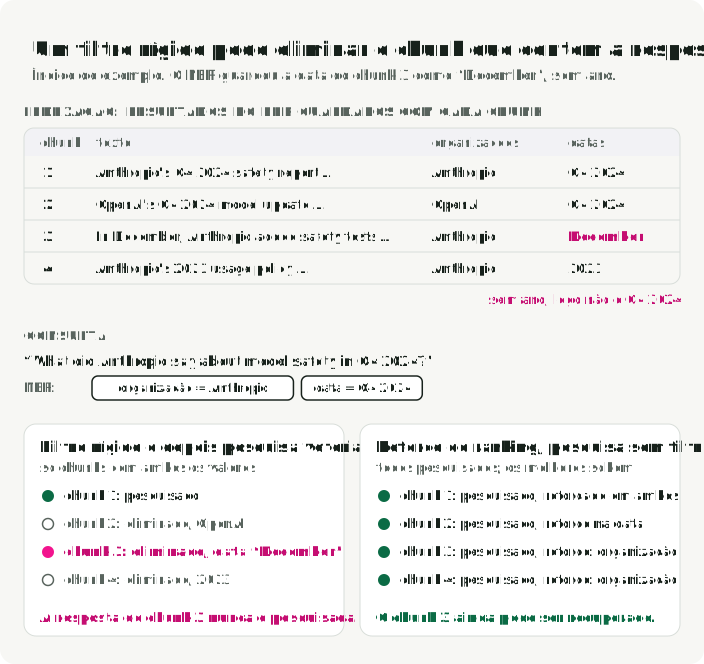
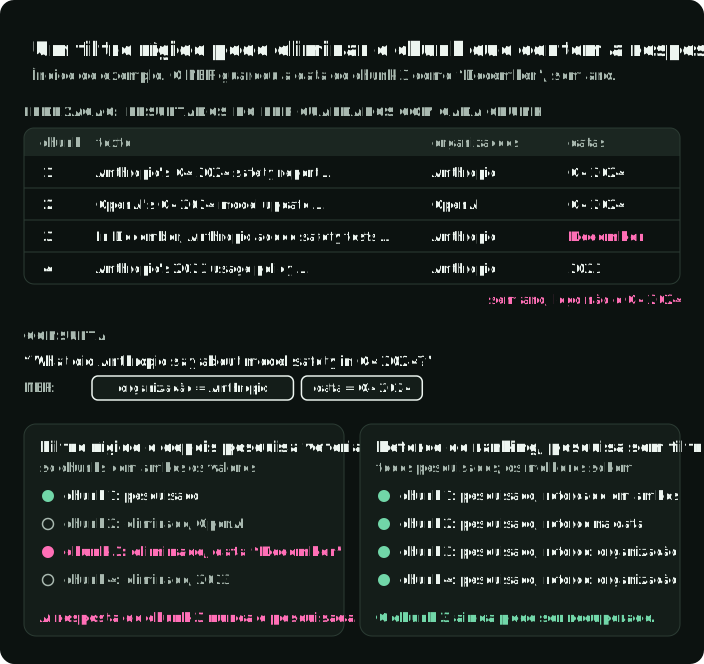
A pesquisa por similaridade isolada tem dificuldades quando a pergunta contém entidades exatas. Para “o que disse a Anthropic sobre a segurança dos modelos no T4 de 2024?”, a extração de entidades pode propor “Anthropic” e “T4 de 2024” como filtros. Aplique um filtro rígido apenas quando os metadados indexados e a semântica das datas o permitirem; caso contrário, use-o como sinal de ranking ou mantenha um caminho de retrieval sem filtro. Um alias em falta ou um intervalo de datas inferido de forma incorreta pode excluir a resposta.
Durante a indexação, extraem-se as entidades de cada chunk e guardam-se como metadados: {"organizations": ["Anthropic"], "dates": ["Q4 2024"], ...}. Isto permite filtrar por entidade antes de executar a pesquisa vetorial. O RAG com grafo de conhecimento (GraphRAG, grafos de propriedades do LlamaIndex) acrescenta relações nomeadas que o retrieval pode seguir ao longo de vários saltos.
O diagrama percorre um índice de exemplo com quatro chunks. Compare os dois painéis na parte inferior: o filtro rígido nunca pesquisa o chunk cuja data guardada não tem ano, enquanto o reforço de ranking ainda o pesquisa.
No momento da consulta, as entidades extraídas da pergunta do utilizador orientam o encaminhamento. Uma pergunta que menciona o nome de uma empresa vai para um índice financeiro; uma que menciona nomes de fármacos vai para uma base de conhecimento clínica. O GLiNER é útil quando o schema ou os tipos de entidade mudam no momento da consulta. Nomes de empresas ou de fármacos nunca vistos não exigem, só por si, etiquetas de vocabulário aberto; um modelo de etiquetas fechadas ainda consegue reconhecer novas menções de tipos conhecidos.
Agentes de AI: transformar texto em factos estruturados
Os agentes recebem texto não estruturado, como páginas web, respostas de APIs e mensagens de utilizadores. O NER converte esse texto em factos estruturados sobre os quais o agente pode raciocinar, que pode guardar ou passar a ferramentas.
No encaminhamento para ferramentas, um pedido como “schedule a meeting with Sarah Chen from Accenture on Thursday at 2pm” pode produzir PERSON: Sarah Chen, ORGANIZATION: Accenture, DATE: Thursday e TIME: 2pm. Um resolvedor de calendário combina depois a data e a hora no timestamp que a API exige. Um encoder local evita a ida e volta à API, mas a sua latência depende do modelo, do runtime, do hardware, do tamanho do batch e do número de etiquetas.
O NER também apoia o rastreio de entidades ao longo de conversas. Os sistemas de memória de agentes precisam de saber que “Sarah” no turno 3 e “Sr.ª Chen” no turno 12 são a mesma pessoa. O NER identifica os spans; a resolução de correferência decide se as menções se referem à mesma pessoa no contexto. A ligação de entidades mapeia depois essa pessoa para um registo canónico, quando existe.
Em ambos os casos, a restrição é a latência. Se cada um de dez passos sequenciais fizer uma chamada de NER de 200 ms, essas chamadas somam 2 segundos de atraso percebido. Uma só chamada soma 200 ms. Os modelos encoder costumam encaixar melhor do que a extração baseada em LLM no trabalho com entidades dentro de agent loops.
Inteligência documental: de imagens a dados estruturados
O OCR transforma imagens em texto. O NER transforma esse texto em campos estruturados.
Um pipeline típico usa primeiro OCR, como o Tesseract, o Azure Document Intelligence ou o AWS Textract, para produzir texto e caixas delimitadoras. O NER encontra depois spans para campos como invoice_number, vendor_name, total e due_date. Um passo de schema ou de extração de relações tem de agrupar as descrições das linhas, as quantidades e os preços em line_items. A mesma sequência aplica-se a contratos, registos médicos e documentos regulatórios.
Cada etapa tem a sua própria pontuação. Um erro de OCR que perde um dígito parece uma falha do NER se só pontuar o registo final.
| Etapa | O que produz | Pontuação |
|---|---|---|
| OCR e layout | Texto, ordem de leitura, caixas | Taxa de erro de caracteres |
| NER | invoice_number, vendor_name, total | F1 por span exato |
| Agrupamento | Linhas de fatura (descrição, quantidade, preço por linha) | F1 por registo |
| Ligação e normalização | ID do fornecedor, datas ISO, montantes | Precisão da ligação ou da normalização |
Os pipelines de documentos modernos podem combinar compreensão de layout, extração de entidades e extração de relações. O OCR ou um modelo de documentos com perceção de layout continua a fornecer o texto, a ordem de leitura, as tabelas e as caixas delimitadoras. O GLiNER2.5 atual expõe entidades, relações, classificação e registos estruturados através de uma única interface de schema; pontue cada saída em separado.
O custo decide a maior parte destes pipelines. Calcule o preço do seu com o volume mensal real de documentos, incluindo repetições e revisão. Um encoder compacto pode correr em CPU, enquanto um LLM acedido por API acrescenta custo e latência de inferência por documento. Um teste prático é anotar um conjunto representativo de faturas com um LLM. Faça depois o fine-tuning do GLiNER com os registos revistos e compare os dois caminhos em F1 por campo, latência e custo total.
Deteção de PII e guardrails para LLMs
Leis de privacidade como o RGPD, o HIPAA e o CCPA exigem salvaguardas para dados pessoais, mas não exigem NER. O NER pode encontrar dados pessoais para ocultação ou minimização; o seu recall tem de ser verificado com os seus dados antes de contar como controlo.
Os modelos de desidentificação encontram spans de PERSON, SSN, PHONE, EMAIL e ADDRESS e ou os ocultam ou os substituem por equivalentes sintéticos. O Microsoft Presidio combina reconhecedores com operadores de anonimização, e os seus exemplos incluem o GLiNER como reconhecedor. O GLiNER2-PII, com 0,3B de parâmetros, é outro candidato: o respetivo artigo cobre 42 tipos de PII com resolução ao nível do span de caracteres.
Na comparação da John Snow Labs, realizada pelo próprio fornecedor, 48 documentos anotados por especialistas cobrem seis classes de PHI. As etiquetas dos fornecedores foram remapeadas e as previsões sem correspondência foram excluídas, o que limita a interpretação entre fornecedores. O relatório da Providence descreve 281 eventos de fuga de PHI numa revisão de 1000 notas com 34 701 frases. Eventos não são o mesmo que frases afetadas distintas: numa avaliação de privacidade, conte tanto as instâncias que vazaram como os documentos afetados.
Nos guardrails para LLMs, o NER funciona como camada de pré-triagem: analisa-se a entrada do utilizador à procura de PII antes de a enviar para uma API externa e depois bloqueia-se ou anonimiza-se.
Um detetor local pode ser mais rápido do que pedir ao LLM que se automodere, mas continuam a ser possíveis falsos negativos, pelo que deve acrescentar outro controlo para a exposição de PII que o seu sistema não pode aceitar. O GLiNER é útil aqui porque as categorias de PII variam consoante a jurisdição. Uma API pode aceitar uma nova etiqueta, como “genetic information”, sem novo treino. O recall dessa nova etiqueta é desconhecido até o verificar com exemplos revistos.
GLiNER: correspondência entre span e etiqueta para NER de vocabulário aberto
O GLiNER (NAACL 2024, Zaratiana et al.) tornou o NER baseado em encoders competitivo com os LLMs por uma fração do custo. Em vez de tratar o NER como etiquetagem de sequências ou geração de texto, o GLiNER trata-o como um problema de correspondência. Pontua cada span de texto candidato (cada sequência contígua de palavras como “Bill Gates” ou “Microsoft”) face a cada etiqueta de tipo de entidade e depois mantém os pares com pontuação alta.
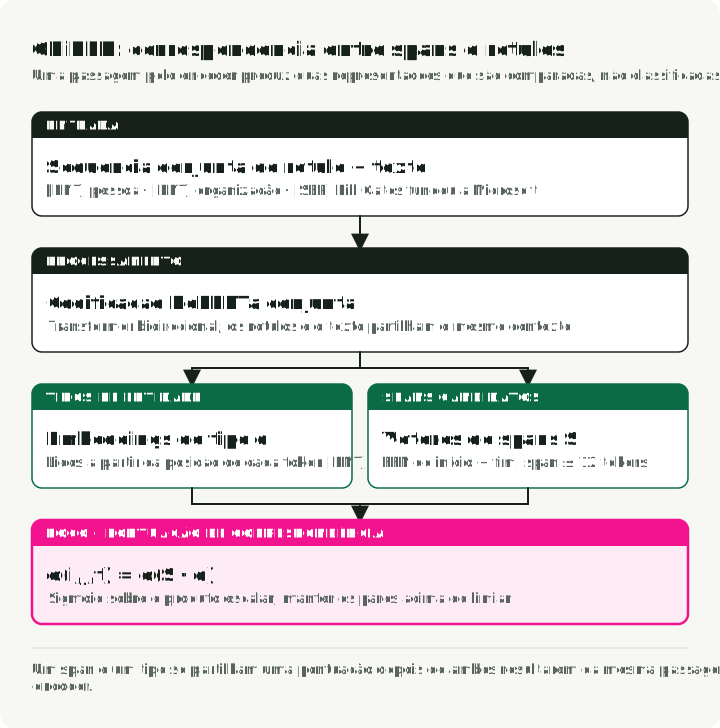
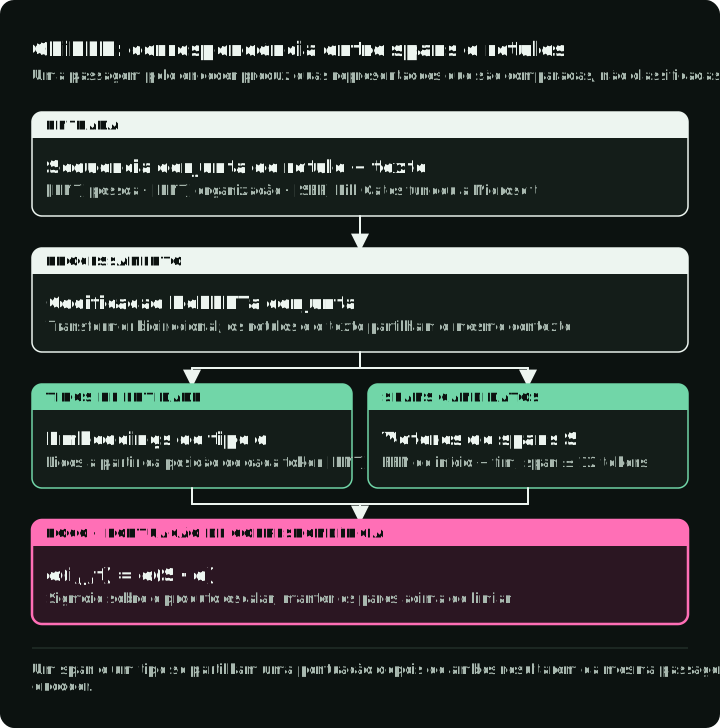
O modelo recebe as etiquetas de tipo de entidade e o texto de entrada como uma única sequência: [ENT] person [ENT] organization [ENT] date [SEP] Bill Gates founded Microsoft.... Um transformer bidirecional (DeBERTa-v3) codifica tudo em conjunto.
A partir da saída, o modelo constrói dois conjuntos de representações. Um refina a representação de cada tipo de entidade a partir da posição de um token [ENT], através de uma pequena rede feed-forward (FFN) que transforma o vetor do encoder. O outro representa os spans de texto combinando os vetores da palavra inicial e da palavra final através de outra FFN. Um produto escalar entre a representação de um span e a de um tipo de entidade dá uma pontuação.
Aplicando a sigmoide obtém-se a probabilidade de o span que vai da posição de palavra à posição de palavra pertencer ao tipo de entidade : . Aqui, é o vetor do span produzido pela FFN e é o embedding do tipo de entidade refinado pela FFN, obtido do token [ENT] correspondente (Zaratiana et al., 2024, Eqs. 1–2). Os spans candidatos estão limitados a 12 palavras; o tokenizer pode dividir uma palavra em vários subtokens.
O GLiNER aceita descrições de etiquetas em linguagem natural no momento da inferência, sem novo treino, mas a qualidade da extração depende da formulação das etiquetas e do ajuste ao domínio. Passam-se tipos de entidade como “person”, “adverse drug reaction” ou “financial instrument” e o modelo pontua os spans face a eles. As configurações de 50M, 90M e 300M abaixo são os modelos do artigo original. O model card da v2.1 lista, em vez disso, checkpoints em inglês de 166M, 209M e 459M, além de um checkpoint multilingue de 209M, todos sob Apache 2.0. Não compare a latência nem a memória entre essas gerações como se os nomes dos parâmetros fossem equivalentes (model card do GLiNER v2.1).
Num teste zero-shot rigoroso, retenha tanto os tipos-alvo como os exemplos-alvo: o modelo não tem exemplos anotados para a tarefa-alvo. Uma descrição de tipo como “um efeito adverso confirmado clinicamente e causado por um tratamento” dá ao modelo mais informação do que adverse event sozinho. Isso não garante transferência, mas o ZeroNER, orientado por descrições, superou as referências baseadas apenas no nome nos seus benchmarks com tipos retidos (Cocchieri et al., 2025).
Os dados de treino do modelo original vieram do dataset Pile-NER: 44 889 passagens com 240 mil spans de entidades em 13 mil tipos de entidade, todos anotados pelo ChatGPT. Treinar o GLiNER-L demorou cerca de 5 horas numa única A100 (Zaratiana et al., 2024).
Resultados nos benchmarks
Resultados zero-shot de Zaratiana et al. (2024), Tabelas 1 e 2. O F1 combina precisão e recall numa só pontuação; uma pontuação mais alta só é melhor sob a mesma tarefa e as mesmas regras de avaliação. A média dos sete datasets combina cinco datasets CrossNER com MIT Movie e MIT Restaurant:
| Modelo | Parâm. | F1 médio (CrossNER + MIT) | F1 médio (20 datasets) |
|---|---|---|---|
| GLiNER-L | 300M | 60,9% | 47,8% |
| GoLLIE | 7B | 58,0% | — |
| UniNER-13B | 13B | 55,6% | — |
| GLiNER-M | 90M | 55,4% | — |
| UniNER-7B | 7B | 53,7% | 45,7% |
| GLiNER-S | 50M | 52,7% | — |
| ChatGPT (GPT-3.5) | — | 47,5% | 36,5% |
O GLiNER-M, com 90M de parâmetros, quase iguala o UniNER-13B na média dos sete datasets do artigo (55,4% vs. 55,6% de F1), usando cerca de 140 vezes menos parâmetros. O GLiNER-S, de 50M, supera em 5 pontos de F1 o resultado reportado para o ChatGPT (GPT-3.5). A variante multilingue, treinada apenas com dados em inglês, supera esse mesmo baseline do ChatGPT em 8 de 10 línguas não inglesas (Zaratiana et al., 2024). Estas comparações usam as versões de modelos e o harness de avaliação do artigo; não dizem nada sobre LLMs mais recentes.
Uma chamada mínima ao GLiNER
Numa nova comparação com cross-encoders, inclua os checkpoints GLiNER v2.5 mantidos ao lado do v2.1. Na verificação do repositório complementar com 32 frases do Few-NERD, um dataset público de NER, o gliner_small-v2.5 encontrou 44 de 54 spans de referência e o gliner_medium-v2.1 encontrou 39. Essa amostra é demasiado pequena para classificar os dois, mas é um motivo para incluir o v2.5 na sua própria execução. O GLiNER v2.5 e o Fastino GLiNER2.5 (abaixo) são famílias de modelos diferentes.
A chamada abaixo carrega o checkpoint médio da v2.1 e imprime cada span com a respetiva pontuação. A versão do repositório complementar é ner_demo/quickstart.py.
from gliner import GLiNER

model = GLiNER.from_pretrained("urchade/gliner_medium-v2.1")
text = "Bill Gates founded Microsoft on April 4, 1975."
labels = ["person", "organization", "date"]
entities = model.predict_entities(text, labels, threshold=0.5)

for entity in entities:
    print(f"{entity['text']} => {entity['label']} ({entity['score']:.3f})")
# Bill Gates => person (0.994)
# Microsoft => organization (0.973)
# April 4, 1975 => date (0.951)O bi-encoder: NER à escala de milhões de etiquetas
O GLiNER original codifica as etiquetas e o texto em conjunto. A codificação conjunta torna-se cada vez mais dispendiosa à medida que o texto das etiquetas consome o contexto e tem de ser recodificado com cada documento. O ponto de cruzamento depende do checkpoint, das descrições das etiquetas e do hardware. Quando o mesmo inventário de tipos grande é reutilizado em muitos documentos, faça do GLiNER bi-encoder a comparação por defeito. Divide a codificação do texto e a das etiquetas em dois transformers separados (Stepanov et al., 2026).
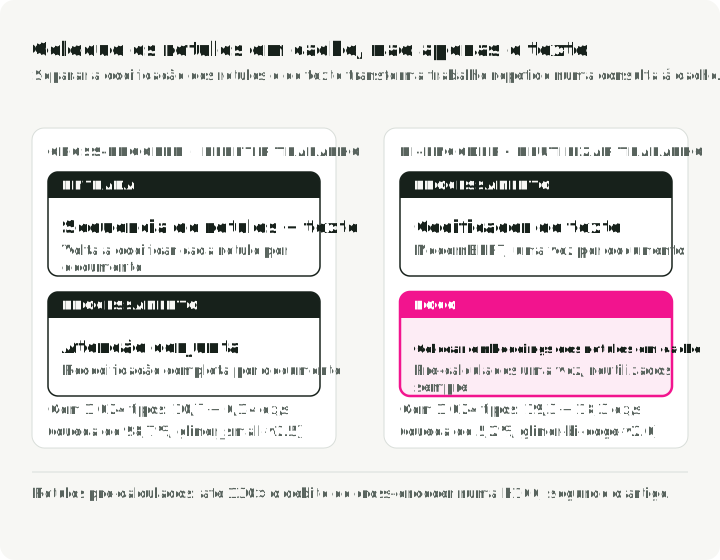
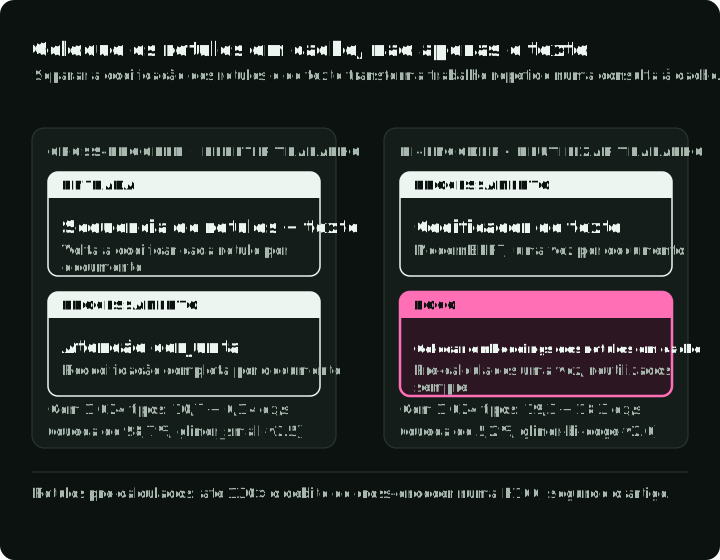
A figura compara os dois desenhos com três documentos. Na faixa do cross-encoder, todas as etiquetas entram no encoder com cada documento. Na faixa do bi-encoder, um encoder de etiquetas corre uma só vez, os seus vetores ficam em cache e só o encoder de texto corre por documento. O gráfico abaixo mostra o custo em débito com 1024 etiquetas.
O encoder de texto usa o ModernBERT (família Ettin) e o encoder de etiquetas usa sentence transformers (BGE ou MiniLM). Os spans e as etiquetas são pontuados por produto escalar. Esta divisão significa que os embeddings dos tipos de entidade podem ser pré-calculados uma só vez e guardados em cache. Na inferência, as etiquetas em cache evitam a codificação repetida. Pontuar os spans candidatos face a essas etiquetas continua a exigir computação e memória; uma aplicação com um milhão de etiquetas precisa também de uma seleção limitada de candidatos ou de batching, com o recall medido para as etiquetas excluídas antes da pontuação.
Existem quatro tamanhos de modelo, todos avaliados no CrossNER (Stepanov et al., 2026, Tabela 1):
| Modelo | Parâmetros | F1 médio (CrossNER + MIT) | Débito (H100) | Com etiquetas pré-calculadas |
|---|---|---|---|---|
| gliner-bi-edge-v2.0 | 60M | 54,0% | 13,64 ex/s | 24,62 ex/s |
| gliner-bi-small-v2.0 | 108M | 57,2% | 7,99 ex/s | 15,22 ex/s |
| gliner-bi-base-v2.0 | 194M | 60,3% | 5,91 ex/s | 9,51 ex/s |
| gliner-bi-large-v2.0 | 530M | 61,5% | 2,68 ex/s | 3,60 ex/s |
Com 1024 tipos de entidade, o bi-encoder gliner-bi-edge-v2.0 com etiquetas pré-calculadas perde apenas 5,2% de débito face a uma única etiqueta (19,3 → 18,3 ex/s). O cross-encoder comparável gliner_small-v2.5 perde 98,7% (10,7 → 0,14 ex/s). Nos testes do artigo com uma só H100, batch de tamanho 1 e entradas de 64, 256 e 512 tokens, o bi-encoder pré-calculado atinge uma vantagem de débito até 130× sobre o gliner_small-v2.5. Com 100 tipos de entidade numa só H100, o bi-encoder processa 1,96 milhões de previsões por dia, contra 368 mil do cross-encoder (Stepanov et al., 2026).
O artigo do bi-encoder reporta 61,5% para o gliner-bi-large-v2.0 contra 60,9% para o gliner_large-v2.5 na mesma média CrossNER mais MIT, pelo que, nesse benchmark, o bi-encoder não troca precisão por velocidade. Os autores recomendam o bi-base-v2.0 (194M) como o melhor compromisso de tamanho: 98% da precisão do modelo grande a 2,6 vezes a velocidade (Stepanov et al., 2026).
O varrimento de tempos pára nas 1024 etiquetas, com uma H100, batch de tamanho um e dez passagens forward por configuração. Não mede um serviço de produção com um milhão de etiquetas. O artigo indica como um dos usos a ligação de entidades a grandes bases de conhecimento como a Wikidata; a ligação de entidades está disponível através do framework GLiNKER da Knowledgator.
O código codifica o conjunto de etiquetas uma só vez e reutiliza os embeddings para cada texto. Com as três etiquetas abaixo, devolve os mesmos três spans que a chamada do cross-encoder acima.
from gliner import GLiNER

model = GLiNER.from_pretrained("knowledgator/gliner-bi-base-v2.0")

# Pre-compute embeddings for a reused label set; rebuild this cache when labels or the checkpoint change.
entity_types = ["person", "organization", "date"]  # Small example; large inventories need bounded candidate selection
entity_embeddings = model.encode_labels(entity_types, batch_size=8)

# Encode text and score spans against the cached labels
texts = ["Bill Gates founded Microsoft on April 4, 1975."]
outputs = model.batch_predict_with_embeds(texts, entity_embeddings, entity_types)GLiNER2 e GLiNER2.5: um schema para várias tarefas
O ecossistema GLiNER original dividia o NER, a extração de relações, a classificação e a extração ao nível do documento por modelos separados. O artigo GLiNER2 do EMNLP 2025 unificou o NER, a classificação e a extração hierárquica num só modelo de 205M parâmetros; as versões atuais acrescentaram depois a extração de relações à mesma interface de schema.
Essa arquitetura de 2025 mantém o desenho de cross-encoder, mas alarga o contexto para 2048 tokens (4x o original) e acrescenta schemas declarativos para definir tarefas de extração. O treino usa 135 698 documentos reais anotados com o GPT-4o e 118 636 exemplos sintéticos (Zaratiana et al., 2025).
No CrossNER zero-shot, o GLiNER 2 obtém 0,590 de F1, próximo dos 0,599 do GPT-4o no benchmark de meados de 2025 do artigo. Na classificação, obtém em média 0,72 em 7 benchmarks, contra 0,69 do DeBERTa-v3-large. Em CPU, o artigo reporta latências de classificação de 130-208 ms nos números de etiquetas testados. O baseline DeBERTa zero-shot precisa de uma passagem forward por etiqueta candidata e sobe de 1714 ms para 5 etiquetas para 16 897 ms para 50; este não é o tempo de execução de um classificador DeBERTa supervisionado (Zaratiana et al., 2025).
O exemplo abaixo carrega o GLiNER2.5, um checkpoint posterior, pelo que as pontuações de 2025 acima não o descrevem. O GLiNER2.5 (194M de parâmetros) prevê as posições inicial e final dos spans em vez de pontuar todos os spans. A sua janela é de 4096 tokens, por isso divida os documentos mais longos em chunks sobrepostos com a função auxiliar da biblioteca e verifique se os offsets devolvidos correspondem ao texto completo. Carregue-o com AutoExtractor, como abaixo.
from gliner2 import AutoExtractor

# Requires `pip install gliner2[local]` and downloads the checkpoint.
extractor = AutoExtractor.from_pretrained("fastino/gliner2.5-base-v1")

# Compose tasks through the current schema interface
schema = (extractor.create_schema()
    .entities({"person": "Names of people", "company": "Organization names"})
    .classification("sentiment", ["positive", "negative", "neutral"])
    .relations(["works_for", "founded", "located_in"])
    .structure("product_info")
        .field("name", dtype="str")
        .field("price", dtype="str"))
text = "Acme launched a $19 widget in Berlin."
results = extractor.extract(text, schema)
O artigo do EMNLP avalia apenas NER e classificação. Não reporta nenhum benchmark de extração hierárquica e não cobre a API de relações posterior. Um modelo que executa quatro tarefas pode ainda assim pontuar menos em cada uma do que quatro modelos especializados, por isso compare cada tarefa com o seu próprio baseline.
Outras variantes do GLiNER para necessidades específicas
A família GLiNER tem agora várias arquiteturas além do cross-encoder, do bi-encoder e do GLiNER2.5. Cada uma responde a uma necessidade:
| Necessidade | Candidato | O que verificar |
|---|---|---|
| Entidades e relações numa só passagem | GLiNER-Relex | O F1 de spans e o de relações nos mesmos documentos. |
| Candidato local para PII | GLiNER2-PII | O recall por língua, formato de documento e tipo de PII. |
| Candidato multilingue de vocabulário aberto | GLiNER-X | A qualidade por língua; o card lista 23 línguas. |
| Tipos gerados ou variáveis | GLiNER Decoder | Se os tipos gerados são estáveis e úteis a jusante. |
| Ocultação de PII em streaming | GLiNER Streaming PII | Os caracteres vazados antes da libertação, não só o recall do span final. |
Os resultados do GLiNER-Relex e do GLiNER2-PII vêm dos seus próprios artigos e harnesses. O GLiNER-X e o GLiNER Decoder têm model cards, não benchmarks revistos por pares, pelo que os seus números não são comparáveis com os dos artigos acima.
O PII em streaming muda o momento em que se pode libertar o texto
O GLiNER Streaming PII acrescenta deteção incremental com um backbone causal Qwen3-0.6B e estado de sessão em cache. A sua API devolve o snapshot completo da sessão atual, com offsets no texto acumulado. Preserve as fronteiras dos chunks, mantenha as etiquetas fixas até uma recomputação completa e limpe as sessões terminadas.
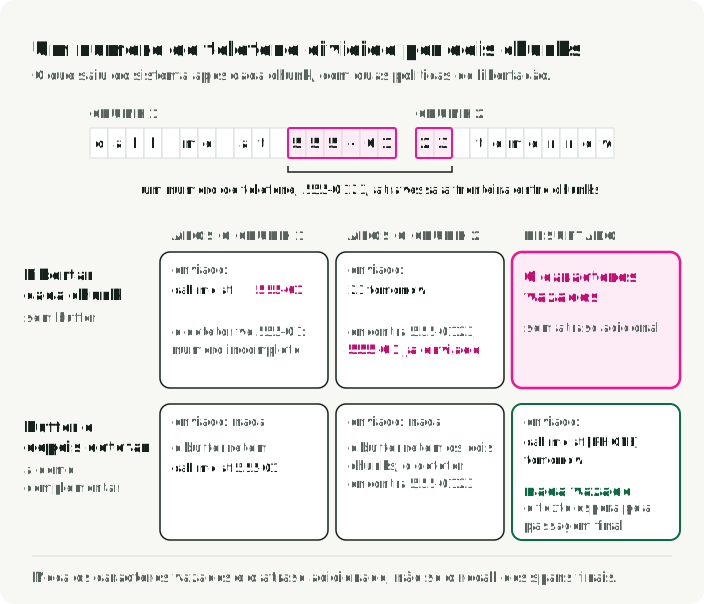
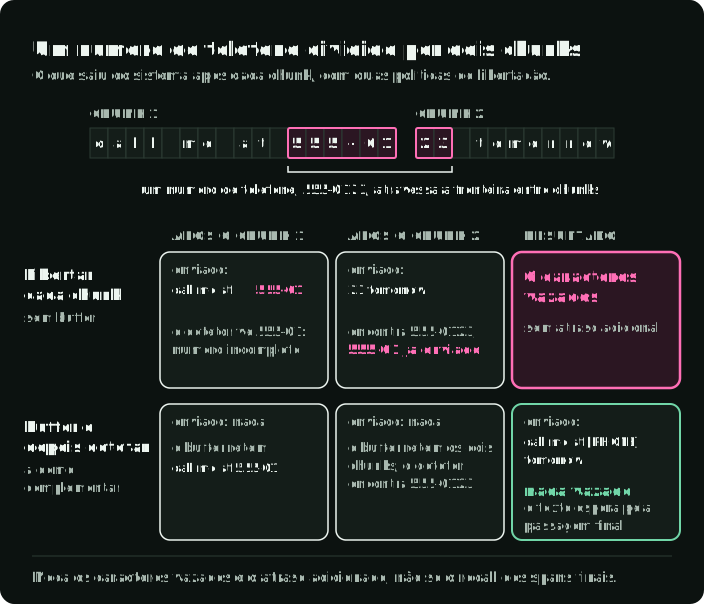
Na ocultação em streaming, eu guardaria em buffer o texto ainda não libertado e testaria entidades divididas entre chunks. Encontrar um número de telefone depois de enviar a primeira metade não permite retirar esses bytes. Meça os caracteres vazados antes da libertação e o atraso acrescentado, além do recall do span final. O model card reporta o F2 de mascaramento do PIIMB em separado do F1 estrito de spans com tipo; respondem a perguntas diferentes. O model card também reporta resultados multilingues mais fracos, pelo que o checkpoint publicado não é um filtro de privacidade universal.
A figura divide um número de telefone por dois chunks. Libertado chunk a chunk, a primeira metade já saiu quando chega a segunda. Com buffer, o detetor vê o número completo e só sai texto mascarado. O ner_demo.streaming do repositório complementar retém todo o texto até uma passagem final de deteção e liberta-o depois com os spans detetados mascarados.
Alternativas de etiquetas fechadas: spaCy e um classificador de tokens com fine-tuning
Quando o conjunto de etiquetas é estável e tem dados anotados, não precisa das etiquetas abertas do GLiNER. Um modelo treinado nesse conjunto de etiquetas é a referência a bater.
Os pipelines treinados do spaCy (en_core_web_sm, en_core_web_trf) reconhecem um conjunto fixo de tipos de entidade (PERSON, ORG, GPE, DATE e outros) definido no treino. Alargar o componente ner treinado exige exemplos anotados e treino. Para identificadores ou um dicionário controlado, o EntityRuler acrescenta etiquetas personalizadas através de padrões, sem novo treino; o seu recall fora desses padrões é zero. O model card do en_core_web_trf 3.8.0 reporta 90,19 de F1 em NER no OntoNotes 5.0, mas apenas para os seus 18 tipos predefinidos (model card do spaCy).
O exemplo acrescenta um padrão de ticker antes do componente ner treinado, para que a regra fique com $AAPL primeiro e o modelo etiquete o resto:
import spacy

nlp = spacy.load("en_core_web_trf")
ruler = nlp.add_pipe("entity_ruler", before="ner")
ruler.add_patterns([{"label": "TICKER", "pattern": [{"TEXT": "$"}, {"TEXT": {"REGEX": r"^[A-Z]{1,5}$"}}]}])

doc = nlp("Tim Cook said Apple ($AAPL) will open an office in Berlin in March 2027.")
print([(ent.text, ent.label_) for ent in doc.ents])
# [('Tim Cook', 'PERSON'), ('Apple', 'ORG'), ('$AAPL', 'TICKER'), ('Berlin', 'GPE'), ('March 2027', 'DATE')]
Para etiquetas estáveis com spans anotados representativos, um classificador de tokens com fine-tuning, como BERT, RoBERTa ou DeBERTa, é a referência supervisionada. O pipeline do Hugging Face carrega um numa só linha. O dslim/bert-base-NER, o encoder fixo da avaliação do repositório complementar, foi treinado no CoNLL-2003, pelo que as suas etiquetas são fixas: PER, ORG, LOC e MISC. A data na mesma frase não é encontrada porque o modelo não tem etiqueta de data:
from transformers import pipeline

ner = pipeline("token-classification", model="dslim/bert-base-NER", aggregation_strategy="simple")
for ent in ner("Tim Cook said Apple will open an office in Berlin in March 2027."):
    print(ent["word"], ent["entity_group"], round(float(ent["score"]), 3))
# Tim Cook PER 1.0
# Apple ORG 0.998
# Berlin LOC 0.999
Para obter as suas próprias etiquetas, faça o fine-tuning de um modelo destes com os seus spans anotados. Compare-o com o spaCy e o GLiNER em F1 por span exato, recall por etiqueta, calibração, latência e custo, no mesmo conjunto de domínio.
A minha recomendação: use spaCy ou um classificador de tokens com fine-tuning para tipos de entidade padrão ou estáveis quando tem dados de treino. Use o GLiNER quando precisa de tipos flexíveis, zero-shot, ou quando o seu pipeline tem de se adaptar sem novo treino. Podem partilhar um pipeline, com o spaCy a tratar da tokenização e da divisão em frases e o GLiNER a tratar da extração de entidades.
As licenças dos checkpoints fazem parte da escolha do modelo
Os modelos deste guia não partilham uma única licença. Verifique os termos do código, dos pesos e do dataset do checkpoint exato antes do deployment:
| Publicação | Licença publicada | Consequência prática |
|---|---|---|
| GLiNER v2.1, GLiNER v2.5 e GLiNER bi | Apache 2.0 | Termos permissivos no model card; reveja ainda dependências e dados. |
| GLiNER2, GLiNER2.5 e GLiNER2-PII | Apache 2.0 | Confirme o checkpoint escolhido, não apenas a biblioteca. |
spaCy en_core_web_trf e dslim/bert-base-NER | MIT | Permissiva; os corpora de treino têm os seus próprios termos. |
| UniNER-7B-all | CC BY-NC 4.0 | Não use num caminho comercial sem autorização separada. |
| NuNER | MIT | O modelo e o dataset publicados indicam termos MIT. |
As indicações de licença não são aconselhamento jurídico. Uma revisão para produção tem de incluir os termos do modelo base, dos dados de treino e do fornecedor.
LLMs como professores: um caso de estudo de $70 e um pipeline implementável
O padrão LLM-as-teacher separa a anotação dispendiosa da inferência mais barata: um LLM anota os dados de treino uma só vez e um encoder pequeno treinado com essas anotações serve cada pedido. Dois artigos de investigação estabeleceram que modelos pequenos conseguem aprender NER a partir de anotações de LLMs, e dois casos de estudo publicados mostram como as equipas o aplicaram.
A investigação por trás deste padrão: UniNER e NuNER
O UniNER (ICLR 2024, Zhou et al.) e o NuNER (EMNLP 2024, Bogdanov et al.) destilam ambos anotações de LLMs para modelos de NER mais pequenos, mas discordam quanto a quão pequeno se pode ir.
O UniNER faz o fine-tuning do LLaMA-7B/13B com 45 889 pares entrada-saída gerados pelo ChatGPT. Para cada tipo de entidade, o modelo responde a “What describes [type] in the text?” e devolve listas JSON. Um truque de treino importante: a amostragem negativa baseada na frequência aumenta o F1 de 31,5% para 53,4% (Zhou et al., 2024).
O UniNER-7B atinge 41,7% de F1 zero-shot em 43 datasets, superando em 7 pontos os 34,9% do ChatGPT. A variante de 13B chega a 43,4%, apenas mais 1,7 pontos para quase o dobro dos parâmetros (Zhou et al., 2024).
O compromisso em produção: a configuração do tipo UniNER com melhor pontuação no artigo consulta cada tipo de entidade em sequência. A sua variante tudo-em-um usa uma só resposta, mas teve em média menos 3,3%. Em FP16, um checkpoint de 7B precisa de cerca de 14 GB só para os pesos; a quantização de menos bits pode reduzir esse espaço. O checkpoint UniNER-7B-all é não comercial (veja a tabela de licenças acima).
O NuNER parte do RoBERTa-base (125M de parâmetros) e usa treino contrastivo com 4,38 milhões de anotações do GPT-3.5 em 200 mil conceitos. Depois do treino, o encoder de conceitos é descartado; o encoder de texto encaixa em qualquer pipeline de NER padrão como substituto do RoBERTa (Bogdanov et al., 2024).
A Tabela 3 do NuNER reporta cerca de 6,1–16,2 pontos acima do RoBERTa no F1 médio macro de classificação de tokens, com encoders congelados e cabeças lineares, em quatro datasets e tamanhos de treino amostrados (Bogdanov et al., 2024).
Ambos os artigos mostram que um modelo mais pequeno pode aprender com anotações de LLMs. Nenhum mostra que o aluno supera o professor num domínio novo, e é por isso que o pipeline abaixo mantém um conjunto de teste revisto em separado.
O caso de estudo da CFM
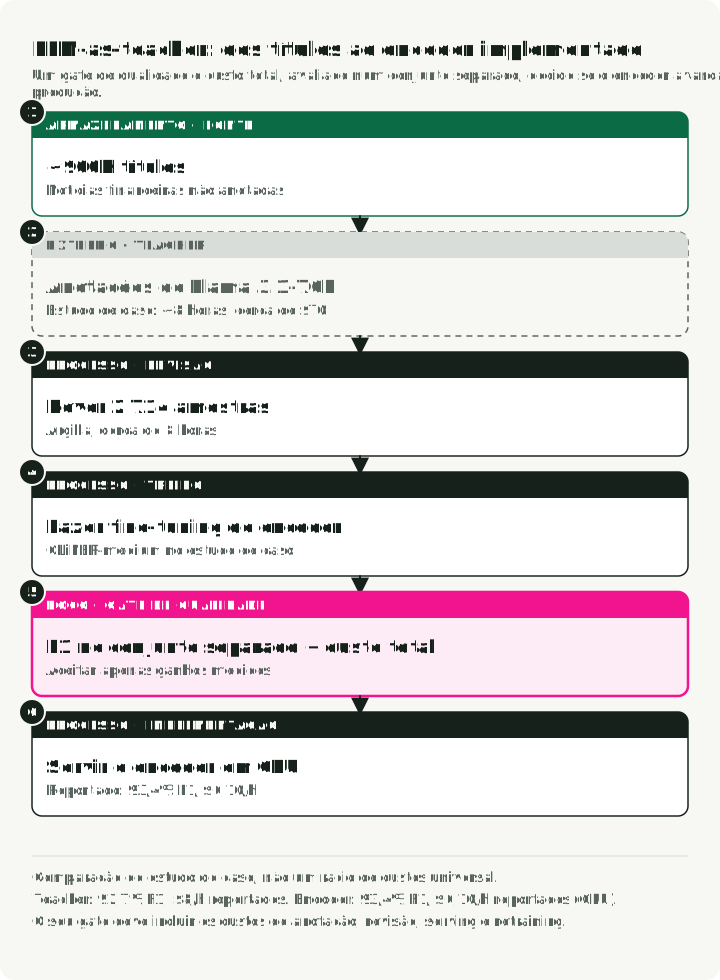
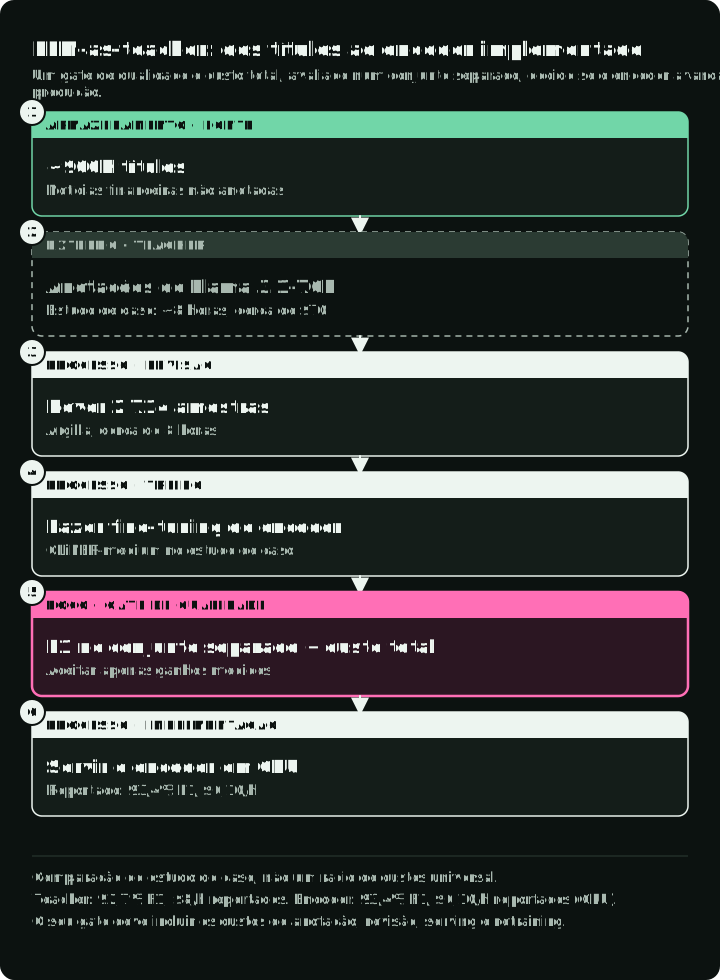
Num caso de estudo da Hugging Face, a Capital Fund Management extraiu nomes de empresas de cerca de 900 000 títulos de notícias financeiras. O GLiNER zero-shot obteve 87,0% de F1. A equipa usou o Llama 3.1-70B para anotar o dataset em cerca de 8 horas por cerca de $70 e depois reviu 2714 amostras através do Argilla em mais 8 horas.
O fine-tuning do GLiNER com estes dados chegou a 93,4% de F1 no caso de estudo, contra 92,7% do professor Llama-70B. Os autores reportam $0,10 por hora em CPU para o modelo com fine-tuning e $8 por hora para o professor (caso de estudo da CFM). Estes valores descrevem uma tarefa de notícias financeiras e uma configuração de infraestrutura.
O estudo da Refuel AI
O relatório técnico da Refuel AI, um relatório de fornecedor, avalia a anotação por LLM em 8 datasets de NLP, incluindo o CoNLL-2003. Reporta 88,4% de concordância com a referência para o GPT-4 (março de 2023) e 86,2% para os anotadores humanos na sua configuração, além de uma anotação 20 vezes mais rápida e 7 vezes mais barata. Uma experiência separada com um ensemble em dados proprietários excedeu 95% de concordância, com o melhor LLM individual a 89%. O encaminhamento por confiança para modelos mais baratos ou mais fortes é um uso proposto, não o mecanismo medido por trás do resultado dos oito datasets (relatório técnico da Refuel AI).
Um pipeline de produção
Um fluxo de produção prático tem seis passos. O diagrama coloca cada passo na faixa de quem o executa, com os números da CFM e o ciclo de regresso à revisão quando o aluno não atinge o objetivo. O gráfico abaixo compara o F1 e o custo por hora da CFM para o professor e para o aluno.
- Escreva diretrizes de anotação em linguagem natural.
- Crie conjuntos de desenvolvimento e de teste retido anotados por humanos. A secção de avaliação abaixo dá um procedimento para os dimensionar.
- Use um LLM com um prompt versionado e um schema de saída explícito para propor anotações de treino em volume. Guarde o modelo pedido e o efetivamente usado, o prompt e o texto de origem. Rejeite tipos desconhecidos e spans que não se consigam alinhar com a origem.
- Reveja um subconjunto através do Argilla ou do Label Studio.
- Faça o fine-tuning de um encoder compacto (GLiNER, SpanMarker, RoBERTa). Para o GLiNER, use o
train.pydo repositório (python train.py --config configs/config.yaml) ou o métodotrain_model()do modelo, com o ficheiro de treino revisto como dados de treino e o ficheiro de desenvolvimento para avaliação durante o treino. - Faça o deployment apenas depois de o encoder passar uma verificação de qualidade retida e de custo total. A CFM reportou um custo horário de infraestrutura 16-80x inferior na sua configuração; inclua os custos de anotação, revisão, serving e novo treino na sua comparação.
O LLM pode reduzir o volume de anotação manual, mas a equipa continua a ser responsável pelo conjunto de validação, pelas diretrizes de anotação, pela revisão dirigida e pela análise de erros.
O repositório complementar demonstra uma proposta do professor e converte anotações revistas para o passo 5 (secção do README). Execute estes comandos nesse repositório com Python 3.11+, uv e as dependências instaladas por uv sync --locked --all-extras. Defina OPENAI_API_KEY para a chamada paga ao professor. A conversão precisa dos ficheiros do modelo GLiNER fixado e do seu backbone em cache; uv run --all-extras python -m ner_demo.quickstart --download descarrega-os uma vez.
-
Execute a demonstração do professor para um documento. Faz um pedido pago para uma frase fixa sobre a proposta de aquisição da Arm pela NVIDIA e escreve um registo não revisto em
artifacts/teacher_annotations.jsonl:uv run --all-extras python -m ner_demo.teacher --allow-paid -
Reveja a proposta manualmente e resolva as anotações rejeitadas. Prepare
artifacts/reviewed.jsonlcom documentos de treino revistos e os documentos de desenvolvimento e teste anotados separadamente por pessoas no processo de produção acima. Os três splits devem conter dados, os identificadores dos documentos devem ser únicos e nenhum texto de origem pode aparecer em mais de um split. Não copie a frase de demonstração entre splits. Definareviewed: true, umreviewer,status: "ok"e umsplit(train,developmentoutest) em cada registo e mantenhasource_sha256consistente com o texto de origem. Um registo de demonstração não pode fornecer os três splits. -
Converta o ficheiro revisto completo. Isto escreve
train.json,development.jsonetest.jsonemartifacts/training/, no formato de treino do GLiNER, depois de passar cada linha pelo próprio data collator do GLiNER:uv run --all-extras python -m ner_demo.training artifacts/reviewed.jsonl
Passe train.json e development.json à execução de fine-tuning do GLiNER no passo 5 e guarde test.json para a verificação final.
Onde o GLiNER falha e os LLMs continuam úteis
O benchmark da Sease (outubro de 2025) testou o GLiNER contra o GPT-4.1-mini em 30 tarefas de análise de consultas. O GPT-4.1-mini obteve 100% totalmente corretas. O GLiNER obteve 53% (16 de 30). Mas o GLiNER respondeu em 0,08 segundos contra os 1,21 segundos do LLM, 15x mais rápido.
Neste benchmark de 30 tarefas, o GLiNER falhou em três padrões recorrentes:
- Entidades implícitas: extrair “event” de “Elton John performed at Madison Square Garden”. Nenhum texto diz literalmente “event”, mas o LLM infere “concert”.
- Sensibilidade à formulação da etiqueta: “2022” obtém 0,388 face a “date” mas 0,958 face a “year”. Pequenas alterações nas etiquetas causam grandes oscilações de pontuação.
- Mapeamento de valores: o GLiNER devolve o texto de superfície exato (“family houses”) em vez do valor canónico (“Single family house”). Um LLM consegue fazer essa normalização quando o seu prompt e o schema definem os valores-alvo.
Entidades aninhadas e sobrepostas
Uma entidade aninhada está dentro de outra. Em “New York University”, “New York” é uma localização dentro do nome de uma organização. O texto biomédico (“acute myeloid leukemia” dentro de um diagnóstico mais longo) e o texto jurídico (um departamento dentro de uma autoridade nomeada) têm o mesmo padrão.
O GLiNER usa por defeito a descodificação plana, que suprime spans sobrepostos. A sua API também suporta flat_ner=False, que permite previsões sobrepostas:
entities = model.predict_entities(
    "She studied at New York University.", ["organization", "location"],
    flat_ner=False, threshold=0.3)
# [{'text': 'New York University', 'label': 'organization', 'score': 0.855, ...}]
Com o urchade/gliner_medium-v2.1, esta chamada devolveu apenas a organização, mesmo com um limiar de 0,05. Desativar a descodificação plana permite saída aninhada, mas o checkpoint ainda tem de pontuar o span interior acima do limiar. Se os seus dados têm entidades aninhadas, construa um conjunto de teste aninhado e verifique se os spans interiores aparecem de todo, antes de escolher o GLiNER em vez de um modelo de NER aninhado especializado.
Use o GLiNER para extração explícita de entidades e encaminhe para um LLM os casos que exigem inferência, raciocínio ou mapeamento para ontologias predefinidas. O limiar de encaminhamento deve vir de um conjunto de domínio anotado.
Avaliar o NER: métricas, armadilhas e conjuntos de teste
Cada número deste guia vem do modelo, dos dados e do hardware da respetiva fonte. Volte a executar a comparação no seu próprio conjunto anotado antes de escolher. Esta secção explica como construir esse conjunto e pontuá-lo.
Um modelo pode obter 95% de F1 num conjunto de teste selecionado e, mesmo assim, falhar na mistura de documentos que vê depois do deployment. Construa o conjunto de avaliação a partir da distribuição de produção e mantenha fatias para os formatos raros e os tipos de entidade raros que o F1 agregado pode esconder.
As métricas principais
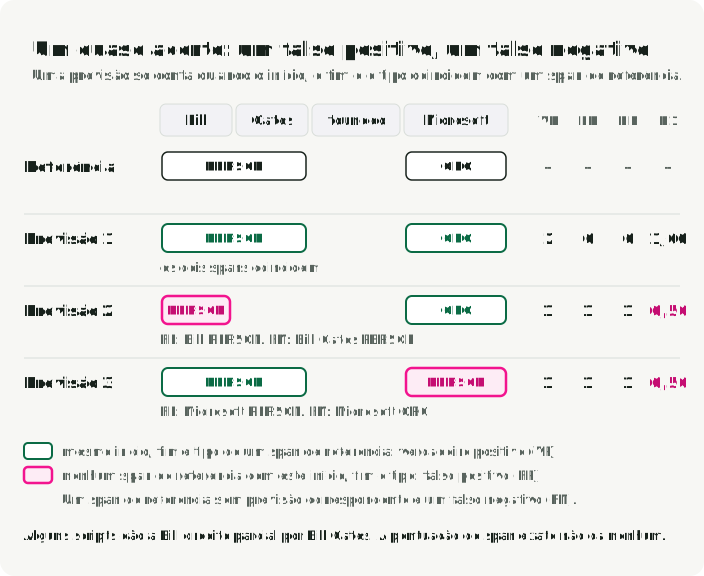
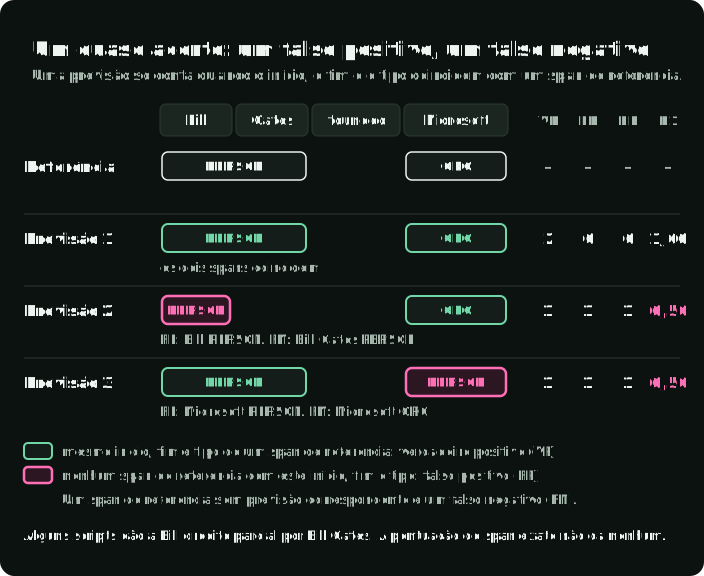
Identifique cada ocorrência pelo ID do documento, pelos offsets de início e fim em intervalo semiaberto e pelo tipo, e verifique que text[start:end] recupera a menção. Duas ocorrências de “John” são dois alvos. A figura pontua três previsões para uma frase.
Valide a contagem de documentos antes de fazer a correspondência: previsões em falta têm de gerar falsos negativos, não desaparecer através de zip(). Conte tipos ou offsets errados como uma previsão sem correspondência e um span de referência sem correspondência. Reporte precisão, recall e F1 micro, o suporte e o recall por tipo, e defina a agregação macro e os casos vazios. O avaliador exato do repositório complementar implementa estas regras e mantém os documentos em falta, falhados e ignorados no denominador de referência.
- F1 ao nível da entidade: a métrica padrão. Uma previsão só está correta se as fronteiras do span e o tipo coincidirem exatamente com a referência. É o que a maioria dos artigos reporta.
- F1 ao nível do token: pontua cada token de forma independente. Pode fazer uma fronteira parcial parecer melhor do que numa pontuação por span exato, por isso reporte o F1 por span exato quando a correção das fronteiras importa; use métricas ao nível do token apenas quando a decisão a jusante for ao nível do token.
- Precisão vs recall: têm frequentemente custos assimétricos. Na desidentificação, o recall importa mais: falhar um nome é pior do que ocultar em excesso. Na extração para bases de dados, a precisão importa mais: entradas falsas corrompem a análise a jusante.
Armadilhas comuns na avaliação
- Inflação por correspondência parcial: “Bill” extraído quando a referência é “Bill Gates”. Alguns scripts contam isto como correspondência parcial. Use correspondência de span exato, a menos que tenha motivo para não o fazer.
- Confusão de tipos: “Microsoft” identificado corretamente como span mas etiquetado como PERSON em vez de ORG deve pontuar zero. Verifique que o seu código de avaliação trata este caso.
- Fuga no conjunto de teste: mantenha registos, documentos e anotações duplicados e quase duplicados fora do conjunto de teste. Para uma afirmação zero-shot rigorosa, mantenha também os tipos de entidade-alvo fora do treino; strings de superfície repetidas, por si só, não são fuga.
- Prompts de etiquetas não controlados: um nome de tipo curto e uma descrição de tipo testada são entradas diferentes. Versione as descrições das etiquetas, os limiares, as revisões dos checkpoints e o modo de descodificação juntamente com a pontuação.
- Afirmações zero-shot numa só língua: não infira a qualidade multilingue a partir do inglês. O OpenNER abrange 36 corpora e 52 línguas, e os seus baselines não encontraram um modelo único que fosse o melhor em todas as línguas (Palen-Michel et al., 2025). Em experiências do FiNERweb, passar de etiquetas em inglês para etiquetas na língua-alvo alterou o F1 em 0,02–0,09, consoante a configuração (Golde et al., 2026). Teste as duas línguas das etiquetas quando o produto usa terminologia local.
- Uma só execução como resultado final: reporte a variação entre sementes aleatórias quando aplicável, varrimentos de limiar e amostras de produção repetidas. Contagens pequenas por fatia tornam instável a classificação dos modelos.
Mantenha a normalização, a ligação de entidades, o agrupamento de registos e os extremos das relações separados do F1 extrativo. Para a privacidade, reporte as instâncias vazadas e os documentos aceites automaticamente que foram afetados, as ocultações incorretas e a fração enviada para revisão. Para o serving, reporte a taxa de conclusão, a latência por documento p50/p95, execuções a frio e a quente, tamanhos de batch e de etiquetas, memória máxima e custo por documento aceite.
Construir um conjunto de teste de domínio
Para a avaliação em produção, recomendo:
- Amostrar dados de produção, não exemplos selecionados. Inclua os documentos desarrumados que o seu modelo vai realmente ver.
- Dimensionar o conjunto de teste a partir de um piloto. Anote um piloto de cerca de 50 documentos, conte os spans de referência por etiqueta e faça bootstrap do recall por etiqueta. Acrescente documentos até o intervalo de 95% para a etiqueta mais rara que lhe interessa ser mais estreito do que a diferença que precisa de detetar.
- Usar pelo menos dois anotadores num subconjunto de calibração. Arbitre os desacordos e reporte o F1 por span exato entre os spans dos dois anotadores. A concordância mostra onde as diretrizes são ambíguas; não é um limite superior para o desempenho do modelo.
- Estratificar por dificuldade: casos fáceis (texto limpo, tipos padrão) e casos difíceis (entidades ambíguas, jargão, texto com ruído).
- Manter fatias de privacidade e de equidade. Para PII, reporte o recall por tipo de PII, língua, locale, formato de documento e fatias demográficas ou de origem do nome relevantes. Minimize o acesso dos avaliadores a texto sensível em bruto, defina limites de retenção e reveja os falsos negativos.
O NER contínuo precisa de um conjunto de regressão imutável
As taxonomias de produção mudam. Acrescente novos tipos sem alterar em silêncio o que um tipo antigo significa. Mantenha um conjunto de regressão versionado e imutável para os tipos existentes, um conjunto de teste separado para o novo tipo e um registo de alterações para as mudanças nas diretrizes de anotação. Reporte em separado as pontuações dos tipos antigos e do novo tipo antes de substituir um checkpoint. É a forma mais simples de detetar esquecimento e deriva da taxonomia.
NER em produção em quatro setores
Cada domínio extrai coisas diferentes e tem um ponto de partida publicado diferente. A última coluna indica a ressalva que muda o que se testa primeiro.
| Domínio | O que é extraído | Ponto de partida | Ressalva que muda uma escolha |
|---|---|---|---|
| Saúde | Nomes, datas, IDs e outra PHI para desidentificação | As avaliações da John Snow Labs e da Providence acima; os modelos abertos de NER médico do OpenMed | Reporte as instâncias vazadas e os documentos afetados, não só o F1. |
| Finanças | Menções de empresas em notícias; campos em relatórios | O caso de estudo da CFM para notícias; o FinBERT-MRC para relatórios (92,78 de F1 no ChFinAnn, 96,80 no AdminPunish) | Os resultados do FinBERT-MRC são em relatórios chineses; teste em separado relatórios SEC em inglês, documentos longos e entidades aninhadas. |
| E-commerce | Tipo de produto, marca e atributos em consultas de pesquisa | O EAMT da Walmart (cerca de 60 etiquetas de NER para consultas); o TripleLearn da Home Depot (F1 retido 69,5 → 93,3, em produção há mais de 9 meses) | O método do TripleLearn são rondas repetidas de supervisão de domínio; o artigo não compara arquiteturas atuais. |
| Cibersegurança | Malware, agentes de ameaça e indicadores de comprometimento | CyNER (76,66 de F1 micro por span, XLM-RoBERTa-large); CyberNER (21 etiquetas STIX 2.1, RoBERTa 0,736 de F1) | Apenas datasets de investigação; os conjuntos de etiquetas diferem, por isso mapeie-os para STIX antes de comparar modelos. |
Otimização do deployment: de Python à inferência com menor latência
Quando um modelo passa no conjunto de teste do domínio, a pergunta seguinte é como o servir. Esta é a ordem em que eu experimentaria os runtimes, com uma verificação depois de cada passo. Mude uma coisa de cada vez, para que uma queda de qualidade tenha uma só causa.
- Servir com PyTorch e Ray Serve.
- Exportar ONNX FP32 ou executá-lo com gline-rs. Se os spans diferirem do PyTorch, corrija a exportação.
- Quantizar para INT8 dinâmico, mantendo as projeções descendentes da FFN em FP32.
- Fazer o deployment do INT8 apenas se o recall por etiqueta ficar dentro do objetivo. Caso contrário, manter o FP32.
Serving nativo do GLiNER
Antes de passar para um novo runtime, teste o caminho Ray Serve do projeto. O gliner[serve] oferece batching dinâmico, dimensionamento de batches consciente da memória, escalabilidade com várias réplicas e um cliente HTTP. O batching e as réplicas podem melhorar o débito mantendo o código do modelo. O batching também acrescenta tempo de espera, por isso meça a latência na fila e a latência a quente com a sua mistura de pedidos.
Exportação para ONNX
O GLiNER tem conversão nativa para ONNX, e existem modelos já convertidos no Hugging Face (onnx-community/gliner_small-v2.1). A exportação escreve o grafo, a configuração e o tokenizer num só diretório, e a mesma classe GLiNER volta a carregá-lo com a mesma chamada predict_entities:
from gliner import GLiNER

model = GLiNER.from_pretrained("urchade/gliner_medium-v2.1")
model.export_to_onnx("onnx/fp32")

onnx_model = GLiNER.from_pretrained("onnx/fp32", load_onnx_model=True)
entities = onnx_model.predict_entities(text, labels, threshold=0.5)
A comparação ONNX do repositório complementar executa PyTorch, ONNX FP32 e ONNX INT8 com as mesmas entradas e compara os respetivos spans. Precisa de Python 3.11+ e de uv. O comando de dados descarrega uma partição fixa do Few-NERD e mantém as suas primeiras 32 frases, o suficiente para verificar a exportação, não para classificar modelos. O quickstart com --download obtém uma vez o checkpoint fixo:
uv sync --locked --all-extras
# Run once if the pinned model files are not cached:
uv run --all-extras python -m ner_demo.quickstart --download
uv run --all-extras python -m ner_demo.data --split test --limit 32
uv run --all-extras python -m ner_demo.onnx_check \
  --dataset artifacts/few-nerd-test.json --output artifacts/onnx-comparison
Use um novo diretório de saída, ou --reuse para verificar pacotes existentes. O comando falha quando os spans do FP32 diferem do PyTorch, ou quando o INT8 perde mais de 0,02 de recall micro. Numa CPU Apple M5 Max, o ONNX FP32 devolveu exatamente os spans do PyTorch, com uma latência p50 de 16-19 ms por frase, contra 64-66 ms do PyTorch.
Quantização INT8
A quantização INT8 dinâmica guarda os pesos como inteiros de 8 bits e torna o ficheiro ONNX mais pequeno. No encoder DeBERTa do GLiNER, quantizar todas as camadas não funciona. No repositório complementar, quantizar todas as camadas MatMul não devolveu entidade nenhuma. Quantizar as camadas um grupo de cada vez mostrou a causa: as doze projeções descendentes da FFN (layer.N/output/dense, a segunda camada linear da rede feed-forward de cada bloco do encoder) sozinhas empurram todas as pontuações para baixo do limiar. Manter essas doze camadas em FP32 resolve o problema. O código copia o pacote FP32 (para os seus ficheiros de configuração e de tokenizer) e depois quantiza tudo o resto:
import shutil

import onnx
from onnxruntime.quantization import QuantType, quantize_dynamic

shutil.copytree("onnx/fp32", "onnx/int8")
graph = onnx.load("onnx/fp32/model.onnx", load_external_data=False).graph
keep_fp32 = [n.name for n in graph.node if n.op_type == "MatMul" and "/output/dense/" in n.name and "/attention/" not in n.name]

quantize_dynamic("onnx/fp32/model.onnx", "onnx/int8/model.onnx",
                 weight_type=QuantType.QInt8,
                 op_types_to_quantize=["MatMul", "Gemm", "Gather"],
                 nodes_to_exclude=keep_fp32)
Carregue onnx/int8 com load_onnx_model=True, como no FP32. O quantize_package do repositório complementar faz o mesmo e depois valida o pacote. Nas 32 frases do Few-NERD (Apple M5 Max, ONNX Runtime 1.24.4), os resultados medidos foram:
| Caminho | Pacote | Latência p50 | Precisão micro | Recall micro |
|---|---|---|---|---|
| PyTorch | - | 64-66 ms | 0,506 | 0,722 |
| ONNX FP32 | 790 MB | 16-19 ms | 0,506 | 0,722 |
| ONNX INT8 | 353 MB | 13-15 ms | 0,487 | 0,722 |
O INT8 reduziu o pacote em mais de metade e manteve o recall, mas alterou os spans em 4 de 32 frases e acrescentou 3 falsos positivos. Nesta execução, o INT8 compensa quando a memória ou o tamanho do pacote são o limite; quanto à latência, a maior parte do ganho veio da exportação ONNX FP32. Verifique o recall por etiqueta face ao FP32 nos seus próprios dados antes do deployment: um ficheiro mais pequeno não diz nada sobre a qualidade da extração. A orientação atual do GLiNER recomenda o treino com consciência de quantização (QAT) quando o INT8 tem de igualar a precisão do FP32.
gline-rs: reimplementação em Rust
O gline-rs (Apache 2.0) remove o runtime Python do caminho de inferência. O projeto reporta cerca de quatro vezes o débito em CPU do Python no seu próprio benchmark. Suporta modelos de span e de token, GPU/NPU via ONNX Runtime e é distribuído como crate no crates.io. Carrega uma exportação ONNX e o respetivo tokenizer.json, como o pacote escrito acima; o README do projeto mostra a chamada em Rust.
O pacote fast-gliner oferece bindings Python via PyO3.
Que runtime usar e quando
| Caminho | Use quando | Evidência disponível | Meça antes do deployment |
|---|---|---|---|
| Ray Serve nativo | Quer manter o Python e acrescentar batching e réplicas | Documentação do projeto GLiNER | Latência na fila, latência a quente, débito |
| ONNX FP32 | Primeira mudança de runtime em qualquer hardware | Repositório complementar: mesmos spans do PyTorch, latência 3,4-4x inferior | Latência a quente, débito e F1 por span exato |
| ONNX INT8 | A memória ou o tamanho do pacote é o limite em CPU | Repositório complementar: 353 MB vs 790 MB, mesmo recall, 3 FPs a mais | Recall e precisão por etiqueta face ao FP32 |
| gline-rs | Precisa de remover o runtime Python | Benchmark do projeto com o hardware e a configuração documentados | O seu modo de modelo, etiquetas, hardware e batch |
Extração estruturada: schemas nativos, Instructor e decoders locais
Quando precisa de mais flexibilidade do que os modelos encoder oferecem (entidades implícitas, raciocínio, mapeamento para ontologias), comece pelo mecanismo de schema nativo do fornecedor. A OpenAI suporta formatos de resposta json_schema estritos, os structured outputs da Anthropic suportam saídas JSON e entradas de ferramentas estritas, e a API do Gemini suporta um subconjunto de JSON Schema. Um modelo Pydantic ou Zod partilhado pode descrever o contrato, mas cada fornecedor aceita um subconjunto de schema diferente e tem um comportamento diferente quanto a recusas e complexidade.
A conformidade com o schema torna o parsing fiável. Não prova que um span extraído existe no texto de origem nem que um valor normalizado está correto. Valide os valores dos campos, preserve offsets ou citações sempre que possível e pontue a precisão semântica num conjunto anotado.
As três bibliotecas abaixo impõem a estrutura de formas diferentes. A figura passa uma frase por cada uma: o Instructor valida e repete, o Outlines bloqueia uma etiqueta inválida durante a descodificação e o LangExtract devolve offsets de caracteres para cada campo.
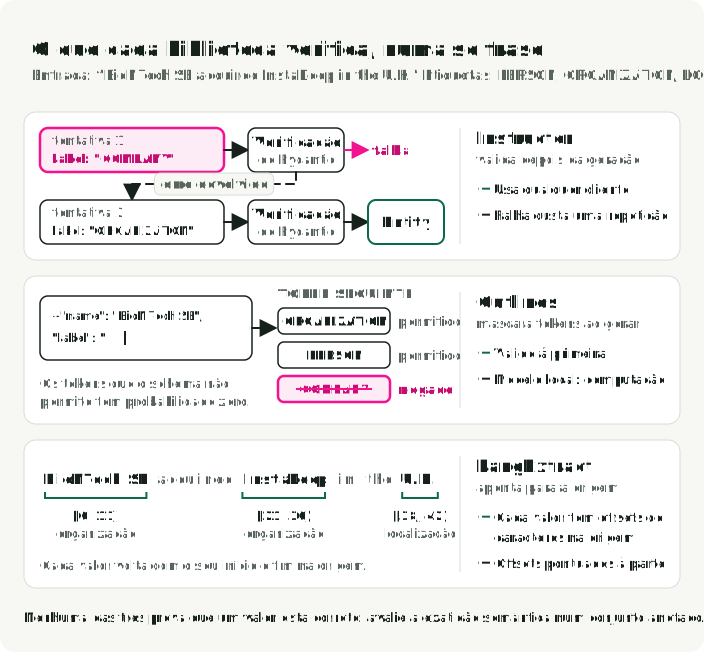
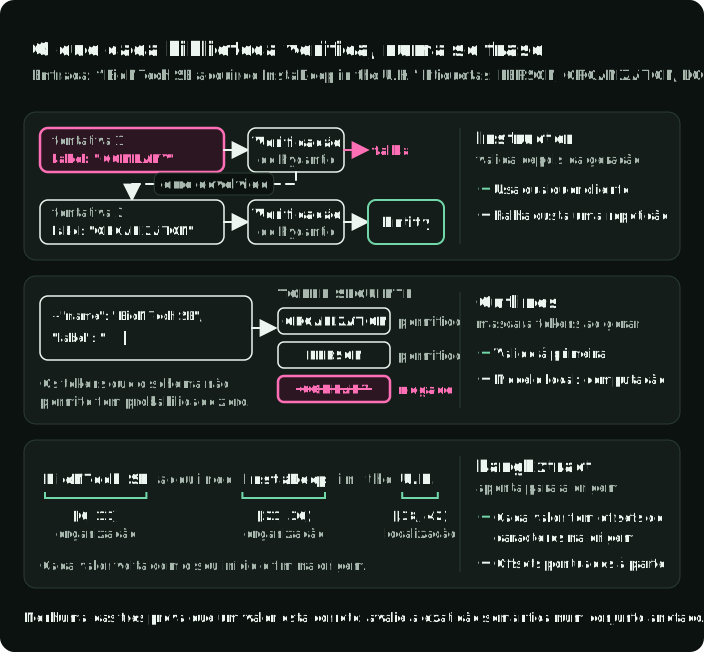
O Instructor envolve os clientes dos fornecedores com validação Pydantic e repetições opcionais após falhas de validação.
Este exemplo autónomo exige pip install instructor openai pydantic, uma OPENAI_API_KEY e um pedido pago ao fornecedor. Qualquer modelo com suporte a structured output serve aqui; o exemplo usa o gpt-5.4-mini, o mesmo valor por defeito do professor do repositório complementar.
import instructor
from pydantic import BaseModel
from typing import List, Literal
from openai import OpenAI

class Entity(BaseModel):
    name: str
    label: Literal["PERSON", "ORGANIZATION", "LOCATION"]

class ExtractEntities(BaseModel):
    entities: List[Entity]

client = instructor.from_openai(OpenAI())
result = client.chat.completions.create(
    model="gpt-5.4-mini", reasoning_effort="none",
    response_model=ExtractEntities,
    messages=[{"role": "user", "content": "BioNTech SE acquired InstaDeep in the U.K."}])
# entities=[Entity(name='BioNTech SE', label='ORGANIZATION'), ...]
O Outlines, da dottxt, adota uma abordagem diferente: geração de tokens com restrições através de máquinas de estados finitos. O decoder mascara os tokens que violariam a gramática-alvo, em vez de esperar por uma falha de validação e repetir. Uma visão geral da AWS cita 98% de aderência ao schema contra 76% para a validação posterior à geração. Repete também a afirmação da .txt Engineering de uma geração até 5 vezes mais rápida, sem detalhe de método suficiente para comparar os dois valores.
No Outlines, outlines.from_transformers envolve um modelo Hugging Face e o seu tokenizer. Chamar esse modelo com um prompt e uma classe Pydantic como ExtractEntities acima devolve JSON que corresponde à classe. Para uma nova comparação de extração auto-alojada, inclua o Qwen3.8-27B atual ou os checkpoints Qwen3.5 mais pequenos. Carregue-os com o loader de modelos documentado, o chat template e o backend de serving; uma arquitetura multimodal ou um formato de raciocínio pode exigir mais do que um novo ID de modelo.
O LangExtract é útil quando um campo gerado tem de estar ancorado na origem: devolve intervalos de caracteres e suporta backends de LLM alojados ou locais. Para a extração de documentos auto-alojada, o NuExtract converte JSON schemas em templates e inclui modelos de documentos multimodais. Ambos são sistemas de extração estruturada, não substitutos diretos do NER por spans: as suas saídas de campos, offsets e layout precisam das suas próprias pontuações.
A escolha depende de onde executa os seus modelos. Os schemas nativos são o caminho de menor atrito para um fornecedor suportado. O Instructor acrescenta uma camada de validação Pydantic e de repetição independente do fornecedor. O Outlines restringe a geração local face a um schema. O LangExtract dá prioridade à ancoragem na origem, enquanto o NuExtract visa a extração de documentos auto-alojada. Todos os caminhos com LLM incluem geração autorregressiva, por isso costumam demorar mais por documento do que um encoder no mesmo hardware.
A arquitetura de produção em três níveis
Eu encaminharia o NER em produção pela forma da tarefa e não por uma classificação de modelos única. Cada linha da figura mostra um pedido de exemplo, o que volta e os modelos a testar. Os casos revistos do Nível 3 voltam ao Nível 1 apenas como spans encontrados na origem.
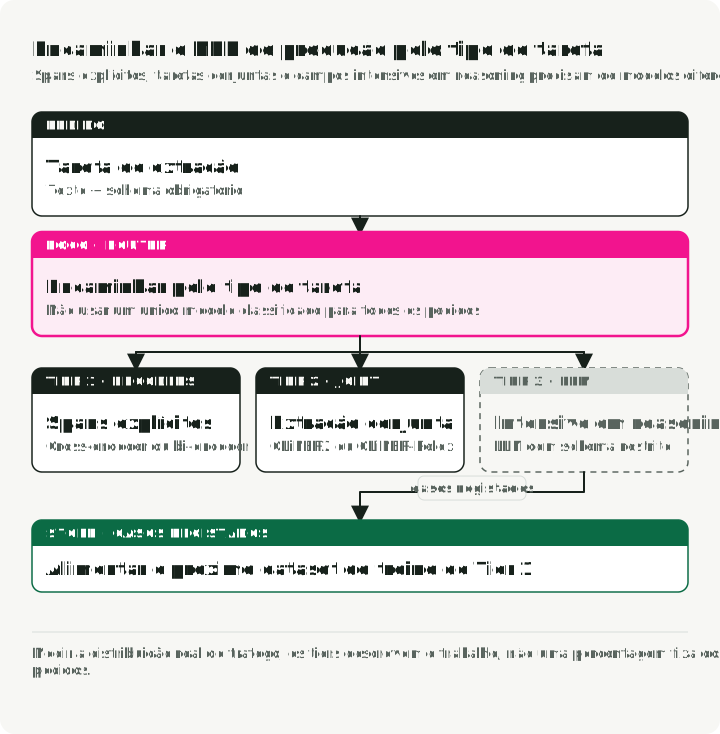
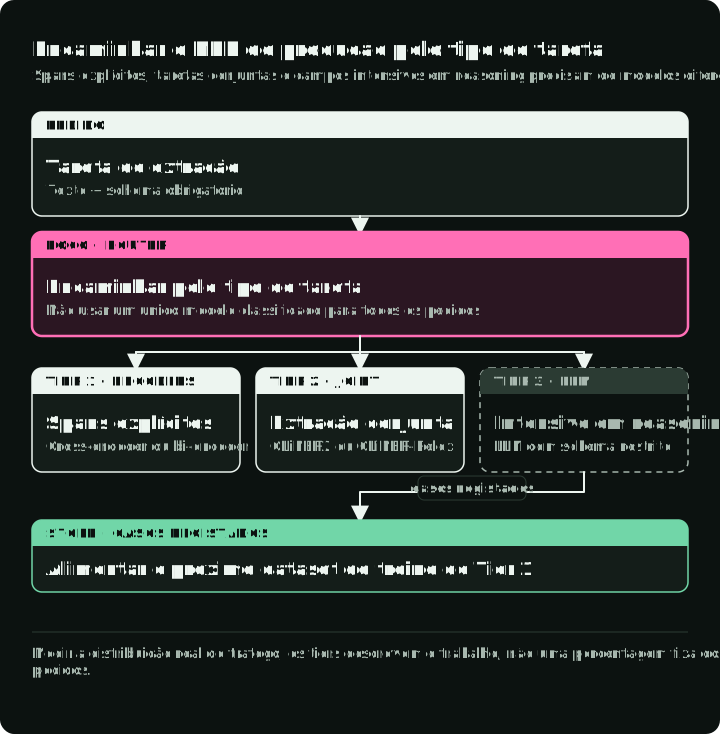
Nível 1: modelos encoder para spans explícitos. Use um GLiNER cross-encoder para um inventário de tipos pequeno. Quando um inventário grande é reutilizado, compare o bi-encoder com embeddings de tipos em cache. Faça o fine-tuning através do pipeline LLM-as-teacher e depois o deployment com serving nativo, ONNX, INT8 ou gline-rs apenas quando esse caminho passar no benchmark do domínio.
Nível 2: extração multitarefa ou de relações. Quando um pedido precisa de NER, classificação e campos hierárquicos, teste o checkpoint atual GLiNER2.5 de 194M de parâmetros contra baselines separados por tarefa. Quando o requisito central são spans e relações em conjunto, teste o GLiNER-Relex. O artigo do GLiNER2 reporta latências de classificação em CPU de 130-208 ms nos números de etiquetas testados; não mediu a API de relações posterior.
Nível 3: LLMs para extração que exige raciocínio. Encaminhe entidades implícitas, inferência contextual e mapeamento para ontologias para uma API de schema nativa ou o Instructor, no caso de APIs na cloud, e para o Outlines, no caso de saída local com restrições. Use o LangExtract quando os intervalos de origem forem essenciais e o NuExtract quando o próprio documento for a entrada. Registe estes casos para revisão. Só spans explícitos e alinhados com a origem podem tornar-se alvos de treino normais do Nível 1; factos inferidos e valores normalizados precisam dos seus próprios alvos e da sua própria avaliação.
O caso de estudo da CFM dá uma referência de custo para o Nível 1: 93,4% de F1 a $0,10 por hora em CPU reportados, contra 92,7% de F1 e $8 por hora para o seu professor Llama-70B. Os preços horários de instâncias não determinam o custo por documento sem o débito. Volte a calcular com o seu hardware, o modelo professor, o conjunto de etiquetas, a utilização e o custo de revisão.
Compromissos e limitações
Os erros do LLM-as-teacher propagam-se. Se o LLM errar de forma consistente um tipo de entidade específico (por exemplo, confundir nomes de subsidiárias com os de empresas-mãe), o encoder com fine-tuning herda esse viés. Reveja de forma intensiva os tipos de baixa confiança ou inconsistentes e mantenha uma amostra aleatória estratificada para apanhar erros sistemáticos cometidos com confiança.
Um schema válido pode conter factos falsos. O structured output nativo, o Instructor e os decoders com restrições conseguem tornar uma resposta analisável. Não conseguem garantir que cada campo está ancorado, que a fronteira de um span está correta nem que um valor normalizado corresponde ao registo certo. Guarde a evidência de origem e valide a semântica em separado.
As perdas de quantização dependem do checkpoint e das camadas que quantiza. Quantizar todas as camadas MatMul do GLiNER do repositório complementar não devolveu entidade nenhuma; manter as projeções descendentes da FFN em FP32 preservou o recall na sua verificação com 32 frases. Outro checkpoint pode ter camadas sensíveis diferentes. Compare os modelos quantizado e original em F1 por span exato e recall por etiqueta antes do deployment.
Quando a arquitetura em três níveis é exagerada. Um único domínio com tipos de entidade estáveis e exemplos anotados suficientes pode precisar apenas de um RoBERTa com fine-tuning ou de um pipeline spaCy. O padrão em três níveis serve vários domínios, tipos de entidade em evolução ou uma mistura medida de extração explícita e extração que exige raciocínio. Um pipeline de faturas estreito que extrai nomes e datas pode ficar no Nível 1.
A qualidade do bi-encoder varia conforme o dataset e o tamanho do checkpoint. No CoNLL-2003, gliner_small-v2.5 obtém 65,4% de F1, acima dos bi-encoders edge/small com 61,6%/64,2%, mas abaixo de bi-base/large com 65,6%/66,5% (Stepanov et al., 2026, tabelas 2–3). Escolha com base na qualidade exact-span medida, na calibração, no número de rótulos e no throughput no seu conjunto de domínio.
As afirmações sobre PII e multilinguismo exigem fatias. Uma pontuação agregada alta pode esconder uma perda de recall perigosa para um locale, uma forma de nome, um layout de documento ou uma classe de PII rara. Use um modelo de privacidade como um de vários controlos, defina um processo de resposta a falsos negativos e volte a avaliar quando a taxonomia, a mistura de línguas ou a origem dos dados mudar.
Principais conclusões
- Use um encoder compacto para spans explícitos só depois de passar num conjunto de teste de domínio com suporte por tipo e intervalos de confiança.
- Use o GLiNER para vocabulários de etiquetas variáveis. Compare primeiro o bi-encoder quando um inventário de tipos grande é reutilizado; ative
flat_ner=Falseapenas depois de verificar que o checkpoint encontra os spans interiores. - Use o spaCy ou um classificador de tokens com fine-tuning quando as etiquetas são estáveis e tem dados de treino.
- Use descrições de tipos testadas para afirmações zero-shot rigorosas e teste em separado a formulação das etiquetas em inglês e na língua local nos produtos multilingues.
- Mantenha o OCR, o NER, a extração de relações e a ligação de entidades como etapas de avaliação distintas, mesmo quando um só modelo expõe várias tarefas.
- Trate um LLM professor como um sistema que propõe anotações. As diretrizes humanas, a arbitragem, os conjuntos de regressão imutáveis e um conjunto de teste retido continuam a ser obrigatórios.
- Use schemas nativos nos fornecedores de LLM que os suportam, mas valide a correção semântica e a ancoragem na origem em separado da validade do JSON.
- Mude um passo de runtime de cada vez: primeiro ONNX FP32, depois INT8 com as camadas sensíveis mantidas em FP32, com uma comparação de spans após cada passo.
Referências
Artigos
- GLiNER: Generalist Model for Named Entity Recognition using Bidirectional Transformer - Zaratiana et al., NAACL 2024. A arquitetura fundacional de correspondência entre span e entidade.
- GLiNER2: An Efficient Multi-Task Information Extraction System with Schema-Driven Interface - Zaratiana et al., EMNLP 2025 System Demonstrations. Unifica NER, classificação e extração hierárquica; as versões atuais acrescentaram depois a extração de relações.
- GLiNER Bi-Encoder: Scalable Named Entity Recognition with Bi-Encoder Architecture - Stepanov et al., fevereiro de 2026. Codificação desacoplada para escala de milhões de etiquetas.
- GLiNER-Relex: A Unified Framework for Joint Named Entity Recognition and Relation Extraction - Stepanov et al., 2026. Extração conjunta e zero-shot de entidades e relações.
- GLiNER2-PII: A Multilingual Model for Personally Identifiable Information Extraction - Zaratiana et al., 2026. 42 tipos de PII com resolução ao nível do span de caracteres.
- ZeroNER: Fueling Zero-Shot Named Entity Recognition via Entity Type Descriptions - Cocchieri et al., ACL 2025. Avaliação zero-shot rigorosa com descrições de tipos.
- OpenNER 1.0: Standardized Open-Access Named Entity Recognition Datasets in 50+ Languages - Palen-Michel et al., EMNLP 2025. 36 corpora, 52 línguas e baselines multi-ontologia.
- FiNERweb: Datasets and Artifacts for Scalable Multilingual Named Entity Recognition - Golde et al., EACL 2026. Etiquetas multilingues e avaliação de transferência.
- UniversalNER: Targeted Distillation from Large Language Models for Open Named Entity Recognition - Zhou et al., ICLR 2024. NER universal baseado em LLM por destilação a partir do ChatGPT.
- NuNER: Entity Recognition Encoder Pre-training via LLM-Annotated Data - Bogdanov et al., EMNLP 2024. Estuda um encoder de 125M pré-treinado com anotações de LLM.
Artigos da indústria
- EAMT: Entity-Aware Multi-Task Learning for Query Understanding - Walmart, KDD 2023. Compreensão multitarefa de consultas com cerca de 60 etiquetas de NER.
- TripleLearn: End-to-End NER for E-Commerce Search - Home Depot, AAAI 2021. F1 de 69,5 para 93,3.
- CyNER: A Python Library for Cybersecurity Named Entity Recognition - Reconhecimento neuronal combinado com outras fontes de extração.
- CyberNER: A Harmonized STIX Corpus for Cybersecurity NER - 21 tipos de entidade alinhados com o STIX 2.1.
- FinBERT-MRC: Financial NER via Machine Reading Comprehension - Formulação MRC avaliada em datasets financeiros chineses.
Casos de estudo
- CFM Case Study: Fine-tuning GLiNER for Financial NER - O pipeline de anotação com LLM de $70 da Capital Fund Management, que atinge 93,4% de F1.
- Refuel AI: LLM Labeling Technical Report - O GPT-4 atinge 88,4% de concordância na anotação, superando os anotadores humanos.
- Sease: GLiNER as an Alternative to LLMs for Query Parsing - Onde o GLiNER falha e os LLMs continuam a ser necessários.
- John Snow Labs: Medical Text De-Identification Benchmark - Estudo de fornecedor com remapeamento e exclusões de etiquetas.
- OpenMed: Year in Review 2025 - Modelos abertos de NER médico; retrospetiva de janeiro de 2026.
Ferramentas e frameworks
- ner-field-guide demo repo - Código complementar deste artigo: pontuação por span exato, exemplos de GLiNER, conversão de anotações revistas, verificações de ONNX FP32 e INT8 e uma demonstração de PII em streaming.
- GLiNER - Biblioteca, script de treino e caminho Ray Serve com batching dinâmico e deployment com várias réplicas.
- gline-rs: Rust reimplementation of GLiNER - Inferência em Rust sobre ficheiros ONNX do GLiNER; código sob Apache 2.0.
- spaCy English pipelines - Métricas versionadas de pipelines de etiquetas fechadas.
- dslim/bert-base-NER - Classificador de tokens BERT com fine-tuning no CoNLL-2003.
- Microsoft Presidio - Análise e anonimização de PII com reconhecedores personalizados.
- Instructor - Extração estruturada com LLM através de modelos Pydantic.
- Outlines - Geração de tokens com restrições via FSMs, com um benchmark reportado de aderência ao schema.
- LangExtract - Extração estruturada ancorada na origem, com intervalos de caracteres.
- NuExtract - Extração de documentos auto-alojada, de schema para template.
- OpenAI Structured Outputs - Referência do formato de resposta estrito com JSON schema.
- Anthropic Structured Outputs - Saídas JSON e entradas de ferramentas estritas.
- Gemini Structured Outputs - Subconjunto de JSON Schema para respostas estruturadas.
- ONNX Runtime quantization - Referência de quantização INT8 dinâmica e estática.
- AWS: Structured Output with Outlines - Benchmark de 98% de aderência ao schema.