Guide NER 2026 : GLiNER, spaCy, Transformers et LLMs

Traduction automatique
Cet article a été traduit automatiquement depuis la version originale en anglais.
Ce guide s’adresse aux ingénieurs qui choisissent une solution de reconnaissance d’entités nommées (NER) pour des pipelines de retrieval, de protection de la vie privée ou de traitement de documents. Il explique comment choisir entre les reconnaisseurs de spans et l’extraction structurée par LLM, comment évaluer leurs erreurs et comment tester les options de déploiement par rapport à la latence et au coût que votre charge de travail tolère.
La NER transforme un texte en éléments étiquetés qu’un programme peut exploiter. À partir de « Bill Gates founded Microsoft on April 4, 1975 », elle peut renvoyer les spans de texte contigus Bill Gates, Microsoft et April 4, 1975, avec les types personne, organisation et date. Dans un encodeur fondé sur les spans comme GLiNER, le modèle lit le texte une seule fois et note les spans candidats par rapport aux labels que vous fournissez.
Pour un pipeline de retrieval ou de protection de la vie privée, je commencerais par me demander si la sortie doit être une mention littérale. Cette décision sépare un reconnaisseur de spans des systèmes qui normalisent aussi les valeurs, relient des enregistrements ou infèrent des faits. Les LLMs restent utiles pour proposer des annotations d’entraînement et pour traiter les cas qui demandent de l’inférence ou de la normalisation.
Dépôt associé : ner-field-guide fournit le calcul exact des scores par span, des exemples GLiNER, la conversion d’annotations révisées, des vérifications ONNX en FP32 et en INT8, et une démo de PII en streaming.
Pour la comparaison courte des modèles, voir Best NER Models in 2026.
Qu’est-ce que la reconnaissance d’entités nommées ?
La reconnaissance d’entités nommées repère des spans dans un texte et leur attribue des types : personne, organisation, date, produit ou labels propres à un domaine. Un span est un segment contigu du texte d’origine. La NER identifie la mention ; l’entity linking est l’étape distincte qui la rattache à un enregistrement canonique ou à un concept d’ontologie.
| Charge de travail | Premier modèle à tester | Passer à l’étape suivante quand |
|---|---|---|
| Identifiants ou dictionnaires contrôlés | Règles ou spaCy EntityRuler | Le recall hors des patterns connus compte. |
| Labels stables et nombreuses données d’entraînement | spaCy ou un encodeur fine-tuné | Le jeu de labels change ou le recall stagne sur les types rares. |
| Labels changeants ; petit inventaire de types | GLiNER cross-encodeur | L’inventaire grandit ou les labels sont réutilisés sur de nombreux documents. |
| Vaste inventaire de types réutilisable | GLiNER bi-encodeur | Le jeu du domaine montre une régression de qualité ou de calibration. |
| Plusieurs tâches d’extraction dans un même pipeline | GLiNER2.5 | La qualité multi-tâche rate la cible de chaque tâche. |
| Faits implicites ou raisonnement sur le schéma | Extraction structurée par LLM | La latence, le coût ou les affirmations non étayées dépassent le budget du produit. |
Un cross-encodeur GLiNER lit ensemble les noms de labels et le texte : chaque document ré-encode donc tous les labels. Un bi-encodeur encode les labels séparément et peut les mettre en cache. GLiNER2.5 est une famille de modèles distincte, qui extrait entités, classes, relations et champs structurés à partir d’un seul schéma. Chacun a sa propre section ci-dessous.
Le premier cas qui correspond l’emporte quand vous parcourez cette liste, dans l’ordre où je me poserais les questions :
- La sortie n’est pas un span littéral : utilisez un structured output de LLM.
- Des identifiants ou un dictionnaire fixe : utilisez des règles ou un EntityRuler.
- Des labels fixes et assez de données d’entraînement : utilisez spaCy ou BERT-NER.
- Un grand jeu de labels réutilisé d’un document à l’autre : utilisez le bi-encodeur GLiNER.
- Sinon : utilisez le cross-encodeur GLiNER, et essayez GLiNER2.5 quand vous avez besoin de plusieurs tâches en une passe.
Où les systèmes modernes utilisent la NER
La NER trouve toujours des spans de texte et leur attribue des labels. Ce qui a changé, c’est sa place dans le système. Elle fournit désormais des filtres pour le RAG, des arguments structurés pour les outils des agents et des champs pour les pipelines de traitement de documents. Avec ces usages, la latence, le coût et la souplesse du schéma comptent autant que la précision sur les benchmarks.
RAG : un meilleur retrieval grâce à l’extraction d’entités
La recherche par similarité seule peine quand une question contient des entités exactes. Pour « what did Anthropic say about model safety in Q4 2024? », l’extraction d’entités peut proposer « Anthropic » et « Q4 2024 » comme filtres. N’appliquez un filtre strict que si les métadonnées indexées et la sémantique des dates le permettent ; sinon, utilisez-le comme signal de classement ou conservez un chemin de retrieval sans filtre. Un alias manqué ou une plage de dates mal déduite peut exclure la réponse.
Pendant l’indexation, vous extrayez les entités de chaque chunk et les stockez comme métadonnées : {"organizations": ["Anthropic"], "dates": ["Q4 2024"], ...}. Cela permet de filtrer par entité avant la recherche vectorielle. Le RAG à base de graphe de connaissances (GraphRAG, property graphs de LlamaIndex) ajoute des relations nommées que le retrieval peut suivre sur plusieurs sauts.
Le schéma déroule un exemple d’index de quatre chunks. Comparez les deux panneaux du bas : le filtre strict ne cherche jamais dans le chunk dont la date stockée n’a pas d’année, alors que le bonus de classement y cherche quand même.
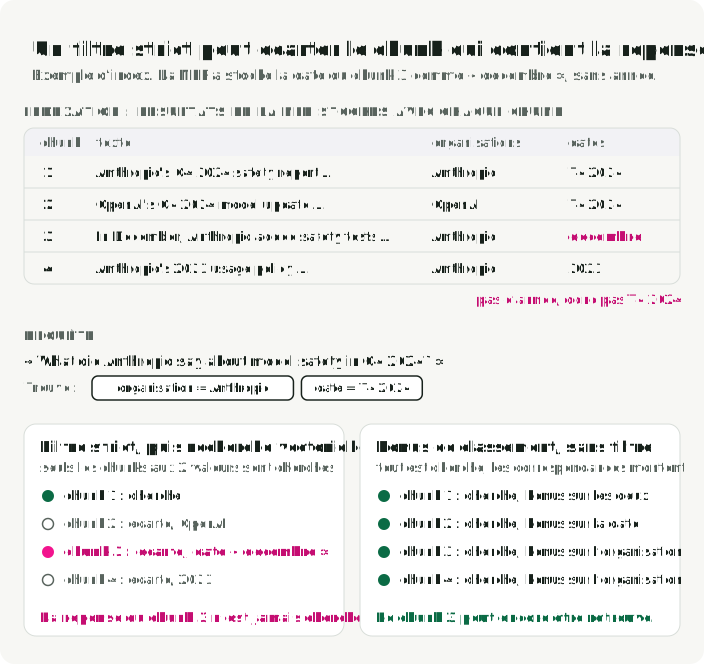
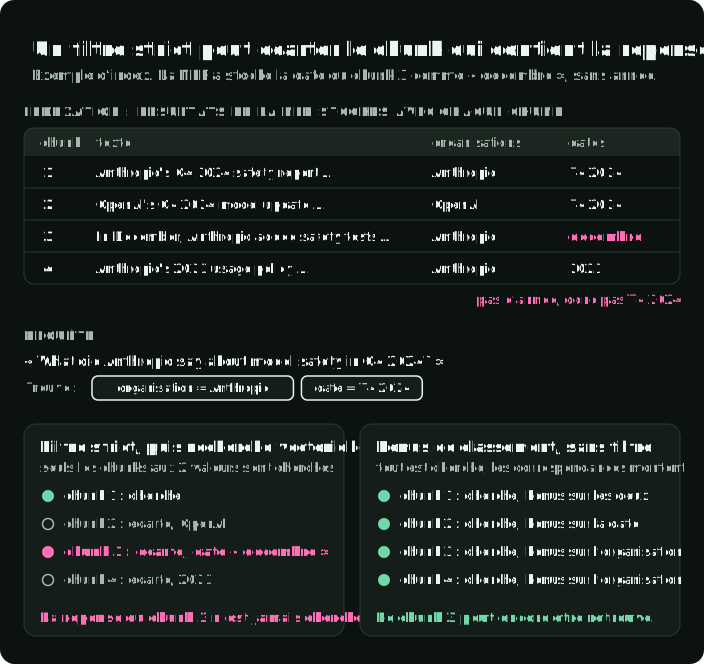
À la requête, les entités extraites de la question de l’utilisateur pilotent le routage. Une question qui mentionne le nom d’une entreprise va vers un index financier ; une question qui mentionne des noms de médicaments va vers une base de connaissances clinique. GLiNER est utile quand le schéma ou les types d’entités changent au moment de la requête. Des noms d’entreprises ou de médicaments encore jamais vus ne suffisent pas à exiger des labels à vocabulaire ouvert : un modèle à labels fermés peut reconnaître de nouvelles mentions de types connus.
Agents AI : transformer du texte en faits structurés
Les agents reçoivent du texte non structuré : pages web, réponses d’API, messages d’utilisateurs. La NER convertit ce texte en faits structurés sur lesquels l’agent peut raisonner, qu’il peut stocker ou transmettre à des outils.
Pour le routage vers un outil, une demande comme « schedule a meeting with Sarah Chen from Accenture on Thursday at 2pm » peut produire PERSON: Sarah Chen, ORGANIZATION: Accenture, DATE: Thursday et TIME: 2pm. Un résolveur de calendrier combine ensuite la date et l’heure en l’horodatage que l’API exige. Un encodeur local évite l’aller-retour vers l’API, mais sa latence dépend du modèle, du runtime, du matériel, de la taille de batch et du nombre de labels.
La NER permet aussi de suivre les entités au fil des conversations. Les systèmes de mémoire des agents doivent savoir que « Sarah » au tour 3 et « Ms. Chen » au tour 12 désignent la même personne. La NER identifie les spans ; la résolution de coréférence détermine si les mentions renvoient à la même personne dans le contexte. L’entity linking rattache ensuite cette personne à un enregistrement canonique, s’il en existe un.
Dans les deux cas, la contrainte est la latence. Si chacune de dix étapes séquentielles fait un appel NER de 200 ms, ces appels ajoutent 2 secondes de délai perçu. Un seul appel ajoute 200 ms. Les modèles encodeurs s’intègrent généralement mieux que l’extraction par LLM dans les agent loops.
Intelligence documentaire : des images aux données structurées
L’OCR transforme des images en texte. La NER transforme ce texte en champs structurés.
Un pipeline standard utilise d’abord l’OCR, par exemple Tesseract, Azure Document Intelligence ou AWS Textract, pour produire du texte et des boîtes englobantes. La NER repère ensuite des spans pour des champs comme invoice_number, vendor_name, total et due_date. Une étape de schéma ou d’extraction de relations doit regrouper les descriptions de lignes, les quantités et les prix dans line_items. La même séquence s’applique aux contrats, aux dossiers médicaux et aux dépôts réglementaires.
Chaque étape a son propre score. Une erreur d’OCR qui perd un chiffre ressemble à un oubli de la NER si vous ne notez que l’enregistrement final.
| Étape | Ce qu’elle produit | Score |
|---|---|---|
| OCR et mise en page | Texte, ordre de lecture, boîtes | Taux d’erreur de caractères |
| NER | invoice_number, vendor_name, total | F1 par span exact |
| Regroupement | Lignes de facture (description, quantité, prix par ligne) | F1 par enregistrement |
| Linking et normalisation | ID du fournisseur, dates ISO, montants | Précision du linking ou de la normalisation |
Les pipelines documentaires modernes peuvent combiner compréhension de la mise en page, extraction d’entités et extraction de relations. L’OCR ou un modèle de document sensible à la mise en page fournit toujours le texte, l’ordre de lecture, les tableaux et les boîtes englobantes. GLiNER2.5 expose aujourd’hui les entités, les relations, la classification et les enregistrements structurés via une seule interface de schéma ; notez chaque sortie séparément.
Le coût décide de la plupart de ces pipelines. Chiffrez le vôtre au volume mensuel réel de documents, nouvelles tentatives et relecture comprises. Un encodeur compact peut tourner sur CPU, alors qu’un LLM accessible par API ajoute un coût d’inférence et une latence par document. Un test pratique consiste à annoter avec un LLM un jeu représentatif de factures. Faites ensuite un fine-tuning de GLiNER sur les enregistrements révisés, puis comparez les deux chemins sur le F1 par champ, la latence et le coût total.
Détection des PII et guardrails pour les LLMs
Des lois sur la vie privée comme le RGPD, HIPAA et le CCPA exigent des garanties pour les données personnelles, mais n’imposent pas la NER. La NER peut repérer les données personnelles pour les masquer ou les minimiser ; son recall doit être vérifié sur vos données avant de compter comme un contrôle.
Les modèles de dé-identification repèrent des spans PERSON, SSN, PHONE, EMAIL et ADDRESS et les masquent ou les remplacent par des équivalents synthétiques. Microsoft Presidio combine des reconnaisseurs avec des opérateurs d’anonymisation, et ses exemples incluent GLiNER comme reconnaisseur. GLiNER2-PII, avec 0,3 milliard de paramètres, est un autre candidat : son article couvre 42 types de PII à la résolution du caractère.
Dans la comparaison de John Snow Labs, réalisée par un éditeur, 48 documents annotés par des experts couvrent six classes de PHI. Les labels des fournisseurs ont été remappés et les prédictions non mappables exclues, ce qui limite l’interprétation d’un fournisseur à l’autre. Le rapport Providence décrit 281 événements de fuite de PHI dans une revue de 1 000 notes contenant 34 701 phrases. Ces événements ne sont pas des phrases distinctes touchées : dans une évaluation de la vie privée, comptez à la fois les instances divulguées et les documents touchés.
Pour les guardrails de LLM, la NER sert de couche de pré-filtrage : analysez l’entrée de l’utilisateur à la recherche de PII avant de l’envoyer à une API externe, puis bloquez-la ou anonymisez-la.
Un détecteur local peut être plus rapide que de demander au LLM de se modérer lui-même, mais les faux négatifs restent possibles : ajoutez donc un autre contrôle pour l’exposition de PII que votre système ne peut pas accepter. GLiNER est utile ici parce que les catégories de PII varient selon la juridiction. Une API peut accepter un nouveau label comme « genetic information » sans réentraînement. Le recall pour ce nouveau label reste inconnu tant que vous ne l’avez pas vérifié sur des exemples révisés.
GLiNER : mise en correspondance span-label pour la NER à vocabulaire ouvert
GLiNER (NAACL 2024, Zaratiana et al.) a rendu la NER à base d’encodeur compétitive face aux LLMs pour une fraction du coût. Au lieu de traiter la NER comme de l’étiquetage de séquence ou de la génération de texte, GLiNER la traite comme un problème de mise en correspondance. Il note chaque span candidat (chaque suite contiguë de mots comme « Bill Gates » ou « Microsoft ») par rapport à chaque label de type d’entité, puis garde les paires à score élevé.
Le modèle reçoit les labels de types d’entités et le texte d’entrée comme une seule séquence : [ENT] person [ENT] organization [ENT] date [SEP] Bill Gates founded Microsoft.... Un transformer bidirectionnel (DeBERTa-v3) encode l’ensemble.
À partir de la sortie, le modèle construit deux ensembles de représentations. Le premier affine la représentation de chaque type d’entité à partir de la position d’un token [ENT], à travers un petit réseau feed-forward (FFN) qui transforme le vecteur de l’encodeur. Le second représente les spans du texte en combinant les vecteurs des mots de début et de fin à travers un autre FFN. Un produit scalaire entre une représentation de span et une représentation de type d’entité donne un score.
En appliquant une sigmoïde, on obtient la probabilité que le span allant de la position de mot à la position de mot appartienne au type d’entité : . Ici, est le vecteur de span produit par le FFN et est l’embedding du type d’entité affiné par le FFN à partir du token [ENT] correspondant (Zaratiana et al., 2024, éq. 1–2). Les spans candidats sont plafonnés à 12 mots ; le tokenizer peut découper un mot en plusieurs sous-tokens.
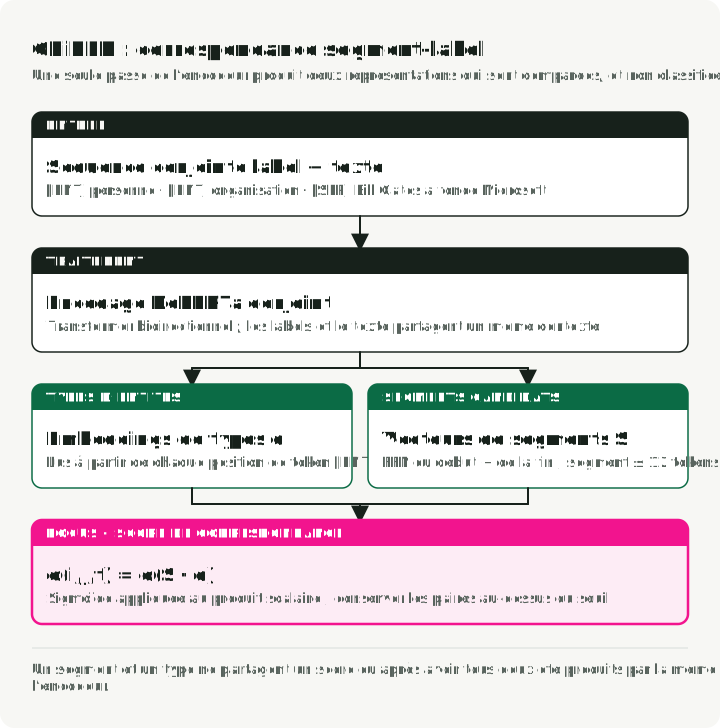
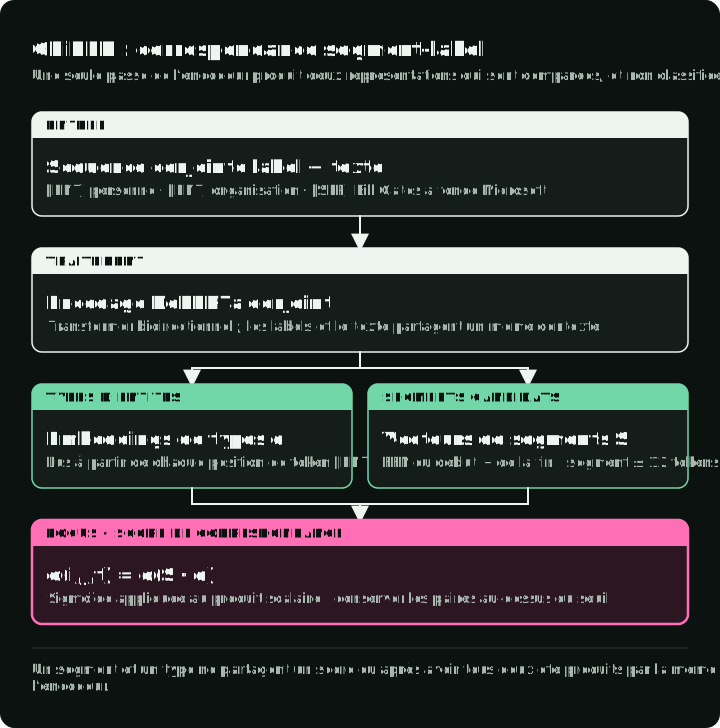
GLiNER accepte au moment de l’inférence des descriptions de labels en langage naturel sans réentraînement, mais la qualité de l’extraction dépend de la formulation des labels et de l’adéquation au domaine. Vous fournissez des types d’entités comme « person », « adverse drug reaction » ou « financial instrument », et le modèle note les spans par rapport à eux. Les configurations 50M, 90M et 300M ci-dessous sont les modèles de l’article original. La fiche du modèle v2.1 liste en revanche des checkpoints anglais de 166M, 209M et 459M, plus un checkpoint multilingue de 209M, tous sous Apache 2.0. Ne comparez pas la latence ou la mémoire entre ces générations comme si les noms de paramètres étaient identiques (fiche du modèle GLiNER v2.1).
Pour un vrai test zero-shot strict, mettez de côté les types cibles aussi bien que les exemples cibles : le modèle n’a aucun exemple annoté pour la tâche cible. Une description de type comme « a medically confirmed adverse effect caused by a treatment » donne au modèle plus d’information que adverse event seul. Ce n’est pas une garantie de transfert, mais ZeroNER, guidé par des descriptions, a surpassé les baselines qui n’utilisent que le nom sur ses benchmarks à types exclus (Cocchieri et al., 2025).
Les données d’entraînement du modèle original viennent du dataset Pile-NER : 44 889 passages avec 240K spans d’entités sur 13K types d’entités, tous annotés par ChatGPT. L’entraînement de GLiNER-L a pris environ 5 heures sur un seul A100 (Zaratiana et al., 2024).
Résultats des benchmarks
Résultats zero-shot de Zaratiana et al. (2024), tableaux 1 et 2. Le F1 combine précision et recall en un seul score ; un score plus élevé n’est meilleur que sous les mêmes règles de tâche et d’évaluation. La moyenne sur sept datasets combine cinq datasets CrossNER avec MIT Movie et MIT Restaurant :
| Modèle | Params | F1 moyen (CrossNER + MIT) | F1 moyen (20 datasets) |
|---|---|---|---|
| GLiNER-L | 300M | 60,9 % | 47,8 % |
| GoLLIE | 7B | 58,0 % | — |
| UniNER-13B | 13B | 55,6 % | — |
| GLiNER-M | 90M | 55,4 % | — |
| UniNER-7B | 7B | 53,7 % | 45,7 % |
| GLiNER-S | 50M | 52,7 % | — |
| ChatGPT (GPT-3.5) | — | 47,5 % | 36,5 % |
GLiNER-M, avec 90M de paramètres, égale presque UniNER-13B sur la moyenne des sept datasets de l’article (55,4 % contre 55,6 % de F1) en utilisant environ 140 fois moins de paramètres. GLiNER-S, à 50M, dépasse de 5 points de F1 le résultat rapporté pour ChatGPT (GPT-3.5). La variante multilingue, entraînée uniquement sur des données anglaises, dépasse ce même ChatGPT dans 8 langues non anglaises sur 10 (Zaratiana et al., 2024). Ces comparaisons utilisent les versions de modèles et le harness d’évaluation de l’article ; elles ne disent rien des LLMs plus récents.
Un appel GLiNER minimal
Pour une nouvelle comparaison de cross-encodeurs, incluez les checkpoints GLiNER v2.5 maintenus à côté de la v2.1. Dans la vérification du dépôt associé sur 32 phrases de Few-NERD, un dataset public de NER, gliner_small-v2.5 a trouvé 44 des 54 spans de référence et gliner_medium-v2.1 en a trouvé 39. Cet échantillon est trop petit pour classer les deux, mais c’est une raison d’inclure la v2.5 dans votre propre essai. GLiNER v2.5 et Fastino GLiNER2.5 (plus bas) sont des familles de modèles différentes.
L’appel ci-dessous charge le checkpoint medium v2.1 et affiche chaque span avec son score. La version du dépôt associé est ner_demo/quickstart.py.
from gliner import GLiNER

model = GLiNER.from_pretrained("urchade/gliner_medium-v2.1")
text = "Bill Gates founded Microsoft on April 4, 1975."
labels = ["person", "organization", "date"]
entities = model.predict_entities(text, labels, threshold=0.5)

for entity in entities:
    print(f"{entity['text']} => {entity['label']} ({entity['score']:.3f})")
# Bill Gates => person (0.994)
# Microsoft => organization (0.973)
# April 4, 1975 => date (0.951)Le bi-encodeur : passer à la NER à un million de labels
GLiNER d’origine encode ensemble les labels et le texte. L’encodage conjoint coûte de plus en plus cher à mesure que le texte des labels occupe le contexte et doit être ré-encodé à chaque document. Le point de croisement dépend du checkpoint, des descriptions de labels et du matériel. Quand le même vaste inventaire de types est réutilisé sur de nombreux documents, faites du bi-encodeur GLiNER la comparaison par défaut. Il sépare l’encodage du texte et celui des labels dans deux transformers distincts (Stepanov et al., 2026).
Le schéma compare les deux conceptions sur trois documents. Dans la voie du cross-encodeur, tous les labels entrent dans l’encodeur avec chaque document. Dans la voie du bi-encodeur, un encodeur de labels s’exécute une seule fois, ses vecteurs sont mis en cache, et seul l’encodeur de texte s’exécute par document. Le graphique en dessous montre le coût en débit à 1 024 labels.
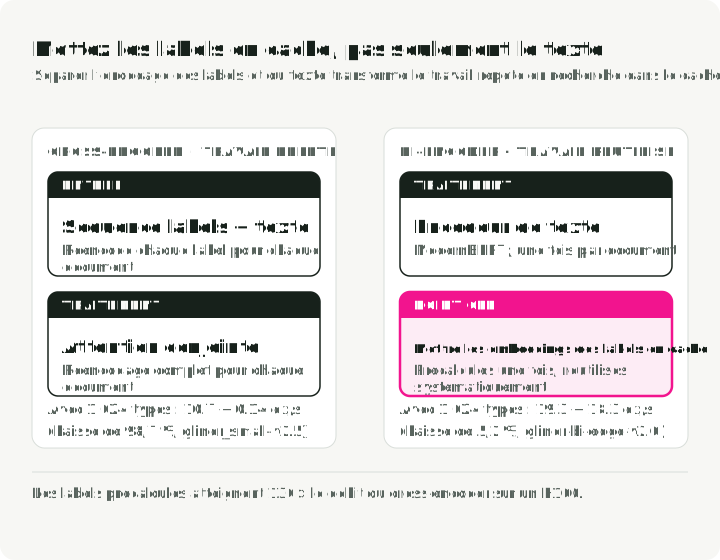
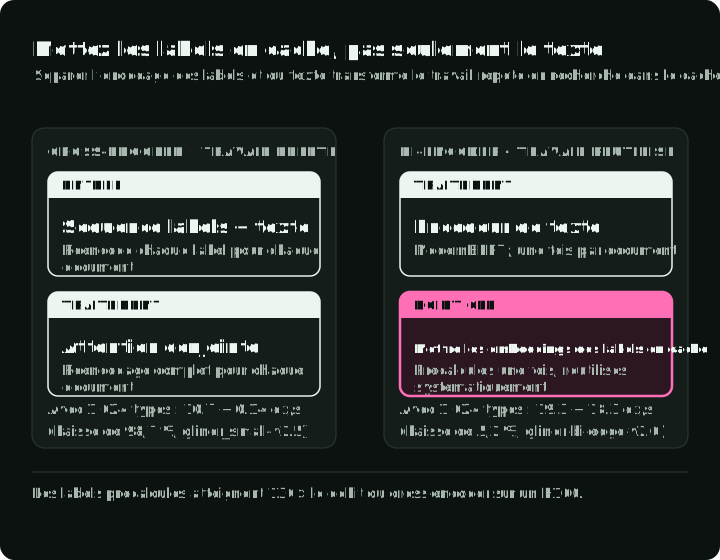
L’encodeur de texte utilise ModernBERT (famille Ettin), l’encodeur de labels utilise des sentence transformers (BGE ou MiniLM). Les spans et les labels sont notés par produit scalaire. Cette séparation permet de pré-calculer une fois les embeddings des types d’entités et de les mettre en cache. À l’inférence, les labels en cache évitent de les ré-encoder. Noter les spans candidats par rapport à ces labels demande tout de même du calcul et de la mémoire ; une application à un million de labels a aussi besoin d’une récupération de candidats bornée ou d’un traitement par batch, avec le recall mesuré pour les labels écartés avant la notation.
Quatre tailles de modèles sont disponibles, toutes évaluées sur CrossNER (Stepanov et al., 2026, tableau 1) :
| Modèle | Paramètres | F1 moyen (CrossNER + MIT) | Débit (H100) | Avec labels pré-calculés |
|---|---|---|---|---|
| gliner-bi-edge-v2.0 | 60M | 54,0 % | 13,64 ex/s | 24,62 ex/s |
| gliner-bi-small-v2.0 | 108M | 57,2 % | 7,99 ex/s | 15,22 ex/s |
| gliner-bi-base-v2.0 | 194M | 60,3 % | 5,91 ex/s | 9,51 ex/s |
| gliner-bi-large-v2.0 | 530M | 61,5 % | 2,68 ex/s | 3,60 ex/s |
Avec 1 024 types d’entités, le bi-encodeur gliner-bi-edge-v2.0 aux labels pré-calculés ne perd que 5,2 % de débit par rapport à un seul label (19,3 → 18,3 ex/s). Le cross-encodeur comparable gliner_small-v2.5 perd 98,7 % (10,7 → 0,14 ex/s). Dans les tests de l’article sur un seul H100 avec un batch de taille 1 et des entrées de 64, 256 et 512 tokens, le bi-encodeur pré-calculé atteint un avantage de débit allant jusqu’à 130× sur gliner_small-v2.5. Avec 100 types d’entités sur un seul H100, le bi-encodeur traite 1,96 million de prédictions par jour, contre 368K pour le cross-encodeur (Stepanov et al., 2026).
L’article du bi-encodeur rapporte 61,5 % pour gliner-bi-large-v2.0 contre 60,9 % pour gliner_large-v2.5 sur la même moyenne CrossNER plus MIT : sur ce benchmark, le bi-encodeur n’échange donc pas de précision contre de la vitesse. Les auteurs recommandent bi-base-v2.0 (194M) comme meilleur compromis de taille : 98 % de la précision du grand modèle pour 2,6 fois sa vitesse (Stepanov et al., 2026).
Le balayage de mesures s’arrête à 1 024 labels, sur un H100, avec un batch de taille un et dix passes avant par configuration. Il ne mesure pas un service déployé à un million de labels. L’article cite comme cas d’usage l’entity linking sur de grandes bases de connaissances comme Wikidata ; l’entity linking est disponible via le framework GLiNKER de Knowledgator.
Le code encode une seule fois le jeu de labels et réutilise les embeddings pour chaque texte. Avec les trois labels ci-dessous, il renvoie les mêmes trois spans que l’appel au cross-encodeur plus haut.
from gliner import GLiNER

model = GLiNER.from_pretrained("knowledgator/gliner-bi-base-v2.0")

# Pre-compute embeddings for a reused label set; rebuild this cache when labels or the checkpoint change.
entity_types = ["person", "organization", "date"]  # Small example; large inventories need bounded candidate selection
entity_embeddings = model.encode_labels(entity_types, batch_size=8)

# Encode text and score spans against the cached labels
texts = ["Bill Gates founded Microsoft on April 4, 1975."]
outputs = model.batch_predict_with_embeds(texts, entity_embeddings, entity_types)GLiNER2 et GLiNER2.5 : un seul schéma pour plusieurs tâches
L’écosystème GLiNER d’origine répartissait la NER, l’extraction de relations, la classification et l’extraction au niveau du document entre des modèles distincts. L’article GLiNER2 d’EMNLP 2025 a unifié la NER, la classification et l’extraction hiérarchique dans un seul modèle de 205M paramètres ; les versions actuelles ont ensuite ajouté l’extraction de relations à la même interface de schéma.
Cette architecture de 2025 garde la conception en cross-encodeur, mais étend le contexte à 2 048 tokens (4 fois l’original) et ajoute des schémas déclaratifs pour définir les tâches d’extraction. L’entraînement utilise 135 698 documents réels annotés avec GPT-4o plus 118 636 exemples synthétiques (Zaratiana et al., 2025).
Sur CrossNER en zero-shot, GLiNER 2 obtient 0,590 de F1, proche des 0,599 de GPT-4o dans le benchmark de mi-2025 de l’article. En classification, il atteint en moyenne 0,72 sur 7 benchmarks, contre 0,69 pour DeBERTa-v3-large. Sur CPU, l’article rapporte une latence de classification de 130 à 208 ms sur les nombres de labels testés. La baseline DeBERTa zero-shot demande une passe avant par label candidat et passe de 1 714 ms pour 5 labels à 16 897 ms pour 50 ; ce n’est pas le temps d’exécution d’un classifieur DeBERTa supervisé (Zaratiana et al., 2025).
L’exemple ci-dessous charge GLiNER2.5, un checkpoint plus récent : les scores de 2025 ci-dessus ne le décrivent donc pas. GLiNER2.5 (194M paramètres) prédit les positions de début et de fin des spans au lieu de noter chaque span. Sa fenêtre est de 4 096 tokens : découpez donc les documents plus longs en chunks qui se chevauchent avec l’utilitaire de la bibliothèque, et vérifiez que les offsets renvoyés correspondent bien au texte complet. Chargez-le avec AutoExtractor, comme ci-dessous.
from gliner2 import AutoExtractor

# Requires `pip install gliner2[local]` and downloads the checkpoint.
extractor = AutoExtractor.from_pretrained("fastino/gliner2.5-base-v1")

# Compose tasks through the current schema interface
schema = (extractor.create_schema()
    .entities({"person": "Names of people", "company": "Organization names"})
    .classification("sentiment", ["positive", "negative", "neutral"])
    .relations(["works_for", "founded", "located_in"])
    .structure("product_info")
        .field("name", dtype="str")
        .field("price", dtype="str"))
text = "Acme launched a $19 widget in Berlin."
results = extractor.extract(text, schema)
L’article d’EMNLP n’évalue que la NER et la classification. Il ne rapporte aucun benchmark d’extraction hiérarchique et ne couvre pas l’API de relations ajoutée ensuite. Un modèle unique qui exécute quatre tâches peut quand même obtenir un score plus bas sur chacune que quatre modèles spécialisés : comparez donc chaque tâche à sa propre baseline.
Autres variantes de GLiNER pour des besoins précis
La famille GLiNER compte désormais plusieurs architectures en plus du cross-encodeur, du bi-encodeur et de GLiNER2.5. Chacune répond à un besoin :
| Besoin | Candidat | À vérifier |
|---|---|---|
| Entités et relations en une passe | GLiNER-Relex | Le F1 des spans et celui des relations sur les mêmes documents. |
| Candidat local pour les PII | GLiNER2-PII | Le recall par langue, format de document et type de PII. |
| Candidat multilingue à vocabulaire ouvert | GLiNER-X | La qualité par langue ; sa fiche liste 23 langues. |
| Types générés ou changeants | GLiNER Decoder | Si les types générés sont stables et utiles en aval. |
| Masquage des PII en streaming | GLiNER Streaming PII | Les caractères divulgués avant la libération, pas seulement le recall final. |
Les résultats de GLiNER-Relex et de GLiNER2-PII viennent de leurs propres articles et harnesses d’évaluation. GLiNER-X et GLiNER Decoder ont des fiches de modèle, pas de benchmarks évalués par des pairs : leurs chiffres ne sont donc pas comparables à ceux des articles ci-dessus.
Les PII en streaming changent le moment où l’on peut libérer le texte
GLiNER Streaming PII ajoute une détection incrémentale avec un backbone causal Qwen3-0.6B et un état de session en cache. Son API renvoie tout l’instantané courant de la session, avec des offsets dans le texte accumulé. Conservez les limites des chunks, gardez les labels fixes jusqu’à un recalcul complet et supprimez les sessions terminées.
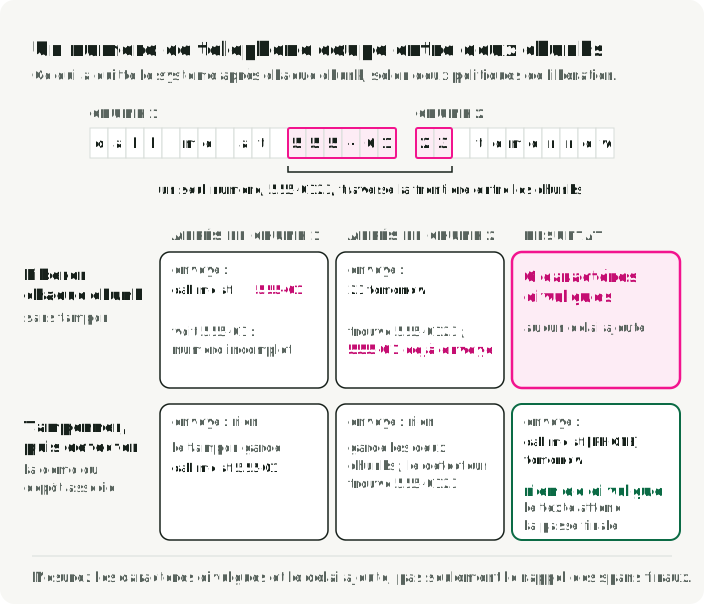
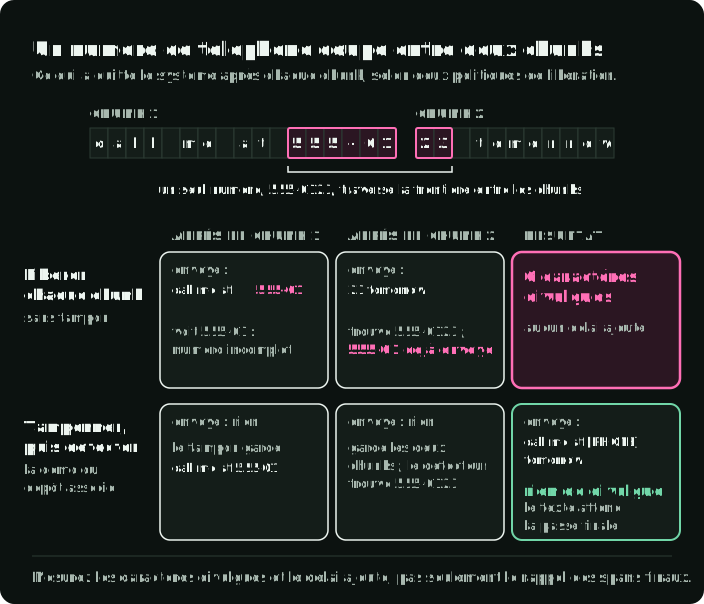
Pour le masquage en streaming, je mettrais en tampon le texte non libéré et je testerais les entités coupées entre deux chunks. Trouver un numéro de téléphone après en avoir envoyé la première moitié ne permet pas de reprendre ces octets. Mesurez les caractères divulgués avant la libération et le délai ajouté, en plus du recall final des spans. La fiche du modèle rapporte le F2 de masquage PIIMB séparément du F1 strict par span typé ; ils répondent à des questions différentes. La fiche rapporte aussi des résultats multilingues plus faibles : le checkpoint publié n’est donc pas un filtre de confidentialité universel.
Le schéma coupe un numéro de téléphone en deux chunks. Libéré chunk par chunk, la première moitié est déjà partie quand la seconde arrive. Avec un tampon, le détecteur voit le numéro entier et seul le texte masqué sort. Le module ner_demo.streaming du dépôt associé conserve tout le texte jusqu’à une passe de détection finale, puis le libère avec les spans détectés masqués.
Alternatives à labels fermés : spaCy et un classifieur de tokens fine-tuné
Quand le jeu de labels est stable et que vous avez des données annotées, vous n’avez pas besoin des labels ouverts de GLiNER. Un modèle entraîné sur ce jeu de labels est la baseline à battre.
Les pipelines entraînés de spaCy (en_core_web_sm, en_core_web_trf) reconnaissent un ensemble fixe de types d’entités (PERSON, ORG, GPE, DATE, etc.) défini à l’entraînement. Étendre le composant ner entraîné demande des exemples annotés et un entraînement. Pour des identifiants ou un dictionnaire contrôlé, EntityRuler ajoute des labels personnalisés par des patterns sans réentraînement ; son recall hors de ces patterns est nul. La fiche du modèle en_core_web_trf 3.8.0 rapporte 90,19 de F1 en NER sur OntoNotes 5.0, mais seulement pour ses 18 types prédéfinis (fiche du modèle spaCy).
L’exemple ajoute un pattern de ticker avant le composant ner entraîné : la règle prend donc $AAPL en premier, et le modèle étiquette le reste :
import spacy

nlp = spacy.load("en_core_web_trf")
ruler = nlp.add_pipe("entity_ruler", before="ner")
ruler.add_patterns([{"label": "TICKER", "pattern": [{"TEXT": "$"}, {"TEXT": {"REGEX": r"^[A-Z]{1,5}$"}}]}])

doc = nlp("Tim Cook said Apple ($AAPL) will open an office in Berlin in March 2027.")
print([(ent.text, ent.label_) for ent in doc.ents])
# [('Tim Cook', 'PERSON'), ('Apple', 'ORG'), ('$AAPL', 'TICKER'), ('Berlin', 'GPE'), ('March 2027', 'DATE')]
Pour des labels stables avec des spans annotés représentatifs, un classifieur de tokens fine-tuné comme BERT, RoBERTa ou DeBERTa est la baseline supervisée. Le pipeline de Hugging Face en charge un en une ligne. dslim/bert-base-NER, l’encodeur fixe de l’évaluation du dépôt associé, a été entraîné sur CoNLL-2003 : ses labels sont donc figés à PER, ORG, LOC et MISC. La date de la même phrase n’est pas trouvée, car le modèle n’a pas de label de date :
from transformers import pipeline

ner = pipeline("token-classification", model="dslim/bert-base-NER", aggregation_strategy="simple")
for ent in ner("Tim Cook said Apple will open an office in Berlin in March 2027."):
    print(ent["word"], ent["entity_group"], round(float(ent["score"]), 3))
# Tim Cook PER 1.0
# Apple ORG 0.998
# Berlin LOC 0.999
Pour obtenir vos propres labels, faites un fine-tuning d’un tel modèle sur vos spans annotés. Comparez-le à spaCy et à GLiNER sur le F1 par span exact, le recall par label, la calibration, la latence et le coût, sur le même jeu de domaine.
Ma recommandation : utilisez spaCy ou un classifieur de tokens fine-tuné pour les types d’entités standard ou stables quand vous avez des données d’entraînement. Utilisez GLiNER quand vous avez besoin de types flexibles en zero-shot ou quand votre pipeline doit s’adapter sans réentraînement. Ils peuvent partager un même pipeline : spaCy gère la tokenisation et le découpage en phrases, GLiNER gère l’extraction d’entités.
Les licences des checkpoints font partie du choix du modèle
Les modèles de ce guide ne partagent pas une même licence. Vérifiez les conditions du code, des poids et des datasets du checkpoint exact avant de le déployer :
| Version | Licence publiée | Conséquence pratique |
|---|---|---|
| GLiNER v2.1, GLiNER v2.5 et GLiNER bi | Apache 2.0 | Conditions permissives dans la fiche du modèle ; vérifiez quand même dépendances et données. |
| GLiNER2, GLiNER2.5 et GLiNER2-PII | Apache 2.0 | Confirmez le checkpoint choisi, pas seulement la bibliothèque. |
spaCy en_core_web_trf et dslim/bert-base-NER | MIT | Permissif ; les corpus d’entraînement ont leurs propres conditions. |
| UniNER-7B-all | CC BY-NC 4.0 | Ne pas l’utiliser dans un parcours commercial sans autorisation séparée. |
| NuNER | MIT | Le modèle et le dataset publiés indiquent des conditions MIT. |
Les mentions de licence ne sont pas un avis juridique. Une revue de production doit inclure les conditions du modèle de base, des données d’entraînement et du fournisseur.
Les LLMs comme professeurs : une étude de cas à $70 et un pipeline déployable
Le pattern LLM-as-teacher sépare l’annotation coûteuse de l’inférence moins chère : un LLM annote une fois les données d’entraînement, puis un petit encodeur entraîné sur ces labels sert chaque requête. Deux articles de recherche ont établi que de petits modèles peuvent apprendre la NER à partir de labels produits par un LLM, et deux études de cas publiées montrent comment des équipes l’ont appliqué.
La recherche derrière ce pattern : UniNER et NuNER
UniNER (ICLR 2024, Zhou et al.) et NuNER (EMNLP 2024, Bogdanov et al.) distillent tous deux des annotations de LLM dans des modèles de NER plus petits, mais ils ne s’accordent pas sur la taille minimale possible.
UniNER fait un fine-tuning de LLaMA-7B/13B sur 45 889 paires entrée-sortie générées par ChatGPT. Pour chaque type d’entité, le modèle répond à « What describes [type] in the text? » et produit des listes JSON. Une astuce d’entraînement déterminante : l’échantillonnage négatif fondé sur la fréquence fait passer le F1 de 31,5 % à 53,4 % (Zhou et al., 2024).
UniNER-7B atteint 41,7 % de F1 en zero-shot sur 43 datasets, devant les 34,9 % de ChatGPT, soit 7 points de plus. La variante 13B atteint 43,4 %, seulement 1,7 point de plus pour presque le double de paramètres (Zhou et al., 2024).
Le compromis en production : la configuration de type UniNER la mieux notée de l’article interroge chaque type d’entité de façon séquentielle. Sa variante tout-en-un utilise une seule réponse, mais obtient en moyenne 3,3 % de moins. En FP16, un checkpoint 7B demande environ 14 Go rien que pour les poids ; une quantization à moins de bits peut réduire cette empreinte. Le checkpoint UniNER-7B-all est non commercial (voir le tableau des licences ci-dessus).
NuNER part de RoBERTa-base (125M paramètres) et utilise un entraînement contrastif avec 4,38 millions d’annotations GPT-3.5 couvrant 200K concepts. Après l’entraînement, l’encodeur de concepts est écarté ; l’encodeur de texte s’insère dans n’importe quel pipeline de NER standard à la place de RoBERTa (Bogdanov et al., 2024).
Le tableau 3 de NuNER rapporte environ 6,1 à 16,2 points de plus que RoBERTa en F1 macro-moyen de classification de tokens, avec des encodeurs gelés et des têtes linéaires, sur quatre datasets et des tailles d’entraînement échantillonnées (Bogdanov et al., 2024).
Les deux articles montrent qu’un modèle plus petit peut apprendre à partir d’annotations de LLM. Aucun ne montre que l’élève dépasse son professeur sur un nouveau domaine, c’est pourquoi le pipeline ci-dessous garde un jeu de test révisé séparément.
L’étude de cas CFM
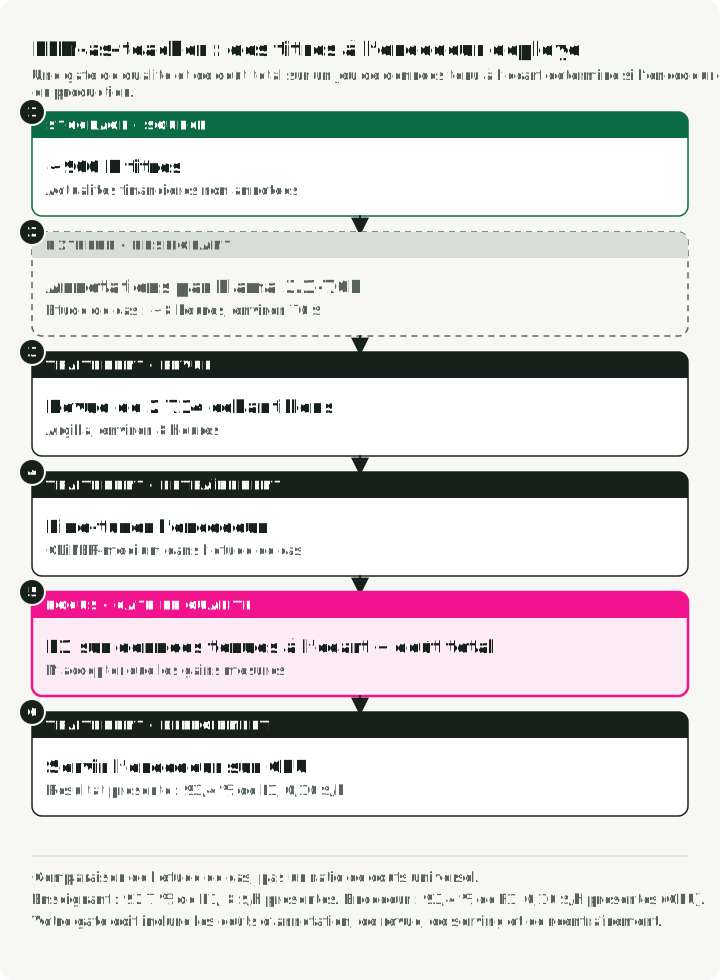
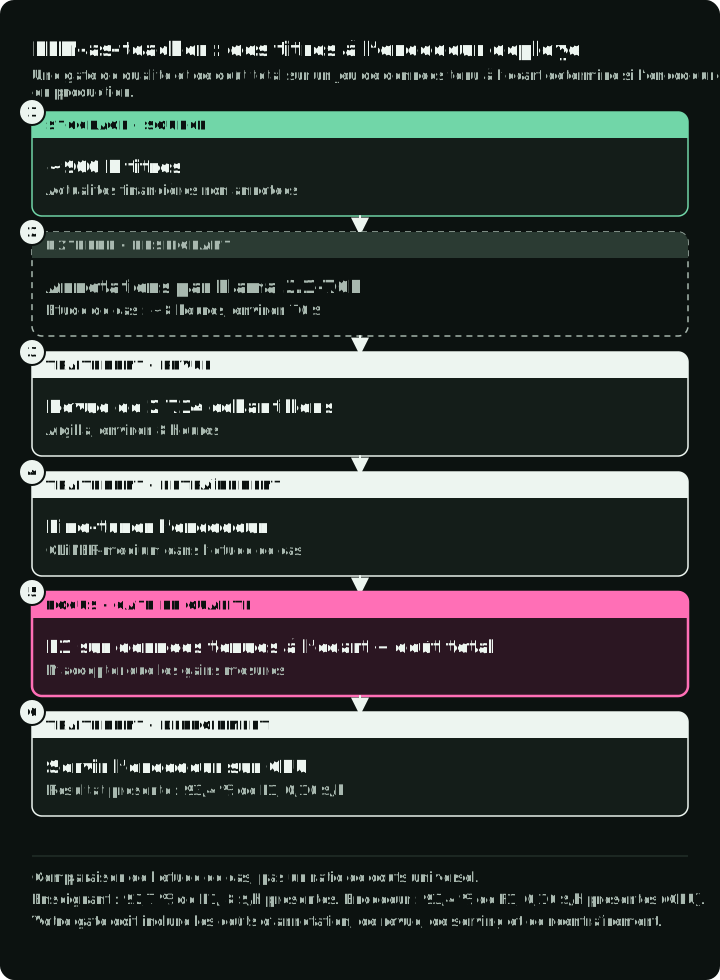
Dans une étude de cas de Hugging Face, Capital Fund Management a extrait des noms d’entreprises dans environ 900 000 titres d’actualité financière. GLiNER en zero-shot a obtenu 87,0 % de F1. L’équipe a utilisé Llama 3.1-70B pour annoter le dataset en environ 8 heures pour environ $70, puis a révisé 2 714 échantillons dans Argilla en 8 heures de plus.
Le fine-tuning de GLiNER sur ces données a atteint 93,4 % de F1 dans l’étude de cas, contre 92,7 % pour le professeur Llama-70B. Les auteurs rapportent $0,10 par heure sur CPU pour le modèle fine-tuné et $8 par heure pour le professeur (étude de cas CFM). Ces chiffres décrivent une seule tâche d’actualité financière et une seule infrastructure.
L’étude Refuel AI
Le rapport technique d’un éditeur, Refuel AI, évalue l’annotation par LLM sur 8 datasets de NLP, dont CoNLL-2003. Il rapporte 88,4 % d’accord avec la vérité terrain pour GPT-4 (mars 2023) et 86,2 % pour les annotateurs humains dans son dispositif, ainsi qu’une annotation 20 fois plus rapide et 7 fois moins chère. Une expérience distincte d’ensemble sur des données propriétaires a dépassé 95 % d’accord, son meilleur LLM individuel atteignant 89 %. Le routage fondé sur la confiance vers des modèles moins chers ou plus puissants est un usage proposé, pas le mécanisme mesuré derrière le résultat sur huit datasets (rapport technique Refuel AI).
Un pipeline de production
Un flux de production pratique comporte six étapes. Le schéma place chaque étape dans la voie de celui qui l’exécute, avec les chiffres de CFM et la boucle de retour vers la révision quand l’élève rate sa cible. Le graphique en dessous compare le F1 et le coût horaire de CFM pour le professeur et pour l’élève.
- Rédigez des consignes d’annotation en langage naturel.
- Créez des jeux de développement et de test annotés par des humains, le jeu de test étant mis de côté. La section sur l’évaluation plus bas donne une procédure pour les dimensionner.
- Utilisez un LLM avec un prompt versionné et un schéma de sortie explicite pour proposer en masse des labels d’entraînement. Conservez le modèle demandé et le modèle réellement utilisé, le prompt et le texte source. Rejetez les types inconnus et les spans qui ne peuvent pas être alignés sur la source.
- Révisez un sous-ensemble avec Argilla ou Label Studio.
- Faites le fine-tuning d’un encodeur compact (GLiNER, SpanMarker, RoBERTa). Pour GLiNER, utilisez le
train.pydu dépôt (python train.py --config configs/config.yaml) ou la méthodetrain_model()du modèle, avec le fichier d’entraînement révisé comme données d’entraînement et le fichier de développement pour l’évaluation pendant l’entraînement. - Ne déployez qu’après avoir vérifié que l’encodeur passe un contrôle de qualité et de coût total sur le jeu mis de côté. CFM a rapporté un coût d’infrastructure horaire 16 à 80 fois plus bas dans son dispositif ; incluez dans votre comparaison les coûts d’annotation, de révision, de serving et de réentraînement.
Le LLM peut réduire le volume d’annotation manuelle, mais l’équipe reste responsable du jeu de validation, des consignes d’annotation, de la révision ciblée et de l’analyse des erreurs.
Le dépôt compagnon démontre une proposition de l’enseignant et convertit les annotations vérifiées pour l’étape 5 (section du README). Exécutez ces commandes dans ce dépôt avec Python 3.11+, uv et les dépendances installées avec uv sync --locked --all-extras. Définissez OPENAI_API_KEY pour l’appel payant à l’enseignant. La conversion nécessite les fichiers du modèle GLiNER fixé et de son backbone en cache ; uv run --all-extras python -m ner_demo.quickstart --download les télécharge une fois.
-
Exécutez la démonstration de l’enseignant sur un document. Elle effectue une requête payante pour une phrase fixe sur le projet d’acquisition d’Arm par NVIDIA et écrit un enregistrement non vérifié dans
artifacts/teacher_annotations.jsonl:uv run --all-extras python -m ner_demo.teacher --allow-paid -
Vérifiez la proposition à la main et résolvez les annotations rejetées. Préparez
artifacts/reviewed.jsonlavec les documents d’entraînement vérifiés et les documents de développement et de test annotés séparément par des humains dans le processus de production ci-dessus. Les trois splits doivent être non vides, les identifiants des documents doivent être uniques et aucun texte source ne doit apparaître dans plusieurs splits. Ne recopiez pas la phrase de démonstration entre les splits. Définissezreviewed: true, unreviewer,status: "ok"et unsplit(train,developmentoutest) sur chaque enregistrement, et gardezsource_sha256conforme au texte source. Un seul enregistrement de démonstration ne peut pas fournir les trois splits. -
Convertissez le fichier révisé complet. Cela écrit
train.json,development.jsonettest.jsondansartifacts/training/au format d’entraînement de GLiNER, après avoir fait passer chaque ligne par le data collator propre à GLiNER :uv run --all-extras python -m ner_demo.training artifacts/reviewed.jsonl
Passez train.json et development.json à l’exécution du fine-tuning de GLiNER de l’étape 5, et gardez test.json pour la vérification finale.
Là où GLiNER échoue et où les LLMs restent utiles
Le benchmark de Sease (octobre 2025) a testé GLiNER face à GPT-4.1-mini sur 30 tâches d’analyse de requêtes. GPT-4.1-mini a eu 100 % de réponses entièrement correctes. GLiNER en a eu 53 % (16 sur 30). Mais GLiNER a répondu en 0,08 seconde contre 1,21 seconde pour le LLM, soit 15 fois plus vite.
Sur ce benchmark de 30 tâches, GLiNER a échoué selon trois schémas récurrents :
- Entités implicites : extraire « event » de « Elton John performed at Madison Square Garden ». Aucun texte ne dit littéralement « event », mais le LLM en déduit « concert ».
- Sensibilité à la formulation des labels : « 2022 » obtient 0,388 face à « date » mais 0,958 face à « year ». De petits changements de label provoquent de grands écarts de score.
- Mapping de valeurs : GLiNER renvoie le texte de surface exact (« family houses ») au lieu de la valeur canonique (« Single family house »). Un LLM peut faire cette normalisation quand son prompt et son schéma définissent les valeurs cibles.
Entités imbriquées et chevauchantes
Une entité imbriquée se trouve à l’intérieur d’une autre. Dans « New York University », « New York » est un lieu à l’intérieur du nom d’une organisation. Les textes biomédicaux (« acute myeloid leukemia » dans un diagnostic plus long) et juridiques (un service à l’intérieur d’une autorité nommée) présentent le même schéma.
GLiNER décode par défaut à plat, ce qui supprime les spans qui se chevauchent. Son API prend aussi en charge flat_ner=False, qui autorise les prédictions qui se chevauchent :
entities = model.predict_entities(
    "She studied at New York University.", ["organization", "location"],
    flat_ner=False, threshold=0.3)
# [{'text': 'New York University', 'label': 'organization', 'score': 0.855, ...}]
Avec urchade/gliner_medium-v2.1, cet appel n’a renvoyé que l’organisation, même avec un seuil de 0,05. Désactiver le décodage à plat autorise une sortie imbriquée, mais le checkpoint doit encore noter le span interne au-dessus du seuil. Si vos données contiennent des entités imbriquées, construisez un jeu de test imbriqué et vérifiez que les spans internes apparaissent bien avant de choisir GLiNER plutôt qu’un modèle de NER imbriquée spécialisé.
Utilisez GLiNER pour l’extraction d’entités explicites et envoyez à un LLM les cas qui demandent de l’inférence, du raisonnement ou un mapping vers des ontologies prédéfinies. Le seuil de routage doit venir d’un jeu de domaine annoté.
Évaluer la NER : métriques, pièges et jeux de test
Chaque chiffre de ce guide vient du modèle, des données et du matériel de sa source. Relancez la comparaison sur votre propre jeu annoté avant de choisir. Cette section explique comment construire ce jeu et le noter.
Un modèle peut obtenir 95 % de F1 sur un jeu de test soigné et pourtant échouer sur le mélange de documents qu’il voit après le déploiement. Construisez le jeu d’évaluation à partir de la distribution de production et gardez des tranches pour les formats rares et les types d’entités rares que le F1 agrégé peut masquer.
Les métriques essentielles
Identifiez chaque occurrence par l’ID du document, des offsets de début et de fin semi-ouverts et un type, et vérifiez que text[start:end] retrouve la mention. Deux occurrences de « John » sont deux cibles. Le schéma note trois prédictions pour une même phrase.
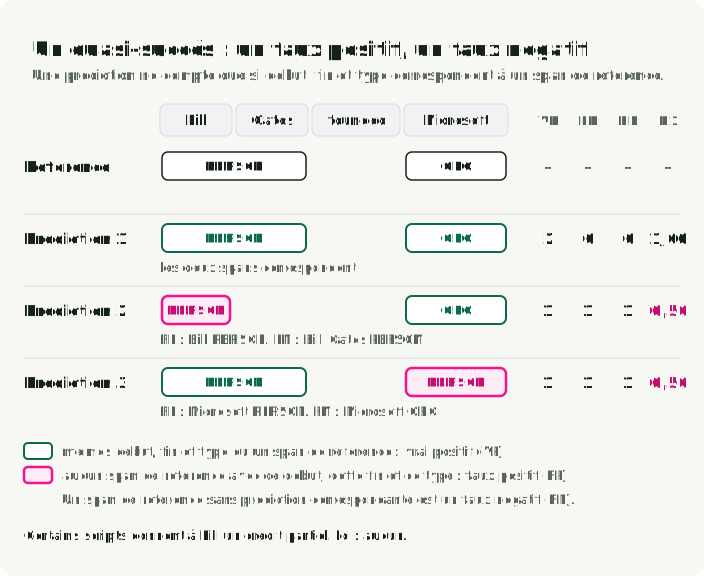
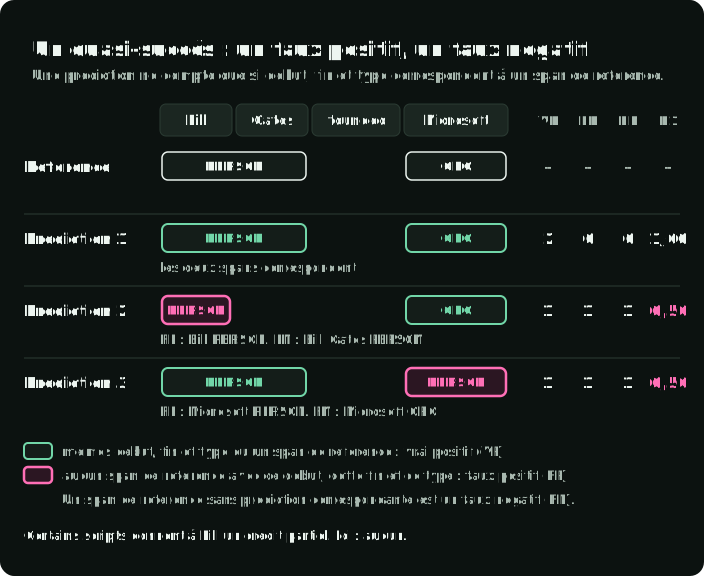
Validez le nombre de documents avant la mise en correspondance : les prédictions manquantes doivent créer des faux négatifs, pas disparaître à travers zip(). Comptez un type ou des offsets erronés comme une prédiction non appariée et un span de référence non apparié. Rapportez la précision, le recall et le F1 micro, le support et le recall par type, et définissez l’agrégation macro et les cas vides. L’évaluateur exact du dépôt associé implémente ces règles et garde les documents manquants, en échec ou ignorés dans le dénominateur de référence.
- F1 au niveau de l’entité : la métrique standard. Une prédiction n’est correcte que si les bornes du span et le type correspondent exactement à la vérité terrain. C’est ce que rapportent la plupart des articles.
- F1 au niveau du token : note chaque token indépendamment. Il peut faire paraître une borne partielle meilleure qu’un score par span exact : rapportez donc le F1 par span exact quand la justesse des bornes compte, et n’utilisez les métriques par token que si la décision en aval se prend au niveau du token.
- Précision et recall : leurs coûts sont souvent asymétriques. Pour la dé-identification, le recall compte davantage : rater un nom est pire que trop masquer. Pour l’extraction vers une base de données, la précision compte davantage : de fausses entrées corrompent l’analyse en aval.
Pièges courants de l’évaluation
- Gonflement par correspondance partielle : « Bill » est extrait alors que le label de référence est « Bill Gates ». Certains scripts comptent cela comme une correspondance partielle. Utilisez la correspondance par span exact, sauf raison contraire.
- Confusion de types : « Microsoft » correctement identifié comme span mais étiqueté PERSON au lieu de ORG doit obtenir zéro. Vérifiez que votre code d’évaluation le gère.
- Fuite du jeu de test : gardez hors du jeu de test les enregistrements, documents et annotations en double ou quasi doublons. Pour une affirmation zero-shot stricte, gardez aussi les types d’entités cibles hors de l’entraînement ; des chaînes de surface répétées ne sont pas à elles seules une fuite.
- Prompts de labels non contrôlés : un nom de type court et une description de type testée sont deux entrées différentes. Versionnez avec le score les descriptions de labels, les seuils, les révisions de checkpoint et le mode de décodage.
- Affirmations zero-shot sur une seule langue : n’en déduisez pas la qualité multilingue à partir de l’anglais. OpenNER couvre 36 corpus et 52 langues, et ses baselines n’ont trouvé aucun modèle meilleur dans toutes les langues (Palen-Michel et al., 2025). Dans les expériences de FiNERweb, passer de labels en anglais à des labels dans la langue cible a modifié le F1 de 0,02 à 0,09 selon le cadre (Golde et al., 2026). Testez les deux langues de labels quand le produit utilise une terminologie locale.
- Une seule exécution comme résultat final : rapportez la variation selon les seeds aléatoires quand c’est applicable, les balayages de seuil et les échantillons de production répétés. Un faible nombre d’éléments par tranche rend instable le classement des modèles.
Gardez la normalisation, l’entity linking, le regroupement d’enregistrements et les extrémités de relations séparés du F1 d’extraction. Pour la vie privée, rapportez les instances divulguées et les documents acceptés automatiquement qui sont touchés, les faux masquages et la fraction relue. Pour le serving, rapportez le taux d’achèvement, la latence p50/p95 par document, les exécutions à froid et à chaud, les tailles de batch et de labels, la mémoire de pointe et le coût par document accepté.
Construire un jeu de test de domaine
Pour l’évaluation en production, je recommande :
- Échantillonnez les données de production, pas des exemples soignés. Incluez les documents en désordre que votre modèle verra réellement.
- Dimensionnez le jeu de test à partir d’un pilote. Annotez un pilote d’environ 50 documents, comptez les spans de référence par label et calculez par bootstrap le recall par label. Ajoutez des documents jusqu’à ce que l’intervalle à 95 % du label le plus rare qui vous importe soit plus étroit que la différence que vous voulez détecter.
- Utilisez au moins deux annotateurs sur un sous-ensemble de calibration. Arbitrez les désaccords et rapportez le F1 par span exact entre les spans des deux annotateurs. L’accord montre où les consignes sont ambiguës ; ce n’est pas une limite supérieure de la performance du modèle.
- Stratifiez par difficulté : cas faciles (texte propre, types standard) et cas difficiles (entités ambiguës, jargon, texte bruité).
- Gardez des tranches pour la vie privée et l’équité. Pour les PII, rapportez le recall par type de PII, langue, locale, format de document et tranches démographiques ou d’origine des noms pertinentes. Limitez l’accès des évaluateurs au texte sensible brut, fixez des limites de conservation et révisez les faux négatifs.
La NER continue exige un jeu de régression immuable
Les taxonomies de production évoluent. Ajoutez de nouveaux types sans changer silencieusement le sens d’un ancien type. Gardez un jeu de régression versionné et immuable pour les types existants, un jeu de test distinct pour le nouveau type et un journal des modifications des consignes d’annotation. Rapportez séparément les scores des anciens et des nouveaux types avant de remplacer un checkpoint. C’est le moyen le plus simple de détecter l’oubli et la dérive de la taxonomie.
La NER en production dans quatre secteurs
Chaque domaine extrait des choses différentes et a un point de départ publié différent. La dernière colonne nomme la réserve qui change ce que vous testez en premier.
| Domaine | Ce qui est extrait | Point de départ | Réserve qui change un choix |
|---|---|---|---|
| Santé | Noms, dates, identifiants et autres PHI pour la dé-identification | Les évaluations de John Snow Labs et de Providence ci-dessus ; les modèles ouverts de NER médicale d’OpenMed | Rapportez les instances divulguées et les documents touchés, pas seulement le F1. |
| Finance | Mentions d’entreprises dans l’actualité ; champs des dépôts | L’étude de cas CFM pour l’actualité ; FinBERT-MRC pour les dépôts (92,78 de F1 sur ChFinAnn, 96,80 sur AdminPunish) | Les résultats de FinBERT-MRC portent sur des dépôts chinois ; testez séparément les dépôts SEC en anglais, les longs documents et les entités imbriquées. |
| E-commerce | Type de produit, marque et attributs dans les requêtes de recherche | EAMT de Walmart (environ 60 labels de NER de requêtes) ; TripleLearn de Home Depot (F1 sur jeu mis de côté de 69,5 → 93,3, en production depuis plus de 9 mois) | La méthode de TripleLearn repose sur des tours répétés de supervision du domaine ; l’article ne compare pas les architectures actuelles. |
| Cybersécurité | Logiciels malveillants, acteurs de la menace et indicateurs de compromission | CyNER (76,66 de micro-F1 par span, XLM-RoBERTa-large) ; CyberNER (21 labels STIX 2.1, RoBERTa 0,736 de F1) | Datasets de recherche uniquement ; les jeux de labels diffèrent : mappez-les vers STIX avant de comparer des modèles. |
Optimisation du déploiement : de Python à une inférence à plus faible latence
Une fois qu’un modèle passe le jeu de test du domaine, la question suivante est de savoir comment le servir. Voici l’ordre dans lequel j’essaierais les runtimes, avec une vérification après chaque étape. Ne changez qu’un élément à la fois, pour qu’une baisse de qualité n’ait qu’une seule cause.
- Servez avec PyTorch et Ray Serve.
- Exportez en ONNX FP32, ou exécutez-le avec gline-rs. Si les spans diffèrent de ceux de PyTorch, corrigez l’export.
- Quantifiez en INT8 dynamique, en gardant les projections descendantes du FFN en FP32.
- Ne déployez l’INT8 que si le recall par label reste dans la cible. Sinon, gardez le FP32.
Serving natif de GLiNER
Avant de passer à un nouveau runtime, testez le chemin Ray Serve du projet. gliner[serve] fournit du batching dynamique, un dimensionnement des batchs selon la mémoire, une montée en charge multi-réplicas et un client HTTP. Le batching et les réplicas peuvent améliorer le débit tout en gardant le code du modèle. Le batching ajoute aussi du temps d’attente : mesurez la latence de file d’attente et la latence à chaud avec votre mélange de requêtes.
Export ONNX
GLiNER dispose d’une conversion ONNX native, et des modèles déjà convertis existent sur Hugging Face (onnx-community/gliner_small-v2.1). L’export écrit le graphe, la config et le tokenizer dans un seul répertoire, et la même classe GLiNER le recharge avec le même appel predict_entities :
from gliner import GLiNER

model = GLiNER.from_pretrained("urchade/gliner_medium-v2.1")
model.export_to_onnx("onnx/fp32")

onnx_model = GLiNER.from_pretrained("onnx/fp32", load_onnx_model=True)
entities = onnx_model.predict_entities(text, labels, threshold=0.5)
La comparaison ONNX du dépôt associé exécute PyTorch, ONNX FP32 et ONNX INT8 sur les mêmes entrées et compare leurs spans. Elle demande Python 3.11+ et uv. La commande de données télécharge un shard Few-NERD épinglé et garde ses 32 premières phrases, assez pour vérifier l’export, pas pour classer des modèles. Le quickstart avec --download récupère une fois le checkpoint épinglé :
uv sync --locked --all-extras
# Run once if the pinned model files are not cached:
uv run --all-extras python -m ner_demo.quickstart --download
uv run --all-extras python -m ner_demo.data --split test --limit 32
uv run --all-extras python -m ner_demo.onnx_check \
  --dataset artifacts/few-nerd-test.json --output artifacts/onnx-comparison
Utilisez un nouveau répertoire de sortie, ou --reuse pour vérifier des paquets existants. La commande échoue quand les spans FP32 diffèrent de ceux de PyTorch, ou quand l’INT8 perd plus de 0,02 de recall micro. Sur un CPU Apple M5 Max, l’ONNX FP32 a renvoyé exactement les spans de PyTorch avec une latence p50 de 16 à 19 ms par phrase, contre 64 à 66 ms pour PyTorch.
Quantization INT8
La quantization INT8 dynamique stocke les poids sous forme d’entiers sur 8 bits et réduit la taille du fichier ONNX. Pour l’encodeur DeBERTa de GLiNER, quantifier toutes les couches ne fonctionne pas. Dans le dépôt associé, quantifier toutes les couches MatMul n’a renvoyé aucune entité. Quantifier les couches groupe par groupe a révélé la cause : les douze projections descendantes du FFN (layer.N/output/dense, la seconde couche linéaire du réseau feed-forward de chaque bloc de l’encodeur) suffisent à elles seules à faire passer tous les scores sous le seuil. Garder ces douze couches en FP32 règle le problème. Le code copie le paquet FP32 (pour ses fichiers de config et de tokenizer), puis quantifie tout le reste :
import shutil

import onnx
from onnxruntime.quantization import QuantType, quantize_dynamic

shutil.copytree("onnx/fp32", "onnx/int8")
graph = onnx.load("onnx/fp32/model.onnx", load_external_data=False).graph
keep_fp32 = [n.name for n in graph.node if n.op_type == "MatMul" and "/output/dense/" in n.name and "/attention/" not in n.name]

quantize_dynamic("onnx/fp32/model.onnx", "onnx/int8/model.onnx",
                 weight_type=QuantType.QInt8,
                 op_types_to_quantize=["MatMul", "Gemm", "Gather"],
                 nodes_to_exclude=keep_fp32)
Chargez onnx/int8 avec load_onnx_model=True, comme pour le FP32. La fonction quantize_package du dépôt associé fait la même chose, puis valide le paquet. Sur les 32 phrases de Few-NERD (Apple M5 Max, ONNX Runtime 1.24.4), les résultats mesurés sont :
| Chemin | Paquet | Latence p50 | Précision micro | Recall micro |
|---|---|---|---|---|
| PyTorch | - | 64-66 ms | 0,506 | 0,722 |
| ONNX FP32 | 790 Mo | 16-19 ms | 0,506 | 0,722 |
| ONNX INT8 | 353 Mo | 13-15 ms | 0,487 | 0,722 |
L’INT8 a réduit le paquet de plus de moitié et conservé le recall, mais il a modifié les spans de 4 phrases sur 32 et ajouté 3 faux positifs. Sur cette exécution, l’INT8 vaut le coup quand la mémoire ou la taille du paquet est la limite ; pour la seule latence, l’essentiel du gain est venu de l’export ONNX FP32. Comparez le recall par label au FP32 sur vos propres données avant de le déployer : un fichier plus petit ne dit rien de la qualité d’extraction. Les recommandations actuelles de GLiNER préconisent un entraînement conscient de la quantization quand la précision de l’INT8 doit égaler celle du FP32.
gline-rs : réimplémentation en Rust
gline-rs (Apache 2.0) retire le runtime Python du chemin d’inférence. Le projet rapporte environ quatre fois le débit CPU de Python dans son propre benchmark. Il prend en charge les modèles à spans et à tokens, le GPU/NPU via ONNX Runtime, et il est publié comme crate sur crates.io. Il charge un export ONNX et son tokenizer.json, comme le paquet écrit plus haut ; le README du projet montre l’appel en Rust.
Le paquet fast-gliner fournit des bindings Python via PyO3.
Quel runtime utiliser et quand
| Chemin | À utiliser quand | Preuves disponibles | À mesurer avant le déploiement |
|---|---|---|---|
| Ray Serve natif | Vous voulez garder Python et ajouter batching et réplicas | Documentation du projet GLiNER | Latence de file d’attente, latence à chaud, débit |
| ONNX FP32 | Premier changement de runtime sur n’importe quel matériel | Dépôt associé : mêmes spans que PyTorch, latence 3,4 à 4 fois plus basse | Latence à chaud, débit et F1 par span exact |
| ONNX INT8 | La mémoire ou la taille du paquet est la limite sur CPU | Dépôt associé : 353 Mo contre 790 Mo, même recall, 3 faux positifs en plus | Recall et précision par label par rapport au FP32 |
| gline-rs | Vous devez retirer le runtime Python | Benchmark du projet, avec son matériel et son dispositif documentés | Votre mode de modèle, vos labels, votre matériel et votre batch |
Extraction structurée : schémas natifs, Instructor et décodeurs locaux
Quand vous avez besoin de plus de souplesse que les modèles encodeurs n’en offrent (entités implicites, raisonnement, mapping vers une ontologie), commencez par le mécanisme de schéma natif du fournisseur. OpenAI prend en charge des formats de réponse json_schema stricts, les structured outputs d’Anthropic prennent en charge les sorties JSON et les entrées d’outils strictes, et l’API Gemini prend en charge un sous-ensemble de JSON Schema. Un modèle Pydantic ou Zod partagé peut décrire le contrat, mais chaque fournisseur accepte un sous-ensemble de schéma différent et a un comportement différent face aux refus et à la complexité.
La conformité au schéma rend l’analyse fiable. Elle ne prouve pas qu’un span extrait existe dans le texte source ni qu’une valeur normalisée est correcte. Validez les valeurs des champs, conservez les offsets ou les citations quand c’est possible, et mesurez la justesse sémantique sur un jeu annoté.
Les trois bibliothèques ci-dessous imposent la structure de façons différentes. Le schéma fait passer une même phrase dans chacune : Instructor valide et réessaie, Outlines bloque un label invalide pendant le décodage, et LangExtract renvoie des offsets de caractères pour chaque champ.
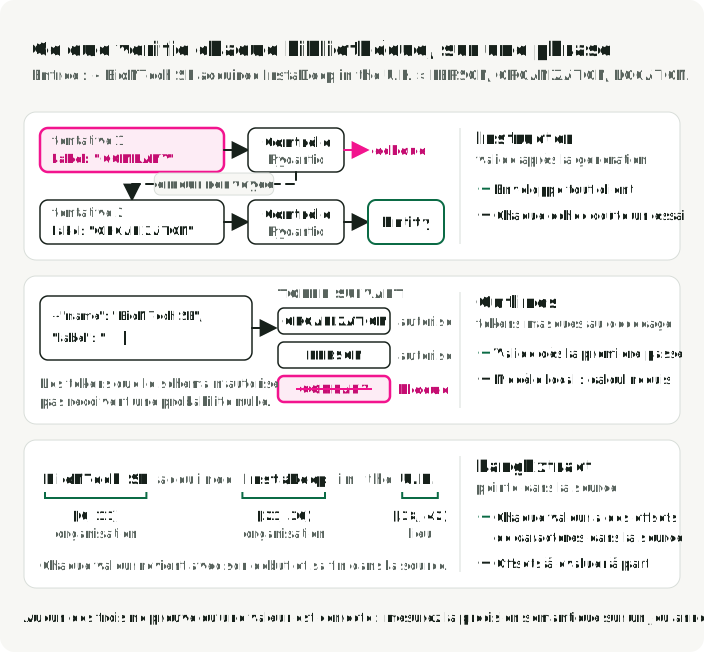
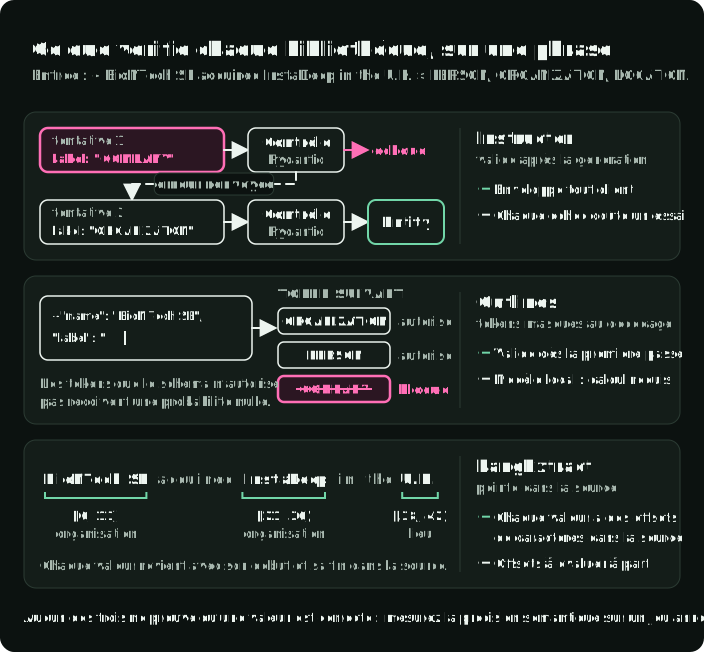
Instructor enveloppe les clients des fournisseurs avec une validation Pydantic et des nouvelles tentatives optionnelles après un échec de validation.
Cet exemple autonome demande pip install instructor openai pydantic, une OPENAI_API_KEY et une requête payante auprès d’un fournisseur. N’importe quel modèle qui prend en charge les structured outputs convient ici ; l’exemple utilise gpt-5.4-mini, le même modèle par défaut que le professeur du dépôt associé.
import instructor
from pydantic import BaseModel
from typing import List, Literal
from openai import OpenAI

class Entity(BaseModel):
    name: str
    label: Literal["PERSON", "ORGANIZATION", "LOCATION"]

class ExtractEntities(BaseModel):
    entities: List[Entity]

client = instructor.from_openai(OpenAI())
result = client.chat.completions.create(
    model="gpt-5.4-mini", reasoning_effort="none",
    response_model=ExtractEntities,
    messages=[{"role": "user", "content": "BioNTech SE acquired InstaDeep in the U.K."}])
# entities=[Entity(name='BioNTech SE', label='ORGANIZATION'), ...]
Outlines de dottxt adopte une approche différente : la génération de tokens contrainte par des automates à états finis. Le décodeur masque les tokens qui violeraient la grammaire cible au lieu d’attendre un échec de validation pour réessayer. Une présentation d’AWS cite 98 % de respect du schéma contre 76 % pour la validation après génération. Elle reprend aussi l’affirmation de .txt Engineering d’une génération jusqu’à 5 fois plus rapide, sans assez de détails de méthode pour comparer les deux chiffres.
Dans Outlines, outlines.from_transformers enveloppe un modèle Hugging Face et son tokenizer. Appeler ce modèle avec un prompt et une classe Pydantic comme ExtractEntities plus haut renvoie un JSON conforme à la classe. Pour une nouvelle comparaison d’extraction auto-hébergée, incluez le Qwen3.8-27B actuel ou les checkpoints Qwen3.5, plus petits. Chargez-les avec leur chargeur de modèle documenté, leur chat template et leur backend de serving ; une architecture multimodale ou un format de raisonnement peut demander plus qu’un nouvel identifiant de modèle.
LangExtract est utile quand un champ généré doit être ancré dans la source : il renvoie des intervalles de caractères et prend en charge des backends LLM hébergés ou locaux. Pour l’extraction de documents auto-hébergée, NuExtract convertit des JSON Schemas en templates et inclut des modèles de documents multimodaux. Ce sont deux systèmes d’extraction structurée, pas des remplaçants directs de la NER par spans : leurs sorties de champs, d’offsets et de mise en page demandent leurs propres scores.
Le choix dépend de l’endroit où vous exécutez vos modèles. Les schémas natifs sont le chemin le plus simple pour un fournisseur pris en charge. Instructor ajoute une couche de validation Pydantic et de nouvelles tentatives indépendante du fournisseur. Outlines contraint la génération locale selon un schéma. LangExtract privilégie l’ancrage dans la source, tandis que NuExtract vise l’extraction de documents auto-hébergée. Tous les chemins par LLM impliquent une génération autorégressive : ils prennent donc généralement plus de temps par document qu’un encodeur sur le même matériel.
L’architecture de production à trois niveaux
Je répartirais la NER en production selon la forme de la tâche plutôt que selon un classement unique des modèles. Chaque ligne du schéma montre un exemple de requête, ce qui revient, et les modèles à tester. Les cas révisés du niveau 3 ne retournent au niveau 1 que sous forme de spans trouvés dans la source.
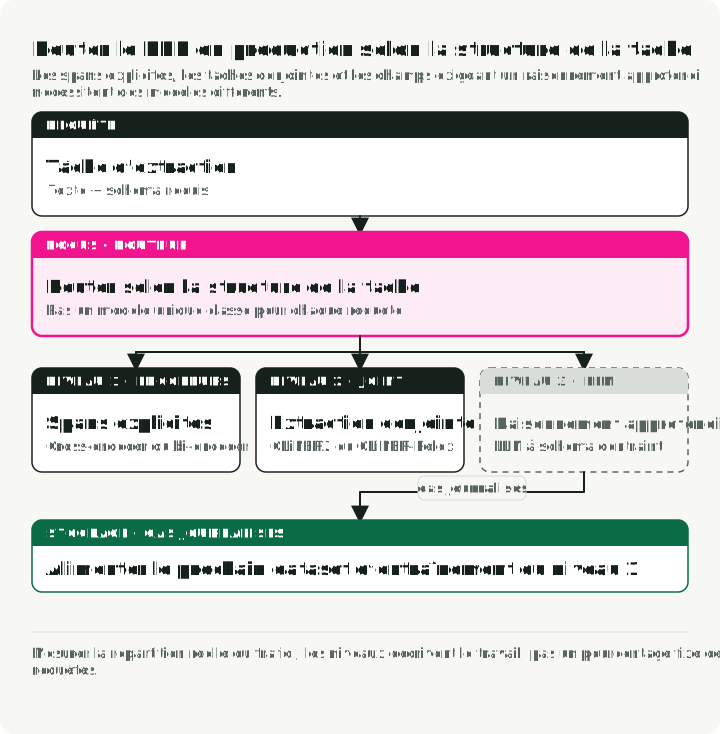
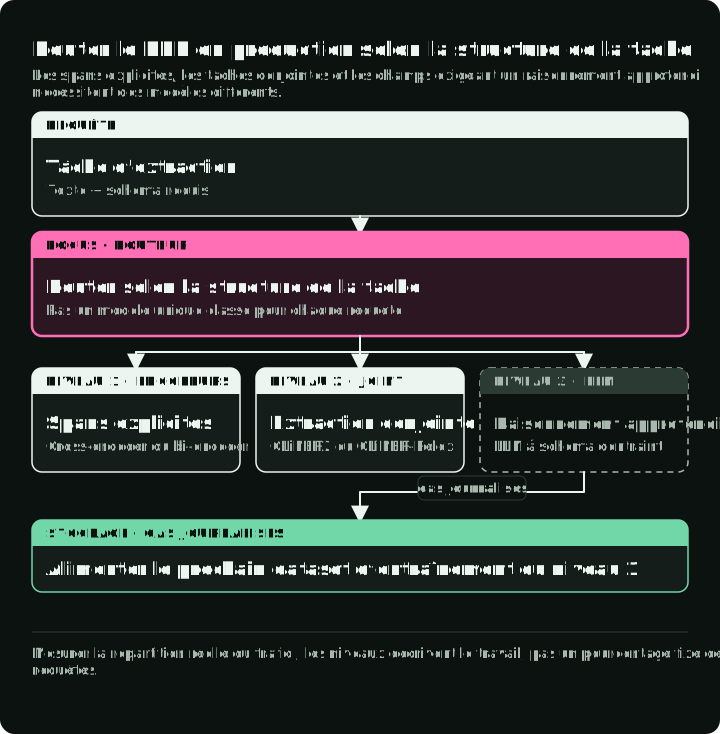
Niveau 1 : modèles encodeurs pour les spans explicites. Utilisez un cross-encodeur GLiNER pour un petit inventaire de types. Quand un grand inventaire est réutilisé, comparez le bi-encodeur avec des embeddings de types en cache. Faites le fine-tuning via le pipeline LLM-as-teacher, puis déployez avec le serving natif, ONNX, INT8 ou gline-rs seulement si ce chemin passe le benchmark du domaine.
Niveau 2 : extraction multi-tâche ou de relations. Quand une requête demande à la fois de la NER, de la classification et des champs hiérarchiques, testez le checkpoint actuel GLiNER2.5 de 194M paramètres face à des baselines séparées par tâche. Quand l’exigence centrale est d’obtenir ensemble spans et relations, testez GLiNER-Relex. L’article GLiNER2 rapporte une latence de classification sur CPU de 130 à 208 ms sur les nombres de labels testés ; il n’a pas mesuré l’API de relations ajoutée ensuite.
Niveau 3 : LLMs pour l’extraction qui demande du raisonnement. Envoyez les entités implicites, l’inférence contextuelle et le mapping vers une ontologie à une API de schéma native ou à Instructor pour les API cloud, et à Outlines pour une sortie contrainte en local. Utilisez LangExtract quand les intervalles dans la source sont essentiels, et NuExtract quand l’entrée est le document lui-même. Journalisez ces cas pour les réviser. Seuls les spans explicites alignés sur la source peuvent devenir des cibles d’entraînement ordinaires du niveau 1 ; les faits inférés et les valeurs normalisées ont besoin de leurs propres cibles et de leur propre évaluation.
L’étude de cas CFM donne une référence de coût pour le niveau 1 : 93,4 % de F1 pour un coût rapporté de $0,10 par heure sur CPU, contre 92,7 % de F1 et $8 par heure pour son professeur Llama-70B. Les prix horaires des instances ne déterminent pas le coût par document sans le débit. Recalculez avec votre matériel, votre modèle professeur, votre jeu de labels, votre taux d’utilisation et le coût de révision.
Compromis et limites
Les erreurs du LLM-as-teacher se propagent. Si le LLM se trompe systématiquement sur un type d’entité précis (par exemple en confondant des noms de filiales avec ceux de maisons mères), l’encodeur fine-tuné hérite de ce biais. Révisez en profondeur les types peu fiables ou incohérents, et gardez un échantillon aléatoire stratifié pour attraper les erreurs systématiques sûres d’elles.
Un schéma valide peut contenir de faux faits. Les structured outputs natifs, Instructor et les décodeurs contraints peuvent rendre une réponse analysable. Ils ne peuvent pas garantir que chaque champ est ancré dans la source, qu’une borne de span est correcte ou qu’une valeur normalisée correspond au bon enregistrement. Conservez les preuves de la source et validez la sémantique séparément.
Les pertes dues à la quantization dépendent du checkpoint et des couches quantifiées. Quantifier toutes les couches MatMul du GLiNER du dépôt associé n’a renvoyé aucune entité ; garder les projections descendantes du FFN en FP32 a conservé le recall sur sa vérification de 32 phrases. Un autre checkpoint peut avoir d’autres couches sensibles. Comparez les modèles quantifié et d’origine sur le F1 par span exact et le recall par label avant le déploiement.
Quand l’architecture à trois niveaux est excessive. Un seul domaine avec des types d’entités stables et assez d’exemples annotés peut se contenter d’un RoBERTa fine-tuné ou d’un pipeline spaCy. Le pattern à trois niveaux convient à plusieurs domaines, à des types d’entités qui évoluent ou à un mélange mesuré d’extraction explicite et d’extraction qui demande du raisonnement. Un pipeline de factures étroit qui extrait des noms et des dates peut s’arrêter au niveau 1.
La qualité du bi-encoder varie selon le dataset et la taille du checkpoint. Sur CoNLL-2003, gliner_small-v2.5 obtient 65,4 % de F1, au-dessus des bi-encoders edge/small à 61,6 %/64,2 %, mais en dessous de bi-base/large à 65,6 %/66,5 % (Stepanov et al., 2026, tableaux 2–3). Choisissez selon la qualité exact-span mesurée, la calibration, le nombre de labels et le throughput sur votre jeu de domaine.
Les affirmations sur les PII et le multilingue exigent des tranches. Un score agrégé élevé peut masquer une perte de recall dangereuse pour une locale, une forme de nom, une mise en page de document ou une classe rare de PII. Utilisez un modèle de protection de la vie privée comme un contrôle parmi plusieurs, mettez en place un processus de réponse aux faux négatifs et réévaluez quand la taxonomie, le mélange de langues ou la source de données change.
Points clés
- N’utilisez un encodeur compact pour les spans explicites qu’après avoir vérifié qu’il passe un jeu de test du domaine, avec le support par type et des intervalles de confiance.
- Utilisez GLiNER pour des vocabulaires de labels changeants. Comparez d’abord son bi-encodeur quand un grand inventaire de types est réutilisé ; n’activez
flat_ner=Falsequ’après avoir vérifié que le checkpoint trouve les spans internes. - Utilisez spaCy ou un classifieur de tokens fine-tuné quand les labels sont stables et que vous avez des données d’entraînement.
- Utilisez des descriptions de types testées pour les affirmations zero-shot strictes, et testez séparément la formulation des labels en anglais et en langue locale pour les produits multilingues.
- Gardez l’OCR, la NER, l’extraction de relations et l’entity linking comme des étapes d’évaluation distinctes, même quand un seul modèle expose plusieurs tâches.
- Traitez un LLM professeur comme un système de propositions d’annotation. Les consignes humaines, l’arbitrage, les jeux de régression immuables et un jeu de test mis de côté restent nécessaires.
- Utilisez les schémas natifs pour les fournisseurs de LLM pris en charge, mais validez séparément la justesse sémantique et l’ancrage dans la source, à part de la validité du JSON.
- Ne changez qu’une étape du runtime à la fois : d’abord ONNX FP32, puis INT8 en gardant les couches sensibles en FP32, avec une comparaison des spans après chaque étape.
Références
Articles
- GLiNER: Generalist Model for Named Entity Recognition using Bidirectional Transformer - Zaratiana et al., NAACL 2024. L’architecture fondatrice de mise en correspondance span-entité.
- GLiNER2: An Efficient Multi-Task Information Extraction System with Schema-Driven Interface - Zaratiana et al., EMNLP 2025 System Demonstrations. Unifie la NER, la classification et l’extraction hiérarchique ; les versions actuelles ont ensuite ajouté l’extraction de relations.
- GLiNER Bi-Encoder: Scalable Named Entity Recognition with Bi-Encoder Architecture - Stepanov et al., février 2026. Encodage découplé pour une échelle d’un million de labels.
- GLiNER-Relex: A Unified Framework for Joint Named Entity Recognition and Relation Extraction - Stepanov et al., 2026. Extraction conjointe et zero-shot d’entités et de relations.
- GLiNER2-PII: A Multilingual Model for Personally Identifiable Information Extraction - Zaratiana et al., 2026. 42 types de PII à la résolution du caractère.
- ZeroNER: Fueling Zero-Shot Named Entity Recognition via Entity Type Descriptions - Cocchieri et al., ACL 2025. Évaluation zero-shot stricte avec descriptions de types.
- OpenNER 1.0: Standardized Open-Access Named Entity Recognition Datasets in 50+ Languages - Palen-Michel et al., EMNLP 2025. 36 corpus, 52 langues et baselines multi-ontologies.
- FiNERweb: Datasets and Artifacts for Scalable Multilingual Named Entity Recognition - Golde et al., EACL 2026. Labels multilingues et évaluation du transfert.
- UniversalNER: Targeted Distillation from Large Language Models for Open Named Entity Recognition - Zhou et al., ICLR 2024. NER universelle fondée sur un LLM par distillation de ChatGPT.
- NuNER: Entity Recognition Encoder Pre-training via LLM-Annotated Data - Bogdanov et al., EMNLP 2024. Étudie un encodeur de 125M pré-entraîné sur des annotations de LLM.
Articles issus de l’industrie
- EAMT: Entity-Aware Multi-Task Learning for Query Understanding - Walmart, KDD 2023. Compréhension multi-tâche des requêtes avec environ 60 labels de NER.
- TripleLearn: End-to-End NER for E-Commerce Search - Home Depot, AAAI 2021. F1 de 69,5 à 93,3.
- CyNER: A Python Library for Cybersecurity Named Entity Recognition - Reconnaissance neuronale combinée à d’autres sources d’extraction.
- CyberNER: A Harmonized STIX Corpus for Cybersecurity NER - 21 types d’entités alignés sur STIX 2.1.
- FinBERT-MRC: Financial NER via Machine Reading Comprehension - Formulation MRC évaluée sur des datasets financiers chinois.
Études de cas
- CFM Case Study: Fine-tuning GLiNER for Financial NER - Le pipeline d’annotation par LLM à $70 de Capital Fund Management, qui atteint 93,4 % de F1.
- Refuel AI: LLM Labeling Technical Report - GPT-4 atteint 88,4 % d’accord d’annotation, au-dessus des annotateurs humains.
- Sease: GLiNER as an Alternative to LLMs for Query Parsing - Là où GLiNER échoue et où les LLMs restent nécessaires.
- John Snow Labs: Medical Text De-Identification Benchmark - Étude d’un éditeur avec remappage et exclusions de labels.
- OpenMed: Year in Review 2025 - Modèles ouverts de NER médicale ; rétrospective de janvier 2026.
Outils et frameworks
- ner-field-guide demo repo - Code associé à cet article : calcul exact des scores par span, exemples GLiNER, conversion d’annotations révisées, vérifications ONNX en FP32 et en INT8, et démo de PII en streaming.
- GLiNER - Bibliothèque, script d’entraînement et chemin Ray Serve avec batching dynamique et déploiement multi-réplicas.
- gline-rs: Rust reimplementation of GLiNER - Inférence en Rust sur des fichiers ONNX de GLiNER ; code Apache 2.0.
- spaCy English pipelines - Métriques versionnées des pipelines à labels fermés.
- dslim/bert-base-NER - Classifieur de tokens BERT fine-tuné sur CoNLL-2003.
- Microsoft Presidio - Analyse et anonymisation des PII avec reconnaisseurs personnalisés.
- Instructor - Extraction structurée par LLM via des modèles Pydantic.
- Outlines - Génération de tokens contrainte par automates à états finis, avec un benchmark de respect du schéma rapporté.
- LangExtract - Extraction structurée ancrée dans la source, avec intervalles de caractères.
- NuExtract - Extraction de documents auto-hébergée, du schéma vers le template.
- OpenAI Structured Outputs - Référence du format de réponse strict par JSON Schema.
- Anthropic Structured Outputs - Sorties JSON et entrées d’outils strictes.
- Gemini Structured Outputs - Sous-ensemble de JSON Schema pour les réponses structurées.
- ONNX Runtime quantization - Référence de la quantization INT8 dynamique et statique.
- AWS: Structured Output with Outlines - Benchmark de 98 % de respect du schéma.