NER-gids 2026: GLiNER, spaCy, Transformers en LLMs

Automatische vertaling
Dit artikel is automatisch vertaald vanuit de oorspronkelijke Engelse versie.
Deze gids is bedoeld voor engineers die named entity recognition (NER) kiezen voor retrieval-, privacy- of documentverwerkingspipelines. Hij legt uit hoe je kiest tussen span recognizers en gestructureerde LLM-extractie, hoe je hun fouten evalueert en hoe je deploymentopties toetst aan de latency en kosten die je workload toelaat.
NER zet tekst om in gelabelde stukken die een programma kan gebruiken. Bij “Bill Gates founded Microsoft on April 4, 1975” kan het de aaneengesloten tekstspans Bill Gates, Microsoft en April 4, 1975 teruggeven, met de types person, organization en date. In een span-based encoder zoals GLiNER leest het model de tekst één keer en scoort het kandidaatspans tegen de labels die je meegeeft.
Voor een retrieval- of privacypipeline vraag ik eerst of de output een letterlijke vermelding moet zijn. Die keuze scheidt een span recognizer van systemen die ook waarden normaliseren, records koppelen of feiten afleiden. LLMs blijven nuttig om trainingsannotaties voor te stellen en om gevallen te verwerken die inference of normalisatie vragen.
Companion-repo: ner-field-guide bevat exacte span-scoring, GLiNER-voorbeelden, de conversie van gereviewde annotaties, ONNX FP32- en INT8-controles en een streaming PII-demo.
Voor de korte modelvergelijking, zie Best NER Models in 2026.
Wat is named entity recognition?
Named entity recognition vindt spans in tekst en wijst er types aan toe, zoals person, organization, date, product of domeinspecifieke labels. Een span is een aaneengesloten stuk van de oorspronkelijke tekst. NER identificeert de vermelding; entity linking is de aparte stap die de vermelding koppelt aan een canoniek record of ontologieconcept.
| Workload | Eerste model om te testen | Stap op wanneer |
|---|---|---|
| ID’s of gecontroleerde woordenlijsten | Regels of spaCy EntityRuler | Recall buiten bekende patronen belangrijk is. |
| Stabiele labels en veel trainingsdata | spaCy of een fine-tuned encoder | De labelset verandert of de recall stagneert bij zeldzame types. |
| Wisselende labels; kleine typeset | GLiNER cross-encoder | De typeset groeit of labels worden over veel documenten hergebruikt. |
| Grote, herbruikbare typeset | GLiNER bi-encoder | De domeinset een kwaliteits- of calibration-regressie toont. |
| Meerdere extractietaken in één tekstpipeline | GLiNER2.5 | De kwaliteit van de gezamenlijke taken het doel per taak mist. |
| Impliciete feiten of schema-reasoning | Gestructureerde LLM-extractie | Latency, kosten of onondersteunde claims het productbudget overschrijden. |
Een GLiNER cross-encoder leest de labelnamen en de tekst samen, dus elk document encodeert elk label opnieuw. Een bi-encoder encodeert labels apart en kan ze cachen. GLiNER2.5 is een aparte modelfamilie die entities, klassen, relaties en gestructureerde velden uit één schema haalt. Elk krijgt hieronder een eigen sectie.
De eerste treffer wint als je deze lijst afloopt, in de volgorde waarin ik de vragen zou stellen:
- De output is geen letterlijke span: gebruik gestructureerde LLM-output.
- ID’s of een vaste woordenlijst: gebruik regels of een EntityRuler.
- Vaste labels en genoeg trainingsdata: gebruik spaCy of BERT-NER.
- Een grote labelset die over documenten heen wordt hergebruikt: gebruik de GLiNER bi-encoder.
- Anders: gebruik de GLiNER cross-encoder en probeer GLiNER2.5 als je meerdere taken in één pass nodig hebt.
Waar moderne systemen NER gebruiken
NER vindt nog steeds tekstspans en wijst er labels aan toe. Wat veranderd is, is de plaats in het systeem. Het levert nu filters voor RAG, gestructureerde argumenten voor agent tools en velden voor documentverwerkingspipelines. Door die toepassingen zijn latency, kosten en schemaflexibiliteit net zo belangrijk als benchmarknauwkeurigheid.
RAG: betere retrieval dankzij entity extraction
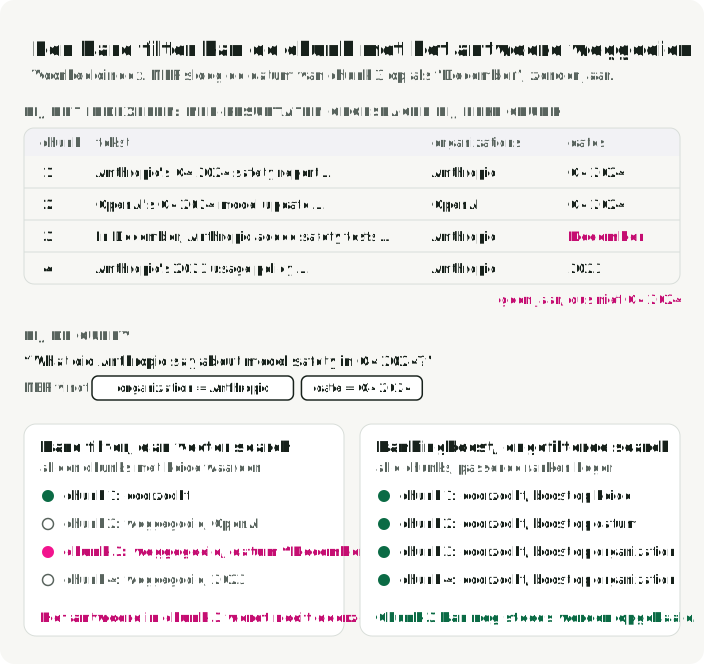
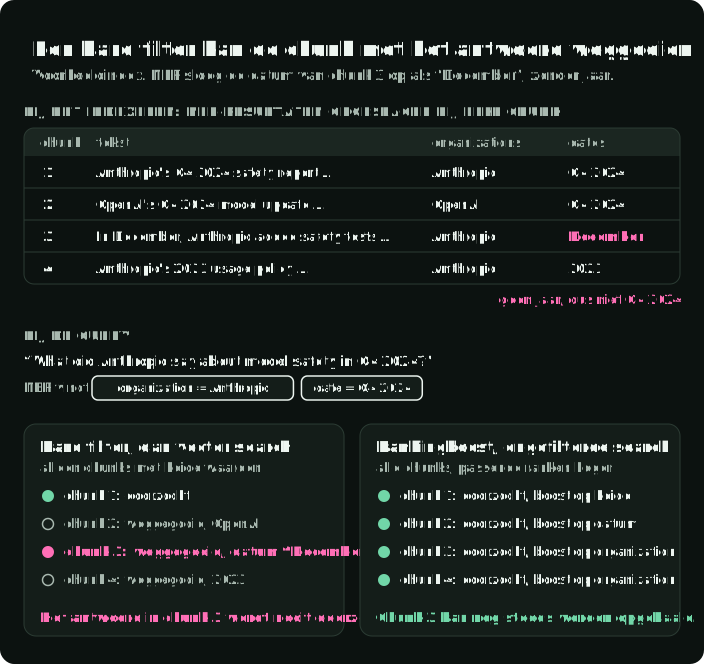
Similarity search alleen schiet tekort wanneer een vraag exacte entities bevat. Bij “what did Anthropic say about model safety in Q4 2024?” kan entity extraction “Anthropic” en “Q4 2024” voorstellen als filters. Pas alleen een hard filter toe als de geïndexeerde metadata en de datumsemantiek dat ondersteunen; gebruik het anders als rankingsignaal of behoud een ongefilterd retrievalpad. Een gemiste alias of een verkeerd afgeleid datumbereik kan het antwoord uitsluiten.
Tijdens het indexeren haal je entities uit elke chunk en sla je ze op als metadata: {"organizations": ["Anthropic"], "dates": ["Q4 2024"], ...}. Zo kun je op entity filteren voordat je vector search uitvoert. Knowledge graph RAG (GraphRAG, LlamaIndex property graphs) voegt benoemde relaties toe die retrieval over meerdere hops kan volgen.
Het diagram werkt een voorbeeldindex van vier chunks door. Vergelijk de twee panelen onderaan: het harde filter doorzoekt de chunk waarvan de opgeslagen datum geen jaar heeft nooit, terwijl de rankingboost die chunk wel doorzoekt.
Bij een query sturen de entities uit de vraag van de gebruiker de routing aan. Een vraag met een bedrijfsnaam gaat naar een financiële index; een vraag met geneesmiddelnamen gaat naar een klinische knowledge base. GLiNER is nuttig wanneer het schema of de entity types tijdens de query wisselen. Onbekende bedrijfs- of geneesmiddelnamen alleen vereisen geen open-vocabulary labels; een closed-label model kan nieuwe vermeldingen van bekende types nog steeds herkennen.
AI agents: tekst omzetten in gestructureerde feiten
Agents ontvangen ongestructureerde tekst, zoals webpagina’s, API-responses en gebruikersberichten. NER zet die tekst om in gestructureerde feiten waarover de agent kan redeneren, die hij kan opslaan of aan tools kan doorgeven.
Voor tool-routing kan een verzoek als “schedule a meeting with Sarah Chen from Accenture on Thursday at 2pm” PERSON: Sarah Chen, ORGANIZATION: Accenture, DATE: Thursday en TIME: 2pm opleveren. Een agenda-resolver combineert datum en tijd daarna tot de timestamp die de API vereist. Een lokale encoder bespaart de API-roundtrip, maar de latency hangt af van het model, de runtime, de hardware, de batchgrootte en het aantal labels.
NER ondersteunt ook entity tracking over gesprekken heen. Systemen voor agent memory moeten weten dat “Sarah” in beurt 3 en “Ms. Chen” in beurt 12 dezelfde persoon zijn. NER identificeert de spans; coreference resolution bepaalt of de vermeldingen in de context naar dezelfde persoon verwijzen. Entity linking koppelt die persoon vervolgens aan een canoniek record, als dat bestaat.
De beperking is in beide gevallen latency. Als elk van tien opeenvolgende stappen een NER-aanroep van 200 ms doet, leveren die aanroepen samen 2 seconden merkbare vertraging op. Eén aanroep kost 200 ms. Encoder-models passen doorgaans beter voor entity-werk binnen agent loops dan extractie met een LLM.
Document intelligence: van afbeeldingen naar gestructureerde data
OCR zet afbeeldingen om in tekst. NER zet die tekst om in gestructureerde velden.
Een standaardpipeline gebruikt eerst OCR, zoals Tesseract, Azure Document Intelligence of AWS Textract, om tekst en bounding boxes te maken. NER vindt daarna spans voor velden als invoice_number, vendor_name, total en due_date. Een schema- of relation-extraction-stap moet omschrijvingen, aantallen en prijzen van factuurregels groeperen in line_items. Dezelfde volgorde geldt voor contracten, medische dossiers en documenten voor toezichthouders.
Elke stap heeft een eigen score. Een OCR-fout die een cijfer weglaat, lijkt een NER-misser als je alleen het eindrecord scoort.
| Stap | Wat het oplevert | Score |
|---|---|---|
| OCR en layout | Tekst, leesvolgorde, boxes | Character error rate |
| NER | invoice_number, vendor_name, total | Exact-span F1 |
| Groepering | Factuurregels (omschrijving, aantal, prijs per rij) | Record-F1 |
| Linking en normalisatie | Vendor-ID, ISO-datums, bedragen | Linking- of normalisatienauwkeurigheid |
Moderne documentpipelines kunnen layoutbegrip, entity extraction en relation extraction combineren. OCR of een layout-aware documentmodel levert nog steeds tekst, leesvolgorde, tabellen en bounding boxes. Het huidige GLiNER2.5 biedt entities, relaties, classificatie en gestructureerde records via één schema-interface; score elke output apart.
Kosten bepalen de meeste van deze pipelines. Prijs de jouwe op het werkelijke maandvolume aan documenten, inclusief retries en review. Een compacte encoder kan op CPU draaien, terwijl een LLM via een API inferencekosten en latency per document toevoegt. Een praktische test is om een representatieve set facturen met een LLM te labelen. Fine-tune GLiNER op de gereviewde records en vergelijk beide paden op F1 per veld, latency en totale kosten.
PII-detectie en LLM-guardrails
Privacywetten zoals de GDPR, HIPAA en CCPA vereisen waarborgen voor persoonsgegevens, maar schrijven geen NER voor. NER kan persoonsgegevens vinden voor maskering of minimalisatie; de recall moet op jouw data worden gecontroleerd voordat het als beheersmaatregel telt.
De-identificatiemodels vinden spans voor PERSON, SSN, PHONE, EMAIL en ADDRESS en maskeren ze of vervangen ze door synthetische equivalenten. Microsoft Presidio combineert recognizers met anonimiseringsoperators, en zijn voorbeelden bevatten GLiNER als recognizer. Het GLiNER2-PII-model met 0,3B parameters is een andere kandidaat: het paper beslaat 42 PII-types op karakterspan-resolutie.
In de door de leverancier uitgevoerde vergelijking van John Snow Labs dekken 48 door experts geannoteerde documenten zes PHI-klassen. Labels van providers zijn opnieuw gemapt en niet-mapbare voorspellingen zijn uitgesloten, wat de interpretatie tussen providers beperkt. Het Providence-rapport beschrijft 281 gelekte PHI-gebeurtenissen in een review van 1.000 notities met 34.701 zinnen. Gebeurtenissen zijn niet hetzelfde als afzonderlijke getroffen zinnen: tel in een privacy-evaluatie zowel gelekte instanties als getroffen documenten.
Voor LLM-guardrails werkt NER als prescreeninglaag: scan gebruikersinput op PII voordat je die naar een externe API stuurt, en blokkeer of anonimiseer daarna.
Een lokale detector kan sneller zijn dan de LLM zichzelf laten modereren, maar false negatives blijven mogelijk, dus voeg een extra controle toe voor de PII-blootstelling die je systeem niet kan accepteren. GLiNER is hier nuttig omdat PII-categorieën per rechtsgebied verschillen. Een API kan een nieuw label als “genetic information” accepteren zonder retraining. De recall voor dat nieuwe label is onbekend totdat je die op gereviewde voorbeelden controleert.
GLiNER: span-to-label matching voor open-vocabulary NER
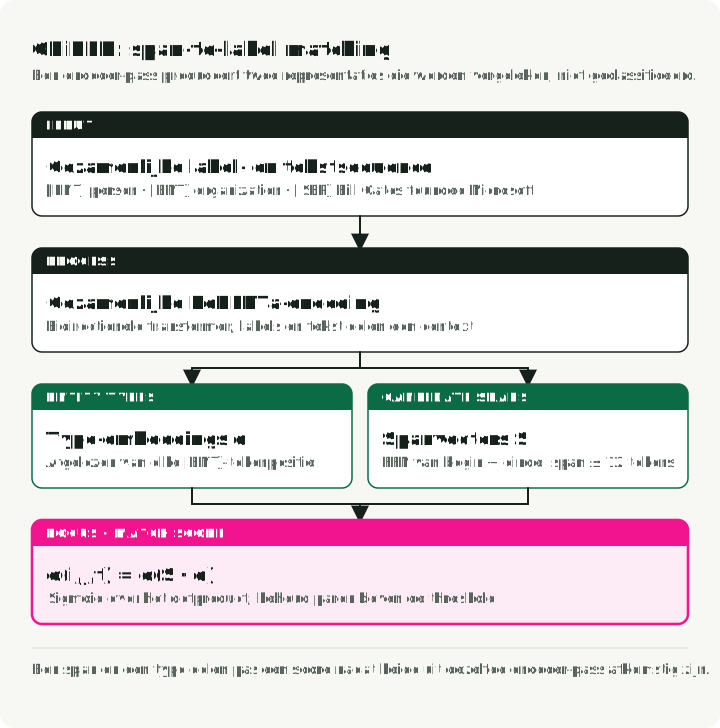
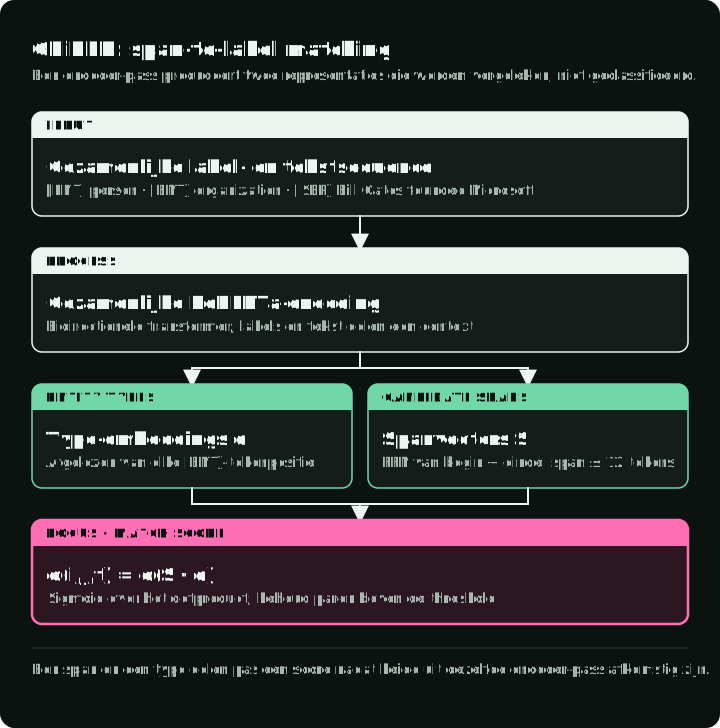
GLiNER (NAACL 2024, Zaratiana et al.) maakte encoder-based NER concurrerend met LLMs tegen een fractie van de kosten. In plaats van NER te behandelen als sequence labeling of tekstgeneratie, behandelt GLiNER het als een matching-probleem. Het scoort elke kandidaatspan (elke aaneengesloten reeks woorden, zoals “Bill Gates” of “Microsoft”) tegen elk entity-type-label en behoudt de paren met een hoge score.
Het model neemt entity-type-labels en invoertekst als één sequentie: [ENT] person [ENT] organization [ENT] date [SEP] Bill Gates founded Microsoft.... Een bidirectionele transformer (DeBERTa-v3) encodeert alles samen.
Uit de output bouwt het model twee sets representaties. De ene verfijnt elke entity-type-representatie vanaf een [ENT]-tokenpositie via een klein feed-forward network (FFN) dat de vector van de encoder transformeert. De andere representeert tekstspans door de vectoren van het eerste en laatste woord via een ander FFN te combineren. Een dot product tussen een spanrepresentatie en een entity-type-representatie levert een score op.
Pas sigmoid toe en je krijgt de kans dat de span van woordpositie tot woordpositie tot entity type behoort: . Hier is de spanvector die het FFN produceert en de door het FFN verfijnde entity-type-embedding van de bijbehorende [ENT]-token (Zaratiana et al., 2024, vergelijkingen 1–2). Kandidaatspans zijn beperkt tot 12 woorden; de tokenizer kan een woord in meerdere subword-tokens splitsen.
GLiNER accepteert tijdens inference labelbeschrijvingen in natuurlijke taal zonder retraining, maar de extractiekwaliteit hangt af van de formulering van het label en de pasvorm met het domein. Je geeft entity types door, zoals “person”, “adverse drug reaction” of “financial instrument”, en het model scoort spans daartegen. De configuraties van 50M, 90M en 300M hieronder zijn de oorspronkelijke paper-models. De v2.1 model card noemt in plaats daarvan Engelse checkpoints van 166M, 209M en 459M, plus een meertalig checkpoint van 209M, allemaal onder Apache 2.0. Vergelijk latency of geheugengebruik niet tussen die generaties alsof de parameternamen identiek waren (GLiNER v2.1 model card).
Houd voor een echte hard zero-shot test zowel de doeltypes als de doelvoorbeelden apart: het model heeft geen gelabelde voorbeelden voor de doeltaak. Een typebeschrijving als “a medically confirmed adverse effect caused by a treatment” geeft het model meer informatie dan adverse event alleen. Dat garandeert geen transfer, maar op benchmarks met held-out types presteerde description-driven ZeroNER beter dan baselines die alleen de naam gebruikten (Cocchieri et al., 2025).
De trainingsdata voor het oorspronkelijke model kwam uit de Pile-NER-dataset: 44.889 passages met 240K entity spans over 13K entity types, allemaal gelabeld door ChatGPT. Het trainen van GLiNER-L duurde ongeveer 5 uur op één A100 (Zaratiana et al., 2024).
Benchmarkresultaten
Zero-shotresultaten uit Zaratiana et al. (2024), tabellen 1 en 2. F1 combineert precision en recall in één score; een hogere score is alleen beter onder dezelfde taak en evaluatieregels. Het gemiddelde over zeven datasets combineert vijf CrossNER-datasets met MIT Movie en MIT Restaurant:
| Model | Params | Gem. F1 (CrossNER + MIT) | Gem. F1 (20 datasets) |
|---|---|---|---|
| GLiNER-L | 300M | 60.9% | 47.8% |
| GoLLIE | 7B | 58.0% | — |
| UniNER-13B | 13B | 55.6% | — |
| GLiNER-M | 90M | 55.4% | — |
| UniNER-7B | 7B | 53.7% | 45.7% |
| GLiNER-S | 50M | 52.7% | — |
| ChatGPT (GPT-3.5) | — | 47.5% | 36.5% |
GLiNER-M met 90M parameters evenaart UniNER-13B bijna in het gemiddelde over zeven datasets van het paper (55.4% tegenover 55.6% F1), terwijl het ongeveer 140 keer minder parameters gebruikt. De 50M-variant GLiNER-S overtreft het gerapporteerde ChatGPT-resultaat (GPT-3.5) met 5 F1-punten. De meertalige variant, alleen op Engelse data getraind, overtreft diezelfde ChatGPT-baseline in 8 van de 10 niet-Engelse talen (Zaratiana et al., 2024). Deze vergelijkingen gebruiken de modelversies en de evaluatieharness van het paper; ze zeggen niets over nieuwere LLMs.
Een minimale GLiNER-aanroep
Neem voor een nieuwe cross-encodervergelijking de onderhouden GLiNER v2.5-checkpoints naast v2.1 mee. In de controle van de companion op 32 zinnen uit Few-NERD, een openbare NER-dataset, vond gliner_small-v2.5 44 van de 54 gold spans en gliner_medium-v2.1 er 39. Die steekproef is te klein om de twee te rangschikken, maar het is een reden om v2.5 in je eigen run op te nemen. GLiNER v2.5 en Fastino GLiNER2.5 (hieronder) zijn verschillende modelfamilies.
De aanroep hieronder laadt het v2.1 medium-checkpoint en print elke span met zijn score. De versie van de companion is ner_demo/quickstart.py.
from gliner import GLiNER

model = GLiNER.from_pretrained("urchade/gliner_medium-v2.1")
text = "Bill Gates founded Microsoft on April 4, 1975."
labels = ["person", "organization", "date"]
entities = model.predict_entities(text, labels, threshold=0.5)

for entity in entities:
    print(f"{entity['text']} => {entity['label']} ({entity['score']:.3f})")
# Bill Gates => person (0.994)
# Microsoft => organization (0.973)
# April 4, 1975 => date (0.951)De bi-encoder: opschalen naar NER met miljoenen labels
De oorspronkelijke GLiNER encodeert labels en tekst samen. Gezamenlijk encoderen wordt steeds duurder naarmate labeltekst meer van de context in beslag neemt en bij elk document opnieuw moet worden geëncodeerd. Het kantelpunt hangt af van het checkpoint, de labelbeschrijvingen en de hardware. Wanneer dezelfde grote typeset over veel documenten wordt hergebruikt, maak je van de GLiNER bi-encoder de standaardvergelijking. Die splitst tekst- en labelencoding over twee aparte transformers (Stepanov et al., 2026).
De figuur vergelijkt de twee ontwerpen over drie documenten. In de cross-encoder-baan gaan alle labels bij elk document de encoder in. In de bi-encoder-baan draait een label-encoder één keer, worden de vectoren gecachet en draait per document alleen de tekst-encoder. De grafiek eronder toont de throughput-kosten bij 1.024 labels.
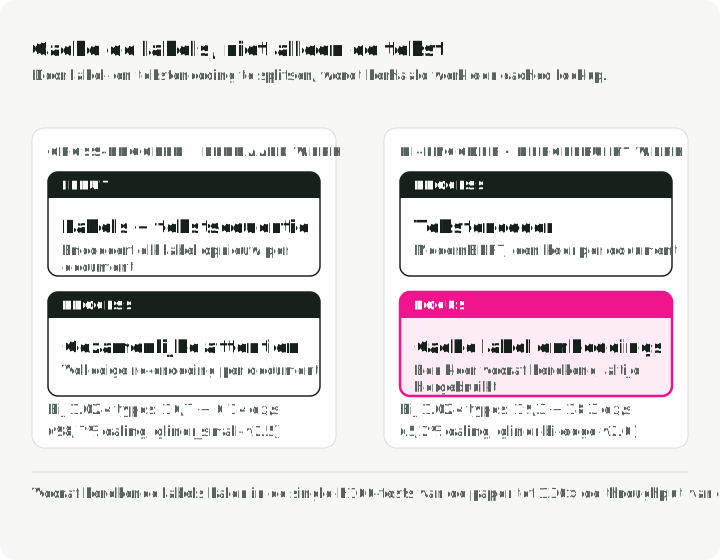
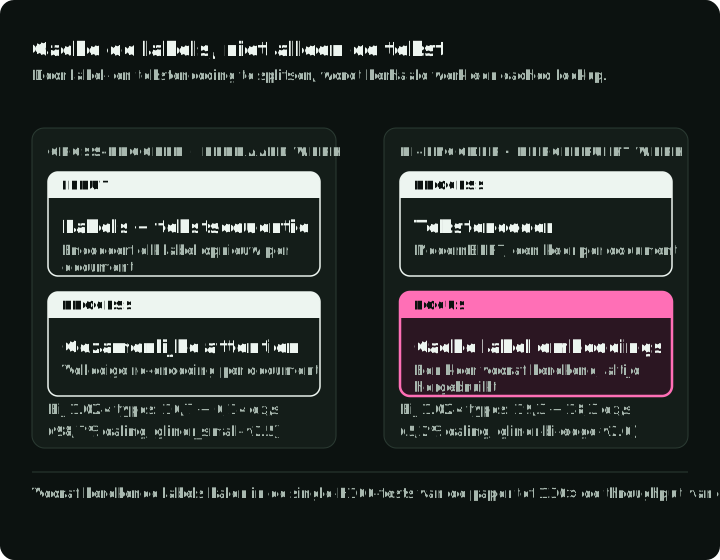
De tekst-encoder gebruikt ModernBERT (Ettin-familie), de label-encoder gebruikt sentence transformers (BGE of MiniLM). Spans en labels worden gescoord via een dot product. Door die splitsing kunnen entity-type-embeddings eenmalig vooraf worden berekend en gecachet. Bij inference voorkomen gecachete labels herhaald encoderen van labels. Het scoren van kandidaatspans tegen die labels kost nog steeds rekenkracht en geheugen; een toepassing met een miljoen labels heeft ook begrensde kandidaatselectie of batching nodig, met gemeten recall voor labels die vóór het scoren zijn uitgesloten.
Er zijn vier modelgroottes beschikbaar, allemaal gebenchmarkt op CrossNER (Stepanov et al., 2026, tabel 1):
| Model | Parameters | Gem. F1 (CrossNER + MIT) | Throughput (H100) | Met vooraf berekende labels |
|---|---|---|---|---|
| gliner-bi-edge-v2.0 | 60M | 54.0% | 13.64 ex/s | 24.62 ex/s |
| gliner-bi-small-v2.0 | 108M | 57.2% | 7.99 ex/s | 15.22 ex/s |
| gliner-bi-base-v2.0 | 194M | 60.3% | 5.91 ex/s | 9.51 ex/s |
| gliner-bi-large-v2.0 | 530M | 61.5% | 2.68 ex/s | 3.60 ex/s |
Bij 1.024 entity types verliest de bi-encoder gliner-bi-edge-v2.0 met vooraf berekende labels slechts 5,2% throughput ten opzichte van één enkel label (19.3 → 18.3 ex/s). De vergelijkbare cross-encoder gliner_small-v2.5 verliest 98,7% (10.7 → 0.14 ex/s). In de tests van het paper op één H100, met batchgrootte 1 en invoer van 64, 256 en 512 tokens, haalt de bi-encoder met vooraf berekende labels een throughputvoordeel tot 130× ten opzichte van gliner_small-v2.5. Met 100 entity types op één H100 verwerkt de bi-encoder 1,96 miljoen voorspellingen per dag, tegenover 368K voor de cross-encoder (Stepanov et al., 2026).
Het bi-encoder-paper rapporteert 61.5% voor gliner-bi-large-v2.0 tegenover 60.9% voor gliner_large-v2.5 op hetzelfde CrossNER-plus-MIT-gemiddelde, dus op die benchmark levert de bi-encoder geen nauwkeurigheid in voor snelheid. De auteurs bevelen bi-base-v2.0 (194M) aan als beste afweging tussen grootte en prestaties: 98% van de nauwkeurigheid van het grote model bij 2,6 keer de snelheid (Stepanov et al., 2026).
De timingsweep stopt bij 1.024 labels, met een H100, batchgrootte 1 en tien forward passes per configuratie. Hij meet geen gedeployde service met een miljoen labels. Het paper noemt entity linking over grote knowledge bases zoals Wikidata als één toepassing; entity linking is beschikbaar via het framework GLiNKER van Knowledgator.
De code encodeert de labelset één keer en hergebruikt de embeddings voor elke tekst. Met de drie labels hieronder geeft ze dezelfde drie spans terug als de cross-encoder-aanroep hierboven.
from gliner import GLiNER

model = GLiNER.from_pretrained("knowledgator/gliner-bi-base-v2.0")

# Pre-compute embeddings for a reused label set; rebuild this cache when labels or the checkpoint change.
entity_types = ["person", "organization", "date"]  # Small example; large inventories need bounded candidate selection
entity_embeddings = model.encode_labels(entity_types, batch_size=8)

# Encode text and score spans against the cached labels
texts = ["Bill Gates founded Microsoft on April 4, 1975."]
outputs = model.batch_predict_with_embeds(texts, entity_embeddings, entity_types)GLiNER2 en GLiNER2.5: één schema voor meerdere taken
Het oorspronkelijke GLiNER-ecosysteem verdeelde NER, relation extraction, classificatie en extractie op documentniveau over aparte models. Het EMNLP 2025-paper over GLiNER2 verenigde NER, classificatie en hiërarchische extractie in één model van 205M parameters; huidige releases voegden later relation extraction toe aan dezelfde schema-interface.
Die architectuur uit 2025 behoudt het cross-encoderontwerp, maar breidt de context uit tot 2.048 tokens (4x het origineel) en voegt declaratieve schema’s toe om extractietaken te definiëren. De training gebruikt 135.698 echte documenten geannoteerd met GPT-4o plus 118.636 synthetische voorbeelden (Zaratiana et al., 2025).
Op zero-shot CrossNER scoort GLiNER2 0.590 F1, dicht bij 0.599 van GPT-4o in de benchmark van het paper uit medio 2025. Voor classificatie haalt het gemiddeld 0.72 over 7 benchmarks, tegenover 0.69 voor DeBERTa-v3-large. Op CPU rapporteert het paper een classificatielatency van 130-208 ms over de geteste aantallen labels. De zero-shot DeBERTa-baseline heeft een forward pass per kandidaatlabel nodig en stijgt van 1.714 ms bij 5 labels naar 16.897 ms bij 50; dit is niet de runtime van een supervised DeBERTa-classifier (Zaratiana et al., 2025).
Het voorbeeld hieronder laadt GLiNER2.5, een later checkpoint, dus de scores uit 2025 hierboven beschrijven dat niet. GLiNER2.5 (194M parameters) voorspelt de begin- en eindpositie van spans in plaats van elke span te scoren. Het venster is 4.096 tokens, dus splits langere documenten met de helper van de library in overlappende chunks en controleer of de teruggegeven offsets terug te mappen zijn op de volledige tekst. Laad het met AutoExtractor, zoals hieronder.
from gliner2 import AutoExtractor

# Requires `pip install gliner2[local]` and downloads the checkpoint.
extractor = AutoExtractor.from_pretrained("fastino/gliner2.5-base-v1")

# Compose tasks through the current schema interface
schema = (extractor.create_schema()
    .entities({"person": "Names of people", "company": "Organization names"})
    .classification("sentiment", ["positive", "negative", "neutral"])
    .relations(["works_for", "founded", "located_in"])
    .structure("product_info")
        .field("name", dtype="str")
        .field("price", dtype="str"))
text = "Acme launched a $19 widget in Berlin."
results = extractor.extract(text, schema)
Het EMNLP-paper evalueert alleen NER en classificatie. Het rapporteert geen benchmark voor hiërarchische extractie en dekt de latere relatie-API niet. Eén model dat vier taken uitvoert, kan op elke taak toch lager scoren dan vier gespecialiseerde models, dus vergelijk elke taak met zijn eigen baseline.
Andere GLiNER-varianten voor specifieke behoeften
De GLiNER-familie heeft nu meerdere architecturen naast de cross-encoder, de bi-encoder en GLiNER2.5. Elk richt zich op één behoefte:
| Behoefte | Kandidaat | Wat je moet verifiëren |
|---|---|---|
| Entities en relaties in één pass | GLiNER-Relex | Zowel span-F1 als relatie-F1 op dezelfde documenten. |
| Lokale PII-kandidaat | GLiNER2-PII | Recall per taal, documentformaat en PII-type. |
| Meertalige open-vocabulary-kandidaat | GLiNER-X | Kwaliteit per taal; de card noemt 23 talen. |
| Gegenereerde of wisselende types | GLiNER Decoder | Of gegenereerde types stabiel en bruikbaar zijn voor vervolgstappen. |
| Streaming PII-maskering | GLiNER Streaming PII | Gelekte tekens vóór vrijgave, niet alleen de recall van de eindspan. |
De resultaten van GLiNER-Relex en GLiNER2-PII komen uit hun eigen papers en evaluatieharnesses. GLiNER-X en GLiNER Decoder hebben model cards, geen peer-reviewed benchmarks, dus hun cijfers zijn niet vergelijkbaar met de papers hierboven.
Streaming PII verandert wanneer je tekst kunt vrijgeven
GLiNER Streaming PII voegt incrementele detectie toe met een causale Qwen3-0.6B-backbone en gecachete sessiestatus. De API geeft de volledige actuele sessiesnapshot terug, met offsets in de opgebouwde tekst. Behoud de chunkgrenzen, houd de labels vast tot een volledige herberekening en ruim afgeronde sessies op.
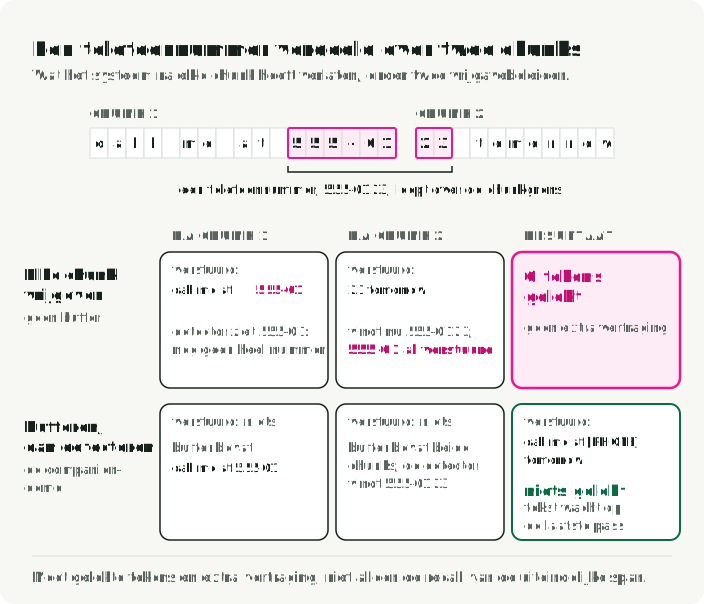
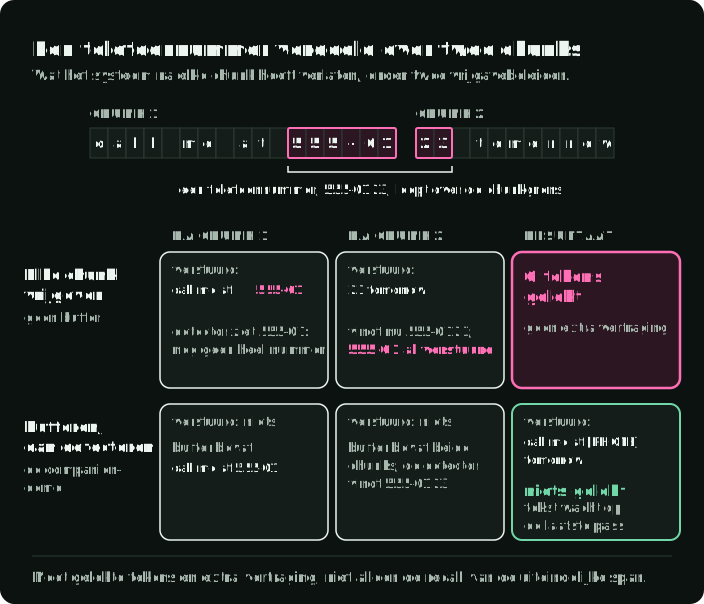
Voor streaming-maskering zou ik nog niet vrijgegeven tekst bufferen en entities testen die over chunks heen gesplitst zijn. Een telefoonnummer vinden nadat de eerste helft al is verzonden, kan die bytes niet meer terughalen. Meet de gelekte tekens vóór vrijgave en de toegevoegde vertraging, naast de recall van de eindspan. De model card rapporteert PIIMB-masking-F2 apart van strikte getypeerde span-F1; ze beantwoorden verschillende vragen. De model card rapporteert ook zwakkere meertalige resultaten, dus het vrijgegeven checkpoint is geen universeel privacyfilter.
De figuur splitst één telefoonnummer over twee chunks. Als je chunk voor chunk vrijgeeft, is de eerste helft al weg wanneer de tweede aankomt. Met een buffer ziet de detector het hele nummer en verlaat alleen gemaskeerde tekst de buffer. De ner_demo.streaming van de companion houdt alle tekst vast tot een laatste detectieronde en geeft die dan vrij met gedetecteerde spans gemaskeerd.
Closed-label-alternatieven: spaCy en een fine-tuned token classifier
Wanneer de labelset stabiel is en je geannoteerde data hebt, heb je de open labels van GLiNER niet nodig. Een model dat op die labelset is getraind, is de baseline om te verslaan.
De getrainde pipelines van spaCy (en_core_web_sm, en_core_web_trf) herkennen een vaste set entity types (PERSON, ORG, GPE, DATE en andere) die bij de training is vastgelegd. Voor het uitbreiden van de getrainde ner-component zijn gelabelde voorbeelden en training nodig. Voor identifiers of een gecontroleerde woordenlijst voegt EntityRuler eigen labels toe via patronen, zonder retraining; de recall buiten die patronen is nul. De model card van en_core_web_trf 3.8.0 rapporteert 90.19 NER F1 op OntoNotes 5.0, maar alleen voor de 18 vooraf gedefinieerde types (model card van spaCy).
Het voorbeeld voegt een tickerpatroon toe vóór de getrainde ner-component, zodat de regel eerst $AAPL claimt en het model de rest labelt:
import spacy

nlp = spacy.load("en_core_web_trf")
ruler = nlp.add_pipe("entity_ruler", before="ner")
ruler.add_patterns([{"label": "TICKER", "pattern": [{"TEXT": "$"}, {"TEXT": {"REGEX": r"^[A-Z]{1,5}$"}}]}])

doc = nlp("Tim Cook said Apple ($AAPL) will open an office in Berlin in March 2027.")
print([(ent.text, ent.label_) for ent in doc.ents])
# [('Tim Cook', 'PERSON'), ('Apple', 'ORG'), ('$AAPL', 'TICKER'), ('Berlin', 'GPE'), ('March 2027', 'DATE')]
Voor stabiele labels met representatieve geannoteerde spans is een fine-tuned token classifier zoals BERT, RoBERTa of DeBERTa de supervised baseline. De Hugging Face pipeline laadt er een in één regel. dslim/bert-base-NER, de vaste encoder in de evaluatie van de companion, is getraind op CoNLL-2003, dus zijn labels liggen vast op PER, ORG, LOC en MISC. De datum in dezelfde zin wordt niet gevonden, omdat het model geen datumlabel heeft:
from transformers import pipeline

ner = pipeline("token-classification", model="dslim/bert-base-NER", aggregation_strategy="simple")
for ent in ner("Tim Cook said Apple will open an office in Berlin in March 2027."):
    print(ent["word"], ent["entity_group"], round(float(ent["score"]), 3))
# Tim Cook PER 1.0
# Apple ORG 0.998
# Berlin LOC 0.999
Om je eigen labels te krijgen, fine-tune je zo’n model op je geannoteerde spans. Vergelijk het met spaCy en GLiNER op exact-span F1, recall per label, calibration, latency en kosten op dezelfde domeinset.
Mijn aanbeveling: gebruik spaCy of een fine-tuned token classifier voor standaard of stabiele entity types waarvoor je trainingsdata hebt. Gebruik GLiNER wanneer je flexibele, zero-shot types nodig hebt of wanneer je pipeline zich zonder retraining moet aanpassen. Ze kunnen één pipeline delen, waarbij spaCy de tokenization en zinsplitsing doet en GLiNER de entity extraction.
Checkpointlicenties maken deel uit van de modelkeuze
De models in deze gids delen niet één licentie. Controleer vóór deployment de voorwaarden voor code, weights en dataset van het exacte checkpoint:
| Release | Gepubliceerde licentie | Praktisch gevolg |
|---|---|---|
| GLiNER v2.1, GLiNER v2.5 en GLiNER bi | Apache 2.0 | Ruime voorwaarden op de model card; controleer nog wel dependencies en data. |
| GLiNER2, GLiNER2.5 en GLiNER2-PII | Apache 2.0 | Bevestig het gekozen checkpoint, niet alleen de library. |
spaCy en_core_web_trf en dslim/bert-base-NER | MIT | Ruim; de trainingscorpora hebben eigen voorwaarden. |
| UniNER-7B-all | CC BY-NC 4.0 | Gebruik niet voor een commercieel pad zonder aparte toestemming. |
| NuNER | MIT | Het vrijgegeven model en de dataset vermelden MIT-voorwaarden. |
Licentielabels zijn geen juridisch advies. Een productiereview moet de voorwaarden van het basismodel, de trainingsdata en providers omvatten.
LLMs als teachers: een $70-case study en een deployable pipeline
Het LLM-as-teacher-patroon scheidt dure annotatie van goedkopere inference: een LLM labelt eenmalig trainingsdata en een kleine encoder die op die labels is getraind, bedient elk verzoek. Twee onderzoekspapers toonden aan dat kleine models NER kunnen leren van LLM-labels, en twee gepubliceerde case studies laten zien hoe teams het toepasten.
Het onderzoek achter dit patroon: UniNER en NuNER
UniNER (ICLR 2024, Zhou et al.) en NuNER (EMNLP 2024, Bogdanov et al.) destilleren beide LLM-annotaties tot kleinere NER-models, maar ze verschillen van mening over hoe klein je kunt gaan.
UniNER fine-tunet LLaMA-7B/13B op 45.889 input-outputparen die ChatGPT genereerde. Voor elk entity type beantwoordt het model “What describes [type] in the text?” en geeft het JSON-lijsten terug. Een belangrijke trainingstruc: negative sampling op basis van frequentie verhoogt de F1 van 31,5% naar 53,4% (Zhou et al., 2024).
UniNER-7B haalt 41,7% zero-shot F1 over 43 datasets en verslaat daarmee de 34,9% van ChatGPT met 7 punten. De 13B-variant haalt 43,4%, slechts 1,7 punt meer voor bijna het dubbele aantal parameters (Zhou et al., 2024).
De afweging in productie: de UniNER-opzet met de hogere score uit het paper bevraagt elk entity type achtereenvolgens. De all-in-one-variant gebruikt één antwoord, maar scoorde gemiddeld 3,3% lager. Bij FP16 heeft een 7B-checkpoint alleen al voor de weights ongeveer 14GB nodig; quantization met minder bits kan die footprint verkleinen. Het UniNER-7B-all-checkpoint is niet-commercieel (zie de licentietabel hierboven).
NuNER begint bij RoBERTa-base (125M parameters) en gebruikt contrastieve training met 4,38 miljoen GPT-3.5-annotaties over 200K concepten. Na de training wordt de concept-encoder weggegooid; de tekst-encoder past als RoBERTa-vervanger in elke standaard NER-pipeline (Bogdanov et al., 2024).
Tabel 3 van NuNER rapporteert ongeveer 6,1–16,2 punten boven RoBERTa in macro-average token-classification-F1 met bevroren encoders en lineaire heads, over vier datasets en gesamplede trainingsgroottes (Bogdanov et al., 2024).
Beide papers laten zien dat een kleiner model kan leren van LLM-annotaties. Geen van beide laat zien dat de student zijn teacher verslaat in een nieuw domein, en daarom houdt de pipeline hieronder een apart gereviewde testset aan.
De CFM-case study
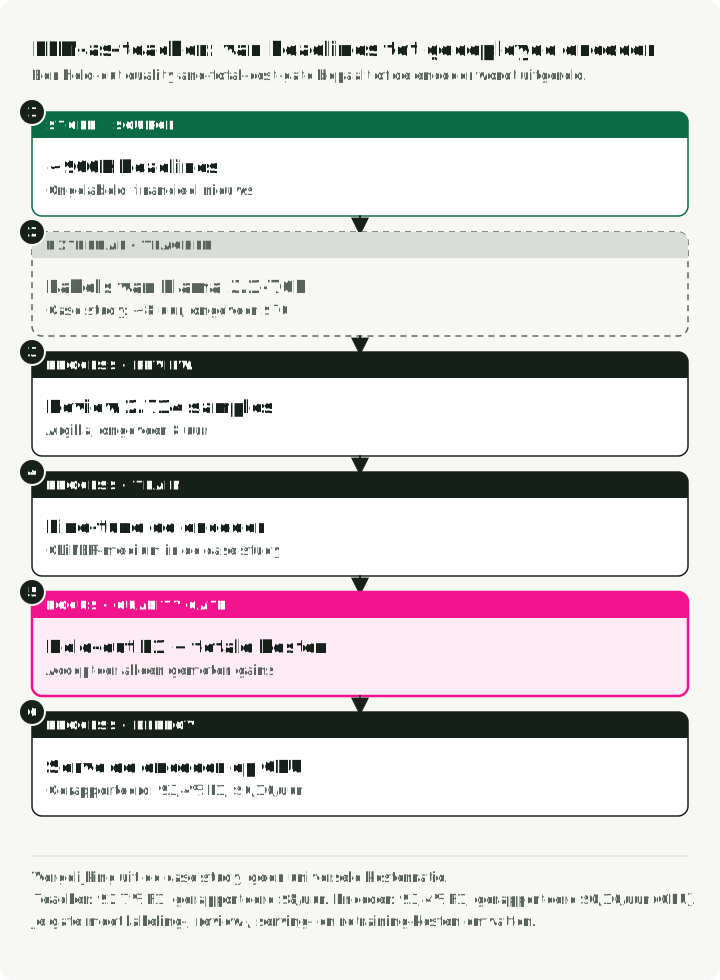
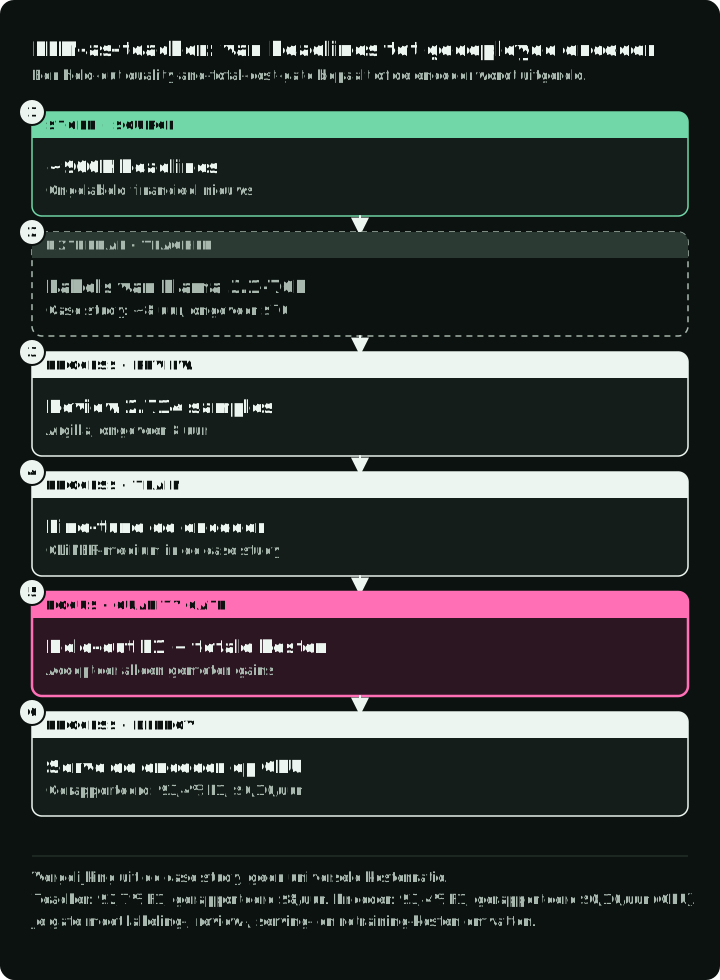
In een case study van Hugging Face haalde Capital Fund Management bedrijfsnamen uit ongeveer 900.000 financiële nieuwskoppen. Zero-shot GLiNER scoorde 87,0% F1. Het team gebruikte Llama 3.1-70B om de dataset in ongeveer 8 uur te annoteren voor circa $70, en reviewde daarna 2.714 samples via Argilla in nog eens 8 uur.
Fine-tuning van GLiNER op deze data bereikte in de case study 93,4% F1, tegenover 92,7% voor de Llama-70B-teacher. De auteurs rapporteren $0,10 per uur op CPU voor het fine-tuned model en $8 per uur voor de teacher (CFM-case study). Die cijfers beschrijven één financiële nieuwstaak en één infrastructuuropzet.
De Refuel AI-studie
Het technische rapport van leverancier Refuel AI benchmarkt LLM-labeling over 8 NLP-datasets, waaronder CoNLL-2003. Het rapporteert 88,4% overeenstemming met de ground truth voor GPT-4 (maart 2023) en 86,2% voor de menselijke annotators in zijn opzet, plus 20 keer snellere en 7 keer goedkopere labeling. Een apart ensemble-experiment met eigen data haalde meer dan 95% overeenstemming, met 89% voor het beste individuele LLM. Op vertrouwen gebaseerde routing naar goedkopere of sterkere models is een voorgesteld gebruik, niet het gemeten mechanisme achter het resultaat over acht datasets (technisch rapport van Refuel AI).
Een productiepipeline
Een praktische productieflow heeft zes stappen. Het diagram plaatst elke stap in de baan van wie hem uitvoert, met de CFM-cijfers en de lus terug naar review wanneer de student zijn doel mist. De grafiek eronder vergelijkt de F1 en de kosten per uur van CFM voor de teacher en de student.
- Schrijf annotatierichtlijnen in natuurlijke taal.
- Maak door mensen gelabelde development- en held-out-testsets. De evaluatiesectie hieronder geeft een procedure om ze te dimensioneren.
- Gebruik een LLM met een geversioneerde prompt en een expliciet outputschema om bulktrainingslabels voor te stellen. Bewaar het gevraagde en het werkelijk gebruikte model, de prompt en de brontekst. Weiger onbekende types en spans die niet op de bron zijn uit te lijnen.
- Review een deel via Argilla of Label Studio.
- Fine-tune een compacte encoder (GLiNER, SpanMarker, RoBERTa). Gebruik voor GLiNER de
train.pyvan de repository (python train.py --config configs/config.yaml) of de methodetrain_model()van het model, met het gereviewde trainbestand als trainingsdata en het developmentbestand voor evaluatie tijdens de training. - Deploy pas nadat de encoder een controle op held-out kwaliteit en totale kosten doorstaat. CFM rapporteerde in zijn opzet 16-80x lagere infrastructuurkosten per uur; neem annotatie, review, serving en hertraining mee in je vergelijking.
De LLM kan de hoeveelheid handmatige annotatie verminderen, maar het team blijft eigenaar van de validatieset, de annotatierichtlijnen, gerichte review en foutenanalyse.
De begeleidende repository demonstreert één voorstel van de teacher en converteert gecontroleerde annotaties voor stap 5 (README-sectie). Voer deze opdrachten uit in die repository met Python 3.11+, uv en dependencies die via uv sync --locked --all-extras zijn geïnstalleerd. Stel OPENAI_API_KEY in voor de betaalde teacheraanroep. De conversie vereist de bestanden van het vastgelegde GLiNER-model en zijn backbone in de cache; uv run --all-extras python -m ner_demo.quickstart --download downloadt ze eenmalig.
-
Voer de teacherdemo voor één document uit. Deze doet één betaald verzoek voor een vaste zin over NVIDIA’s voorgenomen overname van Arm en schrijft één ongecontroleerd record naar
artifacts/teacher_annotations.jsonl:uv run --all-extras python -m ner_demo.teacher --allow-paid -
Controleer het voorstel handmatig en los afgewezen annotaties op. Maak
artifacts/reviewed.jsonlmet gecontroleerde trainingsdocumenten en de afzonderlijk door mensen gelabelde ontwikkel- en testdocumenten uit het productieproces hierboven. Alle drie de splits moeten gegevens bevatten, document-ID’s moeten uniek zijn en geen brontekst mag in meer dan één split voorkomen. Kopieer de demozin niet tussen splits. Stel voor ieder recordreviewed: true, eenreviewer,status: "ok"en eensplit(train,developmentoftest) in en houdsource_sha256consistent met de brontekst. Eén demorecord kan niet alle drie de splits leveren. -
Converteer het volledige gereviewde bestand. Dit schrijft
train.json,development.jsonentest.jsononderartifacts/training/in het trainingsformaat van GLiNER, nadat elke rij door de eigen data collator van GLiNER is gehaald:uv run --all-extras python -m ner_demo.training artifacts/reviewed.jsonl
Geef train.json en development.json door aan de GLiNER-fine-tuningrun in stap 5 en bewaar test.json voor de laatste controle.
Waar GLiNER faalt en LLMs nuttig blijven
De Sease-benchmark (oktober 2025) testte GLiNER tegen GPT-4.1-mini op 30 queryparsingtaken. GPT-4.1-mini had 100% volledig correct. GLiNER haalde 53% (16 van de 30). Maar GLiNER antwoordde in 0,08 seconden tegenover 1,21 seconden voor de LLM, 15x sneller.
In deze benchmark van 30 taken faalde GLiNER in drie terugkerende patronen:
- Impliciete entities: “event” extraheren uit “Elton John performed at Madison Square Garden”. Nergens in de tekst staat letterlijk “event”, maar de LLM leidt “concert” af.
- Gevoeligheid voor labelformulering: “2022” scoort 0.388 tegen “date” maar 0.958 tegen “year”. Kleine labelwijzigingen veroorzaken grote scoreverschillen.
- Waardemapping: GLiNER geeft de exacte oppervlaktetekst terug (“family houses”) in plaats van de canonieke waarde (“Single family house”). Een LLM kan die normalisatie uitvoeren wanneer zijn prompt en schema de doelwaarden definiëren.
Geneste en overlappende entities
Een geneste entity zit binnen een andere. In “New York University” is “New York” een locatie binnen een organisatienaam. Biomedische tekst (“acute myeloid leukemia” binnen een langere diagnose) en juridische tekst (een afdeling binnen een benoemde instantie) hebben hetzelfde patroon.
GLiNER gebruikt standaard flat decoding, die overlappende spans onderdrukt. De API ondersteunt ook flat_ner=False, waarmee overlappende voorspellingen zijn toegestaan:
entities = model.predict_entities(
    "She studied at New York University.", ["organization", "location"],
    flat_ner=False, threshold=0.3)
# [{'text': 'New York University', 'label': 'organization', 'score': 0.855, ...}]
Met urchade/gliner_medium-v2.1 gaf deze aanroep alleen de organization terug, zelfs bij een threshold van 0.05. Flat decoding uitzetten maakt geneste output mogelijk, maar het checkpoint moet de binnenste span nog steeds boven de threshold scoren. Als je data geneste entities bevat, bouw dan een geneste testset en controleer of de binnenste spans überhaupt verschijnen voordat je GLiNER boven een gespecialiseerd model voor geneste NER kiest.
Gebruik GLiNER voor expliciete entity extraction en stuur gevallen die inference, reasoning of mapping naar vooraf gedefinieerde ontologieën vereisen naar een LLM. De routingdrempel moet uit een gelabelde domeinset komen.
NER evalueren: metrics, valkuilen en testsets
Elk getal in deze gids komt uit het model, de data en de hardware van zijn bron. Draai de vergelijking opnieuw op je eigen gelabelde set voordat je kiest. Deze sectie legt uit hoe je die set bouwt en scoort.
Een model kan 95% F1 halen op een samengestelde testset en toch falen op de documentmix die het na deployment ziet. Bouw de evaluatieset op uit de productieverdeling en bewaar slices voor de zeldzame formaten en entity types die een totale F1 kan verbergen.
De kernmetrics
Identificeer elk voorkomen met document-ID, half-open start- en eindoffsets en type, en controleer dat text[start:end] de vermelding teruggeeft. Twee voorkomens van “John” zijn twee doelen. De figuur scoort drie voorspellingen voor één zin.
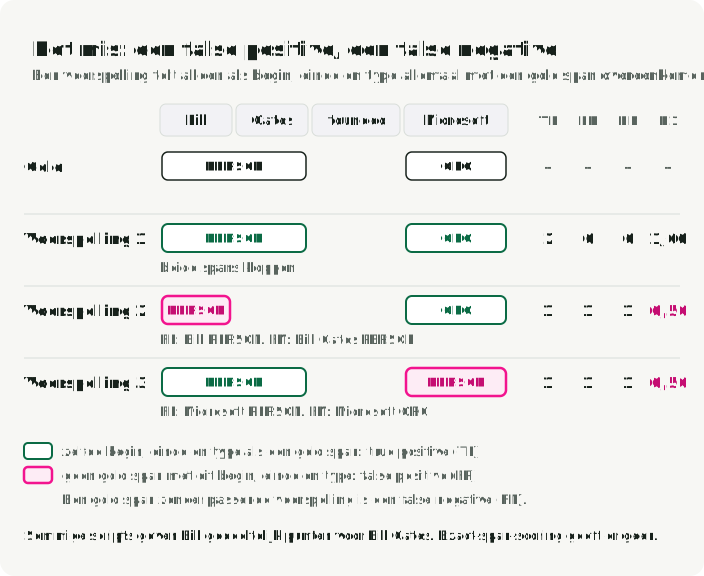
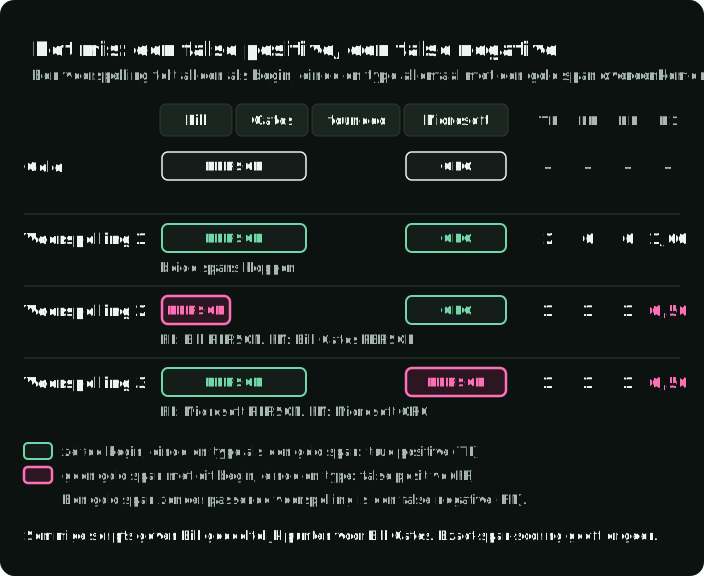
Valideer het aantal documenten vóór het matchen: ontbrekende voorspellingen moeten false negatives opleveren en mogen niet verdwijnen via zip(). Tel een verkeerd type of verkeerde offsets als een niet-gematchte voorspelling en een niet-gematchte gold span. Rapporteer micro precision, recall en F1, support en recall per type, en definieer macro-aggregatie en lege gevallen. De exacte evaluator van de companion implementeert deze regels en houdt ontbrekende, mislukte en overgeslagen documenten in de gold-noemer.
- Entity-level F1: De standaardmetric. Een voorspelling is alleen correct als zowel de spangrenzen als het type exact met de ground truth overeenkomen. Dit is wat de meeste papers rapporteren.
- Token-level F1: Scoort elk token afzonderlijk. Een gedeeltelijk juiste grens kan hier beter uitzien dan bij een exact-span-score, dus rapporteer exact-span F1 wanneer de juistheid van grenzen telt; gebruik token-levelmetrics alleen als de beslissing erna op tokenniveau valt.
- Precision versus recall: Die hebben vaak asymmetrische kosten. Bij de-identificatie telt recall zwaarder: een gemiste naam is erger dan te veel maskeren. Bij database-extractie telt precision zwaarder: foute invoer verstoort de analyse erna.
Veelvoorkomende evaluatievalkuilen
- Opgeblazen score door partial matches: “Bill” geëxtraheerd terwijl het gold label “Bill Gates” is. Sommige scripts tellen dit als partial match. Gebruik exact span matching tenzij je een reden hebt om dat niet te doen.
- Typeverwarring: “Microsoft” correct als span geïdentificeerd maar als PERSON in plaats van ORG gelabeld, moet nul scoren. Controleer of je evaluatiecode dit afhandelt.
- Lekkage uit de testset: Houd dubbele en bijna dubbele records, documenten en annotaties buiten de testset. Houd voor een hard zero-shot-claim ook de doel-entitytypes buiten de training; herhaalde oppervlaktestrings alleen zijn geen lekkage.
- Ongecontroleerde labelprompts: Een korte typenaam en een geteste typebeschrijving zijn verschillende inputs. Versioneer labelbeschrijvingen, thresholds, checkpointrevisies en decodingmodus samen met de score.
- Zero-shot-claims in één taal: Leid meertalige kwaliteit niet af uit het Engels. OpenNER beslaat 36 corpora en 52 talen, en zijn baselines vonden geen enkel model dat in elke taal het beste was (Palen-Michel et al., 2025). In FiNERweb-experimenten veranderde de overstap van Engelse naar doeltaallabels de F1 met 0,02–0,09, afhankelijk van de instelling (Golde et al., 2026). Test beide labeltalen wanneer het product lokale terminologie gebruikt.
- Eén run als eindresultaat: Rapporteer waar van toepassing de variatie over random seeds, thresholdsweeps en herhaalde productiesteekproeven. Kleine slice-aantallen maken een modelranglijst instabiel.
Houd normalisatie, entity linking, recordgroepering en relatie-eindpunten gescheiden van extractieve F1. Rapporteer voor privacy gelekte instanties en getroffen automatisch geaccepteerde documenten, onterechte maskeringen en het reviewaandeel. Rapporteer voor serving het slagingspercentage, p50/p95-documentlatency, koude en warme runs, batch- en labelgroottes, piekgeheugen en kosten per geaccepteerd document.
Een domeintestset bouwen
Voor productie-evaluatie raad ik aan:
- Neem een steekproef uit productiedata, geen samengestelde voorbeelden. Neem de rommelige documenten op die je model echt gaat zien.
- Bepaal de omvang van de testset aan de hand van een pilot. Label een pilot van ongeveer 50 documenten, tel de gold spans per label en bootstrap de recall per label. Voeg documenten toe tot het 95%-interval voor het zeldzaamste label waar je om geeft smaller is dan het verschil dat je wilt kunnen aantonen.
- Gebruik minstens twee annotators op een calibration-subset. Beslecht meningsverschillen en rapporteer de exact-span-F1 tussen de spans van de twee annotators. Overeenstemming laat zien waar de richtlijnen dubbelzinnig zijn; het is geen bovengrens voor de modelprestaties.
- Stratificeer op moeilijkheid: makkelijke gevallen (schone tekst, standaardtypes) en moeilijke gevallen (dubbelzinnige entities, jargon, ruisende tekst).
- Houd privacy- en fairness-slices bij. Rapporteer voor PII de recall per PII-type, taal, locale, documentformaat en relevante demografische of naamherkomstslices. Beperk de toegang van evaluatoren tot ruwe gevoelige tekst, stel bewaartermijnen vast en review false negatives.
Continual NER vereist een onveranderlijke regressieset
Productietaxonomieën veranderen. Voeg nieuwe types toe zonder stilzwijgend te veranderen wat een oud type betekent. Houd een geversioneerde, onveranderlijke regressieset voor bestaande types aan, een aparte testset voor het nieuwe type en een changelog voor wijzigingen in de annotatierichtlijnen. Rapporteer de scores van oude en nieuwe types apart voordat je een checkpoint vervangt. Dit is de eenvoudigste manier om vergeten en taxonomiedrift op te sporen.
Productie-NER in vier sectoren
Elk domein extraheert andere dingen en heeft een ander gepubliceerd startpunt. De laatste kolom noemt het voorbehoud dat bepaalt wat je als eerste test.
| Domein | Wat wordt geëxtraheerd | Startpunt | Voorbehoud dat een keuze verandert |
|---|---|---|---|
| Healthcare | Namen, datums, ID’s en andere PHI voor de-identificatie | De evaluaties van John Snow Labs en Providence hierboven; de open medische NER-models van OpenMed | Rapporteer gelekte instanties en getroffen documenten, niet alleen F1. |
| Finance | Bedrijfsvermeldingen in nieuws; velden in filings | De CFM-case study voor nieuws; FinBERT-MRC voor filings (92.78 F1 op ChFinAnn, 96.80 op AdminPunish) | De resultaten van FinBERT-MRC betreffen Chinese filings; test Engelse SEC-filings, lange documenten en geneste entities apart. |
| E-commerce | Producttype, merk en attributen in zoekopdrachten | EAMT van Walmart (ongeveer 60 NER-labels voor queries); TripleLearn van Home Depot (held-out F1 69.5 → 93.3, 9+ maanden in productie) | De methode van TripleLearn bestaat uit herhaalde rondes van domeinsupervisie; het paper vergelijkt geen huidige architecturen. |
| Cybersecurity | Malware, threat actors en indicators of compromise | CyNER (76.66 span-micro-F1, XLM-RoBERTa-large); CyberNER (21 STIX 2.1-labels, RoBERTa 0.736 F1) | Alleen onderzoeksdatasets; labelsets verschillen, dus map ze naar STIX voordat je models vergelijkt. |
Deploymentoptimalisatie: van Python naar inference met lagere latency
Zodra een model de domeintestset doorstaat, is de volgende vraag hoe je het serveert. Dit is de volgorde waarin ik de runtimes zou proberen, met na elke stap een controle. Verander telkens één ding, zodat een kwaliteitsdaling één oorzaak heeft.
- Serveer met PyTorch en Ray Serve.
- Exporteer ONNX FP32, of draai het met gline-rs. Als de spans van PyTorch afwijken, herstel dan de export.
- Quantize naar dynamische INT8 en houd de FFN-down-projecties in FP32.
- Deploy INT8 alleen als de recall per label binnen het doel blijft. Anders houd je FP32.
Native GLiNER-serving
Test vóór de overstap naar een nieuwe runtime het Ray Serve-pad van het project. gliner[serve] biedt dynamic batching, geheugenbewuste batchgroottes, schalen met meerdere replica’s en een HTTP-client. Batching en replica’s kunnen de throughput verbeteren terwijl de modelcode behouden blijft. Batching voegt ook wachttijd toe, dus meet queue-latency en warme latency onder je eigen verzoekmix.
ONNX-export
GLiNER heeft native ONNX-conversie, en vooraf geconverteerde models bestaan op Hugging Face (onnx-community/gliner_small-v2.1). De export schrijft de graph, de config en de tokenizer naar één directory, en dezelfde GLiNER-klasse laadt hem terug met dezelfde predict_entities-aanroep:
from gliner import GLiNER

model = GLiNER.from_pretrained("urchade/gliner_medium-v2.1")
model.export_to_onnx("onnx/fp32")

onnx_model = GLiNER.from_pretrained("onnx/fp32", load_onnx_model=True)
entities = onnx_model.predict_entities(text, labels, threshold=0.5)
De ONNX-vergelijking van de companion draait PyTorch, ONNX FP32 en ONNX INT8 op dezelfde inputs en vergelijkt hun spans. Ze vereist Python 3.11+ en uv. Het datacommando downloadt een vastgepinde Few-NERD-shard en houdt de eerste 32 zinnen over, genoeg om de export te controleren, niet om models te rangschikken. De quickstart met --download haalt het vastgepinde checkpoint eenmalig op:
uv sync --locked --all-extras
# Run once if the pinned model files are not cached:
uv run --all-extras python -m ner_demo.quickstart --download
uv run --all-extras python -m ner_demo.data --split test --limit 32
uv run --all-extras python -m ner_demo.onnx_check \
  --dataset artifacts/few-nerd-test.json --output artifacts/onnx-comparison
Gebruik een nieuwe outputdirectory, of --reuse om bestaande packages te controleren. Het commando faalt wanneer FP32-spans van PyTorch afwijken, of wanneer INT8 meer dan 0.02 micro recall verliest. Op een Apple M5 Max CPU gaf FP32 ONNX exact dezelfde spans als PyTorch, met een p50-latency van 16-19 ms per zin, tegenover 64-66 ms voor PyTorch.
INT8-quantization
Dynamische INT8-quantization slaat weights op als 8-bit integers en maakt het ONNX-bestand kleiner. Voor de DeBERTa-encoder van GLiNER werkt het quantizen van elke laag niet. In de companion gaf het quantizen van alle MatMul-lagen helemaal geen entities terug. Door lagen groep voor groep te quantizen werd de oorzaak zichtbaar: alleen de twaalf FFN-down-projecties (layer.N/output/dense, de tweede lineaire laag van het feed-forward network van elk encoderblok) duwen elke score onder de threshold. Die twaalf lagen in FP32 houden lost het op. De code kopieert het FP32-package (voor de config- en tokenizerbestanden) en quantizet daarna al het andere:
import shutil

import onnx
from onnxruntime.quantization import QuantType, quantize_dynamic

shutil.copytree("onnx/fp32", "onnx/int8")
graph = onnx.load("onnx/fp32/model.onnx", load_external_data=False).graph
keep_fp32 = [n.name for n in graph.node if n.op_type == "MatMul" and "/output/dense/" in n.name and "/attention/" not in n.name]

quantize_dynamic("onnx/fp32/model.onnx", "onnx/int8/model.onnx",
                 weight_type=QuantType.QInt8,
                 op_types_to_quantize=["MatMul", "Gemm", "Gather"],
                 nodes_to_exclude=keep_fp32)
Laad onnx/int8 met load_onnx_model=True, net als bij FP32. De quantize_package van de companion doet hetzelfde en valideert daarna het package. Op de 32 Few-NERD-zinnen (Apple M5 Max, ONNX Runtime 1.24.4) waren de gemeten resultaten:
| Pad | Package | p50-latency | Micro precision | Micro recall |
|---|---|---|---|---|
| PyTorch | - | 64-66 ms | 0.506 | 0.722 |
| ONNX FP32 | 790 MB | 16-19 ms | 0.506 | 0.722 |
| ONNX INT8 | 353 MB | 13-15 ms | 0.487 | 0.722 |
INT8 verkleinde het package met meer dan de helft en behield de recall, maar veranderde de spans in 4 van de 32 zinnen en voegde 3 false positives toe. In deze run loont INT8 wanneer geheugen of packagegrootte de beperking is; voor alleen latency kwam het grootste deel van de winst van de FP32 ONNX-export. Controleer de recall per label ten opzichte van FP32 op je eigen data voordat je het deployt: een kleiner bestand zegt niets over de extractiekwaliteit. Huidige GLiNER-richtlijnen raden quantization-aware training aan wanneer de INT8-nauwkeurigheid gelijk moet zijn aan die van FP32.
gline-rs: Rust-herimplementatie
gline-rs (Apache 2.0) haalt de Python-runtime uit het inferencepad. Het project rapporteert in zijn eigen benchmark ongeveer vier keer de CPU-throughput van Python. Het ondersteunt span- en tokenmodels, GPU/NPU via ONNX Runtime, en wordt geleverd als crate op crates.io. Het laadt een ONNX-export en bijbehorende tokenizer.json, zoals het package dat hierboven is geschreven; de README van het project toont de Rust-aanroep.
Het package fast-gliner biedt Python-bindings via PyO3.
Welke runtime wanneer
| Pad | Gebruik wanneer | Beschikbaar bewijs | Meet vóór deployment |
|---|---|---|---|
| Native Ray Serve | Je Python wilt behouden en batching en replica’s wilt toevoegen | Projectdocumentatie van GLiNER | Queue-latency, warme latency, throughput |
| ONNX FP32 | Eerste runtimewijziging op elke hardware | Companion: dezelfde spans als PyTorch, 3,4-4x lagere latency | Warme latency, throughput en exact-span F1 |
| ONNX INT8 | Geheugen of packagegrootte is de beperking op CPU | Companion: 353 MB tegenover 790 MB, dezelfde recall, 3 extra FPs | Recall en precision per label ten opzichte van FP32 |
| gline-rs | Je moet de Python-runtime verwijderen | Projectbenchmark onder zijn gedocumenteerde hardware/opzet | Je modelmodus, labels, hardware en batch |
Gestructureerde extractie: native schema’s, Instructor en lokale decoders
Wanneer je meer flexibiliteit nodig hebt dan encoder-models bieden (impliciete entities, reasoning, ontologiemapping), begin dan met het native schemamechanisme van de provider. OpenAI ondersteunt strikte json_schema-responseformaten, Anthropic structured outputs ondersteunt JSON-outputs en strikte tool-inputs, en de Gemini API ondersteunt een subset van JSON Schema. Een gedeeld Pydantic- of Zod-model kan het contract beschrijven, maar elke provider accepteert een andere schemasubset en gedraagt zich anders bij weigeringen en complexiteit.
Schemaconformiteit maakt parsen betrouwbaar. Het bewijst niet dat een geëxtraheerde span in de brontekst voorkomt of dat een genormaliseerde waarde klopt. Valideer veldwaarden, bewaar waar mogelijk offsets of citaten en score de semantische nauwkeurigheid op een gelabelde set.
De drie libraries hieronder dwingen structuur op verschillende manieren af. De figuur laat één zin door elk van de drie lopen: Instructor valideert en probeert opnieuw, Outlines blokkeert tijdens het decoderen een ongeldig label en LangExtract geeft karakteroffsets terug voor elk veld.
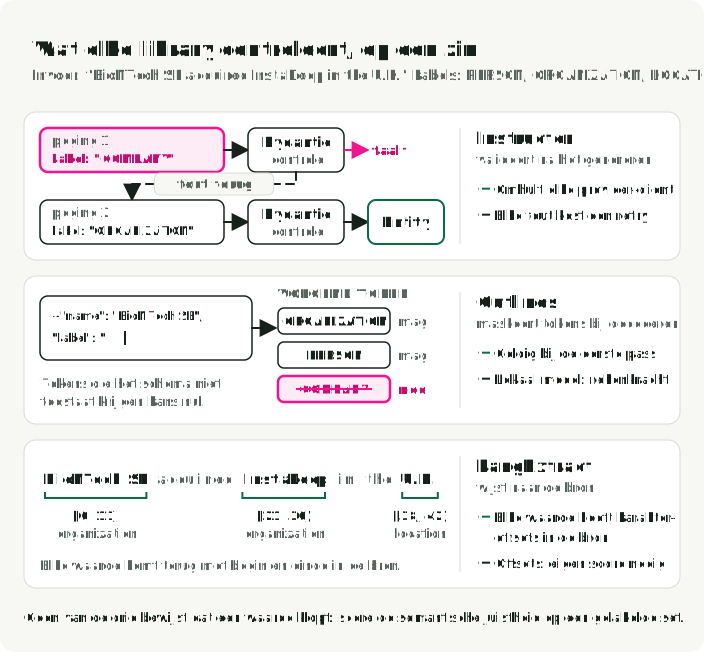
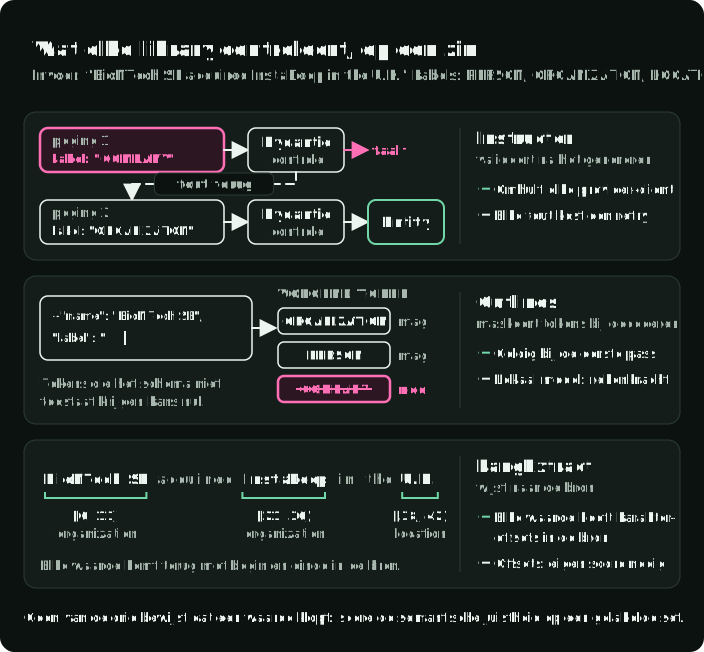
Instructor omhult provider-clients met Pydantic-validatie en optionele retries na mislukte validatie.
Dit zelfstandige voorbeeld vereist pip install instructor openai pydantic, een OPENAI_API_KEY en een betaald providerverzoek. Elk model met ondersteuning voor structured output werkt hier; het voorbeeld gebruikt gpt-5.4-mini, dezelfde standaard als de teacher van de companion.
import instructor
from pydantic import BaseModel
from typing import List, Literal
from openai import OpenAI

class Entity(BaseModel):
    name: str
    label: Literal["PERSON", "ORGANIZATION", "LOCATION"]

class ExtractEntities(BaseModel):
    entities: List[Entity]

client = instructor.from_openai(OpenAI())
result = client.chat.completions.create(
    model="gpt-5.4-mini", reasoning_effort="none",
    response_model=ExtractEntities,
    messages=[{"role": "user", "content": "BioNTech SE acquired InstaDeep in the U.K."}])
# entities=[Entity(name='BioNTech SE', label='ORGANIZATION'), ...]
Outlines van dottxt kiest een andere aanpak: constrained tokengeneratie via finite-state machines. De decoder maskeert tokens die de doelgrammatica zouden schenden, in plaats van op een mislukte validatie te wachten en opnieuw te proberen. Een AWS-overzicht noemt 98% schemaconformiteit tegenover 76% voor validatie na generatie. Het herhaalt ook de bewering van .txt Engineering dat generatie tot 5 keer sneller kan, zonder genoeg methodedetails om de twee cijfers te vergelijken.
In Outlines omhult outlines.from_transformers een Hugging Face-model en zijn tokenizer. Het model aanroepen met een prompt en een Pydantic-klasse zoals ExtractEntities hierboven geeft JSON terug die bij de klasse past. Neem voor een nieuwe zelfgehoste extractievergelijking het huidige Qwen3.8-27B of de kleinere Qwen3.5-checkpoints mee. Laad ze met hun gedocumenteerde modelloader, chat template en serving-backend; een multimodale architectuur of een reasoning-formaat kan meer vragen dan een nieuwe model-ID.
LangExtract is nuttig wanneer een gegenereerd veld in de bron verankerd moet zijn: het geeft karakterintervallen terug en ondersteunt gehoste of lokale LLM-backends. Voor zelfgehoste documentextractie zet NuExtract JSON-schema’s om in templates en bevat het multimodale documentmodels. Beide zijn systemen voor gestructureerde extractie, geen drop-in-vervangers voor span-NER: hun veld-, offset- en layoutoutputs hebben eigen scores nodig.
De keuze hangt af van waar je je models draait. Native schema’s zijn het pad met de minste frictie voor een ondersteunde provider. Instructor voegt een providerneutrale laag voor Pydantic-validatie en retries toe. Outlines beperkt lokale generatie tegen een schema. LangExtract geeft voorrang aan bronverankering, terwijl NuExtract zich richt op zelfgehoste documentextractie. Alle LLM-paden omvatten nog steeds autoregressieve generatie, dus ze kosten doorgaans meer tijd per document dan een encoder op dezelfde hardware.
De productiearchitectuur met drie tiers
Ik zou productie-NER routeren op de vorm van de taak, niet op één modelranglijst. Elke rij van de figuur toont een voorbeeldverzoek, wat er terugkomt en de models om te testen. Gereviewde Tier 3-gevallen keren alleen als spans uit de bron terug naar Tier 1.
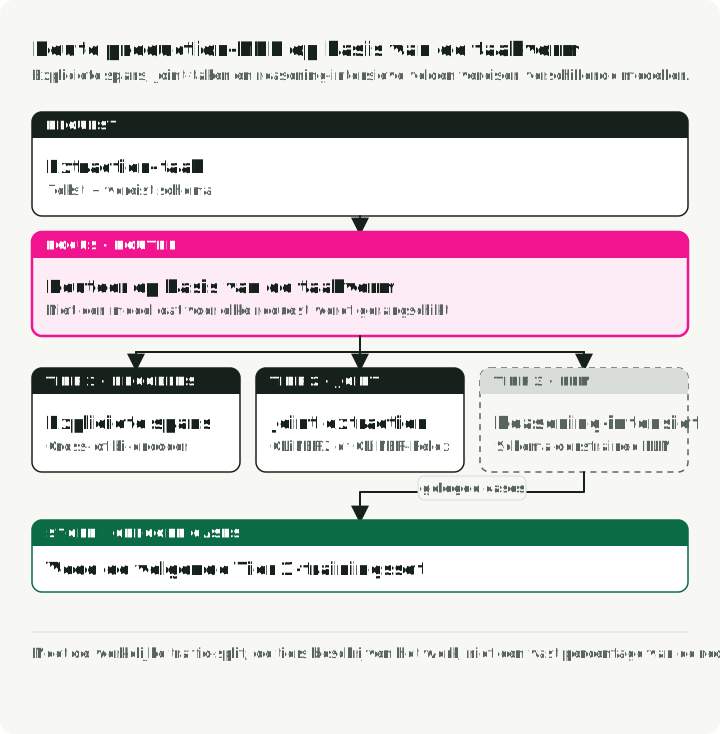
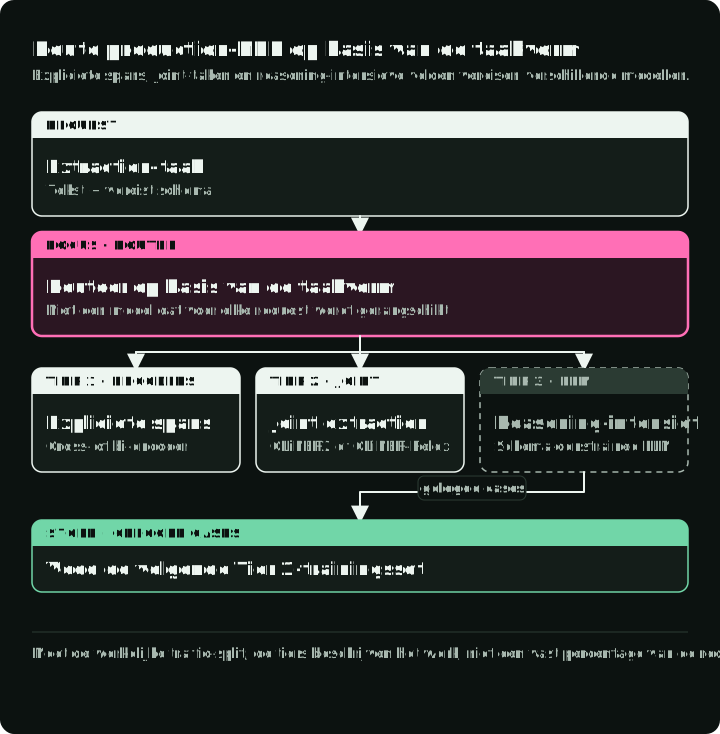
Tier 1: encoder-models voor expliciete spans. Gebruik een GLiNER cross-encoder voor een kleine typeset. Wanneer een grote typeset wordt hergebruikt, vergelijk dan de bi-encoder met gecachete type-embeddings. Fine-tune via de LLM-as-teacher-pipeline en deploy daarna met native serving, ONNX, INT8 of gline-rs, alleen als dat pad de domeinbenchmark doorstaat.
Tier 2: multi-task of relation extraction. Wanneer één verzoek NER, classificatie en hiërarchische velden nodig heeft, test dan het huidige GLiNER2.5-checkpoint van 194M parameters tegen aparte baselines per taak. Wanneer de kernvereiste gezamenlijke spans plus relaties is, test dan GLiNER-Relex. Het GLiNER2-paper rapporteert een CPU-classificatielatency van 130-208 ms over de geteste aantallen labels; de latere relatie-API heeft het niet gemeten.
Tier 3: LLMs voor redeneerintensieve extractie. Stuur impliciete entities, contextuele inference en ontologiemapping naar een native schema-API of Instructor voor cloud-API’s, en naar Outlines voor lokale constrained output. Gebruik LangExtract wanneer bronintervallen essentieel zijn en NuExtract wanneer het document zelf de input is. Log deze gevallen voor review. Alleen expliciete, op de bron uitgelijnde spans kunnen gewone Tier 1-trainingsdoelen worden; afgeleide feiten en genormaliseerde waarden hebben eigen doelen en evaluatie nodig.
De CFM-case study geeft één kostenreferentie voor Tier 1: 93,4% F1 bij gerapporteerde $0,10 per uur op CPU, tegenover 92,7% F1 en $8 per uur voor zijn Llama-70B-teacher. Uurprijzen van instances bepalen de kosten per document niet zonder throughput. Bereken opnieuw met je hardware, teacher-model, labelset, benuttingsgraad en reviewkosten.
Afwegingen en beperkingen
Fouten van de LLM-as-teacher planten zich voort. Als de LLM consequent een bepaald entity type fout heeft (bijvoorbeeld dochterbedrijfsnamen verwarren met moederbedrijven), erft de fine-tuned encoder die bias. Review types met lage confidence of inconsistente types zwaar en houd een gestratificeerde willekeurige steekproef aan om zelfverzekerde systematische fouten te vangen.
Een geldig schema kan onjuiste feiten bevatten. Native structured output, Instructor en constrained decoders kunnen een response parseerbaar maken. Ze kunnen niet garanderen dat elk veld verankerd is, dat een spangrens klopt of dat een genormaliseerde waarde naar het juiste record mapt. Bewaar bronbewijs en valideer de semantiek apart.
Quantization-verliezen hangen af van het checkpoint en de lagen die je quantizet. Het quantizen van elke MatMul-laag van het GLiNER van de companion gaf geen entities terug; de FFN-down-projecties in FP32 houden behield de recall in de controle met 32 zinnen. Een ander checkpoint kan andere gevoelige lagen hebben. Vergelijk het gequantizede en het oorspronkelijke model op exact-span F1 en recall per label vóór deployment.
Wanneer de architectuur met drie tiers overdreven is. Eén domein met stabiele entity types en genoeg gelabelde voorbeelden heeft misschien alleen een fine-tuned RoBERTa of een spaCy-pipeline nodig. Het patroon met drie tiers past bij meerdere domeinen, evoluerende entity types of een gemeten mix van expliciete en redeneerintensieve extractie. Een smalle factuurpipeline die namen en datums extraheert, kan bij Tier 1 stoppen.
De kwaliteit van de bi-encoder varieert per dataset en checkpointgrootte. Op CoNLL-2003 haalt gliner_small-v2.5 65,4% F1, meer dan de bi-encoders edge/small met 61,6%/64,2%, maar minder dan bi-base/large met 65,6%/66,5% (Stepanov et al., 2026, tabellen 2–3). Kies op basis van gemeten exact-span-kwaliteit, calibration, aantal labels en throughput op je domeinset.
PII- en meertalige claims vereisen slices. Een hoge totaalscore kan een gevaarlijk recallverlies verbergen voor een locale, naamvorm, documentlayout of zeldzame PII-klasse. Gebruik een privacymodel als één van meerdere controles, stel een proces in voor het afhandelen van false negatives en evalueer opnieuw wanneer de taxonomie, de taalmix of de databron verandert.
Belangrijkste punten
- Gebruik een compacte encoder voor expliciete spans pas nadat hij een domeintestset doorstaat, met support per type en betrouwbaarheidsintervallen.
- Gebruik GLiNER voor wisselende labelvocabulaires. Vergelijk eerst zijn bi-encoder wanneer een grote typeset wordt hergebruikt; schakel
flat_ner=Falsepas in nadat je hebt gecontroleerd dat het checkpoint de binnenste spans vindt. - Gebruik spaCy of een fine-tuned token classifier wanneer de labels stabiel zijn en je trainingsdata hebt.
- Gebruik geteste typebeschrijvingen voor hard zero-shot-claims en test Engelse en gelokaliseerde labelformuleringen apart voor meertalige producten.
- Houd OCR, NER, relation extraction en entity linking als afzonderlijke evaluatiestappen, ook wanneer één model meerdere taken biedt.
- Behandel een LLM-teacher als een systeem dat annotaties voorstelt. Menselijke richtlijnen, beslechting van meningsverschillen, onveranderlijke regressiesets en een held-out testset blijven vereist.
- Gebruik native schema’s voor ondersteunde LLM-providers, maar valideer semantische juistheid en bronverankering apart van JSON-geldigheid.
- Verander telkens één runtimestap: eerst ONNX FP32, daarna INT8 met de gevoelige lagen in FP32, met een spanvergelijking na elke stap.
Referenties
Papers
- GLiNER: Generalist Model for Named Entity Recognition using Bidirectional Transformer - Zaratiana et al., NAACL 2024. De fundamentele architectuur voor span-entity-matching.
- GLiNER2: An Efficient Multi-Task Information Extraction System with Schema-Driven Interface - Zaratiana et al., EMNLP 2025 System Demonstrations. Verenigt NER, classificatie en hiërarchische extractie; huidige releases voegden later relation extraction toe.
- GLiNER Bi-Encoder: Scalable Named Entity Recognition with Bi-Encoder Architecture - Stepanov et al., februari 2026. Ontkoppelde encoding voor schaal met miljoenen labels.
- GLiNER-Relex: A Unified Framework for Joint Named Entity Recognition and Relation Extraction - Stepanov et al., 2026. Gezamenlijke, zero-shot extractie van entities en relaties.
- GLiNER2-PII: A Multilingual Model for Personally Identifiable Information Extraction - Zaratiana et al., 2026. 42 PII-types op karakterspan-resolutie.
- ZeroNER: Fueling Zero-Shot Named Entity Recognition via Entity Type Descriptions - Cocchieri et al., ACL 2025. Hard zero-shot-evaluatie met typebeschrijvingen.
- OpenNER 1.0: Standardized Open-Access Named Entity Recognition Datasets in 50+ Languages - Palen-Michel et al., EMNLP 2025. 36 corpora, 52 talen en baselines voor meerdere ontologieën.
- FiNERweb: Datasets and Artifacts for Scalable Multilingual Named Entity Recognition - Golde et al., EACL 2026. Meertalige labels en evaluatie van transfer.
- UniversalNER: Targeted Distillation from Large Language Models for Open Named Entity Recognition - Zhou et al., ICLR 2024. Universele LLM-gebaseerde NER via destillatie van ChatGPT.
- NuNER: Entity Recognition Encoder Pre-training via LLM-Annotated Data - Bogdanov et al., EMNLP 2024. Onderzoekt een encoder van 125M die is gepretraind op LLM-annotaties.
Industriepapers
- EAMT: Entity-Aware Multi-Task Learning for Query Understanding - Walmart, KDD 2023. Multitask query understanding met ongeveer 60 NER-labels.
- TripleLearn: End-to-End NER for E-Commerce Search - Home Depot, AAAI 2021. F1 van 69.5 naar 93.3.
- CyNER: A Python Library for Cybersecurity Named Entity Recognition - Neurale herkenning gecombineerd met andere extractiebronnen.
- CyberNER: A Harmonized STIX Corpus for Cybersecurity NER - 21 entity types afgestemd op STIX 2.1.
- FinBERT-MRC: Financial NER via Machine Reading Comprehension - MRC-formulering geëvalueerd op Chinese financiële datasets.
Case studies
- CFM Case Study: Fine-tuning GLiNER for Financial NER - De LLM-labelingpipeline van Capital Fund Management van $70 die 93,4% F1 haalt.
- Refuel AI: LLM Labeling Technical Report - GPT-4 haalt 88,4% annotatie-overeenstemming, meer dan menselijke annotators.
- Sease: GLiNER as an Alternative to LLMs for Query Parsing - Waar GLiNER faalt en LLMs nog nodig zijn.
- John Snow Labs: Medical Text De-Identification Benchmark - Leveranciersstudie met label-remapping en uitsluitingen.
- OpenMed: Year in Review 2025 - Open medische NER-models; terugblik van januari 2026.
Tools en frameworks
- ner-field-guide demo repo - Companion-code bij dit artikel: exacte span-scoring, GLiNER-voorbeelden, conversie van gereviewde annotaties, ONNX FP32- en INT8-controles en een streaming PII-demo.
- GLiNER - Library, trainingsscript en Ray Serve-pad met dynamic batching en deployment met meerdere replica’s.
- gline-rs: Rust reimplementation of GLiNER - Rust-inference over GLiNER ONNX-bestanden; code onder Apache 2.0.
- spaCy English pipelines - Geversioneerde metrics van closed-label-pipelines.
- dslim/bert-base-NER - BERT token classifier, fine-tuned op CoNLL-2003.
- Microsoft Presidio - PII-analyse en anonimisering met eigen recognizers.
- Instructor - Gestructureerde LLM-extractie via Pydantic-models.
- Outlines - Constrained tokengeneratie via FSMs, met een gerapporteerde benchmark voor schemaconformiteit.
- LangExtract - Aan de bron verankerde gestructureerde extractie met karakterintervallen.
- NuExtract - Zelfgehoste documentextractie van schema naar template.
- OpenAI Structured Outputs - Referentie voor het strikte JSON-schema-responseformaat.
- Anthropic Structured Outputs - JSON-outputs en strikte tool-inputs.
- Gemini Structured Outputs - Subset van JSON Schema voor gestructureerde responses.
- ONNX Runtime quantization - Referentie voor dynamische en statische INT8-quantization.
- AWS: Structured Output with Outlines - Benchmark van 98% schemaconformiteit.