Przewodnik po NER 2026: GLiNER, spaCy, Transformers i LLM

Tłumaczenie automatyczne
Ten artykuł został automatycznie przetłumaczony z angielskiego oryginału.
Ten przewodnik jest dla inżynierów, którzy wybierają rozpoznawanie nazwanych encji (NER) do potoków wyszukiwania, ochrony prywatności lub przetwarzania dokumentów. Wyjaśnia, jak wybierać między rozpoznawaniem spanów a ustrukturyzowaną ekstrakcją przez LLM, jak oceniać ich błędy i jak sprawdzać opcje wdrożenia pod kątem opóźnień i kosztów, na jakie pozwala Twoje obciążenie.
NER zamienia tekst w oznaczone fragmenty, z których może korzystać program. Dla zdania „Bill Gates founded Microsoft on April 4, 1975” może zwrócić ciągłe spany tekstu Bill Gates, Microsoft i April 4, 1975 z typami person, organization i date. W encoderze opartym na spanach, takim jak GLiNER, model czyta tekst raz i ocenia spany-kandydaty względem podanych etykiet.
W potoku wyszukiwania lub ochrony prywatności najpierw zapytałbym, czy wynik musi być dosłowną wzmianką. Ta decyzja oddziela rozpoznawanie spanów od systemów, które dodatkowo normalizują wartości, łączą rekordy lub wnioskują o faktach. LLM nadal przydają się do proponowania adnotacji treningowych i do obsługi przypadków, które wymagają wnioskowania lub normalizacji.
Repozytorium towarzyszące: ner-field-guide zawiera dokładne liczenie wyniku dla spanów, przykłady GLiNER, konwersję zweryfikowanych adnotacji, testy ONNX FP32 i INT8 oraz demo strumieniowego wykrywania PII.
Krótkie porównanie modeli znajdziesz w Best NER Models in 2026.
Czym jest rozpoznawanie nazwanych encji?
Rozpoznawanie nazwanych encji (NER) znajduje w tekście spany i przypisuje im typy, takie jak person, organization, date, product lub etykiety specyficzne dla domeny. Span to ciągły fragment oryginalnego tekstu. NER identyfikuje wzmiankę; entity linking to osobny krok, który przypisuje ją do kanonicznego rekordu lub pojęcia z ontologii.
| Obciążenie | Pierwszy model do przetestowania | Kiedy przejść wyżej |
|---|---|---|
| Identyfikatory lub kontrolowane słowniki | Reguły lub spaCy EntityRuler | Liczy się recall poza znanymi wzorcami. |
| Stałe etykiety i dużo danych treningowych | spaCy lub fine-tuningowany encoder | Zestaw etykiet się zmienia albo recall dla rzadkich typów stoi w miejscu. |
| Zmienne etykiety; mały inwentarz typów | GLiNER cross-encoder | Inwentarz rośnie albo etykiety są używane w wielu dokumentach. |
| Duży, wielokrotnie używany inwentarz typów | GLiNER bi-encoder | Na zbiorze domenowym spada jakość lub kalibracja. |
| Kilka zadań ekstrakcji w jednym potoku tekstu | GLiNER2.5 | Jakość łącznego modelu nie osiąga celu dla poszczególnych zadań. |
| Fakty ukryte lub rozumowanie o schemacie | Ustrukturyzowana ekstrakcja przez LLM | Opóźnienie, koszt lub nieuzasadnione twierdzenia przekraczają budżet produktu. |
GLiNER cross-encoder czyta nazwy etykiet razem z tekstem, więc każdy dokument ponownie koduje każdą etykietę. Bi-encoder koduje etykiety osobno i może je buforować. GLiNER2.5 to osobna rodzina modeli, która z jednego schematu wydobywa encje, klasy, relacje i pola ustrukturyzowane. Każdy z nich ma poniżej własną sekcję.
Idąc po tej liście od góry, wybierz pierwszy pasujący punkt. Pytania mają kolejność, w jakiej bym je zadał:
- Wynik nie jest dosłownym spanem: użyj ustrukturyzowanego wyniku LLM.
- Identyfikatory lub stały słownik: użyj reguł albo EntityRuler.
- Stałe etykiety i dość danych treningowych: użyj spaCy lub BERT-NER.
- Duży zestaw etykiet używany w wielu dokumentach: użyj GLiNER bi-encodera.
- W pozostałych przypadkach: użyj modelu GLiNER cross-encoder i wypróbuj GLiNER2.5, gdy potrzebujesz kilku zadań w jednym przebiegu.
Gdzie nowoczesne systemy używają NER
NER nadal znajduje w tekście spany i przypisuje im etykiety. Zmieniło się jego miejsce w systemie. Dostarcza teraz filtry dla RAG, ustrukturyzowane argumenty dla narzędzi agentów i pola dla potoków przetwarzania dokumentów. Przy takich zastosowaniach opóźnienie, koszt i elastyczność schematu liczą się tak samo jak dokładność w benchmarkach.
RAG: lepsze wyszukiwanie dzięki ekstrakcji encji
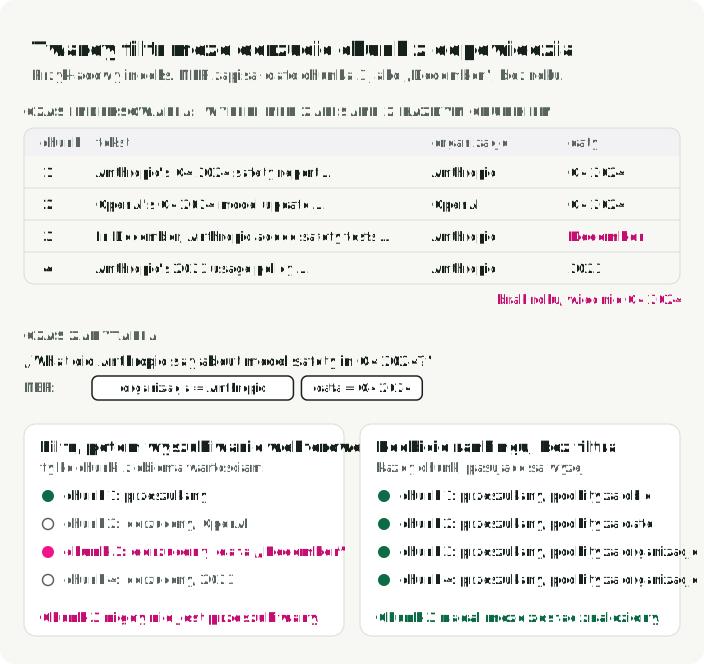
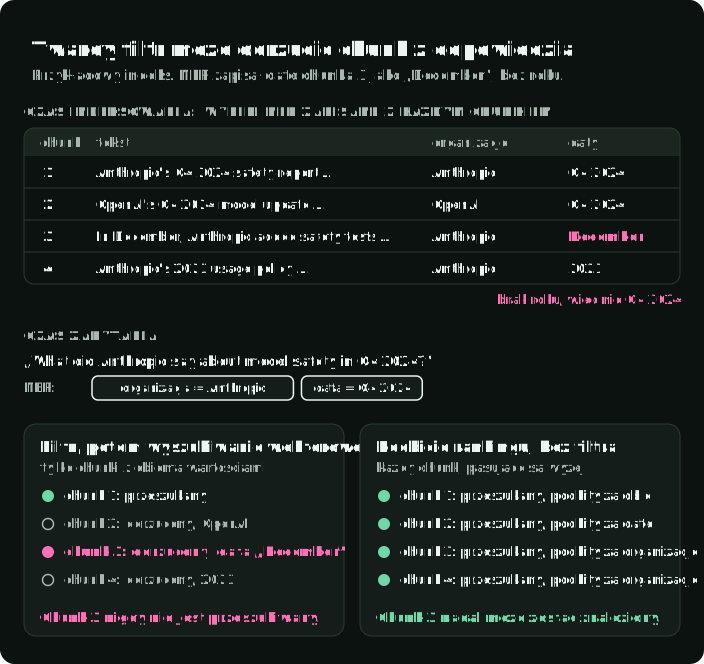
Samo wyszukiwanie podobieństwa zawodzi, gdy pytanie zawiera dokładne encje. Dla pytania „what did Anthropic say about model safety in Q4 2024?” ekstrakcja encji może zaproponować „Anthropic” i „Q4 2024” jako filtry. Twardy filtr stosuj tylko wtedy, gdy zaindeksowane metadane i semantyka dat go uzasadniają; w przeciwnym razie użyj go jako sygnału rankingowego albo zachowaj ścieżkę wyszukiwania bez filtra. Pominięty alias lub błędnie wywnioskowany zakres dat może wykluczyć odpowiedź.
Podczas indeksowania wydobywasz encje z każdego chunka i zapisujesz je jako metadane: {"organizations": ["Anthropic"], "dates": ["Q4 2024"], ...}. Dzięki temu możesz filtrować po encji przed wyszukiwaniem wektorowym. Knowledge graph RAG (GraphRAG, grafy właściwości w LlamaIndex) dodaje nazwane relacje, po których wyszukiwanie może przejść przez kilka skoków.
Diagram pokazuje przykładowy indeks z czterema chunkami. Porównaj dwa panele na dole: twardy filtr nigdy nie przeszukuje chunka, którego zapisana data nie ma roku, a podbicie rankingu nadal go przeszukuje.
W czasie zapytania encje wydobyte z pytania użytkownika sterują routingiem. Pytanie z nazwą firmy trafia do indeksu finansowego, a pytanie z nazwami leków do klinicznej bazy wiedzy. GLiNER przydaje się, gdy schemat zapytania lub typy encji zmieniają się w czasie działania. Same nowe nazwy firm lub leków nie wymagają etykiet z otwartym słownikiem; model ze stałym zestawem etykiet nadal rozpozna nowe wzmianki znanych typów.
Agenci AI: zamiana tekstu w ustrukturyzowane fakty
Agenci otrzymują nieustrukturyzowany tekst, na przykład strony internetowe, odpowiedzi API i wiadomości użytkowników. NER zamienia ten tekst w ustrukturyzowane fakty, o których agent może rozumować, które może zapisać lub przekazać narzędziom.
Przy routingu do narzędzi prośba „schedule a meeting with Sarah Chen from Accenture on Thursday at 2pm” może dać PERSON: Sarah Chen, ORGANIZATION: Accenture, DATE: Thursday i TIME: 2pm. Resolver kalendarza łączy potem datę i godzinę w znacznik czasu wymagany przez API. Lokalny encoder eliminuje wywołanie sieciowego API, ale jego opóźnienie zależy od modelu, środowiska uruchomieniowego, sprzętu, rozmiaru batcha i liczby etykiet.
NER wspiera też śledzenie encji w rozmowach. Systemy pamięci agenta muszą wiedzieć, że „Sarah” w turze 3 i „Ms. Chen” w turze 12 to ta sama osoba. NER wskazuje spany; rozwiązywanie koreferencji rozstrzyga, czy wzmianki w danym kontekście dotyczą tej samej osoby. Entity linking przypisuje potem tę osobę do kanonicznego rekordu, jeśli taki istnieje.
W obu przypadkach ograniczeniem jest opóźnienie. Jeśli każdy z dziesięciu kolejnych kroków wykonuje wywołanie NER trwające 200 ms, te wywołania dodają 2 sekundy odczuwalnego opóźnienia. Jedno wywołanie dodaje 200 ms. Modele typu encoder zwykle lepiej mieszczą się w pętlach agenta niż ekstrakcja oparta na LLM.
Inteligencja dokumentów: od obrazów do danych ustrukturyzowanych
OCR zamienia obrazy w tekst. NER zamienia ten tekst w pola ustrukturyzowane.
Standardowy potok najpierw używa OCR, na przykład Tesseract, Azure Document Intelligence lub AWS Textract, by uzyskać tekst i ramki ograniczające. Potem NER znajduje spany dla pól takich jak invoice_number, vendor_name, total i due_date. Krok schematu lub ekstrakcji relacji musi pogrupować opisy pozycji, ilości i ceny w line_items. Ta sama sekwencja dotyczy umów, dokumentacji medycznej i dokumentów regulacyjnych.
Każdy etap ma własny wynik. Błąd OCR, który gubi cyfrę, wygląda jak pominięcie przez NER, jeśli oceniasz tylko końcowy rekord.
| Etap | Co daje | Wynik |
|---|---|---|
| OCR i układ | Tekst, kolejność czytania, ramki | Odsetek błędnych znaków |
| NER | invoice_number, vendor_name, total | F1 dla dokładnych spanów |
| Grupowanie | Pozycje (opis, ilość, cena w każdym wierszu) | F1 rekordu |
| Linkowanie i normalizacja | ID dostawcy, daty ISO, kwoty | Dokładność linkowania lub normalizacji |
Nowoczesne potoki dokumentów mogą łączyć rozumienie układu, ekstrakcję encji i ekstrakcję relacji. Tekst, kolejność czytania, tabele i ramki ograniczające nadal dostarcza OCR lub model dokumentów świadomy układu. Obecny GLiNER2.5 udostępnia encje, relacje, klasyfikację i rekordy ustrukturyzowane przez jeden interfejs schematu; oceniaj każdy wynik osobno.
O większości takich potoków decyduje koszt. Wyceń swój przy rzeczywistej miesięcznej liczbie dokumentów, wraz z ponowieniami i przeglądem. Kompaktowy encoder może działać na CPU, a LLM przez API dodaje koszt inferencji i opóźnienie na dokument. Praktyczny test: oznacz reprezentatywny zbiór faktur za pomocą LLM. Wykonaj fine-tuning GLiNER na zweryfikowanych rekordach, a potem porównaj obie ścieżki pod względem F1 na poziomie pól, opóźnienia i łącznego kosztu.
Wykrywanie PII i guardrails dla LLM
Przepisy o prywatności, takie jak RODO, HIPAA i CCPA, wymagają zabezpieczeń danych osobowych, ale nie wymagają NER. NER może znajdować dane osobowe do maskowania lub minimalizacji; zanim uznasz go za środek kontroli, sprawdź jego recall na własnych danych.
Modele deidentyfikacji znajdują spany PERSON, SSN, PHONE, EMAIL i ADDRESS i albo je maskują, albo zastępują syntetycznymi odpowiednikami. Microsoft Presidio łączy rozpoznawacze z operatorami anonimizacji, a jego przykłady zawierają GLiNER jako rozpoznawacz. Innym kandydatem jest GLiNER2-PII o 0,3 mld parametrów: jego artykuł obejmuje 42 typy PII z rozdzielczością do znaku.
W porównaniu prowadzonym przez firmę John Snow Labs 48 dokumentów z adnotacjami ekspertów obejmuje sześć klas PHI. Etykiety dostawców zmapowano ponownie, a niemożliwe do zmapowania predykcje wykluczono, co ogranicza możliwość porównywania między dostawcami. Raport Providence opisuje 281 zdarzeń wycieku PHI w przeglądzie 1000 notatek zawierających 34 701 zdań. Zdarzenia to nie to samo co odrębne dotknięte zdania: w ocenie prywatności licz zarówno wycieknięte wystąpienia, jak i dotknięte dokumenty.
W guardrails dla LLM NER działa jako warstwa wstępnej kontroli: skanuje dane wejściowe użytkownika pod kątem PII przed wysłaniem do zewnętrznego API, a potem blokuje je lub anonimizuje.
Lokalny detektor może być szybszy niż prośba do LLM o samomoderację, ale fałszywe negatywy nadal są możliwe, więc dodaj kolejną kontrolę dla ekspozycji PII, której system nie może zaakceptować. GLiNER przydaje się tu, bo kategorie PII różnią się w zależności od jurysdykcji. API może przyjąć nową etykietę, taką jak „genetic information”, bez ponownego trenowania. Recall dla tej nowej etykiety jest nieznany, dopóki nie sprawdzisz go na zweryfikowanych przykładach.
GLiNER: dopasowanie spanów do etykiet w NER z otwartym słownikiem
GLiNER (NAACL 2024, Zaratiana i in.) sprawił, że NER oparty na encoderach dorównuje LLM przy ułamku kosztów. Zamiast traktować NER jako etykietowanie sekwencji lub generowanie tekstu, GLiNER traktuje go jako problem dopasowania. Ocenia każdy kandydujący span tekstu (każdą ciągłą sekwencję słów, jak „Bill Gates” lub „Microsoft”) względem każdej etykiety typu encji, a potem zachowuje pary z wysokim wynikiem.
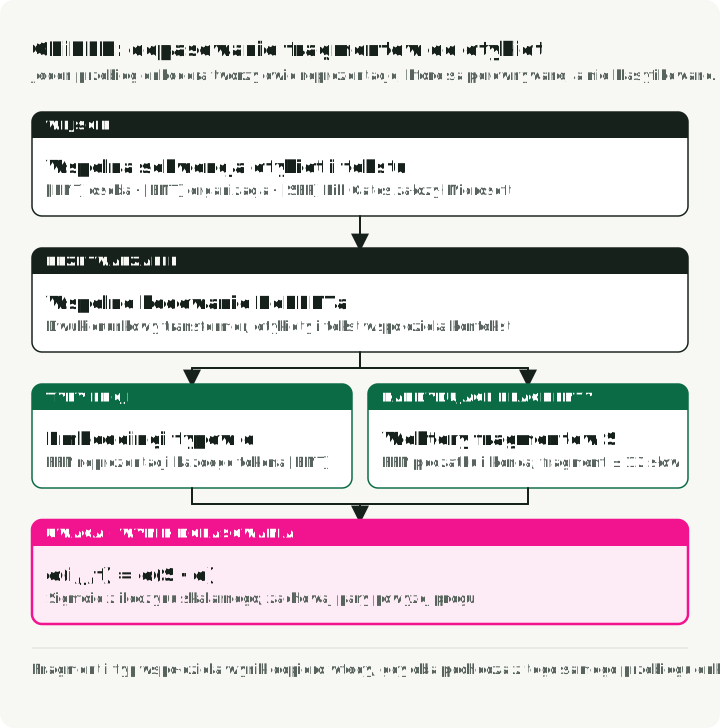
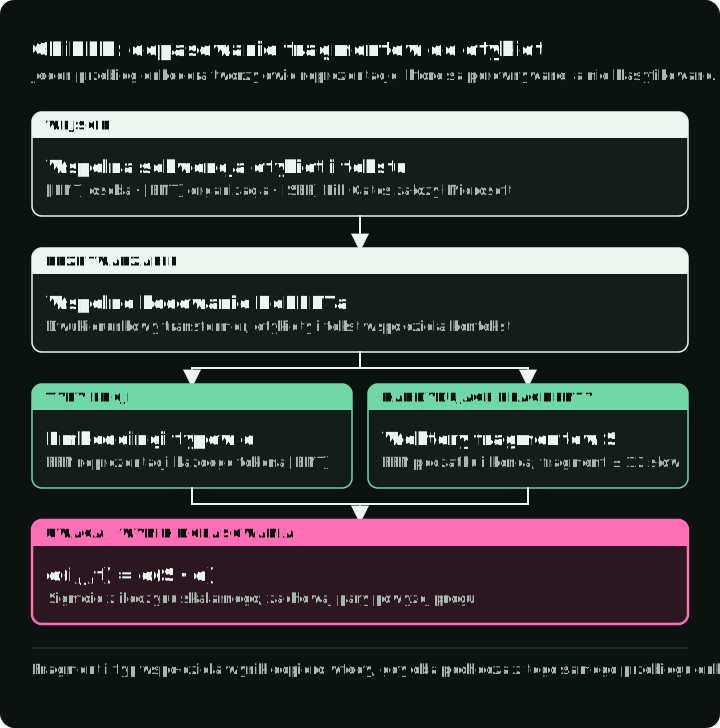
Model przyjmuje etykiety typów encji i tekst wejściowy jako jedną sekwencję: [ENT] person [ENT] organization [ENT] date [SEP] Bill Gates founded Microsoft.... Dwukierunkowy transformer (DeBERTa-v3) koduje wszystko razem.
Z wyjścia model buduje dwa zestawy reprezentacji. Jeden doprecyzowuje reprezentację każdego typu encji z pozycji jednostki token [ENT] przez małą sieć feed-forward (FFN), która przekształca wektor encodera. Drugi reprezentuje spany, łącząc wektory pierwszego i ostatniego słowa przez kolejną FFN. Iloczyn skalarny reprezentacji spanu i reprezentacji typu encji daje wynik.
Po zastosowaniu sigmoidy dostajesz prawdopodobieństwo, że span od pozycji słowa do pozycji słowa należy do typu encji : . Tu to wektor spanu wytworzony przez FFN, a to doprecyzowany przez FFN embedding typu encji z odpowiadającej jednostki token [ENT] (Zaratiana i in., 2024, równ. 1–2). Kandydackie spany są ograniczone do 12 słów; tokenizer może podzielić słowo na kilka jednostek token dla podsłów.
GLiNER przyjmuje w czasie inferencji opisy etykiet w języku naturalnym bez ponownego trenowania, ale jakość ekstrakcji zależy od sformułowania etykiety i dopasowania do domeny. Podajesz typy encji, takie jak „person”, „adverse drug reaction” lub „financial instrument”, a model ocenia względem nich spany. Konfiguracje 50M, 90M i 300M poniżej to modele z oryginalnego artykułu. Karta modelu v2.1 wymienia natomiast angielskie warianty checkpoint 166M, 209M i 459M oraz wielojęzyczny checkpoint 209M, wszystkie na licencji Apache 2.0. Nie porównuj opóźnień ani zużycia pamięci między tymi generacjami tak, jakby nazwy parametrów oznaczały to samo (karta modelu GLiNER v2.1).
W prawdziwym teście hard zero-shot wyłącz z danych treningowych zarówno docelowe typy, jak i docelowe przykłady: model nie ma żadnych oznaczonych przykładów dla zadania docelowego. Opis typu, taki jak „a medically confirmed adverse effect caused by a treatment”, daje modelowi więcej informacji niż samo adverse event. To nie gwarantuje transferu, ale ZeroNER oparty na opisach przewyższył punkty odniesienia oparte na samych nazwach w testach z wyłączonymi typami (Cocchieri i in., 2025).
Dane treningowe oryginalnego modelu pochodziły ze zbioru Pile-NER: 44 889 fragmentów z 240 tys. spanów encji w 13 tys. typów encji, wszystkie oznaczone przez ChatGPT. Trenowanie GLiNER-L zajęło około 5 godzin na jednym A100 (Zaratiana i in., 2024).
Wyniki benchmarków
Wyniki zero-shot z Zaratiana i in. (2024), tabele 1 i 2. F1 łączy precision i recall w jeden wynik; wyższy wynik jest lepszy tylko przy tym samym zadaniu i tych samych regułach oceny. Średnia z siedmiu zbiorów łączy pięć zbiorów CrossNER z MIT Movie i MIT Restaurant:
| Model | Parametry | Śr. F1 (CrossNER + MIT) | Śr. F1 (20 zbiorów) |
|---|---|---|---|
| GLiNER-L | 300M | 60.9% | 47.8% |
| GoLLIE | 7B | 58.0% | — |
| UniNER-13B | 13B | 55.6% | — |
| GLiNER-M | 90M | 55.4% | — |
| UniNER-7B | 7B | 53.7% | 45.7% |
| GLiNER-S | 50M | 52.7% | — |
| ChatGPT (GPT-3.5) | — | 47.5% | 36.5% |
GLiNER-M z 90M parametrów prawie dorównuje UniNER-13B w średniej z siedmiu zbiorów z artykułu (55,4% vs. 55,6% F1), używając około 140 razy mniej parametrów. GLiNER-S z 50M przewyższa raportowany wynik ChatGPT (GPT-3.5) o 5 punktów F1. Wariant wielojęzyczny, trenowany wyłącznie na danych angielskich, przewyższa ten sam punkt odniesienia ChatGPT w 8 z 10 języków innych niż angielski (Zaratiana i in., 2024). Te porównania używają wersji modeli i środowiska oceny z artykułu; nic nie mówią o nowszych LLM.
Minimalne wywołanie GLiNER
W nowym porównaniu modeli cross-encoder uwzględnij utrzymywane warianty checkpoint GLiNER v2.5 obok v2.1. W sprawdzeniu z repozytorium towarzyszącego na 32 zdaniach z Few-NERD, publicznego zbioru NER, gliner_small-v2.5 znalazł 44 z 54 spanów wzorcowych, a gliner_medium-v2.1 znalazł 39. Ta próbka jest zbyt mała, by uszeregować oba modele, ale to powód, by uwzględnić v2.5 we własnym teście. GLiNER v2.5 i Fastino GLiNER2.5 (poniżej) to różne rodziny modeli.
Poniższe wywołanie ładuje średni checkpoint v2.1 i wypisuje każdy span z jego wynikiem. Wersja z repozytorium towarzyszącego to ner_demo/quickstart.py.
from gliner import GLiNER

model = GLiNER.from_pretrained("urchade/gliner_medium-v2.1")
text = "Bill Gates founded Microsoft on April 4, 1975."
labels = ["person", "organization", "date"]
entities = model.predict_entities(text, labels, threshold=0.5)

for entity in entities:
    print(f"{entity['text']} => {entity['label']} ({entity['score']:.3f})")
# Bill Gates => person (0.994)
# Microsoft => organization (0.973)
# April 4, 1975 => date (0.951)Bi-encoder: skalowanie do NER z milionem etykiet
Oryginalny GLiNER koduje etykiety i tekst razem. Łączne kodowanie robi się coraz droższe, bo tekst etykiet zajmuje kontekst i musi być kodowany ponownie przy każdym dokumencie. Punkt przecięcia zależy od wybranego wariantu checkpoint, opisów etykiet i sprzętu. Gdy ten sam duży inwentarz typów jest używany w wielu dokumentach, jako domyślne porównanie wybierz GLiNER bi-encoder. Dzieli on kodowanie tekstu i etykiet na dwa osobne transformery (Stepanov i in., 2026).
Rysunek porównuje oba projekty na przykładzie trzech dokumentów. W ścieżce modelu cross-encoder wszystkie etykiety wchodzą do encodera z każdym dokumentem. W ścieżce bi-encodera encoder etykiet działa raz, jego wektory są buforowane, a dla każdego dokumentu działa tylko encoder tekstu. Wykres pod nimi pokazuje koszt przepustowości przy 1024 etykietach.
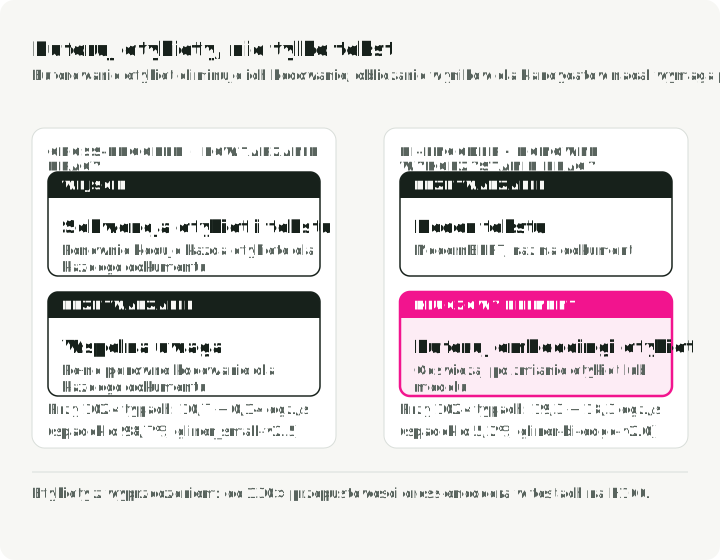
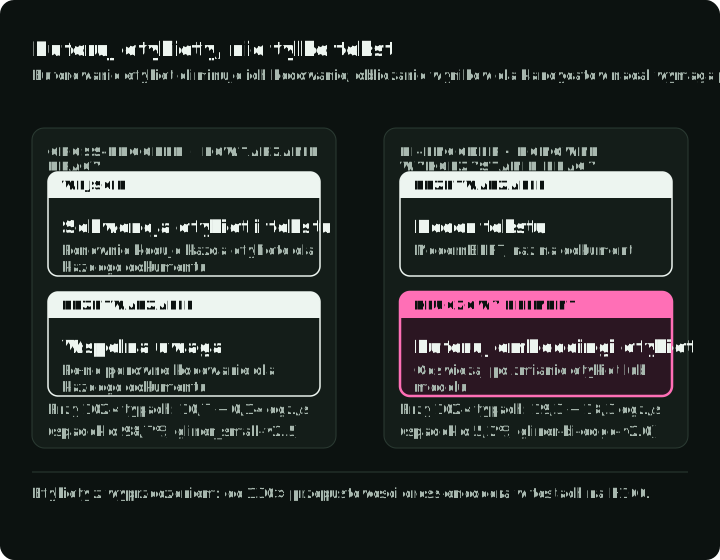
Encoder tekstu używa ModernBERT (rodzina Ettin), a encoder etykiet używa sentence transformers (BGE lub MiniLM). Spany i etykiety są oceniane przez iloczyn skalarny. Ten podział oznacza, że wektory embeddings typów encji można obliczyć raz i zbuforować. W czasie inferencji zbuforowane etykiety oszczędzają ponowne kodowanie etykiet. Ocena spanów-kandydatów względem tych etykiet nadal wymaga mocy obliczeniowej i pamięci; aplikacja z milionem etykiet potrzebuje też ograniczonego wyboru kandydatów lub batchowania, z pomiarem recallu dla etykiet odrzuconych przed oceną.
Dostępne są cztery rozmiary modelu, wszystkie testowane na CrossNER (Stepanov i in., 2026, tabela 1):
| Model | Parametry | Śr. F1 (CrossNER + MIT) | Przepustowość (H100) | Z wstępnie obliczonymi etykietami |
|---|---|---|---|---|
| gliner-bi-edge-v2.0 | 60M | 54.0% | 13.64 ex/s | 24.62 ex/s |
| gliner-bi-small-v2.0 | 108M | 57.2% | 7.99 ex/s | 15.22 ex/s |
| gliner-bi-base-v2.0 | 194M | 60.3% | 5.91 ex/s | 9.51 ex/s |
| gliner-bi-large-v2.0 | 530M | 61.5% | 2.68 ex/s | 3.60 ex/s |
Przy 1024 typach encji bi-encoder gliner-bi-edge-v2.0 z wstępnie obliczonymi etykietami traci tylko 5,2% przepustowości w porównaniu z jedną etykietą (19,3 → 18,3 ex/s). Porównywalny cross-encoder gliner_small-v2.5 traci 98,7% (10,7 → 0,14 ex/s). W testach z artykułu na jednym H100, z batchem o rozmiarze 1 i wejściami po 64, 256 i 512 jednostek token, bi-encoder ze wstępnie obliczonymi etykietami osiąga do 130× większą przepustowość niż gliner_small-v2.5. Przy 100 typach encji na jednym H100 bi-encoder przetwarza 1,96 mln predykcji dziennie wobec 368 tys. dla modelu cross-encoder (Stepanov i in., 2026).
Artykuł o bi-encoderze podaje 61,5% dla gliner-bi-large-v2.0 wobec 60,9% dla gliner_large-v2.5 w tej samej średniej CrossNER plus MIT, więc na tym benchmarku bi-encoder nie wymienia dokładności na szybkość. Autorzy polecają bi-base-v2.0 (194M) jako najlepszy kompromis rozmiaru: 98% dokładności modelu large przy 2,6 razy większej szybkości (Stepanov i in., 2026).
Pomiary czasu kończą się na 1024 etykietach, przy użyciu H100, batcha o rozmiarze jeden i dziesięciu przebiegów w przód na konfigurację. Nie mierzą wdrożonej usługi z milionem etykiet. Artykuł wymienia jako jedno z zastosowań entity linking w dużych bazach wiedzy, takich jak Wikidata; entity linking jest dostępny w frameworku Knowledgator GLiNKER.
Kod koduje zestaw etykiet raz i używa tych wektorów embeddings dla każdego tekstu. Dla trzech poniższych etykiet zwraca te same trzy spany co wywołanie modelu cross-encoder powyżej.
from gliner import GLiNER

model = GLiNER.from_pretrained("knowledgator/gliner-bi-base-v2.0")

# Pre-compute embeddings for a reused label set; rebuild this cache when labels or the checkpoint change.
entity_types = ["person", "organization", "date"]  # Small example; large inventories need bounded candidate selection
entity_embeddings = model.encode_labels(entity_types, batch_size=8)

# Encode text and score spans against the cached labels
texts = ["Bill Gates founded Microsoft on April 4, 1975."]
outputs = model.batch_predict_with_embeds(texts, entity_embeddings, entity_types)GLiNER2 i GLiNER2.5: jeden schemat dla kilku zadań
Oryginalny ekosystem GLiNER rozdzielał NER, ekstrakcję relacji, klasyfikację i ekstrakcję na poziomie dokumentu między osobne modele. Artykuł GLiNER2 z EMNLP 2025 połączył NER, klasyfikację i hierarchiczną ekstrakcję w jednym modelu o 205M parametrów; obecne wydania dodały później do tego samego interfejsu schematu ekstrakcję relacji.
Ta architektura z 2025 roku zachowuje projekt modelu cross-encoder, ale rozszerza kontekst do 2048 jednostek token (4 razy więcej niż w oryginale) i dodaje deklaratywne schematy do definiowania zadań ekstrakcji. Trening wykorzystuje 135 698 prawdziwych dokumentów z adnotacjami GPT-4o oraz 118 636 przykładów syntetycznych (Zaratiana i in., 2025).
W zero-shot CrossNER GLiNER 2 osiąga 0,590 F1, blisko 0,599 GPT-4o w benchmarku z artykułu z połowy 2025 roku. W klasyfikacji uzyskuje średnio 0,72 w 7 benchmarkach, wobec 0,69 dla DeBERTa-v3-large. Na CPU artykuł podaje opóźnienie klasyfikacji 130-208 ms dla testowanych liczb etykiet. Zero-shotowy punkt odniesienia DeBERTa potrzebuje jednego przebiegu w przód na każdą etykietę kandydującą i rośnie z 1714 ms dla 5 etykiet do 16 897 ms dla 50; to nie jest czas działania nadzorowanego klasyfikatora DeBERTa (Zaratiana i in., 2025).
Poniższy przykład ładuje GLiNER2.5, późniejszy checkpoint, więc wyniki z 2025 roku powyżej go nie opisują. GLiNER2.5 (194M parametrów) przewiduje pozycje początku i końca spanu zamiast oceniać każdy span. Jego okno ma 4096 jednostek token, więc dłuższe dokumenty dziel na zachodzące na siebie chunki za pomocą pomocnika z biblioteki i sprawdź, czy zwrócone offsety odpowiadają pełnemu tekstowi. Załaduj go przez AutoExtractor, jak poniżej.
from gliner2 import AutoExtractor

# Requires `pip install gliner2[local]` and downloads the checkpoint.
extractor = AutoExtractor.from_pretrained("fastino/gliner2.5-base-v1")

# Compose tasks through the current schema interface
schema = (extractor.create_schema()
    .entities({"person": "Names of people", "company": "Organization names"})
    .classification("sentiment", ["positive", "negative", "neutral"])
    .relations(["works_for", "founded", "located_in"])
    .structure("product_info")
        .field("name", dtype="str")
        .field("price", dtype="str"))
text = "Acme launched a $19 widget in Berlin."
results = extractor.extract(text, schema)
Artykuł z EMNLP ocenia tylko NER i klasyfikację. Nie podaje benchmarku hierarchicznej ekstrakcji i nie obejmuje późniejszego API relacji. Jeden model wykonujący cztery zadania może nadal osiągać niższy wynik w każdym z nich niż cztery wyspecjalizowane modele, więc porównuj każde zadanie z jego własnym punktem odniesienia.
Inne warianty GLiNER do konkretnych potrzeb
Rodzina GLiNER ma teraz kilka architektur poza modelem cross-encoder, bi-encoderem i GLiNER2.5. Każda odpowiada na jedną potrzebę:
| Potrzeba | Kandydat | Co sprawdzić |
|---|---|---|
| Encje i relacje w jednym przebiegu | GLiNER-Relex | F1 dla spanów i relacji na tych samych dokumentach. |
| Lokalny kandydat do PII | GLiNER2-PII | Recall według języka, formatu dokumentu i typu PII. |
| Wielojęzyczny kandydat z otwartym słownikiem | GLiNER-X | Jakość w każdym języku; jego karta wymienia 23 języki. |
| Typy generowane lub zmienne | GLiNER Decoder | Czy wygenerowane typy są stabilne i użyteczne dalej w potoku. |
| Strumieniowe maskowanie PII | GLiNER Streaming PII | Wycieknięte znaki przed wydaniem, nie tylko recall końcowych spanów. |
Wyniki GLiNER-Relex i GLiNER2-PII pochodzą z ich własnych artykułów i środowisk oceny. GLiNER-X i GLiNER Decoder mają karty modeli, a nie recenzowane benchmarki, więc ich liczby nie są porównywalne z artykułami powyżej.
Strumieniowe PII zmienia moment, w którym można wydać tekst
GLiNER Streaming PII dodaje przyrostowe wykrywanie z przyczynowym backbone Qwen3-0.6B i buforowanym stanem sesji. Jego API zwraca cały bieżący zrzut sesji z offsetami w zgromadzonym tekście. Zachowuj granice chunków, trzymaj stałe etykiety do pełnego ponownego obliczenia i czyść zakończone sesje.
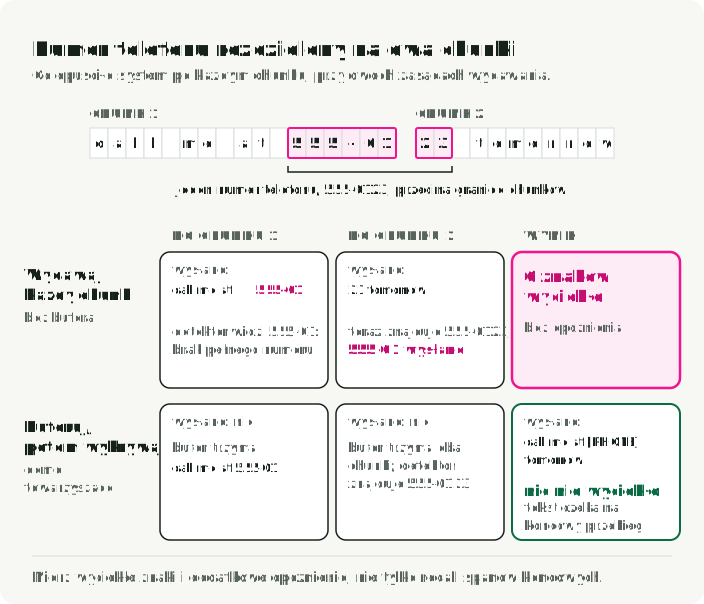
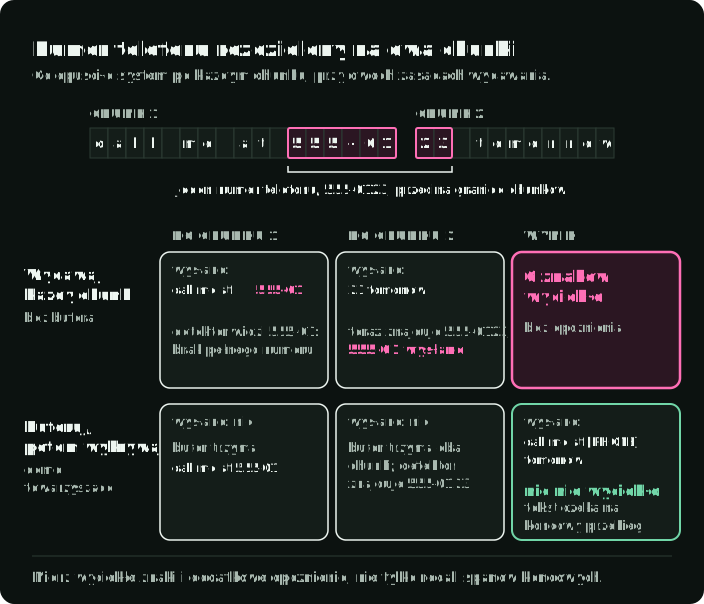
Przy strumieniowym maskowaniu buforowałbym niewydany tekst i testował encje podzielone między chunki. Znalezienie numeru telefonu po wysłaniu jego pierwszej połowy nie cofnie tych bajtów. Mierz wycieknięte znaki przed wydaniem i dodane opóźnienie, a nie tylko recall końcowych spanów. Karta modelu podaje F2 maskowania PIIMB osobno od ścisłego F1 typowanych spanów; odpowiadają one na różne pytania. Karta podaje też słabsze wyniki wielojęzyczne, więc wydany checkpoint nie jest uniwersalnym filtrem prywatności.
Rysunek dzieli jeden numer telefonu na dwa chunki. Przy wydawaniu chunk po chunku pierwsza połowa wychodzi, zanim dotrze druga. Przy buforowaniu detektor widzi cały numer, a wychodzi tylko zamaskowany tekst. ner_demo.streaming z repozytorium towarzyszącego trzyma cały tekst do końcowego przebiegu wykrywania, a potem wydaje go z zamaskowanymi wykrytymi spanami.
Alternatywy ze stałymi etykietami: spaCy i fine-tuningowany klasyfikator dla jednostek token
Gdy zestaw etykiet jest stały i masz dane z adnotacjami, otwarte etykiety GLiNER nie są potrzebne. Model wytrenowany na tym zestawie etykiet jest punktem odniesienia, który trzeba pobić.
Wytrenowane potoki spaCy (en_core_web_sm, en_core_web_trf) rozpoznają stały zestaw typów encji (PERSON, ORG, GPE, DATE i inne) zdefiniowany w czasie treningu. Rozszerzenie wytrenowanego komponentu ner wymaga oznaczonych przykładów i treningu. Dla identyfikatorów lub kontrolowanego słownika EntityRuler dodaje własne etykiety przez wzorce bez ponownego trenowania; jego recall poza tymi wzorcami wynosi zero. Karta modelu en_core_web_trf 3.8.0 podaje 90,19 NER F1 na OntoNotes 5.0, ale tylko dla jego 18 predefiniowanych typów (karta modelu spaCy).
Przykład dodaje wzorzec tickera przed wytrenowanym komponentem ner, więc reguła przejmuje $AAPL jako pierwsza, a model etykietuje resztę:
import spacy

nlp = spacy.load("en_core_web_trf")
ruler = nlp.add_pipe("entity_ruler", before="ner")
ruler.add_patterns([{"label": "TICKER", "pattern": [{"TEXT": "$"}, {"TEXT": {"REGEX": r"^[A-Z]{1,5}$"}}]}])

doc = nlp("Tim Cook said Apple ($AAPL) will open an office in Berlin in March 2027.")
print([(ent.text, ent.label_) for ent in doc.ents])
# [('Tim Cook', 'PERSON'), ('Apple', 'ORG'), ('$AAPL', 'TICKER'), ('Berlin', 'GPE'), ('March 2027', 'DATE')]
Przy stałych etykietach i reprezentatywnych oznaczonych spanach nadzorowanym punktem odniesienia jest fine-tuningowany klasyfikator dla jednostek token, taki jak BERT, RoBERTa lub DeBERTa. pipeline z Hugging Face ładuje go jedną linią. dslim/bert-base-NER, stały encoder w ewaluacji z repozytorium towarzyszącego, został wytrenowany na CoNLL-2003, więc jego etykiety są ustalone na PER, ORG, LOC i MISC. Data w tym samym zdaniu nie zostaje znaleziona, bo model nie ma etykiety daty:
from transformers import pipeline

ner = pipeline("token-classification", model="dslim/bert-base-NER", aggregation_strategy="simple")
for ent in ner("Tim Cook said Apple will open an office in Berlin in March 2027."):
    print(ent["word"], ent["entity_group"], round(float(ent["score"]), 3))
# Tim Cook PER 1.0
# Apple ORG 0.998
# Berlin LOC 0.999
Aby uzyskać własne etykiety, wykonaj fine-tuning takiego modelu na swoich oznaczonych spanach. Porównaj go ze spaCy i GLiNER pod względem F1 dla dokładnych spanów, recallu dla każdej etykiety, kalibracji, opóźnienia i kosztu na tym samym zbiorze domenowym.
Moja rekomendacja: używaj spaCy lub fine-tuningowanego klasyfikatora dla jednostek token dla standardowych lub stałych typów encji, gdy masz dane treningowe. Używaj GLiNER, gdy potrzebujesz elastycznych typów zero-shot lub gdy potok musi się dostosowywać bez ponownego trenowania. Mogą współdzielić potok: spaCy obsługuje tokenizację i podział na zdania, a GLiNER ekstrakcję encji.
Licencje wariantów checkpoint są częścią wyboru modelu
Modele z tego przewodnika nie mają jednej licencji. Przed wdrożeniem sprawdź warunki dotyczące kodu, wag i danych dla konkretnego wariantu checkpoint:
| Wydanie | Opublikowana licencja | Praktyczna konsekwencja |
|---|---|---|
| GLiNER v2.1, GLiNER v2.5 i GLiNER bi | Apache 2.0 | Liberalne warunki z karty modelu; nadal sprawdź zależności i dane. |
| GLiNER2, GLiNER2.5 i GLiNER2-PII | Apache 2.0 | Potwierdź wybrany checkpoint, nie tylko bibliotekę. |
spaCy en_core_web_trf i dslim/bert-base-NER | MIT | Liberalna; korpusy treningowe mają własne warunki. |
| UniNER-7B-all | CC BY-NC 4.0 | Nie używaj w ścieżce komercyjnej bez osobnego zezwolenia. |
| NuNER | MIT | Wydany model i zbiór danych podają warunki MIT. |
Oznaczenia licencji nie są poradą prawną. Przegląd produkcyjny musi obejmować warunki modelu bazowego, danych treningowych i dostawców.
LLM jako nauczyciele: studium przypadku za $70 i potok do wdrożenia
Wzorzec LLM-as-teacher oddziela drogą adnotację od tańszej inferencji: LLM raz oznacza dane treningowe, a mały encoder wytrenowany na tych etykietach obsługuje każde żądanie. Dwa artykuły badawcze pokazały, że małe modele mogą nauczyć się NER z etykiet LLM, a dwa opublikowane studia przypadków pokazują, jak zespoły to zastosowały.
Badania stojące za tym wzorcem: UniNER i NuNER
UniNER (ICLR 2024, Zhou i in.) oraz NuNER (EMNLP 2024, Bogdanov i in.) destylują adnotacje LLM do mniejszych modeli NER, ale nie zgadzają się co do tego, jak małe mogą być.
UniNER wykonuje fine-tuning LLaMA-7B/13B na 45 889 parach wejście-wyjście wygenerowanych przez ChatGPT. Dla każdego typu encji model odpowiada na pytanie „What describes [type] in the text?” i zwraca listy JSON. Kluczowy trik treningowy: negatywne próbkowanie oparte na częstości podnosi F1 z 31,5% do 53,4% (Zhou i in., 2024).
UniNER-7B osiąga 41,7% F1 zero-shot w 43 zbiorach, pokonując 34,9% ChatGPT o 7 punktów. Wariant 13B osiąga 43,4%, czyli tylko 1,7 punktu więcej przy niemal dwukrotnie większej liczbie parametrów (Zhou i in., 2024).
Kompromis w produkcji: konfiguracja typu UniNER z wyższym wynikiem w artykule odpytuje każdy typ encji po kolei. Jej wariant all-in-one używa jednej odpowiedzi, ale wypadł średnio o 3,3% gorzej. W FP16 checkpoint 7B potrzebuje około 14 GB tylko na wagi; kwantyzacja do mniejszej liczby bitów może ten rozmiar zmniejszyć. Checkpoint UniNER-7B-all jest niekomercyjny (zobacz tabelę licencji powyżej).
NuNER zaczyna od RoBERTa-base (125M parametrów) i używa treningu kontrastowego na 4,38 mln adnotacji GPT-3.5 obejmujących 200 tys. pojęć. Po treningu encoder pojęć jest odrzucany; encoder tekstu pasuje do dowolnego standardowego potoku NER jako zamiennik RoBERTa (Bogdanov i in., 2024).
Tabela 3 w NuNER podaje około 6,1–16,2 punktu przewagi nad RoBERTa w makro-średnim F1 klasyfikacji jednostek token z zamrożonymi encoderami i liniowymi głowicami, w czterech zbiorach i dla próbkowanych rozmiarów treningu (Bogdanov i in., 2024).
Oba artykuły pokazują, że mniejszy model może uczyć się z adnotacji LLM. Żaden nie pokazuje, że uczeń pokonuje nauczyciela w nowej domenie, dlatego poniższy potok zachowuje osobno zweryfikowany zbiór testowy.
Studium przypadku CFM
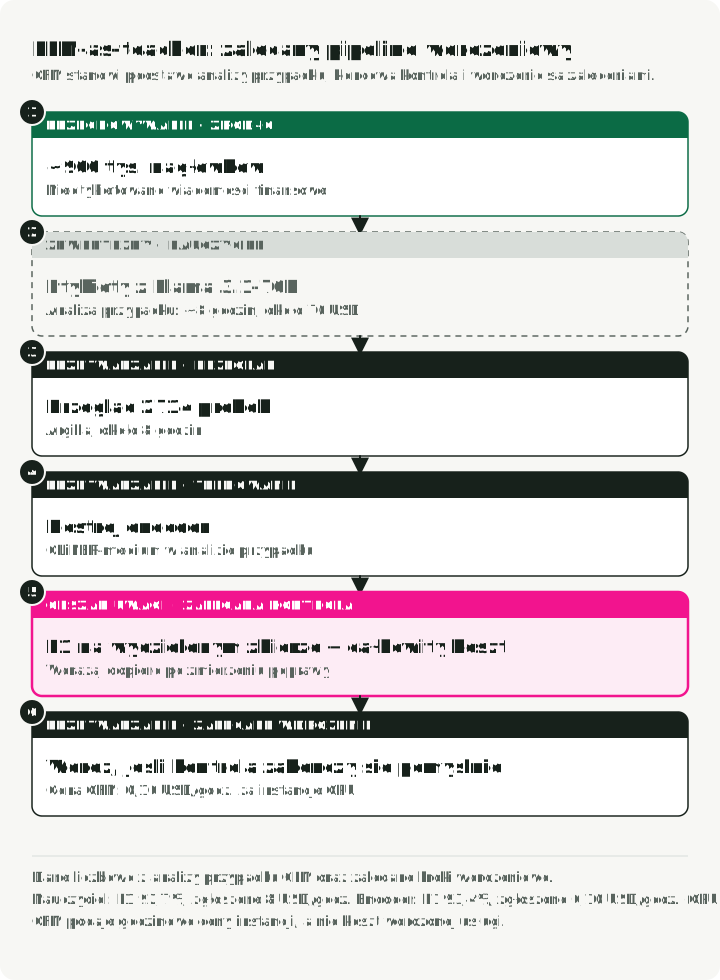
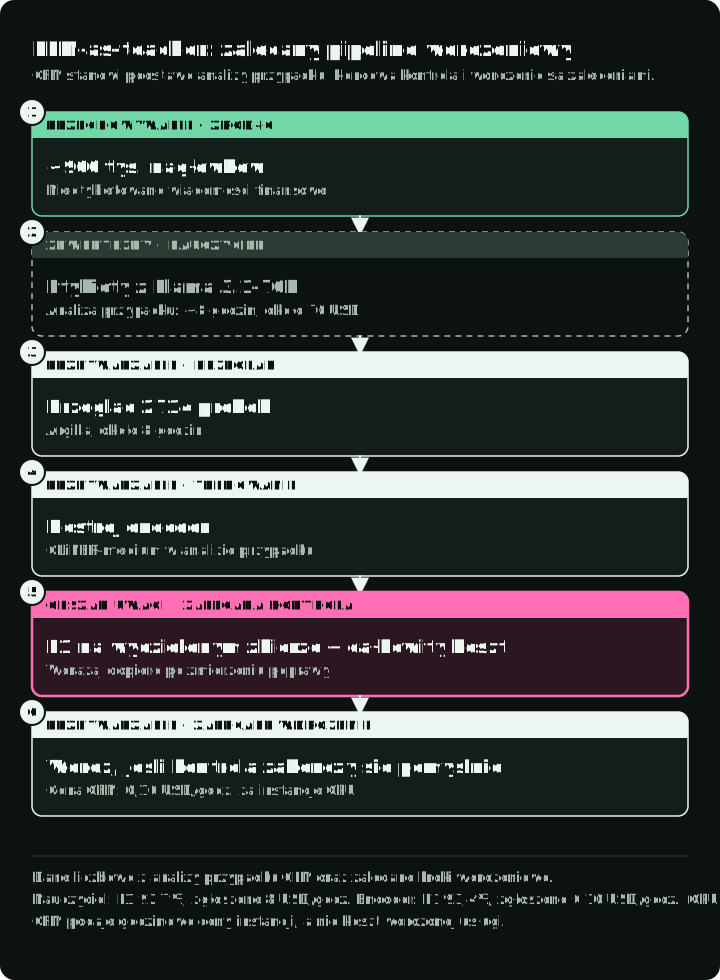
W studium przypadku Hugging Face Capital Fund Management wydobywało nazwy firm z około 900 000 nagłówków wiadomości finansowych. Zero-shotowy GLiNER osiągnął 87,0% F1. Zespół użył Llama 3.1-70B do oznaczenia zbioru w około 8 godzin za około $70, a potem przejrzał 2714 próbek przez Argilla w kolejnych 8 godzinach.
Fine-tuning GLiNER na tych danych dał w studium przypadku 93,4% F1, wobec 92,7% nauczyciela Llama-70B. Autorzy podają $0,10 za godzinę na CPU dla modelu po procesie fine-tuning i $8 za godzinę dla nauczyciela (studium przypadku CFM). Te liczby opisują jedno zadanie z wiadomościami finansowymi i jedną konfigurację infrastruktury.
Badanie Refuel AI
Raport techniczny firmy Refuel AI, będącej dostawcą, porównuje etykietowanie przez LLM w 8 zbiorach NLP, w tym CoNLL-2003. Podaje 88,4% zgodności z prawdą wzorcową dla GPT-4 (marzec 2023) i 86,2% dla ludzkich adnotatorów w jego konfiguracji, a także 20 razy szybsze i 7 razy tańsze etykietowanie. Osobny eksperyment z zespołem modeli na danych własnościowych przekroczył 95% zgodności, a jego najlepszy pojedynczy LLM osiągnął 89%. Routing oparty na pewności do tańszych lub mocniejszych modeli jest proponowanym zastosowaniem, a nie zmierzonym mechanizmem stojącym za wynikiem z ośmiu zbiorów (raport techniczny Refuel AI).
Potok produkcyjny
Praktyczny przepływ produkcyjny ma sześć kroków. Diagram umieszcza każdy krok na ścieżce tego, kto go wykonuje, z liczbami CFM i pętlą powrotną do przeglądu, gdy uczeń nie osiąga celu. Wykres pod nim porównuje F1 i godzinowy koszt CFM dla nauczyciela i ucznia.
- Napisz wytyczne adnotacji w języku naturalnym.
- Utwórz zbiory deweloperski i wydzielony zbiór testowy oznaczone przez ludzi. Sekcja o ewaluacji poniżej podaje procedurę ustalania ich rozmiaru.
- Użyj LLM z wersjonowanym tekstem prompt i jawnym schematem wyjścia, by zaproponować zbiorcze etykiety treningowe. Zachowaj zażądany i faktyczny model, prompt oraz tekst źródłowy. Odrzucaj nieznane typy i spany, których nie da się dopasować do źródła.
- Przejrzyj podzbiór przez Argilla lub Label Studio.
- Wykonaj fine-tuning kompaktowego encodera (GLiNER, SpanMarker, RoBERTa). Dla GLiNER użyj
train.pyz repozytorium (python train.py --config configs/config.yaml) albo metodytrain_model()modelu, ze zweryfikowanym plikiem treningowym jako danymi treningowymi i plikiem deweloperskim do oceny w trakcie treningu. - Wdrażaj dopiero po tym, jak encoder przejdzie kontrolę jakości na wydzielonym zbiorze oraz kontrolę łącznego kosztu. CFM podało w swojej konfiguracji 16-80x niższy godzinowy koszt infrastruktury; w swoim porównaniu uwzględnij koszty adnotacji, przeglądu, serwowania i ponownego trenowania.
LLM może zmniejszyć ilość ręcznej adnotacji, ale zespół nadal odpowiada za zbiór walidacyjny, wytyczne adnotacji, celowany przegląd i analizę błędów.
Repozytorium towarzyszące pokazuje jedną propozycję nauczyciela i konwertuje sprawdzone adnotacje dla kroku 5 (sekcja README). Uruchom te polecenia w tym repozytorium z Pythonem 3.11+, uv i zależnościami zainstalowanymi przez uv sync --locked --all-extras. Ustaw OPENAI_API_KEY dla płatnego wywołania nauczyciela. Konwersja wymaga plików przypiętego modelu GLiNER i jego backbone w pamięci podręcznej; uv run --all-extras python -m ner_demo.quickstart --download pobiera je jednorazowo.
-
Uruchom demonstrację nauczyciela dla jednego dokumentu. Wykonuje jedno płatne żądanie dla stałego zdania o proponowanym przejęciu Arm przez NVIDIA i zapisuje jeden niesprawdzony rekord w
artifacts/teacher_annotations.jsonl:uv run --all-extras python -m ner_demo.teacher --allow-paid -
Sprawdź propozycję ręcznie i rozstrzygnij odrzucone adnotacje. Przygotuj
artifacts/reviewed.jsonlze sprawdzonymi dokumentami treningowymi oraz oddzielnie oznaczonymi przez ludzi dokumentami walidacyjnymi i testowymi z powyższego procesu produkcyjnego. Wszystkie trzy podzbiory muszą być niepuste, identyfikatory dokumentów muszą być unikalne, a żaden tekst źródłowy nie może wystąpić w więcej niż jednym podzbiorze. Nie kopiuj zdania demonstracyjnego pomiędzy podzbiorami. W każdym rekordzie ustawreviewed: true,reviewer,status: "ok"orazsplit(train,developmentlubtest) i zachowaj zgodnośćsource_sha256z tekstem źródłowym. Jeden rekord demonstracyjny nie może dostarczyć wszystkich trzech podzbiorów. -
Przekonwertuj kompletny zweryfikowany plik. Zapisuje
train.json,development.jsonitest.jsonwartifacts/training/w formacie treningowym GLiNER, po przepuszczeniu każdego wiersza przez własny data collator GLiNER:uv run --all-extras python -m ner_demo.training artifacts/reviewed.jsonl
Przekaż train.json i development.json do procesu fine-tuning GLiNER w kroku 5, a test.json zachowaj na końcową kontrolę.
Gdzie GLiNER zawodzi, a LLM nadal się przydają
Benchmark Sease (październik 2025) testował GLiNER wobec GPT-4.1-mini na 30 zadaniach parsowania zapytań. GPT-4.1-mini uzyskał 100% w pełni poprawnych wyników. GLiNER uzyskał 53% (16 z 30). Za to GLiNER odpowiadał w 0,08 sekundy wobec 1,21 sekundy LLM, czyli 15 razy szybciej.
W tym benchmarku z 30 zadaniami GLiNER zawodził w trzech powtarzających się wzorcach:
- Encje ukryte: wydobycie „event” z „Elton John performed at Madison Square Garden”. Żaden fragment tekstu nie mówi dosłownie „event”, ale LLM wnioskuje „concert”.
- Wrażliwość na sformułowanie etykiety: „2022” dostaje 0,388 dla „date”, ale 0,958 dla „year”. Małe zmiany etykiety powodują duże wahania wyniku.
- Mapowanie wartości: GLiNER zwraca dokładny tekst z powierzchni („family houses”) zamiast wartości kanonicznej („Single family house”). LLM może wykonać taką normalizację, gdy jego prompt i schemat definiują wartości docelowe.
Encje zagnieżdżone i nakładające się
Encja zagnieżdżona leży wewnątrz innej. W „New York University” „New York” to lokalizacja wewnątrz nazwy organizacji. Tekst biomedyczny („acute myeloid leukemia” w dłuższej diagnozie) i prawniczy (wydział w nazwie organu) mają ten sam wzorzec.
GLiNER domyślnie używa płaskiego dekodowania, które tłumi nakładające się spany. Jego API obsługuje też flat_ner=False, co dopuszcza nakładające się predykcje:
entities = model.predict_entities(
    "She studied at New York University.", ["organization", "location"],
    flat_ner=False, threshold=0.3)
# [{'text': 'New York University', 'label': 'organization', 'score': 0.855, ...}]
Z urchade/gliner_medium-v2.1 to wywołanie zwróciło tylko organizację, nawet przy progu 0,05. Wyłączenie płaskiego dekodowania dopuszcza wynik zagnieżdżony, ale checkpoint nadal musi ocenić wewnętrzny span powyżej progu. Jeśli Twoje dane mają encje zagnieżdżone, zbuduj zagnieżdżony zbiór testowy i sprawdź, czy wewnętrzne spany w ogóle się pojawiają, zanim wybierzesz GLiNER zamiast wyspecjalizowanego modelu NER dla encji zagnieżdżonych.
Używaj GLiNER do jawnej ekstrakcji encji, a przypadki wymagające wnioskowania, rozumowania lub mapowania na predefiniowane ontologie kieruj do LLM. Próg routingu powinien pochodzić z oznaczonego zbioru domenowego.
Ewaluacja NER: metryki, pułapki i zbiory testowe
Każda liczba w tym przewodniku pochodzi z modelu, danych i sprzętu swojego źródła. Zanim wybierzesz, powtórz porównanie na własnym oznaczonym zbiorze. Ta sekcja wyjaśnia, jak ten zbiór zbudować i ocenić.
Model może osiągnąć 95% F1 na wyselekcjonowanym zbiorze testowym i mimo to zawieść na mieszance dokumentów, jaką widzi po wdrożeniu. Zbuduj zbiór ewaluacyjny z rozkładu produkcyjnego i zachowaj wycinki dla rzadkich formatów i typów encji, które zagregowane F1 może ukryć.
Podstawowe metryki
Identyfikuj każde wystąpienie przez ID dokumentu, półotwarte offsety początku i końca oraz typ, i sprawdź, że text[start:end] odtwarza wzmiankę. Dwa wystąpienia „John” to dwa cele. Rysunek ocenia trzy predykcje dla jednego zdania.
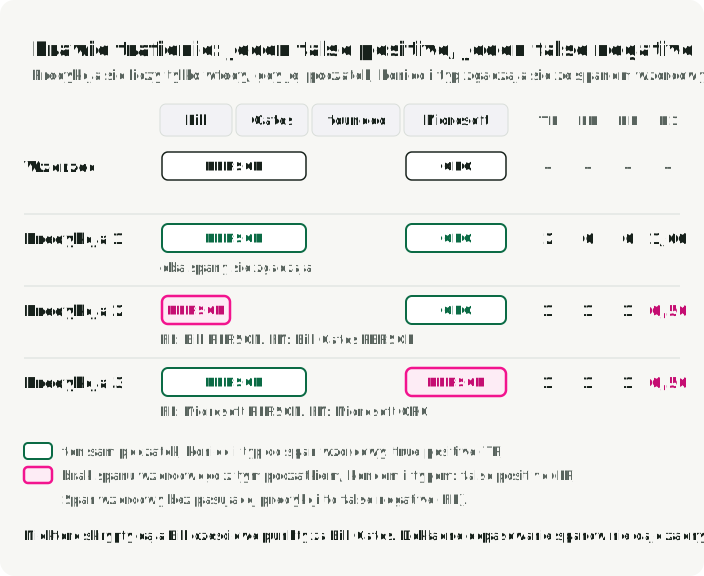
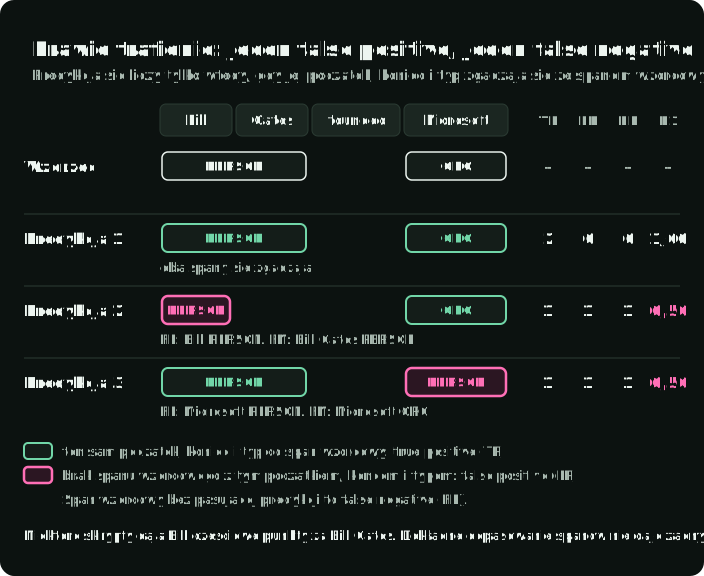
Zweryfikuj liczby dokumentów przed dopasowaniem: brakujące predykcje muszą tworzyć false negatives, a nie znikać przez zip(). Błędny typ lub offsety licz jako niedopasowaną predykcję i niedopasowany span wzorcowy. Raportuj micro precision, recall i F1, wsparcie i recall dla każdego typu oraz zdefiniuj agregację makro i przypadki puste. Dokładny ewaluator z repozytorium towarzyszącego implementuje te reguły i zostawia brakujące, nieudane i pominięte dokumenty w mianowniku wzorca.
- F1 na poziomie encji: Standardowa metryka. Predykcja jest poprawna tylko wtedy, gdy zarówno granice spanu, jak i typ dokładnie zgadzają się z prawdą wzorcową. Tak raportuje większość artykułów.
- F1 na poziomie jednostek token: Ocenia każdy token niezależnie. Może sprawić, że częściowa granica wygląda lepiej niż w wyniku dla dokładnych spanów, więc gdy liczy się poprawność granic, raportuj F1 dla dokładnych spanów; metryk na poziomie jednostek token używaj tylko wtedy, gdy decyzja dalej w potoku jest podejmowana na poziomie jednostek token.
- Precision a recall: Mają często asymetryczne koszty. W deidentyfikacji ważniejszy jest recall: pominięcie nazwiska jest gorsze niż nadmierne maskowanie. W ekstrakcji do bazy danych ważniejszy jest precision: fałszywe wpisy psują dalszą analizę.
Typowe pułapki ewaluacji
- Zawyżanie przez częściowe dopasowania: wydobyto „Bill”, gdy etykieta wzorcowa to „Bill Gates”. Niektóre skrypty liczą to jako częściowe dopasowanie. Używaj dopasowania dokładnych spanów, chyba że masz powód, by tego nie robić.
- Pomylenie typu: „Microsoft” poprawnie zidentyfikowany jako span, ale oznaczony PERSON zamiast ORG, powinien dostać zero. Sprawdź, czy Twój kod ewaluacji to obsługuje.
- Wyciek zbioru testowego: Trzymaj duplikaty i prawie-duplikaty rekordów, dokumentów i adnotacji poza zbiorem testowym. Dla twierdzenia o hard zero-shot trzymaj też docelowe typy encji poza treningiem; same powtarzające się ciągi znaków nie są wyciekiem.
- Niekontrolowane teksty prompt dla etykiet: Krótka nazwa typu i przetestowany opis typu to różne dane wejściowe. Wersjonuj opisy etykiet, progi, rewizje wariantów checkpoint i tryb dekodowania razem z wynikiem.
- Twierdzenia zero-shot dla jednego języka: Nie wnioskuj o jakości wielojęzycznej na podstawie angielskiego. OpenNER obejmuje 36 korpusów i 52 języki, a jego punkty odniesienia nie wskazały jednego modelu najlepszego w każdym języku (Palen-Michel i in., 2025). W eksperymentach FiNERweb przejście z etykiet angielskich na etykiety w języku docelowym zmieniało F1 o 0,02–0,09 w zależności od ustawień (Golde i in., 2026). Gdy produkt używa lokalnej terminologii, testuj oba języki etykiet.
- Jeden przebieg jako wynik końcowy: Raportuj zmienność między ziarnami losowymi, gdzie ma to zastosowanie, przeszukiwania progów i powtarzane próbki produkcyjne. Mała liczba przykładów w wycinkach sprawia, że ranking modeli jest niestabilny.
Normalizację, entity linking, grupowanie rekordów i końce relacji oceniaj osobno od ekstrakcyjnego F1. Dla prywatności raportuj wycieknięte wystąpienia i dotknięte dokumenty przyjęte automatycznie, nieuzasadnione maskowanie oraz odsetek kierowany do przeglądu. Dla serwowania raportuj odsetek ukończeń, opóźnienie dokumentu p50/p95, uruchomienia zimne i ciepłe, rozmiary batcha i liczby etykiet, szczytowe zużycie pamięci oraz koszt na przyjęty dokument.
Budowanie domenowego zbioru testowego
Dla ewaluacji produkcyjnej polecam:
- Próbkuj z danych produkcyjnych, nie z wyselekcjonowanych przykładów. Uwzględnij nieuporządkowane dokumenty, które model faktycznie zobaczy.
- Ustal rozmiar zbioru testowego na podstawie pilota. Oznacz pilota liczącego około 50 dokumentów, policz spany wzorcowe dla każdej etykiety i oszacuj bootstrapem recall dla każdej etykiety. Dodawaj dokumenty, aż 95% przedział dla najrzadszej istotnej etykiety będzie węższy niż różnica, którą chcesz wykryć.
- Użyj co najmniej dwóch adnotatorów na podzbiorze kalibracyjnym. Rozstrzygnij rozbieżności i raportuj F1 dla dokładnych spanów między spanami obu adnotatorów. Zgodność pokazuje, gdzie wytyczne są niejednoznaczne; nie jest górną granicą jakości modelu.
- Stratyfikuj według trudności: przypadki łatwe (czysty tekst, standardowe typy) i trudne (niejednoznaczne encje, żargon, zaszumiony tekst).
- Zachowaj wycinki dotyczące prywatności i sprawiedliwości. Dla PII raportuj recall według typu PII, języka, ustawień regionalnych, formatu dokumentu oraz istotnych wycinków demograficznych lub pochodzenia nazwisk. Ogranicz dostęp ewaluatorów do surowego wrażliwego tekstu, ustaw limity retencji i przeglądaj false negatives.
Ciągły NER wymaga niezmiennego zbioru regresji
Taksonomie produkcyjne się zmieniają. Dodawaj nowe typy, nie zmieniając po cichu znaczenia starego typu. Utrzymuj wersjonowany, niezmienny zbiór regresji dla istniejących typów, osobny zbiór testowy dla nowego typu i dziennik zmian wytycznych adnotacji. Przed wymianą wariantu checkpoint raportuj wyniki dla starych i nowych typów osobno. To najprostszy sposób na wykrycie zapominania i dryfu taksonomii.
NER w produkcji w czterech branżach
Każda dziedzina wydobywa co innego i ma inny opublikowany punkt wyjścia. Ostatnia kolumna wskazuje zastrzeżenie, które zmienia to, co testujesz najpierw.
| Dziedzina | Co jest wydobywane | Punkt wyjścia | Zastrzeżenie, które zmienia wybór |
|---|---|---|---|
| Ochrona zdrowia | Nazwiska, daty, ID i inne PHI do deidentyfikacji | Ewaluacje John Snow Labs i Providence powyżej; otwarte medyczne modele NER OpenMed | Raportuj wycieknięte wystąpienia i dotknięte dokumenty, nie tylko F1. |
| Finanse | Wzmianki o firmach w wiadomościach; pola w dokumentach | Studium przypadku CFM dla wiadomości; FinBERT-MRC dla dokumentów (92,78 F1 na ChFinAnn, 96,80 na AdminPunish) | Wyniki FinBERT-MRC dotyczą chińskich dokumentów; testuj osobno angielskie dokumenty SEC, długie dokumenty i encje zagnieżdżone. |
| E-commerce | Typ produktu, marka i atrybuty w zapytaniach | EAMT Walmart (około 60 etykiet NER dla zapytań); TripleLearn Home Depot (F1 na zbiorze wydzielonym 69,5 → 93,3, w produkcji ponad 9 miesięcy) | Metoda TripleLearn to powtarzane rundy nadzoru domenowego; artykuł nie porównuje obecnych architektur. |
| Cyberbezpieczeństwo | Złośliwe oprogramowanie, aktorzy zagrożeń i wskaźniki naruszenia | CyNER (76,66 micro-F1 dla spanów, XLM-RoBERTa-large); CyberNER (21 etykiet STIX 2.1, RoBERTa 0,736 F1) | Tylko zbiory badawcze; zestawy etykiet się różnią, więc przed porównaniem modeli zmapuj je na STIX. |
Optymalizacja wdrożenia: od Pythona do inferencji z mniejszym opóźnieniem
Gdy model przejdzie domenowy zbiór testowy, kolejne pytanie brzmi, jak go serwować. To jest kolejność, w jakiej wypróbowałbym środowiska uruchomieniowe, z kontrolą po każdym kroku. Zmieniaj jedną rzecz naraz, żeby spadek jakości miał jedną przyczynę.
- Serwuj przez PyTorch i Ray Serve.
- Wyeksportuj ONNX FP32 lub uruchom go przez gline-rs. Jeśli spany różnią się od PyTorch, napraw eksport.
- Skwantyzuj do dynamicznego INT8, zostawiając projekcje w dół FFN w FP32.
- Wdrażaj INT8 tylko wtedy, gdy recall dla każdej etykiety mieści się w celu. W przeciwnym razie zostań przy FP32.
Natywne serwowanie GLiNER
Zanim przejdziesz na nowe środowisko uruchomieniowe, przetestuj ścieżkę Ray Serve projektu. gliner[serve] zapewnia dynamiczne batchowanie, dobór rozmiaru batcha z uwzględnieniem pamięci, skalowanie wielu replik i klienta HTTP. Batchowanie i repliki mogą zwiększyć przepustowość przy zachowaniu kodu modelu. Batchowanie dodaje też czas oczekiwania, więc zmierz opóźnienie kolejki i opóźnienie ciepłe przy swoim rozkładzie żądań.
Eksport do ONNX
GLiNER ma natywną konwersję do ONNX, a gotowe przekonwertowane modele są dostępne w Hugging Face (onnx-community/gliner_small-v2.1). Eksport zapisuje graf, konfigurację i tokenizer w jednym katalogu, a ta sama klasa GLiNER wczytuje go z powrotem tym samym wywołaniem predict_entities:
from gliner import GLiNER

model = GLiNER.from_pretrained("urchade/gliner_medium-v2.1")
model.export_to_onnx("onnx/fp32")

onnx_model = GLiNER.from_pretrained("onnx/fp32", load_onnx_model=True)
entities = onnx_model.predict_entities(text, labels, threshold=0.5)
Porównanie ONNX z repozytorium towarzyszącego uruchamia PyTorch, ONNX FP32 i ONNX INT8 na tych samych danych wejściowych i porównuje ich spany. Wymaga Pythona 3.11+ i uv. Polecenie danych pobiera przypięty fragment Few-NERD i zachowuje jego pierwsze 32 zdania, co wystarcza do sprawdzenia eksportu, ale nie do uszeregowania modeli. Quickstart z --download jednorazowo pobiera przypięty checkpoint:
uv sync --locked --all-extras
# Run once if the pinned model files are not cached:
uv run --all-extras python -m ner_demo.quickstart --download
uv run --all-extras python -m ner_demo.data --split test --limit 32
uv run --all-extras python -m ner_demo.onnx_check \
  --dataset artifacts/few-nerd-test.json --output artifacts/onnx-comparison
Użyj nowego katalogu wyjściowego lub --reuse, aby sprawdzić istniejące pakiety. Polecenie kończy się błędem, gdy spany FP32 różnią się od PyTorch albo gdy INT8 traci więcej niż 0,02 micro recall. Na CPU Apple M5 Max ONNX FP32 zwrócił dokładnie te same spany co PyTorch, z opóźnieniem p50 16-19 ms na zdanie wobec 64-66 ms dla PyTorch.
Kwantyzacja INT8
Dynamiczna kwantyzacja INT8 zapisuje wagi jako 8-bitowe liczby całkowite i zmniejsza plik ONNX. W encoderze DeBERTa używanym przez GLiNER kwantyzacja wszystkich warstw nie działa. W repozytorium towarzyszącym kwantyzacja wszystkich warstw MatMul nie zwróciła żadnych encji. Kwantyzacja warstw grupa po grupie wykazała przyczynę: dwanaście projekcji w dół FFN (layer.N/output/dense, druga warstwa liniowa sieci feed-forward każdego bloku encodera) samych w sobie spycha każdy wynik poniżej progu. Pozostawienie tych dwunastu warstw w FP32 to naprawia. Kod kopiuje pakiet FP32 (ze względu na pliki konfiguracji i tokenizera), a potem kwantyzuje całą resztę:
import shutil

import onnx
from onnxruntime.quantization import QuantType, quantize_dynamic

shutil.copytree("onnx/fp32", "onnx/int8")
graph = onnx.load("onnx/fp32/model.onnx", load_external_data=False).graph
keep_fp32 = [n.name for n in graph.node if n.op_type == "MatMul" and "/output/dense/" in n.name and "/attention/" not in n.name]

quantize_dynamic("onnx/fp32/model.onnx", "onnx/int8/model.onnx",
                 weight_type=QuantType.QInt8,
                 op_types_to_quantize=["MatMul", "Gemm", "Gather"],
                 nodes_to_exclude=keep_fp32)
Załaduj onnx/int8 z load_onnx_model=True, tak jak FP32. quantize_package z repozytorium towarzyszącego robi to samo, a potem waliduje pakiet. Na 32 zdaniach Few-NERD (Apple M5 Max, ONNX Runtime 1.24.4) zmierzone wyniki były następujące:
| Ścieżka | Pakiet | Opóźnienie p50 | Micro precision | Micro recall |
|---|---|---|---|---|
| PyTorch | - | 64-66 ms | 0.506 | 0.722 |
| ONNX FP32 | 790 MB | 16-19 ms | 0.506 | 0.722 |
| ONNX INT8 | 353 MB | 13-15 ms | 0.487 | 0.722 |
INT8 zmniejszył pakiet o ponad połowę i zachował recall, ale zmienił spany w 4 z 32 zdań i dodał 3 false positives. W tym przebiegu INT8 opłaca się, gdy ograniczeniem jest pamięć lub rozmiar pakietu; jeśli chodzi o samo opóźnienie, większość zysku dał eksport FP32 do ONNX. Zanim wdrożysz INT8, porównaj recall dla każdej etykiety z FP32 na własnych danych: mniejszy plik nic nie mówi o jakości ekstrakcji. Obecne wskazówki dla GLiNER zalecają trening świadomy kwantyzacji (quantization-aware training), gdy dokładność INT8 musi dorównywać FP32.
gline-rs: reimplementacja w Rust
gline-rs (Apache 2.0) usuwa środowisko uruchomieniowe Pythona ze ścieżki inferencji. Projekt podaje w swoim benchmarku około czterokrotnie wyższą przepustowość na CPU niż Python. Obsługuje modele spanowe i tokenowe, GPU/NPU przez ONNX Runtime, a jako crate jest dostępny na crates.io. Wczytuje eksport ONNX i jego tokenizer.json, na przykład pakiet zapisany powyżej; README projektu pokazuje wywołanie w Rust.
Pakiet fast-gliner udostępnia powiązania z Pythonem przez PyO3.
Które środowisko uruchomieniowe i kiedy
| Ścieżka | Użyj, gdy | Dostępne dowody | Zmierz przed wdrożeniem |
|---|---|---|---|
| Natywny Ray Serve | Chcesz zostać przy Pythonie i dodać batchowanie, repliki | Dokumentacja projektu GLiNER | Opóźnienie kolejki, opóźnienie ciepłe, przepustowość |
| ONNX FP32 | Pierwsza zmiana środowiska na dowolnym sprzęcie | Repozytorium towarzyszące: te same spany co PyTorch, 3,4-4x niższe opóźnienie | Opóźnienie ciepłe, przepustowość i F1 dla dokładnych spanów |
| ONNX INT8 | Ograniczeniem na CPU jest pamięć lub rozmiar pakietu | Repozytorium towarzyszące: 353 MB vs 790 MB, ten sam recall, 3 dodatkowe FP | Recall i precision dla każdej etykiety względem FP32 |
| gline-rs | Musisz usunąć środowisko uruchomieniowe Pythona | Benchmark projektu przy opisanym sprzęcie i konfiguracji | Twój tryb modelu, etykiety, sprzęt i batch |
Ustrukturyzowana ekstrakcja: natywne schematy, Instructor i lokalne dekodery
Gdy potrzebujesz większej elastyczności, niż dają modele typu encoder (encje ukryte, rozumowanie, mapowanie na ontologię), zacznij od natywnego mechanizmu schematów dostawcy. OpenAI obsługuje ścisłe formaty odpowiedzi json_schema, ustrukturyzowane dane wyjściowe Anthropic obsługują wyjścia JSON i ścisłe wejścia narzędzi, a Gemini API obsługuje podzbiór JSON Schema. Wspólny model Pydantic lub Zod może opisywać kontrakt, ale każdy dostawca akceptuje inny podzbiór schematu i inaczej zachowuje się przy odmowach i złożoności.
Zgodność ze schematem czyni parsowanie niezawodnym. Nie dowodzi, że wydobyty span istnieje w tekście źródłowym ani że znormalizowana wartość jest poprawna. Waliduj wartości pól, zachowuj offsety lub cytaty, gdy to możliwe, i oceniaj dokładność semantyczną na oznaczonym zbiorze.
Trzy poniższe biblioteki wymuszają strukturę na różne sposoby. Rysunek przepuszcza przez każdą z nich jedno zdanie: Instructor waliduje i ponawia, Outlines blokuje nieprawidłową etykietę podczas dekodowania, a LangExtract zwraca offsety znaków dla każdego pola.
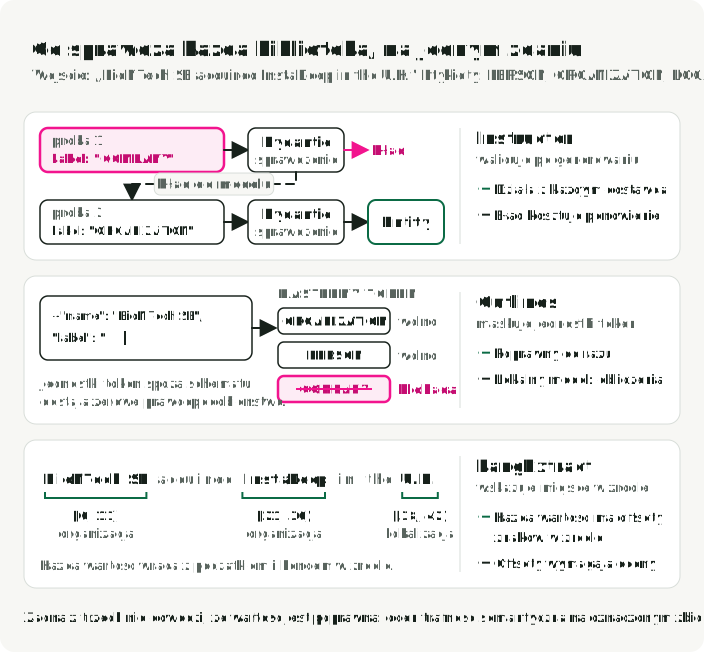
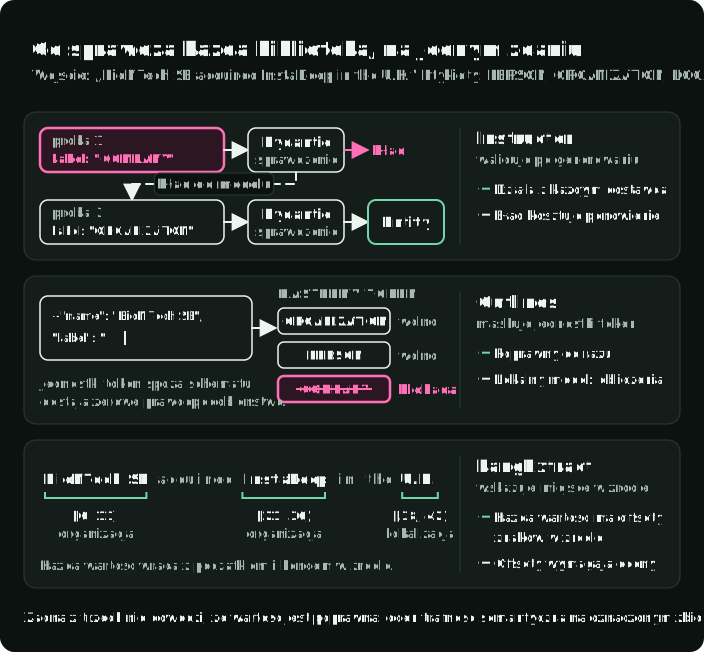
Instructor opakowuje klientów dostawców walidacją Pydantic i opcjonalnymi ponowieniami po błędach walidacji.
Ten samodzielny przykład wymaga pip install instructor openai pydantic, OPENAI_API_KEY i płatnego żądania do dostawcy. Działa tu każdy model z obsługą ustrukturyzowanych danych wyjściowych; przykład używa gpt-5.4-mini, czyli tego samego domyślnego modelu co nauczyciel w repozytorium towarzyszącym.
import instructor
from pydantic import BaseModel
from typing import List, Literal
from openai import OpenAI

class Entity(BaseModel):
    name: str
    label: Literal["PERSON", "ORGANIZATION", "LOCATION"]

class ExtractEntities(BaseModel):
    entities: List[Entity]

client = instructor.from_openai(OpenAI())
result = client.chat.completions.create(
    model="gpt-5.4-mini", reasoning_effort="none",
    response_model=ExtractEntities,
    messages=[{"role": "user", "content": "BioNTech SE acquired InstaDeep in the U.K."}])
# entities=[Entity(name='BioNTech SE', label='ORGANIZATION'), ...]
Outlines firmy dottxt przyjmuje inne podejście: generowanie jednostek token z ograniczeniami przez automaty skończone. Dekoder maskuje jednostki token, które naruszałyby docelową gramatykę, zamiast czekać na błąd walidacji i ponawiać. Przegląd AWS podaje 98% zgodności ze schematem wobec 76% dla walidacji po generowaniu. Powtarza też twierdzenie .txt Engineering o nawet 5 razy szybszym generowaniu, bez wystarczających szczegółów metody, by porównać oba wyniki.
W Outlines outlines.from_transformers opakowuje model Hugging Face i jego tokenizer. Wywołanie tego modelu z tekstem prompt i klasą Pydantic, taką jak ExtractEntities powyżej, zwraca JSON zgodny z klasą. W nowym porównaniu ekstrakcji na własnej infrastrukturze uwzględnij aktualny Qwen3.8-27B lub mniejsze warianty checkpoint Qwen3.5. Ładuj je udokumentowanym loaderem modelu, szablonem czatu i backendem serwowania; architektura multimodalna lub format rozumowania mogą wymagać czegoś więcej niż nowego ID modelu.
LangExtract przydaje się, gdy wygenerowane pole musi być oparte na źródle: zwraca przedziały znaków i obsługuje hostowane lub lokalne backendy LLM. Do ekstrakcji dokumentów na własnej infrastrukturze NuExtract konwertuje schematy JSON na szablony i zawiera multimodalne modele dokumentów. Oba to systemy ustrukturyzowanej ekstrakcji, a nie proste zamienniki NER opartego na spanach: ich wyniki dla pól, offsetów i układu wymagają własnych metryk.
Wybór zależy od tego, gdzie uruchamiasz modele. Natywne schematy to ścieżka o najmniejszym tarciu dla obsługiwanego dostawcy. Instructor dodaje niezależną od dostawcy warstwę walidacji Pydantic i ponowień. Outlines ogranicza lokalne generowanie względem schematu. LangExtract stawia na oparcie w źródle, a NuExtract celuje w ekstrakcję dokumentów na własnej infrastrukturze. Wszystkie ścieżki LLM nadal obejmują generowanie autoregresyjne, więc zwykle trwają dłużej na dokument niż encoder na tym samym sprzęcie.
Trzywarstwowa architektura produkcyjna
Produkcyjny NER kierowałbym według kształtu zadania, a nie według jednego rankingu modeli. Każdy wiersz rysunku pokazuje przykładowe żądanie, to, co wraca, oraz modele do przetestowania. Zweryfikowane przypadki z warstwy 3 wracają do warstwy 1 tylko jako spany znalezione w źródle.
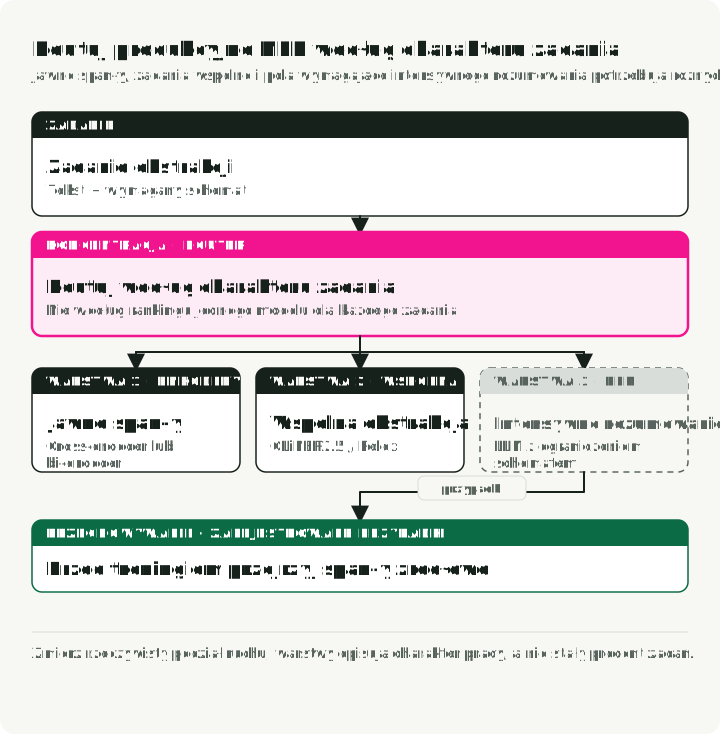
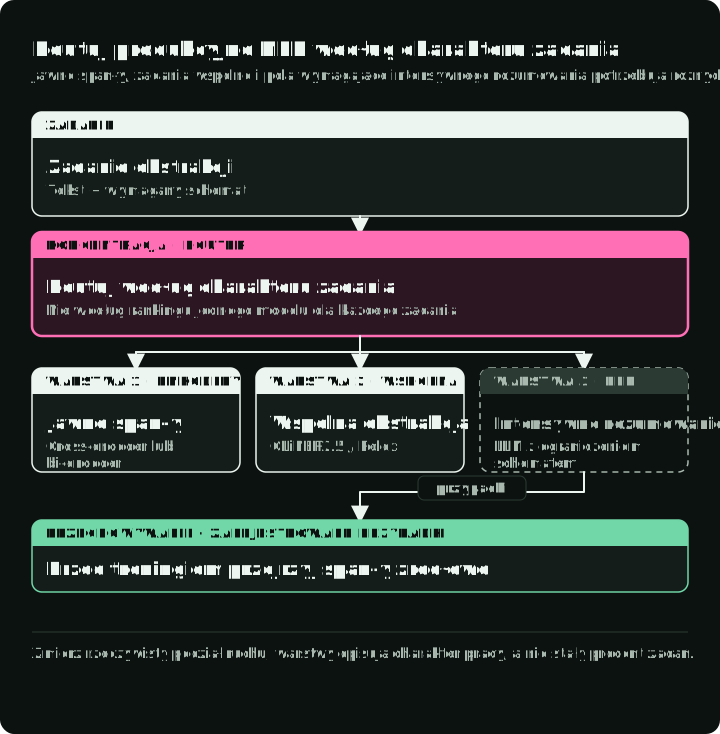
Warstwa 1: modele typu encoder dla jawnych spanów. Dla małego inwentarza typów użyj modelu GLiNER cross-encoder. Gdy duży inwentarz jest używany wielokrotnie, porównaj bi-encoder ze zbuforowanymi wektorami embeddings typów. Wykonaj fine-tuning przez potok LLM-as-teacher, a potem wdróż przez natywne serwowanie, ONNX, INT8 lub gline-rs tylko wtedy, gdy ta ścieżka przejdzie domenowy benchmark.
Warstwa 2: wielozadaniowa ekstrakcja lub ekstrakcja relacji. Gdy jedno żądanie potrzebuje NER, klasyfikacji i pól hierarchicznych, przetestuj obecny checkpoint GLiNER2.5 o 194M parametrów względem osobnych punktów odniesienia dla każdego zadania. Gdy głównym wymaganiem są łączne spany i relacje, przetestuj GLiNER-Relex. Artykuł GLiNER2 podaje opóźnienie klasyfikacji na CPU 130-208 ms dla testowanych liczb etykiet; nie mierzył późniejszego API relacji.
Warstwa 3: LLM do ekstrakcji wymagającej rozumowania. Encje ukryte, wnioskowanie z kontekstu i mapowanie na ontologię kieruj do natywnego API schematów lub Instructor dla API w chmurze, a do Outlines dla lokalnych wyjść z ograniczeniami. Użyj LangExtract, gdy kluczowe są przedziały w źródle, a NuExtract, gdy daną wejściową jest sam dokument. Loguj te przypadki do przeglądu. Tylko jawne spany dopasowane do źródła mogą stać się zwykłymi celami treningowymi warstwy 1; fakty wnioskowane i wartości znormalizowane potrzebują własnych celów i ewaluacji.
Studium przypadku CFM podaje jeden punkt odniesienia kosztu dla warstwy 1: 93,4% F1 przy podanym koszcie $0,10 za godzinę na CPU, wobec 92,7% F1 i $8 za godzinę dla nauczyciela Llama-70B. Godzinowe ceny instancji nie określają kosztu na dokument bez przepustowości. Przelicz ponownie dla swojego sprzętu, modelu nauczyciela, zestawu etykiet, wykorzystania i kosztu przeglądu.
Kompromisy i ograniczenia
Błędy nauczyciela LLM się propagują. Jeśli LLM konsekwentnie myli się dla jakiegoś typu encji (np. myli nazwy spółek zależnych z nazwami spółek matek), encoder po procesie fine-tuning dziedziczy to obciążenie. Intensywnie przeglądaj typy o niskiej pewności lub niespójne, a stratyfikowaną losową próbkę zachowaj, by wychwycić pewne, systematyczne błędy.
Poprawny schemat może zawierać fałszywe fakty. Natywne ustrukturyzowane dane wyjściowe, Instructor i dekodery z ograniczeniami mogą sprawić, że odpowiedź da się sparsować. Nie zapewnią, że każde pole ma oparcie w źródle, że granica spanu jest poprawna ani że znormalizowana wartość wskazuje właściwy rekord. Zachowuj dowody ze źródła i waliduj semantykę osobno.
Straty z kwantyzacji zależą od wybranego wariantu checkpoint i kwantyzowanych warstw. Kwantyzacja każdej warstwy MatMul w GLiNER z repozytorium towarzyszącego nie zwróciła żadnych encji; pozostawienie projekcji w dół FFN w FP32 zachowało recall w jego sprawdzeniu na 32 zdaniach. Inny checkpoint może mieć inne wrażliwe warstwy. Przed wdrożeniem porównaj model skwantyzowany z oryginalnym pod względem F1 dla dokładnych spanów i recallu dla każdej etykiety.
Kiedy architektura trzywarstwowa to przesada. Pojedyncza domena ze stałymi typami encji i wystarczającą liczbą oznaczonych przykładów może potrzebować tylko fine-tuningowanego RoBERTa lub potoku spaCy. Wzorzec trzywarstwowy pasuje do wielu domen, zmieniających się typów encji lub zmierzonej mieszanki ekstrakcji jawnej i wymagającej rozumowania. Wąski potok faktur, który wydobywa nazwy i daty, może skończyć się na warstwie 1.
Jakość bi-encodera zależy od datasetu i rozmiaru wariantu checkpoint. Na CoNLL-2003 gliner_small-v2.5 osiąga 65,4% F1, więcej niż bi-encodery edge/small z 61,6%/64,2%, ale mniej niż bi-base/large z 65,6%/66,5% (Stepanov et al., 2026, tabele 2–3). Wybieraj na podstawie zmierzonej jakości exact-span, kalibracji, liczby etykiet i throughput na swoim zbiorze domenowym.
Twierdzenia o PII i wielojęzyczności wymagają wycinków. Wysoki wynik zagregowany może ukryć groźny spadek recallu dla ustawień regionalnych, formy nazwiska, układu dokumentu lub rzadkiej klasy PII. Używaj modelu prywatności jako jednej z kilku kontroli, ustal proces reagowania na false negatives i oceniaj ponownie, gdy zmienia się taksonomia, mieszanka języków lub źródło danych.
Najważniejsze wnioski
- Używaj kompaktowego encodera dla jawnych spanów dopiero po tym, jak przejdzie domenowy zbiór testowy z wsparciem dla każdego typu i przedziałami ufności.
- Używaj GLiNER dla zmieniających się słowników etykiet. Gdy duży inwentarz typów jest używany wielokrotnie, najpierw porównaj jego bi-encoder; włączaj
flat_ner=Falsedopiero po sprawdzeniu, że checkpoint znajduje wewnętrzne spany. - Używaj spaCy lub fine-tuningowanego klasyfikatora dla jednostek token, gdy etykiety są stałe i masz dane treningowe.
- Dla twierdzeń o hard zero-shot używaj przetestowanych opisów typów, a w produktach wielojęzycznych testuj osobno angielskie i lokalne sformułowania etykiet.
- Traktuj OCR, NER, ekstrakcję relacji i entity linking jako odrębne etapy ewaluacji, nawet gdy jeden model udostępnia kilka zadań.
- Traktuj nauczyciela LLM jako system proponowania adnotacji. Wytyczne ludzi, rozstrzyganie rozbieżności, niezmienne zbiory regresji i wydzielony zbiór testowy nadal są wymagane.
- Używaj natywnych schematów dla obsługiwanych dostawców LLM, ale poprawność semantyczną i oparcie w źródle waliduj osobno od poprawności JSON.
- Zmieniaj jeden krok środowiska naraz: najpierw ONNX FP32, potem INT8 z wrażliwymi warstwami w FP32, z porównaniem spanów po każdym kroku.
Źródła
Artykuły
- GLiNER: Generalist Model for Named Entity Recognition using Bidirectional Transformer - Zaratiana i in., NAACL 2024. Podstawowa architektura dopasowania spanów do encji.
- GLiNER2: An Efficient Multi-Task Information Extraction System with Schema-Driven Interface - Zaratiana i in., EMNLP 2025 System Demonstrations. Łączy NER, klasyfikację i hierarchiczną ekstrakcję; obecne wydania dodały później ekstrakcję relacji.
- GLiNER Bi-Encoder: Scalable Named Entity Recognition with Bi-Encoder Architecture - Stepanov i in., luty 2026. Rozdzielone kodowanie dla skali miliona etykiet.
- GLiNER-Relex: A Unified Framework for Joint Named Entity Recognition and Relation Extraction - Stepanov i in., 2026. Łączna ekstrakcja encji i relacji w trybie zero-shot.
- GLiNER2-PII: A Multilingual Model for Personally Identifiable Information Extraction - Zaratiana i in., 2026. 42 typy PII z rozdzielczością do znaku.
- ZeroNER: Fueling Zero-Shot Named Entity Recognition via Entity Type Descriptions - Cocchieri i in., ACL 2025. Ewaluacja hard zero-shot z opisami typów.
- OpenNER 1.0: Standardized Open-Access Named Entity Recognition Datasets in 50+ Languages - Palen-Michel i in., EMNLP 2025. 36 korpusów, 52 języki i punkty odniesienia dla wielu ontologii.
- FiNERweb: Datasets and Artifacts for Scalable Multilingual Named Entity Recognition - Golde i in., EACL 2026. Etykiety wielojęzyczne i ewaluacja transferu.
- UniversalNER: Targeted Distillation from Large Language Models for Open Named Entity Recognition - Zhou i in., ICLR 2024. Uniwersalny NER oparty na LLM przez destylację z ChatGPT.
- NuNER: Entity Recognition Encoder Pre-training via LLM-Annotated Data - Bogdanov i in., EMNLP 2024. Bada encoder 125M wstępnie wytrenowany na adnotacjach LLM.
Artykuły z przemysłu
- EAMT: Entity-Aware Multi-Task Learning for Query Understanding - Walmart, KDD 2023. Wielozadaniowe rozumienie zapytań z około 60 etykietami NER.
- TripleLearn: End-to-End NER for E-Commerce Search - Home Depot, AAAI 2021. F1 z 69,5 do 93,3.
- CyNER: A Python Library for Cybersecurity Named Entity Recognition - Rozpoznawanie neuronowe połączone z innymi źródłami ekstrakcji.
- CyberNER: A Harmonized STIX Corpus for Cybersecurity NER - 21 typów encji zgodnych ze STIX 2.1.
- FinBERT-MRC: Financial NER via Machine Reading Comprehension - Sformułowanie MRC oceniane na chińskich zbiorach finansowych.
Studia przypadków
- CFM Case Study: Fine-tuning GLiNER for Financial NER - Potok etykietowania przez LLM za $70 w Capital Fund Management, osiągający 93,4% F1.
- Refuel AI: LLM Labeling Technical Report - GPT-4 osiągający 88,4% zgodności adnotacji, powyżej ludzkich adnotatorów.
- Sease: GLiNER as an Alternative to LLMs for Query Parsing - Gdzie GLiNER zawodzi i gdzie nadal potrzebne są LLM.
- John Snow Labs: Medical Text De-Identification Benchmark - Badanie dostawcy z ponownym mapowaniem etykiet i wykluczeniami.
- OpenMed: Year in Review 2025 - Otwarte medyczne modele NER; retrospektywa ze stycznia 2026.
Narzędzia i frameworki
- ner-field-guide demo repo - Kod towarzyszący temu artykułowi: dokładne liczenie wyniku dla spanów, przykłady GLiNER, konwersja zweryfikowanych adnotacji, testy ONNX FP32 i INT8 oraz demo strumieniowego PII.
- GLiNER - Biblioteka, skrypt treningowy i ścieżka Ray Serve z dynamicznym batchowaniem i wdrożeniem wielu replik.
- gline-rs: Rust reimplementation of GLiNER - Inferencja w Rust na plikach ONNX GLiNER; kod na licencji Apache 2.0.
- spaCy English pipelines - Wersjonowane metryki potoków ze stałymi etykietami.
- dslim/bert-base-NER - Klasyfikator dla jednostek token BERT po procesie fine-tuning na CoNLL-2003.
- Microsoft Presidio - Analiza i anonimizacja PII z własnymi rozpoznawaczami.
- Instructor - Ustrukturyzowana ekstrakcja przez LLM za pomocą modeli Pydantic.
- Outlines - Generowanie jednostek token z ograniczeniami przez automaty skończone, z raportowanym benchmarkiem zgodności ze schematem.
- LangExtract - Ustrukturyzowana ekstrakcja oparta na źródle, z przedziałami znaków.
- NuExtract - Ekstrakcja dokumentów na własnej infrastrukturze, ze schematu do szablonu.
- OpenAI Structured Outputs - Dokumentacja ścisłego formatu odpowiedzi ze schematem JSON.
- Anthropic Structured Outputs - Wyjścia JSON i ścisłe wejścia narzędzi.
- Gemini Structured Outputs - Podzbiór JSON Schema dla odpowiedzi ustrukturyzowanych.
- ONNX Runtime quantization - Dokumentacja dynamicznej i statycznej kwantyzacji INT8.
- AWS: Structured Output with Outlines - Benchmark 98% zgodności ze schematem.