Руководство по NER 2026: GLiNER, spaCy, Transformers и LLM

Автоматический перевод
Эта статья была автоматически переведена с оригинальной английской версии.
Это руководство для инженеров, которые выбирают распознавание именованных сущностей (NER) для retrieval, задач приватности или пайплайнов обработки документов. В нём разобрано, как выбирать между спан-распознавателями и структурированным LLM-извлечением, как оценивать их ошибки и как проверять варианты деплоя на латентность и стоимость, которые допускает ваша нагрузка.
NER превращает текст в размеченные фрагменты, с которыми может работать программа. Для фразы «Bill Gates founded Microsoft on April 4, 1975» он вернёт непрерывные спаны текста Bill Gates, Microsoft и April 4, 1975 с типами «персона», «организация» и «дата». В энкодере на основе спанов, таком как GLiNER, модель читает текст один раз и сопоставляет кандидатные спаны с заданными вами метками.
Для пайплайна retrieval или приватности я бы сначала спросил, должен ли результат быть буквальным упоминанием. Этот вопрос отделяет спан-распознаватель от систем, которые ещё и нормализуют значения, связывают записи или выводят факты. LLM по-прежнему полезны, когда нужно предложить обучающую разметку и обработать случаи, где требуется вывод или нормализация.
Репозиторий-компаньон: ner-field-guide содержит точный подсчёт метрик по спанам, примеры GLiNER, конвертацию проверенной разметки, проверки ONNX FP32 и INT8 и демо потокового PII.
Краткое сравнение моделей смотрите в статье Best NER Models in 2026.
Что такое распознавание именованных сущностей?
Распознавание именованных сущностей находит в тексте спаны и присваивает им типы: персона, организация, дата, продукт или доменные метки. Спан — это непрерывный фрагмент исходного текста. NER определяет упоминание; entity linking — отдельный шаг, который сопоставляет его с канонической записью или понятием онтологии.
| Нагрузка | Что проверить первым | Когда переходить дальше |
|---|---|---|
| Идентификаторы или контролируемые словари | Правила или spaCy EntityRuler | Важен recall вне известных шаблонов. |
| Стабильные метки и много обучающих данных | spaCy или дообученный энкодер | Набор меток меняется или recall на редких типах перестаёт расти. |
| Меняющиеся метки; небольшой набор типов | GLiNER cross-encoder | Набор типов растёт или метки переиспользуются на многих документах. |
| Большой переиспользуемый набор типов | GLiNER bi-encoder | На доменном наборе заметно падает качество или калибровка. |
| Несколько задач извлечения в одном текстовом пайплайне | GLiNER2.5 | Качество совместных задач не достигает цели по каждой задаче. |
| Неявные факты или рассуждения по схеме | Структурированное LLM-извлечение | Латентность, стоимость или неподтверждённые утверждения выходят за бюджет продукта. |
GLiNER cross-encoder читает названия меток и текст вместе, поэтому каждый документ заново кодирует каждую метку. Bi-encoder кодирует метки отдельно и может их кэшировать. GLiNER2.5 — отдельное семейство моделей, которое извлекает сущности, классы, связи и структурированные поля по одной схеме. Каждому посвящён свой раздел ниже.
При движении по этому списку срабатывает первый подходящий пункт. Вопросы стоят в том порядке, в котором я бы их задавал:
- Результат не является буквальным спаном: используйте structured output LLM.
- Идентификаторы или фиксированный словарь: используйте правила или EntityRuler.
- Фиксированные метки и достаточно обучающих данных: используйте spaCy или BERT-NER.
- Большой набор меток, переиспользуемый на многих документах: используйте GLiNER bi-encoder.
- В остальных случаях: используйте GLiNER cross-encoder и попробуйте GLiNER2.5, если нужно несколько задач за один проход.
Где современные системы используют NER
NER по-прежнему находит в тексте спаны и присваивает им метки. Изменилось его место в системе. Теперь он поставляет фильтры для RAG, структурированные аргументы для инструментов агентов и поля для пайплайнов обработки документов. Из-за этого латентность, стоимость и гибкость схемы становятся такими же важными, как точность на бенчмарке.
RAG: лучший retrieval за счёт извлечения сущностей
Поиск по сходству плохо справляется, когда вопрос содержит точные сущности. Для вопроса «what did Anthropic say about model safety in Q4 2024?» извлечение сущностей может предложить «Anthropic» и «Q4 2024» как фильтры. Жёсткий фильтр применяйте, только если индексированные метаданные и семантика дат это поддерживают; иначе используйте его как сигнал ранжирования или оставьте путь retrieval без фильтра. Пропущенный алиас или неверно выведенный диапазон дат могут исключить правильный ответ.
При индексации вы извлекаете сущности из каждого чанка и сохраняете их как метаданные: {"organizations": ["Anthropic"], "dates": ["Q4 2024"], ...}. Это позволяет фильтровать по сущности до запуска vector search. Knowledge graph RAG (GraphRAG, property graphs в LlamaIndex) добавляет именованные связи, по которым retrieval может переходить через несколько шагов.
Диаграмма разбирает пример индекса из четырёх чанков. Сравните две нижние панели: жёсткий фильтр вообще не ищет в чанке, у которого сохранённая дата указана без года, а усиление ранжирования всё равно в нём ищет.
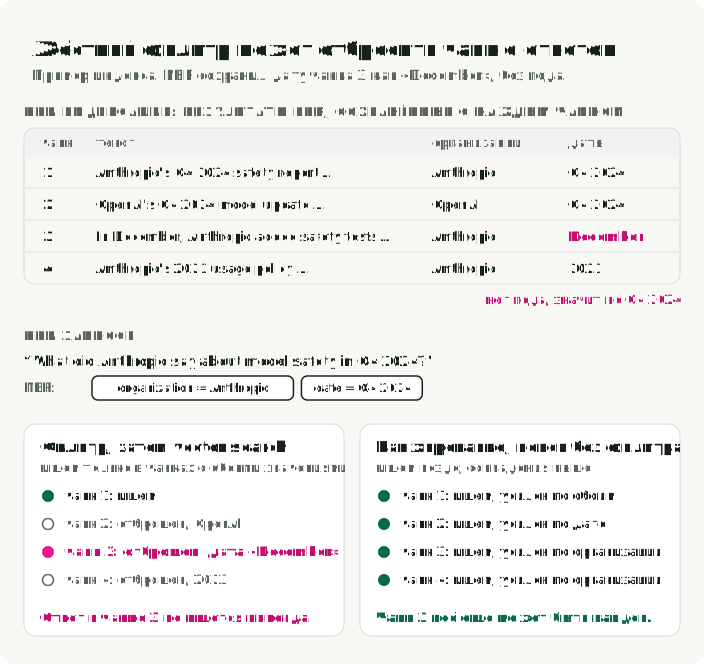
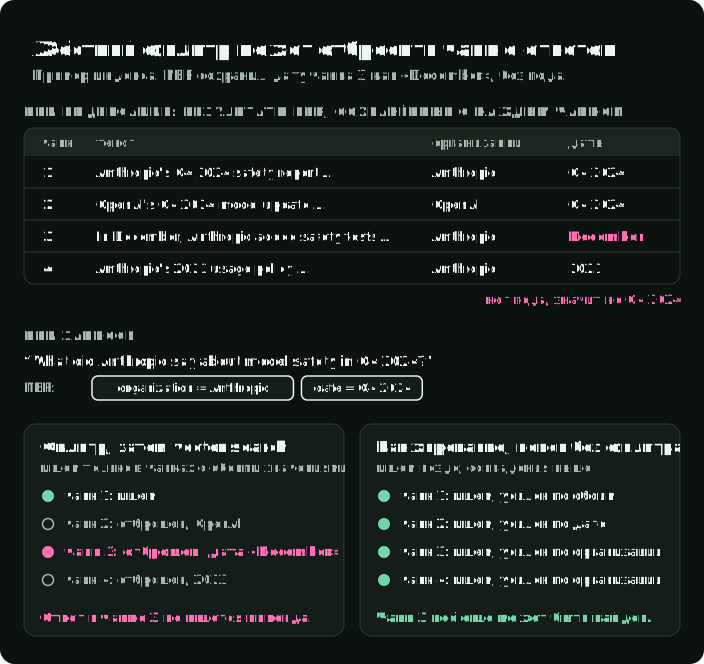
Во время запроса сущности, извлечённые из вопроса пользователя, определяют роутинг. Вопрос с названием компании уходит в финансовый индекс; вопрос с названиями лекарств — в клиническую базу знаний. GLiNER полезен, когда схема или типы сущностей на этапе запроса меняются. Одни лишь невиданные названия компаний или лекарств не требуют меток с открытым словарём: модель с закрытым набором меток всё равно может распознавать новые упоминания известных типов.
ИИ-агенты: превращаем текст в структурированные факты
Агенты получают неструктурированный текст: веб-страницы, ответы API, сообщения пользователей. NER превращает этот текст в структурированные факты, по которым агент может рассуждать, которые он может сохранять или передавать инструментам.
Для роутинга инструментов запрос «schedule a meeting with Sarah Chen from Accenture on Thursday at 2pm» может дать PERSON: Sarah Chen, ORGANIZATION: Accenture, DATE: Thursday и TIME: 2pm. Затем резолвер календаря объединяет дату и время в метку времени, которую требует API. Локальный энкодер избавляет от сетевого вызова API, но его латентность зависит от модели, рантайма, железа, размера батча и числа меток.
NER также помогает отслеживать сущности на протяжении разговора. Системам памяти агента нужно знать, что «Sarah» на третьем ходе и «Ms. Chen» на двенадцатом — один и тот же человек. NER находит спаны; разрешение кореференции решает, относятся ли упоминания в контексте к одному человеку. Затем entity linking сопоставляет этого человека с канонической записью, если она есть.
В обоих случаях ограничение — латентность. Если каждый из десяти последовательных шагов делает вызов NER на 200 мс, эти вызовы добавляют 2 секунды видимой задержки. Один вызов добавляет 200 мс. Модели-энкодеры обычно лучше подходят для работы с сущностями внутри агентных циклов, чем LLM-извлечение.
Обработка документов: от изображений к структурированным данным
OCR превращает изображения в текст. NER превращает этот текст в структурированные поля.
Стандартный пайплайн сначала использует OCR (например, Tesseract, Azure Document Intelligence или AWS Textract), чтобы получить текст и ограничивающие рамки. Затем NER находит спаны для полей вроде invoice_number, vendor_name, total и due_date. Описания позиций, количества и цены нужно сгруппировать в line_items на шаге со схемой или извлечения связей. Та же последовательность подходит для контрактов, медицинских записей и регуляторных документов.
У каждого этапа своя метрика. Ошибка OCR, из-за которой потерялась цифра, выглядит как промах NER, если оценивать только итоговую запись.
| Этап | Что он выдаёт | Метрика |
|---|---|---|
| OCR и разбор разметки | Текст, порядок чтения, рамки | Доля ошибочных символов |
| NER | invoice_number, vendor_name, total | Exact-span F1 |
| Группировка | Позиции (описание, количество, цена в каждой строке) | F1 по записям |
| Связывание и нормализация | ID поставщика, даты ISO, суммы | Точность связывания или нормализации |
Современные пайплайны документов могут объединять понимание разметки, извлечение сущностей и извлечение связей. Текст, порядок чтения, таблицы и ограничивающие рамки по-прежнему поставляет OCR или модель документов, учитывающая разметку. Текущий GLiNER2.5 предоставляет сущности, связи, классификацию и структурированные записи через один интерфейс схемы; каждый результат оценивайте отдельно.
Стоимость определяет выбор большинства таких пайплайнов. Посчитайте её для реального месячного объёма документов, включая повторные попытки и проверку. Компактный энкодер может работать на CPU, а LLM через API добавляет стоимость инференса и латентность на каждый документ. Практичный тест: разметьте с помощью LLM репрезентативный набор счетов. Дообучите GLiNER на проверенных записях, затем сравните оба пути по F1 на уровне полей, латентности и полной стоимости.
Обнаружение PII и гардрейлы для LLM
Законы о приватности, такие как GDPR, HIPAA и CCPA, требуют защиты персональных данных, но не требуют NER. NER может находить персональные данные для скрытия или минимизации; прежде чем считать его мерой защиты, проверьте его recall на ваших данных.
Модели деидентификации находят спаны PERSON, SSN, PHONE, EMAIL и ADDRESS и либо скрывают их, либо заменяют синтетическими аналогами. Microsoft Presidio сочетает распознаватели с операторами анонимизации, а в его примерах есть GLiNER как распознаватель. Ещё один кандидат — GLiNER2-PII на 0,3 млрд параметров: в статье рассмотрены 42 типа PII с разрешением до символьного спана.
В сравнении John Snow Labs, проведённом самим вендором, 48 документов, размеченных экспертами, охватывают шесть классов PHI. Метки провайдеров были переотображены, а предсказания, которые не удалось сопоставить, исключены, что ограничивает интерпретацию сравнения между провайдерами. В отчёте Providence описаны 281 событие утечки PHI при проверке 1000 заметок, содержащих 34 701 предложение. События — это не число различных затронутых предложений: при оценке приватности считайте и утёкшие экземпляры, и затронутые документы.
Для гардрейлов LLM NER работает как слой предварительной проверки: просканируйте ввод пользователя на PII до отправки во внешний API, затем заблокируйте или анонимизируйте.
Локальный детектор может быть быстрее, чем просить LLM модерировать себя самой, но ложноотрицательные срабатывания возможны, поэтому добавьте ещё один контроль для той утечки PII, которую ваша система допустить не может. GLiNER здесь полезен, потому что категории PII различаются по юрисдикциям. API может принять новую метку, например «genetic information», без переобучения. Recall для этой новой метки неизвестен, пока вы не проверите его на размеченных примерах.
GLiNER: сопоставление спанов с метками для NER с открытым словарём
GLiNER (NAACL 2024, Zaratiana et al.) сделал NER на энкодерах конкурентоспособным с LLM за малую долю их стоимости. Вместо того чтобы рассматривать NER как разметку последовательности или генерацию текста, GLiNER рассматривает его как задачу сопоставления. Он оценивает каждый кандидатный спан текста (каждую непрерывную последовательность слов вроде «Bill Gates» или «Microsoft») относительно каждой метки типа сущности, а затем оставляет пары с высокой оценкой.
Модель принимает метки типов сущностей и входной текст как единую последовательность: [ENT] person [ENT] organization [ENT] date [SEP] Bill Gates founded Microsoft.... Двунаправленный трансформер (DeBERTa-v3) кодирует всё вместе.
Из выхода модель строит два набора представлений. Одно уточняет представление каждого типа сущности из позиции токена [ENT] через небольшую полносвязную сеть (FFN), преобразующую вектор энкодера. Другое представляет спаны текста, объединяя векторы начального и конечного слов через ещё одну FFN. Скалярное произведение представления спана и представления типа сущности даёт оценку.
Примените сигмоиду, и получите вероятность того, что спан от слова с позицией до слова с позицией принадлежит типу сущности : . Здесь — вектор спана, полученный через FFN, а — эмбеддинг типа сущности, уточнённый через FFN, из соответствующего токена [ENT] (Zaratiana et al., 2024, формулы 1–2). Кандидатные спаны ограничены 12 словами; токенизатор может разбить слово на несколько подсловных токенов.
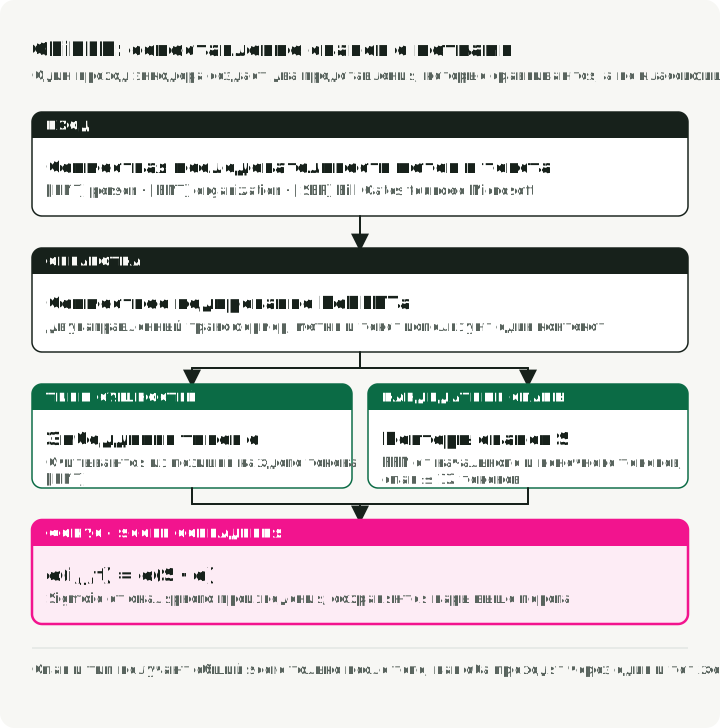
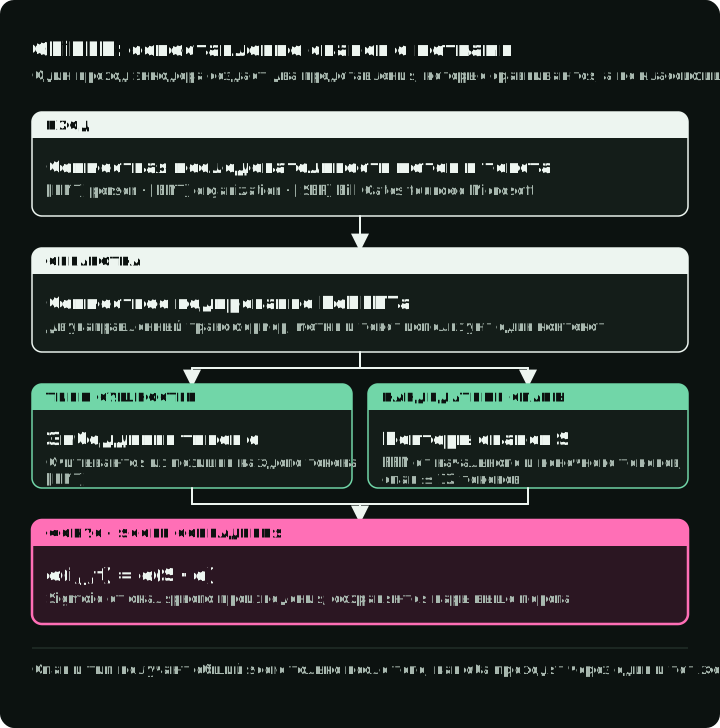
GLiNER принимает описания меток на естественном языке на этапе инференса без переобучения, но качество извлечения зависит от формулировки меток и соответствия домену. Вы передаёте типы сущностей вроде «person», «adverse drug reaction» или «financial instrument», и модель оценивает спаны относительно них. Конфигурации на 50M, 90M и 300M ниже — это модели из оригинальной статьи. В карточке модели v2.1 вместо них указаны английские чекпоинты на 166M, 209M и 459M, а также многоязычный чекпоинт на 209M, все под Apache 2.0. Не сравнивайте латентность и память между этими поколениями: размеры в названиях не совпадают по числу параметров (карточка модели GLiNER v2.1).
Для настоящего жёсткого zero-shot теста исключите из обучения и целевые типы, и целевые примеры: у модели нет размеченных примеров целевой задачи. Описание типа вроде «a medically confirmed adverse effect caused by a treatment» даёт модели больше информации, чем одно adverse event. Это не гарантия переноса, но ZeroNER, основанный на описаниях, превзошёл базовые модели, использующие только названия, на своих бенчмарках с исключёнными типами (Cocchieri et al., 2025).
Обучающие данные для оригинальной модели взяты из датасета Pile-NER: 44 889 фрагментов текста с 240 тыс. спанов сущностей по 13 тыс. типов сущностей, всё размечено ChatGPT. Обучение GLiNER-L заняло около 5 часов на одной A100 (Zaratiana et al., 2024).
Результаты бенчмарков
Zero-shot результаты из Zaratiana et al. (2024), таблицы 1 и 2. F1 объединяет precision и recall в одну оценку; более высокая оценка лучше только при одной и той же задаче и правилах оценки. Среднее по семи датасетам объединяет пять датасетов CrossNER с MIT Movie и MIT Restaurant:
| Модель | Параметры | Средний F1 (CrossNER + MIT) | Средний F1 (20 датасетов) |
|---|---|---|---|
| GLiNER-L | 300M | 60.9% | 47.8% |
| GoLLIE | 7B | 58.0% | — |
| UniNER-13B | 13B | 55.6% | — |
| GLiNER-M | 90M | 55.4% | — |
| UniNER-7B | 7B | 53.7% | 45.7% |
| GLiNER-S | 50M | 52.7% | — |
| ChatGPT (GPT-3.5) | — | 47.5% | 36.5% |
GLiNER-M на 90M параметров почти равен UniNER-13B по среднему значению статьи на семи датасетах (55,4% против 55,6% F1), используя примерно в 140 раз меньше параметров. GLiNER-S на 50M превосходит заявленный результат ChatGPT (GPT-3.5) на 5 пунктов F1. Многоязычный вариант, обученный только на английских данных, превосходит ту же базовую линию ChatGPT на 8 из 10 неанглийских языков (Zaratiana et al., 2024). Эти сравнения используют версии моделей и тестовую обвязку из статьи; о более новых LLM они ничего не говорят.
Минимальный вызов GLiNER
Для нового сравнения cross-encoder включите поддерживаемые чекпоинты GLiNER v2.5 рядом с v2.1. В проверке репозитория-компаньона на 32 предложениях из Few-NERD, публичного датасета для NER, gliner_small-v2.5 нашёл 44 из 54 эталонных спанов, а gliner_medium-v2.1 — 39. Эта выборка слишком мала, чтобы ранжировать две модели, но это повод включить v2.5 в ваш собственный прогон. GLiNER v2.5 и Fastino GLiNER2.5 (ниже) — разные семейства моделей.
Вызов ниже загружает чекпоинт v2.1 medium и печатает каждый спан с его оценкой. Версия из репозитория-компаньона — ner_demo/quickstart.py.
from gliner import GLiNER

model = GLiNER.from_pretrained("urchade/gliner_medium-v2.1")
text = "Bill Gates founded Microsoft on April 4, 1975."
labels = ["person", "organization", "date"]
entities = model.predict_entities(text, labels, threshold=0.5)

for entity in entities:
    print(f"{entity['text']} => {entity['label']} ({entity['score']:.3f})")
# Bill Gates => person (0.994)
# Microsoft => organization (0.973)
# April 4, 1975 => date (0.951)Bi-encoder: масштабирование до NER с миллионом меток
Оригинальный GLiNER кодирует метки и текст вместе. Совместное кодирование дорожает по мере того, как текст меток занимает контекст и его приходится заново кодировать для каждого документа. Точка пересечения зависит от чекпоинта, описаний меток и железа. Когда один и тот же большой набор типов переиспользуется на многих документах, сделайте GLiNER bi-encoder сравнением по умолчанию. Он разделяет кодирование текста и меток на два отдельных трансформера (Stepanov et al., 2026).
На схеме сравниваются два дизайна на трёх документах. В дорожке cross-encoder все метки попадают в энкодер вместе с каждым документом. В дорожке bi-encoder энкодер меток запускается один раз, его векторы кэшируются, и на каждый документ работает только энкодер текста. График под ними показывает потерю throughput при 1 024 метках.
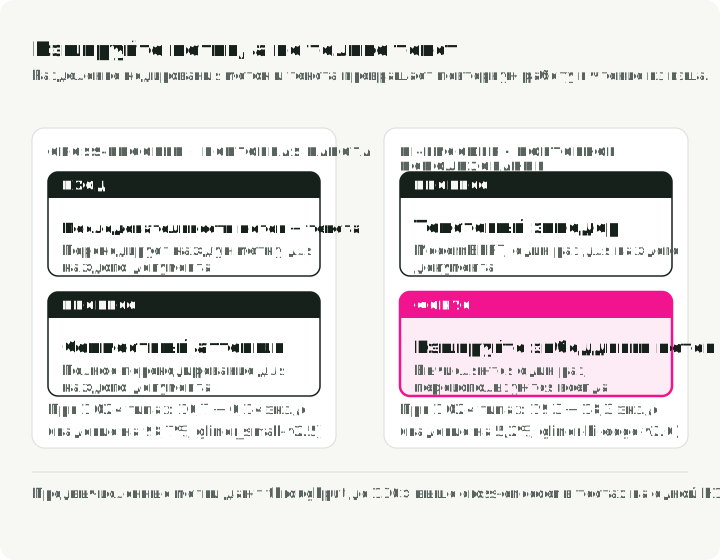
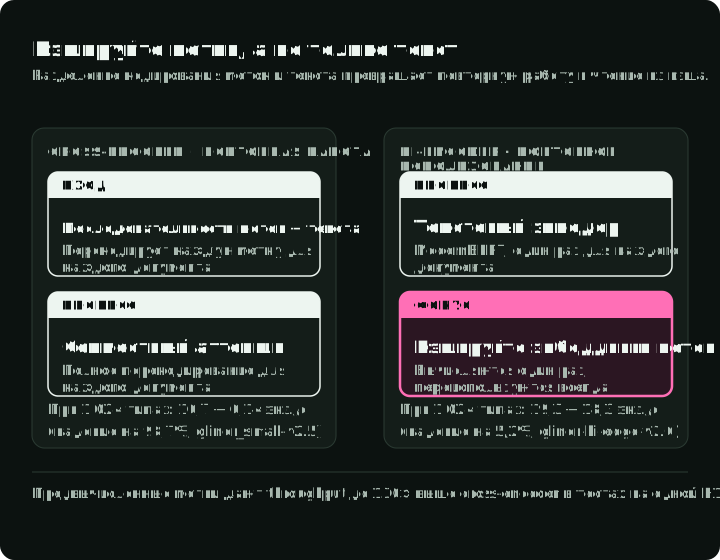
Энкодер текста использует ModernBERT (семейство Ettin), энкодер меток — sentence transformers (BGE или MiniLM). Спаны и метки оцениваются через скалярное произведение. Такое разделение означает, что эмбеддинги типов сущностей можно вычислить заранее один раз и закэшировать. При инференсе кэшированные метки избавляют от повторного кодирования меток. Оценка кандидатных спанов относительно этих меток всё равно требует вычислений и памяти; приложению с миллионом меток также нужны ограниченный отбор кандидатов или батчинг, при этом recall для меток, исключённых до оценки, нужно измерять.
Доступны четыре размера модели, все проверены на CrossNER (Stepanov et al., 2026, таблица 1):
| Модель | Параметры | Средний F1 (CrossNER + MIT) | Throughput (H100) | С предвычисленными метками |
|---|---|---|---|---|
| gliner-bi-edge-v2.0 | 60M | 54.0% | 13.64 ex/s | 24.62 ex/s |
| gliner-bi-small-v2.0 | 108M | 57.2% | 7.99 ex/s | 15.22 ex/s |
| gliner-bi-base-v2.0 | 194M | 60.3% | 5.91 ex/s | 9.51 ex/s |
| gliner-bi-large-v2.0 | 530M | 61.5% | 2.68 ex/s | 3.60 ex/s |
На 1024 типах сущностей bi-encoder gliner-bi-edge-v2.0 с предвычисленными метками теряет всего 5,2% throughput по сравнению с одной меткой (19,3 → 18,3 ex/s). Сопоставимый cross-encoder gliner_small-v2.5 теряет 98,7% (10,7 → 0,14 ex/s). В тестах статьи на одной H100 с размером батча 1 на входах в 64, 256 и 512 токенов bi-encoder с предвычисленными метками достигает преимущества по throughput до 130× над gliner_small-v2.5. При 100 типах сущностей на одной H100 bi-encoder обрабатывает 1,96 млн предсказаний в день против 368 тыс. у cross-encoder (Stepanov et al., 2026).
Статья о bi-encoder сообщает 61,5% для gliner-bi-large-v2.0 против 60,9% для gliner_large-v2.5 на том же среднем по CrossNER и MIT, так что на этом бенчмарке bi-encoder не жертвует точностью ради скорости. Авторы рекомендуют bi-base-v2.0 (194M) как лучший компромисс по размеру: 98% точности большой модели при скорости в 2,6 раза выше (Stepanov et al., 2026).
Замер скорости останавливается на 1024 метках, использует H100, размер батча один и десять прямых проходов на конфигурацию. Он не измеряет развёрнутый сервис с миллионом меток. Статья называет одним из применений entity linking по большим базам знаний вроде Wikidata; entity linking доступен во фреймворке GLiNKER от Knowledgator.
Код кодирует набор меток один раз и переиспользует эмбеддинги для каждого текста. С тремя метками ниже он возвращает те же три спана, что и вызов cross-encoder выше.
from gliner import GLiNER

model = GLiNER.from_pretrained("knowledgator/gliner-bi-base-v2.0")

# Pre-compute embeddings for a reused label set; rebuild this cache when labels or the checkpoint change.
entity_types = ["person", "organization", "date"]  # Small example; large inventories need bounded candidate selection
entity_embeddings = model.encode_labels(entity_types, batch_size=8)

# Encode text and score spans against the cached labels
texts = ["Bill Gates founded Microsoft on April 4, 1975."]
outputs = model.batch_predict_with_embeds(texts, entity_embeddings, entity_types)GLiNER2 и GLiNER2.5: одна схема для нескольких задач
В оригинальной экосистеме GLiNER NER, извлечение связей, классификация и извлечение на уровне документа были разнесены по разным моделям. Статья GLiNER2 с EMNLP 2025 объединила NER, классификацию и иерархическое извлечение в одной модели на 205 млн параметров; текущие релизы позже добавили в тот же интерфейс схемы извлечение связей.
Архитектура 2025 года сохраняет дизайн cross-encoder, но расширяет контекст до 2048 токенов (в 4 раза больше оригинала) и добавляет декларативные схемы для описания задач извлечения. Обучение использует 135 698 реальных документов, размеченных GPT-4o, плюс 118 636 синтетических примеров (Zaratiana et al., 2025).
На zero-shot CrossNER GLiNER 2 набирает 0,590 F1, что близко к 0,599 у GPT-4o на бенчмарке статьи середины 2025 года. В классификации он в среднем получает 0,72 на 7 бенчмарках против 0,69 у DeBERTa-v3-large. На CPU статья сообщает о латентности классификации 130–208 мс на всех проверенных числах меток. Zero-shot базовая линия DeBERTa требует прямого прохода на каждую кандидатную метку и растёт с 1714 мс для 5 меток до 16 897 мс для 50; это не время работы обученного с учителем классификатора DeBERTa (Zaratiana et al., 2025).
Пример ниже загружает GLiNER2.5, более поздний чекпоинт, поэтому приведённые выше оценки 2025 года его не описывают. GLiNER2.5 (194M параметров) предсказывает начальную и конечную позиции спана вместо оценки каждого спана. Его окно — 4096 токенов, поэтому более длинные документы разбивайте на перекрывающиеся чанки вспомогательной функцией библиотеки и проверяйте, что возвращённые смещения соответствуют полному тексту. Загружайте его через AutoExtractor, как показано ниже.
from gliner2 import AutoExtractor

# Requires `pip install gliner2[local]` and downloads the checkpoint.
extractor = AutoExtractor.from_pretrained("fastino/gliner2.5-base-v1")

# Compose tasks through the current schema interface
schema = (extractor.create_schema()
    .entities({"person": "Names of people", "company": "Organization names"})
    .classification("sentiment", ["positive", "negative", "neutral"])
    .relations(["works_for", "founded", "located_in"])
    .structure("product_info")
        .field("name", dtype="str")
        .field("price", dtype="str"))
text = "Acme launched a $19 widget in Berlin."
results = extractor.extract(text, schema)
Статья EMNLP оценивает только NER и классификацию. Она не приводит бенчмарка иерархического извлечения и не охватывает более позднее API связей. Одна модель, выполняющая четыре задачи, может по каждой набирать меньше, чем четыре специализированные модели, поэтому сравнивайте каждую задачу с её собственной базовой линией.
Другие варианты GLiNER для особых нужд
В семействе GLiNER теперь есть несколько архитектур помимо cross-encoder, bi-encoder и GLiNER2.5. Каждая нацелена на одну потребность:
| Потребность | Кандидат | Что проверить |
|---|---|---|
| Сущности и связи за один проход | GLiNER-Relex | F1 и по спанам, и по связям на одних и тех же документах. |
| Локальный кандидат для PII | GLiNER2-PII | Recall по языкам, форматам документов и типам PII. |
| Многоязычный кандидат с открытым словарём | GLiNER-X | Качество по каждому языку; в его карточке указаны 23 языка. |
| Генерируемые или меняющиеся типы | GLiNER Decoder | Стабильны ли сгенерированные типы и полезны ли они дальше по цепочке. |
| Потоковое скрытие PII | GLiNER Streaming PII | Утёкшие символы до выпуска, а не только recall итоговых спанов. |
Результаты GLiNER-Relex и GLiNER2-PII взяты из их собственных статей и тестовых обвязок. У GLiNER-X и GLiNER Decoder есть карточки моделей, но нет рецензируемых бенчмарков, поэтому их числа несопоставимы с числами из статей выше.
Потоковое PII меняет момент, когда можно выпускать текст
GLiNER Streaming PII добавляет инкрементальное обнаружение с каузальной основой Qwen3-0.6B и кэшированным состоянием сессии. Его API возвращает снапшот всей текущей сессии со смещениями в накопленном тексте. Сохраняйте границы чанков, держите метки неизменными до полного пересчёта и очищайте завершённые сессии.
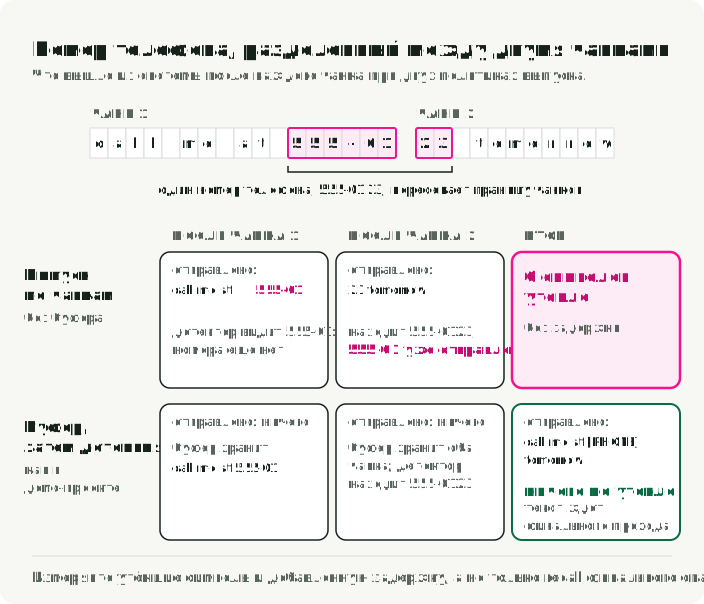
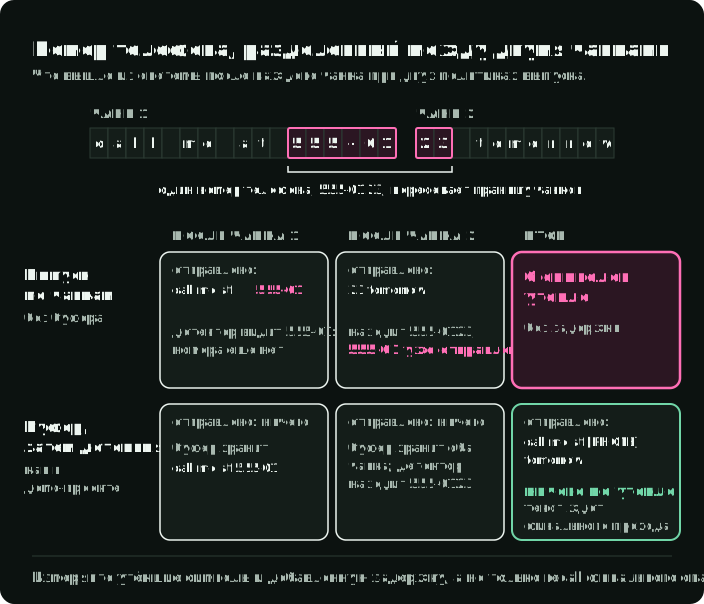
Для потокового скрытия я бы буферизовал ещё не выпущенный текст и проверял сущности, разделённые между чанками. Если номер телефона обнаружен после отправки его первой половины, эти байты уже не вернуть. Измеряйте утёкшие символы до выпуска и добавленную задержку, а также recall итоговых спанов. Карточка модели сообщает F2 маскирования на PIIMB отдельно от строгого F1 по типизированным спанам; они отвечают на разные вопросы. Карточка также сообщает о более слабых многоязычных результатах, так что выпущенный чекпоинт — не универсальный фильтр приватности.
На схеме один номер телефона разделён между двумя чанками. Если выпускать чанк за чанком, первая половина уже ушла, когда приходит вторая. С буфером детектор видит весь номер, и наружу выходит только маскированный текст. ner_demo.streaming из репозитория-компаньона держит весь текст до финального прохода обнаружения, а затем выпускает его с замаскированными найденными спанами.
Альтернативы с закрытым набором меток: spaCy и дообученный токен-классификатор
Когда набор меток стабилен и у вас есть размеченные данные, открытые метки GLiNER не нужны. Модель, обученная на этом наборе меток, — базовая линия, которую нужно превзойти.
Обученные пайплайны spaCy (en_core_web_sm, en_core_web_trf) распознают фиксированный набор типов сущностей (PERSON, ORG, GPE, DATE и другие), заданный при обучении. Расширение обученного компонента ner требует размеченных примеров и обучения. Для идентификаторов или контролируемого словаря EntityRuler добавляет собственные метки через шаблоны без переобучения; его recall вне этих шаблонов равен нулю. Карточка модели en_core_web_trf 3.8.0 сообщает 90,19 NER F1 на OntoNotes 5.0, но только для её 18 предопределённых типов (карточка модели spaCy).
Пример добавляет шаблон тикера перед обученным компонентом ner, так что правило сначала захватывает $AAPL, а модель размечает остальное:
import spacy

nlp = spacy.load("en_core_web_trf")
ruler = nlp.add_pipe("entity_ruler", before="ner")
ruler.add_patterns([{"label": "TICKER", "pattern": [{"TEXT": "$"}, {"TEXT": {"REGEX": r"^[A-Z]{1,5}$"}}]}])

doc = nlp("Tim Cook said Apple ($AAPL) will open an office in Berlin in March 2027.")
print([(ent.text, ent.label_) for ent in doc.ents])
# [('Tim Cook', 'PERSON'), ('Apple', 'ORG'), ('$AAPL', 'TICKER'), ('Berlin', 'GPE'), ('March 2027', 'DATE')]
Для стабильных меток при наличии репрезентативных размеченных спанов базовая линия с обучением с учителем — дообученный токен-классификатор вроде BERT, RoBERTa или DeBERTa. pipeline из Hugging Face загружает такой классификатор одной строкой. dslim/bert-base-NER, фиксированный энкодер в оценке репозитория-компаньона, обучен на CoNLL-2003, поэтому его метки фиксированы: PER, ORG, LOC и MISC. Дата в том же предложении не находится, потому что у модели нет метки даты:
from transformers import pipeline

ner = pipeline("token-classification", model="dslim/bert-base-NER", aggregation_strategy="simple")
for ent in ner("Tim Cook said Apple will open an office in Berlin in March 2027."):
    print(ent["word"], ent["entity_group"], round(float(ent["score"]), 3))
# Tim Cook PER 1.0
# Apple ORG 0.998
# Berlin LOC 0.999
Чтобы получить собственные метки, дообучите такую модель на ваших размеченных спанах. Сравните её со spaCy и GLiNER по exact-span F1, recall по меткам, калибровке, латентности и стоимости на одном и том же доменном наборе.
Моя рекомендация: используйте spaCy или дообученный токен-классификатор для стандартных или стабильных типов сущностей, когда есть обучающие данные. Используйте GLiNER, когда нужны гибкие zero-shot типы или когда пайплайн должен адаптироваться без переобучения. Они могут работать в одном пайплайне: spaCy отвечает за токенизацию и разбиение на предложения, а GLiNER — за извлечение сущностей.
Лицензии чекпоинтов — часть выбора модели
Модели в этом руководстве не имеют одной общей лицензии. Перед деплоем проверьте условия на код, веса и датасет для конкретного чекпоинта:
| Релиз | Опубликованная лицензия | Практическое следствие |
|---|---|---|
| GLiNER v2.1, GLiNER v2.5 и GLiNER bi | Apache 2.0 | Разрешающие условия карточки модели; всё равно проверьте зависимости и данные. |
| GLiNER2, GLiNER2.5 и GLiNER2-PII | Apache 2.0 | Подтвердите выбранный чекпоинт, а не только библиотеку. |
spaCy en_core_web_trf и dslim/bert-base-NER | MIT | Разрешающая; у обучающих корпусов свои условия. |
| UniNER-7B-all | CC BY-NC 4.0 | Не используйте в коммерческом пути без отдельного разрешения. |
| NuNER | MIT | Выпущенная модель и датасет заявляют условия MIT. |
Метки лицензий — не юридическая консультация. Производственная проверка должна учитывать условия базовой модели, обучающих данных и провайдера.
LLM как учитель: кейс за $70 и пайплайн для деплоя
Паттерн LLM-as-teacher разделяет дорогую разметку и более дешёвый инференс: LLM один раз размечает обучающие данные, а небольшой энкодер, обученный на этих метках, обслуживает каждый запрос. Две исследовательские работы показали, что небольшие модели могут учиться NER на разметке LLM, а два опубликованных кейса показывают, как команды применили этот подход.
Исследования за этим паттерном: UniNER и NuNER
UniNER (ICLR 2024, Zhou et al.) и NuNER (EMNLP 2024, Bogdanov et al.) оба дистиллируют разметку LLM в небольшие модели NER, но расходятся в том, насколько маленькой можно сделать модель.
UniNER дообучает LLaMA-7B/13B на 45 889 парах «вход–выход», сгенерированных ChatGPT. Для каждого типа сущности модель отвечает на вопрос «What describes [type] in the text?» и выдаёт списки JSON. Ключевой приём обучения: негативное сэмплирование по частоте поднимает F1 с 31,5% до 53,4% (Zhou et al., 2024).
UniNER-7B достигает 41,7% zero-shot F1 на 43 датасетах, обгоняя ChatGPT с его 34,9% на 7 пунктов. Вариант 13B доходит до 43,4%, всего на 1,7 пункта больше при почти вдвое большем числе параметров (Zhou et al., 2024).
Компромисс для продакшена: более результативная конфигурация типа UniNER из статьи опрашивает каждый тип сущности последовательно. Её вариант «всё в одном» использует один ответ, но в среднем на 3,3% ниже. В FP16 для чекпоинта 7B нужно примерно 14 ГБ только под веса; квантизация с меньшей разрядностью может уменьшить этот объём. Чекпоинт UniNER-7B-all некоммерческий (см. таблицу лицензий выше).
NuNER стартует с RoBERTa-base (125M параметров) и использует контрастное обучение на 4,38 млн аннотаций GPT-3.5 по 200 тыс. понятий. После обучения энкодер понятий выбрасывается; энкодер текста встаёт в любой стандартный пайплайн NER вместо RoBERTa (Bogdanov et al., 2024).
Таблица 3 в статье NuNER показывает прирост примерно на 6,1–16,2 пункта над RoBERTa по макро-среднему F1 токен-классификации с замороженными энкодерами и линейными головами на четырёх датасетах и выборочных размерах обучения (Bogdanov et al., 2024).
Обе статьи показывают, что небольшая модель может учиться на разметке LLM. Ни одна не показывает, что ученик превосходит своего учителя в новом домене, поэтому пайплайн ниже сохраняет отдельно проверенный тестовый набор.
Кейс CFM
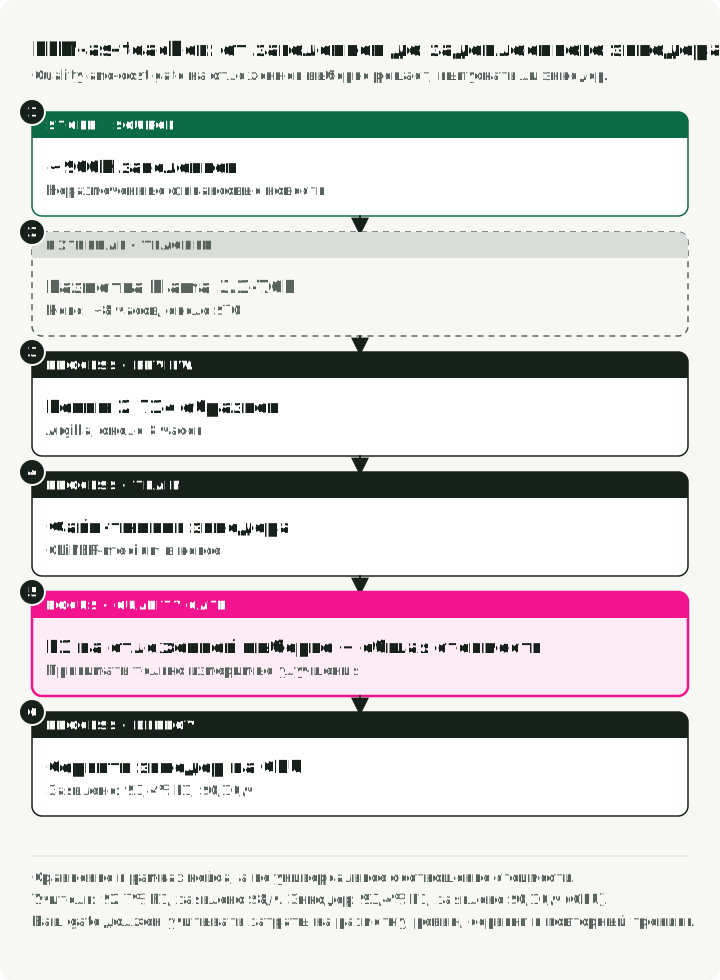
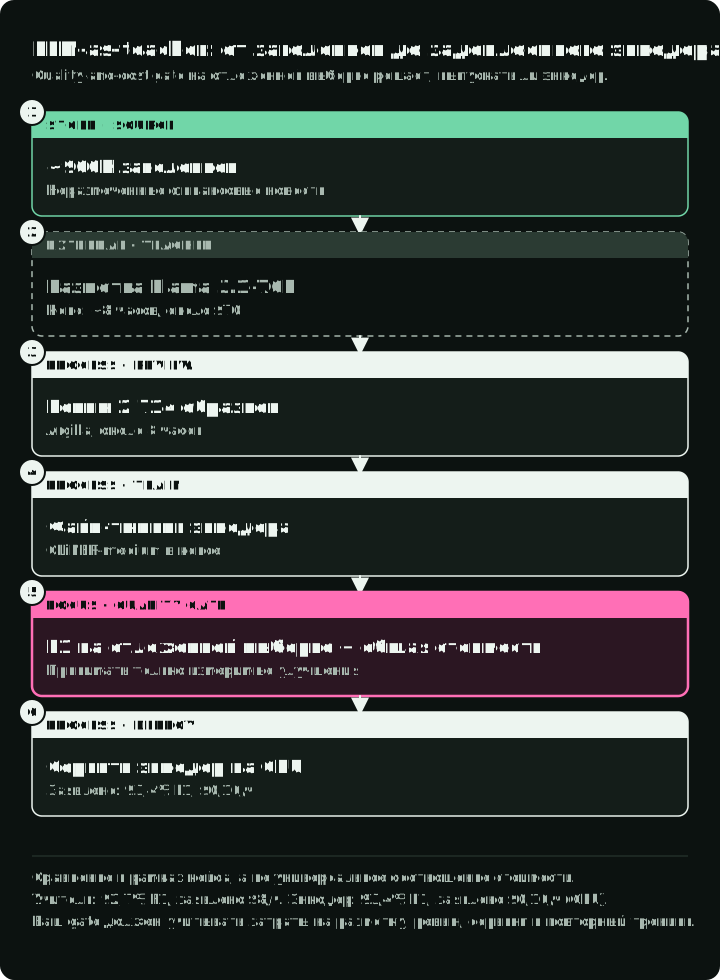
В кейсе на Hugging Face Capital Fund Management извлекала названия компаний примерно из 900 000 заголовков финансовых новостей. Zero-shot GLiNER показал 87,0% F1. Команда использовала Llama 3.1-70B, чтобы разметить датасет примерно за 8 часов и около $70, а затем проверила 2714 примеров через Argilla ещё за 8 часов.
Дообучение GLiNER на этих данных дало в кейсе 93,4% F1 против 92,7% у учителя Llama-70B. Авторы сообщают о $0,10 в час на CPU для дообученной модели и $8 в час для учителя (кейс CFM). Эти цифры описывают одну задачу на финансовых новостях и одну конфигурацию инфраструктуры.
Исследование Refuel AI
Технический отчёт вендора Refuel AI сравнивает разметку LLM на 8 датасетах NLP, включая CoNLL-2003. Он сообщает о 88,4% согласия с эталоном у GPT-4 (март 2023) и 86,2% у людей-аннотаторов в их постановке, а также о разметке в 20 раз быстрее и в 7 раз дешевле. Отдельный эксперимент с ансамблем на проприетарных данных превысил 95% согласия, при этом лучшая отдельная LLM дала 89%. Роутинг по уверенности на более дешёвые или более сильные модели — предлагаемое применение, а не измеренный механизм, стоящий за результатом на восьми датасетах (технический отчёт Refuel AI).
Продакшен-пайплайн
Практичный продакшен-процесс состоит из шести шагов. На схеме каждый шаг стоит в дорожке того, кто его выполняет, с цифрами CFM и возвратом к ревью, когда ученик не достигает цели. График под ней сравнивает F1 и стоимость часа у CFM для учителя и ученика.
- Напишите руководство по разметке на естественном языке.
- Создайте размеченные людьми валидационный и отложенный тестовый наборы. Процедура определения их размера приведена в разделе об оценке ниже.
- Используйте LLM с версионированным промптом и явной схемой вывода, чтобы предложить массовые обучающие метки. Сохраняйте запрошенную и фактическую модель, промпт и исходный текст. Отклоняйте неизвестные типы и спаны, которые нельзя привязать к исходному тексту.
- Проверьте подмножество через Argilla или Label Studio.
- Дообучите компактный энкодер (GLiNER, SpanMarker, RoBERTa). Для GLiNER используйте
train.pyиз репозитория (python train.py --config configs/config.yaml) или методtrain_model()модели, передав проверенный обучающий файл как обучающие данные, а валидационный файл — для оценки во время обучения. - Выкатывайте только после того, как энкодер пройдёт проверку качества и полной стоимости на отложенном наборе. CFM сообщила о почасовой стоимости инфраструктуры в 16–80 раз ниже в её конфигурации; включите в своё сравнение стоимость разметки, проверки, сервинга и переобучения.
LLM может уменьшить объём ручной разметки, но команда по-прежнему отвечает за валидационный набор, руководство по разметке, целевую проверку и анализ ошибок.
Репозиторий-компаньон демонстрирует одно предложение учителя и преобразует проверенную разметку для шага 5 (раздел README). Выполняйте эти команды в репозитории-компаньоне с Python 3.11+, uv и зависимостями, установленными через uv sync --locked --all-extras. Задайте OPENAI_API_KEY для платного вызова учителя. Преобразованию нужны закэшированные файлы закреплённой модели GLiNER и её backbone; uv run --all-extras python -m ner_demo.quickstart --download загружает их один раз.
-
Запустите демо учителя для одного документа. Оно делает один платный запрос для фиксированного предложения о предложенном приобретении Arm компанией NVIDIA и записывает одну непроверенную запись в
artifacts/teacher_annotations.jsonl:uv run --all-extras python -m ner_demo.teacher --allow-paid -
Проверьте предложение вручную и разберите отклонённые аннотации. Подготовьте
artifacts/reviewed.jsonlс проверенными обучающими документами и отдельно размеченными людьми документами разработки и тестирования из производственного процесса выше. Все три подмножества должны быть непустыми, идентификаторы документов должны быть уникальными, и ни один исходный текст не должен встречаться более чем в одном подмножестве. Не копируйте демонстрационное предложение между подмножествами. В каждой записи задайтеreviewed: true,reviewer,status: "ok"иsplit(train,developmentилиtest), аsource_sha256должен соответствовать исходному тексту. Одна демонстрационная запись не может обеспечить все три подмножества. -
Преобразуйте полный проверенный файл. Он записывает
train.json,development.jsonиtest.jsonвartifacts/training/в обучающем формате GLiNER, пропустив каждую строку через собственный data collator GLiNER:uv run --all-extras python -m ner_demo.training artifacts/reviewed.jsonl
Передайте train.json и development.json в запуск дообучения GLiNER на шаге 5, а test.json оставьте для финальной проверки.
Где GLiNER не справляется и LLM остаются полезными
Бенчмарк Sease (октябрь 2025) сравнил GLiNER с GPT-4.1-mini на 30 задачах разбора запросов. GPT-4.1-mini получил 100% полностью верных ответов. GLiNER — 53% (16 из 30). Зато GLiNER отвечал за 0,08 секунды против 1,21 секунды у LLM, то есть в 15 раз быстрее.
В этом бенчмарке из 30 задач GLiNER ошибался по трём повторяющимся схемам:
- Неявные сущности: извлечь «event» из «Elton John performed at Madison Square Garden». В тексте нигде нет слова «event», а LLM выводит «concert».
- Чувствительность к формулировке метки: «2022» получает 0,388 для метки «date», но 0,958 для «year». Небольшие изменения метки вызывают большие скачки оценки.
- Маппинг значений: GLiNER возвращает точный текст из источника («family houses») вместо канонического значения («Single family house»). LLM может выполнить такую нормализацию, если её промпт и схема задают целевые значения.
Вложенные и перекрывающиеся сущности
Вложенная сущность находится внутри другой. В «New York University» «New York» — это локация внутри названия организации. В биомедицинских текстах («acute myeloid leukemia» внутри более длинного диагноза) и юридических (отдел внутри названия ведомства) тот же паттерн.
GLiNER по умолчанию использует плоское декодирование, которое подавляет перекрывающиеся спаны. Его API также поддерживает flat_ner=False, что разрешает перекрывающиеся предсказания:
entities = model.predict_entities(
    "She studied at New York University.", ["organization", "location"],
    flat_ner=False, threshold=0.3)
# [{'text': 'New York University', 'label': 'organization', 'score': 0.855, ...}]
С urchade/gliner_medium-v2.1 этот вызов вернул только организацию, даже при пороге 0,05. Отключение плоского декодирования разрешает вложенный вывод, но чекпоинт всё равно должен оценить внутренний спан выше порога. Если в ваших данных есть вложенные сущности, соберите вложенный тестовый набор и проверьте, появляются ли внутренние спаны вообще, прежде чем выбирать GLiNER вместо специализированной модели для вложенного NER.
Используйте GLiNER для явного извлечения сущностей, а случаи, где требуются инференс, ризонинг или маппинг на предопределённые онтологии, отправляйте в LLM. Порог роутинга должен определяться по размеченному доменному набору.
Оценка NER: метрики, ловушки и тестовые наборы
Каждое число в этом руководстве получено на модели, данных и железе своего источника. Перед выбором повторите сравнение на собственном размеченном наборе. Этот раздел объясняет, как собрать такой набор и оценить на нём модель.
Модель может набрать 95% F1 на отобранном тестовом наборе и всё равно ошибаться на смеси документов, которую увидит после деплоя. Собирайте оценочный набор из продакшен-распределения и держите срезы для редких форматов и типов сущностей, которые агрегированный F1 может скрыть.
Основные метрики
Идентифицируйте каждое вхождение по ID документа, полуоткрытым смещениям начала и конца и типу и проверяйте, что text[start:end] возвращает упоминание. Два вхождения «John» — это две цели. Схема оценивает три предсказания для одного предложения.
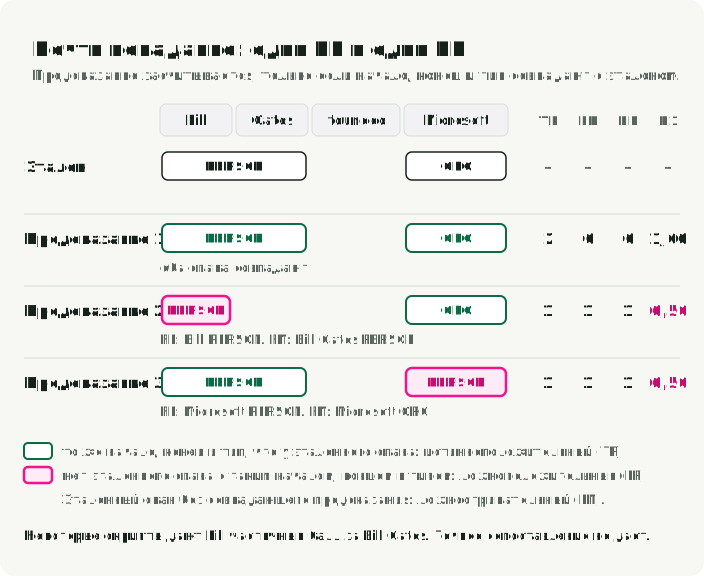
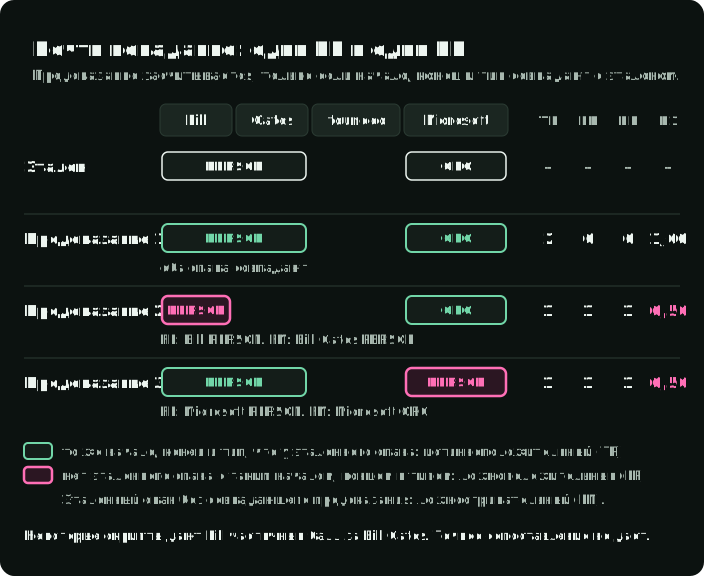
Проверяйте число документов до сопоставления: отсутствующие предсказания должны порождать ложноотрицательные результаты, а не пропадать через zip(). Неверный тип или смещения считайте несопоставленным предсказанием и несопоставленным эталонным спаном. Сообщайте micro precision, recall и F1, поддержку и recall по типам, а также определите макро-агрегацию и пустые случаи. Точный оценщик из репозитория-компаньона реализует эти правила и оставляет отсутствующие, неудавшиеся и пропущенные документы в знаменателе эталона.
- F1 на уровне сущностей: стандартная метрика. Предсказание верно, только если и границы спана, и тип точно совпадают с эталоном. Именно её приводит большинство статей.
- F1 на уровне токенов: оценивает каждый токен независимо. Из-за неё частичное попадание в границы может выглядеть лучше, чем по exact-span оценке, поэтому, когда важна корректность границ, сообщайте exact-span F1; метрики на уровне токенов используйте, только когда последующее решение принимается на уровне токенов.
- Precision и recall: у них часто несимметричная цена. При деидентификации важнее recall: пропустить имя хуже, чем скрыть лишнее. При извлечении в базу данных важнее precision: ложные записи портят последующий анализ.
Типичные ловушки оценки
- Завышение из-за частичных совпадений: извлечено «Bill», а эталон — «Bill Gates». Некоторые скрипты засчитывают это как частичное совпадение. Используйте точное сопоставление спанов, если нет причины поступать иначе.
- Путаница типов: «Microsoft», верно найденный как спан, но помеченный PERSON вместо ORG, должен получать ноль. Проверьте, что ваш код оценки это учитывает.
- Утечка тестового набора: не допускайте в тестовый набор дубликаты и почти дубликаты записей, документов и аннотаций. Для строгого zero-shot утверждения также не допускайте целевые типы сущностей в обучение; одни лишь повторяющиеся поверхностные строки утечкой не являются.
- Неконтролируемые промпты меток: короткое название типа и проверенное описание типа — это разные входы. Версионируйте описания меток, пороги, ревизии чекпоинтов и режим декодирования вместе с оценкой.
- Zero-shot утверждения только для одного языка: не выводите многоязычное качество из английского. OpenNER охватывает 36 корпусов и 52 языка, и его базовые линии не нашли единой лучшей модели для каждого языка (Palen-Michel et al., 2025). В экспериментах FiNERweb переход от английских меток к меткам на целевом языке менял F1 на 0,02–0,09 в зависимости от постановки (Golde et al., 2026). Если продукт использует локальную терминологию, проверьте оба языка меток.
- Один прогон как итоговый результат: сообщайте разброс по случайным зёрнам там, где это применимо, перебор порогов и повторные продакшен-выборки. Малое число примеров в срезах делает ранжирование моделей нестабильным.
Нормализацию, entity linking, группировку записей и концы связей оценивайте отдельно от экстрактивного F1. Для приватности сообщайте утёкшие экземпляры и затронутые автоматически принятые документы, необоснованное скрытие и долю проверки. Для сервинга сообщайте долю завершённых запросов, латентность документа p50/p95, холодные и тёплые прогоны, размеры батча и набора меток, пиковую память и стоимость на один принятый документ.
Сборка доменного тестового набора
Для продакшен-оценки я рекомендую следующее:
- Берите выборку из продакшен-данных, а не отобранные примеры. Включите неаккуратные документы, которые модель реально увидит.
- Определяйте размер тестового набора по пилоту. Разметьте пилот примерно из 50 документов, посчитайте эталонные спаны на метку и оцените recall по каждой метке бутстрепом. Добавляйте документы, пока 95%-й интервал для самой редкой важной вам метки не станет уже, чем различие, которое нужно обнаружить.
- Используйте минимум двух аннотаторов на калибровочном подмножестве. Разберите расхождения и сообщите exact-span F1 между спанами двух аннотаторов. Согласие показывает, где руководство по разметке неоднозначно; это не верхняя граница качества модели.
- Стратифицируйте по сложности: простые случаи (чистый текст, стандартные типы) и сложные (неоднозначные сущности, жаргон, зашумлённый текст).
- Держите срезы по приватности и справедливости. Для PII сообщайте recall по типу PII, языку, локали, формату документа и релевантным демографическим срезам или срезам по происхождению имён. Минимизируйте доступ оценщиков к исходному чувствительному тексту, задайте сроки хранения и проверяйте ложноотрицательные результаты.
Continual NER требует неизменяемого регрессионного набора
Продакшен-таксономии меняются. Добавляйте новые типы, не меняя незаметно смысл старого типа. Держите версионируемый неизменяемый регрессионный набор для существующих типов, отдельный тестовый набор для нового типа и журнал изменений руководства по разметке. Перед заменой чекпоинта сообщайте оценки по старым и новым типам отдельно. Это самый простой способ заметить забывание и дрейф таксономии.
Продакшен-NER в четырёх отраслях
В каждой области извлекается своё и есть своя опубликованная отправная точка. Последний столбец называет оговорку, которая меняет то, что проверять в первую очередь.
| Область | Что извлекается | Отправная точка | Оговорка, меняющая выбор |
|---|---|---|---|
| Здравоохранение | Имена, даты, ID и другие PHI для деидентификации | Оценки John Snow Labs и Providence выше; открытые медицинские модели NER от OpenMed | Сообщайте утёкшие экземпляры и затронутые документы, а не только F1. |
| Финансы | Упоминания компаний в новостях; поля в отчётности | Кейс CFM для новостей; FinBERT-MRC для отчётности (92,78 F1 на ChFinAnn, 96,80 на AdminPunish) | Результаты FinBERT-MRC получены на китайской отчётности; отдельно проверьте английские документы SEC, длинные документы и вложенные сущности. |
| E-commerce | Тип продукта, бренд и атрибуты в поисковых запросах | EAMT от Walmart (около 60 меток NER для запросов); TripleLearn от Home Depot (F1 на отложенном наборе 69,5 → 93,3, в продакшене 9+ месяцев) | TripleLearn — это повторяющиеся раунды доменного обучения с учителем; статья не сравнивает современные архитектуры. |
| Кибербезопасность | Вредоносное ПО, группировки угроз и индикаторы компрометации | CyNER (76,66 span micro-F1, XLM-RoBERTa-large); CyberNER (21 метка STIX 2.1, RoBERTa 0,736 F1) | Только исследовательские датасеты; наборы меток различаются, поэтому перед сравнением моделей сопоставьте их со STIX. |
Оптимизация деплоя: от Python к инференсу с меньшей латентностью
Когда модель проходит доменный тестовый набор, следующий вопрос — как её обслуживать. Вот порядок, в котором я бы пробовал рантаймы, с проверкой после каждого шага. Меняйте что-то одно за раз, чтобы у падения качества была одна причина.
- Сервинг через PyTorch и Ray Serve.
- Экспорт в ONNX FP32 или запуск через gline-rs. Если спаны отличаются от PyTorch, исправьте экспорт.
- Квантизация в динамический INT8 с FFN down-projections в FP32.
- Выкатывайте INT8, только если recall по меткам остаётся в пределах цели. Иначе оставьте FP32.
Нативный сервинг GLiNER
Прежде чем переходить на новый рантайм, проверьте путь Ray Serve проекта. gliner[serve] даёт динамический батчинг, подбор размера батча с учётом памяти, масштабирование на несколько реплик и HTTP-клиент. Батчинг и реплики могут повысить throughput, сохранив код модели. Батчинг также добавляет время ожидания, поэтому измеряйте латентность очереди и тёплую латентность на вашей смеси запросов.
Экспорт в ONNX
В GLiNER есть нативное преобразование в ONNX, а готовые модели лежат на Hugging Face (onnx-community/gliner_small-v2.1). Экспорт записывает граф, конфиг и токенизатор в один каталог, и тот же класс GLiNER загружает его обратно с тем же вызовом predict_entities:
from gliner import GLiNER

model = GLiNER.from_pretrained("urchade/gliner_medium-v2.1")
model.export_to_onnx("onnx/fp32")

onnx_model = GLiNER.from_pretrained("onnx/fp32", load_onnx_model=True)
entities = onnx_model.predict_entities(text, labels, threshold=0.5)
Сравнение ONNX из репозитория-компаньона запускает PyTorch, ONNX FP32 и ONNX INT8 на одних и тех же входах и сравнивает их спаны. Нужны Python 3.11+ и uv. Команда для данных загружает зафиксированный шард Few-NERD и оставляет его первые 32 предложения — достаточно, чтобы проверить экспорт, но не чтобы ранжировать модели. Quickstart с --download один раз загружает зафиксированный чекпоинт:
uv sync --locked --all-extras
# Run once if the pinned model files are not cached:
uv run --all-extras python -m ner_demo.quickstart --download
uv run --all-extras python -m ner_demo.data --split test --limit 32
uv run --all-extras python -m ner_demo.onnx_check \
  --dataset artifacts/few-nerd-test.json --output artifacts/onnx-comparison
Используйте новый выходной каталог или --reuse, чтобы проверить существующие пакеты. Команда завершается ошибкой, если спаны FP32 отличаются от PyTorch или если INT8 теряет более 0,02 micro recall. На CPU Apple M5 Max ONNX FP32 вернул ровно те же спаны, что и PyTorch, с латентностью p50 16–19 мс на предложение против 64–66 мс у PyTorch.
Квантизация INT8
Динамическая квантизация INT8 хранит веса как 8-битные целые и уменьшает файл ONNX. Для энкодера DeBERTa в GLiNER квантизовать каждый слой нельзя. В репозитории-компаньоне квантизация всех слоёв MatMul не вернула вообще ни одной сущности. Квантизация слоёв по одной группе показала причину: двенадцать FFN down-projections (layer.N/output/dense, второй линейный слой feed-forward сети каждого блока энкодера) одни опускают все оценки ниже порога. Если оставить эти двенадцать слоёв в FP32, проблема исчезает. Код копирует пакет FP32 (ради файлов конфига и токенизатора), а затем квантизует всё остальное:
import shutil

import onnx
from onnxruntime.quantization import QuantType, quantize_dynamic

shutil.copytree("onnx/fp32", "onnx/int8")
graph = onnx.load("onnx/fp32/model.onnx", load_external_data=False).graph
keep_fp32 = [n.name for n in graph.node if n.op_type == "MatMul" and "/output/dense/" in n.name and "/attention/" not in n.name]

quantize_dynamic("onnx/fp32/model.onnx", "onnx/int8/model.onnx",
                 weight_type=QuantType.QInt8,
                 op_types_to_quantize=["MatMul", "Gemm", "Gather"],
                 nodes_to_exclude=keep_fp32)
Загружайте onnx/int8 с load_onnx_model=True, как и FP32. quantize_package из репозитория-компаньона делает то же самое, а затем проверяет пакет. На 32 предложениях Few-NERD (Apple M5 Max, ONNX Runtime 1.24.4) измеренные результаты были такими:
| Путь | Пакет | Латентность p50 | Micro precision | Micro recall |
|---|---|---|---|---|
| PyTorch | - | 64-66 ms | 0.506 | 0.722 |
| ONNX FP32 | 790 MB | 16-19 ms | 0.506 | 0.722 |
| ONNX INT8 | 353 MB | 13-15 ms | 0.487 | 0.722 |
INT8 сократил пакет более чем вдвое и сохранил recall, но изменил спаны в 4 из 32 предложений и добавил 3 ложноположительных результата. В этом прогоне INT8 стоит использовать, когда ограничением служат память или размер пакета; если нужна только латентность, основной выигрыш дал экспорт в FP32 ONNX. Прежде чем выкатывать INT8, проверьте recall по меткам относительно FP32 на своих данных: меньший файл ничего не говорит о качестве извлечения. Текущие рекомендации GLiNER советуют quantization-aware training, когда точность INT8 должна совпадать с FP32.
gline-rs: реализация на Rust
gline-rs (Apache 2.0) убирает рантайм Python из пути инференса. Проект сообщает о throughput на CPU примерно вчетверо выше, чем у Python, в собственном бенчмарке. Он поддерживает спан-модели и токен-модели, GPU/NPU через ONNX Runtime и поставляется как крейт на crates.io. Он загружает экспорт ONNX и его tokenizer.json, например пакет, записанный выше; README проекта показывает вызов на Rust.
Пакет fast-gliner предоставляет привязки для Python через PyO3.
Какой рантайм когда использовать
| Путь | Когда использовать | Доступные данные | Что измерить перед деплоем |
|---|---|---|---|
| Нативный Ray Serve | Хотите остаться на Python и добавить батчинг и реплики | Документация проекта GLiNER | Латентность очереди, тёплая латентность, throughput |
| ONNX FP32 | Первая смена рантайма на любом железе | Репозиторий-компаньон: те же спаны, что у PyTorch, латентность ниже в 3,4–4 раза | Тёплая латентность, throughput и exact-span F1 |
| ONNX INT8 | Ограничение — память или размер пакета на CPU | Репозиторий-компаньон: 353 МБ против 790 МБ, тот же recall, 3 лишних FP | Recall и precision по меткам относительно FP32 |
| gline-rs | Нужно убрать рантайм Python | Бенчмарк проекта на документированном железе и конфигурации | Ваш режим модели, метки, железо и батч |
Структурированное извлечение: нативные схемы, Instructor и локальные декодеры
Когда нужна более гибкая схема, чем дают энкодеры (неявные сущности, ризонинг, маппинг на онтологию), начните с нативного механизма схем у провайдера. OpenAI поддерживает строгие форматы ответа json_schema, structured outputs Anthropic поддерживают вывод JSON и строгие входные данные инструментов, а Gemini API поддерживает подмножество JSON Schema. Общая модель Pydantic или Zod может описывать контракт, но каждый провайдер принимает своё подмножество схем и по-своему ведёт себя при отказах и сложных схемах.
Соответствие схеме делает разбор надёжным. Оно не доказывает, что извлечённый спан существует в исходном тексте или что нормализованное значение верно. Проверяйте значения полей, по возможности сохраняйте смещения или цитаты и оценивайте семантическую точность на размеченном наборе.
Три библиотеки ниже обеспечивают структуру по-разному. На схеме через каждую проходит одно предложение: Instructor валидирует и повторяет попытки, Outlines блокирует недопустимую метку при декодировании, а LangExtract возвращает символьные смещения для каждого поля.
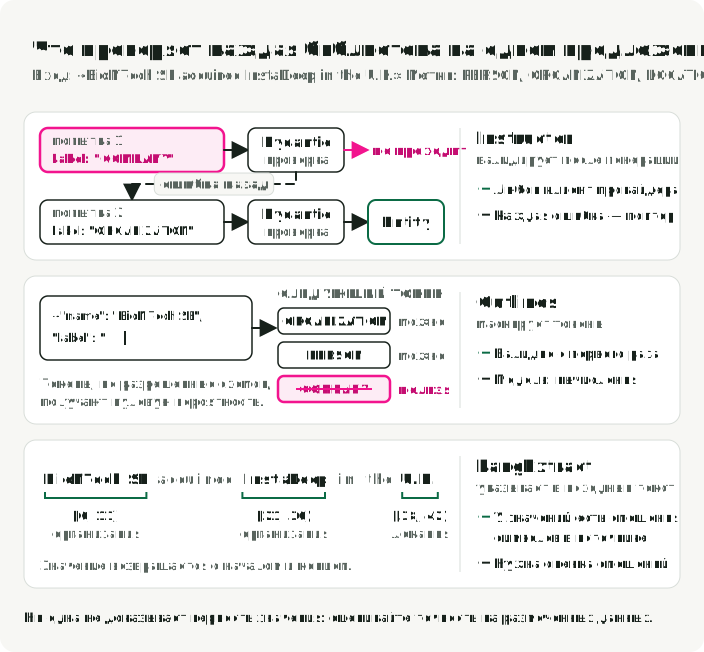
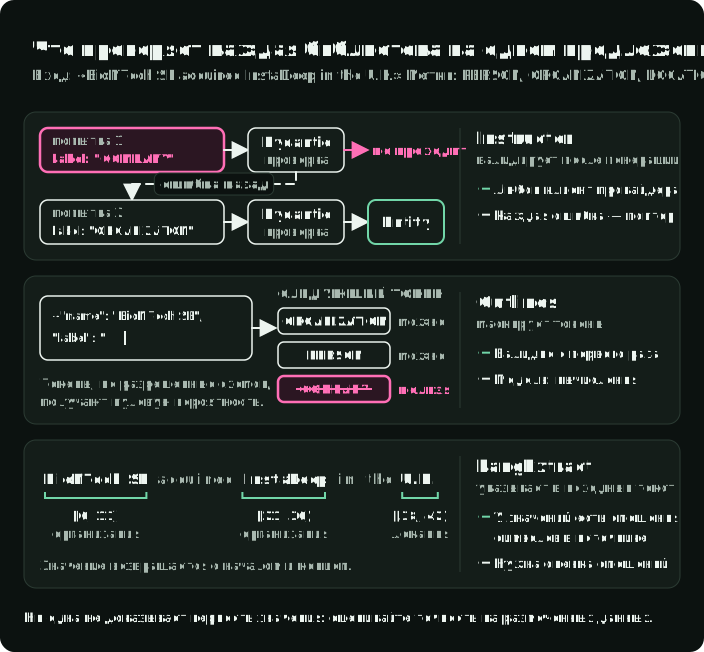
Instructor оборачивает клиентов провайдеров валидацией Pydantic и необязательными повторами после ошибок валидации.
Этому автономному примеру нужны pip install instructor openai pydantic, OPENAI_API_KEY и платный запрос к провайдеру. Подойдёт любая модель с поддержкой structured output; в примере используется gpt-5.4-mini, как и по умолчанию у учителя в репозитории-компаньоне.
import instructor
from pydantic import BaseModel
from typing import List, Literal
from openai import OpenAI

class Entity(BaseModel):
    name: str
    label: Literal["PERSON", "ORGANIZATION", "LOCATION"]

class ExtractEntities(BaseModel):
    entities: List[Entity]

client = instructor.from_openai(OpenAI())
result = client.chat.completions.create(
    model="gpt-5.4-mini", reasoning_effort="none",
    response_model=ExtractEntities,
    messages=[{"role": "user", "content": "BioNTech SE acquired InstaDeep in the U.K."}])
# entities=[Entity(name='BioNTech SE', label='ORGANIZATION'), ...]
Outlines от dottxt использует другой подход: ограниченную генерацию токенов через конечные автоматы. Декодер маскирует токены, которые нарушили бы целевую грамматику, вместо того чтобы ждать ошибки валидации и повторять запрос. В обзоре AWS приводится 98% соответствия схеме против 76% при валидации после генерации. Там же повторяется заявление .txt Engineering о генерации до 5 раз быстрее, без достаточных подробностей метода, чтобы сравнить две цифры.
В Outlines outlines.from_transformers оборачивает модель Hugging Face и её токенизатор. Вызов такой модели с промптом и классом Pydantic вроде ExtractEntities выше возвращает JSON, соответствующий классу. Для нового сравнения самостоятельно размещённого извлечения включите актуальную Qwen3.8-27B или более мелкие чекпоинты Qwen3.5. Загружайте их документированным загрузчиком модели, шаблоном чата и бэкендом сервинга; мультимодальной архитектуре или формату ризонинга может потребоваться больше, чем новый ID модели.
LangExtract полезен, когда сгенерированное поле должно быть привязано к источнику: он возвращает символьные интервалы и поддерживает облачные и локальные бэкенды LLM. Для самостоятельно размещённого извлечения из документов NuExtract преобразует JSON Schema в шаблоны и включает мультимодальные модели для документов. Оба — системы структурированного извлечения, а не готовая замена спановому NER: их поля, смещения и результаты по разметке нужно оценивать отдельно.
Выбор зависит от того, где вы запускаете модели. Нативные схемы — самый простой путь для поддерживаемого провайдера. Instructor добавляет не зависящий от провайдера слой валидации Pydantic с повторами. Outlines ограничивает локальную генерацию схемой. LangExtract в приоритете ставит привязку к источнику, а NuExtract нацелен на самостоятельно размещённое извлечение из документов. Все пути на LLM по-прежнему включают авторегрессионную генерацию, поэтому на одном и том же железе они обычно занимают на документ больше времени, чем энкодер.
Трёхуровневая продакшен-архитектура
Я бы направлял продакшен-NER по форме задачи, а не по единому рейтингу моделей. Каждая строка схемы показывает пример запроса, что возвращается и какие модели стоит проверить. Проверенные случаи Tier 3 возвращаются в Tier 1 только как спаны, найденные в исходном тексте.
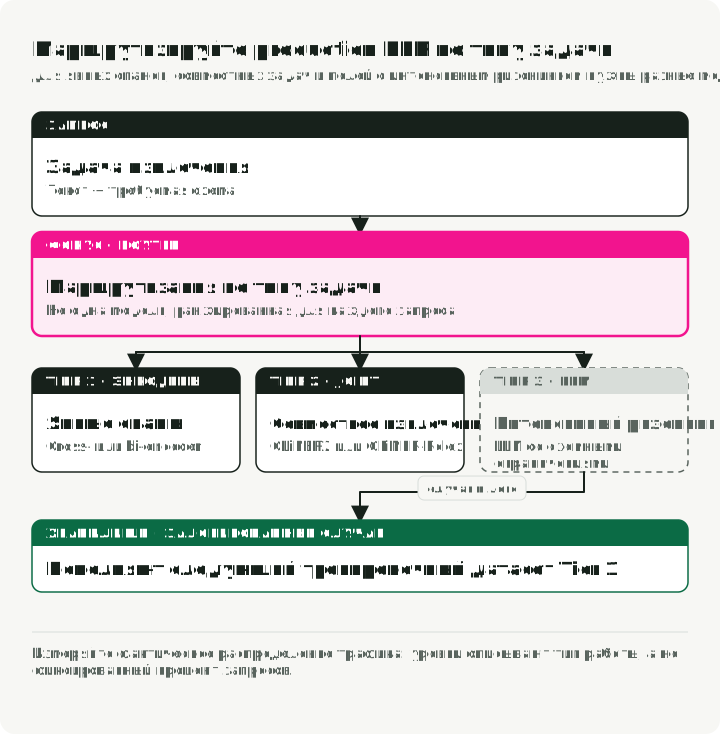
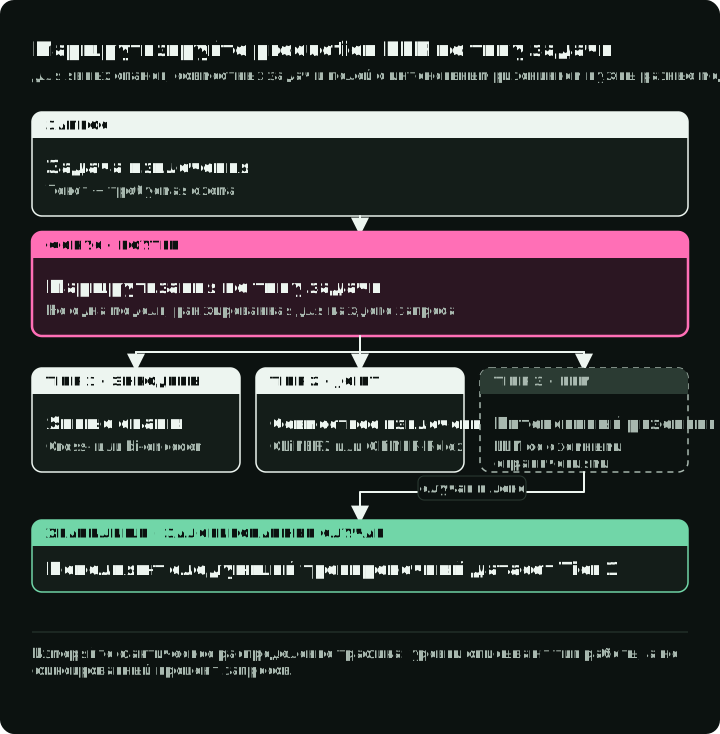
Tier 1: модели-энкодеры для явных спанов. Используйте GLiNER cross-encoder для небольшого набора типов. Когда большой набор переиспользуется, сравните bi-encoder с кэшированными эмбеддингами типов. Дообучайте через пайплайн LLM-as-teacher, затем деплойте с нативным сервингом, ONNX, INT8 или gline-rs, только если этот путь проходит доменный бенчмарк.
Tier 2: мультизадачное извлечение или извлечение связей. Когда одному запросу нужны NER, классификация и иерархические поля, проверьте текущий чекпоинт GLiNER2.5 на 194M параметров против отдельных базовых линий по задачам. Когда главное требование — совместные спаны и связи, проверьте GLiNER-Relex. Статья GLiNER2 сообщает о латентности классификации на CPU 130–208 мс на всех проверенных числах меток; более позднее API связей она не измеряла.
Tier 3: LLM для извлечения, требующего ризонинга. Неявные сущности, контекстный вывод и маппинг на онтологию направляйте в нативное schema API или Instructor для облачных API, а для локального ограниченного вывода — в Outlines. Используйте LangExtract, когда критичны интервалы в источнике, и NuExtract, когда входом служит сам документ. Логируйте эти случаи для проверки. Обычными обучающими целями Tier 1 могут стать только явные спаны, выровненные по источнику; выведенным фактам и нормализованным значениям нужны собственные цели и оценка.
Кейс CFM даёт один ориентир по стоимости для Tier 1: 93,4% F1 при заявленных $0,10 в час на CPU против 92,7% F1 и $8 в час у её учителя Llama-70B. Почасовая цена инстанса без throughput не определяет стоимость на документ. Пересчитайте для вашего железа, учителя, набора меток, загрузки и стоимости проверки.
Компромиссы и ограничения
Ошибки LLM-as-teacher распространяются. Если LLM стабильно ошибается с определённым типом сущности (например, путает названия дочерних компаний с материнскими), дообученный энкодер наследует это смещение. Тщательно проверяйте типы с низкой уверенностью или несогласованные и держите стратифицированную случайную выборку, чтобы ловить уверенные систематические ошибки.
Корректная схема может содержать ложные факты. Нативный structured output, Instructor и constrained-декодеры могут сделать ответ пригодным для разбора. Они не гарантируют, что каждое поле подтверждено источником, что граница спана верна или что нормализованное значение соответствует нужной записи. Сохраняйте подтверждение из источника и проверяйте семантику отдельно.
Потери при квантизации зависят от чекпоинта и квантизуемых слоёв. Квантизация каждого слоя MatMul в GLiNER из репозитория-компаньона не вернула ни одной сущности; сохранение FFN down-projections в FP32 сохранило recall в его проверке на 32 предложениях. У другого чекпоинта чувствительными могут оказаться другие слои. Перед деплоем сравните квантизованную и исходную модели по exact-span F1 и recall по меткам.
Когда трёхуровневая архитектура избыточна. Одному домену со стабильными типами сущностей и достаточным числом размеченных примеров может хватить дообученного RoBERTa или пайплайна spaCy. Трёхуровневый паттерн подходит для нескольких доменов, эволюционирующих типов сущностей или измеренной смеси явного извлечения и извлечения, требующего ризонинга. Узкий пайплайн счетов, извлекающий имена и даты, может остановиться на Tier 1.
Качество bi-encoder зависит от датасета и размера чекпоинта. На CoNLL-2003 gliner_small-v2.5 достигает 65,4% F1: выше bi-encoder edge/small с 61,6%/64,2%, но ниже bi-base/large с 65,6%/66,5% (Stepanov et al., 2026, таблицы 2–3). Выбирайте по измеренному exact-span качеству, калибровке, числу меток и throughput на вашем доменном наборе.
Утверждения о PII и многоязычности требуют срезов. Высокая агрегированная оценка может скрывать опасное падение recall для локали, формы имени, макета документа или редкого класса PII. Используйте модель приватности как одну из нескольких мер, определите процесс реагирования на ложноотрицательные результаты и переоценивайте при смене таксономии, языкового состава или источника данных.
Ключевые выводы
- Используйте компактный энкодер для явных спанов, только когда он прошёл доменный тестовый набор с поддержкой по типам и доверительными интервалами.
- Используйте GLiNER для меняющихся словарей меток. Сначала сравнивайте его bi-encoder, когда переиспользуется большой набор типов; включайте
flat_ner=Falseтолько после проверки, что чекпоинт находит внутренние спаны. - Используйте spaCy или дообученный токен-классификатор, когда метки стабильны и есть обучающие данные.
- Для строгих zero-shot утверждений используйте проверенные описания типов, а для многоязычных продуктов отдельно проверяйте английские и локализованные формулировки меток.
- Держите OCR, NER, извлечение связей и entity linking отдельными этапами оценки, даже если одна модель выполняет несколько задач.
- Рассматривайте учителя-LLM как систему предложения разметки. Руководство по разметке от людей, разбор расхождений, неизменяемые регрессионные наборы и отложенный тестовый набор по-прежнему обязательны.
- Используйте нативные схемы для поддерживаемых провайдеров LLM, но проверяйте семантическую корректность и привязку к источнику отдельно от валидности JSON.
- Меняйте за раз один шаг рантайма: сначала ONNX FP32, затем INT8 с чувствительными слоями в FP32, сравнивая спаны после каждого шага.
Ссылки
Статьи
- GLiNER: Generalist Model for Named Entity Recognition using Bidirectional Transformer - Zaratiana et al., NAACL 2024. Базовая архитектура сопоставления спанов и сущностей.
- GLiNER2: An Efficient Multi-Task Information Extraction System with Schema-Driven Interface - Zaratiana et al., EMNLP 2025 System Demonstrations. Объединяет NER, классификацию и иерархическое извлечение; текущие релизы позже добавили извлечение связей.
- GLiNER Bi-Encoder: Scalable Named Entity Recognition with Bi-Encoder Architecture - Stepanov et al., февраль 2026. Раздельное кодирование для масштаба в миллион меток.
- GLiNER-Relex: A Unified Framework for Joint Named Entity Recognition and Relation Extraction - Stepanov et al., 2026. Совместное zero-shot извлечение сущностей и связей.
- GLiNER2-PII: A Multilingual Model for Personally Identifiable Information Extraction - Zaratiana et al., 2026. 42 типа PII с разрешением до символьного спана.
- ZeroNER: Fueling Zero-Shot Named Entity Recognition via Entity Type Descriptions - Cocchieri et al., ACL 2025. Строгая zero-shot оценка с описаниями типов.
- OpenNER 1.0: Standardized Open-Access Named Entity Recognition Datasets in 50+ Languages - Palen-Michel et al., EMNLP 2025. 36 корпусов, 52 языка и базовые линии для нескольких онтологий.
- FiNERweb: Datasets and Artifacts for Scalable Multilingual Named Entity Recognition - Golde et al., EACL 2026. Многоязычные метки и оценка переноса.
- UniversalNER: Targeted Distillation from Large Language Models for Open Named Entity Recognition - Zhou et al., ICLR 2024. Универсальный NER на основе LLM через дистилляцию из ChatGPT.
- NuNER: Entity Recognition Encoder Pre-training via LLM-Annotated Data - Bogdanov et al., EMNLP 2024. Изучает энкодер на 125M, предобученный на разметке LLM.
Отраслевые статьи
- EAMT: Entity-Aware Multi-Task Learning for Query Understanding - Walmart, KDD 2023. Мультизадачное понимание запросов с примерно 60 метками NER.
- TripleLearn: End-to-End NER for E-Commerce Search - Home Depot, AAAI 2021. F1 с 69,5 до 93,3.
- CyNER: A Python Library for Cybersecurity Named Entity Recognition - Нейросетевое распознавание в сочетании с другими источниками извлечения.
- CyberNER: A Harmonized STIX Corpus for Cybersecurity NER - 21 тип сущностей, согласованный со STIX 2.1.
- FinBERT-MRC: Financial NER via Machine Reading Comprehension - Постановка MRC, оценённая на китайских финансовых датасетах.
Кейсы
- CFM Case Study: Fine-tuning GLiNER for Financial NER - Пайплайн разметки LLM от Capital Fund Management за $70, давший 93,4% F1.
- Refuel AI: LLM Labeling Technical Report - GPT-4 достигает 88,4% согласия разметки, превосходя людей-аннотаторов.
- Sease: GLiNER as an Alternative to LLMs for Query Parsing - Где GLiNER не справляется и LLM всё ещё нужны.
- John Snow Labs: Medical Text De-Identification Benchmark - Исследование вендора с переотображением меток и исключениями.
- OpenMed: Year in Review 2025 - Открытые медицинские модели NER; ретроспектива января 2026 года.
Инструменты и фреймворки
- Демо-репозиторий ner-field-guide - Код-компаньон к этой статье: точный подсчёт метрик по спанам, примеры GLiNER, конвертация проверенной разметки, проверки ONNX FP32 и INT8 и демо потокового PII.
- GLiNER - Библиотека, скрипт обучения и путь Ray Serve с динамическим батчингом и деплоем на несколько реплик.
- gline-rs: Rust reimplementation of GLiNER - Инференс на Rust по файлам GLiNER ONNX; код под Apache 2.0.
- Английские пайплайны spaCy - Версионированные метрики пайплайнов с закрытым набором меток.
- dslim/bert-base-NER - Токен-классификатор BERT, дообученный на CoNLL-2003.
- Microsoft Presidio - Анализ и анонимизация PII с собственными распознавателями.
- Instructor - Структурированное извлечение с LLM через модели Pydantic.
- Outlines - Ограниченная генерация токенов через конечные автоматы, с заявленным бенчмарком соответствия схеме.
- LangExtract - Структурированное извлечение с привязкой к источнику и символьными интервалами.
- NuExtract - Самостоятельно размещаемое извлечение из документов по схеме и шаблону.
- OpenAI Structured Outputs - Справочник по строгому формату ответа JSON Schema.
- Anthropic Structured Outputs - Вывод JSON и строгие входные данные инструментов.
- Gemini Structured Outputs - Подмножество JSON Schema для структурированных ответов.
- ONNX Runtime quantization - Справочник по динамической и статической квантизации INT8.
- AWS: Structured Output with Outlines - Бенчмарк соответствия схеме 98%.