Guía de NER 2026: GLiNER, spaCy, Transformers y LLMs

Traducción automática
Este artículo se tradujo automáticamente a partir de la versión original en inglés.
Esta guía está pensada para ingenieros que deben elegir un sistema de reconocimiento de entidades nombradas (NER) para pipelines de retrieval, privacidad o procesamiento de documentos. Explica cómo elegir entre reconocedores de spans y extracción estructurada con LLM, cómo evaluar sus errores y cómo probar las opciones de despliegue frente a la latencia y el coste que admite vuestra carga de trabajo.
NER convierte el texto en fragmentos etiquetados que un programa puede utilizar. Dada la frase «Bill Gates founded Microsoft on April 4, 1975», puede devolver los spans de texto contiguos Bill Gates, Microsoft y April 4, 1975, con los tipos persona, organización y fecha. En un encoder basado en spans, como GLiNER, el modelo lee el texto una vez y puntúa los spans candidatos frente a las etiquetas que le proporcionáis.
Para un pipeline de retrieval o de privacidad, lo primero que yo preguntaría es si la salida debe ser una mención literal. Esa decisión separa un reconocedor de spans de los sistemas que además normalizan valores, enlazan registros o infieren hechos. Los LLMs siguen siendo útiles para proponer anotaciones de entrenamiento y para los casos que exigen inferencia o normalización.
Repositorio complementario: ner-field-guide incluye puntuación de spans exactos, ejemplos de GLiNER, conversión de anotaciones revisadas, comprobaciones de ONNX FP32 e INT8 y una demo de PII en streaming.
Para una comparación breve de modelos, consultad Mejores modelos de NER en 2026.
¿Qué es el reconocimiento de entidades nombradas?
El reconocimiento de entidades nombradas encuentra spans en el texto y les asigna tipos como persona, organización, fecha, producto o etiquetas propias de un dominio. Un span es un fragmento contiguo del texto original. NER identifica la mención; el entity linking es el paso independiente que la resuelve a un registro canónico o a un concepto de una ontología.
| Carga de trabajo | Primer modelo que probar | Escalar cuando |
|---|---|---|
| ID o diccionarios controlados | Reglas o spaCy EntityRuler | Importe el recall fuera de los patrones conocidos. |
| Etiquetas estables y muchos datos de entrenamiento | spaCy o un encoder con fine-tuning | Cambie el conjunto de etiquetas o el recall se estanque en tipos raros. |
| Etiquetas cambiantes; inventario pequeño de tipos | GLiNER cross-encoder | Crezca el inventario o se reutilicen las etiquetas en muchos documentos. |
| Inventario grande y reutilizable de tipos | GLiNER bi-encoder | El conjunto del dominio muestre una regresión de calidad o de calibración. |
| Varias tareas de extracción en un mismo pipeline de texto | GLiNER2.5 | La calidad conjunta no alcance el objetivo de cada tarea. |
| Hechos implícitos o razonamiento sobre esquemas | Extracción estructurada con LLM | La latencia, el coste o las afirmaciones sin respaldo superen el presupuesto del producto. |
Un GLiNER cross-encoder lee a la vez los nombres de las etiquetas y el texto, de modo que cada documento vuelve a codificar todas las etiquetas. Un bi-encoder codifica las etiquetas por separado y puede guardarlas en caché. GLiNER2.5 es una familia de modelos distinta que extrae entidades, clases, relaciones y campos estructurados a partir de un único esquema. Cada uno tiene su propia sección más abajo.
Al recorrer esta lista, gana la primera coincidencia, en el orden en que yo haría las preguntas:
- La salida no es un span literal: usad structured output de LLM.
- ID o un diccionario fijo: usad reglas o un EntityRuler.
- Etiquetas fijas y datos de entrenamiento suficientes: usad spaCy o BERT-NER.
- Un conjunto grande de etiquetas reutilizado en muchos documentos: usad el GLiNER bi-encoder.
- En cualquier otro caso: usad el GLiNER cross-encoder y probad GLiNER2.5 cuando necesitéis varias tareas en una sola pasada.
Dónde se usan los sistemas modernos de NER
NER sigue encontrando spans de texto y asignándoles etiquetas. Lo que ha cambiado es su posición en el sistema. Ahora proporciona filtros para RAG, argumentos estructurados para las herramientas de los agentes y campos para los pipelines de procesamiento de documentos. Con esos usos, la latencia, el coste y la flexibilidad del esquema pesan tanto como la precisión en los benchmarks.
RAG: mejorar el retrieval mediante la extracción de entidades
La búsqueda por similitud por sí sola tiene dificultades cuando una pregunta contiene entidades exactas. Para «¿qué dijo Anthropic sobre la seguridad de los modelos en el cuarto trimestre de 2024?», la extracción de entidades puede proponer «Anthropic» y «Q4 2024» como filtros. Aplicad un filtro estricto solo cuando los metadatos indexados y la semántica de las fechas lo permitan; en caso contrario, usadlo como señal de ranking o conservad una ruta de retrieval sin filtrar. Un alias omitido o un rango de fechas mal inferido pueden excluir la respuesta.
Durante la indexación, extraéis las entidades de cada chunk y las guardáis como metadatos: {"organizations": ["Anthropic"], "dates": ["Q4 2024"], ...}. Así podéis filtrar por entidad antes de ejecutar la búsqueda vectorial. El RAG con grafos de conocimiento (GraphRAG, los grafos de propiedades de LlamaIndex) añade relaciones con nombre que el retrieval puede seguir a lo largo de varios saltos.
El diagrama recorre un índice de ejemplo con cuatro chunks. Compara los dos paneles inferiores: el filtro estricto nunca busca en el chunk cuya fecha guardada no tiene año, mientras que el refuerzo de ranking sí busca en él.
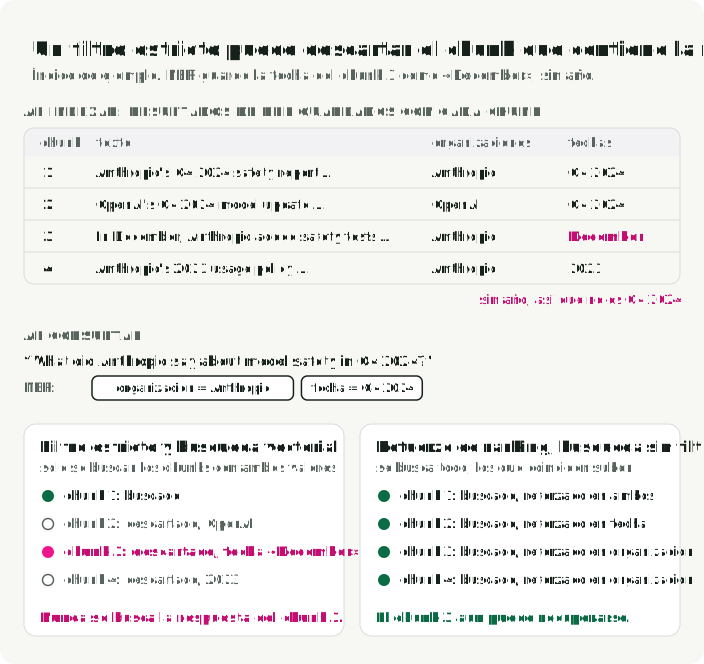
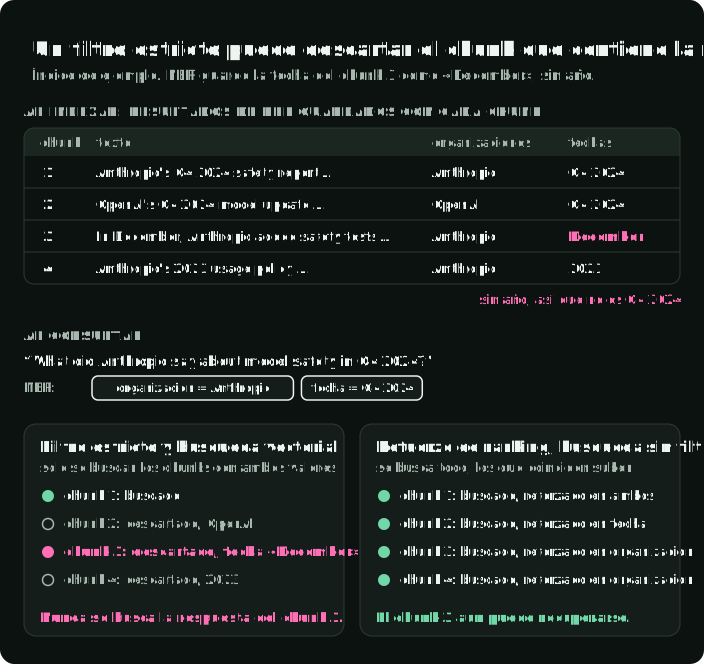
En el momento de la consulta, las entidades extraídas de la pregunta del usuario guían el enrutamiento. Una pregunta que menciona el nombre de una empresa va a un índice financiero; una que menciona nombres de fármacos va a una base de conocimiento clínica. GLiNER resulta útil cuando cambia el esquema o los tipos de entidad en la consulta. Que los nombres de empresas o de fármacos sean nuevos no exige por sí solo etiquetas de vocabulario abierto: un modelo de etiquetas cerradas también puede reconocer menciones nuevas de tipos conocidos.
Agentes de AI: convertir texto en hechos estructurados
Los agentes reciben texto no estructurado, como páginas web, respuestas de APIs y mensajes de usuarios. NER convierte ese texto en hechos estructurados sobre los que el agente puede razonar, que puede guardar o pasar a herramientas.
Para el enrutamiento a herramientas, una petición como «schedule a meeting with Sarah Chen from Accenture on Thursday at 2pm» puede producir PERSON: Sarah Chen, ORGANIZATION: Accenture, DATE: Thursday y TIME: 2pm. Después, un resolvedor de calendario combina la fecha y la hora en la marca de tiempo que exige la API. Un encoder local evita la ida y vuelta a la API, pero su latencia depende del modelo, el runtime, el hardware, el tamaño de batch y el número de etiquetas.
NER también sirve para seguir entidades a lo largo de las conversaciones. Los sistemas de memoria de los agentes necesitan saber que «Sarah» en el turno 3 y «la Sra. Chen» en el turno 12 son la misma persona. NER identifica los spans; la resolución de correferencias decide si las menciones se refieren a la misma persona en contexto. Después, el entity linking asigna esa persona a un registro canónico, cuando existe.
En ambos casos la restricción es la latencia. Si cada uno de diez pasos secuenciales hace una llamada de NER de 200 ms, esas llamadas suman 2 segundos de retraso percibido. Una sola llamada suma 200 ms. Los modelos encoder suelen encajar mejor que la extracción basada en LLM para el trabajo con entidades dentro de los agent loops.
Inteligencia documental: de las imágenes a los datos estructurados
El OCR convierte imágenes en texto. NER convierte ese texto en campos estructurados.
Un pipeline estándar usa primero OCR, como Tesseract, Azure Document Intelligence o AWS Textract, para producir texto y cuadros delimitadores. Después, NER encuentra spans para campos como invoice_number, vendor_name, total y due_date. Un paso de esquema o de extracción de relaciones debe agrupar las descripciones, cantidades y precios de las líneas de factura en line_items. La misma secuencia sirve para contratos, historiales médicos y documentos regulatorios.
Cada etapa tiene su propia puntuación. Un error de OCR que pierde un dígito parece un fallo de NER si solo puntuáis el registro final.
| Etapa | Qué produce | Puntuación |
|---|---|---|
| OCR y layout | Texto, orden de lectura, cuadros | Tasa de error de caracteres |
| NER | invoice_number, vendor_name, total | F1 de span exacto |
| Agrupación | Líneas de factura (descripción, cantidad, precio por fila) | F1 de registro |
| Enlazado y normalización | ID de proveedor, fechas ISO, importes | Precisión de enlazado o de normalización |
Los pipelines de documentos modernos pueden combinar comprensión del layout, extracción de entidades y extracción de relaciones. El OCR o un modelo de documentos que entienda el layout sigue aportando el texto, el orden de lectura, las tablas y los cuadros delimitadores. El GLiNER2.5 actual expone entidades, relaciones, clasificación y registros estructurados a través de una única interfaz de esquema; puntuad cada salida por separado.
El coste decide la mayoría de estos pipelines. Calculad el vuestro con el volumen mensual real de documentos, incluidos los reintentos y la revisión. Un encoder compacto puede ejecutarse en CPU, mientras que un LLM accesible por API añade coste de inferencia y latencia por documento. Una prueba práctica consiste en etiquetar con un LLM un conjunto representativo de facturas. Haced fine-tuning de GLiNER con los registros revisados y comparad ambas rutas en F1 por campo, latencia y coste total.
Detección de PII y guardrails para LLM
Leyes de privacidad como el RGPD, HIPAA y CCPA exigen salvaguardas para los datos personales, pero no exigen NER. NER puede encontrar datos personales para ocultarlos o minimizarlos; hay que comprobar su recall con vuestros datos antes de considerarlo un control.
Los modelos de desidentificación encuentran spans de PERSON, SSN, PHONE, EMAIL y ADDRESS y los ocultan o los sustituyen por equivalentes sintéticos. Microsoft Presidio combina reconocedores con operadores de anonimización, y sus ejemplos incluyen GLiNER como reconocedor. El modelo de 0,3B parámetros GLiNER2-PII es otro candidato: su artículo cubre 42 tipos de PII con resolución a nivel de span de caracteres.
En la comparación de John Snow Labs, realizada por el propio proveedor, 48 documentos anotados por expertos cubren seis clases de PHI. Las etiquetas de los proveedores se reasignaron y se excluyeron las predicciones que no se podían mapear, lo que limita la interpretación entre proveedores. El informe de Providence describe 281 eventos de PHI filtrados en una revisión de 1000 notas con 34 701 frases. Los eventos no son frases afectadas distintas: en una evaluación de privacidad, contad tanto las instancias filtradas como los documentos afectados.
Como guardrail de LLM, NER funciona como una capa de cribado previo: analiza la entrada del usuario en busca de PII antes de enviarla a una API externa y luego la bloquea o la anonimiza.
Un detector local puede ser más rápido que pedirle al LLM que se automodere, pero siguen siendo posibles los falsos negativos, así que añadid otro control para la exposición de PII que vuestro sistema no pueda aceptar. GLiNER es útil aquí porque las categorías de PII varían según la jurisdicción. Una API puede aceptar una etiqueta nueva como «genetic information» sin reentrenar. El recall de esa etiqueta nueva es desconocido hasta que lo comprobéis con ejemplos revisados.
GLiNER: matching de spans con etiquetas para NER de vocabulario abierto
GLiNER (NAACL 2024, Zaratiana et al.) hizo que el NER basado en encoders fuera competitivo con los LLMs a una fracción del coste. En lugar de tratar NER como etiquetado de secuencias o generación de texto, GLiNER lo trata como un problema de matching. Puntúa cada span de texto candidato (cada secuencia contigua de palabras como «Bill Gates» o «Microsoft») frente a cada etiqueta de tipo de entidad y conserva los pares con puntuación alta.
El modelo recibe las etiquetas de tipo de entidad y el texto de entrada como una única secuencia: [ENT] person [ENT] organization [ENT] date [SEP] Bill Gates founded Microsoft.... Un transformer bidireccional (DeBERTa-v3) lo codifica todo junto.
A partir de la salida, el modelo construye dos conjuntos de representaciones. Uno refina la representación de cada tipo de entidad a partir de la posición de un token [ENT] mediante una pequeña red feed-forward (FFN) que transforma el vector del encoder. El otro representa los spans de texto combinando los vectores de la palabra inicial y la final mediante otra FFN. Un producto escalar entre la representación de un span y la de un tipo de entidad da una puntuación.
Aplicando la sigmoide se obtiene la probabilidad de que el span que va de la posición de palabra a la posición de palabra pertenezca al tipo de entidad : . Aquí es el vector del span producido por la FFN y es el embedding del tipo de entidad refinado por la FFN a partir del token [ENT] correspondiente (Zaratiana et al., 2024, ecs. 1–2). Los spans candidatos se limitan a 12 palabras; el tokenizador puede dividir una palabra en varios tokens de subpalabra.
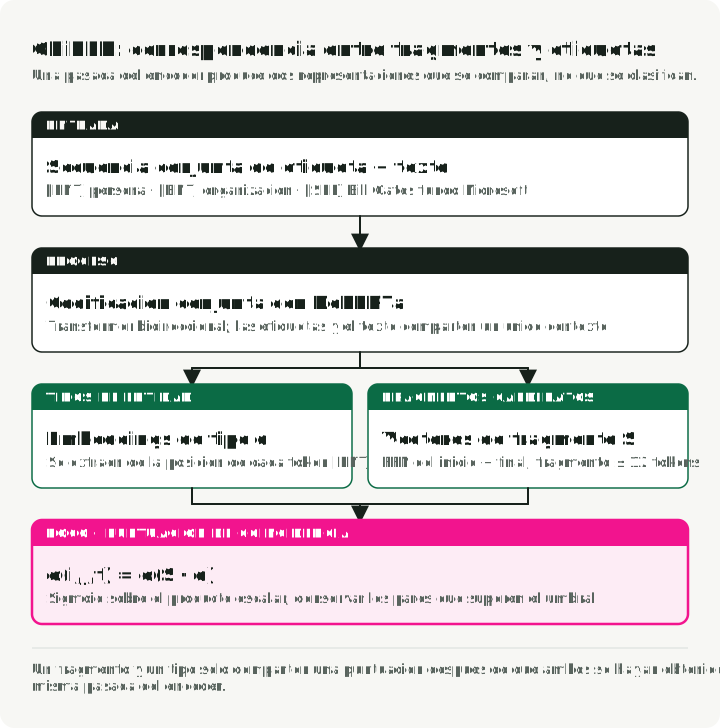
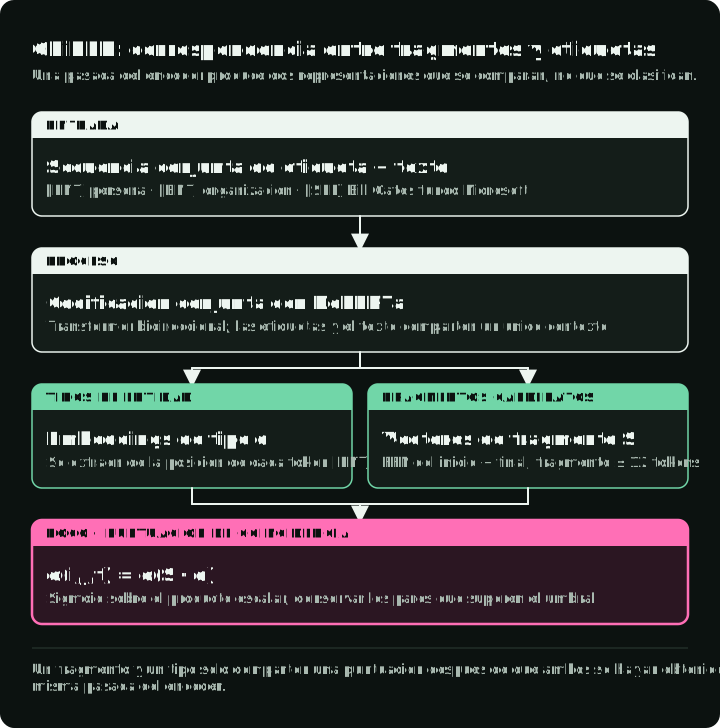
GLiNER acepta descripciones de etiquetas en lenguaje natural en el momento de la inferencia sin reentrenar, pero la calidad de la extracción depende de la redacción de las etiquetas y del ajuste al dominio. Le pasáis tipos de entidad como «person», «adverse drug reaction» o «financial instrument», y el modelo puntúa los spans frente a ellos. Las configuraciones de 50M, 90M y 300M que aparecen más abajo son los modelos del artículo original. La ficha del modelo v2.1 lista en cambio checkpoints en inglés de 166M, 209M y 459M, además de un checkpoint multilingüe de 209M, todos con licencia Apache 2.0. No comparéis latencia ni memoria entre esas generaciones como si los nombres de los parámetros fueran equivalentes (ficha del modelo GLiNER v2.1).
Para una prueba zero-shot realmente estricta, reservad fuera del entrenamiento tanto los tipos objetivo como los ejemplos objetivo: el modelo no tiene ejemplos etiquetados de la tarea objetivo. Una descripción de tipo como «a medically confirmed adverse effect caused by a treatment» da al modelo más información que adverse event a secas. Eso no garantiza la transferencia, pero ZeroNER, guiado por descripciones, superó a las baselines que solo usaban el nombre en sus benchmarks de tipos reservados (Cocchieri et al., 2025).
Los datos de entrenamiento del modelo original procedían del dataset Pile-NER: 44 889 pasajes con 240K spans de entidad de 13K tipos de entidad, todos etiquetados por ChatGPT. Entrenar GLiNER-L llevó unas 5 horas en una sola A100 (Zaratiana et al., 2024).
Resultados de benchmark
Resultados zero-shot de Zaratiana et al. (2024), tablas 1 y 2. El F1 combina precisión y recall en una sola puntuación; una puntuación más alta solo es mejor bajo la misma tarea y las mismas reglas de evaluación. La media de siete datasets combina cinco datasets de CrossNER con MIT Movie y MIT Restaurant:
| Modelo | Parámetros | F1 medio (CrossNER + MIT) | F1 medio (20 datasets) |
|---|---|---|---|
| GLiNER-L | 300M | 60,9 % | 47,8 % |
| GoLLIE | 7B | 58,0 % | — |
| UniNER-13B | 13B | 55,6 % | — |
| GLiNER-M | 90M | 55,4 % | — |
| UniNER-7B | 7B | 53,7 % | 45,7 % |
| GLiNER-S | 50M | 52,7 % | — |
| ChatGPT (GPT-3.5) | — | 47,5 % | 36,5 % |
GLiNER-M, con 90M parámetros, casi iguala a UniNER-13B en la media de siete datasets del artículo (55,4 % frente a 55,6 % de F1) con unas 140 veces menos parámetros. El GLiNER-S de 50M supera en 5 puntos de F1 el resultado publicado de ChatGPT (GPT-3.5). La variante multilingüe, entrenada solo con datos en inglés, supera esa misma baseline de ChatGPT en 8 de 10 idiomas distintos del inglés (Zaratiana et al., 2024). Estas comparaciones usan las versiones de modelo y el harness de evaluación del artículo; no dicen nada sobre los LLMs más recientes.
Una llamada mínima a GLiNER
Para una nueva comparación de cross-encoders, incluid los checkpoints GLiNER v2.5 mantenidos junto a v2.1. En la comprobación del repositorio complementario con 32 frases de Few-NERD, un dataset público de NER, gliner_small-v2.5 encontró 44 de los 54 spans de referencia y gliner_medium-v2.1 encontró 39. Esa muestra es demasiado pequeña para ordenar los dos modelos, pero es una razón para incluir v2.5 en vuestra propia ejecución. GLiNER v2.5 y GLiNER2.5 de Fastino (más abajo) son familias de modelos distintas.
La llamada siguiente carga el checkpoint medium de v2.1 e imprime cada span con su puntuación. La versión del repositorio complementario es ner_demo/quickstart.py.
from gliner import GLiNER

model = GLiNER.from_pretrained("urchade/gliner_medium-v2.1")
text = "Bill Gates founded Microsoft on April 4, 1975."
labels = ["person", "organization", "date"]
entities = model.predict_entities(text, labels, threshold=0.5)

for entity in entities:
    print(f"{entity['text']} => {entity['label']} ({entity['score']:.3f})")
# Bill Gates => person (0.994)
# Microsoft => organization (0.973)
# April 4, 1975 => date (0.951)El bi-encoder: escalar NER a millones de etiquetas
El GLiNER original codifica etiquetas y texto juntos. La codificación conjunta se encarece progresivamente a medida que el texto de las etiquetas consume contexto y debe volver a codificarse con cada documento. El punto de cruce depende del checkpoint, de las descripciones de las etiquetas y del hardware. Cuando el mismo inventario grande de tipos se reutiliza en muchos documentos, haced del GLiNER bi-encoder la comparación por defecto. Separa la codificación del texto y la de las etiquetas en dos transformers distintos (Stepanov et al., 2026).
La figura compara los dos diseños con tres documentos. En el carril del cross-encoder, todas las etiquetas entran en el encoder con cada documento. En el carril del bi-encoder, un encoder de etiquetas se ejecuta una vez, sus vectores se guardan en caché y solo el encoder de texto se ejecuta por documento. El gráfico inferior muestra el coste de rendimiento con 1024 etiquetas.
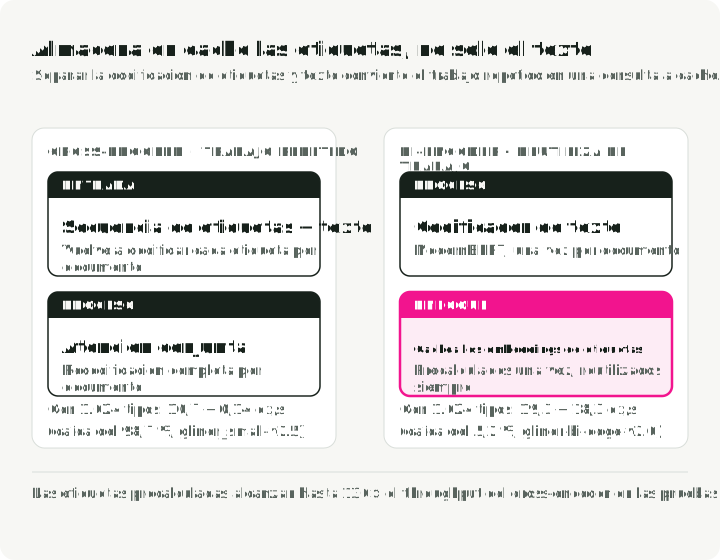
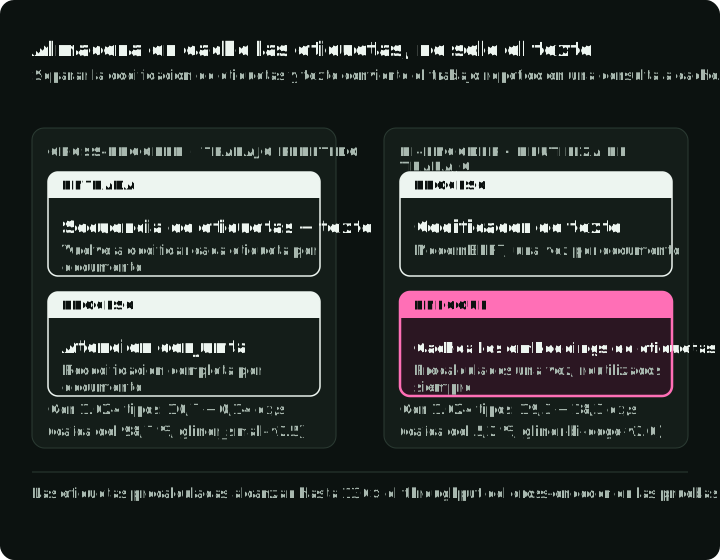
El encoder de texto usa ModernBERT (familia Ettin) y el encoder de etiquetas usa sentence transformers (BGE o MiniLM). Los spans y las etiquetas se puntúan mediante producto escalar. Esa separación significa que los embeddings de los tipos de entidad pueden precalcularse una vez y guardarse en caché. En la inferencia, las etiquetas en caché evitan repetir su codificación. Puntuar los spans candidatos frente a esas etiquetas sigue costando cómputo y memoria; una aplicación con un millón de etiquetas necesita además una recuperación de candidatos acotada o procesamiento por lotes, midiendo el recall de las etiquetas excluidas antes de puntuar.
Hay cuatro tamaños de modelo disponibles, todos evaluados en CrossNER (Stepanov et al., 2026, tabla 1):
| Modelo | Parámetros | F1 medio (CrossNER + MIT) | Throughput (H100) | Con etiquetas precalculadas |
|---|---|---|---|---|
| gliner-bi-edge-v2.0 | 60M | 54,0 % | 13,64 ej./s | 24,62 ej./s |
| gliner-bi-small-v2.0 | 108M | 57,2 % | 7,99 ej./s | 15,22 ej./s |
| gliner-bi-base-v2.0 | 194M | 60,3 % | 5,91 ej./s | 9,51 ej./s |
| gliner-bi-large-v2.0 | 530M | 61,5 % | 2,68 ej./s | 3,60 ej./s |
Con 1024 tipos de entidad, el bi-encoder gliner-bi-edge-v2.0 con etiquetas precalculadas pierde solo un 5,2 % de throughput respecto a una única etiqueta (19,3 → 18,3 ej./s). El cross-encoder comparable gliner_small-v2.5 pierde un 98,7 % (10,7 → 0,14 ej./s). En las pruebas del artículo con una sola H100, batch de tamaño 1 y entradas de 64, 256 y 512 tokens, el bi-encoder con etiquetas precalculadas alcanza una ventaja de throughput de hasta 130× sobre gliner_small-v2.5. Con 100 tipos de entidad en una sola H100, el bi-encoder procesa 1,96 millones de predicciones al día frente a 368K del cross-encoder (Stepanov et al., 2026).
El artículo del bi-encoder da 61,5 % para gliner-bi-large-v2.0 frente a 60,9 % para gliner_large-v2.5 en la misma media de CrossNER más MIT, así que en ese benchmark el bi-encoder no sacrifica precisión por velocidad. Los autores recomiendan bi-base-v2.0 (194M) como mejor equilibrio de tamaño: el 98 % de la precisión del modelo large con 2,6 veces su velocidad (Stepanov et al., 2026).
La batería de mediciones de tiempo se detiene en 1024 etiquetas, con una H100, batch de tamaño uno y diez pasadas hacia delante por configuración. No mide un servicio desplegado con un millón de etiquetas. El artículo cita como uno de los usos el entity linking sobre grandes bases de conocimiento como Wikidata; el entity linking está disponible a través del framework GLiNKER de Knowledgator.
El código codifica el conjunto de etiquetas una vez y reutiliza los embeddings para cada texto. Con las tres etiquetas siguientes, devuelve los mismos tres spans que la llamada al cross-encoder de arriba.
from gliner import GLiNER

model = GLiNER.from_pretrained("knowledgator/gliner-bi-base-v2.0")

# Pre-compute embeddings for a reused label set; rebuild this cache when labels or the checkpoint change.
entity_types = ["person", "organization", "date"]  # Small example; large inventories need bounded candidate selection
entity_embeddings = model.encode_labels(entity_types, batch_size=8)

# Encode text and score spans against the cached labels
texts = ["Bill Gates founded Microsoft on April 4, 1975."]
outputs = model.batch_predict_with_embeds(texts, entity_embeddings, entity_types)GLiNER2 y GLiNER2.5: un esquema para varias tareas
El ecosistema GLiNER original repartía NER, extracción de relaciones, clasificación y extracción a nivel de documento entre modelos distintos. El artículo de GLiNER2 en EMNLP 2025 unificó NER, clasificación y extracción jerárquica en un único modelo de 205M parámetros; las versiones actuales añadieron después la extracción de relaciones a la misma interfaz de esquema.
Esa arquitectura de 2025 mantiene el diseño cross-encoder, pero amplía el contexto a 2048 tokens (4 veces el original) y añade esquemas declarativos para definir las tareas de extracción. El entrenamiento usa 135 698 documentos reales anotados con GPT-4o más 118 636 ejemplos sintéticos (Zaratiana et al., 2025).
En CrossNER zero-shot, GLiNER 2 obtiene 0,590 de F1, cerca del 0,599 de GPT-4o en el benchmark de mediados de 2025 del artículo. En clasificación, promedia 0,72 en 7 benchmarks, frente a 0,69 de DeBERTa-v3-large. En CPU, el artículo informa de una latencia de clasificación de 130-208 ms para los números de etiquetas probados. La baseline zero-shot de DeBERTa necesita una pasada hacia delante por cada etiqueta candidata y sube de 1714 ms con 5 etiquetas a 16 897 ms con 50; ese no es el tiempo de ejecución de un clasificador DeBERTa supervisado (Zaratiana et al., 2025).
El ejemplo siguiente carga GLiNER2.5, un checkpoint posterior, así que las puntuaciones de 2025 de arriba no lo describen. GLiNER2.5 (194M parámetros) predice las posiciones inicial y final de los spans en lugar de puntuar todos los spans. Su ventana es de 4096 tokens, así que dividid los documentos más largos en chunks solapados con la función auxiliar de la librería y comprobad que los offsets devueltos se corresponden con el texto completo. Cargadlo con AutoExtractor, como abajo.
from gliner2 import AutoExtractor

# Requires `pip install gliner2[local]` and downloads the checkpoint.
extractor = AutoExtractor.from_pretrained("fastino/gliner2.5-base-v1")

# Compose tasks through the current schema interface
schema = (extractor.create_schema()
    .entities({"person": "Names of people", "company": "Organization names"})
    .classification("sentiment", ["positive", "negative", "neutral"])
    .relations(["works_for", "founded", "located_in"])
    .structure("product_info")
        .field("name", dtype="str")
        .field("price", dtype="str"))
text = "Acme launched a $19 widget in Berlin."
results = extractor.extract(text, schema)
El artículo de EMNLP evalúa solo NER y clasificación. No informa de ningún benchmark de extracción jerárquica ni cubre la API de relaciones posterior. Un modelo que ejecuta cuatro tareas puede seguir puntuando menos en cada una que cuatro modelos especializados, así que comparad cada tarea con su propia baseline.
Otras variantes de GLiNER para necesidades concretas
La familia GLiNER cuenta ya con varias arquitecturas además del cross-encoder, el bi-encoder y GLiNER2.5. Cada una apunta a una necesidad:
| Necesidad | Candidato | Qué verificar |
|---|---|---|
| Entidades y relaciones en una sola pasada | GLiNER-Relex | El F1 de spans y de relaciones sobre los mismos documentos. |
| Candidato local para PII | GLiNER2-PII | El recall por idioma, formato de documento y tipo de PII. |
| Candidato multilingüe de vocabulario abierto | GLiNER-X | La calidad por idioma; su ficha lista 23 idiomas. |
| Tipos generados o cambiantes | GLiNER Decoder | Si los tipos generados son estables y útiles en el paso posterior. |
| Enmascaramiento de PII en streaming | GLiNER Streaming PII | Los caracteres filtrados antes de la liberación, no solo el recall final de spans. |
Los resultados de GLiNER-Relex y GLiNER2-PII proceden de sus propios artículos y harnesses. GLiNER-X y GLiNER Decoder tienen fichas de modelo, no benchmarks revisados por pares, así que sus cifras no son comparables con las de los artículos anteriores.
El streaming de PII cambia cuándo podéis liberar el texto
GLiNER Streaming PII añade detección incremental con un backbone causal Qwen3-0.6B y un estado de sesión en caché. Su API devuelve la instantánea completa de la sesión actual, con offsets sobre el texto acumulado. Conservad los límites de los chunks, mantened fijas las etiquetas hasta un recálculo completo y limpiad las sesiones terminadas.
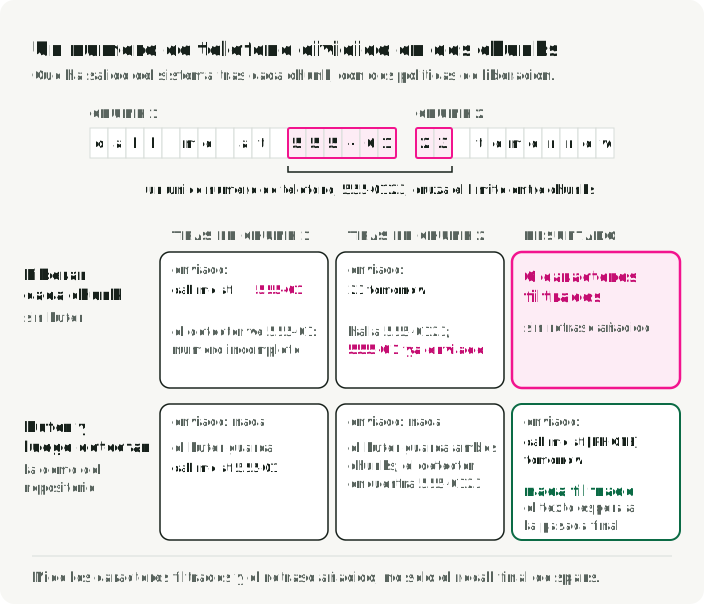
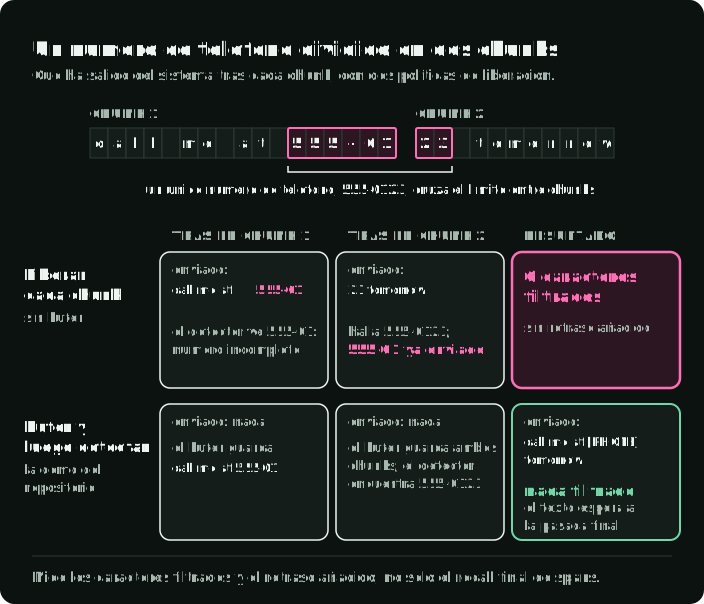
Para el enmascaramiento en streaming, yo retendría en un búfer el texto no liberado y probaría las entidades partidas entre chunks. Si se encuentra un número de teléfono después de enviar su primera mitad, esos bytes ya no se pueden retirar. Medid los caracteres filtrados antes de la liberación y el retraso añadido, además del recall final de spans. La ficha del modelo informa del F2 de enmascaramiento de PIIMB por separado del F1 estricto de spans tipados; responden a preguntas distintas. La ficha también informa de resultados multilingües más débiles, así que el checkpoint publicado no es un filtro de privacidad universal.
La figura divide un número de teléfono entre dos chunks. Si se libera chunk a chunk, la primera mitad ya ha salido cuando llega la segunda. Con búfer, el detector ve el número completo y solo sale texto enmascarado. El módulo ner_demo.streaming del repositorio complementario retiene todo el texto hasta una pasada final de detección y luego lo libera con los spans detectados enmascarados.
Alternativas de etiquetas cerradas: spaCy y un clasificador de tokens con fine-tuning
Cuando el conjunto de etiquetas es estable y tenéis datos anotados, no necesitáis las etiquetas abiertas de GLiNER. Un modelo entrenado con ese conjunto de etiquetas es la baseline que hay que superar.
Los pipelines entrenados de spaCy (en_core_web_sm, en_core_web_trf) reconocen un conjunto fijo de tipos de entidad (PERSON, ORG, GPE, DATE y otros) definido en el momento del entrenamiento. Ampliar el componente ner entrenado requiere ejemplos etiquetados y entrenamiento. Para identificadores o un diccionario controlado, EntityRuler añade etiquetas propias mediante patrones sin reentrenar; su recall fuera de esos patrones es cero. La ficha del modelo en_core_web_trf 3.8.0 informa de 90,19 de F1 en NER sobre OntoNotes 5.0, pero solo para sus 18 tipos predefinidos (ficha del modelo de spaCy).
El ejemplo añade un patrón de ticker antes del componente ner entrenado, de modo que la regla se queda primero con $AAPL y el modelo etiqueta el resto:
import spacy

nlp = spacy.load("en_core_web_trf")
ruler = nlp.add_pipe("entity_ruler", before="ner")
ruler.add_patterns([{"label": "TICKER", "pattern": [{"TEXT": "$"}, {"TEXT": {"REGEX": r"^[A-Z]{1,5}$"}}]}])

doc = nlp("Tim Cook said Apple ($AAPL) will open an office in Berlin in March 2027.")
print([(ent.text, ent.label_) for ent in doc.ents])
# [('Tim Cook', 'PERSON'), ('Apple', 'ORG'), ('$AAPL', 'TICKER'), ('Berlin', 'GPE'), ('March 2027', 'DATE')]
Para etiquetas estables con spans anotados representativos, un clasificador de tokens con fine-tuning, como BERT, RoBERTa o DeBERTa, es la baseline supervisada. El pipeline de Hugging Face carga uno en una línea. dslim/bert-base-NER, el encoder fijo de la evaluación del repositorio complementario, se entrenó con CoNLL-2003, así que sus etiquetas están fijadas en PER, ORG, LOC y MISC. La fecha de la misma frase no se encuentra porque el modelo no tiene etiqueta de fecha:
from transformers import pipeline

ner = pipeline("token-classification", model="dslim/bert-base-NER", aggregation_strategy="simple")
for ent in ner("Tim Cook said Apple will open an office in Berlin in March 2027."):
    print(ent["word"], ent["entity_group"], round(float(ent["score"]), 3))
# Tim Cook PER 1.0
# Apple ORG 0.998
# Berlin LOC 0.999
Para obtener vuestras propias etiquetas, haced fine-tuning de un modelo así con vuestros spans anotados. Comparadlo con spaCy y GLiNER en F1 de span exacto, recall por etiqueta, calibración, latencia y coste sobre el mismo conjunto del dominio.
Mi recomendación: usad spaCy o un clasificador de tokens con fine-tuning para tipos de entidad estándar o estables cuando tengáis datos de entrenamiento. Usad GLiNER cuando necesitéis tipos flexibles y zero-shot o cuando vuestro pipeline deba adaptarse sin reentrenar. Pueden compartir pipeline: spaCy se encarga de la tokenización y la división en frases, y GLiNER de la extracción de entidades.
Las licencias de los checkpoints forman parte de la elección del modelo
Los modelos de esta guía no comparten una misma licencia. Antes de desplegar, comprobad las condiciones del código, de los pesos y de los datos del checkpoint concreto:
| Publicación | Licencia publicada | Consecuencia práctica |
|---|---|---|
| GLiNER v2.1, GLiNER v2.5 y GLiNER bi | Apache 2.0 | Condiciones permisivas en la ficha del modelo; revisad de todos modos dependencias y datos. |
| GLiNER2, GLiNER2.5 y GLiNER2-PII | Apache 2.0 | Confirmad el checkpoint elegido, no solo la librería. |
spaCy en_core_web_trf y dslim/bert-base-NER | MIT | Permisiva; los corpus de entrenamiento tienen sus propias condiciones. |
| UniNER-7B-all | CC BY-NC 4.0 | No lo uséis en una vía comercial sin un permiso aparte. |
| NuNER | MIT | El modelo y el dataset publicados declaran condiciones MIT. |
Las etiquetas de licencia no son asesoramiento jurídico. Una revisión de producción debe incluir las condiciones del modelo base, de los datos de entrenamiento y del proveedor.
Los LLMs como teachers: un caso de estudio de $70 y un pipeline desplegable
El patrón de LLM como teacher separa la anotación cara de la inferencia barata: un LLM etiqueta los datos de entrenamiento una sola vez y un encoder pequeño entrenado con esas etiquetas atiende todas las peticiones. Dos artículos de investigación establecieron que los modelos pequeños pueden aprender NER a partir de etiquetas de un LLM, y dos casos de estudio publicados muestran cómo lo aplicaron los equipos.
La investigación detrás de este patrón: UniNER y NuNER
UniNER (ICLR 2024, Zhou et al.) y NuNER (EMNLP 2024, Bogdanov et al.) destilan anotaciones de LLM en modelos de NER más pequeños, pero discrepan sobre hasta qué punto se puede reducir el tamaño.
UniNER hace fine-tuning de LLaMA-7B/13B con 45 889 pares de entrada y salida generados por ChatGPT. Para cada tipo de entidad, el modelo responde a «What describes [type] in the text?» y produce listas JSON. Un truco clave del entrenamiento: el muestreo negativo basado en frecuencia eleva el F1 del 31,5 % al 53,4 % (Zhou et al., 2024).
UniNER-7B alcanza un 41,7 % de F1 zero-shot en 43 datasets, y supera en 7 puntos el 34,9 % de ChatGPT. La variante de 13B llega al 43,4 %, solo 1,7 puntos más con casi el doble de parámetros (Zhou et al., 2024).
El compromiso en producción: la configuración tipo UniNER de mayor puntuación del artículo consulta cada tipo de entidad de forma secuencial. Su variante todo en uno usa una sola respuesta, pero obtuvo de media un 3,3 % menos. En FP16, un checkpoint de 7B necesita aproximadamente 14 GB solo para los pesos; una cuantización a menos bits puede reducir esa huella. El checkpoint UniNER-7B-all es de uso no comercial (véase la tabla de licencias de arriba).
NuNER parte de RoBERTa-base (125M parámetros) y usa entrenamiento contrastivo con 4,38 millones de anotaciones de GPT-3.5 sobre 200K conceptos. Tras el entrenamiento se descarta el encoder de conceptos; el encoder de texto se integra en cualquier pipeline estándar de NER como sustituto de RoBERTa (Bogdanov et al., 2024).
La tabla 3 de NuNER informa de entre 6,1 y 16,2 puntos más que RoBERTa en F1 macro medio de clasificación de tokens con encoders congelados y cabezas lineales, en cuatro datasets y tamaños de entrenamiento muestreados (Bogdanov et al., 2024).
Ambos artículos muestran que un modelo más pequeño puede aprender de anotaciones de un LLM. Ninguno muestra que el estudiante supere a su teacher en un dominio nuevo, y por eso el pipeline siguiente conserva un conjunto de test revisado por separado.
El caso de estudio de CFM
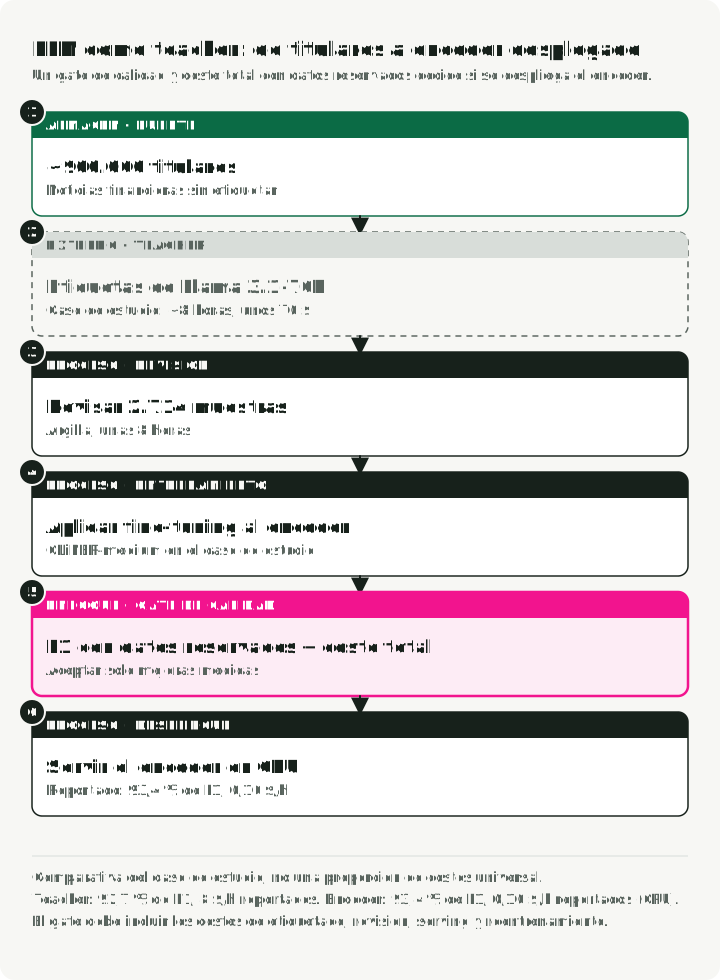
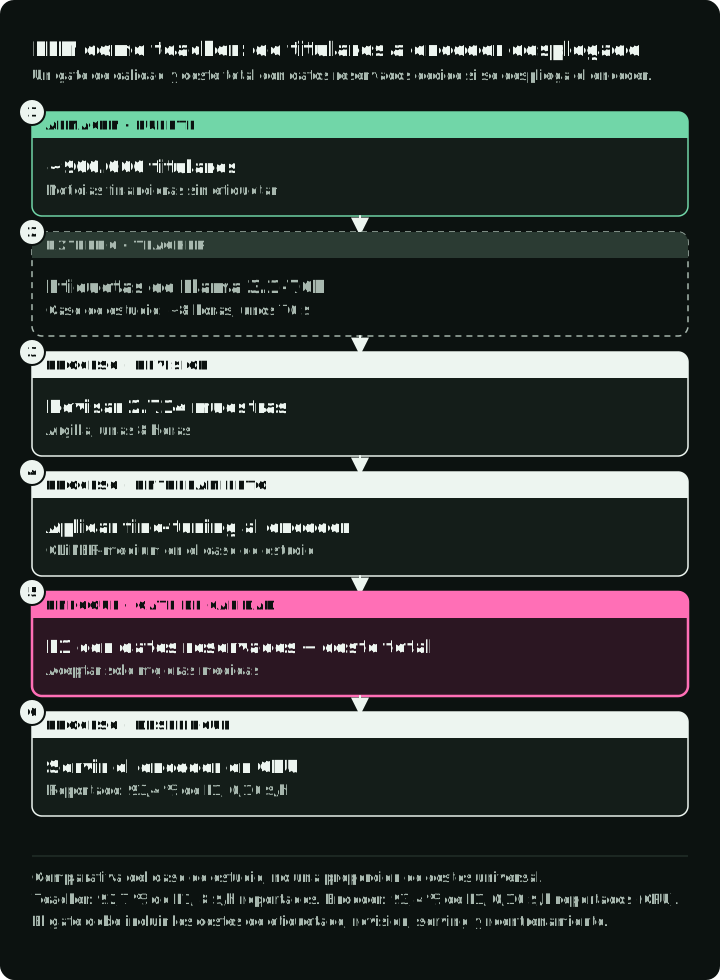
En un caso de estudio de Hugging Face, Capital Fund Management extrajo nombres de empresas de unos 900 000 titulares de noticias financieras. GLiNER zero-shot obtuvo un 87,0 % de F1. El equipo usó Llama 3.1-70B para anotar el dataset en unas 8 horas por unos $70, y después revisó 2714 muestras con Argilla en otras 8 horas.
El fine-tuning de GLiNER con estos datos alcanzó un 93,4 % de F1 en el caso de estudio, frente al 92,7 % del teacher Llama-70B. Los autores informan de $0,10 por hora en CPU para el modelo con fine-tuning y de $8 por hora para el teacher (caso de estudio de CFM). Esas cifras describen una tarea de noticias financieras y una configuración de infraestructura concretas.
El estudio de Refuel AI
El informe técnico del proveedor Refuel AI evalúa el etiquetado con LLM en 8 datasets de NLP, entre ellos CoNLL-2003. Informa de un 88,4 % de concordancia con la referencia para GPT-4 (marzo de 2023) y de un 86,2 % para los anotadores humanos de su configuración, junto con un etiquetado 20 veces más rápido y 7 veces más barato. Un experimento aparte con un ensemble sobre datos propietarios superó el 95 % de concordancia, con su mejor LLM individual en el 89 %. El enrutamiento por confianza hacia modelos más baratos o más potentes es un uso propuesto, no el mecanismo medido detrás del resultado de los ocho datasets (informe técnico de Refuel AI).
Un pipeline de producción
Un flujo de producción práctico tiene seis pasos. El diagrama coloca cada paso en el carril de quien lo hace, con las cifras de CFM y el bucle de vuelta a la revisión cuando el estudiante no alcanza su objetivo. El gráfico inferior compara el F1 de CFM y el coste por hora del teacher y del estudiante.
- Redactad guías de anotación en lenguaje natural.
- Cread conjuntos de desarrollo y de test retenido etiquetados por personas. La sección de evaluación de más abajo da un procedimiento para dimensionarlos.
- Usad un LLM con un prompt versionado y un esquema de salida explícito para proponer en bloque las etiquetas de entrenamiento. Conservad el modelo solicitado y el real, el prompt y el texto fuente. Rechazad los tipos desconocidos y los spans que no se puedan alinear con la fuente.
- Revisad un subconjunto con Argilla o Label Studio.
- Haced fine-tuning de un encoder compacto (GLiNER, SpanMarker, RoBERTa). Para GLiNER, usad el
train.pydel repositorio (python train.py --config configs/config.yaml) o el métodotrain_model()del modelo, con el archivo de entrenamiento revisado como datos de entrenamiento y el archivo de desarrollo para la evaluación durante el entrenamiento. - Desplegad solo cuando el encoder supere una comprobación de calidad retenida y de coste total. CFM informó de un coste de infraestructura por hora entre 16 y 80 veces menor en su configuración; incluid en vuestra comparación los costes de anotación, revisión, serving y reentrenamiento.
El LLM puede reducir el volumen de anotación manual, pero el equipo sigue siendo responsable del conjunto de validación, de las guías de anotación, de la revisión dirigida y del análisis de errores.
El repositorio complementario demuestra una propuesta del profesor y convierte anotaciones revisadas para el paso 5 (sección del README). Ejecutad estos comandos en ese repositorio con Python 3.11+, uv y las dependencias instaladas mediante uv sync --locked --all-extras. Configurad OPENAI_API_KEY para la llamada de pago al profesor. La conversión necesita en caché los archivos del modelo GLiNER fijado y de su backbone; uv run --all-extras python -m ner_demo.quickstart --download los descarga una vez.
-
Ejecutad la demostración del profesor para un documento. Hace una petición de pago para una frase fija sobre la adquisición propuesta de Arm por NVIDIA y escribe un registro sin revisar en
artifacts/teacher_annotations.jsonl:uv run --all-extras python -m ner_demo.teacher --allow-paid -
Revisad la propuesta a mano y resolved las anotaciones rechazadas. Preparad
artifacts/reviewed.jsonlcon documentos de entrenamiento revisados y los documentos de desarrollo y prueba etiquetados por personas de forma separada en el flujo de producción anterior. Los tres splits deben contener datos, los identificadores de documento deben ser únicos y ningún texto fuente puede aparecer en más de un split. No copiéis la frase de demostración entre splits. Configuradreviewed: true, unreviewer,status: "ok"y unsplit(train,developmentotest) en cada registro, y mantenedsource_sha256acorde con el texto fuente. Un registro de demostración no puede proporcionar los tres splits. -
Convertid el archivo revisado completo. Esto escribe
train.json,development.jsonytest.jsonenartifacts/training/en el formato de entrenamiento de GLiNER, después de pasar cada fila por el propio data collator de GLiNER:uv run --all-extras python -m ner_demo.training artifacts/reviewed.jsonl
Pasad train.json y development.json a la ejecución de fine-tuning de GLiNER del paso 5 y guardad test.json para la comprobación final.
Dónde falla GLiNER y los LLMs siguen siendo útiles
El benchmark de Sease (octubre de 2025) probó GLiNER frente a GPT-4.1-mini en 30 tareas de análisis de consultas. GPT-4.1-mini acertó el 100 % por completo. GLiNER, el 53 % (16 de 30). Pero GLiNER respondió en 0,08 segundos frente a los 1,21 segundos del LLM, 15 veces más rápido.
En este benchmark de 30 tareas, GLiNER falló en tres patrones recurrentes:
- Entidades implícitas: extraer «event» de «Elton John performed at Madison Square Garden». Ningún texto dice literalmente «event», pero el LLM infiere «concert».
- Sensibilidad a la redacción de las etiquetas: «2022» puntúa 0,388 frente a «date», pero 0,958 frente a «year». Pequeños cambios en las etiquetas provocan grandes oscilaciones de puntuación.
- Mapeo de valores: GLiNER devuelve el texto literal de la superficie («family houses») en lugar del valor canónico («Single family house»). Un LLM puede hacer esa normalización cuando su prompt y su esquema definen los valores objetivo.
Entidades anidadas y solapadas
Una entidad anidada está dentro de otra. En «New York University», «New York» es una ubicación dentro del nombre de una organización. El texto biomédico («acute myeloid leukemia» dentro de un diagnóstico más largo) y el texto jurídico (un departamento dentro de una autoridad con nombre) tienen el mismo patrón.
GLiNER decodifica por defecto en modo plano, lo que suprime los spans solapados. Su API también admite flat_ner=False, que permite predicciones solapadas:
entities = model.predict_entities(
    "She studied at New York University.", ["organization", "location"],
    flat_ner=False, threshold=0.3)
# [{'text': 'New York University', 'label': 'organization', 'score': 0.855, ...}]
Con urchade/gliner_medium-v2.1, esta llamada devolvió solo la organización, incluso con un umbral de 0,05. Desactivar la decodificación plana permite una salida anidada, pero el checkpoint tiene que puntuar el span interior por encima del umbral. Si vuestros datos tienen entidades anidadas, construid un conjunto de test anidado y comprobad si los spans interiores aparecen siquiera antes de elegir GLiNER en lugar de un modelo de NER anidado especializado.
Usad GLiNER para la extracción de entidades explícitas y dirigid a un LLM los casos que exigen inferencia, razonamiento o mapeo a ontologías predefinidas. El umbral de enrutamiento debe salir de un conjunto etiquetado del dominio.
Evaluar NER: métricas, trampas y conjuntos de test
Cada número de esta guía procede del modelo, los datos y el hardware de su fuente. Repetid la comparación con vuestro propio conjunto etiquetado antes de elegir. Esta sección explica cómo construir ese conjunto y puntuarlo.
Un modelo puede sacar un 95 % de F1 en un conjunto de test cuidado y aun así fallar con la mezcla de documentos que ve tras el despliegue. Construid el conjunto de evaluación a partir de la distribución de producción y mantened porciones para los formatos raros y los tipos de entidad poco frecuentes que el F1 agregado puede ocultar.
Las métricas principales
Identificad cada aparición por ID de documento, offsets de inicio y fin semiabiertos y tipo, y comprobad que text[start:end] recupera la mención. Dos apariciones de «John» son dos objetivos. La figura puntúa tres predicciones para una misma frase.
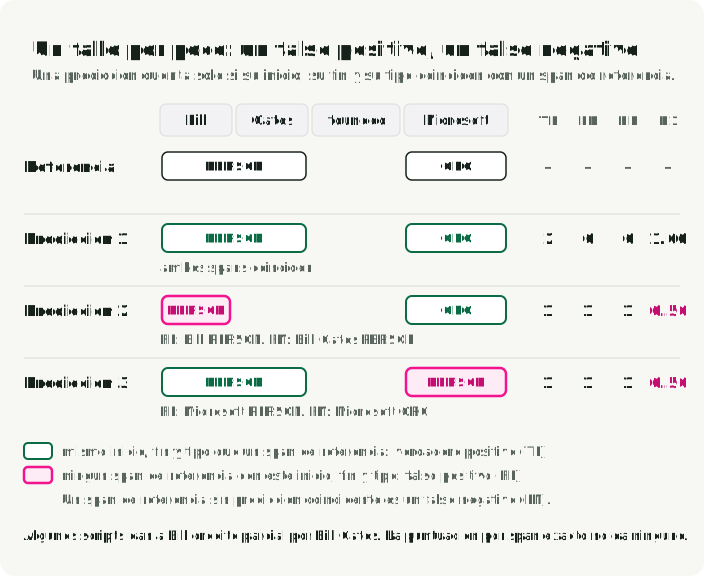
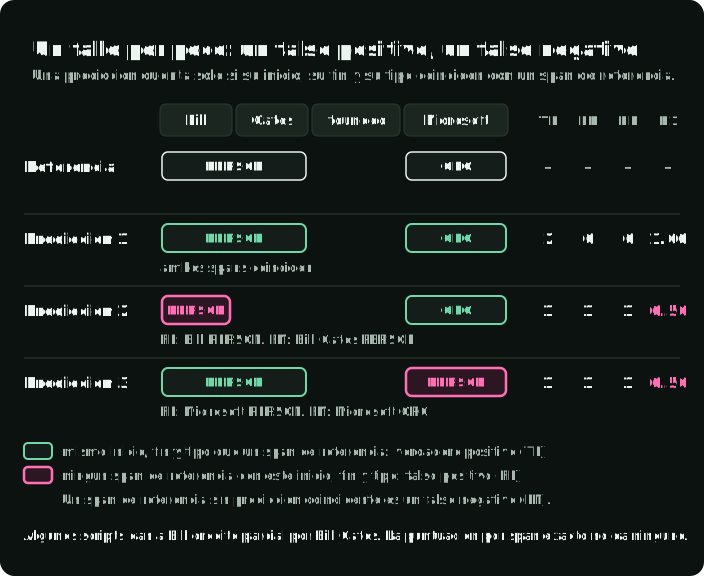
Validad el número de documentos antes de emparejar: las predicciones ausentes deben crear falsos negativos, no desaparecer a través de zip(). Contad un tipo o unos offsets erróneos como una predicción sin emparejar y un span de referencia sin emparejar. Informad de precisión, recall y F1 micro, del soporte y el recall por tipo, y definid la agregación macro y los casos vacíos. El evaluador exacto del repositorio complementario implementa estas reglas y mantiene los documentos ausentes, fallidos y omitidos en el denominador de referencia.
- F1 a nivel de entidad: La métrica estándar. Una predicción es correcta solo si tanto los límites del span como el tipo coinciden exactamente con la referencia. Es lo que informan la mayoría de los artículos.
- F1 a nivel de token: Puntúa cada token de forma independiente. Puede hacer que un límite parcial parezca mejor que con una puntuación de span exacto, así que informad del F1 de span exacto cuando importe la corrección de los límites; usad métricas a nivel de token solo cuando la decisión posterior sea a nivel de token.
- Precisión frente a recall: Suelen tener costes asimétricos. En la desidentificación importa más el recall: omitir un nombre es peor que ocultar de más. En la extracción hacia una base de datos importa más la precisión: las entradas falsas corrompen el análisis posterior.
Trampas habituales de evaluación
- Inflación por coincidencia parcial: se extrae «Bill» cuando la etiqueta de referencia es «Bill Gates». Algunos scripts lo cuentan como coincidencia parcial. Usad coincidencia de span exacta salvo que tengáis una razón para no hacerlo.
- Confusión de tipos: «Microsoft» identificado correctamente como span pero etiquetado PERSON en lugar de ORG debe puntuar cero. Comprobad que vuestro código de evaluación lo gestiona.
- Fuga en el conjunto de test: Mantened los registros, documentos y anotaciones duplicados o casi duplicados fuera del conjunto de test. Para una afirmación zero-shot estricta, mantened también los tipos de entidad objetivo fuera del entrenamiento; las cadenas de superficie repetidas por sí solas no son una fuga.
- Prompts de etiquetas sin control: Un nombre de tipo corto y una descripción de tipo probada son entradas distintas. Versionad junto con la puntuación las descripciones de las etiquetas, los umbrales, las revisiones del checkpoint y el modo de decodificación.
- Afirmaciones zero-shot en un solo idioma: No deduzcáis la calidad multilingüe a partir del inglés. OpenNER abarca 36 corpus y 52 idiomas, y sus baselines no encontraron un único modelo que fuera el mejor en todos los idiomas (Palen-Michel et al., 2025). En los experimentos de FiNERweb, pasar de etiquetas en inglés a etiquetas en el idioma de destino cambió el F1 entre 0,02 y 0,09 según la configuración (Golde et al., 2026). Probad ambos idiomas de etiquetas cuando el producto use terminología local.
- Una sola ejecución como resultado final: Informad de la variación entre semillas aleatorias cuando proceda, de barridos de umbral y de muestras de producción repetidas. Con pocos elementos por porción, la clasificación de modelos es inestable.
Mantened la normalización, el entity linking, la agrupación de registros y los extremos de las relaciones separados del F1 extractivo. Para la privacidad, informad de las instancias filtradas y de los documentos aceptados automáticamente que resultan afectados, de las ocultaciones incorrectas y de la fracción en revisión. Para el serving, informad de la tasa de finalización, de la latencia por documento p50/p95, de las ejecuciones en frío y en caliente, de los tamaños de batch y de etiquetas, del pico de memoria y del coste por documento aceptado.
Construir un conjunto de test del dominio
Para la evaluación en producción, recomiendo:
- Muestrear datos de producción, no ejemplos cuidados. Incluid los documentos desordenados que vuestro modelo verá de verdad.
- Dimensionar el conjunto de test a partir de un piloto. Etiquetad un piloto de unos 50 documentos, contad los spans de referencia por etiqueta y calculad por bootstrap el recall por etiqueta. Añadid documentos hasta que el intervalo del 95 % de la etiqueta más rara que os importe sea más estrecho que la diferencia que necesitáis detectar.
- Usar al menos dos anotadores en un subconjunto de calibración. Resolved los desacuerdos e informad del F1 de span exacto entre los spans de ambos anotadores. El acuerdo muestra dónde son ambiguas las guías; no es un límite superior del rendimiento del modelo.
- Estratificar por dificultad: casos fáciles (texto limpio, tipos estándar) y casos difíciles (entidades ambiguas, jerga, texto ruidoso).
- Mantener porciones de privacidad y de equidad. Para PII, informad del recall por tipo de PII, idioma, configuración regional, formato de documento y porciones demográficas o de origen del nombre relevantes. Minimizad el acceso de los evaluadores al texto sensible en bruto, fijad límites de retención y revisad los falsos negativos.
El NER continuo necesita un conjunto de regresión inmutable
Las taxonomías de producción cambian. Añadid tipos nuevos sin cambiar en silencio lo que significa un tipo antiguo. Mantened un conjunto de regresión versionado e inmutable para los tipos existentes, un conjunto de test aparte para el tipo nuevo y un registro de cambios para las modificaciones de las guías de anotación. Informad por separado de las puntuaciones de los tipos antiguos y del nuevo antes de sustituir un checkpoint. Es la forma más sencilla de detectar el olvido y la deriva de la taxonomía.
NER en producción en cuatro sectores
Cada dominio extrae cosas distintas y tiene un punto de partida publicado distinto. La última columna nombra la salvedad que cambia lo primero que hay que probar.
| Dominio | Qué se extrae | Punto de partida | Salvedad que cambia una decisión |
|---|---|---|---|
| Sanidad | Nombres, fechas, ID y otra PHI para la desidentificación | Las evaluaciones de John Snow Labs y Providence de arriba; los modelos abiertos de NER médico de OpenMed | Informad de las instancias filtradas y de los documentos afectados, no solo del F1. |
| Finanzas | Menciones de empresas en noticias; campos en documentos regulatorios | El caso de estudio de CFM para noticias; FinBERT-MRC para documentos regulatorios (92,78 de F1 en ChFinAnn, 96,80 en AdminPunish) | Los resultados de FinBERT-MRC son sobre documentos regulatorios chinos; probad por separado los documentos de la SEC en inglés, los documentos largos y las entidades anidadas. |
| Comercio electrónico | Tipo de producto, marca y atributos en consultas de búsqueda | EAMT de Walmart (unas 60 etiquetas de NER de consultas); TripleLearn de Home Depot (F1 retenido de 69,5 → 93,3, en producción desde hace más de 9 meses) | El método de TripleLearn son rondas repetidas de supervisión del dominio; el artículo no compara arquitecturas actuales. |
| Ciberseguridad | Malware, actores de amenazas e indicadores de compromiso | CyNER (76,66 de F1 micro de spans, XLM-RoBERTa-large); CyberNER (21 etiquetas STIX 2.1, RoBERTa con 0,736 de F1) | Solo datasets de investigación; los conjuntos de etiquetas difieren, así que mapeadlos a STIX antes de comparar modelos. |
Optimización del despliegue: de Python a inferencia con menor latencia
Cuando un modelo supera el conjunto de test del dominio, la siguiente pregunta es cómo servirlo. Este es el orden en que yo probaría los runtimes, con una comprobación después de cada paso. Cambiad una sola cosa cada vez, para que una caída de calidad tenga una sola causa.
- Servid con PyTorch y Ray Serve.
- Exportad ONNX FP32, o ejecutadlo con gline-rs. Si los spans difieren de los de PyTorch, corregid la exportación.
- Cuantizad a INT8 dinámico, manteniendo las proyecciones descendentes de la FFN en FP32.
- Desplegad INT8 solo si el recall por etiqueta se mantiene dentro del objetivo. En caso contrario, mantened FP32.
Serving nativo de GLiNER
Antes de pasar a un runtime nuevo, probad la ruta con Ray Serve del proyecto. gliner[serve] ofrece batching dinámico, tamaño de batch que tiene en cuenta la memoria, escalado con varias réplicas y un cliente HTTP. El batching y las réplicas pueden mejorar el throughput sin cambiar el código del modelo. El batching también añade tiempo de espera, así que medid la latencia de cola y la latencia en caliente con vuestra mezcla de peticiones.
Exportación a ONNX
GLiNER tiene conversión nativa a ONNX, y hay modelos ya convertidos en Hugging Face (onnx-community/gliner_small-v2.1). La exportación escribe el grafo, la configuración y el tokenizador en un solo directorio, y la misma clase GLiNER lo carga de nuevo con la misma llamada predict_entities:
from gliner import GLiNER

model = GLiNER.from_pretrained("urchade/gliner_medium-v2.1")
model.export_to_onnx("onnx/fp32")

onnx_model = GLiNER.from_pretrained("onnx/fp32", load_onnx_model=True)
entities = onnx_model.predict_entities(text, labels, threshold=0.5)
La comparación de ONNX del repositorio complementario ejecuta PyTorch, ONNX FP32 y ONNX INT8 sobre las mismas entradas y compara sus spans. Necesita Python 3.11+ y uv. El comando de datos descarga un fragmento fijado de Few-NERD y conserva sus primeras 32 frases, suficientes para comprobar la exportación, no para ordenar modelos. El quickstart con --download descarga una vez el checkpoint fijado:
uv sync --locked --all-extras
# Run once if the pinned model files are not cached:
uv run --all-extras python -m ner_demo.quickstart --download
uv run --all-extras python -m ner_demo.data --split test --limit 32
uv run --all-extras python -m ner_demo.onnx_check \
  --dataset artifacts/few-nerd-test.json --output artifacts/onnx-comparison
Usad un directorio de salida nuevo, o --reuse para comprobar paquetes existentes. El comando falla cuando los spans de FP32 difieren de los de PyTorch, o cuando INT8 pierde más de 0,02 de recall micro. En una CPU Apple M5 Max, ONNX FP32 devolvió exactamente los spans de PyTorch con una latencia p50 de 16-19 ms por frase, frente a 64-66 ms de PyTorch.
Cuantización INT8
La cuantización INT8 dinámica almacena los pesos como enteros de 8 bits y reduce el tamaño del archivo ONNX. Con el encoder DeBERTa de GLiNER, cuantizar todas las capas no funciona. En el repositorio complementario, cuantizar todas las capas MatMul no devolvió ninguna entidad. Cuantizar las capas grupo a grupo mostró la causa: las doce proyecciones descendentes de la FFN (layer.N/output/dense, la segunda capa lineal de la red feed-forward de cada bloque del encoder) bastan por sí solas para dejar todas las puntuaciones por debajo del umbral. Mantener esas doce capas en FP32 lo arregla. El código copia el paquete FP32 (para sus archivos de configuración y de tokenizador) y luego cuantiza todo lo demás:
import shutil

import onnx
from onnxruntime.quantization import QuantType, quantize_dynamic

shutil.copytree("onnx/fp32", "onnx/int8")
graph = onnx.load("onnx/fp32/model.onnx", load_external_data=False).graph
keep_fp32 = [n.name for n in graph.node if n.op_type == "MatMul" and "/output/dense/" in n.name and "/attention/" not in n.name]

quantize_dynamic("onnx/fp32/model.onnx", "onnx/int8/model.onnx",
                 weight_type=QuantType.QInt8,
                 op_types_to_quantize=["MatMul", "Gemm", "Gather"],
                 nodes_to_exclude=keep_fp32)
Cargad onnx/int8 con load_onnx_model=True, como con FP32. La función quantize_package del repositorio complementario hace lo mismo y después valida el paquete. En las 32 frases de Few-NERD (Apple M5 Max, ONNX Runtime 1.24.4), los resultados medidos fueron:
| Ruta | Paquete | Latencia p50 | Precisión micro | Recall micro |
|---|---|---|---|---|
| PyTorch | - | 64-66 ms | 0,506 | 0,722 |
| ONNX FP32 | 790 MB | 16-19 ms | 0,506 | 0,722 |
| ONNX INT8 | 353 MB | 13-15 ms | 0,487 | 0,722 |
INT8 redujo el paquete a menos de la mitad y mantuvo el recall, pero cambió los spans en 4 de 32 frases y añadió 3 falsos positivos. En esta ejecución, INT8 compensa cuando el límite es la memoria o el tamaño del paquete; para la latencia por sí sola, la mayor parte de la mejora vino de la exportación ONNX FP32. Comprobad el recall por etiqueta frente a FP32 con vuestros propios datos antes de desplegarlo: un archivo más pequeño no dice nada sobre la calidad de la extracción. La guía actual de GLiNER recomienda el entrenamiento consciente de la cuantización (QAT) cuando la precisión de INT8 debe igualar la de FP32.
gline-rs: reimplementación en Rust
gline-rs (Apache 2.0) elimina el runtime de Python de la ruta de inferencia. El proyecto informa de aproximadamente cuatro veces el throughput en CPU de Python en su propio benchmark. Admite modelos de spans y de tokens, GPU/NPU mediante ONNX Runtime, y se distribuye como crate en crates.io. Carga una exportación ONNX y su tokenizer.json, como el paquete escrito arriba; el README del proyecto muestra la llamada en Rust.
El paquete fast-gliner ofrece bindings de Python mediante PyO3.
Qué runtime usar y cuándo
| Ruta | Usadla cuando | Evidencia disponible | Medid antes de desplegar |
|---|---|---|---|
| Ray Serve nativo | Queréis mantener Python y añadir batching y réplicas | Documentación del proyecto GLiNER | Latencia de cola, latencia en caliente, throughput |
| ONNX FP32 | Primer cambio de runtime en cualquier hardware | Repositorio complementario: mismos spans que PyTorch, latencia 3,4-4 veces menor | Latencia en caliente, throughput y F1 de span exacto |
| ONNX INT8 | La memoria o el tamaño del paquete es el límite en CPU | Repositorio complementario: 353 MB frente a 790 MB, mismo recall, 3 FP de más | Recall y precisión por etiqueta frente a FP32 |
| gline-rs | Necesitáis eliminar el runtime de Python | Benchmark del proyecto con su hardware y configuración documentados | Vuestro modo de modelo, etiquetas, hardware y batch |
Extracción estructurada: esquemas nativos, Instructor y decodificadores locales
Cuando necesitáis más flexibilidad de la que ofrecen los modelos encoder (entidades implícitas, razonamiento, mapeo a ontologías), empezad por el mecanismo de esquemas nativo del proveedor. OpenAI admite formatos de respuesta json_schema estrictos, los structured outputs de Anthropic admiten salidas JSON y entradas de herramientas estrictas, y la API de Gemini admite un subconjunto de JSON Schema. Un modelo compartido de Pydantic o Zod puede describir el contrato, pero cada proveedor acepta un subconjunto de esquema distinto y tiene un comportamiento distinto ante los rechazos y la complejidad.
La conformidad con el esquema hace fiable el parseo. No demuestra que un span extraído exista en el texto fuente ni que un valor normalizado sea correcto. Validad los valores de los campos, conservad offsets o citas textuales cuando sea posible y puntuad la precisión semántica con un conjunto etiquetado.
Las tres librerías siguientes imponen la estructura de maneras distintas. La figura pasa una misma frase por cada una: Instructor valida y reintenta, Outlines bloquea una etiqueta no válida durante la decodificación y LangExtract devuelve los offsets de caracteres de cada campo.
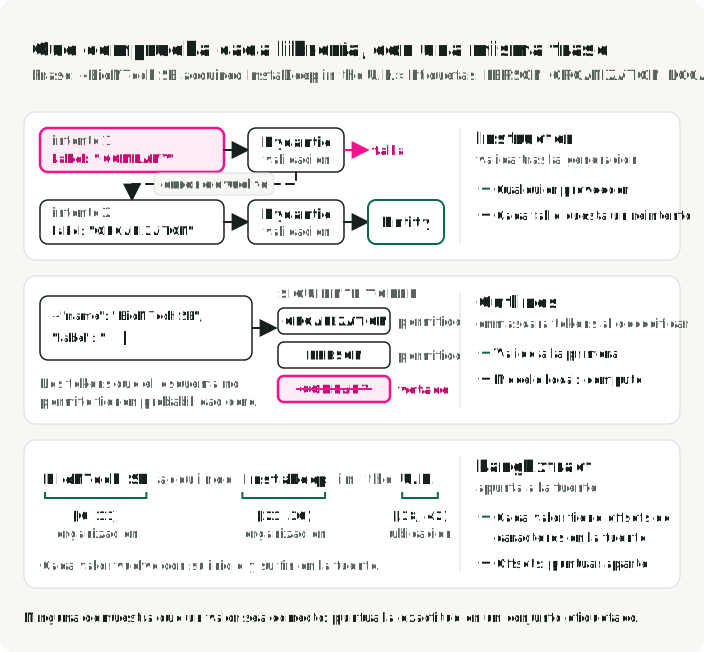
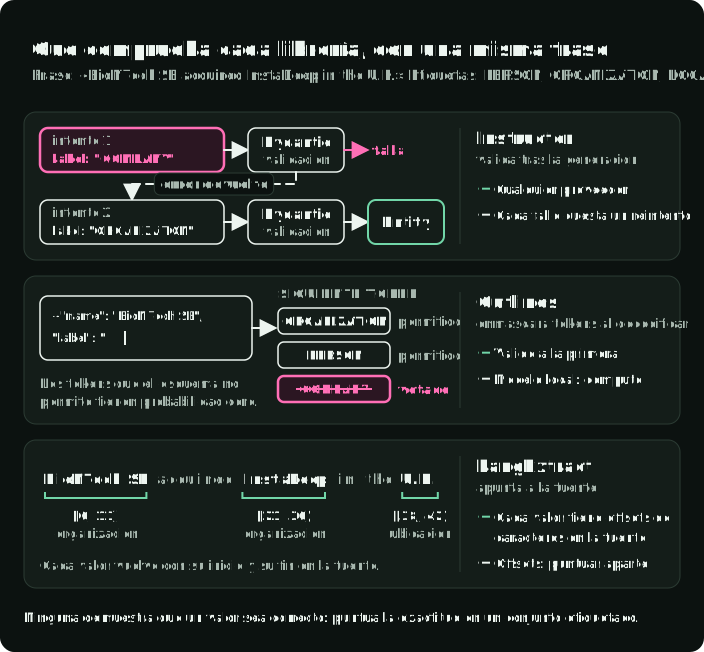
Instructor envuelve los clientes de los proveedores con validación de Pydantic y reintentos opcionales tras los fallos de validación.
Este ejemplo independiente requiere pip install instructor openai pydantic, una OPENAI_API_KEY y una petición de pago al proveedor. Aquí sirve cualquier modelo con soporte de structured outputs; el ejemplo usa gpt-5.4-mini, el mismo valor por defecto que el teacher del repositorio complementario.
import instructor
from pydantic import BaseModel
from typing import List, Literal
from openai import OpenAI

class Entity(BaseModel):
    name: str
    label: Literal["PERSON", "ORGANIZATION", "LOCATION"]

class ExtractEntities(BaseModel):
    entities: List[Entity]

client = instructor.from_openai(OpenAI())
result = client.chat.completions.create(
    model="gpt-5.4-mini", reasoning_effort="none",
    response_model=ExtractEntities,
    messages=[{"role": "user", "content": "BioNTech SE acquired InstaDeep in the U.K."}])
# entities=[Entity(name='BioNTech SE', label='ORGANIZATION'), ...]Outlines, de dottxt, adopta un enfoque distinto: generación de tokens restringida mediante máquinas de estados finitos. El decodificador enmascara los tokens que violarían la gramática objetivo en lugar de esperar a un fallo de validación y reintentar. Una reseña de AWS cita un 98 % de adherencia al esquema frente al 76 % de la validación posterior a la generación. También repite la afirmación de .txt Engineering de una generación hasta 5 veces más rápida, sin detalle de método suficiente para comparar las dos cifras.
En Outlines, outlines.from_transformers envuelve un modelo de Hugging Face y su tokenizador. Llamar a ese modelo con un prompt y una clase de Pydantic como ExtractEntities de arriba devuelve un JSON que se ajusta a la clase. Para una nueva comparación de extracción autoalojada, incluid el actual Qwen3.8-27B o los checkpoints Qwen3.5 más pequeños. Cargadlos con su cargador de modelo documentado, su plantilla de chat y su backend de serving; una arquitectura multimodal o un formato de razonamiento pueden requerir algo más que un nuevo ID de modelo.
LangExtract es útil cuando un campo generado debe estar anclado en la fuente: devuelve intervalos de caracteres y admite backends de LLM alojados o locales. Para la extracción de documentos autoalojada, NuExtract convierte JSON Schemas en plantillas e incluye modelos de documentos multimodales. Ambos son sistemas de extracción estructurada, no sustitutos directos del NER de spans: sus salidas de campos, offsets y layout necesitan sus propias puntuaciones.
La elección depende de dónde ejecutéis vuestros modelos. Los esquemas nativos son el camino con menos fricción para un proveedor compatible. Instructor añade una capa de validación con Pydantic y reintentos independiente del proveedor. Outlines restringe la generación local frente a un esquema. LangExtract prioriza el anclaje en la fuente, mientras que NuExtract apunta a la extracción de documentos autoalojada. Todas las rutas con LLM siguen incluyendo generación autorregresiva, así que suelen tardar más por documento que un encoder en el mismo hardware.
La arquitectura de producción de tres niveles
Yo enrutaría el NER de producción según la forma de la tarea y no según una única clasificación de modelos. Cada fila de la figura muestra una petición de ejemplo, lo que devuelve y los modelos que probar. Los casos revisados del nivel 3 vuelven al nivel 1 solo como spans encontrados en la fuente.
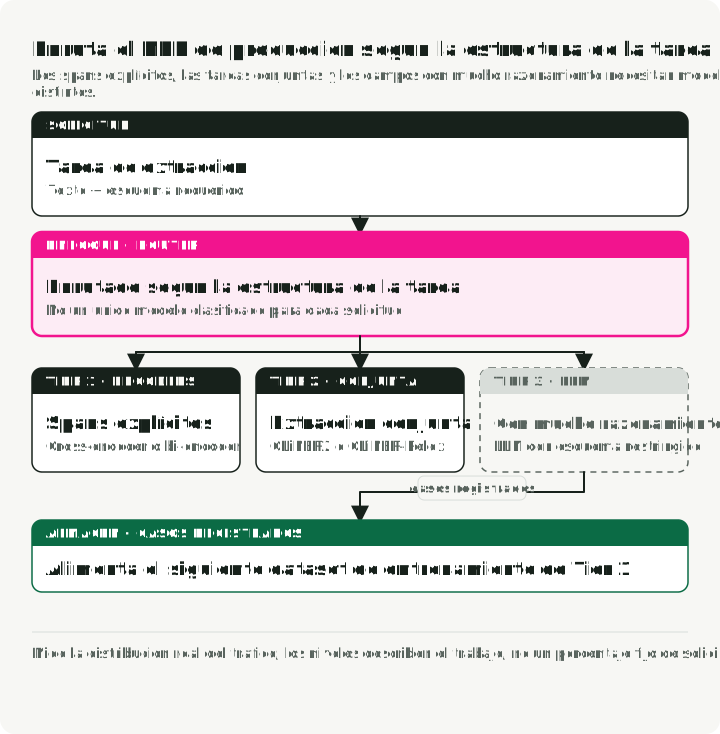
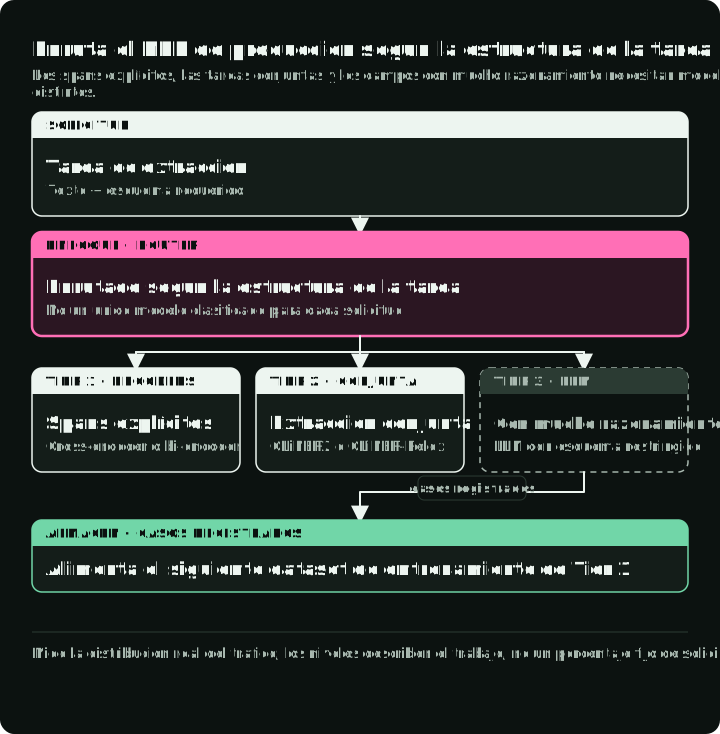
Nivel 1: modelos encoder para spans explícitos. Usad un GLiNER cross-encoder para un inventario pequeño de tipos. Cuando se reutiliza un inventario grande, comparad el bi-encoder con embeddings de tipos en caché. Haced fine-tuning mediante el pipeline de LLM como teacher y desplegad después con serving nativo, ONNX, INT8 o gline-rs solo cuando esa ruta supere el benchmark del dominio.
Nivel 2: extracción multitarea o de relaciones. Cuando una petición necesite NER, clasificación y campos jerárquicos, probad el checkpoint actual de GLiNER2.5 de 194M parámetros frente a baselines separadas por tarea. Cuando el requisito central sean spans y relaciones conjuntos, probad GLiNER-Relex. El artículo de GLiNER2 informa de una latencia de clasificación en CPU de 130-208 ms para los números de etiquetas probados; no midió la API de relaciones posterior.
Nivel 3: LLMs para la extracción que exige razonamiento. Dirigid las entidades implícitas, la inferencia contextual y el mapeo a ontologías a una API de esquemas nativa o a Instructor en las APIs en la nube, y a Outlines para la salida local con restricciones. Usad LangExtract cuando los intervalos de la fuente sean esenciales y NuExtract cuando la entrada sea el propio documento. Registrad estos casos para revisarlos. Solo los spans explícitos y alineados con la fuente pueden convertirse en objetivos de entrenamiento ordinarios del nivel 1; los hechos inferidos y los valores normalizados necesitan sus propios objetivos y su propia evaluación.
El caso de estudio de CFM da una referencia de coste para el nivel 1: 93,4 % de F1 con un coste informado de $0,10 por hora en CPU, frente al 92,7 % de F1 y $8 por hora de su teacher Llama-70B. Los precios por hora de las instancias no determinan el coste por documento sin el throughput. Recalculad con vuestro hardware, modelo teacher, conjunto de etiquetas, utilización y coste de revisión.
Compromisos y limitaciones
Los errores del LLM como teacher se propagan. Si el LLM se equivoca de forma sistemática con un tipo de entidad concreto (por ejemplo, confunde nombres de filiales con empresas matriz), el encoder con fine-tuning hereda ese sesgo. Revisad a fondo los tipos de baja confianza o inconsistentes, y conservad una muestra aleatoria estratificada para detectar errores sistemáticos con alta confianza.
Un esquema válido puede contener hechos falsos. Los structured outputs nativos, Instructor y los decodificadores con restricciones pueden hacer que una respuesta se pueda parsear. No pueden asegurar que cada campo esté anclado en la fuente, que el límite de un span sea correcto ni que un valor normalizado se asigne al registro adecuado. Conservad la evidencia de la fuente y validad la semántica por separado.
Las pérdidas por cuantización dependen del checkpoint y de las capas que cuantizáis. Cuantizar todas las capas MatMul del GLiNER del repositorio complementario no devolvió ninguna entidad; mantener las proyecciones descendentes de la FFN en FP32 conservó el recall en su comprobación de 32 frases. Otro checkpoint puede tener capas sensibles distintas. Comparad los modelos cuantizado y original en F1 de span exacto y recall por etiqueta antes del despliegue.
Cuando la arquitectura de tres niveles es excesiva. Un único dominio con tipos de entidad estables y suficientes ejemplos etiquetados puede necesitar solo un RoBERTa con fine-tuning o un pipeline de spaCy. El patrón de tres niveles encaja con varios dominios, tipos de entidad en evolución o una mezcla medida de extracción explícita y extracción que exige razonamiento. Un pipeline estrecho de facturas que extrae nombres y fechas puede quedarse en el nivel 1.
La calidad del bi-encoder varía según el dataset y el tamaño del checkpoint. En CoNLL-2003, gliner_small-v2.5 alcanza un F1 del 65,4 %, por encima de los bi-encoders edge/small con 61,6 %/64,2 %, pero por debajo de bi-base/large con 65,6 %/66,5 % (Stepanov et al., 2026, tablas 2–3). Elegid según la calidad exact-span medida, la calibración, el número de etiquetas y el throughput en tu conjunto de dominio.
Las afirmaciones sobre PII y multilingües requieren porciones. Una puntuación agregada alta puede ocultar una pérdida peligrosa de recall en una configuración regional, una forma de nombre, un layout de documento o una clase rara de PII. Usad un modelo de privacidad como uno más de varios controles, definid un proceso de respuesta a los falsos negativos y reevaluad cuando cambien la taxonomía, la mezcla de idiomas o la fuente de datos.
Puntos clave
- Usad un encoder compacto para spans explícitos solo después de que supere un conjunto de test del dominio con soporte por tipo e intervalos de confianza.
- Usad GLiNER para vocabularios de etiquetas cambiantes. Comparad primero su bi-encoder cuando se reutilice un inventario grande de tipos; activad
flat_ner=Falsesolo después de comprobar que el checkpoint encuentra los spans interiores. - Usad spaCy o un clasificador de tokens con fine-tuning cuando las etiquetas sean estables y tengáis datos de entrenamiento.
- Usad descripciones de tipo probadas para las afirmaciones zero-shot estrictas, y probad por separado la redacción de etiquetas en inglés y en el idioma local para los productos multilingües.
- Mantened OCR, NER, extracción de relaciones y entity linking como etapas de evaluación distintas, aunque un mismo modelo exponga varias tareas.
- Tratad a un LLM teacher como un sistema que propone anotaciones. Las guías humanas, la adjudicación, los conjuntos de regresión inmutables y un conjunto de test retenido siguen siendo obligatorios.
- Usad esquemas nativos con los proveedores de LLM compatibles, pero validad la corrección semántica y el anclaje en la fuente por separado de la validez del JSON.
- Cambiad un solo paso del runtime cada vez: primero ONNX FP32, luego INT8 con las capas sensibles en FP32, con una comparación de spans después de cada paso.
Referencias
Artículos
- GLiNER: Generalist Model for Named Entity Recognition using Bidirectional Transformer - Zaratiana et al., NAACL 2024. La arquitectura fundacional de matching entre spans y entidades.
- GLiNER2: An Efficient Multi-Task Information Extraction System with Schema-Driven Interface - Zaratiana et al., EMNLP 2025 System Demonstrations. Unifica NER, clasificación y extracción jerárquica; las versiones actuales añadieron después la extracción de relaciones.
- GLiNER Bi-Encoder: Scalable Named Entity Recognition with Bi-Encoder Architecture - Stepanov et al., febrero de 2026. Codificación desacoplada para escala de millones de etiquetas.
- GLiNER-Relex: A Unified Framework for Joint Named Entity Recognition and Relation Extraction - Stepanov et al., 2026. Extracción conjunta zero-shot de entidades y relaciones.
- GLiNER2-PII: A Multilingual Model for Personally Identifiable Information Extraction - Zaratiana et al., 2026. 42 tipos de PII con resolución a nivel de span de caracteres.
- ZeroNER: Fueling Zero-Shot Named Entity Recognition via Entity Type Descriptions - Cocchieri et al., ACL 2025. Evaluación zero-shot estricta con descripciones de tipo.
- OpenNER 1.0: Standardized Open-Access Named Entity Recognition Datasets in 50+ Languages - Palen-Michel et al., EMNLP 2025. 36 corpus, 52 idiomas y baselines con varias ontologías.
- FiNERweb: Datasets and Artifacts for Scalable Multilingual Named Entity Recognition - Golde et al., EACL 2026. Etiquetas multilingües y evaluación de la transferencia.
- UniversalNER: Targeted Distillation from Large Language Models for Open Named Entity Recognition - Zhou et al., ICLR 2024. NER universal basado en LLM mediante destilación de ChatGPT.
- NuNER: Entity Recognition Encoder Pre-training via LLM-Annotated Data - Bogdanov et al., EMNLP 2024. Estudia un encoder de 125M preentrenado con anotaciones de un LLM.
Artículos de la industria
- EAMT: Entity-Aware Multi-Task Learning for Query Understanding - Walmart, KDD 2023. Comprensión multitarea de consultas con unas 60 etiquetas de NER.
- TripleLearn: End-to-End NER for E-Commerce Search - Home Depot, AAAI 2021. F1 de 69,5 a 93,3.
- CyNER: A Python Library for Cybersecurity Named Entity Recognition - Reconocimiento neuronal combinado con otras fuentes de extracción.
- CyberNER: A Harmonized STIX Corpus for Cybersecurity NER - 21 tipos de entidad alineados con STIX 2.1.
- FinBERT-MRC: Financial NER via Machine Reading Comprehension - Formulación MRC evaluada en datasets financieros chinos.
Casos de estudio
- CFM Case Study: Fine-tuning GLiNER for Financial NER - El pipeline de etiquetado con LLM de $70 de Capital Fund Management, que alcanza un 93,4 % de F1.
- Refuel AI: LLM Labeling Technical Report - GPT-4 logra un 88,4 % de concordancia en la anotación, por encima de los anotadores humanos.
- Sease: GLiNER as an Alternative to LLMs for Query Parsing - Dónde falla GLiNER y dónde siguen haciendo falta los LLMs.
- John Snow Labs: Medical Text De-Identification Benchmark - Estudio del proveedor con reasignación de etiquetas y exclusiones.
- OpenMed: Year in Review 2025 - Modelos abiertos de NER médico; retrospectiva de enero de 2026.
Herramientas y frameworks
- Repositorio de demo ner-field-guide - Código complementario de este artículo: puntuación de spans exactos, ejemplos de GLiNER, conversión de anotaciones revisadas, comprobaciones de ONNX FP32 e INT8 y una demo de PII en streaming.
- GLiNER - Librería, script de entrenamiento y ruta con Ray Serve con batching dinámico y despliegue con varias réplicas.
- gline-rs: reimplementación de GLiNER en Rust - Inferencia en Rust sobre archivos ONNX de GLiNER; código con licencia Apache 2.0.
- Pipelines de spaCy en inglés - Métricas versionadas de pipelines de etiquetas cerradas.
- dslim/bert-base-NER - Clasificador de tokens BERT con fine-tuning sobre CoNLL-2003.
- Microsoft Presidio - Análisis y anonimización de PII con reconocedores personalizados.
- Instructor - Extracción estructurada con LLM mediante modelos de Pydantic.
- Outlines - Generación de tokens restringida mediante FSM, con un benchmark de adherencia al esquema publicado.
- LangExtract - Extracción estructurada anclada en la fuente con intervalos de caracteres.
- NuExtract - Extracción de documentos autoalojada, de esquema a plantilla.
- OpenAI Structured Outputs - Referencia del formato de respuesta estricto con JSON Schema.
- Anthropic Structured Outputs - Salidas JSON y entradas de herramientas estrictas.
- Gemini Structured Outputs - Subconjunto de JSON Schema para respuestas estructuradas.
- Cuantización de ONNX Runtime - Referencia de la cuantización INT8 dinámica y estática.
- AWS: Structured Output with Outlines - Benchmark de adherencia al esquema del 98 %.