Einen Agent-Harness entwerfen: von der Aufgabe zur Architektur

Automatische Übersetzung
Dieser Artikel wurde automatisch aus der englischen Originalversion übersetzt.
Ein Agent-Harness ist der Code rund um ein Sprachmodell, der es eine Aufgabe erledigen lässt. Er gibt dem Model Anweisungen und Daten, führt die Aktionen aus, die das Model anfordert, verfolgt den Fortschritt und entscheidet, wann die Aufgabe erledigt ist. Dieser Artikel richtet sich an Engineers, die einen Agent in ihre eigene Anwendung einbauen. Er zeigt, wie man diesen Code aus der Aufgabe heraus entwirft: welche Schritte das Model wählt, welche Schritte Ihr Code im Voraus festlegt und welche Regeln Ihr Code durchsetzt, was auch immer das Model sagt.
Treffen Sie diese Entscheidungen, bevor Sie ein Agent-Framework wählen, denn die Antworten unterscheiden sich von Aufgabe zu Aufgabe. Ein Support-Assistent ändert Kundenkonten und braucht deshalb Berechtigungsprüfungen und eine sichere Art, eine Zahlung zu wiederholen. Ein Coding Agent bearbeitet Dateien und führt Tests aus, also braucht er einen Ort, an dem sein Code laufen kann, ohne etwas anderes zu beschädigen. Ein Dokumentklassifikator gibt nur ein Label zurück und braucht vielleicht gar keine Tools. Wenn alle drei mit demselben Loop, demselben Memory Store und demselben Tool-Set starten, fragt niemand, was die jeweilige Aufgabe braucht.
Wir verfolgen diese Entscheidungen an einem Beispiel, einem Support-Assistenten, der Rückerstattungen auslöst, von der Aufgabenbeschreibung bis zur ersten Implementierung. Der Artikel baut auf Harness Engineering für AI Agents auf, der beschreibt, wofür ein Harness verantwortlich ist. Hier legen wir diese Verantwortlichkeiten für ein Projekt fest.
Warum das Model einen Harness braucht
In unserem Support-Assistenten kann das Model eine Rückerstattung vorschlagen, aber nicht allein durchführen. Code muss das Konto des Kunden finden, die Bestellung laden, prüfen, ob die Rückerstattung erlaubt ist, den Zahlungsdienst aufrufen und das Ergebnis festhalten. Läuft der Zahlungsdienst in einen Timeout, muss Code außerdem entscheiden, ob ein zweiter Versuch sicher ist. Diese Aufgaben bleiben bestehen, auch wenn das Model den nächsten Schritt sehr gut wählt.
Ein Teil dieses Codes existiert in Ihrer Anwendung vielleicht schon. LangChain, das Agent-Framework, das diese Serie später verwendet, definiert einen Harness weit: als den gesamten Code, die Konfiguration und die Ablauflogik rund um das Model. Login, Datenbankzugriff, eine Job Queue und ein Freigabeschritt fallen alle unter diese Definition. Zum Entwurf eines Harness gehört die Entscheidung, wie der Agent sie nutzt. Sie müssen sie nicht in einem Agent-Framework neu bauen.
Ein Harness kann klein oder groß sein. Der kleinste ruft das Model einmal auf, validiert die Ausgabe und gibt ein Ergebnis zurück. Ein größerer lässt das Model Dateien lesen, Programme ausführen und seine Arbeit über viele Turns überarbeiten. Beide müssen zwei Fragen beantworten: Welche Teile der Aufgabe übernimmt das Model, und wie prüfen wir, dass sie korrekt erledigt wurden?
Das Ergebnis beschreiben, bevor man den Agent baut
„Rückerstattungsanfragen bearbeiten“ sagt noch nicht, was der Assistent tun muss. Angenommen, ein Kunde bittet um die Rückerstattung einer gelieferten Bestellung. Der Lauf ist erfolgreich, wenn er die richtige Bestellung und den richtigen Betrag erstattet, dem Kunden das Ergebnis erklärt und sonst nichts am Konto ändert. Verstößt die Anfrage gegen die Rückerstattungsrichtlinie, ist eine klare Ablehnung das richtige Ergebnis. Kann der Assistent nicht erkennen, welche Bestellung der Kunde meint, sollte er nachfragen.
Eine Rückerstattung, eine Ablehnung und eine Rückfrage sind drei verschiedene richtige Ergebnisse. Zählen wir jedes Gespräch, das ohne Fehler endet, als Erfolg, können wir sie nicht voneinander unterscheiden, und auch nicht von einer falschen Antwort, die höflich endete.
Eine korrekte Rückerstattung hängt auch davon ab, wer fragt. Ein Kunde kann jede beliebige Bestellnummer eintippen, daher beweist eine Bestellnummer in einer Nachricht nicht, dass die Bestellung ihm gehört. Die Anwendung muss das angemeldete Konto liefern, und der Rückerstattungsdienst muss prüfen, dass die Bestellung zu diesem Konto gehört. Das Model kann die Anfrage lesen; es kann nicht beweisen, wer der Anrufer ist.
Damit haben wir den Anfang eines Aufgabenvertrags: die Änderungen, die als Erfolg zählen, die Änderungen, die verboten sind, und die Situationen, in denen der Assistent eine Frage stellen oder den Fall an einen Menschen übergeben muss. Manche dieser Anforderungen lassen sich nicht allein mit dem Prompt erfüllen. Einen maximalen Rückerstattungsbetrag muss der Dienst prüfen, der Rückerstattungen auslöst. Ein Ziel für die Antwortzeit braucht einen Timeout im Code. Einen Fall morgen fortzusetzen braucht gespeicherten State.
Mit der beschriebenen Aufgabe können wir entscheiden, wie viel davon das Model steuern soll.
Wie viel vom Ablauf kennen wir schon?
Folgt jede Anfrage denselben Schritten (Bestellnummer extrahieren, Bestellung abrufen, Berechtigung prüfen, eine erlaubte Rückerstattung auslösen und das Ergebnis erklären), können wir diese Schritte im Code als feste Pipeline schreiben. Schlägt eine Prüfung fehl, wird die Rückerstattung übersprungen. Das Model übernimmt die Sprache am Anfang und am Ende. Es braucht keinen zusätzlichen Model-Aufruf, um zu entscheiden, ob es eine Bestellung abrufen soll, die jede Anfrage braucht.
Ein expliziter Workflow ergänzt Verzweigungen und Wartezustände, die der Code steuert. Eine Rückerstattung über einem Limit könnte auf Freigabe warten. Eine Adressänderung könnte nur erlaubt sein, bevor die Bestellung versandt wird. Wir können diese Stufen als Graph von Schritten zeichnen, und der Code entscheidet, welcher Schritt als Nächstes kommt.
Ein Agent Loop lässt das Model jeden Schritt wählen. Das Model wählt eine Aktion, liest das Ergebnis und wählt erneut, bis es sich für eine Antwort entscheidet. Das hilft in einem gemischten Gespräch: Ein Kunde beginnt mit einer Beschwerde über die Lieferung, sagt dann, dass der falsche Artikel ankam, und fragt schließlich nach einem Umtausch. Die nächste sinnvolle Abfrage hängt davon ab, was der Assistent bisher gefunden hat. Der Preis: Der Loop kann mehr Wege nehmen, und jeder muss getestet werden. Das Model kann unnötige Aufrufe machen, eine Abfrage wiederholen oder aufhören, bevor die Aufgabe erledigt ist.
Der Leitfaden von LangGraph zu Workflows und Agents beschreibt dieselbe Trennung: Workflows folgen im Voraus festgelegten Pfaden, und Agents wählen ihre Schritte zur Laufzeit. LangGraph, die Graph-Bibliothek unter LangChain, kann beides bauen, sodass ein als Graph gebautes System trotzdem einen Agent enthalten kann.
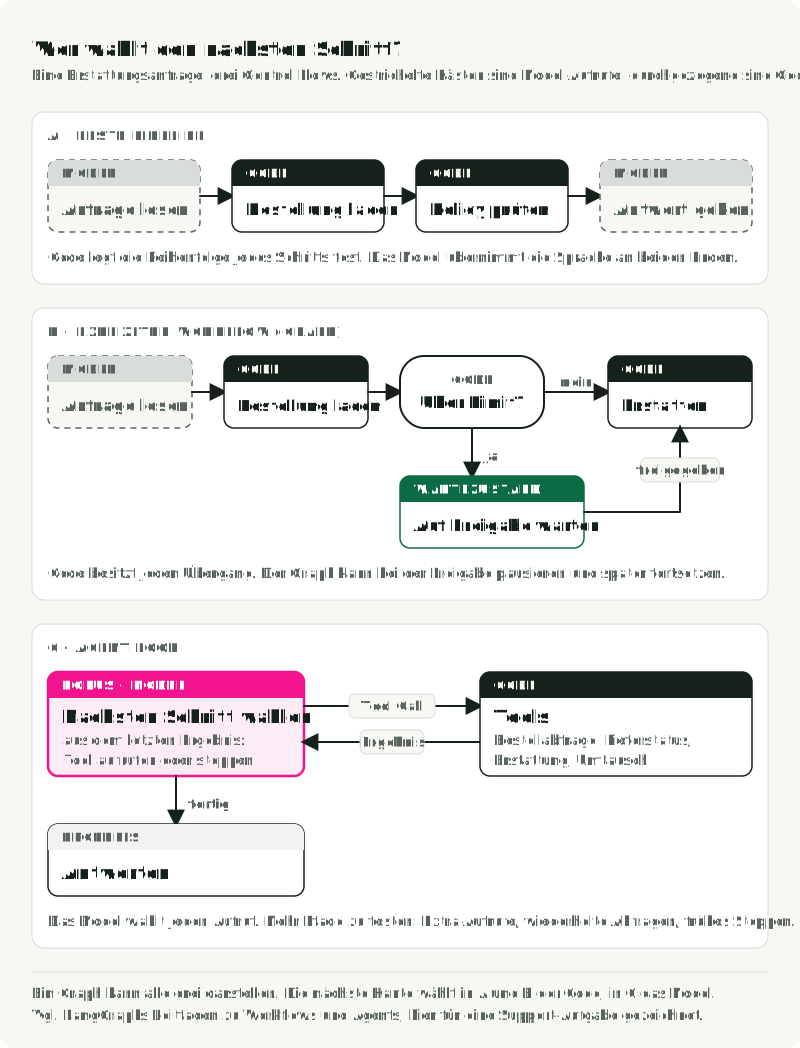
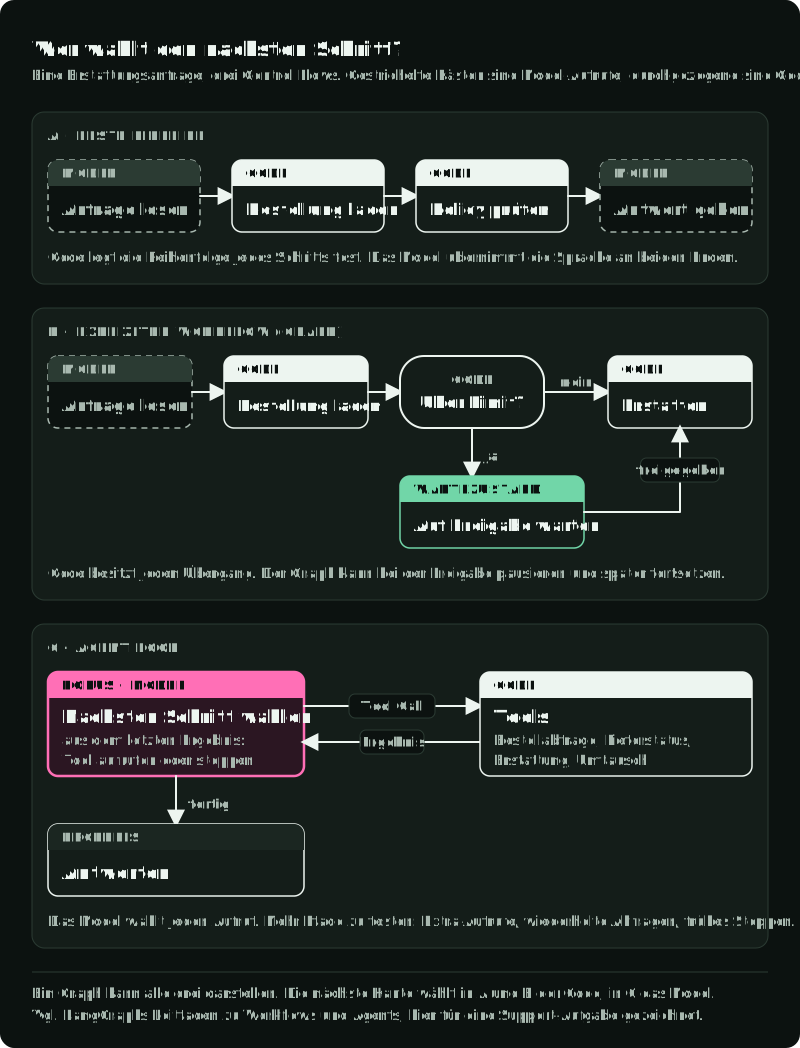
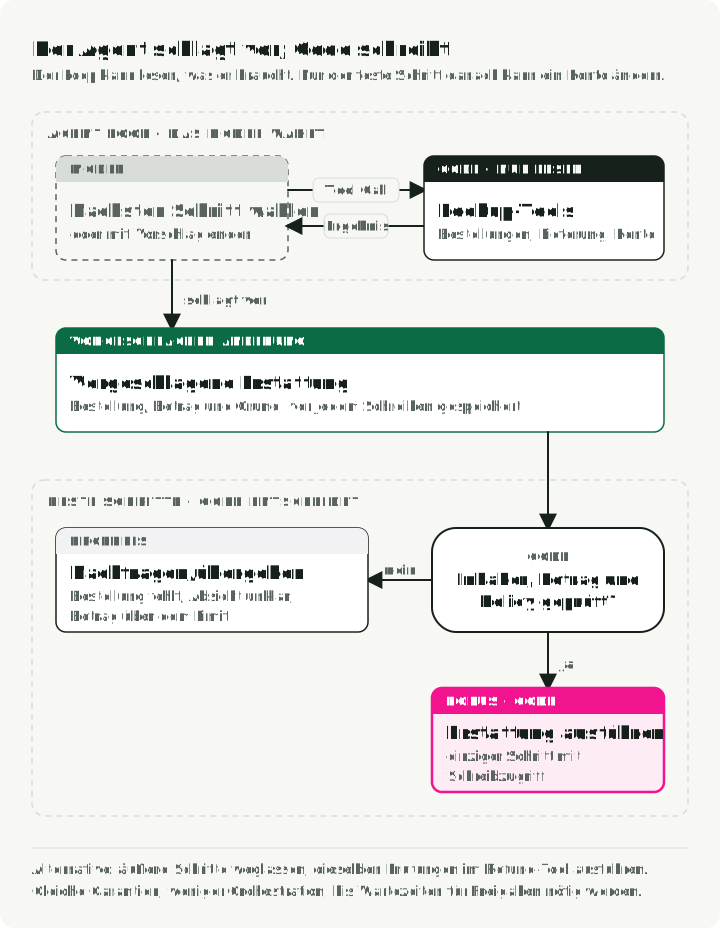
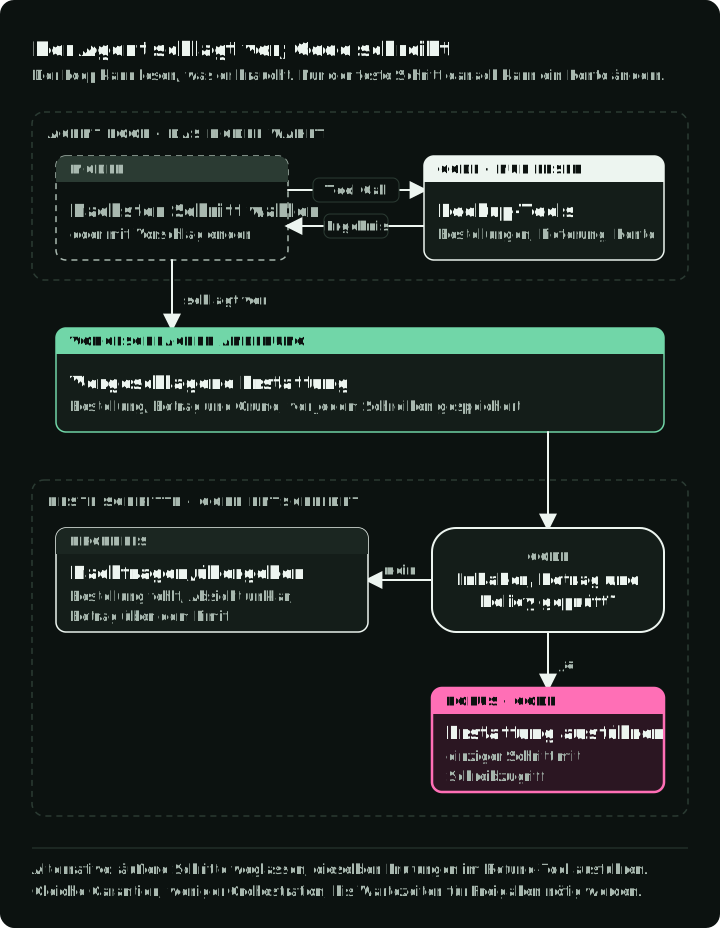
Für unseren Support-Assistenten kombiniert ein Entwurf beides. Ein Agent Loop sammelt Informationen und bereitet eine vorgeschlagene Rückerstattung vor. Ein fester Code-Schritt prüft dann den Vorschlag und führt den Schreibzugriff aus. Das Model darf das Gespräch erkunden, während allein der Code entscheidet, ob geschrieben wird. Wissen wir schon, dass wir diese Aufteilung brauchen, können wir zuerst den Workflow um den Agent herum bauen.
Die andere Möglichkeit ist, mit einem einzelnen Agent Loop mit Schrittlimit zu beginnen und die Prüfungen in die Tools selbst zu legen. So bleibt die erste Version klein, während wir lernen, welche Pfade die Aufgabe braucht. Wählen Sie zuerst den Workflow, wenn Freigabe-Wartezeiten, feste Stufen oder Wiederherstellungsregeln schon Anforderungen sind.
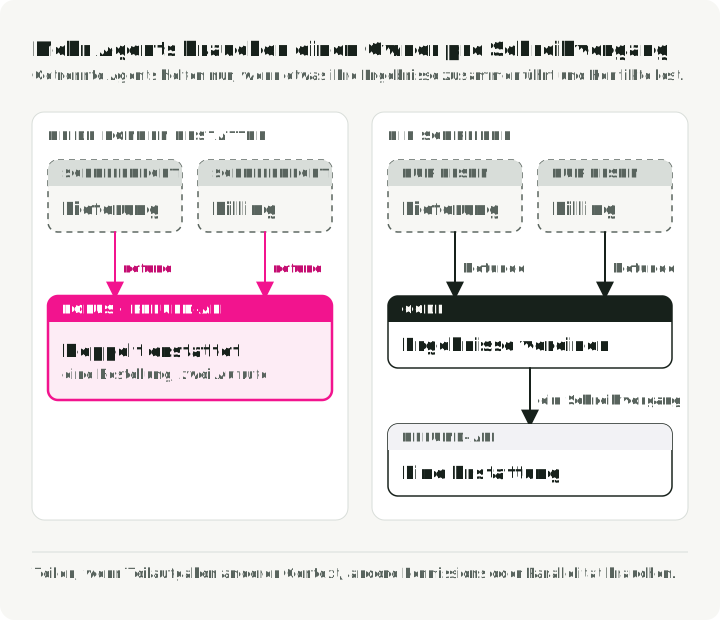
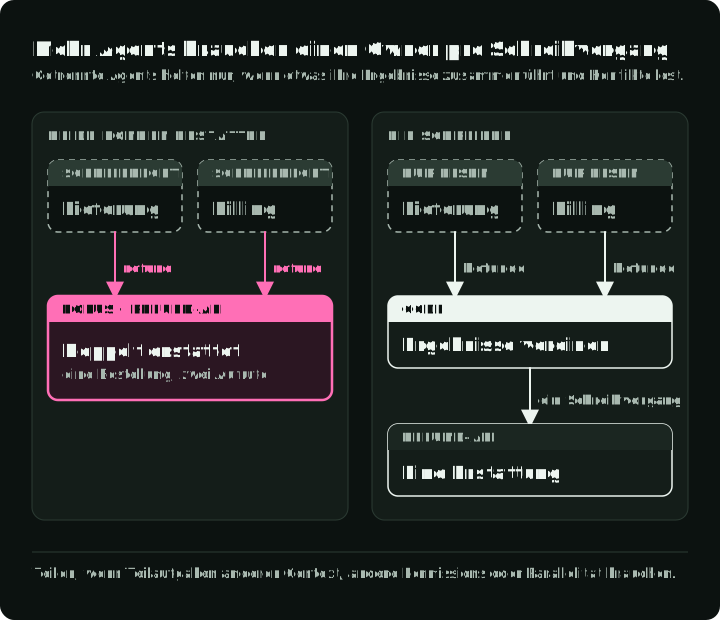
Die Arbeit auf mehrere Agents zu verteilen ist eine eigene Entscheidung, und ein Agent genügt oft. Ein zweiter Agent hilft, wenn eine Teilaufgabe anderen Context oder andere Berechtigungen braucht oder gleichzeitig mit der ersten laufen kann. Dann muss etwas ihre Ergebnisse zusammenführen und Konflikte zwischen ihren Aktionen lösen. Können ein Liefer-Agent und ein Abrechnungs-Agent beide Rückerstattungen auslösen, kann eine Bestellung doppelt erstattet werden.
Tool Calls oder generierter Code?
Nachdem wir entschieden haben, wer den nächsten Schritt wählt, entscheiden wir, wie das Model eine Aktion anfordert. Es kann ein Tool aufrufen: eine benannte Funktion, die Ihr Code bereitstellt und im Auftrag des Models ausführt. Oder es schreibt ein kurzes Programm, das Ihr Code ausführt. Wer den nächsten Schritt wählt und wie das Model eine Aktion anfordert, sind getrennte Entscheidungen. Ein fester Workflow kann einen Schritt enthalten, in dem das Model Code schreibt, und ein offener Agent Loop kann nur wenige schmale Tools nutzen.
Für den Support-Assistenten passt ein Tool wie issue_refund(order_id, amount_cents) gut. Sein Schema benennt die Aktion und ihre Argumente, die Anfrage ist also explizit. Das Tool gibt bei Erfolg eine Refund-ID zurück oder bei einer Ablehnung einen strukturierten Grund. Wir können dieses Tool einzeln testen, weil das Model die Rückerstattungslogik nie schreibt.
Nicht jede Aufgabe braucht Tools. Ein Klassifikator, der seine gesamte Eingabe im Prompt erhält, kann ein validiertes Label zurückgeben. Ergänzen Sie ein Abfrage-Tool, wenn die Aufgabe Daten braucht, die nicht im Prompt stehen. Ergänzen Sie ein Tool, das Daten ändert, nur dann, wenn die Aufgabe etwas ändern muss.
Generierter Code eignet sich für eine andere Art von Arbeit. Angenommen, der Assistent soll eine Tabelle mit Bestellungen lesen, die Zeilen nach Kunden gruppieren und mehrere Summen berechnen. Mit Tools ist jeder Schritt ein eigener Aufruf, und jedes Zwischenergebnis geht zurück an das Model. Mit Code schreibt das Model ein einziges Python-Programm, das die Zwischenwerte in eigenen Variablen hält, und nur die Summen kommen zurück.
Die Bibliothek smolagents von Hugging Face bietet beide Stile. ToolCallingAgent gibt strukturierte Tool Calls zurück. CodeAgent schreibt Python, das dieselben Tools aufruft, Werte in Variablen speichert und die Ergebnisse kombiniert. Ein Code Agent nutzt weiterhin Tools; er ruft sie aus einem Programm auf.
Generierter Code macht uns auch zusätzliche Arbeit. Wir müssen Syntaxfehler behandeln, die Laufzeit begrenzen, Abhängigkeiten verwalten und entscheiden, auf welche Dateien und Netzwerkadressen der Code zugreifen darf. Ob weniger Model-Aufrufe diesen Aufwand aufwiegen, hängt von der Aufgabe und vom Model ab. Messen Sie es an Ihrer Aufgabe; Code ist nicht per se besser.
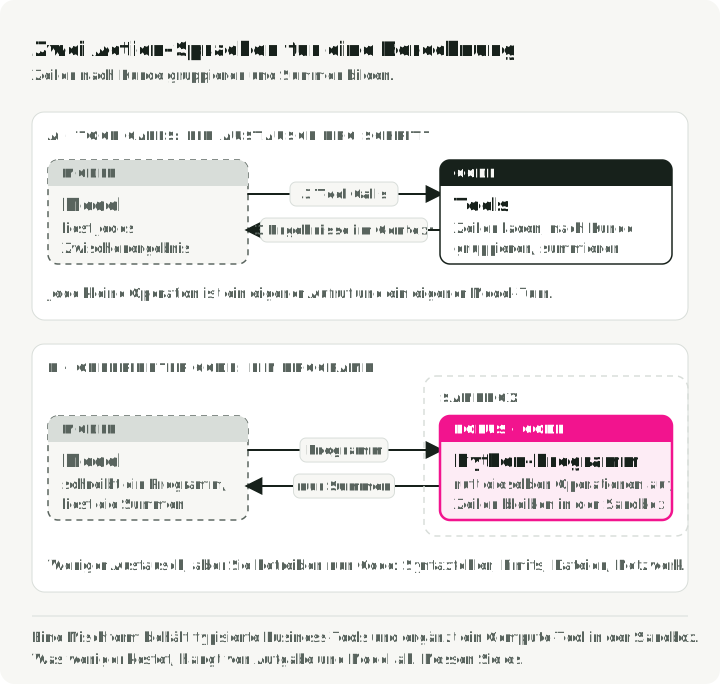
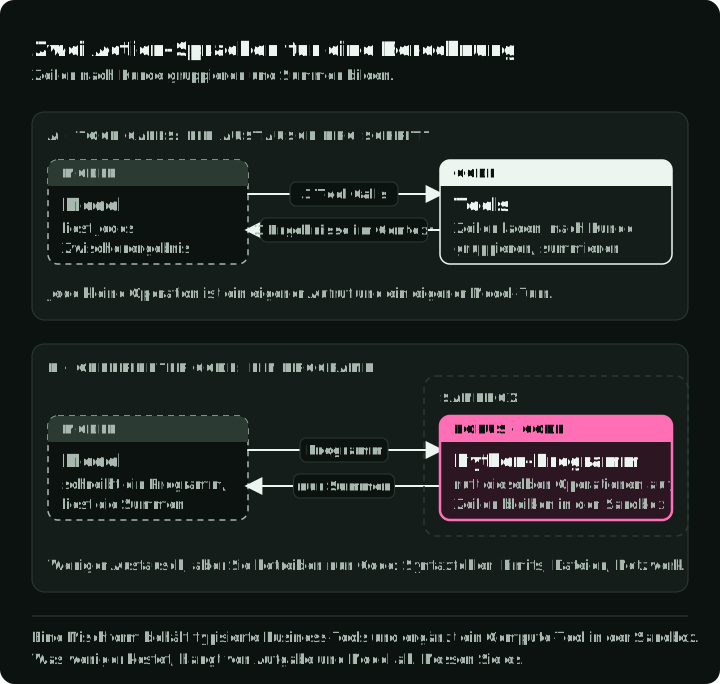
Mehrere gehostete APIs kombinieren beide Stile: Ihre eigenen Business-Tools plus ein eingebautes Tool zur Codeausführung, das in einer Sandbox läuft, einer getrennten Umgebung mit eingeschränktem Zugriff. Die Responses API von OpenAI, die Claude API, die Gemini API und AWS Bedrock AgentCore bieten das alle an.
Das Programmatic Tool Calling von Anthropic geht einen Schritt weiter: Code in der Sandbox kann die Tools aufrufen, die Sie erlauben, und nur die Ergebnisse, die Sie auswählen, gehen an das Model zurück. Anthropic empfiehlt weiterhin standardmäßig direkte Tool Calls und den Code-Pfad für große Ergebnisse und für Aufrufketten, die voneinander abhängen. Manche Entwürfe nutzen ausschließlich Code, etwa der CodeAgent von smolagents und Code Mode von Cloudflare.
Für unseren Rückerstattungs-Assistenten würde ich mit typisierten Business-Tools beginnen. Braucht eine spätere Aufgabe aufwendige Berechnungen, können wir einen Code Runner ergänzen, der keinen Zugriff auf Kundenkonten hat.
Eine dritte Frage ist, wie die Anwendung ihre Tools anbindet. Eine lokale Funktion genügt, wenn eine Anwendung den Code besitzt. Das Model Context Protocol (MCP) ist ein Standard, um Tools von einem separaten Server bereitzustellen, sodass mehrere Anwendungen sie teilen können. MCP legt fest, wie Anwendung und Server Tool Calls austauschen. Es validiert keine Argumente und entscheidet nicht, wer ein Tool aufrufen darf: Die MCP-Tools-Spezifikation überlässt diese Prüfungen der Anwendung und dem Server.
Einschränkungen dort setzen, wo Aktionen stattfinden
Eine Tool-Beschreibung sagt dem Model, wann ein Tool nützlich ist. Sie entscheidet nicht, ob ein bestimmter Aufruf laufen darf. Das muss der Code entscheiden, der den Schreibzugriff ausführt. Bei einer Rückerstattung prüft dieser Code das angemeldete Konto, die Bestellung, den Betrag, die Rückerstattungsrichtlinie und jede nötige Freigabe.
Manche Prüfungen brauchen Interpretation
Manche Prüfungen lassen sich nicht als gewöhnlicher Code schreiben. Angenommen, der Kunde fragt: „Kann ich diese Bestellung zurückgeben?“, und der Agent schlägt eine Rückerstattung vor. Die Bestellung gehört dem Kunden, der Betrag ist gültig und die Rückgabefrist läuft noch. Alle Code-Prüfungen bestehen, doch der Kunde fragt vielleicht nur, ob eine Rückgabe möglich ist, und verlangt nicht jetzt eine Rückerstattung. Jemand muss die Nachricht lesen, um das zu entscheiden.
Gewöhnlicher Code prüft weiterhin die Kontozugehörigkeit, Beträge und Datumsangaben. Das Haupt-Model kann bei unklarer Absicht beim Kunden nachfragen, oder die Anwendung kann vor einer Rückerstattung eine ausdrückliche Bestätigung verlangen. Ein separates Decision Model ist ein weiterer Entwurf, den wir evaluieren können: Es beantwortet eine enge Frage zur Bedeutung, etwa „Hat der Kunde diese Rückerstattung verlangt?“ Diese Frage können wir einzeln testen, ohne das ganze Gespräch auszuführen. Vergleichen Sie diesen Entwurf mit einer Rückfrage oder Bestätigung, bevor Sie ein weiteres Model ergänzen.
Jev, ein Decision Model von TypeSafe, ist eine Option für diese Rolle. Es nimmt den State, den wir liefern, und typisierte Fragen entgegen und gibt strukturierte Antworten zurück. Bei einer Ja/Nein-Frage gibt es die Wahrscheinlichkeit zurück, dass die Antwort Ja lautet.
Ich würde zwei getrennte Fragen stellen: Hat der Kunde die Rückerstattung ausdrücklich verlangt, und hat eine spätere Nachricht diese Anfrage zurückgezogen? TypeSafe empfiehlt spezifische Fragen, deren Antworten im Code kombiniert werden, und mehrere Fragen können sich einen API-Aufruf teilen. Bei zwei Fragen zeigt eine falsche Antwort, welche der beiden Beurteilungen fehlschlug.
Der Code kombiniert diese Antworten dann mit den vorgeschriebenen Prüfungen. Sind die Antworten unklar oder widersprüchlich, fragt der Assistent den Kunden oder übergibt den Fall an einen Menschen. Läuft der Jev-Aufruf in einen Timeout, braucht auch dieser Fehler einen eigenen Pfad. Ein „Ja“ von Jev setzt eine fehlgeschlagene Eigentumsprüfung nie außer Kraft und ersetzt keine vorgeschriebene Bestätigung. Seine Wahrscheinlichkeit ist eine Model-Ausgabe. Sie autorisiert die Rückerstattung nicht und beweist nicht, dass die Entscheidung richtig ist.
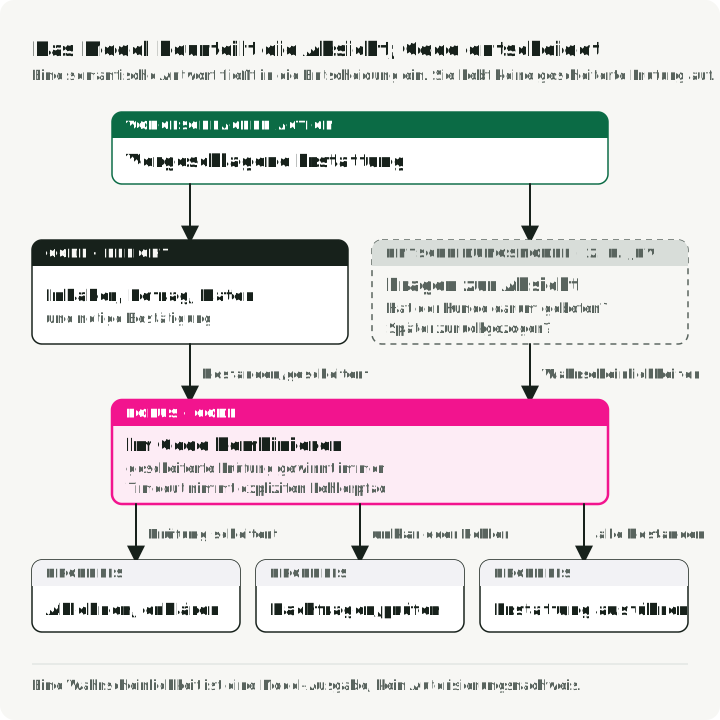
Der Context, den wir der Prüfung geben, bestimmt, was sie sehen kann. Ich würde die vorgeschlagene Aktion, die Nachrichten des Kunden in der richtigen Reihenfolge und die Tool Results liefern, die die Entscheidung braucht, jeweils mit ihrer Quelle gekennzeichnet. Die letzte Nachricht allein könnte eine Stornierung übersehen. Die vollständige Kontohistorie könnte die Anfrage zwischen nicht zusammenhängenden Nachrichten verbergen. Auch ein kleines Allzweck-Model mit Structured Output könnte diese Fragen beantworten. Vergleichen Sie es mit Jev an denselben Beispielen, bei Genauigkeit und Kosten.
Zugriff unabhängig von Model-Urteilen einschränken
Text von einem Kunden oder aus einem abgerufenen Dokument kann Anweisungen enthalten, die sich an den Agent richten. Dieser Text darf keine Berechtigungen erteilen und die Richtlinie der Anwendung nicht ersetzen können. Fordert ein Dokument den Agent auf, alle Kundendaten zu exportieren, muss dem System die Berechtigung dazu fehlen, so überzeugend der Wortlaut auch ist.
Generierter Code braucht eigene Zugriffsgrenzen. Kann das Model nur geprüfte Funktionen mit engen Berechtigungen aufrufen, bringt eine allgemeine Code-Sandbox womöglich wenig. Diese Funktionen brauchen trotzdem Autorisierung, Eingabevalidierung, Timeouts und sichere Datenbankabfragen.
Bevor wir generiertes Python, Shell-Befehle oder Änderungen an ausführbaren Dateien erlauben, müssen wir entscheiden, worauf dieser Code zugreifen kann. In welche Verzeichnisse darf er schreiben? Braucht er Netzwerkzugriff? Welche Zugangsdaten kann er sehen? Wie viel CPU-Zeit, Speicher und Ausgabe darf ein Lauf verbrauchen? Den Code in einem separaten Prozess auszuführen beantwortet diese Fragen nicht von selbst.
Der Leitfaden von Hugging Face zur sicheren Ausführung vergleicht einen eingeschränkten lokalen Interpreter mit stärker isolierten Optionen wie Containern. Jede Option blockiert etwas anderes. Ein Container mit weitem Zugriff auf die Dateien des Hosts und mächtigen Zugangsdaten kann trotzdem die Ressourcen offenlegen, die wir schützen wollten. Testen Sie, dass ein verbotenes Lesen, ein verbotenes Schreiben und eine verbotene Netzwerkanfrage fehlschlagen und dass ein normales Programm gelingt.
Wir können den Code Runner weglassen, bis die Aufgabe ihn braucht, aber seine Isolation muss an dem Tag bereitstehen, an dem wir ihn aktivieren. Isolation kann außerdem den Missbrauch einer API nicht verhindern, die wir dem Code absichtlich geben, daher muss der Rückerstattungsdienst weiterhin seine eigenen Regeln durchsetzen.
Was überlebt, wenn ein Lauf mittendrin stoppt?
Angenommen, der Assistent sendet eine Rückerstattungsanfrage, der Dienst legt die Rückerstattung an, und die Antwort geht auf dem Rückweg verloren. Das Model sieht einen Timeout. Ruft es erneut auf, erhält der Kunde womöglich eine zweite Rückerstattung. Meldet es einen Fehler, sagt es dem Kunden etwas, das nicht mehr stimmt.
Die Lösung ist, die Rückerstattung idempotent zu machen: Dieselbe Anfrage zweimal zu senden hat dieselbe Wirkung wie einmal. Bevor die Anwendung die Rückerstattung sendet, erzeugt sie eine Operations-ID und speichert sie. Bei einem erneuten Versuch sendet sie dieselbe ID, und der Dienst gibt die bereits angelegte Rückerstattung zurück, statt eine weitere anzulegen. Die Hinweise von AWS zu idempotenten APIs erklären dieses Muster. Unterstützt der Dienst es nicht, muss die Wiederherstellung vor jedem zweiten Versuch erst prüfen, was passiert ist, oder einen Menschen fragen.
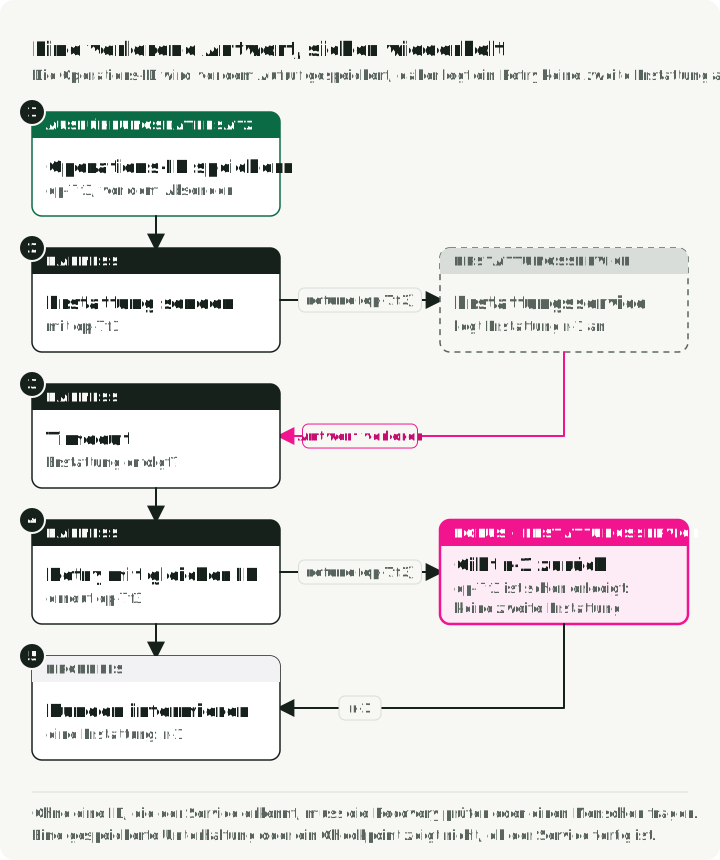
Das Speichern des Gesprächs löst das nicht. Das Gespräch kann festhalten, dass das Model eine Rückerstattung angefordert hat, aber nicht, ob der Dienst sie abgeschlossen hat. Ein Checkpoint, eine gespeicherte Kopie des Agent-States, lässt einen gestoppten Lauf weiterlaufen. Er kann eine Rückerstattung, die der Dienst schon ausgeführt hat, nicht rückgängig machen und macht eine Wiederholung nicht sicher.
Für diesen Assistenten haben drei Arten von State unterschiedliche Aufgaben. Das Gespräch enthält die Anfrage des Kunden und die bisher gesammelten Fakten. Die Bestell- und Rückerstattungsdaten halten den Geschäfts-State. Ein Ausführungsprotokoll listet offene Operationen und Freigaben auf, damit ein neu gestarteter Worker sicher weitermachen kann. Sie können in derselben Datenbank liegen, aber einer kann den anderen nicht ersetzen.
Memory über Sessions hinweg ist eine eigene Entscheidung. Muss der Assistent sich nächste Woche an die Präferenz eines Kunden erinnern, brauchen wir Regeln dafür, wessen Präferenz es ist, wer sie ändern darf und wie sie gelöscht wird. Ist jede Aufgabe unabhängig, brauchen wir vielleicht gar keinen Memory-Dienst. Außerdem kann jeder gespeicherte Text später veraltet oder irrelevant sein und trotzdem wiederverwendet werden.
Lange Gespräche werfen innerhalb einer Session ein ähnliches Problem auf. Wird ein Gespräch zu lang, als dass das Model es gut nutzen kann, rufen wir vielleicht Teile davon ab oder ersetzen ältere Turns durch eine Zusammenfassung. Eine Zusammenfassung, die eine Bestell-ID, eine Freigabebedingung oder eine offene Operation weglässt, kann den Ablauf brechen. Halten Sie diesen operativen State in expliziten Feldern, und testen Sie, was eine Zusammenfassung übersteht, bevor Sie sich darauf verlassen.
Dem Loop einen Weg zum Anhalten geben
Ein Agent Loop findet immer noch etwas, das er prüfen kann, deshalb braucht er eine Abbruchregel für Erfolg, fehlende Informationen, aufgebrauchte Limits und Fehler. Erreicht ein Lauf ein Limit, muss er den wahren Status melden: Die Rückerstattung ist erledigt, wurde nie versucht oder ist noch ungewiss. „Der Agent hat gestoppt“ sagt dem Kunden oder dem nächsten Worker nicht, was passiert ist.
Es hilft, die Möglichkeiten, wie ein Lauf enden kann, zu benennen, bevor man den Loop schreibt. Für den Support-Assistenten würde ich acht verwenden: abgeschlossen und geprüft, abgelehnt, fehlende Informationen erfragt, an einen Menschen übergeben, durch eine Richtlinienprüfung blockiert, durch ein Limit gestoppt, durch einen Infrastrukturfehler beendet und Ergebnis des Schreibzugriffs unbekannt.
Halten Sie diesen Status getrennt davon fest, ob der Lauf den Aufgabenvertrag erfüllt hat. „Abgeschlossen und geprüft“ bestätigt den angeforderten Schreibzugriff. Eine Ablehnung, Rückfrage oder Übergabe kann korrekt sein, wenn die Aufgabe sie verlangt. Die Antwort, die Aktionen und der Endzustand müssen diese Bewertung stützen; ein Stopp allein genügt nicht.
Ein Limit für Model-Aufrufe deckt nur einen Teil des Laufs ab. Ein Tool kann hängen. Ein Retry kann Arbeit wiederholen. Ein Summarizer oder ein Decision Model wie Jev macht eigene Model-Aufrufe. Setzen Sie Limits für verstrichene Zeit, Versuche, Ausgabegröße und Kosten, und zählen Sie jede Komponente, die läuft. Beim Abbrechen eines Laufs müssen auch bereits an einen externen Dienst gesendete Anfragen berücksichtigt werden.
Das Model selbst setzt zusätzliche Grenzen. Prüfen Sie an realistischen Aufgaben, dass es das geforderte Aktionsformat erzeugt. Vergleichen Sie nutzbare Context-Größe, Latency, Kosten und wohin Aufgabendaten gesendet werden dürfen. Ein selbst betriebenes Model und eine gehostete API können sich eine Schnittstelle teilen und sich doch in Kapazität und Datenhandhabung unterscheiden.
Wählen Sie ein erstes Model und einen Endpoint, halten Sie ihre Einstellungen fest und lassen Sie sie unverändert, solange Sie eine Harness-Änderung evaluieren. Sonst stammt ein schnellerer Lauf womöglich von einem anderen Anbieter oder Model und nicht von der Änderung, die Sie testen wollten.
Abschluss bewerten, auch bei Fällen, die nichts tun sollen
Sobald der Assistent eine Anfrage erledigen kann, müssen wir prüfen, ob er das Richtige getan hat. Im Rückerstattungsbeispiel können wir drei Dinge beobachten: was der Assistent gesagt hat, welche Aktionen er versucht hat und was sich im Dienst geändert hat. Jedes fängt Fehler ab, die die anderen übersehen.
Eine Antwort kann „Ich habe Ihre Bestellung erstattet“ sagen, während die Datenbank unverändert ist. Eine korrekte Rückerstattung kann mit einer nicht zusammenhängenden Adressänderung einhergehen, die nur das Protokoll der Aktionen zeigt. Und eine unveränderte Datenbank kann vier verschiedene Dinge bedeuten: eine korrekte Ablehnung, eine nützliche Rückfrage, einen Absturz oder einen Assistenten, der nichts getan hat. Der Endzustand allein kann diese vier nicht unterscheiden.
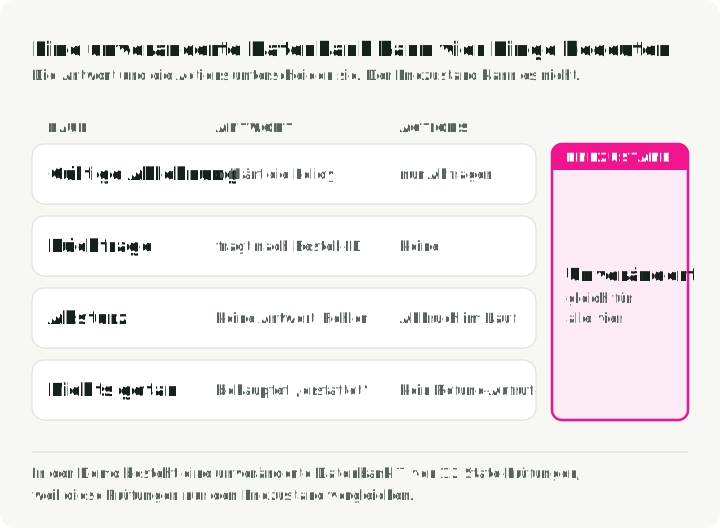
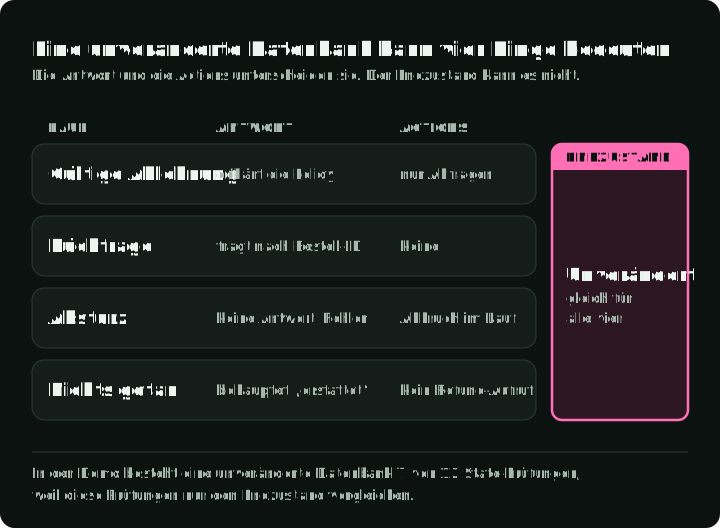
Die Begleit-Demo, die am Ende dieses Artikels beschrieben wird, zeigt diese Grenze mit echten Zahlen. Sie hat zwölf Support-Aufgaben, und sieben davon erwarten keine Änderung an der Datenbank. Ein Agent, der nichts ändert, besteht daher 7 von 12 State-Prüfungen. Diese Zahl beschreibt die Prüfungen; sie ist keine gemessene Erfolgsquote. Die Aufgabendefinitionen vergleichen nur die finale Datenbank, nicht die Antwort oder die Aktionen dazwischen. Ein Schreibzugriff, der erfolgt und dann rückgängig gemacht wird, hinterlässt in diesem Vergleich ebenfalls keine Spur.
Nehmen Sie in Ihr erstes Evaluationsset eine erfolgreiche Aktion, eine berechtigte Ablehnung, eine Anfrage mit fehlenden Informationen und einen Fehler während der Ausführung auf. Definieren Sie für jeden Fall außer dem Endzustand auch die erwartete Antwort und die erlaubten Aktionen. Ein Rückfrage-Fall sollte die richtige Frage verlangen. Ein Ablehnungs-Fall sollte eine nützliche Erklärung verlangen. Diese Fälle zeigen, ob der Agent die Aufgabe versteht und ob die Anwendung sie durchsetzt.
Wenn wir die Jev-Prüfung ergänzen, braucht sie eigene Testfälle. Geben Sie ihr vorgeschlagene Aktionen, deren richtige Entscheidungen ein Mensch im Voraus festgelegt hat: eine ausdrückliche Rückerstattungsanfrage, eine Frage zur Berechtigung, eine zurückgezogene Anfrage und eine in einem Tool Result versteckte Anweisung. Der letzte Fall testet auch, ob der Context, den wir zusammenstellen, Kundennachrichten von Tool-Ausgaben getrennt hält.
Zählen Sie die schlechten Aktionen, die Jev durchlässt, und die gültigen Aktionen, die es blockiert. Verfolgen Sie nach jeder Blockierung den Rest des Gesprächs. Einen Schreibzugriff zu blockieren hilft nur, wenn der Assistent danach dem Kunden eine Frage stellt, statt zu loopen oder aufzuhören. Jev gibt eine Wahrscheinlichkeit zurück, deshalb braucht die Anwendung einen Schwellenwert, der sie in Erlauben oder Blockieren übersetzt. Wählen Sie den Schwellenwert an Entwicklungsbeispielen und legen Sie ihn vor dem finalen Vergleich auf Beispielen fest, auf die Sie nicht abgestimmt haben. Halten Sie die Version der Frage, den gelieferten Context, die zurückgegebenen Wahrscheinlichkeiten, die angewandte Regel, alle Fehler und die Kosten fest. In der aufgezeichneten Demo hat Jev nie einen Schreibzugriff abgelehnt, sie zeigt also nicht, dass Jev hilft.
Halten Sie genug fest, um einen Fehler zu diagnostizieren: die Aufgabe, die Versionen von Model und Harness, die vorgeschlagenen Aktionen, die Ausführungsergebnisse, den Endzustand, Fehler, Latency und Kosten. Halten Sie Geheimnisse und unnötige personenbezogene Daten aus diesem Protokoll heraus.
Der getestete Agent darf nicht ändern können, wie er bewertet wird. Geben Sie ihm die Aufgabeneingabe und die Regeln, die er braucht, aber nicht die Referenzantworten oder die zurückgehaltenen Testfälle. Halten Sie den Evaluator (den Code, der Läufe bewertet) und seine Aufzeichnungen außerhalb der Kontrolle des Agents. Das wird strenger, wenn ein Programm später den Harness automatisch ändert, um seine Punktzahl zu erhöhen: Dieses Programm darf die Prüfungen, die es bewerten, nicht bearbeiten können.
Diese Aufzeichnungen sagen uns auch, wann wir eine optionale Komponente ergänzen. Ergänzen Sie einen Router, einen ersten Schritt, der jede Anfrage an den richtigen Handler schickt, wenn die aufgezeichneten Läufe zeigen, dass die Wahl der Anfrageart eine eigene Stufe braucht. Ergänzen Sie Zusammenfassungen, wenn lange Verläufe einen bestimmten Fehler verursachen. Testen Sie einen Guard gegen verbotene Aktionen, einschließlich der Aktionen, die er erlauben soll. Vorgeschriebene Zugriffskontrollen ergeben sich aus den Regeln der Aufgabe; optionale Komponenten brauchen Belege, dass sie ihre Kosten wert sind.
Den Entwurf in eine erste Implementierung überführen
Für den Support-Assistenten haben wir jetzt einen Ausgangsentwurf: einen Agent Loop mit Limits, um unterschiedliche Anfragen zu interpretieren, schmale Tools für Kontooperationen, Prüfungen in den Diensten, die Daten schreiben, und gespeicherte Aufzeichnungen offener Aktionen. Bisher verlangt nichts generierten Code oder Memory über Sessions hinweg.
Ich würde zuerst einen vollständigen Pfad bauen. Legen Sie ein kleines Testkonto und ein erwartetes Rückerstattungsergebnis an. Implementieren Sie die Abfrage- und Rückerstattungs-Tools samt ihren Ablehnungspfaden. Verbinden Sie das Model mit diesen Tools. Führen Sie dann die Fälle Ablehnung, fehlende Informationen und unterbrochener Schreibzugriff aus. Lücken in den Anforderungen findet man jetzt mit wenigen Aufgaben leichter als später mit vielen.
Ein Loop ohne Framework kann in dieser Phase genügen. Er stellt den Context zusammen, fragt das Model nach der nächsten Aktion, validiert und führt diese Aktion aus und gibt das Ergebnis an das Model zurück. Diesen Loop selbst zu schreiben bedeutet auch, Nachrichtenkonvertierung, Abbruch, State-Handling und Tracing zu schreiben. Ein Framework lohnt sich, wenn es diese Arbeit übernimmt und Ihnen trotzdem die Kontrolle über die Entscheidungen in diesem Artikel lässt.
Diese Serie nutzt create_agent von LangChain als Ausgangspunkt, weil es den Model-und-Tool-Loop plus Hooks bietet, um sein Verhalten zu ändern. Es läuft bereits auf LangGraph. Später zu einem expliziten LangGraph-Workflow zu wechseln heißt, mehr der Stufen um den Agent herum selbst zu schreiben, nicht, einen Graphen aus dem Nichts hinzuzufügen.
Bevor ich die Implementierung schreibe, würde ich die Entscheidungen auf einer Seite festhalten. Die erste Version braucht nicht jede oben besprochene Fähigkeit. Sie braucht nur die Teile, die die Aufgabe erledigen, plus Aufzeichnungen, die zeigen, wo ein Lauf fehlschlägt.
| Frage | Entscheidung, die Sie festhalten |
|---|---|
| Welche Aufgabe erledigen wir? | Der Anrufer, das erwartete Ergebnis, berechtigte Ablehnung oder Übergabe und verbotene Wirkungen |
| Wer wählt den nächsten Schritt? | Bekannte Stufen im Code; an das Model delegierte Entscheidungen; Grund für jede |
| Welche Prüfungen brauchen Interpretation? | Die Frage zur Bedeutung, der Context, den sie sieht, das Model, das antwortet, was bei Unsicherheit gilt |
| Was darf das Model anfordern? | Keine Tools, typisierte Operationen, generierter Code oder eine Kombination |
| Wer autorisiert und führt es aus? | Erlaubte Daten und Aktionen, der Dienst, der sie prüft, Freigaben, Sandbox-Limits |
| Was muss eine Unterbrechung überleben? | Gesprächs-State, Geschäftsdaten, offene Operationen und Wiederherstellungsverhalten |
| Welche Aktionen lassen sich gefahrlos wiederholen? | Lesezugriffe; Schreibzugriffe mit einer Operations-ID, die der Dienst dedupliziert; Schreibzugriffe, die zuerst geprüft werden müssen |
| Welche Limits gelten? | Einschränkungen von Model und Anbieter, Datenhandhabung, Aufrufe, Zeit, Kosten und Abbruch |
| Was belegt den Abschluss? | Prüfungen von Antwort, Aktionen und State; wem ihre Nachweise gehören |
| Was haben wir weggelassen? | Optionale Komponenten und der Fehler oder die neue Anforderung, die jede rechtfertigen würde |
Eine brauchbare Antwort ist konkret genug, um die Implementierung zu ändern. „Braucht Memory“ ist vage. „Muss eine freigegebene Rückerstattung nach einem Worker-Neustart fortsetzen, ohne eine zweite Rückerstattung anzulegen“ sagt uns, was zu persistieren ist und welchen Fehler wir testen müssen.
Teil 2 fragt, wann ein expliziter Workflow die Aufgabe gut genug erledigt, um seine zusätzlichen Stufen zu rechtfertigen. Er baut den kleinsten Workflow, den die Aufgaben brauchen, um den Agent herum und vergleicht ihn mit dem Loop. Spätere Teile halten den Evaluator außerhalb der Kontrolle des Agents und messen, wie die Ergebnisse über wiederholte Läufe schwanken.
Optional: die Implementierung und ihre Grenzen untersuchen
Die Begleit-Demo ist eine kleine, lauffähige Version des Support-Assistenten. Sie läuft in zwei Umgebungen:
- Eigene Support-Aufgaben: zwölf Aufgaben, jeweils gegen eine frische SQLite-Datenbank mit Kunden und Bestellungen.
- τ³-bench Retail: acht Aufgaben aus τ³-bench, einem öffentlichen Benchmark, in dem ein Model den Kunden spielt, mit dem Agent spricht und Datenbankprüfungen das Ergebnis bewerten.
Dieser Abschnitt beschreibt, was die Demo enthält, was sie absichtlich weglässt, was die Ergebnisse zeigen und wie man sie ausführt. Sie können ihn überspringen und den obigen Entwurfsprozess trotzdem nutzen.
Was die Demo enthält
Ein LangChain-Agent wählt die Aufrufe. Er hat fünf Konto-Tools (look_up_account, list_orders, issue_refund, update_address und set_preference) und einen MCP-Server für Richtlinien- und FAQ-Abfragen. Ein In-Memory-Checkpointer speichert den Lauf-State zwischen den Schritten. Es gibt keinen Code Runner und kein Memory über Sessions hinweg.
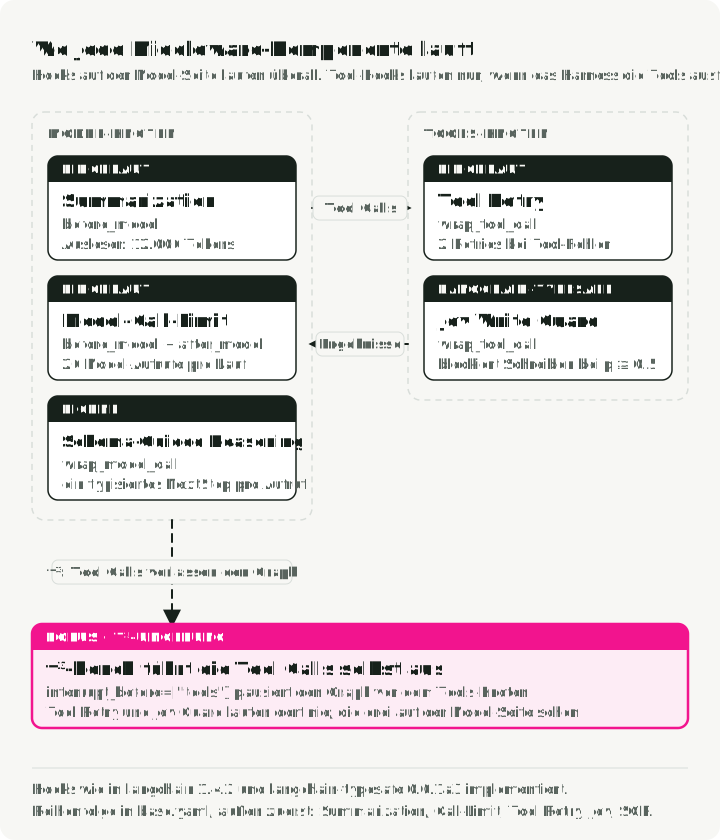
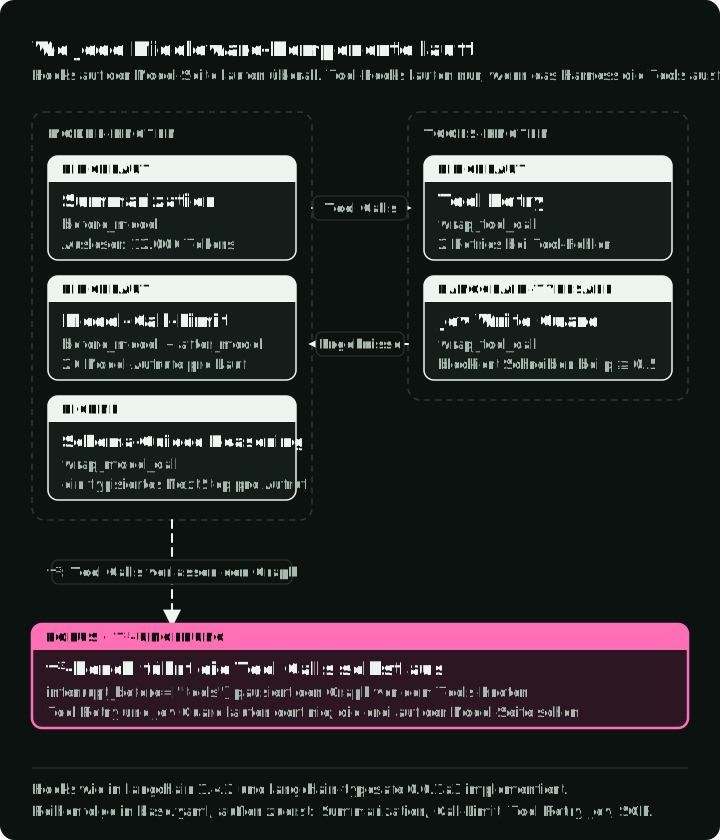
Jeder Lauf liest eine Spec, eine YAML-Datei, die das Model und die zu verwendenden Komponenten benennt. Die Demo enthält zwei Specs. In base lässt Schema-Guided Reasoning (SGR) das Model ein strukturiertes Objekt für den nächsten Schritt zurückgeben statt eines nativen Tool Calls. Der Jev-Write-Guard, die oben beschriebene Prüfung durch ein Decision Model, läuft vor jedem Schreibzugriff und stellt eine zusammengesetzte Frage: Würde dieser Aufruf gegen die Richtlinie verstoßen oder über das hinausgehen, was der Kunde verlangt hat?
| Spec | Komponenten |
|---|---|
plain | Summarization, ein Limit von 20 Model-Aufrufen pro Lauf und 2 Retries bei einem Tool-Fehler |
base | Alles aus plain, plus Schema-Guided Reasoning und ein Jev-Write-Guard |
Die zwei getrennten Fragen weiter oben in diesem Artikel, zur Anfrage und zu ihrem Widerruf, sind ein vorgeschlagener Umbau; die aufgezeichneten Läufe haben sie nicht verwendet. base ergänzt SGR und Jev in einem Schritt, daher können die Ergebnisse der eigenen Aufgaben nicht zeigen, ob SGR oder Jev einen Unterschied verursacht hat.
Was die Demo absichtlich weglässt
- Die Tools prüfen die Datenintegrität, überlassen die Geschäftsrichtlinie aber dem Agent, sodass ein Experiment einen Schreibzugriff offenlegen kann, den die Richtlinie verbietet. Ein echter Dienst würde die Richtlinie beim Schreiben durchsetzen.
- Es gibt kein aufgabenweites Limit für Zeit oder Kosten.
- Der Tool-Retry gilt für jedes Tool, auch für die drei Schreib-Tools, und wiederholte Schreibzugriffe haben keinen Idempotency Key. Der Retry umschließt den Jev-Guard, daher wird jeder wiederholte Schreibzugriff erneut geprüft. Die
ToolRetryMiddlewarevon LangChain akzeptiert eine Liste von Tool-Namen; ein echter Dienst würde Retries auf Lesezugriffe beschränken. - Der Evaluator läuft im selben Prozess wie der Agent.
Diese Ergebnisse testen daher nicht die Durchsetzung in der Produktion, die Sicherheit von Retries oder den Schutz der Nachweise vor Manipulation.
Ergebnisse bei den eigenen Aufgaben
Jede Zeile ist ein Lauf jeder Aufgabe. Die Preise sind die zusammen mit den Ergebnissen aufgezeichneten Endpoint-Preise. Zum Bestehen müssen die finale Datenbank der erwarteten entsprechen und der Lauf ohne Fehler enden. Diese Prüfungen verifizieren weder die Antwort noch alle Zwischenaktionen. Kosten und Latency sind Mittelwerte pro Aufgabe; die Kosten enthalten Jev, wo es läuft.
| Spec | Model | Bestanden | Kosten | Latency |
|---|---|---|---|---|
base | openai/gpt-6-luna | 12/12 | $0.00073 | 11.9 s |
plain | openai/gpt-6-luna | 12/12 | $0.00033 | 5.8 s |
base | z-ai/glm-5.3-flash | 12/12 | $0.00101 | 9.7 s |
base | xiaomi/mimo-v2.6-flash | 7/12 | $0.00087 | 18.6 s |
- Mit
gpt-6-lunabestanden beide Specs alle zwölf Aufgaben.basekostete etwa das 2,2-Fache und dauerte etwa doppelt so lang. - Jev erlaubte jeden Schreibzugriff, den es prüfte: sechs in jedem der Läufe mit
gpt-6-lunaund GLM und vier im MiMo-Lauf. Es blockierte nie einen Schreibzugriff, diese Läufe testen also nicht, ob es einen schlechten stoppt. - MiMos fünf Fehlschläge waren SGR-Ausgabeformatfehler. Drei ließen die Datenbank wie gefordert unverändert, aber die Lauf-Fehler machten sie trotzdem zu Fehlschlägen. Es gibt keinen MiMo-Lauf mit
plain, wir können also nicht sagen, ob natives Tool Calling besser abschneiden würde. - Summarization lief nie. Die größte Anfrage in den sechs aufgezeichneten Läufen (diese vier und die zwei τ³-bench-Läufe unten) hatte 8.351 Input Tokens, unter dem Auslöser von 12.000 Tokens. Diese Ergebnisse können nicht zeigen, ob Summarization hilft. Wenn sie läuft, ersetzt die Summarization-Middleware von LangChain die älteren Nachrichten im State des Agents durch eine einzelne Zusammenfassung, sodass das vollständige Transkript aus dem Trace stammen muss.
Ergebnisse bei τ³-bench
τ³-bench bewertet einen Lauf, indem es die Tool Calls des Agents in einer frischen Umgebung wiedergibt, daher muss der Benchmark die Tools selbst ausführen. Der Adapter der Demo, der Code, der den Agent mit τ³-bench verbindet, hält den Graphen vor seinem Tools-Knoten an, gibt die Tool Calls zurück und schreibt die Ergebnisse des Benchmarks zurück, bevor er fortsetzt.
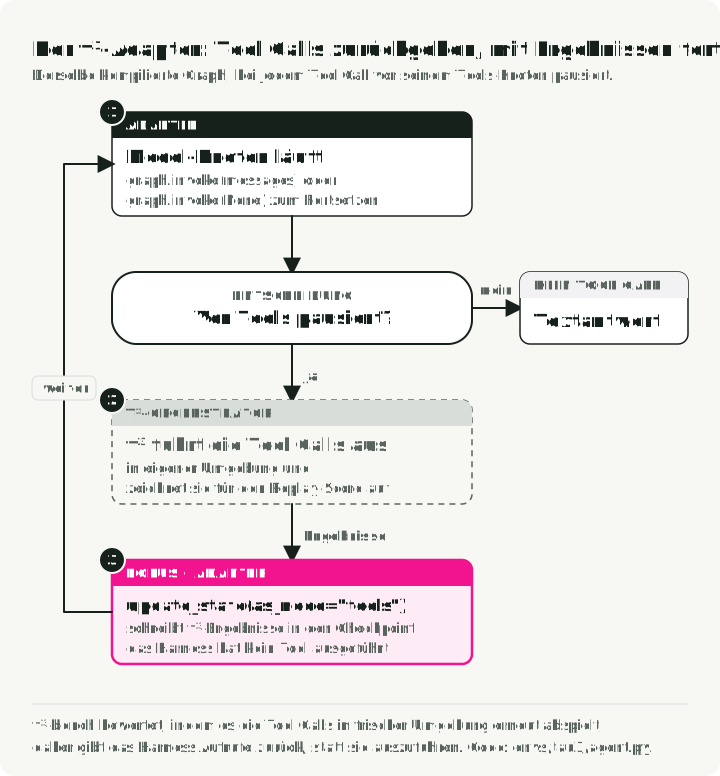
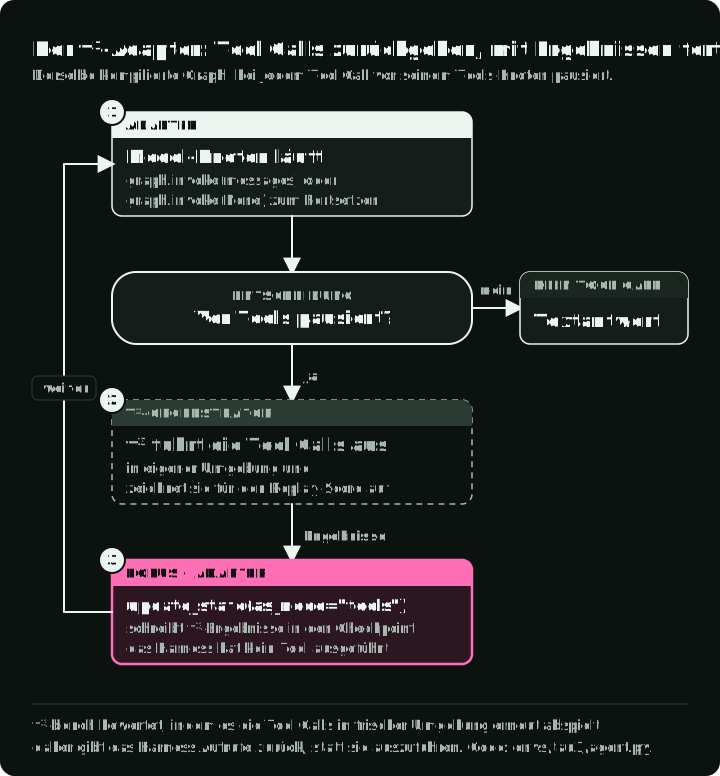
Das hat zwei Folgen. Erstens kommen Prompt, Tools und Richtlinie von τ³-bench, daher sind diese Ergebnisse mit den eigenen nicht vergleichbar, auch nicht bei derselben Spec-Datei. Zweitens laufen Tool-Retry und Jev hier nie: Der einzige Unterschied zwischen base und plain ist SGR.
Beide Läufe verwenden openai/gpt-6-luna für den Agent und für den simulierten Kunden. Die Simulationslatenz enthält die Arbeit des Simulators. Agent-Kosten und Simulationslatenz sind Mittelwerte pro Aufgabe; die Simulator-Kosten sind die Summe für alle acht Aufgaben.
| Spec | Bestanden | Agent-Kosten | Simulationslatenz | Simulator-Kosten, gesamt |
|---|---|---|---|---|
base | 6/8 | $0.00238 | 59.0 s | $0.00453 |
plain | 7/8 | $0.00136 | 38.9 s | $0.00471 |
- Die acht Aufgaben stammen aus dem Retail-Test-Split und haben keine Assertions in natürlicher Sprache, daher entscheiden allein Datenbankprüfungen über die Bewertung.
- Beide Specs beendeten alle acht Aufgaben ohne Adapter-Fehler. Jeder Fehlschlag war ein fehlender Schreibzugriff.
basescheiterte an den Aufgaben 9 und 26.plainübergab Aufgabe 27 an einen Menschen, statt den Umtausch abzuschließen. - Ein wiederholter
base-Lauf, der nicht zu den sechs zählt, bestand ebenfalls 6/8, scheiterte aber an den Aufgaben 9 und 17. Die scheiternden Aufgaben wechseln zwischen den Läufen, ein Unterschied von einer Aufgabe ist also kein Grund,plainzu bevorzugen. Diese Läufe messen diese Schwankung nicht.
Die aufgezeichneten Zahlen prüfen
Die gespeicherten Berichte und Traces enthalten die Ergebnisse pro Aufgabe, Token-Zahlen, Konfigurationen, Paketversionen und aufgezeichnete Preise. Bei den 393 Agent-Chat-Aufrufen in den sechs aufgezeichneten Läufen stimmten die aus den Tokens berechneten Kosten in jeder Antwort mit dem abgerechneten Betrag überein. Diese Prüfung schließt Jev- und Kundensimulator-Aufrufe aus. Die Preise sind historisch und kein Angebot für Ihren Lauf.
Selbst ausführen
Installieren Sie uv und verwenden Sie die unten genannte getaggte Version. Die Tests laufen offline, sobald die Abhängigkeiten installiert sind. Die beiden Umgebungsläufe machen kostenpflichtige Model-Aufrufe über OpenRouter und brauchen einen API-Key.
git clone https://github.com/slavadubrov/agent-harness-lab-public
cd agent-harness-lab-public
git checkout v0.1.2-a1
cp .env.example .env # set OPENROUTER_API_KEY
make test
make a1-custom SPEC=harness/spec/plain.yaml
make a1-tau3 SPEC=harness/spec/plain.yaml
Jeder Lauf ersetzt die Ergebnisse unter reports/article-a1/. Vergleichen Sie sie mit git diff mit der committeten Baseline. Das Makefile installiert aus der eingefrorenen uv.lock.
Um ein anderes Model oder Tool-Set auszuprobieren, kopieren Sie eine Spec unter harness/spec/, ändern Sie diese Felder und übergeben Sie ihren Pfad über SPEC. Einstellungen für Anbieter und eigene Komponenten akzeptieren frei wählbare Schlüssel, daher kann die Validierung nicht jeden verschachtelten Tippfehler abfangen.