Diseñar un harness de agente: de la tarea a la arquitectura

Traducción automática
Este artículo se tradujo automáticamente a partir de la versión original en inglés.
Un harness de agente es el código que rodea a un modelo de lenguaje y le permite completar una tarea. Da al modelo instrucciones y datos, ejecuta las acciones que el modelo pide, sigue el progreso y decide cuándo ha terminado la tarea. Este artículo es para ingenieros que añaden un agente a su propia aplicación. Muestra cómo diseñar ese código a partir de la tarea: qué pasos elige el modelo, qué pasos fija tu código de antemano y qué reglas aplica tu código diga lo que diga el modelo.
Toma estas decisiones antes de elegir un framework de agentes, porque las respuestas cambian de una tarea a otra. Un asistente de soporte modifica cuentas de clientes, así que necesita comprobaciones de permisos y una forma segura de reintentar un pago. Un coding agent edita archivos y ejecuta tests, así que necesita un lugar donde su código se ejecute sin dañar nada más. Un clasificador de documentos solo devuelve una etiqueta, así que quizá no necesite ninguna herramienta. Si los tres parten del mismo bucle, el mismo almacén de memoria y el mismo conjunto de herramientas, nadie se pregunta qué necesita cada tarea.
Seguiremos estas decisiones con un ejemplo, un asistente de soporte que emite reembolsos, desde la descripción de la tarea hasta una primera implementación. El artículo amplía Harness Engineering for AI Agents, que describe de qué es responsable un harness. Aquí elegimos esas responsabilidades para un proyecto concreto.
Por qué el modelo necesita un harness
En nuestro asistente de soporte, el modelo puede proponer un reembolso, pero no puede completarlo por sí solo. El código debe encontrar la cuenta del cliente, cargar el pedido, comprobar que el reembolso está permitido, llamar al servicio de pagos y registrar el resultado. Si el servicio de pagos agota el tiempo de espera, el código también debe decidir si un segundo intento es seguro. Estas tareas siguen ahí aunque el modelo sea muy bueno eligiendo el siguiente paso.
Parte de este código puede existir ya en tu aplicación. LangChain, el framework de agentes que esta serie usa más adelante, define el harness en sentido amplio: todo el código, la configuración y la lógica de ejecución que rodean al modelo. El inicio de sesión, el acceso a la base de datos, una cola de trabajos y un paso de aprobación caben en esa definición. Diseñar un harness incluye decidir cómo los usa el agente. No hace falta reconstruirlos dentro de un framework de agentes.
Un harness puede ser pequeño o grande. El más pequeño hace una llamada al modelo, valida la salida y devuelve un resultado. Uno mayor deja que el modelo lea archivos, ejecute programas y revise su trabajo a lo largo de muchos turnos. Ambos deben responder a dos preguntas: ¿qué partes de la tarea resuelve el modelo y cómo comprobamos que se hicieron bien?
Describe el resultado antes que el agente
«Gestionar solicitudes de reembolso» todavía no dice qué debe hacer el asistente. Supongamos que un cliente pide el reembolso de un pedido entregado. La ejecución tiene éxito si reembolsa el pedido y el importe correctos, explica el resultado al cliente y no cambia nada más en la cuenta. Si la solicitud incumple la política de reembolsos, un rechazo claro es el resultado correcto. Si el asistente no sabe a qué pedido se refiere el cliente, debe preguntar.
Un reembolso, un rechazo y una pregunta son tres resultados correctos distintos. Si contamos como éxito toda conversación que termina sin error, no podemos distinguirlos entre sí, ni de una respuesta equivocada que terminó con cortesía.
Que el reembolso sea correcto también depende de quién lo pide. Un cliente puede escribir cualquier número de pedido, así que un número de pedido en un mensaje no demuestra que el pedido sea suyo. La aplicación debe aportar la cuenta con sesión iniciada, y el servicio de reembolsos debe comprobar que el pedido pertenece a esa cuenta. El modelo puede leer la solicitud; no puede demostrar quién llama.
Ya tenemos el comienzo de un contrato de la tarea: los cambios que cuentan como éxito, los cambios prohibidos y las situaciones en las que el asistente debe hacer una pregunta o pasar el caso a una persona. Algunos de estos requisitos no se cumplen solo con el prompt. El importe máximo de un reembolso debe comprobarlo el servicio que lo emite. Un objetivo de tiempo de respuesta necesita un timeout en el código. Retomar un caso mañana necesita estado guardado.
Con la tarea descrita, podemos decidir cuánto de ella debe controlar el modelo.
¿Cuánto del procedimiento conocemos ya?
Si todas las solicitudes siguen los mismos pasos (extraer un número de pedido, obtener el pedido, comprobar la elegibilidad, emitir un reembolso permitido y explicar el resultado), podemos escribir esos pasos en código como un pipeline fijo. Si una comprobación falla, se omite el reembolso. El modelo se ocupa del lenguaje al principio y al final. No necesita una llamada extra al modelo para decidir si obtiene un pedido que toda solicitud necesita.
Un workflow explícito añade ramas y estados de espera que controla el código. Un reembolso por encima de un límite podría esperar aprobación. Un cambio de dirección podría permitirse solo antes de que se envíe el pedido. Podemos dibujar estas etapas como un grafo de pasos, y el código decide cuál es el siguiente.
Un agent loop deja que el modelo elija cada paso. El modelo escoge una acción, lee el resultado y vuelve a escoger hasta que decide responder. Esto ayuda en una conversación mixta: un cliente empieza con una queja de entrega, luego dice que llegó el artículo equivocado y después pide un cambio. La siguiente consulta útil depende de lo que el asistente haya encontrado hasta ese momento. El coste es que el bucle puede seguir más caminos, y cada uno necesita pruebas: el modelo puede hacer llamadas innecesarias, repetir una consulta o detenerse antes de terminar la tarea.
La guía de workflows y agentes de LangGraph describe la misma división: los workflows siguen caminos fijados de antemano y los agentes eligen sus pasos mientras se ejecutan. LangGraph, la biblioteca de grafos sobre la que se apoya LangChain, puede construir ambos, así que un sistema construido como grafo puede contener un agente.
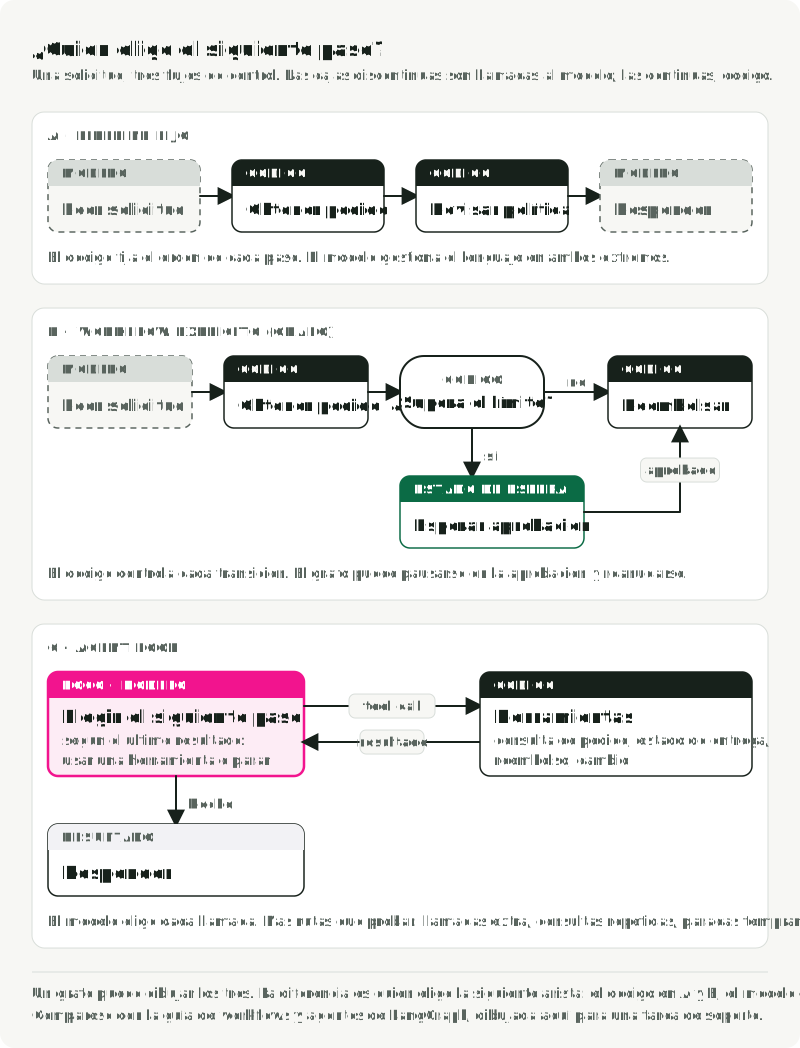
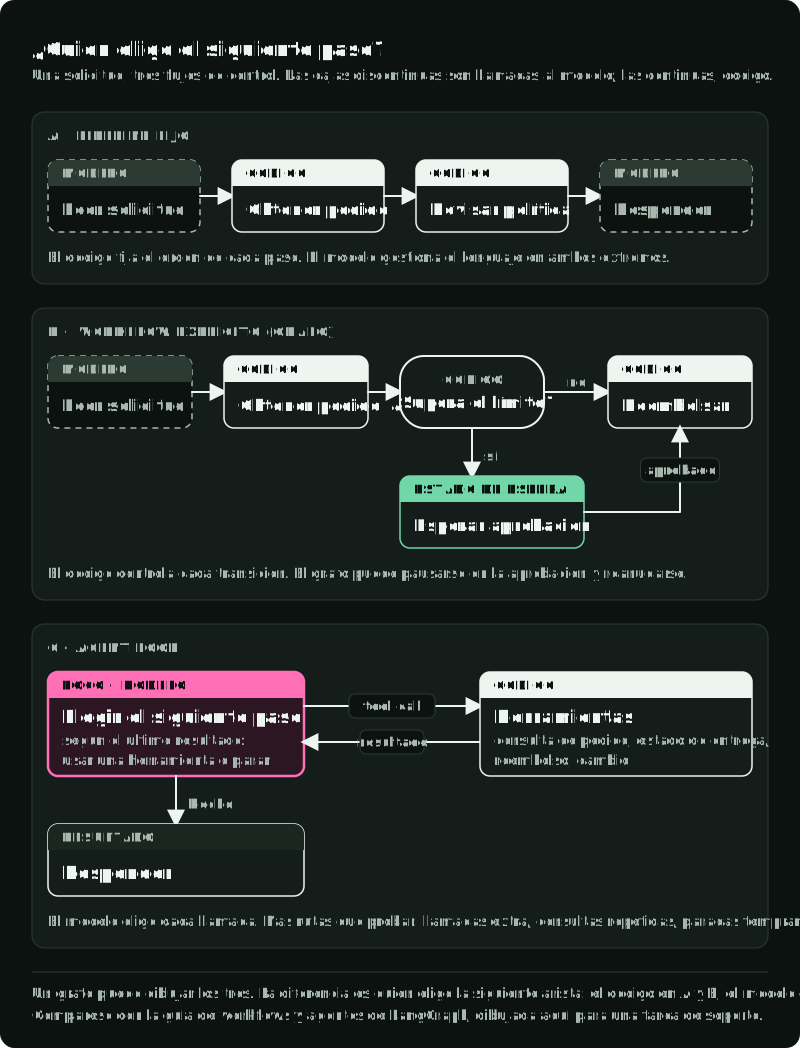
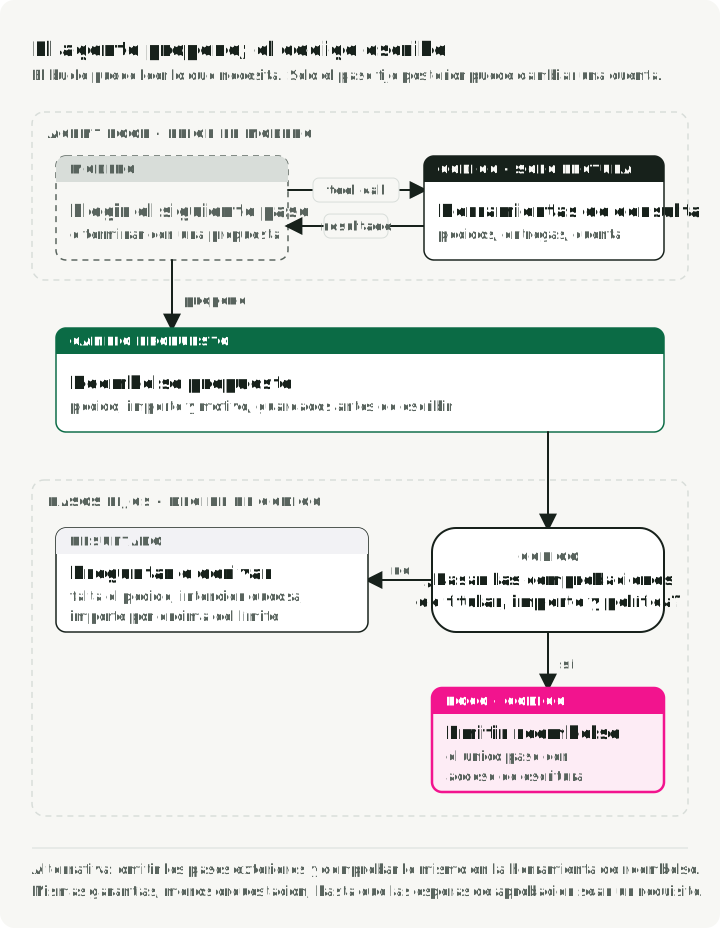
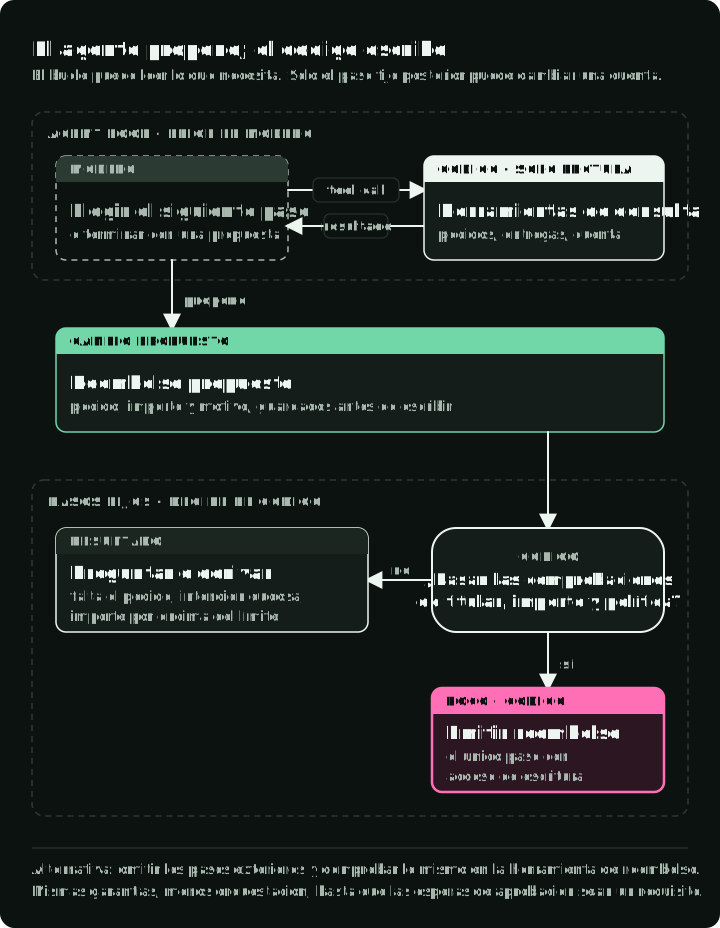
Para nuestro asistente de soporte, un diseño combina ambos. Un agent loop reúne información y prepara una propuesta de reembolso. Después, un paso fijo de código comprueba la propuesta y realiza la escritura. El modelo puede explorar la conversación, pero solo el código decide si se produce una escritura. Si ya sabemos que necesitamos esta división, podemos construir primero el workflow alrededor del agente.
La otra opción es empezar con un único agent loop con un límite de pasos y poner las comprobaciones dentro de las propias herramientas. Así la primera versión se mantiene pequeña mientras averiguamos qué caminos necesita la tarea. Elige primero el workflow si las esperas de aprobación, las etapas fijas o las reglas de recuperación ya son requisitos.
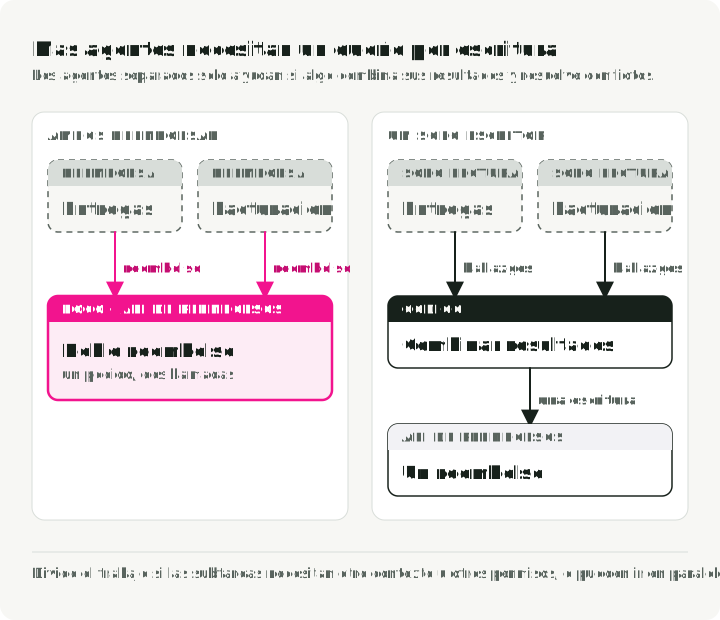
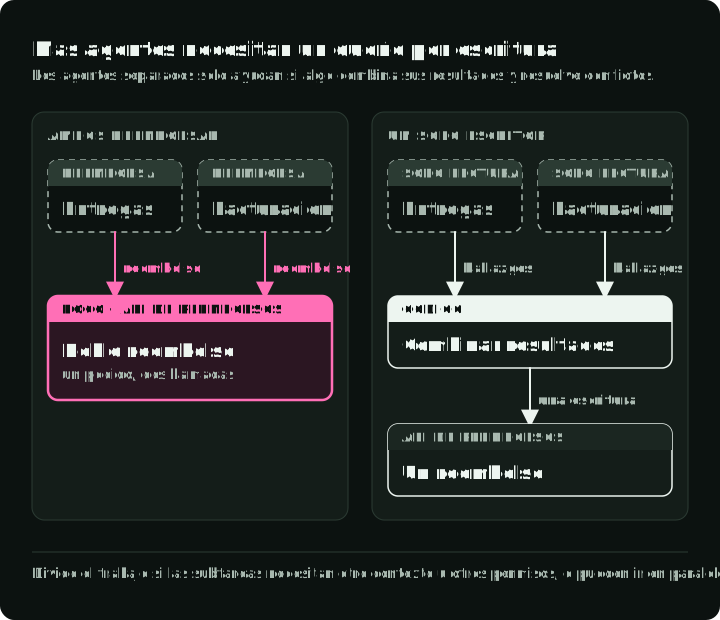
Repartir el trabajo entre varios agentes es una decisión aparte, y a menudo basta con un agente. Un segundo agente ayuda cuando una subtarea necesita otro contexto u otros permisos, o puede ejecutarse a la vez que la primera. Entonces algo debe combinar sus resultados y resolver los conflictos entre sus acciones. Si un agente de entregas y un agente de facturación pueden emitir reembolsos, un mismo pedido puede reembolsarse dos veces.
¿Tool calls o código generado?
Tras decidir quién elige el siguiente paso, decidimos cómo pide el modelo una acción. Puede llamar a una herramienta: una función con nombre que tu código ofrece y ejecuta en nombre del modelo. O puede escribir un programa corto que tu código ejecuta. Quién elige el siguiente paso y cómo pide el modelo una acción son decisiones separadas. Un workflow fijo puede contener un paso en el que el modelo escribe código, y un agent loop abierto puede usar solo unas pocas herramientas con funciones concretas.
Para el asistente de soporte, una herramienta como issue_refund(order_id, amount_cents) encaja bien. Su esquema nombra la acción y sus argumentos, así que la petición es explícita. La herramienta devuelve un ID de reembolso si tiene éxito o un motivo estructurado si se rechaza. Podemos probar esta herramienta por separado, porque el modelo nunca escribe la lógica del reembolso.
No toda tarea necesita herramientas. Un clasificador que recibe toda su entrada en el prompt puede devolver una etiqueta validada. Añade una herramienta de consulta cuando la tarea necesite datos que no están en el prompt. Añade una herramienta que modifique datos solo cuando la tarea deba cambiar algo.
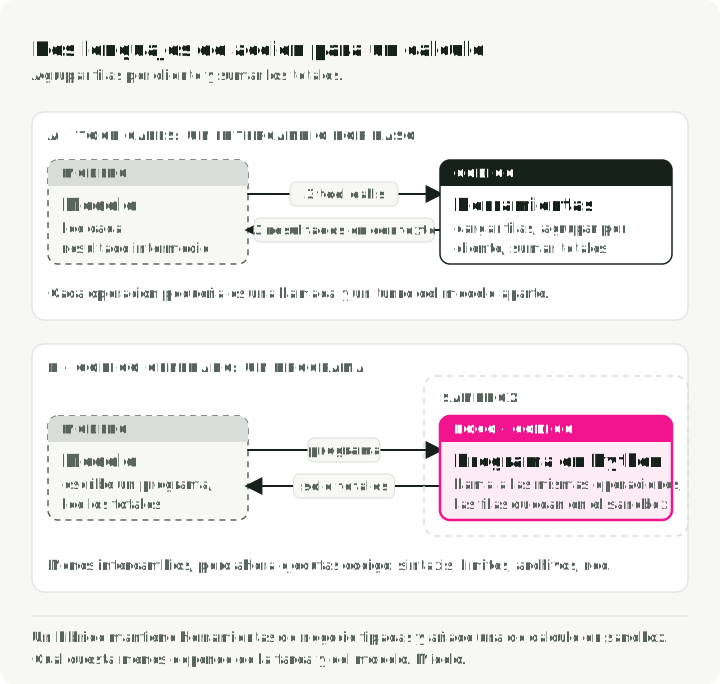
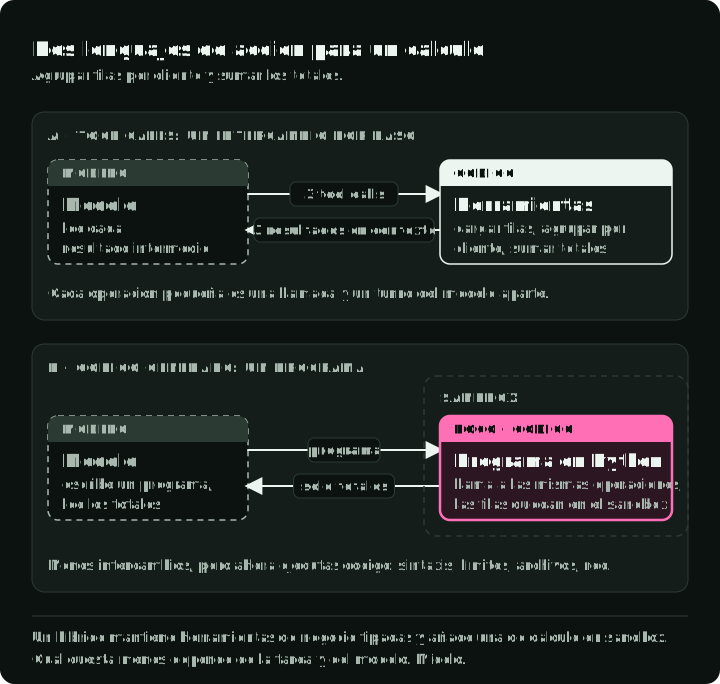
El código generado sirve para otro tipo de trabajo. Supongamos que el asistente debe leer una tabla de pedidos, agrupar las filas por cliente y calcular varios totales. Con herramientas, cada paso es una llamada separada, y cada resultado intermedio vuelve al modelo. Con código, el modelo escribe un único programa en Python que guarda los valores intermedios en sus propias variables, y solo vuelven los totales.
La biblioteca smolagents de Hugging Face ofrece los dos estilos. ToolCallingAgent devuelve tool calls estructuradas. CodeAgent escribe Python que llama a las mismas herramientas, guarda valores en variables y combina los resultados. Un agente de código sigue usando herramientas; las llama desde un programa.
El código generado también nos da más trabajo. Debemos gestionar errores de sintaxis, limitar el tiempo de ejecución, administrar dependencias y decidir a qué archivos y direcciones de red puede acceder el código. Si tener menos llamadas al modelo compensa ese trabajo depende de la tarea y del modelo. Mídelo en tu tarea; el código no es mejor por defecto.
Varias API alojadas combinan ambos estilos: tus propias herramientas de negocio más una herramienta integrada de ejecución de código que corre en un sandbox, un entorno separado con acceso restringido. Lo ofrecen la Responses API de OpenAI, la Claude API, la Gemini API y AWS Bedrock AgentCore.
El programmatic tool calling de Anthropic va un paso más allá: el código del sandbox puede llamar a las herramientas que permites, y al modelo solo vuelven los resultados que seleccionas. Anthropic sigue recomendando las tool calls directas por defecto, y el camino del código para resultados grandes y para cadenas de llamadas que dependen unas de otras. Algunos diseños usan solo código, como el CodeAgent de smolagents y el Code Mode de Cloudflare.
Para nuestro asistente de reembolsos, yo empezaría con herramientas de negocio tipadas. Si una tarea posterior necesita cálculos pesados, podemos añadir un ejecutor de código sin acceso a las cuentas de clientes.
Una tercera pregunta es cómo se conecta la aplicación con sus herramientas. Una función local basta cuando una sola aplicación es dueña del código. El Model Context Protocol (MCP) es una forma estándar de ofrecer herramientas desde un servidor aparte, de modo que varias aplicaciones puedan compartirlas. MCP define cómo intercambian tool calls la aplicación y el servidor. No valida los argumentos ni decide quién puede llamar a una herramienta: la especificación de herramientas de MCP deja esas comprobaciones a la aplicación y al servidor.
Pon las restricciones donde ocurren las acciones
La descripción de una herramienta le dice al modelo cuándo es útil. No decide si una llamada concreta puede ejecutarse. Eso debe decidirlo el código que realiza la escritura. En un reembolso, ese código comprueba la cuenta con sesión iniciada, el pedido, el importe, la política de reembolsos y cualquier aprobación necesaria.
Algunas comprobaciones necesitan interpretación
Algunas comprobaciones no se pueden escribir como código ordinario. Supongamos que el cliente pregunta: «¿Puedo devolver este pedido?» y el agente propone un reembolso. El pedido pertenece al cliente, el importe es válido y el plazo de devolución está abierto. Todas las comprobaciones de código se superan, pero puede que el cliente solo esté preguntando si la devolución es posible, no pidiendo un reembolso ahora. Alguien tiene que leer el mensaje para decidirlo.
El código ordinario sigue comprobando la titularidad, los importes y las fechas. El modelo principal puede preguntar al cliente cuando su intención no está clara, o la aplicación puede exigir una confirmación explícita antes de un reembolso. Un modelo de decisión aparte es otro diseño que evaluar: responde a una pregunta concreta sobre el significado, como «¿Pidió el cliente este reembolso?». Podemos probar esa pregunta por separado, sin ejecutar toda la conversación. Compara este diseño con pedir una aclaración o una confirmación antes de añadir otro modelo.
Jev, un modelo de decisión de TypeSafe, es una opción para ese papel. Recibe el estado que le damos y preguntas tipadas, y devuelve respuestas estructuradas. Ante una pregunta de sí o no, devuelve la probabilidad de que la respuesta sea sí.
Yo haría dos preguntas separadas: si el cliente pidió explícitamente el reembolso y si un mensaje posterior retiró esa petición. TypeSafe recomienda preguntas específicas cuyas respuestas se combinan en código, y varias preguntas pueden compartir una llamada a la API. Con dos preguntas, una respuesta errónea muestra cuál de los dos juicios falló.
Después el código combina esas respuestas con las comprobaciones obligatorias. Si las respuestas no son claras o se contradicen, el asistente pregunta al cliente o envía el caso a una persona. Si la llamada a Jev agota el tiempo de espera, ese error también necesita su propio camino. Un «sí» de Jev nunca anula una comprobación de titularidad fallida ni sustituye una confirmación obligatoria. Su probabilidad es una salida de un modelo. No autoriza el reembolso y no demuestra que la decisión sea correcta.
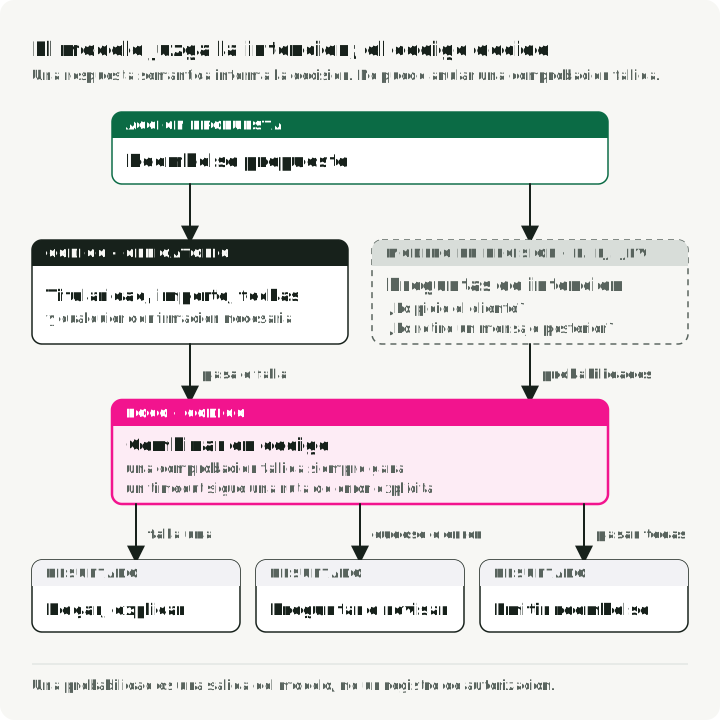
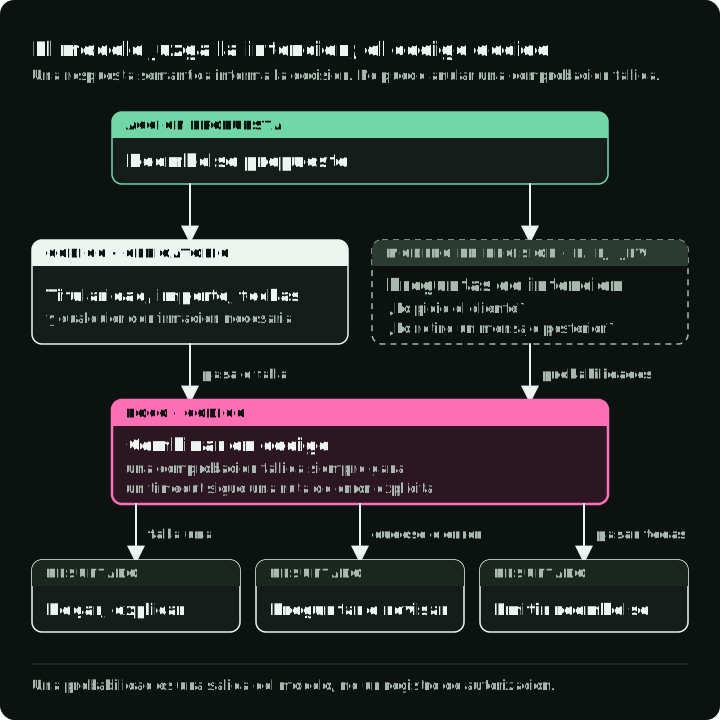
El contexto que damos a la comprobación decide lo que puede ver. Yo aportaría la acción propuesta, los mensajes del cliente en orden y los tool results que la decisión necesita, cada uno etiquetado con su origen. El último mensaje por sí solo podría pasar por alto una cancelación. El historial completo de la cuenta podría esconder la petición entre mensajes no relacionados. Un modelo pequeño de propósito general con structured output también podría responder a estas preguntas. Compáralo con Jev sobre los mismos ejemplos, en precisión y coste.
Restringe el acceso con independencia de los juicios del modelo
El texto de un cliente o de un documento recuperado puede contener instrucciones dirigidas al agente. Ese texto no debe poder conceder permisos ni sustituir la política de la aplicación. Si un documento le dice al agente que exporte todos los registros de clientes, el sistema debe carecer del permiso para hacerlo, por convincente que sea la redacción.
El código generado necesita sus propios límites de acceso. Si el modelo solo puede llamar a funciones revisadas con permisos estrechos, un sandbox de código de propósito general puede aportar poco. Esas funciones siguen necesitando autorización, validación de entradas, timeouts y consultas seguras a la base de datos.
Antes de permitir Python generado, comandos de shell o ediciones de archivos ejecutables, debemos decidir a qué puede acceder ese código. ¿En qué directorios puede escribir? ¿Necesita acceso a la red? ¿Qué credenciales puede ver? ¿Cuánto tiempo de CPU, memoria y salida puede usar una ejecución? Ejecutar el código en un proceso aparte no responde a estas preguntas por sí solo.
La guía de ejecución segura de Hugging Face compara un intérprete local restringido con opciones más aisladas como los contenedores. Cada opción bloquea cosas distintas. Un contenedor con acceso amplio a los archivos del host y con credenciales potentes puede seguir exponiendo los recursos que queríamos proteger. Comprueba que una lectura prohibida, una escritura prohibida y una petición de red prohibida fallan, además de que un programa normal funciona.
Podemos prescindir del ejecutor de código hasta que la tarea lo necesite, pero su aislamiento debe estar listo el día en que lo activemos. Además, el aislamiento no puede impedir el mal uso de una API que damos al código a propósito, así que el servicio de reembolsos debe seguir aplicando sus propias reglas.
¿Qué sobrevive cuando una ejecución se detiene a medias?
Supongamos ahora que el asistente envía una solicitud de reembolso, el servicio crea el reembolso y la respuesta se pierde en el camino de vuelta. El modelo ve un timeout. Si vuelve a llamar, el cliente puede recibir un segundo reembolso. Si informa de un fallo, le dice al cliente algo que ya no es verdad.
La solución es hacer el reembolso idempotente: enviar la misma solicitud dos veces tiene el mismo efecto que enviarla una. Antes de enviar el reembolso, la aplicación crea un ID de operación y lo guarda. En un reintento envía el mismo ID, y el servicio devuelve el reembolso que ya hizo en lugar de hacer otro. La guía de AWS sobre API idempotentes explica este patrón. Si el servicio no lo admite, la recuperación debe comprobar primero qué ocurrió, o preguntar a una persona, antes de cualquier segundo intento.
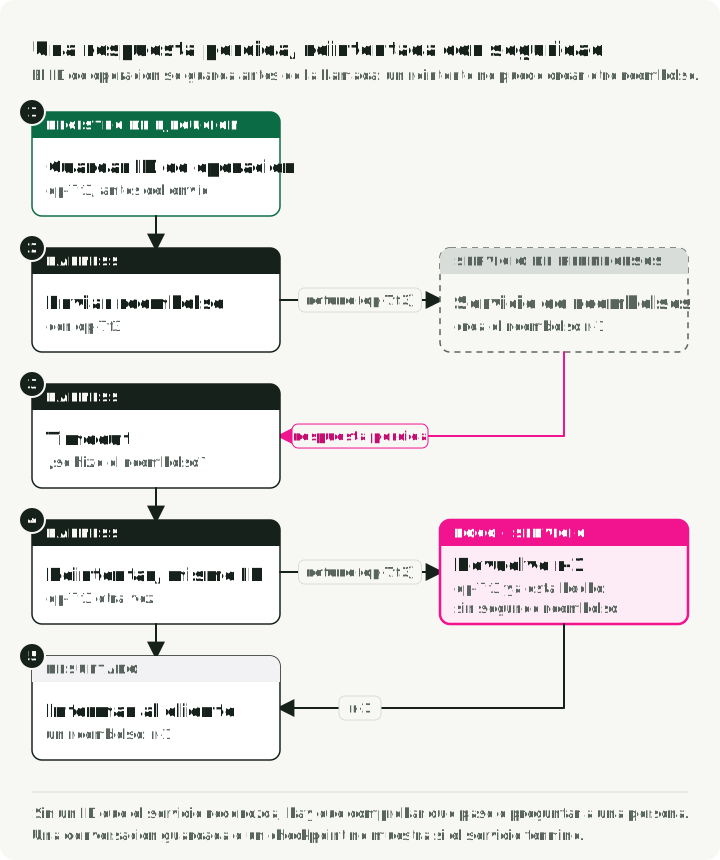
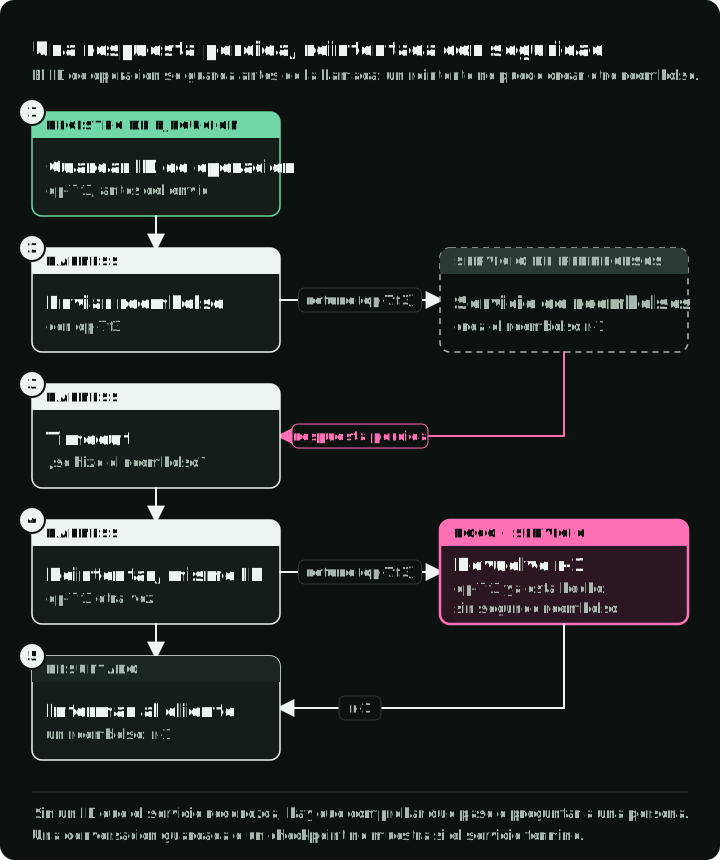
Guardar la conversación no resuelve esto. La conversación puede registrar que el modelo pidió un reembolso, pero no si el servicio lo completó. Un checkpoint, una copia guardada del estado del agente, permite continuar una ejecución detenida. No puede deshacer un reembolso que el servicio ya hizo, y no hace seguro repetirlo.
Para este asistente, tres tipos de estado tienen funciones distintas. La conversación contiene la solicitud del cliente y los hechos reunidos hasta ahora. Los registros de pedidos y reembolsos contienen el estado del negocio. Un registro de ejecución enumera las operaciones pendientes y las aprobaciones, para que un worker reiniciado pueda continuar con seguridad. Pueden vivir en la misma base de datos, pero uno no puede sustituir a otro.
La memoria entre sesiones es una decisión aparte. Si el asistente debe recordar la preferencia de un cliente la semana próxima, necesitamos reglas sobre de quién es esa preferencia, quién puede cambiarla y cómo se borra. Si cada tarea es independiente, quizá no necesitemos ningún servicio de memoria. Además, cada fragmento de texto guardado es una oportunidad de reutilizar más tarde algo obsoleto o irrelevante.
Las conversaciones largas plantean un problema parecido dentro de una misma sesión. Cuando una conversación crece demasiado para que el modelo la aproveche bien, podemos recuperar partes de ella o sustituir los turnos antiguos por un resumen. Un resumen que omita un ID de pedido, una condición de aprobación o una operación pendiente puede romper el procedimiento. Mantén ese estado operativo en campos explícitos y prueba qué sobrevive a un resumen antes de confiar en él.
Dale al bucle una forma de detenerse
Un agent loop siempre puede encontrar algo más que comprobar, así que necesita una regla de parada que cubra el éxito, la información que falta, los límites agotados y el fallo. Cuando una ejecución alcanza un límite, debe informar del estado real: el reembolso está hecho, nunca se intentó o sigue siendo incierto. «El agente se detuvo» no dice al cliente ni al siguiente worker qué ocurrió.
Conviene nombrar las formas en que puede terminar una ejecución antes de escribir el bucle. Para el asistente de soporte usaría ocho: completada y verificada, rechazada, información faltante solicitada, derivada a una persona, bloqueada por una comprobación de política, detenida por un límite, terminada por un error de infraestructura y resultado de la escritura desconocido.
Registra ese estado por separado de si la ejecución cumplió el contrato de la tarea. «Completada y verificada» confirma la escritura solicitada. Un rechazo, una pregunta o una derivación pueden ser correctos cuando la tarea los requiere. La respuesta, las acciones y el estado final deben respaldar esa valoración; detenerse no basta.
Un límite de llamadas al modelo cubre solo una parte de la ejecución. Una herramienta puede quedarse colgada. Un reintento puede repetir trabajo. Un resumidor o un modelo de decisión como Jev hace sus propias llamadas a modelos. Fija límites de tiempo transcurrido, intentos, tamaño de salida y gasto, y cuenta todos los componentes que se ejecutan. Cancelar una ejecución también debe tener en cuenta las peticiones ya enviadas a un servicio externo.
El propio modelo añade límites. Comprueba que produce el formato de acción requerido en tareas realistas. Compara el tamaño de contexto utilizable, la latencia, el coste y adónde pueden enviarse los datos de la tarea. Un modelo que sirves tú mismo y una API alojada pueden compartir una interfaz pero diferir en capacidad y en cómo tratan los datos.
Elige un modelo y un endpoint iniciales, registra su configuración y mantenlos fijos mientras evalúas un cambio del harness. Si no, una ejecución más rápida puede deberse a otro proveedor u otro modelo, no al cambio que querías probar.
Evalúa la finalización, incluidos los casos que no deben hacer nada
Cuando el asistente ya puede completar una solicitud, hay que comprobar si hizo lo correcto. En el ejemplo de los reembolsos podemos observar tres cosas: lo que dijo el asistente, qué acciones intentó y qué cambió en el servicio. Cada una detecta fallos que las otras pasan por alto.
Una respuesta puede decir «He reembolsado tu pedido» mientras la base de datos no ha cambiado. Un reembolso correcto puede ir acompañado de un cambio de dirección no relacionado que solo muestra el registro de acciones. Y una base de datos sin cambios puede significar cuatro cosas distintas: un rechazo correcto, una pregunta útil, un fallo o un asistente que no hizo nada. El estado final por sí solo no distingue estos cuatro casos.
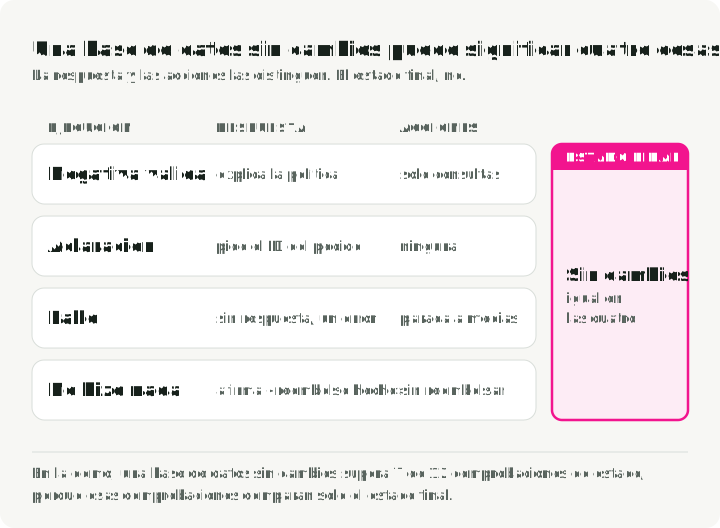
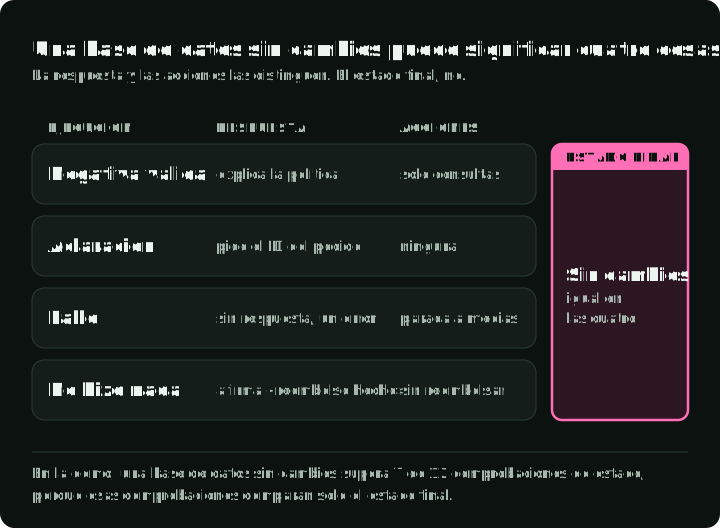
La demo complementaria, descrita al final de este artículo, muestra este límite con números reales. Tiene doce tareas de soporte, y siete de ellas esperan que la base de datos no cambie. Un agente que no cambia nada pasa, por tanto, 7 de 12 comprobaciones de estado. Ese número describe las comprobaciones; no es una tasa de éxito medida. Las definiciones de las tareas comparan solo la base de datos final, no la respuesta ni las acciones intermedias. Una escritura que se hace y luego se revierte tampoco deja rastro en esa comparación.
Para tu primer conjunto de evaluación, incluye una acción correcta, un rechazo válido, una solicitud con información que falta y un fallo durante la ejecución. En cada caso, define la respuesta esperada y las acciones permitidas además del estado final. Un caso de aclaración debe exigir la pregunta correcta. Un caso de rechazo debe exigir una explicación útil. Estos casos muestran si el agente entiende la tarea y si la aplicación la hace cumplir.
Si añadimos la comprobación con Jev, necesita sus propios casos de prueba. Dale acciones propuestas cuyas decisiones correctas fijó una persona de antemano: una petición explícita de reembolso, una pregunta sobre elegibilidad, una petición retirada y una instrucción oculta en un tool result. El último caso también prueba si el contexto que montamos mantiene separados los mensajes del cliente y la salida de las herramientas.
Cuenta las acciones malas que Jev permite y las acciones válidas que bloquea. Después de cada bloqueo, sigue el resto de la conversación. Bloquear una escritura ayuda solo si el asistente luego hace una pregunta al cliente en lugar de entrar en un bucle o detenerse. Jev devuelve una probabilidad, así que la aplicación necesita un umbral que la convierta en permitir o bloquear. Elige el umbral con ejemplos de desarrollo y fíjalo antes de la comparación final con ejemplos con los que no lo ajustaste. Registra la versión de la pregunta, el contexto aportado, las probabilidades devueltas, la regla aplicada, los errores y el coste. En la demo grabada, Jev nunca rechazó una escritura, así que no demuestra que Jev ayude.
Registra lo suficiente para diagnosticar un fallo: la tarea, las versiones del modelo y del harness, las acciones propuestas, los resultados de la ejecución, el estado final, los errores, la latencia y el coste. Mantén los secretos y los datos personales innecesarios fuera de ese registro.
El agente que se prueba no debe poder cambiar cómo se le puntúa. Dale la entrada de la tarea y las reglas que necesita, pero no las respuestas de referencia ni los casos de prueba reservados. Mantén el evaluador (el código que puntúa las ejecuciones) y sus registros fuera del control del agente. Esto se vuelve más estricto si un programa edita después el harness automáticamente para subir su puntuación: ese programa no debe poder editar las comprobaciones que lo puntúan.
Estos registros también nos dicen cuándo añadir un componente opcional. Añade un router, un primer paso que envía cada solicitud al gestor adecuado, cuando las ejecuciones registradas muestren que elegir el tipo de solicitud necesita su propia etapa. Añade resúmenes cuando los historiales largos causen un fallo concreto. Prueba una protección contra acciones prohibidas, incluidas las acciones que debería permitir. Los controles de acceso obligatorios proceden de las reglas de la tarea; los componentes opcionales necesitan evidencia de que compensan su coste.
Convierte el diseño en una primera implementación
Para el asistente de soporte, ya tenemos un diseño de partida: un agent loop con límites para interpretar solicitudes variadas, herramientas con funciones concretas para las operaciones de cuenta, comprobaciones dentro de los servicios que escriben datos y registros guardados de las acciones pendientes. Hasta ahora nada requiere código generado ni memoria entre sesiones.
Yo construiría primero un camino completo. Crea una cuenta de prueba pequeña y un resultado de reembolso esperado. Implementa las herramientas de consulta y de reembolso, incluidos sus caminos de rechazo. Conecta el modelo a esas herramientas. Después ejecuta los casos de rechazo, de información que falta y de escritura interrumpida. Los huecos en los requisitos son más fáciles de encontrar ahora, con pocas tareas, que más tarde con muchas.
En esta etapa puede bastar un bucle sin framework. Monta el contexto, pide al modelo la siguiente acción, valida y ejecuta esa acción, y devuelve el resultado al modelo. Escribir ese bucle tú mismo también significa escribir la conversión de mensajes, la cancelación, la gestión del estado y el tracing. Merece la pena usar un framework cuando hace ese trabajo y aun así te deja controlar las decisiones de este artículo.
Esta serie usa create_agent de LangChain como punto de partida, porque ofrece el bucle de modelo y herramientas junto con hooks para cambiar su comportamiento. Ya se ejecuta sobre LangGraph. Pasar más tarde a un workflow explícito de LangGraph significa escribir nosotros más etapas alrededor del agente, no añadir un grafo desde cero.
Antes de escribir la implementación, yo pondría las decisiones en una sola página. La primera versión no necesita todas las capacidades comentadas arriba. Solo necesita las partes que completan la tarea, más registros que muestren dónde falla una ejecución.
| Pregunta | Decisión que hay que anotar |
|---|---|
| ¿Qué tarea estamos completando? | Quién llama, el resultado esperado, el rechazo o la derivación válidos y los efectos prohibidos |
| ¿Quién elige el siguiente paso? | Etapas conocidas en código; decisiones delegadas al modelo; motivo de cada una |
| ¿Qué comprobaciones requieren interpretación? | La pregunta sobre el significado, el contexto que ve, el modelo que responde, qué hacer si hay duda |
| ¿Qué puede pedir hacer el modelo? | Ninguna herramienta, operaciones tipadas, código generado o una combinación |
| ¿Quién lo autoriza y lo ejecuta? | Datos y acciones permitidos, el servicio que los comprueba, aprobaciones, límites del sandbox |
| ¿Qué debe sobrevivir a una interrupción? | Estado de la conversación, registros de negocio, operaciones pendientes y comportamiento de recuperación |
| ¿Qué acciones se pueden reintentar sin riesgo? | Lecturas; escrituras con un ID de operación que el servicio deduplica; escrituras que hay que comprobar antes |
| ¿Qué límites se aplican? | Restricciones de modelo y proveedor, tratamiento de datos, llamadas, tiempo, gasto y cancelación |
| ¿Qué demuestra que se completó? | Comprobaciones de respuesta, acciones y estado; quién es responsable de su evidencia |
| ¿Qué hemos dejado fuera? | Componentes opcionales y el fallo o el nuevo requisito que justificaría cada uno |
Una respuesta útil es lo bastante específica como para cambiar la implementación. «Necesita memoria» es vago. «Debe reanudar un reembolso aprobado tras reiniciar un worker sin crear un segundo reembolso» nos dice qué persistir y qué fallo probar.
La parte 2 pregunta cuándo un workflow explícito resuelve la tarea lo bastante bien como para justificar sus etapas adicionales. Construimos el workflow más pequeño que las tareas necesitan alrededor del agente y lo comparamos con el bucle. Las partes siguientes mantienen el evaluador fuera del control del agente y miden cómo varían los resultados entre ejecuciones repetidas.
Opcional: inspecciona la implementación y sus límites
La demo complementaria es una versión pequeña y ejecutable del asistente de soporte. Se ejecuta en dos entornos:
- Tareas de soporte personalizadas: doce tareas, cada una contra una base de datos SQLite nueva de clientes y pedidos.
- τ³-bench retail: ocho tareas de τ³-bench, un benchmark público en el que un modelo hace de cliente, habla con el agente y unas comprobaciones de base de datos puntúan el resultado.
Esta sección describe qué contiene la demo, qué deja fuera a propósito, qué muestran los resultados y cómo ejecutarla. Puedes saltártela y aun así usar el proceso de diseño anterior.
Qué contiene la demo
Un agente de LangChain elige las llamadas. Tiene cinco herramientas de cuenta (look_up_account, list_orders, issue_refund, update_address y set_preference) y un servidor MCP para consultas de política y de preguntas frecuentes. Un checkpointer en memoria guarda el estado de la ejecución entre pasos. No hay ejecutor de código ni memoria entre sesiones.
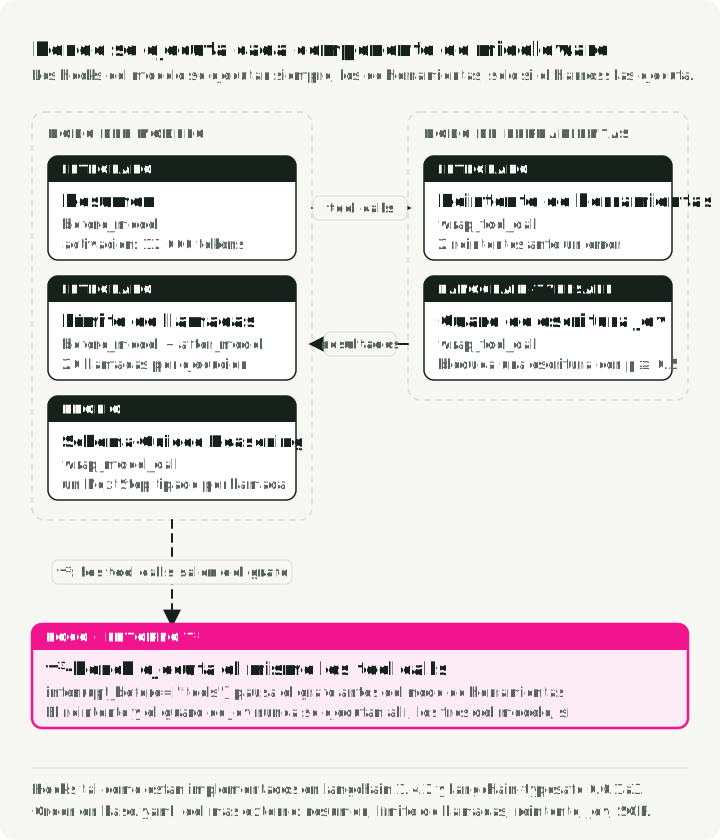
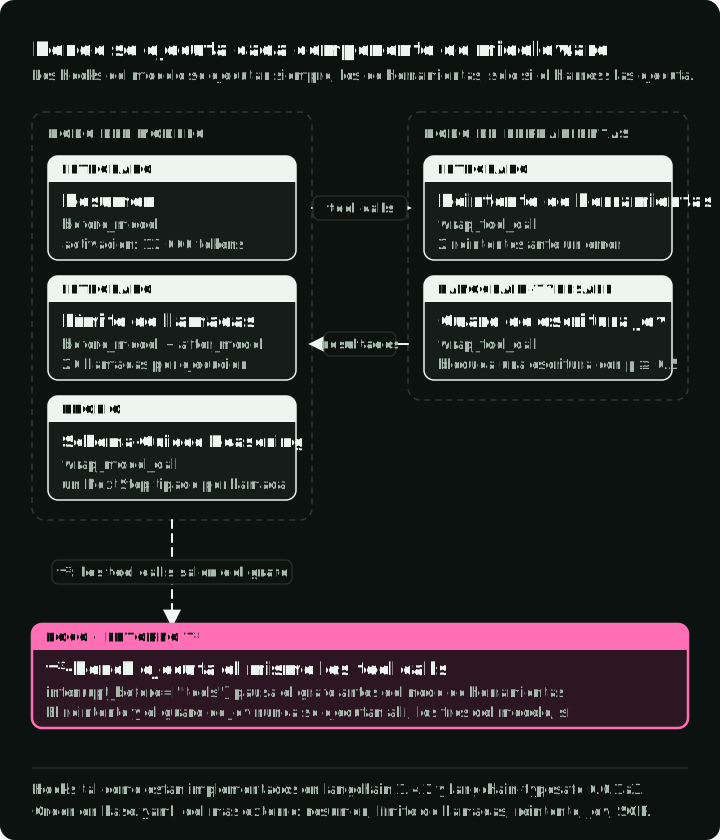
Cada ejecución lee una spec, un archivo YAML que nombra el modelo y los componentes que se usarán. La demo registra dos specs. En base, Schema-Guided Reasoning (SGR) hace que el modelo devuelva un objeto estructurado con el siguiente paso en lugar de una tool call nativa. La protección de escritura con Jev, la comprobación con el modelo de decisión descrita antes, se ejecuta antes de cada escritura y hace una pregunta compuesta: ¿esta llamada incumpliría la política o iría más allá de lo que pidió el cliente?
| Spec | Componentes |
|---|---|
plain | Resumen, un límite de 20 llamadas al modelo por ejecución y 2 reintentos ante un error de herramienta |
base | Todo lo de plain, más Schema-Guided Reasoning y una protección de escritura con Jev |
Las dos preguntas separadas de antes en este artículo, sobre la petición y su retirada, son un rediseño propuesto; las ejecuciones registradas no las usaron. base añade SGR y Jev en un solo paso, así que los resultados personalizados no pueden mostrar si la diferencia la causó SGR o Jev.
Qué deja fuera la demo a propósito
- Las herramientas comprueban la integridad de los datos pero dejan la política de negocio al agente, así que un experimento puede dejar al descubierto una escritura que la política prohíbe. Un servicio real aplicaría la política en la escritura.
- No hay un límite global de tiempo ni de gasto.
- El reintento de herramientas se aplica a todas las herramientas, incluidas las tres de escritura, y las escrituras reintentadas no tienen clave de idempotencia. El reintento envuelve la protección de Jev, así que cada escritura reintentada también se vuelve a comprobar.
ToolRetryMiddlewarede LangChain acepta una lista de nombres de herramientas; un servicio real limitaría los reintentos a las lecturas. - El evaluador se ejecuta en el mismo proceso que el agente.
Por tanto, estos resultados no prueban la aplicación de reglas en producción, la seguridad de los reintentos ni la protección de la evidencia frente a manipulaciones.
Resultados en las tareas personalizadas
Cada fila es una ejecución de cada tarea. Los precios son los precios del endpoint registrados con los resultados. Para superar la tarea se exige la base de datos final esperada y una ejecución sin errores. Estas comprobaciones no verifican la respuesta ni todas las acciones intermedias. El coste y la latencia son medias por tarea; el coste incluye Jev donde se ejecuta.
| Spec | Modelo | Superadas | Coste | Latencia |
|---|---|---|---|---|
base | openai/gpt-6-luna | 12/12 | $0.00073 | 11.9 s |
plain | openai/gpt-6-luna | 12/12 | $0.00033 | 5.8 s |
base | z-ai/glm-5.3-flash | 12/12 | $0.00101 | 9.7 s |
base | xiaomi/mimo-v2.6-flash | 7/12 | $0.00087 | 18.6 s |
- Con
gpt-6-luna, ambas specs pasaron las doce tareas.basecostó unas 2,2 veces más y tardó aproximadamente el doble. - Jev permitió todas las escrituras que comprobó: seis en cada una de las ejecuciones de
gpt-6-lunay de GLM, y cuatro en la de MiMo. Nunca bloqueó una escritura, así que estas ejecuciones no prueban si detiene una mala. - Los cinco fallos de MiMo fueron errores de formato de salida de SGR. Tres dejaron la base de datos sin cambios, tal como se exigía, pero los errores de ejecución hicieron que se consideraran fallos igualmente. No hay ejecución
plaincon MiMo, así que no podemos saber si las tool calls nativas lo harían mejor. - El resumen nunca se ejecutó. La mayor petición de las seis ejecuciones registradas (estas cuatro y las dos de τ³-bench de abajo) tuvo 8351 tokens de entrada, por debajo del umbral de 12 000 tokens. Estos resultados no pueden mostrar si el resumen ayuda. Cuando se ejecuta, el middleware de resumen de LangChain sustituye los mensajes más antiguos del estado del agente por un único mensaje de resumen, así que la transcripción completa tiene que salir de la traza.
Resultados en τ³-bench
τ³-bench puntúa una ejecución reproduciendo las tool calls del agente en un entorno nuevo, así que el benchmark debe ejecutar las herramientas él mismo. El adaptador de la demo, el código que conecta el agente con τ³-bench, pausa el grafo antes de su nodo de herramientas, devuelve las tool calls y escribe de vuelta los resultados del benchmark antes de reanudar.
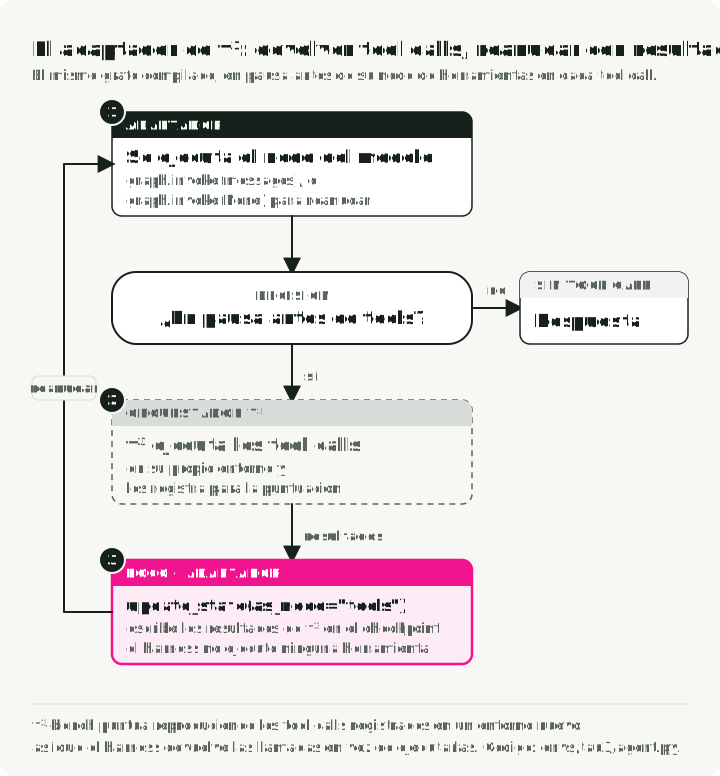
Esto tiene dos consecuencias. Primero, el prompt, las herramientas y la política vienen de τ³-bench, así que estos resultados no son comparables con los personalizados, ni siquiera con el mismo archivo de spec. Segundo, el reintento de herramientas y Jev nunca se ejecutan aquí: la única diferencia entre base y plain es SGR.
Ambas ejecuciones usan openai/gpt-6-luna para el agente y para el cliente simulado. La latencia de simulación incluye el trabajo del simulador. El coste del agente y la latencia de simulación son medias por tarea; el coste del simulador es el total de las ocho tareas.
| Spec | Superadas | Coste del agente | Latencia de simulación | Coste del simulador, total |
|---|---|---|---|---|
base | 6/8 | $0.00238 | 59.0 s | $0.00453 |
plain | 7/8 | $0.00136 | 38.9 s | $0.00471 |
- Las ocho tareas proceden de la partición de test de retail y no tienen aserciones en lenguaje natural, así que deciden la recompensa solo las comprobaciones de la base de datos.
- Ambas specs terminaron las ocho tareas sin errores del adaptador. Todos los fallos fueron una escritura ausente.
basefalló las tareas 9 y 26.plainpasó la tarea 27 a una persona en lugar de completar el cambio. - Una repetición de
base, no contada entre las seis, también superó 6/8 pero falló las tareas 9 y 17. Las tareas que fallan cambian entre ejecuciones, así que una diferencia de una tarea no es motivo para preferirplain. Estas ejecuciones no miden esa variación.
Comprueba los números registrados
Los informes y trazas guardados conservan los resultados por tarea, los recuentos de tokens, las configuraciones, las versiones de los paquetes y los precios registrados. En las 393 llamadas de chat del agente de las seis ejecuciones registradas, el coste calculado a partir de los tokens coincidió con el importe facturado en cada respuesta. Esta comprobación excluye las llamadas de Jev y del cliente simulado. Los precios son históricos, no una cotización para tu ejecución.
Ejecútalo tú mismo
Instala uv y usa la versión etiquetada de abajo. Los tests se ejecutan sin conexión una vez instaladas las dependencias. Las dos ejecuciones de entorno hacen llamadas de pago a modelos a través de OpenRouter y necesitan una clave de API.
git clone https://github.com/slavadubrov/agent-harness-lab-public
cd agent-harness-lab-public
git checkout v0.1.2-a1
cp .env.example .env # set OPENROUTER_API_KEY
make test
make a1-custom SPEC=harness/spec/plain.yaml
make a1-tau3 SPEC=harness/spec/plain.yaml
Cada ejecución reemplaza los resultados de reports/article-a1/. Usa git diff para compararlos con la línea base confirmada. El Makefile instala desde el uv.lock congelado.
Para probar otro modelo o conjunto de herramientas, copia una spec de harness/spec/, cambia esos campos y pasa su ruta mediante SPEC. Los ajustes del proveedor y de los componentes personalizados aceptan claves libres, así que la validación no puede detectar todos los errores tipográficos anidados.