Een agent harness ontwerpen: van taak naar architectuur

Automatische vertaling
Dit artikel is automatisch vertaald vanuit de oorspronkelijke Engelse versie.
Een agent harness is de code rond een taalmodel waarmee het een taak kan uitvoeren. De harness geeft het model instructies en data, voert de acties uit waar het model om vraagt, houdt de voortgang bij en bepaalt wanneer de taak klaar is. Dit artikel is bedoeld voor engineers die een agent aan hun eigen applicatie toevoegen. Het laat zien hoe je die code vanuit de taak ontwerpt: welke stappen het model kiest, welke stappen je code van tevoren vastlegt en welke regels je code afdwingt, wat het model ook zegt.
Neem deze beslissingen voordat je een agent-framework kiest, want de antwoorden verschillen per taak. Een supportassistent wijzigt klantaccounts, dus die heeft permissiecontroles nodig en een veilige manier om een betaling opnieuw te proberen. Een coding agent bewerkt bestanden en draait tests, dus die heeft een plek nodig waar zijn code kan draaien zonder iets anders te beschadigen. Een documentclassifier geeft alleen een label terug en heeft misschien helemaal geen tools nodig. Als alle drie beginnen met dezelfde loop, dezelfde memory store en dezelfde set tools, vraagt niemand wat elke taak nodig heeft.
We volgen deze beslissingen aan de hand van één voorbeeld, een supportassistent die terugbetalingen uitvoert, van taakbeschrijving tot eerste implementatie. Het artikel bouwt voort op Harness Engineering for AI Agents, dat beschrijft waar een harness verantwoordelijk voor is. Hier kiezen we die verantwoordelijkheden voor één project.
Waarom het model een harness nodig heeft
In onze supportassistent kan het model een terugbetaling voorstellen, maar het kan er niet in zijn eentje een afronden. Code moet het account van de klant vinden, de bestelling laden, controleren of de terugbetaling is toegestaan, de betaalservice aanroepen en het resultaat vastleggen. Als de betaalservice een timeout geeft, moet code ook beslissen of een tweede poging veilig is. Dit werk blijft bestaan, ook als het model heel goed is in het kiezen van de volgende stap.
Een deel van deze code bestaat misschien al in je applicatie. LangChain, het agent-framework dat deze serie later gebruikt, definieert een harness breed: alle code, configuratie en run-logica rond het model. Login, databasetoegang, een job queue en een goedkeuringsstap kunnen allemaal onder die definitie vallen. Een harness ontwerpen omvat ook beslissen hoe de agent ze gebruikt. Je hoeft ze niet opnieuw te bouwen binnen een agent-framework.
Een harness kan klein of groot zijn. De kleinste doet één modelaanroep, valideert de output en geeft een resultaat terug. Een grotere laat het model bestanden lezen, programma’s draaien en zijn werk over veel beurten bijstellen. Beide moeten twee vragen beantwoorden: welke delen van de taak handelt het model af, en hoe controleren we dat ze correct zijn uitgevoerd?
Beschrijf het resultaat vóór de agent
“Terugbetalingsverzoeken afhandelen” zegt nog niet wat de assistent moet doen. Stel dat een klant om een terugbetaling vraagt voor een bezorgde bestelling. De run slaagt als de juiste bestelling en het juiste bedrag worden terugbetaald, het resultaat aan de klant wordt uitgelegd en er verder niets aan het account verandert. Als het verzoek het terugbetalingsbeleid schendt, is een duidelijke weigering het juiste resultaat. Als de assistent niet kan achterhalen welke bestelling de klant bedoelt, moet hij het vragen.
Een terugbetaling, een weigering en een vraag zijn drie verschillende correcte resultaten. Als we elk gesprek dat zonder fout eindigt als geslaagd tellen, kunnen we ze niet uit elkaar houden, en ook niet van een fout antwoord dat beleefd eindigde.
Een correcte terugbetaling hangt ook af van wie er vraagt. Een klant kan elk bestelnummer intypen, dus een bestelnummer in een bericht bewijst niet dat de bestelling van hem is. De applicatie moet het ingelogde account aanleveren en de terugbetalingsservice moet controleren dat de bestelling erbij hoort. Het model kan het verzoek lezen; het kan niet bewijzen wie de aanvrager is.
Zo hebben we het begin van een taakcontract: de wijzigingen die als succes gelden, de wijzigingen die verboden zijn en de situaties waarin de assistent een vraag moet stellen of de zaak aan een mens moet overdragen. Aan sommige eisen kan de prompt alleen niet voldoen. Een maximaal terugbetalingsbedrag moet worden gecontroleerd door de service die terugbetalingen uitvoert. Een doel voor de responstijd vraagt om een timeout in code. Een zaak morgen hervatten vraagt om opgeslagen state.
Nu de taak beschreven is, kunnen we beslissen hoeveel ervan het model mag sturen.
Hoeveel van de procedure kennen we al?
Als elk verzoek dezelfde stappen volgt (een bestelnummer eruit halen, de bestelling ophalen, de geschiktheid controleren, een toegestane terugbetaling uitvoeren en het resultaat uitleggen), kunnen we die stappen in code schrijven als een vaste pipeline. Als een controle mislukt, wordt de terugbetaling overgeslagen. Het model verwerkt de taal aan het begin en aan het einde. Het hoeft geen extra modelaanroep te doen om te beslissen of het een bestelling moet ophalen die elk verzoek nodig heeft.
Een expliciete workflow voegt vertakkingen en wachttoestanden toe die code beheert. Een terugbetaling boven een limiet kan op goedkeuring wachten. Een adreswijziging mag misschien alleen vóór verzending van de bestelling. We kunnen deze fasen tekenen als een graaf van stappen, waarbij code bepaalt welke stap volgt.
Een agent loop laat het model elke stap kiezen. Het model kiest een actie, leest het resultaat en kiest opnieuw, tot het besluit te antwoorden. Dat helpt in een gemengd gesprek: een klant begint met een klacht over de bezorging, zegt dan dat het verkeerde artikel is aangekomen en vraagt vervolgens om een ruil. Welke zoekopdracht daarna nuttig is, hangt af van wat de assistent tot nu toe heeft gevonden. De prijs is dat de loop meer paden kan nemen en elk pad getest moet worden: het model kan onnodige aanroepen doen, een zoekopdracht herhalen of stoppen voordat de taak af is.
De workflow- en agentgids van LangGraph beschrijft dezelfde tweedeling: workflows volgen vooraf vastgelegde paden en agents kiezen hun stappen tijdens het draaien. LangGraph, de graafbibliotheek onder LangChain, kan beide bouwen, dus een systeem dat als graaf is gebouwd kan nog steeds een agent bevatten.
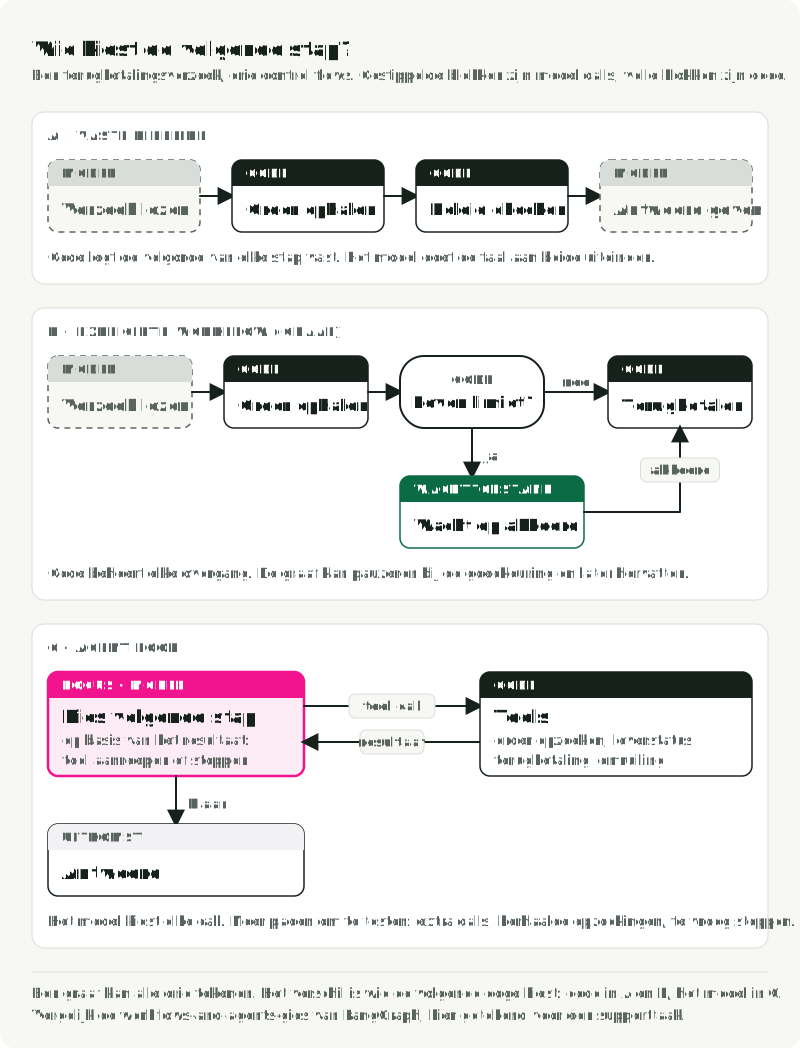
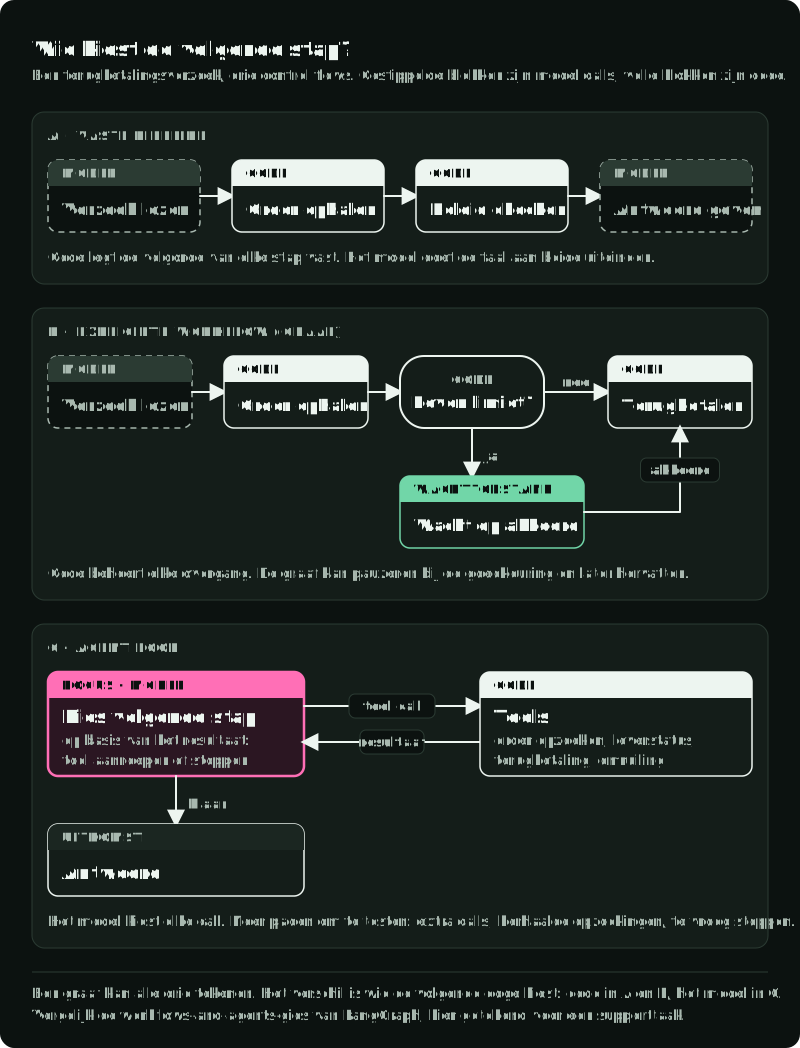
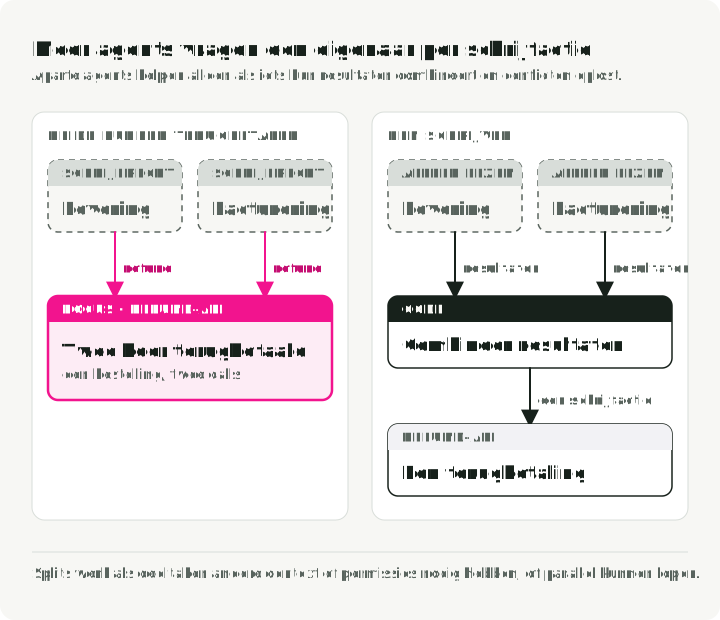
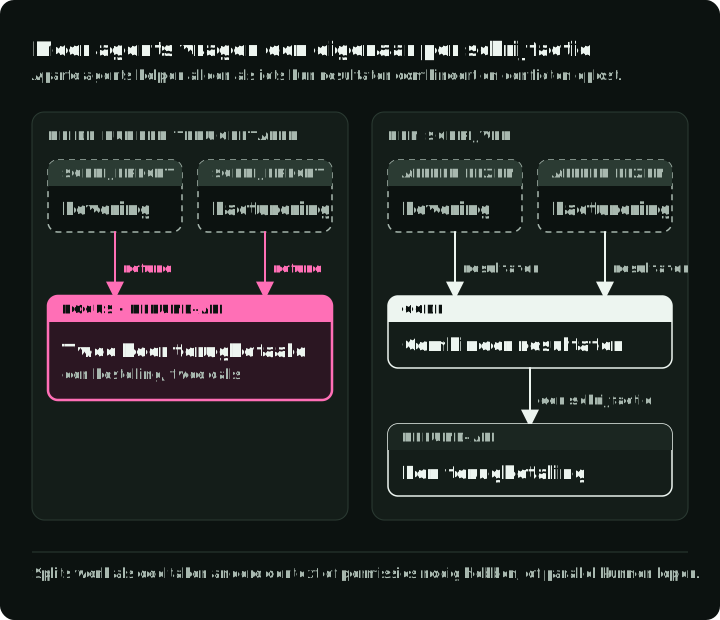
Voor onze supportassistent combineert één ontwerp de twee. Een agent loop verzamelt informatie en bereidt een voorgestelde terugbetaling voor. Een vaste codestap controleert daarna het voorstel en voert de schrijfactie uit. Het model mag het gesprek verkennen, maar alleen code bepaalt of er geschreven wordt. Als we al weten dat we deze splitsing nodig hebben, kunnen we eerst de workflow rond de agent bouwen.
De andere optie is te beginnen met één agent loop met een stappenlimiet en de controles in de tools zelf te leggen. Zo blijft de eerste versie klein terwijl we leren welke paden de taak nodig heeft. Kies eerst de workflow als wachten op goedkeuring, vaste fasen of herstelregels al eisen zijn.
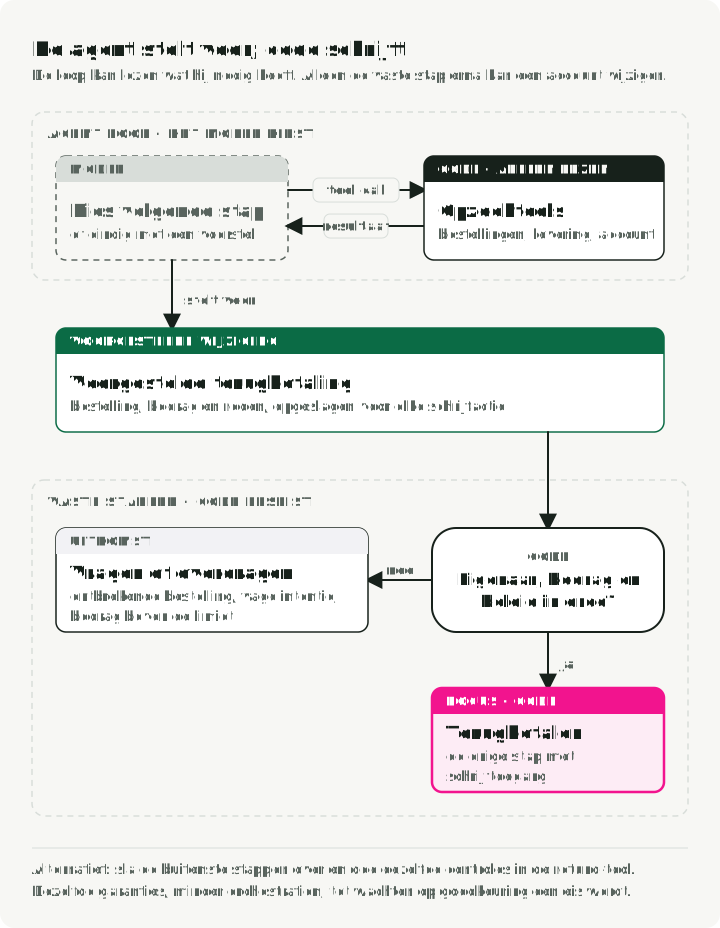
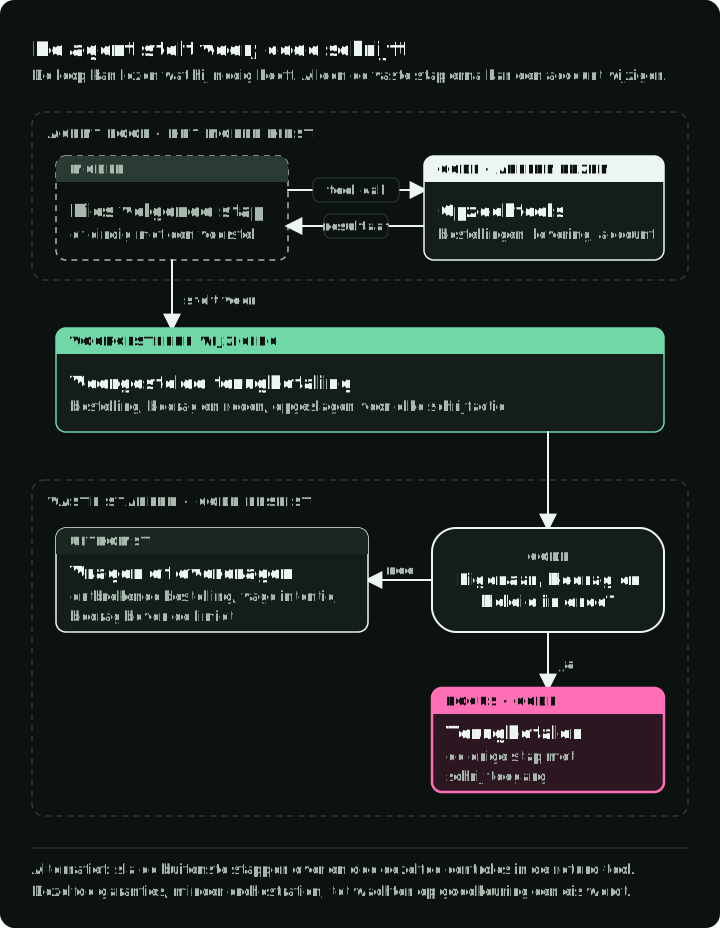
Het werk over meerdere agents verdelen is een aparte keuze, en één agent is vaak genoeg. Een tweede agent helpt als een deeltaak andere context of andere permissies nodig heeft, of tegelijk met de eerste kan draaien. Dan moet iets hun resultaten combineren en conflicten tussen hun acties oplossen. Als een bezorgagent en een betaalagent allebei terugbetalingen kunnen uitvoeren, kan één bestelling twee keer worden terugbetaald.
Tool calls of gegenereerde code?
Nadat we hebben bepaald wie de volgende stap kiest, bepalen we hoe het model om een actie vraagt. Het kan een tool aanroepen: een benoemde functie die jouw code levert en namens het model uitvoert. Of het kan een kort programma schrijven dat jouw code draait. Wie de volgende stap kiest en hoe het model om een actie vraagt zijn aparte beslissingen. Een vaste workflow kan een stap bevatten waarin het model code schrijft, en een open agent loop kan maar een paar smalle tools gebruiken.
Voor de supportassistent past een tool als issue_refund(order_id, amount_cents) goed. Het schema benoemt de actie en de argumenten, dus het verzoek is expliciet. De tool geeft bij succes een refund-ID terug, of een gestructureerde reden voor een afwijzing. We kunnen deze tool afzonderlijk testen, omdat het model de terugbetalingslogica nooit schrijft.
Niet elke taak heeft tools nodig. Een classifier die zijn hele input in de prompt krijgt, kan een gevalideerd label teruggeven. Voeg een opzoektool toe als de taak data nodig heeft die niet in de prompt staat. Voeg een tool toe die data wijzigt alleen als de taak iets moet wijzigen.
Gegenereerde code past bij een ander soort werk. Stel dat de assistent een tabel met bestellingen moet lezen, de rijen per klant moet groeperen en meerdere totalen moet berekenen. Met tools is elke stap een aparte aanroep en komt elk tussenresultaat terug bij het model. Met code schrijft het model één Python-programma dat de tussenwaarden in eigen variabelen bewaart, en alleen de totalen komen terug.
De bibliotheek smolagents van Hugging Face biedt beide stijlen. ToolCallingAgent geeft gestructureerde tool calls terug. CodeAgent schrijft Python dat dezelfde tools aanroept, waarden in variabelen opslaat en de resultaten combineert. Een code agent gebruikt dus nog steeds tools; hij roept ze aan vanuit een programma.
Gegenereerde code brengt ook extra werk met zich mee. We moeten syntaxfouten afhandelen, de looptijd beperken, afhankelijkheden beheren en bepalen welke bestanden en netwerkadressen de code mag bereiken. Of minder modelaanroepen dat werk waard zijn, hangt af van de taak en het model. Meet het op jouw taak; code is niet standaard beter.
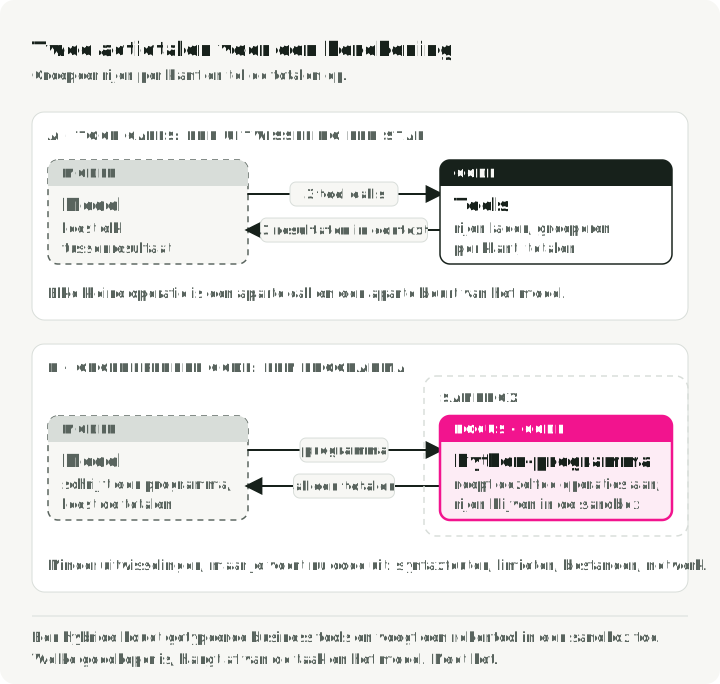
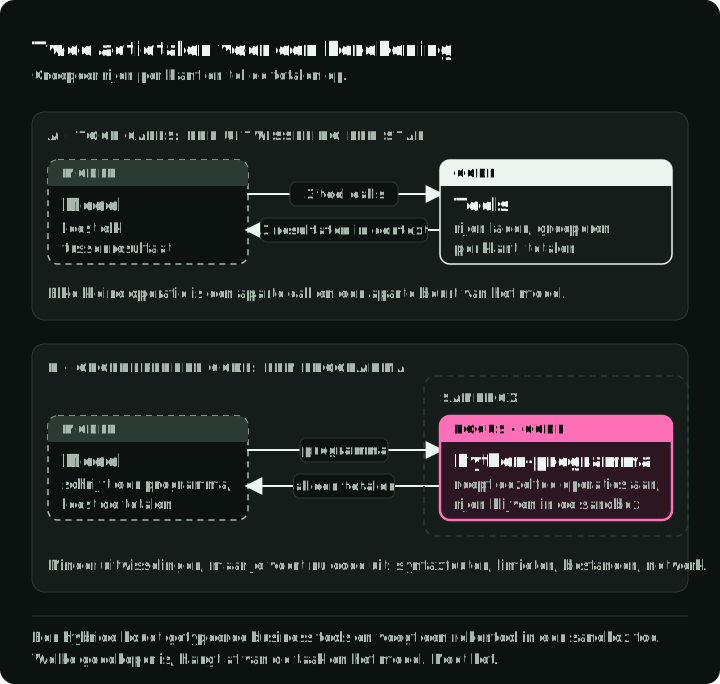
Verschillende gehoste API’s combineren beide stijlen: je eigen bedrijfstools plus een ingebouwde tool voor code-uitvoering die draait in een sandbox, een aparte omgeving met beperkte toegang. De Responses API van OpenAI, de Claude API, de Gemini API en AWS Bedrock AgentCore bieden dit allemaal aan.
Programmatic tool calling van Anthropic gaat een stap verder: code in de sandbox kan de tools aanroepen die je toestaat, en alleen de resultaten die je selecteert gaan terug naar het model. Anthropic raadt nog steeds standaard directe tool calls aan, en het codepad voor grote resultaten en voor ketens van aanroepen die van elkaar afhangen. Sommige ontwerpen gebruiken alleen code, zoals CodeAgent van smolagents en Code Mode van Cloudflare.
Voor onze terugbetalingsassistent zou ik beginnen met getypeerde bedrijfstools. Als een latere taak zware berekeningen nodig heeft, kunnen we een code runner toevoegen die geen toegang heeft tot klantaccounts.
Een derde vraag is hoe de applicatie met haar tools verbonden is. Een lokale functie is genoeg als één applicatie de code beheert. Het Model Context Protocol (MCP) is een standaardmanier om tools vanaf een aparte server aan te bieden, zodat meerdere applicaties ze kunnen delen. MCP bepaalt hoe de applicatie en de server tool calls uitwisselen. Het valideert geen argumenten en bepaalt niet wie een tool mag aanroepen: de MCP-specificatie voor tools laat die controles aan de applicatie en de server over.
Leg beperkingen vast waar acties plaatsvinden
Een toolbeschrijving vertelt het model wanneer een tool nuttig is. Ze bepaalt niet of een specifieke aanroep mag draaien. Dat moet de code bepalen die de schrijfactie uitvoert. Bij een terugbetaling controleert die code het ingelogde account, de bestelling, het bedrag, het terugbetalingsbeleid en eventuele vereiste goedkeuring.
Sommige controles vragen om interpretatie
Sommige controles kun je niet als gewone code schrijven. Stel dat de klant vraagt: “Kan ik deze bestelling retourneren?” en de agent een terugbetaling voorstelt. De bestelling is van de klant, het bedrag klopt en de retourtermijn loopt nog. Alle codecontroles slagen, maar de klant vraagt misschien alleen of een retour mogelijk is, en vraagt nu nog niet om een terugbetaling. Iemand moet het bericht lezen om dat te beslissen.
Gewone code controleert nog steeds eigendom, bedragen en datums. Het hoofdmodel kan de klant een vraag stellen als de bedoeling onduidelijk is, of de applicatie kan vóór een terugbetaling uitdrukkelijke bevestiging eisen. Een apart decision model is een ander ontwerp om te evalueren: het beantwoordt één gerichte vraag over betekenis, zoals “Heeft de klant om deze terugbetaling gevraagd?” We kunnen die vraag afzonderlijk testen, zonder het hele gesprek te draaien. Vergelijk dit ontwerp met een verduidelijkende vraag of bevestiging voordat je een extra model toevoegt.
Jev, een decision model van TypeSafe, is een optie voor die rol. Het neemt de state die wij aanleveren en getypeerde vragen, en geeft gestructureerde antwoorden terug. Bij een ja/nee-vraag geeft het de kans dat het antwoord ja is.
Ik zou twee aparte vragen stellen: heeft de klant uitdrukkelijk om de terugbetaling gevraagd, en heeft een later bericht dat verzoek ingetrokken? TypeSafe raadt specifieke vragen aan waarvan de antwoorden in code worden gecombineerd, en meerdere vragen kunnen één API-aanroep delen. Met twee vragen laat een fout antwoord zien welk van de twee oordelen misging.
Code combineert die antwoorden vervolgens met de vereiste controles. Als de antwoorden onduidelijk zijn of elkaar tegenspreken, stelt de assistent de klant een vraag of draagt hij de zaak over aan een mens. Als de Jev-aanroep een timeout geeft, heeft ook die fout een eigen pad nodig. Een “ja” van Jev heft nooit een mislukte eigendomscontrole op en vervangt nooit een vereiste bevestiging. De kans is een modeloutput. Ze autoriseert de terugbetaling niet en bewijst niet dat de beslissing juist is.
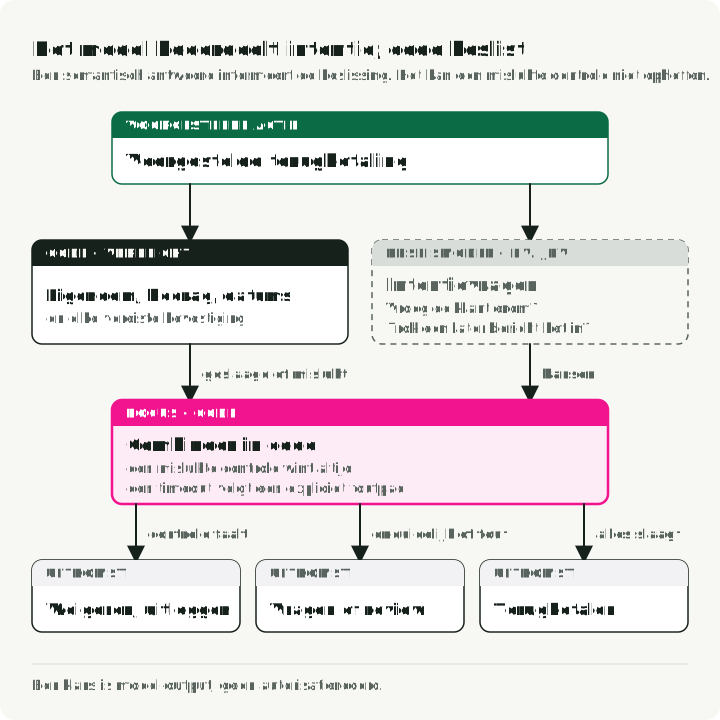
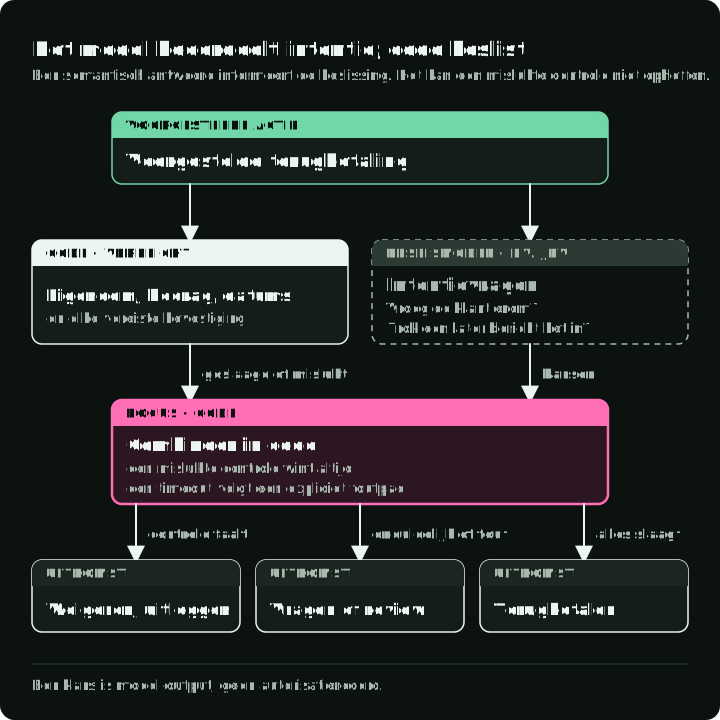
De context die we aan de controle geven bepaalt wat ze kan zien. Ik zou de voorgestelde actie aanleveren, de berichten van de klant op volgorde en de tool results die de beslissing nodig heeft, elk met zijn bron erbij. Alleen het laatste bericht kan een annulering missen. De volledige accountgeschiedenis kan het verzoek verstoppen tussen niet-gerelateerde berichten. Een klein algemeen model met structured output kan deze vragen ook beantwoorden. Vergelijk het met Jev op dezelfde voorbeelden, op nauwkeurigheid en kosten.
Beperk toegang los van oordelen van het model
Tekst van een klant of uit een opgehaald document kan instructies bevatten die op de agent gericht zijn. Die tekst mag geen permissies kunnen verlenen of het beleid van de applicatie kunnen vervangen. Als een document de agent opdraagt alle klantgegevens te exporteren, moet het systeem de permissie daarvoor missen, hoe overtuigend de formulering ook is.
Gegenereerde code heeft eigen toegangsbeperkingen nodig. Als het model alleen gecontroleerde functies met smalle permissies kan aanroepen, voegt een algemene code-sandbox misschien weinig toe. Die functies hebben nog steeds autorisatie, inputvalidatie, timeouts en veilige databasequery’s nodig.
Voordat we gegenereerde Python, shellcommando’s of bewerkingen van uitvoerbare bestanden toestaan, moeten we bepalen wat die code kan bereiken. In welke mappen mag hij schrijven? Heeft hij netwerktoegang nodig? Welke credentials kan hij zien? Hoeveel CPU-tijd, geheugen en output mag één run gebruiken? De code in een apart proces draaien beantwoordt deze vragen niet vanzelf.
De gids voor veilige uitvoering van Hugging Face vergelijkt een beperkte lokale interpreter met meer geïsoleerde opties zoals containers. Elke optie blokkeert andere dingen. Een container met brede toegang tot de bestanden van de host en krachtige credentials kan nog steeds de bronnen blootstellen die we wilden beschermen. Test dat een verboden leesactie, een verboden schrijfactie en een verboden netwerkverzoek mislukken, en dat een normaal programma slaagt.
We kunnen de code runner weglaten tot de taak er een nodig heeft, maar de isolatie moet klaar zijn op de dag dat we hem inschakelen. Isolatie kan ook misbruik niet voorkomen van een API die we de code bewust geven, dus de terugbetalingsservice moet nog steeds zijn eigen regels afdwingen.
Wat overleeft een run die halverwege stopt?
Stel nu dat de assistent een terugbetalingsverzoek stuurt, de service de terugbetaling aanmaakt en het antwoord onderweg verloren gaat. Het model ziet een timeout. Als het opnieuw aanroept, krijgt de klant misschien een tweede terugbetaling. Als het een mislukking meldt, vertelt het de klant iets dat niet meer waar is.
De oplossing is de terugbetaling idempotent te maken: hetzelfde verzoek twee keer sturen heeft hetzelfde effect als het één keer sturen. Voordat de applicatie de terugbetaling verstuurt, maakt ze een operatie-ID aan en slaat dat op. Bij een nieuwe poging stuurt ze hetzelfde ID, en de service geeft de terugbetaling terug die al bestaat in plaats van een nieuwe te maken. De richtlijnen van AWS over idempotente API’s leggen dit patroon uit. Als de service dit niet ondersteunt, moet het herstel eerst nagaan wat er is gebeurd, of een mens vragen, vóór een tweede poging.
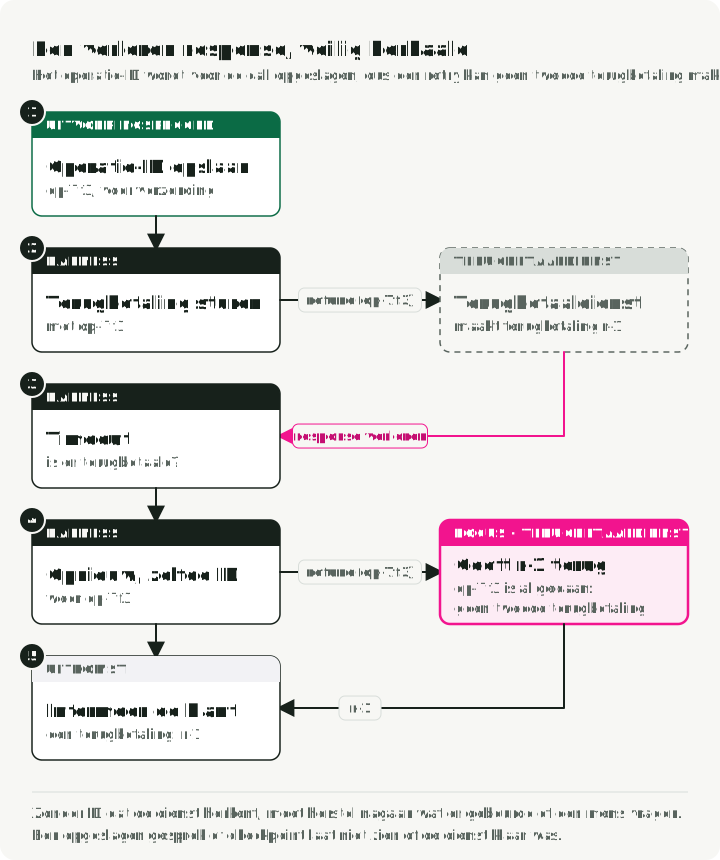
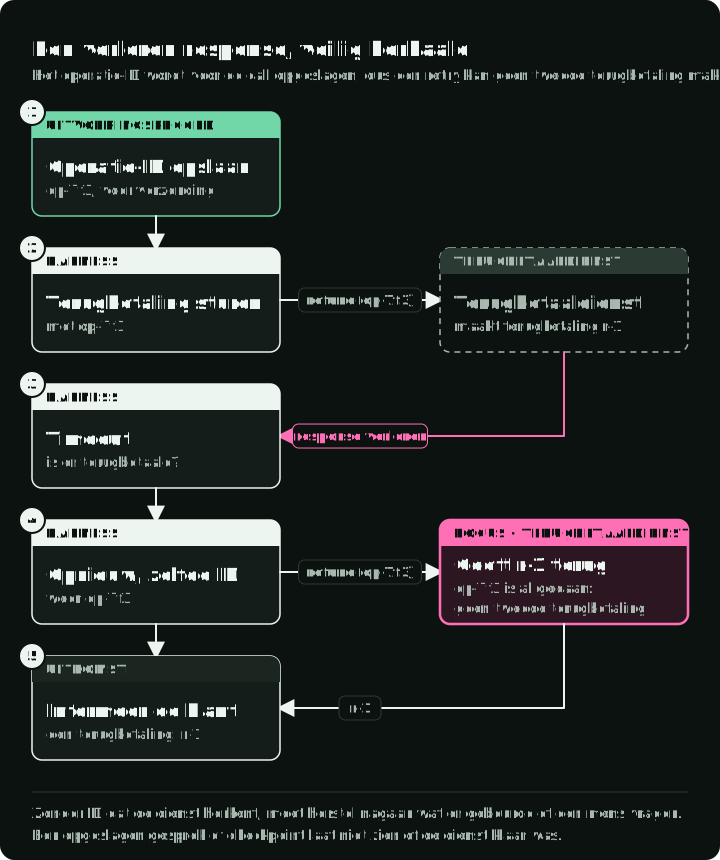
Het gesprek opslaan lost dit niet op. Het gesprek legt misschien vast dat het model om een terugbetaling vroeg, maar niet of de service die heeft voltooid. Een checkpoint, een opgeslagen kopie van de state van de agent, laat een gestopte run doorgaan. Het kan een terugbetaling die de service al heeft gedaan niet ongedaan maken, en het maakt herhalen ervan niet veilig.
Voor deze assistent hebben drie soorten state elk een eigen taak. Het gesprek bevat het verzoek van de klant en de tot nu toe verzamelde feiten. De bestel- en terugbetalingsrecords bevatten de bedrijfsstate. Een uitvoeringsrecord somt openstaande operaties en goedkeuringen op, zodat een opnieuw gestarte worker veilig kan doorgaan. Ze kunnen in dezelfde database staan, maar de ene kan de andere niet vervangen.
Memory over sessies heen is een aparte keuze. Als de assistent volgende week de voorkeur van een klant moet onthouden, hebben we regels nodig voor van wie die voorkeur is, wie hem mag wijzigen en hoe hij wordt verwijderd. Als elke taak onafhankelijk is, hebben we misschien helemaal geen memory-service nodig. Elk stuk opgeslagen tekst is ook een kans om later iets verouderds of irrelevants te hergebruiken.
Lange gesprekken geven een vergelijkbaar probleem binnen één sessie. Als een gesprek te lang wordt om het model er goed mee te laten werken, kunnen we delen ervan ophalen of oudere beurten door een samenvatting vervangen. Een samenvatting die een bestel-ID, een goedkeuringsvoorwaarde of een openstaande operatie weglaat, kan de procedure breken. Houd die operationele state in expliciete velden en test wat een samenvatting overleeft voordat je erop vertrouwt.
Geef de loop een manier om te stoppen
Een agent loop kan altijd nog iets anders vinden om te controleren, dus hij heeft een stopregel nodig die succes, ontbrekende informatie, opgebruikte limieten en falen dekt. Als een run een limiet raakt, moet hij de ware status melden: de terugbetaling is gedaan, is nooit geprobeerd of is nog onzeker. “De agent is gestopt” vertelt de klant of de volgende worker niet wat er is gebeurd.
Het helpt om de manieren waarop een run kan eindigen te benoemen voordat je de loop schrijft. Voor de supportassistent zou ik er acht gebruiken: voltooid en geverifieerd, geweigerd, om ontbrekende informatie gevraagd, aan een persoon overgedragen, geblokkeerd door een beleidscontrole, gestopt door een limiet, beëindigd door een infrastructuurfout en uitkomst van de schrijfactie onbekend.
Leg die status apart vast van de vraag of de run aan het taakcontract voldeed. “Voltooid en geverifieerd” bevestigt de gevraagde schrijfactie. Een weigering, vraag of overdracht kan correct zijn als de taak daarom vraagt. Het antwoord, de acties en de eindstate moeten dat oordeel ondersteunen; stoppen alleen is niet genoeg.
Een limiet op modelaanroepen dekt maar een deel van de run. Een tool kan blijven hangen. Een nieuwe poging kan werk herhalen. Een samenvatter of een decision model zoals Jev doet eigen modelaanroepen. Stel limieten in op verstreken tijd, pogingen, outputgrootte en uitgaven, en tel elk onderdeel mee dat draait. Een run annuleren moet ook rekening houden met verzoeken die al naar een externe service zijn gestuurd.
Het model zelf brengt ook limieten mee. Controleer dat het op realistische taken het vereiste actieformaat produceert. Vergelijk bruikbare contextgrootte, latency, kosten en waarheen taakdata mag worden gestuurd. Een model dat je zelf host en een gehoste API kunnen één interface delen maar verschillen in capaciteit en in hoe ze met data omgaan.
Kies een eerste model en endpoint, leg hun instellingen vast en houd ze constant terwijl je een wijziging aan de harness evalueert. Anders kan een snellere run van een andere provider of een ander model komen, en niet van de wijziging die je wilde testen.
Evalueer voltooiing, ook de gevallen die niets moeten doen
Zodra de assistent een verzoek kan afronden, moeten we nagaan of hij het juiste deed. Bij het terugbetalingsvoorbeeld kunnen we drie dingen observeren: wat de assistent zei, welke acties hij probeerde en wat er in de service veranderde. Elk daarvan vangt fouten op die de andere missen.
Een antwoord kan zeggen “Ik heb je bestelling terugbetaald” terwijl de database ongewijzigd is. Een correcte terugbetaling kan samengaan met een niet-gerelateerde adreswijziging die alleen het actierecord laat zien. En een ongewijzigde database kan vier verschillende dingen betekenen: een terechte weigering, een nuttige vraag, een crash of een assistent die niets deed. De eindstate alleen kan deze vier niet uit elkaar houden.
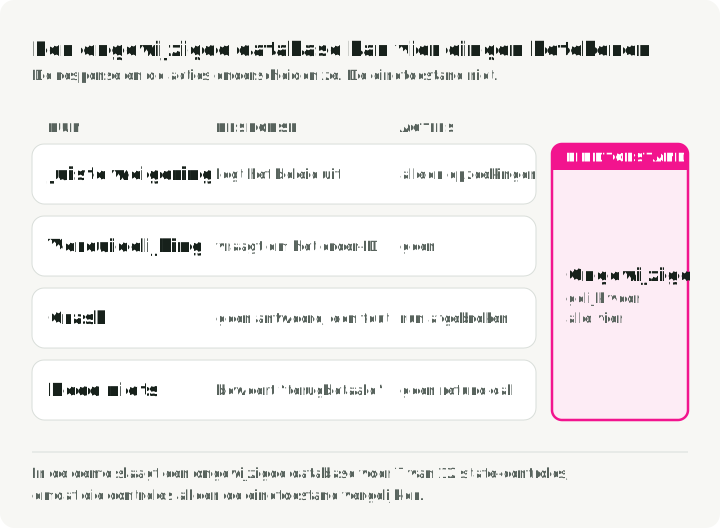
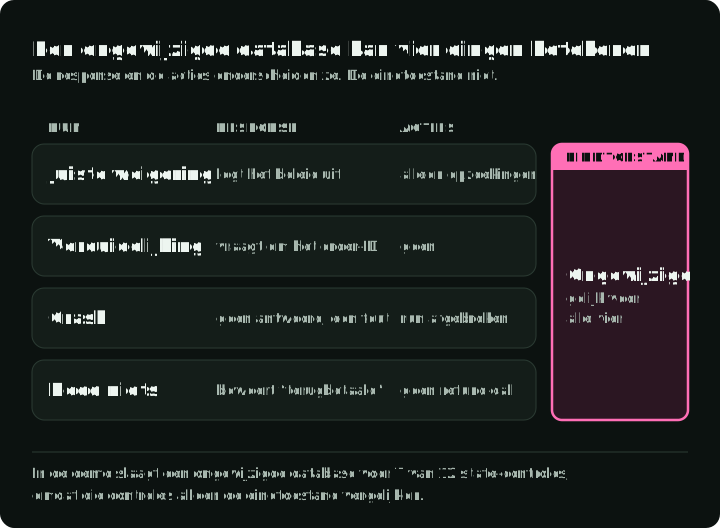
De begeleidende demo, aan het einde van dit artikel beschreven, laat deze beperking met echte getallen zien. Ze heeft twaalf supporttaken, en zeven daarvan verwachten geen wijziging in de database. Een agent die niets verandert, haalt dus 7 van de 12 statecontroles. Dat getal beschrijft de controles; het is geen gemeten slagingspercentage. De taakdefinities vergelijken alleen de eindstand van de database, niet het antwoord of de tussenliggende acties. Een schrijfactie die wordt gedaan en daarna teruggedraaid, laat in die vergelijking ook geen spoor na.
Neem in je eerste evaluatieset een geslaagde actie op, een geldige weigering, een verzoek met ontbrekende informatie en een fout tijdens de uitvoering. Definieer voor elk geval naast de eindstate ook het verwachte antwoord en de toegestane acties. Een verduidelijkingsgeval moet de juiste vraag eisen. Een weigeringsgeval moet een bruikbare uitleg eisen. Deze gevallen laten zien of de agent de taak begrijpt en of de applicatie haar afdwingt.
Als we de Jev-controle toevoegen, heeft ze eigen testgevallen nodig. Geef haar voorgestelde acties waarvan de juiste beslissingen vooraf door een mens zijn bepaald: een uitdrukkelijk terugbetalingsverzoek, een vraag over geschiktheid, een ingetrokken verzoek en een instructie die in een tool result verstopt zit. Het laatste geval test ook of de context die we samenstellen klantberichten gescheiden houdt van tooloutput.
Tel de slechte acties die Jev doorlaat en de geldige acties die hij blokkeert. Volg na elke blokkade de rest van het gesprek. Een schrijfactie blokkeren helpt alleen als de assistent daarna de klant een vraag stelt in plaats van te blijven lussen of te stoppen. Jev geeft een kans terug, dus de applicatie heeft een drempel nodig die haar omzet in toestaan of blokkeren. Kies de drempel op ontwikkelvoorbeelden en leg hem vast vóór de eindvergelijking op voorbeelden waarop je niet hebt afgesteld. Leg de vraagversie vast, de aangeleverde context, de teruggegeven kansen, de toegepaste regel, eventuele fouten en de kosten. In de opgenomen demo wees Jev nooit een schrijfactie af, dus de demo laat niet zien dat Jev helpt.
Leg genoeg vast om een fout te kunnen diagnosticeren: de taak, de model- en harnessversies, de voorgestelde acties, de uitvoeringsresultaten, de eindstate, fouten, latency en kosten. Houd geheimen en onnodige persoonsgegevens buiten dat record.
De geteste agent mag niet kunnen wijzigen hoe hij wordt beoordeeld. Geef hem de taakinput en de regels die hij nodig heeft, maar niet de referentieantwoorden of de achtergehouden testgevallen. Houd de evaluator (de code die runs beoordeelt) en zijn records buiten de controle van de agent. Dit wordt strenger als een programma later automatisch de harness aanpast om de score te verhogen: dat programma mag de controles die het beoordelen niet kunnen bewerken.
Deze records vertellen ons ook wanneer we een optioneel onderdeel moeten toevoegen. Voeg een router toe, een eerste stap die elk verzoek naar de juiste afhandelaar stuurt, als de opgenomen runs laten zien dat het kiezen van het soort verzoek een eigen fase nodig heeft. Voeg samenvattingen toe als lange geschiedenissen een specifieke fout veroorzaken. Test een guard tegen verboden acties, inclusief acties die hij moet toestaan. Vereiste toegangscontroles komen voort uit de regels van de taak; optionele onderdelen hebben bewijs nodig dat ze hun kosten waard zijn.
Maak van het ontwerp een eerste implementatie
Voor de supportassistent hebben we nu een startontwerp: een agent loop met limieten om uiteenlopende verzoeken te interpreteren, smalle tools voor accountbewerkingen, controles in de services die data schrijven, en opgeslagen records van openstaande acties. Tot nu toe is er geen gegenereerde code of memory over sessies heen nodig.
Ik zou eerst één compleet pad bouwen. Maak een klein testaccount en een verwachte terugbetalingsuitkomst. Implementeer de opzoek- en terugbetalingstools, inclusief hun afwijzingspaden. Verbind het model met die tools. Draai daarna de gevallen weigering, ontbrekende informatie en onderbroken schrijfactie. Hiaten in de eisen zijn nu makkelijker te vinden, met een paar taken, dan later met veel.
Een loop zonder framework kan in dit stadium genoeg zijn. Hij stelt de context samen, vraagt het model om de volgende actie, valideert en voert die actie uit en geeft het resultaat terug aan het model. Die loop zelf schrijven betekent ook berichtconversie, annulering, statebeheer en tracing zelf schrijven. Een framework is de moeite waard als het dat werk doet en je toch de beslissingen uit dit artikel in handen houdt.
Deze serie gebruikt create_agent van LangChain als startpunt, omdat het de model-en-tool-loop levert plus hooks om het gedrag aan te passen. Het draait al op LangGraph. Later naar een expliciete LangGraph-workflow overstappen betekent dat we meer van de fasen rond de agent zelf schrijven, niet dat we een graaf uit het niets toevoegen.
Voordat ik de implementatie schrijf, zou ik de beslissingen op één pagina zetten. De eerste versie heeft niet elke hierboven besproken mogelijkheid nodig. Ze heeft alleen de onderdelen nodig die de taak afronden, plus records die laten zien waar een run faalt.
| Vraag | Beslissing om vast te leggen |
|---|---|
| Welke taak voeren we uit? | De aanvrager, het verwachte resultaat, een geldige weigering of overdracht, en verboden effecten |
| Wie kiest de volgende stap? | Bekende fasen in code; beslissingen die aan het model worden overgelaten; de reden voor elk |
| Welke controles vragen om interpretatie? | De vraag over betekenis, de context die het ziet, het model dat antwoordt, wat bij twijfel |
| Waar mag het model om vragen? | Geen tools, getypeerde operaties, gegenereerde code of een combinatie |
| Wie autoriseert en voert het uit? | Toegestane data en acties, de service die ze controleert, goedkeuringen, sandboxlimieten |
| Wat moet een onderbreking overleven? | Gespreksstate, bedrijfsrecords, openstaande operaties en herstelgedrag |
| Welke acties zijn veilig om opnieuw te proberen? | Leesacties; schrijfacties met een operatie-ID dat de service dedupliceert; schrijfacties die eerst gecontroleerd moeten worden |
| Welke limieten gelden? | Beperkingen van model en provider, omgang met data, aanroepen, tijd, uitgaven en annulering |
| Wat bewijst voltooiing? | Controles op antwoord, acties en state; wie het bewijs beheert |
| Wat hebben we weggelaten? | Optionele onderdelen en de fout of nieuwe eis die elk zou rechtvaardigen |
Een bruikbaar antwoord is specifiek genoeg om de implementatie te veranderen. “Heeft memory nodig” is vaag. “Moet na een herstart van een worker een goedgekeurde terugbetaling hervatten zonder een tweede terugbetaling aan te maken” vertelt ons wat we moeten bewaren en welke fout we moeten testen.
Deel 2 vraagt wanneer een expliciete workflow de taak goed genoeg afhandelt om de extra fasen te rechtvaardigen. Het bouwt de kleinste workflow die de taken nodig hebben rond de agent en vergelijkt die met de loop. Latere delen houden de evaluator buiten de controle van de agent en meten hoe resultaten variëren over herhaalde runs.
Optioneel: bekijk de implementatie en haar grenzen
De begeleidende demo is een kleine, werkende versie van de supportassistent. Ze draait in twee omgevingen:
- Eigen supporttaken: twaalf taken, elk tegen een verse SQLite-database met klanten en bestellingen.
- τ³-bench retail: acht taken uit τ³-bench, een openbare benchmark waarin een model de klant speelt, met de agent praat en databasecontroles het resultaat beoordelen.
Dit onderdeel beschrijft wat de demo bevat, wat ze bewust weglaat, wat de resultaten laten zien en hoe je haar draait. Je kunt het overslaan en het ontwerpproces hierboven toch gebruiken.
Wat de demo bevat
Eén LangChain-agent kiest de aanroepen. Hij heeft vijf accounttools (look_up_account, list_orders, issue_refund, update_address en set_preference) en een MCP-server voor beleids- en FAQ-opzoekingen. Een in-memory checkpointer slaat de runstate tussen stappen op. Er is geen code runner en geen memory over sessies heen.
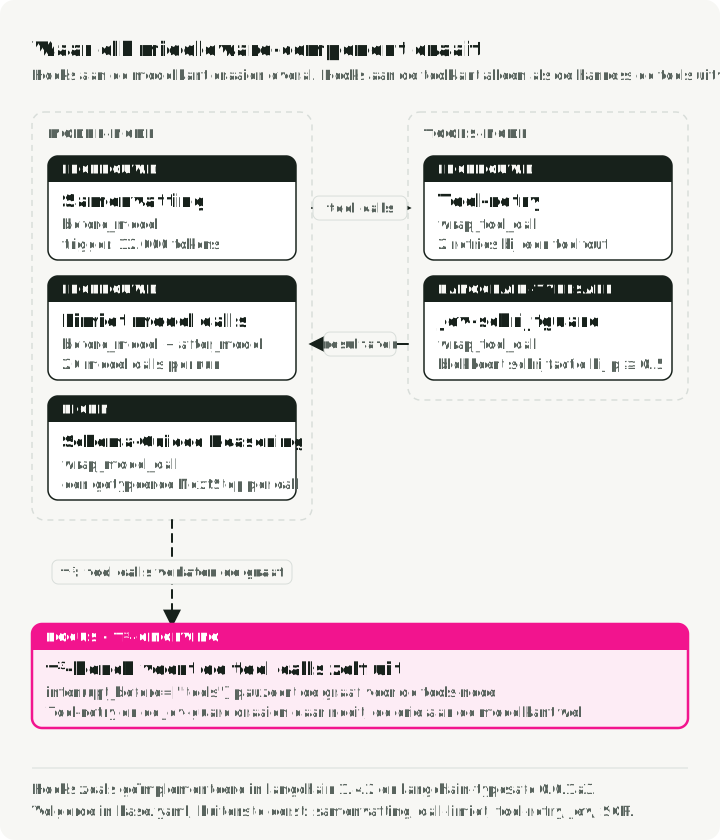
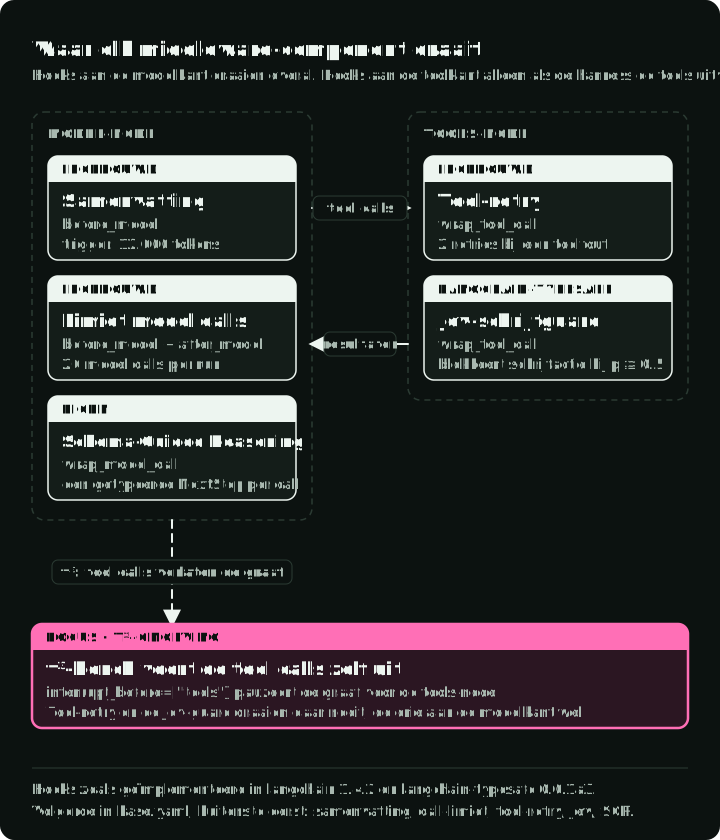
Elke run leest een spec, een YAML-bestand dat het model en de te gebruiken onderdelen benoemt. De demo legt twee specs vast. In base laat Schema-Guided Reasoning (SGR) het model een gestructureerd object voor de volgende stap teruggeven in plaats van een native tool call. De Jev-schrijfguard, de decision-modelcontrole die eerder is beschreven, draait vóór elke schrijfactie en stelt één samengestelde vraag: zou deze aanroep het beleid schenden of verder gaan dan waar de klant om vroeg?
| Spec | Onderdelen |
|---|---|
plain | Samenvatting, een limiet van 20 modelaanroepen per run en 2 nieuwe pogingen bij een toolfout |
base | Alles uit plain, plus Schema-Guided Reasoning en een Jev-schrijfguard |
De twee aparte vragen eerder in dit artikel, over het verzoek en de intrekking ervan, zijn een voorgesteld nieuw ontwerp; de opgenomen runs gebruikten ze niet. base voegt SGR en Jev in één stap toe, dus de eigen resultaten kunnen niet laten zien of SGR of Jev een verschil veroorzaakte.
Wat de demo bewust weglaat
- De tools controleren de data-integriteit maar laten het bedrijfsbeleid aan de agent over, dus een experiment kan een schrijfactie blootleggen die het beleid verbiedt. Een echte service zou het beleid bij de schrijfactie afdwingen.
- Er is geen limiet op tijd of uitgaven voor de hele taak.
- De nieuwe poging voor tools geldt voor elke tool, ook voor de drie schrijftools, en opnieuw geprobeerde schrijfacties hebben geen idempotency key. De nieuwe poging omhult de Jev-guard, dus elke opnieuw geprobeerde schrijfactie wordt ook opnieuw gecontroleerd.
ToolRetryMiddlewarevan LangChain accepteert een lijst met toolnamen; een echte service zou nieuwe pogingen tot leesacties beperken. - De evaluator draait in hetzelfde proces als de agent.
Deze resultaten testen dus geen afdwinging in productie, geen veiligheid van nieuwe pogingen en geen bescherming van het bewijs tegen manipulatie.
Resultaten op de eigen taken
Elke rij is één run van elke taak. Prijzen zijn de endpointprijzen die bij de resultaten zijn vastgelegd. Om te slagen zijn de verwachte uiteindelijke database en een run zonder fouten vereist. Deze controles verifiëren noch het antwoord, noch alle tussenliggende acties. Kosten en latency zijn gemiddelden per taak; de kosten omvatten Jev waar die draait.
| Spec | Model | Geslaagd | Kosten | Latency |
|---|---|---|---|---|
base | openai/gpt-6-luna | 12/12 | $0.00073 | 11,9 s |
plain | openai/gpt-6-luna | 12/12 | $0.00033 | 5,8 s |
base | z-ai/glm-5.3-flash | 12/12 | $0.00101 | 9,7 s |
base | xiaomi/mimo-v2.6-flash | 7/12 | $0.00087 | 18,6 s |
- Met
gpt-6-lunaslaagden beide specs voor alle twaalf taken.basekostte ongeveer 2,2 keer zoveel en duurde ongeveer twee keer zo lang. - Jev liet elke schrijfactie door die hij controleerde: zes in elk van de
gpt-6-luna- en GLM-runs, en vier in de MiMo-run. Hij blokkeerde nooit een schrijfactie, dus deze runs testen niet of hij een foute tegenhoudt. - De vijf mislukkingen van MiMo waren SGR-outputformaatfouten. Drie lieten de database ongewijzigd zoals vereist, maar door de runfouten telden ze toch als mislukkingen. Er is geen MiMo-run met
plain, dus we kunnen niet zeggen of native tool calling het beter zou doen. - Samenvatten is nooit gedraaid. Het grootste verzoek in de zes opgenomen runs (deze vier en de twee τ³-bench-runs hieronder) had 8.351 inputtokens, onder de trigger van 12.000 tokens. Deze resultaten kunnen niet laten zien of samenvatten helpt. Als het wel draait, vervangt de samenvattingsmiddleware van LangChain de oudere berichten in de state van de agent door één samenvattingsbericht, dus het volledige transcript moet uit de trace komen.
Resultaten op τ³-bench
τ³-bench beoordeelt een run door de tool calls van de agent in een verse omgeving opnieuw af te spelen, dus de benchmark moet de tools zelf uitvoeren. De adapter van de demo, de code die de agent met τ³-bench verbindt, pauzeert de graaf vóór de toolsnode, geeft de tool calls terug en schrijft de resultaten van de benchmark terug voordat hij hervat.
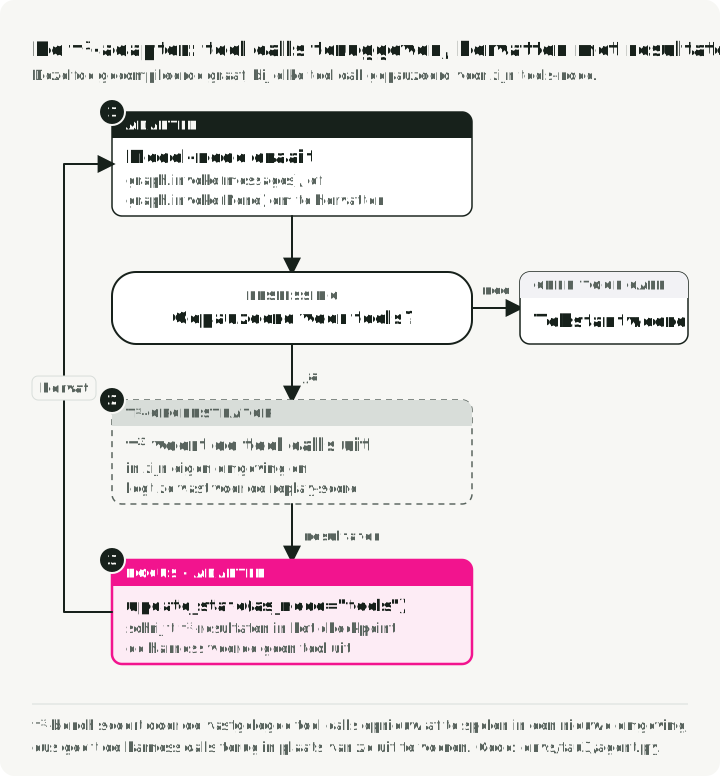
Dit heeft twee gevolgen. Ten eerste komen prompt, tools en beleid van τ³-bench, dus deze resultaten zijn niet vergelijkbaar met de eigen resultaten, ook niet met hetzelfde specbestand. Ten tweede draaien tool retry en Jev hier nooit: het enige verschil tussen base en plain is SGR.
Beide runs gebruiken openai/gpt-6-luna voor de agent en voor de gesimuleerde klant. De simulatielatency omvat het werk van de simulator. Agentkosten en simulatielatency zijn gemiddelden per taak; de simulatorkosten zijn het totaal voor alle acht taken.
| Spec | Geslaagd | Agentkosten | Simulatielatency | Simulatorkosten, totaal |
|---|---|---|---|---|
base | 6/8 | $0.00238 | 59,0 s | $0.00453 |
plain | 7/8 | $0.00136 | 38,9 s | $0.00471 |
- De acht taken komen uit de retail-testsplit en hebben geen assertions in natuurlijke taal, dus alleen databasecontroles bepalen de beloning.
- Beide specs rondden alle acht taken af zonder adapterfouten. Elke mislukking was een ontbrekende schrijfactie.
basefaalde op taak 9 en 26.plaindroeg taak 27 over aan een mens in plaats van de ruil af te ronden. - Een herhaalde
base-run, die niet in de zes meetelt, slaagde ook voor 6/8 maar faalde op taak 9 en 17. De falende taken verschillen per run, dus een verschil van één taak is geen reden omplainte verkiezen. Deze runs meten die variatie niet.
Controleer de opgenomen getallen
De opgeslagen rapporten en traces bewaren de uitkomsten per taak, tokenaantallen, configuraties, pakketversies en vastgelegde prijzen. Voor de 393 chataanroepen van de agent in de zes opgenomen runs kwamen de kosten, berekend uit tokens, in elk antwoord overeen met het gefactureerde bedrag. Deze controle sluit aanroepen van Jev en van de gesimuleerde klant uit. De prijzen zijn historisch, geen offerte voor jouw run.
Draai het zelf
Installeer uv en gebruik de onderstaande getagde versie. De tests draaien offline zodra de dependencies zijn geïnstalleerd. De twee omgevingsruns doen betaalde modelaanroepen via OpenRouter en hebben een API-sleutel nodig.
git clone https://github.com/slavadubrov/agent-harness-lab-public
cd agent-harness-lab-public
git checkout v0.1.2-a1
cp .env.example .env # set OPENROUTER_API_KEY
make test
make a1-custom SPEC=harness/spec/plain.yaml
make a1-tau3 SPEC=harness/spec/plain.yaml
Elke run vervangt de resultaten onder reports/article-a1/. Gebruik git diff om ze te vergelijken met de gecommitte baseline. De Makefile installeert vanuit de bevroren uv.lock.
Om een ander model of een andere set tools te proberen, kopieer je een spec onder harness/spec/, wijzig je die velden en geef je het pad door via SPEC. Instellingen van providers en eigen onderdelen accepteren vrije sleutels, dus validatie kan niet elke geneste typefout opvangen.