Harness engineering voor AI agents: voltooiing verifiëren

Automatische vertaling
Dit artikel is automatisch vertaald vanuit de oorspronkelijke Engelse versie.
Een agent kan zijn beurt afronden terwijl het werk nog niet af is. Dit artikel is bedoeld voor engineers die coding agents bouwen of reviewen en moeten beslissen wanneer ze een resultaat accepteren, een onzekere operatie opnieuw proberen of werk in een andere session hervatten. Het laat ook zien hoe je meet of een extra harness-component die uitkomsten genoeg verbetert om de kosten te rechtvaardigen.
De harness is de applicatiecode rond de reasoning loop van het model. Die levert context, controleert voorgestelde acties, legt vast wat er gebeurde en beslist of het bewijs volstaat om af te ronden. De runtime voert geaccepteerde acties uit en houdt de session, de sandbox en het checkpoint beschikbaar. De eerdere artikelen behandelen de reasoning loop, memory, tools en permissions. Hier gaat het om wat de harness doet nadat het model een actie voorstelt of “klaar” zegt.
De winkel- en betaalvoorbeelden hieronder zijn fictieve lesvoorbeelden. Het bijbehorende lab is een deterministische simulatie; het meet geen live coding agent.
Wat telt als klaar
Stel dat een coding agent in een fictieve winkelrepository de drempel voor een automatische korting van 10% moet verlagen van $100 naar $75. Hij wijzigt src/checkout.py. Een winkelwagen van $80 moet nu $8 korting krijgen. De taak heeft twee verplichte checks:
pytest tests/test_checkout.pycontroleert de berekening.pnpm playwright test tests/checkout_discount.spec.tscontroleert het zichtbare checkout-resultaat in een lokale winkel met seed-data.
Een plausibel eindantwoord is geen van die checks. De harness moet alleen een kandidaat accepteren waarvan de volledige geteste snapshot is geïdentificeerd en waarvan beide verplichte checks op diezelfde snapshot zijn geslaagd. Een schone commit kan die snapshot identificeren; gebruik anders een digest of manifest dat ook relevante untracked bestanden bevat. Houd de tests buiten het bereik waarin de agent mag schrijven, of laat wijzigingen eraan onafhankelijk goedkeuren voordat je beoordeelt.
Hier hebben het model, de harness en de runtime verschillende taken. Implementaties kunnen er meerdere samenvoegen in één proces, maar hun faalgrenzen blijven verschillen:
| Component | Taak | Voorbeeld bij een coding agent |
|---|---|---|
| Model | Stelt tekst, een tool call of een eindantwoord voor | Stelt een wijziging in src/checkout.py voor |
| Reasoning loop | Kiest de volgende stap op basis van de beschikbare context | Inspecteren, bewerken, testen, opnieuw inspecteren |
| Harness | Levert context, valideert en autoriseert voorstellen, dispatcht geaccepteerde calls, legt resultaten vast, controleert voltooiing | Staat bewerkingen onder src/ toe en vereist beide genoemde tests |
| Runtime | Voert geaccepteerde calls uit en houdt state in stand buiten het workerproces | Session-log, sandbox, checkpoint store, trace-backend |
OpenAI’s walkthrough van de Codex-loop beschrijft de cyclus: de harness stelt een prompt samen, vraagt het model om de volgende actie, stuurt een geaccepteerde tool call naar de runtime, voegt het resultaat toe en vraagt opnieuw, totdat hij het resultaat accepteert of de controle teruggeeft aan de gebruiker. Voor de kortingswijziging ziet één ronde er zo uit:
- De context builder levert de taak, de repository-instructies, relevante bestanden, eerdere tool results en het huidige plan.
- Het model stelt een
edit_file-call voor met een pad en vervangende tekst. - De tool-grens valideert de argumenten, controleert het pad tegen het toegestane bereik en vraagt om goedkeuring als de operatie die nodig heeft.
- De runtime past de bewerking toe in de sandbox en geeft een gestructureerd resultaat terug.
- De harness draait
pytest tests/test_checkout.py, daarnapnpm playwright test tests/checkout_discount.spec.ts, en leest beide exitcodes. - Een mislukte check wordt nieuwe context voor de volgende beurt van het model; twee geslaagde checks maken de wijziging een kandidaat voor voltooiing.
- De harness legt de commando’s, exitcodes, geteste snapshot, grader en omgevingsversies duurzaam vast; een trace kan naar dat record verwijzen.
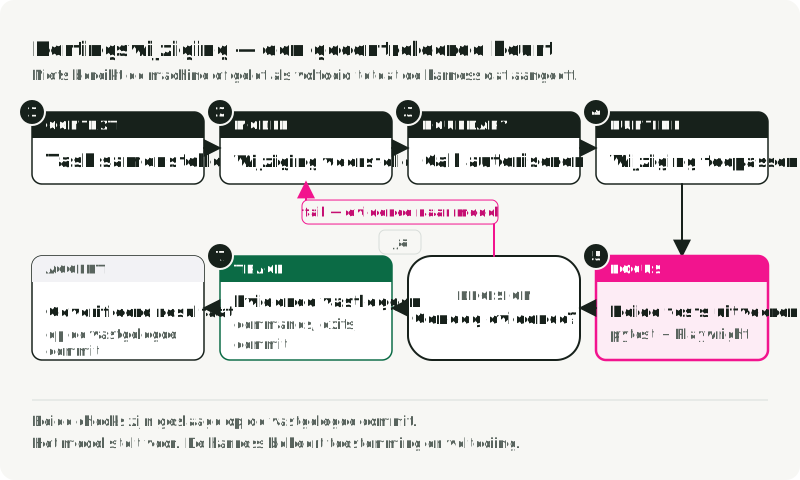
Na stap 2 is er nog geen bestand gewijzigd. De harness kan dan nog ../../secrets.env weigeren, goedkeuring eisen voor een destructief commando of een run stoppen die zijn budget heeft opgebruikt. Na stap 5 leest de harness de exitcodes zelf, zodat het model zijn eigen wijziging niet als geslaagd kan markeren.
Een voltooiingsrecord voor deze taak bevat de kandidaat-snapshot, beide commando’s en exitcodes, en de versies van de testomgeving en de grader. Het moet duurzaam zijn en buiten de controle van de kandidaat liggen. Een trace kan het voorstel, de goedgekeurde call, het runtime-resultaat en het acceptatierecord aan elkaar koppelen voor diagnose. Een trace alleen is niet de acceptatiebeslissing.
Een trace bevat het verzoek ook niet per se. Die kan het brondocument of een middleware-event vastleggen zonder te laten zien wat het samengestelde verzoek uiteindelijk bevatte. Als je moet vaststellen wat het model heeft ontvangen, leg het dan vast op het laatste punt voordat de call vertrekt, na elke transformatie.
OpenAI’s case study over harness engineering beschrijft per worktree een opstartbare applicatie plus browsertoegang, logs, metrics en traces. Met die opzet kon de agent een latency-doel voor een gebruikersflow inspecteren. Het illustreert de voorwaarde achter een acceptatieregel: de relevante applicatie en signalen moeten beschikbaar zijn in de testomgeving. Lopopolo, de auteur van die case study, houdt een praktijkgids voor harness engineering bij met dezelfde twee hefbomen: houd het model vast en ontwerp de context en tools eromheen. De kwaliteitseisen, procedures en goedkeuringsregels van een organisatie vallen buiten wat een algemeen model weet; de harness levert ze als repository-instructies, permission-regels en acceptatiechecks.
Neem drie uitkomsten die op het eerste gezicht op elkaar lijken:
| Bewijs aan het einde van de run | Beslissing van de harness | Waarom |
|---|---|---|
| Unittest slaagt; browserresultaat ontbreekt | Doorgaan of stoppen als onvolledig | Eén verplichte check heeft geen resultaat |
| Beide tests slagen, daarna bewerkt de agent een bestand | Beide checks opnieuw draaien | De vastgelegde passes horen bij een oudere snapshot |
| Beide tests slagen op dezelfde geïdentificeerde snapshot | Komt in aanmerking voor acceptatie | Het vereiste bewijs hoort bij de kandidaat |
“Komt in aanmerking” laat ruimte voor een menselijke goedkeuring of een andere verplichte regel; het laat het model niet zijn eigen werk certificeren. Een evaluator met verse context kan een visueel resultaat tegen een rubric beoordelen wanneer een exitcode het criterium niet kan uitdrukken. Vergelijk die evaluator met menselijke reviews voordat je hem over voltooiing laat beslissen. Hij kan een verplichte deterministische check niet vervangen.
Voor de research agent in deze serie zou een voorgestelde deterministische voltooiingsregel het rapportschema controleren en bevestigen dat de gevraagde tickers erin staan. Die checks kunnen niet vaststellen dat de analyse feitelijk klopt; daarvoor blijft bronnenreview nodig. Anthropic’s richtlijnen voor evaluatie raden voor coding-taken stabiele omgevingen en grondige tests aan, met menselijke kalibratie voor model-graders.
Waar elke regel wordt afgedwongen
De eis dat tests/checkout_discount.spec.ts slaagt, hoort in deterministische code, niet in de prompt. Een prompt kan het model eraan herinneren de test te draaien. Hij kan het model niet tegenhouden als het zonder bewijs succes meldt. Andere regels passen op andere plekken:
| Zet de regel in | Geschikt voor | Voorbeeld |
|---|---|---|
| Prompt of skill | Zoekvolgorde, codeconventies en planformaat | Lees AGENTS.md voordat je checkout-code bewerkt |
| Tool-grens | Argumentvalidatie, toegestane paden, goedkeuringen en tooltoegang | Sta schrijven alleen toe onder src/ |
| Deterministische code | Budgetten, timeouts, retries, exitcodes van tests en release-eisen | Houd de run open zolang de Playwright-test faalt |
| Evaluator met verse context | Visuele review of criteria die oordeel vragen | Vergelijk een gegenereerd diagram met een geschreven rubric |
De eerdere delen van deze serie beslissen elk één ding binnen die walkthrough:
| Eerder deel | Wat het voor deze beurt beslist | Waar het in de walkthrough werkt |
|---|---|---|
| Deel 2 — memory | Welke eerdere state in de prompt komt | Stap 1, de context builder |
| Deel 3 — tool use | Welke acties bestaan en hoe een gevalideerd resultaat eruitziet | De validatie in stap 3 en het resultaat in stap 4 |
| Deel 4 — security | Of deze specifieke call nu mag draaien | Stap 3, de padcontrole en goedkeuring |
| Deel 6 — dit artikel | Of het resulterende bewijs de run beëindigt | Stap 5 tot 7, de acceptatiechecks |
De tabel brengt verantwoordelijkheden in kaart, niet de uitvoeringsvolgorde. Deel 3 en 4 delen stap 3: dezelfde harness-code die een ongeldig argument weigert, weigert ook een call die is toegestaan maar nog niet goedgekeurd. Als validatie en autorisatie in aparte services draaien, geef de gevalideerde argumenten dan over die grens door, zodat de autorisatiebeslissing geldt voor de call die daadwerkelijk wordt uitgevoerd.
Behandel een timeout als een onbekende uitkomst
De kortingswijziging is lokaal en de tests ervan kunnen opnieuw draaien. Een betaalmigratie in dezelfde fictieve winkel brengt een ander probleem mee. Stel dat de agent create_test_order aanroept op een staging-service en de call een timeout krijgt. De service heeft de order misschien al aangemaakt, ook al heeft de harness het antwoord nooit ontvangen. Blind opnieuw proberen kan een tweede order aanmaken.
De naam van de actie of een door het model gegenereerde tool-call-ID is niet genoeg om die te herstellen. Sla vóór de dispatch een operatie-ID op die van de applicatie is, samen met de goedgekeurde argumenten. De service moet retries voor die ID dedupliceren, of een status-lookup bieden waarmee de uitkomst te reconciliëren is. Gebruik na een herstart dezelfde ID voor dezelfde bedoelde order; een gewijzigd orderverzoek vraagt om een nieuwe beslissing. De richtlijnen van AWS voor idempotente APIs beschrijven de client-identifier en de server-side atomiciteit die dit veilig maken. Controleer hoe lang de provider keys bewaart: het contract van Stripe staat bijvoorbeeld toe dat ze na minstens 24 uur worden opgeschoond, dus een latere retry heeft reconciliatie nodig in plaats van een nieuwe verzending.
De figuur volgt één create_test_order-call met een timeout twee keer: eenmaal blind opnieuw verzonden en eenmaal opnieuw verzonden met de opgeslagen operatie-ID.
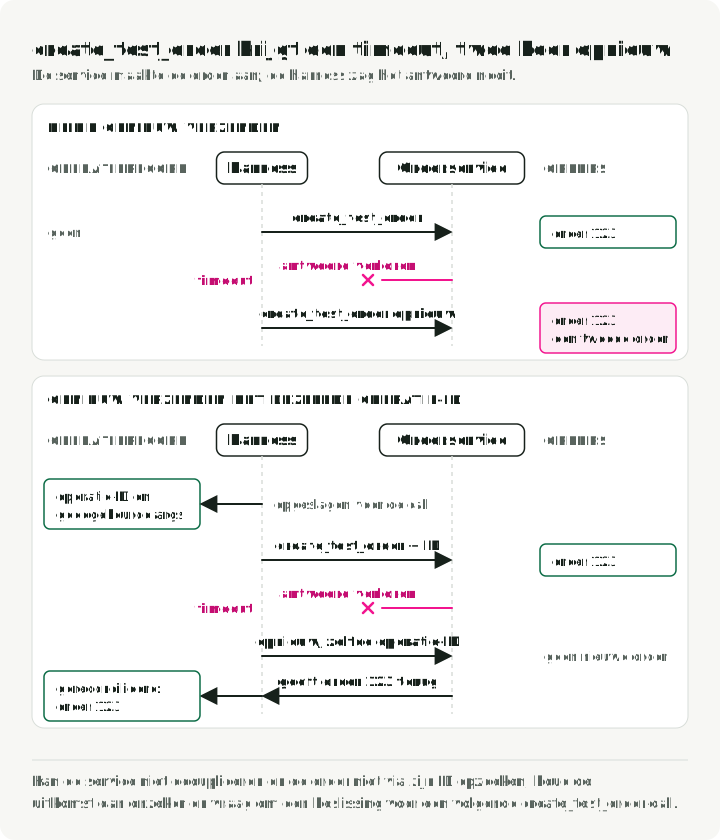
De harness kan deze beslissingen alleen zonder het model nemen als elke tool een expliciet contract heeft. Voor create_test_order bevat dat contract:
- gevalideerde argumenten, zodat ongeldige invoer vóór uitvoering wordt geweigerd;
- een gestructureerd resultaat zoals
{ "order_id": "123", "created": true }, zodat latere checks geen vrije tekst hoeven te parsen; - een effectcategorie: of de call alleen leest, of een bestand, record of externe service wijzigt, en of herhalen veilig is;
- een timeout- en retrybeleid, zodat een verloren antwoord geen onbeperkte reeks calls start;
- een permission-regel: orderstatus lezen mag automatisch, terwijl een order aanmaken bevestiging kan vereisen.
| Resultaat dat de harness ziet | Volgende actie |
|---|---|
Een read-only get_order_status-call geeft 503 terug | Binnen een limiet opnieuw proberen als die lookup veilig herhaald kan worden |
create_test_order krijgt een timeout; de lookup vindt de order onder zijn operatie-ID | De bestaande order gebruiken en het gereconcilieerde resultaat vastleggen |
create_test_order krijgt een timeout; de service kan niet dedupliceren of status controleren | De uitkomst als onzeker laten en om een beslissing vragen vóór een nieuwe aanmaak |
Die laatste toestand moet een crash van de worker overleven. “Mislukt” noemen zou onjuist zijn: de order bestaat misschien. Het duurzame operatierecord bevat de goedgekeurde payload, de operatie-ID, de dispatchstatus, het serverresultaat of de status-lookup, en eventuele goedkeuring. De trace helpt dat record te vinden; het transcript laat alleen zien wat het model zag.
Een toolbeschrijving helpt het model een actie te kiezen. Ze verleent geen permission en bewijst niet dat een retry veilig is. Als de orderservice via MCP beschikbaar is, moet de client nog steeds zijn eigen validatie- en vertrouwensbeleid toepassen, en moet de server toegangscontrole afdwingen. De MCP-specificatie voor tools zegt dat clients annotaties over toolgedrag als onbetrouwbaar moeten behandelen, tenzij ze van een vertrouwde server komen. Een server die create_test_order als read-only beschrijft, maakt het daarmee niet read-only. De specificatie schrijft geen enkele vertrouwensinstelling voor, dus schrijf voor je deployment een expliciet beleid dat vastlegt welke servermetadata permission- of retrybeslissingen mag beïnvloeden.
MCP heeft ook een standaardmanier om een langlopende call in handen te houden. Met de officiële Tasks-extensie kan een server op tools/call antwoorden met een taak-handle in plaats van een eindresultaat. De client pollt dan met tasks/get of stopt het werk met tasks/cancel. De Tasks-specificatie zegt dat clients taak-ID’s zouden moeten bewaren, zodat het pollen na een crash kan worden hervat; sla het taak-ID daarom op in hetzelfde operatierecord. Een taak met status completed betekent niet dat de tool is geslaagd: een tool result met isError: true voltooit de taak toch, en alleen een protocolfout zet haar op failed. Client en server onderhandelen de ondersteuning bij elk verzoek, dus controleer of beide kanten het implementeren voordat je erop vertrouwt.
Draag voortgang over aan de volgende session
Nu moet de fictieve agent de checkout migreren van betaaladapter v1 naar v2. Hij heeft de handler en de client gewijzigd, een lokale betaal-sandbox gestart en tests/payment_migration.spec.ts falend achtergelaten. De taak duurt langer dan één session van het model. Een samenvatting van het oude gesprek kan zeggen dat de sandbox draait, ook nadat het proces is gestopt.
De volgende session heeft drie verschillende soorten state nodig:
| State | Wat de volgende session moet controleren |
|---|---|
| Gesprek | Het verzoek, de beslissingen en relevante tool results |
| Workspace en runtime | Huidige bestanden, branch, processen en testomgeving |
| Taakvoortgang | Voltooide checks, openstaande goedkeuring of onzekere write, en volgende actie |
Compaction vervangt oudere berichten door een kortere samenvatting, zodat de huidige session kan doorgaan. Een voortgangs-handoff is document memory voor de volgende session. Als het oude gesprek verouderde aannames bevat, kan de harness een nieuwe session starten met de handoff en de huidige workspace; een gecrashte worker vervangen en zijn processen herstellen is een aparte taak van de runtime.
Een checkpoint kan de uitvoeringsstate bewaren, maar bewijst niet dat een externe betaaloperatie is gecommit of dat een proces nog draait. Een voortgangs-handoff helpt wanneer de volgende context van het model geen bruikbare taakstatus heeft. Leg de branch, gewijzigde bestanden, het laatste commando en resultaat, openstaande operatie-ID’s en de volgende onopgeloste stap vast. Controleer bij hervatten die beweringen tegen de live workspace en service voordat je handelt. Anthropic’s experimenten met langlopende coding agents gebruikten git-geschiedenis en een voortgangsbestand om latere sessions werk te laten herstellen. Anthropic’s latere rapport over harness-ontwerp merkt op dat handoffs orchestration, tokens en doorlooptijd toevoegen.
De handoff moet conditioneel zijn. Een kleine wijziging die in één session klaar is, heeft er geen nodig. Zelfs een lange taak heeft misschien geen extra bestand nodig als het checkpoint de vereiste voortgang al bevat en de volgende session die kan gebruiken. Controleer of een hervatte session voltooid werk herhaalt, een openstaande write mist of op een verouderde omgeving handelt. Vul de ontbrekende state aan in plaats van standaard een samenvatting toe te voegen.
Diagnosticeer de fout voordat je een component toevoegt
De drie gevallen hierboven leveren verschillende traces op: een ontbrekende acceptatietest, een onzekere externe write en herhaald werk na hervatten. Hun oplossingen horen op verschillende plekken. Een browserresultaat dat in het acceptatierecord ontbreekt, vraagt om een verplichte voltooiingscheck. Een onzekere order vraagt om server-side deduplicatie of reconciliatie. Een herhaalde bewerking na een nieuwe session vraagt om bruikbare voortgangsstate.
Leg voor de volgende run de taak- en harness-versie vast, plus de voorgestelde actie, goedkeuring, het tool result, de geteste snapshot, het acceptatieresultaat, latency en kosten. Noteer het aantal input-tokens apart van de gefactureerde invoerkosten, inclusief gecachete reads: twee harnesses die zich identiek gedragen, kunnen verschillend factureren, afhankelijk van hoe elk zijn verzoek samenstelt en of de cache van de provider warm was. Houd secrets en onnodige persoonsgegevens uit traces. Koppel externe operatierecords via hun ID, want een timeout aan de clientkant kan niet laten zien wat de server deed. Schrijf bij een terugkerende fout een regressiecase die hem reproduceert. AI Agent Evaluation in Production werkt dat proces van trace naar test uit.
Elk herhaald symptoom suggereert een kleine wijziging en een meting die laat zien of die hielp:
| Herhaald symptoom | Kleine wijziging om te proberen | Wat te meten |
|---|---|---|
| Read-only lookups falen tijdelijk | Begrensde retry met backoff | Herstelpercentage, extra calls, doorlooptijd |
| Hervatte sessions herhalen voltooid werk | Gestructureerde voortgangs-handoff | Dubbele tool-acties na hervatten |
| Verplichte tests ontbreken bij voltooiing | Voltooiing weigeren tot elke verplichte check slaagt | Taken geaccepteerd zonder alle verplichte checks |
| Visuele defecten overleven deterministische checks | Evaluator met verse context en een rubric | Gevonden defecten, onterechte afwijzingen, reviewtijd |
| De agent bewerkt buiten zijn bereik | Nauwere tool-permission | Geblokkeerde calls en handmatige overrides |
| Opgehaald memory verdringt de huidige taak | Opgehaalde feiten begrenzen; rangschikken vóór injectie | Tokens besteed aan recall, voltooide taken, kosten |
| Een genoemde regel of status bereikt het model nooit | Het samengestelde verzoek vastleggen voordat de call vertrekt | Verzoeken zonder de regel; rondes tot ze weer verschijnt |
Benoem vóór het toevoegen van een retrybeleid, handoff of evaluator de fout die het moet veranderen en de metric die verbetering zou aantonen. Tel ook de kosten mee: meer geaccepteerde taken zijn niet nuttig als de extra calls de reviewtijd verdubbelen of dubbele orders aanmaken. Autorisatie, isolatie, privacyregels en verplichte acceptatiechecks zijn vereisten; een kleine benchmark voor succes is geen reden om ze te verwijderen. Test die beperkingen met expliciete verboden gevallen.
Meet één optionele wijziging tegelijk
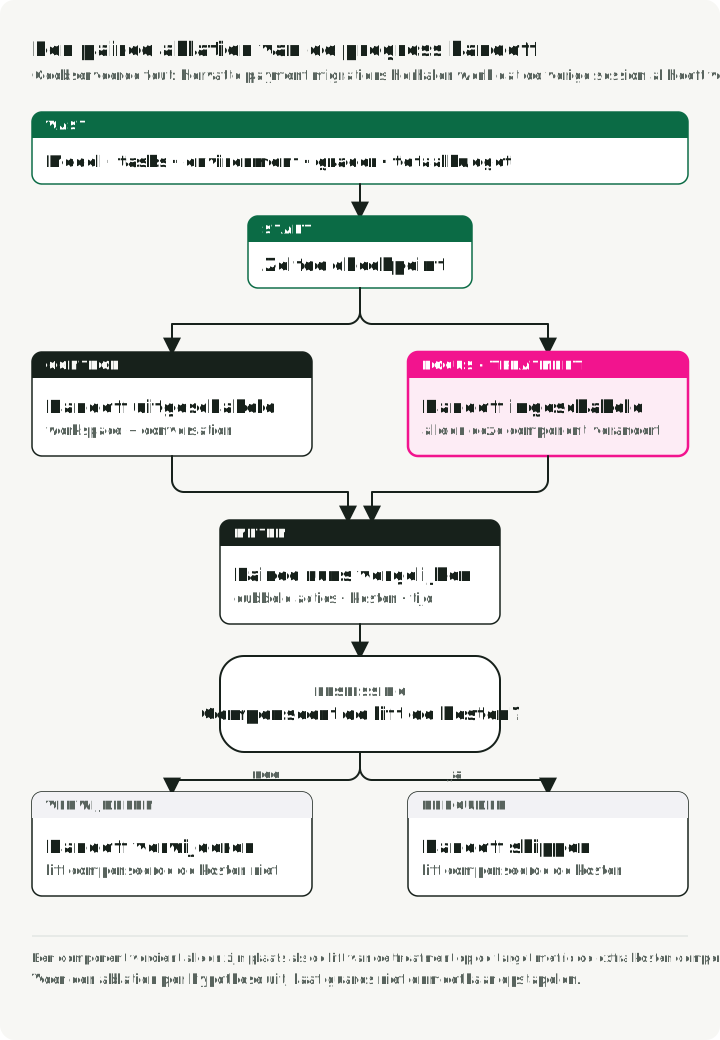
Een ablation vergelijkt een harness met en zonder één component, terwijl de rest van het experiment gelijk blijft. Gebruik dit protocol:
- Bevries de versie van het model en het provider-endpoint, taakinstanties, de omgeving en de rekenlimieten ervan, grader en de prompts buiten het geteste component. Resourcelimieten alleen kunnen de score van een benchmark voor agents veranderen; het evals-artikel behandelt de meting van Anthropic.
- Geef beide varianten hetzelfde totale budget aan tokens, tijd en dollars.
- Kies het aantal trials of de stopregel voordat je de vergelijking draait.
- Draai dezelfde taakinstanties in beide varianten en herhaal elke taak, omdat de output van het model varieert.
- Rapporteer het gemiddelde met de spreiding of het betrouwbaarheidsinterval.
- Tel elke gestarte trial mee, inclusief timeouts, stops door beleid, crashes van de harness en fouten van de evaluator.
Voor de betaalmigratie is de optionele voortgangs-handoff een kandidaat. Start elk control–treatment-paar vanaf dezelfde repository-commit en hetzelfde checkpoint met seed-data, met de handoff als enige schakelaar.
De primaire maat kan het aantal dubbele tool-acties na hervatten zijn: een operatie op een artefact dat de vorige session al had afgerond. Rapporteer ook geaccepteerde taken, ontsnapte defecten, doorlooptijd, kosten van model en evaluator, en reviewminuten. Kies het aantal trials en de stopregel vooraf en rapporteer daarna de variatie, niet alleen het gemiddelde. Als de handoff duplicaten vermindert maar meer kost dan hij oplevert, is dat een nuttig negatief resultaat.
Het SWE-agent-paper geeft een afgebakend voorbeeld van interface-ablation. Met GPT-4 Turbo op de SWE-bench Lite-split van 300 taken en een limiet van $4 per taak veranderde het één interface-feature per keer:
| Interfacewijziging | Opgelost |
|---|---|
| Volledige SWE-agent-interface (referentie) | 18.0% |
| Editor zonder linting | 15.0% |
| Volledig bestand in plaats van een viewer van 100 regels | 12.7% |
| Volledige observatiegeschiedenis in plaats van de laatste vijf | 15.0% |
Dit zijn resultaten voor dat model en die benchmark, geen verwachte winst voor deze fictieve winkel. Wat overdraagbaar is, is de methode: test een benoemde interfacekeuze onder een vaste opzet en rapporteer de omstandigheden bij het getal.
Gebundelde vergelijkingen komen vaak voor, en ze kunnen de wijziging die hielp niet aanwijzen. LangChain rapporteert voor deepagents-cli een winst op Terminal-Bench 2.0 van 52.8% naar 66.5% met een vast model, nadat de system prompt, tools en middleware tegelijk waren veranderd. OpenAI’s ARC-AGI-3-rapport laat het omgekeerde risico zien: een score verdrievoudigde bijna toen de harness reasoning behield en compaction gebruikte, twee API-instellingen die tegelijk veranderden. Leg de API, het behoud van reasoning, het compaction-beleid en de budgetten vast samen met de ID van het model; anders kan een schijnbare regressie van het model een ontbrekende capability in de adapter zijn.
Door één wijziging tegelijk te testen vang je ook wijzigingen die te klein lijken om uit te maken. Anthropic’s postmortem over Claude Code van april 2026 meldt dat de API niet was geraakt, maar dat drie wijzigingen in de productlaag de kwaliteit verlaagden: een lagere standaard reasoning-inspanning, een bug die na een inactieve session bij elke beurt eerdere reasoning wiste, en een regel in de system prompt die de tekst tussen tool calls beperkte. Toen Anthropic een ablatie van die ene regel deed op een bredere set evals, liet een daarvan een daling van 3% zien voor zowel Opus 4.6 als Opus 4.7. Een regel in een prompt of een standaardinstelling is een harness-wijziging; test haar zo.
Valideer componenten opnieuw wanneer het model verandert. Anthropic’s rapport over langlopende applicaties is een kwalitatieve case study: toen Opus 4.6 uitkwam, verwijderde het team harness-componenten één voor één en ontdekte dat evaluator-calls overhead werden bij taken die het model nu alleen afrondde, terwijl ze nog steeds hielpen bij taken aan de grens van zijn kunnen.
Neem een safety stop van de provider op in de foutensuite: die moet de dispatch stoppen en naar review gaan, niet opnieuw proberen. Deel 4 behandelt de details.
Probeer de vergelijking in het bijbehorende lab
Het harness-demo-project op commit 517353f3 maakt de ablation-regel uitvoerbaar. De twaalf generieke synthetische taken, zoals fix-parser-edge-case, split-large-module en wire-browser-test, declareren elk een moeilijkheidsgraad en vier condities: een onbetrouwbare tool, verloren voortgang, een gemist gat in de implementatie en onduidelijke voltooiing. De simulator leidt een vijfde af voor moeilijke taken die ook een voortgangsbestand nodig hebben: zonder context_reset behoudt compaction verouderde aannames. Een pure functie markeert een taak als geslaagd wanneer de gekozen configuratie elke toepasselijke conditie afhandelt. Er is geen model, geen externe tool en geen echte coding-taak. De uitkomsten en token-aantallen zijn gesimuleerde lesdata, geen bewijs dat een harness met vijf componenten een live agent verbetert.
Clone de vastgepinde revisie en draai de checks en de simulatie met uv geïnstalleerd:
git clone https://github.com/slavadubrov/harness-demo.git
cd harness-demo
git checkout 517353f3a47541d66099983170fe90812b6ef23b
make check
make run
make failures
make check draait Ruff en zeven unittests, waaronder een test die een vergelijking weigert waarin twee componenten veranderen. make run print een cumulatieve lesmatrix en vijf leave-one-component-out-paren. make failures benoemt elke gesimuleerde fout; de volledige configuratie eindigt met all synthetic tasks pass.
| Component teruggezet in de volledige configuratie | Zonder | Met |
|---|---|---|
| Retrybeleid | 8/12 | 12/12 |
| Voortgangs-handoff | 7/12 | 12/12 |
| Verse evaluator | 8/12 | 12/12 |
| Fail-closed acceptatie | 7/12 | 12/12 |
| Context reset | 10/12 | 12/12 |
De rijen zijn deterministische gevolgen van de taakflags en de grader-code. Het zijn geen schattingen van een effectgrootte in een live systeem. De eerdere cumulatieve matrix voegt meerdere componenten toe in één overgang en kan niet aanwijzen welke de verandering veroorzaakte.
De model.py van het lab voorkomt dat een gebundelde wijziging een ablation wordt genoemd: het vergelijkt elk componentveld van een paar, en de regressietest levert een ongeldig paar aan waarin zowel retry als evaluator veranderd zijn. Deze zelfstandige versie van de controle draait op één geldig paar voor de voortgangs-handoff:
from dataclasses import dataclass, fields

@dataclass(frozen=True)
class Config:
    progress_handoff: bool = False
    evaluator: bool = False
    retry_policy: bool = False
    fail_closed_acceptance: bool = False
    context_reset: bool = False

def changed_components(control: Config, treatment: Config) -> tuple[str, ...]:
    return tuple(
        field.name
        for field in fields(control)
        if getattr(control, field.name) != getattr(treatment, field.name)
    )

control = Config(progress_handoff=False, evaluator=True, retry_policy=True)
treatment = Config(progress_handoff=True, evaluator=True, retry_policy=True)
assert changed_components(control, treatment) == ("progress_handoff",)
Om de methode naar een live project over te brengen, vervang je de synthetische taakflags door een geversioneerde taaksuite en de gesimuleerde token-aantallen door metingen uit traces. Houd de acceptatieregels buiten de controle van de kandidaat. Een vast model alleen is geen gecontroleerde vergelijking als prompts, testdata, permissions of de reasoning- en compaction-instellingen van de API ook veranderd zijn.
Vind de code achter een gedrag
Een harness die zijn ablations doorstaat, kan nog steeds het model overleven waarvoor hij is afgesteld, en om hem later te wijzigen heb je de code nodig die een gedrag implementeert. Een verzoek als “maskeer secrets in elk capture-pad” noemt een gedrag, geen bestand. In een productie-harness kan dat gedrag meerdere uitvoeringsfasen en gedeelde state omvatten.
Een preprint uit 2026 van Wang et al. stelt voor deze zoektocht een Harness Handbook voor, wat het paper behavior localization noemt. Statische analyse haalt een programmagraaf op, een LLM groepeert de eenheden daarvan in uitvoeringsfasen, en een maintainer of coding agent daalt af van een systeemoverzicht naar op de broncode gebaseerde entries voor een functie of bestand. Elke entry moet te herleiden zijn tot de live repository en wordt na elke wijziging opnieuw gesynchroniseerd.
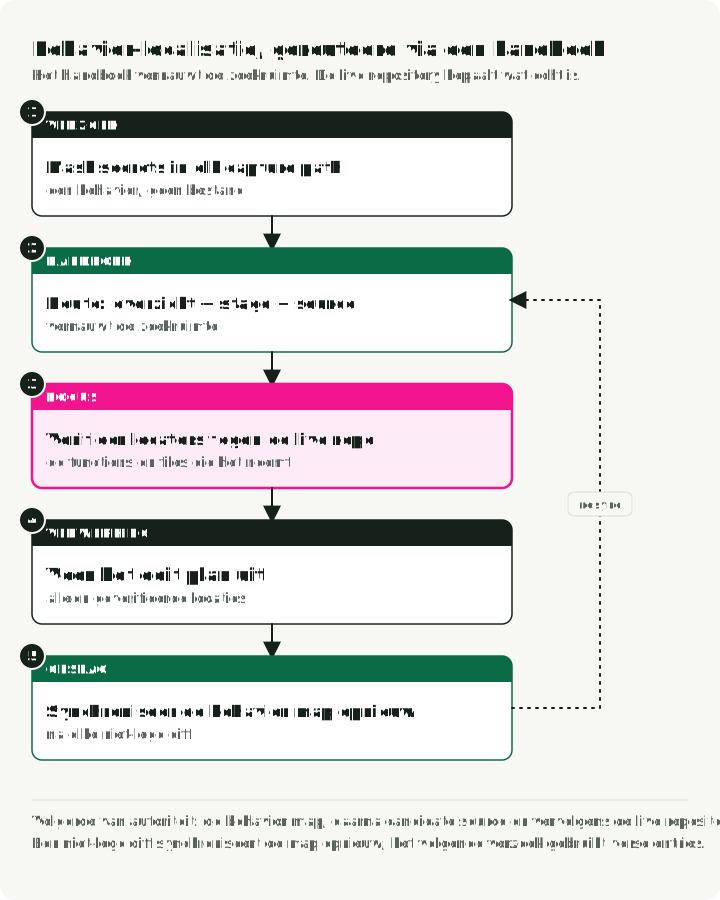
Op twee open-source systemen met een harness produceerde een planner die via het handbook routeerde bewerkingsplannen die judges vaker verkozen, met minder tokens. De studie beoordeelde plannen in plaats van uitgevoerde wijzigingen en rapporteerde geen onzekerheid, dus behandel het als een aanpak in onderzoeksfase.
Gebruik de fout om de eigenaar te vinden
Deze serie bouwde vanaf de reasoning loop naar buiten. Wanneer een run faalt, zoek dan de eerste verantwoordelijkheid die het kan voorkomen of detecteren:
| Wat er gebeurde | Onderzoek |
|---|---|
| Slechte volgende stap terwijl de juiste informatie beschikbaar was | Model en reasoning loop |
| Een eerdere beslissing kwijt of voltooid werk herhaald | Contextopbouw en memory |
| Kon een actie niet uitdrukken of het resultaat niet lezen | Toolcontract |
| Voerde een verboden actie uit | Permission-check en de afdwingende service |
| Worker crashte en zijn omgeving verdween | Runtime en checkpoint |
| Meldde succes zonder het vereiste bewijs | Acceptatieregel van de harness en geteste snapshot |
Ik zou beginnen met één capabel model, tools met een beperkt bereik, een sandbox en één expliciete acceptatiecheck. Leg de eerste fout vast, voeg de kleinste controle toe die hem aanpakt en vergelijk met die controle uitgeschakeld. Houd de regel en de trace bij elkaar, zodat de volgende upgrade van het model je een reden geeft om het component te houden of te verwijderen. Leg voor elk component vast wie het onderhoudt, hoeveel tokens of seconden het toevoegt en welke regressietest het verwijderen zou rechtvaardigen. Zes maanden later moet iemand die progress_handoff=True ziet de mislukte traces kunnen vinden die het rechtvaardigden, en de regressiecases die het er nog steeds houden.
Referenties
- OpenAI, Unrolling the Codex agent loop.
- OpenAI, Harness engineering: leveraging Codex in an agent-first world.
- Anthropic Engineering, Demystifying evals for AI agents.
- Anthropic Engineering, Effective harnesses for long-running agents.
- Anthropic Engineering, Harness design for long-running application development.
- Lopopolo, Harness engineering: anthology, field guide, and agent context bundle.
- LangChain, Improving Deep Agents with harness engineering.
- OpenAI, How two settings tripled our ARC-AGI-3 scores.
- Wang et al., Harness Handbook: Making Evolving Agent Harnesses Readable, Navigable, and Editable, arXiv:2607.13285, 2026.
- Stripe, Idempotent requests.
- Yang et al., SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering.
- AWS, Making retries safe with idempotent APIs.
- Model Context Protocol, Tools specification.
- Model Context Protocol, Tasks extension en Tasks specification.
- Anthropic Engineering, An update on recent Claude Code quality reports.
De Market Analyst Agent-code van de serie staat op GitHub.