Harness engineering pour les agents AI : vérifier l’achèvement

Traduction automatique
Cet article a été traduit automatiquement depuis la version originale en anglais.
Un agent peut terminer son tour alors que le travail reste incomplet. Cet article s’adresse aux ingénieurs qui construisent ou évaluent des coding agents et doivent décider quand accepter un résultat, relancer une opération incertaine ou reprendre le travail dans une autre session. Il montre aussi comment mesurer si un composant supplémentaire du harness améliore suffisamment ces résultats pour justifier son coût.
Le harness est le code applicatif qui entoure le reasoning loop du modèle. Il fournit le contexte, vérifie les actions proposées, enregistre ce qui s’est passé et décide si les éléments probants suffisent pour terminer. Le runtime exécute les actions acceptées et maintient disponibles la session, le sandbox et le checkpoint. Les articles précédents expliquent le reasoning loop, la mémoire, les outils et les permissions. Ici, la question est de savoir ce que fait le harness après que le modèle a proposé une action ou déclaré « terminé ».
Les exemples de boutique et de paiement ci-dessous sont des cas pédagogiques fictifs. Le laboratoire associé est une simulation déterministe ; il ne mesure pas un coding agent réel.
Ce qui compte comme terminé
Supposons qu’on demande à un coding agent d’abaisser de $100 à $75 le seuil d’une remise automatique de 10 % dans le dépôt d’une boutique fictive. Il modifie src/checkout.py. Un panier de $80 doit désormais recevoir une remise de $8. La tâche comporte deux vérifications requises :
pytest tests/test_checkout.pyvérifie le calcul.pnpm playwright test tests/checkout_discount.spec.tsvérifie le résultat visible au checkout dans une boutique locale initialisée avec des données de test.
Une réponse finale plausible ne fait pas partie de ces vérifications. Le harness ne doit accepter qu’un candidat dont le snapshot testé complet est identifié et dont les deux vérifications requises ont réussi sur ce même snapshot. Un commit propre peut l’identifier ; sinon, utilisez un digest ou un manifeste qui inclut les fichiers non suivis pertinents. Gardez les tests hors du périmètre accessible en écriture à l’agent, ou faites approuver indépendamment leurs modifications avant l’évaluation.
C’est ici que le modèle, le harness et le runtime ont des rôles différents. Une implémentation peut en fusionner plusieurs dans un seul processus, mais leurs frontières de défaillance restent distinctes :
| Composant | Rôle | Exemple pour un coding agent |
|---|---|---|
| Modèle | Propose du texte, un tool call ou une réponse finale | Suggère une modification de src/checkout.py |
| Reasoning loop | Choisit la prochaine action à partir du contexte disponible | Inspecter, modifier, tester, inspecter à nouveau |
| Harness | Fournit le contexte, valide et autorise les propositions, dispatche les calls acceptés, enregistre les résultats, vérifie l’achèvement | Autorise les modifications sous src/ et exige les deux tests nommés |
| Runtime | Exécute les calls acceptés et maintient l’état en vie hors du processus worker | Journal de session, sandbox, stockage des checkpoints, backend de traces |
La présentation de la boucle de Codex d’OpenAI décrit le cycle : le harness assemble un prompt, demande au modèle la prochaine action, envoie un tool call accepté au runtime, ajoute le résultat et recommence jusqu’à accepter le résultat ou rendre la main à l’utilisateur. Pour la modification de la remise, un passage ressemble à ceci :
- Le context builder fournit la tâche, les instructions du dépôt, les fichiers pertinents, les tool results précédents et le plan courant.
- Le modèle propose un call
edit_fileavec un chemin et un texte de remplacement. - La frontière de l’outil valide les arguments, vérifie le chemin par rapport au périmètre autorisé et demande une approbation si l’opération l’exige.
- Le runtime applique la modification dans le sandbox et renvoie un résultat structuré.
- Le harness exécute
pytest tests/test_checkout.py, puispnpm playwright test tests/checkout_discount.spec.ts, et lit les deux codes de sortie. - Une vérification en échec devient un nouveau contexte pour le tour suivant du modèle ; deux vérifications réussies font de la modification une candidate à l’achèvement.
- Le harness enregistre durablement les commandes, les codes de sortie, le snapshot testé, le grader et les versions de l’environnement ; une trace peut pointer vers cet enregistrement.
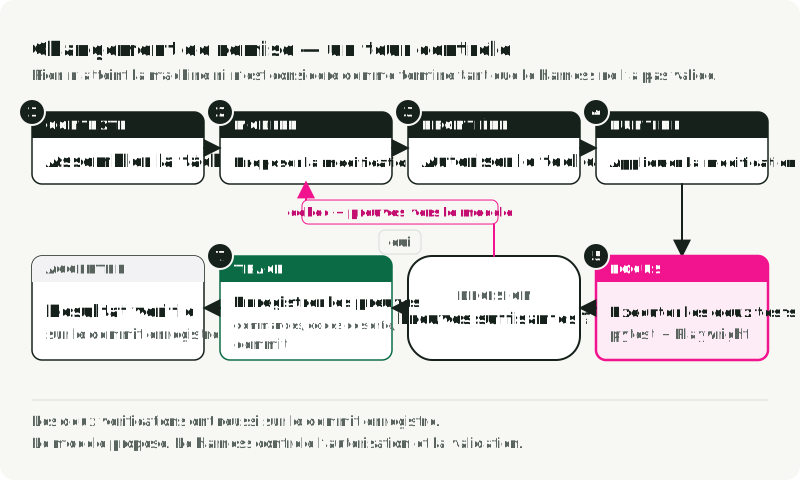
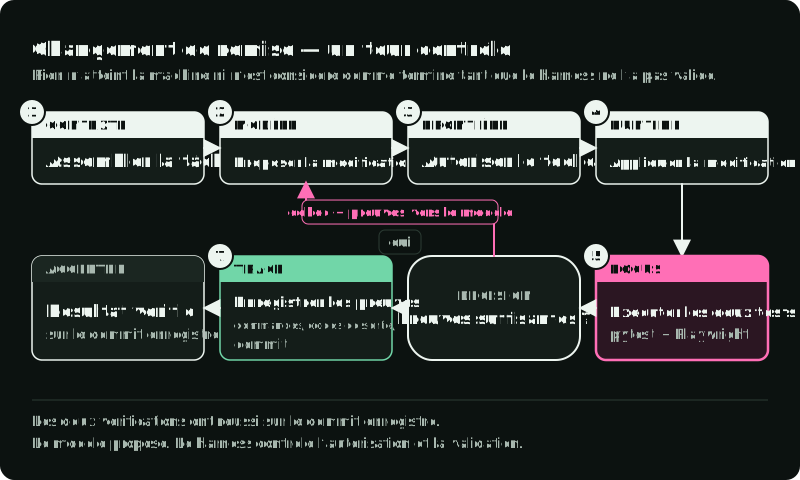
Après l’étape 2, aucun fichier n’a changé. Le harness peut encore rejeter ../../secrets.env, exiger une approbation pour une commande destructrice ou arrêter une exécution qui a épuisé son budget. Après l’étape 5, le harness lit lui-même les codes de sortie : le modèle ne peut donc pas déclarer que sa propre modification réussit.
Un enregistrement d’achèvement pour cette tâche doit contenir le snapshot candidat, les deux commandes et leurs codes de sortie, ainsi que les versions de l’environnement de test et du grader. Il doit être durable et hors du contrôle du candidat. Une trace peut relier la proposition, le call approuvé, le résultat du runtime et l’enregistrement d’acceptation pour le diagnostic. Une trace seule n’est pas la décision d’acceptation.
Une trace ne contient pas non plus nécessairement la demande. Elle peut enregistrer le document source ou un événement de middleware sans montrer ce que contenait finalement la demande assemblée. Si vous devez établir ce que le modèle a reçu, capturez-le au dernier point avant que le call ne parte, après chaque transformation.
L’étude de cas sur le harness engineering d’OpenAI décrit une application démarrable par worktree, avec accès au navigateur, aux logs, aux métriques et aux traces. Cette configuration a rendu un objectif de latence sur un parcours utilisateur inspectable par l’agent. Elle illustre le prérequis d’une règle d’acceptation : l’application et les signaux pertinents doivent être disponibles dans l’environnement de test. Lopopolo, l’auteur de cette étude de cas, tient un guide pratique du harness engineering qui repose sur les deux mêmes leviers : garder le modèle fixe, et concevoir le contexte et les outils qui l’entourent. Le niveau de qualité d’une organisation, ses procédures et ses règles d’approbation se situent hors de ce que sait un modèle généraliste ; le harness les fournit sous forme d’instructions de dépôt, de règles de permission et de vérifications d’acceptation.
Considérons trois résultats qui se ressemblent en apparence :
| Éléments probants à la fin de l’exécution | Décision du harness | Pourquoi |
|---|---|---|
| Le test unitaire réussit ; le résultat navigateur manque | Continuer ou arrêter comme incomplet | Une vérification requise n’a aucun résultat |
| Les deux tests réussissent, puis l’agent modifie un fichier | Relancer les deux vérifications | Les réussites enregistrées appartiennent à un snapshot plus ancien |
| Les deux tests réussissent sur le même snapshot identifié | Éligible à l’acceptation | Les éléments probants requis correspondent au candidat |
« Éligible » laisse de la place à une approbation humaine ou à une autre règle requise ; cela ne permet pas au modèle de certifier son propre travail. Un évaluateur avec un contexte neuf peut examiner un résultat visuel à l’aide d’une grille lorsqu’un code de sortie ne peut pas exprimer le critère. Comparez cet évaluateur à des revues humaines avant de lui permettre de décider de l’achèvement. Il ne peut pas remplacer une vérification déterministe requise.
Pour l’agent de recherche de cette série, une règle d’achèvement déterministe proposée vérifierait le schéma du rapport et confirmerait que les tickers demandés y figurent. Ces vérifications ne peuvent pas établir que l’analyse est factuellement correcte ; cela exige toujours une revue des sources. Le guide d’évaluation d’Anthropic recommande des environnements stables et des tests approfondis pour les tâches de code, avec une calibration humaine pour les graders basés sur un modèle.
Où chaque règle est appliquée
L’exigence que tests/checkout_discount.spec.ts réussisse relève du code déterministe, pas du prompt. Un prompt peut rappeler au modèle d’exécuter le test. Il ne peut pas empêcher le modèle de déclarer un succès sans éléments probants. D’autres règles ont leur place ailleurs :
| Placer la règle dans | Adapté à | Exemple |
|---|---|---|
| Prompt ou skill | Ordre de recherche, conventions de code et format du plan | Lire AGENTS.md avant de modifier le code du checkout |
| Frontière de l’outil | Validation des arguments, chemins autorisés, approbations et accès aux outils | N’autoriser les écritures que sous src/ |
| Code déterministe | Budgets, timeouts, retries, codes de sortie des tests et exigences de release | Garder l’exécution ouverte tant que le test Playwright échoue |
| Évaluateur avec un contexte neuf | Revue visuelle ou critères qui demandent du jugement | Comparer un diagramme généré à une grille écrite |
Les parties précédentes de cette série décident chacune d’un point de ce déroulé :
| Partie précédente | Ce qu’elle décide pour ce tour | Où elle agit dans le déroulé |
|---|---|---|
| Partie 2 — mémoire | Quel état antérieur entre dans le prompt | Étape 1, le context builder |
| Partie 3 — tool use | Quelles actions existent et à quoi ressemble un résultat validé | La validation de l’étape 3 et le résultat de l’étape 4 |
| Partie 4 — sécurité | Si ce call précis peut s’exécuter maintenant | Étape 3, la vérification du chemin et l’approbation |
| Partie 6 — cet article | Si les éléments probants obtenus mettent fin à l’exécution | Étapes 5 à 7, les vérifications d’acceptation |
Le tableau représente des responsabilités, pas un ordre d’exécution. Les parties 3 et 4 partagent l’étape 3 : le même code du harness qui rejette un argument mal formé rejette aussi un call autorisé mais pas encore approuvé. Si la validation et l’autorisation s’exécutent dans des services distincts, transmettez les arguments validés à travers cette frontière afin que la décision d’autorisation s’applique au call qui sera exécuté.
Traiter un timeout comme un résultat inconnu
La modification de la remise est locale et ses tests peuvent être relancés. Une migration de paiement dans la même boutique fictive pose un problème différent. Supposons que l’agent appelle create_test_order sur un service de staging et que le call expire. Le service a peut-être créé la commande même si le harness n’a jamais reçu sa réponse. Un retry aveugle peut créer une seconde commande.
Le nom de l’action ou un identifiant de tool call généré par le modèle ne suffit pas pour la récupérer. Avant le dispatch, persistez un identifiant d’opération détenu par l’application avec les arguments approuvés. Le service doit dédupliquer les retries pour cet identifiant, ou fournir une lookup de statut capable de réconcilier le résultat. Réutilisez le même identifiant pour la même commande prévue après un redémarrage ; une demande de commande modifiée nécessite une nouvelle décision. Le guide AWS sur les API idempotentes décrit l’identifiant client et l’atomicité côté serveur nécessaires pour rendre cela sûr. Vérifiez combien de temps le fournisseur conserve les clés : le contrat de Stripe, par exemple, autorise leur suppression après au moins 24 heures ; un retry plus tardif exige donc une réconciliation plutôt qu’un nouvel envoi.
La figure suit un call create_test_order expiré, deux fois : renvoyé à l’aveugle, puis renvoyé avec l’identifiant d’opération enregistré.
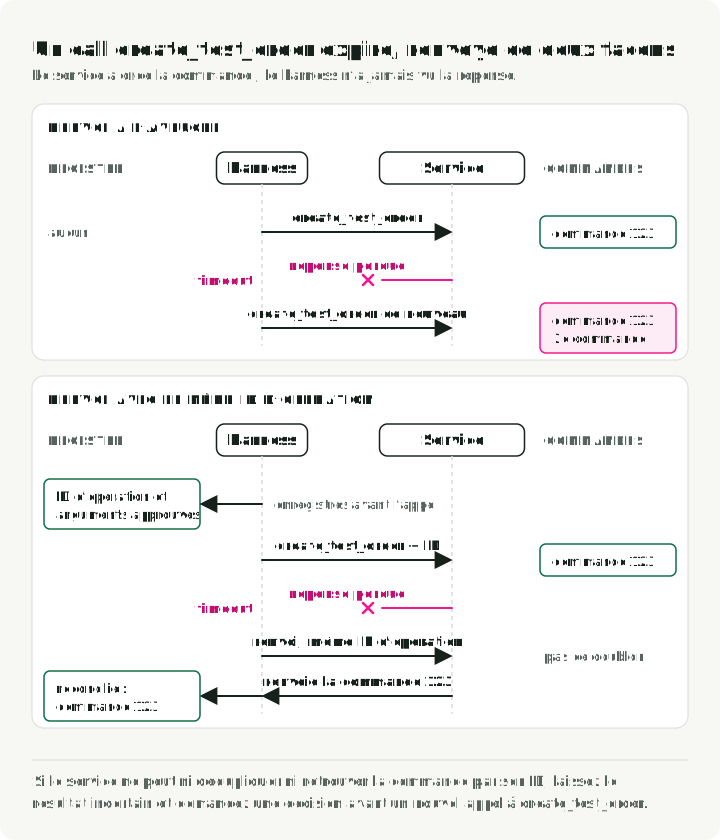
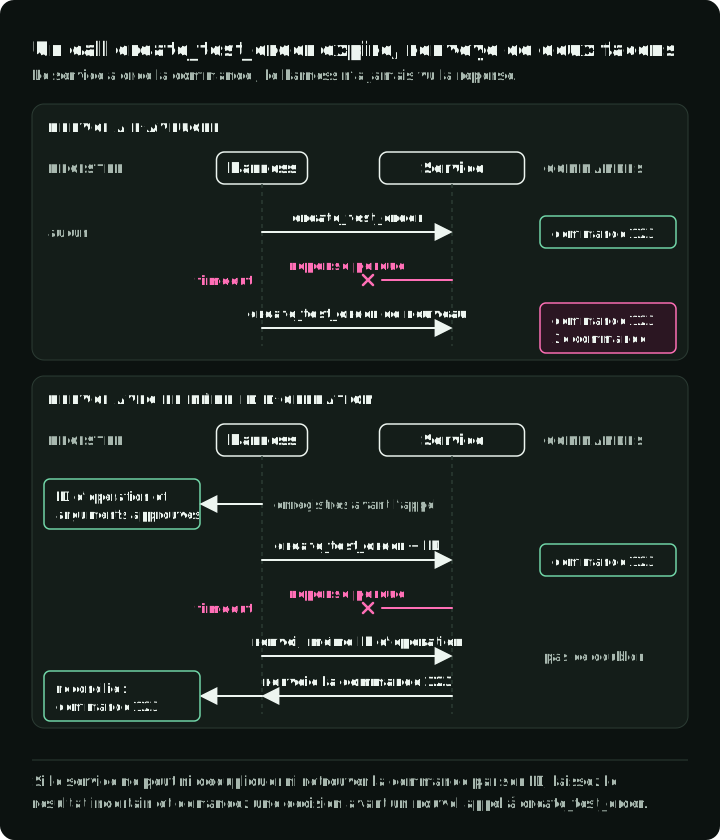
Le harness ne peut prendre ces décisions sans interroger le modèle que si chaque outil possède un contrat explicite. Pour create_test_order, ce contrat comprend :
- des arguments validés, afin que les entrées mal formées soient rejetées avant l’exécution ;
- un résultat structuré tel que
{ "order_id": "123", "created": true }, afin que les vérifications ultérieures n’analysent pas du texte libre ; - une catégorie d’effet : si le call se contente de lire, ou s’il modifie un fichier, un enregistrement ou un service externe, et s’il est sûr de le répéter ;
- un timeout et une politique de retry, afin qu’une réponse perdue ne déclenche pas une série illimitée de calls ;
- une règle de permission : la lecture du statut d’une commande peut s’exécuter automatiquement, tandis que la création d’une commande peut nécessiter une confirmation.
| Résultat observé par le harness | Action suivante |
|---|---|
Un call read-only get_order_status renvoie 503 | Retenter dans une limite si cette lookup peut être répétée sans risque |
create_test_order expire ; la lookup trouve la commande sous son identifiant d’opération | Utiliser la commande existante et enregistrer le résultat réconcilié |
create_test_order expire ; le service ne peut ni dédupliquer ni vérifier le statut | Laisser le résultat incertain et demander une décision avant toute nouvelle création |
Ce dernier état doit survivre à un crash du worker. Le qualifier d’« échec » serait faux : la commande existe peut-être. L’enregistrement durable de l’opération doit contenir le payload approuvé, l’identifiant d’opération, le statut du dispatch, le résultat du serveur ou de la lookup de statut, et toute approbation. La trace aide à retrouver cet enregistrement ; le transcript montre seulement ce que le modèle a vu.
Une description d’outil aide le modèle à choisir une action. Elle n’accorde aucune permission et ne prouve pas qu’un retry est sûr. Si le service de commandes est exposé via MCP, le client doit tout de même appliquer sa propre validation et sa propre politique de confiance, et le serveur doit appliquer les contrôles d’accès. La spécification des outils MCP indique que les clients doivent traiter les annotations de comportement des outils comme non fiables, sauf si elles proviennent d’un serveur de confiance. Un serveur qui décrit create_test_order comme read-only ne peut pas le rendre tel. La spécification n’impose pas de paramètre de confiance unique ; écrivez donc une politique explicite pour votre déploiement, qui précise quelles métadonnées du serveur peuvent influencer les décisions de permission ou de retry.
MCP propose aussi un moyen standard de garder la main sur un appel de longue durée. Avec l’extension Tasks officielle, un serveur peut répondre à tools/call par un handle de tâche au lieu d’un résultat final. Le client interroge ensuite la tâche avec tasks/get ou arrête le travail avec tasks/cancel. La spécification de Tasks indique que les clients devraient persister les identifiants de tâche pour pouvoir reprendre l’interrogation après un crash ; stockez donc l’identifiant de tâche dans le même enregistrement d’opération. Une tâche completed ne signifie pas que l’outil a réussi : un tool result avec isError: true termine quand même la tâche, et seule une erreur de protocole la fait passer à failed. Client et serveur négocient la prise en charge à chaque requête ; vérifiez donc que les deux côtés l’implémentent avant de vous y fier.
Transmettre la progression à la session suivante
L’agent fictif doit maintenant migrer le checkout de l’adapter de paiement v1 vers v2. Il a modifié le handler et le client, démarré un sandbox de paiement local et laissé tests/payment_migration.spec.ts en échec. La tâche dépasse une seule session de modèle. Un résumé de l’ancienne conversation peut indiquer que le sandbox tourne alors que le processus s’est arrêté.
La session suivante a besoin de trois types d’état différents :
| État | Ce que la session suivante doit vérifier |
|---|---|
| Conversation | La demande, les décisions et les tool results pertinents |
| Workspace et runtime | Fichiers actuels, branche, processus et environnement de test |
| Progression de la tâche | Vérifications terminées, approbation en attente ou écriture incertaine, et action suivante |
La compaction remplace les anciens messages par un résumé plus court afin que la session actuelle puisse continuer. Un progress handoff est une mémoire documentaire destinée à la session suivante. Si l’ancienne conversation contient des hypothèses obsolètes, le harness peut démarrer une nouvelle session avec le handoff et le workspace courant ; remplacer un worker crashé et restaurer ses processus est une tâche distincte du runtime.
Un checkpoint peut préserver l’état d’exécution, mais il ne prouve pas qu’une opération de paiement externe a été validée ni qu’un processus tourne encore. Un progress handoff aide lorsque le contexte du modèle suivant ne dispose pas d’un statut de tâche exploitable. Enregistrez la branche, les fichiers modifiés, la dernière commande et son résultat, les identifiants d’opération en attente et la prochaine étape non résolue. À la reprise, vérifiez ces affirmations par rapport au workspace et au service réels avant d’agir. Les expériences d’Anthropic avec des coding agents de longue durée utilisaient l’historique Git et un fichier de progression pour aider les sessions suivantes à récupérer le travail. Le rapport ultérieur d’Anthropic sur la conception des harness note que les handoffs ajoutent de l’orchestration, des tokens et de la durée d’exécution.
Le handoff doit rester conditionnel. Une petite modification terminée en une seule session n’en a pas besoin. Même une longue tâche peut se passer d’un fichier supplémentaire si son checkpoint contient déjà la progression requise et que la session suivante peut l’utiliser. Vérifiez si une session reprise répète un travail terminé, manque une écriture en attente ou agit sur un environnement obsolète. Complétez l’état manquant plutôt que d’ajouter un résumé par défaut.
Diagnostiquer la défaillance avant d’ajouter un composant
Les trois cas ci-dessus produisent des traces différentes : un test d’acceptation manquant, une écriture externe incertaine et un travail répété après une reprise. Leurs corrections se situent à des endroits différents. Un résultat navigateur absent de l’enregistrement d’acceptation appelle une vérification d’achèvement requise. Une commande incertaine appelle une déduplication ou une réconciliation côté serveur. Une modification répétée après une nouvelle session appelle un état de progression exploitable.
Pour la prochaine exécution, enregistrez la tâche et la version du harness, l’action proposée, l’approbation, le tool result, le snapshot testé, le résultat d’acceptation, la latence et le coût. Consignez les nombres de tokens d’entrée séparément du coût d’entrée facturé, lectures en cache comprises : deux harnesses qui se comportent de façon identique peuvent facturer différemment selon la manière dont chacun assemble sa demande et selon que le cache du fournisseur était chaud ou non. Gardez les secrets et les données personnelles inutiles hors des traces. Reliez les enregistrements d’opérations externes par leur identifiant, car un timeout côté client ne peut pas révéler ce qu’a fait le serveur. Lorsqu’une défaillance se répète, écrivez un cas de régression qui la reproduit. L’évaluation des agents AI en production développe ce processus qui transforme les traces en tests.
Chaque symptôme récurrent suggère une petite modification et une mesure qui montrerait si elle a aidé :
| Symptôme récurrent | Petite modification à essayer | Ce qu’il faut mesurer |
|---|---|---|
| Les lookups read-only échouent de façon transitoire | Retry borné avec backoff | Taux de récupération, calls supplémentaires, durée d’exécution |
| Les sessions reprises répètent un travail terminé | Progress handoff structuré | Actions d’outil dupliquées après la reprise |
| Des tests requis manquent à l’achèvement | Rejeter l’achèvement tant que chaque vérification requise n’a pas réussi | Tâches acceptées sans toutes les vérifications requises |
| Des défauts visuels échappent aux vérifications déterministes | Évaluateur avec un contexte neuf et une grille | Défauts trouvés, faux rejets, temps de revue |
| L’agent modifie des fichiers hors de son périmètre | Permission d’outil plus étroite | Calls bloqués et dérogations manuelles |
| La mémoire rappelée évince la tâche courante | Plafonner les faits rappelés ; les classer avant de les injecter | Tokens consacrés au rappel, tâches terminées, coût |
| Une règle ou un statut énoncé n’atteint jamais le modèle | Capturer la demande assemblée avant que le call ne parte | Demandes sans la règle ; tours avant sa réapparition |
Avant d’ajouter une politique de retry, un handoff ou un évaluateur, indiquez la défaillance qu’il doit changer et la métrique qui montrerait une amélioration. Comptez aussi le coût : davantage de tâches acceptées n’est pas utile si les calls supplémentaires doublent le temps de revue ou créent des commandes en double. L’autorisation, l’isolation, les règles de confidentialité et les vérifications d’acceptation obligatoires sont des exigences ; un petit benchmark de succès ne justifie pas de les supprimer. Testez ces contraintes avec des cas interdits explicites.
Mesurer une seule modification optionnelle à la fois
Une ablation compare un harness avec et sans un composant, tout en gardant fixe le reste de l’expérience. Utilisez ce protocole :
- Figez la version du modèle et l’endpoint du fournisseur, les instances de tâches, l’environnement et ses limites de calcul, le grader et les prompts en dehors du composant testé. Les seules limites de ressources peuvent modifier le score d’un benchmark d’agents ; l’article sur les evals présente la mesure d’Anthropic.
- Donnez aux deux variantes le même budget total en tokens, en temps et en dollars.
- Choisissez le nombre d’essais ou la règle d’arrêt avant de lancer la comparaison.
- Exécutez les mêmes instances de tâches dans les deux variantes et répétez chaque tâche, car la sortie du modèle varie.
- Rapportez la moyenne avec sa dispersion ou son intervalle de confiance.
- Comptez chaque essai démarré, y compris les timeouts, les arrêts par politique, les crashs du harness et les défaillances de l’évaluateur.
Pour la migration de paiement, le progress handoff optionnel est un candidat. Démarrez chaque paire contrôle–traitement à partir du même commit du dépôt et du même checkpoint initialisé, le handoff étant le seul élément qui change.
La mesure principale pourrait être le nombre d’actions d’outil dupliquées après la reprise : une opération sur un artefact que la session précédente avait déjà terminé. Rapportez aussi les tâches acceptées, les défauts non détectés, la durée d’exécution, le coût du modèle et de l’évaluateur, et les minutes de revue. Choisissez à l’avance le nombre d’essais et la règle d’arrêt, puis rapportez la variation plutôt que la seule moyenne. Si le handoff réduit les doublons mais coûte plus qu’il ne fait économiser, c’est un résultat négatif utile.
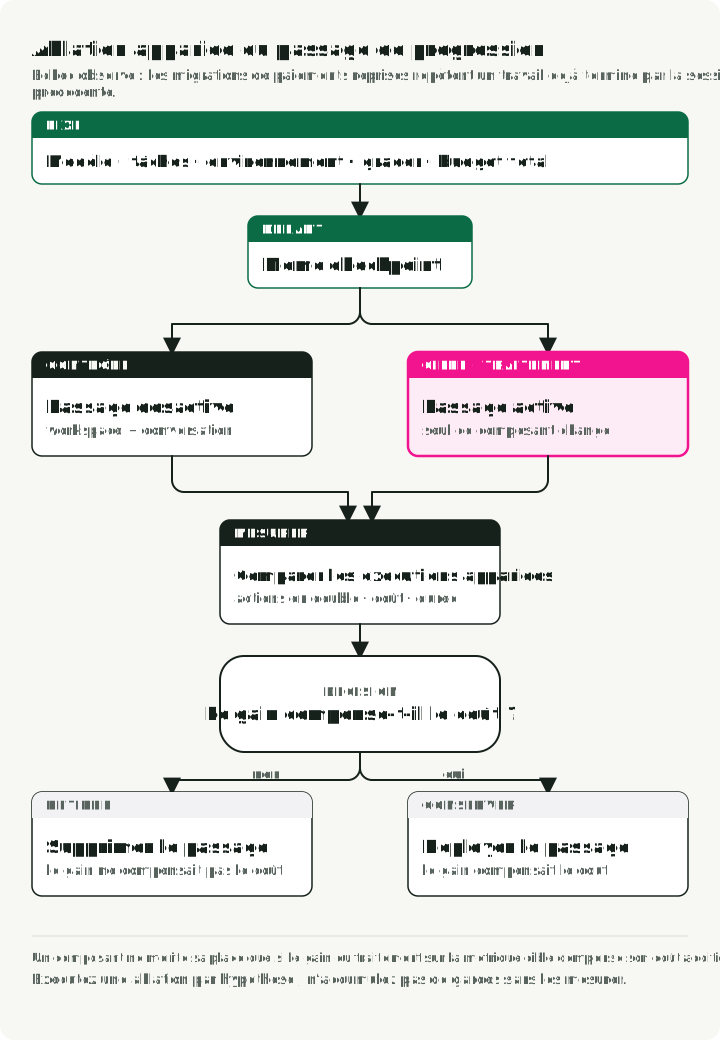
L’article sur SWE-agent donne un exemple circonscrit d’ablation d’interface. Avec GPT-4 Turbo sur le split SWE-bench Lite de 300 tâches et un plafond de $4 par tâche, il a modifié une fonctionnalité d’interface à la fois :
| Modification de l’interface | Résolues |
|---|---|
| Interface SWE-agent complète (référence) | 18,0 % |
| Éditeur sans linting | 15,0 % |
| Fichier complet au lieu d’un viewer de 100 lignes | 12,7 % |
| Historique complet des observations au lieu des cinq dernières | 15,0 % |
Ce sont des résultats pour ce modèle et ce benchmark, pas des gains attendus pour cette boutique fictive. Ce qui se transpose, c’est la méthode : tester un choix d’interface nommé dans une configuration fixe, puis rapporter les conditions avec le chiffre.
Les comparaisons groupées sont courantes, et elles ne peuvent pas nommer la modification qui a aidé. LangChain rapporte un gain sur Terminal-Bench 2.0 pour deepagents-cli, de 52,8 % à 66,5 % à modèle fixe, après avoir modifié ensemble le system prompt, les outils et le middleware. Le rapport ARC-AGI-3 d’OpenAI montre le risque inverse : un score a presque triplé lorsque le harness a conservé le raisonnement et utilisé la compaction, deux paramètres d’API modifiés ensemble. Enregistrez l’API, la conservation du raisonnement, la politique de compaction et les budgets avec l’identifiant du modèle ; sinon, une régression apparente du modèle peut être une capacité manquante dans l’adapter.
Tester une modification à la fois permet aussi de repérer des changements qui semblent trop petits pour compter. Le postmortem de Claude Code d’avril 2026 d’Anthropic indique que l’API n’était pas en cause, mais que trois changements de la couche produit ont dégradé la qualité : un niveau d’effort de raisonnement par défaut plus bas, un bug qui effaçait le raisonnement précédent à chaque tour après une session inactive, et une ligne du system prompt qui limitait le texte entre les tool calls. Lorsqu’Anthropic a fait l’ablation de cette seule ligne sur un ensemble d’evals plus large, l’une d’elles a montré une baisse de 3 % pour Opus 4.6 comme pour Opus 4.7. Une ligne de prompt ou un réglage par défaut est une modification du harness ; testez-la comme telle.
Revalidez les composants lorsque le modèle change. Le rapport d’Anthropic sur les applications de longue durée est une étude de cas qualitative : à la sortie d’Opus 4.6, l’équipe a retiré les composants du harness un par un et constaté que les calls de l’évaluateur devenaient une surcharge sur les tâches que le modèle accomplissait désormais seul, tout en restant utiles près de ses limites.
Incluez un arrêt de sécurité du fournisseur dans la suite de défaillances : il doit arrêter le dispatch et renvoyer vers une revue, sans retry. La partie 4 couvre les détails.
Essayer la comparaison dans le laboratoire associé
Le projet harness-demo au commit 517353f3 rend la règle d’ablation exécutable. Ses douze tâches synthétiques génériques, comme fix-parser-edge-case, split-large-module et wire-browser-test, déclarent chacune une difficulté et quatre conditions : un outil instable, une progression perdue, une lacune d’implémentation manquée et un achèvement ambigu. Le simulateur en dérive une cinquième pour les tâches difficiles qui nécessitent aussi un fichier de progression : sans context_reset, la compaction conserve des hypothèses obsolètes. Une fonction pure marque une tâche comme réussie lorsque la configuration choisie gère chaque condition applicable. Il n’y a ni modèle, ni outil externe, ni vraie tâche de code. Ses résultats et ses nombres de tokens sont des données pédagogiques simulées, et non la preuve qu’un harness à cinq composants améliore un agent réel.
Clonez la révision épinglée et lancez les vérifications et la simulation avec uv installé :
git clone https://github.com/slavadubrov/harness-demo.git
cd harness-demo
git checkout 517353f3a47541d66099983170fe90812b6ef23b
make check
make run
make failures
make check exécute Ruff et sept tests unitaires, dont un test qui rejette une comparaison modifiant deux composants. make run affiche une matrice pédagogique cumulative et cinq paires leave-one-component-out. make failures nomme chaque défaillance simulée ; la configuration complète se termine par all synthetic tasks pass.
| Composant restauré dans la configuration complète | Sans lui | Avec lui |
|---|---|---|
| Politique de retry | 8/12 | 12/12 |
| Progress handoff | 7/12 | 12/12 |
| Évaluateur avec un contexte neuf | 8/12 | 12/12 |
| Acceptation fail-closed | 7/12 | 12/12 |
| Réinitialisation du contexte | 10/12 | 12/12 |
Les lignes sont des conséquences déterministes des indicateurs de tâche et du code du grader. Ce ne sont pas des estimations d’une taille d’effet dans un système réel. La matrice cumulative précédente ajoute plusieurs composants en une seule transition et ne peut pas identifier lequel a causé son changement.
Le fichier model.py du laboratoire empêche de présenter une modification groupée comme une ablation : il compare chaque champ de composant d’une paire, et son test de régression fournit une paire invalide où le retry et l’évaluateur changent tous les deux. Cette version autonome du garde-fou s’exécute sur une paire valide de progress handoff :
from dataclasses import dataclass, fields

@dataclass(frozen=True)
class Config:
    progress_handoff: bool = False
    evaluator: bool = False
    retry_policy: bool = False
    fail_closed_acceptance: bool = False
    context_reset: bool = False

def changed_components(control: Config, treatment: Config) -> tuple[str, ...]:
    return tuple(
        field.name
        for field in fields(control)
        if getattr(control, field.name) != getattr(treatment, field.name)
    )

control = Config(progress_handoff=False, evaluator=True, retry_policy=True)
treatment = Config(progress_handoff=True, evaluator=True, retry_policy=True)
assert changed_components(control, treatment) == ("progress_handoff",)
Pour appliquer la méthode à un projet réel, remplacez les indicateurs de tâche synthétiques par une suite de tâches versionnée et les nombres de tokens simulés par des mesures issues des traces. Gardez les règles d’acceptation hors du contrôle du candidat. Un modèle fixe ne suffit pas à rendre une comparaison contrôlée si les prompts, les données de test, les permissions ou les paramètres de raisonnement et de compaction de l’API ont aussi changé.
Trouver le code derrière un comportement
Un harness qui passe ses ablations peut tout de même survivre au modèle pour lequel il a été ajusté, et le modifier plus tard exige de trouver le code qui implémente un comportement. Une demande comme « masquer les secrets dans chaque chemin de capture » nomme un comportement, pas un fichier. Dans un harness de production, ce comportement peut s’étendre sur plusieurs étapes d’exécution et un état partagé.
Un preprint de 2026 de Wang et al. propose un Harness Handbook pour cette recherche, que l’article appelle behavior localization. Une analyse statique extrait un graphe du programme, un LLM regroupe ses unités en étapes d’exécution, et un mainteneur ou un coding agent descend d’une vue d’ensemble du système vers des entrées ancrées dans le code source pour une fonction ou un fichier. Chaque entrée doit correspondre au dépôt réel et est resynchronisée après chaque modification.
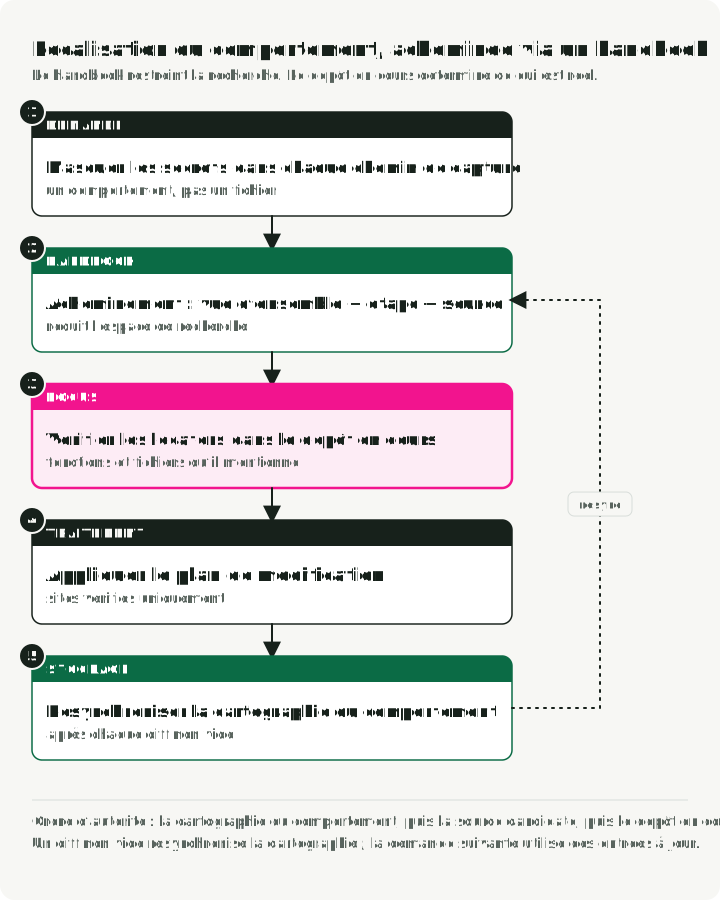
Sur deux harness open source, un planificateur qui passait par le handbook a produit des plans de modification que les juges préféraient plus souvent, avec moins de tokens. L’étude a noté des plans plutôt que des modifications exécutées et n’a indiqué aucune incertitude ; considérez-la donc comme une approche au stade de la recherche.
Partir de la défaillance pour trouver le responsable
Cette série s’est construite vers l’extérieur à partir du reasoning loop. Lorsqu’une exécution échoue, cherchez la première responsabilité capable de prévenir ou de détecter la défaillance :
| Ce qui s’est passé | À examiner |
|---|---|
| Mauvaise étape suivante alors que la bonne information était disponible | Modèle et reasoning loop |
| Perte d’une décision antérieure ou travail terminé répété | Assemblage du contexte et mémoire |
| Impossible d’exprimer une action ou de lire son résultat | Contrat de l’outil |
| Exécution d’une action interdite | Vérification des permissions et service qui l’applique |
| Le worker a planté et son environnement a disparu | Runtime et checkpoint |
| Succès déclaré sans les éléments probants requis | Règle d’acceptation du harness et snapshot testé |
Je commencerais avec un modèle compétent, des outils restreints, un sandbox et une vérification d’acceptation explicite. Enregistrez la première défaillance, ajoutez le plus petit contrôle qui la traite et comparez avec ce contrôle désactivé. Conservez la règle et la trace ensemble, afin que la prochaine mise à niveau du modèle vous donne une raison de garder ou de retirer le composant. Pour chaque composant, notez qui le maintient, combien de tokens ou de secondes il ajoute et quel test de régression justifierait de le retirer. Six mois plus tard, quelqu’un qui voit progress_handoff=True doit pouvoir retrouver les traces en échec qui l’ont justifié et les cas de régression qui le maintiennent encore.
Références
- OpenAI, Unrolling the Codex agent loop.
- OpenAI, Harness engineering: leveraging Codex in an agent-first world.
- Anthropic Engineering, Demystifying evals for AI agents.
- Anthropic Engineering, Effective harnesses for long-running agents.
- Anthropic Engineering, Harness design for long-running application development.
- Lopopolo, Harness engineering: anthology, field guide, and agent context bundle.
- LangChain, Improving Deep Agents with harness engineering.
- OpenAI, How two settings tripled our ARC-AGI-3 scores.
- Wang et al., Harness Handbook: Making Evolving Agent Harnesses Readable, Navigable, and Editable, arXiv:2607.13285, 2026.
- Stripe, Idempotent requests.
- Yang et al., SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering.
- AWS, Making retries safe with idempotent APIs.
- Model Context Protocol, Tools specification.
- Model Context Protocol, Tasks extension et Tasks specification.
- Anthropic Engineering, An update on recent Claude Code quality reports.
Le code du Market Analyst Agent de la série est disponible sur GitHub.