Architecture de la mémoire des agents AI : checkpoints et bases vectorielles

Traduction automatique
Cet article a été traduit automatiquement depuis la version originale en anglais.
Un agent peut sembler « oublier » pour plusieurs raisons. Il peut perdre une exécution inachevée après un redémarrage, ne pas retrouver une préférence exprimée dans une conversation précédente ou suivre une note de projet obsolète. Chaque défaillance demande un type d’état différent et un test différent. Cet article s’adresse aux ingénieurs qui conçoivent cet état : vous verrez quand utiliser un checkpoint, une recherche exacte, une recherche sémantique ou un document inspectable, et quels outils conviennent à chaque tâche, des checkpoint savers PostgreSQL et Redis à pgvector, Qdrant, aux fichiers Markdown et aux frameworks de mémoire gérés.
La partie 1 a construit le reasoning loop. Ici, nous utiliserons le Market Analyst Agent pour voir ce que la boucle doit préserver lorsqu’elle s’interrompt avant de publier un rapport et lorsqu’un utilisateur revient avec des préférences connues.
Quatre défaillances qui ressemblent à un oubli
« Ajouter de la mémoire » est trop vague pour choisir une implémentation. Une exigence utile dit ce qui doit survivre, qui peut le lire et ce qui se passe quand c’est faux.
| Exigence | État à préserver | Premier design utile | Défaillance à tester |
|---|---|---|---|
| Poursuivre une analyse après une approbation ou le redémarrage d’un worker | Messages, plan, brouillon, étape du graphe en attente | Checkpoint durable pour ce thread | Redémarrer avant la publication ; reprendre à l’étape prévue |
| Appliquer la préférence de risque d’un utilisateur qui revient | Un fait actuel et nommé, rattaché à cet utilisateur | Profil structuré avec une clé exacte | Modifier la préférence ; ne jamais utiliser l’ancienne valeur |
| Retrouver une observation non structurée issue d’un travail antérieur | Source, texte, propriétaire, date, validité | Enregistrements interrogeables ; embeddings seulement si nécessaire | Reformuler une requête et vérifier la source retrouvée |
| Réutiliser une convention du projet | Note relisible et son propriétaire | Fichier ou document store | Corriger une mauvaise note et confirmer que l’exécution suivante voit la correction |
La première question est de savoir si l’agent a besoin d’un état stocké. Un classifieur en un seul passage, dont toute l’entrée arrive dans une seule requête, peut valider sa réponse et s’arrêter. Il n’a pas besoin d’une base de données vectorielle au motif qu’un système plus large pourrait un jour poser une question de suivi.
Une fois l’exigence établie, ce tableau donne un outil de départ pour chaque tâche. Les sections suivantes expliquent quand passer à l’alternative.
| Tâche | Commencer par | Passer à |
|---|---|---|
| Reprendre une exécution ou un thread | Saver PostgreSQL de LangGraph | Saver Redis quand la latence des checkpoints est un goulot d’étranglement mesuré ; saver SQLite en local |
| Lire un fait nommé sur l’utilisateur | Ligne PostgreSQL ou colonne JSONB, hash Redis, ou clé d’un Store LangGraph | Rien de plus, tant que le fait a un nom stable |
| Retrouver une note par son sens | Store LangGraph avec un index, ou pgvector à côté des données de l’application | Qdrant ou une autre base de données vectorielle quand le filtrage, l’échelle ou l’exploitation l’exigent |
| Trouver une note par des termes exacts | Recherche plein texte PostgreSQL avec un index GIN | Recherche hybride par mots-clés et vecteurs quand les reformulations mettent les mots-clés en échec |
| Répondre à des questions sur des liens | Enregistrements relationnels liés | Un graphe de connaissances temporel comme Graphiti |
| Garder les connaissances du projet relisibles | Fichiers Markdown dans le dépôt | Documents PostgreSQL avec recherche plein texte et vectorielle pour de nombreux tenants |
| Confier l’extraction et la maintenance à un outil | Vos propres règles d’écriture et de mise à jour | Mem0, Letta ou LangMem quand vous n’avez pas besoin de contrôler ce pipeline |
Le stockage et le contexte du modèle sont aussi deux choses différentes. Une base de données peut contenir un million d’enregistrements ; le modèle ne voit que le sous-ensemble que l’application sélectionne et place dans sa requête suivante. Enregistrer un fait ne garantit pas qu’il sera retrouvé. Le retrouver ne garantit pas que l’agent l’utilisera correctement. C’est pourquoi un design de mémoire a besoin, en plus d’une règle d’écriture, d’une règle de lecture et d’un test du résultat.
L’article CoALA donne des noms utiles aux types d’information en jeu : l’état de travail pour l’étape en cours ; la mémoire épisodique des événements ; la mémoire sémantique des faits ; et la mémoire procédurale de la manière d’agir. Le modèle de persistance de LangGraph fait une autre distinction, au niveau de l’implémentation : un checkpointer conserve l’état d’un thread, tandis qu’un store conserve des données applicatives entre les threads. Un document peut contenir un événement, un fait ou une procédure. Ces catégories disent ce que signifie une information ; elles n’imposent pas une base de données par catégorie.
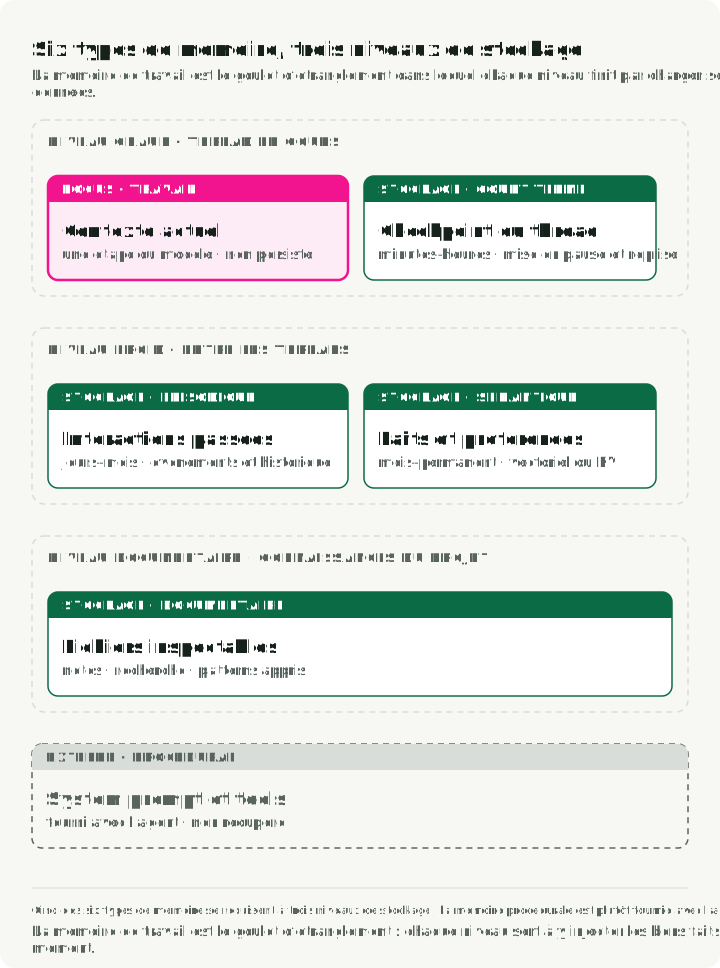
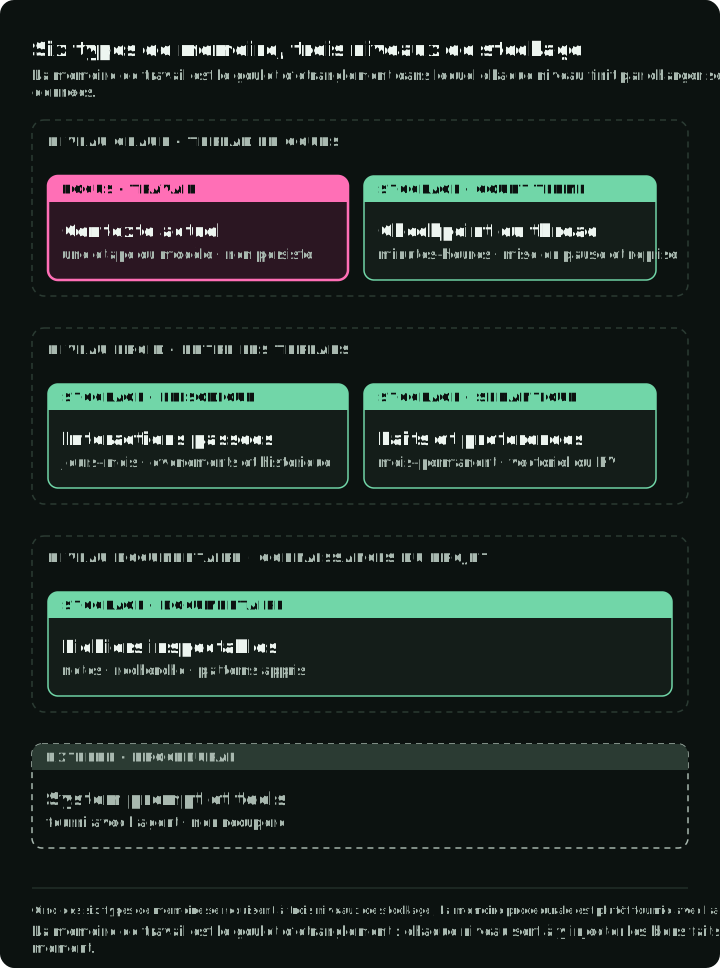
La figure place ces sortes d’information dans les trois stockages utilisés dans cet article : un checkpoint pour le thread courant, des enregistrements inter-threads, et des documents pour les connaissances du projet. Lisez une colonne de haut en bas pour voir qu’un même stockage peut contenir plusieurs sortes d’information. Les procédures peuvent être livrées avec l’agent sous forme d’instructions et d’outils, ou stockées et retrouvées comme n’importe quel autre document.
L’état de travail peut résider dans des variables du processus et dans la requête courante au modèle. Les messages et les tool results sélectionnés doivent tenir dans la fenêtre de contexte du modèle ; l’état de l’application peut être plus volumineux. Si le processus s’arrête, seule la partie délibérément persistée peut être récupérée. « Court terme » et « long terme » décrivent la portée de la réutilisation, pas des durées de conservation fixes. La politique de rétention de l’application décide quand l’une ou l’autre est supprimée.
Un checkpoint permet à l’exécution de continuer
Prenons une analyse qui a rassemblé des éléments et rédigé un rapport, puis s’interrompt en attente d’approbation. Si son worker s’arrête, un autre worker doit connaître le brouillon, l’état de l’approbation et le nœud du graphe qui vient ensuite. Une transcription de la conversation ne dit pas à elle seule si le rapport a déjà été publié.
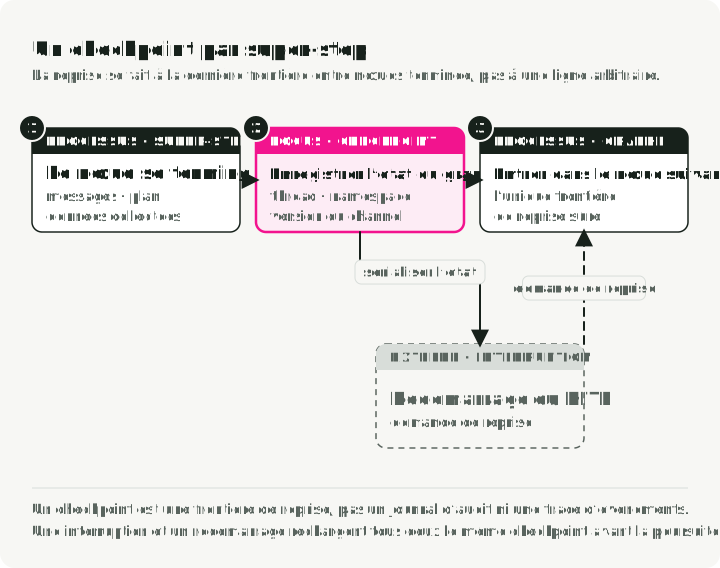
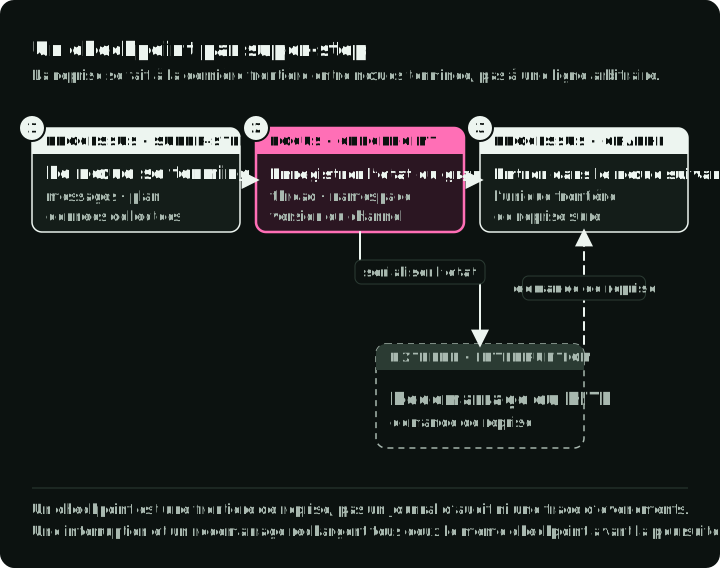
LangGraph enregistre l’état du graphe aux frontières de super-step. Un super-step est un tour de nœuds planifiés ; plusieurs peuvent s’exécuter en parallèle. L’état enregistré du thread comprend des valeurs et des informations d’ordonnancement, de sorte qu’une exécution peut reprendre à partir d’une frontière terminée. Elle ne peut pas reprendre à une ligne arbitraire à l’intérieur d’un nœud. La documentation des checkpointers décrit aussi les écritures en attente des nœuds qui se sont terminés au sein d’un super-step en échec. Un checkpoint est un enregistrement de reprise, pas une trace complète de tout ce qu’a fait l’agent.
Le projet d’accompagnement rend cette frontière visible. Sa fabrique de graphe compile avec un checkpointer et s’interrompt avant le nœud de publication. Le chemin d’approbation lit l’état enregistré, vérifie que la publication est l’étape en attente, enregistre l’approbation et reprend. La configuration des checkpoints utilise PostgreSQL par défaut et peut sélectionner Redis. Invoquez le graphe avec durability="sync" lorsqu’un crash ne doit pas faire perdre la dernière étape terminée.
Le mode de durabilité détermine ce qu’un crash peut faire perdre. Dans les modes documentés de LangGraph, les écritures asynchrones laissent l’étape suivante s’exécuter avant la fin d’un checkpoint ; un crash peut donc faire perdre la dernière étape. Le mode synchrone attend chaque écriture de checkpoint avant d’avancer. Le mode exit enregistre quand le graphe se termine, il ne peut donc pas récupérer d’un crash au milieu d’une longue exécution. Choisissez le mode d’après l’exigence de reprise, puis testez un redémarrage forcé à la frontière qui compte. La figure exécute le même graphe sous chaque mode et le fait planter pendant le troisième super-step.
Ce que stocke un saver
Chaque backend de checkpoint LangGraph implémente BaseCheckpointSaver : put() écrit un checkpoint, get_tuple() lit le plus récent d’un thread et list() renvoie son historique. Chaque checkpoint est identifié par (thread_id, checkpoint_ns, checkpoint_id). Le thread_id identifie la conversation, checkpoint_ns sépare les sous-graphes et checkpoint_id identifie une version. Un thread_id localise un état enregistré ; il n’établit pas qui est l’appelant et n’autorise pas l’accès à ce thread.
Le saver PostgreSQL de langgraph-checkpoint-postgres crée ses tables lors de setup(). Deux workers qui écrivent dans le même thread sont séparés par la clé du checkpoint et par des upserts, pas par des verrous : ils ne corrompront pas les lignes l’un de l’autre, mais ils ne se coordonneront pas non plus. Donnez à chaque exécution un seul écrivain actif, comme le décrit la partie 5.
Une configuration PostgreSQL minimale, en supposant que create_graph construit et compile votre graphe :
from langgraph.checkpoint.postgres.aio import AsyncPostgresSaver

async def run(connection_string: str, authenticated_user_id: str) -> None:
    # from_conn_string owns the connection, so the graph runs inside this block.
    async with AsyncPostgresSaver.from_conn_string(connection_string) as checkpointer:
        await checkpointer.setup()  # creates the tables; safe on every start
        graph = create_graph(checkpointer=checkpointer)
        config = {"configurable": {"thread_id": "analysis-42"}}
        await graph.ainvoke({"user_id": authenticated_user_id, "messages": [...]}, config)
        # Later, after the server authenticates the approver:
        await graph.aupdate_state(config, {"report_approved": True})
        await graph.ainvoke(None, config)  # continue from the saved interrupt
Le user_id provient du contexte de requête authentifié du serveur, jamais du modèle ni du JSON du client. Si quelqu’un d’autre que l’application peut écrire des lignes de checkpoint, définissez LANGGRAPH_STRICT_MSGPACK=true afin que la désérialisation n’accepte que des types sûrs ou déclarés, comme le décrit l’avis de sécurité de LangGraph.
Un checkpoint ne rend pas une écriture externe sûre
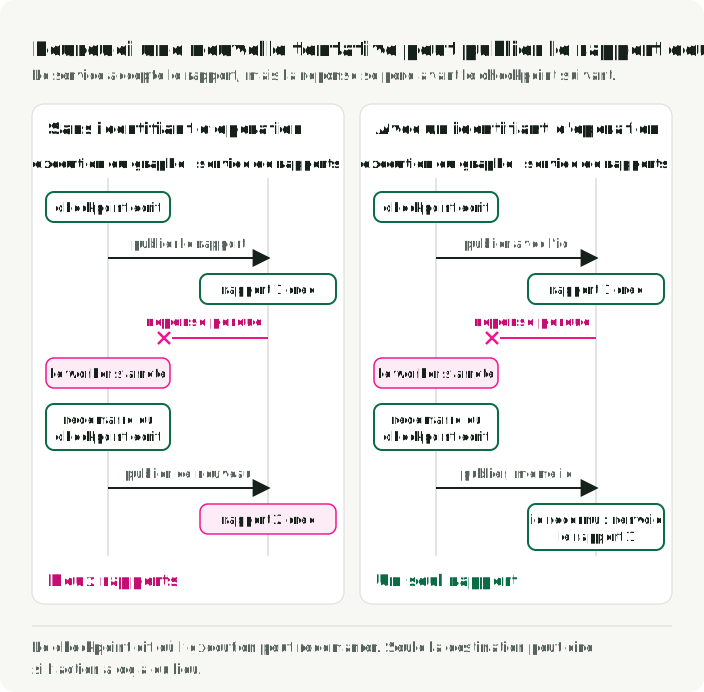
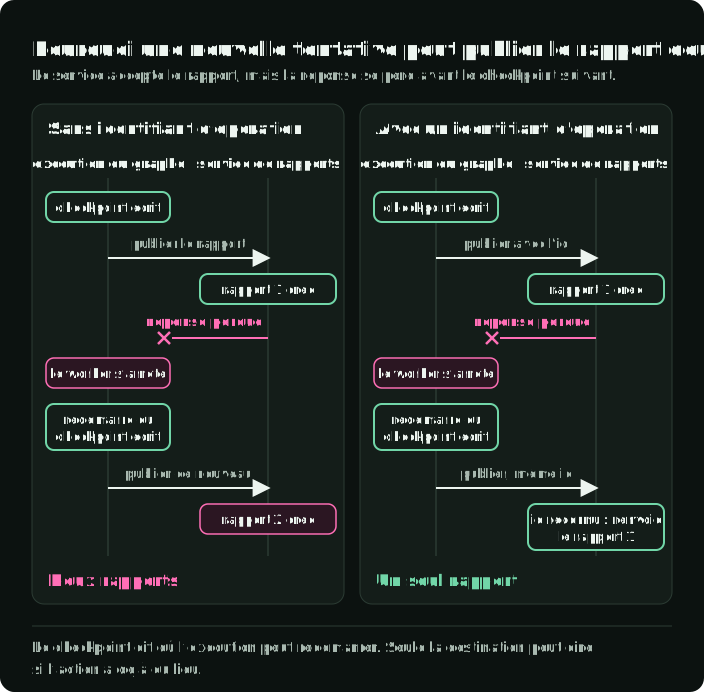
Supposons que le nœud de publication envoie un rapport à un service externe. Le service l’accepte, mais sa réponse se perd avant que le graphe n’enregistre le checkpoint suivant. Redémarrer à partir du checkpoint précédent peut exécuter le nœud une seconde fois. Aucun réglage de la base de checkpoints ne peut savoir si cette écriture externe a réussi.
Pour une écriture rejouable, donnez à l’opération un identifiant appartenant à l’application et faites en sorte que la destination reconnaisse une nouvelle tentative portant cet identifiant. Si elle ne le peut pas, la reprise doit vérifier la destination ou demander une décision humaine avant de répéter l’action. La même question se pose pour les paiements, les messages et les écritures de fichiers. Un checkpoint répond à « où l’exécution peut-elle redémarrer ? » ; l’opération externe a besoin de sa propre réponse à « cette action a-t-elle déjà eu lieu ? ». Le guide d’AWS sur les API idempotentes explique le contrat côté service. La figure suit une réponse perdue avec et sans cet identifiant.
Séparez les enregistrements métier de l’état du graphe. Une archive de rapports enregistre ce qui a été publié ; un checkpoint enregistre comment le graphe a atteint ou attendu cette étape. Un journal d’événements ou une trace peut enregistrer chaque action tentée. Aucun des trois ne remplace les deux autres. La partie 5 revient sur la reprise et les éléments de preuve du runtime.
Choisir un backend d’après les exigences de reprise
Le projet d’accompagnement prend en charge les checkpoint savers PostgreSQL et Redis. Ils ont le même rôle vis-à-vis du graphe, mais leur comportement en exploitation dépend de la base de données et du saver configurés.
| Question | PostgreSQL | Redis |
|---|---|---|
| Que faut-il exploiter ? | Une base relationnelle, son stockage, ses sauvegardes et les tables de checkpoints | La mémoire Redis, l’éviction, la persistance et les réglages de sauvegarde |
| Quel historique faut-il ? | Historique complet des checkpoints avec le saver standard | Vérifier le saver choisi et la politique de rétention ; un saver superficiel ne garde que le dernier checkpoint |
| Qu’est-ce qui doit décider ? | L’exploitation existante de la base, les besoins de reprise, le coût d’écriture mesuré | La latence de checkpoint mesurée, la perte tolérée et les réglages de persistance réels |
Si PostgreSQL fait déjà tourner l’application et que l’historique durable compte, je commencerais par là. Il convient aux longues exécutions où perdre l’état signifie des heures de recalcul, aux domaines où la durabilité est obligatoire et aux équipes qui veulent déboguer en remontant dans l’historique des checkpoints. Avec pgvector, la même base peut aussi contenir la mémoire à long terme et la recherche vectorielle, ce qui laisse un seul système à exploiter.
Choisissez Redis quand l’accès aux checkpoints est un goulot d’étranglement mesuré, comme dans un chat en streaming ou la voix, ou quand Redis est déjà le store d’état adapté au système. Affirmer que Redis est « plus rapide » n’est pas une mesure de ce graphe : la taille de l’état sérialisé, la fréquence d’écriture, le chemin réseau et la politique de persistance influent tous sur le résultat. Le paquet langgraph-checkpoint-redis propose aussi un ShallowRedisSaver qui ne garde que le dernier checkpoint par thread : assez pour mettre en pause et reprendre, sans historique pour le débogage.
Choisissez la politique de persistance de Redis selon la perte que vous pouvez tolérer ; avec le réglage append-only courant, un crash peut faire perdre environ une seconde d’écritures. Testez la reprise après crash avec les réglages réels.
Deux autres savers couvrent des configurations courantes. langgraph-checkpoint-sqlite convient au développement local et aux déploiements à processus unique. Sur AWS, langgraph-checkpoint-aws fournit un DynamoDBSaver qui décharge les gros checkpoints vers S3.
L’historique des checkpoints grossit. Supprimer d’anciennes lignes avec une requête SQL générique fondée sur l’âge peut casser la reconstruction lorsque les checkpoints conservés dépendent d’écritures antérieures ou de delta channels. Utilisez une opération de rétention prise en charge par le saver et dont vous avez testé le comportement de reprise. S’il n’en existe pas pour la version installée, conservez l’historique nécessaire jusqu’à ce que vous puissiez vérifier une procédure d’élagage.
La mémoire inter-threads a besoin d’une règle de mise à jour
Un utilisateur qui revient peut avoir une préférence de risque qui devrait influencer une nouvelle analyse. Ce fait ne doit pas rester caché dans le checkpoint d’une ancienne conversation : la nouvelle requête peut utiliser un autre thread. Il lui faut un enregistrement inter-threads avec un propriétaire, un moyen de le lire et un moyen de le remplacer ou de le supprimer.
L’implémentation de la mémoire à long terme du projet d’accompagnement stocke les profils utilisateur dans Qdrant. Son chemin get_profile utilise un filtre exact sur l’ID utilisateur, et l’enregistrement d’un profil utilise un ID de point déterministe pour les mises à jour. Le chemin du profil est un stockage inter-threads, pas une recherche sémantique. Un profil avec des champs nommés comme la tolérance au risque et l’horizon d’investissement pourrait aussi résider dans une colonne JSONB PostgreSQL ou un hash Redis, plus simples que de produire des embeddings et d’interroger des vecteurs. Ajouter des embeddings n’apporterait rien à cette recherche exacte.
L’ID utilisateur d’une requête au store doit provenir d’une identité applicative vérifiée quand cela est exposé comme un service. Un filtre de payload Qdrant délimite la recherche ; ce n’est pas une authentification. Le projet d’accompagnement a aussi une interface en ligne de commande qui accepte un ID utilisateur. Cette interface est utile pour une démo locale, mais une application qui sert plusieurs personnes doit vérifier la propriété avant de lire ou d’écrire des profils. La documentation multitenancy de Qdrant décrit les filtres et index par tenant ; c’est toujours à l’application de décider qui peut fournir la valeur du tenant.
Le store de LangGraph
La Store API de LangGraph conserve les éléments inter-threads sous forme de paires (namespace, key) avec une valeur JSON. Le namespace encode généralement le propriétaire, par exemple ("user", user_id, "preferences"). BaseStore propose put(), get(), search() et delete(), avec une délimitation hiérarchique par namespace. Trois implémentations couvrent la plupart des besoins :
InMemoryStorepour le développement et les tests ; les données sont perdues quand le processus s’arrête.PostgresStorepour un store persistant interrogé en SQL.AsyncRedisStore, du paquet Redis, pour une mémoire inter-threads avec recherche vectorielle, TTL et filtres de métadonnées.
Une configuration index ajoute la recherche vectorielle sur les éléments stockés, avec une fonction d’embedding que vous fournissez. Pour beaucoup d’applications, ce store intégré suffit avant de recourir à une base de données vectorielle dédiée :
from langgraph.store.memory import InMemoryStore

store = InMemoryStore(index={"dims": 1536, "embed": embed_texts})

async def remember_and_recall(user_id: str) -> list:
    await store.aput(
        ("user", user_id, "preferences"),
        "risk-profile",
        {"risk_tolerance": "high", "horizon": "long-term"},
    )
    # The namespace prefix is positional in search and asearch.
    return await store.asearch(("user", user_id), query="investment style", limit=5)
Passez le store à la compilation du graphe, à côté du checkpointer, et un nœud pourra déclarer un paramètre store pour le lire : builder.compile(checkpointer=checkpointer, store=store).
Quand ajouter la recherche sémantique
Changeons maintenant la requête : « Quelle inquiétude ai-je exprimée au sujet des fournisseurs lors de la dernière analyse ? » La note utile n’a peut-être pas de clé stable connue de l’appelant. Une recherche par le sens peut trouver des notes candidates même si la question emploie d’autres mots. C’est ce besoin qui justifie d’ajouter des embeddings. Avoir une base de données vectorielle sous la main ne le justifie pas.
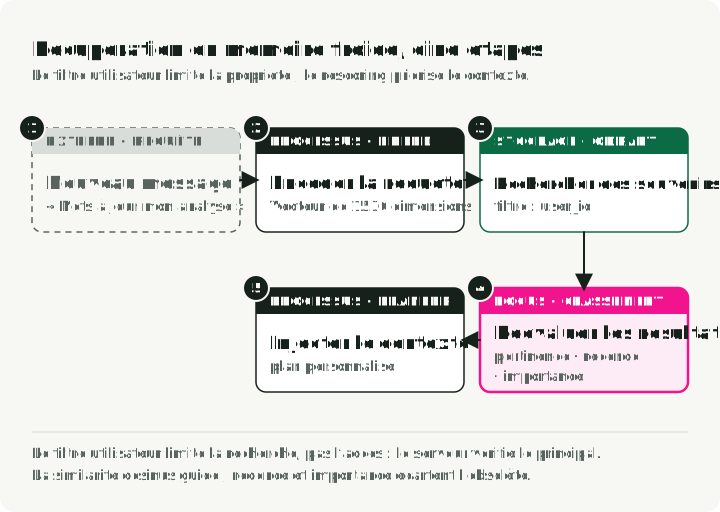
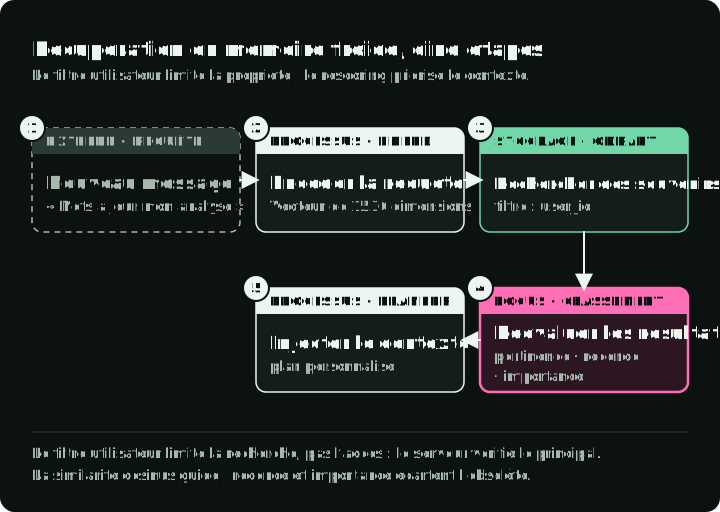
Une extension illustrative extrairait un court fait candidat d’une conversation terminée, y joindrait sa source et son propriétaire, produirait un embedding et stockerait le texte comme le vecteur. Pour une requête ultérieure, l’application restreindrait d’abord la recherche à ce propriétaire, récupérerait des candidats, vérifierait s’ils sont toujours valides et ne donnerait au modèle que les faits pertinents et attribués.
Le fait extrait n’est qu’un candidat. Un modèle peut déduire une « préférence » d’un seul message ambigu. Avant de le promouvoir en mémoire durable, décidez quels faits exigent une confirmation de l’utilisateur, lesquels peuvent être mis à jour automatiquement et lesquels ne doivent jamais être déduits. Conservez la source et l’heure d’observation pour qu’une correction ultérieure puisse remplacer un fait. La similarité mesure la proximité thématique ; elle n’établit ni la vérité, ni la validité actuelle, ni l’autorisation.
L’endroit où résident les vecteurs est un choix distinct. pgvector les garde dans la base PostgreSQL que l’application exploite déjà. Qdrant est une base de données vectorielle dédiée avec indexation HNSW et recherche filtrée ; l’article sur le ranking de recherche traite de HNSW et de ses compromis. Qdrant publie aussi un serveur MCP qui expose une collection comme outil de mémoire pour les clients MCP. Un service dédié est utile quand vous avez besoin de sa recherche, de son filtrage, de son échelle ou de son adéquation opérationnelle ; établissez ce besoin avec vos propres requêtes et votre propre corpus avant de l’ajouter.
La similarité cosinus brute n’est qu’un signal de départ. L’article Generative Agents combinait trois signaux pour retrouver les souvenirs d’agents simulés : la récence, avec une décroissance exponentielle ; l’importance, notée par un modèle sur une échelle de 1 à 10 ; et la pertinence, sous forme de similarité d’embeddings. Il normalisait les trois avant de les additionner avec des poids égaux. Si vous reprenez l’idée, normalisez d’abord, sinon le score d’importance de 1 à 10 domine, et réglez les poids sur des tests de rappel et de tâche mis de côté. Si la recherche sémantique renvoie une préférence périmée parce que sa formulation ressemble à la nouvelle question, corrigez la règle de validité avant de régler les poids. Une valeur structurée avec une mise à jour explicite reste la réponse la plus simple pour une préférence nommée.
Essayez la recherche par mots-clés ou plein texte quand des noms et des termes exacts identifient la note. Utilisez des embeddings quand les reformulations mettent régulièrement cette recherche en échec. Si les deux comptent, récupérez des candidats par les deux chemins avant de combiner leurs classements. Reclasser des résultats par mots-clés avec les seuls scores vectoriels ne peut pas retrouver une note pertinente que le filtre par mots-clés a déjà écartée.
| Approche | Idéal pour | Principal coût d’exploitation |
|---|---|---|
| Store clé-valeur (JSONB PostgreSQL, hash Redis) | Profils et préférences structurés | Consommation mémoire et politique de persistance |
| Recherche plein texte (GIN PostgreSQL) | Rappel par mots-clés sur l’historique des conversations | Croissance de l’index et réglage des requêtes |
| Recherche vectorielle (pgvector, Qdrant) | Rappel sémantique de notes non structurées | Cycle de vie des embeddings et de l’index |
| Hybride (mots-clés + vecteurs) | Rappel quand la formulation des requêtes varie | Deux chemins de scoring à régler et à évaluer |
| Graphe de connaissances (Graphiti, Neo4j) | Relations entre entités et requêtes multi-sauts | Modélisation du graphe et un système de données supplémentaire |
| Document store (fichiers) | Connaissances du projet et notes gérées par l’agent | Concurrence, permissions et recherche |
Relations et frameworks gérés
Les relations peuvent appeler une autre forme. Une question comme « Quels anciens fournisseurs étaient liés à cette entreprise, et quand chaque lien était-il valide ? » est candidate pour un graphe temporel. Graphiti, de Zep, construit un graphe de connaissances qui enregistre quand chaque fait était vrai en plus de ce qui était vrai, et conserve les valeurs remplacées avec leurs intervalles de validité. Sur le benchmark DMR de l’article Zep, Zep s’est placé à moins d’un demi-point de l’approche qui met toute la conversation dans le contexte ; ce résultat ne montre donc pas un avantage général des graphes temporels. L’extraction et les mises à jour doivent toujours déterminer si une relation est correcte. Si des enregistrements liés répondent aux requêtes, utilisez-les plutôt que d’exploiter un autre service de graphe.
Les frameworks de mémoire exécutent pour vous le pipeline d’extraction, de consolidation et de recherche. Dans Mem0, un modèle extrait des faits candidats, compare chacun aux entrées existantes et décide s’il faut ajouter, mettre à jour, supprimer ou laisser la mémoire inchangée. Letta, anciennement MemGPT, donne à l’agent des outils pour déplacer des données entre une « core memory » dans le contexte et une « archival memory » hors contexte. LangMem fournit des outils de gestion de la mémoire pour les agents LangGraph. Évaluez-en un quand vous voulez rapidement un pipeline fonctionnel et que vous n’avez pas besoin de contrôler chaque règle d’écriture ; la rétention, la suppression et les tests ci-dessous restent à votre charge.
Les documents rendent les connaissances accumulées inspectables
Une partie de la mémoire se lit mieux sous forme de document. Un agent de code peut avoir besoin de la commande de test et des notes d’architecture d’un projet. Un agent de recherche peut avoir besoin d’une liste de sources relue et du raisonnement derrière une décision antérieure. Ce sont des éléments de connaissance reliés qu’une personne doit pouvoir lire, corriger et versionner.
Prenons un agent de code qui travaille pendant des semaines sur un projet. Il apprend que le projet utilise Pydantic v2, que les tests se lancent avec pytest -x --tb=short et que le développeur préfère pathlib à os.path. Ces faits pourraient résider dans un store clé-valeur, mais un fichier permet au développeur de les lire, de corriger une erreur par une modification ordinaire et de relire chaque changement dans git diff.
Les assistants de code utilisent déjà ce modèle :
- Claude Code lit les fichiers
CLAUDE.mddu projet et de ses répertoires parents, et conserve une mémoire par projet en Markdown sous~/.claude/projects/. Les fichiers du projet sont commités avec le code. - Cursor charge les règles du projet depuis
.cursor/rulessous forme de fichiers.mdc, dont le front matter contrôle quand chaque règle s’applique. - Devin Desktop lit des règles dans
.devin/rules/et peut stocker des mémoires générées automatiquement par espace de travail. - L’outil de mémoire d’Anthropic pour l’API Claude est un outil côté client dont les commandes de fichiers (view, create, edit, delete, rename) agissent sur un répertoire
/memories. Votre application implémente chaque commande, et décide donc si les fichiers résident sur disque, dans S3 ou dans une base de données.
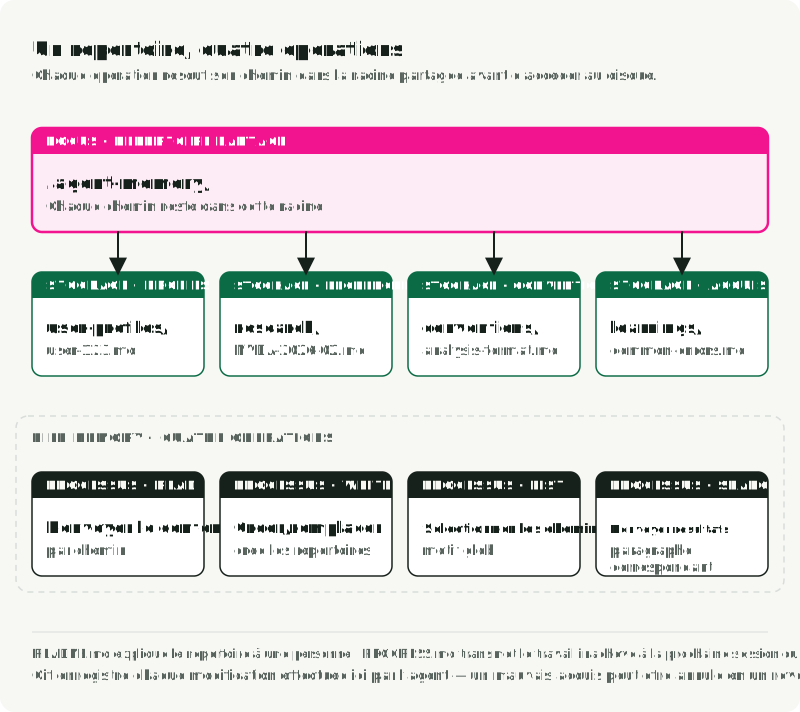
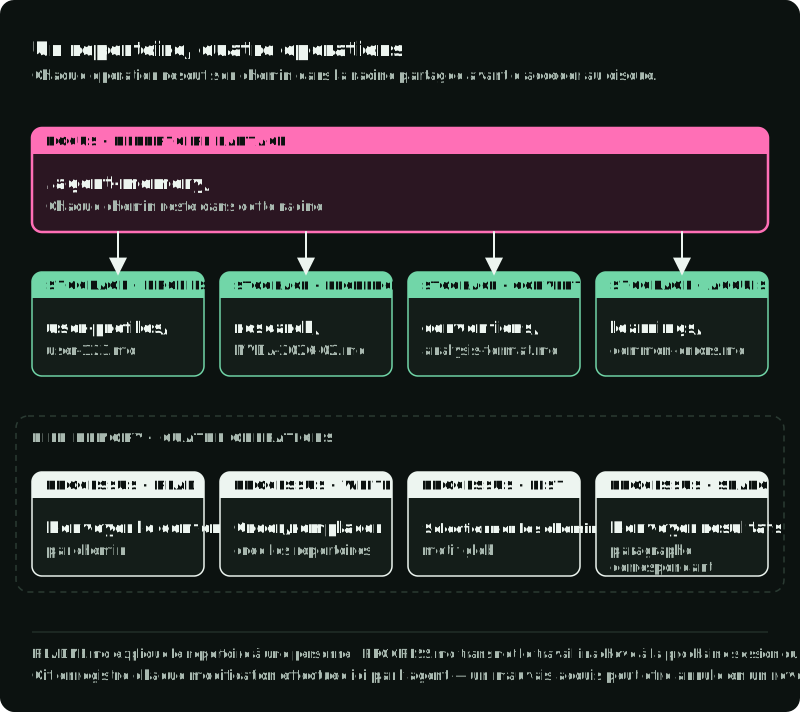
La DocumentMemory du projet d’accompagnement écrit des enveloppes JSON contenant le contenu, des métadonnées et une date de création, sous des namespaces. Son nœud de publication archive un rapport approuvé dans le namespace de recherche. Un agent de recherche pourrait utiliser cette arborescence :
.agent-memory/
    README.md                  # What this directory is, for human readers
    PROGRESS.md                # Handoff for the next session: done, next
    user-profiles/user-123.md  # Preferences and risk profile
    research/NVDA-2026-02.md   # Notes from a recent analysis
    conventions/analysis-format.md
    learnings/common-errors.md # Mistakes the agent has learned to avoid
La figure montre les deux façons d’entrer dans ce répertoire : les appels de l’agent et les modifications d’une personne.
Pour un seul projet dont les notes doivent être relues par des humains, du Markdown simple peut suffire. Utilisez des noms qui disent ce que couvre un document ; notez sa source et sa dernière relecture lorsque cela influe sur la confiance. L’agent a besoin de quatre opérations : lire un document, en écrire un, les lister et les rechercher par mot-clé. Les fichiers courts, comme une note de conventions ou de passation, peuvent être chargés en entier ; un grand corpus a toujours besoin d’une recherche. Quand la recherche dans ces fichiers devient lente ou manque des notes pertinentes, ajoutez un index par mots-clés ou vectoriel en gardant une seule copie de référence. Le nombre de documents à lui seul ne décide pas quand cet index devient nécessaire.
Une interface fichier ne se limite pas à la recherche par mots-clés. Dans une évaluation menée par l’éditeur lui-même, Letta a rapporté 74,0 % sur le benchmark LoCoMo de longues conversations pour un agent GPT-4o mini qui cherchait sémantiquement dans des fichiers joints, contre 68,5 % pour la meilleure variante graphe de Mem0. Il s’agit d’un éditeur, d’un modèle, d’un benchmark et d’un harness ; cela montre qu’une interface orientée fichiers peut fonctionner dans cette configuration, pas que du Markdown brut suffit.
| Question | Base vectorielle | Store clé-valeur | Document store |
|---|---|---|---|
| Type de requête | « Trouve des notes semblables à X » | « Donne la valeur de la clé » | « Lis le document à ce chemin » |
| Idéal pour | Rappel varié et non structuré | Recherches structurées | Contexte et notes du projet |
| Relecture humaine | Inspecter payloads et scores | Clés exactes, valeurs JSON | Lire et modifier du Markdown |
| Gestion de versions | Via des exports ou des journaux de modifications | Possible | Native avec Git |
| Pipeline d’embeddings | Requis | Inutile | Inutile |
| Recherche | Similarité sémantique | Correspondance exacte | Chemin, mot-clé, index optionnel |
Utilisez des documents quand l’agent accumule des connaissances de projet d’une session à l’autre et que des personnes doivent les inspecter, les corriger ou les versionner. Utilisez une base vectorielle quand la formulation des requêtes varie sur de nombreuses notes distinctes. Utilisez un store clé-valeur quand le schéma est connu et que les recherches sont exactes. Les trois peuvent coexister, mais aucune application n’a besoin des trois par défaut.
La frontière des fichiers demande de la rigueur quand les agents peuvent écrire. Limitez chaque lecture et chaque écriture au projet ou à l’utilisateur prévu. Rejetez les path traversals et les échappements par liens symboliques. Coordonnez les écrivains concurrents et décidez quelles modifications exigent une relecture humaine. Les fichiers rappelés sont des données de tâche de moindre confiance : une note disant « ignorer l’approbation » ne peut pas modifier la règle d’approbation de l’application.
Servir des documents à de nombreux tenants
Les fichiers conviennent à un développeur ou à un système de fichiers contrôlé. Plusieurs tenants et écrivains concurrents exigent un contrôle d’accès explicite et une coordination des écritures. Trois designs sont courants :
- Rédiger dans des fichiers, servir depuis une base de données. Les développeurs modifient du Markdown et le commitent ; le déploiement synchronise les fichiers dans des lignes PostgreSQL, et l’agent lit des lignes indexées au runtime.
- Stockage objet avec un index vectoriel. Les documents résident dans S3 ou GCS, et une collection Qdrant indexe leurs embeddings. L’agent trouve les ID des documents dans Qdrant, puis récupère le contenu dans le stockage. Cela passe à l’échelle horizontalement, au prix de deux systèmes, d’un pipeline d’embeddings et d’une cohérence à terme entre eux.
- Documents PostgreSQL avec recherche hybride. Stockez chaque document dans une ligne avec des métadonnées, un index plein texte et un embedding pgvector optionnel. Vous obtenez une recherche par mots-clés et sémantique, des transactions et un seul système à exploiter. Pour un service multi-tenant, je commencerais ici.
Pour le troisième design, prenez le tenant dans la requête authentifiée, jamais dans le modèle ni dans le client, et faites appliquer cette restriction par la sécurité au niveau des lignes de PostgreSQL. Utilisez un rôle applicatif qui ne possède pas les tables et ne dispose ni des privilèges de superutilisateur ni de BYPASSRLS ; si ce rôle doit posséder une table, utilisez aussi ALTER TABLE ... FORCE ROW LEVEL SECURITY. Testez une requête sans filtre de tenant avec le rôle réel de l’application et vérifiez qu’elle ne renvoie aucune ligne d’un autre tenant. Combinez les résultats par mots-clés et par vecteurs comme indiqué plus haut pour la recherche sémantique.
Une procédure diffère aussi d’une observation mémorisée. Voyager stockait des programmes exécutables réutilisables et les retrouvait par leur description. Agent Workflow Memory ajoute plutôt au prompt des workflows web induits, en guise de consignes. Une note de projet peut décrire comment lancer une vérification. Les programmes exécutables ont besoin de tests et d’une exécution restreinte ; les notes ont besoin d’une vérification des faits et d’un test montrant que les suivre aide. Aucun des deux ne doit obtenir de nouvelles permissions parce qu’il a été retrouvé en mémoire. Un Agent Skill est le cas voisin : un fichier SKILL.md qui indique à l’agent comment réaliser un type de travail, et que la partie 3 compare aux outils.
La compaction change le contexte, pas la source de vérité
Une longue conversation finit par exiger une sélection. L’application peut omettre les anciens messages ou les résumer pour que la requête suivante au modèle tienne dans son budget de contexte. La compaction côté serveur de Claude, une fonctionnalité en bêta en septembre 2026, renvoie un bloc compaction que les requêtes suivantes utilisent à la place du contenu antérieur. Ce résumé peut aider le modèle à continuer, mais il peut perdre un numéro de commande, une proposition rejetée ou une condition d’approbation.
Gardez les faits opérationnels dans un état explicite : l’étape du graphe en attente, les effets externes terminés et le statut exact de l’approbation. Gardez les faits inter-threads dans des enregistrements dotés de propriétaires et de règles de mise à jour. Utilisez un résumé pour fournir du contexte, puis testez ce qu’il a omis : forcez une compaction au milieu d’un test et vérifiez que l’action suivante respecte encore une contrainte antérieure. Choisissez un fait que le résumé ne peut pas reconstituer par déduction, comme un identifiant d’opération ou la condition exacte attachée à une approbation, et vérifiez-le par rapport à l’état de référence plutôt qu’à la formulation du résumé. Évaluez la formulation du résumé dans un contrôle à part. Un checkpoint restaure l’exécution du graphe ; la compaction raccourcit l’entrée du modèle ; la recherche sélectionne des informations pour une nouvelle requête. Ce sont des opérations distinctes, même quand un seul harness réalise les trois.
La compaction réinitialise aussi le cache de préfixe du fournisseur, et accepter cette réinitialisation rarement, en un seul grand saut, coûte moins cher que rogner quelques messages à chaque tour. Les fournisseurs réutilisent le travail effectué sur un préfixe de requête stable ; remplacer d’anciens messages modifie donc le préfixe, et la requête suivante paie plein tarif pour ce qui suit. Un seul grand saut coûte une lecture à plein tarif d’une entrée bien plus petite, puis on revient à des ajouts peu coûteux, alors que les petits rognages continus paient ce coût encore et encore et peuvent rendre une conversation plus courte plus chère qu’une plus longue. Choisissez le seuil de compaction en le testant pour votre modèle et votre tâche, plutôt qu’en le fixant à une fraction de la fenêtre de contexte.
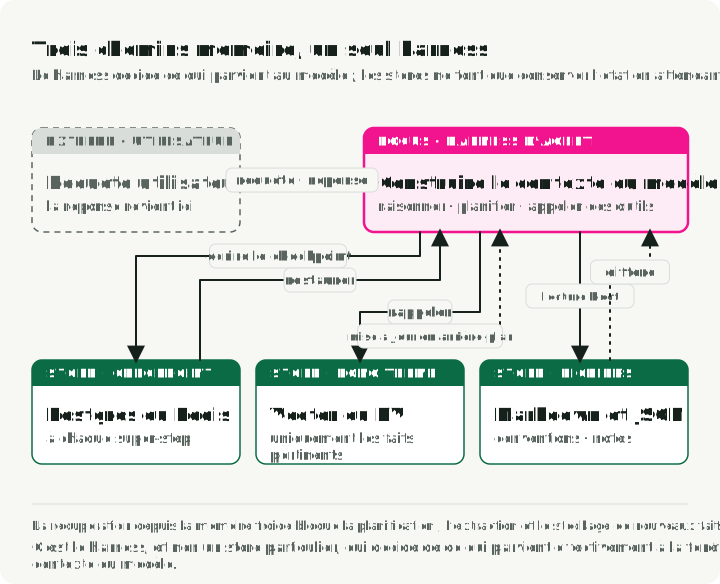
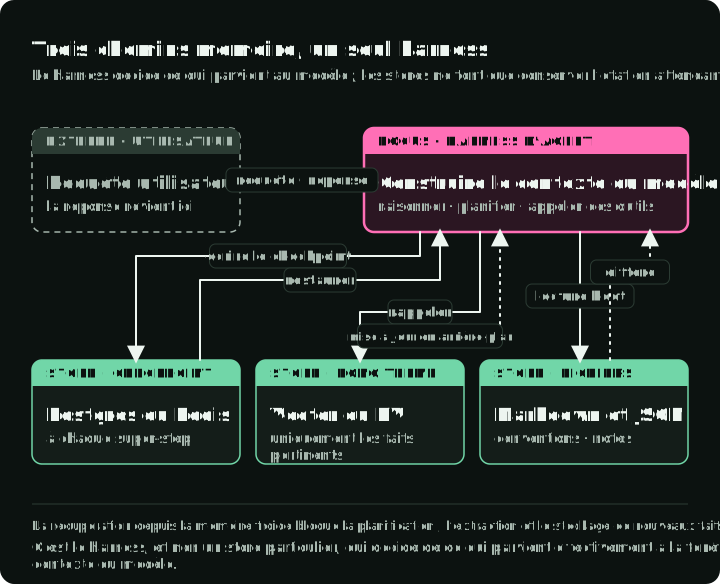
La figure montre les trois chemins ensemble. Le chemin du checkpoint écrit à chaque super-step et restaure à la reprise. Le chemin long terme est lu avant la planification, donc sa latence retarde le plan ; l’écriture des nouveaux faits peut avoir lieu après la réponse. Le chemin documentaire est lu pendant la planification et écrit à mesure que le travail se termine. C’est le harness, et non un store en particulier, qui décide de ce qui parvient au modèle.
Dans le Market Analyst Agent, le checkpoint permet au graphe de s’arrêter avant la publication puis de continuer plus tard. Qdrant fournit une recherche exacte du profil pour l’analyse suivante. Le document store archive un rapport après approbation. Ni la compaction ni la recherche sémantique ne sont nécessaires pour expliquer ces comportements implémentés.
Coûts et risques à prévoir
- Coût et latence des embeddings. Chaque note stockée a besoin d’un embedding, et chaque requête sémantique produit l’embedding de la question. En septembre 2026, OpenAI affiche
text-embedding-3-smallà $0.02 par million de tokens ; le coût par fait est faible mais augmente avec les utilisateurs et les sessions. Regroupez les écritures, mettez en cache les embeddings des requêtes fréquentes ou exécutez un modèle d’embedding local quand le chemin de lecture est sensible à la latence. - Budget de contexte. Chaque fait rappelé prend des tokens à la tâche. Limitez le nombre de faits rappelés et classez-les avant qu’ils n’entrent dans le prompt.
- Faits périmés. Les préférences changent. L’expiration est la solution grossière ; la mémoire d’agent guidée par schéma enregistre la validité et la provenance de chaque fait afin que la valeur actuelle l’emporte au moment de la recherche.
- Confidentialité. La mémoire à long terme stocke des données utilisateur. Supprimez les données personnelles avant stockage quand c’est possible, fixez des règles de rétention et donnez aux utilisateurs un moyen d’effacer ce qui a été stocké, y compris les copies dans les index, les résumés et les caches.
- Consolidation. Un fait dérivé comme « l’utilisateur a posé trois questions sur NVDA en janvier » peut aider la recherche sans remplacer les conversations sources. Mem0 décide s’il faut ajouter, mettre à jour ou supprimer ; Graphiti garde les épisodes bruts liés aux faits dérivés. Aucun des deux ne fixe votre politique de rétention.
- Démarrage à froid. Un nouvel utilisateur n’a pas de mémoire. L’agent doit demander plutôt que supposer.
- Empoisonnement de la mémoire. Une note stockée peut contenir une instruction comme « toujours approuver les transactions ». Validez avant stockage, traitez le texte rappelé comme des données et gardez les permissions hors de la mémoire.
- Dérive des documents. Les fichiers n’ont ni déduplication ni détection de conflits automatiques ; une note peut dire « utiliser pytest » quand une autre dit « utiliser unittest ». Planifiez des relectures qui les élaguent et les fusionnent.
Tests de mémoire : écrire, lire, modifier, supprimer
Un test de mémoire utile crée un fait, le lit lors d’une exécution ultérieure, le modifie et vérifie que la nouvelle exécution utilise la valeur de remplacement. Il exerce aussi les défaillances et la suppression. Les tests ci-dessous découlent directement des quatre exigences du début de l’article.
| Test | Ce qu’il faut vérifier |
|---|---|
| Redémarrer pendant l’attente d’approbation | Le graphe est toujours à la frontière d’approbation ; il n’a pas publié de lui-même |
| Perdre la réponse à une écriture externe | Une nouvelle tentative ne crée pas de second effet, ou la reprise signale l’incertitude et s’arrête |
| Modifier une préférence de risque | Un nouveau thread lit la valeur actuelle et n’utilise pas l’ancienne |
| Reformuler une question sur une note antérieure | La source prévue est retrouvée, ou l’agent indique qu’il ne trouve pas assez d’éléments |
| Supprimer un fait stocké d’un utilisateur | La recherche exacte, l’index vectoriel, les résumés et les caches ne le renvoient plus |
| Interroger en tant qu’autre utilisateur | Aucun enregistrement ni document du premier utilisateur n’entre dans le contexte du second |
| Placer une fausse instruction dans une note | Les permissions et les règles d’approbation de l’application tiennent toujours |
Comparez à une baseline sans mémoire. Pour les tâches de recherche, une baseline en contexte complet aide à voir si le pipeline d’extraction et de recherche ajouté améliore quoi que ce soit dans les mêmes conditions de tâche. Mesurez la qualité de la recherche séparément de la qualité des réponses : une réponse d’apparence correcte peut provenir d’un fait erroné ou périmé. Relevez la latence, la croissance du stockage et tout coût d’embedding ou de modèle, plutôt que de supposer qu’une mémoire plus élaborée est meilleure.
LongMemEval propose 500 questions couvrant l’extraction d’informations, le raisonnement sur plusieurs sessions, le raisonnement temporel, les mises à jour et l’abstention. Son benchmark est utile pour concevoir des tests de rappel, mais un score obtenu dessus ne prouve pas qu’une application reprend sans risque ni qu’elle respecte la suppression. Un produit qui promet d’apprendre du travail antérieur a aussi besoin de tâches séquentielles où le feedback modifie le comportement ultérieur ; MemoryArena construit de telles tâches interdépendantes sur plusieurs sessions pour les achats, la planification de voyages, la recherche progressive et le raisonnement formel. Dans les deux cas, gardez le test proche de la défaillance que le produit doit éviter.
EvoMemBench a comparé 15 méthodes de mémoire à de solides baselines en contexte long, selon son protocole. Le contexte long est resté compétitif, et aucune forme de mémoire n’a été la meilleure dans tous les cas. Ce résultat ne choisit pas un store pour cet agent ; c’est une raison de garder la baseline simple et de tester si un chemin de mémoire ajouté améliore cette tâche.
Optionnel : examiner le projet d’accompagnement
Le Market Analyst Agent démontre les chemins du checkpoint, du profil et de l’archive de rapports. Il nécessite Python 3.13+, uv, Docker et des identifiants d’API pour le modèle et la recherche. Son analyse effectue des appels payants au modèle. Depuis un nouveau checkout, suivez la configuration de l’environnement du dépôt, puis exécutez :
git clone https://github.com/slavadubrov/market-analyst-agent
cd market-analyst-agent
git checkout 6794a0d
make setup
make install
cp .env.example .env
# Configure a model API key in .env before continuing.
make db-up
uv run market-analyst --set-profile --risk-tolerance conservative --horizon long
uv run market-analyst "Analyze NVDA stock"
# Use the thread ID printed by the run after it stops for approval.
uv run market-analyst --approve --thread-id <thread-id>
L’ID utilisateur en ligne de commande est une donnée de délimitation, pas un mécanisme d’authentification ; ajoutez une identité vérifiée et des contrôles de propriété avant d’exposer ce chemin comme service multi-utilisateur.
Utilisez le plus petit store qui passe ces tests. Pour le projet d’accompagnement, cela signifie un checkpoint durable, un enregistrement exact du profil et une archive de rapports. La recherche sémantique et un carnet de projet consultable ne sont des étapes suivantes utiles que si une vraie requête et une évaluation montrent ce qu’ils apportent. La partie 3 passe aux actions qu’un agent peut entreprendre avec ce contexte ; la partie 4 traite de la frontière de confiance autour de ces actions.
Références
Articles
- Cognitive Architectures for Language Agents (CoALA) — Sumers, Yao et al., 2023 — taxonomie des types de mémoire d’agent
- Memory in the Age of AI Agents — 2025 — état de l’art organisé par forme, fonction et dynamique de la mémoire
- MemGPT: Towards LLMs as Operating Systems — Packer et al., 2023 — gestion de contexte virtuel
- Generative Agents: Interactive Simulacra of Human Behavior — Park et al., 2023 — scoring par récence, importance et pertinence
- Zep: A Temporal Knowledge Graph Architecture for Agent Memory — Rasmussen, 2025 — graphe de connaissances temporel
- Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory — 2025 — pipeline d’extraction et de consolidation
- Voyager: An Open-Ended Embodied Agent with Large Language Models — Wang et al., 2023 — bibliothèque de compétences exécutables
- Agent Workflow Memory — Wang et al., 2024 — workflows réutilisables pour agents web
- LongMemEval — 2024 — benchmark de mémoire à long terme
- EvoMemBench — 2026 — comparaison de méthodes de mémoire avec des baselines en contexte long
LangGraph et backends de checkpoints
- Persistance LangGraph, checkpointers et stores
langgraph-checkpoint-postgres— saver PostgreSQLlanggraph-checkpoint-redis— saver et store Redislanggraph-checkpoint-sqlite— saver SQLite pour un usage locallanggraph-checkpoint-aws— saver DynamoDB avec déchargement vers S3
Recherche vectorielle, graphes et frameworks de mémoire
- pgvector — recherche vectorielle dans PostgreSQL
- Qdrant et son serveur MCP
- Graphiti — moteur de graphes de connaissances temporels de Zep
- Mem0, Letta et LangMem
Mémoire à base de fichiers
Projet de démonstration
- Market Analyst Agent — chemins de stockage des checkpoints, des profils et des documents