Mémoire des AI agents : état guidé par schéma et provenance

Traduction automatique
Cet article a été traduit automatiquement depuis la version originale en anglais.
Cet article s’adresse aux ingénieurs qui construisent des agents de longue durée ou multi-tenant. La mémoire sémantique simple n’a aucune règle pour dire quelle valeur d’un fait est la valeur courante, donc les agents renvoient des faits périmés. Quand un utilisateur modifie l’échéance de son passeport du 15 juillet au 30 juin, la recherche vectorielle peut retrouver les deux énoncés. Une couche de mémoire à état doit enregistrer que la valeur du 30 juin remplace la précédente.
Vous apprendrez à stocker la mémoire sous forme d’enregistrements typés avec fenêtres de validité, périmètre de tenant et liens vers les sources, à écrire une correction sans perdre l’historique, et à tester les lectures de l’état courant et à un instant donné.
Pourquoi le contexte et le rappel vectoriel renvoient des faits périmés
La fenêtre de contexte est l’entrée disponible pour un appel de modèle. Une application peut reporter des messages dans les appels suivants, mais c’est la politique de l’application qui doit décider quels anciens faits restent vrais et qui peut les voir.
Les agents de longue durée doivent mémoriser des préférences, l’état des tâches, des faits sur les clients, des décisions sur les outils, des notes de conformité et des erreurs passées. La version facile consiste à ajouter des résumés ou à déverser les anciennes notes dans un magasin vectoriel. Cela fonctionne jusqu’à ce qu’un des faits mémorisés change.
L’agent a alors deux échéances de passeport, deux formats préférés ou deux décisions de projet. La recherche sémantique peut retrouver les deux. Un résumé peut en écraser un. Un contexte long peut inclure le fait périmé à côté du fait actif. Ces conceptions renvoient du texte, mais ne peuvent pas dire quelle valeur est courante.
Le contrat de mémoire doit répondre à des questions concrètes :
- Qu’est-ce qui est vrai maintenant ?
- Qu’est-ce qui était vrai le 2 juin ?
- Qui l’a dit ?
- À quel tenant appartient-il ?
- Quel fait plus ancien ce fait a-t-il remplacé ?
- Puis-je le supprimer ou le faire expirer ?
Schema-Guided Agent Memory (SGAM) stocke ces réponses sous forme de champs et de relations, au lieu de les laisser implicites dans la prose.
Ce que signifie SGAM
Deux idées de recherche aux noms proches délimitent le périmètre de SGAM.
Schema-Guided Memory (SGM) est le terme de recherche utilisé par Mei et al. dans According to Me: Long-Term Personalized Referential Memory QA. L’article compare la Descriptive Memory (DM) en texte libre avec des éléments de mémoire clé-valeur à schéma fixe. Les deux représentations contiennent les mêmes informations sources dans des structures différentes. Un usage antérieur du nom, le Schema-Guided Dialogue dataset, suit l’état du dialogue pour des API de services et n’a aucun rapport avec la mémoire à long terme.
Dans cet article, j’utilise Schema-Guided Agent Memory (SGAM) pour désigner un pattern d’ingénierie dans lequel des schémas gouvernent les écritures, les mises à jour, la récupération et la suppression. Le schéma définit l’état applicatif et son cycle de vie.
ATM-Bench montre pourquoi la représentation compte. Il utilise environ quatre ans de données personnelles : e-mails, images et vidéos. Les questions exigent des références personnelles, un lieu, plusieurs éléments de preuve et des mises à jour dans le temps. SGM expose des champs tels que l’heure, la source, le lieu, les entités et les tags dans une représentation fixe. Sur le split difficile de 25 questions, le tableau 3 de l’article indique que le score global (QS) passe de 25,6 avec DM à 47,3 avec SGM lorsque le modèle de réponse reçoit les preuves de référence. Avec la récupération du système ATM-RAG des auteurs, le score du split difficile ne passe que de 14,1 à 16,3 : trouver les preuves reste donc le principal écart.
Le graphique place côte à côte les quatre scores du hard split. Comparez le gain apporté par les champs fixes avec la preuve de référence et avec la récupération.
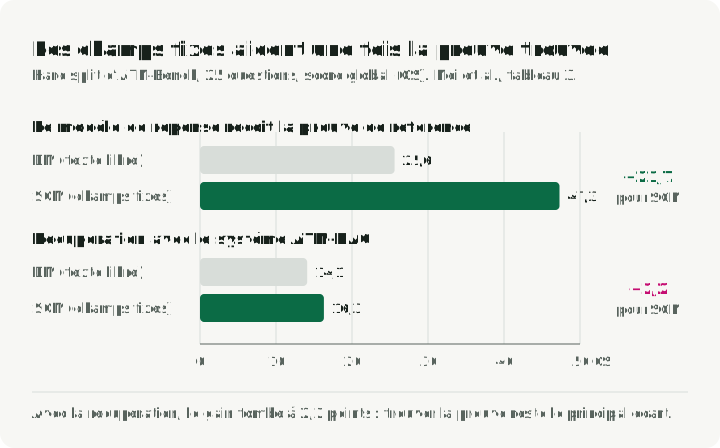
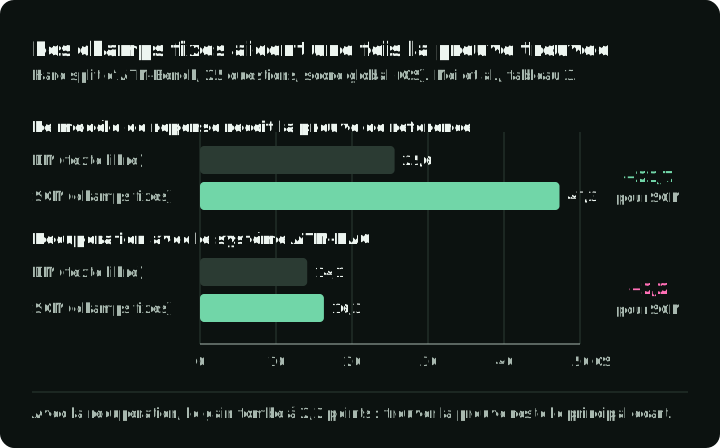
SGM contre DM répond à une question de stockage : la mémoire doit-elle rester en texte libre, ou utiliser des champs nommés ? Un agent en production a un autre problème avant le stockage. Il doit transformer une conversation non structurée en une proposition de mise à jour de la mémoire. La section suivante montre comment Schema-Guided Reasoning (SGR) façonne cet appel de modèle et où SGAM prend le relais.
Séparer l’extraction par le modèle de la responsabilité de la mémoire
L’écriture en mémoire traverse trois couches. Structured Output (SO) impose la forme de l’objet candidat. Schema-Guided Reasoning (SGR) rend les champs prévus par le modèle et l’intention de sa décision inspectables dans une réponse structurée. Schema-Guided Agent Memory (SGAM) gère le candidat comme un état durable après l’appel au modèle. Des appels distincts, des validateurs et la politique de l’application imposent les dépendances, l’ordre et les règles de cycle de vie.
Des articles précédents appliquent SGR aux juges structurés, aux planificateurs et routeurs et aux grilles d’évaluation de RAG. Dans chacun, un verdict, une route ou un plan expire en général avec la requête en cours. Une autre exécution peut lire un candidat de mémoire plusieurs jours plus tard, ou s’en servir pour choisir un tool call. Cette durée de vie plus longue exige des règles de stockage que SGR ne fournit pas.
SGR dispose les champs d’une réponse du modèle dans l’ordre où le modèle doit les remplir. Pour une écriture en mémoire, la réponse peut inclure la preuve source, un sujet et un attribut normalisés, une comparaison avec l’état courant et une mise à jour proposée. Pydantic ou JSON Schema décrit ces champs. Le Structured Output natif du fournisseur ou un runtime de décodage guidé comme XGrammar maintient la réponse dans cette forme. La forme ne peut pas garantir une conclusion correcte ni prouver que le modèle a utilisé ces champs dans l’ordre.
SGAM décide de ce qui se passe une fois cet objet créé. Faut-il le stocker ? Remplace-t-il un fait plus ancien ? Quel tenant peut le voir ? Est-il courant ou historique ? Quel épisode source l’appuie ?
Le tableau présente la responsabilité et le mode de défaillance de chaque couche :
| Dimension | SO | SGR | SGAM |
|---|---|---|---|
| Objectif | Renvoyer un objet conforme à un schéma | Rendre inspectables les champs prévus et l’intention de la décision | Gérer la mémoire durable après l’appel au modèle |
| Portée | Une réponse générée | Une réponse du modèle ; la politique inter-étapes peut couvrir plusieurs appels | Enregistrements utilisés entre les appels, les sessions et les exécutions |
| Rôle du schéma | Définit les champs de sortie, les types et les valeurs permises | Décrit la preuve, les champs intermédiaires et la décision candidate | Définit les enregistrements stockés, les relations et le cycle de vie |
| Application | Le constrained decoding bloque toute sortie invalide pour le schéma | Forme uniquement ; des appels distincts, des validateurs et la politique imposent les dépendances et l’ordre | La validation applicative, les contraintes de la base et les règles de conflit imposent le cycle de vie |
| Durée de vie | L’appel en cours, sauf si l’application stocke l’objet | La trace de raisonnement est en général jetée après la décision | Persiste jusqu’à mise à jour, expiration ou suppression |
| Mode de défaillance | Forme valide mais sens erroné | Les champs sont présents, mais le raisonnement ou la gestion des dépendances peut rester erroné | État périmé, pollué, sans périmètre ou impossible à auditer |
Le diagramme suit la correction de l’exemple ci-dessous jusqu’à une ligne stockée et montre qui définit chaque colonne : le modèle, le service d’écriture à partir de la requête, ou replace_fact.
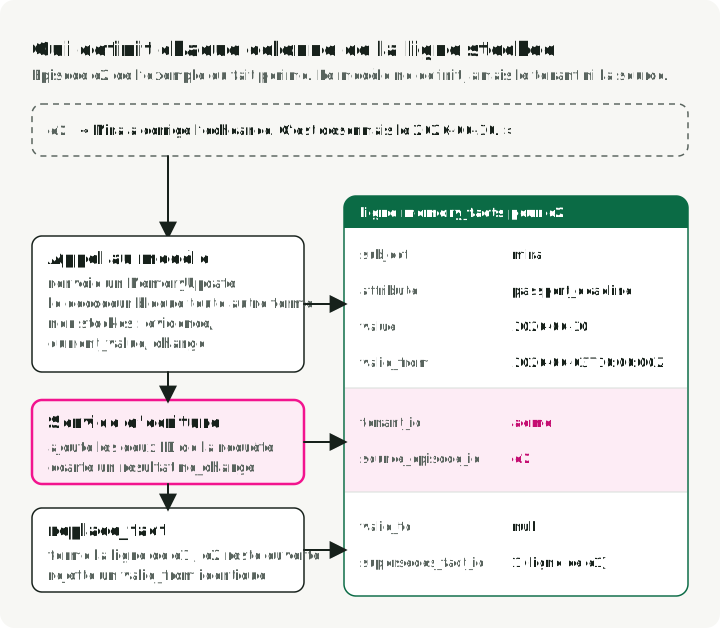
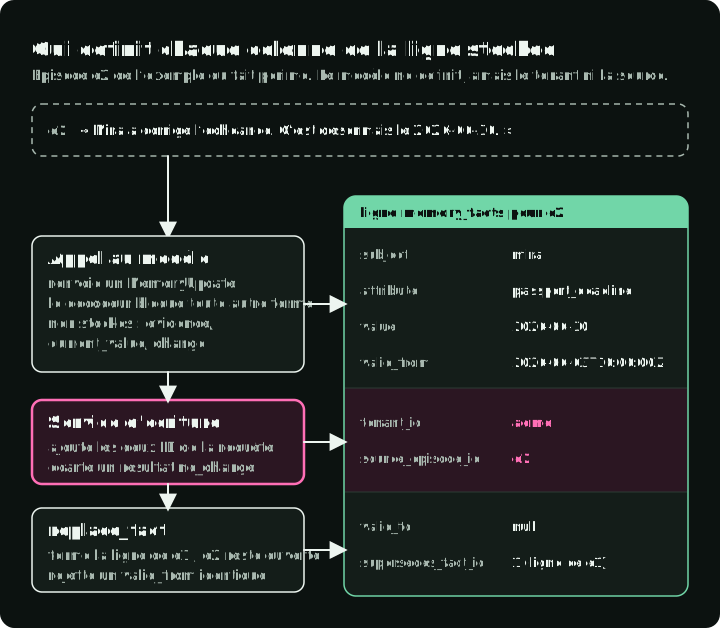
Le schéma suivant définit l’objet transmis de l’extraction au service d’écriture SGAM. Il requiert Pydantic. L’application place la valeur actuellement stockée dans le prompt, afin que le modèle puisse la comparer à la nouvelle preuve :
from datetime import datetime
from typing import Literal

from pydantic import BaseModel, Field

class MemoryUpdate(BaseModel):
    evidence: str = Field(description="Exact quote from the episode")
    subject: str = Field(description="Normalized entity ID, e.g. mira")
    attribute: str = Field(description="Property being updated")
    current_value: str | None = Field(description="Stored value shown in the prompt")
    change: Literal["new", "update", "no_change"]
    value: str | None = Field(description="New value; None when change is no_change")
    valid_from: datetime = Field(description="When the new value starts to apply")
Le service d’écriture écarte les résultats no_change, ajoute tenant_id et source_episode_id à partir de la requête, et transmet le reste à replace_fact dans l’exemple ci-dessous. Le modèle ne choisit jamais le tenant ni l’épisode source.
Les chemins d’écriture et de lecture ont des rôles différents
Seul le chemin d’écriture modifie l’état stocké. Le chemin de lecture sélectionne les enregistrements pour la requête en cours.
Le flux d’ingestion est le chemin d’écriture :
- Capturez un épisode brut à partir de messages, de tool results ou d’événements métier. Enregistrez son tenant et sa classe de rétention.
- Extrayez des candidats typés avec du structured output.
- Validez le payload avec Pydantic ou la couche de schéma que votre stack utilise déjà, et rejetez les écritures mal formées.
- Résolvez les conflits avant l’insertion : décidez si le nouvel enregistrement remplace un ancien, et clôturez le fait périmé.
- Conservez un pointeur de source vers l’épisode brut, le tool result, le fichier, le ticket ou la confirmation de l’utilisateur qui a produit l’enregistrement.
- Enregistrez durablement l’enregistrement dans le store SGAM avec son
schema_version, au lieu de laisser la version seulement dans le code de l’application.
Le flux de requête est le chemin de lecture :
- Partez de la question de l’utilisateur.
- Décidez si la question demande l’état courant ou l’état à un instant donné.
- Filtrez par tenant, type de mémoire, sujet, attribut et fenêtre de validité.
- N’ajoutez une expansion vectorielle ou par graphe que si la recherche exacte de l’état ne suffit pas. Utilisez-la pour les preuves complémentaires, les entités liées et les exemples, pas comme source d’autorité pour les faits courants.
- Assemblez le plus petit contexte cité pour le modèle.
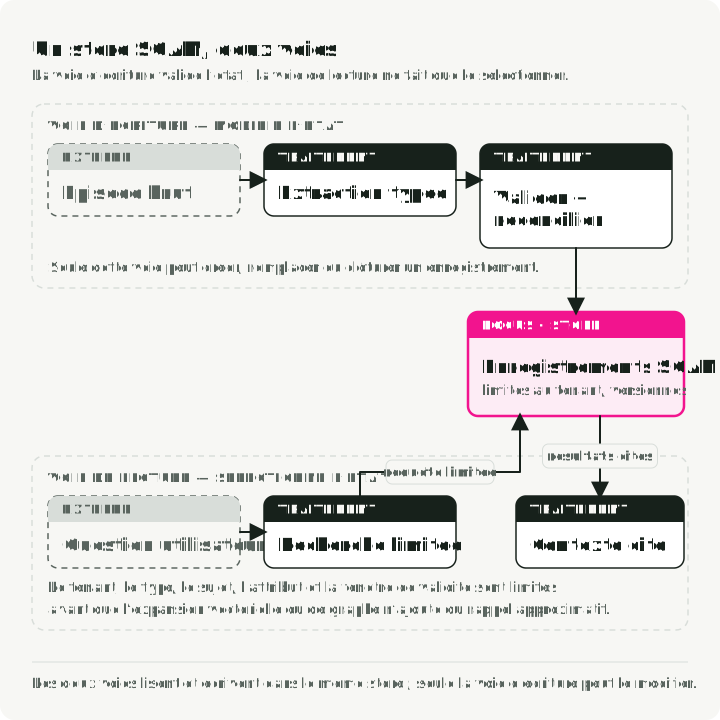
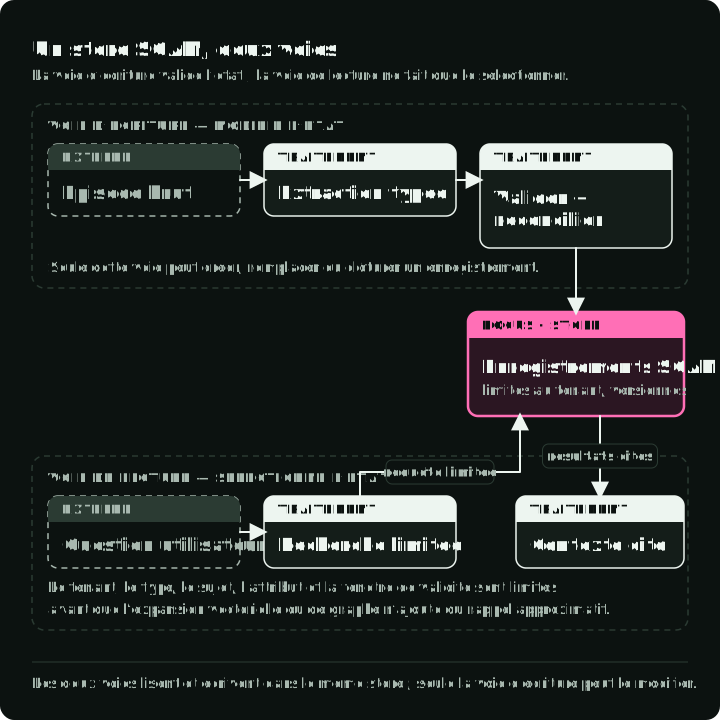
Lisez ce diagramme de haut en bas. Le chemin d’écriture ferme e1 et insère e2 dans un seul store. Le chemin de lecture choisit un filtre d’état courant ou à un instant donné, puis sélectionne des lignes dans ce même store.
Ce que contient un schéma de mémoire
Un enregistrement SGAM minimal demande plus que text. Chaque champ répond à l’une des questions de la première section ou remplit une fonction dans le cycle de vie :
| Champ | Question à laquelle il répond ou fonction qu’il remplit |
|---|---|
tenant_id | À quel tenant appartient-il ? Chaque lecture et chaque écriture filtrent dessus. |
memory_id | Un ID stable vers lequel pointent les autres enregistrements et les tâches de suppression. |
subject, attribute | La clé : quelle entité et quelle propriété, par exemple mira et passport_deadline. |
value | La valeur stockée. |
memory_type | Le type de mémoire : sémantique (faits stables et profils), épisodique (événements passés et traces) ou procédurale (instructions et règles de prompt), comme les décrit LangGraph. |
schema_version | Quel schéma a écrit l’enregistrement, afin qu’une migration puisse retrouver et convertir les anciens enregistrements. |
valid_from, valid_to | Qu’est-ce qui est vrai maintenant ? valid_from <= now et (valid_to est null ou now < valid_to). Qu’est-ce qui était vrai le 2 juin ? L’intervalle contient cet instant. |
supersedes_memory_id | Quel fait plus ancien ce fait a-t-il remplacé ? |
source_episode_id | Qui l’a dit ? Il pointe vers l’épisode brut. |
confidence | Un score que le service d’écriture compare à un seuil : promouvoir le candidat en état courant, ou demander à l’utilisateur de le confirmer. |
retention_policy | Puis-je le supprimer ou le faire expirer ? Elle indique aux tâches de suppression ce qu’elles doivent retirer d’autre. |
Avec ces champs, une nouvelle échéance de passeport peut clôturer l’échéance précédente sans effacer l’historique. La même table peut répondre aux requêtes sur l’état courant et à un instant donné, puis remonter du résultat à son épisode source.
Utilisez RAG pour récupérer des documents et SGAM pour maintenir un état modifiable. La recherche vectorielle garde sa place dans le système pour le rappel approximatif, le clustering et l’expansion. La valeur courante de mira.passport_deadline doit provenir d’un enregistrement de mémoire délimité par tenant, et non du chunk qui s’est trouvé en tête du classement.
Un exemple de fait périmé
Prenons une trace synthétique de deux épisodes, représentée par une baseline DM et un registre SGAM :
e1: Mira prefers concise answers. Her passport deadline is 2026-07-15.
e2: Mira corrected the deadline. It is now 2026-06-30.
Une baseline DM garde les deux épisodes en texte libre : la recherche textuelle peut donc renvoyer e1, parce qu’il contient les bons mots. SGAM extrait un fait typé de chaque épisode, identifié par tenant, sujet et attribut. Il doit renvoyer e2 comme état courant et garder e1 pour une requête historique.
Le script ci-dessous répond à deux des questions précédentes : ce qui est vrai maintenant, et ce qui était vrai le 2 juin. Regardez replace_fact : il clôture l’ancienne ligne au lieu de la supprimer, et il enregistre quelle ligne la nouvelle remplace. L’appelant doit normaliser chaque horodatage stocké ou utilisé dans une requête dans un format de chaîne UTC unique, avec une précision fixe à la seconde : YYYY-MM-DDTHH:MM:SSZ. SQLite compare ces valeurs TEXT dans l’ordre lexicographique ; mélanger les décalages horaires ou les précisions peut donc placer les faits dans le mauvais ordre. Chaque ligne est valide à partir de valid_from jusqu’à valid_to exclu. La table rejette les intervalles invalides et possède un index unique partiel qui garantit un seul fait ouvert par tenant, sujet et attribut. replace_fact gère sa propre transaction et la démarre avec BEGIN IMMEDIATE avant de lire une ligne. Appelez-la sur une connexion sans transaction active. SQLite sérialise les écritures concurrentes, donc les appelants doivent relancer toute la transaction après une erreur de verrou ou d’unicité. Une correspondance de mots-clés tient lieu de recherche vectorielle à la fin. Tout classement qui ignore la correction peut renvoyer e1.
import sqlite3
from dataclasses import dataclass

@dataclass(frozen=True)
class MemoryFact:
    tenant_id: str
    subject: str
    attribute: str
    value: str
    valid_from: str
    source_episode_id: str

def open_db() -> sqlite3.Connection:
    db = sqlite3.connect(":memory:")
    db.row_factory = sqlite3.Row
    db.executescript(
        """
        create table memory_facts (
            fact_id integer primary key,
            tenant_id text not null,
            subject text not null,
            attribute text not null,
            value text not null,
            valid_from text not null,
            valid_to text,
            supersedes_fact_id integer references memory_facts (fact_id),
            source_episode_id text not null,
            check (valid_to is null or valid_from < valid_to)
        );
        create unique index one_open_fact
        on memory_facts (tenant_id, subject, attribute)
        where valid_to is null;
        """
    )
    return db

def replace_fact(db: sqlite3.Connection, fact: MemoryFact) -> None:
    with db:
        db.execute("BEGIN IMMEDIATE")
        exact = db.execute(
            """
            select fact_id
            from memory_facts
            where tenant_id = ? and subject = ? and attribute = ? and valid_from = ?
            """,
            (fact.tenant_id, fact.subject, fact.attribute, fact.valid_from),
        ).fetchone()
        if exact:
            raise ValueError("equal valid_from requires an application conflict policy")

        containing = db.execute(
            """
            select fact_id, valid_to
            from memory_facts
            where tenant_id = ?
              and subject = ?
              and attribute = ?
              and valid_from < ?
              and (valid_to is null or valid_to > ?)
            limit 1
            """,
            (
                fact.tenant_id,
                fact.subject,
                fact.attribute,
                fact.valid_from,
                fact.valid_from,
            ),
        ).fetchone()
        if containing:
            db.execute(
                "update memory_facts set valid_to = ? where fact_id = ?",
                (fact.valid_from, containing["fact_id"]),
            )
            successor_boundary = containing["valid_to"]
        else:
            successor = db.execute(
                """
                select valid_from
                from memory_facts
                where tenant_id = ? and subject = ? and attribute = ? and valid_from > ?
                order by valid_from
                limit 1
                """,
                (fact.tenant_id, fact.subject, fact.attribute, fact.valid_from),
            ).fetchone()
            successor_boundary = successor["valid_from"] if successor else None

        db.execute(
            """
            insert into memory_facts
                (tenant_id, subject, attribute, value, valid_from, valid_to,
                 supersedes_fact_id, source_episode_id)
            values (?, ?, ?, ?, ?, ?, ?, ?)
            """,
            (
                fact.tenant_id,
                fact.subject,
                fact.attribute,
                fact.value,
                fact.valid_from,
                successor_boundary,
                containing["fact_id"] if containing else None,
                fact.source_episode_id,
            ),
        )

def fact_at(
    db: sqlite3.Connection, tenant_id: str, subject: str, attribute: str, timestamp: str
) -> sqlite3.Row | None:
    return db.execute(
        """
        select fact_id, value, valid_from, supersedes_fact_id, source_episode_id
        from memory_facts
        where tenant_id = ?
          and subject = ?
          and attribute = ?
          and valid_from <= ?
          and (valid_to is null or valid_to > ?)
        limit 1
        """,
        (tenant_id, subject, attribute, timestamp, timestamp),
    ).fetchone()

KEY = ("acme", "mira", "passport_deadline")

db = open_db()
replace_fact(db, MemoryFact(*KEY, "2026-07-15", "2026-06-01T09:00:00Z", "e1"))
replace_fact(db, MemoryFact(*KEY, "2026-06-30", "2026-06-03T10:00:00Z", "e2"))
current = fact_at(db, *KEY, "2026-06-04T00:00:00Z")
assert (current["value"], current["source_episode_id"]) == ("2026-06-30", "e2")

historical = fact_at(db, *KEY, "2026-06-02T00:00:00Z")
assert (historical["value"], historical["source_episode_id"]) == ("2026-07-15", "e1")
assert current["supersedes_fact_id"] == historical["fact_id"]

# A delayed extraction predates e1. It ends at e1's existing boundary,
# rather than closing e2, which remains current.
replace_fact(db, MemoryFact(*KEY, "2026-08-01", "2026-05-30T08:00:00Z", "e0"))
delayed = fact_at(db, *KEY, "2026-05-31T00:00:00Z")
assert (delayed["value"], delayed["source_episode_id"]) == ("2026-08-01", "e0")
current = fact_at(db, *KEY, "2026-06-04T00:00:00Z")
assert (current["value"], current["source_episode_id"]) == ("2026-06-30", "e2")
intervals = db.execute("select valid_from, valid_to from memory_facts").fetchall()
assert all(row["valid_to"] is None or row["valid_from"] < row["valid_to"] for row in intervals)

episodes = (
    "e1: Mira prefers concise answers. Her passport deadline is 2026-07-15.",
    "e2: Mira corrected the deadline. It is now 2026-06-30.",
)
naive_match = next(episode for episode in episodes if "passport deadline" in episode)
assert naive_match.startswith("e1:")

print("Naive text memory:")
print(f"  returned episode: {naive_match}")
print()
print("SGAM current state:")
print(f"  mira.passport_deadline = {current['value']}")
print(f"  valid_from={current['valid_from']}, source={current['source_episode_id']}")
print()
print("SGAM point-in-time state:")
print(f"  on 2026-06-02, mira.passport_deadline = {historical['value']}")
L’exécution du script affiche :
Naive text memory:
  returned episode: e1: Mira prefers concise answers. Her passport deadline is 2026-07-15.

SGAM current state:
  mira.passport_deadline = 2026-06-30
  valid_from=2026-06-03T10:00:00Z, source=e2

SGAM point-in-time state:
  on 2026-06-02, mira.passport_deadline = 2026-07-15
replace_fact rejette d’abord un valid_from identique : ce conflit demande une politique applicative, comme la priorité des sources ou une révision confirmée par l’utilisateur, plutôt qu’un écrasement silencieux. Sinon, la fonction cherche l’intervalle qui contient l’horodatage entrant. Si elle en trouve un, elle clôture ce prédécesseur à la borne entrante, donne à la ligne insérée l’ancienne fin du prédécesseur, et enregistre le prédécesseur dans supersedes_fact_id. Si l’horodatage précède tous les intervalles stockés, elle utilise le valid_from de l’intervalle suivant comme fin de la nouvelle ligne. Ainsi, un fait tardif antérieur à e1 devient [2026-05-30, 2026-06-01) et laisse intacts e1 et e2, qui reste courant. L’index unique partiel est la garde de la base pour une seule ligne ouverte. DM n’a pas d’étape de mise à jour équivalente : l’ancien texte peut donc encore passer devant la correction.
La chronologie montre les lignes après chaque appel à replace_fact dans le script, puis les trois lectures. Regardez l’étape 2, où e2 ferme e1, et l’étape 3, où le e0 tardif se termine là où e1 commence.
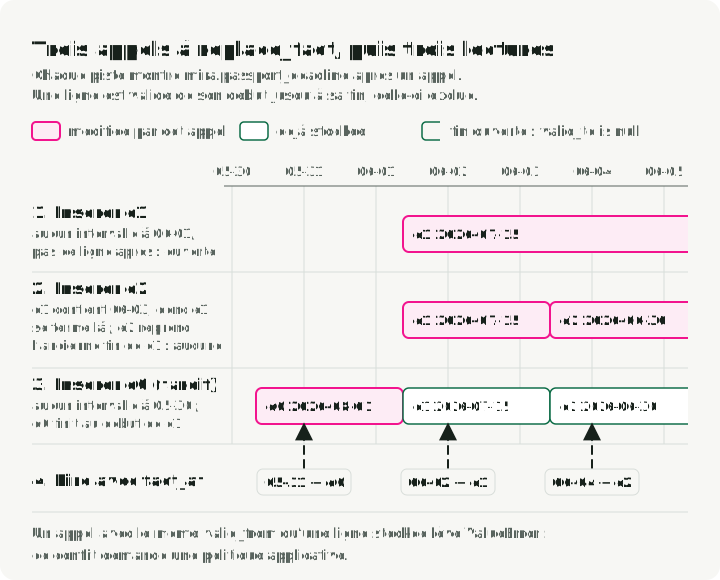
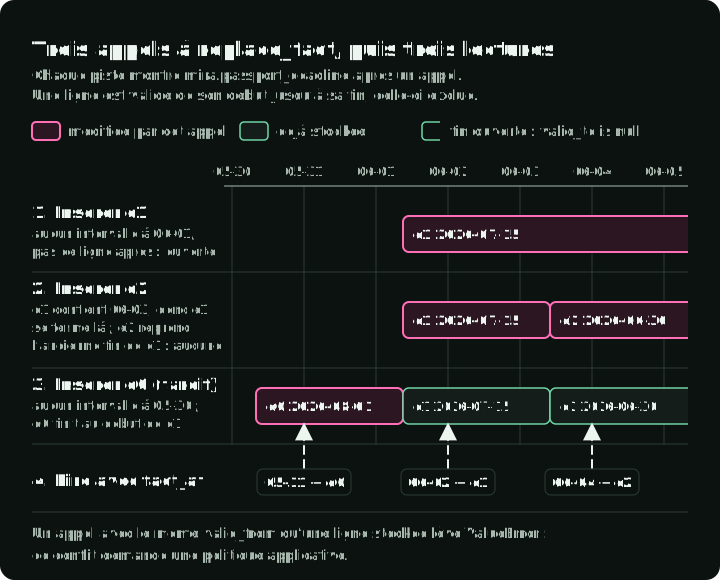
En production, associez cette transaction à une extraction structurée sur le chemin d’écriture. La transaction de base de données met à jour la validité temporelle. Le modèle extrait un fait candidat, mais ne décide pas quelle ligne stockée reste courante.
Les choix de stockage suivent le pattern de récupération
Les projets emploient plusieurs noms pour des parties de ce pattern : memory stores, context graphs, profils, stores à long terme, graph RAG et agents à état.
| Outil ou framework | Couche de stockage principale | Mécanisme d’état temporel | Mécanisme de schéma | À utiliser quand |
|---|---|---|---|---|
| Graphiti | Neo4j, FalkorDB et Amazon Neptune ; Kuzu est déprécié | Intervalles de validité des faits plus provenance par épisode source | Types d’entités et d’arêtes Pydantic, arêtes temporelles, provenance | Vous avez besoin d’intervalles de validité et de parcours de graphe, et vous exploiterez la base de graphe |
| Zep | Context Graph Engine propriétaire | Context Graphs temporels managés qui conservent les faits changeants | Types d’entités et d’arêtes par défaut et personnalisés | Vous voulez le même modèle de graphe temporel sous forme de service managé |
| LangGraph / LangMem | Stores LangGraph, stores adossés à Postgres | Horodatages et champs gérés par l’application dans les enregistrements du store | Stores JSON plus extraction de profils ou de collections avec Pydantic | Vous utilisez déjà LangGraph et acceptez de gérer vous-même les horodatages et les règles de conflit |
| Mem0 | Stack managée, Valkey / Redis / backends vectoriels dans les installations OSS | Mises à jour de la mémoire ; la politique temporelle reste à la charge de l’application | Types de mémoire, catégories personnalisées, prompts d’extraction | Vous voulez des opérations managées d’ajout, de recherche, de mise à jour et de suppression, délimitées par utilisateur, agent, application ou exécution, et vous gérerez la politique temporelle |
| Letta / MemGPT | État d’agent et blocs de mémoire adossés à une base de données | Blocs modifiables sans intervalles de validité par champ | Blocs de mémoire étiquetés et modifiables | L’agent modifie lui-même ses blocs de mémoire, ou plusieurs agents ont besoin d’un bloc partagé que tous voient |
| Cognee | Graphe plus backends vectoriels et relationnels | L’historique dépend de l’ontologie et du backend choisi | Extraction et validation orientées ontologie | Vous validez l’extraction par rapport à une ontologie métier |
| LlamaIndex property graph | Stores de property graph plus magasins vectoriels | Les champs de temps dépendent du schéma du graphe et du store | SchemaLLMPathExtractor avec entités et relations autorisées | Vous extrayez un property graph à partir de documents ou de traces |
LangGraph sépare les checkpoints de thread, qui reprennent une conversation, des stores inter-threads, qui contiennent des données que les threads suivants lisent. L’article Zep rapporte des gains sur Deep Memory Retrieval et LongMemEval, et l’article Mem0 en rapporte sur LoCoMo. Chaque éditeur a rédigé son propre article : lisez ces chiffres comme des résultats d’éditeur, pas comme des garanties pour votre charge de travail.
Commencez par le modèle de données. Si la recherche exacte de faits est l’opération principale, une table relationnelle avec des payloads JSON, des colonnes de validité, des index de tenant et un vector sidecar suffit en général. Ajoutez un graphe quand les requêtes du produit suivent des relations.
Construire le chemin d’écriture avant le graphe
Décidez d’abord ce que le produit a le droit de mémoriser. Le choix entre graphe et vecteurs vient ensuite.
Un agent de support peut mémoriser le niveau du compte, les cas ouverts et les préférences de contact durables. Il ne doit pas promouvoir en état de profil chaque remarque agacée. Un agent de code peut mémoriser les conventions du dépôt et les tâches non résolues. Il ne doit pas garder indéfiniment une note privée parce qu’elle a été récupérée une fois.
Le premier store SGAM peut être une table relationnelle avec une colonne JSON et quelques index, alimentée par le chemin d’écriture en six étapes ci-dessus. Un graphe devient utile quand le produit doit parcourir des relations comme client-compte, compte-politique, tâche-artefact ou projet-décision.
Hot path et écritures en arrière-plan
L’extraction immédiate vaut le coup quand le tour suivant dépend de la nouvelle mémoire. Si l’utilisateur dit « retiens que je préfère les réponses courtes », le système ne doit pas attendre une tâche nocturne pour changer de comportement.
La plupart des tours n’exigent pas d’écriture immédiate. Enregistrez l’épisode brut avec les métadonnées de tenant, de session et d’outil, puis laissez un worker en arrière-plan extraire les candidats plus tard. Avec une consolidation par récurrence, le worker met en tampon les signaux faibles et ne promeut un fait qu’après répétition d’une preuve similaire ou confirmation de l’utilisateur. Cela ajoute un décalage de fraîcheur. C’est acceptable pour « l’utilisateur demande souvent des exports CSV » et risqué pour « le client a changé son adresse de livraison ».
Traitez la migration de schéma comme un changement de produit, car elle modifie ce que l’agent peut rappeler, citer ou supprimer. Elle peut aussi changer les faits historiques considérés comme courants. Planifiez dans la même version les scripts de migration, les backfills, les fenêtres de double lecture et le comportement de suppression.
Quand SGAM justifie sa complexité
Utilisez SGAM quand les faits peuvent changer dans le temps :
- préférences utilisateur qui peuvent être mises à jour ou révoquées
- faits sur les clients ou les comptes soumis à des exigences d’audit
- état des tâches pour les assistants de longue durée
- mémoire de projet d’un agent de code
- état partagé multi-agent
- notes de conformité où la provenance compte
- questions temporelles comme « que croyions-nous avant la migration ? »
SGAM est excessif quand la mémoire est éphémère, exploratoire ou peu coûteuse à recalculer. Si l’agent n’a besoin que de quelques tours de continuité, un checkpoint et un historique de messages tronqué suffisent. L’interrogation de documents statiques peut se contenter de RAG. Et si le domaine est si instable que le schéma change tous les jours, la mémoire typée ralentira l’équipe.
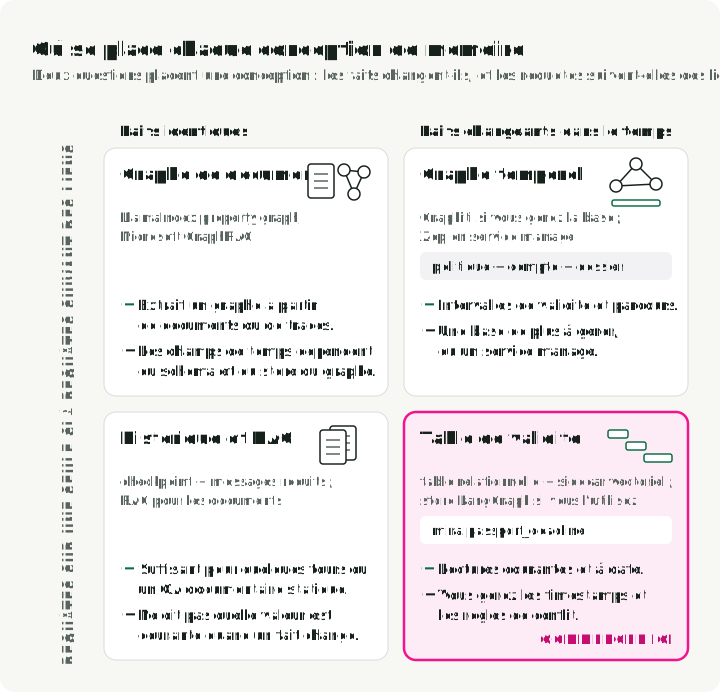
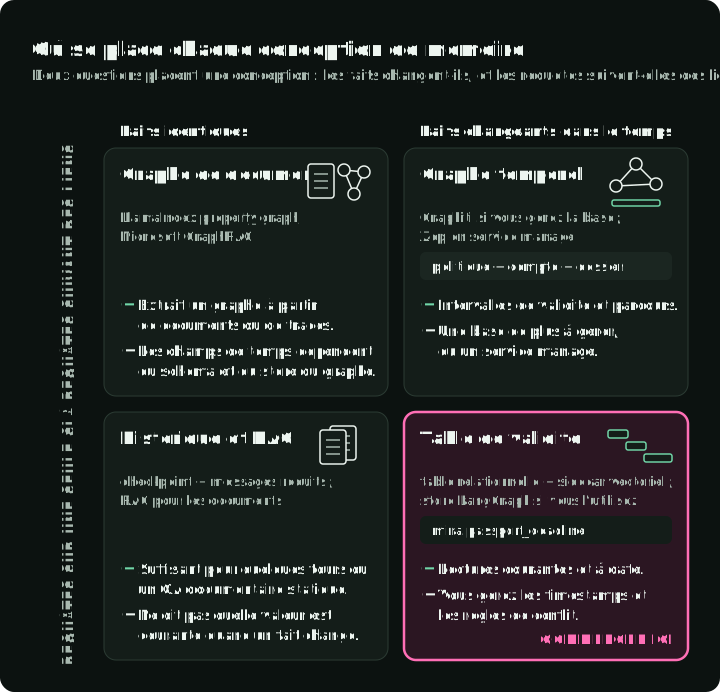
La grille place chaque conception selon deux questions : vos faits changent-ils, et vos requêtes suivent-elles des liens entre enregistrements ?
Checklist d’évaluation
Évaluez le cycle de vie de la mémoire en plus de la réponse finale. Un système peut produire une réponse plausible après avoir écrit un mauvais fait, récupéré un fait périmé ou franchi une frontière de tenant.
J’utilise la même découpe étape par étape que dans mon article sur l’évaluation de RAG. Mesurez l’étape où une défaillance peut survenir plutôt que de limiter l’évaluation au texte généré. La discipline de traçage de l’article sur l’évaluation des agents s’applique aussi, car un bug de mémoire apparaît souvent dans l’historique d’exécution avant d’atteindre la réponse.
Je testerais SGAM par rejeu. Injectez une séquence fixe d’épisodes dans le service d’écriture de mémoire et inspectez le registre après chaque tour significatif. Posez ensuite des questions sur l’état courant et sur l’état à un instant donné au store obtenu.
| Couche | Défaillance recherchée | Mesures |
|---|---|---|
| Extraction à l’écriture | L’agent a manqué un fait, en a inventé un ou a produit une forme invalide | Taux d’écritures valides pour le schéma, précision et rappel d’extraction, couverture des épisodes sources |
| Gestion des conflits | Un fait périmé est resté courant ou un ancien fait valide a été écrasé | Exactitude du remplacement, taux de doublons, exactitude de l’invalidation des faits périmés |
| Isolation et politique | La mémoire a fuité entre utilisateurs ou a survécu à sa fenêtre de politique | Échecs d’isolation entre tenants, exactitude des suppressions, conformité de la rétention |
| Récupération à la lecture | Le bon enregistrement existe mais le lecteur ne l’a pas récupéré | Exactitude de l’état courant, exactitude à un instant donné, recall@k sur les enregistrements de mémoire |
| Ancrage de la réponse | La réponse a utilisé la mémoire sans appui ou cité la mauvaise source | Appui des affirmations par les épisodes sources, exactitude des citations, exactitude de la résolution des conflits |
| Exploitation | Le chemin de mémoire est trop lent, trop périmé ou trop coûteux | Latence d’écriture p95, décalage de fraîcheur, latence de lecture, coût par requête |
Des benchmarks comme LoCoMo, LongMemEval et ATM-Bench fournissent des cas de test publics. Ils ne remplacent pas une suite de tests propre à votre domaine. Un assistant de code, un bot de support client et un copilote de conformité ont besoin de schémas, de filtres, de règles de rétention et de tests de défaillance différents.
From traces to better memory exécute une boucle d’amélioration sur un outil de mémoire qui stocke des faits avec un propriétaire, un événement source et un intervalle de validité, en suivant ces règles.
Réserves
SGAM est mon étiquette pour un pattern, pas un standard. Les outils du tableau ci-dessus utilisent d’autres noms pour des parties de ce pattern : memory stores, context graphs temporels, blocs de mémoire et graphes de connaissances. Microsoft GraphRAG présente une partie voisine du problème comme de la récupération par graphe sur des documents.
Un profil utilisateur, un journal d’épisodes, un graphe de documents et un bloc de mémoire modifiable par l’agent résolvent des problèmes différents de récupération et de mise à jour. Je réserve SGAM à la mémoire durable qui représente l’état courant de l’application et qui a donc besoin de schéma, de validité, de provenance, de gestion des conflits, de rétention et de migration.
Une mémoire typée peut quand même être fausse. Un schéma rend les mauvaises écritures plus faciles à inspecter ; il ne les rend pas dignes de confiance. Il vous faut toujours de la confiance dans les sources, une confirmation de l’utilisateur pour les faits sensibles, une politique de conflit, de la suppression et de la supervision.
Références
- According to Me: Long-Term Personalized Referential Memory QA - article de Mei et al. qui introduit ATM-Bench et Schema-Guided Memory.
- Towards Scalable Multi-Domain Conversational Agents: The Schema-Guided Dialogue Dataset - article de Rastogi et al. sur le dataset SGD.
- Evaluating Very Long-Term Conversational Memory of LLM Agents - article de Maharana et al. qui introduit LoCoMo.
- LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory - benchmark de Wu et al. pour les capacités de mémoire à long terme.
- Graphiti: Build Temporal Context Graphs for AI Agents
- Zep: A Temporal Knowledge Graph Architecture for Agent Memory
- Mem0 Platform Overview
- Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory
- LangGraph Memory Overview
- LangGraph Persistence
- LangMem documentation
- Letta: Introduction to Stateful Agents
- Letta: Shared memory
- Microsoft GraphRAG documentation
- LlamaIndex: Using a Property Graph Index
- Cognee Documentation
- Pydantic model validation docs
- Python sqlite3 documentation