AI Agent Memory: schemagestuurde state en herkomst

Automatische vertaling
Dit artikel is automatisch vertaald vanuit de oorspronkelijke Engelse versie.
Dit artikel is voor engineers die langlopende of multi-tenant agents bouwen. Eenvoudige semantic memory heeft geen regel voor welke waarde van een feit de huidige is, dus agents geven verouderde feiten terug. Wijzigt een gebruiker een paspoortdeadline van 15 juli naar 30 juni, dan kan vector search beide uitspraken ophalen. Een stateful geheugenlaag moet vastleggen dat de waarde van 30 juni de eerdere vervangt.
Je leert hoe je geheugen opslaat als getypeerde records met geldigheidsperiodes, tenant-scope en bronverwijzingen, hoe je een correctie schrijft zonder de historie te verliezen en hoe je huidige en point-in-time-reads test.
Waarom context en vector-recall verouderde feiten teruggeven
Het context window is de input die beschikbaar is voor één modelaanroep. Een applicatie kan berichten meenemen naar latere aanroepen, maar het applicatiebeleid moet bepalen welke oude feiten nog waar zijn en wie ze mag zien.
Langlopende agents moeten voorkeuren, taakstatus, klantfeiten, tool-beslissingen, compliance-notities en eerdere fouten onthouden. De makkelijke aanpak is samenvattingen toevoegen of oude notities in een vector store gooien. Dat werkt totdat een van de onthouden feiten verandert.
Dan heeft de agent twee paspoortdeadlines, twee voorkeursformaten of twee projectbeslissingen. Semantic search kan beide ophalen. Een samenvatting kan er één overschrijven. Een lange context kan de verouderde naast de actieve bevatten. Deze ontwerpen geven tekst terug, maar kunnen niet zeggen welke waarde actueel is.
Het geheugencontract moet concrete vragen beantwoorden:
- Wat is nu waar?
- Wat was waar op 2 juni?
- Wie zei het?
- Bij welke tenant hoort het?
- Welk ouder feit heeft dit feit vervangen?
- Kan ik het verwijderen of laten verlopen?
Schema-Guided Agent Memory (SGAM) slaat die antwoorden op als velden en relaties in plaats van ze impliciet in proza te laten.
Wat SGAM betekent
Twee onderzoeksideeën met een vergelijkbare naam bepalen de reikwijdte van SGAM.
Schema-Guided Memory (SGM) is de onderzoeksterm van Mei et al. in According to Me: Long-Term Personalized Referential Memory QA. Het paper vergelijkt Descriptive Memory (DM) in vrije tekst met key-value-geheugenitems met een vast schema. Beide representaties bevatten dezelfde broninformatie in een andere structuur. Een eerder gebruik van de naam, de Schema-Guided Dialogue dataset, volgt de dialoogstatus voor service-APIs en staat los van long-term memory.
In dit artikel gebruik ik Schema-Guided Agent Memory (SGAM) voor een engineeringpatroon waarin schema’s het schrijven, bijwerken, ophalen en verwijderen sturen. Het schema definieert de applicatiestate en de levenscyclus ervan.
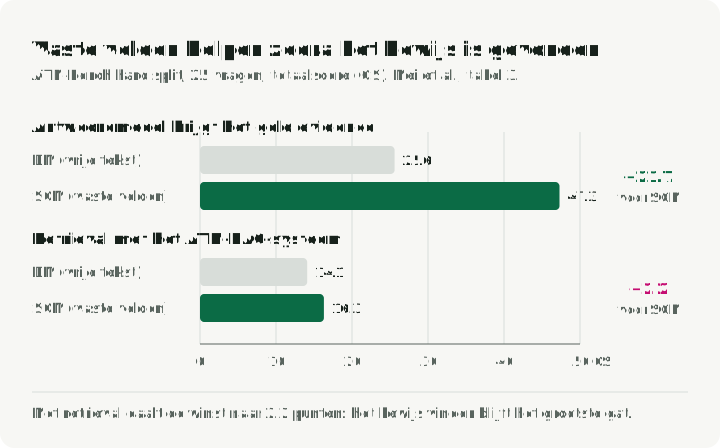
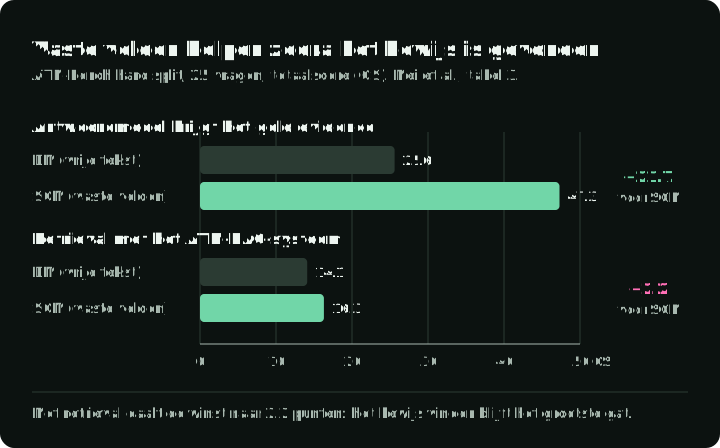
ATM-Bench laat zien waarom de representatie ertoe doet. Het gebruikt ongeveer vier jaar aan persoonlijke data uit e-mails, afbeeldingen en video’s. De vragen vereisen persoonlijke verwijzingen, locatie, meerdere bewijsstukken en updates in de tijd. SGM legt velden zoals tijd, bron, locatie, entiteiten en tags vast in een vaste representatie. Op de hard split van 25 vragen meldt Tabel 3 van het paper dat de totaalscore (QS) stijgt van 25,6 met DM naar 47,3 met SGM wanneer het antwoordmodel het gold evidence krijgt. Met retrieval in het ATM-RAG-systeem van de auteurs stijgt de score op de hard split slechts van 14,1 naar 16,3, dus het vinden van het bewijs blijft de grootste kloof.
De grafiek zet de vier scores van de hard split naast elkaar. Vergelijk de winst van vaste velden met gold evidence en met retrieval.
SGM tegenover DM beantwoordt een opslagvraag: moet geheugen vrije tekst blijven, of benoemde velden gebruiken? Een productie-agent heeft vóór de opslag een ander probleem. Hij moet een ongestructureerd gesprek omzetten in een voorgestelde geheugenupdate. De volgende sectie laat zien hoe Schema-Guided Reasoning (SGR) die modelaanroep vormgeeft en waar SGAM het overneemt.
Scheid modelextractie van geheugeneigenaarschap
Het schrijven van geheugen doorloopt drie lagen. Structured Output (SO) dwingt de vorm van het kandidaatobject af. Schema-Guided Reasoning (SGR) maakt de beoogde velden en de beslissingsintentie van het model inspecteerbaar in een gestructureerd antwoord. Schema-Guided Agent Memory (SGAM) beheert de kandidaat als duurzame state na de modelaanroep. Aparte aanroepen, validators en applicatiebeleid dwingen afhankelijkheden, volgorde en levenscyclusregels af.
Eerdere artikelen passen SGR toe op gestructureerde judges, planners en routers en RAG-rubrics. In elk daarvan vervalt een oordeel, route of plan meestal met het huidige verzoek. Een andere run kan een geheugenkandidaat dagen later lezen of gebruiken om een tool call te kiezen. Die langere levensduur vraagt om opslagregels die SGR niet biedt.
SGR legt de velden van één modelantwoord neer in de volgorde waarin het model ze moet invullen. Bij een geheugenwrite kan het antwoord bronbewijs bevatten, een genormaliseerd onderwerp en attribuut, een vergelijking met de huidige state en een voorgestelde update. Pydantic of JSON Schema beschrijft die velden. Provider-native Structured Output of een guided-decoding-runtime zoals XGrammar houdt het antwoord in die vorm. De vorm kan geen juiste conclusie garanderen en bewijst niet dat het model die velden in volgorde heeft gebruikt.
SGAM beslist wat er gebeurt zodra dat object bestaat. Moet het worden opgeslagen? Vervangt het een ouder feit? Welke tenant mag het zien? Is het actueel of historisch? Welke bronepisode ondersteunt het?
De tabel toont het eigenaarschap en de faalwijze van elke laag:
| Dimensie | SO | SGR | SGAM |
|---|---|---|---|
| Doel | Een object teruggeven dat aan een schema voldoet | Beoogde velden en beslissingsintentie inspecteerbaar maken | Duurzaam geheugen beheren na de modelaanroep |
| Bereik | Eén gegenereerd antwoord | Eén modelantwoord; beleid over meerdere stappen kan meerdere aanroepen beslaan | Records die tussen aanroepen, sessions en runs worden gebruikt |
| Rol schema | Definieert outputvelden, typen en toegestane waarden | Beschrijft bewijs, tussenvelden en de kandidaatbeslissing | Definieert opgeslagen records, relaties en levenscyclus |
| Afdwinging | Constrained decoding blokkeert output die het schema schendt | Alleen de vorm; aparte aanroepen, validators en beleid dwingen afhankelijkheden en volgorde af | Applicatievalidatie, databaseconstraints en conflictregels dwingen de levenscyclus af |
| Levensduur | De huidige aanroep, tenzij de applicatie het object opslaat | De reasoning trace wordt na de beslissing meestal weggegooid | Blijft bestaan tot het wordt bijgewerkt, verloopt of wordt verwijderd |
| Faalwijze | Geldige vorm met de verkeerde betekenis | De velden zijn aanwezig, maar de reasoning of afhankelijkheidsafhandeling kan nog fout zijn | Verouderde, vervuilde, niet afgebakende of niet controleerbare state |
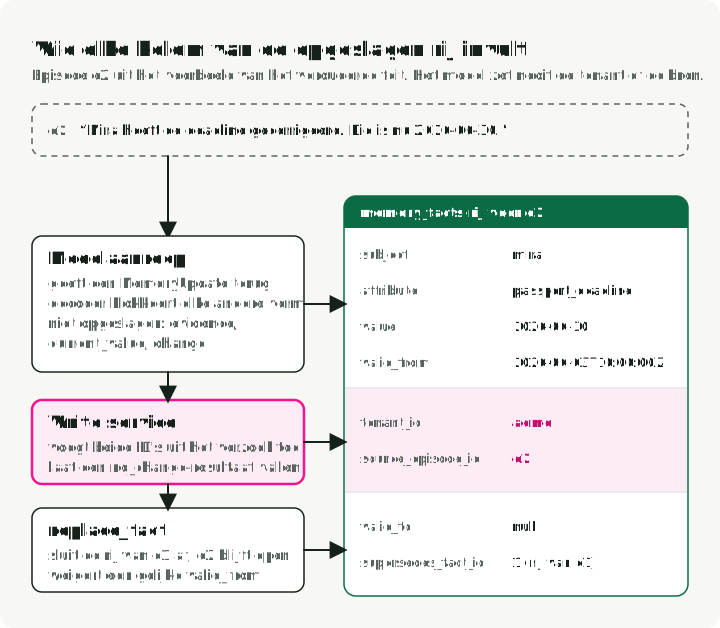
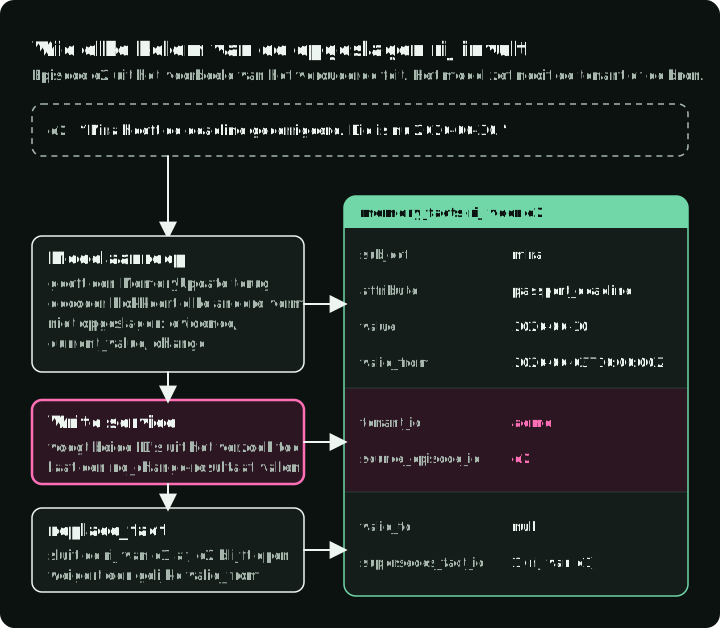
Het diagram volgt de correctie uit het onderstaande voorbeeld naar één opgeslagen rij en toont wie elke kolom invult: het model, de write service op basis van het verzoek, of replace_fact.
Het volgende schema definieert het object dat van extractie naar de SGAM-writeservice gaat. Het vereist Pydantic. De applicatie zet de nu opgeslagen waarde in de prompt, zodat het model die kan vergelijken met het nieuwe bewijs:
from datetime import datetime
from typing import Literal

from pydantic import BaseModel, Field

class MemoryUpdate(BaseModel):
    evidence: str = Field(description="Exact quote from the episode")
    subject: str = Field(description="Normalized entity ID, e.g. mira")
    attribute: str = Field(description="Property being updated")
    current_value: str | None = Field(description="Stored value shown in the prompt")
    change: Literal["new", "update", "no_change"]
    value: str | None = Field(description="New value; None when change is no_change")
    valid_from: datetime = Field(description="When the new value starts to apply")
De writeservice laat no_change-resultaten vallen, voegt tenant_id en source_episode_id uit het verzoek toe en geeft de rest door aan replace_fact in het voorbeeld hieronder. Het model kiest nooit de tenant of de bronepisode.
Schrijf- en leespad hebben een verschillende taak
Alleen het schrijfpad verandert opgeslagen state. Het leespad selecteert records voor het huidige verzoek.
De ingestion flow is het schrijfpad:
- Leg een ruwe episode vast uit berichten, tool results of bedrijfsgebeurtenissen. Registreer de tenant en de bewaarklasse.
- Extraheer getypeerde kandidaten met structured output.
- Valideer de payload met Pydantic of de schemalaag die je stack al gebruikt, en wijs onjuiste writes af.
- Los conflicten op vóór de insert: bepaal of het nieuwe record een oud record vervangt en sluit het verouderde feit af.
- Bewaar een bronverwijzing naar de ruwe episode, het tool result, het bestand, het ticket of de gebruikersbevestiging die het record heeft opgeleverd.
- Commit het record naar de SGAM-store met zijn
schema_version, in plaats van de versie alleen in applicatiecode te laten.
De request flow is het leespad:
- Begin met de vraag van de gebruiker.
- Bepaal of de vraag de huidige state of de state op een bepaald moment nodig heeft.
- Filter op tenant, geheugentype, onderwerp, attribuut en geldigheidsperiode.
- Voeg vector- of grafuitbreiding alleen toe als de exacte state-lookup niet genoeg is. Gebruik die voor ondersteunend bewijs, gerelateerde entiteiten en voorbeelden, niet als autoriteit voor huidige feiten.
- Stel de kleinst mogelijke context met bronvermelding samen voor het model.
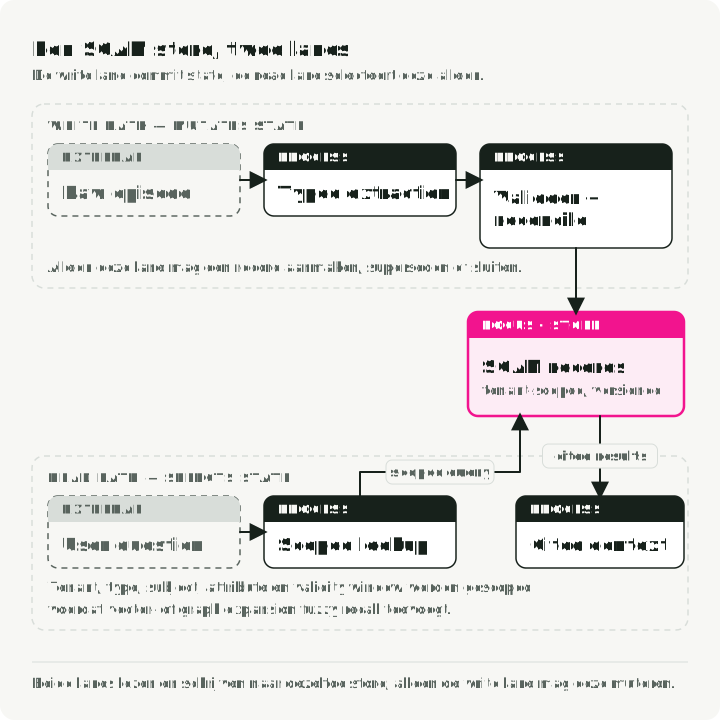
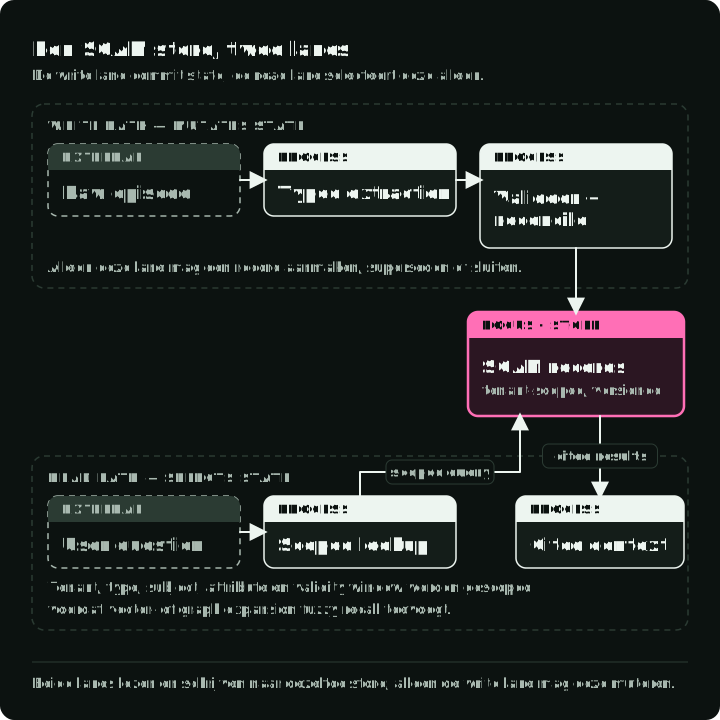
Lees dat diagram van boven naar beneden. Het schrijfpad sluit e1 af en voegt e2 in één store in. Het leespad kiest een filter voor huidige of point-in-time-state en selecteert daarna rijen uit diezelfde store.
Wat in een geheugenschema thuishoort
Een minimaal SGAM-record heeft meer nodig dan text. Elk veld beantwoordt een van de vragen uit de eerste sectie of doet één taak in de levenscyclus:
| Veld | Vraag die het beantwoordt of taak die het doet |
|---|---|
tenant_id | Bij welke tenant hoort het? Elke read en write filtert erop. |
memory_id | Een stabiel ID waar andere records en verwijderjobs naar verwijzen. |
subject, attribute | De sleutel: welke entiteit en welke eigenschap, zoals mira en passport_deadline. |
value | De opgeslagen waarde. |
memory_type | Het soort geheugen: semantisch (stabiele feiten en profielen), episodisch (eerdere gebeurtenissen en traces) of procedureel (instructies en promptregels), zoals LangGraph ze beschrijft. |
schema_version | Welk schema het record schreef, zodat een migratie oude records kan vinden en omzetten. |
valid_from, valid_to | Wat is nu waar? valid_from <= now en (valid_to is null of now < valid_to). Wat was waar op 2 juni? Het interval bevat dat tijdstip. |
supersedes_memory_id | Welk ouder feit heeft dit feit vervangen? |
source_episode_id | Wie zei het? Het verwijst naar de ruwe episode. |
confidence | Een score die de writeservice met een drempel vergelijkt: de kandidaat promoveren tot huidige state, of de gebruiker om bevestiging vragen. |
retention_policy | Kan ik het verwijderen of laten verlopen? Het vertelt verwijderjobs wat ze nog meer moeten wissen. |
Met deze velden kan een nieuwe paspoortdeadline de vorige afsluiten zonder de historie te wissen. Dezelfde tabel kan huidige en point-in-time-queries beantwoorden en het resultaat herleiden tot de bronepisode.
Gebruik RAG om documenten op te halen en SGAM om veranderlijke state bij te houden. Vector search hoort nog steeds in het systeem voor vage recall, clustering en uitbreiding. De huidige waarde van mira.passport_deadline moet uit een afgebakend geheugenrecord komen, niet uit de chunk die toevallig als eerste scoorde.
Een voorbeeld met een verouderd feit
Neem een synthetische trace met twee episodes, weergegeven als DM-baseline en als SGAM-ledger:
e1: Mira prefers concise answers. Her passport deadline is 2026-07-15.
e2: Mira corrected the deadline. It is now 2026-06-30.
Een DM-baseline bewaart beide episodes als vrije tekst, dus tekstzoeken kan e1 teruggeven omdat die de juiste woorden bevat. SGAM haalt uit elke episode een getypeerd feit, gesleuteld op tenant, onderwerp en attribuut. Het hoort e2 terug te geven als huidige state en e1 te bewaren voor een historische query.
Het script hieronder beantwoordt twee van de eerdere vragen: wat nu waar is en wat waar was op 2 juni. Kijk naar replace_fact: het sluit de oude rij af in plaats van die te verwijderen en legt vast welke rij de nieuwe vervangt. De aanroeper moet elke opgeslagen of voor een query gebruikte tijdstempel normaliseren naar één UTC-stringformaat met een vaste precisie van seconden: YYYY-MM-DDTHH:MM:SSZ. SQLite vergelijkt deze TEXT-waarden lexicografisch; gemengde tijdzone-offsets of precisies kunnen feiten daardoor verkeerd ordenen. Elke rij is geldig vanaf valid_from tot valid_to, die zelf niet meer meetelt. De tabel wijst ongeldige intervallen af en heeft een partiële unieke index voor één open feit per tenant, onderwerp en attribuut. replace_fact beheert één transactie en start die met BEGIN IMMEDIATE voordat de functie rijen leest. Roep de functie aan op een verbinding zonder actieve transactie. SQLite serialiseert gelijktijdige writers, dus aanroepers moeten de hele transactie opnieuw proberen na een lock- of uniciteitsfout. Aan het eind staat een keyword-match in plaats van vector search. Elke ranking die de correctie niet kent, kan e1 teruggeven.
import sqlite3
from dataclasses import dataclass

@dataclass(frozen=True)
class MemoryFact:
    tenant_id: str
    subject: str
    attribute: str
    value: str
    valid_from: str
    source_episode_id: str

def open_db() -> sqlite3.Connection:
    db = sqlite3.connect(":memory:")
    db.row_factory = sqlite3.Row
    db.executescript(
        """
        create table memory_facts (
            fact_id integer primary key,
            tenant_id text not null,
            subject text not null,
            attribute text not null,
            value text not null,
            valid_from text not null,
            valid_to text,
            supersedes_fact_id integer references memory_facts (fact_id),
            source_episode_id text not null,
            check (valid_to is null or valid_from < valid_to)
        );
        create unique index one_open_fact
        on memory_facts (tenant_id, subject, attribute)
        where valid_to is null;
        """
    )
    return db

def replace_fact(db: sqlite3.Connection, fact: MemoryFact) -> None:
    with db:
        db.execute("BEGIN IMMEDIATE")
        exact = db.execute(
            """
            select fact_id
            from memory_facts
            where tenant_id = ? and subject = ? and attribute = ? and valid_from = ?
            """,
            (fact.tenant_id, fact.subject, fact.attribute, fact.valid_from),
        ).fetchone()
        if exact:
            raise ValueError("equal valid_from requires an application conflict policy")

        containing = db.execute(
            """
            select fact_id, valid_to
            from memory_facts
            where tenant_id = ?
              and subject = ?
              and attribute = ?
              and valid_from < ?
              and (valid_to is null or valid_to > ?)
            limit 1
            """,
            (
                fact.tenant_id,
                fact.subject,
                fact.attribute,
                fact.valid_from,
                fact.valid_from,
            ),
        ).fetchone()
        if containing:
            db.execute(
                "update memory_facts set valid_to = ? where fact_id = ?",
                (fact.valid_from, containing["fact_id"]),
            )
            successor_boundary = containing["valid_to"]
        else:
            successor = db.execute(
                """
                select valid_from
                from memory_facts
                where tenant_id = ? and subject = ? and attribute = ? and valid_from > ?
                order by valid_from
                limit 1
                """,
                (fact.tenant_id, fact.subject, fact.attribute, fact.valid_from),
            ).fetchone()
            successor_boundary = successor["valid_from"] if successor else None

        db.execute(
            """
            insert into memory_facts
                (tenant_id, subject, attribute, value, valid_from, valid_to,
                 supersedes_fact_id, source_episode_id)
            values (?, ?, ?, ?, ?, ?, ?, ?)
            """,
            (
                fact.tenant_id,
                fact.subject,
                fact.attribute,
                fact.value,
                fact.valid_from,
                successor_boundary,
                containing["fact_id"] if containing else None,
                fact.source_episode_id,
            ),
        )

def fact_at(
    db: sqlite3.Connection, tenant_id: str, subject: str, attribute: str, timestamp: str
) -> sqlite3.Row | None:
    return db.execute(
        """
        select fact_id, value, valid_from, supersedes_fact_id, source_episode_id
        from memory_facts
        where tenant_id = ?
          and subject = ?
          and attribute = ?
          and valid_from <= ?
          and (valid_to is null or valid_to > ?)
        limit 1
        """,
        (tenant_id, subject, attribute, timestamp, timestamp),
    ).fetchone()

KEY = ("acme", "mira", "passport_deadline")

db = open_db()
replace_fact(db, MemoryFact(*KEY, "2026-07-15", "2026-06-01T09:00:00Z", "e1"))
replace_fact(db, MemoryFact(*KEY, "2026-06-30", "2026-06-03T10:00:00Z", "e2"))
current = fact_at(db, *KEY, "2026-06-04T00:00:00Z")
assert (current["value"], current["source_episode_id"]) == ("2026-06-30", "e2")

historical = fact_at(db, *KEY, "2026-06-02T00:00:00Z")
assert (historical["value"], historical["source_episode_id"]) == ("2026-07-15", "e1")
assert current["supersedes_fact_id"] == historical["fact_id"]

# A delayed extraction predates e1. It ends at e1's existing boundary,
# rather than closing e2, which remains current.
replace_fact(db, MemoryFact(*KEY, "2026-08-01", "2026-05-30T08:00:00Z", "e0"))
delayed = fact_at(db, *KEY, "2026-05-31T00:00:00Z")
assert (delayed["value"], delayed["source_episode_id"]) == ("2026-08-01", "e0")
current = fact_at(db, *KEY, "2026-06-04T00:00:00Z")
assert (current["value"], current["source_episode_id"]) == ("2026-06-30", "e2")
intervals = db.execute("select valid_from, valid_to from memory_facts").fetchall()
assert all(row["valid_to"] is None or row["valid_from"] < row["valid_to"] for row in intervals)

episodes = (
    "e1: Mira prefers concise answers. Her passport deadline is 2026-07-15.",
    "e2: Mira corrected the deadline. It is now 2026-06-30.",
)
naive_match = next(episode for episode in episodes if "passport deadline" in episode)
assert naive_match.startswith("e1:")

print("Naive text memory:")
print(f"  returned episode: {naive_match}")
print()
print("SGAM current state:")
print(f"  mira.passport_deadline = {current['value']}")
print(f"  valid_from={current['valid_from']}, source={current['source_episode_id']}")
print()
print("SGAM point-in-time state:")
print(f"  on 2026-06-02, mira.passport_deadline = {historical['value']}")
Het script geeft als uitvoer:
Naive text memory:
  returned episode: e1: Mira prefers concise answers. Her passport deadline is 2026-07-15.

SGAM current state:
  mira.passport_deadline = 2026-06-30
  valid_from=2026-06-03T10:00:00Z, source=e2

SGAM point-in-time state:
  on 2026-06-02, mira.passport_deadline = 2026-07-15
replace_fact wijst eerst een gelijke valid_from af: dat conflict vraagt om applicatiebeleid, zoals bronvoorrang of een door de gebruiker bevestigde herziening, in plaats van stil overschrijven. Anders zoekt het het interval dat de binnenkomende timestamp bevat. Vindt het er een, dan sluit het die voorganger af op de binnenkomende grens, geeft het de ingevoegde rij het vroegere einde van de voorganger en legt het de voorganger vast in supersedes_fact_id. Ligt de timestamp vóór alle opgeslagen intervallen, dan gebruikt het de valid_from van het volgende interval als einde van de nieuwe rij. Een laat aankomend feit vóór e1 wordt dus [2026-05-30, 2026-06-01) en laat e1 en het huidige e2 intact. De partiële unieke index is de databasebeveiliging voor één open rij. DM heeft geen equivalente updatestap, dus de oude tekst kan nog steeds hoger scoren dan de correctie.
De tijdlijn toont de rijen na elke replace_fact-aanroep in het script, daarna de drie reads. Kijk naar stap 2, waarin e2 e1 afsluit, en naar stap 3, waarin de vertraagde e0 eindigt waar e1 begint.
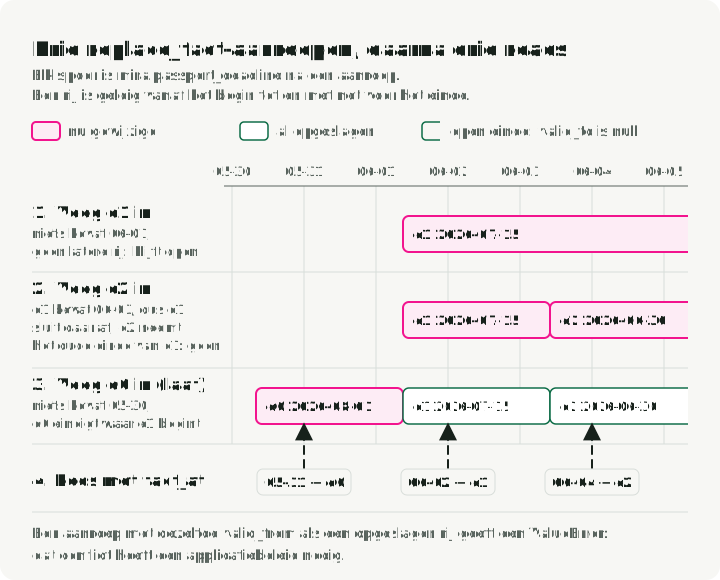
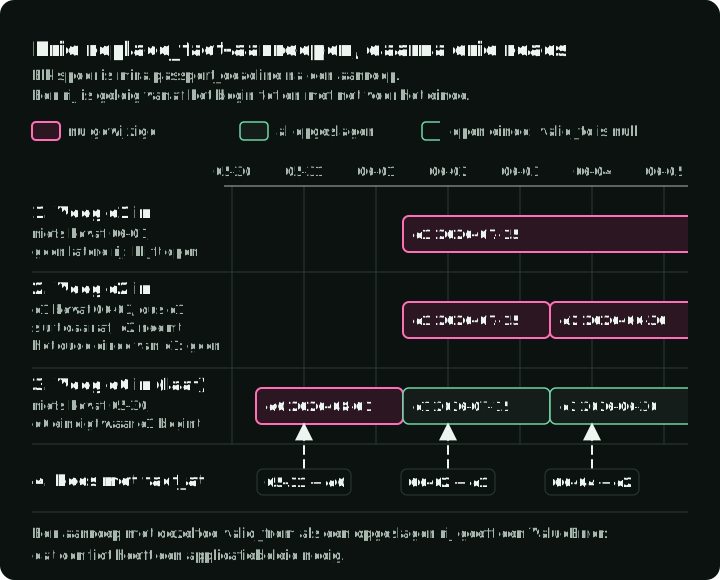
Combineer deze transactie in productie met gestructureerde extractie op het schrijfpad. De databasetransactie werkt de temporele geldigheid bij. Het model extraheert een kandidaatfeit, maar beslist niet welke opgeslagen rij actueel blijft.
Opslagkeuzes volgen het retrievalpatroon
Projecten gebruiken meerdere namen voor delen van dit patroon: geheugenstores, context graphs, profielen, langetermijnstores, graph RAG en stateful agents.
| Tool of framework | Belangrijkste opslaglaag | Mechanisme voor temporele state | Schemamechanisme | Gebruik wanneer |
|---|---|---|---|---|
| Graphiti | Neo4j, FalkorDB en Amazon Neptune; Kuzu is deprecated | Geldigheidsintervallen van feiten plus herkomst via bronepisodes | Pydantic-entiteit- en edgetypen, temporele edges, herkomst | Je geldigheidsintervallen en graaftraversal nodig hebt en de graafdatabase zelf draait |
| Zep | Propriëtaire Context Graph Engine | Beheerde temporele Context Graphs die veranderende feiten bewaren | Standaard en eigen entiteit- en edgetypen | Je hetzelfde temporele graafmodel als beheerde dienst wilt |
| LangGraph / LangMem | LangGraph-stores, stores op basis van Postgres | Door de applicatie beheerde timestamps en velden in storerecords | JSON-stores plus Pydantic-extractie van profielen of collecties | Je al LangGraph gebruikt en zelf timestamps en conflictregels wilt beheren |
| Mem0 | Beheerde stack, Valkey / Redis / vectorbackends in OSS-opstellingen | Geheugenupdates; temporeel beleid blijft bij de applicatie | Geheugentypen, eigen categorieën, extractieprompts | Je beheerde add, search, update en delete wilt, afgebakend per gebruiker, agent, app of run, en zelf het temporele beleid beheert |
| Letta / MemGPT | Door een database ondersteunde agentstate en geheugenblokken | Bewerkbare blokken zonder geldigheidsintervallen per veld | Bewerkbare geheugenblokken met labels | Je wilt dat de agent zijn eigen geheugenblokken bewerkt, of meerdere agents één gedeeld blok nodig hebben dat ze allemaal zien |
| Cognee | Graaf plus vector- en relationele backends | Historie hangt af van de ontologie en de gekozen backend | Ontologiegerichte extractie en validatie | Je extractie valideert tegen een domeinontologie |
| LlamaIndex property graph | Property graph-stores plus vector stores | Tijdvelden hangen af van het graafschema en de store | SchemaLLMPathExtractor met toegestane entiteiten en relaties | Je een property graph uit documenten of traces haalt |
LangGraph scheidt thread-checkpoints, die één gesprek hervatten, van cross-thread-stores, die data bevatten die latere threads lezen. Het Zep-paper meldt winst op Deep Memory Retrieval en LongMemEval, en het Mem0-paper meldt winst op LoCoMo. Elke leverancier schreef zijn eigen paper, dus lees de cijfers als leveranciersresultaten, niet als garanties voor jouw workload.
Begin met het datamodel. Als exacte feitenlookup de hoofdbewerking is, is een relationele tabel met JSON-payloads, geldigheidskolommen, tenant-indexen en een vector-sidecar meestal genoeg. Voeg een graaf toe wanneer de queries van het product relaties volgen.
Bouw het schrijfpad vóór de graaf
Bepaal eerst wat het product mag onthouden. De keuze tussen graaf en vector komt later.
Een support-agent kan accounttier, open cases en duurzame contactvoorkeuren onthouden. Hij moet niet elke gefrustreerde opmerking tussendoor promoveren tot profielstate. Een coding agent kan repoconventies en openstaande taken onthouden. Hij moet een privénotitie niet eeuwig bewaren omdat die notitie toevallig één keer is opgehaald.
De eerste SGAM-store kan een relationele tabel zijn met een JSON-kolom en een paar indexen, geschreven via het zesstappen-schrijfpad hierboven. Een graaf wordt nuttig wanneer het product relaties moet doorlopen, zoals klant-naar-account, account-naar-beleid, taak-naar-artefact of project-naar-beslissing.
Hot path en achtergrondwrites
Directe extractie loont wanneer de volgende beurt van het nieuwe geheugen afhangt. Zegt de gebruiker “onthoud dat ik korte antwoorden wil”, dan mag het systeem geen nachtelijke job nodig hebben voordat het zich anders gedraagt.
De meeste beurten hebben geen directe write nodig. Sla de ruwe episode op met tenant-, session- en toolmetadata en laat een achtergrondworker later kandidaten extraheren. Bij consolidatie op basis van herhaling buffert de worker zwakke signalen en promoveert hij een feit pas nadat vergelijkbaar bewijs zich herhaalt of de gebruiker het bevestigt. Dit voegt vertraging in actualiteit toe. Dat is acceptabel voor “gebruiker vraagt vaak om CSV-exports” en riskant voor “klant heeft het afleveradres gewijzigd”.
Behandel schemamigratie als een productwijziging, omdat die verandert wat de agent kan herinneren, citeren of verwijderen. Ze kan ook veranderen welke historische feiten als actueel gelden. Plan migratiescripts, backfills, dual-read-periodes en verwijdergedrag in dezelfde release.
Wanneer SGAM de complexiteit waard is
Gebruik SGAM wanneer feiten in de tijd kunnen veranderen:
- gebruikersvoorkeuren die kunnen worden bijgewerkt of ingetrokken
- klant- of accountfeiten met auditvereisten
- taakstatus voor langlopende assistenten
- projectgeheugen van coding agents
- gedeelde state van multi-agent-systemen
- compliance-notities waarbij herkomst telt
- temporele vragen zoals “wat geloofden we vóór de migratie?”
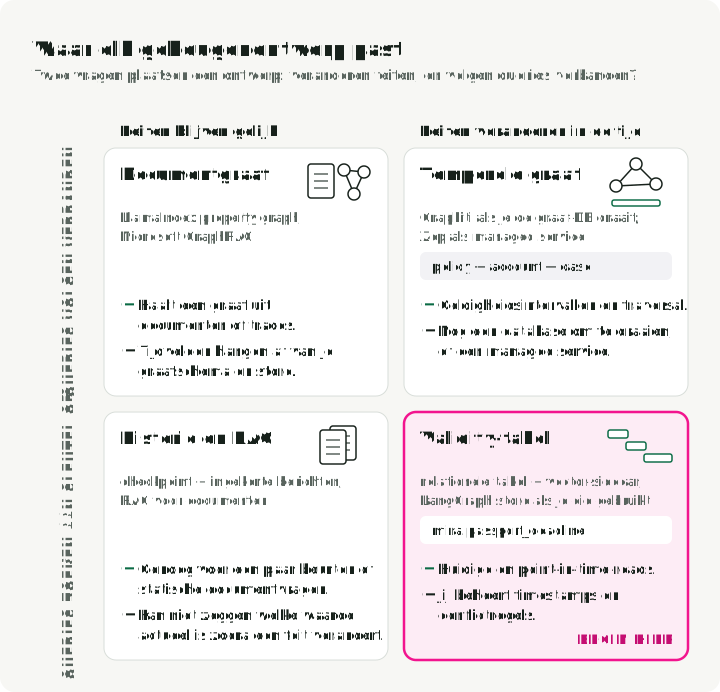
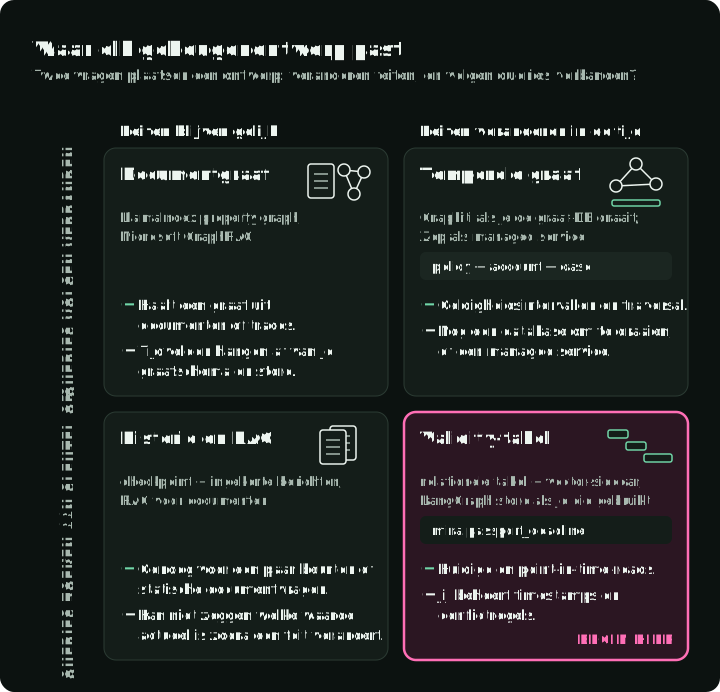
SGAM is overkill wanneer geheugen kortlevend, verkennend of goedkoop opnieuw te berekenen is. Heeft de agent maar een paar beurten continuïteit nodig, dan volstaan een checkpoint en een ingekorte berichtenhistorie. Vraag-en-antwoord over statische documenten heeft misschien alleen RAG nodig. En als het domein zo onrustig is dat het schema elke dag verandert, vertraagt getypeerd geheugen het team.
Het raster plaatst elk ontwerp op twee vragen: veranderen je feiten, en volgen je queries verbanden tussen records?
Evaluatiechecklist
Evalueer de levenscyclus van het geheugen en niet alleen het eindantwoord. Een systeem kan een plausibel antwoord geven nadat het het verkeerde feit schreef, een verouderd feit ophaalde of een tenantgrens overschreed.
Ik gebruik dezelfde fase-voor-fase-indeling als in mijn artikel over RAG-evaluatie. Meet de fase waarin een fout kan optreden in plaats van de evaluatie te beperken tot de gegenereerde tekst. De tracediscipline uit het artikel over agent-evaluatie is ook van toepassing, want een geheugenbug verschijnt vaak in de runhistorie voordat hij het antwoord bereikt.
Ik zou SGAM testen met replay. Voer een vaste reeks episodes in de geheugenwriter in en inspecteer de ledger na elke betekenisvolle beurt. Stel daarna vragen over de huidige state en over de state op een bepaald moment aan de resulterende store.
| Laag | Fout waar je naar zoekt | Metingen |
|---|---|---|
| Write-extractie | De agent miste een feit, verzon er een of produceerde een ongeldige vorm | Percentage schemageldige writes, extractieprecisie/-recall, dekking van bronepisodes |
| Conflictafhandeling | Een verouderd feit bleef actueel of een geldig oud feit werd overschreven | Correctheid van supersession, duplicaatpercentage, correctheid van invalidatie van verouderde feiten |
| Isolatie en beleid | Geheugen lekte tussen gebruikers of overleefde zijn beleidsperiode | Tenant-isolatiefouten, correctheid van verwijdering, naleving van bewaartermijnen |
| Leesretrieval | Het juiste record bestaat, maar de reader haalde het niet op | Nauwkeurigheid huidige state, nauwkeurigheid point-in-time, recall@k over geheugenrecords |
| Antwoordgrounding | Het antwoord gebruikte geheugen zonder onderbouwing of citeerde de verkeerde bron | Claimonderbouwing tegen bronepisodes, citatienauwkeurigheid, correctheid van conflictoplossing |
| Operatie | Het geheugenpad is te traag, te verouderd of te duur | p95-writelatency, vertraging in actualiteit, leeslatency, kosten per query |
Benchmarks zoals LoCoMo, LongMemEval en ATM-Bench bieden openbare testcases. Ze vervangen geen domeinspecifieke testsuite. Een coding assistant, een klantenservicebot en een compliance-copilot hebben elk andere schema’s, filters, bewaarregels en faaltests nodig.
From traces to better memory voert een verbeterlus uit op een geheugentool die feiten opslaat met een eigenaar, een brongebeurtenis en een geldigheidsinterval, volgens deze regels.
Kanttekeningen
SGAM is mijn label voor een patroon, geen standaard. De tools in de tabel hierboven gebruiken andere namen voor delen ervan: geheugenstores, temporele context graphs, geheugenblokken en knowledge graphs. Microsoft GraphRAG beschrijft een verwant deel van het probleem als graafgebaseerde retrieval over documenten.
Een gebruikersprofiel, een episodelog, een documentgraaf en een door de agent bewerkbaar geheugenblok lossen verschillende retrieval- en updateproblemen op. Ik reserveer SGAM voor duurzaam geheugen dat de huidige applicatiestate weergeeft en daarom schema, geldigheid, herkomst, conflictafhandeling, bewaring en migratie nodig heeft.
Getypeerd geheugen kan nog steeds fout zijn. Een schema maakt slechte writes makkelijker te inspecteren; het maakt ze niet betrouwbaar. Je hebt nog steeds brontrust, gebruikersbevestiging voor gevoelige feiten, conflictbeleid, verwijdering en monitoring nodig.
Referenties
- According to Me: Long-Term Personalized Referential Memory QA - Paper van Mei et al. dat ATM-Bench en Schema-Guided Memory introduceert.
- Towards Scalable Multi-Domain Conversational Agents: The Schema-Guided Dialogue Dataset - Paper van Rastogi et al. over de SGD-dataset.
- Evaluating Very Long-Term Conversational Memory of LLM Agents - Paper van Maharana et al. dat LoCoMo introduceert.
- LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory - Benchmark van Wu et al. voor long-term memoryvaardigheden.
- Graphiti: Build Temporal Context Graphs for AI Agents
- Zep: A Temporal Knowledge Graph Architecture for Agent Memory
- Mem0 Platform Overview
- Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory
- LangGraph Memory Overview
- LangGraph Persistence
- LangMem documentation
- Letta: Introduction to Stateful Agents
- Letta: Shared memory
- Microsoft GraphRAG documentation
- LlamaIndex: Using a Property Graph Index
- Cognee Documentation
- Pydantic model validation docs
- Python sqlite3 documentation