Pamięć agenta AI: stan sterowany schematem i proweniencja

Tłumaczenie automatyczne
Ten artykuł został automatycznie przetłumaczony z angielskiego oryginału.
Ten artykuł jest dla inżynierów budujących agentów działających długo lub obsługujących wielu tenantów. Zwykła pamięć semantyczna nie ma reguły określającej, która wartość faktu jest bieżąca, więc agenci zwracają nieaktualne fakty. Gdy użytkownik zmienia termin dotyczący paszportu z 15 lipca na 30 czerwca, wyszukiwanie wektorowe może zwrócić oba stwierdzenia. Warstwa pamięci utrzymująca stan musi zapisać, że wartość z 30 czerwca zastępuje wcześniejszą.
Dowiesz się, jak przechowywać pamięć jako typowane rekordy z oknami ważności, zakresem tenanta i odnośnikami do źródeł, jak zapisać korektę bez utraty historii oraz jak testować odczyty bieżące i odczyty z określonego momentu.
Dlaczego kontekst i wyszukiwanie wektorowe zwracają nieaktualne fakty
Okno kontekstowe to dane wejściowe dostępne dla jednego wywołania modelu. Aplikacja może przenosić wiadomości do kolejnych wywołań, ale to polityka aplikacji musi zdecydować, które stare fakty pozostają prawdziwe i kto może je zobaczyć.
Agenci działający długo muszą pamiętać preferencje, stan zadań, fakty o klientach, decyzje dotyczące narzędzi, notatki zgodności i dawne błędy. Najprostsze rozwiązanie to dopisywanie podsumowań albo wrzucanie starych notatek do magazynu wektorowego. Działa to do momentu, gdy jeden z zapamiętanych faktów się zmieni.
Wtedy agent ma dwa terminy dotyczące paszportu, dwa preferowane formaty albo dwie decyzje projektowe. Wyszukiwanie semantyczne może zwrócić obie. Podsumowanie może nadpisać jedną z nich. Długi kontekst może zawierać nieaktualną obok aktywnej. Takie projekty zwracają tekst, ale nie potrafią powiedzieć, która wartość jest bieżąca.
Kontrakt pamięci musi odpowiadać na konkretne pytania:
- Co jest prawdą teraz?
- Co było prawdą 2 czerwca?
- Kto to powiedział?
- Do którego tenanta to należy?
- Który wcześniejszy fakt zastąpił ten fakt?
- Czy mogę go usunąć albo wygasić?
Schema-Guided Agent Memory (SGAM) zapisuje te odpowiedzi jako pola i relacje, zamiast zostawiać je domyślnie w prozie.
Co oznacza SGAM
Zakres SGAM wyznaczają dwa podobnie nazwane pomysły z badań.
Schema-Guided Memory (SGM) to termin badawczy używany przez Mei i in. w According to Me: Long-Term Personalized Referential Memory QA. Praca porównuje Descriptive Memory (DM), czyli pamięć w tekście swobodnym, z pamięcią o stałym schemacie złożoną z elementów klucz-wartość. Obie reprezentacje zawierają te same informacje źródłowe w różnych strukturach. Wcześniejsze użycie tej nazwy, zbiór Schema-Guided Dialogue, śledzi stan dialogu dla API usług i nie ma związku z pamięcią długoterminową.
W tym artykule Schema-Guided Agent Memory (SGAM) oznacza wzorzec inżynierski, w którym schematy rządzą zapisami, aktualizacjami, wyszukiwaniem i usuwaniem. Schemat definiuje stan aplikacji i jego cykl życia.
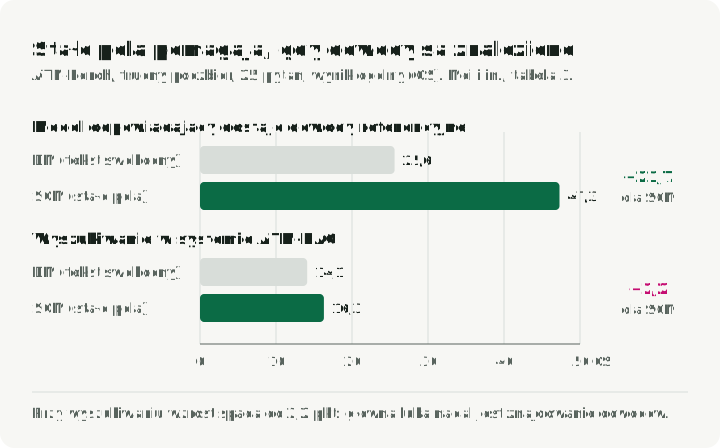
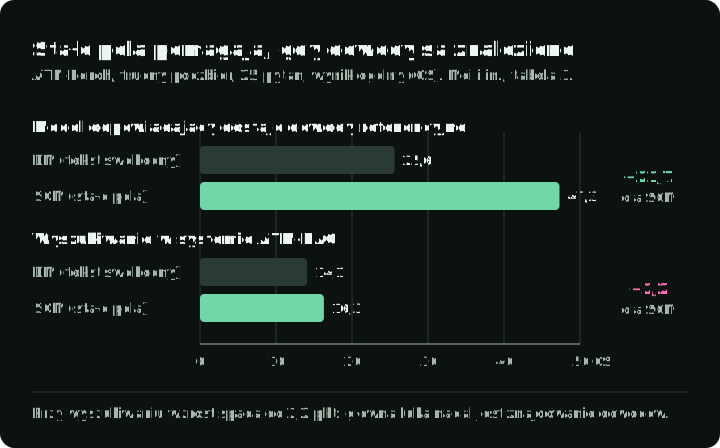
ATM-Bench pokazuje, dlaczego reprezentacja ma znaczenie. Korzysta z danych osobistych z około czterech lat: e-maili, obrazów i filmów. Pytania wymagają odwołań osobistych, lokalizacji, wielu dowodów i uwzględnienia zmian w czasie. SGM udostępnia w stałej reprezentacji pola takie jak czas, źródło, lokalizacja, encje i tagi. Na trudnym podzbiorze 25 pytań tabela 3 w pracy podaje wzrost wyniku ogólnego (QS) z 25,6 dla DM do 47,3 dla SGM, gdy model odpowiadający dostaje dowody referencyjne. Przy wyszukiwaniu w systemie ATM-RAG autorów wynik na trudnym podzbiorze rośnie tylko z 14,1 do 16,3, więc główną luką nadal jest znajdowanie dowodów.
Wykres zestawia obok siebie cztery wyniki na trudnym podzbiorze. Porównaj wzrost dzięki stałym polom z dowodami referencyjnymi i z wyszukiwaniem.
SGM kontra DM odpowiada na pytanie o przechowywanie: czy pamięć ma pozostać tekstem swobodnym, czy używać nazwanych pól? Agent produkcyjny ma jednak wcześniejszy problem. Musi zamienić nieustrukturyzowaną rozmowę w proponowaną aktualizację pamięci. Następna sekcja pokazuje, jak Schema-Guided Reasoning (SGR) kształtuje takie wywołanie modelu i gdzie SGAM przejmuje odpowiedzialność.
Oddziel ekstrakcję modelu od własności pamięci
Zapis do pamięci przechodzi przez trzy warstwy. Structured Output (SO) wymusza kształt obiektu kandydata. Schema-Guided Reasoning (SGR) sprawia, że zamierzone pola modelu i intencja decyzji są widoczne w ustrukturyzowanej odpowiedzi. Schema-Guided Agent Memory (SGAM) zarządza kandydatem jako trwałym stanem po wywołaniu modelu. Zależności, kolejność i reguły cyklu życia wymuszają osobne wywołania, walidatory i polityka aplikacji.
Wcześniejsze artykuły stosują SGR w ustrukturyzowanych sędziach, planistach i routerach oraz rubrykach RAG. W każdym z nich werdykt, trasa lub plan zwykle wygasa wraz z bieżącym żądaniem. Inne uruchomienie może odczytać kandydata do pamięci po kilku dniach albo użyć go do wyboru wywołania narzędzia. Taki dłuższy czas życia wymaga reguł przechowywania, których SGR nie zapewnia.
SGR układa pola jednej odpowiedzi modelu w kolejności, w jakiej model powinien je wypełniać. W zapisie do pamięci odpowiedź może zawierać dowód ze źródła, znormalizowany podmiot i atrybut, porównanie z bieżącym stanem oraz proponowaną aktualizację. Pydantic lub JSON Schema opisuje te pola. Natywne ustrukturyzowane dane wyjściowe dostawcy albo środowisko kierowanego dekodowania, takie jak XGrammar, utrzymuje odpowiedź w tym kształcie. Kształt nie gwarantuje poprawnego wniosku ani nie dowodzi, że model użył tych pól w tej kolejności.
SGAM decyduje, co dzieje się po powstaniu tego obiektu. Czy go zapisać? Czy zastępuje starszy fakt? Który tenant może go zobaczyć? Czy jest bieżący, czy historyczny? Który epizod źródłowy go potwierdza?
Tabela pokazuje, za co odpowiada każda warstwa i jak zawodzi:
| Wymiar | SO | SGR | SGAM |
|---|---|---|---|
| Cel | Zwrócić obiekt zgodny ze schematem | Uczynić zamierzone pola i intencję decyzji widocznymi | Zarządzać trwałą pamięcią po wywołaniu modelu |
| Zakres | Jedna wygenerowana odpowiedź | Jedna odpowiedź modelu; polityka obejmująca kilka kroków może rozciągać się na wywołania | Rekordy używane między wywołaniami, sesjami i uruchomieniami |
| Rola schematu | Definiuje pola wyjściowe, typy i dozwolone wartości | Opisuje dowody, pola pośrednie i decyzję kandydata | Definiuje przechowywane rekordy, relacje i cykl życia |
| Egzekwowanie | Dekodowanie z ograniczeniami blokuje dane niezgodne ze schematem | Tylko kształt; zależności i kolejność wymuszają osobne wywołania, walidatory i polityka | Cykl życia wymuszają walidacja aplikacji, ograniczenia bazy danych i reguły konfliktów |
| Czas życia | Bieżące wywołanie, chyba że aplikacja zapisze obiekt | Ślad rozumowania zwykle jest odrzucany po podjęciu decyzji | Trwa do aktualizacji, wygaśnięcia lub usunięcia |
| Typowy błąd | Poprawny kształt, ale błędne znaczenie | Pola są obecne, ale rozumowanie lub obsługa zależności nadal może być błędna | Nieaktualny, zanieczyszczony, pozbawiony zakresu lub niemożliwy do zaudytowania stan |
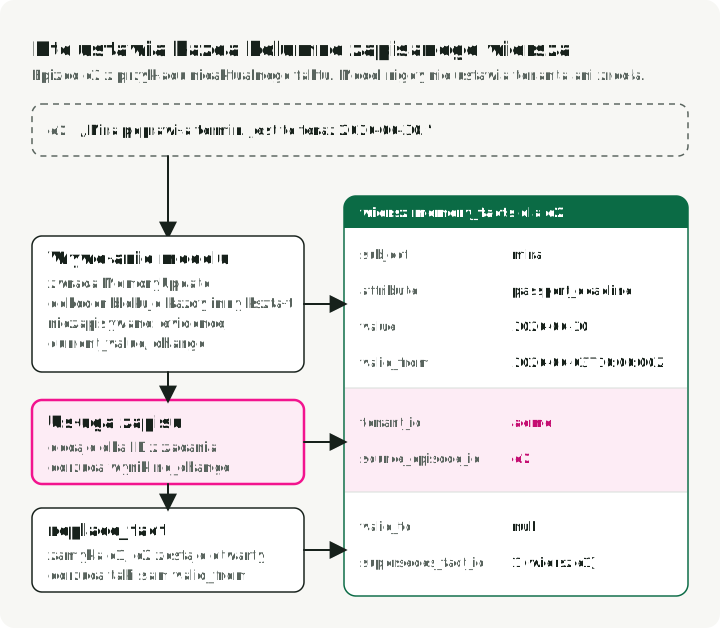
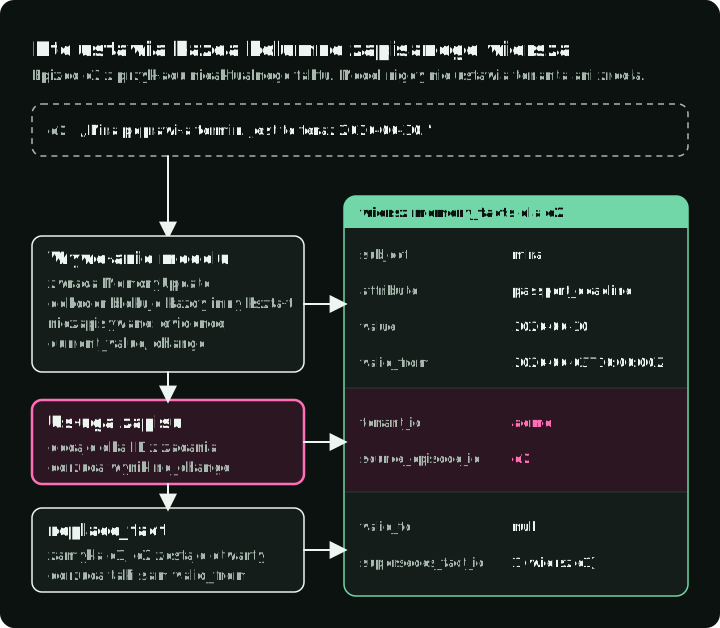
Diagram śledzi korektę z poniższego przykładu aż do jednego zapisanego wiersza i pokazuje, kto ustawia każdą kolumnę: model, usługa zapisu na podstawie żądania albo replace_fact.
Poniższy schemat definiuje obiekt przekazywany z ekstrakcji do usługi zapisu SGAM. Wymaga Pydantic. Aplikacja umieszcza aktualnie przechowywaną wartość w tekście prompt, żeby model mógł porównać ją z nowym dowodem:
from datetime import datetime
from typing import Literal

from pydantic import BaseModel, Field

class MemoryUpdate(BaseModel):
    evidence: str = Field(description="Exact quote from the episode")
    subject: str = Field(description="Normalized entity ID, e.g. mira")
    attribute: str = Field(description="Property being updated")
    current_value: str | None = Field(description="Stored value shown in the prompt")
    change: Literal["new", "update", "no_change"]
    value: str | None = Field(description="New value; None when change is no_change")
    valid_from: datetime = Field(description="When the new value starts to apply")
Usługa zapisu odrzuca wyniki no_change, dodaje tenant_id i source_episode_id z żądania, a resztę przekazuje do replace_fact w poniższym przykładzie. Model nigdy nie wybiera tenanta ani epizodu źródłowego.
Ścieżki zapisu i odczytu mają różne zadania
Stan przechowywany zmienia tylko ścieżka zapisu. Ścieżka odczytu wybiera rekordy dla bieżącego żądania.
Przepływ przyjmowania danych to ścieżka zapisu:
- Zarejestruj surowy epizod z wiadomości, wyników narzędzi lub zdarzeń biznesowych. Zapisz jego tenanta i klasę retencji.
- Wyodrębnij typowanych kandydatów za pomocą ustrukturyzowanych danych wyjściowych.
- Zwaliduj ładunek za pomocą Pydantic lub warstwy schematów, której już używa twój stos, i odrzucaj błędne zapisy.
- Rozstrzygnij konflikty przed wstawieniem: zdecyduj, czy nowy rekord zastępuje stary, i zamknij nieaktualny fakt.
- Zachowaj wskaźnik do źródła rekordu: surowego epizodu, wyniku narzędzia, pliku, zgłoszenia lub potwierdzenia użytkownika.
- Zatwierdź rekord w magazynie SGAM razem z jego
schema_version, zamiast zostawiać wersję tylko w kodzie aplikacji.
Przepływ żądania to ścieżka odczytu:
- Zacznij od pytania użytkownika.
- Zdecyduj, czy pytanie wymaga stanu bieżącego, czy stanu z określonego momentu.
- Filtruj według tenanta, typu pamięci, podmiotu, atrybutu i okna ważności.
- Dodaj rozszerzenie wektorowe lub grafowe tylko wtedy, gdy dokładne wyszukanie stanu nie wystarcza. Używaj go do dowodów pomocniczych, powiązanych encji i przykładów, a nie jako autorytetu dla faktów bieżących.
- Złóż najmniejszy kontekst z cytatami dla modelu.
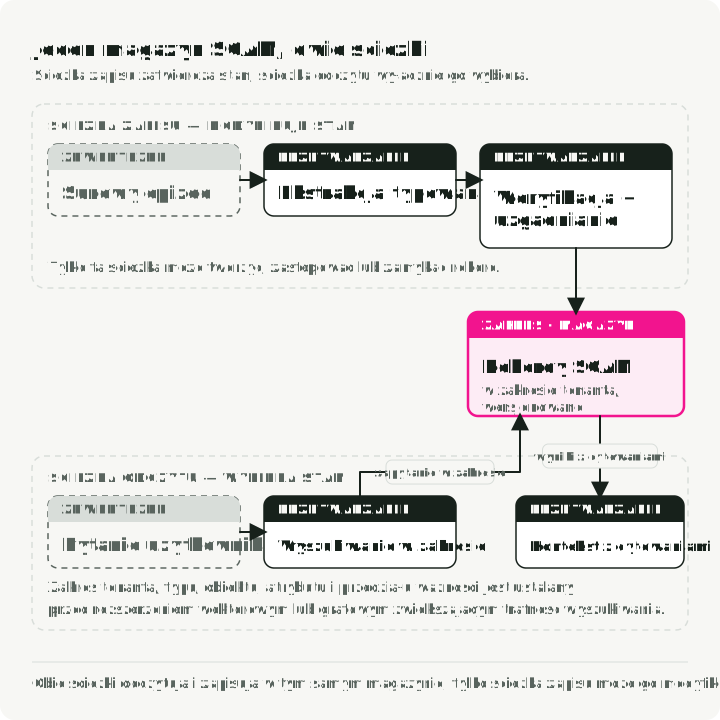
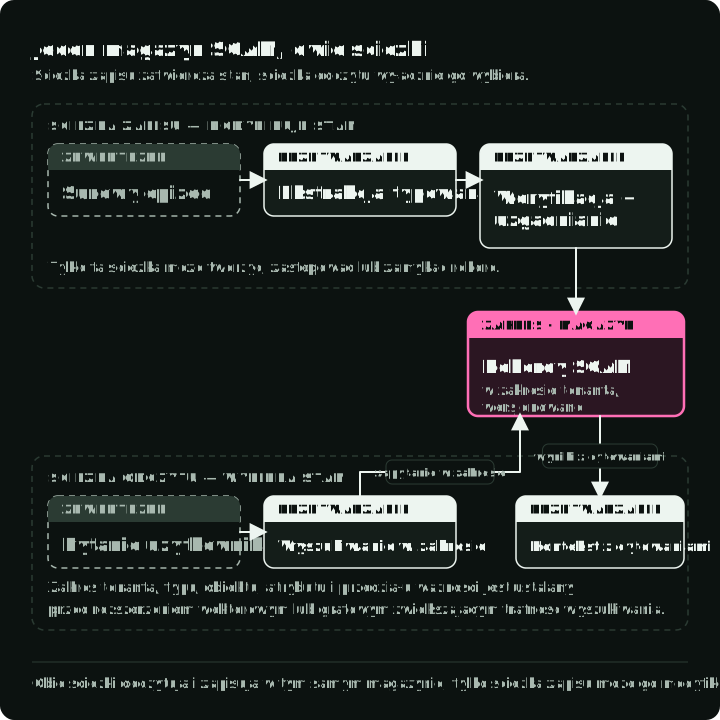
Czytaj ten diagram od góry do dołu. Ścieżka zapisu zamyka e1 i wstawia e2 w jednym magazynie. Ścieżka odczytu wybiera filtr stanu bieżącego lub z określonego momentu, a potem wybiera wiersze z tego samego magazynu.
Co powinno należeć do schematu pamięci
Minimalny rekord SGAM potrzebuje więcej niż text. Każde pole odpowiada na jedno pytanie z pierwszej sekcji albo pełni jedną rolę w cyklu życia:
| Pole | Na jakie pytanie odpowiada lub jaką rolę pełni |
|---|---|
tenant_id | Do którego tenanta należy rekord? Każdy odczyt i zapis filtruje według tego pola. |
memory_id | Stabilny identyfikator, na który wskazują inne rekordy i zadania usuwania. |
subject, attribute | Klucz: która encja i która właściwość, na przykład mira i passport_deadline. |
value | Przechowywana wartość. |
memory_type | Rodzaj pamięci: semantyczna (stabilne fakty i profile), epizodyczna (przeszłe zdarzenia i ślady) albo proceduralna (instrukcje i reguły prompt), zgodnie z opisem w LangGraph. |
schema_version | Który schemat zapisał rekord, żeby migracja mogła znaleźć i przekonwertować stare rekordy. |
valid_from, valid_to | Co jest prawdą teraz? valid_from <= now i (valid_to jest null lub now < valid_to). Co było prawdą 2 czerwca? Przedział zawiera ten moment. |
supersedes_memory_id | Który wcześniejszy fakt zastąpił ten fakt? |
source_episode_id | Kto to powiedział? Wskazuje surowy epizod. |
confidence | Wynik, który usługa zapisu porównuje z progiem: awansuje kandydata do stanu bieżącego albo prosi użytkownika o potwierdzenie. |
retention_policy | Czy mogę go usunąć albo wygasić? Mówi zadaniom usuwania, co jeszcze muszą skasować. |
Dzięki tym polom nowy termin dotyczący paszportu może zamknąć poprzedni termin bez wymazywania historii. Ta sama tabela odpowiada na zapytania o stan bieżący i z określonego momentu, a następnie wskazuje epizod źródłowy wyniku.
Używaj RAG do wyszukiwania dokumentów, a SGAM do utrzymywania zmiennego stanu. Wyszukiwanie wektorowe nadal ma miejsce w systemie przy przybliżonym przywoływaniu, klastrowaniu i rozszerzaniu. Bieżąca wartość mira.passport_deadline powinna pochodzić z rekordu pamięci o właściwym zakresie, a nie z fragmentu, który akurat znalazł się na pierwszym miejscu w rankingu.
Przykład nieaktualnego faktu
Weźmy syntetyczny ślad z dwóch epizodów, przedstawiony jako punkt odniesienia DM i rejestr SGAM:
e1: Mira prefers concise answers. Her passport deadline is 2026-07-15.
e2: Mira corrected the deadline. It is now 2026-06-30.
Punkt odniesienia DM przechowuje oba epizody jako tekst swobodny, więc wyszukiwanie tekstowe może zwrócić e1, bo zawiera właściwe słowa. SGAM wyodrębnia typowany fakt z każdego epizodu, z kluczem złożonym z tenanta, podmiotu i atrybutu. Powinien zwrócić e2 jako stan bieżący i zachować e1 na potrzeby zapytania historycznego.
Poniższy skrypt odpowiada na dwa z wcześniejszych pytań: co jest prawdą teraz i co było prawdą 2 czerwca. Zwróć uwagę na replace_fact: zamyka stary wiersz zamiast go usuwać i zapisuje, który wiersz zastępuje nowy. Kod wywołujący musi normalizować każdy znacznik czasu zapisany w bazie lub używany w zapytaniu do jednego formatu tekstowego UTC ze stałą dokładnością do sekund: YYYY-MM-DDTHH:MM:SSZ. SQLite porównuje te wartości TEXT leksykograficznie, więc różne przesunięcia stref czasowych lub dokładności mogą ustawić fakty w niewłaściwej kolejności. Każdy wiersz jest ważny od valid_from do valid_to, bez samej wartości valid_to. Tabela odrzuca niepoprawne przedziały i ma częściowy indeks unikalny, który dopuszcza jeden otwarty fakt na tenanta, podmiot i atrybut. replace_fact zarządza jedną transakcją i rozpoczyna ją poleceniem BEGIN IMMEDIATE przed odczytem jakichkolwiek wierszy. Wywołuj tę funkcję na połączeniu bez aktywnej transakcji. SQLite serializuje współbieżne operacje zapisu, więc po błędzie blokady lub unikalności kod wywołujący powinien ponowić całą transakcję. Na końcu dopasowanie słów kluczowych zastępuje wyszukiwanie wektorowe. Każdy ranking, który nie zna korekty, może zwrócić e1.
import sqlite3
from dataclasses import dataclass

@dataclass(frozen=True)
class MemoryFact:
    tenant_id: str
    subject: str
    attribute: str
    value: str
    valid_from: str
    source_episode_id: str

def open_db() -> sqlite3.Connection:
    db = sqlite3.connect(":memory:")
    db.row_factory = sqlite3.Row
    db.executescript(
        """
        create table memory_facts (
            fact_id integer primary key,
            tenant_id text not null,
            subject text not null,
            attribute text not null,
            value text not null,
            valid_from text not null,
            valid_to text,
            supersedes_fact_id integer references memory_facts (fact_id),
            source_episode_id text not null,
            check (valid_to is null or valid_from < valid_to)
        );
        create unique index one_open_fact
        on memory_facts (tenant_id, subject, attribute)
        where valid_to is null;
        """
    )
    return db

def replace_fact(db: sqlite3.Connection, fact: MemoryFact) -> None:
    with db:
        db.execute("BEGIN IMMEDIATE")
        exact = db.execute(
            """
            select fact_id
            from memory_facts
            where tenant_id = ? and subject = ? and attribute = ? and valid_from = ?
            """,
            (fact.tenant_id, fact.subject, fact.attribute, fact.valid_from),
        ).fetchone()
        if exact:
            raise ValueError("equal valid_from requires an application conflict policy")

        containing = db.execute(
            """
            select fact_id, valid_to
            from memory_facts
            where tenant_id = ?
              and subject = ?
              and attribute = ?
              and valid_from < ?
              and (valid_to is null or valid_to > ?)
            limit 1
            """,
            (
                fact.tenant_id,
                fact.subject,
                fact.attribute,
                fact.valid_from,
                fact.valid_from,
            ),
        ).fetchone()
        if containing:
            db.execute(
                "update memory_facts set valid_to = ? where fact_id = ?",
                (fact.valid_from, containing["fact_id"]),
            )
            successor_boundary = containing["valid_to"]
        else:
            successor = db.execute(
                """
                select valid_from
                from memory_facts
                where tenant_id = ? and subject = ? and attribute = ? and valid_from > ?
                order by valid_from
                limit 1
                """,
                (fact.tenant_id, fact.subject, fact.attribute, fact.valid_from),
            ).fetchone()
            successor_boundary = successor["valid_from"] if successor else None

        db.execute(
            """
            insert into memory_facts
                (tenant_id, subject, attribute, value, valid_from, valid_to,
                 supersedes_fact_id, source_episode_id)
            values (?, ?, ?, ?, ?, ?, ?, ?)
            """,
            (
                fact.tenant_id,
                fact.subject,
                fact.attribute,
                fact.value,
                fact.valid_from,
                successor_boundary,
                containing["fact_id"] if containing else None,
                fact.source_episode_id,
            ),
        )

def fact_at(
    db: sqlite3.Connection, tenant_id: str, subject: str, attribute: str, timestamp: str
) -> sqlite3.Row | None:
    return db.execute(
        """
        select fact_id, value, valid_from, supersedes_fact_id, source_episode_id
        from memory_facts
        where tenant_id = ?
          and subject = ?
          and attribute = ?
          and valid_from <= ?
          and (valid_to is null or valid_to > ?)
        limit 1
        """,
        (tenant_id, subject, attribute, timestamp, timestamp),
    ).fetchone()

KEY = ("acme", "mira", "passport_deadline")

db = open_db()
replace_fact(db, MemoryFact(*KEY, "2026-07-15", "2026-06-01T09:00:00Z", "e1"))
replace_fact(db, MemoryFact(*KEY, "2026-06-30", "2026-06-03T10:00:00Z", "e2"))
current = fact_at(db, *KEY, "2026-06-04T00:00:00Z")
assert (current["value"], current["source_episode_id"]) == ("2026-06-30", "e2")

historical = fact_at(db, *KEY, "2026-06-02T00:00:00Z")
assert (historical["value"], historical["source_episode_id"]) == ("2026-07-15", "e1")
assert current["supersedes_fact_id"] == historical["fact_id"]

# A delayed extraction predates e1. It ends at e1's existing boundary,
# rather than closing e2, which remains current.
replace_fact(db, MemoryFact(*KEY, "2026-08-01", "2026-05-30T08:00:00Z", "e0"))
delayed = fact_at(db, *KEY, "2026-05-31T00:00:00Z")
assert (delayed["value"], delayed["source_episode_id"]) == ("2026-08-01", "e0")
current = fact_at(db, *KEY, "2026-06-04T00:00:00Z")
assert (current["value"], current["source_episode_id"]) == ("2026-06-30", "e2")
intervals = db.execute("select valid_from, valid_to from memory_facts").fetchall()
assert all(row["valid_to"] is None or row["valid_from"] < row["valid_to"] for row in intervals)

episodes = (
    "e1: Mira prefers concise answers. Her passport deadline is 2026-07-15.",
    "e2: Mira corrected the deadline. It is now 2026-06-30.",
)
naive_match = next(episode for episode in episodes if "passport deadline" in episode)
assert naive_match.startswith("e1:")

print("Naive text memory:")
print(f"  returned episode: {naive_match}")
print()
print("SGAM current state:")
print(f"  mira.passport_deadline = {current['value']}")
print(f"  valid_from={current['valid_from']}, source={current['source_episode_id']}")
print()
print("SGAM point-in-time state:")
print(f"  on 2026-06-02, mira.passport_deadline = {historical['value']}")
Uruchomienie skryptu wypisuje:
Naive text memory:
  returned episode: e1: Mira prefers concise answers. Her passport deadline is 2026-07-15.

SGAM current state:
  mira.passport_deadline = 2026-06-30
  valid_from=2026-06-03T10:00:00Z, source=e2

SGAM point-in-time state:
  on 2026-06-02, mira.passport_deadline = 2026-07-15
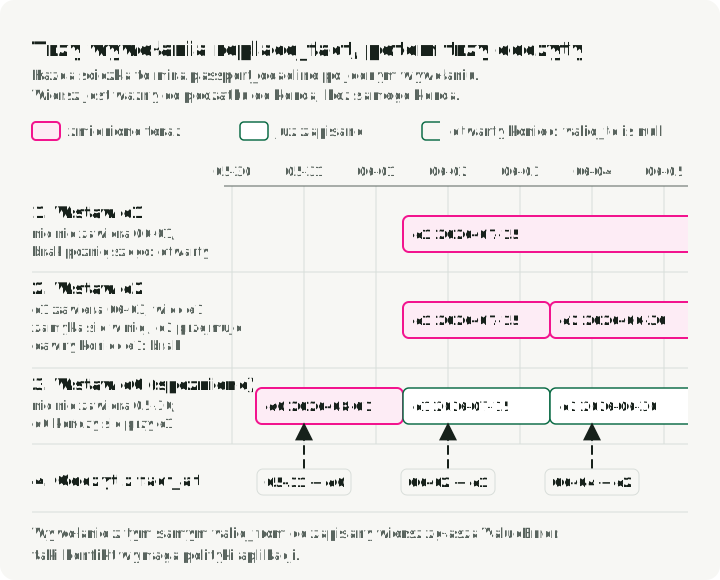
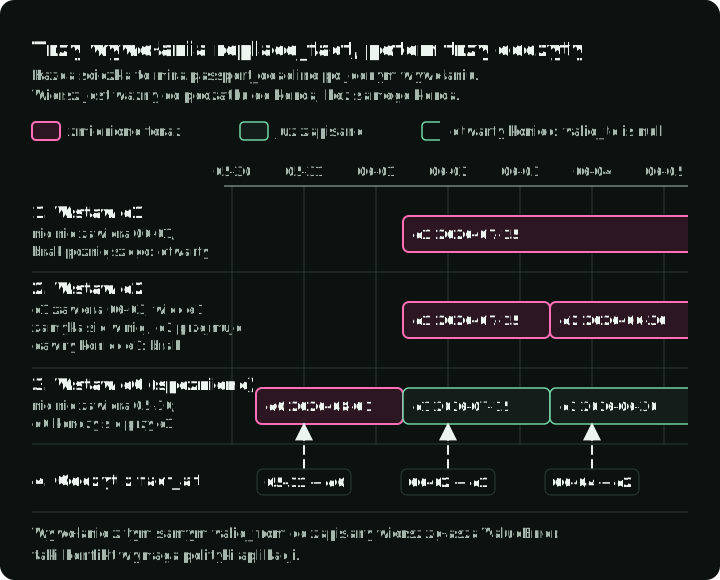
replace_fact najpierw odrzuca równe valid_from: taki konflikt wymaga polityki aplikacji, na przykład pierwszeństwa źródeł albo korekty potwierdzonej przez użytkownika, a nie cichego nadpisania. W przeciwnym razie szuka przedziału zawierającego nadchodzący znacznik czasu. Jeśli go znajdzie, zamyka tego poprzednika na nadchodzącej granicy, nadaje wstawianemu wierszowi dawny koniec poprzednika i zapisuje poprzednika w supersedes_fact_id. Jeśli znacznik czasu leży przed każdym przechowywanym przedziałem, używa valid_from następnego przedziału jako końca nowego wiersza. Dlatego opóźniony fakt sprzed e1 dostaje przedział [2026-05-30, 2026-06-01) i zostawia nietknięte e1 oraz bieżące e2. Częściowy indeks unikalny to zabezpieczenie bazy danych dla jednego otwartego wiersza. DM nie ma odpowiednika kroku aktualizacji, więc stary tekst nadal może wyprzedzić korektę w rankingu.
Oś czasu pokazuje wiersze po każdym wywołaniu replace_fact w skrypcie, a potem trzy odczyty. Zwróć uwagę na krok 2, w którym e2 zamyka e1, oraz na krok 3, w którym opóźnione e0 kończy się tam, gdzie zaczyna się e1.
W produkcji połącz tę transakcję z ustrukturyzowaną ekstrakcją na ścieżce zapisu. Transakcja bazy danych aktualizuje ważność czasową. Model wyodrębnia fakt kandydujący, ale nie decyduje, który przechowywany wiersz pozostaje bieżący.
Wybór magazynu wynika ze wzorca wyszukiwania
Projekty używają kilku nazw dla części tego wzorca: magazyny pamięci, grafy kontekstu, profile, magazyny długoterminowe, graph RAG i agenci ze stanem.
| Narzędzie lub framework | Główna warstwa przechowywania | Mechanizm stanu czasowego | Mechanizm schematu | Używaj, gdy |
|---|---|---|---|---|
| Graphiti | Neo4j, FalkorDB i Amazon Neptune; Kuzu jest przestarzały | Przedziały ważności faktów plus proweniencja epizodów źródłowych | Typy encji i krawędzi w Pydantic, krawędzie czasowe, proweniencja | Potrzebujesz przedziałów ważności i przechodzenia po grafie, a bazę grafową będziesz uruchamiać sam |
| Zep | Własnościowy Context Graph Engine | Zarządzane czasowe grafy kontekstu, które zachowują zmieniające się fakty | Domyślne i własne typy encji i krawędzi | Chcesz tego samego czasowego modelu grafu jako usługi zarządzanej |
| LangGraph / LangMem | Magazyny LangGraph, magazyny oparte na Postgresie | Znaczniki czasu i pola w rekordach magazynu należą do aplikacji | Magazyny JSON oraz ekstrakcja profilu lub kolekcji przez Pydantic | Już używasz LangGraph i godzisz się na samodzielne zarządzanie znacznikami czasu i regułami konfliktów |
| Mem0 | Stos zarządzany, Valkey / Redis / backendy wektorowe w instalacjach OSS | Aktualizacje pamięci; polityka czasowa pozostaje po stronie aplikacji | Typy pamięci, własne kategorie, prompt do ekstrakcji | Chcesz zarządzanych operacji dodawania, wyszukiwania, aktualizacji i usuwania, z zakresem użytkownika, agenta, aplikacji lub uruchomienia, i sam przejmiesz politykę czasową |
| Letta / MemGPT | Stan agenta i bloki pamięci oparte na bazie danych | Edytowalne bloki bez przedziałów ważności na poziomie pól | Edytowalne, oznaczone etykietami bloki pamięci | Agent edytuje własne bloki pamięci albo kilku agentów potrzebuje jednego wspólnego bloku, który wszyscy widzą |
| Cognee | Graf plus backendy wektorowe i relacyjne | Historia zależy od ontologii i wybranego backendu | Ekstrakcja i walidacja oparte na ontologii | Walidujesz ekstrakcję względem ontologii dziedziny |
| LlamaIndex property graph | Magazyny grafów właściwości plus magazyny wektorowe | Pola czasu zależą od schematu grafu i magazynu | SchemaLLMPathExtractor z dozwolonymi encjami i relacjami | Wyodrębniasz graf właściwości z dokumentów lub śladów |
LangGraph oddziela zapisy checkpoint wątków, które wznawiają jedną rozmowę, od magazynów międzywątkowych, które przechowują dane odczytywane przez późniejsze wątki. Praca o Zep podaje wzrosty na Deep Memory Retrieval i LongMemEval, a praca o Mem0 podaje wzrosty na LoCoMo. Każdy dostawca napisał własną pracę, więc traktuj te liczby jako wyniki dostawców, a nie gwarancje dla twojego obciążenia.
Zacznij od modelu danych. Jeśli główną operacją jest dokładne wyszukiwanie faktów, zwykle wystarczy tabela relacyjna z ładunkami JSON, kolumnami ważności, indeksami tenantów i pomocniczym magazynem wektorowym. Dodaj graf, gdy zapytania produktu podążają za relacjami.
Najpierw zbuduj ścieżkę zapisu, dopiero potem graf
Najpierw zdecyduj, co produkt może zapamiętywać. Wybór między grafem a wektorami przychodzi później.
Agent wsparcia może zapamiętywać poziom konta, otwarte sprawy i trwałe preferencje kontaktu. Nie powinien awansować każdej sfrustrowanej uwagi na stan profilu. Agent programistyczny może zapamiętywać konwencje repozytorium i nierozwiązane zadania. Nie powinien przechowywać prywatnej notatki w nieskończoność tylko dlatego, że raz została wyszukana.
Pierwszy magazyn SGAM może być tabelą relacyjną z kolumną JSON i kilkoma indeksami, zapisywaną sześcioma krokami ścieżki zapisu opisanej wyżej. Graf staje się przydatny, gdy produkt musi przechodzić po relacjach, takich jak klient-konto, konto-polityka, zadanie-artefakt czy projekt-decyzja.
Zapisy natychmiastowe i zapisy w tle
Natychmiastowa ekstrakcja ma sens, gdy następna tura zależy od nowej pamięci. Jeśli użytkownik mówi „zapamiętaj, że wolę krótkie odpowiedzi”, system nie powinien potrzebować nocnego zadania, żeby zacząć zachowywać się inaczej.
Większość tur nie wymaga natychmiastowego zapisu. Zapisz surowy epizod z metadanymi tenanta, sesji i narzędzi, a potem pozwól procesowi w tle wyodrębnić kandydatów później. Przy konsolidacji opartej na powtarzalności proces buforuje słabe sygnały i awansuje fakt dopiero wtedy, gdy podobny dowód się powtórzy albo użytkownik go potwierdzi. Dodaje to opóźnienie świeżości. Jest ono akceptowalne dla „użytkownik często prosi o eksporty CSV” i ryzykowne dla „klient zmienił adres dostawy”.
Traktuj migrację schematu jak zmianę produktu, bo zmienia to, co agent może przywołać, zacytować lub usunąć. Może też zmienić, które fakty historyczne uchodzą za bieżące. Zaplanuj skrypty migracji, uzupełnianie danych, okna podwójnego odczytu i zachowanie przy usuwaniu w tym samym wydaniu.
Kiedy SGAM jest warte złożoności
Używaj SGAM, gdy fakty mogą zmieniać się w czasie:
- preferencje użytkownika, które można aktualizować lub odwołać
- fakty o kliencie lub koncie objęte wymaganiami audytu
- stan zadań dla długo działających asystentów
- pamięć projektowa agenta programistycznego
- wspólny stan wielu agentów
- notatki zgodności, w których liczy się proweniencja
- pytania czasowe, takie jak „w co wierzyliśmy przed migracją?”
SGAM to przesada, gdy pamięć jest krótkotrwała, eksploracyjna lub tania do ponownego obliczenia. Jeśli agent potrzebuje tylko kilku tur ciągłości, wystarczą checkpoint i przycięta historia wiadomości. QA na statycznych dokumentach może wymagać tylko RAG. A jeśli dziedzina jest tak niestabilna, że schemat zmienia się codziennie, typowana pamięć spowolni zespół.
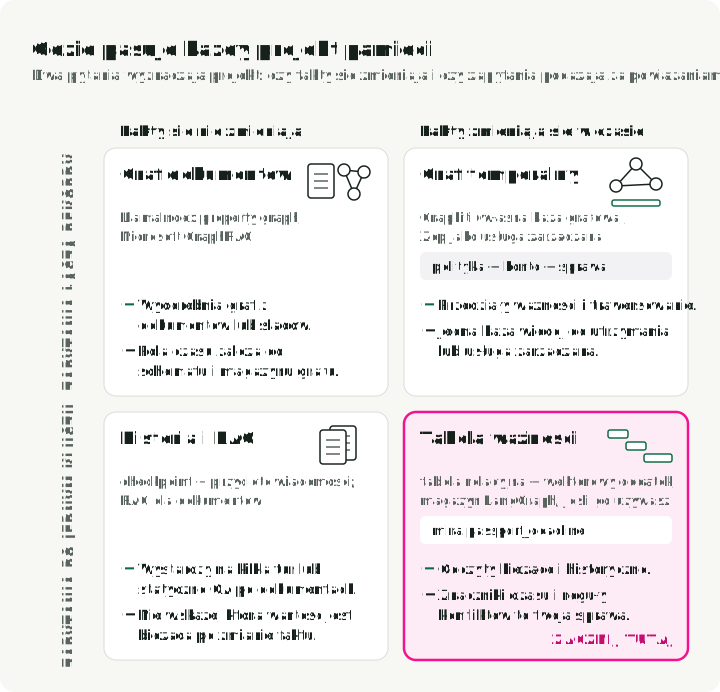
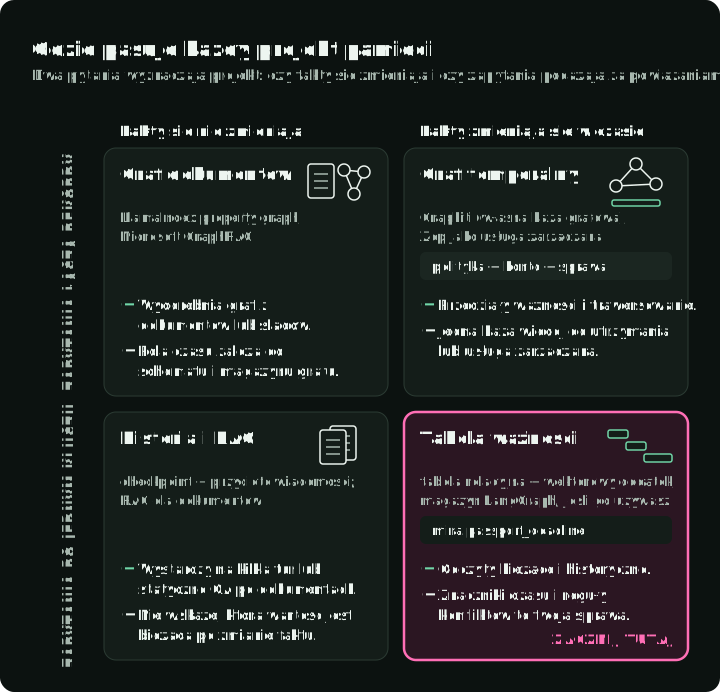
Siatka umieszcza każdy projekt według dwóch pytań: czy twoje fakty się zmieniają i czy zapytania podążają za powiązaniami między rekordami?
Lista kontrolna ewaluacji
Oceniaj cykl życia pamięci, a nie tylko końcową odpowiedź. System może wytworzyć wiarygodną odpowiedź po zapisaniu błędnego faktu, pobraniu nieaktualnego albo przekroczeniu granicy tenanta.
Stosuję ten sam podział etap po etapie co w artykule o ewaluacji RAG. Mierz etap, na którym może wystąpić błąd, zamiast ograniczać ewaluację do wygenerowanego tekstu. Zastosowanie ma też dyscyplina śladów z artykułu o ewaluacji agentów, bo błąd pamięci często widać w historii uruchomienia, zanim dotrze do odpowiedzi.
SGAM testowałbym przez odtwarzanie. Podaj procesowi zapisu pamięci stałą sekwencję epizodów i sprawdzaj rejestr po każdej istotnej turze. Potem zadawaj pytania o stan bieżący i stan z określonego momentu względem powstałego magazynu.
| Warstwa | Błąd, którego szukasz | Miary |
|---|---|---|
| Ekstrakcja zapisu | Agent pominął fakt, wymyślił go albo wytworzył niepoprawny kształt | Odsetek zapisów zgodnych ze schematem, precyzja i recall ekstrakcji, pokrycie epizodów źródłowych |
| Obsługa konfliktów | Nieaktualny fakt pozostał bieżący albo poprawny stary fakt został nadpisany | Poprawność zastępowania, odsetek duplikatów, poprawność unieważniania nieaktualnych faktów |
| Izolacja i polityka | Pamięć wyciekła między użytkownikami albo przetrwała poza oknem polityki | Naruszenia izolacji tenantów, poprawność usuwania, zgodność z retencją |
| Wyszukiwanie przy odczycie | Właściwy rekord istnieje, ale czytnik go nie pobrał | Dokładność stanu bieżącego, dokładność stanu z określonego momentu, recall@k dla rekordów pamięci |
| Ugruntowanie odpowiedzi | Odpowiedź użyła pamięci bez poparcia albo zacytowała złe źródło | Poparcie twierdzeń epizodami źródłowymi, poprawność cytowań, poprawność rozstrzygania konfliktów |
| Operacje | Ścieżka pamięci jest zbyt wolna, zbyt nieaktualna lub zbyt droga | Opóźnienie zapisu p95, opóźnienie świeżości, opóźnienie odczytu, koszt zapytania |
Benchmarki takie jak LoCoMo, LongMemEval i ATM-Bench dostarczają publiczne przypadki testowe. Nie zastępują zestawu testów dla twojej dziedziny. Asystent programistyczny, bot wsparcia klienta i copilot zgodności potrzebują różnych schematów, filtrów, reguł retencji i testów błędów.
From traces to better memory prowadzi pętlę usprawnień na narzędziu pamięci, które przechowuje fakty z właścicielem, zdarzeniem źródłowym i przedziałem ważności, według tych reguł.
Zastrzeżenia
SGAM to moja etykieta dla wzorca, a nie standard. Narzędzia z tabeli wyżej używają innych nazw dla jego części: magazyny pamięci, czasowe grafy kontekstu, bloki pamięci i grafy wiedzy. Microsoft GraphRAG opisuje powiązaną część problemu jako wyszukiwanie oparte na grafie nad dokumentami.
Profil użytkownika, log epizodów, graf dokumentów i edytowalny przez agenta blok pamięci rozwiązują różne problemy wyszukiwania i aktualizacji. Nazwę SGAM rezerwuję dla trwałej pamięci, która reprezentuje bieżący stan aplikacji i dlatego potrzebuje schematu, ważności, proweniencji, obsługi konfliktów, retencji i migracji.
Typowana pamięć nadal może być błędna. Schemat ułatwia kontrolę złych zapisów, ale nie czyni ich wiarygodnymi. Nadal potrzebujesz zaufania do źródeł, potwierdzenia przez użytkownika dla faktów wrażliwych, polityki konfliktów, usuwania i monitorowania.
Referencje
- According to Me: Long-Term Personalized Referential Memory QA - praca Mei i in. wprowadzająca ATM-Bench i Schema-Guided Memory.
- Towards Scalable Multi-Domain Conversational Agents: The Schema-Guided Dialogue Dataset - praca Rastogi i in. o zbiorze SGD.
- Evaluating Very Long-Term Conversational Memory of LLM Agents - praca Maharana i in. wprowadzająca LoCoMo.
- LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory - benchmark Wu i in. dla zdolności pamięci długoterminowej.
- Graphiti: Build Temporal Context Graphs for AI Agents
- Zep: A Temporal Knowledge Graph Architecture for Agent Memory
- Mem0 Platform Overview
- Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory
- LangGraph Memory Overview
- LangGraph Persistence
- LangMem documentation
- Letta: Introduction to Stateful Agents
- Letta: Shared memory
- Microsoft GraphRAG documentation
- LlamaIndex: Using a Property Graph Index
- Cognee Documentation
- Pydantic model validation docs
- Python sqlite3 documentation