Architektura pamięci agenta AI: zapisy checkpoint i bazy wektorowe

Tłumaczenie automatyczne
Ten artykuł został automatycznie przetłumaczony z angielskiego oryginału.
Agent może sprawiać wrażenie, że „zapomina”, z kilku powodów. Może stracić niedokończony przebieg po restarcie, nie odnaleźć preferencji z wcześniejszej rozmowy albo kierować się nieaktualną notatką projektową. Każda z tych awarii wymaga innego rodzaju stanu i innego testu. Ten artykuł jest dla inżynierów, którzy projektują ten stan: dowiesz się, kiedy użyć zapisu checkpoint, dokładnego wyszukiwania po kluczu, wyszukiwania semantycznego albo dokumentu, który da się przejrzeć, oraz jakie narzędzia pasują do każdego zadania — od checkpoint saverów dla PostgreSQL i Redis po pgvector, Qdrant, pliki Markdown i zarządzane frameworki pamięci.
Część 1 zbudowała pętlę rozumowania. Tutaj użyjemy Market Analyst Agent, aby zobaczyć, co pętla musi zachować, gdy zatrzymuje się przed opublikowaniem raportu, i gdy użytkownik wraca ze znanymi preferencjami.
Cztery awarie, które wyglądają jak zapominanie
„Dodaj pamięć” to zbyt ogólne sformułowanie, by wybrać implementację. Użyteczne wymaganie mówi, co musi przetrwać, kto może to odczytać i co się dzieje, gdy informacja jest błędna.
| Wymaganie | Stan do zachowania | Pierwszy użyteczny projekt | Awaria do przetestowania |
|---|---|---|---|
| Kontynuować analizę po zatwierdzeniu lub restarcie workera | Wiadomości, plan, szkic, oczekujący krok grafu | Trwały checkpoint dla tego wątku | Restart przed publikacją; wznowienie od zamierzonego kroku |
| Zastosować preferencję ryzyka powracającego użytkownika | Jeden aktualny, nazwany fakt powiązany z tym użytkownikiem | Ustrukturyzowany profil z dokładnym kluczem | Zmienić preferencję; nigdy nie użyć starej wartości |
| Przywołać nieustrukturyzowaną obserwację z wcześniejszej pracy | Źródło, tekst, właściciel, czas, ważność | Przeszukiwalne rekordy; embeddings tylko w razie potrzeby | Sparafrazować zapytanie i sprawdzić odnalezione źródło |
| Ponownie użyć konwencji projektu | Notatka do przeglądu i jej właściciel | Plik lub magazyn dokumentów | Poprawić błędną notatkę i potwierdzić, że następny przebieg widzi poprawkę |
Pierwsze pytanie brzmi: czy agent w ogóle potrzebuje zapisanego stanu. Klasyfikator jednorazowy, którego całe wejście przychodzi w jednym żądaniu, może zweryfikować odpowiedź i zakończyć działanie. Nie potrzebuje bazy wektorowej tylko dlatego, że większy system mógłby kiedyś zadać pytanie uzupełniające.
Gdy wymaganie już istnieje, ta tabela podaje narzędzie startowe dla każdego zadania. Sekcje poniżej wyjaśniają, kiedy przejść na alternatywę.
| Zadanie | Zacznij od | Przejdź na |
|---|---|---|
| Wznowić jeden przebieg lub wątek | Saver PostgreSQL z LangGraph | Saver Redis, gdy opóźnienie zapisów checkpoint jest zmierzonym wąskim gardłem; saver SQLite do użytku lokalnego |
| Odczytać nazwany fakt o użytkowniku | Wiersz PostgreSQL lub kolumna JSONB, hash Redis albo klucz w Store z LangGraph | Nic więcej, dopóki fakt ma stabilną nazwę |
| Przywołać notatkę po znaczeniu | Store z LangGraph z indeksem albo pgvector obok danych aplikacji | Qdrant lub inna baza wektorowa, gdy wymagają tego filtrowanie, skala lub eksploatacja |
| Znaleźć notatkę po dokładnych terminach | Wyszukiwanie pełnotekstowe PostgreSQL z indeksem GIN | Hybrydowe wyszukiwanie po słowach kluczowych i wektorach, gdy parafrazy omijają słowa kluczowe |
| Odpowiadać na pytania o powiązania | Powiązane rekordy relacyjne | Temporalny graf wiedzy, taki jak Graphiti |
| Utrzymać wiedzę o projekcie w formie do przeglądu | Pliki Markdown w repozytorium | Dokumenty w PostgreSQL z wyszukiwaniem pełnotekstowym i wektorowym dla wielu tenantów |
| Przekazać ekstrakcję i utrzymanie narzędziu | Własne reguły zapisu i aktualizacji | Mem0, Letta lub LangMem, gdy nie musisz kontrolować tego pipeline’u |
Pamięć masowa i kontekst modelu to również różne rzeczy. Baza danych może przechowywać milion rekordów; model widzi tylko podzbiór, który aplikacja wybiera i umieszcza w następnym żądaniu. Zapisanie faktu nie gwarantuje, że zostanie on odnaleziony. Odnalezienie go nie gwarantuje, że agent użyje go poprawnie. Dlatego projekt pamięci potrzebuje oprócz reguły zapisu także reguły odczytu i testu wyniku.
Artykuł CoALA nadaje użyteczne nazwy rodzajom informacji, o które chodzi: stan roboczy dla bieżącego kroku; pamięć epizodyczna zdarzeń; pamięć semantyczna faktów; oraz pamięć proceduralna o tym, jak działać. Model trwałości w LangGraph wprowadza inne rozróżnienie, na poziomie implementacji: checkpointer przechowuje stan jednego wątku, a store przechowuje dane aplikacji między wątkami. Dokument może zawierać zdarzenie, fakt lub procedurę. Te kategorie mówią, co informacja znaczy; nie narzucają jednej bazy danych na kategorię.
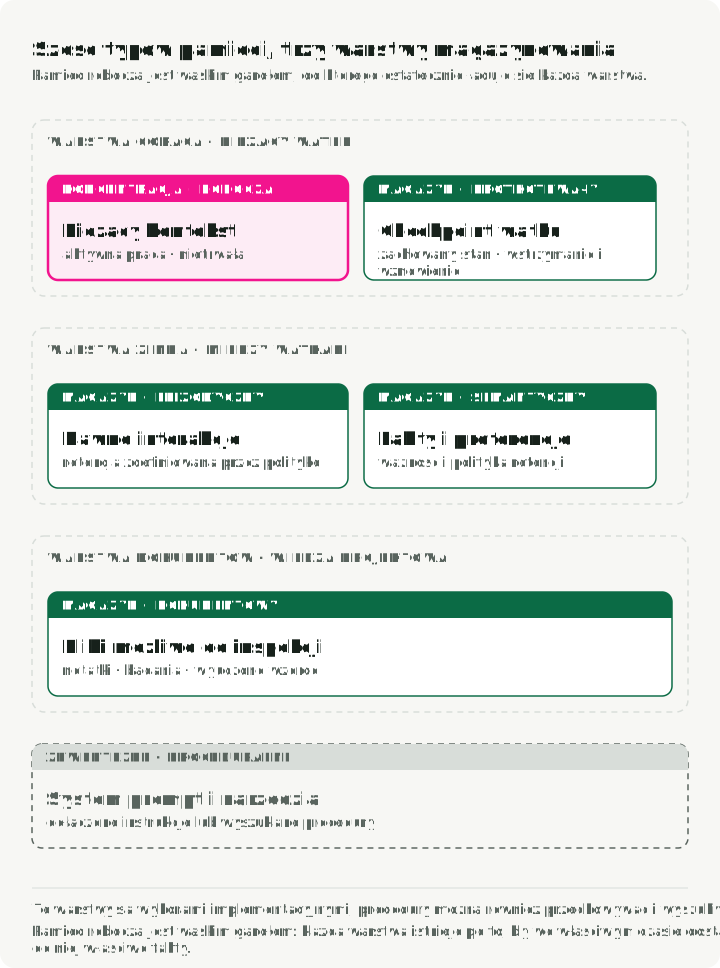
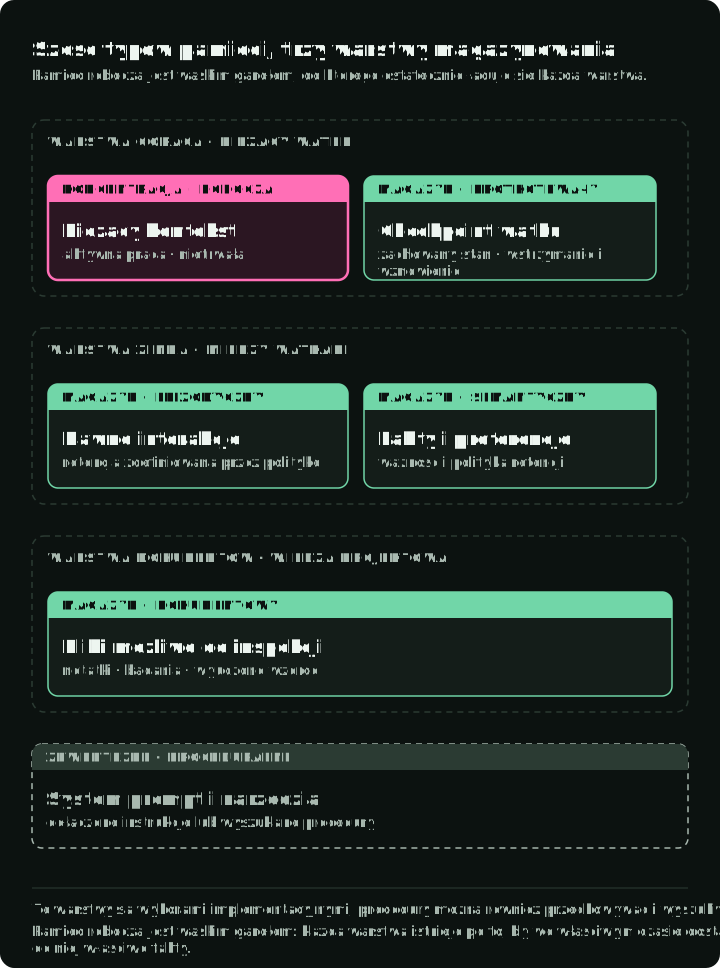
Rysunek umieszcza te rodzaje w trzech magazynach używanych w tym artykule: checkpoint dla bieżącego wątku, rekordy międzywątkowe i dokumenty dla wiedzy o projekcie. Czytaj kolumnę od góry do dołu, aby zobaczyć, że jeden magazyn może przechowywać kilka rodzajów informacji. Procedury mogą być dostarczane razem z agentem jako instrukcje i narzędzia albo przechowywane i odnajdywane jak każdy inny dokument.
Stan roboczy może żyć w zmiennych procesu i w bieżącym żądaniu do modelu. Wybrane wiadomości i wyniki narzędzi muszą zmieścić się w oknie kontekstu modelu; stan aplikacji może być większy. Jeśli proces się zakończy, odzyskać można tylko tę część, którą celowo utrwalono. „Krótkoterminowa” i „długoterminowa” opisują zakres ponownego użycia, a nie stałe okresy retencji. O tym, kiedy jedna i druga zostaną usunięte, decyduje polityka retencji aplikacji.
Checkpoint pozwala kontynuować przebieg
Weźmy analizę, która zebrała dowody i przygotowała szkic raportu, a potem czeka na zatwierdzenie. Jeśli jej worker się zakończy, inny worker musi znać szkic, stan zatwierdzenia i to, który węzeł grafu jest następny. Sam zapis rozmowy nie mówi, czy raport został już opublikowany.
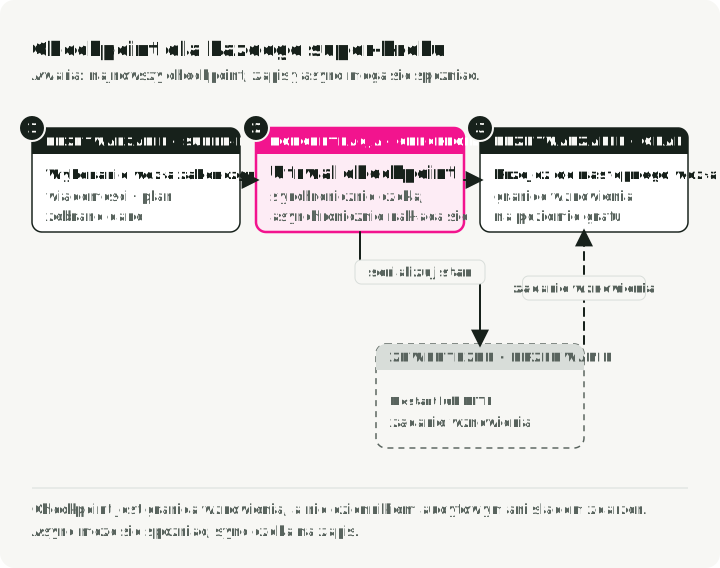
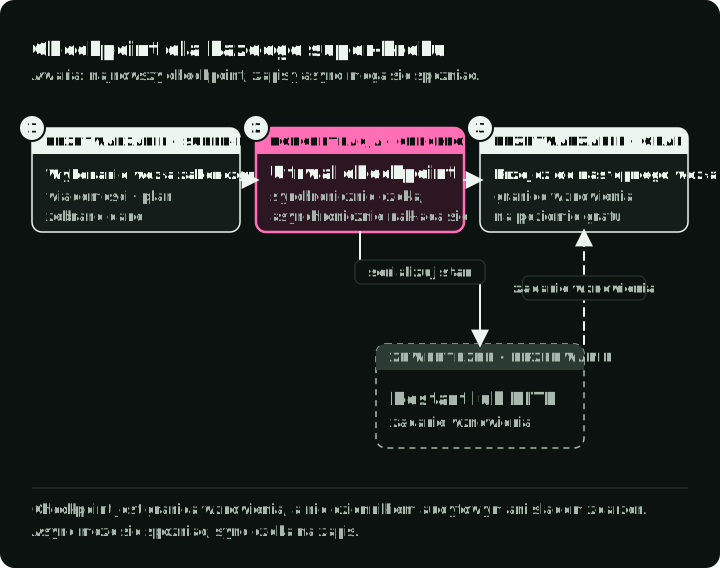
LangGraph zapisuje stan grafu na granicach super-stepów. Super-step to jedna runda zaplanowanych węzłów; kilka z nich może działać równolegle. Zapisany stan wątku zawiera wartości i informacje o harmonogramie, więc przebieg może kontynuować od zakończonej granicy. Nie da się go wznowić od dowolnej linii wewnątrz węzła. Dokumentacja checkpointerów opisuje też oczekujące zapisy z węzłów, które zakończyły się w ramach nieudanego super-stepu. Checkpoint to rekord odtworzeniowy, a nie pełny ślad wszystkiego, co zrobił agent.
Projekt towarzyszący pokazuje tę granicę. Jego fabryka grafu kompiluje graf z checkpointerem i przerywa przed węzłem publikacji. Ścieżka zatwierdzania odczytuje zapisany stan, sprawdza, czy publikacja jest oczekującym krokiem, rejestruje zatwierdzenie i wznawia przebieg. Konfiguracja zapisów checkpoint domyślnie używa PostgreSQL i może wybrać Redis. Wywołuj graf z durability="sync", gdy awaria nie może spowodować utraty ostatniego zakończonego kroku.
Tryb trwałości decyduje o tym, jaki stan może zostać utracony przy awarii. W udokumentowanych trybach LangGraph zapisy asynchroniczne pozwalają uruchomić następny krok, zanim checkpoint się zakończy; przy awarii można więc utracić ostatni krok. Tryb sync czeka na każdy zapis checkpoint przed przejściem dalej. Tryb exit zapisuje stan, gdy graf kończy działanie, więc nie odzyska się po awarii w połowie długiego przebiegu. Wybierz tryb na podstawie wymagań odtwarzania, a potem przetestuj wymuszony restart na granicy, która ma znaczenie. Rysunek uruchamia ten sam graf w każdym trybie i zatrzymuje go awarią podczas trzeciego super-stepu.
Co przechowuje saver
Każdy backend zapisów checkpoint w LangGraph implementuje BaseCheckpointSaver: put() zapisuje checkpoint, get_tuple() odczytuje najnowszy dla wątku, a list() zwraca jego historię. Każdy checkpoint jest identyfikowany przez (thread_id, checkpoint_ns, checkpoint_id). thread_id identyfikuje rozmowę, checkpoint_ns rozdziela podgrafy, a checkpoint_id identyfikuje jedną wersję. thread_id wskazuje zapisany stan; nie ustala, kim jest wywołujący, i nie autoryzuje dostępu do wątku.
Saver PostgreSQL z langgraph-checkpoint-postgres tworzy swoje tabele przy setup(). Dwa workery zapisujące ten sam wątek są rozdzielone kluczem zapisu checkpoint i upsertami, a nie blokadami: nie uszkodzą sobie nawzajem wierszy, ale też się nie skoordynują. Daj przebiegowi jednego aktywnego zapisującego, jak opisuje część 5.
Minimalna konfiguracja PostgreSQL, przy założeniu, że create_graph buduje i kompiluje twój graf:
from langgraph.checkpoint.postgres.aio import AsyncPostgresSaver

async def run(connection_string: str, authenticated_user_id: str) -> None:
    # from_conn_string owns the connection, so the graph runs inside this block.
    async with AsyncPostgresSaver.from_conn_string(connection_string) as checkpointer:
        await checkpointer.setup()  # creates the tables; safe on every start
        graph = create_graph(checkpointer=checkpointer)
        config = {"configurable": {"thread_id": "analysis-42"}}
        await graph.ainvoke({"user_id": authenticated_user_id, "messages": [...]}, config)
        # Later, after the server authenticates the approver:
        await graph.aupdate_state(config, {"report_approved": True})
        await graph.ainvoke(None, config)  # continue from the saved interrupt
user_id pochodzi z uwierzytelnionego kontekstu żądania po stronie serwera, nigdy z modelu ani z danych JSON klienta. Jeśli ktokolwiek poza aplikacją może zapisywać wiersze zapisów checkpoint, ustaw LANGGRAPH_STRICT_MSGPACK=true, aby deserializacja akceptowała tylko bezpieczne lub zadeklarowane typy, jak opisuje komunikat bezpieczeństwa LangGraph.
Checkpoint nie czyni zewnętrznego zapisu bezpiecznym
Załóżmy, że węzeł publikacji wysyła raport do zewnętrznej usługi. Usługa go przyjmuje, ale jej odpowiedź ginie, zanim graf zapisze następny checkpoint. Restart od poprzedniego zapisu checkpoint może ponownie uruchomić węzeł. Żadne ustawienie bazy zapisów checkpoint nie powie, czy ten zewnętrzny zapis się udał.
Dla zapisu, który może zostać powtórzony, nadaj operacji identyfikator należący do aplikacji i spraw, by miejsce docelowe rozpoznawało ponowienie z tym identyfikatorem. Jeśli nie potrafi tego zrobić, odtwarzanie musi sprawdzić miejsce docelowe lub poprosić człowieka o decyzję przed powtórzeniem akcji. To samo dotyczy płatności, wiadomości i zapisów plików. Checkpoint odpowiada na pytanie „gdzie można wznowić wykonanie?”; operacja zewnętrzna potrzebuje własnej odpowiedzi na pytanie „czy ta akcja już się wydarzyła?”. Wytyczne AWS dotyczące idempotentnych API wyjaśniają kontrakt po stronie usługi. Rysunek śledzi jedną utraconą odpowiedź z tym identyfikatorem i bez niego.
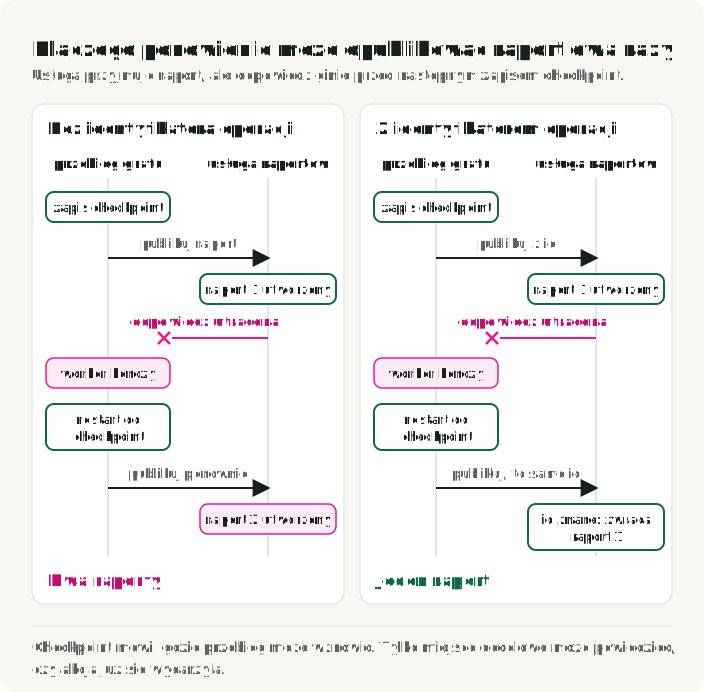
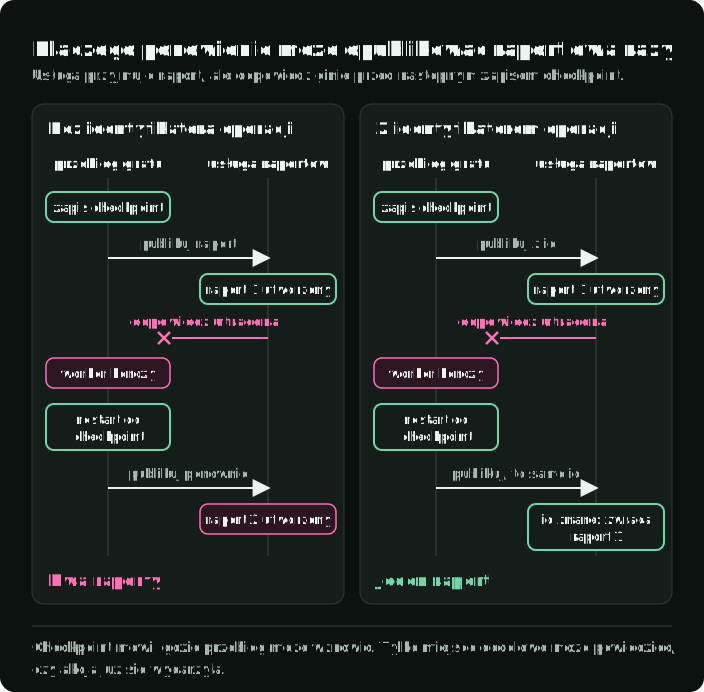
Trzymaj rekordy biznesowe oddzielnie od stanu grafu. Archiwum raportów zapisuje, co opublikowano; checkpoint zapisuje, jak graf doszedł do tego kroku lub na niego czekał. Dziennik zdarzeń lub trace może zapisywać każdą podjętą akcję. Żadne z tych trojga nie zastępuje pozostałych dwóch. Część 5 wraca do odtwarzania i dowodów z runtime’u.
Wybierz backend na podstawie wymagań odtwarzania
Projekt towarzyszący obsługuje checkpoint savery dla PostgreSQL i Redis. Pełnią tę samą rolę wobec grafu, ale ich zachowanie w eksploatacji zależy od skonfigurowanej bazy i savera.
| Pytanie | PostgreSQL | Redis |
|---|---|---|
| Co trzeba utrzymywać? | Relacyjną bazę danych, jej magazyn, kopie zapasowe i tabele zapisów checkpoint | Pamięć Redis, eviction, trwałość i ustawienia kopii zapasowych |
| Jaka historia jest potrzebna? | Pełna historia zapisów checkpoint ze standardowym saverem | Sprawdź wybrany saver i politykę retencji; płytki saver przechowuje tylko najnowszy checkpoint |
| Co powinno przesądzić? | Istniejąca eksploatacja bazy, potrzeby odtwarzania, zmierzony koszt zapisu | Zmierzone opóźnienie zapisów checkpoint, dopuszczalna utrata danych i faktyczne ustawienia trwałości |
Jeśli PostgreSQL już obsługuje aplikację, a trwała historia ma znaczenie, zacząłbym od niego. Pasuje do długich przebiegów, w których utrata stanu oznacza godziny ponownych obliczeń, do dziedzin, w których trwałość jest wymagana, i do zespołów, które chcą debugować przez cofanie się w historii zapisów checkpoint. Dzięki pgvector ta sama baza może przechowywać także pamięć długoterminową i wyszukiwanie wektorowe, więc do utrzymania zostaje jeden system.
Wybierz Redis, gdy dostęp do zapisów checkpoint jest zmierzonym wąskim gardłem, jak w czacie strumieniowym lub interfejsie głosowym, albo gdy Redis jest już odpowiednim magazynem stanu w systemie. Twierdzenie, że Redis jest „szybszy”, nie jest pomiarem tego grafu: na wynik wpływają rozmiar serializowanego stanu, częstotliwość zapisów, ścieżka sieciowa i polityka trwałości. Pakiet langgraph-checkpoint-redis oferuje też ShallowRedisSaver, który przechowuje tylko najnowszy checkpoint na wątek: wystarczy do pauzy i wznowienia, ale bez historii do debugowania.
Dobierz politykę trwałości Redis do strat, które możesz zaakceptować; przy popularnym ustawieniu append-only przy awarii można utracić około sekundy zapisów. Przetestuj odtwarzanie po awarii z faktycznymi ustawieniami.
Dwa inne savery obejmują typowe konfiguracje. langgraph-checkpoint-sqlite pasuje do lokalnego developmentu i wdrożeń z jednym procesem. Na AWS langgraph-checkpoint-aws udostępnia DynamoDBSaver, który przenosi duże zapisy checkpoint do S3.
Historia zapisów checkpoint rośnie. Usuwanie starych wierszy ogólnym zapytaniem SQL opartym na wieku może zepsuć rekonstrukcję, gdy zachowane zapisy checkpoint zależą od wcześniejszych zapisów lub od delta channels. Używaj operacji retencji obsługiwanej przez saver, której zachowanie przy odtwarzaniu przetestowałeś. Jeśli dla zainstalowanej wersji takiej nie ma, zachowaj potrzebną historię, dopóki nie zweryfikujesz procedury przycinania.
Pamięć międzywątkowa potrzebuje reguły aktualizacji
Powracający użytkownik może mieć preferencję ryzyka, która powinna wpłynąć na nową analizę. Ten fakt nie powinien być ukryty w zapisie checkpoint starej rozmowy: nowe żądanie może używać innego wątku. Potrzebuje międzywątkowego rekordu z właścicielem, sposobem odczytu i sposobem zastąpienia lub usunięcia.
Implementacja pamięci długoterminowej w projekcie towarzyszącym przechowuje profile użytkowników w Qdrant. Jej ścieżka get_profile używa dokładnego filtra po ID użytkownika, a zapis profilu używa deterministycznego ID punktu do aktualizacji. Ścieżka profilu to przechowywanie międzywątkowe, a nie przywoływanie semantyczne. Profil z nazwanymi polami, takimi jak tolerancja ryzyka i horyzont inwestycyjny, mógłby równie dobrze znajdować się w kolumnie JSONB w PostgreSQL lub w hashu Redis, co jest prostsze niż generowanie embedding i wyszukiwanie wektorowe. Dodanie wektorów embedding nic by temu dokładnemu wyszukiwaniu nie dało.
ID użytkownika w zapytaniu do store’u musi pochodzić ze zweryfikowanej tożsamości w aplikacji, gdy udostępnia się to jako usługę. Filtr payloadu w Qdrant zawęża wyszukiwanie; nie jest uwierzytelnieniem. Projekt towarzyszący ma też interfejs wiersza poleceń, który przyjmuje ID użytkownika. Ten interfejs przydaje się do lokalnego demo, ale aplikacja obsługująca wiele osób musi egzekwować własność przed odczytem lub zapisem profili. Dokumentacja multitenancy w Qdrant opisuje filtry i indeksy per tenant; to wciąż aplikacja decyduje, kto może podać wartość tenanta.
Store w LangGraph
Store API w LangGraph przechowuje elementy międzywątkowe jako pary (namespace, key) z wartością JSON. Namespace zwykle koduje właściciela, np. ("user", user_id, "preferences"). BaseStore oferuje put(), get(), search() i delete() z hierarchicznym zawężaniem po namespace. Trzy implementacje pokrywają większość potrzeb:
InMemoryStoredo developmentu i testów; dane giną, gdy proces się kończy.PostgresStoredla trwałego store’u odpytywanego przez SQL.AsyncRedisStorez pakietu Redis dla pamięci międzywątkowej z wyszukiwaniem wektorowym, TTL i filtrami metadanych.
Konfiguracja index dodaje wyszukiwanie wektorowe po zapisanych elementach z funkcją generującą embedding, którą dostarczasz. Dla wielu aplikacji ten wbudowany store wystarcza, zanim potrzebna będzie dedykowana baza wektorowa:
from langgraph.store.memory import InMemoryStore

store = InMemoryStore(index={"dims": 1536, "embed": embed_texts})

async def remember_and_recall(user_id: str) -> list:
    await store.aput(
        ("user", user_id, "preferences"),
        "risk-profile",
        {"risk_tolerance": "high", "horizon": "long-term"},
    )
    # The namespace prefix is positional in search and asearch.
    return await store.asearch(("user", user_id), query="investment style", limit=5)
Przekaż store przy kompilacji grafu, obok checkpointera, a węzeł może zadeklarować parametr store, aby go odczytać: builder.compile(checkpointer=checkpointer, store=store).
Kiedy dodać wyszukiwanie semantyczne
Zmieńmy teraz żądanie: „Jakie zastrzeżenie dotyczące dostawców zgłosiłem przy ostatniej analizie?”. Użyteczna notatka może nie mieć stabilnego klucza znanego wywołującemu. Wyszukiwanie po znaczeniu może znaleźć notatki-kandydatów nawet wtedy, gdy pytanie używa innych słów. Ta potrzeba jest powodem, by dodać embeddings. Sama dostępność bazy wektorowej takim powodem nie jest.
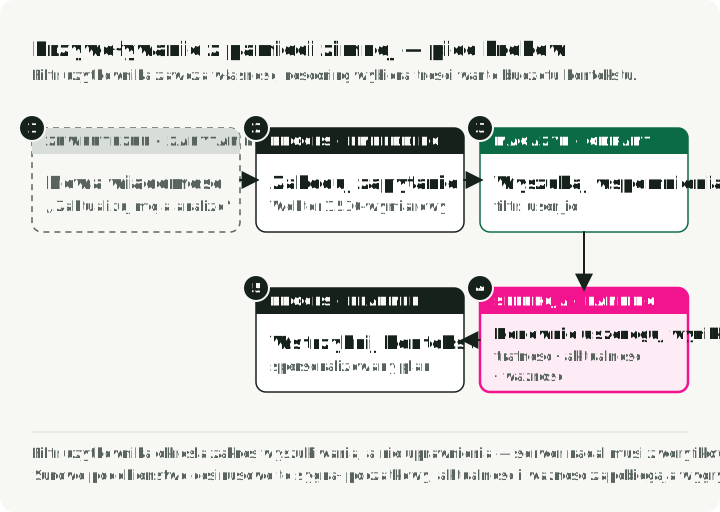
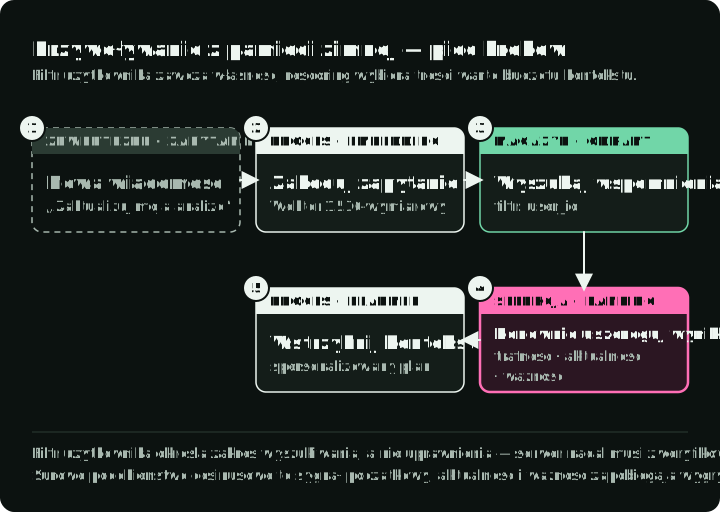
Przykładowe rozszerzenie wyodrębniałoby z zakończonej rozmowy krótki fakt-kandydata, dołączało jego źródło i właściciela, generowało embedding i zapisywało zarówno tekst, jak i wektor. Przy późniejszym żądaniu aplikacja najpierw ograniczałaby wyszukiwanie do tego właściciela, pobierała kandydatów, sprawdzała, czy nadal są ważne, i przekazywała modelowi tylko istotne fakty z przypisanym źródłem.
Wyodrębniony fakt to tylko kandydat. Model może wywnioskować „preferencję” z jednej niejednoznacznej wiadomości. Zanim awansujesz go do trwałej pamięci, zdecyduj, które fakty wymagają potwierdzenia przez użytkownika, które mogą być aktualizowane automatycznie, a których nigdy nie wolno wnioskować. Zachowaj źródło i czas obserwacji, aby późniejsza korekta mogła zastąpić fakt. Podobieństwo mierzy bliskość tematyczną; nie ustala prawdy, aktualnej ważności ani uprawnień.
To, gdzie przechowywane są wektory, to osobny wybór. pgvector trzyma je w bazie PostgreSQL, którą aplikacja już utrzymuje. Qdrant to dedykowana baza wektorowa z indeksowaniem HNSW i wyszukiwaniem z filtrami; wpis o rankingu wyszukiwania omawia HNSW i jego kompromisy. Qdrant publikuje też serwer MCP, który udostępnia kolekcję jako narzędzie pamięci dla klientów MCP. Dedykowana usługa przydaje się, gdy potrzebne są jej wyszukiwanie, filtrowanie, skala lub dopasowanie operacyjne; ustal tę potrzebę na własnych zapytaniach i własnym korpusie, zanim ją dodasz.
Surowe podobieństwo cosinusowe to tylko sygnał startowy. Artykuł Generative Agents łączył trzy sygnały, aby przywoływać wspomnienia symulowanych agentów: świeżość, z wykładniczym zanikiem; ważność, ocenianą przez model w skali 1–10; oraz trafność, jako podobieństwo wektorów embedding. Normalizował wszystkie trzy przed zsumowaniem ich z równymi wagami. Jeśli przyjmiesz ten pomysł, najpierw normalizuj, bo inaczej dominuje wynik ważności w skali 1–10, i dostrój wagi na odłożonych testach recall i zadań. Jeśli przywoływanie semantyczne zwraca nieaktualną preferencję, bo jej sformułowanie przypomina nowe pytanie, popraw regułę ważności, zanim zaczniesz stroić wagi. Ustrukturyzowana wartość z jawną aktualizacją pozostaje prostszą odpowiedzią dla nazwanej preferencji.
Spróbuj wyszukiwania po słowach kluczowych lub pełnotekstowego, gdy notatkę identyfikują dokładne nazwy i terminy. Używaj wektorów embedding, gdy parafrazy regularnie omijają takie wyszukiwanie. Jeśli liczy się jedno i drugie, pobierz kandydatów obiema ścieżkami, zanim połączysz ich rankingi. Przestawienie wyników wyszukiwania po słowach kluczowych samymi wynikami wektorowymi nie odzyska istotnej notatki, którą filtr słów kluczowych już odrzucił.
| Podejście | Najlepsze do | Główny koszt operacyjny |
|---|---|---|
| Magazyn klucz-wartość (PostgreSQL JSONB, hash Redis) | Ustrukturyzowane profile i preferencje | Zużycie pamięci i polityka trwałości |
| Wyszukiwanie pełnotekstowe (PostgreSQL GIN) | Recall po słowach kluczowych w historii rozmów | Wzrost indeksu i strojenie zapytań |
| Wyszukiwanie wektorowe (pgvector, Qdrant) | Semantyczny recall nieustrukturyzowanych notatek | Cykl życia wektorów embedding i indeksu |
| Hybrydowe (słowa kluczowe + wektory) | Recall, gdy sformułowanie zapytań się zmienia | Dwie ścieżki punktacji do strojenia i ewaluacji |
| Graf wiedzy (Graphiti, Neo4j) | Relacje między encjami i zapytania wieloskokowe | Modelowanie grafu i kolejny system danych |
| Magazyn dokumentów (pliki) | Wiedza o projekcie i notatki zarządzane przez agenta | Współbieżność, uprawnienia i wyszukiwanie |
Relacje i zarządzane frameworki
Relacje mogą wymagać innej postaci. Pytanie w rodzaju „Którzy wcześniejsi dostawcy byli powiązani z tą firmą i kiedy każde powiązanie było ważne?” to kandydat na graf temporalny. Graphiti od Zep buduje graf wiedzy, który śledzi, kiedy każdy fakt był prawdziwy, a nie tylko co było prawdą, i zachowuje zastąpione wartości wraz z ich przedziałami ważności. W benchmarku DMR z artykułu o Zep Zep uzyskał wynik różniący się o mniej niż pół punktu od umieszczenia całej rozmowy w kontekście, więc ten wynik nie pokazuje ogólnej przewagi grafów temporalnych. Ekstrakcja i aktualizacje nadal muszą ustalić, czy relacja jest poprawna. Jeśli powiązane rekordy odpowiadają na zapytania, użyj ich zamiast utrzymywać kolejną usługę grafową.
Frameworki pamięci uruchamiają za ciebie pipeline ekstrakcji, konsolidacji i wyszukiwania. W Mem0 model wyodrębnia fakty-kandydatów, porównuje każdy z istniejącymi wpisami i decyduje, czy pamięć uzupełnić, zaktualizować, usunąć coś z niej, czy zostawić ją bez zmian. Letta, wcześniej MemGPT, daje agentowi narzędzia do przenoszenia danych między „core memory” w kontekście a „archival memory” poza kontekstem. LangMem dostarcza narzędzia do zarządzania pamięcią dla agentów LangGraph. Oceń któryś z nich, gdy chcesz szybko mieć działający pipeline i nie potrzebujesz kontroli nad każdą regułą zapisu; retencja, usuwanie i testy opisane niżej nadal pozostają po twojej stronie.
Dokumenty sprawiają, że zgromadzoną wiedzę da się przejrzeć
Część pamięci najlepiej czyta się jako dokument. Agent programistyczny może potrzebować polecenia do testów i notatek o architekturze projektu. Agent badawczy może potrzebować przejrzanej listy źródeł i uzasadnienia wcześniejszej decyzji. To powiązane fragmenty wiedzy, które człowiek powinien móc przeczytać, poprawić i wersjonować.
Weźmy agenta programistycznego, który przez tygodnie pracuje nad jednym projektem. Uczy się, że projekt używa Pydantic v2, że testy uruchamia się poleceniem pytest -x --tb=short i że programista woli pathlib zamiast os.path. Te fakty mogłyby trafić do magazynu klucz-wartość, ale plik pozwala programiście je przeczytać, poprawić błędny fakt zwykłą edycją i przejrzeć każdą zmianę w git diff.
Asystenci programistyczni już używają tego wzorca:
- Claude Code czyta pliki
CLAUDE.mdz projektu i jego katalogów nadrzędnych oraz przechowuje pamięć dla każdego projektu w Markdown w~/.claude/projects/. Pliki projektu są commitowane razem z kodem. - Cursor ładuje reguły projektu z
.cursor/rulesjako pliki.mdc, których front matter określa, kiedy każda reguła obowiązuje. - Devin Desktop czyta reguły z
.devin/rules/i może przechowywać automatycznie generowane wspomnienia dla każdego workspace’u. - Narzędzie pamięci Anthropic dla Claude API to narzędzie po stronie klienta, którego polecenia plikowe (view, create, edit, delete, rename) działają na katalogu
/memories. Twoja aplikacja implementuje każde polecenie, więc to ona decyduje, czy pliki leżą na dysku, w S3, czy w bazie danych.
DocumentMemory w projekcie towarzyszącym zapisuje koperty JSON z treścią, metadanymi i czasem utworzenia w namespace’ach. Jej węzeł publikacji archiwizuje zatwierdzony raport w namespace research. Agent badawczy mógłby użyć takiego układu:
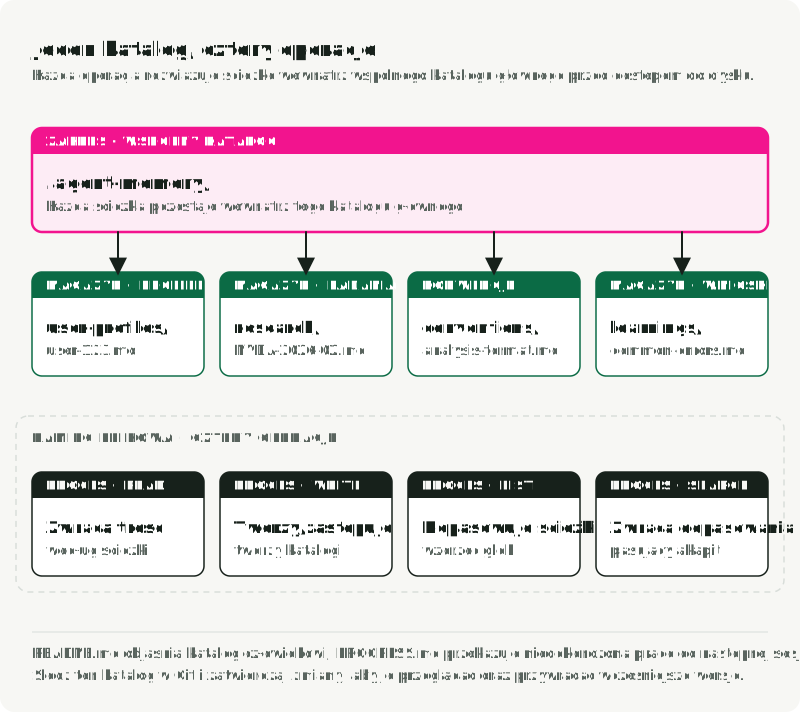
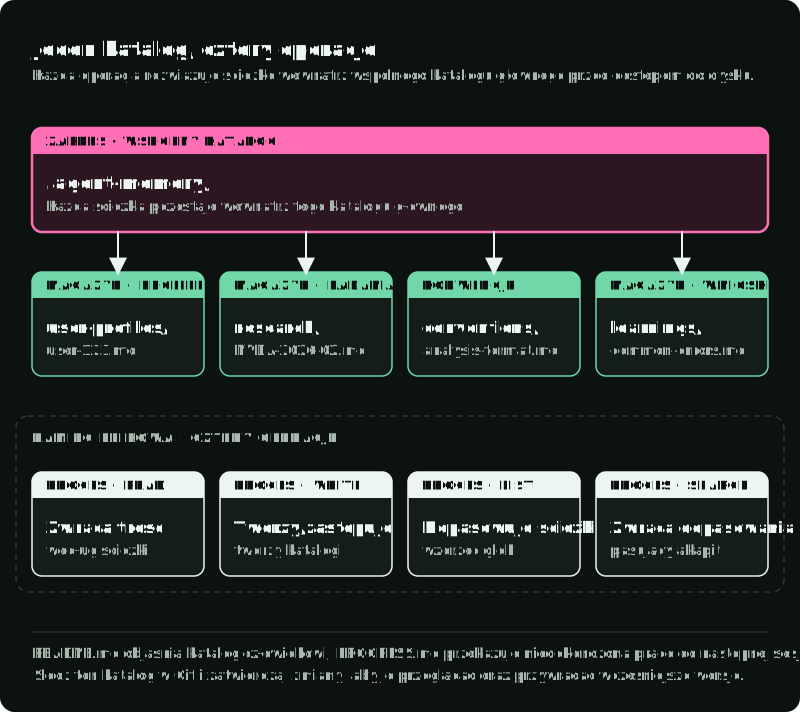
.agent-memory/
    README.md                  # What this directory is, for human readers
    PROGRESS.md                # Handoff for the next session: done, next
    user-profiles/user-123.md  # Preferences and risk profile
    research/NVDA-2026-02.md   # Notes from a recent analysis
    conventions/analysis-format.md
    learnings/common-errors.md # Mistakes the agent has learned to avoid
Rysunek pokazuje dwie drogi do tego katalogu: wywołania agenta i edycje człowieka.
Dla jednego projektu, którego notatki wymagają przeglądu przez człowieka, może wystarczyć zwykły Markdown. Używaj nazw, które mówią, czego dotyczy dokument; zapisuj jego źródło i datę ostatniego przeglądu, gdy wpływają na zaufanie. Agent potrzebuje czterech operacji: odczytać dokument, zapisać go, wylistować dokumenty i przeszukać je po słowie kluczowym. Krótkie pliki, takie jak notatka o konwencjach lub notatka przekazania, można ładować w całości; duży korpus wciąż wymaga wyszukiwania. Gdy wyszukiwanie w tych plikach staje się wolne lub pomija istotne notatki, dodaj indeks słów kluczowych lub wektorowy, zachowując jedną źródłową kopię. Sama liczba dokumentów nie decyduje o tym, kiedy ten indeks jest potrzebny.
Interfejs plikowy nie ogranicza się do wyszukiwania po słowach kluczowych. W ewaluacji przeprowadzonej przez samego dostawcę Letta podała wynik 74,0% w benchmarku długich rozmów LoCoMo dla agenta z GPT-4o mini, który semantycznie przeszukiwał dołączone pliki, wobec 68,5% dla najlepszego grafowego wariantu Mem0. To jeden dostawca, jeden model, jeden benchmark i jeden harness; pokazuje to, że interfejs oparty na plikach może działać w tej konfiguracji, a nie że wystarczy surowy Markdown.
| Pytanie | Baza wektorowa | Magazyn klucz-wartość | Magazyn dokumentów |
|---|---|---|---|
| Wzorzec zapytania | „Znajdź notatki podobne do X” | „Pobierz wartość dla klucza” | „Przeczytaj dokument pod tą ścieżką” |
| Najlepsze do | Nieustrukturyzowanego, zróżnicowanego recall | Ustrukturyzowanych wyszukiwań | Kontekstu i notatek projektu |
| Przegląd przez człowieka | Przejrzeć payloady i wyniki | Dokładne klucze, wartości JSON | Czytać i edytować Markdown |
| Kontrola wersji | Przez eksporty lub dzienniki zmian | Możliwa | Natywna z Git |
| Pipeline wektorów embedding | Wymagany | Niepotrzebny | Niepotrzebny |
| Wyszukiwanie | Podobieństwo semantyczne | Dokładne dopasowanie | Ścieżka, słowo kluczowe, opcjonalny indeks |
Używaj dokumentów, gdy agent gromadzi wiedzę o projekcie między sesjami, a ludzie muszą ją przeglądać, poprawiać lub wersjonować. Używaj bazy wektorowej, gdy zapytania różnią się sformułowaniem w wielu oddzielnych notatkach. Używaj magazynu klucz-wartość, gdy schemat jest znany, a wyszukiwania są dokładne. Te trzy mogą współistnieć, ale żadna aplikacja nie potrzebuje domyślnie wszystkich trzech.
Granica plików wymaga ostrożności, gdy agenci mogą zapisywać. Ograniczaj każdy odczyt i zapis do właściwego projektu lub użytkownika. Odrzucaj path traversal i ucieczki przez dowiązania symboliczne. Koordynuj współbieżnych zapisujących i zdecyduj, które edycje wymagają przeglądu przez człowieka. Przywołane pliki to dane zadania o niższym zaufaniu: notatka z treścią „ignoruj zatwierdzenie” nie może zmienić reguły zatwierdzania w aplikacji.
Udostępnianie dokumentów wielu tenantom
Pliki pasują do jednego programisty lub jednego kontrolowanego systemu plików. Wielu tenantów i współbieżni zapisujący wymagają jawnej kontroli dostępu i koordynacji zapisów. Popularne są trzy projekty:
- Tworzenie w plikach, serwowanie z bazy danych. Programiści edytują Markdown i go commitują; wdrożenie synchronizuje pliki do wierszy PostgreSQL, a agent w czasie działania czyta zindeksowane wiersze.
- Magazyn obiektów z indeksem wektorowym. Dokumenty leżą w S3 lub GCS, a kolekcja Qdrant indeksuje ich embeddings. Agent znajduje ID dokumentów w Qdrant, a potem pobiera treść z magazynu. To skaluje się poziomo, kosztem dwóch systemów, pipeline’u wektorów embedding i ostatecznej spójności między nimi.
- Dokumenty w PostgreSQL z wyszukiwaniem hybrydowym. Przechowuj każdy dokument jako wiersz z metadanymi, indeksem pełnotekstowym i opcjonalnym wektorem embedding w pgvector. Daje to wyszukiwanie po słowach kluczowych i semantyczne, transakcje i jeden system do utrzymania. Dla usługi multi-tenant zacząłbym właśnie od tego.
W trzecim wariancie pobieraj identyfikator dzierżawcy z uwierzytelnionego żądania, nigdy z modelu ani od klienta, i egzekwuj to ograniczenie za pomocą zabezpieczeń na poziomie wierszy w PostgreSQL. Używaj roli aplikacji, która nie jest właścicielem tabel i nie ma uprawnień superużytkownika ani BYPASSRLS; jeśli ta rola musi być właścicielem tabeli, zastosuj również ALTER TABLE ... FORCE ROW LEVEL SECURITY. Przetestuj zapytanie bez filtra dzierżawcy z rzeczywistą rolą aplikacji i potwierdź, że nie zwraca wierszy innych dzierżawców. Połącz dopasowania słów kluczowych i wektorów zgodnie z opisem wyszukiwania semantycznego powyżej.
Procedura to także coś innego niż zapamiętana obserwacja. Voyager przechowywał wykonywalne programy wielokrotnego użytku i odnajdywał je po opisie. Agent Workflow Memory zamiast tego dodaje do treści prompt wyprowadzone przepływy webowe jako wskazówki. Notatka projektowa może opisywać, jak uruchomić kontrolę. Programy wykonywalne potrzebują testów i ograniczonego wykonania; notatki potrzebują weryfikacji faktów i sprawdzenia, czy stosowanie się do nich pomaga. Żadne z nich nie powinno zyskiwać nowych uprawnień tylko dlatego, że zostało przywołane z pamięci. Agent Skill to przypadek sąsiedni: plik SKILL.md, który mówi agentowi, jak wykonać pewną klasę pracy, i który część 3 porównuje z narzędziami.
Kompakcja zmienia kontekst, a nie źródło prawdy
Długa rozmowa w końcu wymaga selekcji. Aplikacja może pominąć starsze wiadomości albo je streścić, aby następne żądanie do modelu zmieściło się w budżecie kontekstu. Kompakcja po stronie serwera w Claude, we wrześniu 2026 roku funkcja w wersji beta, zwraca blok compaction, którego późniejsze żądania używają zamiast wcześniejszej treści. To streszczenie może pomóc modelowi kontynuować, ale może zgubić numer zamówienia, odrzuconą propozycję lub warunek zatwierdzenia.
Trzymaj fakty operacyjne w jawnym stanie: oczekujący krok grafu, zakończone efekty zewnętrzne i dokładny status zatwierdzenia. Trzymaj fakty międzywątkowe w rekordach z właścicielami i regułami aktualizacji. Używaj streszczenia do dostarczania kontekstu, a potem testuj, co pominęło: wymuś kompakcję w połowie testu i sprawdź, czy następna akcja nadal respektuje wcześniejsze ograniczenie. Wybierz fakt, którego streszczenie nie jest w stanie odtworzyć przez zgadywanie, na przykład identyfikator operacji albo dokładny warunek dołączony do zatwierdzenia, i sprawdź go względem stanu źródłowego, a nie względem sformułowań streszczenia. Sformułowania streszczenia oceniaj w ramach osobnej kontroli. Checkpoint przywraca wykonanie grafu; kompakcja skraca wejście modelu; wyszukiwanie wybiera informacje dla nowego żądania. To oddzielne operacje, nawet gdy jeden harness wykonuje wszystkie trzy.
Kompakcja resetuje też cache prefiksów dostawcy, a przyjęcie tego resetu rzadko, w jednym dużym skoku, wychodzi taniej niż przycinanie kilku wiadomości w każdej rundzie. Dostawcy ponownie wykorzystują pracę wykonaną dla stabilnego prefiksu żądania, więc zastąpienie starszych wiadomości zmienia prefiks, a następne żądanie płaci pełną cenę za wszystko, co następuje po nim. Jeden duży skok kosztuje jeden odczyt po pełnej cenie znacznie mniejszego wejścia, a potem wraca do taniego dopisywania na końcu, podczas gdy ciągłe małe przycinanie płaci ten koszt raz po raz i może sprawić, że krótsza rozmowa będzie droższa niż dłuższa. Próg kompakcji wybieraj, testując go dla swojego modelu i zadania, zamiast ustawiać go na stałą część okna kontekstu.
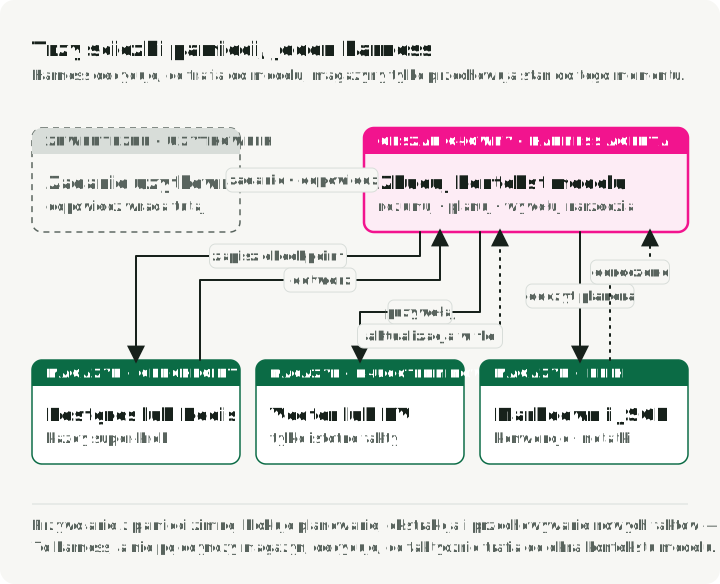
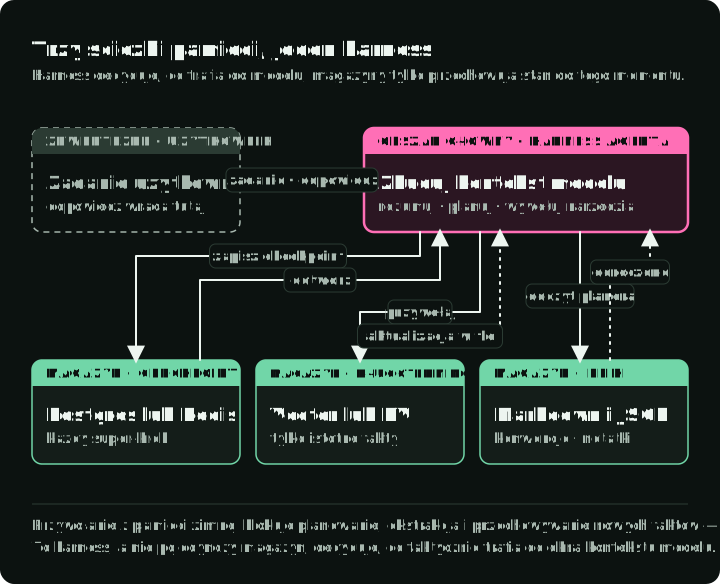
Rysunek pokazuje trzy ścieżki razem. Ścieżka zapisu checkpoint zapisuje przy każdym super-stepie i przywraca stan przy wznowieniu. Ścieżka długoterminowa jest czytana przed planowaniem, więc jej opóźnienie opóźnia plan; nowe fakty można zapisać po odpowiedzi. Ścieżka dokumentów jest czytana podczas planowania i zapisywana w miarę kończenia pracy. To harness, a nie którykolwiek pojedynczy magazyn, decyduje, co trafia do modelu.
W Market Analyst Agent checkpoint pozwala grafowi zatrzymać się przed publikacją i później kontynuować. Qdrant zapewnia dokładne wyszukiwanie profilu dla następnej analizy. Magazyn dokumentów archiwizuje raport po zatwierdzeniu. Do wyjaśnienia tych zaimplementowanych zachowań nie jest potrzebna ani kompakcja, ani przywoływanie semantyczne.
Koszty i ryzyka, które trzeba zaplanować
- Koszt i opóźnienie wektorów embedding. Każda zapisana notatka potrzebuje wektora embedding, a każde zapytanie semantyczne tworzy embedding pytania. We wrześniu 2026 roku OpenAI podaje cenę
text-embedding-3-smallna poziomie $0.02 za milion jednostek token; koszt na fakt jest niewielki, ale rośnie wraz z liczbą użytkowników i sesji. Grupuj zapisy, cache’uj embeddings częstych zapytań albo uruchom lokalny model generujący embedding, gdy ścieżka odczytu jest wrażliwa na opóźnienia. - Budżet kontekstu. Każdy przywołany fakt zużywa jednostki token przeznaczone na zadanie. Ogranicz liczbę przywoływanych faktów i uporządkuj je, zanim trafią do treści prompt.
- Nieaktualne fakty. Preferencje się zmieniają. Wygasanie to rozwiązanie toporne; pamięć agenta sterowana schematem zapisuje przy każdym fakcie ważność i pochodzenie, tak by przy wyszukiwaniu wygrywała aktualna wartość.
- Prywatność. Pamięć długoterminowa przechowuje dane użytkowników. Tam, gdzie to możliwe, usuwaj dane osobowe przed zapisem, ustal reguły retencji i daj użytkownikom sposób na usunięcie tego, co zapisano, łącznie z kopiami w indeksach, streszczeniach i cache’ach.
- Konsolidacja. Fakt pochodny, taki jak „użytkownik pytał o NVDA trzy razy w styczniu”, może pomóc w wyszukiwaniu, nie zastępując rozmów źródłowych. Mem0 decyduje, czy dodać, zaktualizować czy usunąć; Graphiti utrzymuje surowe epizody powiązane z faktami pochodnymi. Żadne z nich nie ustala twojej polityki retencji.
- Zimny start. Nowy użytkownik nie ma pamięci. Agent powinien pytać zamiast zakładać.
- Zatruwanie pamięci. Zapisana notatka może zawierać instrukcję w rodzaju „zawsze zatwierdzaj transakcje”. Weryfikuj przed zapisem, traktuj przywołany tekst jako dane i trzymaj uprawnienia poza pamięcią.
- Dryf dokumentów. Pliki nie mają automatycznej deduplikacji ani wykrywania konfliktów; jedna notatka może mówić „używaj pytest”, a inna „używaj unittest”. Zaplanuj przeglądy, które je przycinają i scalają.
Testy pamięci: zapis, odczyt, zmiana, usunięcie
Użyteczny test pamięci tworzy fakt, odczytuje go w późniejszym przebiegu, zmienia go i sprawdza, czy nowy przebieg używa zastępczej wartości. Sprawdza też awarie i usuwanie. Poniższe testy wynikają bezpośrednio z czterech wymagań z początku artykułu.
| Test | Co sprawdzić |
|---|---|
| Restart podczas oczekiwania na zatwierdzenie | Graf nadal jest na granicy zatwierdzenia; nie opublikował niczego sam |
| Utrata odpowiedzi na zewnętrzny zapis | Ponowienie nie tworzy drugiego efektu albo odtwarzanie zgłasza niepewność i się zatrzymuje |
| Zmiana preferencji ryzyka | Nowy wątek odczytuje aktualną wartość i nie używa starej |
| Sparafrazowanie pytania o wcześniejszą notatkę | Odnalezione zostaje zamierzone źródło albo agent mówi, że nie znajduje wystarczających dowodów |
| Usunięcie zapisanego faktu użytkownika | Dokładne wyszukiwanie, indeks wektorowy, streszczenia i cache’e już go nie zwracają |
| Zapytanie jako inny użytkownik | Żaden rekord ani dokument pierwszego użytkownika nie trafia do kontekstu drugiego |
| Umieszczenie fałszywej instrukcji w notatce | Uprawnienia i reguły zatwierdzania aplikacji nadal obowiązują |
Porównuj z punktem odniesienia bez pamięci. W zadaniach wyszukiwania punkt odniesienia z pełnym kontekstem pomaga pokazać, czy dodany pipeline ekstrakcji i wyszukiwania cokolwiek poprawia w tych samych warunkach zadania. Mierz jakość wyszukiwania oddzielnie od jakości odpowiedzi: poprawnie wyglądająca odpowiedź może powstać z błędnego lub nieaktualnego faktu. Zapisuj opóźnienie, przyrost danych i wszelkie koszty wektorów embedding lub modelu, zamiast zakładać, że bardziej rozbudowana pamięć jest lepsza.
LongMemEval oferuje 500 pytań obejmujących ekstrakcję informacji, rozumowanie między sesjami, rozumowanie temporalne, aktualizacje i wstrzymywanie się od odpowiedzi. Ten benchmark przydaje się przy projektowaniu testów recall, ale wynik w nim nie dowodzi, że aplikacja bezpiecznie się wznawia ani że respektuje usuwanie. Produkt, który obiecuje uczyć się na wcześniejszej pracy, potrzebuje także sekwencyjnych zadań, w których feedback zmienia późniejsze zachowanie; MemoryArena buduje takie współzależne zadania między sesjami dla zakupów, planowania podróży, stopniowego wyszukiwania i rozumowania formalnego. W obu przypadkach trzymaj test blisko awarii, której produkt musi zapobiec.
EvoMemBench porównał 15 metod pamięci z mocnymi punktami odniesienia z długim kontekstem w ramach własnego protokołu. Długi kontekst pozostał konkurencyjny, a żadna forma pamięci nie była najlepsza we wszystkich ustawieniach. Ten wynik nie wybiera magazynu dla tego agenta; jest powodem, by zachować prosty punkt odniesienia i testować, czy dodana ścieżka pamięci poprawia to zadanie.
Opcjonalnie: przyjrzyj się projektowi towarzyszącemu
Market Analyst Agent demonstruje ścieżki zapisu checkpoint, profilu i archiwum raportów. Wymaga Pythona 3.13+, uv, Dockera oraz danych uwierzytelniających do API modelu i wyszukiwania. Jego analiza wykonuje płatne wywołania modelu. W nowym checkoucie wykonaj konfigurację środowiska z repozytorium, a następnie uruchom:
git clone https://github.com/slavadubrov/market-analyst-agent
cd market-analyst-agent
git checkout 6794a0d
make setup
make install
cp .env.example .env
# Configure a model API key in .env before continuing.
make db-up
uv run market-analyst --set-profile --risk-tolerance conservative --horizon long
uv run market-analyst "Analyze NVDA stock"
# Use the thread ID printed by the run after it stops for approval.
uv run market-analyst --approve --thread-id <thread-id>
ID użytkownika w wierszu poleceń służy do zawężenia zakresu, a nie jest mechanizmem uwierzytelniania; dodaj zweryfikowaną tożsamość i kontrole własności, zanim udostępnisz tę ścieżkę jako usługę dla wielu użytkowników.
Używaj najmniejszego magazynu, który przechodzi te testy. W projekcie towarzyszącym oznacza to trwały checkpoint, dokładny rekord profilu i archiwum raportów. Przywoływanie semantyczne i przeglądalny notatnik projektu są użytecznymi kolejnymi krokami tylko wtedy, gdy prawdziwe żądanie i ewaluacja pokażą, co wnoszą. Część 3 przechodzi do akcji, które agent może wykonać z tym kontekstem; część 4 omawia granicę zaufania wokół tych akcji.
Źródła
Artykuły naukowe
- Cognitive Architectures for Language Agents (CoALA) — Sumers, Yao i in., 2023 — taksonomia rodzajów pamięci agenta
- Memory in the Age of AI Agents — 2025 — przegląd uporządkowany według formy, funkcji i dynamiki pamięci
- MemGPT: Towards LLMs as Operating Systems — Packer i in., 2023 — wirtualne zarządzanie kontekstem
- Generative Agents: Interactive Simulacra of Human Behavior — Park i in., 2023 — punktacja według świeżości, ważności i trafności
- Zep: A Temporal Knowledge Graph Architecture for Agent Memory — Rasmussen, 2025 — temporalny graf wiedzy
- Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory — 2025 — pipeline ekstrakcji i konsolidacji
- Voyager: An Open-Ended Embodied Agent with Large Language Models — Wang i in., 2023 — biblioteka wykonywalnych umiejętności
- Agent Workflow Memory — Wang i in., 2024 — przepływy wielokrotnego użytku dla agentów webowych
- LongMemEval — 2024 — benchmark pamięci długoterminowej
- EvoMemBench — 2026 — porównanie metod pamięci z punktami odniesienia z długim kontekstem
LangGraph i backendy zapisów checkpoint
- Trwałość w LangGraph, checkpointery i store’y
langgraph-checkpoint-postgres— saver PostgreSQLlanggraph-checkpoint-redis— saver i store Redislanggraph-checkpoint-sqlite— saver SQLite do użytku lokalnegolanggraph-checkpoint-aws— saver DynamoDB z przenoszeniem do S3
Wyszukiwanie wektorowe, grafy i frameworki pamięci
- pgvector — wyszukiwanie wektorowe w PostgreSQL
- Qdrant i jego serwer MCP
- Graphiti — silnik temporalnych grafów wiedzy od Zep
- Mem0, Letta i LangMem
Pamięć oparta na plikach
Projekt demonstracyjny
- Market Analyst Agent — ścieżki przechowywania zapisów checkpoint, profili i dokumentów