Architektur der Agent Memory: Checkpoints und Vector Stores

Automatische Übersetzung
Dieser Artikel wurde automatisch aus der englischen Originalversion übersetzt.
Ein Agent kann aus mehreren Gründen scheinbar „vergessen“. Er kann einen unvollendeten Lauf nach einem Neustart verlieren, eine Präferenz aus einem früheren Gespräch nicht abrufen oder einer veralteten Projektnotiz folgen. Jeder dieser Fehler braucht eine andere Art von Zustand und einen anderen Test. Dieser Artikel richtet sich an Engineers, die diesen Zustand entwerfen: Sie erfahren, wann ein Checkpoint, ein exakter Lookup, semantisches Retrieval oder ein prüfbares Dokument passt und welche Werkzeuge zu welcher Aufgabe gehören, von PostgreSQL- und Redis-Checkpoint-Savern über pgvector, Qdrant und Markdown-Dateien bis zu verwalteten Memory-Frameworks.
Teil 1 hat den Reasoning Loop gebaut. Hier nutzen wir den Market Analyst Agent, um zu sehen, was der Loop bewahren muss, wenn er vor der Veröffentlichung eines Reports pausiert und wenn ein Nutzer mit bekannten Präferenzen zurückkehrt.
Vier Fehler, die wie Vergessen aussehen
„Memory hinzufügen“ ist zu vage, um eine Implementierung zu wählen. Eine nützliche Anforderung sagt, was erhalten bleiben muss, wer es lesen darf und was passiert, wenn es falsch ist.
| Anforderung | Zu bewahrender Zustand | Erstes sinnvolles Design | Zu testender Fehler |
|---|---|---|---|
| Eine Analyse nach Freigabe oder Worker-Neustart fortsetzen | Nachrichten, Plan, Entwurf, ausstehender Graph-Schritt | Dauerhafter Checkpoint für diesen Thread | Neustart vor der Veröffentlichung; Fortsetzen am vorgesehenen Schritt |
| Die Risikopräferenz eines wiederkehrenden Nutzers anwenden | Ein aktueller, benannter Fakt, der an diesen Nutzer gebunden ist | Strukturiertes Profil mit exaktem Schlüssel | Präferenz ändern; den alten Wert nie verwenden |
| Eine unstrukturierte Beobachtung aus früherer Arbeit abrufen | Quelle, Text, Eigentümer, Zeit, Gültigkeit | Durchsuchbare Datensätze; Embeddings nur bei Bedarf | Anfrage umformulieren und die abgerufene Quelle prüfen |
| Eine Projektkonvention wiederverwenden | Prüfbare Notiz und ihr Eigentümer | Datei- oder Document Store | Eine falsche Notiz korrigieren und bestätigen, dass der nächste Lauf die Korrektur sieht |
Die erste Frage ist, ob der Agent überhaupt gespeicherten Zustand braucht. Ein One-Shot-Klassifikator, dessen gesamte Eingabe in einer Anfrage ankommt, kann seine Antwort validieren und aufhören. Er braucht keine Vector Database, nur weil ein größeres System eines Tages eine Folgefrage stellen könnte.
Sobald eine Anforderung besteht, nennt diese Tabelle ein Startwerkzeug für jede Aufgabe. Die Abschnitte darunter erklären, wann man zur Alternative wechselt.
| Aufgabe | Beginnen mit | Wechseln zu |
|---|---|---|
| Einen Lauf oder Thread fortsetzen | LangGraph PostgreSQL Saver | Redis Saver, wenn die Checkpoint-Latency ein gemessener Bottleneck ist; SQLite Saver für lokale Nutzung |
| Einen benannten Nutzerfakt lesen | PostgreSQL-Zeile oder JSONB-Spalte, Redis-Hash oder ein LangGraph-Store-Schlüssel | Nichts weiter, solange der Fakt einen stabilen Namen hat |
| Eine Notiz nach Bedeutung abrufen | LangGraph Store mit Index oder pgvector neben den Anwendungsdaten | Qdrant oder eine andere Vector Database, wenn Filterung, Skalierung oder Betrieb es erfordern |
| Eine Notiz über exakte Begriffe finden | PostgreSQL-Volltextsuche mit GIN-Index | Hybrides Keyword- und Vektor-Retrieval, wenn Umformulierungen die Keywords aushebeln |
| Fragen zu Verknüpfungen beantworten | Verknüpfte relationale Datensätze | Ein temporaler Knowledge Graph wie Graphiti |
| Projektwissen prüfbar halten | Markdown-Dateien im Repository | PostgreSQL-Dokumente mit Volltext- und Vector Search für viele Tenants |
| Extraktion und Pflege an ein Werkzeug abgeben | Eigene Schreib- und Aktualisierungsregeln | Mem0, Letta oder LangMem, wenn Sie diese Pipeline nicht selbst steuern müssen |
Speicher und Modellkontext sind ebenfalls verschiedene Dinge. Eine Datenbank kann eine Million Datensätze halten; das Model sieht nur die Teilmenge, die die Anwendung auswählt und in die nächste Anfrage setzt. Einen Fakt zu speichern garantiert nicht, dass er abgerufen wird. Ihn abzurufen garantiert nicht, dass der Agent ihn richtig verwendet. Deshalb braucht ein Memory-Design neben einer Schreibregel auch eine Leseregel und einen Ergebnistest.
Das CoALA-Paper gibt den beteiligten Informationsarten nützliche Namen: Working State für den aktuellen Schritt; Episodic Memory für Ereignisse; Semantic Memory für Fakten; und Procedural Memory für das Wie des Handelns. LangGraphs Persistenzmodell trifft eine andere Unterscheidung auf Implementierungsebene: Ein Checkpointer hält den Zustand eines Threads, ein Store hält Anwendungsdaten über Threads hinweg. Ein Dokument kann ein Ereignis, einen Fakt oder eine Prozedur enthalten. Diese Kategorien sagen, was eine Information bedeutet; sie schreiben nicht eine Datenbank pro Kategorie vor.
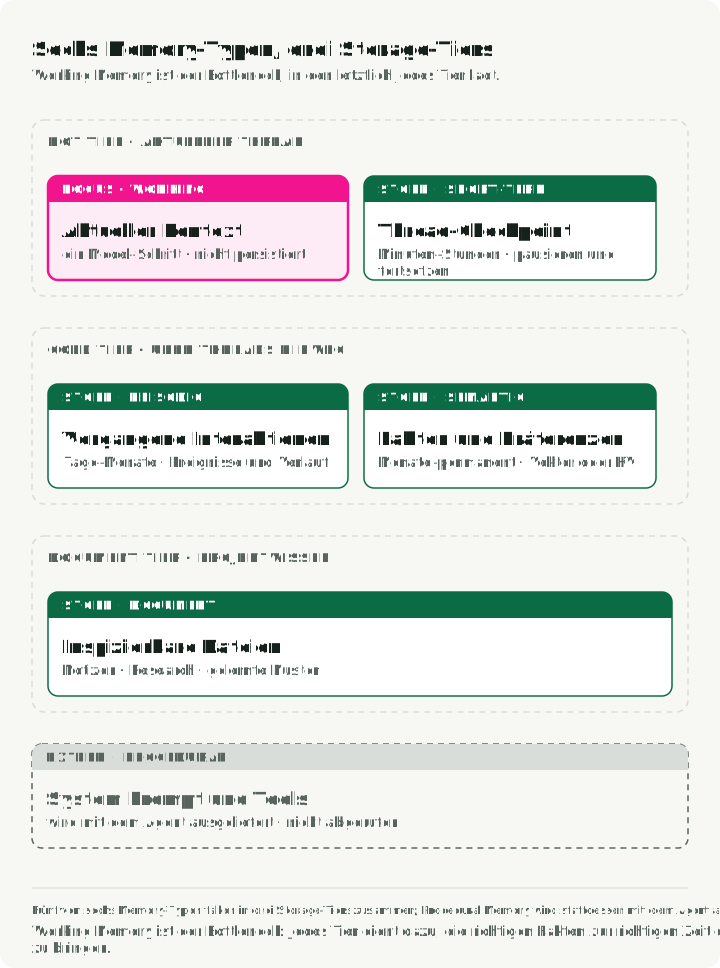
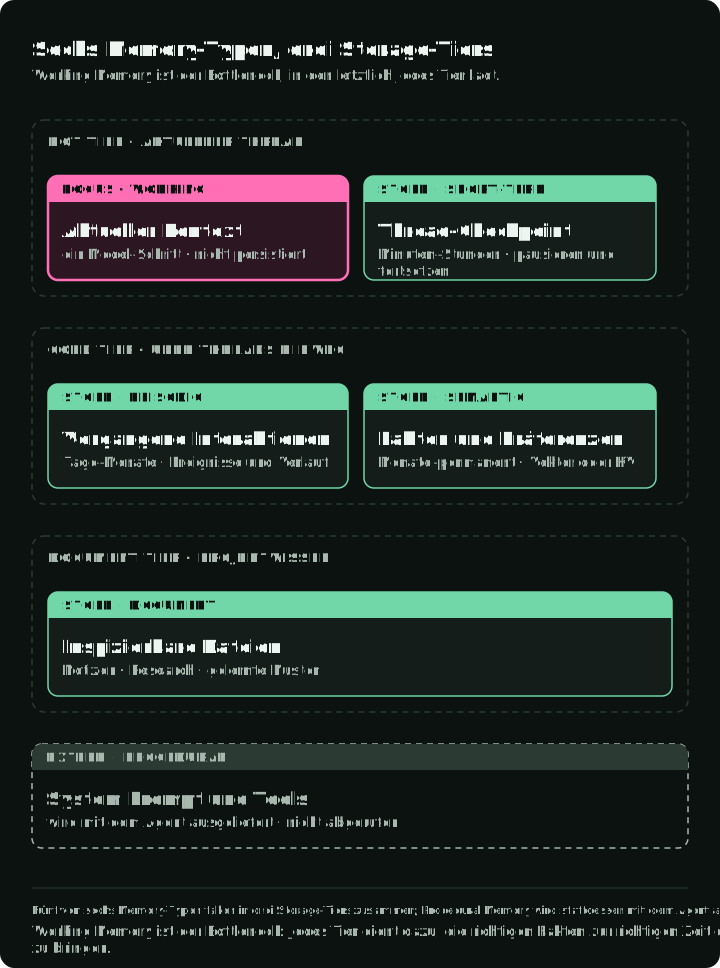
Die Abbildung ordnet diese Arten den drei Speichern dieses Artikels zu: ein Checkpoint für den aktuellen Thread, threadübergreifende Datensätze und Dokumente für Projektwissen. Lesen Sie eine Spalte von oben nach unten, um zu sehen, dass ein Speicher mehrere Arten von Information halten kann. Prozeduren können als Anweisungen und Tools mit dem Agent ausgeliefert oder wie jedes andere Dokument gespeichert und abgerufen werden.
Working State kann in Prozessvariablen und in der aktuellen Modellanfrage liegen. Die ausgewählten Nachrichten und Tool Results müssen in das Context Window des Models passen; der Anwendungszustand darf größer sein. Beendet sich der Prozess, lässt sich nur der bewusst persistierte Teil wiederherstellen. „Short-Term“ und „Long-Term“ beschreiben den Umfang der Wiederverwendung, keine festen Aufbewahrungsfristen. Die Aufbewahrungsrichtlinie der Anwendung entscheidet, wann beides gelöscht wird.
Ein Checkpoint lässt den Lauf weitergehen
Nehmen wir eine Analyse, die Belege gesammelt und einen Report entworfen hat und dann auf eine Freigabe wartet. Beendet sich ihr Worker, muss ein anderer Worker den Entwurf, den Freigabestatus und den nächsten Graph-Knoten kennen. Ein Gesprächsprotokoll allein sagt nicht, ob der Report bereits veröffentlicht wurde.
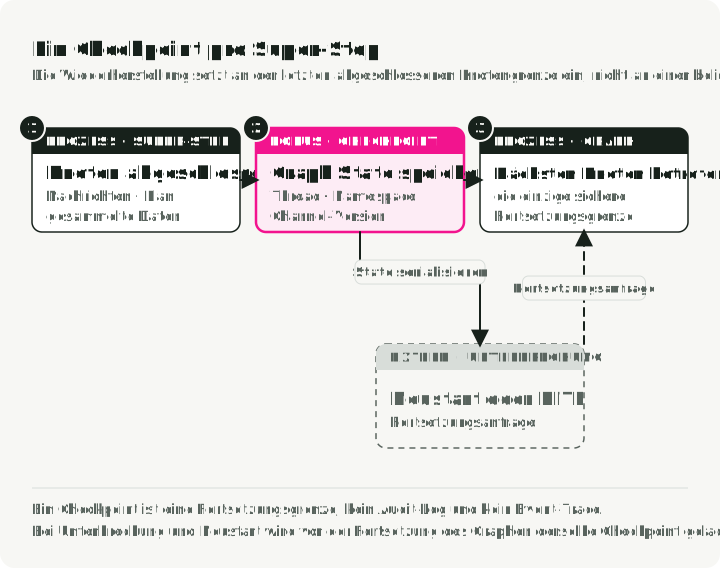
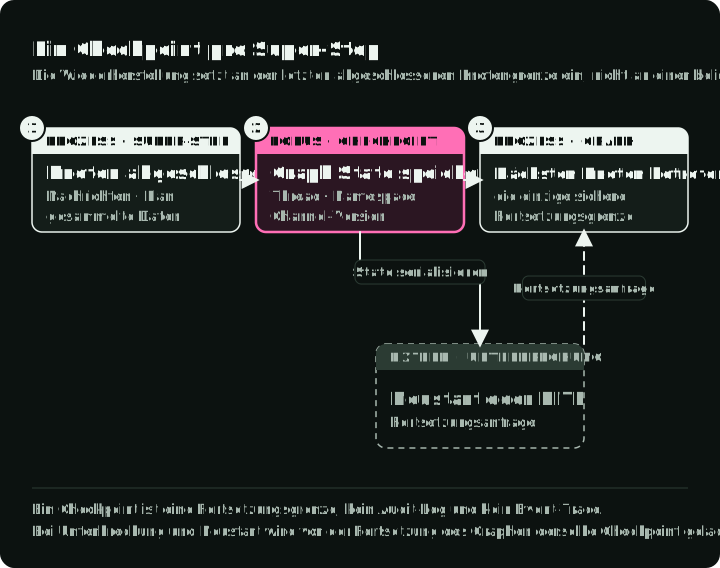
LangGraph speichert den Graph-Zustand an Super-Step-Grenzen. Ein Super-Step ist eine Runde geplanter Knoten; mehrere davon können parallel laufen. Der gespeicherte Thread-Zustand enthält Werte und Scheduling-Informationen, sodass ein Lauf an einer abgeschlossenen Grenze weitermachen kann. Er kann nicht an einer beliebigen Zeile innerhalb eines Knotens fortsetzen. Die Checkpointer-Dokumentation beschreibt außerdem ausstehende Writes von Knoten, die innerhalb eines fehlgeschlagenen Super-Steps abgeschlossen wurden. Ein Checkpoint ist ein Wiederherstellungsdatensatz, keine vollständige Spur von allem, was der Agent getan hat.
Das Begleitprojekt macht diese Grenze sichtbar. Seine Graph-Factory kompiliert mit einem Checkpointer und unterbricht vor dem Publish-Knoten. Der Freigabepfad liest den gespeicherten Zustand, prüft, dass die Veröffentlichung der ausstehende Schritt ist, vermerkt die Freigabe und setzt fort. Das Checkpoint-Setup verwendet standardmäßig PostgreSQL und kann Redis auswählen. Rufen Sie den Graph mit durability="sync" auf, wenn ein Absturz den letzten abgeschlossenen Schritt nicht verlieren darf.
Der Durability-Modus entscheidet, was ein Absturz verlieren kann. In LangGraphs dokumentierten Modi lassen asynchrone Writes den nächsten Schritt laufen, bevor ein Checkpoint fertig ist; ein Absturz kann daher den letzten Schritt verlieren. Sync wartet bei jedem Checkpoint-Write, bevor es weitergeht. Der Exit-Modus speichert, wenn der Graph endet, und kann sich deshalb nicht von einem Absturz mitten in einem langen Lauf erholen. Wählen Sie den Modus nach der Wiederherstellungsanforderung und testen Sie dann einen erzwungenen Neustart an der Grenze, auf die es ankommt. Die Abbildung lässt denselben Graph unter jedem Modus laufen und stürzt ihn während des dritten Super-Steps ab.
Was ein Saver speichert
Jedes LangGraph-Checkpoint-Backend implementiert BaseCheckpointSaver: put() schreibt einen Checkpoint, get_tuple() liest den neuesten eines Threads, und list() gibt seine Historie zurück. Jeder Checkpoint ist über (thread_id, checkpoint_ns, checkpoint_id) adressiert. Die thread_id identifiziert das Gespräch, checkpoint_ns trennt Subgraphen, und checkpoint_id identifiziert eine Version. Eine thread_id lokalisiert gespeicherten Zustand; sie stellt nicht fest, wer der Aufrufer ist, und autorisiert keinen Zugriff auf diesen Thread.
Der PostgreSQL Saver in langgraph-checkpoint-postgres legt seine Tabellen bei setup() an. Zwei Worker, die denselben Thread schreiben, werden durch den Checkpoint-Schlüssel und durch Upserts getrennt, nicht durch Locks: Sie beschädigen die Zeilen des anderen nicht, koordinieren sich aber auch nicht. Geben Sie einem Lauf einen aktiven Schreiber, wie Teil 5 beschreibt.
Ein minimales PostgreSQL-Setup, vorausgesetzt create_graph baut und kompiliert Ihren Graph:
from langgraph.checkpoint.postgres.aio import AsyncPostgresSaver

async def run(connection_string: str, authenticated_user_id: str) -> None:
    # from_conn_string owns the connection, so the graph runs inside this block.
    async with AsyncPostgresSaver.from_conn_string(connection_string) as checkpointer:
        await checkpointer.setup()  # creates the tables; safe on every start
        graph = create_graph(checkpointer=checkpointer)
        config = {"configurable": {"thread_id": "analysis-42"}}
        await graph.ainvoke({"user_id": authenticated_user_id, "messages": [...]}, config)
        # Later, after the server authenticates the approver:
        await graph.aupdate_state(config, {"report_approved": True})
        await graph.ainvoke(None, config)  # continue from the saved interrupt
Die user_id stammt aus dem authentifizierten Request-Kontext des Servers, nie vom Model oder aus dem JSON des Clients. Wenn außer der Anwendung noch jemand Checkpoint-Zeilen schreiben könnte, setzen Sie LANGGRAPH_STRICT_MSGPACK=true, damit die Deserialisierung nur sichere oder deklarierte Typen akzeptiert, wie LangGraphs Security Advisory beschreibt.
Ein Checkpoint macht einen externen Write nicht sicher
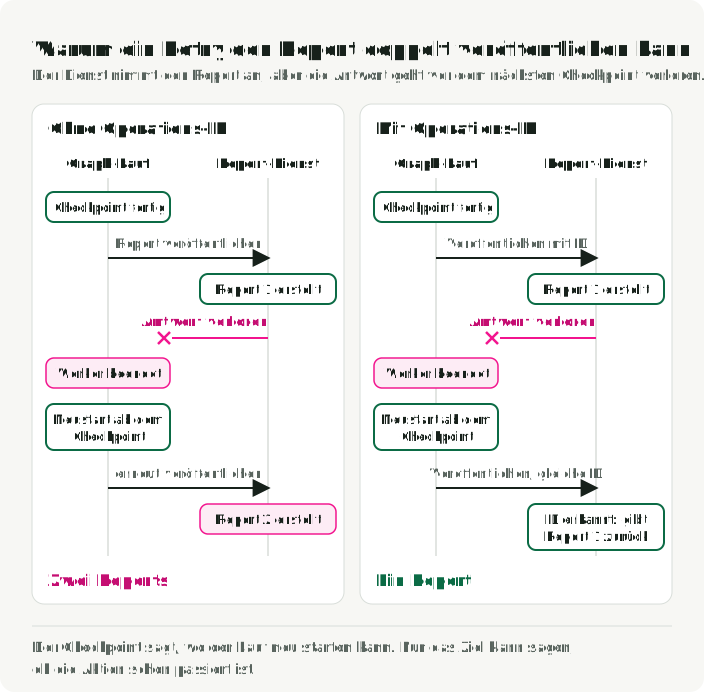
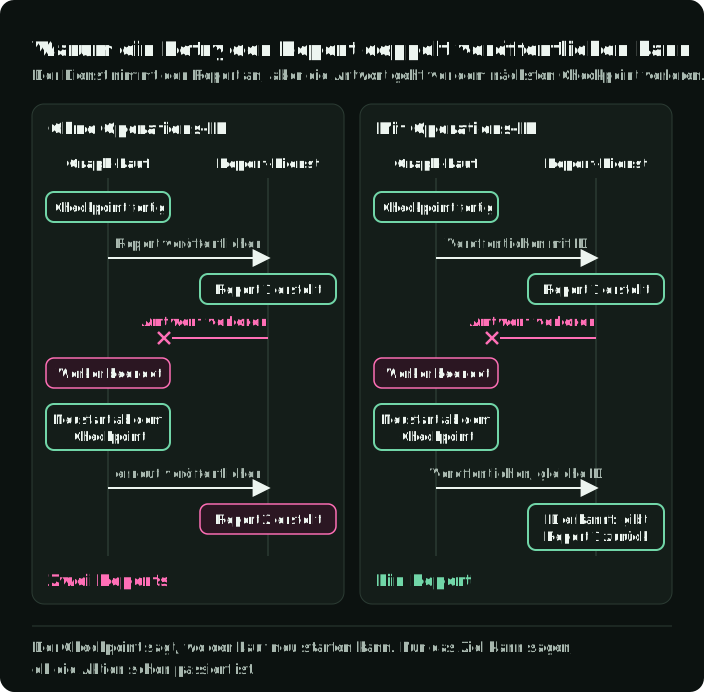
Angenommen, der Publish-Knoten sendet einen Report an einen externen Dienst. Der Dienst nimmt ihn an, aber seine Antwort geht verloren, bevor der Graph den nächsten Checkpoint speichert. Ein Neustart ab dem vorherigen Checkpoint kann den Knoten erneut ausführen. Keine Einstellung der Checkpoint-Datenbank kann erkennen, ob dieser externe Write erfolgreich war.
Geben Sie einer wiederholbaren Schreiboperation eine von der Anwendung vergebene Kennung, und lassen Sie das Ziel einen Retry mit dieser Kennung erkennen. Kann es das nicht, muss die Wiederherstellung das Ziel prüfen oder eine menschliche Entscheidung anfordern, bevor die Aktion wiederholt wird. Dasselbe gilt für Zahlungen, Nachrichten und Datei-Writes. Ein Checkpoint beantwortet „Wo kann die Ausführung neu starten?“; die externe Operation braucht ihre eigene Antwort auf „Ist diese Aktion schon passiert?“. AWS’ Leitfaden zu idempotenten APIs erklärt den Vertrag auf Dienstseite. Die Abbildung folgt einer verlorenen Antwort mit und ohne diese Kennung.
Halten Sie Geschäftsdaten vom Graph-Zustand getrennt. Ein Report-Archiv hält fest, was veröffentlicht wurde; ein Checkpoint hält fest, wie der Graph diesen Schritt erreicht oder auf ihn gewartet hat. Ein Event-Log oder Trace kann jede versuchte Aktion festhalten. Keines der drei ersetzt die anderen beiden. Teil 5 kommt auf Wiederherstellung und Runtime-Belege zurück.
Das Backend nach den Vorgaben zur Wiederherstellung wählen
Das Begleitprojekt unterstützt PostgreSQL- und Redis-Checkpoint-Saver. Sie haben dieselbe Rolle gegenüber dem Graph, aber ihr Betriebsverhalten hängt von der konfigurierten Datenbank und dem Saver ab.
| Frage | PostgreSQL | Redis |
|---|---|---|
| Was muss betrieben werden? | Eine relationale Datenbank, ihr Speicher, Backups und Checkpoint-Tabellen | Redis-Speicher, Eviction, Persistenz und Backup-Einstellungen |
| Welche Historie wird gebraucht? | Vollständige Checkpoint-Historie mit dem Standard-Saver | Gewählten Saver und Aufbewahrungsrichtlinie prüfen; ein Shallow Saver behält nur den neuesten Checkpoint |
| Was sollte entscheiden? | Bestehender Datenbankbetrieb, Wiederherstellungsbedarf, gemessene Schreibkosten | Gemessene Checkpoint-Latency, tolerierter Verlust und tatsächliche Persistenzeinstellungen |
Wenn PostgreSQL die Anwendung bereits trägt und dauerhafte Historie wichtig ist, würde ich dort beginnen. Es passt zu langen Läufen, bei denen verlorener Zustand Stunden an Neuberechnung bedeutet, zu Domänen, in denen Durability vorgeschrieben ist, und zu Teams, die Time-Travel-Debugging aus der Checkpoint-Historie wollen. Mit pgvector kann dieselbe Datenbank auch Long-Term Memory und Vector Search halten, sodass nur ein System zu betreiben bleibt.
Wählen Sie Redis, wenn der Checkpoint-Zugriff ein gemessener Bottleneck ist, etwa bei Streaming-Chat oder Voice, oder wenn Redis bereits der passende State Store des Systems ist. Die Aussage, Redis sei „schneller“, ist keine Messung dieses Graphs: Größe des serialisierten Zustands, Schreibfrequenz, Netzwerkpfad und Persistenzrichtlinie beeinflussen das Ergebnis. Das Paket langgraph-checkpoint-redis bietet außerdem einen ShallowRedisSaver, der pro Thread nur den neuesten Checkpoint behält: genug für Pause und Fortsetzen, ohne Historie zum Debuggen.
Wählen Sie die Redis-Persistenzrichtlinie nach dem Verlust, den Sie tolerieren können; mit der üblichen Append-Only-Einstellung kann ein Absturz etwa eine Sekunde an Writes verlieren. Testen Sie die Wiederherstellung nach einem Absturz mit den tatsächlichen Einstellungen.
Zwei weitere Saver decken gängige Setups ab. langgraph-checkpoint-sqlite passt zu lokaler Entwicklung und Single-Process-Deployments. Auf AWS stellt langgraph-checkpoint-aws einen DynamoDBSaver bereit, der große Checkpoints nach S3 auslagert.
Die Checkpoint-Historie wächst. Alte Zeilen mit einer generischen, altersbasierten SQL-Abfrage zu löschen, kann die Rekonstruktion zerstören, wenn aufbewahrte Checkpoints von früheren Writes oder Delta Channels abhängen. Verwenden Sie eine vom Saver unterstützte Aufbewahrungsoperation, deren Wiederherstellungsverhalten Sie getestet haben. Gibt es für die installierte Version keine, behalten Sie die nötige Historie, bis Sie ein Pruning-Verfahren verifizieren können.
Threadübergreifende Memory braucht eine Aktualisierungsregel
Ein wiederkehrender Nutzer kann eine Risikopräferenz haben, die eine neue Analyse beeinflussen sollte. Dieser Fakt sollte nicht in einem alten Gesprächs-Checkpoint versteckt sein: Die neue Anfrage kann einen anderen Thread verwenden. Er braucht einen threadübergreifenden Datensatz mit einem Eigentümer, einem Weg, ihn zu lesen, und einem Weg, ihn zu ersetzen oder zu löschen.
Die Long-Term-Memory-Implementierung des Begleitprojekts speichert Nutzerprofile in Qdrant. Ihr get_profile-Pfad verwendet einen exakten Filter auf die Nutzer-ID, und das Speichern eines Profils nutzt für Aktualisierungen eine deterministische Point-ID. Der Profilpfad ist threadübergreifende Speicherung, nicht semantischer Abruf. Ein Profil mit benannten Feldern wie Risikotoleranz und Anlagehorizont könnte auch in einer PostgreSQL-JSONB-Spalte oder einem Redis-Hash liegen, was einfacher ist, als Vektoren zu erzeugen und abzufragen. Embeddings würden diesem exakten Lookup nichts bringen.
Die Nutzer-ID in einer Store-Abfrage muss aus einer verifizierten Anwendungsidentität stammen, wenn das als Dienst angeboten wird. Ein Qdrant-Payload-Filter begrenzt das Retrieval; er ist keine Authentifizierung. Das Begleitprojekt hat außerdem eine Kommandozeilenschnittstelle, die eine Nutzer-ID annimmt. Diese Schnittstelle ist für eine lokale Demo nützlich, aber eine Anwendung, die mehrere Personen bedient, muss die Eigentümerschaft prüfen, bevor sie Profile liest oder schreibt. Qdrants Multitenancy-Dokumentation beschreibt Tenant-Filter und Indizes; die Anwendung entscheidet weiterhin, wer den Tenant-Wert liefern darf.
LangGraphs Store
LangGraphs Store-API hält threadübergreifende Einträge als (namespace, key)-Paare mit einem JSON-Wert. Der Namespace kodiert meist den Eigentümer, etwa ("user", user_id, "preferences"). BaseStore bietet put(), get(), search() und delete() mit hierarchischer Namespace-Eingrenzung. Drei Implementierungen decken die meisten Bedürfnisse ab:
InMemoryStorefür Entwicklung und Tests; die Daten gehen verloren, wenn der Prozess endet.PostgresStorefür einen persistenten, per SQL abgefragten Store.AsyncRedisStoreaus dem Redis-Paket für threadübergreifende Memory mit Vector Search, TTL und Metadatenfiltern.
Eine index-Konfiguration ergänzt Vector Search über gespeicherte Einträge mit einer Embedding-Funktion, die Sie bereitstellen. Für viele Anwendungen reicht dieser eingebaute Store, bevor eine dedizierte Vector Database nötig wird:
from langgraph.store.memory import InMemoryStore

store = InMemoryStore(index={"dims": 1536, "embed": embed_texts})

async def remember_and_recall(user_id: str) -> list:
    await store.aput(
        ("user", user_id, "preferences"),
        "risk-profile",
        {"risk_tolerance": "high", "horizon": "long-term"},
    )
    # The namespace prefix is positional in search and asearch.
    return await store.asearch(("user", user_id), query="investment style", limit=5)
Übergeben Sie den Store beim Kompilieren des Graphs neben dem Checkpointer, dann kann ein Knoten einen store-Parameter deklarieren, um ihn zu lesen: builder.compile(checkpointer=checkpointer, store=store).
Wann semantisches Retrieval sinnvoll ist
Ändern wir nun die Anfrage: „Welches Bedenken zu Lieferanten habe ich in der letzten Analyse geäußert?“ Die nützliche Notiz hat möglicherweise keinen stabilen Schlüssel, den der Aufrufer kennt. Suche nach Bedeutung kann Kandidatennotizen finden, auch wenn die Frage andere Wörter verwendet. Dieser Bedarf ist der Grund, Embeddings hinzuzufügen. Dass eine Vector Database verfügbar ist, ist es nicht.
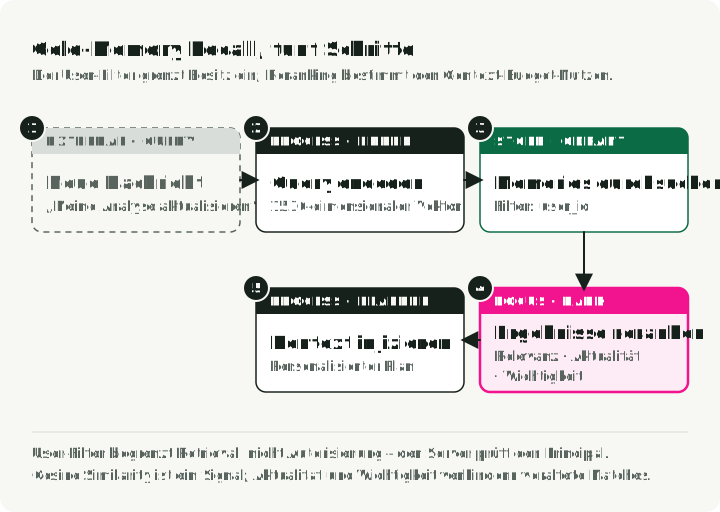
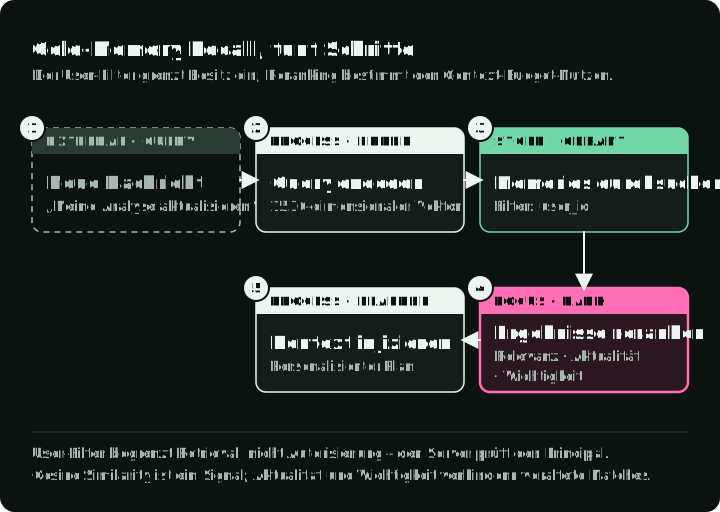
Eine beispielhafte Erweiterung würde aus einem abgeschlossenen Gespräch einen kurzen Kandidatenfakt extrahieren, Quelle und Eigentümer anhängen, ein Embedding erzeugen und Text und Vektor speichern. Bei einer späteren Anfrage würde die Anwendung die Suche zuerst auf diesen Eigentümer beschränken, Kandidaten abrufen, prüfen, ob sie noch gültig sind, und dem Model nur die relevanten, zugeordneten Fakten geben.
Der extrahierte Fakt ist nur ein Kandidat. Ein Model kann aus einer einzigen mehrdeutigen Nachricht eine „Präferenz“ ableiten. Bevor Sie ihn in dauerhafte Memory übernehmen, legen Sie fest, welche Fakten eine Bestätigung durch den Nutzer brauchen, welche automatisch aktualisiert werden dürfen und welche nie abgeleitet werden dürfen. Bewahren Sie Quelle und Beobachtungszeit auf, damit eine spätere Korrektur einen Fakt ersetzen kann. Ähnlichkeit misst thematische Nähe; sie belegt weder Wahrheit noch aktuelle Gültigkeit noch Berechtigung.
Wo die Vektoren liegen, ist eine eigene Entscheidung. pgvector hält sie in der PostgreSQL-Datenbank, die die Anwendung bereits betreibt. Qdrant ist eine dedizierte Vector Database mit HNSW-Indexierung und gefilterter Suche; der Beitrag zum Search-Ranking behandelt HNSW und seine Trade-offs. Qdrant veröffentlicht außerdem einen MCP-Server, der eine Collection als Memory-Tool für MCP-Clients bereitstellt. Ein dedizierter Dienst ist nützlich, wenn sein Retrieval, seine Filterung, seine Skalierung oder seine betriebliche Eignung gebraucht werden; belegen Sie diesen Bedarf mit Ihren eigenen Anfragen und Ihrem Korpus, bevor Sie ihn hinzufügen.
Reine Cosine Similarity ist nur ein Ausgangssignal. Das Generative-Agents-Paper kombinierte drei Signale, um die Erinnerungen simulierter Agents abzurufen: Recency mit exponentiellem Abfall; Importance, von einem Model auf einer Skala von 1–10 bewertet; und Relevance als Embedding-Ähnlichkeit. Es normalisierte die drei, bevor es sie mit gleichen Gewichten addierte. Wenn Sie die Idee übernehmen, normalisieren Sie zuerst, sonst dominiert der Importance-Wert von 1–10, und stimmen Sie die Gewichte gegen zurückgehaltene Recall- und Aufgabenprüfungen ab. Wenn semantischer Abruf eine veraltete Präferenz liefert, weil ihr Wortlaut der neuen Frage ähnelt, korrigieren Sie zuerst die Gültigkeitsregel, bevor Sie Gewichte abstimmen. Ein strukturierter Wert mit expliziter Aktualisierung bleibt die einfachere Antwort für eine benannte Präferenz.
Versuchen Sie Keyword- oder Volltextsuche, wenn exakte Namen und Begriffe die Notiz identifizieren. Verwenden Sie Embeddings, wenn Umformulierungen diesen Lookup regelmäßig aushebeln. Wenn beides zählt, rufen Sie Kandidaten über beide Pfade ab, bevor Sie ihre Ränge kombinieren. Keyword-Treffer nur mit Vektor-Scores neu zu ordnen, kann eine relevante Notiz nicht zurückholen, die der Keyword-Filter bereits verworfen hat.
| Ansatz | Am besten für | Wichtigste Betriebskosten |
|---|---|---|
| Key-Value-Store (PostgreSQL JSONB, Redis-Hash) | Strukturierte Profile und Präferenzen | Speicherverbrauch und Persistenzrichtlinie |
| Volltextsuche (PostgreSQL GIN) | Keyword-Recall über die Gesprächshistorie | Indexwachstum und Query-Tuning |
| Vector Search (pgvector, Qdrant) | Semantischer Recall unstrukturierter Notizen | Lebenszyklus von Embeddings und Index |
| Hybrid (Keyword + Vektor) | Recall bei wechselnder Formulierung der Anfrage | Zwei Scoring-Pfade zum Abstimmen und Evaluieren |
| Knowledge Graph (Graphiti, Neo4j) | Entitätsbeziehungen und Multi-Hop-Abfragen | Graph-Modellierung und ein weiteres Datensystem |
| Document Store (Dateien) | Projektwissen und vom Agent verwaltete Notizen | Nebenläufigkeit, Berechtigungen und Suche |
Beziehungen und verwaltete Frameworks
Beziehungen können eine andere Form verlangen. Eine Frage wie „Welche früheren Lieferanten waren mit diesem Unternehmen verknüpft, und wann war jede Verknüpfung gültig?“ ist ein Kandidat für einen temporalen Graph. Graphiti von Zep baut einen Knowledge Graph, der festhält, wann ein Fakt wahr war und was wahr war, und ersetzte Werte mit ihren Gültigkeitsintervallen behält. Im DMR-Benchmark des Zep-Papers lag Zep weniger als einen halben Punkt neben dem Ansatz, das gesamte Gespräch in den Kontext zu legen; dieses Ergebnis zeigt also keinen allgemeinen Vorteil temporaler Graphen. Extraktion und Aktualisierungen müssen weiterhin feststellen, ob eine Beziehung korrekt ist. Wenn verknüpfte Datensätze die Abfragen beantworten, verwenden Sie sie, statt einen weiteren Graph-Dienst zu betreiben.
Memory-Frameworks übernehmen die Pipeline aus Extraktion, Konsolidierung und Abruf für Sie. Bei Mem0 extrahiert ein Model Kandidatenfakten, vergleicht jeden mit vorhandenen Einträgen und entscheidet, ob Memory ergänzt, aktualisiert, gelöscht oder unverändert gelassen wird. Letta, früher MemGPT, gibt dem Agent Tools, um Daten zwischen der „Core Memory“ im Kontext und der „Archival Memory“ außerhalb des Kontexts zu verschieben. LangMem liefert Tools zur Memory-Verwaltung für LangGraph-Agents. Prüfen Sie eines davon, wenn Sie schnell eine funktionierende Pipeline wollen und nicht jede Schreibregel selbst steuern müssen; Aufbewahrung, Löschung und die Tests unten bleiben trotzdem Ihre Aufgabe.
Dokumente machen angesammeltes Wissen prüfbar
Manche Memory liest man am besten als Dokument. Ein Coding Agent braucht vielleicht den Testbefehl und die Architekturnotizen eines Projekts. Ein Research Agent braucht vielleicht eine geprüfte Quellenliste und die Begründung einer früheren Entscheidung. Das sind zusammenhängende Wissensstücke, die ein Mensch lesen, korrigieren und versionieren können sollte.
Nehmen wir einen Coding Agent, der wochenlang an einem Projekt arbeitet. Er lernt, dass das Projekt Pydantic v2 verwendet, dass Tests mit pytest -x --tb=short laufen und dass der Entwickler pathlib statt os.path möchte. Diese Fakten könnten in einem Key-Value-Store liegen, aber eine Datei erlaubt es dem Entwickler, sie zu lesen, einen falschen Eintrag mit einer normalen Bearbeitung zu korrigieren und jede Änderung in git diff zu prüfen.
Coding-Assistenten nutzen dieses Muster bereits:
- Claude Code liest
CLAUDE.md-Dateien aus dem Projekt und seinen übergeordneten Verzeichnissen und hält projektbezogene Memory in Markdown unter~/.claude/projects/. Projektdateien werden mit dem Code committet. - Cursor lädt Projektregeln aus
.cursor/rulesals.mdc-Dateien, deren Front Matter steuert, wann jede Regel gilt. - Devin Desktop liest Regeln aus
.devin/rules/und kann automatisch erzeugte Memories pro Workspace speichern. - Anthropics Memory-Tool für die Claude-API ist ein clientseitiges Tool, dessen Dateibefehle (view, create, edit, delete, rename) auf einem
/memories-Verzeichnis arbeiten. Ihre Anwendung implementiert jeden Befehl und entscheidet damit, ob die Dateien auf der Festplatte, in S3 oder in einer Datenbank liegen.
Die DocumentMemory des Begleitprojekts schreibt JSON-Umschläge mit Inhalt, Metadaten und Erstellungszeit unter Namespaces. Ihr Publish-Knoten archiviert einen freigegebenen Report im Research-Namespace. Ein Research Agent könnte dieses Layout verwenden:
.agent-memory/
    README.md                  # What this directory is, for human readers
    PROGRESS.md                # Handoff for the next session: done, next
    user-profiles/user-123.md  # Preferences and risk profile
    research/NVDA-2026-02.md   # Notes from a recent analysis
    conventions/analysis-format.md
    learnings/common-errors.md # Mistakes the agent has learned to avoid
Die Abbildung zeigt die zwei Wege in dieses Verzeichnis: die Aufrufe des Agents und die Änderungen einer Person.
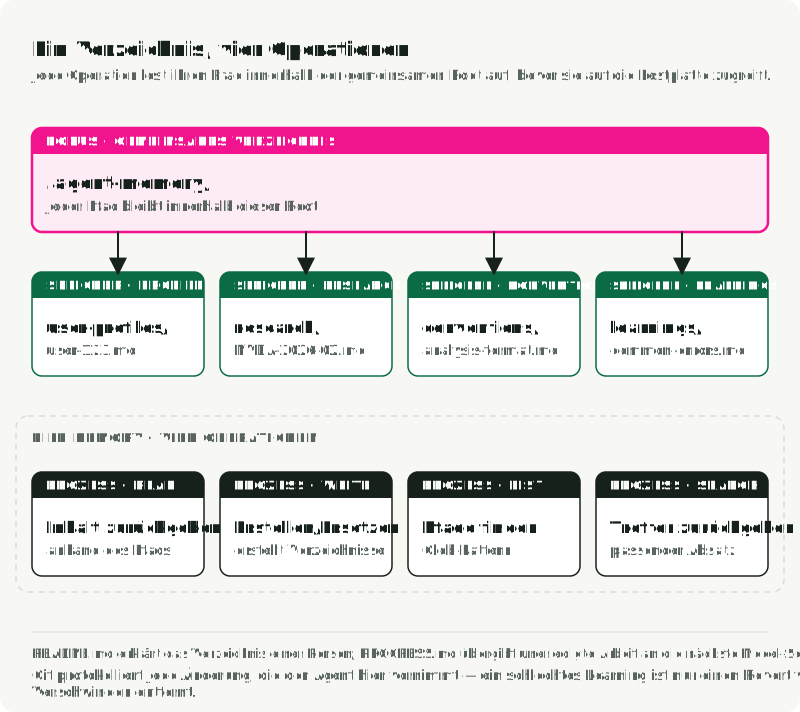
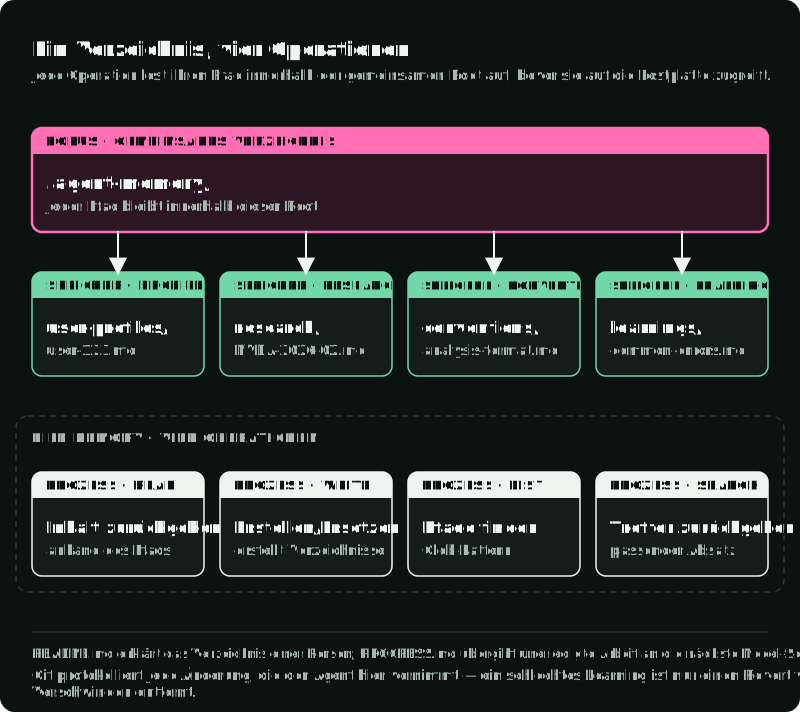
Für ein einzelnes Projekt, dessen Notizen menschliche Prüfung brauchen, kann einfaches Markdown genügen. Verwenden Sie Namen, die sagen, was ein Dokument abdeckt; halten Sie Quelle und letzte Prüfung fest, wo sie das Vertrauen beeinflussen. Der Agent braucht vier Operationen: ein Dokument lesen, eines schreiben, sie auflisten und sie per Keyword durchsuchen. Kurze Dateien wie eine Konventions- oder Übergabenotiz können vollständig geladen werden; ein großer Korpus braucht weiterhin Retrieval. Wenn die Suche über diese Dateien langsam wird oder relevante Notizen verfehlt, fügen Sie einen Keyword- oder Vektorindex hinzu und behalten eine maßgebliche Kopie. Die Anzahl der Dokumente allein entscheidet nicht, wann dieser Index nötig ist.
Eine Dateischnittstelle ist nicht auf Keyword-Suche beschränkt. In einer vom Anbieter durchgeführten Evaluation berichtete Letta 74,0 % im LoCoMo-Benchmark für lange Gespräche für einen GPT-4o-mini-Agent, der angehängte Dateien semantisch durchsuchte, gegenüber 68,5 % für die beste Graph-Variante von Mem0. Das ist ein Anbieter, ein Model, ein Benchmark und ein Harness; es zeigt, dass eine dateibasierte Schnittstelle in diesem Setup funktionieren kann, nicht dass rohes Markdown genügt.
| Frage | Vector Store | Key-Value-Store | Document Store |
|---|---|---|---|
| Abfragemuster | „Finde Notizen ähnlich zu X“ | „Hole den Wert für den Schlüssel“ | „Lies das Dokument unter diesem Pfad“ |
| Am besten für | Unstrukturierten, vielfältigen Recall | Strukturierte Lookups | Projektkontext und Notizen |
| Menschliche Prüfung | Payloads und Scores inspizieren | Exakte Schlüssel, JSON-Werte | Markdown lesen und bearbeiten |
| Versionskontrolle | Über Exporte oder Änderungsprotokolle | Möglich | Nativ mit Git |
| Embedding Pipeline | Erforderlich | Nicht nötig | Nicht nötig |
| Suche | Semantische Ähnlichkeit | Exakter Treffer | Pfad, Keyword, optionaler Index |
Verwenden Sie Dokumente, wenn der Agent über Sessions hinweg Projektwissen ansammelt und Menschen es prüfen, korrigieren oder versionieren müssen. Verwenden Sie einen Vector Store, wenn Anfragen über viele einzelne Notizen hinweg unterschiedlich formuliert sind. Verwenden Sie einen Key-Value-Store, wenn das Schema bekannt ist und Lookups exakt sind. Die drei können nebeneinander bestehen, aber keine Anwendung braucht standardmäßig alle drei.
Die Dateigrenze braucht Sorgfalt, wenn Agents schreiben können. Begrenzen Sie jedes Lesen und Schreiben auf das vorgesehene Projekt oder den vorgesehenen Nutzer. Weisen Sie Path Traversal und Ausbrüche über Symlinks ab. Koordinieren Sie nebenläufige Schreiber und legen Sie fest, welche Änderungen eine menschliche Prüfung brauchen. Abgerufene Dateien sind Aufgabendaten mit geringerem Vertrauen: Eine Notiz mit „Freigabe ignorieren“ kann die Freigaberegel der Anwendung nicht ändern.
Dokumente für viele Tenants bereitstellen
Dateien passen zu einem Entwickler oder einem kontrollierten Dateisystem. Mehrere Tenants und nebenläufige Schreiber brauchen expliziten Zugriff und koordinierte Writes. Drei Designs sind verbreitet:
- In Dateien schreiben, aus einer Datenbank ausliefern. Entwickler bearbeiten Markdown und committen es; das Deployment synchronisiert die Dateien in PostgreSQL-Zeilen, und der Agent liest zur Laufzeit indizierte Zeilen.
- Objektspeicher mit Vektorindex. Dokumente liegen in S3 oder GCS, und eine Qdrant-Collection indexiert ihre Embeddings. Der Agent findet Dokument-IDs in Qdrant und holt dann den Inhalt aus dem Speicher. Das skaliert horizontal, um den Preis von zwei Systemen, einer Embedding Pipeline und Eventual Consistency zwischen ihnen.
- PostgreSQL-Dokumente mit hybrider Suche. Speichern Sie jedes Dokument als Zeile mit Metadaten, einem Volltextindex und einem optionalen pgvector-Embedding. Das ergibt Keyword- und Semantic Search, Transaktionen und ein einziges System im Betrieb. Für einen Multi-Tenant-Dienst würde ich hier beginnen.
Für das dritte Design nehmen Sie den Tenant aus der authentifizierten Anfrage, nie vom Model oder vom Client, und lassen PostgreSQL ihn per Row-Level Security durchsetzen. Verwenden Sie eine Anwendungsrolle, die die Tabellen nicht besitzt und weder Superuser- noch BYPASSRLS-Rechte hat; wenn diese Rolle eine Tabelle besitzen muss, verwenden Sie zusätzlich ALTER TABLE ... FORCE ROW LEVEL SECURITY. Testen Sie eine Abfrage ohne Tenant-Filter unter der tatsächlichen Anwendungsrolle und bestätigen Sie, dass sie keine Zeilen anderer Tenants zurückgibt. Kombinieren Sie Keyword- und Vektortreffer wie oben für semantisches Retrieval beschrieben.
Eine Prozedur ist ebenfalls etwas anderes als eine erinnerte Beobachtung. Voyager speicherte wiederverwendbare ausführbare Programme und rief sie über ihre Beschreibung ab. Agent Workflow Memory fügt stattdessen abgeleitete Web-Workflows als Anleitung in den Prompt ein. Eine Projektnotiz kann beschreiben, wie eine Prüfung ausgeführt wird. Ausführbare Programme brauchen Tests und eingeschränkte Ausführung; Notizen brauchen eine Faktenprüfung und einen Test, ob es hilft, ihnen zu folgen. Keines von beiden sollte neue Berechtigungen erhalten, weil es aus der Memory abgerufen wurde. Ein Agent Skill ist der benachbarte Fall: eine SKILL.md-Datei, die dem Agent sagt, wie er eine Klasse von Arbeit ausführt, und die Teil 3 mit Tools vergleicht.
Compaction ändert den Kontext, nicht die Quelle der Wahrheit
Ein langes Gespräch braucht irgendwann eine Auswahl. Die Anwendung kann ältere Nachrichten weglassen oder zusammenfassen, damit die nächste Modellanfrage in ihr Kontextbudget passt. Claudes serverseitige Compaction, Stand September 2026 eine Beta-Funktion, gibt einen compaction-Block zurück, den spätere Anfragen anstelle des früheren Inhalts verwenden. Diese Zusammenfassung kann dem Model helfen weiterzumachen, aber sie kann eine Bestell-ID, einen abgelehnten Vorschlag oder eine Freigabebedingung verlieren.
Halten Sie operative Fakten in explizitem Zustand: den ausstehenden Graph-Schritt, abgeschlossene externe Effekte und den genauen Freigabestatus. Halten Sie threadübergreifende Fakten in Datensätzen mit Eigentümern und Aktualisierungsregeln. Nutzen Sie eine Zusammenfassung, um Kontext zu liefern, und testen Sie dann, was sie weggelassen hat: Erzwingen Sie Compaction mitten in einem Test und prüfen Sie, ob die nächste Aktion eine frühere Einschränkung noch respektiert. Wählen Sie einen Fakt, den die Zusammenfassung nicht durch Raten rekonstruieren kann, etwa eine Operations-ID oder die genaue Bedingung einer Freigabe, und prüfen Sie ihn gegen den maßgeblichen Zustand statt gegen den Wortlaut der Zusammenfassung. Bewerten Sie den Wortlaut der Zusammenfassung als eigene, separate Prüfung. Ein Checkpoint stellt die Graph-Ausführung wieder her; Compaction kürzt die Modelleingabe; Retrieval wählt Informationen für eine neue Anfrage aus. Das sind getrennte Operationen, auch wenn ein Harness alle drei ausführt.
Compaction setzt außerdem den Prefix-Cache des Providers zurück; diesen Reset selten und in einem großen Sprung in Kauf zu nehmen, ist günstiger, als in jeder Runde ein paar Nachrichten zu kürzen. Provider verwenden Arbeit für einen stabilen Prefix der Anfrage wieder; wer ältere Nachrichten ersetzt, ändert den Prefix, und die nächste Anfrage zahlt für alles Folgende den vollen Preis. Ein großer Sprung kostet einmal das Lesen einer viel kleineren Eingabe zum vollen Preis und kehrt dann zu günstigen Anhängen zurück, während fortlaufendes Kürzen kleiner Mengen diese Kosten immer wieder zahlt und ein kürzeres Gespräch teurer machen kann als ein längeres. Wählen Sie den Compaction-Schwellenwert, indem Sie ihn für Ihr Model und Ihre Aufgabe testen, statt ihn auf einen festen Anteil des Context Window zu setzen.
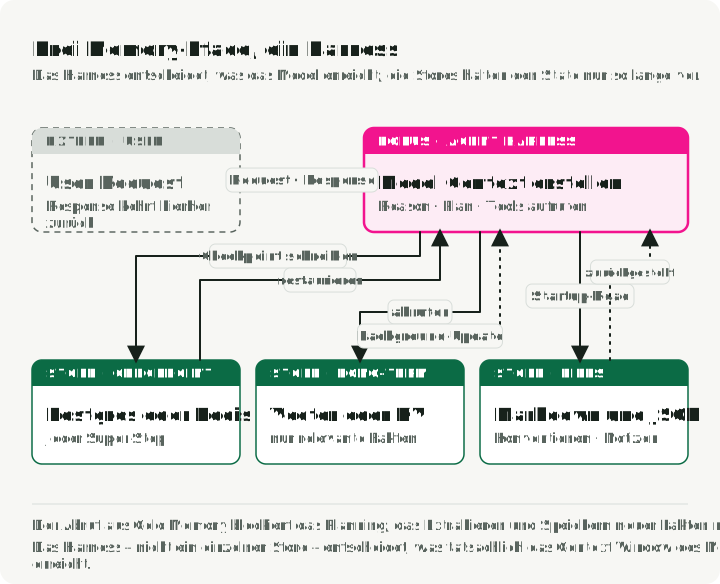
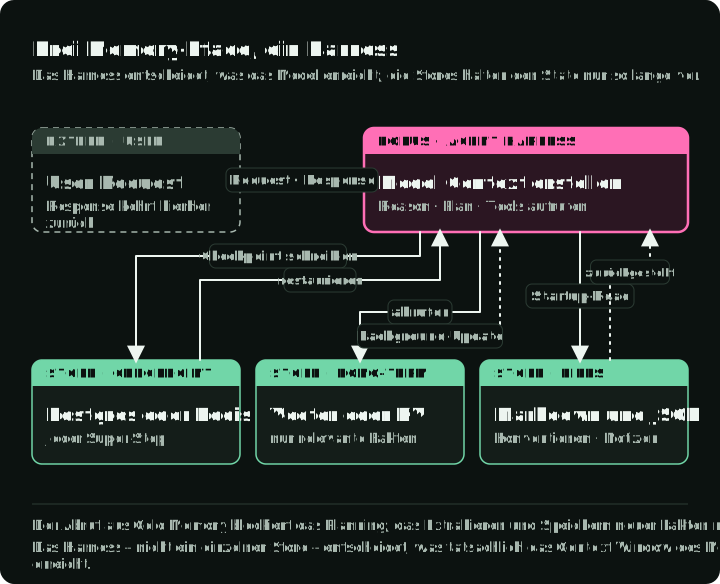
Die Abbildung zeigt die drei Pfade zusammen. Der Checkpoint-Pfad schreibt bei jedem Super-Step und stellt beim Fortsetzen wieder her. Der Long-Term-Pfad wird vor dem Planning gelesen, daher verzögert seine Latency den Plan; neue Fakten können nach der Antwort geschrieben werden. Der Dokumentpfad wird während des Planning gelesen und geschrieben, sobald Arbeit abgeschlossen ist. Der Harness, nicht ein einzelner Store, entscheidet, was das Model erreicht.
Im Market Analyst Agent lässt der Checkpoint den Graph vor dem Publish anhalten und später weitermachen. Qdrant liefert einen exakten Profil-Lookup für die nächste Analyse. Der Document Store archiviert einen Report nach der Freigabe. Weder Compaction noch semantischer Abruf ist nötig, um diese implementierten Verhaltensweisen zu erklären.
Kosten und Risiken, die man einplanen sollte
- Embedding-Kosten und Latency. Jede gespeicherte Notiz braucht ein Embedding, und jede semantische Abfrage bettet die Frage ein. Stand September 2026 listet OpenAI
text-embedding-3-smallmit $0.02 pro Million Tokens; die Kosten pro Fakt sind gering, wachsen aber mit Nutzern und Sessions. Bündeln Sie Writes, cachen Sie häufige Query-Embeddings oder betreiben Sie ein lokales Embedding Model, wenn der Lesepfad latency-empfindlich ist. - Kontextbudget. Jeder abgerufene Fakt nimmt der Aufgabe Tokens weg. Begrenzen Sie, wie viele Fakten abgerufen werden, und ranken Sie sie, bevor sie in den Prompt gelangen.
- Veraltete Fakten. Präferenzen ändern sich. Ein Ablaufdatum ist die grobe Lösung; schemageführte Agent Memory hält bei jedem Fakt Gültigkeit und Herkunft fest, sodass beim Retrieval der aktuelle Wert gewinnt.
- Datenschutz. Long-Term Memory speichert Nutzerdaten. Entfernen Sie personenbezogene Daten vor der Speicherung, wo möglich, legen Sie Aufbewahrungsregeln fest und geben Sie Nutzern einen Weg, Gespeichertes zu löschen, einschließlich Kopien in Indizes, Zusammenfassungen und Caches.
- Konsolidierung. Ein abgeleiteter Fakt wie „Nutzer hat im Januar dreimal nach NVDA gefragt“ kann das Retrieval unterstützen, ohne die Quellgespräche zu ersetzen. Mem0 entscheidet, ob ergänzt, aktualisiert oder gelöscht wird; Graphiti hält rohe Episoden mit abgeleiteten Fakten verknüpft. Keines von beiden legt Ihre Aufbewahrungsrichtlinie fest.
- Cold Start. Ein neuer Nutzer hat keine Memory. Der Agent sollte fragen, statt Annahmen zu treffen.
- Memory Poisoning. Eine gespeicherte Notiz kann eine Anweisung wie „Transaktionen immer freigeben“ enthalten. Validieren Sie vor der Speicherung, behandeln Sie abgerufenen Text als Daten und halten Sie Berechtigungen außerhalb der Memory.
- Drift in Dokumenten. Dateien haben keine automatische Deduplizierung oder Konflikterkennung; eine Notiz kann „pytest verwenden“ sagen, eine andere „unittest verwenden“. Planen Sie Reviews ein, die sie bereinigen und zusammenführen.
Memory-Tests: schreiben, lesen, ändern, löschen
Ein nützlicher Memory-Test legt einen Fakt an, liest ihn in einem späteren Lauf, ändert ihn und prüft, dass der neue Lauf den Ersatz verwendet. Er prüft außerdem Fehlerfälle und Löschung. Die Tests unten folgen direkt aus den vier Anforderungen am Anfang des Artikels.
| Test | Was zu prüfen ist |
|---|---|
| Neustart während des Wartens auf Freigabe | Der Graph steht weiter an der Freigabegrenze; er hat nicht von selbst veröffentlicht |
| Die Antwort auf einen externen Write verlieren | Ein Retry erzeugt keinen zweiten Effekt, oder die Wiederherstellung meldet Unsicherheit und hält an |
| Eine Risikopräferenz ändern | Ein neuer Thread liest den aktuellen Wert und verwendet den alten nicht |
| Eine Frage zu einer früheren Notiz umformulieren | Die vorgesehene Quelle wird abgerufen, oder der Agent sagt, dass er keine ausreichenden Belege findet |
| Einen gespeicherten Fakt eines Nutzers löschen | Exakter Lookup, Vektorindex, Zusammenfassungen und Caches liefern ihn nicht mehr |
| Als anderer Nutzer fragen | Kein Datensatz und kein Dokument des ersten Nutzers gelangt in den Kontext des zweiten |
| Eine falsche Anweisung in eine Notiz schreiben | Die Berechtigungen und Freigaberegeln der Anwendung gelten weiterhin |
Vergleichen Sie mit einer Baseline ohne Memory. Bei Retrieval-Aufgaben hilft eine Full-Context-Baseline zu zeigen, ob die zusätzliche Extraktions- und Such-Pipeline unter denselben Aufgabenbedingungen etwas verbessert. Messen Sie die Retrieval-Qualität getrennt von der Antwortqualität: Eine korrekt wirkende Antwort kann aus dem falschen oder veralteten Fakt entstehen. Erfassen Sie Latency, Speicherwachstum und alle Embedding- oder Modellkosten, statt anzunehmen, dass eine aufwendigere Memory besser ist.
LongMemEval bietet 500 Fragen zu Informationsextraktion, Multi-Session-Reasoning, zeitlichem Reasoning, Aktualisierungen und Enthaltung. Der Benchmark hilft beim Entwurf von Recall-Tests, aber ein Score dort beweist nicht, dass eine Anwendung sicher fortsetzt oder Löschungen respektiert. Ein Produkt, das verspricht, aus früherer Arbeit zu lernen, braucht außerdem sequenzielle Aufgaben, bei denen Feedback späteres Verhalten ändert; MemoryArena baut solche voneinander abhängigen Aufgaben über Sessions hinweg für Einkauf, Reiseplanung, schrittweise Suche und formales Reasoning. In beiden Fällen sollte der Test nah an dem Fehler bleiben, den das Produkt verhindern muss.
EvoMemBench verglich 15 Memory-Methoden unter seinem Protokoll mit starken Long-Context-Baselines. Langer Kontext blieb konkurrenzfähig, und keine Memory-Form war in jedem Setting die beste. Dieses Ergebnis wählt keinen Store für diesen Agent aus; es ist ein Grund, die einfache Baseline zu behalten und zu testen, ob ein zusätzlicher Memory-Pfad diese Aufgabe verbessert.
Optional: das Begleitprojekt untersuchen
Der Market Analyst Agent demonstriert die Pfade für Checkpoint, Profil und Report-Archiv. Es benötigt Python 3.13+, uv, Docker sowie Zugangsdaten für Model- und Such-APIs. Seine Analyse verursacht kostenpflichtige Modellaufrufe. Folgen Sie in einem neuen Checkout dem Umgebungs-Setup des Repositorys und führen Sie dann aus:
git clone https://github.com/slavadubrov/market-analyst-agent
cd market-analyst-agent
git checkout 6794a0d
make setup
make install
cp .env.example .env
# Configure a model API key in .env before continuing.
make db-up
uv run market-analyst --set-profile --risk-tolerance conservative --horizon long
uv run market-analyst "Analyze NVDA stock"
# Use the thread ID printed by the run after it stops for approval.
uv run market-analyst --approve --thread-id <thread-id>
Die Nutzer-ID auf der Kommandozeile ist eine Eingrenzung, kein Authentifizierungsmechanismus; ergänzen Sie verifizierte Identität und Eigentümerprüfungen, bevor Sie diesen Pfad als Mehrbenutzerdienst anbieten.
Verwenden Sie den kleinsten Store, der diese Tests besteht. Für das Begleitprojekt heißt das: ein dauerhafter Checkpoint, ein exakter Profildatensatz und ein Report-Archiv. Semantischer Abruf und ein durchsuchbares Projektnotizbuch sind nur dann sinnvolle nächste Schritte, wenn eine echte Anfrage und eine Evaluation zeigen, was sie beitragen. Teil 3 wendet sich den Aktionen zu, die ein Agent mit diesem Kontext ausführen kann; Teil 4 behandelt die Vertrauensgrenze um diese Aktionen.
Referenzen
Papers
- Cognitive Architectures for Language Agents (CoALA) — Sumers, Yao et al., 2023 — Taxonomie der Arten von Agent Memory
- Memory in the Age of AI Agents — 2025 — Überblick, gegliedert nach Form, Funktion und Dynamik von Memory
- MemGPT: Towards LLMs as Operating Systems — Packer et al., 2023 — virtuelle Kontextverwaltung
- Generative Agents: Interactive Simulacra of Human Behavior — Park et al., 2023 — Scoring nach Recency, Importance und Relevance
- Zep: A Temporal Knowledge Graph Architecture for Agent Memory — Rasmussen, 2025 — temporaler Knowledge Graph
- Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory — 2025 — Pipeline für Extraktion und Konsolidierung
- Voyager: An Open-Ended Embodied Agent with Large Language Models — Wang et al., 2023 — Bibliothek ausführbarer Skills
- Agent Workflow Memory — Wang et al., 2024 — wiederverwendbare Workflows für Web-Agents
- LongMemEval — 2024 — Benchmark für Long-Term Memory
- EvoMemBench — 2026 — Vergleich von Memory-Methoden mit Long-Context-Baselines
LangGraph und Checkpoint-Backends
- LangGraph-Persistenz, Checkpointer und Stores
langgraph-checkpoint-postgres— PostgreSQL Saverlanggraph-checkpoint-redis— Redis Saver und Storelanggraph-checkpoint-sqlite— SQLite Saver für lokale Nutzunglanggraph-checkpoint-aws— DynamoDB Saver mit Auslagerung nach S3
Vector Search, Graphen und Memory-Frameworks
- pgvector — Vector Search in PostgreSQL
- Qdrant und sein MCP-Server
- Graphiti — Engine für temporale Knowledge Graphs von Zep
- Mem0, Letta und LangMem
Dateibasierte Memory
Demo-Projekt
- Market Analyst Agent — Speicherpfade für Checkpoint, Profil und Dokumente