Harness Engineering für AI Agents: den Abschluss verifizieren

Automatische Übersetzung
Dieser Artikel wurde automatisch aus der englischen Originalversion übersetzt.
Ein Agent kann seinen Turn beenden, obwohl die Arbeit noch nicht abgeschlossen ist. Dieser Artikel richtet sich an Engineers, die Coding Agents entwickeln oder überprüfen und entscheiden müssen, wann sie ein Ergebnis akzeptieren, eine unsichere Operation wiederholen oder die Arbeit in einer anderen Session fortsetzen. Er zeigt außerdem, wie man misst, ob eine zusätzliche Harness-Komponente diese Ergebnisse so weit verbessert, dass sich ihre Kosten lohnen.
Das Harness ist der Anwendungscode rund um den Reasoning Loop des Models. Es liefert Context, prüft vorgeschlagene Actions, protokolliert, was passiert ist, und entscheidet, ob die Nachweise für einen Abschluss ausreichen. Die Runtime führt akzeptierte Actions aus und hält Session, Sandbox und Checkpoint verfügbar. Die früheren Artikel erklären den Reasoning Loop, Memory, Tools und Permissions. Hier geht es darum, was das Harness tut, nachdem das Model eine Action vorgeschlagen oder „fertig“ gesagt hat.
Die Store- und Payment-Beispiele unten sind fiktive Lehrfälle. Das begleitende Lab ist eine deterministische Simulation; es misst keinen laufenden Coding Agent.
Was als fertig gilt
Angenommen, ein Coding Agent soll in einem fiktiven Store-Repository den Schwellenwert für einen automatischen Rabatt von 10 % von $100 auf $75 senken. Er ändert src/checkout.py. Ein Warenkorb von $80 sollte nun einen Rabatt von $8 erhalten. Die Aufgabe hat zwei erforderliche Checks:
pytest tests/test_checkout.pyprüft die Berechnung.pnpm playwright test tests/checkout_discount.spec.tsprüft das sichtbare Checkout-Ergebnis in einem lokalen Store mit geseedeten Testdaten.
Eine plausible abschließende Antwort ist keiner dieser Checks. Das Harness sollte nur einen Candidate akzeptieren, dessen vollständiger getesteter Snapshot identifiziert ist und dessen zwei erforderliche Checks auf genau diesem Snapshot bestanden wurden. Ein sauberer Commit kann ihn identifizieren; andernfalls verwende einen Digest oder ein Manifest, das relevante untracked Files einschließt. Halte die Tests außerhalb des vom Agent beschreibbaren Scopes oder genehmige Änderungen an ihnen vor dem Grading unabhängig.
Hier haben Model, Harness und Runtime unterschiedliche Aufgaben. Implementierungen können mehrere davon in einem Prozess zusammenfassen, aber ihre Failure Boundaries bleiben unterschiedlich:
| Komponente | Aufgabe | Beispiel für einen Coding Agent |
|---|---|---|
| Model | Schlägt Text, einen Tool Call oder eine abschließende Antwort vor | Schlägt ein Edit an src/checkout.py vor |
| Reasoning Loop | Wählt den nächsten Schritt aus dem verfügbaren Context | Inspizieren, editieren, testen, erneut inspizieren |
| Harness | Liefert Context, validiert und autorisiert Proposals, dispatcht akzeptierte Calls, protokolliert Results und prüft den Abschluss | Erlaubt Edits unter src/ und verlangt beide benannten Tests |
| Runtime | Führt akzeptierte Calls aus und hält State außerhalb des Worker-Prozesses am Leben | Session Log, Sandbox, Checkpoint Store, Trace Backend |
OpenAIs Codex Loop Walkthrough beschreibt den Zyklus: Das Harness stellt einen Prompt zusammen, bittet das Model um die nächste Action, sendet einen akzeptierten Tool Call an die Runtime, hängt das Result an und fragt erneut, bis es das Ergebnis akzeptiert oder die Kontrolle an den User zurückgibt. Für die Rabattänderung sieht ein Durchlauf so aus:
- Der Context Builder stellt Task, Repository Instructions, relevante Files, frühere Tool Results und den aktuellen Plan bereit.
- Das Model schlägt einen
edit_file-Call mit einem Pfad und Replacement Text vor. - Die Tool Boundary validiert die Argumente, prüft den Pfad gegen den erlaubten Scope und fordert ein Approval an, wenn die Operation eines benötigt.
- Die Runtime wendet das Edit in der Sandbox an und gibt ein strukturiertes Result zurück.
- Das Harness führt
pytest tests/test_checkout.pyund anschließendpnpm playwright test tests/checkout_discount.spec.tsaus und liest beide Exit Codes. - Ein fehlgeschlagener Check wird zu neuem Context für den nächsten Model-Turn; zwei bestandene Checks machen die Änderung zu einem Completion Candidate.
- Das Harness protokolliert Commands, Exit Codes, getesteten Snapshot, Grader und Environment-Versionen dauerhaft; ein Trace kann auf diesen Record verweisen.
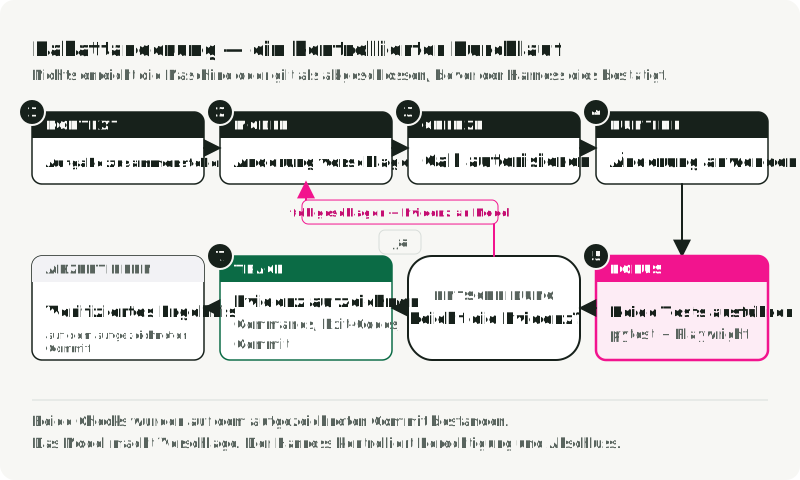
Nach Schritt 2 wurde noch keine Datei geändert. Das Harness kann ../../secrets.env noch ablehnen, für einen destruktiven Command ein Approval verlangen oder einen Run stoppen, der sein Budget ausgeschöpft hat. Nach Schritt 5 liest das Harness die Exit Codes selbst, sodass das Model sein eigenes Edit nicht als bestanden markieren kann.
Ein Completion Record für diese Aufgabe braucht den Candidate Snapshot, beide Commands und Exit Codes sowie die Versionen von Testumgebung und Grader. Er sollte dauerhaft gespeichert sein und außerhalb der Kontrolle des Candidates liegen. Ein Trace kann Proposal, genehmigten Call, Runtime Result und Acceptance Record für die Diagnose verknüpfen. Ein Trace allein ist nicht die Acceptance-Entscheidung.
Ein Trace enthält auch den Request nicht unbedingt. Er kann das Quelldokument oder ein Middleware-Event festhalten, ohne zu zeigen, was der zusammengesetzte Request am Ende enthielt. Wenn du feststellen musst, was das Model erhalten hat, erfasse es am letzten Punkt, bevor der Call hinausgeht, nach jeder Transformation.
OpenAIs Case Study zu Harness Engineering beschreibt eine bootfähige Anwendung pro Worktree sowie Browserzugriff, Logs, Metrics und Traces. Dieses Setup machte ein Latency-Ziel für eine User Journey für den Agent überprüfbar. Es zeigt die Voraussetzung hinter einer Acceptance-Regel: Die relevante Anwendung und ihre Signals müssen in der Testumgebung verfügbar sein. Lopopolo, der Autor dieser Case Study, pflegt einen Field Guide für Harness Engineering mit denselben zwei Hebeln: das Model unverändert lassen und Context sowie Tools darum herum entwickeln. Der Qualitätsmaßstab einer Organisation, ihre Procedures und Approval-Regeln liegen außerhalb dessen, was ein allgemeines Model weiß; das Harness liefert sie als Repository Instructions, Permission Rules und Acceptance Checks.
Betrachte drei oberflächlich ähnliche Ergebnisse:
| Nachweise am Ende des Runs | Entscheidung des Harness | Warum |
|---|---|---|
| Unit-Test besteht; Browser-Ergebnis fehlt | Fortsetzen oder als unvollständig stoppen | Für einen erforderlichen Check gibt es kein Ergebnis |
| Beide Tests bestehen, dann editiert der Agent eine Datei | Beide Checks erneut ausführen | Die protokollierten Ergebnisse gehören zu einem älteren Snapshot |
| Beide Tests bestehen auf demselben identifizierten Snapshot | Kommt für die Acceptance infrage | Die erforderlichen Nachweise passen zum Candidate |
„Kommt infrage“ lässt Raum für ein menschliches Approval oder eine andere erforderliche Regel; es erlaubt dem Model nicht, seine eigene Arbeit zu bestätigen. Ein Evaluator mit frischem Context kann ein visuelles Ergebnis anhand einer Rubric prüfen, wenn ein Exit Code das Kriterium nicht ausdrücken kann. Vergleiche diesen Evaluator mit Human Reviews, bevor du ihn über den Abschluss entscheiden lässt. Einen erforderlichen deterministischen Check kann er nicht ersetzen.
Für den Research Agent dieser Serie würde eine vorgeschlagene deterministische Abschlussregel das Report-Schema prüfen und bestätigen, dass die angefragten Ticker vorkommen. Diese Checks können nicht belegen, dass die Analyse sachlich stimmt; dafür braucht es weiterhin eine Prüfung der Quellen. Anthropics Evaluation Guidance empfiehlt für Coding-Aufgaben stabile Umgebungen und gründliche Tests sowie eine menschliche Kalibrierung von Model Gradern.
Wo jede Regel durchgesetzt wird
Die Anforderung, dass tests/checkout_discount.spec.ts besteht, gehört in deterministischen Code und nicht in den Prompt. Ein Prompt kann das Model daran erinnern, den Test auszuführen. Er kann das Model nicht daran hindern, ohne Nachweise Erfolg zu melden. Andere Regeln passen an andere Stellen:
| Regel platzieren in | Geeignet für | Beispiel |
|---|---|---|
| Prompt oder Skill | Suchreihenfolge, Coding Conventions und Planformat | Vor dem Editieren von Checkout-Code AGENTS.md lesen |
| Tool Boundary | Argumentvalidierung, erlaubte Pfade, Approvals und Tool-Zugriff | Writes nur unter src/ erlauben |
| Deterministischer Code | Budgets, Timeouts, Retries, Test-Exit-Codes und Release-Anforderungen | Run offen halten, solange der Playwright-Test fehlschlägt |
| Evaluator mit frischem Context | Visual Review oder Kriterien, die ein Urteil erfordern | Ein generiertes Diagramm mit einer schriftlichen Rubric vergleichen |
Die früheren Parts dieser Serie entscheiden jeweils eine Sache innerhalb dieses Walkthroughs:
| Früherer Part | Was er für diesen Turn entscheidet | Wo er im Walkthrough wirkt |
|---|---|---|
| Part 2 – Memory | Welcher frühere State in den Prompt gelangt | Schritt 1, der Context Builder |
| Part 3 – Tool Use | Welche Actions existieren und wie ein validiertes Result aussieht | Validierung in Schritt 3 und Result in Schritt 4 |
| Part 4 – Security | Ob dieser konkrete Call jetzt ausgeführt werden darf | Schritt 3, Pfadprüfung und Approval |
| Part 6 – dieser Artikel | Ob die resultierenden Nachweise den Run beenden | Schritte 5 bis 7, die Acceptance Checks |
Die Tabelle ordnet Verantwortlichkeiten zu, nicht die Reihenfolge der Execution. Parts 3 und 4 teilen sich Schritt 3: Derselbe Harness-Code, der ein fehlerhaftes Argument ablehnt, weist auch einen Call zurück, der zwar erlaubt, aber noch nicht genehmigt ist. Wenn Validierung und Autorisierung in getrennten Services laufen, übergib die validierten Argumente über diese Grenze, damit die Autorisierungsentscheidung für den Call gilt, der tatsächlich ausgeführt wird.
Einen Timeout als unbekanntes Ergebnis behandeln
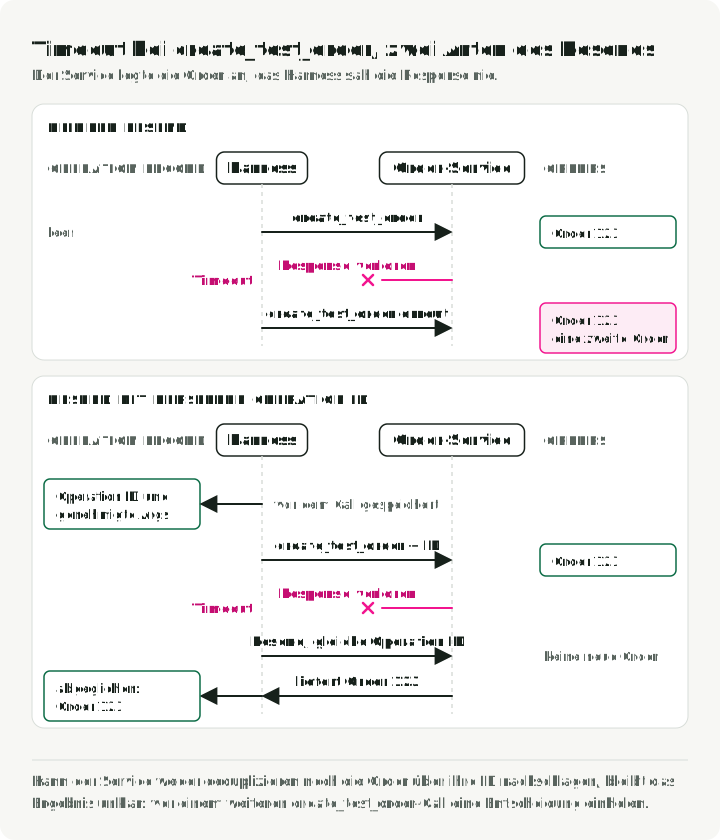
Das Rabatt-Edit ist lokal, und seine Tests lassen sich erneut ausführen. Eine Payment-Migration im selben fiktiven Store bringt ein anderes Problem mit sich. Angenommen, der Agent ruft create_test_order gegen einen Staging Service auf, und der Call läuft in einen Timeout. Der Service hat die Order möglicherweise angelegt, obwohl das Harness nie eine Response erhalten hat. Ein blinder Retry kann eine zweite Order anlegen.
Der Name der Action oder eine vom Model generierte Tool-Call-ID reicht nicht aus, um sie wiederherzustellen. Persistiere vor dem Dispatch eine von der Anwendung verwaltete Operation ID zusammen mit den genehmigten Argumenten. Der Service muss Retries für diese ID deduplizieren oder einen Status Lookup anbieten, mit dem sich das Ergebnis abgleichen lässt. Verwende nach einem Neustart für dieselbe beabsichtigte Order dieselbe ID erneut; ein geänderter Order-Request braucht eine neue Entscheidung. AWS’ Guidance zu idempotenten APIs beschreibt den Client Identifier und die serverseitige Atomarität, die dafür nötig sind. Prüfe, wie lange der Provider Keys aufbewahrt: Der Contract von Stripe erlaubt es beispielsweise, sie nach mindestens 24 Stunden zu entfernen, sodass ein späterer Retry einen Abgleich statt eines erneuten Sendens braucht.
Die Abbildung folgt einem create_test_order-Call mit Timeout zweimal: einmal blind erneut gesendet und einmal erneut gesendet mit der gespeicherten Operation ID.
Das Harness kann diese Entscheidungen nur dann ohne Rückfrage an das Model treffen, wenn jedes Tool einen expliziten Contract hat. Für create_test_order umfasst dieser Contract:
- validierte Argumente, damit fehlerhafte Eingaben vor der Execution abgelehnt werden;
- ein strukturiertes Result wie
{ "order_id": "123", "created": true }, damit spätere Checks keinen Freitext parsen müssen; - eine Effect Category: ob der Call nur liest oder eine Datei, einen Datensatz oder einen externen Service verändert, und ob eine Wiederholung sicher ist;
- eine Timeout- und Retry Policy, damit eine verlorene Response keine unbegrenzte Folge von Calls auslöst;
- eine Permission Rule: Das Lesen des Order-Status darf automatisch laufen, während das Anlegen einer Order eine Bestätigung erfordern kann.
| Vom Harness beobachtetes Result | Nächste Action |
|---|---|
Ein read-only get_order_status-Call gibt 503 zurück | Innerhalb eines Limits wiederholen, wenn dieser Lookup sicher wiederholbar ist |
create_test_order läuft in einen Timeout; der Lookup findet die Order unter ihrer Operation ID | Die vorhandene Order verwenden und das abgeglichene Result protokollieren |
create_test_order läuft in einen Timeout; der Service kann weder deduplizieren noch den Status prüfen | Das Ergebnis als unsicher belassen und vor einer weiteren Erstellung eine Entscheidung anfordern |
Dieser letzte Zustand muss einen Worker-Absturz überstehen. Ihn „fehlgeschlagen“ zu nennen, wäre falsch: Die Order könnte existieren. Der dauerhafte Operation Record braucht den genehmigten Payload, die Operation ID, den Dispatch-Status, das Server-Result oder den Status Lookup und jedes Approval. Der Trace hilft, diesen Record zu finden; das Transcript zeigt nur, was das Model gesehen hat.
Eine Tool Description hilft dem Model, eine Action zu wählen. Sie erteilt keine Permission und beweist nicht, dass ein Retry sicher ist. Wenn der Order Service über MCP bereitgestellt wird, muss der Client trotzdem seine eigene Validierung und Trust Policy anwenden, und der Server muss Zugriffskontrollen durchsetzen. Die MCP-Tools-Spezifikation besagt, dass Clients Behavior Annotations von Tools als nicht vertrauenswürdig behandeln müssen, sofern sie nicht von einem vertrauenswürdigen Server stammen. Ein Server, der create_test_order als read-only beschreibt, macht es dadurch nicht read-only. Die Spezifikation schreibt keine einheitliche Trust-Einstellung vor; schreibe deshalb für dein Deployment eine explizite Policy, die festlegt, welche Server-Metadaten Permission- oder Retry-Entscheidungen beeinflussen dürfen.
MCP bietet außerdem einen Standardweg, lang laufende Calls nachverfolgbar zu halten. Mit der offiziellen Tasks-Erweiterung kann ein Server auf tools/call statt mit einem Endergebnis mit einem Task-Handle antworten. Der Client fragt dann mit tasks/get den Stand ab oder bricht die Arbeit mit tasks/cancel ab. Die Tasks-Spezifikation sieht vor, dass Clients Task-IDs persistieren sollten, damit das Polling nach einem Absturz fortgesetzt werden kann; speichere die Task-ID daher im selben Operation Record. Ein Task im Status completed bedeutet nicht, dass das Tool erfolgreich war: Ein Tool Result mit isError: true schließt den Task trotzdem ab, und nur ein Protokollfehler setzt ihn auf failed. Client und Server handeln die Unterstützung für jede Anfrage aus; prüfe daher, dass beide Seiten sie implementieren, bevor du dich darauf verlässt.
Fortschritt an die nächste Session übergeben
Nun muss der fiktive Agent den Checkout von Payment Adapter v1 auf v2 migrieren. Er hat Handler und Client geändert, eine lokale Payment Sandbox gestartet, und tests/payment_migration.spec.ts schlägt noch fehl. Die Aufgabe dauert länger als eine Model-Session. Eine Summary der alten Conversation kann behaupten, dass die Sandbox läuft, obwohl der Prozess längst beendet ist.
Die nächste Session braucht drei verschiedene Arten von State:
| State | Was die nächste Session prüfen muss |
|---|---|
| Conversation | Den Request, Entscheidungen und relevante Tool Results |
| Workspace und Runtime | Aktuelle Files, Branch, Prozesse und Testumgebung |
| Task Progress | Abgeschlossene Checks, ausstehendes Approval oder unsicherer Write und nächste Action |
Compaction ersetzt ältere Messages durch eine kürzere Summary, damit die aktuelle Session weiterlaufen kann. Ein Progress Handoff ist Document Memory für die nächste Session. Wenn die alte Conversation veraltete Annahmen enthält, kann das Harness eine neue Session mit dem Handoff und dem aktuellen Workspace starten; einen abgestürzten Worker zu ersetzen und seine Prozesse wiederherzustellen, ist eine separate Aufgabe der Runtime.
Ein Checkpoint kann den Execution State bewahren, beweist aber nicht, dass eine externe Payment-Operation committed wurde oder dass ein Prozess noch läuft. Ein Progress Handoff hilft, wenn dem nächsten Model Context der nutzbare Task Status fehlt. Protokolliere Branch, geänderte Files, letzten Command und sein Result, ausstehende Operation IDs und den nächsten offenen Schritt. Prüfe diese Angaben beim Fortsetzen gegen den Live-Workspace und den Service, bevor du handelst. Anthropics Experimente mit Long-Running Coding Agents nutzten Git History und eine Progress-Datei, damit spätere Sessions die Arbeit wieder aufnehmen konnten. Anthropics späterer Report zum Harness Design merkt an, dass Handoffs zusätzliche Orchestration, Tokens und Wall Time kosten.
Der Handoff sollte an Bedingungen geknüpft sein. Ein kleines Edit, das in einer Session fertig wird, braucht keinen. Selbst eine lange Aufgabe braucht vielleicht keine weitere Datei, wenn ihr Checkpoint den erforderlichen Fortschritt bereits enthält und die nächste Session ihn nutzen kann. Prüfe, ob eine fortgesetzte Session abgeschlossene Arbeit wiederholt, einen ausstehenden Write übersieht oder auf einer veralteten Umgebung handelt. Behebe den fehlenden State, statt standardmäßig eine Summary hinzuzufügen.
Den Failure diagnostizieren, bevor man eine Komponente hinzufügt
Die drei Fälle oben erzeugen unterschiedliche Traces: einen fehlenden Acceptance-Test, einen unsicheren externen Write und wiederholte Arbeit nach dem Fortsetzen. Ihre Fixes gehören an unterschiedliche Stellen. Ein Browser-Ergebnis, das im Acceptance Record fehlt, verlangt einen erforderlichen Completion Check. Eine unsichere Order verlangt serverseitige Deduplizierung oder einen Abgleich. Ein wiederholtes Edit nach einer neuen Session verlangt nutzbaren Progress State.
Protokolliere für den nächsten Run Task- und Harness-Version, vorgeschlagene Action, Approval, Tool Result, getesteten Snapshot, Acceptance-Ergebnis, Latency und Kosten. Erfasse die Input-Token-Zahlen getrennt von den abgerechneten Input-Kosten, einschließlich Cached Reads: Zwei Harnesses, die sich identisch verhalten, können unterschiedlich abgerechnet werden, je nachdem, wie jeder seinen Request zusammensetzt und ob der Cache des Providers warm war. Halte Secrets und unnötige personenbezogene Daten aus Traces heraus. Verknüpfe externe Operation Records per ID, da ein clientseitiger Timeout nicht zeigen kann, was der Server getan hat. Wenn ein Failure erneut auftritt, schreibe einen Regression Case, der ihn reproduziert. AI Agent Evaluation in Production entwickelt diesen Prozess vom Trace zum Test.
Jedes wiederkehrende Symptom legt eine kleine Änderung und eine Messgröße nahe, die zeigen würde, ob sie geholfen hat:
| Wiederkehrendes Symptom | Kleine Änderung zum Ausprobieren | Was zu messen ist |
|---|---|---|
| Read-only Lookups schlagen vorübergehend fehl | Begrenzter Retry mit Backoff | Recovery-Rate, zusätzliche Calls, Wall Time |
| Fortgesetzte Sessions wiederholen abgeschlossene Arbeit | Strukturierter Progress Handoff | Doppelte Tool Actions nach dem Fortsetzen |
| Erforderliche Tests fehlen beim Abschluss | Abschluss ablehnen, bis jeder erforderliche Check besteht | Aufgaben, die ohne alle erforderlichen Checks akzeptiert wurden |
| Visuelle Fehler überstehen deterministische Checks | Evaluator mit frischem Context und einer Rubric | Gefundene Fehler, falsche Ablehnungen, Review-Zeit |
| Der Agent editiert außerhalb seines Scopes | Engere Tool Permission | Blockierte Calls und manuelle Overrides |
| Abgerufene Memory verdrängt die aktuelle Aufgabe | Abgerufene Fakten begrenzen; vor dem Einfügen ranken | Für Recall verbrauchte Tokens, abgeschlossene Aufgaben, Kosten |
| Eine genannte Regel oder ein Status erreicht das Model nie | Den zusammengesetzten Request erfassen, bevor der Call hinausgeht | Requests ohne die Regel; Runden, bis sie wieder auftaucht |
Bevor du eine Retry Policy, einen Handoff oder einen Evaluator hinzufügst, benenne den Failure, den er ändern soll, und die Metrik, die eine Verbesserung zeigen würde. Rechne auch die Kosten mit: Mehr akzeptierte Aufgaben nützen nichts, wenn die zusätzlichen Calls die Review-Zeit verdoppeln oder doppelte Orders anlegen. Autorisierung, Isolation, Datenschutzregeln und verpflichtende Acceptance Checks sind Anforderungen; ein kleiner Erfolgs-Benchmark ist kein Grund, sie zu entfernen. Teste diese Einschränkungen mit expliziten verbotenen Fällen.
Eine optionale Änderung nach der anderen messen
Eine Ablation vergleicht ein Harness mit und ohne eine Komponente, während der Rest des Experiments unverändert bleibt. Verwende dieses Protokoll:
- Friere Model-Version und Provider-Endpoint, Task-Instanzen, Umgebung samt Compute-Limits, Grader und Prompts außerhalb der getesteten Komponente ein. Allein Ressourcenlimits können den Score eines Agent-Benchmarks verändern; der Evals-Artikel behandelt Anthropics Messung.
- Gib beiden Varianten dasselbe Gesamtbudget an Tokens, Zeit und Dollar.
- Lege die Anzahl der Versuche oder die Abbruchregel vor dem Vergleich fest.
- Führe in beiden Varianten dieselben Task-Instanzen aus und wiederhole jede Aufgabe, weil der Model-Output variiert.
- Berichte den Mittelwert mit seiner Streuung oder seinem Konfidenzintervall.
- Zähle jeden gestarteten Versuch, einschließlich Timeouts, Policy-Stopps, Harness-Abstürzen und Evaluator-Failures.
Für die Payment-Migration ist der optionale Progress Handoff ein Kandidat. Starte jedes Control-Treatment-Paar vom selben Repository-Commit und demselben geseedeten Checkpoint, mit dem Handoff als einzigem Schalter.
Die primäre Messgröße könnten doppelte Tool Actions nach dem Fortsetzen sein: eine Operation an einem Artefakt, das die vorherige Session bereits abgeschlossen hatte. Berichte außerdem akzeptierte Aufgaben, durchgerutschte Fehler, Wall Time, Model- und Evaluator-Kosten sowie Review-Minuten. Lege Anzahl der Versuche und Abbruchregel vorab fest und berichte dann die Streuung statt nur den Mittelwert. Wenn der Handoff Duplikate reduziert, aber mehr kostet, als er einspart, ist das ein nützliches negatives Ergebnis.
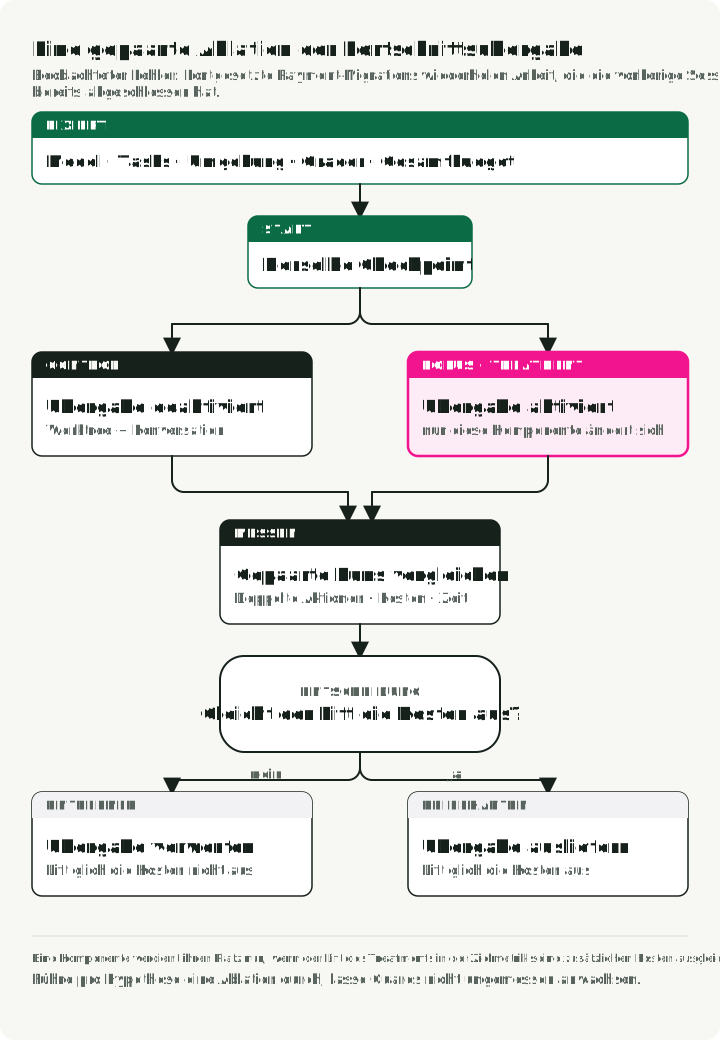
Das SWE-agent-Paper liefert ein eng abgegrenztes Beispiel für eine Interface-Ablation. Mit GPT-4 Turbo auf dem SWE-bench-Lite-Split mit 300 Aufgaben und einer Obergrenze von $4 pro Aufgabe änderte es jeweils ein Interface-Feature:
| Interface-Änderung | Gelöst |
|---|---|
| Vollständiges SWE-agent-Interface (Referenz) | 18.0% |
| Editor ohne Linting | 15.0% |
| Vollständige Datei statt eines Viewers mit 100 Zeilen | 12.7% |
| Vollständige Observation History statt der letzten fünf | 15.0% |
Das sind Ergebnisse für dieses Model und diesen Benchmark, keine zu erwartenden Verbesserungen für diesen fiktiven Store. Übertragbar ist die Methode: eine benannte Interface-Entscheidung unter einem festen Setup testen und die Bedingungen zusammen mit der Zahl berichten.
Gebündelte Vergleiche sind häufig, und sie können die Änderung, die geholfen hat, nicht benennen. LangChain berichtet für deepagents-cli eine Verbesserung auf Terminal-Bench 2.0 von 52.8% auf 66.5% bei festem Model, nachdem System Prompt, Tools und Middleware gemeinsam geändert wurden. OpenAIs ARC-AGI-3-Report zeigt das umgekehrte Risiko: Ein Score hat sich fast verdreifacht, als das Harness Reasoning beibehielt und Compaction nutzte, zwei API-Einstellungen, die gemeinsam geändert wurden. Protokolliere API, Beibehaltung des Reasonings, Compaction Policy und Budgets zusammen mit der Model-ID; andernfalls kann eine scheinbare Model-Regression eine fehlende Fähigkeit im Adapter sein.
Wer jeweils nur eine Änderung testet, findet auch Änderungen, die zu klein wirken, um etwas auszumachen. Anthropics Postmortem zu Claude Code vom April 2026 berichtet, dass die API nicht betroffen war, aber drei Änderungen auf Produktebene die Qualität senkten: ein niedrigerer Standardwert für den Reasoning-Aufwand, ein Bug, der nach einer Leerlaufphase der Session bei jedem Turn das frühere Reasoning löschte, und eine System-Prompt-Zeile, die den Text zwischen Tool Calls begrenzte. Als Anthropic eine Ablation dieser einen Zeile auf einer breiteren Menge von Evals durchführte, zeigte eine davon einen Rückgang von 3% für Opus 4.6 und Opus 4.7. Eine Prompt-Zeile oder eine Standardeinstellung ist eine Harness-Änderung; teste sie wie eine.
Validiere Komponenten erneut, wenn sich das Model ändert. Anthropics Report zu Long-Running Applications ist eine qualitative Case Study: Als Opus 4.6 erschien, entfernte das Team Harness-Komponenten nacheinander und stellte fest, dass Evaluator-Calls bei Aufgaben, die das Model nun allein erledigte, zu Overhead wurden, während sie nahe an seiner Leistungsgrenze weiterhin halfen.
Nimm einen Safety Stop des Providers in die Failure Suite auf: Er sollte den Dispatch stoppen und zum Review führen, nicht zu einem Retry. Part 4 behandelt die Details.
Den Vergleich im begleitenden Lab ausprobieren
Das harness-demo-Projekt bei Commit 517353f3 macht die Ablationsregel ausführbar. Seine zwölf generischen synthetischen Aufgaben, etwa fix-parser-edge-case, split-large-module und wire-browser-test, deklarieren jeweils einen Schwierigkeitsgrad und vier Bedingungen: ein unzuverlässiges Tool, verlorener Fortschritt, eine übersehene Implementierungslücke und ein mehrdeutiger Abschluss. Der Simulator leitet eine fünfte für schwierige Aufgaben ab, die zusätzlich eine Progress-Datei brauchen: Ohne context_reset behält Compaction veraltete Annahmen bei. Eine reine Funktion markiert eine Aufgabe als bestanden, wenn die gewählte Konfiguration jede zutreffende Bedingung abdeckt. Es gibt kein Model, kein externes Tool und keine echte Coding-Aufgabe. Ergebnisse und Token-Zahlen sind simulierte Lehrdaten und kein Beleg dafür, dass ein Harness mit fünf Komponenten einen laufenden Agent verbessert.
Klone die fixierte Revision und führe Checks und Simulation mit installiertem uv aus:
git clone https://github.com/slavadubrov/harness-demo.git
cd harness-demo
git checkout 517353f3a47541d66099983170fe90812b6ef23b
make check
make run
make failures
make check führt Ruff und sieben Unit-Tests aus, darunter einen Test, der einen Vergleich mit zwei geänderten Komponenten ablehnt. make run gibt eine kumulative Lehrmatrix und fünf Leave-one-component-out-Paare aus. make failures benennt jeden simulierten Failure; die vollständige Konfiguration endet mit all synthetic tasks pass.
| In die vollständige Konfiguration zurückgebrachte Komponente | Ohne sie | Mit ihr |
|---|---|---|
| Retry Policy | 8/12 | 12/12 |
| Progress Handoff | 7/12 | 12/12 |
| Fresh Evaluator | 8/12 | 12/12 |
| Fail-closed Acceptance | 7/12 | 12/12 |
| Context Reset | 10/12 | 12/12 |
Die Zeilen sind deterministische Folgen der Task-Flags und des Grader-Codes. Sie sind keine Schätzungen einer Effektgröße in einem laufenden System. Die vorherige kumulative Matrix fügt in einem Übergang mehrere Komponenten hinzu und kann nicht zeigen, welche davon ihre Änderung verursacht hat.
Die Datei model.py des Labs verhindert, dass eine gebündelte Änderung als Ablation bezeichnet wird: Sie vergleicht jedes Komponentenfeld eines Paars, und ihr Regressionstest liefert ein ungültiges Paar, bei dem Retry und Evaluator beide geändert sind. Diese eigenständige Version des Guards läuft auf einem gültigen Progress-Handoff-Paar:
from dataclasses import dataclass, fields

@dataclass(frozen=True)
class Config:
    progress_handoff: bool = False
    evaluator: bool = False
    retry_policy: bool = False
    fail_closed_acceptance: bool = False
    context_reset: bool = False

def changed_components(control: Config, treatment: Config) -> tuple[str, ...]:
    return tuple(
        field.name
        for field in fields(control)
        if getattr(control, field.name) != getattr(treatment, field.name)
    )

control = Config(progress_handoff=False, evaluator=True, retry_policy=True)
treatment = Config(progress_handoff=True, evaluator=True, retry_policy=True)
assert changed_components(control, treatment) == ("progress_handoff",)
Um die Methode in ein echtes Projekt zu übertragen, ersetze die synthetischen Task-Flags durch eine versionierte Task Suite und die simulierten Token-Zahlen durch Trace-Messungen. Halte die Acceptance-Regeln außerhalb der Kontrolle des Candidates. Ein festes Model allein ist noch kein kontrollierter Vergleich, wenn sich auch Prompts, Testdaten, Permissions oder die Reasoning- und Compaction-Einstellungen der API geändert haben.
Den Code hinter einem Verhalten finden
Ein Harness, das seine Ablationen besteht, kann das Model, für das es abgestimmt wurde, trotzdem überdauern, und eine spätere Änderung braucht den Code, der ein Verhalten implementiert. Eine Anfrage wie „Secrets in jedem Capture-Pfad maskieren“ benennt ein Verhalten, keine Datei. In einem produktiven Harness kann sich dieses Verhalten über mehrere Execution Stages und gemeinsamen State erstrecken.
Ein Preprint von Wang et al. aus dem Jahr 2026 schlägt für diese Suche ein Harness Handbook vor; das Paper nennt sie Behavior Localization. Statische Analyse extrahiert einen Programmgraphen, ein LLM gruppiert dessen Einheiten zu Execution Stages, und ein Maintainer oder Coding Agent steigt von einem Systemüberblick zu quellbasierten Einträgen für eine Funktion oder Datei ab. Jeder Eintrag muss sich gegen das Live-Repository auflösen lassen und wird nach jeder Änderung neu synchronisiert.
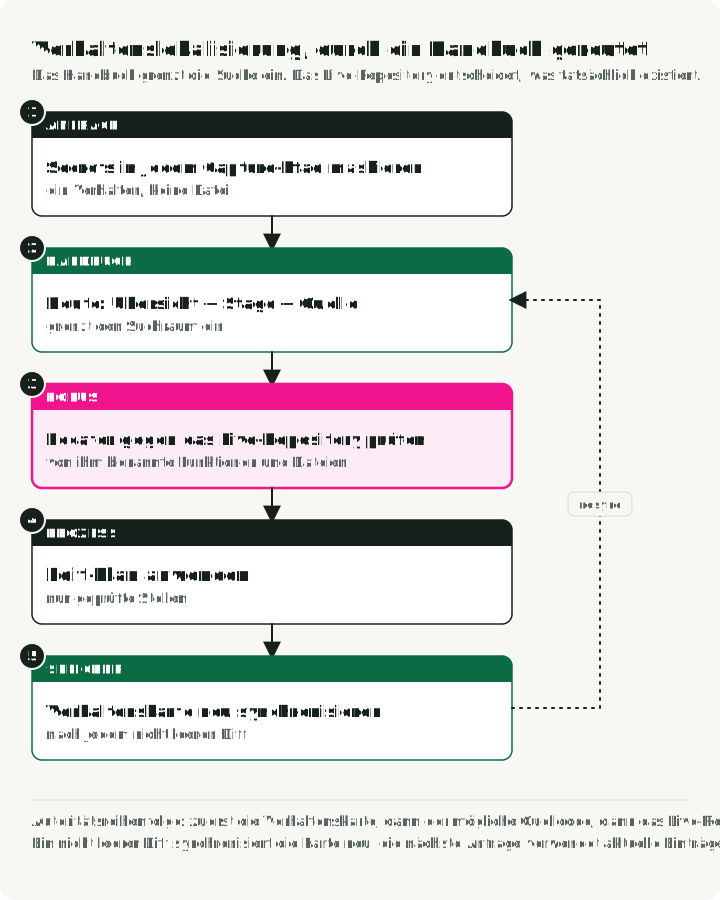
Bei zwei Open-Source-Harnesses erzeugte ein Planner, der über das Handbook routete, Edit-Pläne, die Judges häufiger bevorzugten, und das mit weniger Tokens. Die Studie bewertete Pläne statt ausgeführter Änderungen und berichtete keine Unsicherheit; behandle den Ansatz daher als Forschungsstand.
Den Failure nutzen, um den Verantwortlichen zu finden
Diese Serie hat sich vom Reasoning Loop nach außen aufgebaut. Wenn ein Run fehlschlägt, suche die erste Verantwortlichkeit, die den Failure verhindern oder erkennen kann:
| Was passiert ist | Zu untersuchen |
|---|---|
| Schlechter nächster Schritt, obwohl die richtigen Informationen verfügbar waren | Model und Reasoning Loop |
| Frühere Entscheidung verloren oder abgeschlossene Arbeit wiederholt | Context-Zusammenstellung und Memory |
| Konnte eine Action nicht ausdrücken oder ihr Result nicht lesen | Tool Contract |
| Hat eine verbotene Action ausgeführt | Permission Check und der durchsetzende Service |
| Worker ist abgestürzt und seine Umgebung ist verschwunden | Runtime und Checkpoint |
| Erfolg ohne erforderliche Nachweise gemeldet | Acceptance-Regel des Harness und getesteter Snapshot |
Ich würde mit einem leistungsfähigen Model, eng gefassten Tools, einer Sandbox und einem expliziten Acceptance Check beginnen. Protokolliere den ersten Failure, füge die kleinste Kontrolle hinzu, die ihn adressiert, und vergleiche mit deaktivierter Kontrolle. Halte Regel und Trace zusammen, damit das nächste Model-Upgrade dir einen Grund gibt, die Komponente zu behalten oder zu entfernen. Protokolliere für jede Komponente, wer sie pflegt, wie viele Tokens oder Sekunden sie hinzufügt und welcher Regressionstest ihre Entfernung rechtfertigen würde. Wer sechs Monate später progress_handoff=True sieht, sollte die fehlgeschlagenen Traces finden können, die sie gerechtfertigt haben, und die Regression Cases, die sie weiterhin dort halten.
Referenzen
- OpenAI, Unrolling the Codex agent loop.
- OpenAI, Harness engineering: leveraging Codex in an agent-first world.
- Anthropic Engineering, Demystifying evals for AI agents.
- Anthropic Engineering, Effective harnesses for long-running agents.
- Anthropic Engineering, Harness design for long-running application development.
- Lopopolo, Harness engineering: anthology, field guide, and agent context bundle.
- LangChain, Improving Deep Agents with harness engineering.
- OpenAI, How two settings tripled our ARC-AGI-3 scores.
- Wang et al., Harness Handbook: Making Evolving Agent Harnesses Readable, Navigable, and Editable, arXiv:2607.13285, 2026.
- Stripe, Idempotent requests.
- Yang et al., SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering.
- AWS, Making retries safe with idempotent APIs.
- Model Context Protocol, Tools specification.
- Model Context Protocol, Tasks extension und Tasks specification.
- Anthropic Engineering, An update on recent Claude Code quality reports.
Der Code des Market Analyst Agent aus dieser Serie ist auf GitHub verfügbar.