AI Agent Tool Use: MCP, CLI, Skills und Code Execution

Automatische Übersetzung
Dieser Artikel wurde automatisch aus der englischen Originalversion übersetzt.
Dieser Artikel richtet sich an Engineers, die einem Agent Zugriff auf Daten, Kommandos oder externe Services geben. Du lernst, wie du eine Action definierst, die der Agent zuverlässig nutzen kann, wie du ein Ausführungs-Interface dafür wählst und wie du prüfst, ob dieses Interface bei deinen Tasks hilft. Das durchgehende Beispiel ist der Market Analyst Agent, ein Research Agent, der Marktdaten abruft und Berichte erstellt.
In Teil 1 hat das Model in einem Reasoning Loop den nächsten Schritt gewählt. Teil 2 behandelte, was es zwischen den Schritten behalten kann. Ein Tool gibt dieser Wahl eine Wirkung außerhalb des Models: Es kann einen Kurs abrufen, einen gespeicherten Bericht lesen, Code ausführen oder einen Datensatz ändern. Das Programm um das Model herum, der Harness, entscheidet weiterhin, welche dieser Actions existieren und ob ein vorgeschlagener Call ausgeführt werden darf.
Die erste Designentscheidung betrifft die Action selbst. Wenn der Agent für einen Bericht Kurs- und Bewertungsdaten braucht, soll er zwei API-Endpunkte, einen Aktien-Snapshot oder ein generiertes Programm anfordern? Die Antwort hängt vom Task und vom Feedback ab, das der Agent braucht, nicht vom Integrationsprotokoll.
Die kurze Entscheidung zum Interface findest du unter AI Agent Tool Interfaces.
Was ein Unternehmensüberblick braucht
Angenommen, der Nutzer bittet den Market Analyst Agent um einen aktuellen Überblick über ein Unternehmen. Der Agent braucht dafür vielleicht einen aktuellen Kurs, das Handelsvolumen, Bewertungskennzahlen, den Kursverlauf und News. Das sind verschiedene Fragen. Der letzte Kurs und die Basiskennzahlen gehören oft in dieselbe Antwort, während historische Kurse und News für eine kurze Antwort unnötig sein können. Eine fremde Fähigkeit, einen Trade auszuführen, gehört nicht in diesen Research-Pfad.
Bevor du eine API bereitstellst, schreibe vier Dinge auf:
- Action: Was kann der Agent in einem Schritt anfordern? Bevorzuge eine Operation, die zu einer Frage passt, die er tatsächlich beantworten muss.
- Argumente: Welche Eingaben muss der Aufrufer liefern, und welche kann die Anwendung prüfen, bevor sie den Service kontaktiert?
- Ergebnis: Welche Fakten lassen den Agent seinen nächsten Schritt entscheiden, und welche Herkunftsangaben oder Identifier müssen für spätere Prüfungen erhalten bleiben?
- Fehler und Wirkung: Was kann sich ändern, woran erkennt ein Aufrufer, ob die Action stattgefunden hat, und wann ist ein Retry sicher?
Diese Fragen trennen drei Verantwortlichkeiten. Das Model schlägt eine Action vor. Der Harness validiert und routet sie. Die Tool-Implementierung führt sie aus und liefert ein Ergebnis. Ein JSON Schema kann einen fehlerhaften Ticker ablehnen; es kann nicht feststellen, dass ein Trade autorisiert ist. Ein Protokoll kann einen Tool Call zustellen; es kann einen fehlgeschlagenen Schreibvorgang nicht sicher wiederholbar machen.
Das SWE-agent-Paper nennt das Design dieser Interaktion ein Agent-Computer Interface (ACI), in Analogie zur Mensch-Computer-Interaktion: Sprachmodell-Agents sind eine neue Art von Nutzer und profitieren von Interfaces, die für sie gebaut sind. Seine Ablation auf 300 Tasks aus SWE-bench Lite erreichte mit dem vollständigen Interface 18,0 %, gegenüber 7,3 % für eine reine Shell-Bedingung ohne ausgearbeitete Demonstration und 11,0 % mit einer. Die Bedingungen unterscheiden sich in mehr als einer einzelnen Tool-Beschreibung, daher sagen diese Zahlen den Gewinn aus einem Redesign deiner eigenen Tools nicht voraus. Sie zeigen aber, dass das Interface zusammen mit dem Model getestet werden sollte. Anthropics Building Effective Agents sagt dasselbe: Plane für das Agent-Computer Interface so viel Aufwand ein wie für ein Interface für Menschen.
Die Abbildung folgt einem get_stock_snapshot-Call durch Model, Harness und Tool und nummeriert jeden Schritt mit dem Prinzip aus der Liste unten, das ihn bestimmt. Die Prüfung auf einen fehlenden Preis ist eine Empfehlung: Die fest referenzierte Snapshot-Implementierung setzt einen fehlenden Preis derzeit standardmäßig auf null.
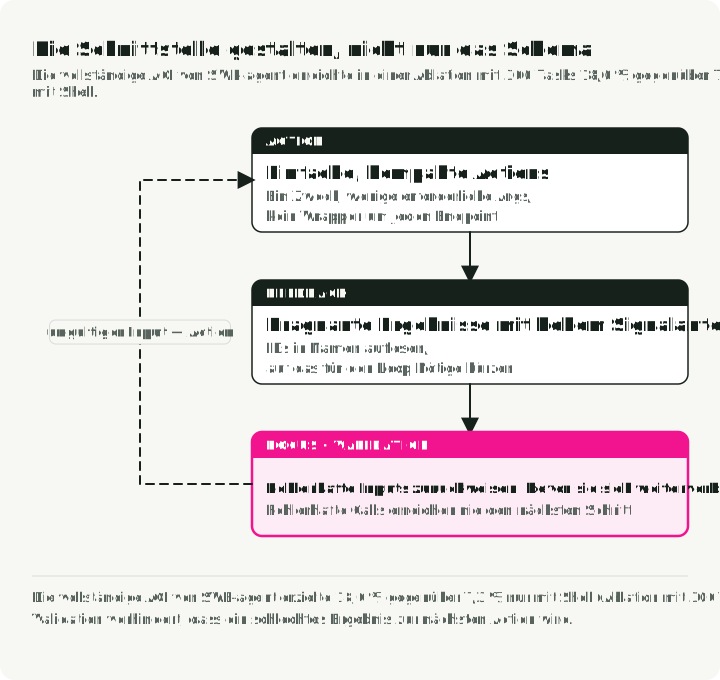
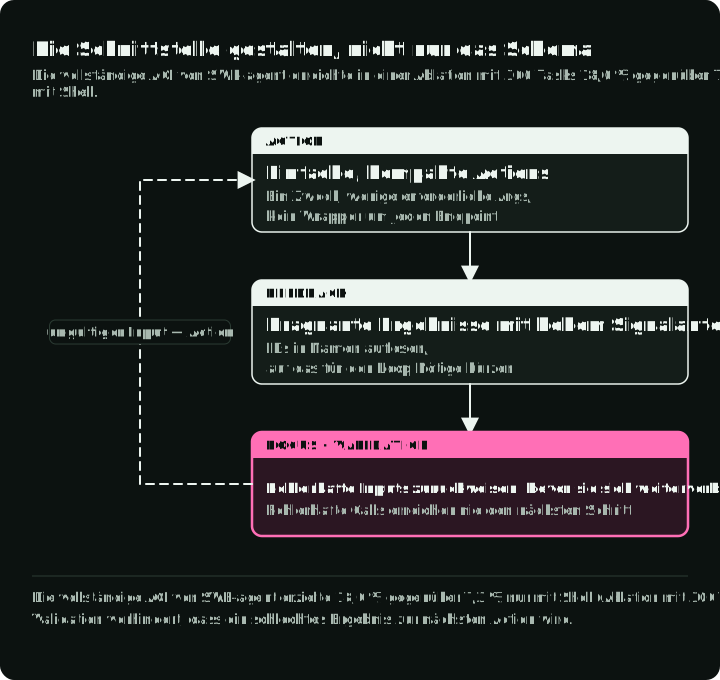
Die vier ACI-Prinzipien gelten für jedes Interface in diesem Artikel:
- Einfache Actions. Wrappe API-Endpunkte nicht eins zu eins. Statt
list_users,list_eventsundcreate_eventbieteschedule_eventan, das in einem Call freie Zeiten findet und bucht. Stattread_logsbietesearch_logsan, das die relevanten Zeilen mit Kontext zurückgibt. - Kompakte Actions. Fasse Operationen zusammen, die einem Task dienen, wie es der Aktien-Snapshot unten tut.
- Knappes, informatives Feedback. Gib semantische Namen statt rohem HTML, vollständiger API-Payloads oder kryptischer IDs zurück, behalte aber jede ID, die ein späterer Call braucht.
- Validierung, die die Ausbreitung von Fehlern stoppt. Prüfe Argumente vor dem Call und Ergebnisse vor der nächsten Action. In SWE-agent lehnte ein Editor mit eingebautem Linting Syntaxfehler ab; das Aktivieren hob die Edit-Bedingung von 15,0 % auf 18,0 %.
Ein Tool leicht wählbar und nutzbar machen
Der Market Analyst Agent liefert ein konkretes Beispiel. Eine frühere Version stellte get_stock_price und get_company_metrics getrennt bereit. Der Executor stellt jetzt get_stock_snapshot, get_price_history, get_financials, search_news und search_competitors bereit. Der Snapshot kombiniert Kurs, Volumen, Marktkapitalisierung und KGV, weil ein einfacher Überblick sie normalerweise zusammen braucht. Kursverlauf, Finanzberichte und News bleiben getrennt, weil der Agent nicht jedes davon braucht.
| Vorher (ursprüngliche Tools) | Nachher (Marktdaten-Tools) | Warum |
|---|---|---|
get_stock_price + get_company_metrics | get_stock_snapshot | Ein Call liefert den grundlegenden Kurs- und Bewertungs-Snapshot |
get_price_history | get_price_history | Beibehalten, mit validierten Zeiträumen und Zusammenfassung des Durchschnittsvolumens |
search_news | search_news | Liefert strukturierte Einträge mit extrahierten Kernpunkten |
search_competitors | search_competitors | Behält die auf Wettbewerber ausgerichtete Such-Action |
| Kein Tool für Finanzberichte | get_financials | Wählt per Parameter Gewinn- und Verlustrechnung, Bilanz oder Cashflow |
Die Tool-Liste des Agents enthält außerdem einen Skill Loader, zwei CLI-Wrapper und einen eingeschränkten In-Process-Python-Evaluator, deckt also drei der unten beschriebenen Interfaces ab; MCP erscheint als separater Sidecar.
Das ist eine Entscheidung über die Größe der Action. Ein Eins-zu-eins-Wrapper um jeden Upstream-Endpunkt zwingt das Model, um das API-Layout des Anbieters herum zu planen. Ein einzelnes Tool mit vielen unzusammenhängenden Modi verschiebt das Auswahlproblem nur in seine Argumente. Gruppiere Felder, die demselben Task dienen, und teste dann, ob Agents die richtige Action wählen.
Die Beschreibung für das Model schreiben
Die Beschreibung des Snapshots sagt, wann er zuerst aufgerufen werden soll, was er zurückgibt und wann stattdessen Kursverlauf oder Finanzberichte zu wählen sind. Dieser Hinweis auf benachbarte Tools ist so wichtig wie der Name. „Search for items“ kann dem Model nicht sagen, ob search_news oder search_competitors eine Anfrage beantwortet. Anthropics Leitfaden zum Tool-Design empfiehlt ebenfalls Beschreibungen, Beispiele und Ergebnisse, die einem Model helfen, die richtige Action zu wählen, und seine Dokumentation zu Tool-Definitionen schlägt mindestens drei oder vier Sätze vor, die abdecken, wann das Tool zu nutzen ist, seine Parameter, seine Ausgabe und Randfälle:
# Vague: the model cannot tell when to use it.
vague = [{"name": "search", "description": "Search for items"}]

# Specific: when to use it, what it returns, and which tool to use instead.
specific = [{
    "name": "search_news",
    "description": (
        "Search for recent news articles about a specific stock or company. "
        "Use this tool when the user asks about recent events, earnings, "
        "announcements, or market-moving news for a specific ticker. "
        "Returns up to 10 articles sorted by relevance. "
        "For company competitors rather than news, use search_competitors instead."
    ),
    "input_schema": {
        "type": "object",
        "properties": {
            "query": {
                "type": "string",
                "description": "Search query. Examples: 'NVDA earnings Q3 2025', 'Tesla delivery numbers'",
            },
            "max_results": {
                "type": "integer",
                "description": "Max articles to return (1-10, default 5)",
                "default": 5,
            },
        },
        "required": ["query"],
    },
}]
Füge Beispiele hinzu, wo Parameter mehrdeutig sind; verbrauche keinen Kontext, um zu wiederholen, was ein einfaches Schema schon sagt. In Anthropics internen Tests hob ein Feld input_examples die Genauigkeit bei komplexer Parameterbehandlung von 72 % auf 90 %. Anthropic berichtet außerdem, dass Präfix- gegenüber Suffix-Namespacing (asana_search oder search_asana) spürbare Effekte auf seine Evaluationen hatte, ohne zu sagen, welche Variante gewann; teste also beide auf deinem Toolset. Anschließend gab Anthropic Evaluations-Transkripte an Claude Code, um die Tools umzuschreiben, und auf zurückgehaltenen Tests übertraf diese Schleife die von Experten geschriebenen Tools.
Argumente validieren und Ergebnisse formen
Die Implementierung validiert den Ticker vor der Marktdatenanfrage. Dieser Auszug ist aus dem verlinkten Quellcode adaptiert; der gemeinsame Normalizer entfernt Leerzeichen, schreibt den Wert groß und akzeptiert Suffixe mit Punkt oder Bindestrich wie BRK.B und BF-B. Die History-Abfrage ergänzt eine erlaubte Menge von Zeiträumen:
from pydantic import BaseModel, Field, field_validator

from market_analyst.utils import normalize_ticker

class StockQuery(BaseModel):
    ticker: str = Field(description="Stock ticker symbol (e.g., NVDA)")

    @field_validator("ticker")
    @classmethod
    def validate_ticker(cls, value: str) -> str:
        return normalize_ticker(value)

class StockHistoryQuery(StockQuery):
    period: str = Field(default="1mo", description="Time period: 1d, 5d, 1mo, 3mo, 6mo, 1y")

    @field_validator("period")
    @classmethod
    def validate_period(cls, value: str) -> str:
        valid = {"1d", "5d", "1mo", "3mo", "6mo", "1y"}
        if value not in valid:
            raise ValueError(f"Invalid period: {value}. Must be one of {valid}")
        return value
Die Aktien- und News-Tools liefern mit Pydantic validierte Ergebnisse statt roher Anbieter-Payloads. Das Feld summary gibt dem Agent einen fertigen String für einen Bericht, und key_points ersparen ihm das Parsen von Artikeltexten:
from pydantic import BaseModel

class StockSnapshot(BaseModel):
    ticker: str
    price: float
    change_pct: float
    volume: int
    market_cap_b: float
    pe_ratio: float | None
    summary: str  # One line for direct use in a report

class NewsItem(BaseModel):
    headline: str
    source: str
    date: str
    relevance_score: float  # Pre-ranked by the tool
    key_points: list[str]  # Extracted by the tool, not the agent

class NewsSearchResult(BaseModel):
    query: str
    results: list[NewsItem]
    summary: str
Das Snapshot-Ergebnis hat diese typisierten Felder für Kurs, prozentuale Änderung, Volumen, Marktkapitalisierung, KGV und eine kurze Zusammenfassung. Füge dem Ergebnis die Datenquelle und den Stand-Zeitpunkt des Markts hinzu und lass den Bericht beide angeben. Dass die Daten jetzt abgerufen werden, beweist nicht, dass der Kurs aktuell ist.
Halte Ergebnisse kurz genug für die nächste Entscheidung, aber verwirf keinen Identifier und keine Quelle, die eine spätere Action braucht. Bei einem Suchergebnis können Titel und Zusammenfassung reichen, um Kandidaten zu ranken; die URL oder ID muss verfügbar bleiben, wenn der Agent ein bestimmtes Element abrufen oder zitieren muss. Ein knappes und ein detailliertes Ergebnis können verschiedenen Schritten dienen: Anthropics Tests ergänzten einen Parameter response_format, der im knappen Modus etwa 72 Tokens und im detaillierten Modus 206 lieferte. Rohe Upstream-Payloads sind selten ein sinnvoller Standard.
Fehler zurückgeben, auf die der Loop reagieren kann
Fehler gehören zum selben Vertrag. Setze einen fehlenden Kurs nicht standardmäßig auf null, denn dann sieht ein nicht verfügbarer Kurs wie ein Kurs von null Dollar aus. Verpacke auch nicht jeden endgültigen Fehler in denselben Exception-Typ, denn dann kann der Aufrufer keine Retry-Kategorie wählen. Lehne fehlende Marktdaten ab und unterscheide ungültige Eingaben, temporäre Anbieterfehler und nicht verfügbare Daten. Bei einem Tool, das externen Zustand schreibt, muss es außerdem einen bekannten Fehler von einem Ergebnis unterscheiden, das trotz verlorener Antwort abgeschlossen sein könnte. Gib genug Detail zurück, um zwischen Retry, Rückfrage und Eskalation zu wählen; verhindere, dass Anbietertext zu einer Anweisung an das Model wird.
Vier Mechanismen behandeln verschiedene Fehlerklassen: Retry mit Backoff für transiente Fehler, Model-Fallback für Anbieterausfälle, eine Klassifizierung, die behebbare Fehler an den Agent zurückgibt und den Rest eskaliert, und Checkpoint-Recovery für Abstürze (Teil 2). Wiederhole nur transiente Fehler wie Timeouts, Netzwerkfehler, 429- und 5xx-Antworten, mit exponentiellem Backoff und einem kleinen Versuchslimit; eine Bibliothek wie Tenacity erledigt das in einem Decorator. Der Aufrufer muss eine endgültige Exception oder einen nicht wiederholbaren 4xx trotzdem in ein stabiles Ergebnis umwandeln, das sagt, welche Operation fehlschlug und was als Nächstes zu tun ist. Ein Retry klassifiziert den Fehler nicht, und er ist nur für einen Lesevorgang oder einen idempotenten Schreibvorgang sicher. Miss Recovery-Rate, Retries und Eskalationen auf deiner eigenen Task-Suite.
Den Vertrag ausprobieren
Installiere im Begleit-Repository die gelockten Abhängigkeiten und führe die Tool-Tests aus:
uv sync --locked
uv run pytest tests/test_tools.py -q
Der Snapshot-Test injiziert synthetische Marktdaten und prüft Ticker, Kurs, Volumen, Bewertungsfelder und Zusammenfassung. Er testet den Tool-Vertrag ohne Live-Kurs und ohne Model; er misst nicht, ob ein Agent das richtige Tool wählt. Mit Anbieter-Credentials, konfiguriert wie im README des Repositorys beschrieben, kannst du auch uv run market-analyst "NVDA price update" --mode flash --no-persist ausführen, um einen Entwurf aus dem Agent-Pfad zu prüfen. Dieser Lauf nutzt Live-Services und ist ein Beispiel, kein Benchmark.
Das Ausführungs-Interface wählen
Sobald der Action-Vertrag klar ist, wähle, wie der Agent sie erreicht. Diese Interfaces beantworten verschiedene Fragen; ein neueres ersetzt kein älteres.
Die Abbildung verfolgt jede Route im Market Analyst Agent vom Model bis zur Operation, die sie erreicht.
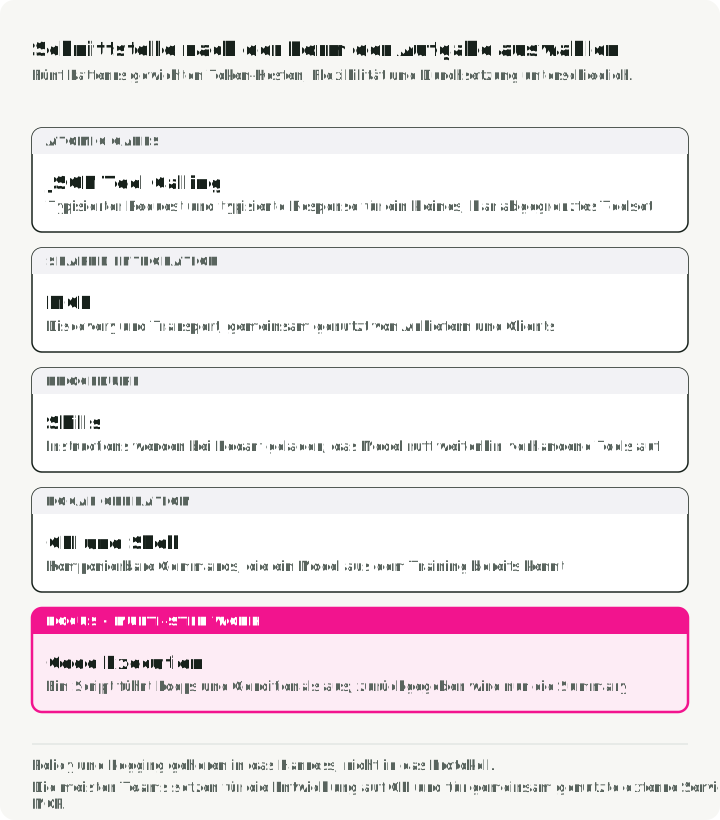
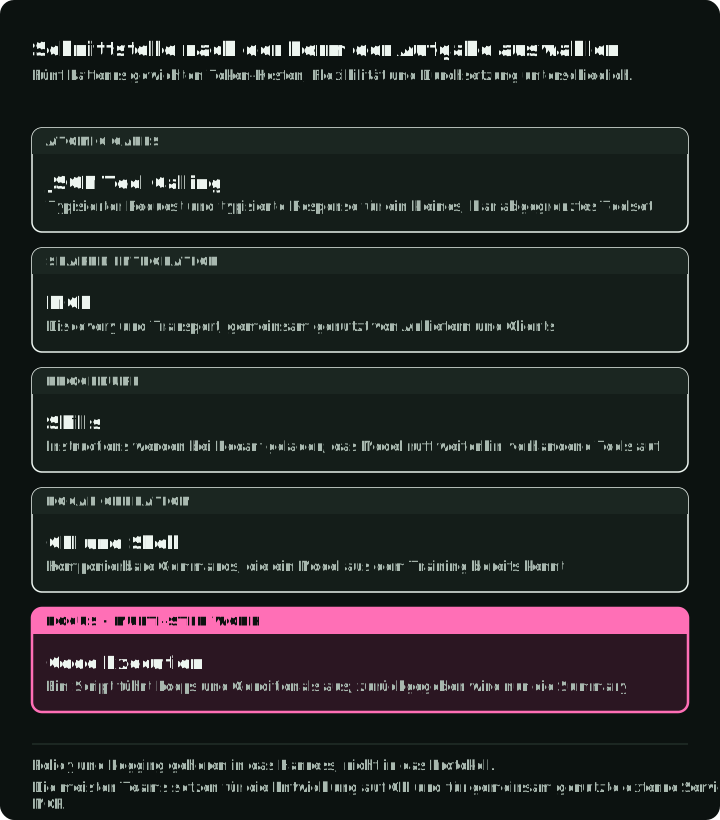
| Bedarf | Einstiegs-Interface | Was es hinzufügt |
|---|---|---|
| Eine kleine Menge typisierter Operationen in einer Anwendung | JSON Tool Calls | Explizite Namen, Argumente und Ergebnisse |
| Dieselben Tools für mehrere Clients | MCP | Gemeinsames Discovery und gemeinsamer Transport |
| Ein bestehendes Kommando mit stabiler Ausgabe | CLI-Wrapper | Wiederverwendung des Kommandos und seiner Hilfe |
| Viele abhängige Operationen oder lokale Datenverarbeitung | Code Execution | Schleifen, Bedingungen und Filterung in einem Lauf |
| Wiederverwendbare Anweisungen für alles oben | Skill | Anleitung, die bei Bedarf geladen wird |
Die Tabelle gibt eine erste Wahl vor; sie rankt die Interfaces nicht nach Leistung. MCP-Tools haben weiterhin Schemas und strukturierte Calls. Ein CLI kann hinter einem JSON-Tool-Wrapper sitzen. Ein Code-Runner kann erlaubte Tools aufrufen. Skills sind Anweisungen zur Nutzung einer Fähigkeit, kein weiterer Ausführungskanal.
Typisierte Calls für eng umrissene Actions
Für get_stock_snapshot(ticker) reicht ein typisierter Call. Das Model liefert einen Ticker; der Harness prüft das Argument, ruft die Implementierung auf und gibt ein strukturiertes Ergebnis zurück. Der nächste Call kann von diesem Ergebnis abhängen. Unabhängige Abfragen können oft parallel laufen, aber ein Call, dessen Argumente vom ersten Ergebnis abhängen, braucht einen weiteren Model-Schritt, sofern nicht Anwendungscode die Operationen kombiniert.
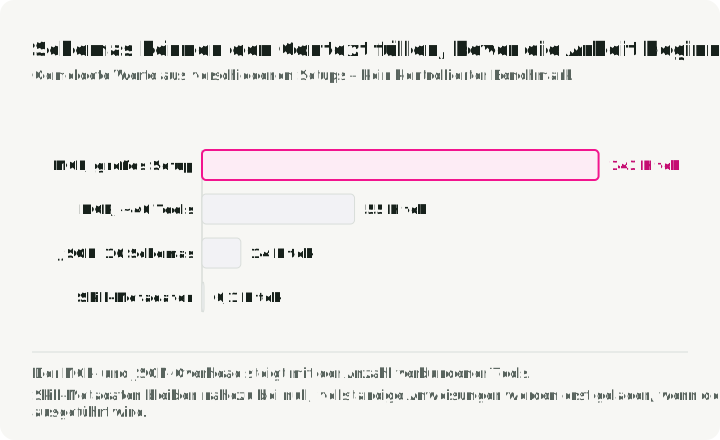
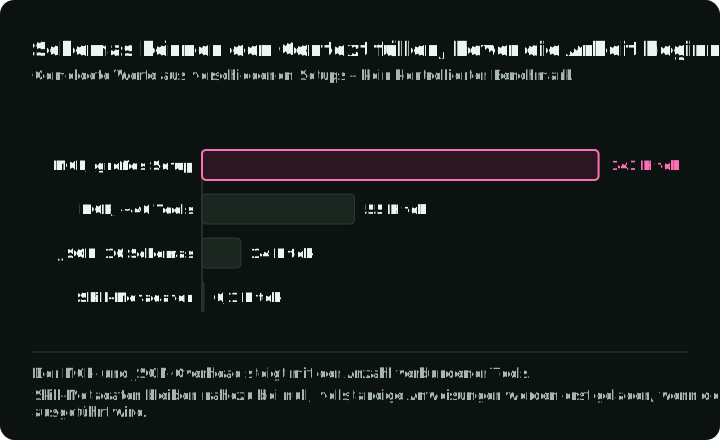
Die geringen Einrichtungskosten sind nützlich, wenn eine Anwendung ein kleines Toolset besitzt. Schema-Tokens zählen trotzdem, wenn Tool-Definitionen in den Kontext geladen werden, also miss die Größe deiner tatsächlichen Definitionen. Wächst der Katalog, kann verzögertes Discovery nur wahrscheinliche Kandidaten laden. In Anthropics Tool-Search-Beispiel sank der ungefähre Kontext vor Arbeitsbeginn in einem Setup mit mehr als 50 Tools von 77.000 auf 8.700 Tokens, weil nur die drei bis fünf Tools geladen wurden, die eine Anfrage braucht. Das ist ein Ergebnis aus seinem Toolset und seiner Retrieval-Methode, und es fügt vor jedem Call einen Discovery-Schritt hinzu. Bei einem kleinen Toolset, das in jeder Session genutzt wird, hilft es weniger. Discovery muss außerdem auf verpasste oder falsche Tools getestet werden.
Das Laden eines Schemas ist tendenziell eine Einbahnstraße: Eine Definition, die das Model zwanzig Schritte später aufrufen darf, muss verfügbar bleiben, und sie zu entfernen verändert den stabilen Teil der Anfrage, von dem Prefix Caching abhängt. Ein Discovery-Schritt fügt deshalb in der Regel Definitionen hinzu und tauscht nie eine aus. Ein Schema, das das Model noch sehen kann, ist außerdem keine Berechtigung, die das Model noch besitzt. Halte die Schema-Version und die tatsächliche Berechtigung zum Zeitpunkt des Discovery fest und prüfe die Berechtigung erneut, wenn der Call zur Ausführung weitergegeben wird.
Wird ein Ergebnis gekürzt, damit es ins Budget passt, sage im Ergebnis selbst, dass es gekürzt wurde, und gib dem Model eine Möglichkeit, einen Zeilen- oder Byte-Bereich der vollständigen Ausgabe abzurufen, damit es eine kurze Antwort von einer abgeschnittenen unterscheiden und den Rest anfordern kann, wenn es darauf ankommt.
Das Diagramm stellt dieses Beispiel auf dieselbe Token-Skala wie die MCP-Setups, die weiter unten in diesem Abschnitt beschrieben werden.
MCP für einen gemeinsamen Service
Mit dem Model Context Protocol kann ein Server Clients über stdio oder HTTP Tools und andere Fähigkeiten anbieten. Der MCP-Client des Agents verbindet sich, fragt den Server, was er anbietet, und leitet die Calls des Models weiter, sodass ein Server mit jedem Client funktioniert, der das Protokoll spricht. Seit Dezember 2025 wird MCP von der Agentic AI Foundation unter der Linux Foundation verwaltet, nicht von einem einzelnen Anbieter.
Nutze MCP, wenn ein Service von mehreren Agent-Hosts erreichbar sein soll, für SaaS-Integrationen wie Figma, Notion oder Salesforce, für Services ohne CLI oder wenn standardisiertes Discovery, OAuth-Handling und Remote-Integration die Kosten für den Betrieb eines Servers rechtfertigen. Der Market Analyst Agent stellt seine Research-Tools auch über einen MCP-Sidecar bereit. Die Aktien-Action ist nicht zu einer anderen Geschäftsoperation geworden, nur weil der Client sie über MCP findet.
Das Protokoll autorisiert keine angeforderte geschäftliche Wirkung. Server und Anwendung brauchen weiterhin Authentifizierung, begrenzte Berechtigungen, Eingabeprüfungen und einen Audit-Eintrag für relevante Operationen. Tool-Beschreibungen und zurückgegebene Dokumente sind ebenfalls nicht vertrauenswürdige Eingaben; Invariant Labs’ Demonstration von Tool Poisoning zeigt, dass bösartige Anweisungen in Tool-Metadaten einen Agent beeinflussen können, bevor das Tool aufgerufen wird. Der MCPTox-Benchmark, der 20 LLM Agents gegen 45 Live-MCP-Server und 353 echte Tools testete, meldete die höchste Angriffserfolgsrate, 72,8 %, für o1-mini in seinem Tool-Poisoning-Setup; das ist das Benchmark-Ergebnis eines Models, keine Vorfallsrate. Das Vulnerable MCP Project sammelt Berichte, die sich als Testfälle eignen. Der Host muss Tool-Text als Daten behandeln, nicht als Erteilung von Befugnissen.
Prüfe, welche MCP-Revision jede Seite unterstützt. Die Revision 2026-07-28 macht Requests zustandslos, ersetzt damit den Initialisierungs-Handshake und entfernt die Wiederaufnahme von Streams, sodass ältere Tutorials möglicherweise nicht zu dem SDK passen, das du installierst. Ein abgebrochener Antwort-Stream braucht dann einen neuen Request, ein weiterer Grund, doppelte geschäftliche Wirkungen im Tool selbst zu verhindern. Prüfe das installierte SDK und den Server-Vertrag, bevor du dich auf ein Feature verlässt. Für einen Aufruf, der länger als eine Antwort dauert, ergänzt die offizielle Tasks-Erweiterung ein dauerhaftes Handle: Der Server gibt eine Task-ID zurück, und der Client fragt die Arbeit mit tasks/get ab oder bricht sie mit tasks/cancel ab. Teil 6 nutzt dieses Handle, wenn ein Aufruf in einen Timeout läuft.
Große Kataloge können teuer werden, wenn jede Beschreibung für jede Anfrage geladen wird. Apideck beschreibt ein verbreitetes Setup, GitHub, Slack und Sentry mit etwa 40 Tools, das rund 55.000 Tokens an Definitionen lädt, bevor der Nutzer etwas fragt, und zitiert ein Team, dessen drei MCP-Server 143.000 von 200.000 Kontext-Tokens belegten. Beides sind berichtete Zahlen, keine Messungen deines Katalogs. Das ist eine Entscheidung über das Laden von Schemas, kein inhärenter Preis des MCP-Wire-Protokolls. Lade nach Möglichkeit eine kleinere relevante Menge und miss, ob Discovery weiterhin das richtige Tool findet.
CLI-Wrapper für etablierte Kommandos
Ein CLI ist attraktiv, wenn die Operation bereits als Kommando mit nützlichem --help, stabilen Exit-Codes und maschinenlesbarer Ausgabe existiert. Die CLI-Tools des Market Analyst Agent wrappen zwei bestimmte Kommandos zum Auflisten und Anzeigen gespeicherter Berichte. Sie übergeben eine Argumentliste an subprocess.run und fordern JSON an; der Agent erhält keine beliebige Shell. Diese Unterscheidung macht die erlaubte Action sichtbar und vermeidet, jeden generierten Kommando-String als vertrauenswürdig zu behandeln.
Ein breit dokumentiertes Kommando wie git, gh, docker, kubectl, curl oder jq braucht für einen Coding Agent vielleicht wenig neue Dokumentation, aber ein internes CLI braucht weiterhin Beispiele und Ausgabeverträge. Ugo Enyiohas Leitfaden Writing CLI Tools That AI Agents Actually Want to Use nennt acht Regeln für ein solches Kommando:
- Unterstütze strukturierte Ausgabe mit
--json. - Nutze verschiedene Exit-Codes für verschiedene Fehlerarten.
- Mache Kommandos idempotent.
- Biete
--helpmit realistischen Beispielen. - Unterstütze Komposition:
--quietfür reine Werte und Eingabe über stdin. - Biete
--dry-runund--yes. - Gib die Version des Tools aus.
- Nimm Credentials aus Umgebungsvariablen.
Eine Shell bringt Pipes und Komposition, zusammen mit Zugriff auf Dateien, Prozesse, Credentials und Netzwerkpfade. Gib ihr nur den Zugriff, den der Task erfordert. Ein CLI hat kein Discovery- oder Autorisierungsmodell auf Protokollebene; der Harness muss Policies durchsetzen und die Calls protokollieren, die er auditieren muss. Ein praktischer Standard ist CLI für Entwicklung und lokale Operationen und MCP für gemeinsame externe Services, wenn clientübergreifendes Discovery oder OAuth-Handling den Betrieb eines Servers wert ist.
In Scalekits Vergleich mit 75 Läufen verbrauchte CLI bei fünf lesenden GitHub-Tasks weniger Tokens als eine Konfiguration, die 43 MCP Tool Schemas lud. Seine sieben MCP-Fehler waren Verbindungs-Timeouts zum Remote-Server. Diese Ergebnisse vergleichen die jeweils eingesetzten Interfaces, keine allgemeine Eigenschaft, dass CLI zuverlässiger ist oder MCP mehr Kontext braucht. Führe den Vergleich mit den Kommandos, dem Server und der Discovery-Policy durch, die du tatsächlich einsetzen würdest.
Code Execution für Komposition
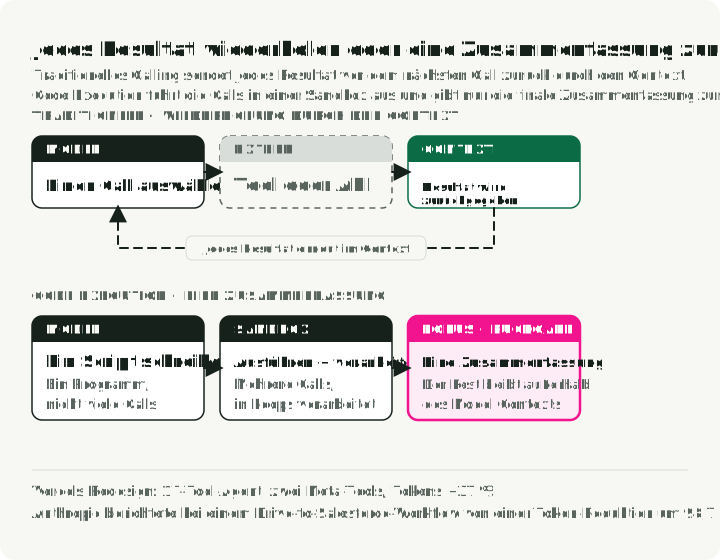
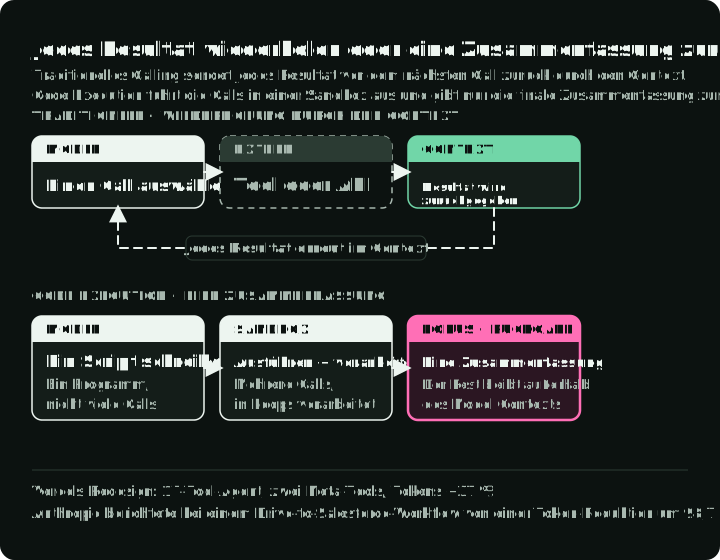
Ein generiertes Programm ist nützlich, wenn der Agent viele Calls kombinieren, Zwischendaten filtern oder über ein großes Ergebnis rechnen muss. Statt jede Zeile durch das Model zu schicken und es die nächste Operation planen zu lassen, kann eine Runtime eine Schleife ausführen und die relevante Zusammenfassung zurückgeben. Das CodeAct-Paper testete 17 Models und fand auf seinen 82 Multi-Tool-Tasks einen um bis zu 20 Prozentpunkte höheren Task-Erfolg, mit bis zu 30 % weniger Actions als JSON-Alternativen. Das ist ein Beleg dafür, das Interface bei ähnlicher Arbeit auszuprobieren, kein Grund, eine einzelne typisierte Abfrage durch einen Code-Runner zu ersetzen.
Die Abbildung führt Anthropics unten beschriebene Spesenprüfung auf beide Arten aus und vergleicht, was den Kontext des Models erreicht.
Hier gibt es zwei verschiedene Muster. Das Code-Tool des Market Analyst Agent akzeptiert Python für Berechnungen auf Daten, die ihm bereits übergeben wurden. Es lässt diesen Code keine Marktdaten-Tools aufrufen. Es prüft die Knoten des Syntaxbaums und führt den Code dann im Anwendungsprozess aus. Diese Allowlist ist eine didaktische Einschränkung, keine Security-Sandbox für nicht vertrauenswürdigen Code. Bevor beliebiger generierter Code oder sensible Prozessressourcen zugänglich werden, braucht die Ausführung eine isolierte Runtime mit Ressourcen- und Zugriffsgrenzen.
Anthropics Programmatic Tool Calling (PTC) ist eine andere Anordnung: Generierter Code kann gezielt aktivierte Tools in einer verwalteten Ausführungsumgebung aufrufen und ein ausgewähltes Ergebnis in den Model-Kontext zurückgeben. In Anthropics Beispiel zur Spesenanalyse braucht Tool-für-Tool-Calling mehr als 20 Model-Durchläufe, wobei jede Zeile durch den Kontext fließt; generierter Code reduzierte das, was den Kontext erreichte, von etwa 200 KB Spesenzeilen auf 1 KB Ergebnisse. Das Skript unten zeigt diesen Kontrollfluss mit gewöhnlichen asynchronen Python-Adaptern, nicht mit den nativen PTC-Wrappern:
# Custom async adapters that return decoded Python objects, not native PTC wrappers.
import asyncio
import json

async def main() -> None:
    team = await get_team_members("engineering")
    levels = list({member["level"] for member in team})
    budgets = dict(zip(levels, await asyncio.gather(*(get_budget_by_level(l) for l in levels))))
    expenses = await asyncio.gather(*(get_expenses(member["id"], "Q3") for member in team))
    over_budget = []
    for member, rows in zip(team, expenses):
        total = sum(row["amount"] for row in rows)
        limit = budgets[member["level"]]["travel_limit"]
        if total > limit:
            over_budget.append({"name": member["name"], "spent": total, "limit": limit})
    print(json.dumps(over_budget))  # Only this summary returns to the model

asyncio.run(main())
Native PTC-Wrapper unterscheiden sich von diesen Adaptern in Argument- und Rückgabeformaten, und nicht jeder Tool-Typ kann aus Code aufgerufen werden; prüfe den aktuellen Leitfaden, bevor du ein Skript portierst. Die API-Einstellung allowed_callers steuert den Aufruf, ersetzt aber nicht die Autorisierung jeder zugrunde liegenden Wirkung durch den Host, einschließlich eines unerwarteten direkten Calls. Zwischenzeilen aus dem Model-Kontext herauszuhalten spart Tokens, macht sie aber weder vertraulich gegenüber der Ausführungsumgebung noch von Logging und Zugriffskontrollen ausgenommen.
Der Nutzen hängt von der Form des Tasks ab. In Anthropics internen Evaluationen verbrauchte ein Projektmanagement-Benchmark mit 75 Tools etwa 38 % weniger abgerechnete Input-Tokens bei unveränderter Genauigkeit. Bei tau2-bench-Tasks mit ein oder zwei sequenziellen Calls pro Turn blieben die Scores unverändert, und die Kosten lagen etwa 8 % höher. Ein separates Drive-to-Salesforce-Beispiel sank von etwa 150.000 auf 2.000 Tokens, eine Reduktion um 98,7 % für diesen Workflow. Keine dieser Zahlen ist eine universelle Rate für Code gegenüber JSON. Codegenerierung, Runtime-Start, Fehler und Ausgabeverarbeitung können bei einfachen Tasks die Kontexteinsparungen übersteigen.
Zwei Fallstudien von Anbietern zeigen dasselbe Design in Produkten. Vercel baute seinen Text-to-SQL Agent d0 um zwei allgemeine Tools herum neu, ExecuteCommand und ExecuteSQL, statt der 17, die sein altes Beispiel nannte. Über fünf repräsentative Abfragen berichtet es einen Anstieg des Erfolgs von 4/5 auf 5/5, eine Senkung der durchschnittlichen Zeit von 274,8 s auf 77,4 s und 37 % weniger Tokens. Bei Cloudflares Code Mode schreiben Agents TypeScript gegen eine API, statt Tool Schemas aufzurufen, mit der Begründung, dass Models weit mehr echtes TypeScript gesehen haben als Beispiele für Tool Calls. Behandle beides als Belege von Anbietern und wiederhole den Vergleich auf deinen Tasks.
JSON Tool Calling bleibt die bessere Wahl für einzelne atomare Operationen, Umgebungen ohne Sandboxing, kleinere Models mit schwacher Codegenerierung und Audit-Regeln, die einen Eintrag für jeden einzelnen Call verlangen.
Skills für Abläufe
Ein Agent Skill bündelt eine Datei SKILL.md mit Name, Beschreibung und Anweisungen; er kann außerdem Skripte und Referenzen enthalten. Der offene Standard verlangt nur name und description. Ein minimaler Skill für diesen Agent könnte so aussehen:
---
name: stock-overview
description: Prepare a short overview of one stock. Use when the user asks for a current snapshot of a company.
---
1. Call get_stock_snapshot for the ticker.
2. If the result has no market timestamp, say that freshness is unknown.
3. Call search_news only if the user asked about recent events.
4. Cite every news item you use.
Der Skill sagt dem Agent, wie er seine Tools nutzt; er fügt keine neue Fähigkeit hinzu. Nutze Skills für Domänenwissen, mehrstufige Abläufe und wiederkehrende Arbeit wie Datenbankmigrationen oder Zahlungsintegrationen. Der Host bestimmt weiterhin, welche Tools der Agent ausführen darf. Der Text eines Skills ist Anleitung, keine Durchsetzung von Policies.
Das Format unterstützt, zuerst den kurzen Namen und die Beschreibung zu laden, etwa 100 Tokens, vor den vollständigen Anweisungen; referenzierte Skripte und Dateien werden nur bei Bedarf geladen. Das hilft, wenn viele Abläufe existieren, aber der aktive Skill und alle Dateien, die er lädt, verbrauchen weiterhin Kontext. Prüfe seine Anweisungen und ausführbaren Dateien wie jede andere Eingabe in den Harness. Ist ein Workflow sicherheitskritisch, kodiere die erforderliche Validierung im Tool oder in der Anwendung, statt dich darauf zu verlassen, dass eine Anweisung befolgt wird.
Ein geladener Skill kann Ergebnisse auch verschlechtern. Eine Studie von 2026 zu SkillsBench und SWE-Skills-Bench führte 307 Fehlschläge auf bestimmte geladene Skills zurück: 125 funktionale Fehler, bei denen das Ergebnis der Aufgabe falsch war, und 182 Effizienzrückgänge, bei denen der Lauf mehr kostete. Das sind Fehler, die die Autoren in zwei Benchmarks zuordnen konnten, keine Fehlerrate für Skills im Allgemeinen. Teste einen neuen Skill auf repräsentativen Aufgaben mit und ohne ihn, bevor du dich darauf verlässt. Die Agent-Framework-Richtlinien von Microsoft beschränken Skills außerdem auf idempotente oder risikoarme Operationen und bevorzugen einen expliziten Workflow, wenn ein Schritt einen Seiteneffekt hat, etwa eine Zahlung, der sich bei einem Retry nicht wiederholen darf. Die Skill-Tools verlangen standardmäßig eine Genehmigung.
Die Interfaces vergleichen
| Frage | JSON Tool Calls | MCP | Skills | CLI | Code Execution |
|---|---|---|---|---|---|
| Am besten für | Einfache, einzelne Actions | Gemeinsame Services über Clients hinweg | Wiederverwendbare Abläufe für ein anderes Interface | Entwicklung und lokale Operationen | Mehrstufige Arbeit über große Ergebnisse |
| Kontextkosten | Geladene Schemas | Geladene oder verzögerte Schemas | Etwa 100 Tokens bis zur Aktivierung | Hilfetext, Kommando und Ausgabe | Einstiegs-Schemas, Code und Ausgabe |
| Abhängige Calls | Meist ein Model-Turn pro Call | Ein Model-Turn plus Transport | Folgt dem zugrunde liegenden Interface | Meist ein Model-Turn pro Call | Ein Skript-Turn; die Runtime führt den Ablauf aus |
| Angriffsfläche | Befugnis über Argumente und Wirkung | Server-Identität und Tool-Befugnis | Der Host und die Ressourcen, die er gewährt | Shell, Pfade, Credentials | Code, Datenzugriff und ausgehender Netzwerkverkehr |
| Einrichtung | Gering | Server-Deployment | Gering; hängt vom zugrunde liegenden Interface ab | Sehr gering für bestehende Kommandos | Eine Sandbox-Runtime |
| Debugging | Strukturierte Ein- und Ausgabe | Fügt eine Transportschicht hinzu | Lesbares Markdown | Kommandos sind sichtbar | Lesbarer Code |
Skills steuern eines der anderen vier Interfaces, daher folgen ihre Latency und Einrichtung dem Interface, das sie wählen. Die Zeilen fassen die zitierten Beispiele zusammen, nicht einen kontrollierten Benchmark über alle fünf.
Einige Trade-offs ziehen sich durch die Tabelle. Code Execution kann Kontext sparen, fügt aber Generierungs- und Container-Zeit hinzu. MCP spart Integrationsarbeit, fügt aber einen zu betreibenden Server hinzu. CLI kostet zum Start nichts und ist im großen Maßstab schwerer zu steuern. Passe das Interface an dein Team an: Code Execution setzt ein Model voraus, das zuverlässigen Code schreibt, CLI setzt Unix-Konventionen voraus, und MCP setzt Vertrautheit mit Transports und OAuth voraus. Das Zusammenfassen von Tools kann auch zu weit gehen, wenn ein Tool unzusammenhängende Modi bündelt. Strukturierte Calls lassen sich leicht protokollieren, aber kein Protokoll erzeugt von selbst einen vollständigen Audit-Eintrag; Host, Server oder Harness protokollieren Calls und Ergebnisse und setzen Policies durch.
Ein erstes Test-Set für das Interface
Eine kleinere Tool-Liste oder ein günstigerer Prompt ist nur nützlich, wenn der Agent die Arbeit weiterhin erledigt. Vergleiche Interfaces mit demselben Task-Set, Model, denselben Daten, erlaubten Operationen und Abschlussregeln. Nimm Fälle auf, in denen der richtige nächste Schritt eine Rückfrage oder ein Abbruch ist.
Für den Market Analyst Agent könnte ein erstes Test-Set diese Fälle enthalten:
| Anfrage oder Bedingung | Was zu prüfen ist |
|---|---|
| Einfacher Aktienüberblick | Richtiger Ticker, Snapshot-Felder, Quelle und Marktzeit in der Antwort |
| Kursverlauf nötig, aber keine News | Der Agent wählt den Kursverlauf ohne unnötige Calls |
| Anbieter liefert keinen gültigen Kurs | Kein erfundener Kurs; der Lauf meldet nicht verfügbare Daten |
| Große Menge unabhängiger Abfragen | Qualität der finalen Antwort, Model-Turns, Input-/Output-Tokens, Latency und Runtime-Fehler |
| Vorgeschlagener Trade während einer Research-Anfrage | Keine Trade-Wirkung; die Research-Tool-Liste gewährt diese Action nicht |
Protokolliere die Tool Calls und ihre Ergebnisse ebenso wie die finale Antwort. Ein plausibler Bericht kann eine fehlgeschlagene Abfrage verbergen; ein korrekter finaler Kurs kann unnötige Calls verbergen. Wenn sich ein Interface ändert, zähle sowohl erfolgreiche Tasks als auch neue Fehlerarten: falsche Tool-Auswahl, ungültige Argumente, verpasstes Discovery, wiederholte Seiteneffekte, Syntaxfehler und Timeouts. Erfasse auch Discovery-Tokens, gecachten und nicht gecachten Input sowie Retries.
Du kannst das Interface dann ändern, wenn eine Messung das stützt. Behalte einen typisierten Call, solange er den Task sauber beantwortet. Ergänze MCP, wenn gemeinsames Discovery nötig ist, einen CLI-Wrapper, wenn ein bestehendes Kommando die klarste Operation ist, oder Code Execution, wenn gemessene Gewinne durch Komposition ihre Runtime rechtfertigen. Der Action-Vertrag, also was geschehen darf, welches Ergebnis es belegt und was ein Fehler bedeutet, muss weiterhin explizit sein.
Drei Richtungen für Tool Use im großen Maßstab
Tool-Retrieval. Bevor das Model wählt, rufe die wenigen Tool-Beschreibungen ab, die zur Anfrage passen. Im Benchmark und MCP-Stresstest von RAG-MCP hob Retrieval die Genauigkeit der Tool-Auswahl von 13,62 % auf 43,13 % und senkte die Prompt-Tokens von etwa 2.134 auf 1.084. Die Beschreibungen des Setups weichen zwischen den Abschnitten des Papers voneinander ab, was die Übertragbarkeit der Zahlen begrenzt.
Agents, die Tools bauen. Bei LATM schreibt ein starkes Model wiederverwendbare Python-Funktionen, die ein kleineres Model dann aufruft. ToolMaker implementierte 12 von 15 Tasks korrekt, die aus Papers mit öffentlichem Code gebaut wurden. Dieser kleine Benchmark belegt keine Zuverlässigkeit in Produktion, weist aber auf die Verwaltung einer Bibliothek generierter Tools hin.
A2A neben MCP. Google übergab A2A im Juni 2025 an die Linux Foundation. Die A2A-Dokumentation teilt die Rollen auf: MCP verbindet einen Agent mit Tools und Ressourcen, während A2A getrennte Agents einander finden, Tasks teilen und Arbeit delegieren lässt.
Teil 4, AI Agent Security, verfolgt die vorgeschlagene Action bis zu ihrer Berechtigungsprüfung. Teil 5, Agent Runtime, verlegt die Ausführung in eine wiederherstellbare Runtime. Teil 6, Harness Engineering für AI Agents, führt Loop, Tools, Policy und Abschlussprüfung zusammen.
Referenzen
Papers
- Executable Code Actions Elicit Better LLM Agents (CodeAct) — Wang et al., ICML 2024
- SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering — Yang, Jimenez et al., NeurIPS 2024
- RAG-MCP: Mitigating Prompt Bloat in LLM Tool Selection
- LLMs As Tool Makers (LATM) — Cai et al., 2023
- ToolMaker: LLM Agents Making Agent Tools — Wölflein et al., ACL 2025
- MCPTox: A Benchmark for Tool Poisoning Attack on Real-World MCP Servers
- Agent Skills Can Be Harmful: An Empirical Study of Skill-Induced Failures in LLM Agents — Dong et al., 2026
Engineering-Artikel und Dokumentation von Anthropic
- Advanced tool use — Tool Search, Programmatic Tool Calling und Input-Beispiele
- Programmatic tool calling — aktueller API-Leitfaden und Einschränkungen
- Code execution with MCP — das Drive-to-Salesforce-Beispiel
- Writing effective tools for agents
- Building effective agents
Protokolle
- Model Context Protocol-Spezifikation, 2026-07-28 und Changelog
- MCP Tasks extension
- Agent-Skills-Spezifikation
- Microsoft Agent Framework: Agent Skills
- A2A and MCP
Fallstudien und Security
- Vercel: We removed 80% of our agent’s tools
- Cloudflare: Code Mode
- Apideck: MCP server eating your context window
- Scalekit: MCP vs CLI
- Invariant Labs: MCP tool poisoning attacks
- Vulnerable MCP Project
- Writing CLI Tools That AI Agents Actually Want to Use — Ugo Enyioha
Demo-Projekt
- Market Analyst Agent — Tool-Konsolidierung und ACI-Muster