Korzystanie z narzędzi przez agentów AI: MCP, CLI, Skills i wykonywanie kodu

Tłumaczenie automatyczne
Ten artykuł został automatycznie przetłumaczony z angielskiego oryginału.
Ten artykuł jest dla inżynierów, którzy dają agentowi dostęp do danych, poleceń lub usług zewnętrznych. Dowiesz się, jak zdefiniować akcję, z której agent może niezawodnie korzystać, jak wybrać dla niej interfejs wykonawczy i jak sprawdzić, czy ten interfejs pomaga w twoich zadaniach. Przykładem prowadzonym przez cały tekst jest Market Analyst Agent, agent badawczy, który pobiera dane rynkowe i przygotowuje raporty.
W części 1 model wybierał następny krok w pętli rozumowania. Część 2 dotyczyła tego, co może zachować między krokami. Narzędzie nadaje temu wyborowi skutek poza modelem: może pobrać notowanie, odczytać zapisany raport, wykonać kod albo zmienić rekord. Program wokół modelu, czyli harness, nadal decyduje, które z tych akcji istnieją i czy proponowane wywołanie może zostać wykonane.
Pierwsza decyzja projektowa dotyczy samej akcji. Jeśli agent potrzebuje do jednego raportu danych o cenie i wycenie, czy powinien wywołać dwa endpointy API, pobrać jeden snapshot akcji, czy wygenerować program? Odpowiedź zależy od zadania i informacji zwrotnej, której agent potrzebuje, a nie od protokołu integracji.
Krótką decyzję o wyborze interfejsu opisuje artykuł Interfejsy narzędzi agentów AI.
Czego wymaga przegląd spółki
Załóżmy, że użytkownik prosi Market Analyst Agent o aktualny przegląd spółki. Agent może potrzebować bieżącego notowania, wolumenu obrotu, wskaźników wyceny, historii cen i wiadomości. To różne pytania. Ostatnie notowanie i podstawowe wskaźniki często trafiają do tej samej odpowiedzi, a historia cen i wiadomości mogą być zbędne w krótkiej odpowiedzi. Niezwiązana możliwość zawarcia transakcji nie powinna trafić na tę ścieżkę badawczą.
Zanim udostępnisz API, zapisz cztery rzeczy:
- Akcja: O co agent może poprosić w jednym kroku? Wybieraj operację, która odpowiada pytaniu, na które naprawdę musi odpowiedzieć.
- Argumenty: Które dane wejściowe musi podać wywołujący, a które aplikacja może zweryfikować przed kontaktem z usługą?
- Wynik: Jakie fakty pozwalają agentowi wybrać następny krok i jakie informacje o pochodzeniu lub identyfikatory muszą przetrwać na potrzeby późniejszych kontroli?
- Błąd i skutek: Co może się zmienić, jak wywołujący może stwierdzić, czy akcja się wykonała, i kiedy ponowienie jest bezpieczne?
Te pytania rozdzielają trzy odpowiedzialności. Model proponuje akcję. Harness ją waliduje i kieruje dalej. Implementacja narzędzia ją wykonuje i zwraca wynik. JSON Schema może odrzucić niepoprawnie sformułowany ticker; nie może ustalić, że transakcja jest autoryzowana. Protokół może dostarczyć wywołanie narzędzia; nie może sprawić, że powtórzenie nieudanego zapisu będzie bezpieczne.
Praca o SWE-agent nazywa projekt tej interakcji Agent-Computer Interface (ACI), przez analogię do interakcji człowiek-komputer: agenci oparci na modelach językowych to nowy rodzaj użytkownika i korzystają na interfejsach zbudowanych z myślą o nich. Jej ablacja na 300 zadaniach SWE-bench Lite osiągnęła 18,0% z pełnym interfejsem, wobec 7,3% w wariancie tylko z powłoką bez rozpisanej demonstracji i 11,0% z demonstracją. Warianty różnią się czymś więcej niż jednym opisem narzędzia, więc te liczby nie przewidują zysku z przeprojektowania twoich własnych narzędzi. Pokazują jednak, że interfejs trzeba testować razem z modelem. Building Effective Agents od Anthropic mówi to samo: zaplanuj tyle pracy nad interfejsem agent-komputer, ile nad interfejsem dla ludzi.
Rysunek śledzi jedno wywołanie get_stock_snapshot przez model, harness i narzędzie oraz numeruje każdy krok zasadą z poniższej listy, która go dotyczy. Sprawdzenie braku ceny jest zaleceniem: implementacja snapshotu we wskazanej rewizji obecnie domyślnie zastępuje brakującą cenę zerem.
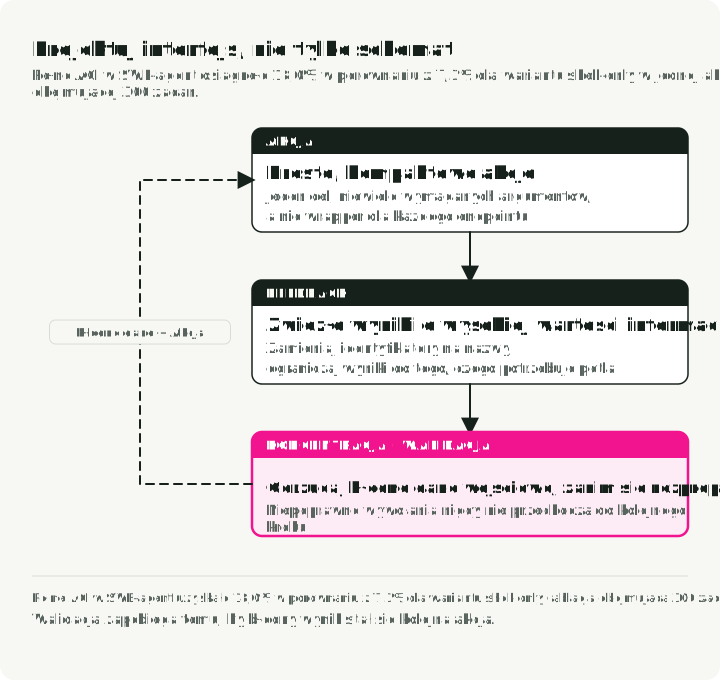
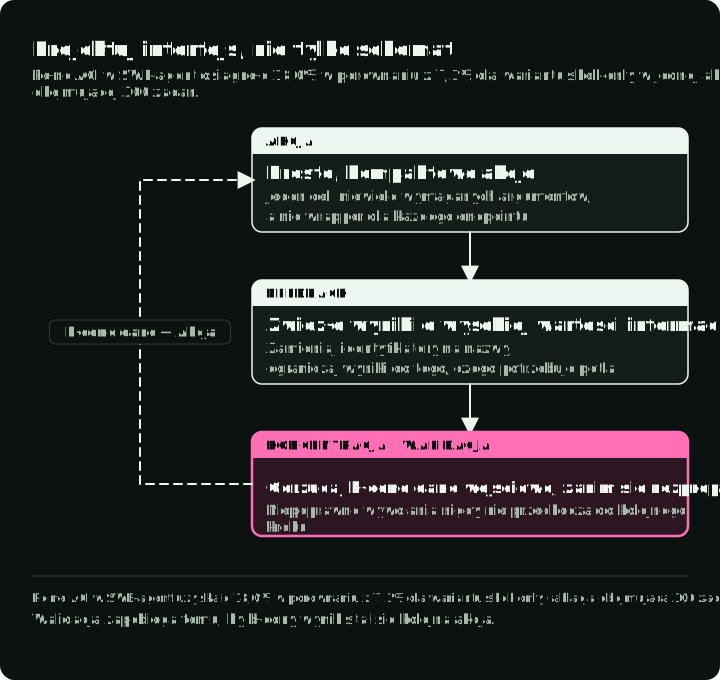
Cztery zasady ACI dotyczą każdego interfejsu w tym artykule:
- Proste akcje. Nie opakowuj endpointów API jeden do jednego. Zamiast
list_users,list_eventsicreate_eventudostępnijschedule_event, które znajduje wolny termin i rezerwuje go w jednym wywołaniu. Zamiastread_logsudostępnijsearch_logs, które zwraca istotne wiersze z kontekstem. - Zwarte akcje. Łącz operacje, które służą jednemu zadaniu, tak jak robi to opisany niżej snapshot akcji.
- Zwięzła, informatywna odpowiedź. Zwracaj nazwy semantyczne zamiast surowego HTML, pełnych payloadów API lub niejasnych identyfikatorów, ale zachowuj każdy identyfikator, którego potrzebuje późniejsze wywołanie.
- Walidacja, która zatrzymuje rozprzestrzenianie się błędów. Sprawdzaj argumenty przed wywołaniem, a wyniki przed następną akcją. W SWE-agent edytor z wbudowanym lintingiem odrzucał błędy składni; jego włączenie podniosło wynik wariantu edycji z 15,0% do 18,0%.
Narzędzie łatwe do wyboru i użycia
Market Analyst Agent daje konkretny przykład. Wcześniejsza wersja udostępniała get_stock_price i get_company_metrics osobno. Executor udostępnia teraz get_stock_snapshot, get_price_history, get_financials, search_news i search_competitors. Snapshot łączy cenę, wolumen, kapitalizację rynkową i wskaźnik C/Z, bo podstawowy przegląd zwykle potrzebuje ich razem. Historia, sprawozdania finansowe i wiadomości pozostają osobno, bo agent może nie potrzebować każdego z nich.
| Przed (pierwotne narzędzia) | Po (narzędzia danych rynkowych) | Dlaczego |
|---|---|---|
get_stock_price + get_company_metrics | get_stock_snapshot | Jedno wywołanie zwraca podstawowy snapshot ceny i wyceny |
get_price_history | get_price_history | Zachowane, z walidowanymi okresami i podsumowaniem średniego wolumenu |
search_news | search_news | Zwraca ustrukturyzowane pozycje z wyodrębnionymi najważniejszymi punktami |
search_competitors | search_competitors | Zachowuje akcję wyszukiwania skupioną na konkurentach |
| Brak narzędzia do sprawozdań finansowych | get_financials | Wybiera parametrem rachunek zysków i strat, bilans lub przepływy pieniężne |
Lista narzędzi agenta zawiera też loader skills, dwa wrappery CLI i ograniczony ewaluator Pythona działający w procesie, więc obejmuje trzy z opisanych niżej interfejsów; MCP występuje jako osobny sidecar.
To decyzja o rozmiarze akcji. Wrapper jeden do jednego wokół każdego endpointu upstream zmusza model do planowania według układu API dostawcy. Jedno narzędzie z wieloma niezwiązanymi trybami tylko przenosi problem wyboru do swoich argumentów. Grupuj pola, które służą temu samemu zadaniu, a potem sprawdzaj, czy agenci wybierają właściwą akcję.
Pisz opis dla modelu
Opis snapshotu mówi, kiedy wywołać go najpierw, co zwraca i kiedy zamiast niego wybrać historię lub sprawozdania finansowe. Ta wskazówka dotycząca sąsiednich narzędzi jest równie ważna jak nazwa. „Search for items” nie powie modelowi, czy na prośbę odpowiada search_news, czy search_competitors. Przewodnik Anthropic po projektowaniu narzędzi również zaleca opisy, przykłady i wyniki, które pomagają modelowi wybrać właściwą akcję, a dokumentacja definiowania narzędzi sugeruje co najmniej trzy lub cztery zdania o tym, kiedy używać narzędzia, jakie ma parametry, co zwraca i jakie są przypadki brzegowe:
# Vague: the model cannot tell when to use it.
vague = [{"name": "search", "description": "Search for items"}]

# Specific: when to use it, what it returns, and which tool to use instead.
specific = [{
    "name": "search_news",
    "description": (
        "Search for recent news articles about a specific stock or company. "
        "Use this tool when the user asks about recent events, earnings, "
        "announcements, or market-moving news for a specific ticker. "
        "Returns up to 10 articles sorted by relevance. "
        "For company competitors rather than news, use search_competitors instead."
    ),
    "input_schema": {
        "type": "object",
        "properties": {
            "query": {
                "type": "string",
                "description": "Search query. Examples: 'NVDA earnings Q3 2025', 'Tesla delivery numbers'",
            },
            "max_results": {
                "type": "integer",
                "description": "Max articles to return (1-10, default 5)",
                "default": 5,
            },
        },
        "required": ["query"],
    },
}]
Dodawaj przykłady tam, gdzie parametry są niejednoznaczne; nie wydawaj kontekstu na powtarzanie tego, co mówi już prosty schemat. W wewnętrznych testach Anthropic dodanie pola input_examples podniosło dokładność obsługi złożonych parametrów z 72% do 90%. Anthropic podaje też, że przestrzeń nazw w prefiksie lub sufiksie (asana_search albo search_asana) miała zauważalny wpływ na jego ewaluacje, ale nie mówi, który wariant wygrał, więc przetestuj oba na własnym zestawie narzędzi. Następnie przekazał transkrypcje z ewaluacji Claude Code, aby przepisał narzędzia, i na odłożonych testach ta pętla wypadła lepiej niż narzędzia napisane przez ekspertów.
Waliduj argumenty i kształtuj wyniki
Implementacja waliduje ticker przed zapytaniem o dane rynkowe. Ten fragment jest zaadaptowany z podlinkowanego kodu; wspólny normalizator usuwa białe znaki, zamienia wartość na wielkie litery i akceptuje sufiksy z kropką lub łącznikiem, takie jak BRK.B i BF-B. Zapytanie o historię dodaje dozwolony zbiór okresów:
from pydantic import BaseModel, Field, field_validator

from market_analyst.utils import normalize_ticker

class StockQuery(BaseModel):
    ticker: str = Field(description="Stock ticker symbol (e.g., NVDA)")

    @field_validator("ticker")
    @classmethod
    def validate_ticker(cls, value: str) -> str:
        return normalize_ticker(value)

class StockHistoryQuery(StockQuery):
    period: str = Field(default="1mo", description="Time period: 1d, 5d, 1mo, 3mo, 6mo, 1y")

    @field_validator("period")
    @classmethod
    def validate_period(cls, value: str) -> str:
        valid = {"1d", "5d", "1mo", "3mo", "6mo", "1y"}
        if value not in valid:
            raise ValueError(f"Invalid period: {value}. Must be one of {valid}")
        return value
Narzędzia akcji i wiadomości zwracają wyniki walidowane przez Pydantic zamiast surowych payloadów dostawcy. Pole summary daje agentowi gotowy tekst do raportu, a key_points oszczędzają mu parsowania treści artykułów:
from pydantic import BaseModel

class StockSnapshot(BaseModel):
    ticker: str
    price: float
    change_pct: float
    volume: int
    market_cap_b: float
    pe_ratio: float | None
    summary: str  # One line for direct use in a report

class NewsItem(BaseModel):
    headline: str
    source: str
    date: str
    relevance_score: float  # Pre-ranked by the tool
    key_points: list[str]  # Extracted by the tool, not the agent

class NewsSearchResult(BaseModel):
    query: str
    results: list[NewsItem]
    summary: str
Wynik snapshotu ma te typowane pola dla ceny, zmiany procentowej, wolumenu, kapitalizacji rynkowej, wskaźnika C/Z i krótkiego podsumowania. Dodaj do wyniku źródło danych i czas rynkowy, którego dotyczy notowanie, i niech raport je podaje. Pobranie danych teraz nie dowodzi, że notowanie jest aktualne.
Utrzymuj wyniki na tyle krótkie, by wystarczyły do następnej decyzji, ale nie odrzucaj identyfikatora ani źródła, którego potrzebuje późniejsza akcja. W wyniku wyszukiwania tytuł i podsumowanie mogą wystarczyć do uszeregowania kandydatów; URL lub identyfikator musi pozostać dostępny, jeśli agent ma pobrać lub zacytować konkretną pozycję. Wynik zwięzły i szczegółowy mogą służyć różnym krokom: w testach Anthropic dodano parametr response_format, który w trybie zwięzłym zwracał około 72 tokenów, a w szczegółowym 206. Surowe payloady upstream rzadko są użytecznym ustawieniem domyślnym.
Zwracaj błędy, na które pętla może zareagować
Błędy są częścią tego samego kontraktu. Nie ustawiaj brakującej ceny domyślnie na zero, bo wtedy niedostępne notowanie wygląda jak cena zero dolarów. Nie opakowuj też każdego ostatecznego błędu w jeden typ wyjątku, bo wtedy wywołujący nie może wybrać kategorii ponowienia. Odrzucaj brakujące dane rynkowe i odróżniaj nieprawidłowe dane wejściowe, tymczasową awarię dostawcy i niedostępne dane. Narzędzie, które zapisuje stan zewnętrzny, musi też odróżniać znany błąd od wyniku, który mógł się zakończyć mimo utraconej odpowiedzi. Zwracaj tyle szczegółów, by dało się wybrać ponowienie, doprecyzowanie lub eskalację; nie pozwól, by tekst dostawcy stał się instrukcją dla modelu.
Cztery mechanizmy obsługują różne klasy błędów: ponowienie z backoffem dla błędów przejściowych, fallback na inny model przy awariach dostawcy, klasyfikacja, która odsyła błędy możliwe do naprawienia do agenta, a resztę eskaluje, oraz odtwarzanie z użyciem checkpoint po awarii procesu (część 2). Ponawiaj tylko błędy przejściowe, takie jak przekroczenia czasu, błędy sieci oraz odpowiedzi 429 i 5xx, z wykładniczym backoffem i małym limitem prób; biblioteka taka jak Tenacity robi to w dekoratorze. Wywołujący i tak musi zamienić ostateczny wyjątek albo błąd 4xx, którego nie należy ponawiać, w stabilny wynik, który mówi, która operacja się nie powiodła i co zrobić dalej. Ponowienie żądania nie klasyfikuje jego błędu i jest bezpieczne tylko dla odczytu lub idempotentnego zapisu. Mierz skuteczność odtwarzania, liczbę ponowień i eskalacji na własnym zestawie zadań.
Wypróbuj kontrakt
W repozytorium towarzyszącym zainstaluj zablokowane zależności i uruchom testy narzędzi:
uv sync --locked
uv run pytest tests/test_tools.py -q
Test snapshotu wstrzykuje syntetyczne dane rynkowe i sprawdza ticker, cenę, wolumen, pola wyceny i podsumowanie. Testuje kontrakt narzędzia bez notowania na żywo i bez modelu; nie mierzy, czy agent wybiera właściwe narzędzie. Po skonfigurowaniu danych uwierzytelniających dostawcy zgodnie z README repozytorium możesz też uruchomić uv run market-analyst "NVDA price update" --mode flash --no-persist, aby obejrzeć szkic ze ścieżki agenta. To uruchomienie korzysta z usług na żywo i jest przykładem, a nie benchmarkiem.
Wybierz interfejs wykonawczy
Gdy kontrakt akcji jest jasny, wybierz, jak agent do niej dociera. Te interfejsy odpowiadają na różne pytania; nowszy nie zastępuje starszego.
Rysunek pokazuje każdą trasę w Market Analyst Agent, od modelu do operacji, do której prowadzi.
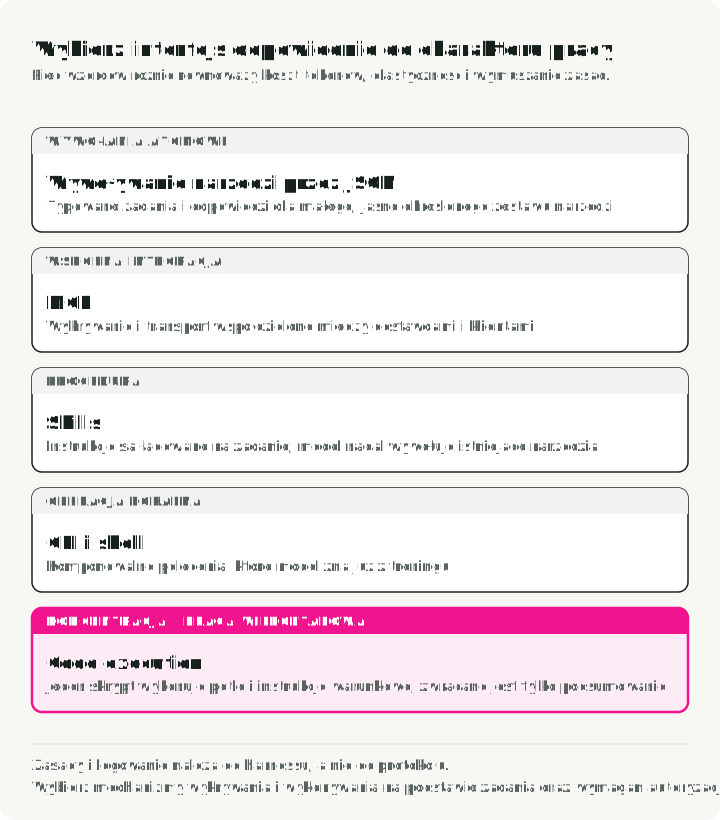
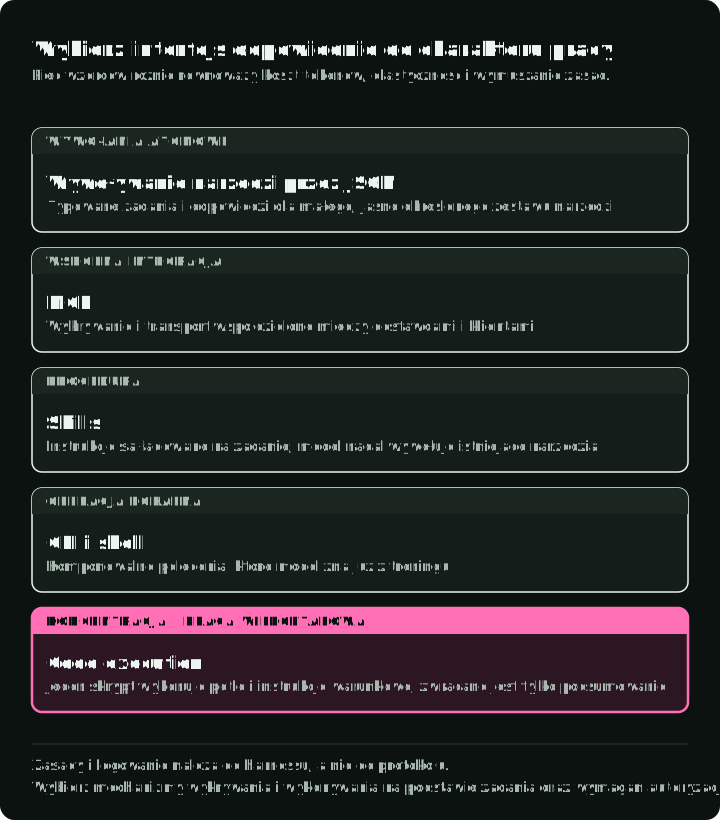
| Potrzeba | Interfejs startowy | Co wnosi |
|---|---|---|
| Mały zestaw typowanych operacji w jednej aplikacji | Wywołania narzędzi JSON | Jawne nazwy, argumenty i wyniki |
| Te same narzędzia udostępniane wielu klientom | MCP | Wspólne wykrywanie i transport |
| Istniejące polecenie ze stabilnym wyjściem | Wrapper CLI | Ponowne użycie polecenia i jego pomocy |
| Wiele zależnych operacji lub lokalne przetwarzanie danych | Wykonywanie kodu | Pętle, warunki i filtrowanie w ramach jednego przebiegu |
| Instrukcje wielokrotnego użytku dla każdej z powyższych opcji | Skill | Wskazówki ładowane, gdy są potrzebne |
Tabela podsuwa pierwszy wybór; nie szereguje interfejsów według wydajności. Narzędzia MCP nadal mają schematy i ustrukturyzowane wywołania. CLI może stać za wrapperem narzędzia JSON. Moduł wykonujący kod może wywoływać dozwolone narzędzia. Skills to instrukcje korzystania z możliwości, a nie kolejny kanał wykonawczy.
Typowane wywołania dla wąskich akcji
Dla get_stock_snapshot(ticker) wystarczy typowane wywołanie. Model podaje ticker; harness sprawdza argument, wywołuje implementację i zwraca ustrukturyzowany wynik. Następne wywołanie może zależeć od tego wyniku. Niezależne zapytania często mogą działać równolegle, ale wywołanie, którego argumenty zależą od pierwszego wyniku, wymaga kolejnego kroku modelu, chyba że operacje łączy kod aplikacji.
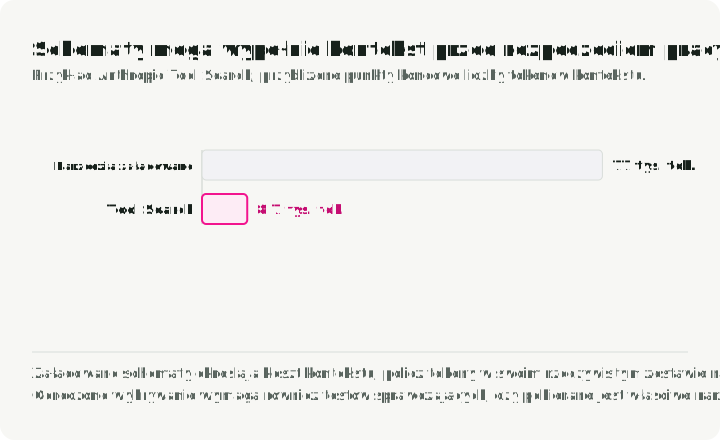
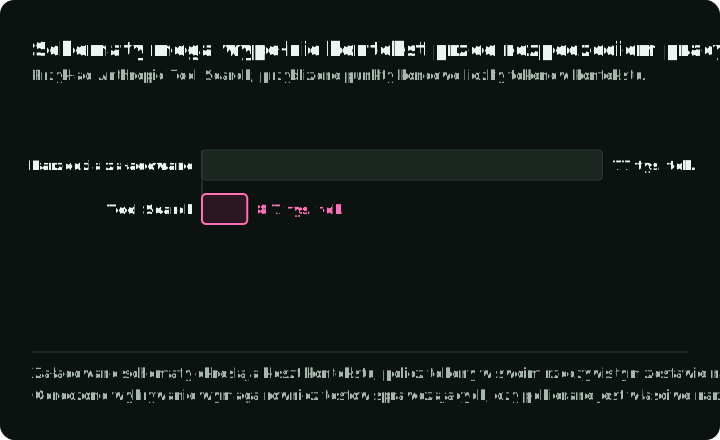
Niski koszt wdrożenia przydaje się, gdy jedna aplikacja ma mały zestaw narzędzi. Tokeny schematów nadal się liczą, gdy definicje narzędzi trafiają do kontekstu, więc zmierz rozmiar swoich rzeczywistych definicji. Gdy katalog rośnie, odroczone wykrywanie może ładować tylko prawdopodobnych kandydatów. W przykładzie Tool Search od Anthropic przybliżony kontekst przed rozpoczęciem pracy spadł z 77 000 do 8700 tokenów w konfiguracji z ponad 50 narzędziami, dzięki ładowaniu tylko trzech do pięciu narzędzi potrzebnych danemu żądaniu. To wynik dla tego zestawu narzędzi i tej metody wyszukiwania, a przed każdym wywołaniem dochodzi krok wykrywania. Mniej pomaga przy małym zestawie narzędzi używanym w każdej sesji. Wykrywanie trzeba też testować pod kątem pominiętych lub błędnych narzędzi.
Ładowanie schematu zwykle jest jednokierunkowe. Definicja, którą model może wywołać dwadzieścia kroków później, musi pozostać dostępna, a jej usunięcie zmienia stabilną część żądania, od której zależy prefix caching, więc krok wykrywania zwykle dodaje definicje i nigdy nie wymienia żadnej. Schemat, który model nadal widzi, nie jest też uprawnieniem, które model nadal posiada. Zapisz wersję schematu i faktyczne uprawnienie w chwili wykrywania, a uprawnienie sprawdź ponownie, gdy wywołanie jest przekazywane do wykonania.
Gdy wynik jest skracany, żeby zmieścić się w budżecie, napisz w samym wyniku, że został skrócony, i daj modelowi sposób zażądania zakresu wierszy lub bajtów pełnych danych wyjściowych, aby odróżniał krótką odpowiedź od uciętej i prosił o resztę, gdy ma to znaczenie.
Wykres umieszcza ten przykład na jednej skali tokenów razem z konfiguracjami MCP opisanymi dalej w tej sekcji.
MCP dla wspólnej usługi
Model Context Protocol pozwala serwerowi ogłaszać klientom narzędzia i inne możliwości przez stdio lub HTTP. Klient MCP agenta łączy się, pyta serwer, co oferuje, i przekazuje wywołania modelu, więc jeden serwer działa z każdym klientem obsługującym protokół. Od grudnia 2025 roku MCP zarządza Agentic AI Foundation w ramach Linux Foundation, a nie jeden dostawca.
Używaj MCP, gdy usługa ma być dostępna z wielu hostów agentów, do integracji SaaS takich jak Figma, Notion czy Salesforce, dla usług bez CLI albo gdy ustandaryzowane wykrywanie, obsługa OAuth i integracja zdalna uzasadniają koszt utrzymania serwera. Market Analyst Agent udostępnia też swoje narzędzia badawcze przez sidecar MCP. Akcja giełdowa nie stała się inną operacją biznesową tylko dlatego, że klient wykrywa ją przez MCP.
Protokół nie autoryzuje żądanego skutku biznesowego. Serwer i aplikacja nadal potrzebują uwierzytelniania, zawężonych uprawnień, kontroli danych wejściowych i wpisu audytowego dla ważnych operacji. Opisy narzędzi i zwracane dokumenty są również niezaufanymi danymi wejściowymi; demonstracja tool poisoning od Invariant Labs pokazuje, że złośliwe instrukcje w metadanych narzędzia mogą wpłynąć na agenta, zanim narzędzie zostanie wywołane. Benchmark MCPTox, który testował 20 agentów LLM na 45 działających serwerach MCP i 353 prawdziwych narzędziach, odnotował najwyższy odsetek udanych ataków, 72,8%, dla o1-mini w swojej konfiguracji tool poisoning; to wynik benchmarku jednego modelu, a nie wskaźnik incydentów. Vulnerable MCP Project zbiera zgłoszenia przydatne jako przypadki testowe. Host musi traktować tekst narzędzi jako dane, a nie jako nadanie uprawnień.
Sprawdź, którą rewizję MCP obsługuje każda strona. Rewizja 2026-07-28 czyni żądania bezstanowymi, zastępując handshake inicjalizacyjny, i usuwa wznawianie strumieni, więc starsze tutoriale mogą nie pasować do instalowanego SDK. Przerwany strumień odpowiedzi wymaga wtedy nowego żądania, co jest kolejnym powodem, by zapobiegać zduplikowanym skutkom biznesowym w samym narzędziu. Zanim zaczniesz polegać na jakiejś funkcji, sprawdź zainstalowane SDK i kontrakt serwera. W przypadku wywołania, które trwa dłużej niż jedna odpowiedź, oficjalne rozszerzenie Tasks dodaje trwały uchwyt: serwer zwraca identyfikator zadania, a klient odpytuje o stan pracy albo ją anuluje za pomocą tasks/get i tasks/cancel. Część 6 używa tego uchwytu, gdy wywołanie przekroczy limit czasu.
Duże katalogi mogą być kosztowne, jeśli każdy opis jest ładowany przy każdym żądaniu. Apideck opisuje typową konfigurację, GitHub, Slack i Sentry z około 40 narzędziami, która ładuje mniej więcej 55 000 tokenów definicji, zanim użytkownik o cokolwiek zapyta, i przytacza zespół, którego trzy serwery MCP zajmowały 143 000 z 200 000 tokenów kontekstu. Obie liczby są zgłoszone, a nie zmierzone na twoim katalogu. To decyzja o ładowaniu schematów, a nie nieodłączny koszt protokołu przesyłowego MCP. Jeśli to możliwe, ładuj mniejszy, istotny zestaw i mierz, czy wykrywanie nadal znajduje właściwe narzędzie.
Wrappery CLI dla utrwalonych poleceń
CLI jest atrakcyjne, gdy operacja istnieje już jako polecenie z użytecznym --help, stabilnymi kodami wyjścia i wyjściem czytelnym dla maszyn. Narzędzia CLI w Market Analyst Agent opakowują dwa konkretne polecenia do wyświetlania listy i pokazywania zapisanych raportów. Przekazują listę argumentów do subprocess.run i żądają JSON; agent nie dostaje dowolnej powłoki. To rozróżnienie czyni dozwoloną akcję widoczną i pozwala nie traktować każdego wygenerowanego polecenia jako zaufanego.
Szeroko udokumentowane polecenie, takie jak git, gh, docker, kubectl, curl czy jq, może wymagać niewiele nowej dokumentacji dla agenta programistycznego, ale wewnętrzne CLI nadal potrzebuje przykładów i kontraktów wyjścia. Przewodnik Ugo Enyiohy Writing CLI Tools That AI Agents Actually Want to Use wymienia osiem zasad dla takiego polecenia:
- Obsługuj ustrukturyzowane wyjście przez
--json. - Używaj różnych kodów wyjścia dla różnych typów błędów.
- Twórz polecenia idempotentne.
- Zapewnij
--helpz realistycznymi przykładami. - Obsługuj kompozycję:
--quietdla samych wartości i wejście ze stdin. - Zapewnij
--dry-runi--yes. - Podawaj wersję narzędzia.
- Pobieraj dane uwierzytelniające ze zmiennych środowiskowych.
Powłoka dodaje potoki i kompozycję, a wraz z nimi dostęp do plików, procesów, danych uwierzytelniających i ścieżek sieciowych. Dawaj jej tylko taki dostęp, jakiego wymaga zadanie. CLI nie ma modelu wykrywania ani autoryzacji na poziomie protokołu; harness musi egzekwować politykę i rejestrować wywołania, które musi audytować. Praktyczne ustawienie domyślne to CLI do developmentu i operacji lokalnych, a MCP do wspólnych usług zewnętrznych, gdy wykrywanie między klientami lub obsługa OAuth są warte utrzymywania serwera.
W porównaniu Scalekit obejmującym 75 przebiegów CLI zużyło mniej tokenów w pięciu zadaniach GitHub tylko do odczytu niż konfiguracja, która ładowała 43 schematy narzędzi MCP. Siedem błędów MCP to były przekroczenia czasu połączenia z serwerem zdalnym. Te wyniki porównują konkretne wdrożone interfejsy, a nie ogólną cechę, że CLI jest bardziej niezawodne albo że MCP wymaga więcej kontekstu. Powtórz porównanie z poleceniami, serwerem i polityką wykrywania, które naprawdę byś wdrożył.
Wykonywanie kodu dla kompozycji
Wygenerowany program jest przydatny, gdy agent musi połączyć wiele wywołań, przefiltrować dane pośrednie lub policzyć coś na dużym wyniku. Zamiast przepuszczać każdy wiersz przez model i prosić go o zaplanowanie następnej operacji, runtime może wykonać pętlę i zwrócić istotne podsumowanie. Praca CodeAct przetestowała 17 modeli i wykazała do 20 punktów procentowych wyższą skuteczność na 82 zadaniach wielonarzędziowych, przy nawet 30% mniejszej liczbie akcji niż alternatywy JSON. To powód, by wypróbować ten interfejs przy podobnej pracy, a nie by zastępować pojedyncze typowane zapytanie modułem wykonującym kod.
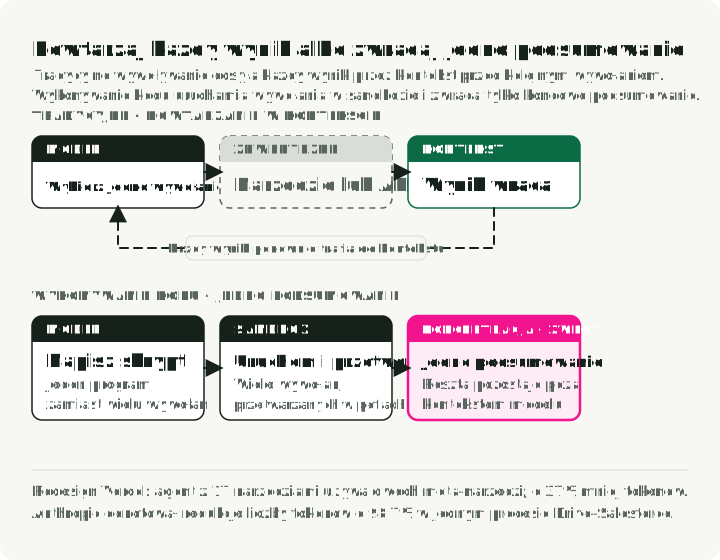
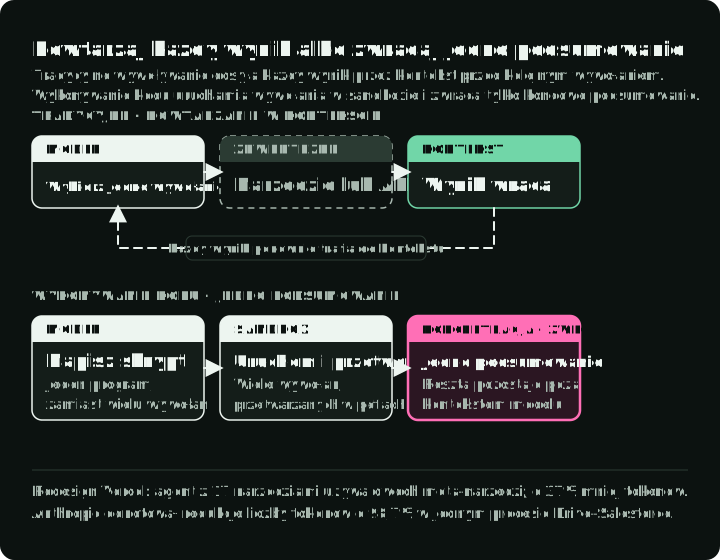
Rysunek uruchamia opisaną niżej kontrolę wydatków Anthropic na oba sposoby i porównuje, co trafia do kontekstu modelu.
Są tu dwa różne wzorce. Narzędzie kodu w Market Analyst Agent przyjmuje Pythona do obliczeń na danych, które już mu przekazano. Nie pozwala temu kodowi wywoływać narzędzi danych rynkowych. Sprawdza węzły drzewa składni, a potem wykonuje kod wewnątrz procesu aplikacji. Ta lista dozwolonych konstrukcji to ograniczenie dydaktyczne, a nie sandbox bezpieczeństwa dla niezaufanego kodu. Zanim udostępnisz dowolny wygenerowany kod lub wrażliwe zasoby procesu, wykonanie wymaga izolowanego runtime’u z limitami zasobów i dostępu.
Programmatic Tool Calling od Anthropic (PTC) to inny układ: wygenerowany kod może wywoływać konkretnie włączone narzędzia w zarządzanym środowisku wykonawczym i zwracać wybrany wynik do kontekstu modelu. W przykładzie Anthropic z analizą wydatków wywoływanie narzędzie po narzędziu wymaga ponad 20 przejść modelu, a każdy wiersz przechodzi przez kontekst; wygenerowany kod zmniejszył to, co trafiało do kontekstu, z około 200 KB wierszy wydatków do 1 KB wyników. Poniższy skrypt pokazuje ten przepływ sterowania za pomocą zwykłych asynchronicznych adapterów Pythona, a nie natywnych wrapperów PTC:
# Custom async adapters that return decoded Python objects, not native PTC wrappers.
import asyncio
import json

async def main() -> None:
    team = await get_team_members("engineering")
    levels = list({member["level"] for member in team})
    budgets = dict(zip(levels, await asyncio.gather(*(get_budget_by_level(l) for l in levels))))
    expenses = await asyncio.gather(*(get_expenses(member["id"], "Q3") for member in team))
    over_budget = []
    for member, rows in zip(team, expenses):
        total = sum(row["amount"] for row in rows)
        limit = budgets[member["level"]]["travel_limit"]
        if total > limit:
            over_budget.append({"name": member["name"], "spent": total, "limit": limit})
    print(json.dumps(over_budget))  # Only this summary returns to the model

asyncio.run(main())
Natywne wrappery PTC różnią się od tych adapterów formatami argumentów i wartości zwracanych, a nie każdy typ narzędzia można wywołać z kodu; przed przeniesieniem skryptu sprawdź aktualny przewodnik. Ustawienie API allowed_callers kieruje wywołaniami, ale nie zastępuje autoryzacji każdego skutku bazowego przez hosta, w tym nieoczekiwanego bezpośredniego wywołania. Trzymanie wierszy pośrednich poza kontekstem modelu oszczędza tokeny, ale nie czyni ich poufnymi wobec środowiska wykonawczego ani nie zwalnia z logowania i kontroli dostępu.
Korzyść zależy od kształtu zadania. W wewnętrznych ewaluacjach Anthropic benchmark zarządzania projektami z 75 narzędziami zużył około 38% mniej rozliczanych tokenów wejściowych przy niezmienionej dokładności. W zadaniach tau2-bench z jednym lub dwoma sekwencyjnymi wywołaniami na turę wyniki się nie zmieniły, a koszt był około 8% wyższy. Osobny przykład Drive-to-Salesforce spadł z około 150 000 do 2000 tokenów, czyli o 98,7% dla tego workflow. Żadna z tych liczb nie jest uniwersalnym wskaźnikiem dla kodu w porównaniu z JSON. Generowanie kodu, start runtime’u, błędy i obsługa wyjścia mogą przy prostych zadaniach przewyższyć oszczędności kontekstu.
Dwa studia przypadków dostawców pokazują ten sam projekt w produktach. Vercel przebudował swojego agenta text-to-SQL d0 wokół dwóch ogólnych narzędzi, ExecuteCommand i ExecuteSQL, zamiast 17 wymienionych w jego starym przykładzie. Na pięciu reprezentatywnych zapytaniach podaje wzrost skuteczności z 4/5 do 5/5, spadek średniego czasu z 274,8 s do 77,4 s i spadek liczby tokenów o 37%. W Code Mode od Cloudflare agenci piszą kod TypeScript korzystający z API zamiast wywoływać schematy narzędzi, przy założeniu, że modele widziały znacznie więcej prawdziwego TypeScriptu niż przykładów wywołań narzędzi. Traktuj oba przypadki jako dowody dostawców i powtórz porównanie na swoich zadaniach.
Wywoływanie narzędzi przez JSON pozostaje lepszym wyborem dla pojedynczych operacji atomowych, środowisk bez sandboxingu, mniejszych modeli słabo generujących kod i reguł audytu, które wymagają zapisu każdego pojedynczego wywołania.
Skills dla procedur
Agent Skill pakuje plik SKILL.md z nazwą, opisem i instrukcjami; może też zawierać skrypty i materiały referencyjne. Otwarty standard wymaga tylko name i description. Minimalny skill dla tego agenta mógłby wyglądać tak:
---
name: stock-overview
description: Prepare a short overview of one stock. Use when the user asks for a current snapshot of a company.
---
1. Call get_stock_snapshot for the ticker.
2. If the result has no market timestamp, say that freshness is unknown.
3. Call search_news only if the user asked about recent events.
4. Cite every news item you use.
Skill mówi agentowi, jak korzystać z jego narzędzi; nie dodaje żadnej nowej możliwości. Używaj skills do wiedzy dziedzinowej, procedur wieloetapowych i powtarzalnej pracy, takiej jak migracje baz danych czy integracje płatności. Host nadal decyduje, które narzędzia agent może uruchamiać. Tekst skilla to wskazówka, a nie egzekwowanie polityki.
Format pozwala najpierw załadować krótką nazwę i opis, około 100 tokenów, a dopiero potem pełne instrukcje; skrypty i pliki, do których się odwołuje, ładują się tylko w razie potrzeby. Pomaga to, gdy istnieje wiele procedur, ale aktywny skill i wszystkie ładowane przez niego pliki nadal zużywają kontekst. Przeglądaj jego instrukcje i pliki wykonywalne tak jak każde inne wejście do harnessu. Jeśli workflow jest krytyczny dla bezpieczeństwa, zakoduj wymaganą walidację w narzędziu lub aplikacji zamiast polegać na tym, że instrukcja zostanie wykonana.
Załadowany skill może też pogorszyć wyniki. Badanie z 2026 roku na SkillsBench i SWE-Skills-Bench przypisało 307 niepowodzeń konkretnym załadowanym skillom: 125 błędów funkcjonalnych, w których wynik zadania był zły, i 182 spadki wydajności, w których uruchomienie kosztowało więcej. To niepowodzenia, które autorzy mogli przypisać w dwóch benchmarkach, a nie odsetek niepowodzeń skills w ogóle. Zanim zaczniesz polegać na nowym skillu, uruchom go na reprezentatywnych zadaniach z nim i bez niego. Wytyczne Agent Framework od Microsoftu ograniczają też skills do operacji idempotentnych lub niskiego ryzyka i wolą jawny workflow, gdy krok ma skutek uboczny, na przykład płatność, który nie może się powtórzyć przy ponowieniu. Narzędzia skills domyślnie wymagają zatwierdzenia.
Porównaj interfejsy
| Pytanie | Wywołania narzędzi JSON | MCP | Skills | CLI | Wykonywanie kodu |
|---|---|---|---|---|---|
| Najlepsze do | Prostych, pojedynczych akcji | Wspólnych usług dla wielu klientów | Procedur wielokrotnego użytku dla innego interfejsu | Developmentu i operacji lokalnych | Pracy wieloetapowej na dużych wynikach |
| Koszt kontekstu | Załadowane schematy | Schematy załadowane lub odroczone | Około 100 tokenów do aktywacji | Tekst pomocy, polecenie i wyjście | Schematy wejściowe, kod i wyjście |
| Zależne wywołania | Zwykle jedna tura modelu na wywołanie | Jedna tura modelu plus transport | Zależą od interfejsu bazowego | Zwykle jedna tura modelu na wywołanie | Jedna tura na skrypt; runtime wykonuje przepływ |
| Powierzchnia ataku | Uprawnienia do argumentów i skutków | Tożsamość serwera i uprawnienia narzędzi | Host i zasoby, które przyznaje | Powłoka, ścieżki, dane uwierzytelniające | Kod, dostęp do danych i ruch wychodzący |
| Wdrożenie | Niskie | Wdrożenie serwera | Niskie; zależy od interfejsu bazowego | Bardzo niskie dla istniejących poleceń | Runtime w sandboxie |
| Debugowanie | Ustrukturyzowane wejście i wyjście | Dochodzi warstwa transportu | Czytelny Markdown | Polecenia są widoczne | Czytelny kod |
Skills sterują jednym z pozostałych czterech interfejsów, więc ich opóźnienie i koszt wdrożenia zależą od wybranego interfejsu. Wiersze podsumowują przytoczone przykłady, a nie jeden kontrolowany benchmark obejmujący wszystkie pięć.
Kilka kompromisów przecina całą tabelę. Wykonywanie kodu może oszczędzać kontekst, ale dodaje czas generowania i uruchamiania kontenera. MCP oszczędza pracę integracyjną, ale dodaje serwer do utrzymania. CLI nic nie kosztuje na start i trudniej nim zarządzać na dużą skalę. Dopasuj interfejs do zespołu: wykonywanie kodu zakłada model, który pisze niezawodny kod, CLI zakłada konwencje Uniksa, a MCP zakłada znajomość transportów i OAuth. Konsolidacja narzędzi też może zajść za daleko, gdy jedno narzędzie zbiera niezwiązane tryby. Ustrukturyzowane wywołania łatwo logować, ale żaden protokół sam nie tworzy pełnego zapisu audytowego; host, serwer lub harness rejestruje wywołania i wyniki oraz egzekwuje politykę.
Pierwszy zestaw testów dla interfejsu
Krótsza lista narzędzi lub tańszy prompt jest przydatny tylko wtedy, gdy agent nadal wykonuje pracę. Porównuj interfejsy na tym samym zestawie zadań, z tym samym modelem, danymi, dozwolonymi operacjami i regułami ukończenia. Uwzględnij przypadki, w których właściwym następnym krokiem jest prośba o doprecyzowanie albo zatrzymanie.
Dla Market Analyst Agent pierwszy zestaw testów mógłby obejmować takie przypadki:
| Żądanie lub warunek | Co sprawdzić |
|---|---|
| Podstawowy przegląd akcji | Poprawny ticker, pola snapshotu, źródło i czas rynkowy w odpowiedzi |
| Potrzebna historia cen, ale bez wiadomości | Agent wybiera historię bez niezwiązanych wywołań |
| Dostawca nie zwraca poprawnej ceny | Brak zmyślonego notowania; przebieg zgłasza niedostępne dane |
| Duży zestaw niezależnych zapytań | Jakość końcowej odpowiedzi, tury modelu, tokeny wejściowe/wyjściowe, opóźnienie i błędy runtime’u |
| Proponowana transakcja w trakcie zadania badawczego | Brak skutku transakcyjnego; lista narzędzi badawczych nie daje tej akcji |
Zapisuj wywołania narzędzi i ich wyniki, a nie tylko końcową odpowiedź. Wiarygodnie wyglądający raport może ukryć nieudane zapytanie; poprawna końcowa cena może ukryć niepotrzebne wywołania. Jeśli interfejs się zmienia, licz zarówno udane zadania, jak i nowe rodzaje błędów: zły wybór narzędzia, nieprawidłowe argumenty, pominięte wykrycie, powtórzone skutki uboczne, błędy składni i przekroczenia czasu. Zapisuj też tokeny wykrywania, wejście z cache i bez cache oraz ponowienia.
Potem możesz zmienić interfejs, gdy popiera to pomiar. Zachowaj typowane wywołanie, dopóki czysto realizuje zadanie. Dodaj MCP, gdy potrzebne jest wspólne wykrywanie, wrapper CLI, gdy istniejące polecenie jest najczytelniejszą operacją, albo wykonywanie kodu, gdy zmierzone zyski z kompozycji uzasadniają jego runtime. Kontrakt akcji, czyli to, co może się wydarzyć, jaki wynik to potwierdza i co oznacza błąd, nadal musi być jawny.
Trzy kierunki korzystania z narzędzi na dużą skalę
Wyszukiwanie narzędzi. Zanim model wybierze, wyszukaj kilka opisów narzędzi pasujących do żądania. W benchmarku i teście obciążeniowym MCP z pracy RAG-MCP wyszukiwanie podniosło dokładność wyboru narzędzi z 13,62% do 43,13% i zmniejszyło liczbę tokenów promptu z około 2134 do 1084. Opisy konfiguracji różnią się między sekcjami pracy, co ogranicza możliwość uogólnienia tych liczb.
Agenci, którzy tworzą narzędzia. W LATM silny model pisze wielokrotnego użytku funkcje w Pythonie, które potem wywołuje mniejszy model. ToolMaker poprawnie zaimplementował 12 z 15 zadań zbudowanych na podstawie prac z publicznym kodem. Ten mały benchmark nie dowodzi niezawodności produkcyjnej, ale wskazuje kierunek: zarządzanie biblioteką wygenerowanych narzędzi.
A2A obok MCP. Google przekazał A2A fundacji Linux Foundation w czerwcu 2025 roku. Dokumentacja A2A rozdziela role: MCP łączy agenta z narzędziami i zasobami, a A2A pozwala osobnym agentom wykrywać się nawzajem, dzielić zadaniami i delegować pracę.
Część 4, AI Agent Security, śledzi proponowaną akcję aż do kontroli uprawnień. Część 5, Agent Runtime, umieszcza wykonanie w runtime’ie, który można odtworzyć po awarii. Część 6, Harness Engineering for AI Agents, łączy pętlę, narzędzia, politykę i kontrolę ukończenia.
Źródła
Prace naukowe
- Executable Code Actions Elicit Better LLM Agents (CodeAct) — Wang et al., ICML 2024
- SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering — Yang, Jimenez et al., NeurIPS 2024
- RAG-MCP: Mitigating Prompt Bloat in LLM Tool Selection
- LLMs As Tool Makers (LATM) — Cai et al., 2023
- ToolMaker: LLM Agents Making Agent Tools — Wölflein et al., ACL 2025
- MCPTox: A Benchmark for Tool Poisoning Attack on Real-World MCP Servers
- Agent Skills Can Be Harmful: An Empirical Study of Skill-Induced Failures in LLM Agents — Dong et al., 2026
Artykuły inżynierskie i dokumentacja Anthropic
- Advanced tool use — Tool Search, Programmatic Tool Calling i przykłady wejścia
- Programmatic tool calling — aktualny przewodnik po API i ograniczenia
- Code execution with MCP — przykład Drive-to-Salesforce
- Writing effective tools for agents
- Building effective agents
Protokoły
- Specyfikacja Model Context Protocol, 2026-07-28 i lista zmian
- MCP Tasks extension
- Specyfikacja Agent Skills
- Microsoft Agent Framework: Agent Skills
- A2A and MCP
Studia przypadków i bezpieczeństwo
- Vercel: We removed 80% of our agent’s tools
- Cloudflare: Code Mode
- Apideck: MCP server eating your context window
- Scalekit: MCP vs CLI
- Invariant Labs: MCP tool poisoning attacks
- Vulnerable MCP Project
- Writing CLI Tools That AI Agents Actually Want to Use — Ugo Enyioha
Projekt demonstracyjny
- Market Analyst Agent — konsolidacja narzędzi i wzorce ACI