Tool use в ИИ-агентах: MCP, CLI, Skills и выполнение кода

Автоматический перевод
Эта статья была автоматически переведена с оригинальной английской версии.
Эта статья для инженеров, которые дают агенту доступ к данным, командам или внешним сервисам. Вы узнаете, как определить действие, которым агент может надежно пользоваться, как выбрать для него интерфейс выполнения и как проверить, помогает ли этот интерфейс на ваших задачах. Сквозной пример — Market Analyst Agent, исследовательский агент, который получает рыночные данные и готовит отчеты.
В части 1 модель выбирала следующий шаг в цикле ризонинга. Часть 2 была о том, что модель может сохранять между шагами. Инструмент дает этому выбору эффект за пределами модели: он может получить котировку, прочитать сохраненный отчет, выполнить код или изменить запись. Программа вокруг модели, харнесс, по-прежнему решает, какие из этих действий существуют и можно ли выполнить предложенный вызов.
Первое проектное решение касается самого действия. Если агенту для одного отчета нужны данные о цене и оценке компании, должен ли он запрашивать два эндпоинта API, один снапшот по акции или сгенерированную программу? Ответ зависит от задачи и от обратной связи, которая нужна агенту, а не от протокола интеграции.
Краткое решение по выбору интерфейса — в статье AI Agent Tool Interfaces.
Что нужно для обзора компании
Допустим, пользователь просит Market Analyst Agent дать актуальный обзор компании. Агенту могут понадобиться свежая котировка, объем торгов, мультипликаторы оценки, история цен и новости. Это разные вопросы. Последняя котировка и базовые показатели часто входят в один ответ, а история цен и новости могут быть лишними для короткого ответа. Не относящаяся к делу возможность совершить сделку не должна попадать в этот исследовательский путь.
Прежде чем открывать API, запишите четыре вещи:
- Действие: что агент может запросить за один шаг? Выбирайте операцию, которая соответствует вопросу, на который ему действительно нужно ответить.
- Аргументы: какие входные данные должен передать вызывающий, а какие приложение может проверить до обращения к сервису?
- Результат: какие факты позволяют агенту выбрать следующий шаг и какие сведения о происхождении или идентификаторы должны сохраниться для последующих проверок?
- Сбой и эффект: что может измениться, как вызывающий может понять, произошло ли действие, и когда повтор безопасен?
Эти вопросы разделяют три зоны ответственности. Модель предлагает действие. Харнесс проверяет его и маршрутизирует. Реализация инструмента выполняет действие и возвращает результат. JSON Schema может отклонить некорректный тикер; она не может установить, что сделка авторизована. Протокол может доставить tool call; он не может сделать безопасным повтор неудавшейся записи.
Статья о SWE-agent называет проектирование этого взаимодействия Agent-Computer Interface (ACI), по аналогии с человеко-компьютерным взаимодействием: агенты на основе языковых моделей — новый тип пользователя, и им полезны интерфейсы, созданные для них. Абляция на 300 задачах SWE-bench Lite дала 18,0% с полным интерфейсом против 7,3% в варианте только с shell без разобранной демонстрации и 11,0% с такой демонстрацией. Варианты отличаются не только одним описанием инструмента, поэтому эти цифры не предсказывают выигрыш от переработки ваших собственных инструментов. Но они показывают, что интерфейс нужно тестировать вместе с моделью. Building Effective Agents от Anthropic говорит то же самое: закладывайте на интерфейс агент-компьютер столько же усилий, сколько на интерфейс для людей.
Схема прослеживает один вызов get_stock_snapshot через модель, харнесс и инструмент и нумерует каждый шаг принципом из списка ниже, который им управляет. Проверка отсутствующей цены — рекомендация: реализация снапшота в указанной ревизии сейчас по умолчанию заменяет отсутствующую цену нулем.
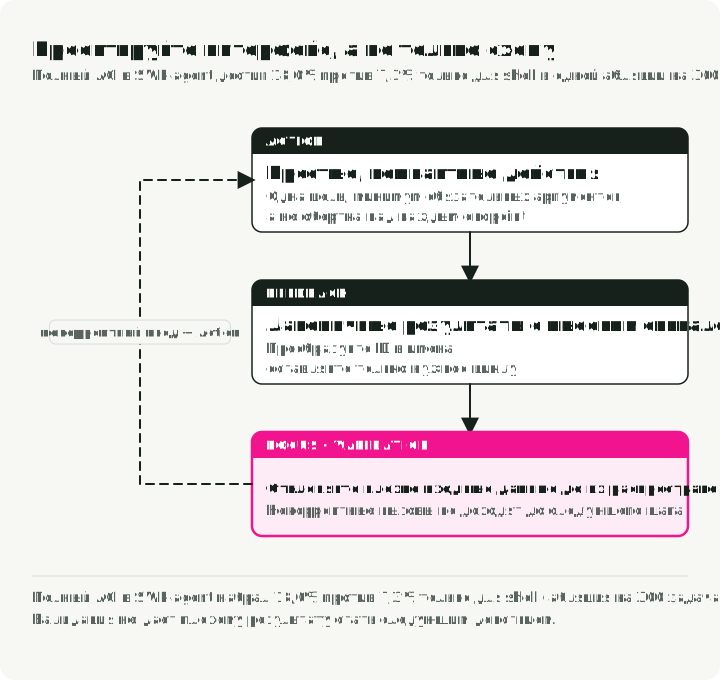
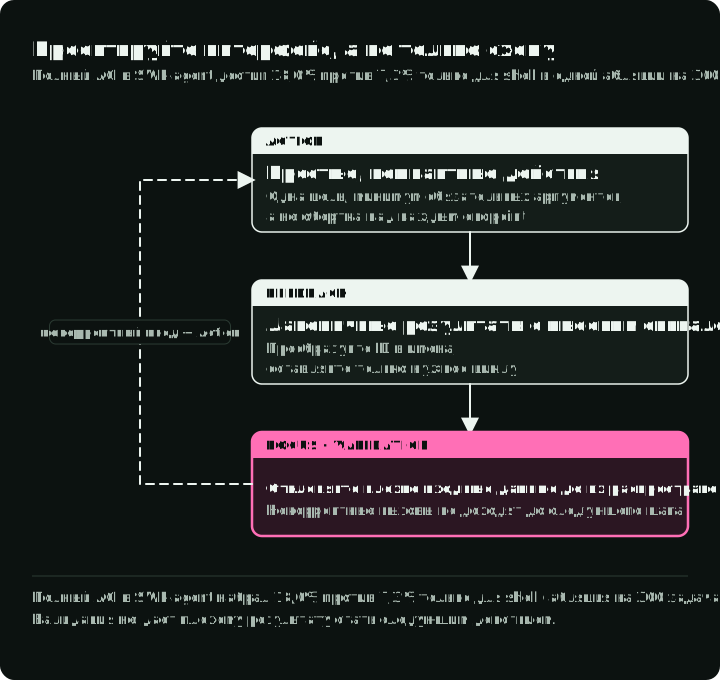
Четыре принципа ACI применимы к каждому интерфейсу в этой статье:
- Простые действия. Не оборачивайте эндпоинты API один к одному. Вместо
list_users,list_eventsиcreate_eventпредложитеschedule_event, который находит свободное время и бронирует его за один вызов. Вместоread_logsпредложитеsearch_logs, который возвращает нужные строки с контекстом. - Компактные действия. Объединяйте операции, которые служат одной задаче, как это делает снапшот по акции ниже.
- Краткая и информативная обратная связь. Возвращайте смысловые имена вместо сырого HTML, полных payload API или непонятных ID, но сохраняйте любой ID, который нужен последующему вызову.
- Проверка, которая не дает ошибкам распространяться. Проверяйте аргументы до вызова, а результаты — до следующего действия. В SWE-agent редактор со встроенным линтингом отклонял синтаксические ошибки; его включение подняло результат варианта с редактированием с 15,0% до 18,0%.
Инструмент, который легко выбрать и использовать
Market Analyst Agent дает конкретный пример. Ранняя версия предоставляла get_stock_price и get_company_metrics по отдельности. Экзекьютор теперь предоставляет get_stock_snapshot, get_price_history, get_financials, search_news и search_competitors. Снапшот объединяет цену, объем, рыночную капитализацию и коэффициент P/E, потому что базовому обзору они обычно нужны вместе. История, финансовая отчетность и новости остаются отдельными, потому что агенту может не понадобиться каждый из этих пунктов.
| До (исходные инструменты) | После (инструменты рыночных данных) | Почему |
|---|---|---|
get_stock_price + get_company_metrics | get_stock_snapshot | Один вызов возвращает базовый снапшот цены и оценки |
get_price_history | get_price_history | Сохранен, с проверкой периодов и сводкой по среднему объему |
search_news | search_news | Возвращает структурированные элементы с извлеченными ключевыми тезисами |
search_competitors | search_competitors | Сохраняет действие поиска, ориентированное на конкурентов |
| Нет инструмента финансовой отчетности | get_financials | Выбирает параметром отчет о прибылях и убытках, баланс или движение денежных средств |
Список инструментов агента также содержит загрузчик skills, две CLI-обертки и ограниченный вычислитель Python внутри процесса, так что он охватывает три из описанных ниже интерфейсов; MCP представлен отдельным sidecar.
Это решение о размере действия. Обертка один к одному вокруг каждого вышестоящего эндпоинта заставляет модель планировать под структуру API поставщика. Один инструмент с множеством несвязанных режимов просто переносит проблему выбора в свои аргументы. Группируйте поля, которые служат одной задаче, а затем проверяйте, выбирают ли агенты правильное действие.
Пишите описание для модели
Описание снапшота говорит, когда вызывать его первым, что он возвращает и когда вместо него выбрать историю или финансовую отчетность. Такая подсказка о соседних инструментах так же важна, как имя. «Search for items» не подскажет модели, отвечает ли на запрос search_news или search_competitors. Руководство Anthropic по проектированию инструментов тоже рекомендует описания, примеры и результаты, которые помогают модели выбрать правильное действие, а документация по определению инструментов советует писать минимум три-четыре предложения: когда использовать инструмент, какие у него параметры, что он выдает и какие есть граничные случаи:
# Vague: the model cannot tell when to use it.
vague = [{"name": "search", "description": "Search for items"}]

# Specific: when to use it, what it returns, and which tool to use instead.
specific = [{
    "name": "search_news",
    "description": (
        "Search for recent news articles about a specific stock or company. "
        "Use this tool when the user asks about recent events, earnings, "
        "announcements, or market-moving news for a specific ticker. "
        "Returns up to 10 articles sorted by relevance. "
        "For company competitors rather than news, use search_competitors instead."
    ),
    "input_schema": {
        "type": "object",
        "properties": {
            "query": {
                "type": "string",
                "description": "Search query. Examples: 'NVDA earnings Q3 2025', 'Tesla delivery numbers'",
            },
            "max_results": {
                "type": "integer",
                "description": "Max articles to return (1-10, default 5)",
                "default": 5,
            },
        },
        "required": ["query"],
    },
}]
Добавляйте примеры там, где параметры неоднозначны; не тратьте контекст на повтор того, что уже говорит простая схема. Во внутренних тестах Anthropic добавление поля input_examples подняло точность обработки сложных параметров с 72% до 90%. Anthropic также сообщает, что пространство имен в префиксе или суффиксе (asana_search или search_asana) заметно влияло на ее эвалы, но не говорит, какой вариант победил, поэтому проверьте оба на своем наборе инструментов. Затем компания передала транскрипты эвалов Claude Code, чтобы он переписал инструменты, и на отложенных тестах этот цикл превзошел инструменты, написанные экспертами.
Проверяйте аргументы и формируйте результаты
Реализация проверяет тикер до запроса рыночных данных. Этот фрагмент адаптирован из исходного кода по ссылке; общий нормализатор обрезает пробелы, переводит значение в верхний регистр и принимает суффиксы с точкой или дефисом, например BRK.B и BF-B. Запрос истории добавляет допустимый набор периодов:
from pydantic import BaseModel, Field, field_validator

from market_analyst.utils import normalize_ticker

class StockQuery(BaseModel):
    ticker: str = Field(description="Stock ticker symbol (e.g., NVDA)")

    @field_validator("ticker")
    @classmethod
    def validate_ticker(cls, value: str) -> str:
        return normalize_ticker(value)

class StockHistoryQuery(StockQuery):
    period: str = Field(default="1mo", description="Time period: 1d, 5d, 1mo, 3mo, 6mo, 1y")

    @field_validator("period")
    @classmethod
    def validate_period(cls, value: str) -> str:
        valid = {"1d", "5d", "1mo", "3mo", "6mo", "1y"}
        if value not in valid:
            raise ValueError(f"Invalid period: {value}. Must be one of {valid}")
        return value
Инструменты для акций и новостей возвращают результаты, проверенные Pydantic, а не сырые payload поставщика. Поле summary дает агенту готовую строку для отчета, а key_points избавляют его от разбора текста статей:
from pydantic import BaseModel

class StockSnapshot(BaseModel):
    ticker: str
    price: float
    change_pct: float
    volume: int
    market_cap_b: float
    pe_ratio: float | None
    summary: str  # One line for direct use in a report

class NewsItem(BaseModel):
    headline: str
    source: str
    date: str
    relevance_score: float  # Pre-ranked by the tool
    key_points: list[str]  # Extracted by the tool, not the agent

class NewsSearchResult(BaseModel):
    query: str
    results: list[NewsItem]
    summary: str
Результат снапшота содержит эти типизированные поля для цены, процентного изменения, объема, рыночной капитализации, P/E и краткой сводки. Добавьте в результат источник данных и рыночное время, на которое действительна котировка, и пусть отчет указывает их. То, что данные получены сейчас, не доказывает, что котировка актуальна.
Держите результаты достаточно короткими для следующего решения, но не выбрасывайте идентификатор или источник, который нужен последующему действию. Для результата поиска заголовка и сводки может хватить, чтобы ранжировать кандидатов; URL или ID должен оставаться доступным, если агенту нужно получить или процитировать конкретный элемент. Краткий и подробный результат могут служить разным шагам: в тестах Anthropic добавили параметр response_format, который возвращал около 72 токенов в кратком режиме и 206 в подробном. Сырые payload от вышестоящего сервиса редко бывают полезным вариантом по умолчанию.
Возвращайте ошибки, на которые цикл может отреагировать
Ошибки — часть того же контракта. Не подставляйте ноль вместо отсутствующей цены: тогда недоступная котировка выглядит как цена в ноль долларов. Не оборачивайте и все окончательные сбои в один тип исключения: тогда вызывающий не может выбрать категорию повтора. Отклоняйте отсутствующие рыночные данные и различайте неверный ввод, временный сбой поставщика и недоступные данные. Инструмент, который записывает внешнее состояние, также должен отличать известный сбой от результата, который мог завершиться, несмотря на потерянный ответ. Возвращайте достаточно деталей, чтобы выбрать между повтором, уточнением и эскалацией; не давайте тексту поставщика стать инструкцией для модели.
Четыре механизма обрабатывают разные классы сбоев: повтор с backoff для временных ошибок, fallback на другую модель при отказах поставщика, классификация, которая возвращает агенту исправимые ошибки и эскалирует остальные, и восстановление из чекпоинта после падений (часть 2). Повторяйте только временные сбои, например таймауты, сетевые ошибки и ответы 429 и 5xx, с экспоненциальным backoff и небольшим лимитом попыток; библиотека вроде Tenacity делает это в декораторе. Вызывающему все равно нужно превратить окончательное исключение или ответ 4xx, после которого запрос не следует повторять, в стабильный результат, который говорит, какая операция не удалась и что делать дальше. Повтор запроса не классифицирует его ошибку и безопасен только для чтения или идемпотентной записи. Измеряйте долю восстановлений, число повторов и эскалаций на собственном наборе задач.
Попробуйте контракт
В сопутствующем репозитории установите зафиксированные зависимости и запустите тесты инструментов:
uv sync --locked
uv run pytest tests/test_tools.py -q
Тест снапшота подставляет синтетические рыночные данные и проверяет тикер, цену, объем, поля оценки и сводку. Он тестирует контракт инструмента без живой котировки и без модели; он не измеряет, выбирает ли агент правильный инструмент. Если настроить учетные данные поставщика, как описано в README репозитория, можно также запустить uv run market-analyst "NVDA price update" --mode flash --no-persist и посмотреть черновик, полученный через путь агента. Этот запуск использует живые сервисы и является примером, а не бенчмарком.
Выберите интерфейс выполнения
Когда контракт действия ясен, выберите, как агент до него добирается. Эти интерфейсы отвечают на разные вопросы; более новый не заменяет более старый.
Схема прослеживает каждый маршрут в Market Analyst Agent от модели до операции, которой он достигает.
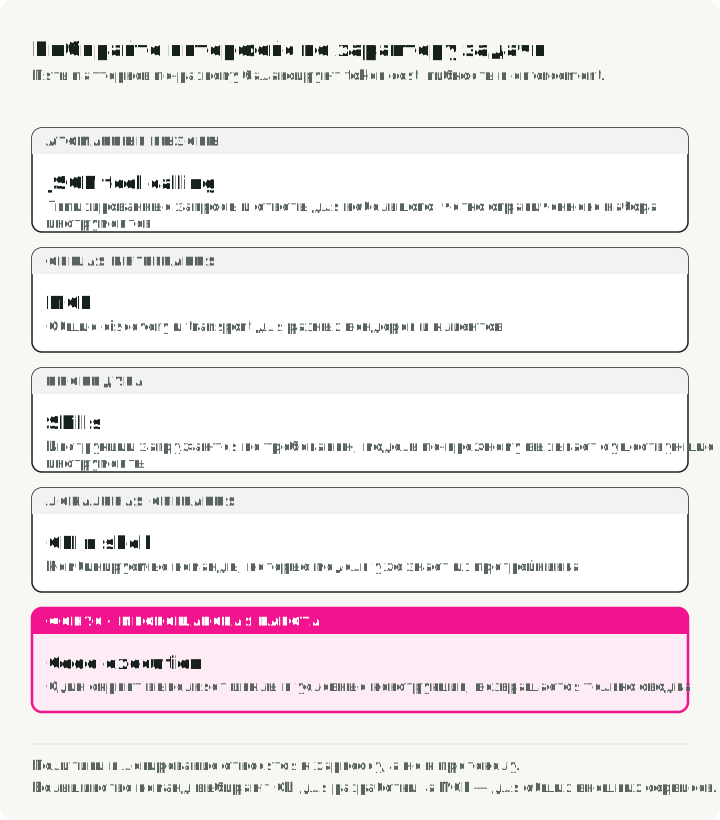
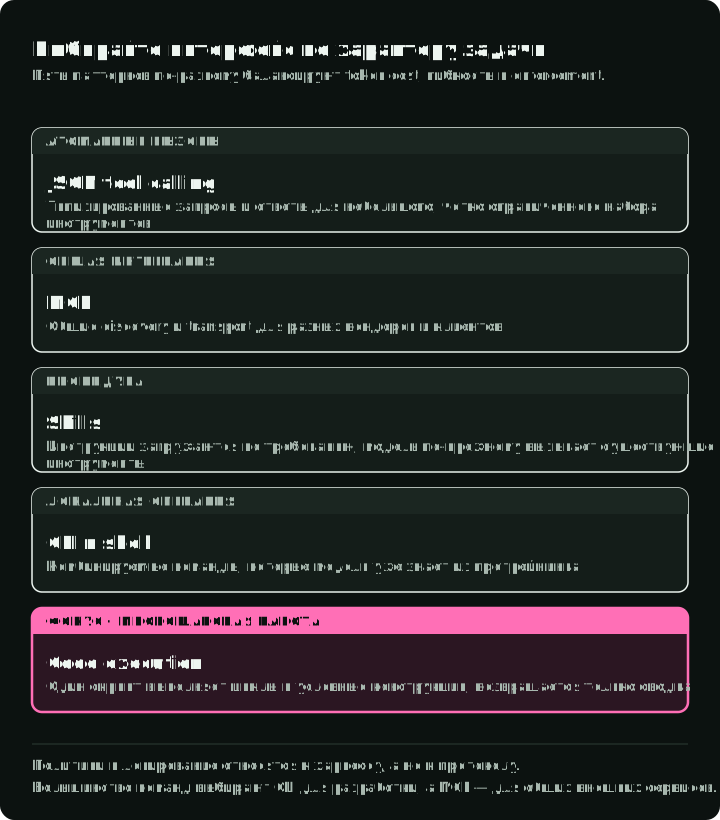
| Потребность | Начальный интерфейс | Что он добавляет |
|---|---|---|
| Небольшой набор типизированных операций в одном приложении | JSON tool calls | Явные имена, аргументы и результаты |
| Одни и те же инструменты для нескольких клиентов | MCP | Общие обнаружение и транспорт |
| Существующая команда со стабильным выводом | CLI-обертка | Повторное использование команды и ее справки |
| Много зависимых операций или локальная обработка данных | Выполнение кода | Циклы, условия и фильтрация внутри одного запуска |
| Переиспользуемые инструкции для любого из вариантов выше | Skill | Указания, которые загружаются, когда они нужны |
Таблица дает первый выбор; она не ранжирует интерфейсы по производительности. У MCP-инструментов по-прежнему есть схемы и структурированные вызовы. CLI может стоять за оберткой JSON-инструмента. Исполнитель кода может вызывать разрешенные инструменты. Skills — это инструкции по использованию возможности, а не еще один канал выполнения.
Типизированные вызовы для узких действий
Для get_stock_snapshot(ticker) достаточно типизированного вызова. Модель передает тикер; харнесс проверяет аргумент, вызывает реализацию и возвращает структурированный результат. Следующий вызов может зависеть от этого результата. Независимые запросы часто можно выполнять параллельно, но вызову, аргументы которого зависят от первого результата, нужен еще один шаг модели, если только операции не объединяет код приложения.
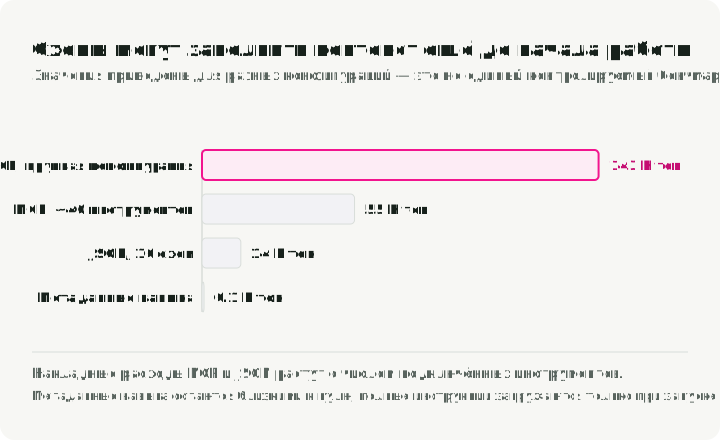
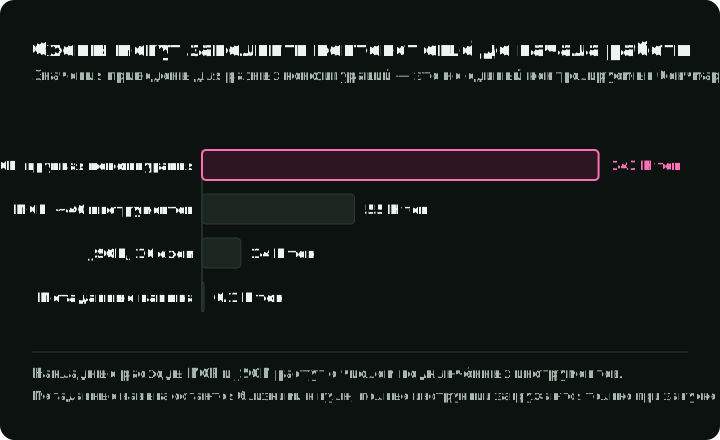
Низкая стоимость настройки полезна, когда одно приложение владеет небольшим набором инструментов. Токены схем все равно учитываются, когда определения инструментов загружаются в контекст, поэтому измерьте размер своих реальных определений. Если каталог растет, отложенное обнаружение может загружать только вероятных кандидатов. В примере Tool Search от Anthropic примерный контекст до начала работы сократился с 77 000 до 8700 токенов в конфигурации с более чем 50 инструментами за счет загрузки только тех трех–пяти инструментов, которые нужны запросу. Это результат для конкретного набора инструментов и метода retrieval, и он добавляет шаг обнаружения перед каждым вызовом. Для небольшого набора инструментов, который используется в каждой сессии, выигрыш меньше. Обнаружение также нужно проверять на пропущенные или неверные инструменты.
Загрузка схемы, как правило, необратима. Определение, которое модель может вызвать двадцать шагов спустя, должно оставаться доступным, а его удаление меняет стабильную часть запроса, от которой зависит prefix caching, поэтому шаг обнаружения обычно добавляет определения и никогда не заменяет одно другим. Схема, которую модель все еще видит, также не является разрешением, которое модель все еще имеет. Записывайте версию схемы и действующее разрешение в момент обнаружения и проверяйте разрешение заново, когда вызов передается на выполнение.
Когда результат сокращают, чтобы уложиться в бюджет, сообщите об этом в самом результате и дайте модели способ запросить диапазон строк или байтов полного вывода, чтобы она отличала короткий ответ от усеченного и запрашивала остальное, когда это важно.
На диаграмме этот пример показан в одном масштабе токенов с MCP-конфигурациями, описанными дальше в этом разделе.
MCP для общего сервиса
Model Context Protocol позволяет серверу объявлять клиентам инструменты и другие возможности через stdio или HTTP. MCP-клиент агента подключается, спрашивает сервер, что тот предлагает, и пересылает вызовы модели, так что один сервер работает с любым клиентом, поддерживающим протокол. С декабря 2025 года MCP управляет Agentic AI Foundation в рамках Linux Foundation, а не один вендор.
Используйте MCP, когда сервис должен быть доступен из нескольких агентных хостов, для SaaS-интеграций вроде Figma, Notion или Salesforce, для сервисов без CLI или когда стандартизированное обнаружение, работа с OAuth и удаленная интеграция оправдывают стоимость эксплуатации сервера. Market Analyst Agent также предоставляет свои исследовательские инструменты через MCP sidecar. Действие с акциями не стало другой бизнес-операцией только потому, что клиент находит его через MCP.
Протокол не авторизует запрошенный бизнес-эффект. Серверу и приложению по-прежнему нужны аутентификация, ограниченные права, проверки ввода и запись аудита для значимых операций. Описания инструментов и возвращаемые документы тоже являются недоверенным вводом; демонстрация tool poisoning от Invariant Labs показывает, что вредоносные инструкции в метаданных инструмента могут повлиять на агента еще до вызова инструмента. Бенчмарк MCPTox, который проверил 20 LLM-агентов на 45 работающих MCP-серверах и 353 реальных инструментах, сообщил о самой высокой доле успешных атак, 72,8%, для o1-mini в своей конфигурации tool poisoning; это результат бенчмарка для одной модели, а не частота инцидентов. Vulnerable MCP Project собирает отчеты, полезные в качестве тестовых случаев. Хост должен рассматривать текст инструментов как данные, а не как выдачу полномочий.
Проверьте, какую ревизию MCP поддерживает каждая сторона. Ревизия 2026-07-28 делает запросы stateless, заменяя handshake инициализации, и убирает возобновление потоков, поэтому старые туториалы могут не совпадать с SDK, который вы установите. Оборванному потоку ответа тогда нужен новый запрос, и это еще одна причина предотвращать дублирование бизнес-эффектов в самом инструменте. Прежде чем полагаться на какую-либо возможность, проверьте установленный SDK и контракт сервера. Для вызова, который длится дольше одного ответа, официальное расширение Tasks добавляет долговечный дескриптор: сервер возвращает ID задачи, а клиент опрашивает или отменяет работу через tasks/get и tasks/cancel. Часть 6 использует этот дескриптор, когда вызов завершается по таймауту.
Большие каталоги могут обходиться дорого, если каждое описание загружается для каждого запроса. Apideck описывает распространенную конфигурацию — GitHub, Slack и Sentry примерно с 40 инструментами, — которая загружает около 55 000 токенов определений еще до того, как пользователь что-то спросит, и приводит команду, чьи три MCP-сервера занимали 143 000 из 200 000 токенов контекста. Обе цифры приведены в отчетах, а не измерены на вашем каталоге. Это решение о загрузке схем, а не неотъемлемая цена самого протокола передачи MCP. По возможности загружайте меньший релевантный набор и измеряйте, находит ли обнаружение по-прежнему правильный инструмент.
CLI-обертки для устоявшихся команд
CLI привлекателен, когда операция уже существует как команда с полезным --help, стабильными кодами выхода и машиночитаемым выводом. CLI-инструменты Market Analyst Agent оборачивают две конкретные команды для вывода списка и показа сохраненных отчетов. Они передают список аргументов в subprocess.run и запрашивают JSON; агент не получает произвольную shell. Это различие делает разрешенное действие видимым и позволяет не считать доверенной каждую сгенерированную строку команды.
Широко документированной команде вроде git, gh, docker, kubectl, curl или jq может понадобиться мало новой документации для агента-программиста, но внутреннему CLI все равно нужны примеры и контракты вывода. Руководство Уго Эньохи Writing CLI Tools That AI Agents Actually Want to Use перечисляет восемь правил для такой команды:
- Поддерживайте структурированный вывод через
--json. - Используйте разные коды выхода для разных типов ошибок.
- Делайте команды идемпотентными.
- Давайте
--helpс реалистичными примерами. - Поддерживайте композицию:
--quietдля голых значений и ввод из stdin. - Предоставляйте
--dry-runи--yes. - Сообщайте версию инструмента.
- Берите учетные данные из переменных окружения.
Shell добавляет пайпы и композицию, а вместе с ними доступ к файлам, процессам, учетным данным и сетевым путям. Давайте ей только тот доступ, который требует задача. У CLI нет модели обнаружения или авторизации на уровне протокола; харнесс должен применять политику и записывать вызовы, которые нужно аудировать. Практичный вариант по умолчанию — CLI для разработки и локальных операций и MCP для общих внешних сервисов, когда обнаружение между клиентами или работа с OAuth стоят эксплуатации сервера.
В сравнении Scalekit на 75 запусках CLI потратил меньше токенов на пяти задачах GitHub только для чтения, чем конфигурация, загружавшая 43 схемы MCP-инструментов. Все семь сбоев MCP были таймаутами подключения к удаленному серверу. Эти результаты сравнивают конкретные развернутые интерфейсы, а не общее свойство, будто CLI надежнее или MCP требует больше контекста. Повторите сравнение с теми командами, сервером и политикой обнаружения, которые вы действительно развернули бы.
Выполнение кода для композиции
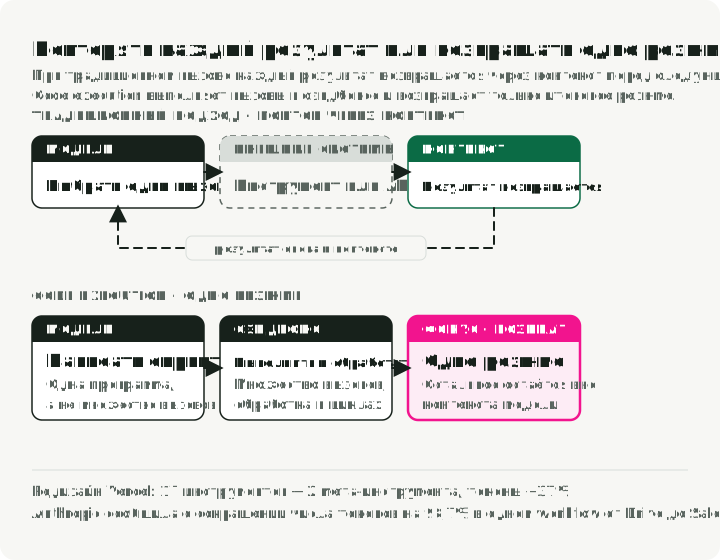
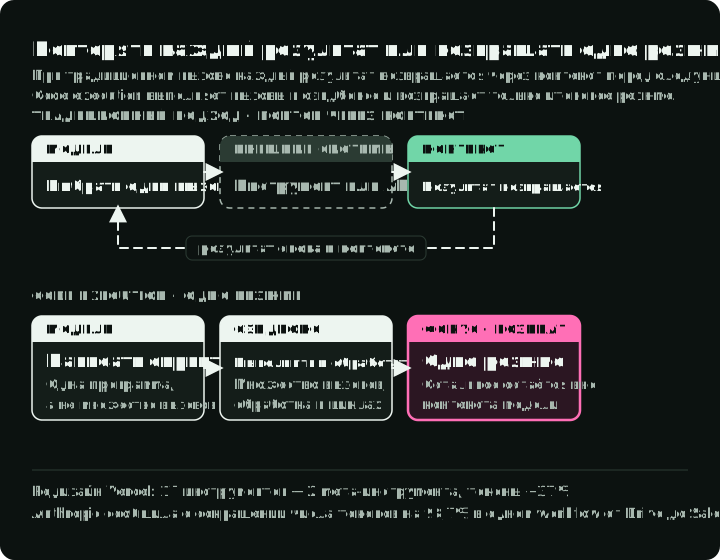
Сгенерированная программа полезна, когда агенту нужно объединить много вызовов, отфильтровать промежуточные данные или посчитать что-то по большому результату. Вместо того чтобы пропускать каждую строку через модель и просить ее спланировать следующую операцию, рантайм может выполнить цикл и вернуть нужную сводку. Статья CodeAct проверила 17 моделей и обнаружила до 20 процентных пунктов прироста успешности на 82 задачах с несколькими инструментами и до 30% меньше действий, чем у JSON-альтернатив. Это повод попробовать интерфейс на похожей работе, а не причина заменять одиночный типизированный запрос исполнителем кода.
Схема прогоняет проверку расходов от Anthropic, описанную ниже, обоими способами и сравнивает, что попадает в контекст модели.
Здесь два разных паттерна. Инструмент кода в Market Analyst Agent принимает Python для вычислений над данными, которые ему уже переданы. Он не позволяет этому коду вызывать инструменты рыночных данных. Он проверяет узлы синтаксического дерева, а затем выполняет код внутри процесса приложения. Этот allowlist — учебное ограничение, а не защитный сэндбокс для недоверенного кода. Прежде чем открывать доступ произвольному сгенерированному коду или чувствительным ресурсам процесса, выполнению нужен изолированный рантайм с ограничениями ресурсов и доступа.
Programmatic Tool Calling от Anthropic (PTC) устроен иначе: сгенерированный код может вызывать специально включенные инструменты внутри управляемой среды выполнения и возвращать выбранный результат в контекст модели. В примере Anthropic с анализом расходов вызов инструментов по одному требует более 20 проходов модели, и каждая строка проходит через контекст; сгенерированный код сократил то, что попадало в контекст, примерно с 200 КБ строк расходов до 1 КБ результатов. Скрипт ниже показывает этот поток управления с обычными асинхронными адаптерами на Python, а не с нативными обертками PTC:
# Custom async adapters that return decoded Python objects, not native PTC wrappers.
import asyncio
import json

async def main() -> None:
    team = await get_team_members("engineering")
    levels = list({member["level"] for member in team})
    budgets = dict(zip(levels, await asyncio.gather(*(get_budget_by_level(l) for l in levels))))
    expenses = await asyncio.gather(*(get_expenses(member["id"], "Q3") for member in team))
    over_budget = []
    for member, rows in zip(team, expenses):
        total = sum(row["amount"] for row in rows)
        limit = budgets[member["level"]]["travel_limit"]
        if total > limit:
            over_budget.append({"name": member["name"], "spent": total, "limit": limit})
    print(json.dumps(over_budget))  # Only this summary returns to the model

asyncio.run(main())
Нативные обертки PTC отличаются от этих адаптеров форматами аргументов и возвращаемых значений, и не каждый тип инструмента можно вызвать из кода; прежде чем переносить скрипт, сверьтесь с актуальным руководством. Настройка API allowed_callers направляет вызовы, но не заменяет авторизацию каждого нижележащего эффекта на стороне хоста, включая неожиданный прямой вызов. Если держать промежуточные строки вне контекста модели, это экономит токены, но не делает их конфиденциальными для среды выполнения и не освобождает от логирования и контроля доступа.
Выигрыш зависит от формы задачи. Во внутренних эвалах Anthropic бенчмарк по управлению проектами с 75 инструментами использовал примерно на 38% меньше оплачиваемых входных токенов при неизменной точности. На задачах tau2-bench с одним-двумя последовательными вызовами за ход оценки не изменились, а стоимость была примерно на 8% выше. Отдельный пример Drive-to-Salesforce сократился примерно со 150 000 до 2000 токенов, то есть на 98,7% для этого workflow. Ни одна из этих цифр не является универсальным показателем для кода в сравнении с JSON. Генерация кода, запуск рантайма, сбои и обработка вывода на простых задачах могут перевесить экономию контекста.
Два кейса вендоров показывают тот же подход в продуктах. Vercel перестроил своего text-to-SQL агента d0 вокруг двух общих инструментов, ExecuteCommand и ExecuteSQL, вместо 17, названных в его старом примере. На пяти репрезентативных запросах компания сообщает о росте успешности с 4/5 до 5/5, снижении среднего времени с 274,8 с до 77,4 с и сокращении токенов на 37%. В Code Mode от Cloudflare агенты пишут код TypeScript для работы с API вместо вызова схем инструментов, исходя из того, что модели видели гораздо больше реального TypeScript, чем примеров tool calls. Считайте оба случая данными вендоров и повторите сравнение на своих задачах.
JSON tool calling остается лучшим выбором для одиночных атомарных операций, сред без сэндбоксинга, небольших моделей со слабой генерацией кода и правил аудита, которые требуют записи каждого отдельного вызова.
Skills для процедур
Agent Skill упаковывает файл SKILL.md с именем, описанием и инструкциями; он также может содержать скрипты и справочные материалы. Открытый стандарт требует только name и description. Минимальный skill для этого агента мог бы выглядеть так:
---
name: stock-overview
description: Prepare a short overview of one stock. Use when the user asks for a current snapshot of a company.
---
1. Call get_stock_snapshot for the ticker.
2. If the result has no market timestamp, say that freshness is unknown.
3. Call search_news only if the user asked about recent events.
4. Cite every news item you use.
Skill говорит агенту, как пользоваться его инструментами; он не добавляет новой возможности. Используйте skills для предметных знаний, многошаговых процедур и повторяющейся работы вроде миграций баз данных или платежных интеграций. Хост по-прежнему определяет, какие инструменты агент может запускать. Текст skill — это указание, а не принудительное применение политики.
Формат позволяет сначала загрузить короткое имя и описание, около 100 токенов, а уже потом полные инструкции; скрипты и файлы, на которые он ссылается, загружаются только при необходимости. Это помогает, когда процедур много, но активный skill и все загружаемые им файлы по-прежнему расходуют контекст. Проверяйте его инструкции и исполняемые файлы так же, как любой другой ввод в харнесс. Если workflow критичен для безопасности, закодируйте нужную проверку в инструменте или приложении, а не полагайтесь на то, что инструкция будет выполнена.
Загруженный skill может и ухудшить результат. Исследование 2026 года на SkillsBench и SWE-Skills-Bench связало 307 сбоев с конкретными загруженными skills: 125 функциональных сбоев, когда результат задачи был неверным, и 182 регрессии эффективности, когда запуск обходился дороже. Это сбои, которые авторы смогли отнести к skills в двух бенчмарках, а не доля сбоев skills вообще. Прежде чем полагаться на новый skill, запустите его на репрезентативных задачах с ним и без него. Рекомендации Agent Framework от Microsoft тоже ограничивают skills идемпотентными или малорискованными операциями и предпочитают явный workflow, если у шага есть побочный эффект, например платеж, который нельзя повторять при повторной попытке. Инструменты skills там по умолчанию требуют подтверждения.
Сравните интерфейсы
| Вопрос | JSON tool calls | MCP | Skills | CLI | Выполнение кода |
|---|---|---|---|---|---|
| Лучше всего для | Простых одиночных действий | Общих сервисов для разных клиентов | Переиспользуемых процедур для другого интерфейса | Разработки и локальных операций | Многошаговой работы с большими результатами |
| Расход контекста | Загруженные схемы | Загруженные или отложенные схемы | Около 100 токенов до активации | Текст справки, команда и вывод | Входные схемы, код и вывод |
| Зависимые вызовы | Обычно один ход модели на вызов | Один ход модели плюс транспорт | Как у нижележащего интерфейса | Обычно один ход модели на вызов | Один ход на скрипт; поток выполняет рантайм |
| Поверхность атаки | Полномочия на аргументы и эффекты | Идентичность сервера и полномочия инструментов | Хост и ресурсы, которые он выдает | Shell, пути, учетные данные | Код, доступ к данным и исходящий сетевой трафик |
| Настройка | Низкая | Деплой сервера | Низкая; зависит от нижележащего интерфейса | Очень низкая для существующих команд | Рантайм в сэндбоксе |
| Отладка | Структурированные ввод и вывод | Добавляет транспортный слой | Читаемый Markdown | Команды видны | Читаемый код |
Skills направляют один из четырех других интерфейсов, поэтому их латентность и настройка определяются выбранным интерфейсом. Строки обобщают процитированные примеры, а не один контролируемый бенчмарк для всех пяти.
Некоторые компромиссы проходят через всю таблицу. Выполнение кода может экономить контекст, но добавляет время генерации и запуска контейнера. MCP экономит работу по интеграции, но добавляет сервер, который нужно эксплуатировать. CLI бесплатен на старте, но им труднее управлять в масштабе. Подбирайте интерфейс под команду: выполнение кода предполагает модель, которая пишет надежный код, CLI предполагает знание Unix-соглашений, а MCP — знакомство с транспортами и OAuth. Консолидация инструментов тоже может зайти слишком далеко, когда один инструмент собирает несвязанные режимы. Структурированные вызовы легко логировать, но ни один протокол сам по себе не создает полной записи аудита; хост, сервер или харнесс записывают вызовы и результаты и применяют политику.
Первый набор тестов для интерфейса
Более короткий список инструментов или более дешевый промпт полезен, только если агент по-прежнему выполняет работу. Сравнивайте интерфейсы на одном и том же наборе задач, с той же моделью, данными, разрешенными операциями и правилами завершения. Включите случаи, где правильный следующий шаг — попросить уточнение или остановиться.
Для Market Analyst Agent первый набор тестов мог бы включать такие случаи:
| Запрос или условие | Что проверить |
|---|---|
| Базовый обзор акции | Правильный тикер, поля снапшота, источник и рыночное время в ответе |
| Нужна история цен, но не нужны новости | Агент выбирает историю без лишних вызовов |
| Поставщик не возвращает корректную цену | Никакой выдуманной котировки; запуск сообщает, что данные недоступны |
| Большой набор независимых запросов | Качество итогового ответа, ходы модели, входные и выходные токены, латентность и сбои рантайма |
| Предложенная сделка во время исследовательского запроса | Никакого эффекта сделки; список исследовательских инструментов не дает такого действия |
Записывайте tool calls и их результаты, а не только итоговый ответ. Правдоподобный отчет может скрыть неудавшийся запрос; правильная итоговая цена может скрыть лишние вызовы. Если интерфейс меняется, считайте и успешные задачи, и новые виды сбоев: неверный выбор инструмента, некорректные аргументы, пропущенное обнаружение, повторные побочные эффекты, синтаксические ошибки и таймауты. Записывайте также токены на обнаружение, кэшированный и некэшированный ввод и повторы.
Затем интерфейс можно менять, когда это подтверждает измерение. Оставляйте типизированный вызов, пока он чисто решает задачу. Добавляйте MCP, когда нужно общее обнаружение, CLI-обертку, когда существующая команда — самая понятная операция, или выполнение кода, когда измеренный выигрыш от композиции оправдывает его рантайм. Контракт действия — что может произойти, какой результат это подтверждает и что означает сбой — по-прежнему должен быть явным.
Три направления для tool use в масштабе
Retrieval инструментов. Прежде чем модель сделает выбор, найдите несколько описаний инструментов, которые соответствуют запросу. В бенчмарке и стресс-тесте MCP из RAG-MCP retrieval поднял точность выбора инструментов с 13,62% до 43,13% и сократил токены промпта примерно с 2134 до 1084. Описания конфигурации в разных разделах статьи расходятся, что ограничивает переносимость этих цифр.
Агенты, которые создают инструменты. В LATM сильная модель пишет переиспользуемые функции на Python, которые затем вызывает модель поменьше. ToolMaker правильно реализовал 12 из 15 задач, построенных по статьям с открытым кодом. Этот небольшой бенчмарк не доказывает надежности в продакшене, но указывает направление: управление библиотекой сгенерированных инструментов.
A2A рядом с MCP. Google передал A2A в Linux Foundation в июне 2025 года. Документация A2A разделяет роли: MCP подключает агента к инструментам и ресурсам, а A2A позволяет отдельным агентам находить друг друга, обмениваться задачами и делегировать работу.
Часть 4, AI Agent Security, прослеживает предложенное действие до проверки прав. Часть 5, Agent Runtime, помещает выполнение в восстанавливаемый рантайм. Часть 6, Harness Engineering for AI Agents, сводит вместе цикл, инструменты, политику и проверку завершения.
Источники
Статьи
- Executable Code Actions Elicit Better LLM Agents (CodeAct) — Wang et al., ICML 2024
- SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering — Yang, Jimenez et al., NeurIPS 2024
- RAG-MCP: Mitigating Prompt Bloat in LLM Tool Selection
- LLMs As Tool Makers (LATM) — Cai et al., 2023
- ToolMaker: LLM Agents Making Agent Tools — Wölflein et al., ACL 2025
- MCPTox: A Benchmark for Tool Poisoning Attack on Real-World MCP Servers
- Agent Skills Can Be Harmful: An Empirical Study of Skill-Induced Failures in LLM Agents — Dong et al., 2026
Инженерные статьи и документация Anthropic
- Advanced tool use — Tool Search, Programmatic Tool Calling и примеры ввода
- Programmatic tool calling — актуальное руководство по API и ограничения
- Code execution with MCP — пример Drive-to-Salesforce
- Writing effective tools for agents
- Building effective agents
Протоколы
- Спецификация Model Context Protocol, 2026-07-28 и список изменений
- MCP Tasks extension
- Спецификация Agent Skills
- Microsoft Agent Framework: Agent Skills
- A2A and MCP
Кейсы и безопасность
- Vercel: We removed 80% of our agent’s tools
- Cloudflare: Code Mode
- Apideck: MCP server eating your context window
- Scalekit: MCP vs CLI
- Invariant Labs: MCP tool poisoning attacks
- Vulnerable MCP Project
- Writing CLI Tools That AI Agents Actually Want to Use — Ugo Enyioha
Демо-проект
- Market Analyst Agent — консолидация инструментов и паттерны ACI