AI Agent Tool Use: MCP, CLI, Skills y ejecución de código

Traducción automática
Este artículo se tradujo automáticamente a partir de la versión original en inglés.
Este artículo está dirigido a ingenieros que dan a un agente acceso a datos, comandos o servicios externos. Aprenderás a definir una acción que el agente pueda usar de forma fiable, a elegir una interfaz de ejecución para ella y a comprobar si esa interfaz ayuda en tus tareas. El ejemplo que recorre el artículo es el Market Analyst Agent, un agente de investigación que obtiene datos de mercado y prepara informes.
En la Parte 1, el modelo elegía el siguiente paso dentro de un reasoning loop. La Parte 2 trató lo que puede conservar entre pasos. Una herramienta da a esa elección un efecto fuera del modelo: puede obtener una cotización, leer un informe guardado, ejecutar código o modificar un registro. El programa que rodea al modelo, el harness, sigue decidiendo qué acciones existen y si una llamada propuesta puede ejecutarse.
La primera decisión de diseño es la propia acción. Si el agente necesita datos de precio y valoración para un informe, ¿debe solicitar dos endpoints de API, un snapshot de la acción bursátil o un programa generado? La respuesta depende de la tarea y del feedback que necesita el agente, no del protocolo de integración.
Para la decisión rápida sobre la interfaz, consulta AI Agent Tool Interfaces.
Qué necesita un resumen de empresa
Supongamos que el usuario pide al Market Analyst Agent un resumen actual de una empresa. El agente puede necesitar una cotización reciente, el volumen negociado, métricas de valoración, el historial de precios y noticias. Son preguntas distintas. La última cotización y las métricas básicas suelen ir en la misma respuesta, mientras que el historial de precios y las noticias pueden sobrar en una respuesta breve. Una capacidad ajena, como ejecutar una operación de compraventa, no debe entrar en este flujo de investigación.
Antes de exponer una API, anota cuatro cosas:
- Acción: ¿Qué puede solicitar el agente en un paso? Prefiere una operación que corresponda a una pregunta que realmente necesita responder.
- Argumentos: ¿Qué entradas debe aportar quien llama y cuáles puede validar la aplicación antes de contactar con el servicio?
- Resultado: ¿Qué datos permiten al agente decidir su siguiente paso y qué procedencia o identificadores deben conservarse para comprobaciones posteriores?
- Fallo y efecto: ¿Qué puede cambiar, cómo sabe quien llama si la acción se produjo y cuándo es seguro reintentar?
Estas preguntas separan tres responsabilidades. El modelo propone una acción. El harness la valida y la enruta. La implementación de la herramienta la ejecuta y devuelve un resultado. Un JSON Schema puede rechazar un ticker mal formado; no puede establecer que una operación de compraventa esté autorizada. Un protocolo puede entregar un tool call; no puede hacer que repetir una escritura fallida sea seguro.
El artículo de SWE-agent llama al diseño de esta interacción Agent-Computer Interface (ACI), por analogía con la interacción persona-ordenador: los agentes basados en modelos de lenguaje son un nuevo tipo de usuario y se benefician de interfaces creadas para ellos. Su ablación sobre 300 tareas de SWE-bench Lite alcanzó un 18,0 % con la interfaz completa, frente al 7,3 % de una condición solo con shell sin demostración resuelta y al 11,0 % con una. Las condiciones difieren en algo más que una descripción de herramienta, así que estas cifras no predicen la mejora de rediseñar tus propias herramientas. Sí muestran que la interfaz debe probarse junto con el modelo. Building Effective Agents, de Anthropic, dice lo mismo: dedica a la interfaz agente-ordenador tanto esfuerzo como a una interfaz para personas.
La figura sigue una llamada a get_stock_snapshot a través del modelo, el harness y la herramienta, y numera cada paso con el principio de la lista siguiente que lo rige. La comprobación de precio ausente es una recomendación: la implementación del snapshot fijada a esta revisión asigna actualmente cero por defecto a un precio ausente.
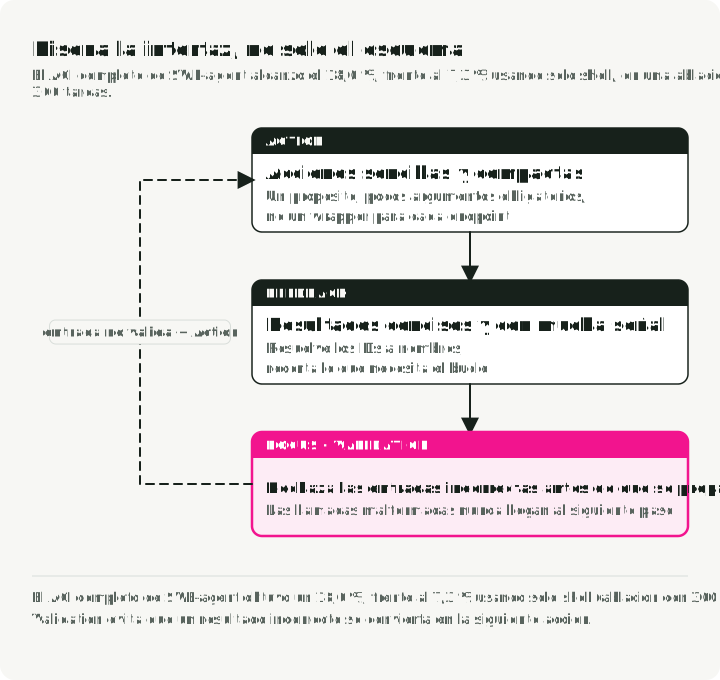
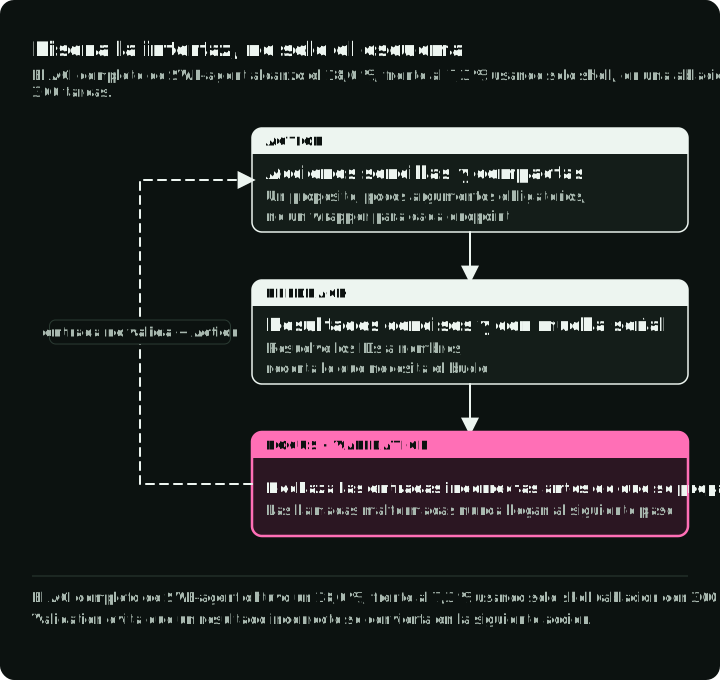
Los cuatro principios ACI se aplican a todas las interfaces de este artículo:
- Acciones simples. No envuelvas los endpoints de la API uno a uno. En lugar de
list_users,list_eventsycreate_event, ofreceschedule_event, que busca disponibilidad y reserva en una sola llamada. En lugar deread_logs, ofrecesearch_logs, que devuelve las líneas relevantes con contexto. - Acciones compactas. Combina operaciones que sirven a una misma tarea, como hace el snapshot de la acción más abajo.
- Feedback conciso e informativo. Devuelve nombres semánticos en lugar de HTML en bruto, payloads completos de la API o IDs crípticos, pero conserva cualquier ID que necesite una llamada posterior.
- Validación que impide que los errores se propaguen. Comprueba los argumentos antes de la llamada y los resultados antes de la siguiente acción. En SWE-agent, un editor con linting integrado rechazaba los errores de sintaxis; activarlo elevó la condición de edición del 15,0 % al 18,0 %.
Una herramienta fácil de elegir y de usar
El Market Analyst Agent ofrece un ejemplo concreto. Una versión anterior exponía get_stock_price y get_company_metrics por separado. El executor expone ahora get_stock_snapshot, get_price_history, get_financials, search_news y search_competitors. El snapshot combina precio, volumen, capitalización bursátil y PER porque un resumen básico suele necesitarlos juntos. El historial, los estados financieros y las noticias siguen separados porque el agente puede no necesitar cada uno de ellos.
| Antes (herramientas originales) | Después (herramientas de datos de mercado) | Por qué |
|---|---|---|
get_stock_price + get_company_metrics | get_stock_snapshot | Una llamada devuelve el snapshot básico de precio y valoración |
get_price_history | get_price_history | Se mantiene, con periodos validados y resumen del volumen medio |
search_news | search_news | Devuelve elementos estructurados con los puntos clave extraídos |
search_competitors | search_competitors | Mantiene la acción de búsqueda centrada en competidores |
| Sin herramienta de estados financieros | get_financials | Selecciona por parámetro cuenta de resultados, balance o flujo de caja |
La lista de herramientas del agente incluye además un cargador de skills, dos wrappers de CLI y un evaluador de Python restringido dentro del proceso, así que cubre tres de las interfaces descritas más abajo; MCP aparece como un sidecar aparte.
Es una decisión sobre el tamaño de la acción. Un wrapper uno a uno de cada endpoint upstream obliga al modelo a planificar en torno a la estructura de la API del proveedor. Una sola herramienta con muchos modos no relacionados solo traslada el problema de selección a sus argumentos. Agrupa los campos que sirven a la misma tarea y después comprueba si los agentes eligen la acción correcta.
Escribe la descripción para el modelo
La descripción del snapshot indica cuándo llamarlo primero, qué devuelve y cuándo elegir en su lugar el historial o los estados financieros. Esa orientación sobre las herramientas vecinas importa tanto como el nombre. «Search for items» no puede decir al modelo si search_news o search_competitors responde a una petición. La guía de diseño de herramientas de Anthropic también recomienda descripciones, ejemplos y resultados que ayuden al modelo a elegir la acción correcta, y su documentación sobre definición de herramientas sugiere al menos tres o cuatro frases que cubran cuándo usar la herramienta, sus parámetros, su salida y los casos límite:
# Vague: the model cannot tell when to use it.
vague = [{"name": "search", "description": "Search for items"}]

# Specific: when to use it, what it returns, and which tool to use instead.
specific = [{
    "name": "search_news",
    "description": (
        "Search for recent news articles about a specific stock or company. "
        "Use this tool when the user asks about recent events, earnings, "
        "announcements, or market-moving news for a specific ticker. "
        "Returns up to 10 articles sorted by relevance. "
        "For company competitors rather than news, use search_competitors instead."
    ),
    "input_schema": {
        "type": "object",
        "properties": {
            "query": {
                "type": "string",
                "description": "Search query. Examples: 'NVDA earnings Q3 2025', 'Tesla delivery numbers'",
            },
            "max_results": {
                "type": "integer",
                "description": "Max articles to return (1-10, default 5)",
                "default": 5,
            },
        },
        "required": ["query"],
    },
}]
Añade ejemplos donde los parámetros sean ambiguos; no gastes contexto repitiendo lo que ya dice un schema simple. En las pruebas internas de Anthropic, añadir un campo input_examples elevó la precisión en el manejo de parámetros complejos del 72 % al 90 %. Anthropic también informa de que usar prefijo o sufijo como espacio de nombres (asana_search o search_asana) tuvo efectos apreciables en sus evaluaciones, sin decir cuál ganó, así que prueba ambos con tu conjunto de herramientas. Después dio transcripciones de evaluación a Claude Code para que reescribiera las herramientas, y en pruebas reservadas ese ciclo superó a sus herramientas escritas por expertos.
Valida los argumentos y da forma a los resultados
La implementación valida el ticker antes de la petición de datos de mercado. Este fragmento está adaptado del código enlazado; el normalizador compartido recorta y pasa a mayúsculas el valor y acepta sufijos con punto o guion como BRK.B y BF-B. La consulta de historial añade un conjunto de periodos permitidos:
from pydantic import BaseModel, Field, field_validator

from market_analyst.utils import normalize_ticker

class StockQuery(BaseModel):
    ticker: str = Field(description="Stock ticker symbol (e.g., NVDA)")

    @field_validator("ticker")
    @classmethod
    def validate_ticker(cls, value: str) -> str:
        return normalize_ticker(value)

class StockHistoryQuery(StockQuery):
    period: str = Field(default="1mo", description="Time period: 1d, 5d, 1mo, 3mo, 6mo, 1y")

    @field_validator("period")
    @classmethod
    def validate_period(cls, value: str) -> str:
        valid = {"1d", "5d", "1mo", "3mo", "6mo", "1y"}
        if value not in valid:
            raise ValueError(f"Invalid period: {value}. Must be one of {valid}")
        return value
Las herramientas de acciones y noticias devuelven resultados validados con Pydantic en lugar de payloads en bruto del proveedor. El campo summary da al agente una cadena lista para un informe, y key_points le evitan analizar el cuerpo de los artículos:
from pydantic import BaseModel

class StockSnapshot(BaseModel):
    ticker: str
    price: float
    change_pct: float
    volume: int
    market_cap_b: float
    pe_ratio: float | None
    summary: str  # One line for direct use in a report

class NewsItem(BaseModel):
    headline: str
    source: str
    date: str
    relevance_score: float  # Pre-ranked by the tool
    key_points: list[str]  # Extracted by the tool, not the agent

class NewsSearchResult(BaseModel):
    query: str
    results: list[NewsItem]
    summary: str
El resultado del snapshot tiene estos campos tipados para precio, variación porcentual, volumen, capitalización bursátil, PER y un breve resumen. Añade al resultado la fuente de los datos y la hora de referencia del mercado, y haz que el informe las indique. Obtener los datos ahora no demuestra que la cotización sea actual.
Mantén los resultados lo bastante cortos para la siguiente decisión, pero no descartes un identificador o una fuente que necesite una acción posterior. En un resultado de búsqueda, un título y un resumen pueden bastar para ordenar candidatos; la URL o el ID debe seguir disponible si el agente tiene que recuperar o citar un elemento concreto. Un resultado conciso y otro detallado pueden servir a pasos distintos: las pruebas de Anthropic añadieron un parámetro response_format que devolvía unos 72 tokens en modo conciso y 206 en modo detallado. Los payloads upstream en bruto rara vez son un valor por defecto útil.
Devuelve errores sobre los que el bucle pueda actuar
Los errores forman parte del mismo contrato. No asignes cero por defecto a un precio ausente, porque entonces una cotización no disponible parece un precio de cero dólares. Tampoco envuelvas todos los fallos finales en un único tipo de excepción, porque entonces quien llama no puede elegir una categoría de reintento. Rechaza los datos de mercado ausentes y distingue entre entrada no válida, fallo temporal del proveedor y datos no disponibles. Una herramienta que escribe estado externo también debe distinguir un fallo conocido de un resultado que puede haberse completado aunque se perdiera la respuesta. Devuelve detalle suficiente para elegir entre reintento, aclaración o escalado; evita que el texto del proveedor se convierta en una instrucción para el modelo.
Cuatro mecanismos gestionan distintas clases de fallo: reintento con backoff para errores transitorios, fallback de modelo para caídas del proveedor, una clasificación que devuelve al agente los errores recuperables y escala el resto, y recuperación desde checkpoint ante caídas del proceso (Parte 2). Reintenta solo los fallos transitorios, como timeouts, errores de red y respuestas 429 y 5xx, con backoff exponencial y un límite pequeño de intentos; una biblioteca como Tenacity lo hace con un decorador. Quien llama sigue teniendo que convertir una excepción final, o un 4xx no reintentable, en un resultado estable que diga qué operación falló y qué hacer a continuación. Reintentar una petición no clasifica su error, y solo es seguro para una lectura o una escritura idempotente. Mide la tasa de recuperación, los reintentos y los escalados en tu propio conjunto de tareas.
Prueba el contrato
Desde el repositorio complementario, instala sus dependencias bloqueadas y ejecuta las pruebas de herramientas:
uv sync --locked
uv run pytest tests/test_tools.py -q
La prueba del snapshot inyecta datos de mercado sintéticos y comprueba el ticker, el precio, el volumen, los campos de valoración y el resumen. Prueba el contrato de la herramienta sin una cotización en vivo ni un modelo; no mide si un agente elige la herramienta correcta. Con credenciales del proveedor configuradas como indica el README del repositorio, también puedes ejecutar uv run market-analyst "NVDA price update" --mode flash --no-persist para revisar un borrador generado por el agente. Esa ejecución usa servicios en vivo y es un ejemplo, no un benchmark.
Elige la interfaz de ejecución
Cuando el contrato de la acción está claro, elige cómo llega el agente a ella. Estas interfaces responden a preguntas distintas; una más nueva no sustituye a otra más antigua.
La figura recorre cada ruta del Market Analyst Agent desde el modelo hasta la operación a la que llega.
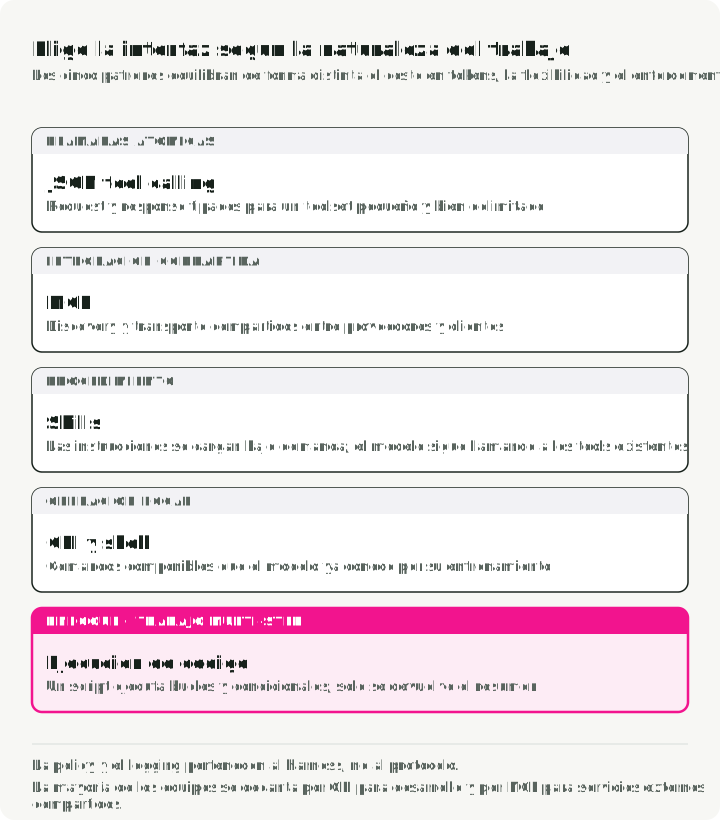
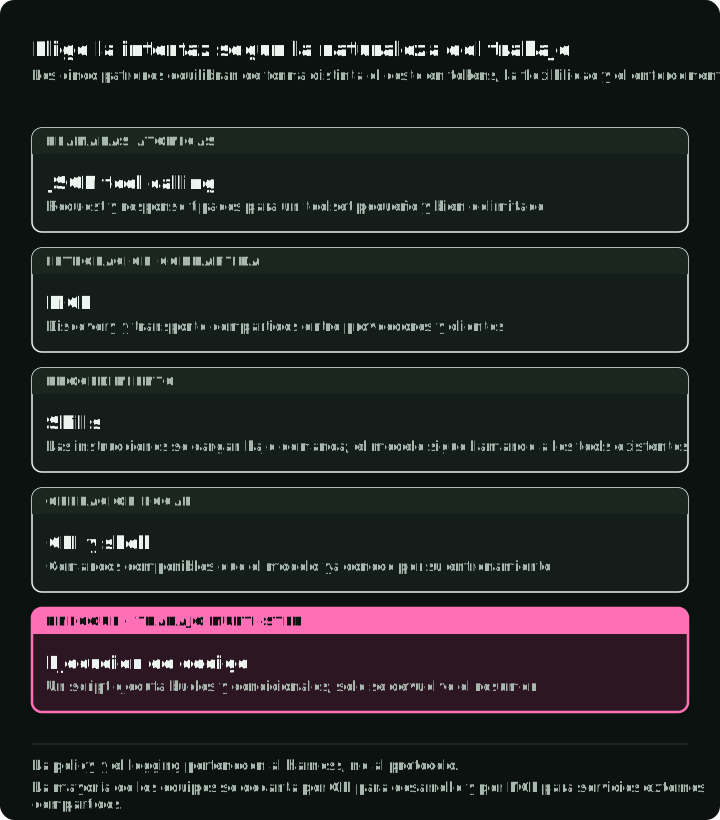
| Necesidad | Interfaz inicial | Qué aporta |
|---|---|---|
| Un conjunto pequeño de operaciones tipadas en una aplicación | Tool calls JSON | Nombres, argumentos y resultados explícitos |
| Las mismas herramientas servidas a varios clientes | MCP | Descubrimiento y transporte compartidos |
| Un comando existente con salida estable | Wrapper de CLI | Reutilización del comando y de su ayuda |
| Muchas operaciones dependientes o procesamiento local de datos | Ejecución de código | Bucles, condicionales y filtrado dentro de una ejecución |
| Instrucciones reutilizables para cualquiera de las anteriores | Skill | Orientación que se carga cuando es relevante |
La tabla da una primera opción; no clasifica las interfaces por rendimiento. Las herramientas MCP siguen teniendo schemas y llamadas estructuradas. Una CLI puede estar detrás de un wrapper de herramienta JSON. Un ejecutor de código puede llamar a herramientas permitidas. Las Skills son instrucciones para usar una capacidad, no otro canal de ejecución.
Llamadas tipadas para acciones acotadas
Para get_stock_snapshot(ticker), basta con una llamada tipada. El modelo aporta un ticker; el harness comprueba el argumento, invoca la implementación y devuelve un resultado estructurado. La siguiente llamada puede depender de ese resultado. Las consultas independientes a menudo pueden ejecutarse en paralelo, pero una llamada cuyos argumentos dependen del primer resultado necesita otro paso del modelo, salvo que el código de la aplicación combine las operaciones.
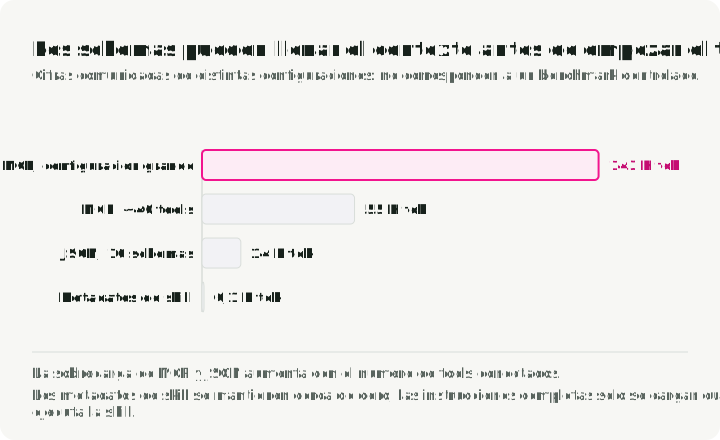
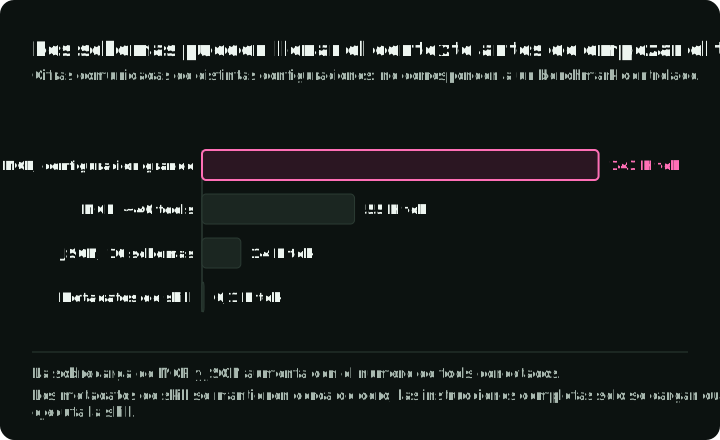
El bajo coste de puesta en marcha es útil cuando una aplicación posee un conjunto pequeño de herramientas. Los tokens de los schemas siguen contando cuando las definiciones de herramientas se cargan en el contexto, así que mide el tamaño de tus definiciones reales. Si el catálogo crece, el descubrimiento diferido puede cargar solo las candidatas probables. En el ejemplo de Tool Search de Anthropic, el contexto aproximado previo al trabajo bajó de 77.000 a 8.700 tokens en una configuración con más de 50 herramientas, al cargar solo las tres a cinco herramientas que necesita una petición. Es un resultado de su conjunto de herramientas y su método de recuperación, y añade un paso de descubrimiento antes de cada llamada. Ayuda menos con un conjunto pequeño de herramientas que se usa en cada sesión. El descubrimiento también debe probarse frente a herramientas omitidas o incorrectas.
Cargar un schema tiende a ser irreversible: una definición que el modelo puede llamar veinte pasos después tiene que seguir disponible, y quitarla cambia la parte estable de la petición de la que depende el prefix caching, así que un paso de descubrimiento normalmente añade definiciones y nunca intercambia una por otra. Además, un schema que el modelo aún puede ver no es un permiso que el modelo aún conserva. Registra la versión del schema y el permiso efectivo en el momento del descubrimiento, y vuelve a comprobar el permiso cuando la llamada se envía a ejecución.
Cuando un resultado se acorta para ajustarse al presupuesto, indícalo en el propio resultado y da al modelo una forma de solicitar un rango de líneas o de bytes de la salida completa, para que distinga una respuesta corta de una truncada y pida el resto cuando importe.
El gráfico sitúa este ejemplo en una misma escala de tokens junto con las configuraciones MCP que se describen más adelante en esta sección.
MCP para un servicio compartido
El Model Context Protocol permite que un servidor anuncie herramientas y otras capacidades a los clientes mediante stdio o HTTP. El cliente MCP del agente se conecta, pregunta al servidor qué ofrece y reenvía las llamadas del modelo, de modo que un servidor funciona con cualquier cliente que hable el protocolo. Desde diciembre de 2025, MCP está gobernado por la Agentic AI Foundation dentro de la Linux Foundation, no por un único proveedor.
Usa MCP cuando un servicio deba ser accesible desde varios hosts de agentes, para integraciones SaaS como Figma, Notion o Salesforce, para servicios sin CLI o cuando el descubrimiento estandarizado, la gestión de OAuth y la integración remota justifiquen el coste de operar un servidor. El Market Analyst Agent también expone sus herramientas de investigación mediante un sidecar MCP. La acción de bolsa no se ha convertido en otra operación de negocio solo porque el cliente la descubra a través de MCP.
El protocolo no autoriza un efecto de negocio solicitado. El servidor y la aplicación siguen necesitando autenticación, permisos acotados, comprobaciones de entrada y un registro de auditoría para las operaciones que importan. Las descripciones de herramientas y los documentos devueltos también son entradas no confiables; la demostración de tool poisoning de Invariant Labs muestra que instrucciones maliciosas en los metadatos de una herramienta pueden influir en un agente antes de que se llame a la herramienta. El benchmark MCPTox, que probó 20 agentes LLM contra 45 servidores MCP en vivo y 353 herramientas reales, informó de la mayor tasa de éxito de ataque, un 72,8 %, para o1-mini en su configuración de tool poisoning; es el resultado de benchmark de un modelo, no una tasa de incidentes. El Vulnerable MCP Project recopila informes útiles como casos de prueba. El host debe tratar el texto de las herramientas como datos, no como una concesión de autoridad.
Comprueba qué revisión de MCP admite cada parte. La revisión 2026-07-28 hace que las peticiones sean sin estado, sustituye el handshake de inicialización y elimina la reanudación de streams, así que los tutoriales antiguos pueden no coincidir con el SDK que instales. Un stream de respuesta interrumpido necesita entonces una nueva petición, otro motivo para evitar efectos de negocio duplicados en la propia herramienta. Revisa el SDK instalado y el contrato del servidor antes de depender de una funcionalidad. Para una llamada que tarda más que una respuesta, la extensión Tasks oficial añade un identificador duradero: el servidor devuelve un ID de tarea, y el cliente consulta o cancela el trabajo con tasks/get y tasks/cancel. La Parte 6 usa ese identificador cuando una llamada agota el tiempo de espera.
Los catálogos grandes pueden salir caros si todas las descripciones se cargan en cada petición. Apideck describe una configuración habitual, GitHub, Slack y Sentry con unas 40 herramientas, que carga aproximadamente 55.000 tokens de definiciones antes de que el usuario pregunte nada, y cita a un equipo cuyos tres servidores MCP usaban 143.000 de 200.000 tokens de contexto. Ambas son cifras reportadas, no mediciones de tu catálogo. Es una decisión sobre la carga de schemas, no un precio inherente al protocolo de transmisión de MCP. Cuando sea posible, carga un conjunto relevante más pequeño y mide si el descubrimiento sigue encontrando la herramienta correcta.
Wrappers de CLI para comandos consolidados
Una CLI resulta atractiva cuando la operación ya existe como comando con un --help útil, códigos de salida estables y salida legible por máquina. Las herramientas CLI del Market Analyst Agent envuelven dos comandos concretos para listar y mostrar informes guardados. Pasan una lista de argumentos a subprocess.run y piden JSON; el agente no recibe una shell arbitraria. Esa distinción hace visible la acción permitida y evita tratar como fiable cada cadena de comando generada.
Un comando ampliamente documentado como git, gh, docker, kubectl, curl o jq puede requerir poca documentación nueva para un agente de programación, pero una CLI interna sigue necesitando ejemplos y contratos de salida. La guía de Ugo Enyioha Writing CLI Tools That AI Agents Actually Want to Use enumera ocho reglas para un comando así:
- Admite salida estructurada con
--json. - Usa códigos de salida distintos para distintos tipos de error.
- Haz que los comandos sean idempotentes.
- Ofrece
--helpcon ejemplos realistas. - Admite la composición:
--quietpara valores sin adornos y entrada por stdin. - Ofrece
--dry-runy--yes. - Indica la versión de la herramienta.
- Toma las credenciales de variables de entorno.
Una shell añade pipes y composición, junto con acceso a archivos, procesos, credenciales y rutas de red. Dale solo el acceso que requiere la tarea. Una CLI no tiene un modelo de descubrimiento ni de autorización a nivel de protocolo; el harness debe aplicar la política y registrar las llamadas que necesite auditar. Una opción práctica por defecto es CLI para desarrollo y operaciones locales, y MCP para servicios externos compartidos cuando el descubrimiento entre clientes o la gestión de OAuth justifiquen operar un servidor.
En la comparación de 75 ejecuciones de Scalekit, la CLI usó menos tokens en cinco tareas de GitHub de solo lectura que una configuración que cargaba 43 tool schemas de MCP. Sus siete fallos de MCP fueron timeouts de conexión con el servidor remoto. Estos resultados comparan esas interfaces desplegadas, no una propiedad general según la cual la CLI sea más fiable o MCP requiera más contexto. Repite la comparación con los comandos, el servidor y la política de descubrimiento que realmente desplegarías.
Ejecución de código para la composición
Un programa generado es útil cuando el agente debe combinar muchas llamadas, filtrar datos intermedios o calcular sobre un resultado grande. En lugar de pasar cada fila por el modelo y pedirle que planifique la siguiente operación, un runtime puede ejecutar un bucle y devolver el resumen relevante. El artículo de CodeAct probó 17 modelos y encontró hasta 20 puntos porcentuales más de éxito en sus 82 tareas con varias herramientas, con hasta un 30 % menos de acciones que las alternativas JSON. Es una prueba para ensayar la interfaz en trabajo similar, no un motivo para sustituir una consulta tipada única por un ejecutor de código.
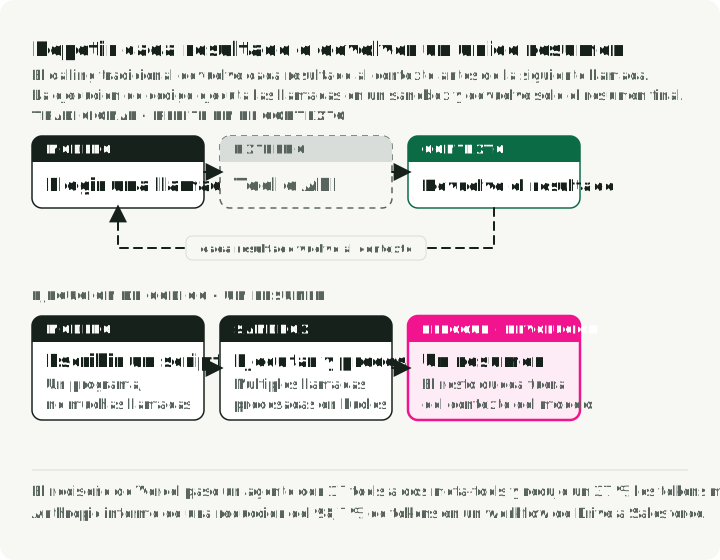
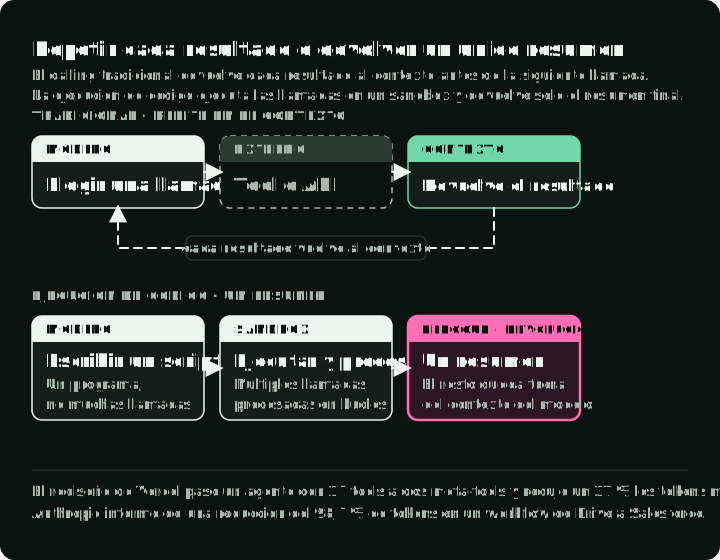
La figura ejecuta de las dos formas la comprobación de gastos de Anthropic, que se describe más abajo, y compara lo que llega al contexto del modelo.
Aquí hay dos patrones distintos. La herramienta de código del Market Analyst Agent acepta Python para cálculos sobre datos que ya se le han proporcionado. No permite que ese código llame a las herramientas de datos de mercado. Comprueba los nodos del árbol sintáctico y después ejecuta el código dentro del proceso de la aplicación. Esa lista de permitidos es una restricción didáctica, no un sandbox de seguridad para código no confiable. Antes de exponer código generado arbitrario o recursos sensibles del proceso, la ejecución necesita un runtime aislado con límites de recursos y de acceso.
El Programmatic Tool Calling de Anthropic (PTC) es una disposición distinta: el código generado puede invocar herramientas habilitadas expresamente dentro de un entorno de ejecución gestionado y devolver un resultado seleccionado al contexto del modelo. En el ejemplo de análisis de gastos de Anthropic, llamar herramienta por herramienta requiere más de 20 pasadas del modelo con cada fila pasando por el contexto; el código generado redujo lo que llegaba al contexto de unos 200 KB de filas de gastos a 1 KB de resultados. El script siguiente muestra ese flujo de control con adaptadores asíncronos de Python corrientes, no con los wrappers nativos de PTC:
# Custom async adapters that return decoded Python objects, not native PTC wrappers.
import asyncio
import json

async def main() -> None:
    team = await get_team_members("engineering")
    levels = list({member["level"] for member in team})
    budgets = dict(zip(levels, await asyncio.gather(*(get_budget_by_level(l) for l in levels))))
    expenses = await asyncio.gather(*(get_expenses(member["id"], "Q3") for member in team))
    over_budget = []
    for member, rows in zip(team, expenses):
        total = sum(row["amount"] for row in rows)
        limit = budgets[member["level"]]["travel_limit"]
        if total > limit:
            over_budget.append({"name": member["name"], "spent": total, "limit": limit})
    print(json.dumps(over_budget))  # Only this summary returns to the model

asyncio.run(main())
Los wrappers nativos de PTC difieren de estos adaptadores en los formatos de argumentos y de retorno, y no todos los tipos de herramienta pueden llamarse desde código; consulta la guía actual antes de portar un script. El ajuste allowed_callers de la API orienta la invocación, pero no sustituye la autorización por parte del host de cada efecto subyacente, incluida una llamada directa inesperada. Mantener las filas intermedias fuera del contexto del modelo ahorra tokens, pero no las hace confidenciales frente al entorno de ejecución ni las exime del registro y los controles de acceso.
El beneficio depende de la forma de la tarea. En las evaluaciones internas de Anthropic, un benchmark de gestión de proyectos con 75 herramientas usó alrededor de un 38 % menos de tokens de entrada facturados con la misma precisión. En tareas de tau2-bench con una o dos llamadas secuenciales por turno, las puntuaciones no cambiaron y el coste fue aproximadamente un 8 % mayor. Un ejemplo aparte de Drive a Salesforce bajó de unos 150.000 a 2.000 tokens, una reducción del 98,7 % para ese workflow. Ninguna es una tasa universal de código frente a JSON. La generación de código, el arranque del runtime, los fallos y el manejo de la salida pueden superar el ahorro de contexto en tareas sencillas.
Dos casos de estudio de proveedores muestran el mismo diseño en productos. Vercel reconstruyó su agente text-to-SQL d0 en torno a dos herramientas generales, ExecuteCommand y ExecuteSQL, en lugar de las 17 que citaba su ejemplo anterior. En cinco consultas representativas informa de que el éxito subió de 4/5 a 5/5, el tiempo medio bajó de 274,8 s a 77,4 s y los tokens bajaron un 37 %. Con el Code Mode de Cloudflare, los agentes escriben TypeScript contra una API en lugar de llamar a tool schemas, con el argumento de que los modelos han visto mucho más TypeScript real que ejemplos de tool calls. Trata ambos como pruebas de proveedores y repite la comparación en tus tareas.
El tool calling JSON sigue siendo la mejor opción para operaciones atómicas únicas, entornos sin sandboxing, modelos pequeños con poca capacidad de generar código y normas de auditoría que exigen un registro de cada llamada individual.
Skills para procedimientos
Una Agent Skill empaqueta un archivo SKILL.md con un nombre, una descripción e instrucciones; también puede contener scripts y referencias. El estándar abierto solo exige name y description. Una skill mínima para este agente podría ser así:
---
name: stock-overview
description: Prepare a short overview of one stock. Use when the user asks for a current snapshot of a company.
---
1. Call get_stock_snapshot for the ticker.
2. If the result has no market timestamp, say that freshness is unknown.
3. Call search_news only if the user asked about recent events.
4. Cite every news item you use.
La skill le dice al agente cómo usar sus herramientas; no añade ninguna capacidad nueva. Usa skills para conocimiento del dominio, procedimientos de varios pasos y trabajo recurrente como migraciones de bases de datos o integraciones de pagos. El host sigue determinando qué herramientas puede ejecutar el agente. El texto de una skill es orientación, no aplicación de políticas.
El formato permite cargar el nombre corto y la descripción, unos 100 tokens, antes de las instrucciones completas; los scripts y archivos referenciados solo se cargan cuando hacen falta. Eso ayuda cuando existen muchos procedimientos, pero la skill activa y los archivos que carga siguen consumiendo contexto. Revisa sus instrucciones y archivos ejecutables como cualquier otra entrada al harness. Si un workflow es crítico para la seguridad, codifica la validación necesaria en la herramienta o en la aplicación en lugar de confiar en que se siga una instrucción.
Una skill cargada también puede empeorar los resultados. Un estudio de 2026 sobre SkillsBench y SWE-Skills-Bench atribuyó 307 fallos a skills concretas cargadas: 125 fallos funcionales, en los que el resultado de la tarea era incorrecto, y 182 regresiones de eficiencia, en las que la ejecución costó más. Son fallos que los autores pudieron atribuir en dos benchmarks, no una tasa de fallos de las skills en general. Ejecuta una skill nueva con tareas representativas, con ella y sin ella, antes de depender de ella. La guía de Agent Framework de Microsoft también limita las skills a operaciones idempotentes o de bajo riesgo y prefiere un flujo de trabajo explícito cuando un paso tiene un efecto secundario, como un pago, que no debe repetirse en un reintento. Sus herramientas de skills requieren aprobación por defecto.
Compara las interfaces
| Pregunta | Tool calls JSON | MCP | Skills | CLI | Ejecución de código |
|---|---|---|---|---|---|
| Ideal para | Acciones simples e individuales | Servicios compartidos entre clientes | Procedimientos reutilizables para otra interfaz | Desarrollo y operaciones locales | Trabajo en varios pasos sobre resultados grandes |
| Coste de contexto | Schemas cargados | Schemas cargados o diferidos | Unos 100 tokens hasta que se activa | Texto de ayuda, comando y salida | Schemas de entrada, código y salida |
| Llamadas dependientes | Normalmente un turno del modelo por llamada | Un turno del modelo más el transporte | Sigue a la interfaz subyacente | Normalmente un turno del modelo por llamada | Un turno para el script; el runtime ejecuta el flujo |
| Superficie de seguridad | Autoridad sobre argumentos y efectos | Identidad del servidor y autoridad de las herramientas | El host y los recursos que concede | Shell, rutas, credenciales | Código, acceso a datos y salida de red |
| Puesta en marcha | Baja | Despliegue del servidor | Baja; depende de la interfaz subyacente | Muy baja para comandos existentes | Un runtime en sandbox |
| Depuración | Entrada y salida estructuradas | Añade una capa de transporte | Markdown legible | Los comandos son visibles | Código legible |
Las Skills guían una de las otras cuatro interfaces, así que su latencia y su puesta en marcha dependen de la interfaz que seleccionan. Las filas resumen los ejemplos citados, no un benchmark controlado de las cinco.
Algunos trade-offs atraviesan la tabla. La ejecución de código puede ahorrar contexto, pero añade tiempo de generación y de contenedor. MCP ahorra trabajo de integración, pero añade un servidor que operar. La CLI no cuesta nada para empezar y es más difícil de gobernar a escala. Adapta la interfaz a tu equipo: la ejecución de código supone un modelo que escribe código fiable, la CLI supone convenciones de Unix y MCP supone familiaridad con transportes y OAuth. Consolidar herramientas también puede ir demasiado lejos, cuando una herramienta reúne modos no relacionados. Las llamadas estructuradas son fáciles de registrar, pero ningún protocolo crea por sí solo un registro de auditoría completo; el host, el servidor o el harness registran llamadas y resultados y aplican la política.
Un primer conjunto de pruebas para la interfaz
Una lista de herramientas más corta o un prompt más barato solo son útiles si el agente sigue completando el trabajo. Compara interfaces con el mismo conjunto de tareas, modelo, datos, operaciones permitidas y reglas de finalización. Incluye casos en los que el siguiente paso correcto sea pedir una aclaración o detenerse.
Para el Market Analyst Agent, un primer conjunto de pruebas podría incluir estos casos:
| Petición o condición | Qué inspeccionar |
|---|---|
| Resumen básico de una acción | Ticker correcto, campos del snapshot, fuente y hora del mercado en la respuesta |
| Hace falta el historial de precios, pero no las noticias | El agente selecciona el historial sin llamadas innecesarias |
| El proveedor no devuelve un precio válido | Ninguna cotización inventada; la ejecución informa de datos no disponibles |
| Gran conjunto de consultas independientes | Calidad de la respuesta final, turnos del modelo, tokens de entrada/salida, latencia y fallos del runtime |
| Operación de compraventa propuesta durante una investigación | Ningún efecto de compraventa; la lista de herramientas de investigación no concede esa acción |
Registra los tool calls y sus resultados, además de la respuesta final. Un informe plausible puede ocultar una consulta fallida; un precio final correcto puede ocultar llamadas innecesarias. Si cambia una interfaz, cuenta tanto las tareas completadas como los nuevos modos de fallo: selección de herramienta incorrecta, argumentos no válidos, descubrimiento fallido, efectos secundarios repetidos, errores de sintaxis y timeouts. Registra también los tokens de descubrimiento, la entrada con y sin caché y los reintentos.
Después puedes cambiar la interfaz cuando una medición lo respalde. Mantén una llamada tipada mientras resuelva la tarea limpiamente. Añade MCP cuando haga falta descubrimiento compartido, un wrapper de CLI cuando un comando existente sea la operación más clara, o ejecución de código cuando las mejoras medidas por composición justifiquen su runtime. El contrato de la acción, es decir, qué puede ocurrir, qué resultado lo demuestra y qué significa un fallo, sigue teniendo que ser explícito.
Tres direcciones para el tool use a escala
Recuperación de herramientas. Antes de que el modelo elija, recupera las pocas descripciones de herramientas que corresponden a la petición. En el benchmark y la prueba de estrés de MCP de RAG-MCP, la recuperación elevó la precisión de selección de herramientas del 13,62 % al 43,13 % y redujo los tokens del prompt de unos 2.134 a 1.084. Las descripciones de su configuración difieren entre secciones del artículo, lo que limita hasta dónde se pueden generalizar las cifras.
Agentes que crean herramientas. En LATM, un modelo potente escribe funciones de Python reutilizables que después llama un modelo más pequeño. ToolMaker implementó correctamente 12 de 15 tareas construidas a partir de artículos con código público. Ese benchmark pequeño no establece fiabilidad en producción, pero apunta hacia la gestión de una biblioteca de herramientas generadas.
A2A junto a MCP. Google transfirió A2A a la Linux Foundation en junio de 2025. La documentación de A2A reparte los papeles: MCP conecta un agente con herramientas y recursos, mientras que A2A permite que agentes separados se descubran entre sí, compartan tareas y deleguen trabajo.
La Parte 4, AI Agent Security, sigue la acción propuesta hasta su comprobación de permisos. La Parte 5, Agent Runtime, sitúa la ejecución dentro de un runtime recuperable. La Parte 6, Harness Engineering for AI Agents, reúne el bucle, las herramientas, la política y la comprobación de finalización.
Referencias
Artículos científicos
- Executable Code Actions Elicit Better LLM Agents (CodeAct) — Wang et al., ICML 2024
- SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering — Yang, Jimenez et al., NeurIPS 2024
- RAG-MCP: Mitigating Prompt Bloat in LLM Tool Selection
- LLMs As Tool Makers (LATM) — Cai et al., 2023
- ToolMaker: LLM Agents Making Agent Tools — Wölflein et al., ACL 2025
- MCPTox: A Benchmark for Tool Poisoning Attack on Real-World MCP Servers
- Agent Skills Can Be Harmful: An Empirical Study of Skill-Induced Failures in LLM Agents — Dong et al., 2026
Ingeniería y documentación de Anthropic
- Advanced tool use — Tool Search, Programmatic Tool Calling y ejemplos de entrada
- Programmatic tool calling — guía actual de la API y restricciones
- Code execution with MCP — el ejemplo de Drive a Salesforce
- Writing effective tools for agents
- Building effective agents
Protocolos
- Especificación del Model Context Protocol, 2026-07-28 y registro de cambios
- MCP Tasks extension
- Especificación de Agent Skills
- Microsoft Agent Framework: Agent Skills
- A2A and MCP
Casos de estudio y seguridad
- Vercel: We removed 80% of our agent’s tools
- Cloudflare: Code Mode
- Apideck: MCP server eating your context window
- Scalekit: MCP vs CLI
- Invariant Labs: MCP tool poisoning attacks
- Vulnerable MCP Project
- Writing CLI Tools That AI Agents Actually Want to Use — Ugo Enyioha
Proyecto de demostración
- Market Analyst Agent — consolidación de herramientas y patrones ACI