Reasoning loops de agentes de AI: ReAct, ReWOO, Plan-and-Execute

Traducción automática
Este artículo se tradujo automáticamente a partir de la versión original en inglés.
Un reasoning loop de agente es el flujo de control que decide cuándo un modelo elige una acción, recibe un tool result y vuelve a elegir, o se detiene. Este artículo está dirigido a ingenieros que deciden cómo debe gestionar un agente un trabajo cuyo siguiente paso puede depender de lo que encuentren sus herramientas. Aprenderás cuándo usar ReAct, ReWOO o Plan-and-Execute, y cómo se reflejan esas decisiones en una implementación con LangGraph.
Una petición del precio actual de una acción tiene pasos de consulta conocidos. Investigar por qué han cambiado sus perspectivas puede exigir que la siguiente búsqueda dependa del primer resultado. El modelo necesita un grado de libertad distinto en esas dos tareas, y la segunda suele requerir más llamadas al modelo.
Esta es la Parte 1 de Engineering the Agentic Stack. El loop es su capa más interna; las partes siguientes tratan la memoria, las herramientas, la seguridad, el runtime y las comprobaciones previas a dar una tarea por terminada. El ejemplo práctico es un Market Analyst Agent construido con LangGraph.
Para una comparación breve de los frameworks que implementan estos loops, consulta Best AI Agent Frameworks in 2026.
Las decisiones que debe tomar un modelo
Enumera las decisiones que quedan una vez definidos la petición y sus herramientas. Para consultar un precio, la aplicación puede llamar a la herramienta de precios y pasar su resultado a un modelo para que lo explique. Si el usuario pide un briefing con precio, datos financieros y noticias recientes, un planificador puede nombrar de antemano esas llamadas independientes. Si una noticia sobre la reformulación de unos resultados exige una nueva consulta, una lista fija ya no basta: el modelo debe ver el resultado antes de elegir esa consulta.
Tres preguntas determinan el loop:
- ¿Puede el código nombrar ahora las llamadas? Si puede, usa un workflow fijo. Un modelo puede seguir resumiendo los resultados, pero no necesita decidir el orden de las consultas.
- Si un modelo debe elegir las llamadas, ¿puede nombrarlas todas antes de ver resultados? ReWOO puede ejecutar ese plan sin volver al modelo entre llamadas. Su worker puede ejecutar a la vez las llamadas independientes.
- ¿Puede un resultado cambiar la siguiente llamada o un objetivo posterior? ReAct da al modelo otra decisión después de cada observación. Plan-and-Execute añade una lista previa de objetivos alrededor de esos loops locales; cambiar objetivos posteriores requiere un paso de replanificación aparte.
La elección también decide dónde aparece un fallo. Un plan ReWOO incorrecto puede recorrer varias llamadas antes de que el solver vea un problema. Un loop ReAct puede recuperarse de un resultado inesperado, pero también puede desviarse o repetir trabajo. Un plan previo facilita el seguimiento de una tarea larga, pero un executor local no puede corregir en silencio un plan general equivocado. Cada patrón sigue necesitando una regla de parada, permisos para las herramientas y una forma de informar de las llamadas fallidas; el loop por sí mismo no ofrece ninguna de esas garantías.
Qué hace cada patrón con un resultado
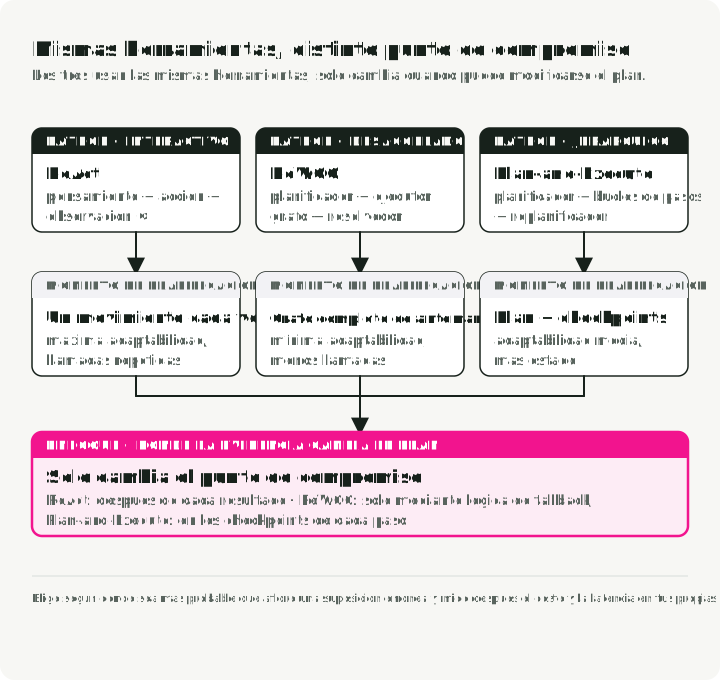
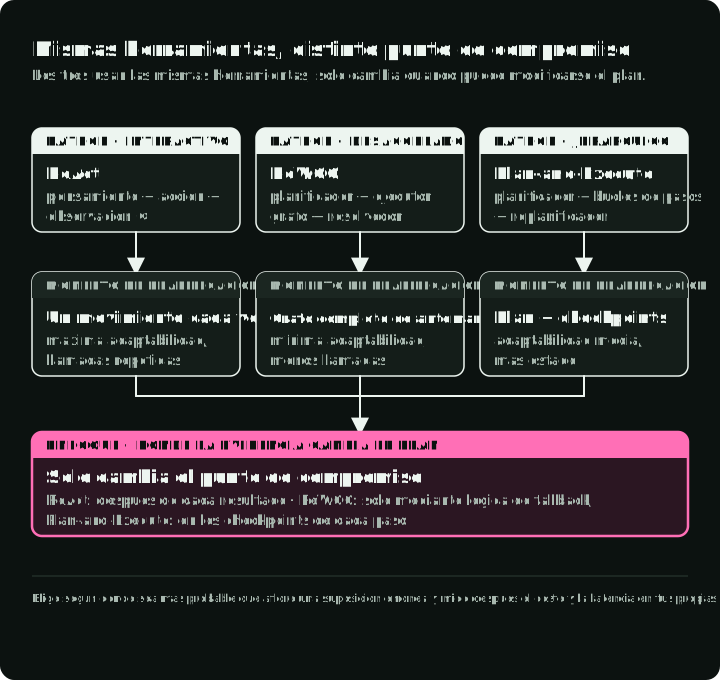
Los tres patrones llaman a las mismas herramientas. Se diferencian en cuándo un tool result puede cambiar el plan: después de cada llamada, solo después de la ejecución o dentro de cada paso planificado.
ReAct: decidir después de cada observación
ReAct (Yao et al., 2022), abreviatura de Reason + Act, repite una decisión: el modelo elige un tool call, la aplicación lo ejecuta y el resultado vuelve al modelo. Ante una petición de investigar el descenso del margen de una empresa, un estado financiero podría apuntar a un aumento de costes; la siguiente llamada podría entonces buscar evidencia sobre esos costes. El modelo no tiene que elegir esa segunda llamada antes de ver el estado financiero.
El paper original lo escribe como Thought → Action → Observation. Las APIs nativas de herramientas exponen la llamada propuesta y el tool result, pero no tienen por qué exponer el razonamiento interno del modelo. Pensar entre tool calls es una capacidad aparte del modelo y de la API.
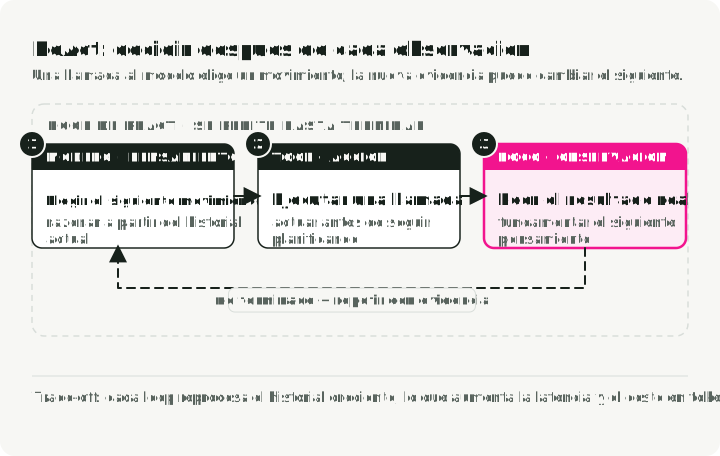
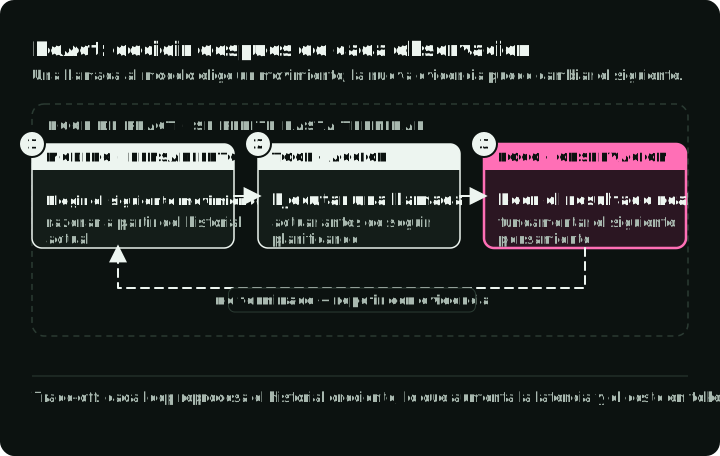
Ese feedback es la ventaja de ReAct: una observación sorprendente puede cambiar la siguiente acción. El historial de tool calls también muestra qué evidencia obtuvo el sistema. En la muestra manual de HotpotQA con PaLM-540B del paper, las observaciones de Wikipedia produjeron menos hechos alucinados que el prompting chain-of-thought. Ese resultado se refiere a su tarea y a su modelo, no a la precisión de cualquier loop que use herramientas.
El coste son las decisiones repetidas. Una implementación con historial completo envía en cada turno una conversación cada vez más larga. El prompt caching puede reducir el procesamiento repetido de la entrada y su coste, pero no elimina las observaciones antiguas de la ventana de contexto. Resumir o truncar sí elimina información. Limita los pasos y el tiempo transcurrido, y comprueba si el agente se recupera de un mal resultado o simplemente sigue buscando.
Usa ReAct para investigación exploratoria, depuración y tareas en las que no puedes predecir la siguiente acción.
ReWOO: compilar primero el grafo de herramientas
ReWOO (Reasoning WithOut Observation) separa la llamada de planificación de un modelo de su respuesta final. El planificador nombra todos los tool calls antes de que llegue ningún resultado. Puede referirse a un resultado futuro como #E1 y después poner #E1 en los argumentos de una llamada posterior. Un worker sin LLM resuelve esos marcadores y ejecuta las llamadas; un modelo solver recibe los resultados reunidos y escribe la respuesta.
Para un snapshot de mercado, el planificador puede pedir a la vez precio, datos financieros y noticias recientes. El worker de este artículo ejecuta en paralelo las llamadas cuyas dependencias están listas. Ese batching es una decisión de implementación; el rasgo definitorio del paper es que el worker sigue un plan sin preguntar al modelo qué hacer a continuación.
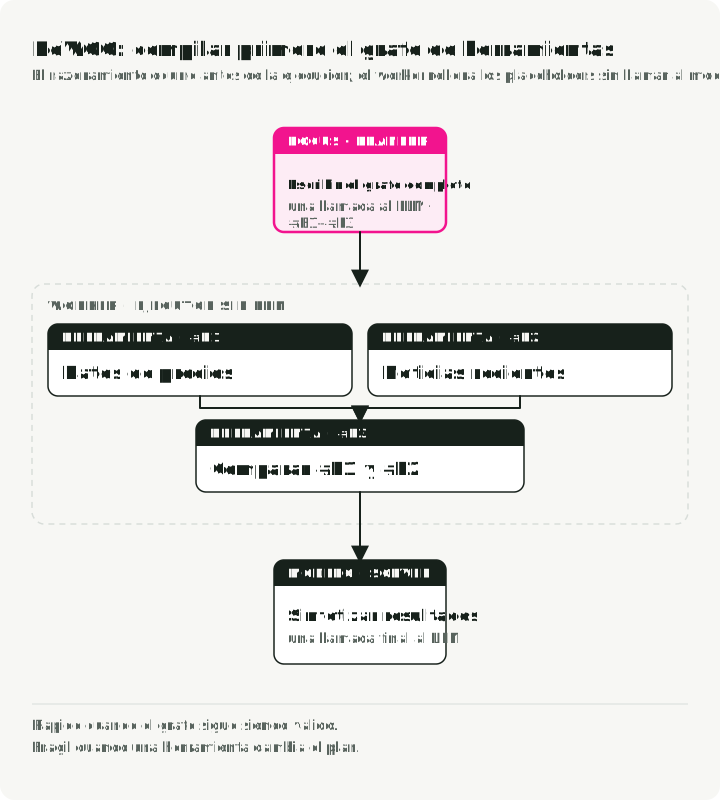
Hay menos llamadas al modelo durante la ejecución, siempre que el plan inicial siga siendo útil. La prueba de estrés del paper en HotpotQA sustituyó cada tool result por No evidence found; ReWOO perdió menos precisión que ReAct en esa prueba. Aun así, no recuperó la evidencia que faltaba. Un worker debe decidir si un error va al solver, se reintenta o detiene la ejecución. El solver no puede corregir una dependencia errónea o una herramienta que falta cuando las llamadas ya se han ejecutado.
Como el planificador nunca lee un tool result, puede ajustarse con fine-tuning o probarse por separado, sin un entorno de herramientas real. Usa ReWOO para snapshots rápidos, comprobaciones de estado y dashboards cuyas herramientas se comportan de forma predecible.
Plan-and-Execute: descomponer y reaccionar localmente
Plan-and-Solve prompting crea primero un plan y después resuelve sus subtareas. El patrón de orquestación de herramientas relacionado, Plan-and-Execute, permite que un planificador enumere objetivos de alto nivel y que un executor los atienda uno a uno. El Market Analyst Agent pide pasos de investigación como comprobar la salud financiera y examinar los riesgos. Dentro de cada paso, un loop ReAct puede elegir herramientas después de ver resultados. La salida del planificador es una lista de objetivos, a diferencia de los tool calls propuestos de ReWOO.
El paper de Plan-and-Solve estudió el prompting zero-shot, no este grafo con herramientas. Elegir modelos distintos para planificar y ejecutar es posible en una implementación; no es un resultado demostrado por ese paper.
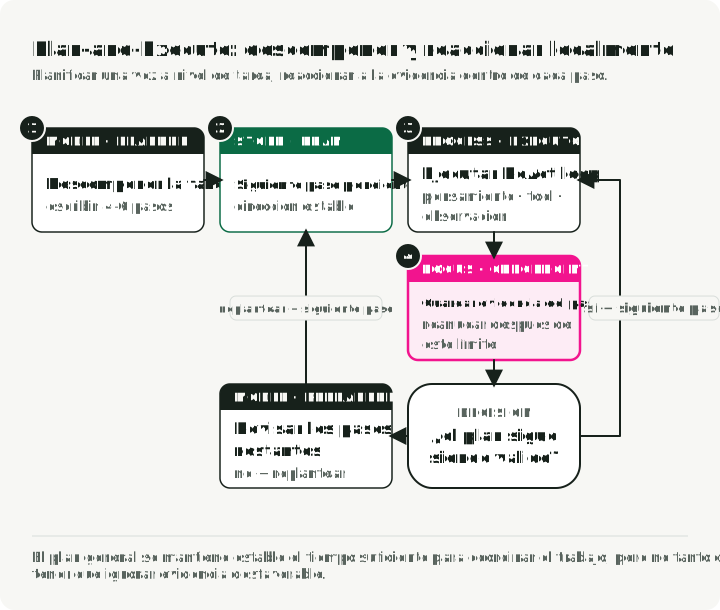
La figura incluye un replanificador opcional. El grafo didáctico de abajo no tiene rama de replanificación: los resultados pueden cambiar el trabajo dentro de un paso, pero la lista de pasos posteriores permanece fija. Añade replanificación solo cuando el resultado de un paso deba cambiar esa lista.
En una implementación, el planificador puede usar un modelo más potente y el executor uno más barato, y con un checkpointer cada paso completado se convierte en un punto desde el que reanudar. El patrón también necesita más llamadas al modelo y más estado que una consulta simple, así que úsalo solo cuando el plan explícito ayude al sistema a completar una tarea más grande, como un informe de investigación que termina en una síntesis.
Elige un loop para la tarea y luego prueba su fallo
| Señal de la tarea | Flujo de control inicial | Ejemplo | Qué probar |
|---|---|---|---|
| Los pasos de consulta ya se conocen | Workflow fijo | Precio actual de un ticker | ¿El resultado necesita interpretación, o puede devolverlo el código directamente? |
| Un modelo puede nombrar cada llamada y dependencia antes de la ejecución | ReWOO | Precio, datos financieros y noticias de un ticker; el tiempo en cinco ciudades | ¿Qué pasa cuando falla una llamada planificada o el plan nombra una dependencia no válida? |
| La siguiente llamada depende del último resultado | ReAct | Averiguar por qué cayó el margen de una empresa | ¿Puede recuperarse de un resultado engañoso y detenerse dentro de un presupuesto limitado? |
| Una tarea larga tiene objetivos con nombre, y cada uno necesita decisiones locales | Plan-and-Execute | Una tesis de inversión con riesgos y competidores | ¿Puede el executor completar un paso, y qué pasa cuando un resultado invalida objetivos posteriores? |
Es una regla de partida, no un ranking de rendimiento. En particular, el grafo didáctico de Plan-and-Execute no puede revisar objetivos posteriores. El worker de ReWOO ejecuta en paralelo las llamadas con dependencias listas, pero no puede crear una llamada nueva después de ver un resultado. Compara las rutas con las mismas tareas, el mismo comportamiento de las herramientas y el mismo presupuesto antes de elegir por número de llamadas al modelo.
Los patrones describen decisiones que están fuera del modelo. Un modelo que razona entre tool calls sigue necesitando un programa que ejecute esas llamadas, detenga el loop y autorice los efectos. Al comparar loops, cuenta los reasoning tokens facturados además de las llamadas; un modelo puede razonar sin mostrar ese texto.
Para una implementación nueva con LangChain, create_agent proporciona un loop de herramientas guiado por observaciones. El grafo de referencia de abajo usa la API anterior create_react_agent de LangGraph, así que sus fragmentos explican el flujo de control en lugar de servir como guía de configuración para un proyecto nuevo.
Si el trabajo necesita contextos aislados para subagentes, un sistema de archivos y gestión automática del contexto, Deep Agents los empaqueta alrededor del mismo loop de herramientas. Es una elección de harness, no un cuarto patrón de razonamiento. Compara un solo agente con la delegación en tareas que se dividen en trabajo independiente, e incluye en el resultado el coste de coordinación y el contexto perdido.
Un ejemplo práctico: el Market Analyst Agent
El Market Analyst Agent envía una petición de flash briefing por ReWOO: planifica llamadas de datos de mercado, las ejecuta y después sintetiza los resultados. Una petición de investigación más profunda pasa por Plan-and-Execute, con un loop ReAct dentro de cada paso planificado. En esa ruta, ReAct es una primitiva de ejecución, no una tercera ruta para el usuario. Las rutas se diferencian en lo que el planificador pasa al executor: tool calls propuestos exactos en ReWOO, u objetivos que aún requieren elegir herramientas en Plan-and-Execute.
Los fragmentos son variantes didácticas abreviadas del commit b4e769a, no scripts independientes.
Usa LangGraph para la orquestación. Un nodo es una función de Python que devuelve los campos que hay que actualizar en el estado compartido; una arista elige el siguiente nodo. Ambas rutas comparten un esquema de estado, mientras que su progreso vive en campos distintos:
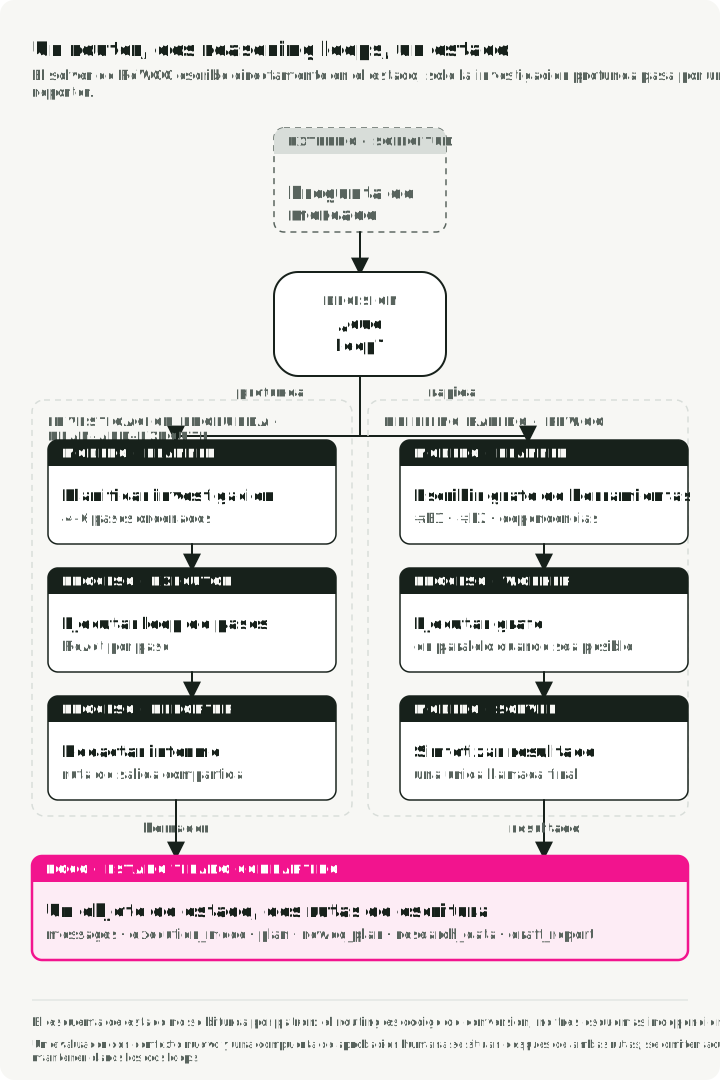
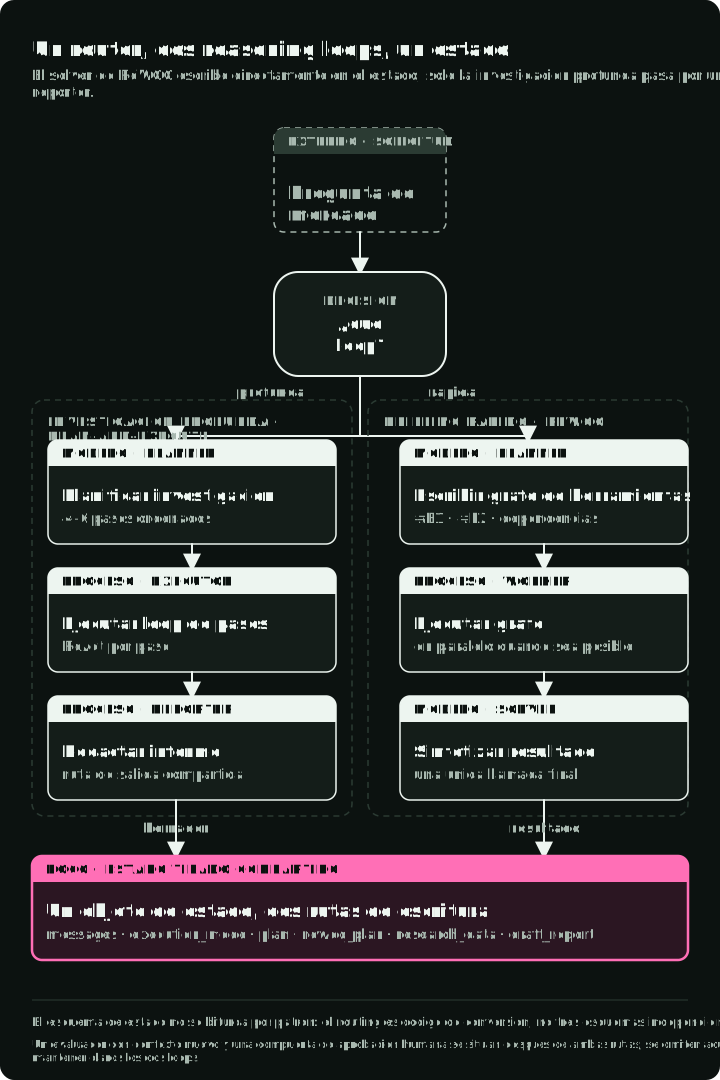
El diagrama aísla el enrutamiento y la creación del borrador. Omite el evaluador compartido y la aprobación humana antes de publicar, que sí incluye el cableado del grafo de más abajo.
Definición del estado
El esquema de estado guarda el progreso específico de cada ruta en plan o rewoo_plan y coloca el borrador final de cualquiera de las rutas en draft_report. Los campos de memoria y aprobación aparecen porque ambas rutas comparten el mismo estado de aplicación; no deciden qué loop se ejecuta.
from typing import Literal

class PlanStep(BaseModel):
    """A single step in the research plan."""
    step_number: int
    description: str
    tool_hint: str | None = None
    completed: bool = False
    result: str | None = None

class UserProfile(BaseModel):
    """Structured user context loaded from long-term memory."""
    risk_tolerance: str | None = None
    investment_horizon: str | None = None

class AgentState(BaseModel):
    """Main state for the Market Analyst Agent graph."""

    # Identity and profile context for memory-backed personalization
    user_id: str
    user_profile: UserProfile = Field(default_factory=UserProfile)

    # Message history with LangGraph's add_messages reducer
    messages: Annotated[list, add_messages] = Field(default_factory=list)

    # Execution mode (set by router)
    execution_mode: ExecutionMode | None = None

    # Plan-and-Execute state
    plan: list[PlanStep] = Field(default_factory=list)
    current_step_index: int = 0

    # ReWOO state
    rewoo_plan: list[ReWOOPlanStep] = Field(default_factory=list)

    # Research results
    research_data: ResearchData | None = None

    # Final report. Both paths write this field, then the graph pauses before
    # publishing (see interrupt_before below), so a human signs off on a draft
    # a fresh-context evaluator has already voted on.
    draft_report: DraftReport | None = None
    report_approved: bool = False
    evaluator_verdict: Literal["pass", "fail", "needs_human"] | None = None
    evaluator_reasons: list[str] = Field(default_factory=list)
Patrón 1: implementación de Plan-and-Execute
Plan-and-Execute encaja con la síntesis en varios pasos. Un planificador escribe los pasos de alto nivel y después un loop ReAct ejecuta cada paso y reacciona a los tool results.
Los fragmentos de referencia mantienen claude-sonnet-4-5-20250929 y la API anterior create_react_agent para seguir siendo comparables con el commit enlazado. Para código nuevo, usa la interfaz create_agent actual. Migrar este grafo también exige probar sus esquemas de planificación, los mensajes internos, el enrutamiento y el comportamiento al reanudar; cambiar solo el nombre del modelo no es esa migración.
El planificador hace una llamada al modelo y devuelve descripciones de pasos. No llama a ninguna herramienta de datos de mercado. El structured output comprueba la forma de la respuesta; sigue haciendo falta una comprobación aparte de que el plan no esté vacío y sea utilizable.
# System prompt guides the LLM to think like a research analyst
# creating a strategic plan, not immediate tool calls
PLANNER_SYSTEM_PROMPT = """You are a senior investment research analyst.
Break down stock analysis requests into 4-6 research steps covering:
1. Current price and basic metrics
2. Recent news and announcements
3. Competitor analysis (if relevant)
4. Financial health assessment
5. Risk factors
6. Investment thesis synthesis

Output as JSON with step_number, description, and tool_hint."""

# Schema-Guided Reasoning: Enforce structure with Pydantic
class PlanOutput(BaseModel):
    """Structured output for the planner."""

    steps: list[PlanStep] = Field(description="Research steps to execute")
    ticker: str = Field(description="The stock ticker being analyzed")

def planner_node(state: AgentState) -> dict:
    """Generate a research plan from the user's request.

    This is Phase 1 of Plan-and-Execute: creating the high-level strategy.
    """

    # Use a powerful model for strategic planning
    llm = ChatAnthropic(model="claude-sonnet-4-5-20250929", temperature=0)

    # Ask for a typed plan and validate it before execution.
    # The API can still fail, so production code also handles that exception.
    structured_llm = llm.with_structured_output(PlanOutput)

    # Pull the request out of the message history
    human = [m for m in state.messages if isinstance(m, HumanMessage)]
    last_user_message = human[-1].content if human else "Analyze the market"

    # Context from long-term memory personalizes the plan
    profile_context = f"""
User Profile:
- Risk Tolerance: {state.user_profile.risk_tolerance}
- Investment Horizon: {state.user_profile.investment_horizon}
"""

    # Single LLM call creates the complete plan
    result: PlanOutput = structured_llm.invoke([
        SystemMessage(content=PLANNER_SYSTEM_PROMPT + profile_context),
        HumanMessage(content=f"Create a research plan for: {last_user_message}"),
    ])

    # State update: Store the plan and initialize tracking
    return {
        "plan": result.steps,           # The sequential steps to execute
        "current_step_index": 0,        # Start at step 0
        "research_data": ResearchData(ticker=result.ticker),  # Initialize data container
    }
Esa línea llm.with_structured_output(PlanOutput) es Schema-Guided Reasoning (SGR), tratado en un post anterior. El esquema comprueba los tipos de los campos, pero no si los pasos son utilizables. Antes de ejecutar, exige una lista no vacía y acotada, con números de paso únicos y descripciones claras.
Patrón 2: ejecución con ReAct
Una vez que existe el plan, executor_node pasa un objetivo y un resumen de los resultados anteriores a un loop ReAct interno. El loop interno puede elegir otra herramienta después de ver una observación. Cuando termina, el grafo externo registra el resultado final del paso y avanza; no conserva la transcripción interna en plan.
# Market-data tools available to the inner loop in this excerpt. The repo's
# TOOLS list also has a skill loader, two CLI wrappers, and a restricted Python
# evaluator; Part 3 compares those interfaces, and MCP runs as a sidecar.
TOOLS = [
    get_stock_snapshot,
    get_price_history,
    search_news,
    search_competitors,
    get_financials,
]

def executor_node(state: AgentState) -> dict:
    """Execute the current step using a ReAct agent.

    This is Phase 2 of Plan-and-Execute: adaptive execution of each planned step.
    Each step runs as a mini ReAct loop until completion.
    """

    # Guard against an empty or exhausted plan before indexing it
    if state.current_step_index >= len(state.plan):
        raise ValueError("No plan step to execute; check the planner output")

    # Get the current step from the plan
    current_step = state.plan[state.current_step_index]

    # Build context from what we've learned so far
    # Each step sees a digest of earlier results
    previous_context = ""
    for step in state.plan[:state.current_step_index]:
        if step.result:
            previous_context += f"\nStep {step.step_number}: {step.result}\n"

    # Create a ReAct agent for this step. The companion pins the older
    # create_react_agent API; new code uses create_agent.
    react_agent = create_react_agent(
        model=ChatAnthropic(model="claude-sonnet-4-5-20250929"),
        tools=TOOLS,
    )

    # Invoke the ReAct loop for this single step
    # The agent will loop internally until it completes the step
    result = react_agent.invoke({
        "messages": [
            SystemMessage(content=EXECUTOR_SYSTEM_PROMPT),
            HumanMessage(content=f"""Execute Step {current_step.step_number}:
{current_step.description}

Ticker: {state.research_data.ticker}
Previous findings: {previous_context}"""),
        ]
    })

    # Extract the final answer from the ReAct agent's message history
    # The last message contains the synthesis after all tool calls
    updated_plan = list(state.plan)
    updated_plan[state.current_step_index] = PlanStep(
        step_number=current_step.step_number,
        description=current_step.description,
        completed=True,
        result=str(result["messages"][-1].text),  # Final synthesized answer
    )

    # State update: Mark step complete and advance to next
    return {
        "plan": updated_plan,
        "current_step_index": state.current_step_index + 1,
    }
Patrón 3: ReWOO para snapshots rápidos
Para un briefing rápido, el planificador devuelve tool calls propuestos en lugar de objetivos de investigación. El worker ejecuta sin modelo las llamadas con dependencias listas; el solver hace una llamada al modelo sobre sus resultados. Estos fragmentos muestran cada traspaso.
Fase 1: planificador ReWOO (escribe por adelantado un plan tipado de llamadas propuestas)
class ReWOOPlanStep(BaseModel):
    """A step in the ReWOO plan with variable placeholders.

    Key difference from Plan-and-Execute's PlanStep:
    - Contains actual tool_name and tool_args (not just description)
    - Uses variable references (#E1) for dependencies
    """
    step_id: str  # e.g., "#E1" - becomes a variable
    description: str
    tool_name: str     # Requested tool name; validate it against a registry in production
    tool_args: dict    # Proposed arguments; may contain refs like {"price": "#E1"}
    depends_on: list[str] = []  # Declared ordering; cross-check it against #E placeholders
    result: str | None = None

class ReWOOPlanOutput(BaseModel):
    """Structured output for ReWOO planner."""
    steps: list[ReWOOPlanStep] = Field(description="Planned tool calls with variables")

def rewoo_planner_node(state: AgentState) -> dict:
    """Generate a complete plan of tool calls upfront.

    This is the key difference from Plan-and-Execute: instead of creating
    human-readable step descriptions, it creates typed proposed tool calls.
    Production code validates them before execution; this teaching worker does not.
    """

    llm = ChatAnthropic(model="claude-sonnet-4-5-20250929", temperature=0)

    # Schema-Guided Reasoning validates the planner response shape.
    # It does not validate a tool name, its arguments, or its dependencies.
    structured_llm = llm.with_structured_output(ReWOOPlanOutput)

    ticker = state.research_data.ticker if state.research_data else "UNKNOWN"
    human = [m for m in state.messages if isinstance(m, HumanMessage)]
    query = human[-1].content if human else f"Analyze {ticker}"

    # Single LLM call to plan ALL tool executions
    result: ReWOOPlanOutput = structured_llm.invoke([
        SystemMessage(content=REWOO_PLANNER_PROMPT),
        HumanMessage(content=f"""Create a ReWOO plan for: {query}

Ticker: {ticker}

Output tool calls with:
- step_id: Variable name (#E1, #E2, etc.)
- description: What this accomplishes
- tool_name: Exact tool from the list
- tool_args: Dictionary of arguments
- depends_on: List of step_ids this depends on"""),
    ])

    # Store the typed proposed-call plan.
    # This teaching worker sends ready steps directly to execute_tool.
    return {"rewoo_plan": result.steps}
Fase 2: worker ReWOO (ejecuta herramientas sin razonamiento del LLM)
def rewoo_worker_node(state: AgentState) -> dict:
    """Execute dependency-ready tools in parallel batches (no LLM calls).

    Independent tools share a batch. Dependent tools wait until their
    prerequisites complete. The worker follows the dependency graph and
    does not add LLM calls.
    """

    results = {}        # Results keyed by step_id (e.g., "#E1": "$150.23")
    updated_steps = []  # Plan steps with their result field filled in
    pending = {step.step_id: step for step in state.rewoo_plan}

    # Keep scheduling dependency-ready batches until the graph is complete.
    # This handles chains even when the planner does not list them topologically.
    with ThreadPoolExecutor(max_workers=5) as executor:
        while pending:
            ready = [
                step for step in pending.values()
                if all(dep in results for dep in step.depends_on)
            ]
            if not ready:
                unresolved = ", ".join(pending)
                raise ValueError(f"Unresolvable ReWOO dependencies: {unresolved}")

            futures = {
                executor.submit(execute_tool, step, results): step
                for step in ready
            }
            for future in as_completed(futures):
                step = futures[future]
                results[step.step_id] = future.result()
                updated_steps.append(step.model_copy(update={"result": results[step.step_id]}))
                del pending[step.step_id]

    # State update: restore the planner's order (sorting on step_id would put
    # "#E10" before "#E2") and hand the filled-in plan to the Solver
    plan_order = {s.step_id: i for i, s in enumerate(state.rewoo_plan)}
    return {"rewoo_plan": sorted(updated_steps, key=lambda s: plan_order[s.step_id])}
Fase 3: solver ReWOO (sintetiza todos los resultados en una sola llamada al LLM)
def rewoo_solver_node(state: AgentState) -> dict:
    """Synthesize all tool results into a flash briefing.

    This is the second efficiency gain: Instead of interleaving
    LLM calls with tool execution (like ReAct), we make ONE
    final synthesis call with all gathered data.
    """

    # Build context from ALL tool results at once
    tool_results = []
    for step in state.rewoo_plan:
        if step.result:
            tool_results.append(f"### {step.description}\n{step.result}")

    context = "\n\n".join(tool_results)

    # Single LLM call to synthesize everything
    llm = ChatAnthropic(model="claude-sonnet-4-5-20250929", temperature=0)
    structured_llm = llm.with_structured_output(FlashBriefingOutput)
    result = structured_llm.invoke([
        SystemMessage(content=REWOO_SOLVER_PROMPT),
        HumanMessage(content=f"Create a flash briefing from this data:\n\n{context}"),
    ])

    # FlashBriefingOutput and DraftReport carry the same fields; the state
    # schema expects DraftReport, so convert before returning.
    return {"draft_report": DraftReport(**result.model_dump())}
El planificador escribe llamadas propuestas, el worker rellena sus marcadores y el solver recibe los resultados. El esquema comprueba su forma, no si el plan puede ejecutarse. El diccionario pending de arriba descarta en silencio los IDs duplicados. Si #E2 usa #E1 en sus argumentos pero omite #E1 en depends_on, ambas llamadas pueden entrar en el mismo lote antes de que exista el primer resultado.
Antes del despacho, rechaza los planes vacíos o demasiado grandes, los IDs duplicados, las dependencias que faltan y los ciclos. Valida los nombres de las herramientas y sus argumentos contra un registro. Inspecciona los marcadores dentro de valores anidados y exige que coincidan con depends_on. Este worker didáctico omite esas comprobaciones. Envía las llamadas listas a execute_tool del código de referencia, cuyas excepciones capturadas se convierten en strings de error. El solver debe tratar un string así como evidencia que falta, no como una consulta correcta. Un grafo que no se puede resolver se detiene antes del solver. La recuperación necesita un resultado de fallo, una arista condicional de replanificación y un límite de intentos.
A qué se compromete el planificador
| Ruta en este grafo | Antes de la primera llamada de datos de mercado | Después de un tool result | Llamadas al modelo en esta implementación | Nodos |
|---|---|---|---|---|
| Deep research: Plan-and-Execute con pasos ReAct | El planificador escribe descripciones de objetivos | El loop ReAct interno puede elegir otra llamada dentro de su objetivo actual; los objetivos posteriores siguen fijos | Un plan, un loop de modelo y herramientas por paso, un informe | planner_node → executor_node por paso → reporter_node |
| Flash briefing: ReWOO | El planificador escribe nombres de herramientas, argumentos y dependencias | El worker sigue el plan; el solver ve los resultados después de la ejecución | Un plan, ninguna llamada al modelo en el worker, una síntesis | rewoo_planner_node → rewoo_worker_node → rewoo_solver_node |
Un PlanStep que dice “Investigate recent earnings” deja la elección de herramienta al agente interno. Un ReWOOPlanStep que nombra search_news y aporta su consulta se compromete con esa llamada antes de que llegue ningún resultado. Esa diferencia, y no el nombre del patrón, decide qué observaciones inesperadas pueden cambiar la ejecución. Una junto a otra, las dos salidas del planificador tienen este aspecto:
# Plan-and-Execute: goals; the inner ReAct loop picks the tools.
plan = [
    PlanStep(step_number=1, description="Get current price and key metrics",
             tool_hint="get_stock_snapshot"),
    PlanStep(step_number=2, description="Search for recent news and earnings",
             tool_hint="search_news"),
]

# ReWOO: exact calls, fixed before any result arrives.
rewoo_plan = [
    ReWOOPlanStep(step_id="#E1", description="Read the price and valuation snapshot",
                  tool_name="get_stock_snapshot", tool_args={"ticker": "NVDA"}),
    ReWOOPlanStep(step_id="#E2", description="Find recent NVDA earnings news",
                  tool_name="search_news",
                  tool_args={"query": "NVDA earnings", "max_results": 5}),
]
Un tool_hint es un consejo que el executor puede ignorar. Un tool_name con tool_args es la llamada que hará el worker.
Un loop ReAct independiente puede llevar todos los mensajes anteriores a cada nueva llamada al modelo. Este grafo inicia cada loop interno con su paso actual y un resumen de los pasos completados. El estado externo guarda los resultados de los pasos, no la transcripción interna de tool calls. ReWOO, en cambio, rellena los pasos planificados con resultados y entrega la lista completa a su solver. Son decisiones de gestión del contexto de este código de referencia, no requisitos de los papers originales.
Conectar ambas rutas en un grafo
El grafo tiene dos rutas para el usuario sobre un único AgentState: deep research usa Plan-and-Execute con un loop ReAct dentro de cada paso, mientras que flash briefing usa ReWOO.
Esta implementación no tiene replanificador: ejecuta el plan inicial hasta el final. Añadir replanificación exigiría una arista de executor de vuelta a planner y una regla sobre cuándo un resultado sorprendente justifica otra llamada al modelo.
LangGraph mantiene el cableado declarativo:
def create_graph(checkpointer=None):
    builder = StateGraph(AgentState)

    # Add nodes
    builder.add_node("router", router_node)
    builder.add_node("planner", planner_node)
    builder.add_node("executor", executor_node)
    builder.add_node("reporter", reporter_node)
    builder.add_node("rewoo_planner", rewoo_planner_node)
    builder.add_node("rewoo_worker", rewoo_worker_node)
    builder.add_node("rewoo_solver", rewoo_solver_node)
    builder.add_node("evaluator", evaluator_node)
    builder.add_node("publish", publish_node)

    # Define edges
    builder.add_edge(START, "router")
    builder.add_conditional_edges("router", route_after_router, {
        "planner": "planner",
        "rewoo_planner": "rewoo_planner",
    })

    # Deep Research path
    builder.add_edge("planner", "executor")
    builder.add_conditional_edges("executor", route_after_executor, {
        "executor": "executor",  # Loop back for more steps
        "reporter": "reporter",  # Done with plan
    })
    builder.add_edge("reporter", "evaluator")

    # Flash Briefing path (ReWOO)
    builder.add_edge("rewoo_planner", "rewoo_worker")
    builder.add_edge("rewoo_worker", "rewoo_solver")
    builder.add_edge("rewoo_solver", "evaluator")

    # Both paths run the same evaluator before the human approval step.
    builder.add_edge("evaluator", "publish")
    builder.add_edge("publish", END)

    return builder.compile(
        checkpointer=checkpointer,
        # Human-in-the-loop pause: the reporter (or ReWOO solver) writes a
        # draft. A separate model session reads that draft and records its
        # assessment. The graph then stops before publishing, whichever
        # assessment it produced, so a human can review both the draft and
        # assessment. Part 6 explains how the program decides a run is complete.
        interrupt_before=["publish"],
    )
Comprueba si la llamada al modelo del router ayuda
El router clasifica los snapshots rápidos, incluido “current price”, como ReWOO, y las peticiones complejas, como una tesis de inversión, como Plan-and-Execute. Por defecto elige deep research cuando la clasificación no está clara. Schema-Guided Reasoning restringe la salida del clasificador a uno de los dos modos:
class ExecutionMode(str, Enum):
    DEEP_RESEARCH = "deep_research"  # Plan-and-Execute with ReAct steps
    FLASH_BRIEFING = "flash_briefing"  # ReWOO

class RouterOutput(BaseModel):
    mode: ExecutionMode
    ticker: str
    reasoning: str

ROUTER_SYSTEM_PROMPT = """Classify the user's request:

1. deep_research: complex analysis requiring synthesis
   - Examples: "Analyze strategic risks", "investment thesis"
2. flash_briefing: quick snapshots, simple data retrieval
   - Examples: "quick snapshot", "current price"

Default to deep_research if unclear."""

llm = ChatAnthropic(model="claude-sonnet-4-5-20250929", temperature=0)
structured_llm = llm.with_structured_output(RouterOutput)
Así enruta las peticiones esta aplicación; no es una prueba de que toda consulta de precio necesite un planificador. Para una petición que solo pide el precio, una llamada directa a la herramienta evitaría las llamadas del router, del planificador ReWOO y del solver. Esas llamadas solo se justifican en peticiones que necesitan que un modelo seleccione o explique datos.
Un router también puede enviar una petición al loop equivocado. Compara ambas rutas y un workflow fijo con las mismas tareas, herramientas y presupuesto. Registra la finalización de la tarea, las aceptaciones indebidas, los tokens con y sin caché, el tiempo real y la recuperación tras errores de herramientas u observaciones engañosas. Repite las ejecuciones cuando la elección del modelo sea estocástica y cuenta cada intento iniciado. Un número menor de llamadas solo ayuda si la ruta sigue completando la tarea dentro de sus restricciones. El artículo de ingeniería de Anthropic también recomienda empezar con workflows sencillos y combinables.
La implementación de referencia completa, incluidos el router y el estado compartido, está en el commit b4e769a del Market Analyst Agent.
Prueba la API actual de loop único
El grafo de arriba usa una factory de agentes más antigua de LangGraph. Si quieres examinar primero la API create_agent actual, este pequeño fixture evita los servicios de datos de mercado. Muestra una llamada de modelo y herramienta y su resultado, no una razón para usar un agente en una consulta conocida. En una aplicación que solo responde a esta pregunta, llama directamente a la función de consulta.
Define ANTHROPIC_API_KEY e instala langchain y langchain-anthropic antes de ejecutar el snippet. La invocación hace una petición de pago al modelo.
from langchain.agents import create_agent
from langchain_anthropic import ChatAnthropic

def lookup_fixture_company(ticker: str) -> str:
    """Look up a company name in a local fixture, not live market data."""
    return {"NVDA": "NVIDIA", "AMD": "AMD"}.get(
        ticker.strip().upper(), "No company in the fixture"
    )

agent = create_agent(
    model=ChatAnthropic(model="claude-sonnet-5", max_tokens=4096),
    tools=[lookup_fixture_company],
    system_prompt="Use the fixture for company names. Do not invent market data.",
)
result = agent.invoke({
    "messages": [{"role": "user", "content": "Which company is NVDA in the fixture?"}]
})
print(result["messages"][-1].text)
Si el modelo propone lookup_fixture_company, la biblioteca invoca esa función de Python y le devuelve su resultado. El snippet no garantiza que el modelo use la herramienta ni prueba una comparación de rutas, una política de fallos o la precisión con datos reales.
La siguiente capa es la memoria
El loop decide qué llamada viene después; el resto del harness tiene que aportar contexto, ejecutar y autorizar llamadas, conservar el estado y comprobar que la tarea se ha completado. La Parte 2, arquitectura de memoria de agentes de AI separa los checkpoints reanudables del conocimiento entre sesiones y de los documentos del proyecto. Sin checkpoints duraderos, un reinicio del worker pierde el estado en curso de este grafo. La Parte 3 examina las interfaces de herramientas, la Parte 4 trata la autorización, la Parte 5 trata la ejecución y la recuperación, y la Parte 6 examina la evidencia de que una tarea está terminada.
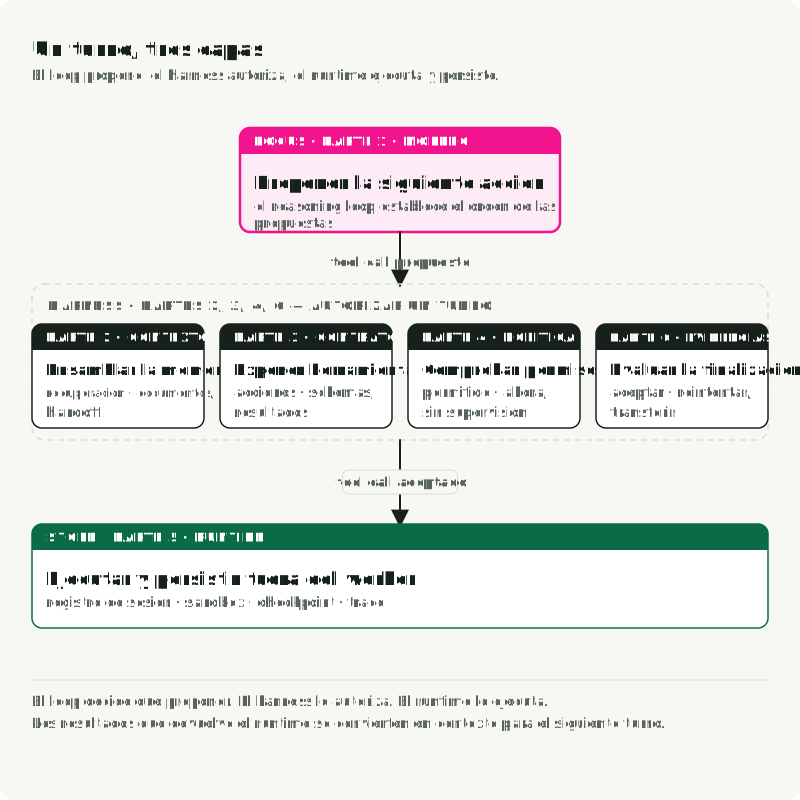
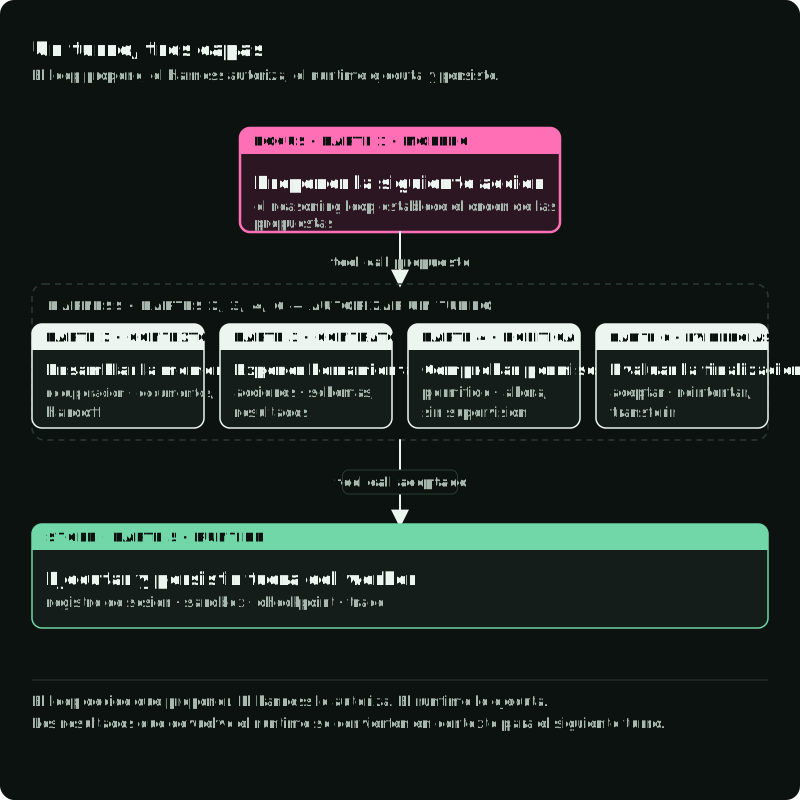
La figura sitúa cada parte en el punto de un turno donde actúa.
Referencias
- ReAct: Synergizing Reasoning and Acting in Language Models (Yao et al., 2022)
- ReWOO: Decoupling Reasoning from Observations for Efficient Augmented Language Models (Xu et al., 2023)
- Plan-and-Solve Prompting: Improving Zero-Shot Chain-of-Thought Reasoning by Large Language Models (Wang et al., 2023)
- Market Analyst Agent Repository