Reasoning loops de agentes de AI: ReAct, ReWOO, Plan-and-Execute

Tradução automática
Este artigo foi traduzido automaticamente a partir da versão original em inglês.
Um reasoning loop de agente é o fluxo de controlo que decide quando um modelo escolhe uma ação, recebe um tool result e volta a escolher, ou para. Este artigo destina-se a engenheiros que decidem como um agente deve tratar trabalho cujo passo seguinte pode depender do que as suas ferramentas encontram. Vai aprender quando usar ReAct, ReWOO ou Plan-and-Execute, e como essas escolhas aparecem numa implementação em LangGraph.
Um pedido da cotação atual de uma ação tem passos de consulta conhecidos. Investigar porque mudaram as perspetivas dessa ação pode exigir que a pesquisa seguinte dependa do primeiro resultado. O modelo precisa de liberdade diferente nessas duas tarefas, e a segunda costuma exigir mais chamadas ao modelo.
Esta é a Parte 1 de Engineering the Agentic Stack. O loop é a sua camada mais interna; as partes seguintes tratam da memória, das ferramentas, da segurança, do runtime e das verificações feitas antes de dar uma tarefa por concluída. O exemplo prático é um Market Analyst Agent construído com LangGraph.
Para uma comparação breve dos frameworks que implementam estes loops, consulte Best AI Agent Frameworks in 2026.
As decisões que um modelo tem de tomar
Liste as decisões que restam depois de definidos o pedido e as suas ferramentas. Para consultar uma cotação, a aplicação pode chamar a ferramenta de cotações e entregar o resultado a um modelo para que o explique. Se o utilizador pedir um briefing com cotação, dados financeiros e notícias recentes, um planeador pode nomear antecipadamente essas chamadas independentes. Se uma notícia sobre uma reformulação de resultados exigir uma nova consulta, uma lista fixa já não chega: o modelo tem de ver o resultado antes de escolher essa consulta.
Três perguntas determinam o loop:
- O código consegue nomear as chamadas agora? Se consegue, use um workflow fixo. Um modelo pode continuar a resumir os resultados, mas não precisa de decidir a ordem das consultas.
- Se um modelo tem de escolher as chamadas, consegue nomeá-las todas antes de ver resultados? O ReWOO pode executar esse plano sem voltar ao modelo entre chamadas. O seu worker pode executar em conjunto as chamadas independentes.
- Um resultado pode alterar a chamada seguinte ou um objetivo posterior? O ReAct dá ao modelo outra decisão depois de cada observação. O Plan-and-Execute acrescenta uma lista prévia de objetivos em torno desses loops locais; alterar objetivos posteriores exige um passo de replaneamento separado.
A escolha também decide onde uma falha aparece. Um plano ReWOO errado pode percorrer várias chamadas antes de o solver ver um problema. Um loop ReAct pode recuperar de um resultado inesperado, mas também pode desviar-se ou repetir trabalho. Um plano prévio torna uma tarefa longa mais fácil de acompanhar, mas um executor local não consegue corrigir em silêncio um plano global errado. Cada padrão continua a precisar de uma regra de paragem, de permissões para as ferramentas e de uma forma de comunicar chamadas falhadas; o loop, por si só, não oferece nenhuma dessas garantias.
O que cada padrão faz com um resultado
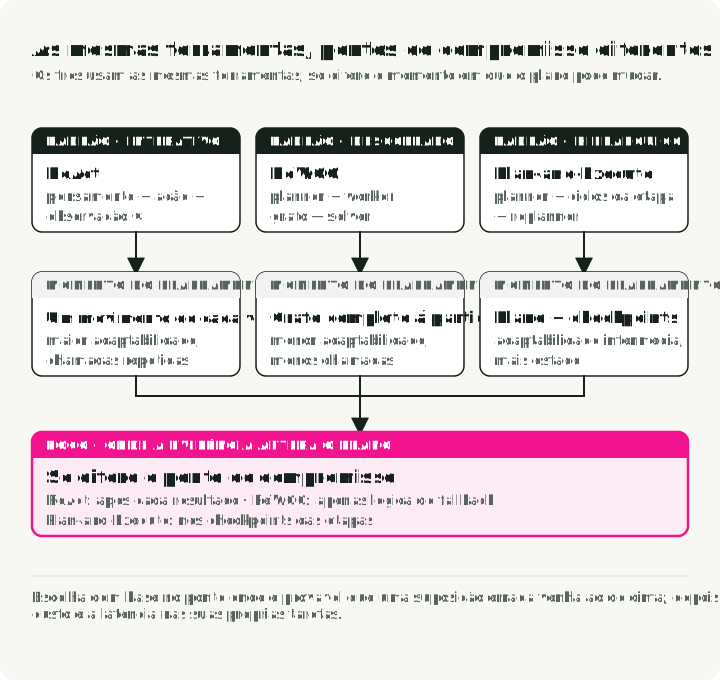
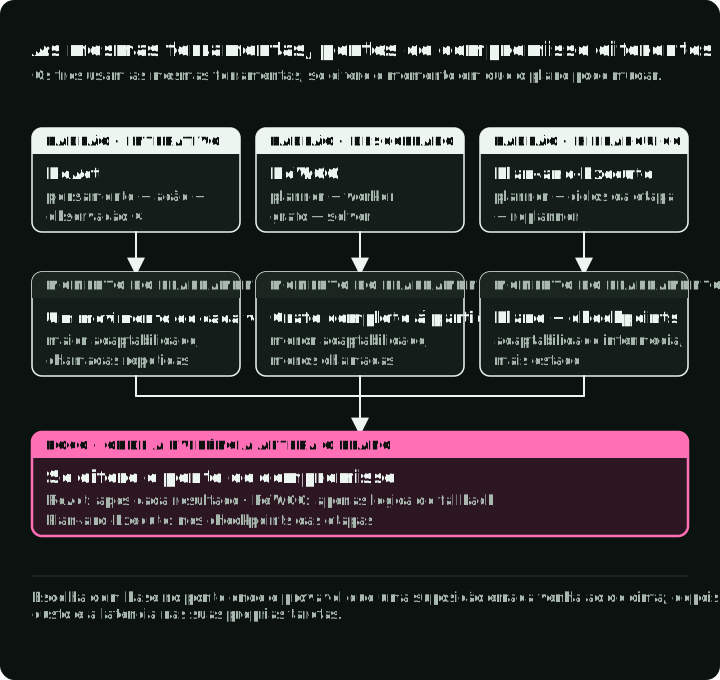
Os três padrões chamam as mesmas ferramentas. Diferem no momento em que um tool result pode alterar o plano: depois de cada chamada, só depois da execução ou dentro de cada passo planeado.
ReAct: decidir depois de cada observação
O ReAct (Yao et al., 2022), abreviatura de Reason + Act, repete uma decisão: o modelo escolhe um tool call, a aplicação executa-o e o resultado regressa ao modelo. Perante um pedido para investigar a queda da margem de uma empresa, uma demonstração financeira pode apontar para custos em alta; a chamada seguinte pode então procurar evidências sobre esses custos. O modelo não tem de escolher essa segunda chamada antes de ver a demonstração.
O artigo original escreve isto como Thought → Action → Observation. As APIs nativas de ferramentas expõem a chamada proposta e o tool result, mas não têm de expor o raciocínio interno do modelo. Pensar entre tool calls é uma capacidade separada do modelo e da API.
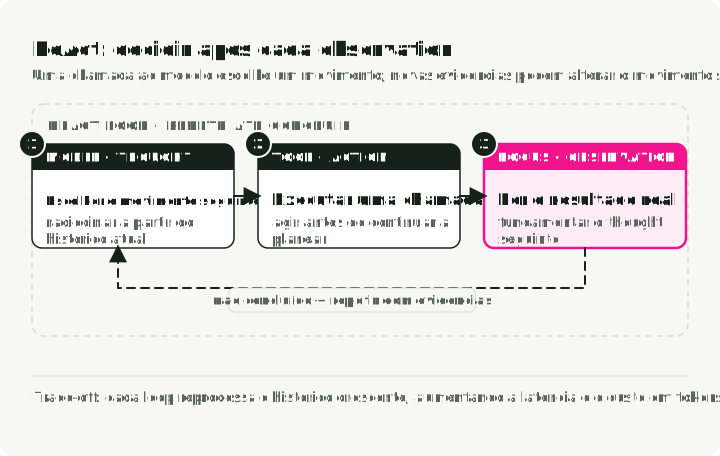
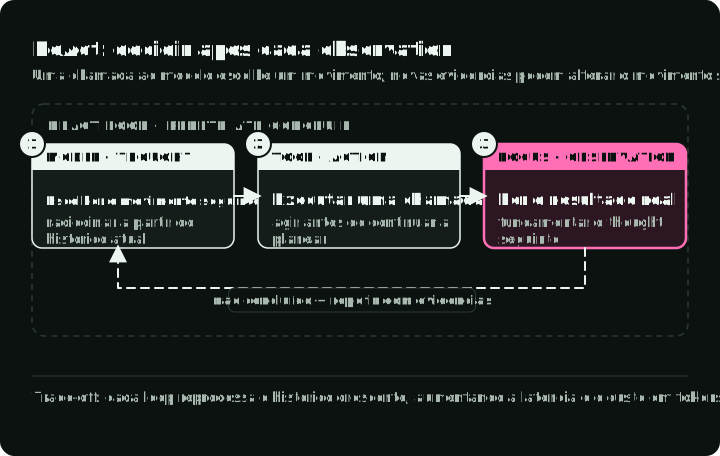
Esse feedback é a vantagem do ReAct: uma observação surpreendente pode alterar a ação seguinte. O histórico de tool calls também mostra que evidências o sistema obteve. Na amostra manual de HotpotQA com PaLM-540B do artigo, as observações da Wikipédia produziram menos factos alucinados do que o prompting chain-of-thought. Esse resultado diz respeito àquela tarefa e àquele modelo, não à precisão de qualquer loop que use ferramentas.
O custo são as decisões repetidas. Uma implementação com histórico completo envia em cada turno uma conversa cada vez mais longa. O prompt caching pode reduzir o processamento repetido da entrada e o respetivo custo, mas não retira as observações antigas da janela de contexto. Resumir ou truncar retira de facto informação. Limite os passos e o tempo decorrido, e teste se o agente recupera de um mau resultado ou se apenas continua a procurar.
Use ReAct para investigação exploratória, depuração e tarefas em que não consegue prever a ação seguinte.
ReWOO: compilar primeiro o grafo de ferramentas
O ReWOO (Reasoning WithOut Observation) separa a chamada de planeamento de um modelo da sua resposta final. O planeador nomeia todos os tool calls antes de chegar qualquer resultado. Pode referir-se a um resultado futuro como #E1 e depois colocar #E1 nos argumentos de uma chamada posterior. Um worker sem LLM resolve esses marcadores e executa as chamadas; um modelo solver recebe os resultados reunidos e escreve a resposta.
Para um snapshot de mercado, o planeador pode pedir em conjunto a cotação, os dados financeiros e as notícias recentes. O worker deste artigo executa em paralelo as chamadas cujas dependências estão prontas. Esse agrupamento é uma escolha de implementação; a característica determinante do sistema descrito no artigo é o worker seguir um plano sem perguntar ao modelo o que fazer a seguir.
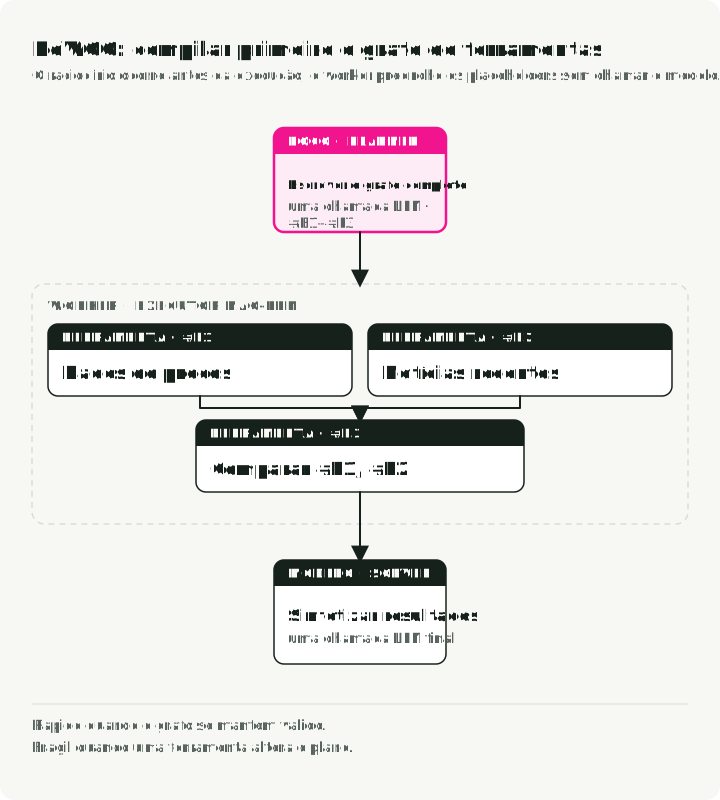
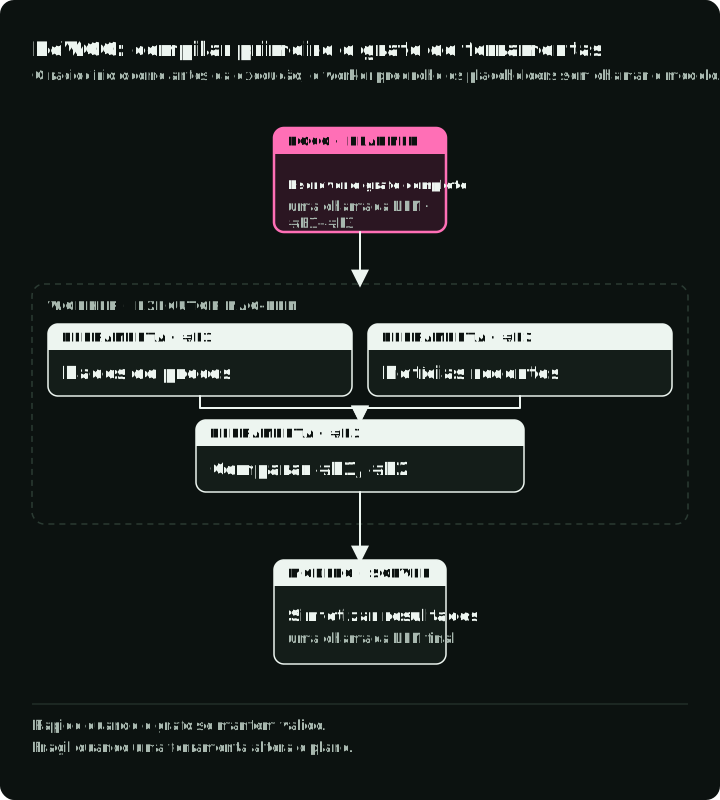
Há menos chamadas ao modelo durante a execução, desde que o plano inicial continue útil. O teste de stress em HotpotQA do artigo substituiu cada tool result por No evidence found; o ReWOO perdeu menos precisão do que o ReAct nesse teste. Mesmo assim, não recuperou as evidências em falta. Um worker tem de decidir se um erro segue para o solver, é repetido ou para a execução. O solver não consegue corrigir uma dependência errada ou uma ferramenta em falta depois de as chamadas já terem sido executadas.
Como o planeador nunca lê um tool result, pode ser sujeito a fine-tuning ou testado isoladamente, sem um ambiente de ferramentas real. Use ReWOO para snapshots rápidos, verificações de estado e dashboards cujas ferramentas têm comportamento previsível.
Plan-and-Execute: decompor e depois reagir localmente
O Plan-and-Solve prompting cria primeiro um plano e depois resolve as suas subtarefas. O padrão de orquestração de ferramentas relacionado, Plan-and-Execute, permite que um planeador liste objetivos de alto nível e que um executor os trate um de cada vez. O Market Analyst Agent pede passos de investigação como verificar a saúde financeira e examinar riscos. Dentro de cada passo, um loop ReAct pode escolher ferramentas depois de ver resultados. A saída do planeador é uma lista de objetivos, ao contrário dos tool calls propostos pelo ReWOO.
O artigo Plan-and-Solve estudou prompting zero-shot, não este grafo com ferramentas. Escolher modelos diferentes para planear e executar é possível numa implementação; não é um resultado demonstrado por esse artigo.
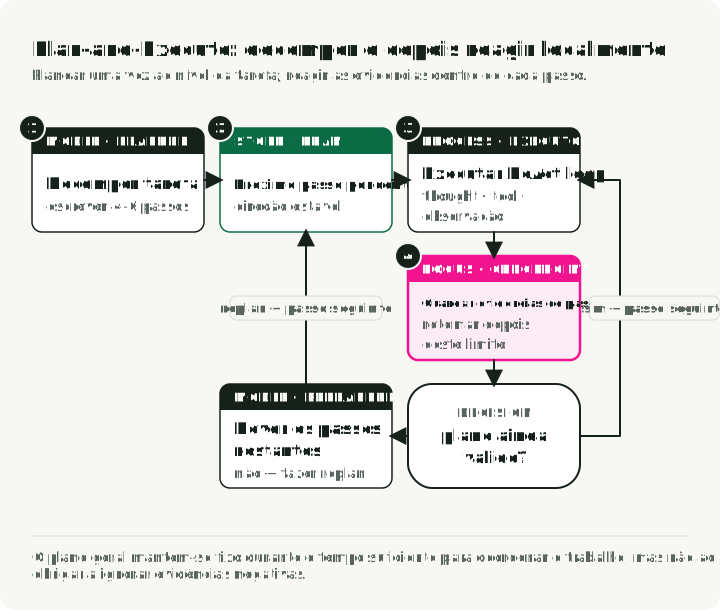
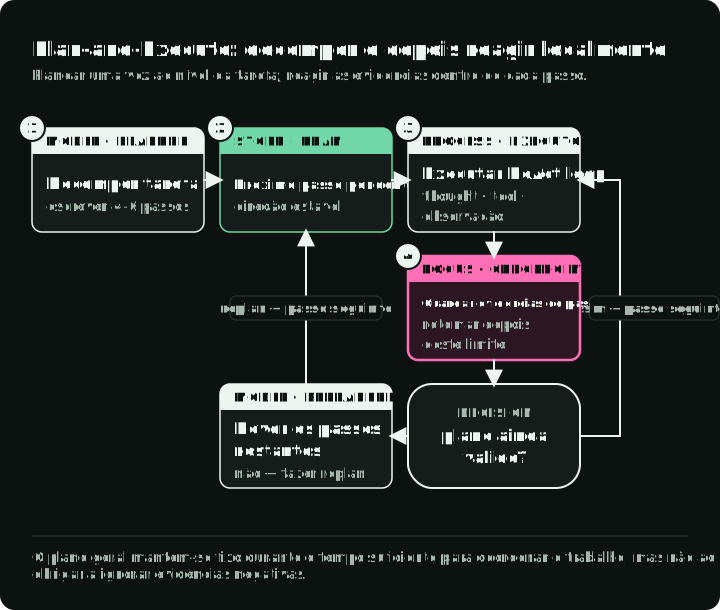
A figura inclui um replaneador opcional. O grafo didático abaixo não tem ramo de replaneamento: os resultados podem alterar o trabalho dentro de um passo, mas a lista de passos posteriores mantém-se fixa. Acrescente replaneamento apenas quando o resultado de um passo tiver de alterar essa lista.
Numa implementação, o planeador pode correr num modelo mais forte e o executor num mais barato, e com um checkpointer cada passo concluído torna-se um ponto a partir do qual se pode retomar. O padrão também precisa de mais chamadas ao modelo e de mais estado do que uma consulta simples, por isso use-o apenas quando o plano explícito ajuda o sistema a concluir uma tarefa maior, como um relatório de investigação que termina numa síntese.
Escolha um loop para a tarefa e depois teste a sua falha
| Sinal da tarefa | Fluxo de controlo inicial | Exemplo | O que testar |
|---|---|---|---|
| Os passos de consulta já são conhecidos | Workflow fixo | Cotação atual de um ticker | O resultado precisa de interpretação, ou o código pode devolvê-lo diretamente? |
| Um modelo consegue nomear cada chamada e dependência antes da execução | ReWOO | Cotação, dados financeiros e notícias de um ticker; tempo em cinco cidades | O que acontece quando uma chamada planeada falha ou o plano nomeia uma dependência inválida? |
| A chamada seguinte depende do último resultado | ReAct | Descobrir porque caiu a margem de uma empresa | Consegue recuperar de um resultado enganador e parar dentro de um orçamento limitado? |
| Uma tarefa longa tem objetivos nomeados, cada um com decisões locais | Plan-and-Execute | Uma tese de investimento com riscos e concorrentes | O executor consegue concluir um passo, e o que acontece quando um resultado invalida objetivos posteriores? |
Esta é uma regra de partida, não um ranking de desempenho. Em particular, o grafo didático de Plan-and-Execute não consegue rever objetivos posteriores. O worker do ReWOO executa em paralelo as chamadas com dependências prontas, mas não consegue criar uma nova chamada depois de ver um resultado. Compare as rotas nas mesmas tarefas, com o mesmo comportamento das ferramentas e o mesmo orçamento, antes de escolher pelo número de chamadas ao modelo.
Os padrões descrevem decisões fora do modelo. Um modelo que raciocina entre tool calls continua a precisar de um programa que execute essas chamadas, pare o loop e autorize os efeitos. Ao comparar loops, conte os reasoning tokens faturados, além das chamadas; um modelo pode raciocinar sem mostrar esse texto.
Para uma nova implementação em LangChain, o create_agent fornece um loop de ferramentas guiado por observações. O grafo de acompanhamento abaixo usa a API mais antiga create_react_agent do LangGraph, pelo que os seus excertos explicam o fluxo de controlo em vez de servirem de guia de configuração para um projeto novo.
Se o trabalho precisar de contextos isolados para subagentes, de um sistema de ficheiros e de gestão automática do contexto, o Deep Agents agrupa essas funções em torno do mesmo loop de ferramentas. É uma escolha de harness, não um quarto padrão de raciocínio. Compare um único agente com delegação em tarefas que se dividem em trabalho independente, e inclua no resultado o custo de coordenação e o contexto perdido.
Um exemplo prático: o Market Analyst Agent
O Market Analyst Agent encaminha um pedido de flash briefing pelo ReWOO: planear chamadas de dados de mercado, executá-las e depois sintetizar os resultados. Um pedido de investigação mais aprofundada passa pelo Plan-and-Execute, com um loop ReAct dentro de cada passo planeado. Nessa rota, o ReAct é uma primitiva de execução, não uma terceira rota para o utilizador. As rotas diferem no que o planeador entrega ao executor: tool calls propostos exatos no ReWOO, ou objetivos que ainda exigem escolher ferramentas no Plan-and-Execute.
Os excertos são variantes didáticas abreviadas do commit b4e769a, não scripts independentes.
Usa o LangGraph para a orquestração. Um nó é uma função Python que devolve os campos a atualizar no estado partilhado; uma aresta escolhe o nó seguinte. Ambas as rotas partilham um esquema de estado, enquanto o seu progresso fica em campos diferentes:
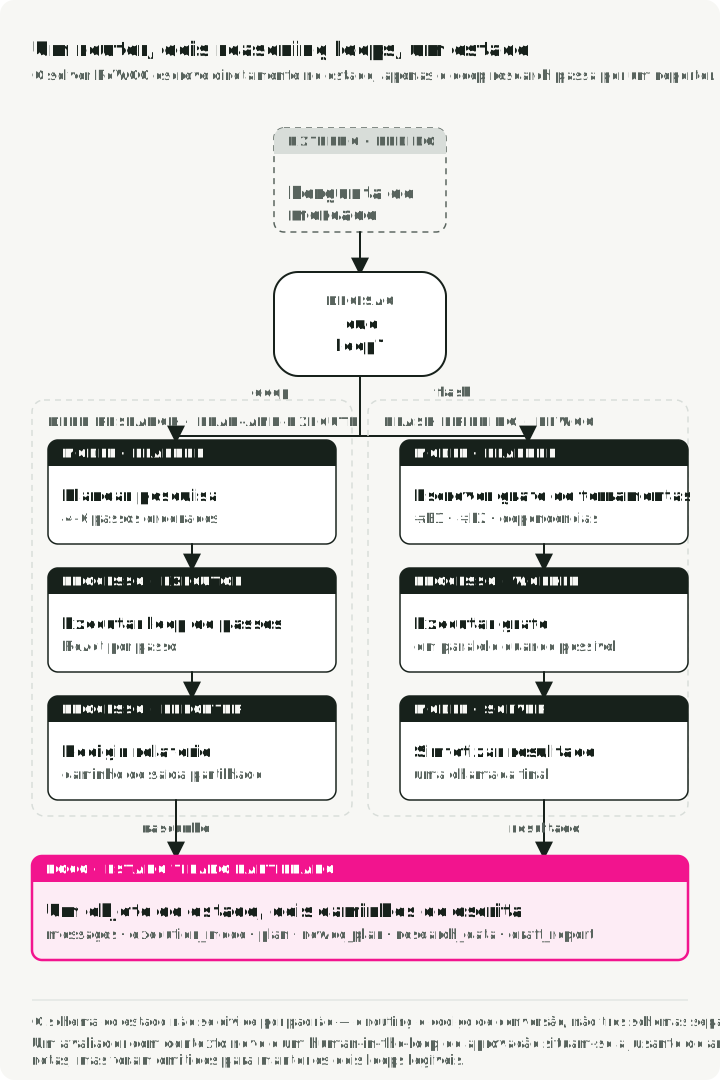
O diagrama isola o encaminhamento e a criação do rascunho. Omite o avaliador partilhado e a aprovação humana antes da publicação, que a ligação do grafo abaixo inclui.
Definição do estado
O esquema de estado guarda o progresso específico de cada rota em plan ou rewoo_plan e coloca o rascunho final de qualquer das rotas em draft_report. Os campos de memória e aprovação aparecem porque ambas as rotas partilham o mesmo estado da aplicação; não decidem que loop é executado.
from typing import Literal

class PlanStep(BaseModel):
    """A single step in the research plan."""
    step_number: int
    description: str
    tool_hint: str | None = None
    completed: bool = False
    result: str | None = None

class UserProfile(BaseModel):
    """Structured user context loaded from long-term memory."""
    risk_tolerance: str | None = None
    investment_horizon: str | None = None

class AgentState(BaseModel):
    """Main state for the Market Analyst Agent graph."""

    # Identity and profile context for memory-backed personalization
    user_id: str
    user_profile: UserProfile = Field(default_factory=UserProfile)

    # Message history with LangGraph's add_messages reducer
    messages: Annotated[list, add_messages] = Field(default_factory=list)

    # Execution mode (set by router)
    execution_mode: ExecutionMode | None = None

    # Plan-and-Execute state
    plan: list[PlanStep] = Field(default_factory=list)
    current_step_index: int = 0

    # ReWOO state
    rewoo_plan: list[ReWOOPlanStep] = Field(default_factory=list)

    # Research results
    research_data: ResearchData | None = None

    # Final report. Both paths write this field, then the graph pauses before
    # publishing (see interrupt_before below), so a human signs off on a draft
    # a fresh-context evaluator has already voted on.
    draft_report: DraftReport | None = None
    report_approved: bool = False
    evaluator_verdict: Literal["pass", "fail", "needs_human"] | None = None
    evaluator_reasons: list[str] = Field(default_factory=list)
Padrão 1: implementação de Plan-and-Execute
O Plan-and-Execute adequa-se a sínteses em vários passos. Um planeador escreve os passos de alto nível e depois um loop ReAct executa cada passo e reage aos tool results.
Os excertos de acompanhamento mantêm claude-sonnet-4-5-20250929 e a API mais antiga create_react_agent para continuarem comparáveis com o commit indicado. Para código novo, use a interface create_agent atual. Migrar este grafo também exige testar os esquemas do planeador, as mensagens internas, o encaminhamento e o comportamento ao retomar; mudar apenas o nome do modelo não é essa migração.
O planeador faz uma chamada ao modelo e devolve descrições de passos. Não chama nenhuma ferramenta de dados de mercado. O structured output verifica a forma da resposta; continua a ser necessária uma verificação separada de que o plano não está vazio e é utilizável.
# System prompt guides the LLM to think like a research analyst
# creating a strategic plan, not immediate tool calls
PLANNER_SYSTEM_PROMPT = """You are a senior investment research analyst.
Break down stock analysis requests into 4-6 research steps covering:
1. Current price and basic metrics
2. Recent news and announcements
3. Competitor analysis (if relevant)
4. Financial health assessment
5. Risk factors
6. Investment thesis synthesis

Output as JSON with step_number, description, and tool_hint."""

# Schema-Guided Reasoning: Enforce structure with Pydantic
class PlanOutput(BaseModel):
    """Structured output for the planner."""

    steps: list[PlanStep] = Field(description="Research steps to execute")
    ticker: str = Field(description="The stock ticker being analyzed")

def planner_node(state: AgentState) -> dict:
    """Generate a research plan from the user's request.

    This is Phase 1 of Plan-and-Execute: creating the high-level strategy.
    """

    # Use a powerful model for strategic planning
    llm = ChatAnthropic(model="claude-sonnet-4-5-20250929", temperature=0)

    # Ask for a typed plan and validate it before execution.
    # The API can still fail, so production code also handles that exception.
    structured_llm = llm.with_structured_output(PlanOutput)

    # Pull the request out of the message history
    human = [m for m in state.messages if isinstance(m, HumanMessage)]
    last_user_message = human[-1].content if human else "Analyze the market"

    # Context from long-term memory personalizes the plan
    profile_context = f"""
User Profile:
- Risk Tolerance: {state.user_profile.risk_tolerance}
- Investment Horizon: {state.user_profile.investment_horizon}
"""

    # Single LLM call creates the complete plan
    result: PlanOutput = structured_llm.invoke([
        SystemMessage(content=PLANNER_SYSTEM_PROMPT + profile_context),
        HumanMessage(content=f"Create a research plan for: {last_user_message}"),
    ])

    # State update: Store the plan and initialize tracking
    return {
        "plan": result.steps,           # The sequential steps to execute
        "current_step_index": 0,        # Start at step 0
        "research_data": ResearchData(ticker=result.ticker),  # Initialize data container
    }
Essa linha llm.with_structured_output(PlanOutput) é Schema-Guided Reasoning (SGR), abordado num artigo anterior. O esquema verifica os tipos dos campos, mas não se os passos são utilizáveis. Antes da execução, exija uma lista não vazia e limitada, com números de passo únicos e descrições claras.
Padrão 2: execução com ReAct
Depois de o plano existir, o executor_node entrega um objetivo e um resumo dos resultados anteriores a um loop ReAct interno. O loop interno pode escolher outra ferramenta depois de ver uma observação. Quando termina, o grafo externo regista o resultado final do passo e avança; não guarda a transcrição interna em plan.
# Market-data tools available to the inner loop in this excerpt. The repo's
# TOOLS list also has a skill loader, two CLI wrappers, and a restricted Python
# evaluator; Part 3 compares those interfaces, and MCP runs as a sidecar.
TOOLS = [
    get_stock_snapshot,
    get_price_history,
    search_news,
    search_competitors,
    get_financials,
]

def executor_node(state: AgentState) -> dict:
    """Execute the current step using a ReAct agent.

    This is Phase 2 of Plan-and-Execute: adaptive execution of each planned step.
    Each step runs as a mini ReAct loop until completion.
    """

    # Guard against an empty or exhausted plan before indexing it
    if state.current_step_index >= len(state.plan):
        raise ValueError("No plan step to execute; check the planner output")

    # Get the current step from the plan
    current_step = state.plan[state.current_step_index]

    # Build context from what we've learned so far
    # Each step sees a digest of earlier results
    previous_context = ""
    for step in state.plan[:state.current_step_index]:
        if step.result:
            previous_context += f"\nStep {step.step_number}: {step.result}\n"

    # Create a ReAct agent for this step. The companion pins the older
    # create_react_agent API; new code uses create_agent.
    react_agent = create_react_agent(
        model=ChatAnthropic(model="claude-sonnet-4-5-20250929"),
        tools=TOOLS,
    )

    # Invoke the ReAct loop for this single step
    # The agent will loop internally until it completes the step
    result = react_agent.invoke({
        "messages": [
            SystemMessage(content=EXECUTOR_SYSTEM_PROMPT),
            HumanMessage(content=f"""Execute Step {current_step.step_number}:
{current_step.description}

Ticker: {state.research_data.ticker}
Previous findings: {previous_context}"""),
        ]
    })

    # Extract the final answer from the ReAct agent's message history
    # The last message contains the synthesis after all tool calls
    updated_plan = list(state.plan)
    updated_plan[state.current_step_index] = PlanStep(
        step_number=current_step.step_number,
        description=current_step.description,
        completed=True,
        result=str(result["messages"][-1].text),  # Final synthesized answer
    )

    # State update: Mark step complete and advance to next
    return {
        "plan": updated_plan,
        "current_step_index": state.current_step_index + 1,
    }
Padrão 3: ReWOO para snapshots rápidos
Para um briefing rápido, o planeador devolve tool calls propostos em vez de objetivos de investigação. O worker executa sem modelo as chamadas com dependências prontas; o solver faz uma chamada ao modelo sobre os resultados. Estes excertos mostram cada passagem.
Fase 1: planeador ReWOO (escreve antecipadamente um plano tipado de chamadas propostas)
class ReWOOPlanStep(BaseModel):
    """A step in the ReWOO plan with variable placeholders.

    Key difference from Plan-and-Execute's PlanStep:
    - Contains actual tool_name and tool_args (not just description)
    - Uses variable references (#E1) for dependencies
    """
    step_id: str  # e.g., "#E1" - becomes a variable
    description: str
    tool_name: str     # Requested tool name; validate it against a registry in production
    tool_args: dict    # Proposed arguments; may contain refs like {"price": "#E1"}
    depends_on: list[str] = []  # Declared ordering; cross-check it against #E placeholders
    result: str | None = None

class ReWOOPlanOutput(BaseModel):
    """Structured output for ReWOO planner."""
    steps: list[ReWOOPlanStep] = Field(description="Planned tool calls with variables")

def rewoo_planner_node(state: AgentState) -> dict:
    """Generate a complete plan of tool calls upfront.

    This is the key difference from Plan-and-Execute: instead of creating
    human-readable step descriptions, it creates typed proposed tool calls.
    Production code validates them before execution; this teaching worker does not.
    """

    llm = ChatAnthropic(model="claude-sonnet-4-5-20250929", temperature=0)

    # Schema-Guided Reasoning validates the planner response shape.
    # It does not validate a tool name, its arguments, or its dependencies.
    structured_llm = llm.with_structured_output(ReWOOPlanOutput)

    ticker = state.research_data.ticker if state.research_data else "UNKNOWN"
    human = [m for m in state.messages if isinstance(m, HumanMessage)]
    query = human[-1].content if human else f"Analyze {ticker}"

    # Single LLM call to plan ALL tool executions
    result: ReWOOPlanOutput = structured_llm.invoke([
        SystemMessage(content=REWOO_PLANNER_PROMPT),
        HumanMessage(content=f"""Create a ReWOO plan for: {query}

Ticker: {ticker}

Output tool calls with:
- step_id: Variable name (#E1, #E2, etc.)
- description: What this accomplishes
- tool_name: Exact tool from the list
- tool_args: Dictionary of arguments
- depends_on: List of step_ids this depends on"""),
    ])

    # Store the typed proposed-call plan.
    # This teaching worker sends ready steps directly to execute_tool.
    return {"rewoo_plan": result.steps}
Fase 2: worker ReWOO (executa ferramentas sem raciocínio do LLM)
def rewoo_worker_node(state: AgentState) -> dict:
    """Execute dependency-ready tools in parallel batches (no LLM calls).

    Independent tools share a batch. Dependent tools wait until their
    prerequisites complete. The worker follows the dependency graph and
    does not add LLM calls.
    """

    results = {}        # Results keyed by step_id (e.g., "#E1": "$150.23")
    updated_steps = []  # Plan steps with their result field filled in
    pending = {step.step_id: step for step in state.rewoo_plan}

    # Keep scheduling dependency-ready batches until the graph is complete.
    # This handles chains even when the planner does not list them topologically.
    with ThreadPoolExecutor(max_workers=5) as executor:
        while pending:
            ready = [
                step for step in pending.values()
                if all(dep in results for dep in step.depends_on)
            ]
            if not ready:
                unresolved = ", ".join(pending)
                raise ValueError(f"Unresolvable ReWOO dependencies: {unresolved}")

            futures = {
                executor.submit(execute_tool, step, results): step
                for step in ready
            }
            for future in as_completed(futures):
                step = futures[future]
                results[step.step_id] = future.result()
                updated_steps.append(step.model_copy(update={"result": results[step.step_id]}))
                del pending[step.step_id]

    # State update: restore the planner's order (sorting on step_id would put
    # "#E10" before "#E2") and hand the filled-in plan to the Solver
    plan_order = {s.step_id: i for i, s in enumerate(state.rewoo_plan)}
    return {"rewoo_plan": sorted(updated_steps, key=lambda s: plan_order[s.step_id])}
Fase 3: solver ReWOO (sintetiza todos os resultados numa única chamada ao LLM)
def rewoo_solver_node(state: AgentState) -> dict:
    """Synthesize all tool results into a flash briefing.

    This is the second efficiency gain: Instead of interleaving
    LLM calls with tool execution (like ReAct), we make ONE
    final synthesis call with all gathered data.
    """

    # Build context from ALL tool results at once
    tool_results = []
    for step in state.rewoo_plan:
        if step.result:
            tool_results.append(f"### {step.description}\n{step.result}")

    context = "\n\n".join(tool_results)

    # Single LLM call to synthesize everything
    llm = ChatAnthropic(model="claude-sonnet-4-5-20250929", temperature=0)
    structured_llm = llm.with_structured_output(FlashBriefingOutput)
    result = structured_llm.invoke([
        SystemMessage(content=REWOO_SOLVER_PROMPT),
        HumanMessage(content=f"Create a flash briefing from this data:\n\n{context}"),
    ])

    # FlashBriefingOutput and DraftReport carry the same fields; the state
    # schema expects DraftReport, so convert before returning.
    return {"draft_report": DraftReport(**result.model_dump())}
O planeador escreve as chamadas propostas, o worker preenche os seus marcadores e o solver recebe os resultados. O esquema verifica a forma, não se o plano pode ser executado. O dicionário pending acima descarta em silêncio IDs duplicados. Se #E2 usar #E1 nos seus argumentos mas omitir #E1 em depends_on, ambas as chamadas podem entrar no mesmo lote antes de o primeiro resultado existir.
Antes do envio, rejeite planos vazios ou demasiado grandes, IDs duplicados, dependências em falta e ciclos. Valide os nomes das ferramentas e os argumentos contra um registo. Inspecione os marcadores dentro de valores aninhados e exija que correspondam a depends_on. Este worker didático salta essas verificações. Envia as chamadas prontas para o execute_tool do código de acompanhamento, cujas exceções capturadas se transformam em strings de erro. O solver tem de tratar uma string dessas como evidência em falta, não como uma consulta bem-sucedida. Um grafo impossível de resolver interrompe a execução antes do solver. A recuperação precisa de um resultado de falha, de uma aresta condicional de replaneamento e de um limite de tentativas.
Aquilo com que o planeador se compromete
| Rota neste grafo | Antes da primeira chamada de dados de mercado | Depois de um tool result | Chamadas ao modelo nesta implementação | Nós |
|---|---|---|---|---|
| Deep research: Plan-and-Execute com passos ReAct | O planeador escreve descrições de objetivos | O loop ReAct interno pode escolher outra chamada dentro do objetivo atual; os objetivos posteriores mantêm-se fixos | Um plano, um loop de modelo/ferramenta por passo, um relatório | planner_node → executor_node por passo → reporter_node |
| Flash briefing: ReWOO | O planeador escreve nomes de ferramentas, argumentos e dependências | O worker segue o plano; o solver vê os resultados depois da execução | Um plano, nenhuma chamada ao modelo no worker, uma síntese | rewoo_planner_node → rewoo_worker_node → rewoo_solver_node |
Um PlanStep que diz “Investigate recent earnings” deixa a escolha da ferramenta ao agente interno. Um ReWOOPlanStep que nomeia search_news e fornece a sua consulta compromete-se com essa chamada antes de chegar qualquer resultado. É essa diferença, e não o nome do padrão, que decide que observações inesperadas podem alterar a execução. Lado a lado, as duas saídas do planeador têm este aspeto:
# Plan-and-Execute: goals; the inner ReAct loop picks the tools.
plan = [
    PlanStep(step_number=1, description="Get current price and key metrics",
             tool_hint="get_stock_snapshot"),
    PlanStep(step_number=2, description="Search for recent news and earnings",
             tool_hint="search_news"),
]

# ReWOO: exact calls, fixed before any result arrives.
rewoo_plan = [
    ReWOOPlanStep(step_id="#E1", description="Read the price and valuation snapshot",
                  tool_name="get_stock_snapshot", tool_args={"ticker": "NVDA"}),
    ReWOOPlanStep(step_id="#E2", description="Find recent NVDA earnings news",
                  tool_name="search_news",
                  tool_args={"query": "NVDA earnings", "max_results": 5}),
]
Um tool_hint é um conselho que o executor pode ignorar. Um tool_name com tool_args é a chamada que o worker vai fazer.
Um loop ReAct independente pode levar todas as mensagens anteriores para cada nova chamada ao modelo. Este grafo inicia cada loop interno com o passo atual e um resumo dos passos concluídos. O estado externo guarda os resultados dos passos, não a transcrição interna dos tool calls. O ReWOO, pelo contrário, preenche os passos planeados com resultados e entrega a lista completa ao seu solver. São escolhas de gestão do contexto neste código de acompanhamento, não requisitos dos artigos originais.
Ligar as duas rotas num grafo
O grafo tem duas rotas para o utilizador sobre um único AgentState: deep research usa Plan-and-Execute com um loop ReAct dentro de cada passo, enquanto flash briefing usa ReWOO.
Esta implementação não tem replaneador: executa o plano inicial até ao fim. Acrescentar replaneamento exigiria uma aresta de executor de volta a planner e uma regra sobre quando um resultado surpreendente justifica outra chamada ao modelo.
O LangGraph mantém a ligação declarativa:
def create_graph(checkpointer=None):
    builder = StateGraph(AgentState)

    # Add nodes
    builder.add_node("router", router_node)
    builder.add_node("planner", planner_node)
    builder.add_node("executor", executor_node)
    builder.add_node("reporter", reporter_node)
    builder.add_node("rewoo_planner", rewoo_planner_node)
    builder.add_node("rewoo_worker", rewoo_worker_node)
    builder.add_node("rewoo_solver", rewoo_solver_node)
    builder.add_node("evaluator", evaluator_node)
    builder.add_node("publish", publish_node)

    # Define edges
    builder.add_edge(START, "router")
    builder.add_conditional_edges("router", route_after_router, {
        "planner": "planner",
        "rewoo_planner": "rewoo_planner",
    })

    # Deep Research path
    builder.add_edge("planner", "executor")
    builder.add_conditional_edges("executor", route_after_executor, {
        "executor": "executor",  # Loop back for more steps
        "reporter": "reporter",  # Done with plan
    })
    builder.add_edge("reporter", "evaluator")

    # Flash Briefing path (ReWOO)
    builder.add_edge("rewoo_planner", "rewoo_worker")
    builder.add_edge("rewoo_worker", "rewoo_solver")
    builder.add_edge("rewoo_solver", "evaluator")

    # Both paths run the same evaluator before the human approval step.
    builder.add_edge("evaluator", "publish")
    builder.add_edge("publish", END)

    return builder.compile(
        checkpointer=checkpointer,
        # Human-in-the-loop pause: the reporter (or ReWOO solver) writes a
        # draft. A separate model session reads that draft and records its
        # assessment. The graph then stops before publishing, whichever
        # assessment it produced, so a human can review both the draft and
        # assessment. Part 6 explains how the program decides a run is complete.
        interrupt_before=["publish"],
    )
Teste se a chamada ao modelo do router ajuda
O router classifica snapshots rápidos, incluindo “current price”, como ReWOO, e pedidos complexos, como uma tese de investimento, como Plan-and-Execute. Por omissão, escolhe deep research quando a classificação não é clara. O Schema-Guided Reasoning restringe a saída do classificador a um dos dois modos:
class ExecutionMode(str, Enum):
    DEEP_RESEARCH = "deep_research"  # Plan-and-Execute with ReAct steps
    FLASH_BRIEFING = "flash_briefing"  # ReWOO

class RouterOutput(BaseModel):
    mode: ExecutionMode
    ticker: str
    reasoning: str

ROUTER_SYSTEM_PROMPT = """Classify the user's request:

1. deep_research: complex analysis requiring synthesis
   - Examples: "Analyze strategic risks", "investment thesis"
2. flash_briefing: quick snapshots, simple data retrieval
   - Examples: "quick snapshot", "current price"

Default to deep_research if unclear."""

llm = ChatAnthropic(model="claude-sonnet-4-5-20250929", temperature=0)
structured_llm = llm.with_structured_output(RouterOutput)
É assim que esta aplicação encaminha os pedidos; não prova que qualquer consulta de cotação precise de um planeador. Para um pedido que só quer a cotação, uma chamada direta à ferramenta evitaria as chamadas do router, do planeador ReWOO e do solver. Essas chamadas só se justificam em pedidos que precisam que um modelo selecione ou explique dados.
Um router também pode enviar um pedido para o loop errado. Compare ambas as rotas e um workflow fixo nas mesmas tarefas, ferramentas e orçamento. Registe a conclusão da tarefa, as aceitações indevidas, os tokens com e sem cache, o tempo real e a recuperação após erros de ferramentas ou observações enganadoras. Repita as execuções quando a escolha do modelo for estocástica e conte cada tentativa iniciada. Um número menor de chamadas só ajuda se a rota continuar a concluir a tarefa dentro das suas restrições. O relato de engenharia da Anthropic também recomenda começar com workflows simples e combináveis.
A implementação de acompanhamento completa, incluindo o router e o estado partilhado, está no commit b4e769a do Market Analyst Agent.
Experimente a API atual de loop único
O grafo acima usa uma factory de agentes mais antiga do LangGraph. Se quiser examinar primeiro a API create_agent atual, esta pequena fixture evita os serviços de dados de mercado. Mostra uma chamada de modelo/ferramenta e o seu resultado, não uma razão para usar um agente numa consulta conhecida. Numa aplicação que só responde a esta pergunta, chame diretamente a função de consulta.
Defina ANTHROPIC_API_KEY e instale langchain e langchain-anthropic antes de executar o snippet. A invocação faz um pedido pago ao modelo.
from langchain.agents import create_agent
from langchain_anthropic import ChatAnthropic

def lookup_fixture_company(ticker: str) -> str:
    """Look up a company name in a local fixture, not live market data."""
    return {"NVDA": "NVIDIA", "AMD": "AMD"}.get(
        ticker.strip().upper(), "No company in the fixture"
    )

agent = create_agent(
    model=ChatAnthropic(model="claude-sonnet-5", max_tokens=4096),
    tools=[lookup_fixture_company],
    system_prompt="Use the fixture for company names. Do not invent market data.",
)
result = agent.invoke({
    "messages": [{"role": "user", "content": "Which company is NVDA in the fixture?"}]
})
print(result["messages"][-1].text)
Se o modelo propuser lookup_fixture_company, a biblioteca invoca essa função Python e devolve-lhe o resultado. O snippet não garante que o modelo use a ferramenta, nem testa uma comparação de rotas, uma política de falhas ou a precisão com dados reais.
A camada seguinte é a memória
O loop decide que chamada vem a seguir; o resto do harness tem de fornecer contexto, executar e autorizar chamadas, preservar o estado e verificar a conclusão. A Parte 2, arquitetura de memória de agentes de AI separa os checkpoints retomáveis do conhecimento entre sessões e dos documentos do projeto. Sem checkpoints duradouros, um reinício do worker perde o estado em curso deste grafo. A Parte 3 examina as interfaces das ferramentas, a Parte 4 trata da autorização, a Parte 5 trata da execução e da recuperação, e a Parte 6 examina as evidências de conclusão.
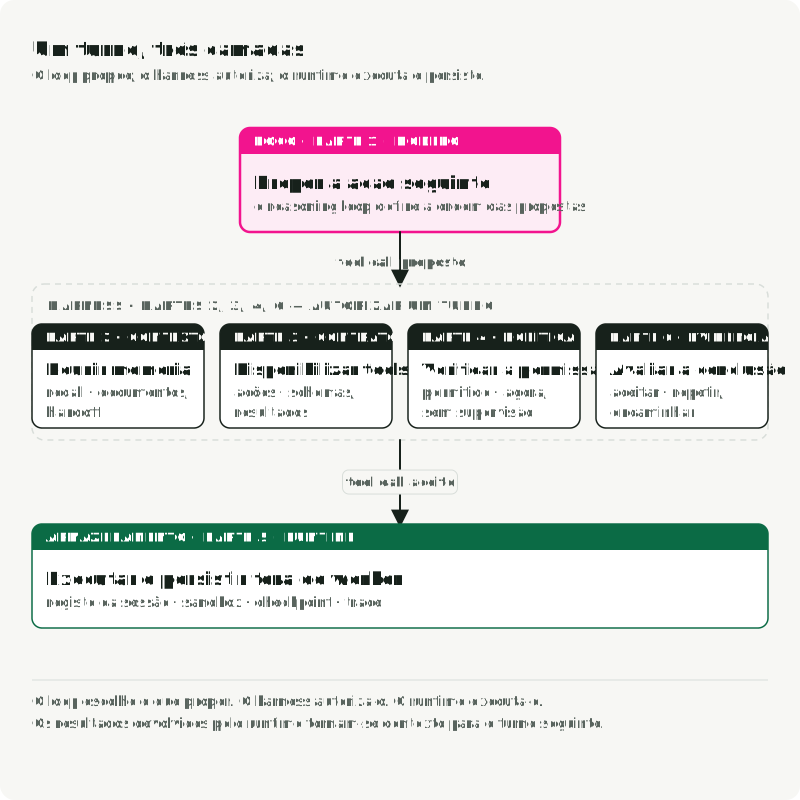
A figura situa cada parte no ponto de um turno em que atua.
Referências
- ReAct: Synergizing Reasoning and Acting in Language Models (Yao et al., 2022)
- ReWOO: Decoupling Reasoning from Observations for Efficient Augmented Language Models (Xu et al., 2023)
- Plan-and-Solve Prompting: Improving Zero-Shot Chain-of-Thought Reasoning by Large Language Models (Wang et al., 2023)
- Market Analyst Agent Repository