Runtime de agentes AI de longa duração: sessões e checkpoints

Tradução automática
Este artigo foi traduzido automaticamente a partir da versão original em inglês.
Um agent runtime de longa duração permite que uma execução com tool use sobreviva ao worker que a iniciou. Este artigo destina-se a engenheiros que estão a passar um agente de um request handler para trabalho em segundo plano. Vai ver que estado tem de sobreviver a um reinício, porque é que um checkpoint não torna seguro repetir uma ação externa e como esses requisitos determinam a forma de deployment. Depois, o artigo compara opções concretas: uma queue e um worker, Temporal, fornecedores de sandbox, Cloud Run, Lambda, Fargate, Kubernetes e plataformas de agentes alojados, com a observabilidade necessária para fazer debugging de uma execução depois de ela falhar.
O modelo continua a propor a ação seguinte. O harness na Parte 6 fornece o contexto, autoriza as ferramentas e verifica a conclusão. O runtime dá a esse loop estado durável e um lugar onde executar. A Parte 4 trata da decisão de permissão; aqui seguimos uma ação aprovada através de uma falha e da recuperação.
Estado que um reinício não pode apagar
Imagine um agente de investigação que reúne fontes, redige um relatório, espera pela aprovação e publica o ficheiro aprovado. A execução pode demorar minutos ou dias, porque a aprovação não tem hora de chegada fixa. Um deploy pode substituir o worker enquanto o agente está a redigir, enquanto espera ou logo depois de o serviço de publicação aceitar o ficheiro.
A memória do worker é descartável. O relatório aprovado e o facto de a publicação já poder ter acontecido não são. Antes de escolher um framework, anote o que outro worker precisa de conseguir responder:
| Pergunta depois de um reinício | Registo durável a manter |
|---|---|
| Que execução é esta e pode continuar? | ID da execução, estado, prazo, orçamento, responsável ou lease |
| O que deve o agente fazer a seguir? | Checkpoint do estado do loop ou do grafo |
| Que relatório foi aprovado? | Versão imutável do artefacto ou hash do conteúdo e a decisão de aprovação |
| A publicação já aconteceu? | ID da operação pendente, argumentos, resultado e resultado da consulta externa |
| Porque falhou esta execução ou gastou o seu orçamento? | Eventos e traces correlacionados |
Estes registos não têm de ser cinco produtos separados. Uma base de dados pode guardar as linhas das execuções, os checkpoints e os eventos das operações em tabelas separadas. Um object store pode guardar os ficheiros dos relatórios. Um backend de traces pode guardar os tempos. Mantenha os registos separados, porque cada um prova uma coisa diferente. O relato da Anthropic sobre agentes de longa duração descreve o mesmo problema básico do lado do modelo: um novo contexto não se lembra do trabalho anterior, a menos que a aplicação lhe dê progresso durável para ler. A equipa do Codex da OpenAI relata execuções individuais que trabalham numa única tarefa durante mais de seis horas, por isso este não é um caso raro.
Chame execução a uma tarefa aceite. Pode usar várias sessões do modelo à medida que os contextos são substituídos, e uma conversa pode conter várias execuções. Os frameworks usam “sessão” e “thread” de formas diferentes. No LangGraph, thread_id é a chave do histórico de checkpoints; decida explicitamente se uma dessas threads corresponde a uma execução ou abrange várias. Em qualquer caso, mantenha um ID de execução da própria aplicação para o log de operações. Os session backends do OpenAI Agents SDK guardam um histórico de conversa mutável que pode ser editado, limpo e compactado, por isso não trate um deles como o log de recuperação append-only.
O workspace é outra parte do estado. Para um agente de programação, um commit pode identificar os ficheiros a restaurar; para o exemplo do relatório, uma chave de objeto imutável e um hash podem identificar o ficheiro aprovado. Um sandbox em pausa pode preservar um sistema de ficheiros conveniente, mas a sua existência continuada não deve ser a única forma de recuperar o resultado. Os Git worktrees separam checkouts; não são sandboxes de execução.
Cinco componentes a posicionar
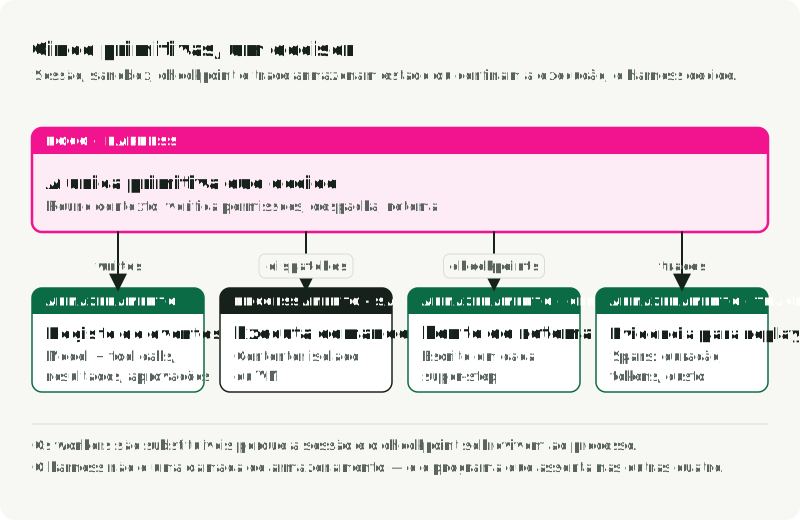
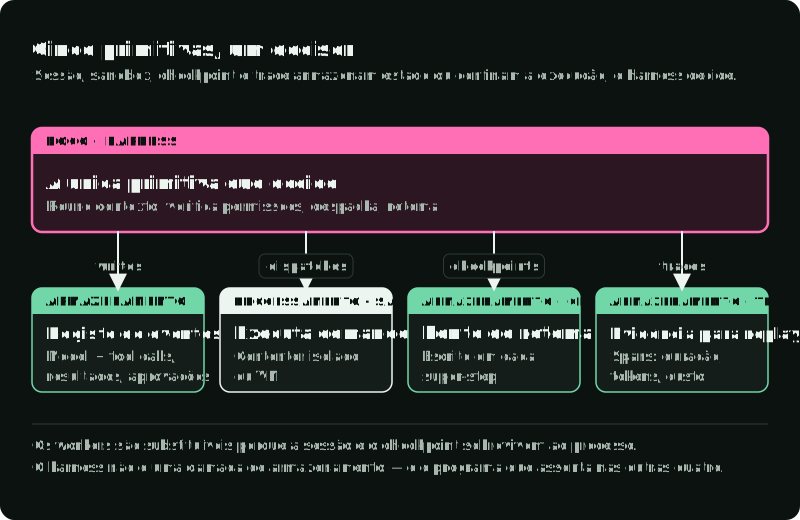
O texto Scaling Managed Agents da Anthropic separa a sessão, o harness e o sandbox. Este artigo também separa os checkpoints e os traces, identificando cinco responsabilidades do runtime a distribuir. Uma implementação pode juntá-las, mas cada uma precisa de um responsável e de um limite de falha conhecido. A figura coloca-as numa configuração de fila e worker e indica o que passa entre elas.
| Componente | Função | Implementação comum |
|---|---|---|
| Sessão | Log append-only de chamadas, resultados e aprovações | Tabela de eventos em PostgreSQL, com o ID da execução como chave |
| Harness | Conduzir os turnos do modelo e das ferramentas até a tarefa terminar | Grafo LangGraph, runner do OpenAI Agents SDK, loop próprio |
| Sandbox | Executar comandos com limites de ficheiros, rede e processos | Container reforçado, microVM, sandbox de browser |
| Checkpoint | Retomar sem repetir toda a execução | Saver PostgreSQL ou Redis do LangGraph, estado do motor de workflows |
| Trace | Fazer debugging de uma execução depois de terminar | Spans OpenTelemetry para Tempo, Jaeger, Honeycomb, LangSmith |
O harness é o único que toma decisões; os outros quatro guardam estado ou restringem a execução. O grafo compilado do LangGraph, os Deep Agents da LangChain e o Claude Code são harnesses neste sentido. O guia de sandbox do OpenAI Agents SDK traça a mesma linha: aprovações, tracing, handoffs e estado de retoma pertencem ao runtime exterior, enquanto comandos, alterações de ficheiros e isolamento do ambiente pertencem à sessão do sandbox.
Os sandboxes diferem no tempo de vida. Um sandbox efémero novo existe para uma tarefa e paga o custo de arranque de todas as vezes. Um sandbox persistente em pausa mantém o sistema de ficheiros e um snapshot da memória entre execuções, para que a retoma seguinte possa evitar um arranque completo. Um sandbox de snapshot ou fork ramifica uma imagem copy-on-write a partir de um pai preparado, para que muitas tarefas partilhem as dependências instaladas sem partilharem o seu estado gravável.
Duas preocupações atravessam os cinco componentes. A aplicação de permissões corre antes de cada tool call. As permissões de sistema de ficheiros dos Deep Agents abrangem apenas as suas ferramentas de sistema de ficheiros integradas, por isso comandos de shell, ferramentas personalizadas e chamadas MCP precisam de controlo na política do sandbox ou atrás de um proxy de ferramentas. Os secrets não devem chegar ao modelo nem, normalmente, ao sandbox. O Managed Agents da Anthropic clona repositórios com um token durante a preparação do sandbox e encaminha as chamadas MCP através de um proxy que guarda os tokens OAuth, para que o harness nunca veja as credenciais.
Verifique o posicionamento anotando cada componente e o que o implementa. O PostgreSQL pode guardar a sessão e os checkpoints, o container do worker executa o harness, um fornecedor como Daytona, Modal ou E2B disponibiliza o sandbox, e o Tempo ou o LangSmith guarda os traces. Depois procure falhas acopladas: dois componentes no mesmo processo falham em conjunto, e uma credencial partilhada atravessa ambas as fronteiras se for exposta.
Um checkpoint, um event log e um registo externo respondem a perguntas diferentes
Um checkpoint indica onde a execução pode ser retomada: as mensagens ou valores do grafo já produzidos, o passo que terminou e o passo que espera para correr. O LangGraph guarda o estado do grafo nas fronteiras dos super-steps. O seu checkpointer também pode reter as escritas bem-sucedidas de nós quando outro nó do mesmo passo falha. É uma tolerância a falhas útil, mas um checkpoint de valores do grafo não prova se um serviço fora do grafo confirmou um pedido.
graph.get_state() devolve um StateSnapshot cujo .values contém o último estado conhecido do grafo, o que é útil num pacote de debug. Nem ele nem o checkpoint conseguem reconstruir eventos que o harness nunca registou.
Um event log de operações indica o que a aplicação tentou e o que ficou a saber: publish_requested, publish_pending, publish_succeeded ou needs_human, todos associados a uma execução e a um ID de operação. Pode viver na mesma base de dados que os checkpoints, desde que a aplicação escreva de facto os eventos. O histórico de checkpoints de um grafo não é automaticamente este log. Uma transcrição de chat é outra coisa: ajuda o modelo a continuar, mas não tem de conter todas as aprovações, argumentos de ferramentas ou efeitos secundários.
O serviço externo detém o resultado autoritativo da publicação. Pode oferecer uma chave de idempotência, uma consulta de estado pelo ID da operação ou uma consulta de um objeto com o hash esperado. Se não oferecer nenhuma destas, o runtime não pode deduzir sucesso a partir de uma resposta em falta. Um trace pode mostrar que um pedido foi enviado e quanto tempo demorou, mas um span que termina num timeout não consegue determinar se o serviço remoto o confirmou.
A diferença aparece quando se repete estado antigo. O replay de checkpoints do LangGraph volta a executar os passos após o checkpoint selecionado, incluindo os pedidos de API nesses passos. É uma funcionalidade de debugging e de controlo de fluxo, não uma garantia de execução exatamente uma vez para efeitos externos. A mesma regra aplica-se a um worker novo que retoma após uma falha.
Seguir uma publicação incerta
O relatório está aprovado e guardado com um ID de artefacto estável. Agora o harness pede ao runtime que o publique. Assuma que o serviço de publicação pode concluir o pedido mesmo que o worker perca a resposta.
- Registar a intenção. Antes de o pedido sair do worker, persista um ID de operação da própria aplicação, o hash do artefacto aprovado, o destino e o estado
pending. Associe esse ID a esses argumentos. Um ID de tool call gerado pelo modelo pode mudar após um novo planeamento; não é a identidade da ação de negócio. - Enviar a ação. Envie o mesmo ID de operação ao serviço de publicação se a sua API suportar idempotência. Se não suportar, use uma chave de objeto estável ou outra forma, suportada pelo fornecedor, de consultar o resultado. O worker não deve assumir que um timeout significa que o serviço não fez nada.
- Registar o resultado. Perante uma resposta confirmada, guarde o ID do resultado externo e marque a operação como concluída antes de continuar a execução. O checkpoint seguinte pode então referir esse resultado.
- Recuperar a lacuna. Suponha que o serviço aceitou o relatório, mas o worker falhou antes do passo 3. Um worker novo vê
pending. Pergunta ao serviço se essa mesma operação ou artefacto existe. Se existir, regista o resultado recuperado e continua sem publicar uma segunda cópia. Se for suportada uma nova tentativa, usa o mesmo ID de operação e argumentos inalterados. - Parar perante a incerteza. Se o serviço não conseguir responder e não prometer novas tentativas idempotentes, deixe a operação por resolver para revisão. Gerar uma nova chave e enviar o pedido outra vez seria uma nova ação, com risco de publicação duplicada.
A sequência abaixo segue a falha do passo 4, entre o sucesso externo e o registo local do resultado.
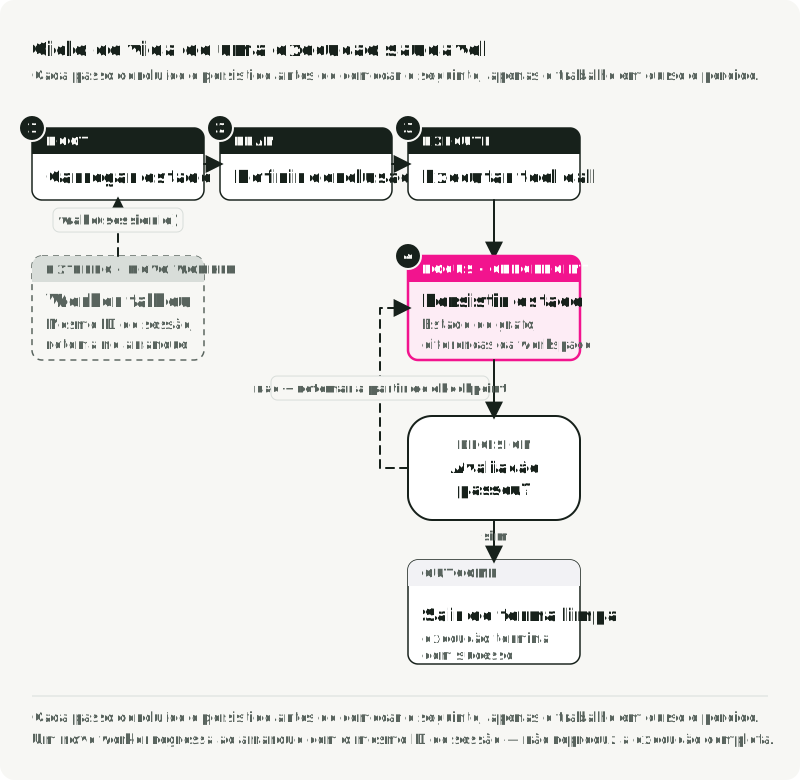
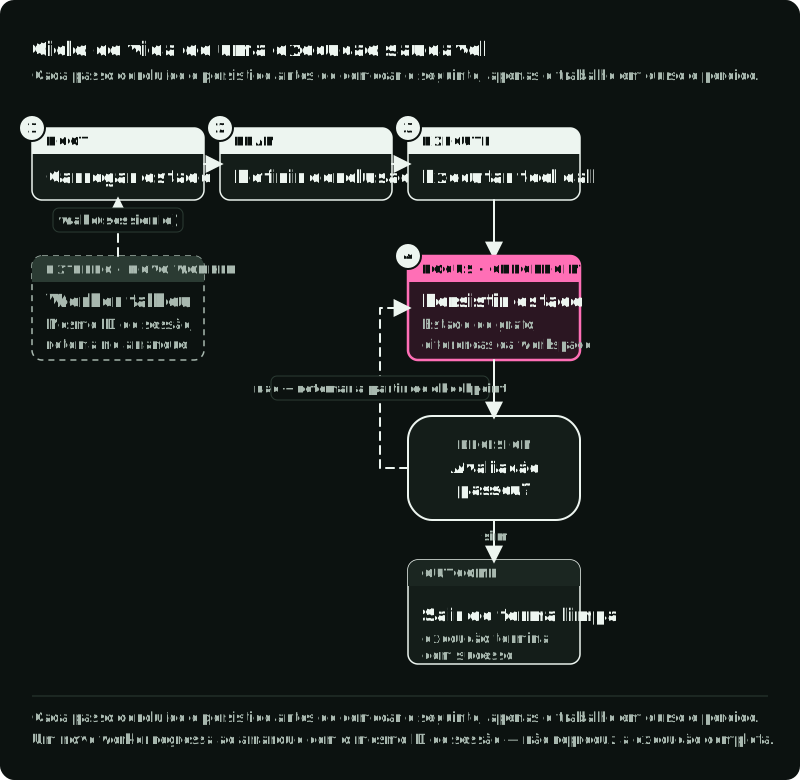
O diff do workspace no diagrama é uma versão ou referência de ficheiro recuperável; o checkpoint do grafo não precisa de conter os próprios ficheiros.
O caso para o qual deve desenhar é uma falha entre o sucesso externo e o armazenamento local do resultado. Nenhuma transação de base de dados consegue confirmar atomicamente uma escrita num serviço não relacionado sem a cooperação desse serviço. O texto da AWS sobre APIs idempotentes explica porque é que um ID de pedido fornecido pelo chamador representa intenção: dois pedidos idênticos podem ser duas ações desejadas, enquanto duas novas tentativas com o mesmo ID devem representar uma só. O serviço recetor tem de respeitar esse contrato e detetar um payload alterado com o mesmo ID. Verifique o seu período de deduplicação; uma chave expirada não é uma promessa permanente. A Stripe, por exemplo, devolve o primeiro resultado para uma chave de idempotência repetida e pode eliminar chaves após pelo menos 24 horas.
O mesmo protocolo aplica-se a enviar um email, cobrar uma conta, abrir um pull request ou alterar uma base de dados que pertence a outro serviço. O método de reconciliação difere. Por exemplo, um fornecedor pode suportar chaves de idempotência, uma restrição de unicidade de um recurso, uma consulta read-after-write ou nenhuma consulta fiável. Desenhe a política de novas tentativas a partir desse contrato, não do facto de o framework de agentes conseguir repetir um nó.
Tornar recuperável o resto da execução
A chamada externa incerta é o caso mais difícil. O resto da execução continua a precisar de algumas regras explícitas:
- Um único escritor ativo. Uma queue pode voltar a entregar trabalho depois de um lease expirar. Use um lease da execução com fencing ou atualizações de estado condicionais, para que um worker desatualizado não consiga fazer avançar a execução. Mantenha a proteção de idempotência para as chamadas já em curso. Confirme um job apenas depois de o estado que ele representa estar durável. A recuperação começa por inspecionar as operações pendentes, não por reiniciar cegamente o modelo. Decida o que significa uma nova entrada do utilizador durante uma execução: rejeitá-la, colocá-la em fila, interromper ou reverter; o relato da LangChain sobre o runtime dos Deep Agents descreve estas opções.
- Uma espera durável. Se a publicação exigir aprovação, persista a ação proposta e os seus argumentos exatos. Retome com a decisão de aprovação e volte a verificá-la se a ação proposta mudar. Não mantenha um processo worker aberto só para esperar por uma pessoa.
- Uma execução limitada. Persista o prazo, os limites de chamadas ou de ferramentas e o orçamento de gastos. Reserve orçamento antes de um envio concorrente, para que duas chamadas não possam gastar ambas o mesmo saldo; reconcilie depois o consumo real. O cancelamento impede novas chamadas e regista o pedido, mas não consegue desfazer um efeito externo em curso. Um alerta de métricas ou um orçamento do lado do fornecedor, como os task budgets em beta da Anthropic, é um segundo sinal; o modelo pode exceder um orçamento indicativo, por isso mantenha o registo de envios em qualquer caso.
- Trabalho restaurável. Guarde uma referência ao artefacto aprovado, o seu hash e a versão do workspace que o produziu. Um processo restaurado deve conseguir validar o ficheiro antes de o publicar. Ficheiros grandes pertencem a um artifact store, não a cada checkpoint do grafo.
- Uma fronteira de execução. Se uma ferramenta executa código gerado, instala pacotes ou navega em páginas não confiáveis, execute-a num ambiente com as restrições de ficheiros, rede e processos necessárias. Mantenha as credenciais de longa duração fora do contexto visível para o modelo; aplique as permissões onde a ação é executada. Um container ou um checkout por worktree, por si só, não estabelece o isolamento que o seu modelo de ameaças pode exigir.
No LangGraph, escolha deliberadamente a durabilidade dos checkpoints. O seu modo "sync" persiste cada checkpoint antes de o passo seguinte começar; "async" pode perder um checkpoint recente numa falha do processo, e "exit" não guarda o progresso intermédio contra uma falha a meio da execução. Mesmo "sync" não fecha a lacuna dos efeitos externos descrita acima. O event log e a lógica de reconciliação continuam a ser trabalho da aplicação.
Falhas que as execuções longas acrescentam
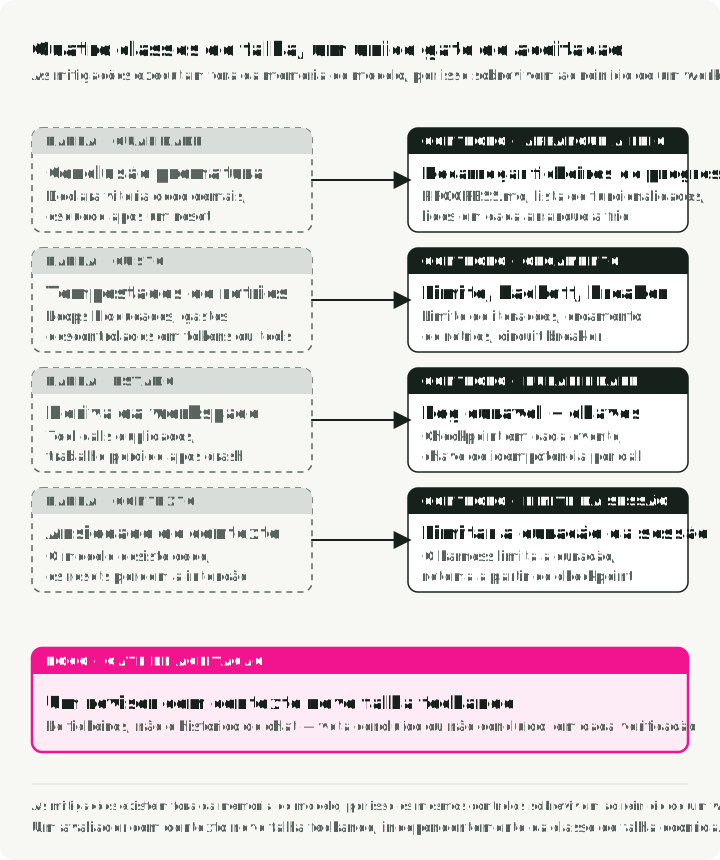
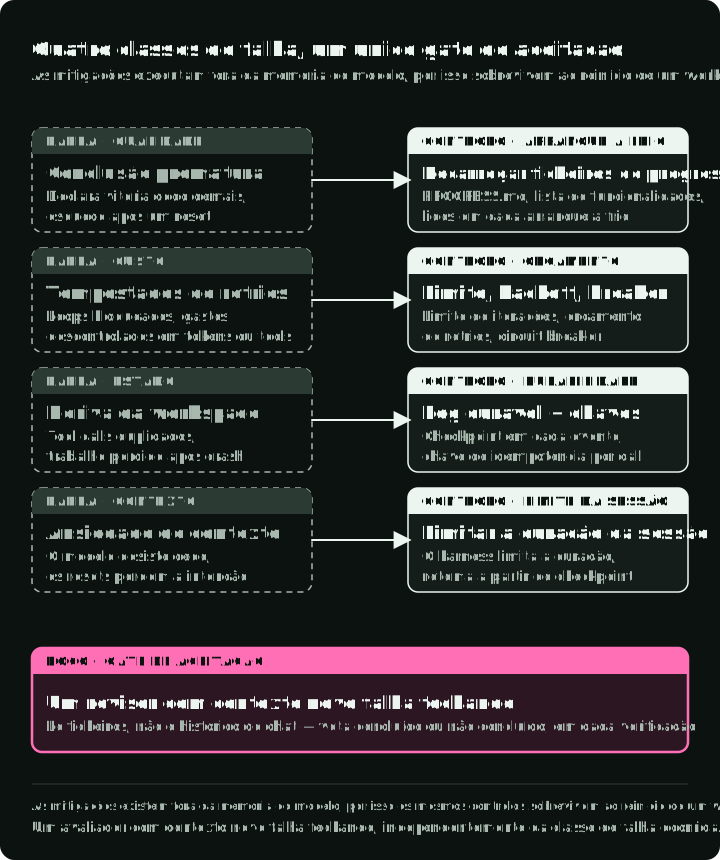
À medida que as execuções atravessam workers e context windows, as falhas deslocam-se para o estado, os efeitos secundários duplicados, a divergência do workspace e o custo. Cada uma precisa de um controlo fora da memória do modelo, para que continue a funcionar após um reinício. A figura coloca cada controlo no passo do ciclo de execução em que atua; a tabela acrescenta onde é implementado.
| Falha | Controlo | Onde corre |
|---|---|---|
| O agente declara a tarefa concluída cedo demais | Verificações de aceitação sobre os artefactos; evaluator opcional com contexto novo e sem ferramentas de escrita | Passo de conclusão do harness; evaluator na sua própria sessão de sandbox |
| O agente esquece trabalho concluído após um reset de contexto | Ficheiros de progresso como PROGRESS.md e feature-list.json, lidos antes da primeira chamada ao modelo | Hook de arranque de cada sessão do modelo |
| O modelo resume e para cedo perto do seu limite | Limitar a sessão e iniciar uma nova a partir do handoff e do checkpoint | Limite de duração da sessão no harness |
| Loops bloqueados e novas tentativas sem limite | Limite de iterações, backoff exponencial, circuit breaker sobre a taxa de erros das ferramentas, orçamento rígido de tool calls | Nó de execução de ferramentas; RetryPolicy nas Activities do Temporal |
| O agente edita ficheiros que pertencem a outra execução | Workspace por execução, commits Git como pontos de recuperação, política de ficheiros no sandbox ou no proxy de ferramentas | Política do sandbox; permissões dos Deep Agents para as suas ferramentas de ficheiros integradas |
| O gasto em tokens ou ferramentas descontrola-se | Reservar orçamento antes do envio, limitar o output, reconciliar o consumo | Registo de orçamento no caminho de envio; alertas Prometheus como segundo sinal |
| Um tool call corre duas vezes após uma falha | Persistir pending e uma chave de idempotência antes do envio; consultar ou repetir com a mesma chave na retoma | Event store mais a API de idempotência ou de consulta do fornecedor |
| Perde-se trabalho quando um worker ou sandbox morre | Event log durável, checkpoint após cada super-step, reconciliar os efeitos pendentes antes de continuar | PostgresSaver mais uma tabela de eventos, ou um Workflow do Temporal |
O quick-start cwc-long-running-agents da Anthropic inclui os padrões de evaluator e de ficheiros de progresso. A paragem precoce perto do limite de contexto depende do modelo, por isso volte a testar qualquer solução alternativa quando o modelo mudar. Como diz a Anthropic, cada componente do harness codifica uma suposição sobre o que o modelo não consegue fazer, e essa suposição pode ficar desatualizada quando o modelo muda.
Falhas de transporte que o ciclo tem de absorver
Um stream pode fechar a meio da resposta. A ligação pode cair depois de ter chegado apenas metade de uma resposta, ou metade de um tool call. Os argumentos da ferramenta chegam como fragmentos de JSON que só podem ser analisados quando o bloco fica completo, pelo que uma chamada montada a meio nunca deve chegar ao envio (dispatch). Executar um comando truncado é exatamente aquilo que a camada de permissões existe para evitar. Trate uma ligação de streaming interrompida como um pedido falhado: descarte o fragmento, nunca o acrescente como algo que o modelo disse e repita a chamada inteira. Isto é comportável porque o prefixo já enviado é uma leitura de cache na repetição. Mantenha a repetição abaixo do ciclo do agente, no wrapper da chamada, para que um pedido repetido nunca volte a executar uma ferramenta que já foi executada.
O streaming também deixa de ser opcional à medida que os pedidos crescem. Os fornecedores impõem timeouts aos pedidos sem streaming e exigem streaming acima de certos tamanhos de saída, e os SDKs podem fazer streaming nos bastidores em chamadas longas. Por isso, um runtime de produção tende a fazer streaming de tudo e a acumular o resultado, mesmo quando nenhuma interface quer os fragmentos. Os tokens que vão chegando passam assim a servir também de sinal de atividade: enquanto continuam a chegar, a chamada está viva, pelo que uma resposta em streaming que fica um minuto em silêncio é indício de bloqueio. Um pedido sem streaming não diz nada até regressar.
Os limites de taxa são medidos em tokens, não em pedidos. Os fornecedores medem os tokens de entrada e de saída por minuto, pelo que um agente que carrega um pedido grande esgota um limite a uma taxa de pedidos que parece trivialmente baixa. O crescimento do contexto surge, por isso, como erros 429 e não como um problema de latência, e o fan-out paralelo multiplica a pressão pelo tamanho de cada pedido e não pelo número de workers. Limite a concorrência e partilhe um único orçamento de tokens no componente que lança o trabalho paralelo; o backoff dentro de cada worker limita-se a distribuir a mesma procura no tempo. Conte os 429 e o endpoint usado por execução, para que um limite do fornecedor não seja confundido com uma propriedade da configuração em teste.
O runtime também precisa de evidências para diagnosticar uma execução. Emita um ID de execução e um ID de operação com os spans do modelo e das ferramentas, o estado, a duração e o consumo de tokens. As convenções GenAI do OpenTelemetry dão nomes comuns a estes campos, embora as convenções ainda estejam em desenvolvimento. O texto dos prompts, os argumentos das ferramentas e os resultados podem conter dados sensíveis; decida se pertencem à telemetria antes de os capturar. Um trace ajuda a explicar uma falha. O event log e a consulta externa decidem se é seguro continuar. A secção de observabilidade mais abaixo transforma isto numa stack.
Escolher a forma de deployment a partir das regras de espera e de falha
O nome da plataforma é uma escolha tardia. Primeiro pergunte se o chamador precisa do resultado final no mesmo pedido, se a execução pode esperar e quem vai operar o seu estado durável.
| Necessidade | Forma inicial | O que ainda precisa |
|---|---|---|
| Tarefa curta concluída dentro de um pedido | agent loop no request handler | Uma fronteira de execução separada para ferramentas não confiáveis; estado durável se a repetição ou a continuação importarem |
| Trabalho em segundo plano que pode sobreviver a um worker | Queue, worker substituível, estado durável | Leases de execução, checkpoints, log de operações, artifact store conforme necessário |
| Muitas aprovações, timers, callbacks ou novas tentativas ao longo de deploys | Motor de workflows durável com workers para chamadas ao modelo e tool calls | Alterações de workflow seguras para replay e activities externas idempotentes |
A duração da execução é um primeiro filtro útil, embora não decida todo o desenho. A figura coloca cada forma inicial numa escala logarítmica de duração de execução, acima dos limites de tempo das plataformas comuns:
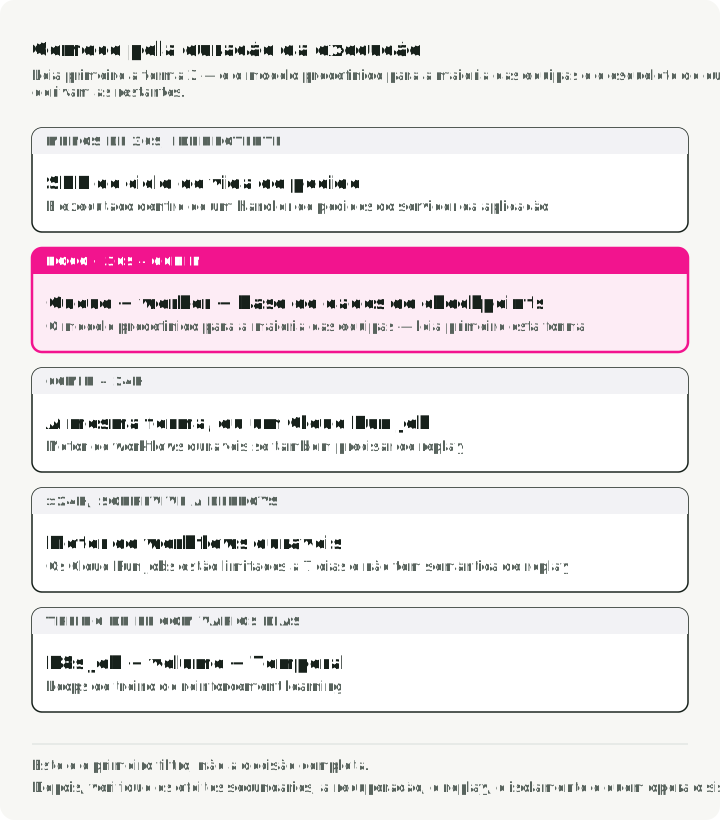
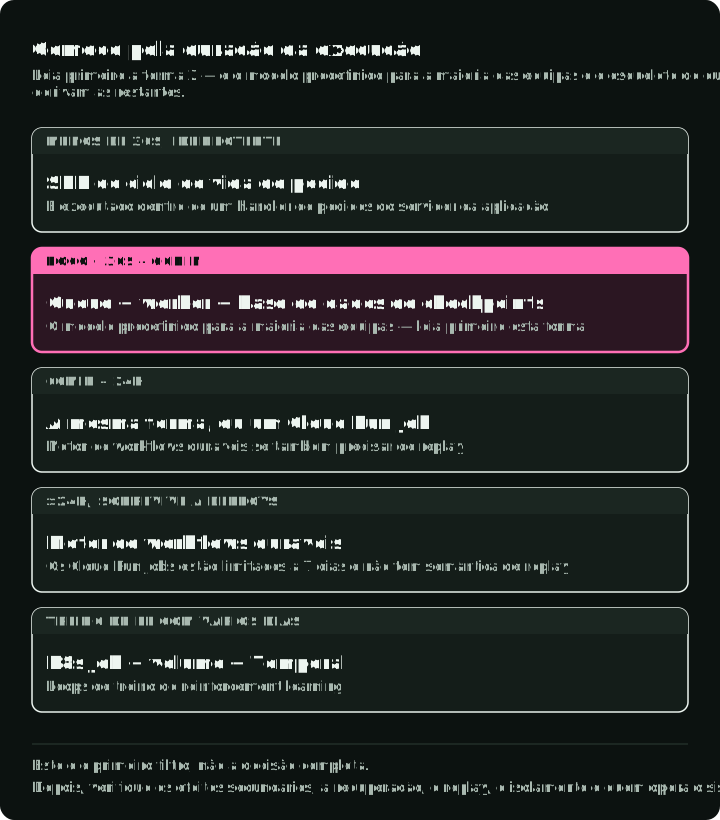
- Menos de 30 segundos, idempotente: o SDK do agente dentro de um request handler do servidor da aplicação.
- De 30 segundos a 60 minutos: queue, worker e base de dados de checkpoints.
- De 60 minutos a 24 horas: a mesma queue e o mesmo worker, ou um Cloud Run Job para trabalho pontual; um motor de workflows se também precisar de versionamento e replay.
- Mais de 24 horas, sobrevivendo a deploys: um motor de workflows durável como o Temporal.
- Loops de treino de reinforcement learning com vários dias: um Kubernetes Job com um volume, mais Temporal.
Depois desse filtro, verifique os efeitos secundários, a recuperação, o replay, o isolamento, a localização dos dados e a equipa que vai operar o sistema.
Eu começaria o exemplo do relatório com uma queue e um worker. A API devolve um ID de execução; o worker faz avançar o harness; um store durável regista os checkpoints e as operações pendentes; um artifact store guarda o relatório. Este desenho cumpre os requisitos específicos de reinício e de aprovação sem assumir uma cloud em particular. Se as regras de espera e de novas tentativas se tornarem um workflow próprio, o Temporal pode persistir o histórico de execução e repetir as decisões do workflow. As suas Activities continuam a executar chamadas externas e podem ser repetidas, por isso precisam do mesmo desenho de idempotência ou reconciliação.
Os serviços cloud implementam estas formas; os seus timeouts não definem a arquitetura. Um pedido a um serviço Cloud Run tem um prazo e pode continuar a ser processado depois de a ligação fechar, por isso um timeout HTTP é uma evidência especialmente fraca de que uma ação parou. Um Cloud Run Job, uma task ECS ou um Kubernetes Job podem alojar um worker em segundo plano, mas um limite longo de tarefa, por si só, não lhe dá progresso durável. Uma invocação normal do AWS Lambda tem um limite de 15 minutos; um workflow pode abranger invocações limitadas. Verifique os limites atuais e o comportamento de novas tentativas do serviço escolhido antes do deployment.
Uma plataforma de agentes alojados pode operar o loop e parte do seu estado por si. Avalie-a com o mesmo exercício de falha: como exporta o estado da execução, encontra um efeito secundário pendente, associa a aprovação a uma ação, inspeciona os dados enviados para o control plane e retoma após um deployment? Mantenha o contrato de sandbox da plataforma separado do seu contrato de harness. Alojar o harness não torna automaticamente as ferramentas seguras, e alojar o sandbox não torna automaticamente a execução durável.
O que cada forma oferece
A matriz indica o componente que fornece cada responsabilidade em cada forma, assinala as células que um fornecedor alojado opera e destaca as células que não bastam por si sós. As notas a seguir indicam os limites que decidem entre elas, verificados em setembro de 2026.
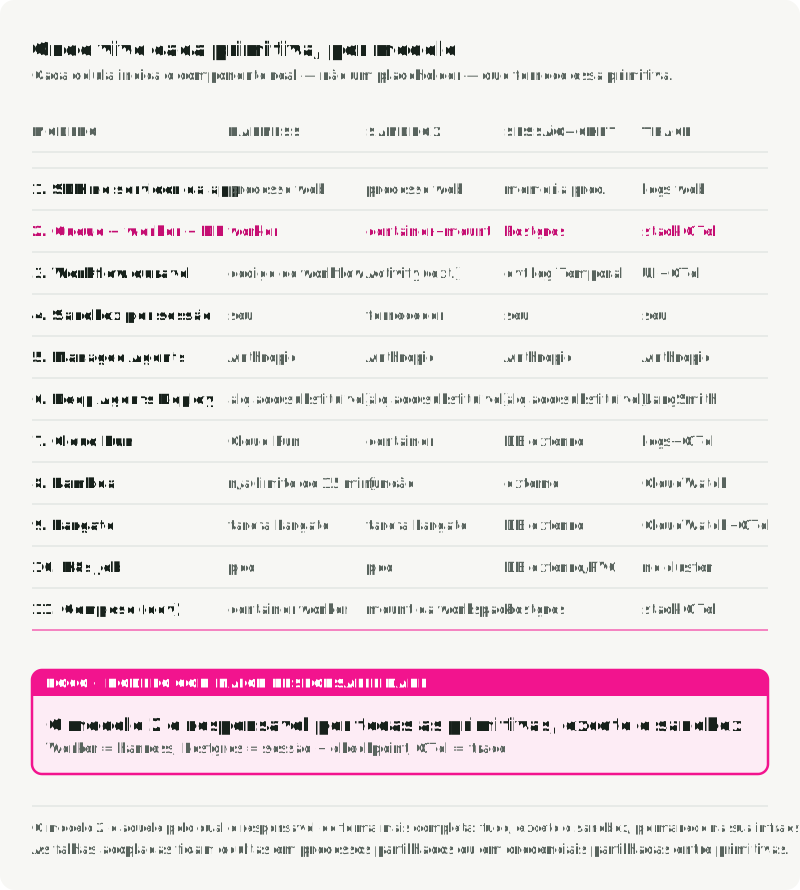
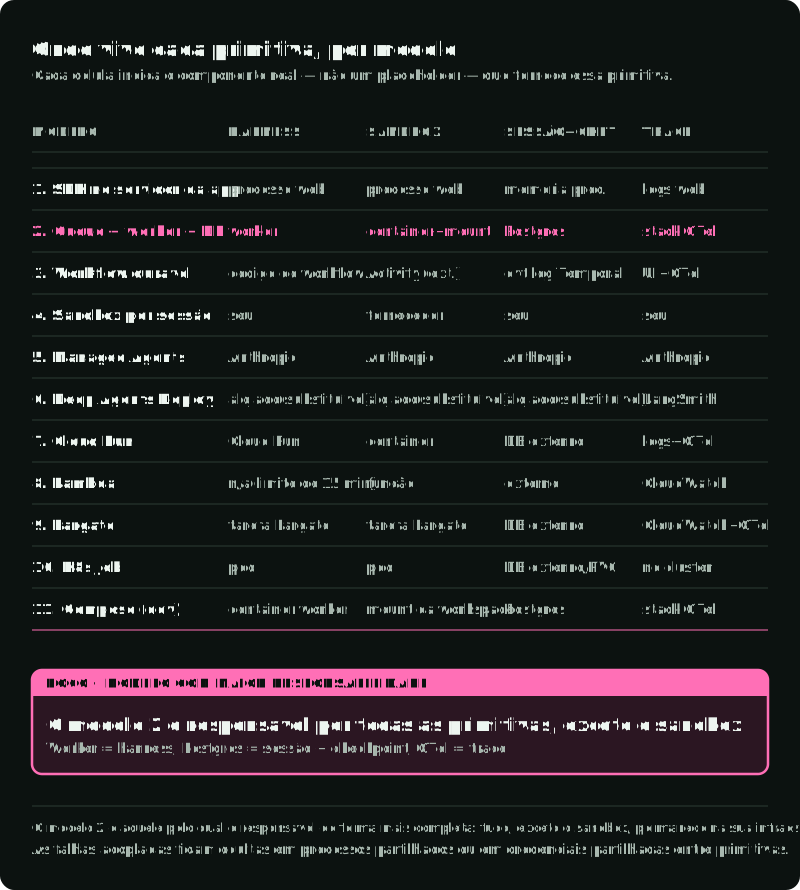
1. SDK dentro de um servidor da aplicação. O agente corre num request handler. Serve para tarefas com menos de cerca de 30 segundos, demonstrações e ferramentas internas. Uma falha da camada web perde o trabalho em memória. Uma desconexão do cliente pode cancelar o trabalho ou deixá-lo em execução, conforme o servidor e a aplicação; não determina o resultado de uma ação externa. Persista o estado se a continuação importar e não use um request handler para trabalho de várias horas.
2. Fila, worker e base de dados de checkpoints. A opção por omissão que recomendo à maioria das equipas: um worker Python com um checkpointer PostgreSQL e Redis Streams ou RabbitMQ para os jobs recebidos. O Market Analyst Agent demonstra esta forma com um worker de fila iniciado separadamente. No desenho de produção, a aplicação cria uma linha de execução, coloca um job na fila e devolve o ID da execução; o worker executa o harness, escreve eventos e checkpoints e guarda os artefactos. A profundidade da fila dá backpressure, e a computação spot ou preemptível funciona se as escritas duráveis terminarem antes de o worker confirmar o job. O worker é o harness; o código não confiável continua a precisar de um sandbox reforçado.
3. Motor de workflows durável. A orquestração do agente corre dentro de um Workflow do Temporal, e as chamadas ao modelo e os tool calls correm como Activities. O estado do workflow vive num histórico de eventos suportado por Cassandra, MySQL ou PostgreSQL, pelo que é reproduzido após falhas, e um workflow inativo não usa computação. Uma aprovação humana torna-se uma espera durável em vez de um loop de polling. Alterações de código que se sobrepõem a uma execução em curso precisam de Worker Versioning seguro para replay ou de patches. A integração do Temporal com o OpenAI Agents SDK executa as ferramentas do agente como Activities; verifique a sua lista de funcionalidades de agentes não suportadas antes de depender dela.
4. Um fornecedor de sandbox por execução. Cada execução recebe a sua própria microVM ou container de um fornecedor, enquanto o harness, a sessão, o checkpoint e o trace ficam do seu lado, normalmente na forma 2. Use esta forma quando o agente executa código não confiável, automação de browser, testes ou instalações de pacotes; o custo é um gasto maior e acoplamento ao fornecedor.
| Fornecedor | Isolamento | Limites de sessão e persistência |
|---|---|---|
| E2B | MicroVM Firecracker | Sessões contínuas de 1 h no Hobby e 24 h no Pro; pausa e retoma à parte |
| Vercel Sandbox | MicroVM Firecracker | 45 min no Hobby, 24 h no Pro e Enterprise; os snapshots expiram por omissão 30 dias após a última utilização |
| Daytona | Sandbox configurado pelo fornecedor | Ciclo de vida configurável de paragem e arquivo; os forks registam o seu pai |
| Modal | gVisor | 5 min por omissão, 24 h no máximo; volumes e snapshots têm regras de persistência próprias |
| Runloop | MicroVMs, segundo a listagem no Marketplace | Suspensão e retoma; snapshots de disco e ramificações |
Os valores de arranque dos fornecedores medem intervalos diferentes, por isso não são uma classificação de velocidade. O arranque de container em cerca de um segundo do Modal, por exemplo, exclui o arranque da aplicação. Meça o tempo desde o pedido à API até ao primeiro comando bem-sucedido e até a aplicação estar pronta, nos percentis p95 e p99 de que precisa, e verifique os limites de concorrência da conta antes de fazer load tests.
5. Anthropic Managed Agents. Uma sessão, um harness, um sandbox e um proxy MCP apoiado num cofre, todos alojados, em beta pública desde 8 de abril de 2026. Cobra as tarifas normais de tokens mais $0.08 por hora de sessão enquanto uma sessão está a correr; o tempo inativo é gratuito, e as sessões não têm modo batch. Uma sessão que corre continuamente custa cerca de $58 por mês antes dos tokens. Não está disponível através do Bedrock nem do Vertex AI. Com sandboxes auto-alojados, opera a execução e o tráfego de saída, mas os inputs e resultados das ferramentas continuam a chegar ao control plane da Anthropic. Sair dele mais tarde significa mudar de plataforma.
6. LangChain Deep Agents Deploy. deepagents deploy empacota um deepagents.toml num LangSmith Deployment com execução durável, memória, human-in-the-loop, código em sandbox e execuções agendadas, nos modos cloud, híbrido ou auto-alojado. O fornecedor de sandbox (LangSmith Sandboxes, Daytona, Modal, Runloop ou personalizado) é um valor de configuração. O harness tem licença MIT e usa o formato aberto AGENTS.md, por isso a dependência do fornecedor é menor do que na forma 5.
7. Google Cloud Run. Um serviço trata HTTP e escala até zero; o timeout de pedido é de 300 segundos por omissão, com um máximo de 60 minutos. Um job corre até terminar sem HTTP; as tasks têm 10 minutos por omissão, com um máximo de 168 horas (7 dias), ou 1 hora com GPUs. Use um serviço para execuções síncronas até 60 minutos e um job para trabalho pontual mais longo. Nenhum deles mantém estado entre execuções nem faz replay entre deploys, por isso as sessões e os checkpoints vão para PostgreSQL, Spanner ou um store semelhante.
8. AWS Lambda. Uma função termina por timeout após 15 minutos. Atrás do API Gateway, um pedido síncrono tem cerca de 30 segundos, a menos que uma REST API regional ou privada aumente o seu limite. As Lambda durable functions, lançadas em dezembro de 2025, acrescentam checkpoints, passos e esperas entre execuções que duram até um ano, enquanto cada invocação continua limitada.
9. AWS ECS ou Fargate, uma task por execução. O Fargate não tem limite de duração documentado e dá a cada task a sua própria interface de rede no modo awsvpc, o que se adequa ao acesso a dados internos da VPC. Não suporta GPUs; para isso, use ECS sobre EC2. O Fargate Spot acrescenta risco de interrupção, e a durabilidade fica a seu cargo. Compare também o Amazon Bedrock AgentCore Runtime, que aloja código de agentes com sessões geridas até 8 horas em microVMs serverless, ou 14 dias no seu tipo de computação Instances, que suporta GPUs.
10. Kubernetes Job por execução. Um Job por execução com activeDeadlineSeconds, um PersistentVolumeClaim para o workspace e um sidecar MCP. Adequa-se a equipas que já operam Kubernetes; os cold starts excluem-no para arranques abaixo de um segundo, e a recuperação de falhas fica a seu cargo. Um isolamento forte continua a depender da runtime class, da network policy e da pod security. A execução em GPU precisa de nós GPU, drivers e um device plugin.
11. Docker Compose local, apenas para desenvolvimento. O projeto de acompanhamento inicia uma aplicação Gradio e os stores da forma 2, com um volume de workspace e sem sandbox reforçado. O worker da fila inicia-se separadamente. A stack de referência abaixo distingue estes processos.
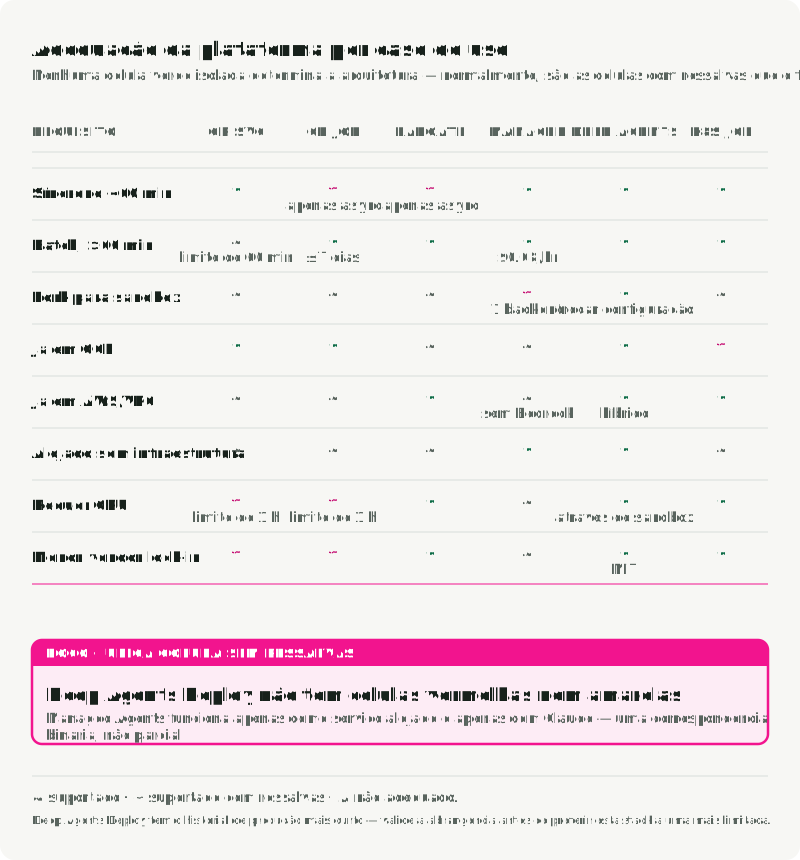
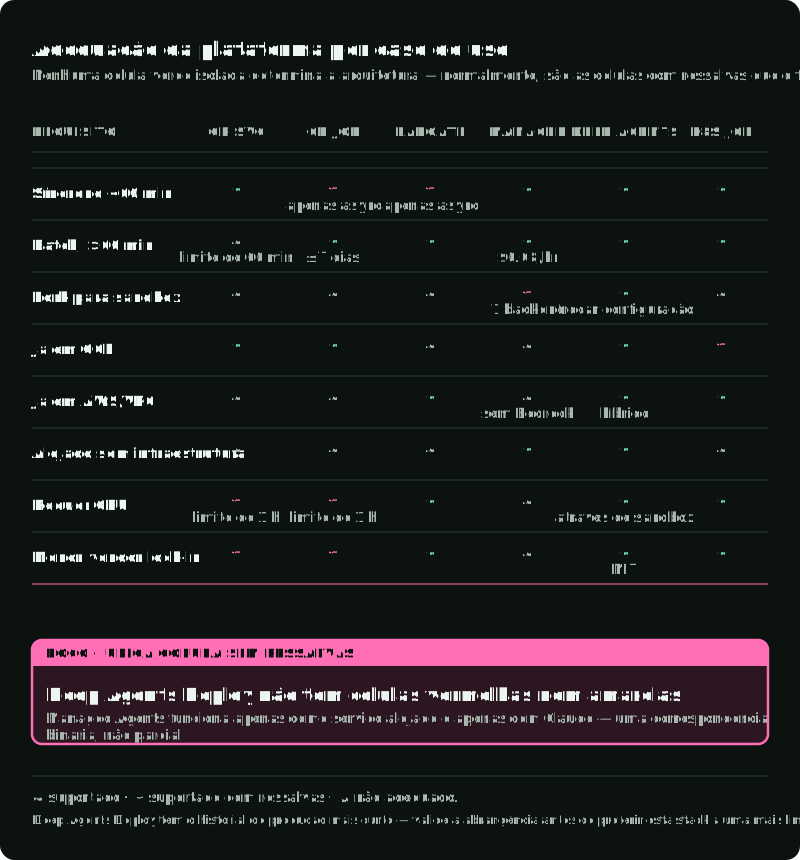
Na matriz, são normalmente as células com ressalva que decidem a escolha, não as marcas de visto. Uma cobertura ampla não mostra a residência dos dados, a semântica de replay, a dependência do fornecedor nem o custo de mover o estado mais tarde.
Harness alojado ou próprio. Alojado significa que o fornecedor executa o loop e o utilizador chama uma API; próprio significa que é o utilizador a executar o loop, mesmo que o código venha de um fornecedor. A LangChain está dos dois lados: o LangGraph é uma biblioteca que executa por si próprio, e o Deep Agents Deploy executa um harness por si no modo cloud. Escolha o alojado quando o suporte de modelos, a fronteira dos dados, o comportamento de recuperação e os pontos de extensão já se adequam. Escolha o próprio quando espera que esses requisitos mudem, e teste o caminho de saída antes de os dados de produção dependerem dele.
Sandbox alojado ou ambiente de execução próprio. Escolha um sandbox alojado quando o seu isolamento, a pausa e retoma ou o comportamento de fork correspondem ao modelo de ameaças e ao orçamento de arranque. Docker ou Fargate podem servir para trabalho interno confiável que precisa de acesso à VPC ou de residência estrita dos dados, mas um container normal não chega para código hostil; a Parte 4 trata das opções de isolamento.
Colocar a fronteira de estado numa aplicação LangGraph
O excerto seguinte mostra apenas a parte do estado do grafo na forma de queue e worker. Assume que builder é um StateGraph existente, run_id é o identificador durável da execução e task é o novo pedido. O worker tem uma ligação PostgreSQL em DATABASE_URL e permissão para criar as tabelas do checkpointer. É uma ligação ilustrativa, não um worker de publicação completo.
import os

from langgraph.checkpoint.postgres import PostgresSaver

with PostgresSaver.from_conn_string(os.environ["DATABASE_URL"]) as checkpointer:
    checkpointer.setup()  # once during setup or migration
    graph = builder.compile(checkpointer=checkpointer)
    graph.invoke(
        {"messages": [{"role": "user", "content": task}]},
        {"configurable": {"thread_id": run_id}},
        durability="sync",
    )
O thread_id é a chave de consulta de checkpoints do LangGraph, não um ID de operação nem prova de que a publicação aconteceu. A aplicação continua a ter de persistir a linha da execução, o artefacto aprovado, a operação pendente e o resultado. Também tem de recuperar jobs interrompidos e decidir o que significa uma nova entrada enquanto uma execução está ativa. Não retome um nó de publicação incerto limitando-se a invocá-lo de novo. Reconcilie primeiro e depois entregue o resultado recuperado ao grafo.
Git, a base de dados de checkpoints e o object storage
As execuções longas usam normalmente três stores ao mesmo tempo, porque cada um guarda um artefacto diferente.
- O Git guarda o workspace: código, documentos e ficheiros de progresso. Use-o quando o trabalho tem a forma de código ou quando o histórico dos ficheiros importa. Crie um branch da execução, faça um commit inicial e faça commit após a preparação, após cada funcionalidade e depois de os testes passarem. Guarde o SHA do último commit ao lado do checkpoint. Na retoma, o worker seguinte faz checkout do branch, lê
git log --oneline -8, inspecionagit statuse o último diff e depois lê o ficheiro de handoff. O Git não consegue dizer que nó do grafo corre a seguir, que chamada espera por aprovação ou que nova tentativa usou a sua chave de idempotência. Dispense-o quando o produto é uma única resposta. - A base de dados de checkpoints guarda o estado do grafo: o que foi decidido, que nós correram e o que corre a seguir. Use checkpoints ao estilo do
PostgresSaverquando o estado intermédio entre nós importa, como entre planner, researcher, writer e verifier. - Um object store como S3 ou GCS guarda outputs grandes: PDFs, ficheiros Parquet, capturas de ecrã. Use-o quando o output é grande demais para a base de dados de checkpoints, quando os consumidores precisam de um URL sem passar pelo agente, ou quando o entregável e a execução têm retenções diferentes. Pode apagar os logs das execuções após 30 dias e manter o relatório final durante anos. Use
(thread_id, checkpoint_id, artifact_name)como chave dos objetos, para que a execução que os produziu continue rastreável.
A stack de referência em Docker Compose
O Market Analyst Agent é o projeto de aprendizagem que acompanha esta série. A partir da raiz do repositório, com Docker Compose disponível e .env preparado a partir de .env.example, make docker-up usa docker/docker-compose.yml para iniciar PostgreSQL, Qdrant, Redis e a aplicação. O comando predefinido da aplicação executa a interface Gradio, que chama o harness de forma síncrona. make worker inicia separadamente o consumidor da fila Redis; requer uv e Python 3.13+, instala as dependências do projeto e inicia as bases de dados. Configure as chaves dos fornecedores em .env antes de executar uma análise em direto. make mcp-up e make observability-up ativam os perfis opcionais de MCP e observabilidade.
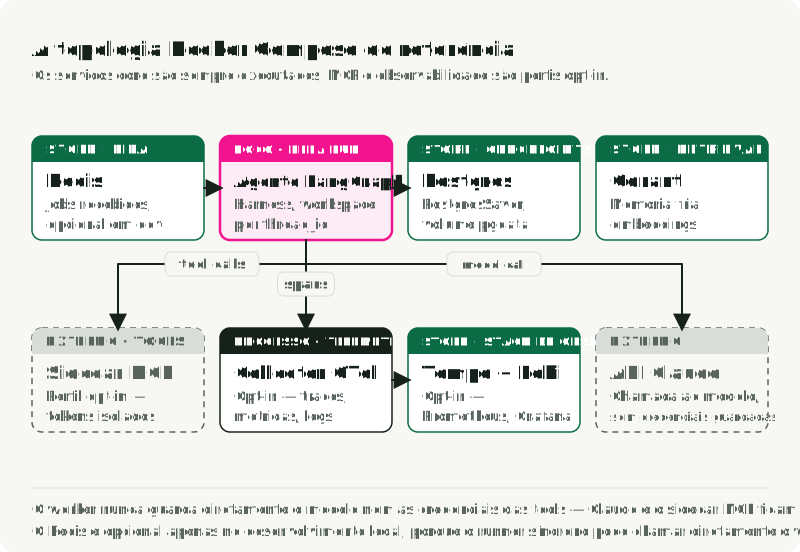
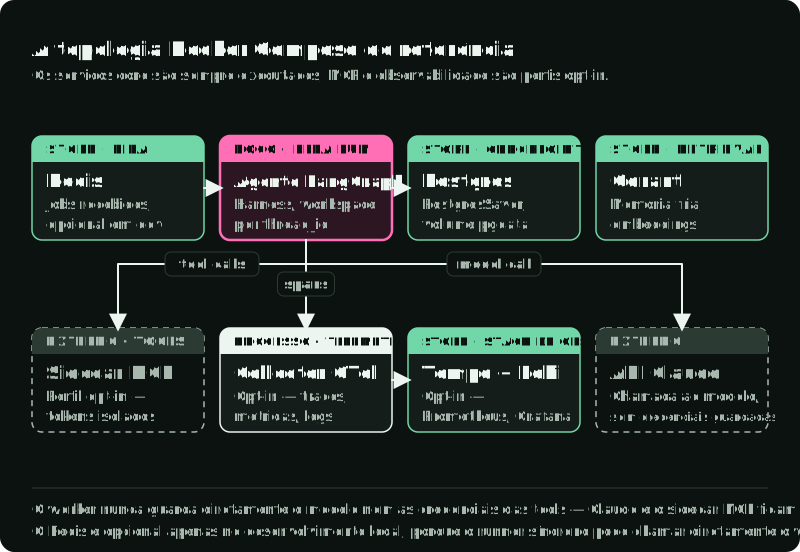
As rotas de observabilidade configuradas estão incompletas. O Collector só tem um pipeline de traces para Tempo. O seu filtro de inclusão strict compara gen_ai.operation.name com o literal .+, pelo que valores normais como chat e execute_tool não correspondem e são excluídos; o matcher do Collector 0.117.0 confirma a comparação de igualdade. O Prometheus recolhe diretamente as métricas de app:9464 e as métricas próprias do Collector; as métricas da aplicação exigem METRICS_ENABLED=true. A exportação de traces da aplicação também exige um endpoint OTLP. Loki tem um backend e uma fonte de dados Grafana, mas não tem entrada de logs configurada. Corrija o filtro de traces e acrescente a ingestão de logs antes de esperar traces e logs preenchidos; o arranque de um contentor não prova que os dashboards funcionam.
Para um contentor worker, acrescente um serviço worker explícito e dê aos processos de escrita concorrentes o mesmo volume de workspace; a aplicação Compose predefinida não é um consumidor da fila. Em produção, acrescente uma tabela de eventos para as intenções e os resultados das ferramentas ao lado dos checkpoints e teste a reconciliação para as suas próprias ações externas.
Ler a execução depois de terminar
Quando uma execução de seis horas falha, o evento que a causou pode ter acontecido horas antes, e o worker que o produziu já foi substituído. O debugging é feito a partir de registos escritos enquanto a execução estava em curso. Dois são lidos depois da execução: um event log consultável de cada passo e traces que mostram para onde foram o tempo e os tokens. Dois são lidos durante a execução: uma vista em direto das alterações ao workspace e uma stack de observabilidade por worktree que o próprio agente pode consultar.
Nenhum dos dois registos lidos depois da execução contém necessariamente o pedido tal como saiu finalmente do processo, depois da montagem das instruções, do retrieval, da compactação e de qualquer middleware. Uma entrada do event log e um span descrevem que uma chamada ao modelo ocorreu e quanto custou. Quando a pergunta é o que o modelo recebeu, é preciso uma captura própria, feita no último ponto antes de a chamada sair e guardada no sítio onde mais tarde irá procurar a resposta a essa pergunta.
Event log. Cada chamada ao modelo, tool call, resultado, erro e aprovação, com o ID da execução e o timestamp como chave, consultável como qualquer tabela. Addy Osmani formula o teste: se não consegue reconstruir, a partir de armazenamento durável, o que o agente fez nas últimas 24 horas, tem um shell script que chama um modelo, não um agente de longa duração.
Traces GenAI do OpenTelemetry. Os spans levam os atributos gen_ai.* normalizados: modelo, fornecedor, contagens de tokens, ID da conversa e nome do workflow. As convenções passaram para um repositório próprio em 2026 e continuam com estabilidade Development, por isso fixe a revisão que validou. Nos backends que as suportam, pode mudar de destino sem voltar a instrumentar o código.
Alterações ao workspace durante a execução. O quick-start da Anthropic observa o workspace. watch -n 5 'git log --oneline -8' mostra os últimos commits a cada cinco segundos, e uma pasta de capturas de ecrã ordenada por tempo mostra o que o agente viu por último. Trate ambos como sinais de atividade e compare-os com os resultados dos testes antes de concluir que a execução está a progredir.
Uma stack por worktree para o agente. No texto de harness engineering da OpenAI, cada worktree do Codex recebe os seus próprios logs, métricas e traces de curta duração, que o agente consulta enquanto trabalha. Isso transforma um requisito como “nenhum span nestes quatro percursos de utilizador excede dois segundos” em algo que o agente consegue verificar.
Uma stack auto-alojada mínima para um agente como o Market Analyst Agent:
- OpenTelemetry Collector, que recebe os spans e pode filtrar os campos
gen_ai.*antes da exportação. - Tempo ou Jaeger para os traces, com
gen_ai.conversation.idouthread_idcomo chave. - Loki para as entradas do event log.
- Prometheus para as métricas de tokens e de latência GenAI.
- Dashboards Grafana organizados por
gen_ai.agent.nameegen_ai.request.model.
Se preferir um serviço alojado, escolha um: LangSmith para LangGraph e Deep Agents Deploy, Braintrust quando as suites de avaliação vêm primeiro, Arize Phoenix para OTLP open source com OpenInference, o dashboard de tracing da OpenAI para o Agents SDK ou o tracing da Anthropic para o Managed Agents.
Defina os atributos normalizados em cada span do modelo, pelo menos a operação, o fornecedor, o modelo, o ID da conversa, o nome do agente e as contagens de tokens. Três painéis de dashboard cobrem a maior parte do debugging: tokens de output por agente por hora, latência p95 do modelo por modelo e tool calls que demoraram mais de 30 segundos.
Quando uma execução falha, faça o worker escrever um pacote de debug em /workspaces/${THREAD_ID}/_debug/:
events.jsonl: o event log exportado, com intenções, resultados, aprovações e erros.checkpoints.jsonl: o histórico do estado do grafo obtido comcheckpointer.list({"configurable": {"thread_id": ...}}), identificado como checkpoints.last_state.json:StateSnapshot.valuesdo último super-step bem-sucedido.trace.json: os spans exportados da execução, segundo a política de captura de conteúdo.tool_calls.csv:(ts, tool, input_hash, latency_ms, status, error).workspace.tar.zst: o workspace mais ogit diffface ao commit inicial.screenshots/*.png,PROGRESS.md,feature-list.jsone outros ficheiros de progresso.env.txt: tags das imagens, versão do modelo e SHA do commit do harness.
Com ele, um relatório pode dizer “a execução s_123 gastou 71 por cento dos seus tokens a repetir três comandos depois de npm install falhar” em vez de “o agente ficou bloqueado”.
Testes de pontos de falha
Uma execução sem interrupções bem-sucedida diz pouco sobre a recuperação. Para o exemplo do relatório, injete uma paragem em três pontos: antes de a operação pendente ser confirmada, depois de o serviço de publicação aceitar o pedido mas antes de o resultado ser guardado, e enquanto a execução espera pela aprovação. Reinicie com um worker novo e verifique o número de artefactos publicados, a aprovação registada e o estado final da operação. O caso do meio é o que expõe efeitos secundários duplicados.
Teste também dois workers a reclamar a mesma execução, o cancelamento enquanto uma chamada está em curso e um fornecedor que não consegue confirmar uma ação que terminou por timeout. O resultado correto deste último caso pode ser needs_human, não outro pedido. Inspecione o event log e o trace para explicar cada resultado. Um teste de recuperação só está completo quando o estado externo coincide com o estado registado da execução.
Antes de lançar um agente de longa duração, responda a estas perguntas em termos de infraestrutura:
- Que store detém os eventos e os checkpoints da execução?
- O que acontece se o worker morrer a meio de um tool call?
- Uma execução pode corromper o workspace de outra?
- Que ações exigem aprovação?
- O modelo ou o sandbox conseguem ler credenciais em bruto?
- Que tool calls podem ser repetidos com segurança?
- Onde é aplicado o limite de custo por execução?
- Que evidência determinística decide a conclusão e que critérios precisam de um revisor?
- Onde ficam os outputs finais depois de o sandbox desaparecer?
- Conseguimos explicar amanhã uma execução falhada sem a voltar a correr?
Se uma resposta for “o prompt diz ao agente para ter cuidado”, o sistema ainda é uma demonstração.
Esta é a Parte 5 de Engineering the Agentic Stack. A Parte 6, Harness Engineering for AI Agents segue o loop dentro deste runtime: como autorizar uma ação proposta, passar trabalho para um contexto novo e decidir, a partir de evidência independente, que a tarefa está concluída.
Referências
Textos de engenharia
- OpenAI, Harness engineering: leveraging Codex in an agent-first world.
- Anthropic Engineering, Effective harnesses for long-running agents.
- Anthropic Engineering, Harness design for long-running application development.
- Anthropic Engineering, Scaling Managed Agents: Decoupling the brain from the hands, 8 de abril de 2026.
- Addy Osmani, Long-running Agents.
Frameworks e SDKs
- LangGraph, Checkpointers e
langgraph-checkpoint-postgres. - LangChain, Deep Agents overview, permissions e The runtime behind production Deep Agents.
- OpenAI Agents SDK, Sessions e Sandbox guide.
- Temporal, OpenAI Agents SDK integration e agentic sandboxes.
anthropics/cwc-long-running-agents: padrões de evaluator e de ficheiros de progresso.
Plataformas e limites
- Anthropic, Claude platform pricing para as horas de sessão do Managed Agents.
- Fornecedores de sandbox: E2B, Vercel Sandbox, Daytona, Modal, Runloop.
- Google Cloud Run, service request timeout e job task timeout.
- AWS, Lambda timeout, Lambda durable functions e Bedrock AgentCore Runtime.
Observabilidade
- OpenTelemetry, Semantic conventions for generative AI, attribute registry e metrics.