Long-running AI agent runtime: sessions en checkpoints

Automatische vertaling
Dit artikel is automatisch vertaald vanuit de oorspronkelijke Engelse versie.
Met een long-running agent runtime kan een tool-using run langer bestaan dan de worker die hem startte. Dit artikel is bedoeld voor engineers die een agent verplaatsen van een request handler naar achtergrondwerk. Je leert welke state een restart moet overleven, waarom een checkpoint een externe actie niet veilig herhaalbaar kan maken, en hoe die eisen de deploymentvorm bepalen. Daarna vergelijkt het concrete opties: een queue en worker, Temporal, sandbox-providers, Cloud Run, Lambda, Fargate, Kubernetes en hosted agent-platforms, met de observability om een run te debuggen nadat hij is mislukt.
Het model stelt nog steeds de volgende actie voor. De harness in Part 6 levert context, autoriseert tools en controleert of het werk klaar is. De runtime geeft die loop durable state en een plek om uit te voeren. Part 4 behandelt de permissiebeslissing; hier volgen we een goedgekeurde actie door een crash en recovery.
State die een restart niet mag wissen
Stel dat een research agent bronnen verzamelt, een rapport opstelt, op approval wacht en het goedgekeurde bestand publiceert. De run kan minuten of dagen duren, omdat approval geen vaste aankomsttijd heeft. Een deploy kan de worker vervangen terwijl de agent schrijft, terwijl hij wacht, of net nadat de publicatieservice het bestand heeft geaccepteerd.
Het geheugen van de worker is vervangbaar. Het goedgekeurde rapport en het feit dat publicatie misschien al is gebeurd, zijn dat niet. Schrijf vóór je een framework kiest op wat een andere worker moet kunnen beantwoorden:
| Vraag na een restart | Durable record om te bewaren |
|---|---|
| Welke run is dit, en mag hij doorgaan? | Run-ID, status, deadline, budget, eigenaar of lease |
| Wat moet de agent hierna doen? | Checkpoint van de loop- of graph-state |
| Welk rapport is goedgekeurd? | Onveranderlijke artifact-versie of content-hash en de approval-beslissing |
| Is de publicatie al gebeurd? | ID van de openstaande operatie, argumenten, uitkomst en externe lookup |
| Waarom is deze run mislukt of heeft hij budget verbruikt? | Gecorreleerde events en traces |
Deze records hoeven geen vijf aparte producten te zijn. Een database kan run-rijen, checkpoints en operatie-events in aparte tabellen bewaren. Een object store kan rapportbestanden bewaren. Een trace-backend kan timings bewaren. Houd de records gescheiden, omdat elk iets anders bewijst. Anthropic’s verslag over long-running agents beschrijft hetzelfde basisprobleem vanuit het model: een nieuwe context herinnert zich het eerdere werk niet, tenzij de applicatie het durable voortgang geeft om te lezen. Het Codex-team van OpenAI rapporteert losse runs die meer dan zes uur aan één taak werken, dus dit is geen zeldzaam geval.
Noem één geaccepteerde taak een run. Die kan meerdere model sessions gebruiken wanneer contexts worden vervangen, en één conversation kan meerdere runs bevatten. Frameworks gebruiken “session” en “thread” verschillend. In LangGraph is thread_id de sleutel van de checkpoint-history; kies expliciet of zo’n thread overeenkomt met één run of meerdere runs omvat. Houd in beide gevallen een run-ID bij die de applicatie beheert, voor het operatielog. De session-backends van de OpenAI Agents SDK bevatten muteerbare conversation-history die je kunt bewerken, wissen en compacten, dus behandel zo’n backend niet als het append-only recovery-log.
De workspace is nog een stuk state. Voor een coding agent kan een commit de te herstellen bestanden identificeren; voor het rapportvoorbeeld kan een onveranderlijke object key met hash het goedgekeurde bestand identificeren. Een gepauzeerde sandbox kan een handig filesystem bewaren, maar het voortbestaan ervan mag niet de enige manier zijn om het resultaat te herstellen. Git worktrees scheiden checkouts; het zijn geen execution-sandboxes.
Vijf componenten om te plaatsen
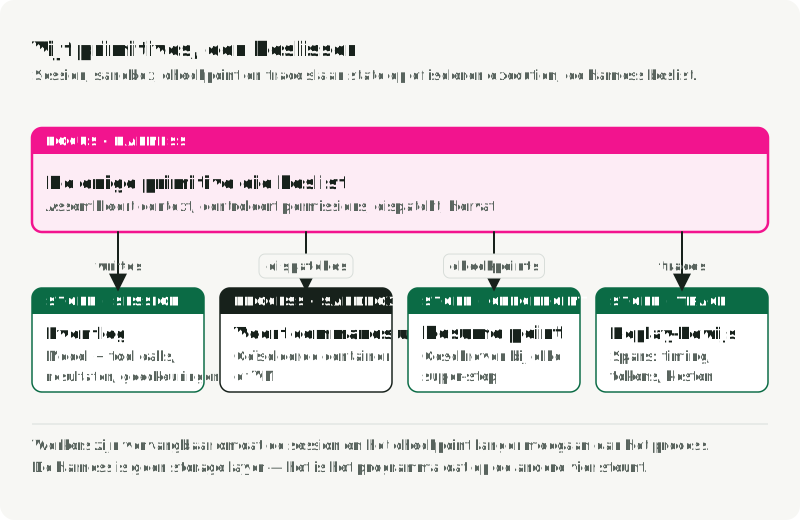
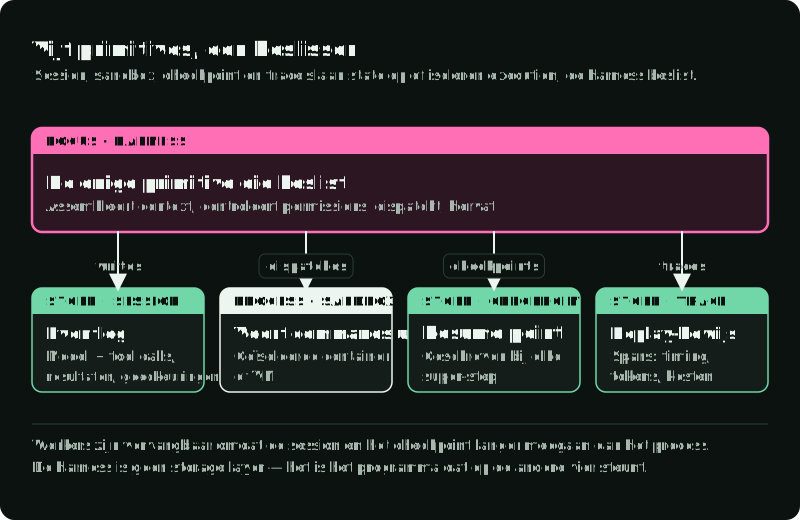
Anthropic’s artikel Scaling Managed Agents onderscheidt session, harness en sandbox. Dit artikel onderscheidt ook checkpoints en traces, en verdeelt zo vijf verantwoordelijkheden van de runtime. Een implementatie kan ze samenvoegen, maar elke verantwoordelijkheid heeft een eigenaar en een bekende uitvalgrens nodig. De figuur plaatst ze in een opzet met queue en worker en benoemt wat ertussen wordt doorgegeven.
| Component | Taak | Gebruikelijke implementatie |
|---|---|---|
| Session | Append-only log van calls, resultaten en approvals | Event-tabel in PostgreSQL, met run-ID als sleutel |
| Harness | Model- en tool-turns aansturen tot de taak klaar is | LangGraph graph, OpenAI Agents SDK runner, custom loop |
| Sandbox | Commands uitvoeren met limieten voor files, netwerk en processen | Hardened container, microVM, browser sandbox |
| Checkpoint | Hervatten zonder de hele run opnieuw af te spelen | LangGraph PostgreSQL- of Redis-saver, workflow engine state |
| Trace | Een run debuggen nadat hij is beëindigd | OpenTelemetry spans naar Tempo, Jaeger, Honeycomb, LangSmith |
De harness is de enige die beslissingen neemt; de andere vier bewaren state of beperken execution. De gecompileerde graph van LangGraph, LangChain’s Deep Agents en Claude Code zijn in deze zin harnesses. De sandbox guide van de OpenAI Agents SDK trekt dezelfde grens: approvals, tracing, handoffs en resume-state horen bij de buitenste runtime, terwijl commands, bestandswijzigingen en omgevingsisolatie bij de sandbox-session horen.
Sandboxes verschillen in hoe lang ze bestaan. Een verse, kortlevende sandbox bestaat voor één taak en betaalt elke keer de opstartkosten. Een persistente, gepauzeerde sandbox bewaart zijn filesystem en een memory snapshot tussen runs, zodat de volgende hervatting een volledige boot kan vermijden. Een snapshot- of fork-sandbox vertakt een copy-on-write image van een voorbereide parent, zodat veel taken geïnstalleerde dependencies delen zonder hun beschrijfbare state te delen.
Twee zaken lopen door alle vijf componenten heen. Permission enforcement draait vóór elke tool call. De filesystem permissions van Deep Agents gelden alleen voor de ingebouwde filesystem-tools, dus shell commands, custom tools en MCP calls hebben enforcement nodig in de sandbox policy of achter een tool proxy. Secrets mogen noch het model, noch meestal de sandbox bereiken. Anthropic’s Managed Agents kloont repositories met een token tijdens de sandbox-setup en routeert MCP calls via een proxy die OAuth-tokens bewaart, zodat de harness de credentials nooit ziet.
Controleer de plaatsing door elke component op te schrijven met wat hem implementeert. PostgreSQL kan de session en checkpoints bevatten, de worker-container draait de harness, een provider zoals Daytona, Modal of E2B levert de sandbox, en Tempo of LangSmith bewaart traces. Zoek daarna naar gekoppelde failures: twee componenten in één proces vallen samen uit, en een gedeelde credential passeert beide grenzen als hij lekt.
Een checkpoint, een event log en een extern record beantwoorden verschillende vragen
Een checkpoint zegt waar execution kan hervatten: de berichten of graph-waarden die al zijn geproduceerd, de stap die klaar is en de stap die nog moet draaien. LangGraph slaat graph-state op bij super-step-grenzen. De checkpointer kan ook geslaagde node-writes bewaren wanneer een andere node in dezelfde stap faalt. Dat is nuttige fault tolerance, maar een checkpoint van graph-waarden bewijst niet of een service buiten de graph een request heeft gecommit.
graph.get_state() geeft een StateSnapshot terug waarvan .values de laatst bekende graph-state bevat, wat nuttig is in een debug-bundel. Noch die snapshot, noch het checkpoint kan events reconstrueren die de harness nooit heeft gelogd.
Een operatie-event log zegt wat de applicatie heeft geprobeerd en wat ze te weten kwam: publish_requested, publish_pending, publish_succeeded of needs_human, allemaal gekoppeld aan één run- en operatie-ID. Het kan in dezelfde database staan als de checkpoints, zolang de applicatie de events ook echt schrijft. De checkpoint-history van een graph is niet automatisch dit log. Een chattranscript is weer iets anders: het helpt het model verder te gaan, maar hoeft niet elke approval, elk tool-argument of elk neveneffect te bevatten.
De externe service is eigenaar van het gezaghebbende resultaat van de publicatie. Die service kan een idempotency key aanbieden, een statuslookup op operatie-ID, of een query naar een object met de verwachte hash. Als geen van deze bestaat, kan de runtime uit een ontbrekende response geen succes afleiden. Een trace kan laten zien dat een request is verstuurd en hoe lang het duurde, maar een span die eindigt in een timeout kan niet uitmaken of de remote service het heeft gecommit.
Het verschil wordt zichtbaar wanneer je oude state opnieuw afspeelt. LangGraph’s checkpoint replay voert stappen na het gekozen checkpoint opnieuw uit, inclusief API-requests in die stappen. Het is een feature voor debugging en control flow, geen exactly-once-garantie voor externe effecten. Dezelfde regel geldt voor een nieuwe worker die na een crash hervat.
Volg één onzekere publicatie
Het rapport is goedgekeurd en opgeslagen onder een stabiel artifact-ID. Nu vraagt de harness de runtime om het te publiceren. Ga ervan uit dat de publicatieservice het request kan voltooien, ook als de worker de response kwijtraakt.
- Leg de intentie vast. Sla, voordat het request de worker verlaat, een operatie-ID van de applicatie, de hash van het goedgekeurde artifact, de bestemming en de status
pendingop. Koppel dat ID aan die argumenten. Een tool-call-ID dat het model genereert, kan na herplanning veranderen; het is niet de identiteit van de zakelijke actie. - Verstuur de actie. Stuur hetzelfde operatie-ID naar de publicatieservice als de API idempotency ondersteunt. Zo niet, gebruik dan een stabiele object key of een andere door de provider ondersteunde manier om het resultaat op te zoeken. De worker mag niet aannemen dat een timeout betekent dat de service niets heeft gedaan.
- Leg de uitkomst vast. Sla bij een bevestigde response het externe resultaat-ID op en markeer de operatie als voltooid voordat de run verdergaat. Het volgende checkpoint kan dan naar dat resultaat verwijzen.
- Herstel het ontbrekende resultaat. Stel dat de service het rapport accepteerde, maar de worker crashte vóór stap 3. Een nieuwe worker ziet
pending. Hij vraagt de service of diezelfde operatie of dat artifact bestaat. Zo ja, dan legt hij de herstelde uitkomst vast en gaat verder zonder een tweede kopie te publiceren. Als een retry wordt ondersteund, gebruikt hij hetzelfde operatie-ID en ongewijzigde argumenten. - Stop bij onzekerheid. Als de service geen antwoord kan geven en geen idempotente retries belooft, laat de operatie dan open voor review. Een nieuwe key genereren en het request opnieuw versturen zou een nieuwe actie zijn, met risico op dubbele publicatie.
De reeks hieronder volgt de crash in stap 4, tussen het externe succes en het lokaal vastleggen van de uitkomst.
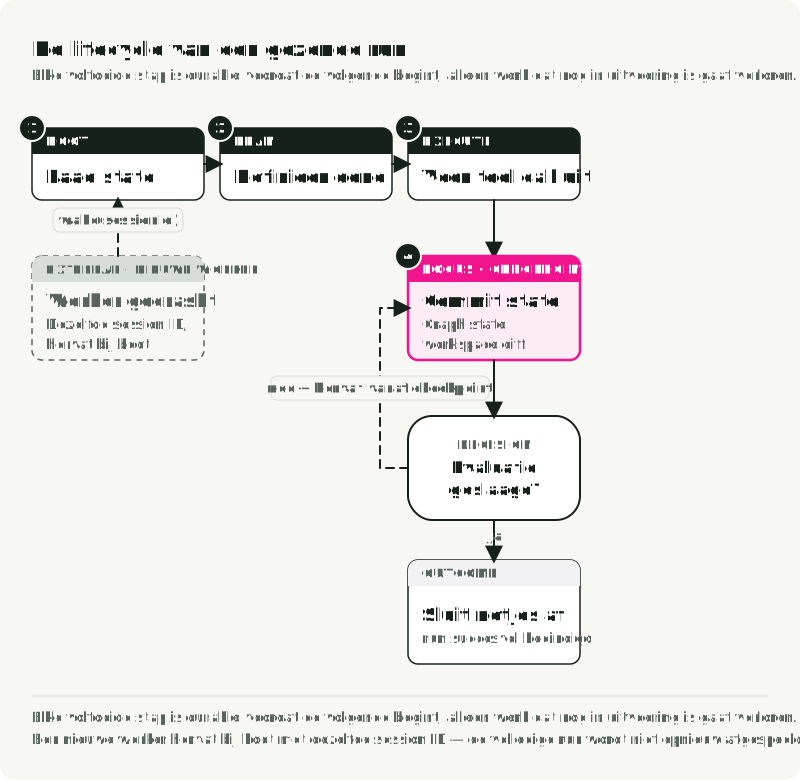
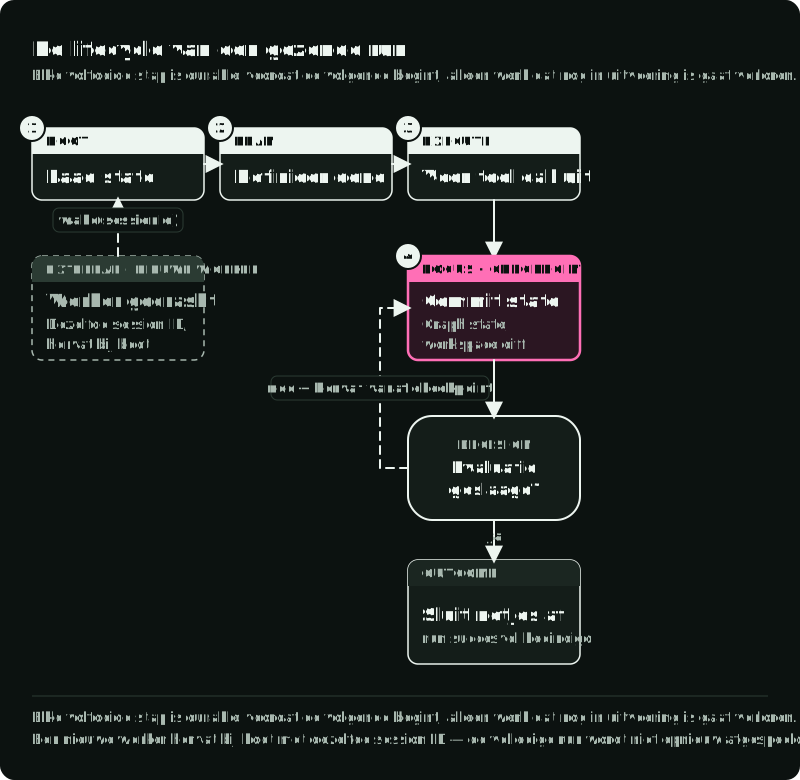
De workspace-diff in het diagram is een herstelbare bestandsversie of referentie; het graph-checkpoint hoeft de bestanden zelf niet te bevatten.
Het geval om voor te ontwerpen is een crash tussen extern succes en het lokaal opslaan van de uitkomst. Geen databasetransactie kan zonder medewerking van een niet-verwante service atomair een write naar die service committen. AWS’ uitleg over idempotente API’s legt uit waarom een request-ID dat de caller meegeeft een intentie representeert: twee identieke requests kunnen twee gewenste acties zijn, terwijl twee retries met één ID één actie moeten voorstellen. De ontvangende service moet dat contract naleven en een gewijzigde payload onder hetzelfde ID detecteren. Controleer de deduplicatieperiode; een verlopen key is geen permanente belofte. Stripe geeft bijvoorbeeld het eerste resultaat terug voor een herhaalde idempotency key en kan keys na minstens 24 uur opruimen.
Hetzelfde protocol geldt voor het versturen van een e-mail, het belasten van een account, het openen van een pull request of het wijzigen van een database van een andere service. De reconciliatiemethode verschilt. Een provider kan bijvoorbeeld idempotency keys ondersteunen, een unieke resource-constraint, een read-after-write-lookup, of helemaal geen betrouwbare query. Ontwerp het retrybeleid op basis van dat contract, niet op basis van het feit dat het agent-framework een node kan herhalen.
Maak de rest van de run herstelbaar
De onzekere externe call is het moeilijkste geval. De rest van de run heeft nog een paar expliciete regels nodig:
- Eén actieve writer. Een queue kan werk opnieuw afleveren nadat een lease verloopt. Gebruik een run-lease met fencing of conditionele statusupdates, zodat een verouderde worker de run niet kan laten doorlopen. Behoud idempotency-bescherming voor calls die al onderweg zijn. Bevestig een job pas wanneer de state die hij vertegenwoordigt durable is. Recovery begint met het inspecteren van openstaande operaties, niet met blind herstarten van het model. Bepaal wat nieuwe gebruikersinput tijdens een run betekent: weigeren, in de wachtrij zetten, onderbreken of terugdraaien; LangChain’s verslag over de Deep Agents runtime beschrijft deze keuzes.
- Een durable wachtmoment. Als publicatie approval vereist, sla dan de voorgestelde actie met de exacte argumenten durable op. Hervat met de approval-beslissing en controleer die opnieuw als de voorgestelde actie verandert. Houd geen workerproces open alleen om op een persoon te wachten.
- Een begrensde run. Sla de deadline, de limieten voor calls of tools en het bestedingsbudget durable op. Reserveer budget vóór parallelle dispatch, zodat twee calls niet allebei hetzelfde restant kunnen uitgeven; reconcilieer het werkelijke gebruik achteraf. Annulering stopt nieuwe calls en legt het verzoek vast, maar kan een extern effect dat al onderweg is niet ongedaan maken. Een metrics-alert of een budget aan providerzijde, zoals Anthropic’s bèta-task budgets, is een tweede signaal; het model kan een adviserend budget overschrijden, dus houd het dispatch-grootboek hoe dan ook bij.
- Herstelbaar werk. Bewaar een referentie naar het goedgekeurde artifact, de hash ervan en de workspace-versie die het produceerde. Een hersteld proces moet het bestand kunnen valideren vóór publicatie. Grote bestanden horen in een artifact store, niet in elk graph-checkpoint.
- Een execution boundary. Als een tool gegenereerde code uitvoert, packages installeert of untrusted pagina’s bezoekt, voer hem dan uit in een omgeving met de vereiste beperkingen voor files, netwerk en processen. Houd langlevende credentials buiten de context die het model ziet; dwing permissions af waar de actie wordt uitgevoerd. Een container of een checkout per worktree alleen biedt niet de isolatie die je threat model mogelijk vereist.
Kies bij LangGraph bewust de durability van checkpoints. De "sync"-modus slaat elk checkpoint durable op voordat de volgende stap begint; "async" kan bij een procescrash een recent checkpoint verliezen, en "exit" slaat geen tussentijdse voortgang op tegen een crash halverwege de run. Zelfs "sync" dicht het hierboven beschreven gat rond externe effecten niet. Het event log en de reconciliatielogica blijven werk voor de applicatie.
Failures die lange runs toevoegen
Naarmate runs over workers en context windows heen lopen, verschuiven failures naar state, dubbele neveneffecten, afwijkende workspaces en kosten. Elk ervan heeft een controle buiten het geheugen van het model nodig, zodat die na een restart nog werkt. De figuur plaatst elke controle bij de stap van de runloop waar die draait; de tabel voegt toe waar ze wordt geïmplementeerd.
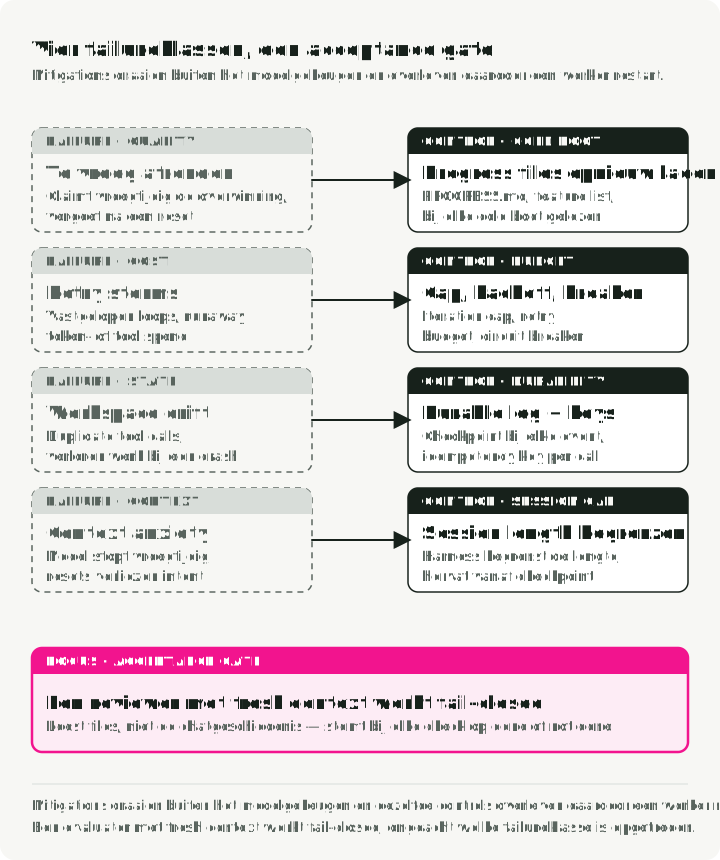
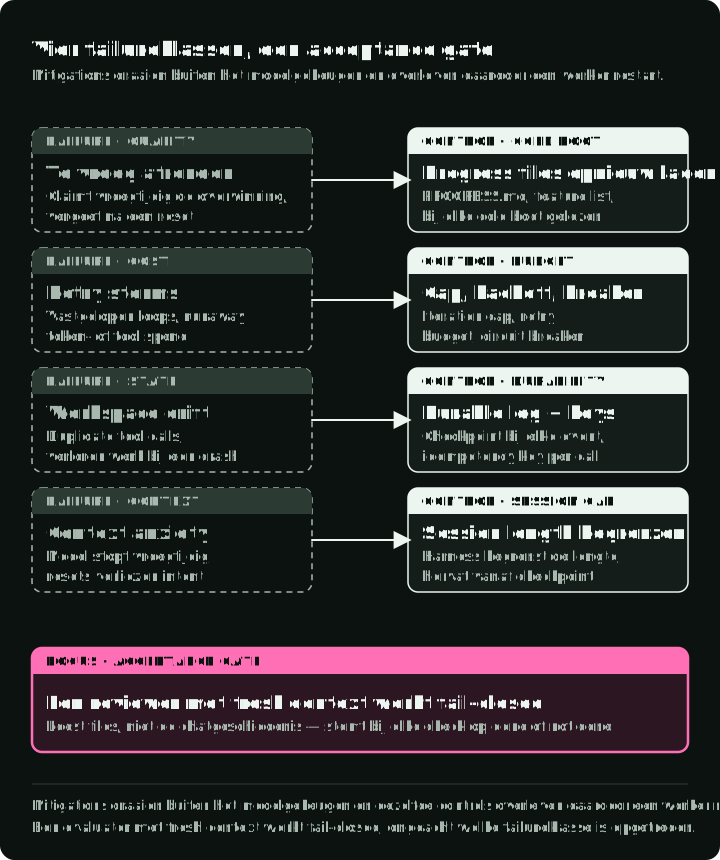
| Failure | Controle | Waar die draait |
|---|---|---|
| Agent verklaart de taak te vroeg klaar | Acceptance checks op artifacts; optionele evaluator met verse context zonder write-tools | Completion-stap van de harness; evaluator in een eigen sandbox-session |
| Agent vergeet voltooid werk na een context reset | Voortgangsbestanden zoals PROGRESS.md en feature-list.json, gelezen vóór de eerste model call | Boot hook van elke model session |
| Model vat samen en stopt te vroeg bij zijn limiet | Begrens de session en start een nieuwe vanaf de handoff en het checkpoint | Limiet op de lengte van harness-sessions |
| Vastgelopen loops en onbegrensde retries | Iteratielimiet, exponential backoff, circuit breaker op het tool-foutpercentage, harde limiet op tool calls | Tool-execution-node; RetryPolicy op Temporal Activities |
| Agent bewerkt bestanden van een andere run | Workspace per run, Git-commits als herstelpunten, file policy in sandbox of tool proxy | Sandbox policy; Deep Agents permissions voor de ingebouwde file tools |
| Uitgaven aan tokens of tools lopen uit de hand | Reserveer budget vóór dispatch, begrens output, reconcilieer gebruik | Budget-grootboek in het dispatch-pad; Prometheus-alerts als tweede signaal |
| Een tool call draait twee keer na een crash | Sla pending en een idempotency key op vóór dispatch; query of retry met dezelfde key bij hervatten | Event store plus de idempotency- of lookup-API van de provider |
| Werk gaat verloren als een worker of sandbox uitvalt | Durable event log, checkpoint na elke super-step, openstaande effecten reconciliëren voordat je verdergaat | PostgresSaver plus een event-tabel, of een Temporal Workflow |
Anthropic’s quick-start cwc-long-running-agents bevat de patronen voor de evaluator en de voortgangsbestanden. Vroegtijdig stoppen bij de contextlimiet is modelspecifiek, dus test elke workaround opnieuw wanneer het model verandert. Zoals Anthropic het zegt, codeert elk harness-component een aanname over wat het model niet kan, en die aanname kan verouderen wanneer het model verandert.
Transportfailures die de loop moet opvangen
Een stream kan midden in een antwoord sluiten. De verbinding kan wegvallen nadat een half antwoord, of een halve tool call, is binnengekomen. Tool-argumenten komen binnen als JSON-fragmenten die pas te parsen zijn als het blok compleet is, dus een half samengestelde call mag nooit de dispatch bereiken; een afgekapt commando uitvoeren is precies wat de permissielaag moet voorkomen. Behandel een afgebroken stream als een mislukte request: gooi het fragment weg, voeg het nooit toe als iets wat het model zei, en probeer de hele call opnieuw. Dat is betaalbaar omdat de prefix die je al hebt verstuurd bij de retry een cache read is. Houd de retry onder de agent loop, in de call wrapper, zodat een opnieuw geprobeerde request nooit een tool opnieuw uitvoert die al gedraaid heeft.
Streaming wordt ook niet meer optioneel naarmate requests groeien. Providers leggen timeouts op aan requests zonder streaming en eisen streaming boven bepaalde outputgroottes, en SDK’s kunnen bij lange calls onder de motorkap streamen. Een productieruntime streamt daarom doorgaans alles en verzamelt het resultaat, ook als geen enkele interface de fragmenten wil. Binnenkomende tokens fungeren dan ook als liveness-signaal: zolang ze blijven binnenkomen, leeft de call, dus een stream die een minuut stil is, wijst erop dat de call is vastgelopen. Een request zonder streaming vertelt je niets totdat hij terugkomt.
Rate limits worden in tokens gemeten, niet in requests. Providers meten input- en outputtokens per minuut, dus een agent met een grote request put een limiet uit bij een requestsnelheid die triviaal laag lijkt. Contextgroei verschijnt daarom als 429’s en niet als latencyprobleem, en parallelle fan-out vermenigvuldigt de druk met de grootte van elke request in plaats van met het aantal workers. Zet een concurrency cap en deel één tokenbudget in de component die parallel werk start; backoff binnen elke worker spreidt dezelfde vraag alleen uit. Tel de 429’s en het gebruikte endpoint per run, zodat een providerlimiet niet wordt aangezien voor een eigenschap van de geteste configuratie.
De runtime heeft ook bewijs nodig om een run te diagnosticeren. Stuur een run-ID en operatie-ID mee met model- en tool-spans, status, duur en tokengebruik. De GenAI-conventies van OpenTelemetry geven deze velden gemeenschappelijke namen, al zijn de conventies nog in ontwikkeling. Prompttekst, tool-argumenten en resultaten kunnen gevoelige data bevatten; bepaal of ze in telemetry horen voordat je ze vastlegt. Een trace helpt een failure te verklaren. Het event log en de externe lookup bepalen of doorgaan veilig is. De observability-sectie hieronder maakt hier een stack van.
Kies de deploymentvorm op basis van de wacht- en failureregels
De platformnaam is een late keuze. Vraag eerst of de caller het eindresultaat in hetzelfde request nodig heeft, of de run mag wachten, en wie de durable state gaat beheren.
| Behoefte | Startvorm | Wat nog nodig is |
|---|---|---|
| Korte taak binnen één request | Agent loop in de request handler | Een aparte execution boundary voor untrusted tools; durable state als retry of voortzetting ertoe doet |
| Achtergrondwerk dat langer kan duren dan één worker | Queue, vervangbare worker, durable state | Run-leases, checkpoints, operatielog, artifact store waar nodig |
| Veel approvals, timers, callbacks of retries over deploys heen | Durable workflow engine met workers voor model- en tool calls | Replay-veilige workflow-wijzigingen en idempotente externe activities |
Runlengte is een nuttig eerste filter, al bepaalt die niet het hele ontwerp. De figuur zet elke startvorm op een logaritmische schaal van runlengte, boven de tijdslimieten van gangbare platforms:
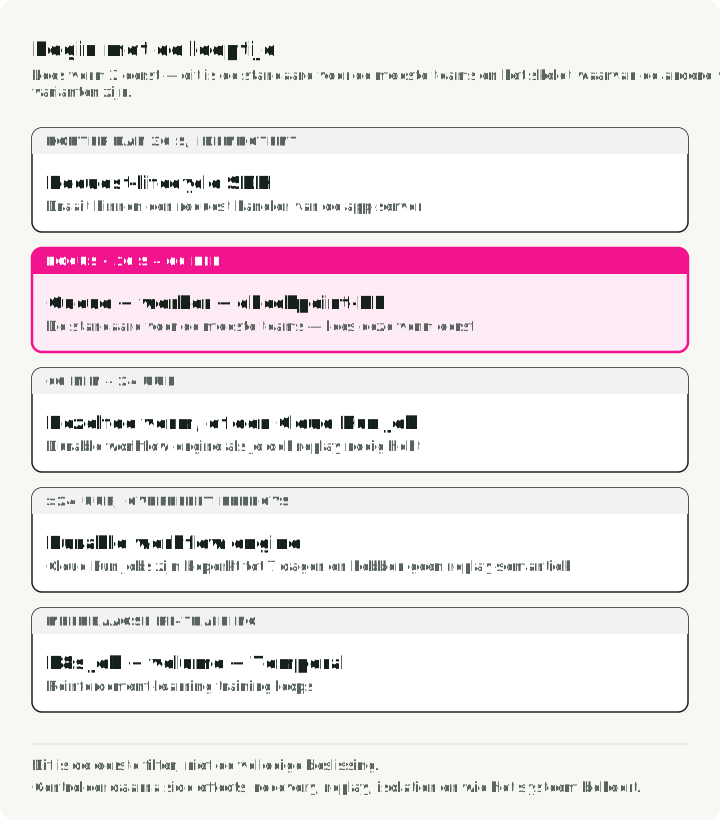
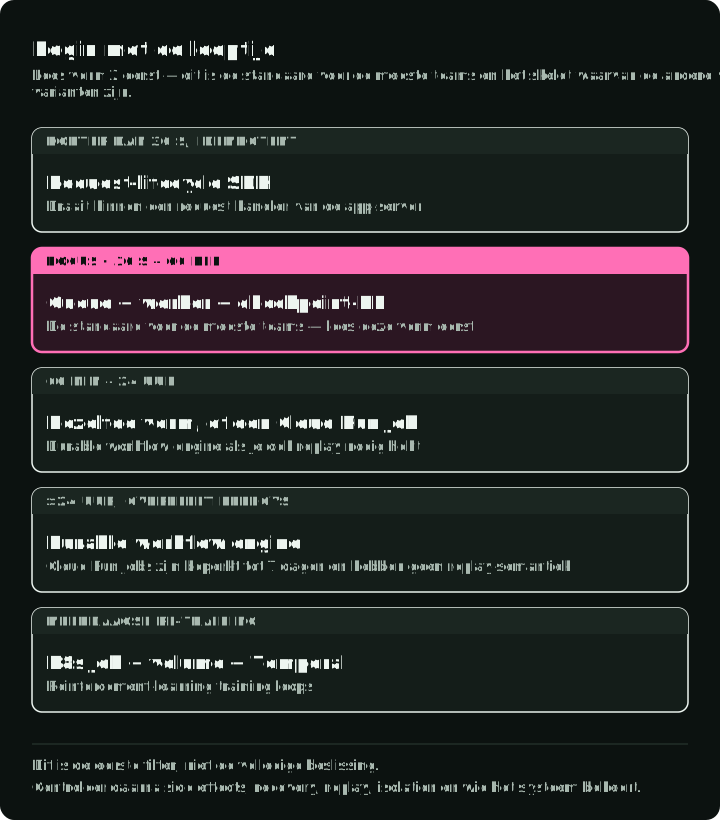
- Onder 30 seconden, idempotent: de agent SDK in een request handler van een app-server.
- 30 seconden tot 60 minuten: queue, worker en checkpoint-database.
- 60 minuten tot 24 uur: dezelfde queue en worker, of een Cloud Run Job voor eenmalig werk; een workflow engine als je ook versioning en replay nodig hebt.
- Meer dan 24 uur, over deploys heen: een durable workflow engine zoals Temporal.
- Meerdaagse training loops voor reinforcement learning: een Kubernetes Job met een volume, plus Temporal.
Controleer na dat filter neveneffecten, recovery, replay, isolatie, datalocatie en het team dat het systeem gaat beheren.
Ik zou het rapportvoorbeeld starten met een queue en worker. De API geeft een run-ID terug; de worker laat de harness doorlopen; een durable store legt checkpoints en openstaande operaties vast; een artifact store bewaart het rapport. Dat ontwerp dekt de specifieke eisen voor restarts en approvals zonder een bepaalde cloud aan te nemen. Als de wacht- en retryregels een eigen workflow worden, kan Temporal de execution-history durable opslaan en workflow-beslissingen opnieuw afspelen. De Activities voeren nog steeds externe calls uit en kunnen opnieuw worden geprobeerd, dus ze hebben hetzelfde ontwerp voor idempotency of reconciliatie nodig.
Cloudservices implementeren deze vormen; hun timeouts definiëren de architectuur niet. Een request aan een Cloud Run-service heeft een deadline en kan doorgaan met verwerken nadat de verbinding is gesloten, dus een HTTP-timeout is bijzonder zwak bewijs dat een actie is gestopt. Een Cloud Run Job, een ECS-task of een Kubernetes Job kan een achtergrondworker hosten, maar een lange tasklimiet alleen geeft die geen durable voortgang. Een gewone AWS Lambda-invocation heeft een limiet van 15 minuten; een workflow kan meerdere begrensde invocations omvatten. Controleer vóór deployment de actuele limieten en het retrygedrag van de gekozen service.
Een hosted agent-platform kan de loop en een deel van de state voor je beheren. Beoordeel het met dezelfde failure-oefening: hoe exporteer je run-state, vind je een openstaand neveneffect, koppel je approval aan een actie, inspecteer je data die naar het control plane gaat, en hervat je na een deployment? Houd het sandbox-contract van het platform gescheiden van het harness-contract. Het hosten van de harness maakt de tools niet automatisch veilig, en het hosten van de sandbox maakt de run niet automatisch durable.
Wat elke vorm je geeft
De matrix noemt de component die elke verantwoordelijkheid levert, markeert de cellen die een gehoste provider beheert en licht de cellen uit die op zichzelf niet genoeg zijn. De notities erna geven de limieten die tussen de vormen beslissen, gecontroleerd in september 2026.
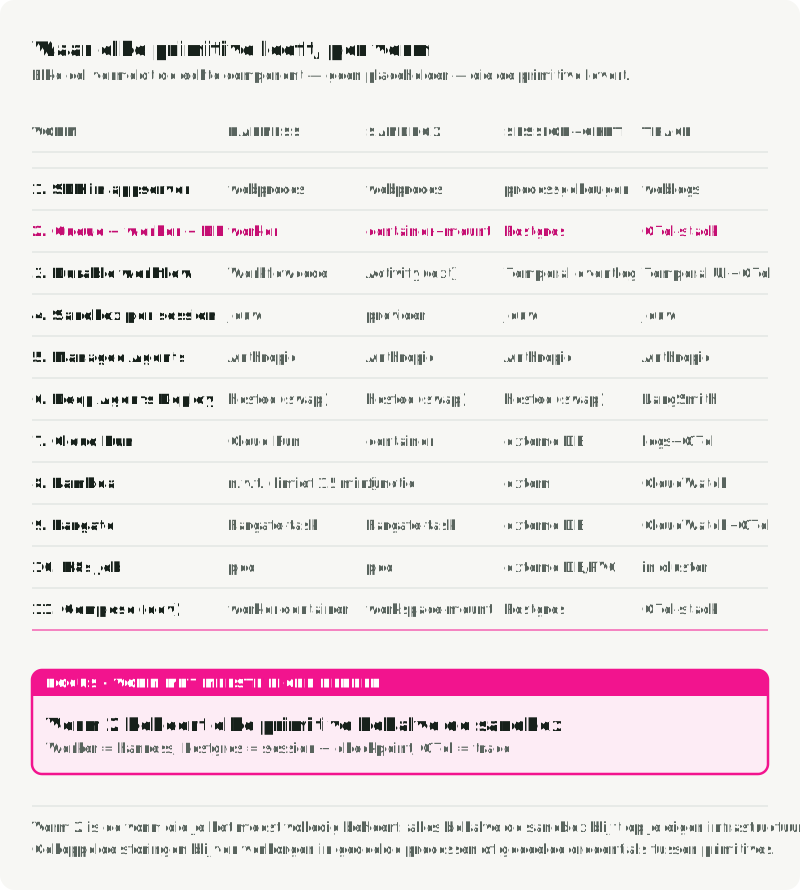
1. SDK in een app-server. De agent draait in een request handler. Dit past bij taken onder ongeveer 30 seconden, demo’s en interne tools. Een crash van de web-tier verliest het werk in het procesgeheugen. Een disconnect van de client kan het werk annuleren of laten doorgaan, afhankelijk van de server en applicatie; het bewijst de uitkomst van een externe actie niet. Sla state duurzaam op als voortzetting nodig is en gebruik geen request handler voor werk van meerdere uren.
2. Queue, worker en checkpoint-database. De standaard die ik voor de meeste teams aanraad: een Python-worker met een PostgreSQL checkpointer en Redis Streams of RabbitMQ voor inkomende jobs. De Market Analyst Agent demonstreert deze vorm met een afzonderlijk gestarte queue-worker. In het productieontwerp maakt de app een run-rij aan, zet een job in de queue en geeft het run-ID terug; de worker draait de harness, schrijft events en checkpoints, en slaat artifacts op. De queuediepte geeft backpressure, en spot- of preemptible compute werkt als duurzame writes klaar zijn voordat de worker de job bevestigt. De worker is de harness; untrusted code heeft nog steeds een hardened sandbox nodig.
3. Durable workflow engine. De agent-orchestration draait in een Temporal Workflow, en model- en tool calls draaien als Activities. De workflow-state leeft in een event history op Cassandra, MySQL of PostgreSQL, zodat die na failures opnieuw wordt afgespeeld, en een inactieve workflow gebruikt geen compute. Een menselijke approval wordt een durable wachtmoment in plaats van een polling loop. Codewijzigingen die een lopende execution overlappen, hebben replay-veilige Worker Versioning of patches nodig. Temporal’s integratie met de OpenAI Agents SDK draait agent-tools als Activities; controleer de lijst met niet-ondersteunde agent-features voordat je erop vertrouwt.
4. Een sandbox-provider per run. Elke run krijgt een eigen microVM of container van een provider, terwijl de harness, session, checkpoint en trace aan jouw kant blijven, meestal in vorm 2. Gebruik het wanneer de agent untrusted code, browserautomatisering, tests of package-installaties uitvoert; de prijs is hogere kosten en afhankelijkheid van de provider.
| Provider | Isolatie | Limieten voor sessions en persistentie |
|---|---|---|
| E2B | Firecracker microVM | Doorlopende sessions van 1 uur bij Hobby, 24 uur bij Pro; pauzeren en hervatten apart |
| Vercel Sandbox | Firecracker microVM | 45 min bij Hobby, 24 uur bij Pro en Enterprise; snapshots verlopen standaard 30 dagen na laatste gebruik |
| Daytona | Sandbox geconfigureerd door de provider | Configureerbare levenscyclus voor stoppen en archiveren; forks leggen hun parent vast |
| Modal | gVisor | Standaard 5 min, maximaal 24 uur; volumes en snapshots hebben eigen regels voor persistentie |
| Runloop | microVMs, volgens de Marketplace-vermelding | Suspend en resume; disk snapshots en branches |
Opstarttijden van providers meten verschillende intervallen, dus ze vormen geen snelheidsranglijst. Modal’s container boot van ongeveer één seconde sluit bijvoorbeeld het opstarten van de applicatie uit. Meet de tijd van API-request tot het eerste geslaagde command en tot een applicatie die klaar is, op de p95 en p99 die je nodig hebt, en controleer de concurrency-limieten van het account voordat je een load test draait.
5. Anthropic Managed Agents. Een hosted session, harness, sandbox en MCP proxy met vault, in publieke bèta sinds 8 april 2026. Het rekent standaard tokentarieven plus $0.08 per session-uur terwijl een session draait; inactieve tijd is gratis, en sessions hebben geen batch-modus. Een session die continu draait, kost ongeveer $58 per maand exclusief tokens. Het is niet beschikbaar via Bedrock of Vertex AI. Met self-hosted sandboxes beheer je zelf execution en egress, maar tool-inputs en -resultaten bereiken nog steeds het control plane van Anthropic. Later overstappen betekent een migratie naar een ander platform.
6. LangChain Deep Agents Deploy. deepagents deploy verpakt een deepagents.toml in een LangSmith Deployment met durable execution, memory, human-in-the-loop, code in een sandbox en geplande runs, in cloud-, hybride of self-hosted modus. De sandbox-provider (LangSmith Sandboxes, Daytona, Modal, Runloop of custom) is één configuratiewaarde. De harness heeft een MIT-licentie en gebruikt het open AGENTS.md-formaat, dus de lock-in is lager dan bij vorm 5.
7. Google Cloud Run. Een service verwerkt HTTP en schaalt naar nul; de request-timeout is standaard 300 seconden met een maximum van 60 minuten. Een job draait tot hij klaar is, zonder HTTP; tasks hebben standaard 10 minuten met een maximum van 168 uur (7 dagen), of 1 uur met GPUs. Gebruik een service voor synchrone runs tot 60 minuten en een job voor langer eenmalig werk. Geen van beide bewaart state tussen runs of speelt opnieuw af over deploys heen, dus sessions en checkpoints gaan naar PostgreSQL, Spanner of een vergelijkbare store.
8. AWS Lambda. Een function krijgt na 15 minuten een timeout. Achter API Gateway krijgt een synchroon request ongeveer 30 seconden, tenzij een Regional of private REST API de limiet verhoogt. Lambda durable functions, gelanceerd in december 2025, voegen checkpoints, steps en waits toe over executions die tot een jaar duren, terwijl elke invocation begrensd blijft.
9. AWS ECS of Fargate, één task per run. Fargate heeft geen gedocumenteerde runtimelimiet en geeft elke task een eigen netwerkinterface in awsvpc-modus, wat past bij datatoegang binnen de VPC. Het ondersteunt geen GPUs; gebruik daarvoor ECS op EC2. Fargate Spot voegt onderbrekingsrisico toe, en durability is jouw taak. Vergelijk ook Amazon Bedrock AgentCore Runtime, dat agent-code host met managed sessions tot 8 uur op serverless microVMs, of 14 dagen op het compute-type Instances, dat GPUs ondersteunt.
10. Kubernetes Job per run. Eén Job per run met activeDeadlineSeconds, een PersistentVolumeClaim voor de workspace en een MCP-sidecar. Het past bij teams die Kubernetes al beheren; cold starts sluiten het uit voor opstarten binnen een seconde, en crash recovery moet je zelf bouwen. Sterke isolatie hangt nog steeds af van runtime class, network policy en pod security. GPU-execution vereist GPU-nodes, drivers en een device plugin.
11. Lokale Docker Compose, alleen voor ontwikkeling. Het begeleidende project start een Gradio-app en de stores uit vorm 2, met een workspace-volume en zonder hardened sandbox. De queue-worker start afzonderlijk. De referentiestack hieronder onderscheidt deze processen.
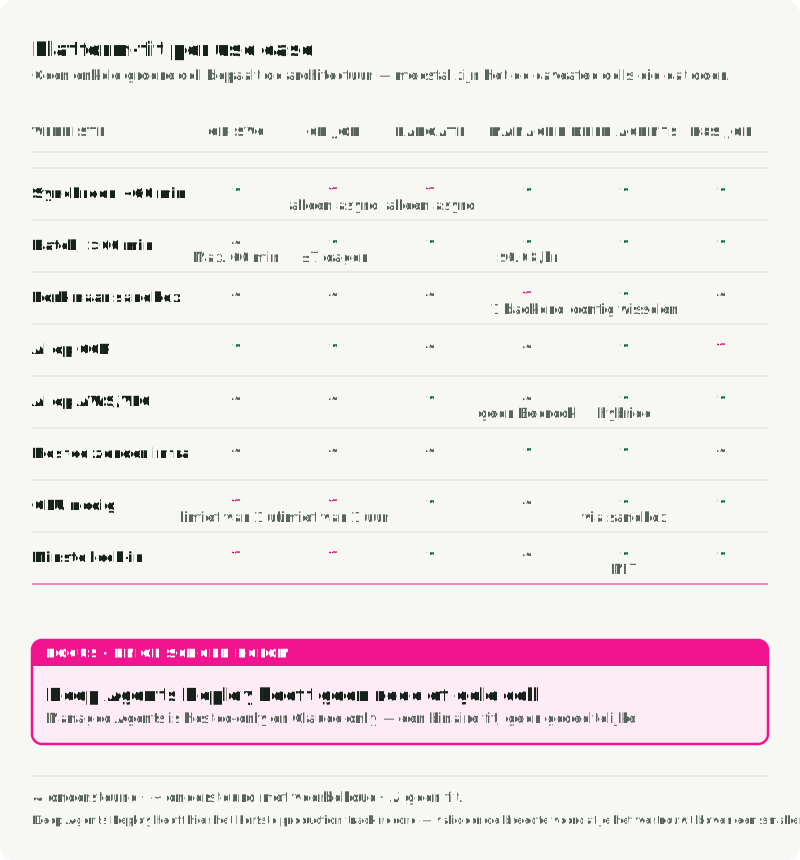
In de matrix bepalen meestal de cellen met een kanttekening de keuze, niet de vinkjes. Brede dekking laat niets zien over data residency, replay-semantiek, afhankelijkheid van de provider of de kosten om state later te verplaatsen.
Hosted of eigen harness. Hosted betekent dat de vendor de loop draait en jij een API aanroept; eigen betekent dat jij de loop draait, ook als de code van een vendor komt. LangChain staat aan beide kanten: LangGraph is een library die je zelf draait, en Deep Agents Deploy draait in de cloudmodus een harness voor je. Kies hosted wanneer de modelondersteuning, de datagrens, het recoverygedrag en de uitbreidingspunten al passen. Kies eigen wanneer je verwacht dat die eisen veranderen, en test de exit-route voordat productiedata ervan afhangt.
Hosted sandbox of je eigen execution-omgeving. Kies een hosted sandbox wanneer de isolatie, pauzeren en hervatten of het fork-gedrag passen bij het threat model en het opstartbudget. Docker of Fargate kan passen bij vertrouwd intern werk dat VPC-toegang of strikte data residency nodig heeft, maar een standaardcontainer is niet genoeg voor vijandige code; Part 4 behandelt de isolatieopties.
Breng de state-grens aan in een LangGraph-applicatie
Het volgende fragment laat alleen het graph-state-deel van de queue-en-worker-vorm zien. Het gaat ervan uit dat builder een bestaande StateGraph is, run_id de durable run-identifier en task het nieuwe request. De worker heeft een PostgreSQL-verbinding in DATABASE_URL en toestemming om checkpointer-tabellen aan te maken. Dit is illustratieve bedrading, geen complete publicatieworker.
import os

from langgraph.checkpoint.postgres import PostgresSaver

with PostgresSaver.from_conn_string(os.environ["DATABASE_URL"]) as checkpointer:
    checkpointer.setup()  # once during setup or migration
    graph = builder.compile(checkpointer=checkpointer)
    graph.invoke(
        {"messages": [{"role": "user", "content": task}]},
        {"configurable": {"thread_id": run_id}},
        durability="sync",
    )
De thread_id is de checkpoint-lookup-key van LangGraph, geen operatie-ID en geen bewijs dat publicatie heeft plaatsgevonden. De applicatie moet nog steeds de run-rij, het goedgekeurde artifact, de openstaande operatie en de uitkomst durable opslaan. Ze moet ook onderbroken jobs terugclaimen en bepalen wat nieuwe input betekent terwijl een run actief is. Hervat een onzekere publish-node niet door hem gewoon opnieuw aan te roepen. Reconcilieer eerst en geef dan het herstelde resultaat aan de graph.
Git, de checkpoint-database en object storage
Lange runs gebruiken meestal drie stores tegelijk, omdat elk een ander artifact bewaart.
- Git bewaart de workspace: code, documenten en voortgangsbestanden. Gebruik het wanneer het werk code-achtig is of de bestandshistorie ertoe doet. Maak een run-branch aan, maak een initializer-commit en commit na de setup, na elke feature en nadat tests slagen. Sla de laatste commit-SHA op naast het checkpoint. Bij hervatten checkt de volgende worker de branch uit, leest
git log --oneline -8, inspecteertgit statusen de laatste diff, en leest dan het handoff-bestand. Git kan niet zeggen welke graph-node hierna draait, welke call op approval wacht of welke retry zijn idempotency key heeft gebruikt. Sla het over wanneer het product één antwoord is. - De checkpoint-database bewaart graph-state: wat is besloten, welke nodes hebben gedraaid en wat hierna draait. Gebruik checkpointing in de stijl van
PostgresSaverwanneer tussentijdse state tussen nodes ertoe doet, zoals bij planner, researcher, writer en verifier. - Een object store zoals S3 of GCS bewaart grote outputs: pdf’s, Parquet-bestanden, screenshots. Gebruik het wanneer de output te groot is voor de checkpoint-database, wanneer consumers een URL nodig hebben zonder via de agent te gaan, of wanneer het eindproduct en de run een verschillende bewaartermijn hebben. Je kunt run-logs na 30 dagen verwijderen en het eindrapport jarenlang bewaren. Geef objects de sleutel
(thread_id, checkpoint_id, artifact_name), zodat de producerende run traceerbaar blijft.
De referentiestack in Docker Compose
De Market Analyst Agent is het leerproject bij deze serie. Vanuit de repositoryroot, met Docker Compose beschikbaar en .env voorbereid vanuit .env.example, gebruikt make docker-up docker/docker-compose.yml om PostgreSQL, Qdrant, Redis en de app te starten. Het standaardcommando van de app draait de Gradio-UI, die de harness synchroon aanroept. make worker start de consumer van de Redis-queue afzonderlijk; het vereist uv en Python 3.13+, installeert de projectdependencies en start de databases. Configureer de providerkeys in .env voordat je een live analyse draait. make mcp-up en make observability-up activeren de optionele MCP- en observability-profielen.
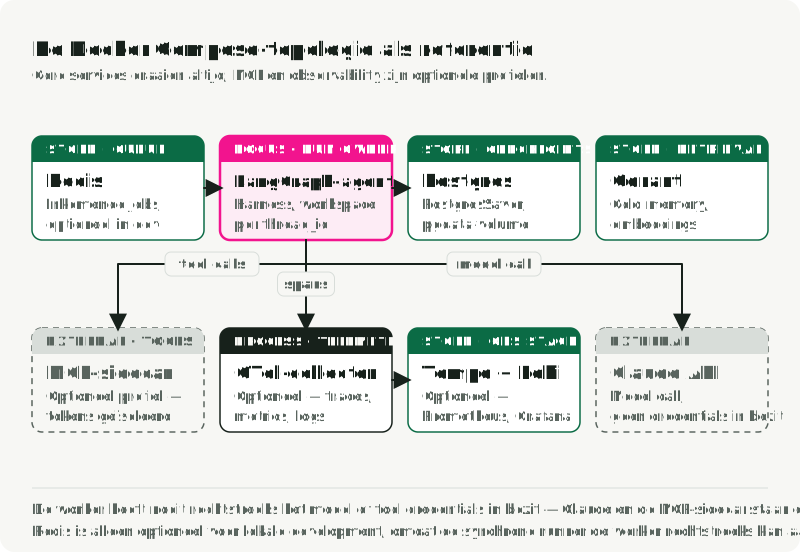
De geconfigureerde observability-routes zijn onvolledig. De Collector heeft alleen een trace-pipeline naar Tempo. Het include-filter met strict vergelijkt gen_ai.operation.name met de letterlijke waarde .+, waardoor gewone waarden zoals chat en execute_tool niet overeenkomen en worden uitgesloten; de matcher van Collector 0.117.0 bevestigt de gelijkheidsvergelijking. Prometheus verzamelt rechtstreeks de metrics van app:9464 en de eigen metrics van de Collector; app-metrics vereisen METRICS_ENABLED=true. Trace-export van de app vereist ook een OTLP-endpoint. Loki heeft een backend en een Grafana-datasource, maar geen geconfigureerde invoer van logs. Corrigeer het trace-filter en voeg invoer van logs toe voordat je gevulde traces en logs verwacht; een gestarte container bewijst niet dat de dashboards werken.
Voeg voor een worker-container een expliciete worker-service toe en geef gelijktijdige schrijvers hetzelfde workspace-volume; de standaard Compose-app is geen queue-consumer. Voeg in productie naast de checkpoints een event-tabel voor tool-intenties en -uitkomsten toe en test reconciliatie voor je eigen externe acties.
Lees de run nadat hij is beëindigd
Wanneer een run van zes uur faalt, kan het event dat de oorzaak was uren eerder hebben plaatsgevonden, en is de worker die het produceerde al vervangen. Je debugt vanuit records die zijn geschreven terwijl de run liep. Twee daarvan lees je na de run: een doorzoekbaar event log van elke stap, en traces van waar tijd en tokens naartoe gingen. Twee lees je tijdens de run: een live overzicht van workspace-wijzigingen, en een observability-stack per worktree die de agent zelf kan bevragen.
De twee records die na de run worden gelezen bevatten niet per se de request zoals die het proces uiteindelijk verliet, na het samenstellen van de instructies, retrieval, compaction en eventuele middleware. Een regel in het event log en een span beschrijven dát er een model call plaatsvond en wat die kostte. Als de vraag is wat het model heeft ontvangen, is daarvoor een eigen capture nodig, gemaakt op het laatste punt voordat de call vertrekt en opgeslagen op de plek waar je later gaat kijken om die vraag te beantwoorden.
Event log. Elke model call, tool call, elk resultaat, elke error en elke approval, met run-ID en timestamp als sleutel, doorzoekbaar zoals elke tabel. Addy Osmani formuleert de test: als je niet vanuit durable storage kunt reconstrueren wat de agent in de laatste 24 uur deed, heb je een shellscript dat een model aanroept, geen long-running agent.
OpenTelemetry GenAI-traces. Spans dragen de standaard gen_ai.*-attributen: model, provider, tokenaantallen, conversation-ID en workflownaam. De conventies zijn in 2026 naar een eigen repository verhuisd en hebben nog steeds de stabiliteit Development, dus pin de revisie die je hebt gevalideerd. Op backends die ze ondersteunen, kun je van bestemming wisselen zonder de code opnieuw te instrumenteren.
Workspace-wijzigingen tijdens de run. Anthropic’s quick-start houdt de workspace in de gaten. watch -n 5 'git log --oneline -8' toont elke vijf seconden de laatste commits, en een op tijd gesorteerde screenshotmap laat zien wat de agent het laatst zag. Behandel beide als tekenen van activiteit en vergelijk ze met testresultaten voordat je concludeert dat de run vooruitgang boekt.
Een stack per worktree voor de agent. In OpenAI’s harness write-up krijgt elke Codex-worktree eigen kortlevende logs, metrics en traces, die de agent bevraagt terwijl hij werkt. Daardoor wordt een eis als “geen span in deze vier user journeys duurt langer dan twee seconden” iets wat de agent kan controleren.
Een minimale self-hosted stack voor een agent zoals de Market Analyst Agent:
- OpenTelemetry Collector, die spans ontvangt en
gen_ai.*-velden kan filteren vóór export. - Tempo of Jaeger voor traces, met
gen_ai.conversation.idofthread_idals sleutel. - Loki voor entries in het event log.
- Prometheus voor de GenAI-metrics voor tokens en latency.
- Grafana-dashboards op basis van
gen_ai.agent.nameengen_ai.request.model.
Als je liever een hosted service gebruikt, kies er één: LangSmith voor LangGraph en Deep Agents Deploy, Braintrust wanneer eval-suites voorop staan, Arize Phoenix voor open-source OTLP met OpenInference, het tracing-dashboard van OpenAI voor de Agents SDK, of de tracing van Anthropic voor Managed Agents.
Zet de standaardattributen op elke model-span, minimaal de operatie, provider, het model, de conversation-ID, de agentnaam en de tokenaantallen. Drie dashboardpanelen dekken het meeste debugwerk: output tokens per agent per uur, p95 model latency per model, en tool calls die langer dan 30 seconden duurden.
Laat de worker bij een mislukte run een debug-bundel schrijven naar /workspaces/${THREAD_ID}/_debug/:
events.jsonl: het geëxporteerde event log, met intenties, uitkomsten, approvals en errors.checkpoints.jsonl: graph-state-history uitcheckpointer.list({"configurable": {"thread_id": ...}}), gelabeld als checkpoints.last_state.json:StateSnapshot.valuesvan de laatste geslaagde super-step.trace.json: de geëxporteerde spans van de run, volgens het beleid voor content capture.tool_calls.csv:(ts, tool, input_hash, latency_ms, status, error).workspace.tar.zst: de workspace plusgit difften opzichte van de initializer-commit.screenshots/*.png,PROGRESS.md,feature-list.jsonen andere voortgangsbestanden.env.txt: image-tags, modelversie en commit-SHA van de harness.
Daarmee kan een rapport zeggen “run s_123 besteedde 71 procent van zijn tokens aan het herhalen van drie commands nadat npm install faalde” in plaats van “de agent liep vast”.
Crashpunttests
Een geslaagde run zonder onderbreking zegt weinig over recovery. Injecteer voor het rapportvoorbeeld een stop op drie punten: voordat de openstaande operatie is gecommit, nadat de publicatieservice het request accepteert maar voordat de uitkomst is opgeslagen, en terwijl de run op approval wacht. Herstart met een nieuwe worker en controleer het aantal gepubliceerde artifacts, de vastgelegde approval en de eindstatus van de operatie. Het middelste geval is het geval dat dubbele neveneffecten blootlegt.
Test ook twee workers die dezelfde run claimen, annulering terwijl een call onderweg is, en een provider die een actie met een timeout niet kan bevestigen. Het juiste resultaat in dat laatste geval kan needs_human zijn, geen nieuw request. Inspecteer het event log en de trace om elke uitkomst te verklaren. Een recoverytest is pas klaar wanneer de externe state overeenkomt met de vastgelegde state van de run.
Beantwoord deze vragen in infrastructuurtermen voordat een long-running agent live gaat:
- Welke store is eigenaar van run-events en checkpoints?
- Wat gebeurt er als de worker halverwege een tool call uitvalt?
- Kan één run de workspace van een andere run beschadigen?
- Welke acties vereisen approval?
- Kan het model of de sandbox ruwe credentials lezen?
- Welke tool calls kunnen veilig opnieuw worden geprobeerd?
- Waar wordt de kostenlimiet per run afgedwongen?
- Welk deterministisch bewijs bepaalt of het werk klaar is, en welke criteria hebben een reviewer nodig?
- Waar staan de eindresultaten nadat de sandbox weg is?
- Kunnen we morgen een mislukte run verklaren zonder hem opnieuw te draaien?
Als een antwoord luidt “de prompt zegt dat de agent voorzichtig moet zijn”, is het systeem nog steeds een demo.
Dit is Part 5 van Engineering the Agentic Stack. Part 6, Harness Engineering for AI Agents volgt de loop binnen deze runtime: hoe je een voorgestelde actie autoriseert, werk overdraagt aan een verse context en op basis van onafhankelijk bewijs beslist dat de taak klaar is.
Referenties
Engineering write-ups
- OpenAI, Harness engineering: leveraging Codex in an agent-first world.
- Anthropic Engineering, Effective harnesses for long-running agents.
- Anthropic Engineering, Harness design for long-running application development.
- Anthropic Engineering, Scaling Managed Agents: Decoupling the brain from the hands, 8 april 2026.
- Addy Osmani, Long-running Agents.
Frameworks en SDKs
- LangGraph, Checkpointers en
langgraph-checkpoint-postgres. - LangChain, Deep Agents overview, permissions en The runtime behind production Deep Agents.
- OpenAI Agents SDK, Sessions en Sandbox guide.
- Temporal, OpenAI Agents SDK integration en agentic sandboxes.
anthropics/cwc-long-running-agents: patronen voor de evaluator en voortgangsbestanden.
Platforms en limieten
- Anthropic, Claude platform pricing voor session-uren van Managed Agents.
- Sandbox-providers: E2B, Vercel Sandbox, Daytona, Modal, Runloop.
- Google Cloud Run, service request timeout en job task timeout.
- AWS, Lambda timeout, Lambda durable functions en Bedrock AgentCore Runtime.
Observability
- OpenTelemetry, Semantic conventions for generative AI, attribute registry en metrics.