Runtime para agentes AI de larga duración: sesiones y checkpoints

Traducción automática
Este artículo se tradujo automáticamente a partir de la versión original en inglés.
Un runtime de agentes de larga duración permite que una ejecución que usa herramientas sobreviva al worker que la inició. Este artículo está dirigido a ingenieros que trasladan un agente de un request handler a trabajo en segundo plano. Verás qué estado debe sobrevivir a un reinicio, por qué un checkpoint no puede hacer que una acción externa sea segura de reintentar y cómo esos requisitos determinan la forma de despliegue. Después, el artículo compara opciones concretas: una cola y un worker, Temporal, proveedores de sandbox, Cloud Run, Lambda, Fargate, Kubernetes y plataformas de agentes alojadas, con la observabilidad necesaria para depurar una ejecución después de que falle.
El modelo sigue proponiendo la siguiente acción. El harness de la parte 6 aporta el contexto, autoriza las herramientas y comprueba que la tarea ha terminado. El runtime da a ese loop un estado durable y un lugar donde ejecutarse. La parte 4 trata la decisión de permisos; aquí seguimos una acción aprobada a través de un fallo y su recuperación.
El estado que un reinicio no debe borrar
Supón que un agente de investigación reúne fuentes, redacta un informe, espera la aprobación y publica el archivo aprobado. La ejecución puede durar minutos o días, porque la aprobación no tiene una hora de llegada fija. Un despliegue podría sustituir su worker mientras el agente redacta, mientras espera o justo después de que el servicio de publicación acepte el archivo.
La memoria del worker es prescindible. El informe aprobado y el hecho de que la publicación quizá ya se haya producido no lo son. Antes de elegir un framework, anota lo que otro worker necesita responder:
| Pregunta después de un reinicio | Registro durable que hay que conservar |
|---|---|
| ¿Qué ejecución es esta y puede continuar? | ID de ejecución, estado, plazo, presupuesto, propietario o lease |
| ¿Qué debe hacer el agente a continuación? | Checkpoint del estado del loop o del grafo |
| ¿Qué informe se aprobó? | Versión inmutable del artefacto o hash de contenido y la decisión de aprobación |
| ¿Se ha producido ya la publicación? | ID de la operación pendiente, argumentos, resultado y resultado de la consulta externa |
| ¿Por qué falló esta ejecución o gastó su presupuesto? | Eventos y trazas correlacionados |
Estos registros no tienen por qué ser cinco productos distintos. Una base de datos puede guardar las filas de ejecución, los checkpoints y los eventos de operación en tablas separadas. Un object store puede guardar los archivos de informe. Un backend de trazas puede guardar los tiempos. Mantén los registros separados porque cada uno demuestra algo distinto. El relato de Anthropic sobre agentes de larga duración describe el mismo problema básico desde el lado del modelo: un contexto nuevo no recuerda el trabajo anterior a menos que la aplicación le dé un progreso durable que leer. El equipo de Codex de OpenAI informa de ejecuciones individuales que trabajan en una sola tarea durante más de seis horas, así que no es un caso raro.
Llama ejecución a una tarea aceptada. Puede usar varias sesiones de modelo a medida que se sustituyen los contextos, y una conversación puede contener varias ejecuciones. Los frameworks usan “session” y “thread” de formas distintas. En LangGraph, thread_id es la clave del historial de checkpoints; decide explícitamente si uno de esos threads corresponde a una ejecución o abarca varias. En cualquier caso, mantén un ID de ejecución propio de la aplicación para el log de operaciones. Los backends de sesión del OpenAI Agents SDK guardan un historial de conversación mutable que se puede editar, vaciar y compactar, así que no trates uno de ellos como el log de recuperación append-only.
El workspace es otra parte del estado. Para un agente de programación, un commit puede identificar los archivos que hay que restaurar; para el ejemplo del informe, una clave de objeto inmutable y un hash pueden identificar el archivo aprobado. Un sandbox en pausa puede conservar un sistema de archivos cómodo, pero que siga existiendo no debe ser la única forma de recuperar el resultado. Los worktrees de Git separan checkouts; no son sandboxes de ejecución.
Cinco componentes que hay que ubicar
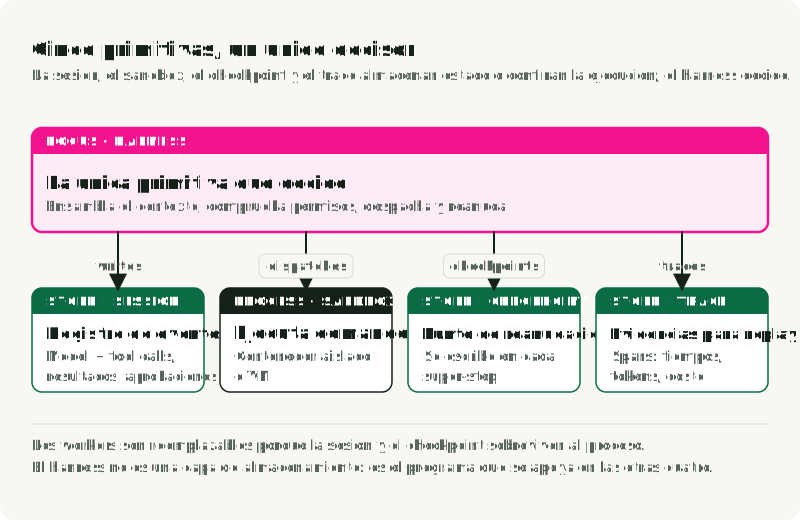
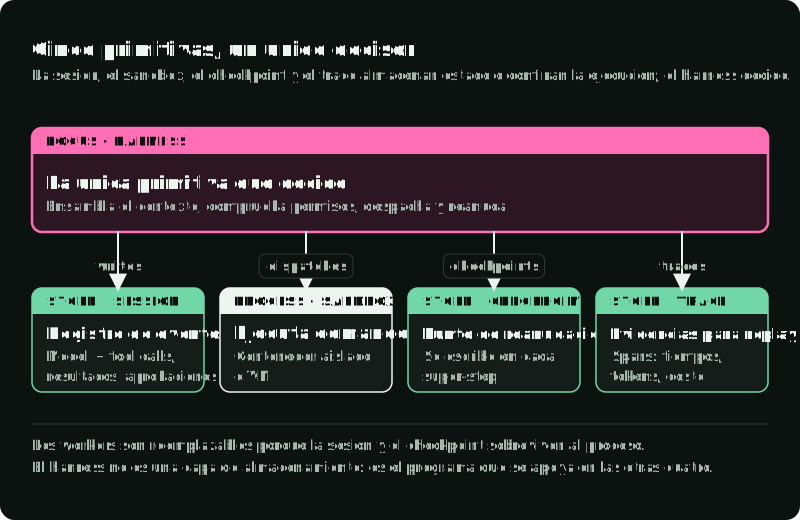
El artículo de Anthropic Scaling Managed Agents separa la sesión, el harness y el sandbox. Este artículo también separa los checkpoints y las trazas, por lo que sitúa cinco responsabilidades del runtime. Una implementación puede fusionarlas, pero cada una necesita un responsable y un límite de fallo conocido. La figura las sitúa en una configuración de cola y worker y etiqueta lo que pasa entre ellas.
| Componente | Función | Implementación habitual |
|---|---|---|
| Sesión | Log append-only de llamadas, resultados y aprobaciones | Tabla de eventos en PostgreSQL, con el ID de ejecución como clave |
| Harness | Dirigir los turnos del modelo y las herramientas hasta el final | Grafo de LangGraph, runner del OpenAI Agents SDK, loop personalizado |
| Sandbox | Ejecutar comandos con límites de archivos, red y procesos | Contenedor reforzado, microVM, sandbox de navegador |
| Checkpoint | Reanudar sin repetir toda la ejecución | Saver de PostgreSQL o Redis de LangGraph, estado del motor de workflows |
| Traza | Depurar una ejecución después de que termine | Spans de OpenTelemetry hacia Tempo, Jaeger, Honeycomb, LangSmith |
El harness es el único que toma decisiones; los otros cuatro almacenan estado o restringen la ejecución. El grafo compilado de LangGraph, los Deep Agents de LangChain y Claude Code son harnesses en este sentido. La guía de sandbox del OpenAI Agents SDK traza la misma línea: las aprobaciones, el tracing, los handoffs y el estado de reanudación pertenecen al runtime externo, mientras que los comandos, los cambios de archivos y el aislamiento del entorno pertenecen a la sesión del sandbox.
Los sandboxes se diferencian en cuánto tiempo viven. Un sandbox efímero nuevo existe para una sola tarea y paga el coste de arranque cada vez. Un sandbox persistente en pausa conserva su sistema de archivos y un snapshot de memoria entre ejecuciones, de modo que la siguiente reanudación puede evitar un arranque completo. Un sandbox de snapshot o fork ramifica una imagen copy-on-write a partir de un padre preparado, de modo que muchas tareas comparten las dependencias instaladas sin compartir su estado escribible.
Dos aspectos atraviesan los cinco componentes. La aplicación de permisos se ejecuta antes de cada tool call. Los permisos de sistema de archivos de Deep Agents solo cubren sus herramientas de archivos integradas, así que los comandos de shell, las herramientas personalizadas y las llamadas MCP necesitan que los permisos se apliquen en la política del sandbox o detrás de un proxy de herramientas. Los secretos no deben llegar ni al modelo ni, normalmente, al sandbox. Managed Agents de Anthropic clona los repositorios con un token durante la preparación del sandbox y enruta las llamadas MCP a través de un proxy que guarda los tokens OAuth, de modo que el harness nunca ve las credenciales.
Comprueba la ubicación anotando cada componente y lo que lo implementa. PostgreSQL podría guardar la sesión y los checkpoints, el contenedor worker ejecuta el harness, un proveedor como Daytona, Modal o E2B aporta el sandbox, y Tempo o LangSmith almacena las trazas. Después busca fallos acoplados: dos componentes en un mismo proceso fallan juntos, y una credencial compartida cruza ambos límites si se filtra.
Un checkpoint, un event log y un registro externo responden a preguntas distintas
Un checkpoint indica dónde puede reanudarse la ejecución: los mensajes o valores del grafo ya producidos, el paso que terminó y el paso que espera para ejecutarse. LangGraph guarda el estado del grafo en los límites de cada super-step. Su checkpointer también puede conservar las escrituras de nodos que tuvieron éxito cuando otro nodo del mismo paso falla. Es una tolerancia a fallos útil, pero un checkpoint de valores del grafo no demuestra si un servicio externo al grafo confirmó una petición.
graph.get_state() devuelve un StateSnapshot cuyo .values contiene el último estado conocido del grafo, algo útil en un debug bundle. Ni este ni el checkpoint pueden reconstruir eventos que el harness nunca registró.
Un event log de operaciones indica lo que la aplicación intentó y lo que averiguó: publish_requested, publish_pending, publish_succeeded o needs_human, todos ligados a una ejecución y a un ID de operación. Puede vivir en la misma base de datos que los checkpoints, siempre que la aplicación escriba realmente los eventos. El historial de checkpoints de un grafo no es automáticamente este log. Una transcripción de chat es otra cosa: ayuda al modelo a continuar, pero no tiene por qué contener cada aprobación, argumento de herramienta o efecto secundario.
El servicio externo es el dueño del resultado autoritativo de la publicación. Puede ofrecer una clave de idempotencia, una consulta de estado por ID de operación o una búsqueda de un objeto con el hash esperado. Si no ofrece ninguna de ellas, el runtime no puede deducir el éxito a partir de una respuesta que falta. Una traza puede mostrar que se envió una petición y cuánto tardó, pero un span que termina en timeout no puede resolver si el servicio remoto la confirmó.
La diferencia aparece cuando haces replay de un estado antiguo. El replay de checkpoints de LangGraph vuelve a ejecutar los pasos posteriores al checkpoint seleccionado, incluidas las peticiones a APIs de esos pasos. Es una función de depuración y de control de flujo, no una garantía exactly-once para los efectos externos. La misma regla se aplica a un worker nuevo que reanuda tras un fallo.
Sigue una publicación incierta
El informe está aprobado y guardado con un ID de artefacto estable. Ahora el harness pide al runtime que lo publique. Supón que el servicio de publicación podría completar la petición aunque el worker pierda la respuesta.
- Registra la intención. Antes de que la petición salga del worker, persiste un ID de operación propio de la aplicación, el hash del artefacto aprobado, el destino y el estado
pending. Vincula ese ID a esos argumentos. Un ID de tool call generado por el modelo puede cambiar tras una nueva planificación; no es la identidad de la acción de negocio. - Despacha la acción. Envía el mismo ID de operación al servicio de publicación si su API admite idempotencia. Si no la admite, usa una clave de objeto estable u otra forma, admitida por el proveedor, de consultar el resultado. El worker no debe suponer que un timeout significa que el servicio no hizo nada.
- Registra el resultado. Ante una respuesta confirmada, guarda el ID del resultado externo y marca la operación como completada antes de continuar la ejecución. El siguiente checkpoint puede entonces hacer referencia a ese resultado.
- Recupera el resultado pendiente. Supón que el servicio aceptó el informe pero el worker falló antes del paso 3. Un worker nuevo ve
pending. Pregunta al servicio si existe esa misma operación o ese artefacto. Si existe, registra el resultado recuperado y continúa sin publicar una segunda copia. Si se admite un reintento, usa el mismo ID de operación y los mismos argumentos. - Detente ante la incertidumbre. Si el servicio no puede responder y no promete reintentos idempotentes, deja la operación sin resolver para que alguien la revise. Generar una clave nueva y volver a enviar la petición sería una acción nueva, con riesgo de publicación duplicada.
La secuencia siguiente sigue el fallo del paso 4, entre el éxito externo y el almacenamiento del resultado local.
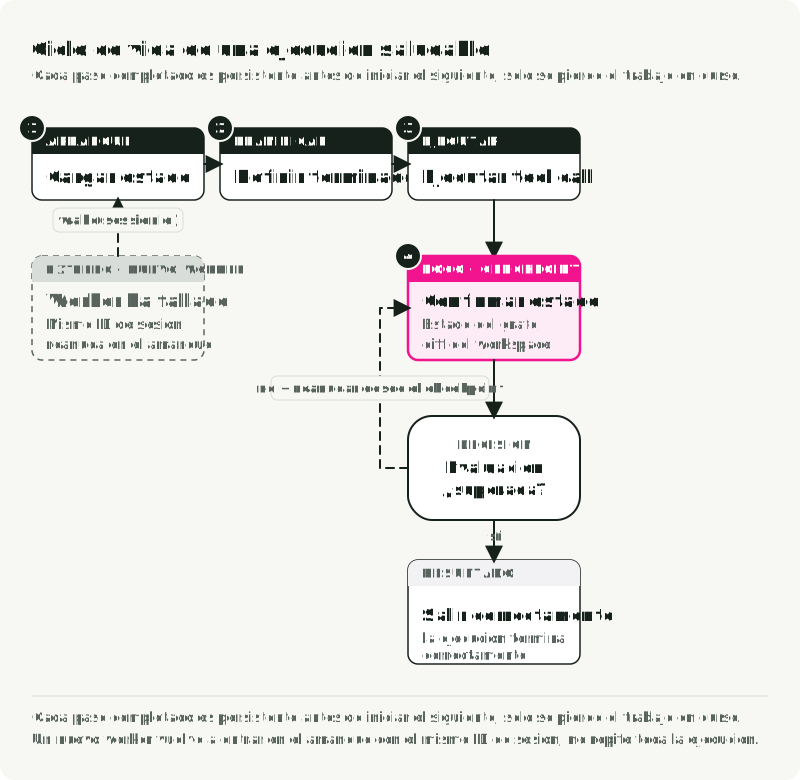
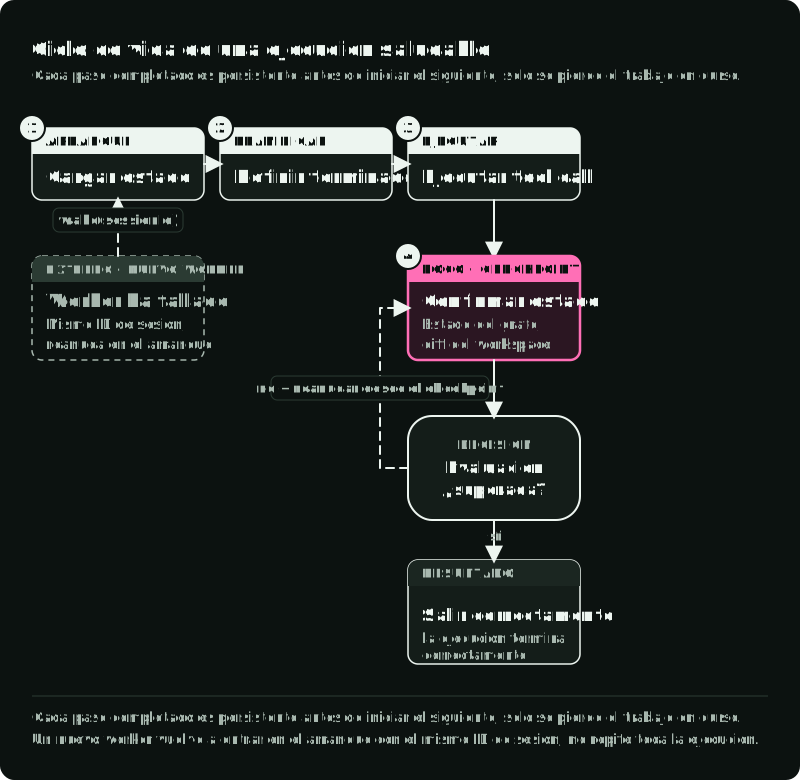
El diff del workspace del diagrama es una versión o referencia de archivo recuperable; el checkpoint del grafo no tiene por qué contener los propios archivos.
El caso para el que hay que diseñar es un fallo entre el éxito externo y el almacenamiento local del resultado. Ninguna transacción de base de datos puede confirmar de forma atómica una escritura en un servicio ajeno sin la cooperación de ese servicio. El análisis de AWS sobre las APIs idempotentes explica por qué un ID de petición proporcionado por el llamante representa una intención: dos peticiones idénticas pueden ser dos acciones deseadas, mientras que dos reintentos de un mismo ID deberían representar una sola. El servicio receptor debe respetar ese contrato y detectar un payload modificado bajo el mismo ID. Comprueba su periodo de deduplicación; una clave caducada no es una promesa permanente. Stripe, por ejemplo, devuelve el primer resultado para una clave de idempotencia repetida y puede eliminar las claves una vez transcurridas al menos 24 horas.
El mismo protocolo se aplica a enviar un correo, cobrar a una cuenta, abrir una pull request o modificar una base de datos que pertenece a otro servicio. Lo que cambia es el método de reconciliación. Por ejemplo, un proveedor puede admitir claves de idempotencia, una restricción de unicidad del recurso, una consulta read-after-write o ninguna consulta fiable. Diseña la política de reintentos a partir de ese contrato, no del hecho de que el framework de agentes pueda repetir un nodo.
Haz recuperable el resto de la ejecución
La llamada externa incierta es el caso más difícil. El resto de la ejecución también necesita unas cuantas reglas explícitas:
- Un único escritor activo. Una cola puede volver a entregar el trabajo cuando caduca un lease. Usa un lease de ejecución con fencing o actualizaciones de estado condicionales para que un worker obsoleto no pueda hacer avanzar la ejecución. Mantén la protección de idempotencia para las llamadas que ya están en curso. Confirma (ack) un job solo después de que el estado que representa sea durable. La recuperación empieza por inspeccionar las operaciones pendientes, no por reiniciar el modelo a ciegas. Decide qué significa una nueva entrada del usuario durante una ejecución: rechazarla, ponerla en cola, interrumpir o revertir; el artículo de LangChain sobre el runtime de Deep Agents describe estas opciones.
- Una espera durable. Si la publicación requiere aprobación, persiste la acción propuesta y sus argumentos exactos. Reanuda con la decisión de aprobación y vuelve a comprobarla si la acción propuesta cambia. No mantengas abierto un proceso worker solo para esperar a una persona.
- Una ejecución acotada. Persiste el plazo, los límites de llamadas o de herramientas y el gasto permitido. Reserva presupuesto antes de un despacho concurrente para que dos llamadas no puedan gastar el mismo remanente; reconcilia después el uso real. La cancelación detiene las llamadas nuevas y registra la solicitud, pero no puede deshacer un efecto externo en curso. Una alerta de métricas o un presupuesto del lado del proveedor, como los task budgets en beta de Anthropic, es una segunda señal; el modelo puede superar un presupuesto orientativo, así que mantén el ledger de despacho en cualquier caso.
- Trabajo restaurable. Guarda una referencia al artefacto aprobado, su hash y la versión del workspace que lo produjo. Un proceso restaurado debe poder validar el archivo antes de publicarlo. Los archivos grandes van en un almacén de artefactos, no dentro de cada checkpoint del grafo.
- Un límite de ejecución. Si una herramienta ejecuta código generado, instala paquetes o navega por páginas no confiables, ejecútala en un entorno con las restricciones de archivos, red y procesos necesarias. Mantén las credenciales de larga duración fuera del contexto visible para el modelo; aplica los permisos donde se ejecuta la acción. Un contenedor o un checkout por worktree no establece por sí solo el aislamiento que puede exigir tu modelo de amenazas.
En LangGraph, elige la durabilidad de los checkpoints de forma deliberada. Su modo "sync" persiste cada checkpoint antes de que empiece el siguiente paso; "async" puede perder un checkpoint reciente si el proceso falla, y "exit" no guarda el progreso intermedio frente a un fallo a mitad de la ejecución. Ni siquiera "sync" cierra el hueco de los efectos externos descrito arriba. El event log y la lógica de reconciliación siguen siendo trabajo de la aplicación.
Fallos que añaden las ejecuciones largas
A medida que las ejecuciones atraviesan workers y ventanas de contexto, los fallos se desplazan hacia el estado, los efectos secundarios duplicados, la deriva del workspace y el coste. Cada uno necesita un control fuera de la memoria del modelo, para que siga funcionando después de un reinicio. La figura sitúa cada control en el paso del bucle de ejecución en el que actúa; la tabla añade dónde se implementa.
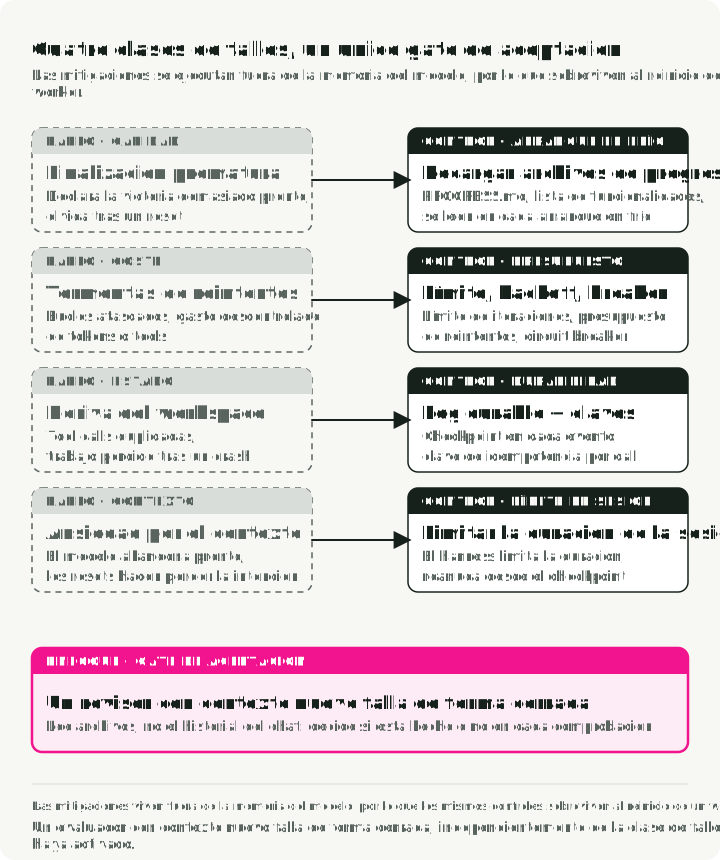
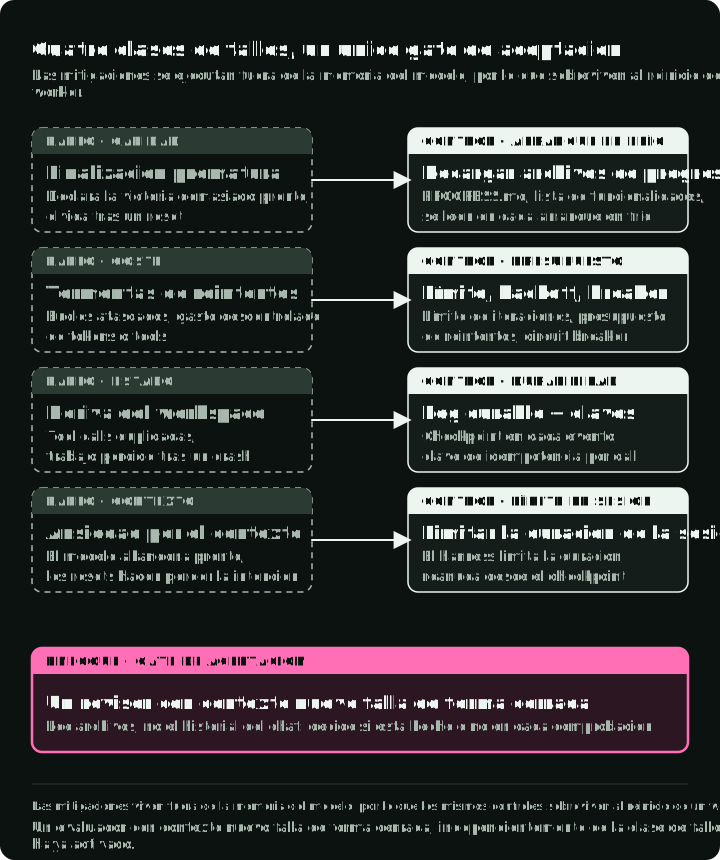
| Fallo | Control | Dónde se ejecuta |
|---|---|---|
| El agente da la tarea por terminada demasiado pronto | Comprobaciones de aceptación sobre los artefactos; evaluador opcional con contexto nuevo y sin herramientas de escritura | Paso de finalización del harness; evaluador en su propia sesión de sandbox |
| El agente olvida el trabajo terminado tras un reset de contexto | Archivos de progreso como PROGRESS.md y feature-list.json, leídos antes de la primera llamada al modelo | Hook de arranque de cada sesión de modelo |
| El modelo resume y se detiene pronto cerca de su límite | Limitar la sesión y empezar una nueva a partir del handoff y el checkpoint | Límite de duración de sesión del harness |
| Loops atascados y reintentos sin límite | Límite de iteraciones, backoff exponencial, circuit breaker según la tasa de errores de herramientas, presupuesto estricto de tool calls | Nodo de ejecución de herramientas; RetryPolicy en las Activities de Temporal |
| El agente edita archivos que pertenecen a otra ejecución | Workspace por ejecución, commits de Git como puntos de recuperación, política de archivos del sandbox o del proxy de herramientas | Política del sandbox; permisos de Deep Agents para sus herramientas de archivos integradas |
| El gasto en tokens o herramientas se dispara | Reservar presupuesto antes del despacho, acotar la salida, reconciliar el uso | Ledger de presupuesto en la ruta de despacho; alertas de Prometheus como segunda señal |
| Un tool call se ejecuta dos veces tras un fallo | Persistir pending y una clave de idempotencia antes del despacho; al reanudar, consultar o reintentar con la misma clave | Event store más la API de idempotencia o de consulta del proveedor |
| Se pierde trabajo cuando muere un worker o un sandbox | Event log durable, checkpoint tras cada super-step, reconciliar los efectos pendientes antes de continuar | PostgresSaver más una tabla de eventos, o un Workflow de Temporal |
El quick-start cwc-long-running-agents de Anthropic incluye los patrones del evaluador y de los archivos de progreso. La parada prematura cerca del límite de contexto depende del modelo, así que vuelve a probar cualquier solución alternativa cuando cambie el modelo. Como dice Anthropic, cada componente del harness codifica una suposición sobre lo que el modelo no puede hacer, y esa suposición puede quedar obsoleta cuando cambia el modelo.
Fallos de transporte que el bucle tiene que absorber
Un stream puede cerrarse a mitad de la respuesta. La conexión puede caerse cuando solo ha llegado la mitad de una respuesta, o la mitad de un tool call. Los argumentos de la herramienta llegan como fragmentos de JSON que solo se pueden parsear cuando el bloque se completa, así que una llamada ensamblada a medias nunca debe llegar al despacho; ejecutar un comando truncado es justo lo que la capa de permisos existe para evitar. Trata un stream roto como una petición fallida: descarta el fragmento, no lo añadas nunca como algo que dijo el modelo y reintenta la llamada completa. Es asumible porque el prefijo que ya enviaste es una lectura de caché en el reintento. Mantén el reintento por debajo del bucle del agente, en el wrapper de la llamada, para que una petición reintentada nunca vuelva a ejecutar una herramienta que ya se ejecutó.
El streaming también deja de ser opcional a medida que crecen las peticiones. Los proveedores aplican timeouts a las peticiones sin streaming y exigen streaming a partir de ciertos tamaños de salida, y los SDK pueden hacer streaming por debajo en las llamadas largas. Por eso un runtime de producción tiende a hacer streaming de todo y a acumular el resultado, aunque ninguna interfaz quiera los fragmentos. Los tokens que llegan sirven entonces también como señal de actividad: mientras siguen llegando, la llamada está viva, así que un stream que lleva un minuto en silencio es indicio de un bloqueo. Una petición sin streaming no te dice nada hasta que vuelve.
Los límites de tasa se miden en tokens, no en peticiones. Los proveedores miden los tokens de entrada y de salida por minuto, así que un agente que lleva una petición grande agota un límite con una tasa de peticiones que parece ridículamente baja. Por eso el crecimiento del contexto aparece como errores 429 y no como un problema de latencia, y el fan-out paralelo multiplica la presión por el tamaño de cada petición, no por el número de workers. Pon un tope de concurrencia y comparte un único presupuesto de tokens en el componente que lanza el trabajo paralelo; el backoff dentro de cada worker solo reparte la misma demanda en el tiempo. Cuenta los 429 y el endpoint usado en cada ejecución, para que un límite del proveedor no se confunda con una propiedad de la configuración que se está probando.
El runtime también necesita evidencias para diagnosticar una ejecución. Emite un ID de ejecución y un ID de operación con los spans de modelo y de herramientas, el estado, la duración y el uso de tokens. Las convenciones GenAI de OpenTelemetry dan nombres comunes a estos campos, aunque las convenciones aún están en desarrollo. El texto de los prompts, los argumentos de las herramientas y los resultados pueden contener datos sensibles; decide si deben ir en la telemetría antes de capturarlos. Una traza ayuda a explicar un fallo. El event log y la consulta externa deciden si es seguro continuar. La sección de observabilidad de más abajo lo convierte en un stack.
Elige la forma de despliegue a partir de las reglas de espera y de fallo
El nombre de la plataforma es una elección tardía. Primero pregúntate si quien llama necesita el resultado final en la misma petición, si la ejecución puede esperar y quién operará su estado durable.
| Necesidad | Forma inicial | Lo que sigue necesitando |
|---|---|---|
| Tarea corta completada dentro de una petición | Agent loop en el request handler | Un límite de ejecución separado para herramientas no confiables; estado durable si importa reintentar o continuar |
| Trabajo en segundo plano que puede durar más que un worker | Cola, worker reemplazable, estado durable | Leases de ejecución, checkpoints, log de operaciones, almacén de artefactos según haga falta |
| Muchas aprobaciones, temporizadores, callbacks o reintentos entre despliegues | Motor de workflows durable con workers para llamadas al modelo y tool calls | Cambios de workflow seguros para el replay y activities externas idempotentes |
La duración de la ejecución es un primer filtro útil, aunque no decide todo el diseño. La figura sitúa cada forma de partida en una escala logarítmica de duración, por encima de los límites de tiempo de las plataformas habituales:
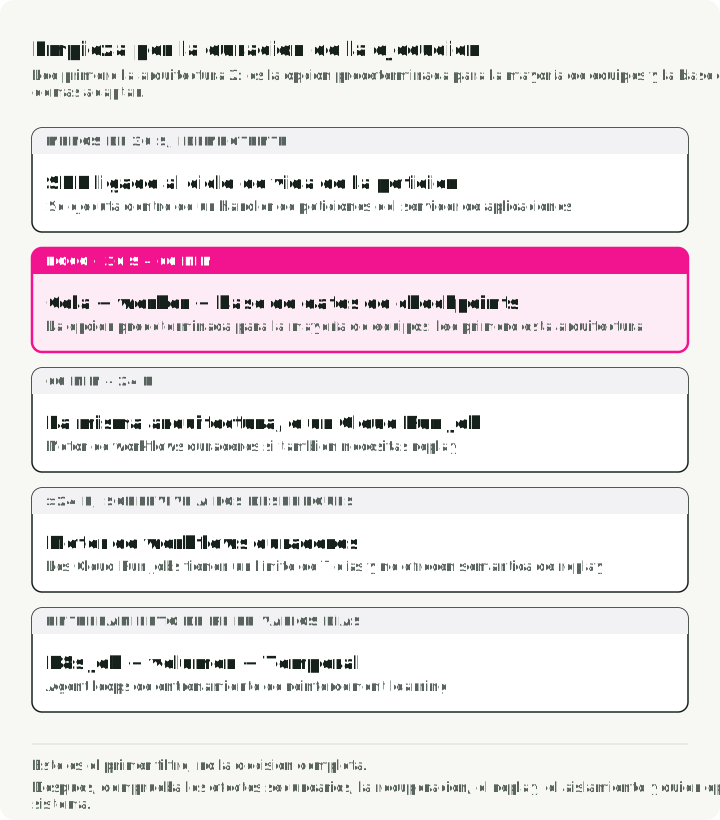
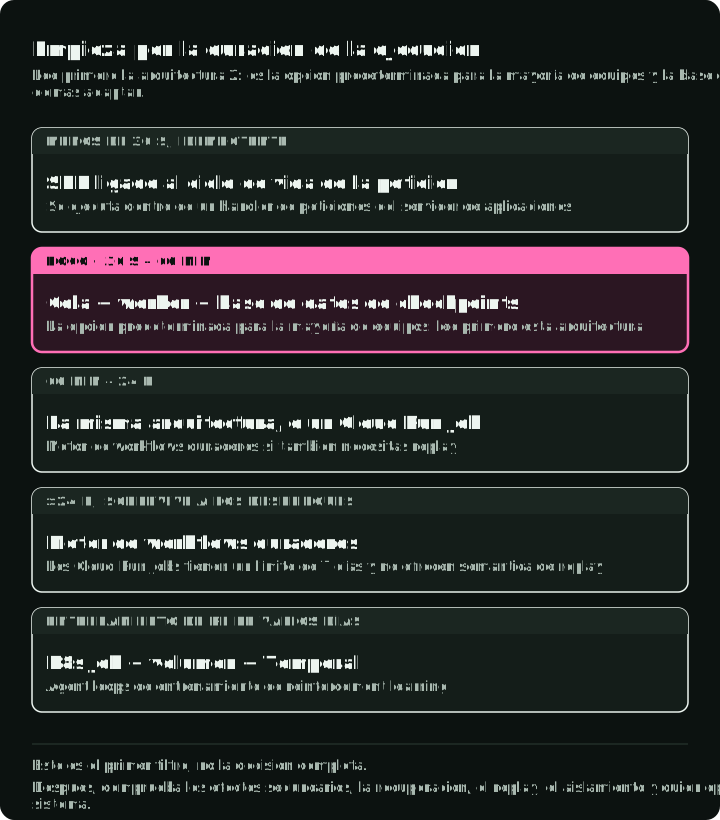
- Menos de 30 segundos, idempotente: el SDK del agente dentro de un request handler del servidor de aplicaciones.
- De 30 segundos a 60 minutos: cola, worker y base de datos de checkpoints.
- De 60 minutos a 24 horas: la misma cola y el mismo worker, o un Cloud Run Job para trabajo puntual; un motor de workflows si además necesitas versionado y replay.
- Más de 24 horas, sobreviviendo a despliegues: un motor de workflows durable como Temporal.
- Loops de entrenamiento por reinforcement learning de varios días: un Kubernetes Job con un volumen, más Temporal.
Después de ese filtro, comprueba los efectos secundarios, la recuperación, el replay, el aislamiento, la ubicación de los datos y el equipo que operará el sistema.
Yo empezaría el ejemplo del informe con una cola y un worker. La API devuelve un ID de ejecución; el worker hace avanzar el harness; un almacén durable registra los checkpoints y las operaciones pendientes; un almacén de artefactos guarda el informe. Ese diseño cubre los requisitos concretos de reinicio y aprobación sin suponer una nube concreta. Si las reglas de espera y reintento se convierten en un workflow por sí mismas, Temporal puede persistir el historial de ejecución y hacer replay de las decisiones del workflow. Sus Activities siguen ejecutando llamadas externas y pueden reintentarse, así que necesitan el mismo diseño de idempotencia o reconciliación.
Los servicios en la nube implementan estas formas; sus timeouts no definen la arquitectura. Una petición a un servicio de Cloud Run tiene un plazo y puede seguir procesándose después de que se cierre la conexión, así que un timeout HTTP es una evidencia especialmente pobre de que una acción se detuvo. Un Cloud Run Job, una tarea de ECS o un Kubernetes Job pueden alojar un worker en segundo plano, pero un límite de tarea largo no le da por sí solo un progreso durable. Una invocación normal de AWS Lambda tiene un límite de 15 minutos; un workflow puede abarcar invocaciones acotadas. Verifica los límites actuales y el comportamiento de reintentos del servicio elegido antes del despliegue.
Una plataforma de agentes alojada puede operar por ti el loop y parte de su estado. Evalúala con el mismo simulacro de fallo: ¿cómo exportas el estado de la ejecución, encuentras un efecto secundario pendiente, vinculas una aprobación a una acción, inspeccionas los datos enviados al control plane y reanudas después de un despliegue? Mantén el contrato de sandbox de la plataforma separado de su contrato de harness. Alojar el harness no hace automáticamente seguras sus herramientas, y alojar el sandbox no hace automáticamente durable la ejecución.
Qué te da cada forma
La matriz nombra el componente que ofrece cada responsabilidad en cada forma, marca las celdas que ejecuta un proveedor alojado y resalta las celdas que no bastan por sí solas. Las notas que la siguen dan los límites que deciden entre ellas, comprobados en septiembre de 2026.
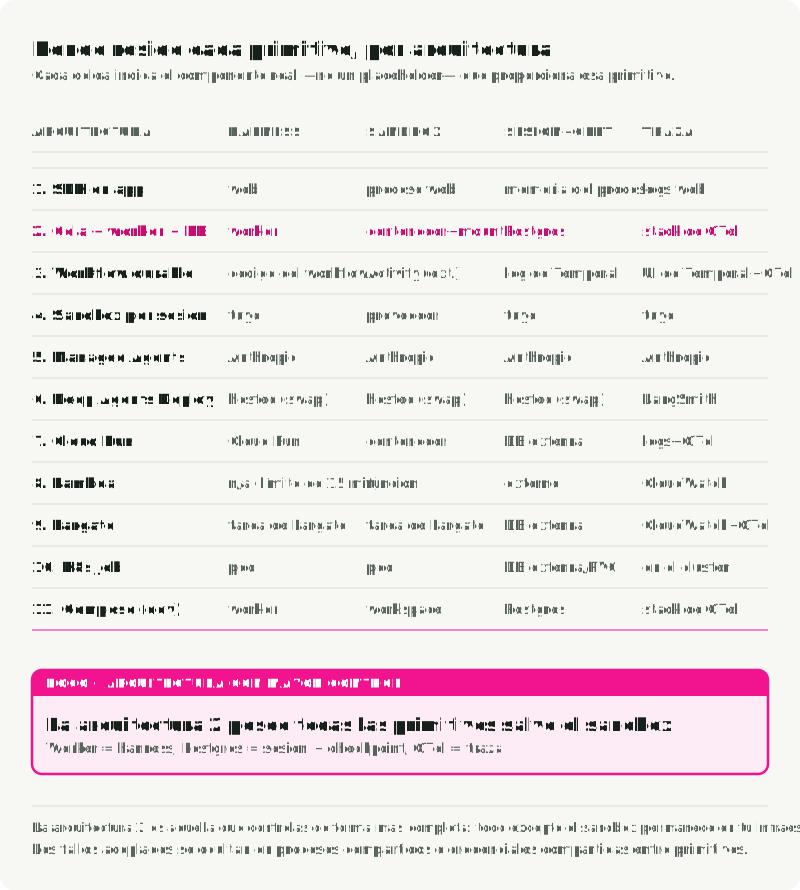
1. SDK dentro de un servidor de aplicaciones. El agente se ejecuta en un request handler. Sirve para tareas de menos de unos 30 segundos, demos y herramientas internas. Un fallo de la capa web pierde el trabajo en memoria. Una desconexión del cliente puede cancelar el trabajo o dejarlo en marcha, según el servidor y la aplicación; no determina el resultado de una acción externa. Persiste el estado si importa continuar y no uses un request handler para trabajo de varias horas.
2. Cola, worker y base de datos de checkpoints. La opción por defecto que recomiendo a la mayoría de los equipos: un worker de Python con un checkpointer de PostgreSQL y Redis Streams o RabbitMQ para los jobs entrantes. El Market Analyst Agent demuestra esta forma con un worker de cola iniciado por separado. En el diseño de producción, la aplicación crea una fila de ejecución, encola un job y devuelve el ID de ejecución; el worker ejecuta el harness, escribe eventos y checkpoints y guarda los artefactos. La profundidad de la cola da backpressure, y la computación spot o preemptible funciona si las escrituras durables terminan antes de que el worker confirme el job. El worker es el harness; el código no confiable sigue necesitando un sandbox reforzado.
3. Motor de workflows durable. La orquestación del agente se ejecuta dentro de un Workflow de Temporal, y las llamadas al modelo y los tool calls se ejecutan como Activities. El estado del workflow vive en un historial de eventos respaldado por Cassandra, MySQL o PostgreSQL, así que se reproduce tras los fallos, y un workflow inactivo no consume computación. Una aprobación humana se convierte en una espera durable en lugar de un loop de sondeo. Los cambios de código que coinciden con una ejecución en curso necesitan Worker Versioning seguro para el replay o parches. La integración de Temporal con el OpenAI Agents SDK ejecuta las herramientas del agente como Activities; revisa su lista de funciones del agente no admitidas antes de depender de ella.
4. Un proveedor de sandbox por ejecución. Cada ejecución obtiene su propia microVM o contenedor de un proveedor, mientras que el harness, la sesión, el checkpoint y la traza se quedan de tu lado, normalmente en la forma 2. Úsalo cuando el agente ejecute código no confiable, automatización de navegador, tests o instalaciones de paquetes; el coste es un gasto mayor y el acoplamiento al proveedor.
| Proveedor | Aislamiento | Límites de sesión y persistencia |
|---|---|---|
| E2B | MicroVM Firecracker | Sesiones continuas de 1 h en Hobby y 24 h en Pro; pausa y reanudación aparte |
| Vercel Sandbox | MicroVM Firecracker | 45 min en Hobby, 24 h en Pro y Enterprise; por defecto, los snapshots caducan 30 días después del último uso |
| Daytona | Sandbox configurado por el proveedor | Ciclo de vida configurable de parada y archivado; los forks registran su padre |
| Modal | gVisor | 5 min por defecto, 24 h como máximo; los volúmenes y los snapshots tienen reglas de persistencia propias |
| Runloop | MicroVMs, según su ficha en Marketplace | Suspensión y reanudación; snapshots de disco y ramas |
Las cifras de arranque de los proveedores miden intervalos distintos, así que no son una clasificación de velocidad. El arranque de contenedor de aproximadamente un segundo de Modal, por ejemplo, excluye el arranque de la aplicación. Mide el tiempo desde la petición a la API hasta el primer comando con éxito y hasta un estado en que la aplicación está lista, en los p95 y p99 que necesites, y comprueba los límites de concurrencia de la cuenta antes de las pruebas de carga.
5. Anthropic Managed Agents. Una sesión, un harness, un sandbox y un proxy MCP respaldado por un vault, todo alojado, en beta pública desde el 8 de abril de 2026. Factura las tarifas estándar por token más $0.08 por hora de sesión mientras una sesión está en ejecución; el tiempo inactivo es gratuito y las sesiones no tienen modo batch. Una sesión que se ejecuta de forma continua cuesta unos $58 al mes antes de los tokens. No está disponible a través de Bedrock ni de Vertex AI. Con los sandboxes self-hosted operas tú la ejecución y el tráfico de salida, pero las entradas y los resultados de las herramientas siguen llegando al control plane de Anthropic. Abandonarlo más adelante implica cambiar de plataforma.
6. LangChain Deep Agents Deploy. deepagents deploy empaqueta un deepagents.toml en un LangSmith Deployment con ejecución durable, memoria, human-in-the-loop, código en sandbox y ejecuciones programadas, en modo cloud, híbrido o self-hosted. El proveedor de sandbox (LangSmith Sandboxes, Daytona, Modal, Runloop o uno personalizado) es un único valor de configuración. El harness tiene licencia MIT y usa el formato abierto AGENTS.md, así que el lock-in es menor que en la forma 5.
7. Google Cloud Run. Un servicio atiende HTTP y escala a cero; su timeout de petición es de 300 segundos por defecto, con un máximo de 60 minutos. Un job se ejecuta hasta completarse sin HTTP; las tareas tienen 10 minutos por defecto, con un máximo de 168 horas (7 días), o 1 hora con GPUs. Usa un servicio para ejecuciones síncronas de hasta 60 minutos y un job para trabajo puntual más largo. Ninguno conserva estado entre ejecuciones ni hace replay entre despliegues, así que las sesiones y los checkpoints van a PostgreSQL, Spanner o un almacén similar.
8. AWS Lambda. Una función hace timeout a los 15 minutos. Detrás de API Gateway, una petición síncrona dispone de unos 30 segundos, salvo que una REST API regional o privada eleve su límite. Las Lambda durable functions, lanzadas en diciembre de 2025, añaden checkpoints, pasos y esperas en ejecuciones de hasta un año, mientras cada invocación sigue acotada.
9. AWS ECS o Fargate, una tarea por ejecución. Fargate no tiene un límite de tiempo de ejecución documentado y da a cada tarea su propia interfaz de red en modo awsvpc, lo que encaja con el acceso a datos internos de la VPC. No admite GPUs; para eso, usa ECS sobre EC2. Fargate Spot añade riesgo de interrupción, y la durabilidad es responsabilidad tuya. Compara también Amazon Bedrock AgentCore Runtime, que aloja código de agentes con sesiones gestionadas de hasta 8 horas en microVMs serverless, o de 14 días con su tipo de computación Instances, que admite GPUs.
10. Un Kubernetes Job por ejecución. Un Job por ejecución con activeDeadlineSeconds, un PersistentVolumeClaim para el workspace y un sidecar MCP. Encaja con equipos que ya operan Kubernetes; los arranques en frío lo descartan cuando se necesita un arranque de menos de un segundo, y la recuperación ante fallos tienes que construirla tú. Un aislamiento fuerte sigue dependiendo de la runtime class, la network policy y la seguridad de los pods. La ejecución en GPU necesita nodos GPU, drivers y un device plugin.
11. Docker Compose local, solo para desarrollo. El proyecto de acompañamiento inicia una aplicación Gradio y los almacenes de la forma 2, con un volumen de workspace y sin sandbox reforzado. Su worker de cola se inicia por separado. El stack de referencia de abajo distingue estos procesos.
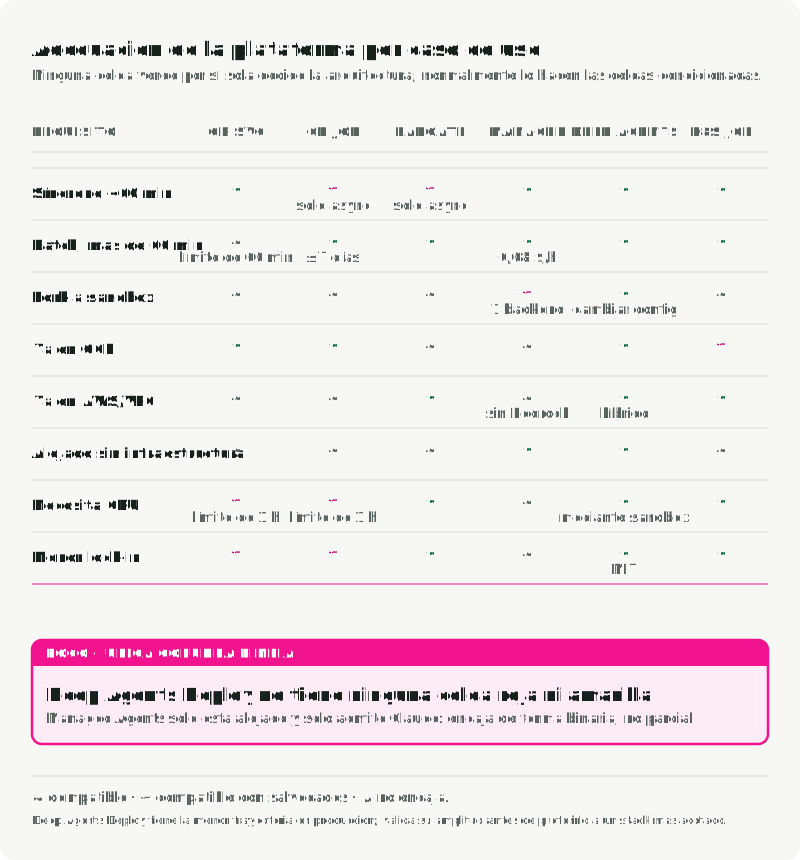
En la matriz, las celdas marcadas con una salvedad suelen decidir la elección, no las marcas de verificación. Una cobertura amplia no muestra la residencia de los datos, la semántica del replay, la dependencia del proveedor ni el coste de mover el estado más adelante.
Harness alojado o propio. Alojado significa que el proveedor ejecuta el loop y tú llamas a una API; propio significa que ejecutas tú el loop, aunque el código venga de un proveedor. LangChain está en ambos lados: LangGraph es una biblioteca que ejecutas tú mismo, y Deep Agents Deploy ejecuta un harness por ti en su modo cloud. Elige el alojado cuando su soporte de modelos, su límite de datos, su comportamiento de recuperación y sus puntos de extensión ya encajen. Elige el propio cuando esperes que esos requisitos cambien, y prueba la ruta de salida antes de que los datos de producción dependan de ella.
Sandbox alojado o entorno de ejecución propio. Elige un sandbox alojado cuando su aislamiento, su pausa y reanudación o su comportamiento de fork encajen con el modelo de amenazas y con el presupuesto de arranque. Docker o Fargate pueden servir para trabajo interno de confianza que necesite acceso a la VPC o una residencia de datos estricta, pero un contenedor estándar no basta para código hostil; la parte 4 trata las opciones de aislamiento.
Lleva el límite de estado a una aplicación de LangGraph
El siguiente fragmento muestra solo la parte de estado del grafo de la forma cola y worker. Supone que builder es un StateGraph existente, run_id es el identificador durable de la ejecución y task es la nueva petición. El worker tiene una conexión a PostgreSQL en DATABASE_URL y permiso para crear las tablas del checkpointer. Es un cableado ilustrativo, no un worker de publicación completo.
import os

from langgraph.checkpoint.postgres import PostgresSaver

with PostgresSaver.from_conn_string(os.environ["DATABASE_URL"]) as checkpointer:
    checkpointer.setup()  # once during setup or migration
    graph = builder.compile(checkpointer=checkpointer)
    graph.invoke(
        {"messages": [{"role": "user", "content": task}]},
        {"configurable": {"thread_id": run_id}},
        durability="sync",
    )
El thread_id es la clave de búsqueda de checkpoints de LangGraph, no un ID de operación ni una prueba de que la publicación se produjo. La aplicación sigue teniendo que persistir la fila de ejecución, el artefacto aprobado, la operación pendiente y su resultado. También tiene que recuperar los jobs interrumpidos y decidir qué significa una nueva entrada mientras una ejecución está activa. No reanudes un nodo de publicación incierto simplemente invocándolo otra vez. Reconcilia primero y después entrega el resultado recuperado al grafo.
Git, la base de datos de checkpoints y el object storage
Las ejecuciones largas suelen usar tres almacenes a la vez, porque cada uno guarda un artefacto distinto.
- Git guarda el workspace: código, documentos y archivos de progreso. Úsalo cuando el trabajo tenga forma de código o importe el historial de archivos. Crea una rama para la ejecución, haz un commit inicializador y haz commit después de la preparación, después de cada funcionalidad y después de que pasen los tests. Guarda el SHA del último commit junto al checkpoint. Al reanudar, el siguiente worker hace checkout de la rama, lee
git log --oneline -8, inspeccionagit statusy el último diff, y después lee el archivo de handoff. Git no puede decir qué nodo del grafo se ejecuta a continuación, qué llamada espera aprobación ni qué reintento usó su clave de idempotencia. Prescinde de él cuando el producto sea una única respuesta. - La base de datos de checkpoints guarda el estado del grafo: qué se decidió, qué nodos se ejecutaron y qué se ejecuta a continuación. Usa checkpointing del estilo de
PostgresSavercuando importe el estado intermedio entre nodos, como planner, investigador, redactor y verificador. - Un object store como S3 o GCS guarda las salidas grandes: PDFs, archivos Parquet, capturas de pantalla. Úsalo cuando la salida sea demasiado grande para la base de datos de checkpoints, cuando los consumidores necesiten una URL sin pasar por el agente o cuando el entregable y la ejecución tengan una retención distinta. Podrías borrar los logs de ejecución a los 30 días y conservar el informe final durante años. Usa
(thread_id, checkpoint_id, artifact_name)como clave de los objetos para que la ejecución que los produjo siga siendo trazable.
El stack de referencia en Docker Compose
El Market Analyst Agent es el proyecto de aprendizaje que acompaña a esta serie. Desde la raíz de su repositorio, con Docker Compose disponible y .env preparada a partir de .env.example, make docker-up usa docker/docker-compose.yml para iniciar PostgreSQL, Qdrant, Redis y la aplicación. El comando predeterminado de la aplicación ejecuta la interfaz Gradio, que llama al harness de forma síncrona. make worker inicia por separado el consumidor de la cola Redis; requiere uv y Python 3.13+, instala las dependencias del proyecto e inicia las bases de datos. Configura las claves de los proveedores en .env antes de ejecutar un análisis en directo. make mcp-up y make observability-up activan los perfiles opcionales de MCP y observabilidad.
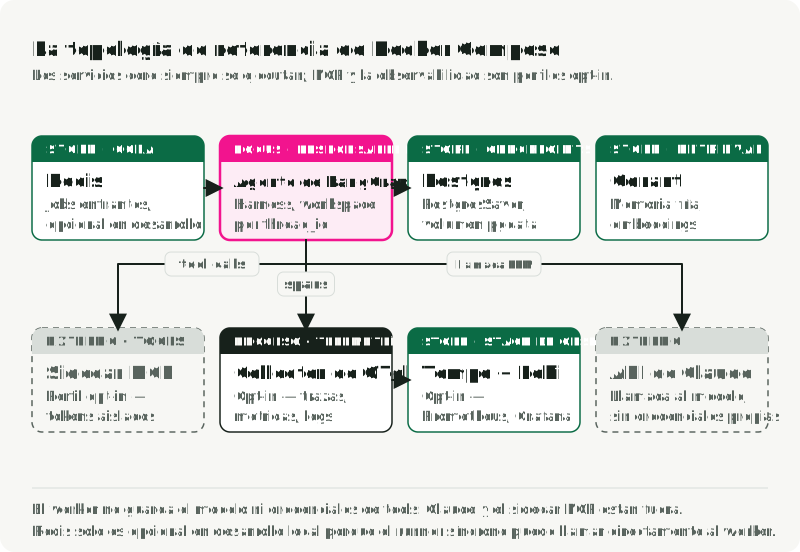
Las rutas de observabilidad configuradas están incompletas. El Collector solo tiene un pipeline de trazas a Tempo. Su filtro de inclusión strict compara gen_ai.operation.name con el literal .+, por lo que valores normales como chat y execute_tool no coinciden y se excluyen; el matcher de Collector 0.117.0 confirma la comparación de igualdad. Prometheus recopila directamente las métricas de app:9464 y las métricas propias del Collector; las métricas de la aplicación requieren METRICS_ENABLED=true. La exportación de trazas de la aplicación también requiere un endpoint OTLP. Loki tiene un backend y una fuente de datos en Grafana, pero no una entrada de logs configurada. Corrige el filtro de trazas y añade la ingesta de logs antes de esperar trazas y logs con datos; arrancar un contenedor no demuestra que los dashboards funcionen.
Para un contenedor worker, añade un servicio worker explícito y proporciona a los escritores concurrentes el mismo volumen de workspace; la aplicación Compose predeterminada no consume la cola. En producción, añade una tabla de eventos para las intenciones y los resultados de las herramientas junto a los checkpoints y prueba la reconciliación para tus propias acciones externas.
Lee la ejecución después de que termine
Cuando falla una ejecución de seis horas, el evento que lo causó puede haber ocurrido horas antes, y el worker que lo produjo ya se ha sustituido. Depuras a partir de registros escritos mientras la ejecución estaba en curso. Dos se leen después de la ejecución: un event log consultable de cada paso y las trazas de adónde fueron el tiempo y los tokens. Dos se leen durante la ejecución: una vista en directo de los cambios del workspace y un stack de observabilidad por worktree que el propio agente puede consultar.
Ninguno de los dos registros que se leen después de la ejecución contiene necesariamente la petición tal como salió por fin del proceso, tras el ensamblado de las instrucciones, la recuperación (retrieval), la compactación y cualquier middleware. Una entrada del event log y un span describen que hubo una llamada al modelo y lo que costó. Cuando la pregunta es qué recibió el modelo, hace falta una captura propia, tomada en el último punto antes de que la llamada salga y almacenada donde irás más adelante a responder esa pregunta.
Event log. Cada llamada al modelo, tool call, resultado, error y aprobación, con el ID de ejecución y la marca de tiempo como clave, consultable como cualquier tabla. Addy Osmani formula la prueba: si no puedes reconstruir desde el almacenamiento durable lo que hizo el agente en las últimas 24 horas, tienes un script de shell que llama a un modelo, no un agente de larga duración.
Trazas GenAI de OpenTelemetry. Los spans llevan los atributos gen_ai.* estándar: modelo, proveedor, recuentos de tokens, ID de conversación y nombre del workflow. Las convenciones se trasladaron a su propio repositorio en 2026 y siguen con estabilidad Development, así que fija la revisión que hayas validado. En los backends que las admiten, puedes cambiar de destino sin volver a instrumentar el código.
Cambios del workspace durante la ejecución. El quick-start de Anthropic vigila el workspace. watch -n 5 'git log --oneline -8' muestra los últimos commits cada cinco segundos, y una carpeta de capturas de pantalla ordenada por tiempo muestra lo último que vio el agente. Trata ambos como señales de actividad y compáralos con los resultados de los tests antes de concluir que la ejecución avanza.
Un stack por worktree para el agente. En el artículo de OpenAI sobre harness engineering, cada worktree de Codex recibe sus propios logs, métricas y trazas de corta duración, que el agente consulta mientras trabaja. Eso convierte un requisito como “ningún span de estos cuatro recorridos de usuario supera los dos segundos” en algo que el agente puede comprobar.
Un stack self-hosted mínimo para un agente como el Market Analyst Agent:
- OpenTelemetry Collector, que recibe los spans y puede filtrar los campos
gen_ai.*antes de exportarlos. - Tempo o Jaeger para las trazas, con
gen_ai.conversation.idothread_idcomo clave. - Loki para las entradas del event log.
- Prometheus para las métricas de tokens y latencia de GenAI.
- Dashboards de Grafana con
gen_ai.agent.nameygen_ai.request.modelcomo clave.
Si prefieres un servicio alojado, elige uno: LangSmith para LangGraph y Deep Agents Deploy, Braintrust cuando las suites de evaluación son lo primero, Arize Phoenix para OTLP de código abierto con OpenInference, el dashboard de tracing de OpenAI para el Agents SDK o el tracing de Anthropic para Managed Agents.
Define los atributos estándar en cada span de modelo, como mínimo la operación, el proveedor, el modelo, el ID de conversación, el nombre del agente y los recuentos de tokens. Tres paneles de dashboard cubren la mayor parte de la depuración: tokens de salida por agente y por hora, latencia p95 del modelo por modelo y tool calls que tardaron más de 30 segundos.
Cuando falle una ejecución, haz que el worker escriba un debug bundle en /workspaces/${THREAD_ID}/_debug/:
events.jsonl: el event log exportado, con intenciones, resultados, aprobaciones y errores.checkpoints.jsonl: el historial del estado del grafo obtenido concheckpointer.list({"configurable": {"thread_id": ...}}), etiquetado como checkpoints.last_state.json:StateSnapshot.valuesdel último super-step con éxito.trace.json: los spans exportados de la ejecución, según la política de captura de contenido.tool_calls.csv:(ts, tool, input_hash, latency_ms, status, error).workspace.tar.zst: el workspace másgit diffcontra el commit inicializador.screenshots/*.png,PROGRESS.md,feature-list.jsony otros archivos de progreso.env.txt: tags de imagen, versión del modelo y SHA del commit del harness.
Con él, un informe puede decir “la ejecución s_123 gastó el 71 por ciento de sus tokens repitiendo tres comandos después de que fallara npm install” en lugar de “el agente se atascó”.
Pruebas de puntos de fallo
Una ejecución completada sin interrupciones dice poco sobre la recuperación. Para el ejemplo del informe, inyecta una parada en tres puntos: antes de que se confirme la operación pendiente, después de que el servicio de publicación acepte la petición pero antes de que se guarde el resultado, y mientras la ejecución espera la aprobación. Reinicia con un worker nuevo y verifica el número de artefactos publicados, la aprobación registrada y el estado final de la operación. El caso intermedio es el que pone al descubierto los efectos secundarios duplicados.
Prueba también dos workers que reclaman la misma ejecución, una cancelación mientras una llamada está en curso y un proveedor que no puede confirmar una acción que hizo timeout. El resultado correcto de este último caso puede ser needs_human, no otra petición. Inspecciona el event log y la traza para explicar cada resultado. Una prueba de recuperación solo está completa cuando el estado externo coincide con el estado registrado de la ejecución.
Antes de lanzar un agente de larga duración, responde a estas preguntas en términos de infraestructura:
- ¿Qué almacén es el dueño de los eventos y los checkpoints de la ejecución?
- ¿Qué ocurre si el worker muere a mitad de un tool call?
- ¿Puede una ejecución corromper el workspace de otra ejecución?
- ¿Qué acciones requieren aprobación?
- ¿Pueden el modelo o el sandbox leer credenciales en bruto?
- ¿Qué tool calls pueden reintentarse de forma segura?
- ¿Dónde se aplica el límite de coste por ejecución?
- ¿Qué evidencia determinista decide que la tarea ha terminado y qué criterios necesitan un revisor?
- ¿Dónde viven las salidas finales cuando el sandbox ya no existe?
- ¿Podemos explicar mañana una ejecución fallida sin volver a ejecutarla?
Si una respuesta es “el prompt le dice al agente que tenga cuidado”, el sistema todavía es una demo.
Esta es la parte 5 de Engineering the Agentic Stack. La parte 6, Harness Engineering para agentes AI, sigue el loop dentro de este runtime: cómo autorizar una acción propuesta, pasar el trabajo a un contexto nuevo y decidir a partir de evidencias independientes que la tarea ha terminado.
Referencias
Artículos de ingeniería
- OpenAI, Harness engineering: leveraging Codex in an agent-first world.
- Anthropic Engineering, Effective harnesses for long-running agents.
- Anthropic Engineering, Harness design for long-running application development.
- Anthropic Engineering, Scaling Managed Agents: Decoupling the brain from the hands, 8 de abril de 2026.
- Addy Osmani, Long-running Agents.
Frameworks y SDKs
- LangGraph, Checkpointers y
langgraph-checkpoint-postgres. - LangChain, Deep Agents overview, permissions y The runtime behind production Deep Agents.
- OpenAI Agents SDK, Sessions y Sandbox guide.
- Temporal, OpenAI Agents SDK integration y agentic sandboxes.
anthropics/cwc-long-running-agents: patrones del evaluador y de los archivos de progreso.
Plataformas y límites
- Anthropic, Claude platform pricing para las horas de sesión de Managed Agents.
- Proveedores de sandbox: E2B, Vercel Sandbox, Daytona, Modal, Runloop.
- Google Cloud Run, service request timeout y job task timeout.
- AWS, Lambda timeout, Lambda durable functions y Bedrock AgentCore Runtime.
Observabilidad
- OpenTelemetry, Semantic conventions for generative AI, attribute registry y metrics.