Рантайм долгоживущих ИИ-агентов: сессии и чекпоинты

Автоматический перевод
Эта статья была автоматически переведена с оригинальной английской версии.
Долгоживущий рантайм агента позволяет запуску с tool use пережить воркер, который его начал. Статья для инженеров, которые переносят агента из обработчика запросов в фоновую работу. Вы узнаете, какое состояние должно пережить перезапуск, почему чекпоинт не делает внешнее действие безопасным для повтора и как эти требования определяют форму деплоя. Затем статья сравнивает конкретные варианты: очередь и воркер, Temporal, провайдеров сэндбоксов, Cloud Run, Lambda, Fargate, Kubernetes и хостинговые платформы агентов, а также observability, с которой запуск можно отладить после сбоя.
Модель по-прежнему предлагает следующее действие. Харнесс из части 6 передаёт контекст, авторизует инструменты и проверяет завершение. Рантайм даёт этому циклу состояние в постоянном хранилище и место для выполнения. Часть 4 разбирает решение о разрешениях; здесь мы проследим одобренное действие через сбой и восстановление.
Состояние, которое перезапуск не должен стереть
Допустим, исследовательский агент собирает источники, пишет черновик отчёта, ждёт согласования и публикует одобренный файл. Запуск может длиться минуты или дни, потому что у согласования нет фиксированного срока. Деплой может заменить воркер, пока агент пишет черновик, пока он ждёт или сразу после того, как сервис публикации принял файл.
Память воркера можно потерять. Одобренный отчёт и факт, что публикация, возможно, уже произошла, — нельзя. До выбора фреймворка запишите, на какие вопросы должен ответить другой воркер:
| Вопрос после перезапуска | Надёжная запись, которую нужно хранить |
|---|---|
| Какой это запуск и можно ли его продолжать? | ID запуска, статус, дедлайн, бюджет, владелец или lease |
| Что агент должен сделать дальше? | Чекпоинт состояния цикла или графа |
| Какой отчёт был одобрен? | Неизменяемая версия артефакта или хэш содержимого и решение о согласовании |
| Произошла ли уже публикация? | ID ожидающей операции, аргументы, результат и ответ внешней проверки |
| Почему запуск упал или израсходовал бюджет? | Связанные события и трейсы |
Для этих записей не нужны пять отдельных продуктов. Одна база данных может хранить строки запусков, чекпоинты и события операций в разных таблицах. Объектное хранилище может хранить файлы отчётов. Бэкенд трейсинга может хранить тайминги. Держите записи раздельно, потому что каждая доказывает своё. Материал Anthropic о долгоживущих агентах описывает ту же базовую проблему со стороны модели: новый контекст не помнит предыдущую работу, если приложение не даёт ему надёжный прогресс для чтения. Команда OpenAI Codex сообщает об отдельных запусках, которые работают над одной задачей больше шести часов, так что это не редкий случай.
Назовём одну принятую задачу запуском. Он может использовать несколько сессий модели по мере замены контекстов, а один диалог может содержать несколько запусков. Фреймворки используют «сессию» и «тред» по-разному. В LangGraph thread_id служит ключом истории чекпоинтов; явно решите, соответствует ли один такой тред одному запуску или охватывает несколько. В любом случае держите собственный ID запуска приложения для лога операций. Бэкенды сессий в OpenAI Agents SDK хранят изменяемую историю диалога, которую можно редактировать, очищать и компактировать, поэтому не считайте их append-only логом для восстановления.
Рабочее пространство — ещё одна часть состояния. Для агента, который пишет код, коммит может указывать, какие файлы восстановить; в примере с отчётом неизменяемый ключ объекта и хэш могут указывать одобренный файл. Приостановленный сэндбокс может сохранить удобную файловую систему, но его дальнейшее существование не должно быть единственным способом восстановить результат. Git worktrees разделяют рабочие копии; это не сэндбоксы для выполнения.
Пять компонентов, которые нужно разместить
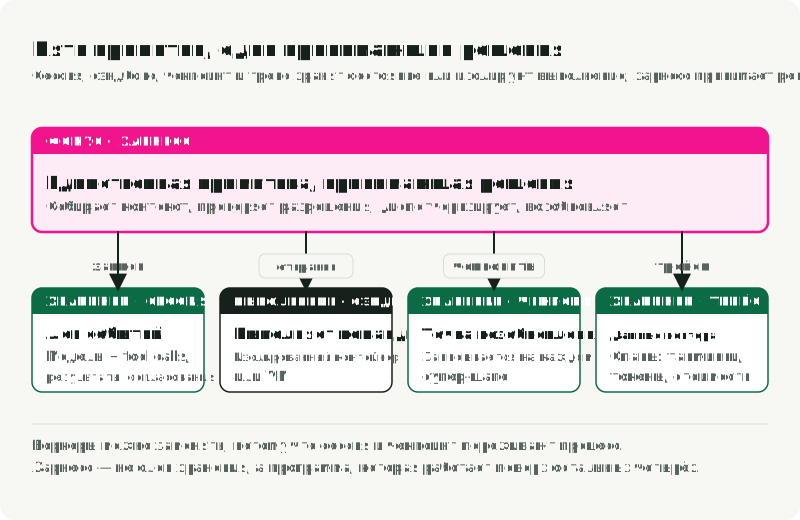
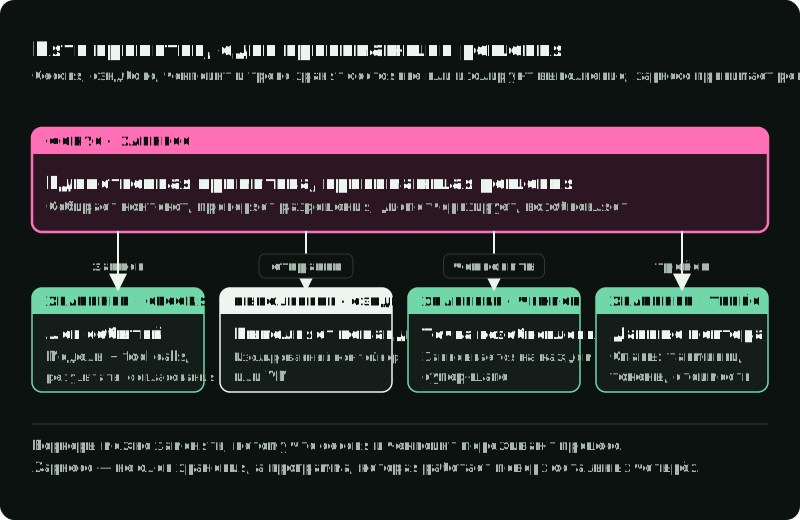
Материал Anthropic Scaling Managed Agents разделяет сессию, харнесс и сэндбокс. Эта статья также разделяет чекпоинты и трейсы, выделяя пять обязанностей рантайма, которые нужно распределить. Реализация может их объединять, но у каждой должен быть ответственный и известная граница отказа. Схема показывает их в конфигурации с очередью и воркером и подписывает то, что передаётся между ними.
| Компонент | Задача | Типичная реализация |
|---|---|---|
| Сессия | Append-only лог вызовов, результатов и согласований | Таблица событий в PostgreSQL с ключом по ID запуска |
| Харнесс | Вести ходы модели и инструментов до завершения задачи | Граф LangGraph, runner OpenAI Agents SDK, собственный цикл |
| Сэндбокс | Запускать команды с ограничениями на файлы, сеть, процессы | Защищённый контейнер, microVM, browser sandbox |
| Чекпоинт | Возобновлять работу без повторного прогона всего запуска | PostgreSQL или Redis saver в LangGraph, состояние workflow-движка |
| Трейс | Отлаживать запуск после его завершения | Спаны OpenTelemetry в Tempo, Jaeger, Honeycomb, LangSmith |
Решения принимает только харнесс; остальные четыре компонента хранят состояние или ограничивают выполнение. Скомпилированный граф LangGraph, Deep Agents от LangChain и Claude Code — харнессы в этом смысле. Руководство по сэндбоксам в OpenAI Agents SDK проводит ту же границу: согласования, трейсинг, handoffs и состояние для возобновления относятся к внешнему рантайму, а команды, изменения файлов и изоляция окружения — к сессии сэндбокса.
Сэндбоксы различаются сроком жизни. Свежий эфемерный сэндбокс существует для одной задачи и каждый раз платит за запуск. Постоянный приостановленный сэндбокс сохраняет файловую систему и снапшот памяти между запусками, поэтому следующее возобновление может обойтись без полной загрузки. Сэндбокс со снапшотом или форком ответвляет copy-on-write образ от подготовленного родителя, поэтому многие задачи используют общие установленные зависимости, но не общее изменяемое состояние.
Две задачи проходят через все пять компонентов. Проверка разрешений выполняется перед каждым tool call. Разрешения на файловую систему в Deep Agents охватывают только встроенные файловые инструменты, поэтому shell-команды, собственные инструменты и вызовы MCP требуют проверки в политике сэндбокса или за прокси инструментов. Секреты не должны попадать ни в модель, ни, как правило, в сэндбокс. Anthropic Managed Agents клонирует репозитории с токеном во время настройки сэндбокса и направляет вызовы MCP через прокси, который хранит OAuth-токены, так что харнесс никогда не видит учётные данные.
Проверьте размещение: запишите каждый компонент и то, чем он реализован. PostgreSQL может хранить сессию и чекпоинты, контейнер воркера запускает харнесс, провайдер вроде Daytona, Modal или E2B даёт сэндбокс, а Tempo или LangSmith хранит трейсы. Затем ищите связанные отказы: два компонента в одном процессе падают вместе, а общие учётные данные при утечке дают доступ к обоим компонентам.
Чекпоинт, лог событий и внешняя запись отвечают на разные вопросы
Чекпоинт говорит, откуда можно возобновить выполнение: какие сообщения или значения графа уже получены, какой шаг завершился и какой шаг ждёт запуска. LangGraph сохраняет состояние графа на границах super-step. Его checkpointer также может сохранить успешные записи узлов, когда другой узел на том же шаге падает. Это полезная отказоустойчивость, но чекпоинт значений графа не доказывает, зафиксировал ли запрос сервис вне графа.
graph.get_state() возвращает StateSnapshot, в .values которого лежит последнее известное состояние графа; это полезно в отладочном пакете. Ни он, ни чекпоинт не могут восстановить события, которые харнесс не записал в лог.
Лог событий операций говорит, что приложение пыталось сделать и что оно узнало: publish_requested, publish_pending, publish_succeeded или needs_human, всё привязано к одному ID запуска и ID операции. Он может жить в той же базе данных, что и чекпоинты, если приложение действительно пишет события. История чекпоинтов графа не становится этим логом автоматически. Транскрипт чата — ещё одна отдельная вещь: он помогает модели продолжить, но не обязан содержать каждое согласование, аргумент инструмента или побочный эффект.
Внешний сервис владеет авторитетным результатом публикации. Он может предлагать ключ идемпотентности, проверку статуса по ID операции или запрос объекта с ожидаемым хэшем. Если он не предлагает ничего из этого, рантайм не может вывести успех из отсутствия ответа. Трейс может показать, что запрос был отправлен и сколько он длился, но спан, закончившийся таймаутом, не может решить, зафиксировал ли его удалённый сервис.
Разница проявляется, когда вы проигрываете старое состояние заново. Replay чекпоинтов в LangGraph заново выполняет шаги после выбранного чекпоинта, включая API-запросы на этих шагах. Это функция для отладки и управления потоком, а не гарантия exactly-once для внешних эффектов. То же правило действует для нового воркера, который возобновляет работу после сбоя.
Одна публикация с неизвестным результатом, шаг за шагом
Отчёт одобрен и сохранён под стабильным ID артефакта. Теперь харнесс просит рантайм опубликовать его. Предположим, что сервис публикации может выполнить запрос, даже если воркер потеряет ответ.
- Запишите намерение. До того как запрос покинет воркер, сохраните ID операции, принадлежащий приложению, хэш одобренного артефакта, место назначения и статус
pending. Привяжите этот ID к этим аргументам. ID tool call, сгенерированный моделью, может измениться после перепланирования; он не идентифицирует бизнес-действие. - Отправьте действие. Передайте тот же ID операции сервису публикации, если его API поддерживает идемпотентность. Если нет, используйте стабильный ключ объекта или другой поддерживаемый провайдером способ проверить результат. Воркер не должен считать, что таймаут означает, что сервис ничего не сделал.
- Запишите результат. При подтверждённом ответе сохраните ID внешнего результата и отметьте операцию завершённой, прежде чем продолжать запуск. Тогда следующий чекпоинт может ссылаться на этот результат.
- Восстановите результат. Допустим, сервис принял отчёт, но воркер упал до шага 3. Новый воркер видит
pending. Он спрашивает сервис, существует ли та же операция или артефакт. Если да, он записывает восстановленный результат и продолжает, не публикуя вторую копию. Если повтор поддерживается, он использует тот же ID операции и неизменённые аргументы. - Остановитесь при неопределённости. Если сервис не может ответить и не обещает идемпотентных повторов, оставьте операцию нерешённой для проверки человеком. Новый ключ и повторная отправка запроса были бы новым действием с риском двойной публикации.
Последовательность ниже показывает сбой на шаге 4, между внешним успехом и локальным сохранением результата.
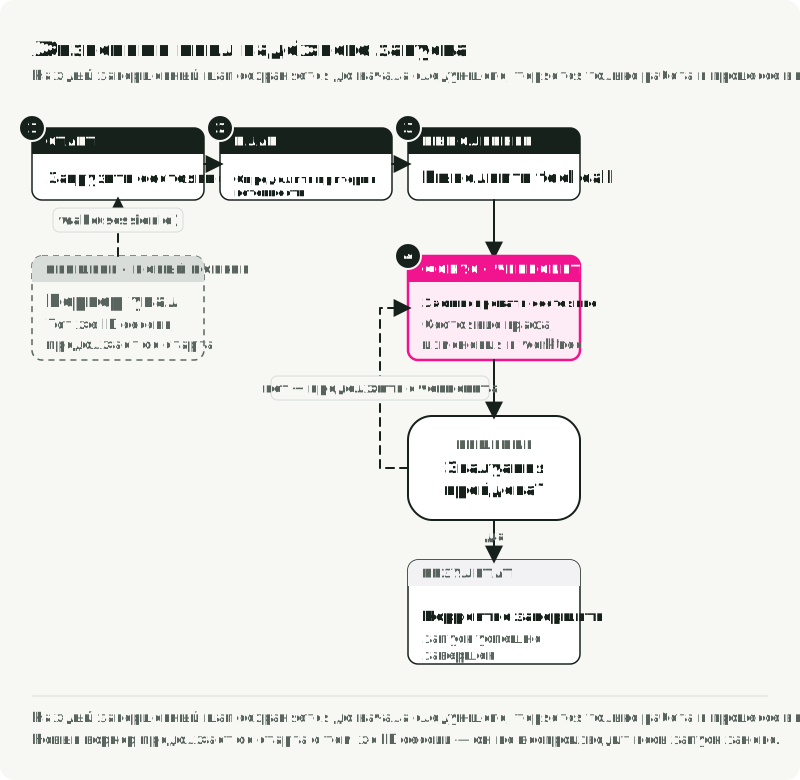
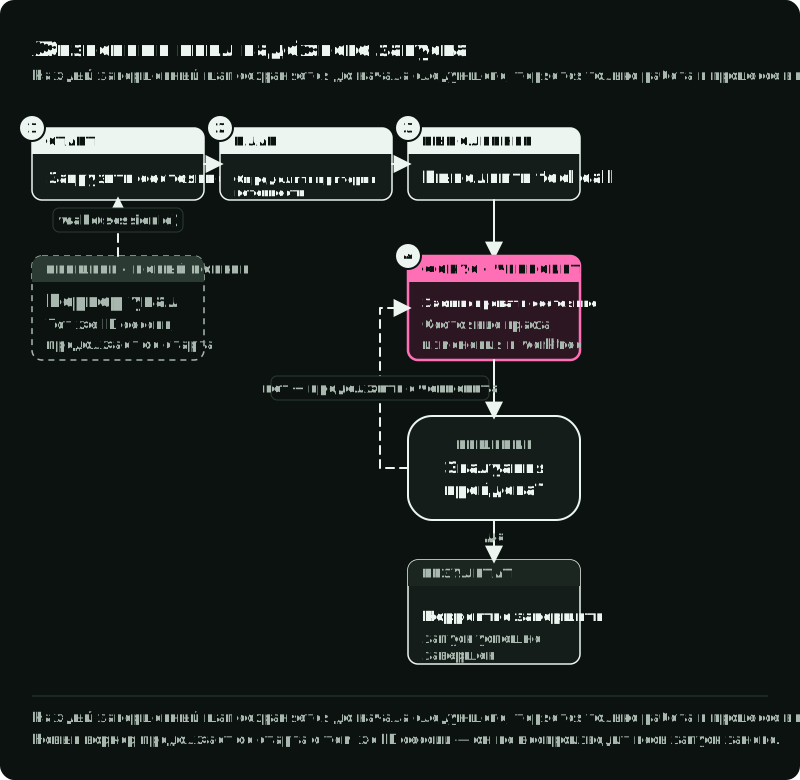
Diff рабочего пространства на схеме — это восстанавливаемая версия файла или ссылка на неё; чекпоинт графа не обязан содержать сами файлы.
Проектировать нужно под случай сбоя между внешним успехом и локальным сохранением результата. Ни одна транзакция базы данных не может атомарно зафиксировать запись в независимом сервисе без участия этого сервиса. Материал AWS об идемпотентных API объясняет, почему ID запроса, переданный вызывающей стороной, выражает намерение: два одинаковых запроса могут быть двумя желаемыми действиями, а два повтора с одним ID должны означать одно. Принимающий сервис должен соблюдать этот контракт и обнаруживать изменённый payload под тем же ID. Проверьте срок дедупликации; истёкший ключ — не вечное обещание. Stripe, например, возвращает первый результат для повторного ключа идемпотентности и может удалять ключи не раньше чем через 24 часа.
Тот же протокол подходит для отправки письма, списания средств со счёта, открытия pull request или изменения базы данных, которой владеет другой сервис. Отличается способ согласования. Например, провайдер может поддерживать ключи идемпотентности, ограничение уникальности ресурса, проверку чтением после записи или не иметь надёжного запроса вообще. Политику повторов проектируйте из этого контракта, а не из того, что фреймворк агента умеет повторить узел.
Сделайте восстанавливаемым остальной запуск
Внешний вызов с неизвестным результатом — самый сложный случай. Остальному запуску тоже нужны несколько явных правил:
- Один активный процесс записи. Очередь может повторно доставить задачу после истечения lease. Используйте lease запуска с fencing или условными обновлениями статуса, чтобы устаревший воркер не мог продвинуть запуск. Сохраняйте защиту идемпотентностью для уже отправленных вызовов. Подтверждайте задачу только после того, как соответствующее ей состояние надёжно сохранено. Восстановление начинается с проверки ожидающих операций, а не со слепого перезапуска модели. Решите, что означает новый ввод пользователя во время запуска: отклонить его, поставить в очередь, прервать или откатить; материал LangChain о рантайме Deep Agents описывает эти варианты.
- Надёжное ожидание. Если публикация требует согласования, сохраните предложенное действие и его точные аргументы. Возобновляйте работу с решением о согласовании и перепроверяйте его, если предложенное действие изменилось. Не держите процесс воркера открытым только ради ожидания человека.
- Ограниченный запуск. Сохраните дедлайн, лимиты вызовов или инструментов и допустимые расходы. Резервируйте бюджет до параллельной отправки, чтобы два вызова не потратили один и тот же остаток; фактическое потребление сверяйте после. Отмена останавливает новые вызовы и записывает запрос, но не может отменить внешний эффект, который уже выполняется. Алерт по метрикам или бюджет на стороне провайдера, например бета-функция Anthropic task budgets, — второй сигнал; модель может превысить рекомендательный бюджет, поэтому журнал отправок нужен в любом случае.
- Восстанавливаемая работа. Храните ссылку на одобренный артефакт, его хэш и версию рабочего пространства, из которой он получен. Восстановленный процесс должен иметь возможность проверить файл перед публикацией. Большим файлам место в хранилище артефактов, а не в каждом чекпоинте графа.
- Граница выполнения. Если инструмент запускает сгенерированный код, устанавливает пакеты или открывает недоверенные страницы, запускайте его в окружении с нужными ограничениями на файлы, сеть и процессы. Держите долгоживущие учётные данные вне контекста, видимого модели; проверяйте разрешения там, где выполняется действие. Контейнер или отдельный checkout на worktree сам по себе не даёт изоляции, которой может требовать ваша модель угроз.
В LangGraph выбирайте надёжность чекпоинтов осознанно. Режим "sync" сохраняет каждый чекпоинт до начала следующего шага; "async" может потерять недавний чекпоинт при падении процесса, а "exit" не сохраняет промежуточный прогресс на случай сбоя посреди запуска. Даже "sync" не закрывает описанный выше разрыв с внешними эффектами. Лог событий и логика согласования остаются работой приложения.
Отказы, которые добавляют долгие запуски
Когда запуски проходят через несколько воркеров и контекстных окон, отказы смещаются к состоянию, двойным побочным эффектам, расхождению рабочего пространства и стоимости. Каждому нужен контроль вне памяти модели, чтобы он работал и после перезапуска. На схеме каждый контроль стоит на том шаге цикла запуска, где он работает; таблица добавляет, где он реализован.
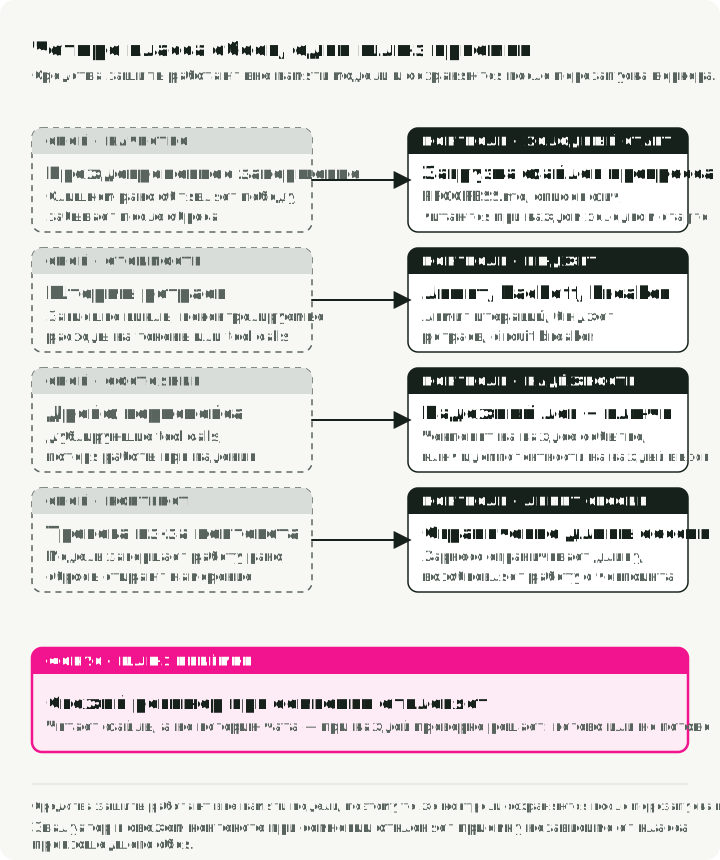
| Отказ | Контроль | Где он работает |
|---|---|---|
| Агент слишком рано объявляет задачу выполненной | Приёмочные проверки артефактов; при желании эвалуатор со свежим контекстом без инструментов записи | Шаг завершения в харнессе; эвалуатор в собственной сессии сэндбокса |
| Агент забывает сделанную работу после сброса контекста | Файлы прогресса, такие как PROGRESS.md и feature-list.json, которые читаются до первого вызова модели | Boot hook каждой сессии модели |
| Модель подводит итог и останавливается у своего лимита | Ограничьте длину сессии и начните новую из handoff и чекпоинта | Лимит длины сессии в харнессе |
| Зацикливание и повторы без лимита | Лимит итераций, экспоненциальный backoff, circuit breaker по доле ошибок инструментов, жёсткий бюджет tool calls | Узел выполнения инструментов; RetryPolicy для Temporal Activities |
| Агент меняет файлы, которые принадлежат другому запуску | Рабочее пространство на запуск, коммиты Git как точки восстановления, файловая политика сэндбокса или прокси | Политика сэндбокса; разрешения Deep Agents для встроенных файловых инструментов |
| Расходы на токены или инструменты выходят из-под контроля | Резервируйте бюджет до отправки, ограничивайте вывод, сверяйте потребление | Журнал бюджета на пути отправки; алерты Prometheus как второй сигнал |
| Tool call выполняется дважды после сбоя | Сохраняйте pending и ключ идемпотентности до отправки; при возобновлении проверяйте или повторяйте с тем же ключом | Хранилище событий плюс API идемпотентности или проверки у провайдера |
| Работа теряется, когда падает воркер или сэндбокс | Надёжный лог событий, чекпоинт после каждого super-step, согласование ожидающих эффектов перед продолжением | PostgresSaver плюс таблица событий или Temporal Workflow |
Quick-start Anthropic cwc-long-running-agents включает паттерны эвалуатора и файлов прогресса. Ранняя остановка у лимита контекста зависит от модели, поэтому перепроверяйте любой обходной путь при смене модели. По словам Anthropic, каждый компонент харнесса кодирует предположение о том, чего модель не умеет, и это предположение может устареть при смене модели.
Транспортные сбои, с которыми цикл должен справляться
Стрим может закрыться посреди ответа. Соединение может оборваться, когда пришла лишь половина ответа или половина tool call. Аргументы инструмента приходят фрагментами JSON, которые разбираются только после завершения блока, поэтому частично собранный вызов ни в коем случае не должен попасть в отправку. Выполнение обрезанной команды — именно то, для предотвращения чего существует слой разрешений. Считайте оборванный стрим неудавшимся запросом: отбросьте фрагмент, никогда не добавляйте его как нечто сказанное моделью и повторите весь вызов. Это по карману, потому что уже отправленный префикс при повторе читается из кэша. Держите повтор ниже агентного цикла, в обёртке вызова, чтобы повторённый запрос никогда не перезапускал инструмент, который уже отработал.
Стриминг тоже перестаёт быть необязательным по мере роста запросов. Провайдеры вводят таймауты для запросов без стриминга и требуют стриминг при выводе больше определённого размера, а SDK могут стримить под капотом при долгих вызовах. Поэтому продакшен-рантайм обычно стримит всё и накапливает результат, даже если ни одному интерфейсу фрагменты не нужны. Приходящие токены тогда служат и сигналом живости: пока они поступают, вызов жив, так что стрим, молчащий минуту, — свидетельство зависания. Запрос без стриминга ничего не говорит, пока не вернётся.
Лимиты скорости считаются в токенах, а не в запросах. Провайдеры считают входные и выходные токены в минуту, поэтому агент с большим запросом выбирает лимит при частоте запросов, которая выглядит смехотворно низкой. Рост контекста поэтому проявляется в виде ответов 429, а не проблемы с латентностью, а параллельный fan-out умножает нагрузку на размер каждого запроса, а не на число воркеров. Ограничьте конкурентность и держите один общий бюджет токенов в компоненте, который запускает параллельную работу; backoff внутри каждого воркера лишь растягивает тот же спрос во времени. Считайте ответы 429 и использованный эндпоинт для каждого запуска, чтобы лимит провайдера не приняли за свойство тестируемой конфигурации.
Рантайму также нужны данные для диагностики запуска. Передавайте ID запуска и ID операции вместе со спанами модели и инструментов, статусом, длительностью и расходом токенов. Конвенции GenAI в OpenTelemetry дают этим полям общие имена, хотя конвенции ещё развиваются. Текст промптов, аргументы инструментов и результаты могут содержать чувствительные данные; решите, место ли им в телеметрии, до того как их собирать. Трейс помогает объяснить сбой. Безопасно ли продолжать, решают лог событий и внешняя проверка. Раздел про observability ниже превращает это в стек.
Выбирайте форму деплоя по правилам ожидания и отказов
Название платформы — позднее решение. Сначала спросите, нужен ли вызывающей стороне итоговый результат в том же запросе, может ли запуск ждать и кто будет эксплуатировать его состояние в постоянном хранилище.
| Потребность | Отправная форма | Что ещё нужно |
|---|---|---|
| Короткая задача, выполняемая в одном запросе | Агентный цикл в обработчике запроса | Отдельная граница выполнения для недоверенных инструментов; состояние в постоянном хранилище, если важны повтор или продолжение |
| Фоновая работа, которая может пережить один воркер | Очередь, заменяемый воркер, состояние в постоянном хранилище | Lease запусков, чекпоинты, лог операций, хранилище артефактов по необходимости |
| Много согласований, таймеров, callbacks или повторов между деплоями | Надёжный workflow-движок с воркерами для вызовов модели и tool calls | Изменения workflow, безопасные для replay, и идемпотентные внешние activities |
Длительность запуска — полезный первый фильтр, хотя всю архитектуру она не определяет. На схеме каждая начальная форма стоит на логарифмической шкале длительности запуска, над лимитами времени распространённых платформ:
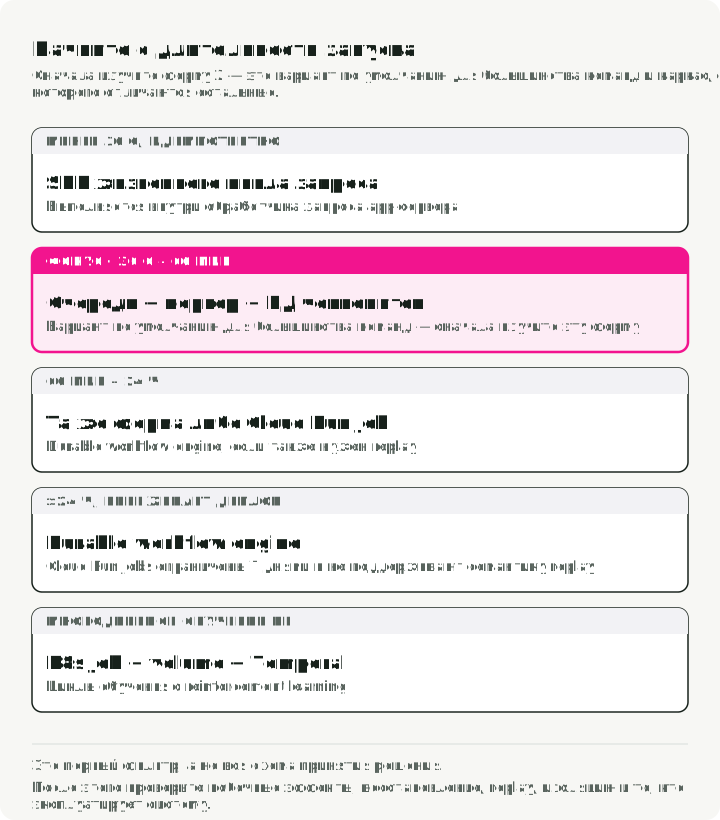
- До 30 секунд, идемпотентно: SDK агента внутри обработчика запросов app-сервера.
- От 30 секунд до 60 минут: очередь, воркер и база данных чекпоинтов.
- От 60 минут до 24 часов: те же очередь и воркер или Cloud Run Job для разовой работы; workflow-движок, если также нужны версионирование и replay.
- Больше 24 часов с переживанием деплоев: надёжный workflow-движок, например Temporal.
- Многодневные циклы обучения с подкреплением: Kubernetes Job с томом плюс Temporal.
После этого фильтра проверьте побочные эффекты, восстановление, replay, изоляцию, расположение данных и команду, которая будет эксплуатировать систему.
Пример с отчётом я бы начал с очереди и воркера. API возвращает ID запуска; воркер продвигает харнесс; надёжное хранилище записывает чекпоинты и ожидающие операции; хранилище артефактов держит отчёт. Такая архитектура покрывает конкретные требования к перезапуску и согласованию, не привязываясь к определённому облаку. Если правила ожидания и повторов превращаются в отдельный workflow, Temporal может сохранять историю выполнения и проигрывать решения workflow заново. Его Activities по-прежнему выполняют внешние вызовы и могут повторяться, поэтому им нужна та же схема идемпотентности или согласования.
Облачные сервисы реализуют эти формы; их таймауты не определяют архитектуру. Запрос к сервису Cloud Run имеет дедлайн и может продолжать обработку после закрытия соединения, так что HTTP-таймаут особенно плохо доказывает, что действие остановилось. Cloud Run Job, задача ECS или Kubernetes Job могут размещать фоновый воркер, но большой лимит на задачу сам по себе не даёт надёжного прогресса. У обычного вызова AWS Lambda предел 15 минут; workflow может охватывать несколько ограниченных вызовов. Перед деплоем проверьте текущие лимиты и поведение повторов выбранного сервиса.
Хостинговая платформа агентов может эксплуатировать цикл и часть его состояния за вас. Оцените её по тому же сценарию отказа: как экспортировать состояние запуска, найти ожидающий побочный эффект, привязать согласование к действию, проверить данные, отправленные в control plane, и возобновить работу после деплоя? Разделяйте контракт сэндбокса платформы и контракт её харнесса. Хостинг харнесса не делает его инструменты безопасными автоматически, а хостинг сэндбокса не делает запуск надёжным автоматически.
Что даёт каждая форма
Матрица называет компонент, который обеспечивает каждую обязанность в каждой форме, отмечает ячейки, которые обслуживает хостинг-провайдер, и выделяет ячейки, которых самих по себе недостаточно. Заметки после неё дают лимиты, по которым делается выбор; данные проверены в сентябре 2026 года.
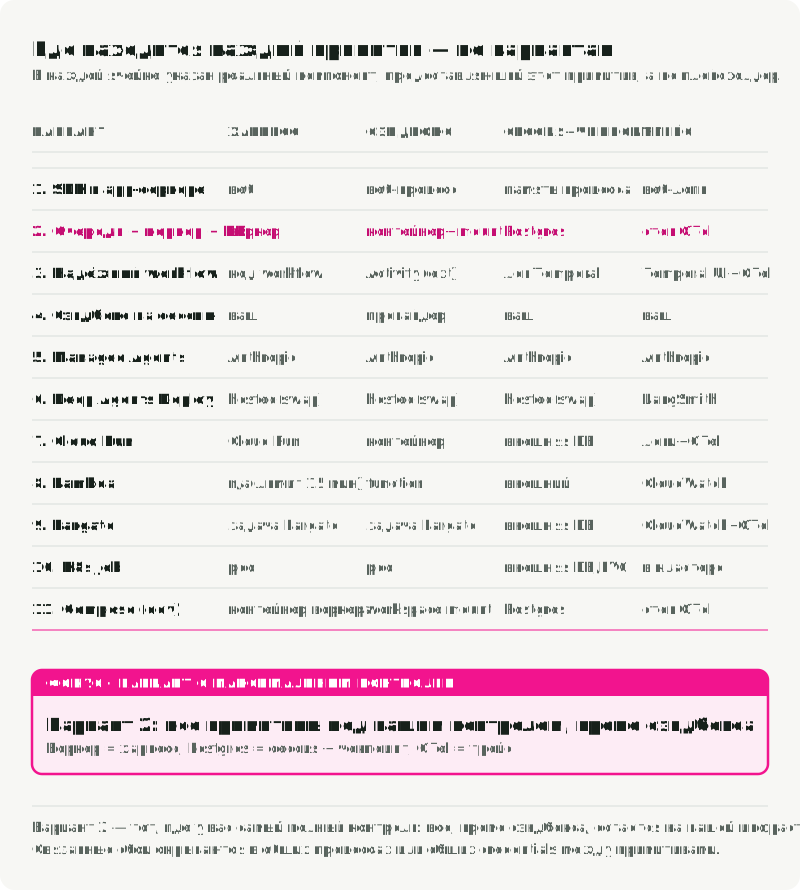
1. SDK внутри сервера приложения. Агент работает в обработчике запроса. Это подходит для задач примерно до 30 секунд, демо и внутренних инструментов. При сбое веб-уровня работа в памяти теряется. Отключение клиента может отменить работу или оставить её выполняться, в зависимости от сервера и приложения; оно не определяет результат внешнего действия. Сохраняйте состояние, если важно продолжение, и не используйте обработчик запроса для многочасовой работы.
2. Очередь, воркер и база данных чекпоинтов. Вариант по умолчанию, который я рекомендую большинству команд: Python-воркер с PostgreSQL checkpointer и Redis Streams или RabbitMQ для входящих задач. Market Analyst Agent демонстрирует эту форму с отдельно запускаемым воркером очереди. В продакшен-архитектуре приложение создаёт строку запуска, отправляет задачу в очередь и возвращает ID запуска; воркер запускает харнесс, пишет события и чекпоинты и сохраняет артефакты. Размер очереди обеспечивает backpressure, а spot- или preemptible-вычисления подходят, если данные сохранены до того, как воркер подтвердит задачу. Воркер и есть харнесс; недоверенному коду всё равно нужен защищённый сэндбокс.
3. Надёжный workflow-движок. Оркестрация агента работает внутри Temporal Workflow, а вызовы модели и tool calls выполняются как Activities. Состояние workflow хранится в истории событий на Cassandra, MySQL или PostgreSQL, поэтому оно проигрывается заново после сбоев, а простаивающий workflow не потребляет вычислений. Согласование человеком становится надёжным ожиданием вместо цикла опроса. Изменения кода, которые пересекаются с выполняющимся запуском, требуют безопасного для replay Worker Versioning или патчей. Интеграция Temporal с OpenAI Agents SDK запускает инструменты агента как Activities; прежде чем на неё полагаться, проверьте список неподдерживаемых функций агента.
4. Провайдер сэндбоксов на каждый запуск. Каждый запуск получает от провайдера собственную microVM или контейнер, а харнесс, сессия, чекпоинт и трейс остаются на вашей стороне, обычно в форме 2. Используйте это, когда агент запускает недоверенный код, автоматизацию браузера, тесты или установку пакетов; цена — более высокие расходы и привязка к провайдеру.
| Провайдер | Изоляция | Лимиты сессий и хранения |
|---|---|---|
| E2B | Firecracker microVM | Непрерывные сессии: 1 ч на Hobby, 24 ч на Pro; пауза и возобновление отдельно |
| Vercel Sandbox | Firecracker microVM | 45 мин на Hobby, 24 ч на Pro и Enterprise; снапшоты по умолчанию истекают через 30 дней после последнего использования |
| Daytona | Сэндбокс, настроенный провайдером | Настраиваемый жизненный цикл остановки и архивации; форки записывают своего родителя |
| Modal | gVisor | 5 мин по умолчанию, максимум 24 ч; для томов и снапшотов действуют отдельные правила хранения |
| Runloop | microVM, согласно описанию в Marketplace | Приостановка и возобновление; снапшоты дисков и ветки |
Цифры времени запуска у провайдеров измеряют разные интервалы, поэтому это не рейтинг скорости. Загрузка контейнера Modal примерно за секунду, например, не включает запуск приложения. Измеряйте время от API-запроса до первой успешной команды и до состояния готовности приложения на нужных вам p95 и p99 и проверяйте лимиты параллелизма аккаунта до нагрузочного тестирования.
5. Anthropic Managed Agents. Хостинговые сессия, харнесс, сэндбокс и MCP-прокси с хранилищем секретов, в публичной бете с 8 апреля 2026 года. Тарификация — стандартные цены за токены плюс $0.08 за час сессии, пока сессия работает; время простоя бесплатно, пакетного режима у сессий нет. Сессия, работающая непрерывно, стоит около $58 в месяц без учёта токенов. Сервис недоступен через Bedrock или Vertex AI. С self-hosted сэндбоксами вы сами управляете выполнением и исходящим трафиком, но входные данные и результаты инструментов всё равно попадают в control plane Anthropic. Последующий отказ от сервиса требует перехода на другую платформу.
6. LangChain Deep Agents Deploy. deepagents deploy упаковывает deepagents.toml в LangSmith Deployment с надёжным выполнением, памятью, human-in-the-loop, кодом в сэндбоксе и запусками по расписанию, в облачном, гибридном или self-hosted режиме. Провайдер сэндбоксов (LangSmith Sandboxes, Daytona, Modal, Runloop или собственный) задаётся одним значением конфигурации. Харнесс распространяется под лицензией MIT и использует открытый формат AGENTS.md, поэтому привязка к вендору слабее, чем в форме 5.
7. Google Cloud Run. Сервис обрабатывает HTTP и масштабируется до нуля; таймаут запроса по умолчанию 300 секунд, максимум 60 минут. Job выполняется до завершения без HTTP; задачи по умолчанию ограничены 10 минутами, максимум 168 часов (7 дней), или 1 час с GPU. Используйте сервис для синхронных запусков до 60 минут, а job — для более долгой разовой работы. Ни один из них не хранит состояние между запусками и не проигрывает его заново между деплоями, поэтому сессии и чекпоинты идут в PostgreSQL, Spanner или похожее хранилище.
8. AWS Lambda. Функция завершается по таймауту через 15 минут. За API Gateway синхронный запрос получает около 30 секунд, если Regional или private REST API не повышает лимит. Lambda durable functions, запущенные в декабре 2025 года, добавляют чекпоинты, шаги и ожидания между выполнениями длительностью до одного года, при этом каждый вызов остаётся ограниченным.
9. AWS ECS или Fargate, одна задача на запуск. У Fargate нет документированного предела времени работы, и в режиме awsvpc каждая задача получает собственный сетевой интерфейс, что подходит для доступа к данным внутри VPC. Он не поддерживает GPU; для них используйте ECS на EC2. Fargate Spot добавляет риск прерывания, а надёжность — ваша забота. Сравните также Amazon Bedrock AgentCore Runtime, который размещает код агента с управляемыми сессиями до 8 часов на serverless microVM или до 14 дней на типе вычислений Instances с поддержкой GPU.
10. Kubernetes Job на каждый запуск. Один Job на запуск с activeDeadlineSeconds, PersistentVolumeClaim для рабочего пространства и MCP-sidecar. Подходит командам, которые уже эксплуатируют Kubernetes; холодный старт исключает его, если нужен запуск быстрее секунды, а восстановление после сбоев придётся строить самим. Сильная изоляция по-прежнему зависит от runtime class, network policy и pod security. Для выполнения на GPU нужны GPU-узлы, драйверы и device plugin.
11. Локальный Docker Compose, только для разработки. Учебный проект запускает приложение Gradio и хранилища из формы 2 с томом рабочего пространства и без защищённого сэндбокса. Его воркер очереди запускается отдельно. Эталонный стек ниже различает эти процессы.
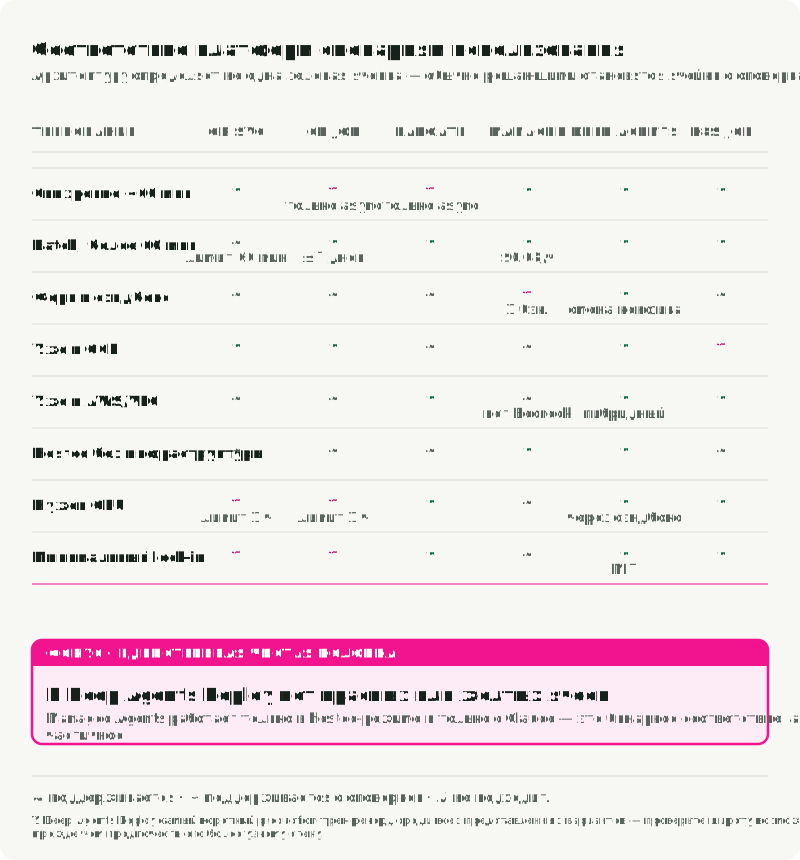
В матрице выбор обычно решают ячейки с оговорками, а не галочки. Широкое покрытие не показывает размещение данных, семантику replay, зависимость от провайдера и стоимость переноса состояния в будущем.
Хостинговый или собственный харнесс. Хостинговый означает, что цикл запускает вендор, а вы вызываете API; собственный — что цикл запускаете вы, даже если код написал вендор. LangChain есть по обе стороны: LangGraph — библиотека, которую вы запускаете сами, а Deep Agents Deploy в облачном режиме запускает харнесс за вас. Выбирайте хостинговый, если его поддержка моделей, граница данных, поведение при восстановлении и точки расширения уже подходят. Выбирайте собственный, если ожидаете, что эти требования изменятся, и проверьте путь ухода до того, как от него начнут зависеть продакшен-данные.
Хостинговый сэндбокс или собственное окружение выполнения. Берите хостинговый сэндбокс, если его изоляция, пауза и возобновление или поведение форков соответствуют модели угроз и бюджету на запуск. Docker или Fargate подходят для доверенной внутренней работы, которой нужен доступ к VPC или строгое размещение данных, но стандартного контейнера недостаточно для враждебного кода; варианты изоляции разобраны в части 4.
Граница состояния в приложении на LangGraph
Следующий фрагмент показывает только часть формы с очередью и воркером, которая относится к состоянию графа. Предполагается, что builder — существующий StateGraph, run_id — надёжный идентификатор запуска, а task — новый запрос. У воркера есть подключение к PostgreSQL в DATABASE_URL и право создавать таблицы checkpointer. Это иллюстрация связки, а не полный воркер публикации.
import os

from langgraph.checkpoint.postgres import PostgresSaver

with PostgresSaver.from_conn_string(os.environ["DATABASE_URL"]) as checkpointer:
    checkpointer.setup()  # once during setup or migration
    graph = builder.compile(checkpointer=checkpointer)
    graph.invoke(
        {"messages": [{"role": "user", "content": task}]},
        {"configurable": {"thread_id": run_id}},
        durability="sync",
    )
thread_id — ключ поиска чекпоинтов в LangGraph, а не ID операции и не доказательство того, что публикация произошла. Приложению всё равно нужно сохранять строку запуска, одобренный артефакт, ожидающую операцию и её результат. Ему также нужно забирать прерванные задачи и решать, что означает новый ввод во время активного запуска. Не возобновляйте узел публикации с неизвестным результатом простым повторным вызовом. Сначала согласуйте, затем передайте восстановленный результат графу.
Git, база данных чекпоинтов и объектное хранилище
Долгие запуски обычно используют сразу три хранилища, потому что каждое держит свой артефакт.
- Git хранит рабочее пространство: код, документы и файлы прогресса. Используйте его, когда работа похожа на код или важна история файлов. Создайте ветку запуска, сделайте коммит инициализации и коммитьте после настройки, после каждой фичи и после прохождения тестов. Храните SHA последнего коммита рядом с чекпоинтом. При возобновлении следующий воркер переключается на ветку, читает
git log --oneline -8, смотритgit statusи последний diff, затем читает файл handoff. Git не может сказать, какой узел графа выполняется следующим, какой вызов ждёт согласования или какой повтор использовал свой ключ идемпотентности. Не используйте его, если продукт — единственный ответ. - База данных чекпоинтов хранит состояние графа: что было решено, какие узлы выполнились и что выполняется дальше. Используйте чекпоинтинг в стиле
PostgresSaver, когда важно промежуточное состояние между узлами, например между планировщиком, исследователем, автором и проверяющим. - Объектное хранилище, например S3 или GCS, хранит большие результаты: PDF, файлы Parquet, скриншоты. Используйте его, когда результат слишком велик для базы данных чекпоинтов, когда потребителям нужен URL без обращения к агенту или когда у результата и запуска разные сроки хранения. Логи запусков можно удалять через 30 дней, а итоговый отчёт хранить годами. Используйте для объектов ключ
(thread_id, checkpoint_id, artifact_name), чтобы запуск, который их создал, оставался отслеживаемым.
Эталонный стек в Docker Compose
Market Analyst Agent — учебный проект к этой серии. Из корня его репозитория, при наличии Docker Compose и .env, подготовленного из .env.example, make docker-up использует docker/docker-compose.yml для запуска PostgreSQL, Qdrant, Redis и приложения. Команда приложения по умолчанию запускает интерфейс Gradio, который синхронно вызывает харнесс. make worker отдельно запускает потребителя очереди Redis; ему нужны uv и Python 3.13+, он устанавливает зависимости проекта и запускает базы данных. Настройте ключи провайдеров в .env перед анализом с реальными вызовами. make mcp-up и make observability-up включают опциональные профили MCP и observability.
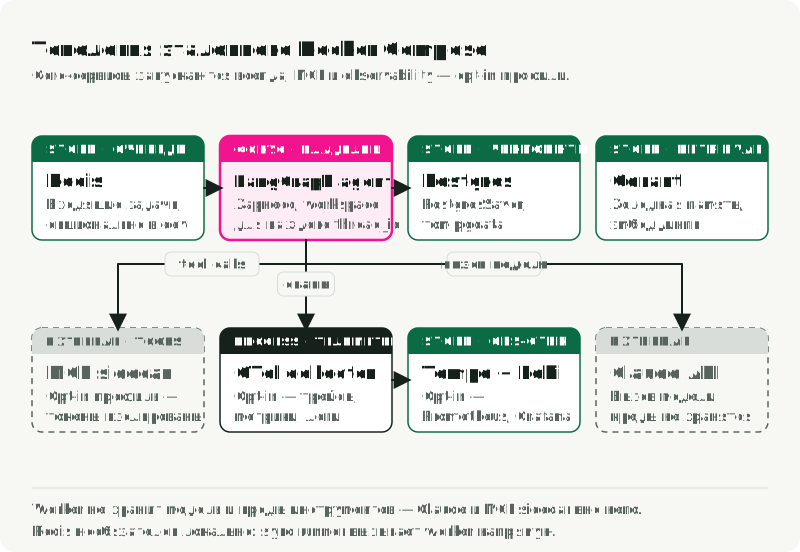
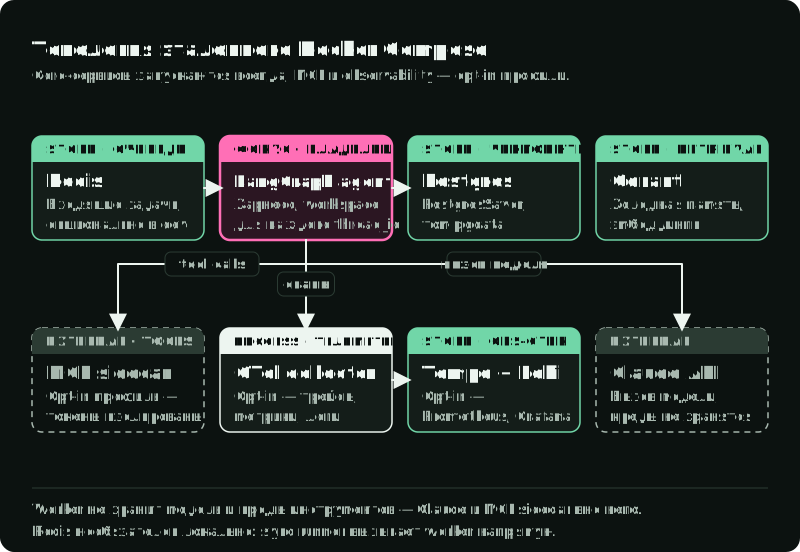
Настроенные маршруты observability неполны. У Collector есть только пайплайн трейсов в Tempo. Его включающий фильтр strict сравнивает gen_ai.operation.name с литералом .+, поэтому обычные значения вроде chat и execute_tool не совпадают и исключаются; код сравнения Collector 0.117.0 подтверждает проверку равенства. Prometheus напрямую собирает метрики app:9464 и собственные метрики Collector; метрики приложения требуют METRICS_ENABLED=true. Для экспорта трейсов приложения также нужен OTLP endpoint. У Loki есть бэкенд и источник данных Grafana, но нет настроенного входа логов. Исправьте фильтр трейсов и добавьте сбор логов, прежде чем ожидать заполненные трейсы и логи; запуск контейнера не доказывает, что дашборды работают.
Для контейнера воркера добавьте отдельный сервис воркера и дайте параллельным процессам записи один и тот же том рабочего пространства; приложение Compose по умолчанию не является потребителем очереди. В продакшене добавьте рядом с чекпоинтами таблицу событий для намерений и результатов инструментов и протестируйте сверку состояния для своих внешних действий.
Разбор запуска после его завершения
Когда шестичасовой запуск падает, вызвавшее сбой событие могло произойти несколькими часами раньше, а воркер, который его породил, уже заменён. Вы отлаживаете по записям, сделанным, пока запуск выполнялся. Две записи читают после запуска: лог событий каждого шага с возможностью запросов и трейсы того, куда ушли время и токены. Две читают во время запуска: текущее представление изменений рабочего пространства и стек observability на каждый worktree, к которому может обращаться сам агент.
Обе записи, которые читают после запуска, не обязательно содержат запрос в том виде, в каком он в итоге покинул процесс, то есть после сборки инструкций, retrieval, сжатия контекста и прохода через любой middleware. Запись в логе событий и спан описывают, что вызов модели произошёл и сколько он стоил. Если вопрос в том, что модель получила, нужен отдельный захват, сделанный в последней точке перед уходом вызова и хранящийся там, куда вы позже пойдёте за ответом на этот вопрос.
Лог событий. Каждый вызов модели, tool call, результат, ошибка и согласование с ключом по ID запуска и временной метке, доступные для запросов, как любая таблица. Addy Osmani формулирует критерий: если вы не можете восстановить по надёжному хранилищу, что агент делал последние 24 часа, у вас shell-скрипт, который вызывает модель, а не долгоживущий агент.
Трейсы OpenTelemetry GenAI. Спаны несут стандартные атрибуты gen_ai.*: модель, провайдер, количество токенов, ID диалога и название workflow. В 2026 году конвенции переехали в собственный репозиторий и всё ещё имеют статус стабильности Development, поэтому зафиксируйте ревизию, которую вы проверили. На бэкендах, которые их поддерживают, можно менять место назначения без повторного инструментирования кода.
Изменения рабочего пространства во время запуска. Quick-start Anthropic следит за рабочим пространством. watch -n 5 'git log --oneline -8' каждые пять секунд показывает последние коммиты, а папка скриншотов, отсортированная по времени, показывает, что агент видел последним. Считайте и то и другое признаками активности и сверяйте их с результатами тестов, прежде чем решить, что запуск продвигается.
Стек на каждый worktree для агента. В материале OpenAI о харнессе каждый worktree Codex получает собственные короткоживущие логи, метрики и трейсы, к которым агент обращается во время работы. Так требование вроде «ни один спан в этих четырёх пользовательских сценариях не длится дольше двух секунд» становится тем, что агент может проверить.
Минимальный self-hosted стек для агента вроде Market Analyst Agent:
- OpenTelemetry Collector, который принимает спаны и может фильтровать поля
gen_ai.*перед экспортом. - Tempo или Jaeger для трейсов с ключом по
gen_ai.conversation.idилиthread_id. - Loki для записей лога событий.
- Prometheus для GenAI-метрик токенов и латентности.
- Дашборды Grafana с ключами по
gen_ai.agent.nameиgen_ai.request.model.
Если вы предпочитаете хостинговый сервис, выберите один: LangSmith для LangGraph и Deep Agents Deploy, Braintrust, когда на первом месте наборы эвалов, Arize Phoenix для open-source OTLP с OpenInference, дашборд трейсинга OpenAI для Agents SDK или трейсинг Anthropic для Managed Agents.
Задавайте стандартные атрибуты на каждом спане модели, как минимум операцию, провайдера, модель, ID диалога, название агента и количество токенов. Три панели дашборда покрывают большую часть отладки: выходные токены на агента в час, латентность модели p95 по моделям и tool calls, которые длились дольше 30 секунд.
Когда запуск падает, пусть воркер пишет отладочный пакет в /workspaces/${THREAD_ID}/_debug/:
events.jsonl: экспортированный лог событий с намерениями, результатами, согласованиями и ошибками.checkpoints.jsonl: история состояния графа изcheckpointer.list({"configurable": {"thread_id": ...}}), помеченная как чекпоинты.last_state.json:StateSnapshot.valuesиз последнего успешного super-step.trace.json: экспортированные спаны запуска с учётом политики сбора содержимого.tool_calls.csv:(ts, tool, input_hash, latency_ms, status, error).workspace.tar.zst: рабочее пространство плюсgit diffотносительно коммита инициализации.screenshots/*.png,PROGRESS.md,feature-list.jsonи другие файлы прогресса.env.txt: теги образов, версия модели и SHA коммита харнесса.
С ним в отчёте можно написать «запуск s_123 потратил 71 процент токенов, повторяя три команды после сбоя npm install», а не «агент застрял».
Тесты с точками сбоя
Успешный запуск без прерываний мало говорит о восстановлении. Для примера с отчётом внедрите остановку в трёх точках: до фиксации ожидающей операции, после того как сервис публикации принял запрос, но до сохранения результата, и во время ожидания согласования. Перезапустите с новым воркером и проверьте количество опубликованных артефактов, записанное согласование и итоговый статус операции. Именно средний случай выявляет двойные побочные эффекты.
Также проверьте два воркера, которые забирают один и тот же запуск, отмену во время выполняющегося вызова и провайдера, который не может подтвердить действие, завершившееся таймаутом. Правильным результатом последнего случая может быть needs_human, а не ещё один запрос. Изучите лог событий и трейс, чтобы объяснить каждый результат. Тест восстановления завершён только тогда, когда внешнее состояние совпадает с записанным состоянием запуска.
Прежде чем выпускать долгоживущего агента, ответьте на эти вопросы в терминах инфраструктуры:
- Какое хранилище владеет событиями запуска и чекпоинтами?
- Что происходит, если воркер падает посреди tool call?
- Может ли один запуск повредить рабочее пространство другого?
- Какие действия требуют согласования?
- Может ли модель или сэндбокс прочитать учётные данные в открытом виде?
- Какие tool calls можно безопасно повторять?
- Где применяется лимит стоимости на запуск?
- Какие детерминированные данные решают о завершении и каким критериям нужен проверяющий?
- Где хранятся итоговые результаты после того, как сэндбокс удалён?
- Сможем ли мы завтра объяснить упавший запуск, не запуская его заново?
Если ответ звучит как «промпт велит агенту быть осторожным», система всё ещё демо.
Это часть 5 серии Engineering the Agentic Stack. Часть 6, харнесс-инжиниринг для ИИ-агентов, разбирает цикл внутри этого рантайма: как авторизовать предложенное действие, передать работу свежему контексту и по независимым данным решить, что задача выполнена.
Источники
Инженерные материалы
- OpenAI, Harness engineering: leveraging Codex in an agent-first world.
- Anthropic Engineering, Effective harnesses for long-running agents.
- Anthropic Engineering, Harness design for long-running application development.
- Anthropic Engineering, Scaling Managed Agents: Decoupling the brain from the hands, 8 апреля 2026 года.
- Addy Osmani, Long-running Agents.
Фреймворки и SDK
- LangGraph, Checkpointers и
langgraph-checkpoint-postgres. - LangChain, Deep Agents overview, permissions и The runtime behind production Deep Agents.
- OpenAI Agents SDK, Sessions и Sandbox guide.
- Temporal, OpenAI Agents SDK integration и agentic sandboxes.
anthropics/cwc-long-running-agents: паттерны эвалуатора и файлов прогресса.
Платформы и лимиты
- Anthropic, Claude platform pricing для часов сессий Managed Agents.
- Провайдеры сэндбоксов: E2B, Vercel Sandbox, Daytona, Modal, Runloop.
- Google Cloud Run, service request timeout и job task timeout.
- AWS, Lambda timeout, Lambda durable functions и Bedrock AgentCore Runtime.
Observability
- OpenTelemetry, Semantic conventions for generative AI, attribute registry и metrics.