Харнесс-инжиниринг для ИИ-агентов: проверка завершения

Автоматический перевод
Эта статья была автоматически переведена с оригинальной английской версии.
Агент может завершить свой ход, хотя работа ещё не закончена. Эта статья для инженеров, которые создают или проверяют агентов для программирования и должны решать, когда принять результат, повторить операцию с неопределённым исходом или продолжить работу в другой сессии. В ней также показано, как измерить, улучшает ли дополнительный компонент харнесса эти исходы настолько, чтобы оправдать свою стоимость.
Харнесс — это код приложения вокруг цикла ризонинга модели. Он предоставляет контекст, проверяет предложенные действия, записывает, что произошло, и решает, достаточно ли свидетельств для завершения. Рантайм выполняет принятые действия и поддерживает доступность сессии, сэндбокса и чекпоинта. Предыдущие статьи объясняют цикл ризонинга, память, инструменты и разрешения. Здесь вопрос в том, что делает харнесс после того, как модель предложила действие или сказала «готово».
Примеры с магазином и платежами ниже — вымышленные учебные случаи. Сопутствующая лаборатория — детерминированная симуляция; она не измеряет работающего агента для программирования.
Что считается завершением
Предположим, агента для программирования просят снизить порог автоматической скидки 10% с $100 до $75 в вымышленном репозитории магазина. Он изменяет src/checkout.py. Корзина на $80 теперь должна получать скидку $8. У задачи две обязательные проверки:
pytest tests/test_checkout.pyпроверяет расчёт.pnpm playwright test tests/checkout_discount.spec.tsпроверяет видимый результат checkout в локальном магазине с заранее подготовленными данными.
Правдоподобный финальный ответ не входит в эти проверки. Харнесс должен принимать только кандидата, чей полный протестированный снапшот идентифицирован и чьи две обязательные проверки прошли на этом же снапшоте. Идентифицировать его может чистый коммит; иначе используйте digest или манифест, включающий релевантные неотслеживаемые файлы. Держите тесты вне доступной агенту области записи либо независимо одобряйте их изменения до грейдинга.
Здесь у модели, харнесса и рантайма разные задачи. Реализация может объединять несколько из них в одном процессе, но границы их отказов остаются разными:
| Компонент | Задача | Пример для агента для программирования |
|---|---|---|
| Модель | Предлагает текст, tool call или финальный ответ | Предлагает изменить src/checkout.py |
| Цикл ризонинга | Выбирает следующий шаг из доступного контекста | Проверить, изменить, протестировать, снова проверить |
| Харнесс | Предоставляет контекст, валидирует и авторизует предложения, отправляет принятые вызовы, записывает результаты, проверяет завершение | Разрешает изменения в src/ и требует оба названных теста |
| Рантайм | Выполняет принятые вызовы и сохраняет состояние вне рабочего процесса | Лог сессии, сэндбокс, хранилище чекпоинтов, бэкенд трейсинга |
В разборе цикла Codex от OpenAI описан этот цикл: харнесс собирает промпт, запрашивает у модели следующее действие, отправляет принятый tool call в рантайм, добавляет результат и снова делает запрос, пока не примет результат или не вернёт управление пользователю. Для изменения скидки один проход выглядит так:
- Сборщик контекста передаёт задачу, инструкции репозитория, релевантные файлы, предыдущие результаты инструментов и текущий план.
- Модель предлагает вызов
edit_fileс путём и текстом замены. - Граница инструмента валидирует аргументы, проверяет путь по разрешённой области и запрашивает одобрение, если операция этого требует.
- Рантайм применяет изменение в сэндбоксе и возвращает структурированный результат.
- Харнесс запускает
pytest tests/test_checkout.py, затемpnpm playwright test tests/checkout_discount.spec.tsи считывает оба кода выхода. - Неуспешная проверка становится новым контекстом для следующего хода модели; две успешные проверки делают изменение кандидатом на завершение.
- Харнесс сохраняет надолго команды, коды выхода, протестированный снапшот, грейдер и версии окружения; трейс может ссылаться на эту запись.
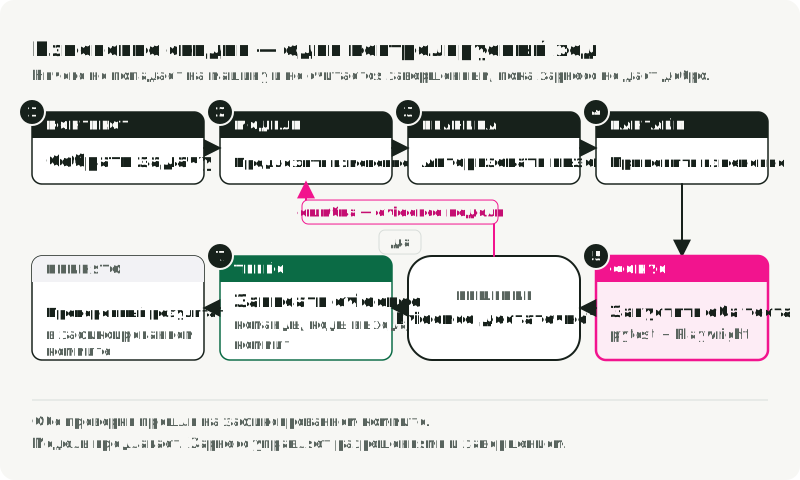
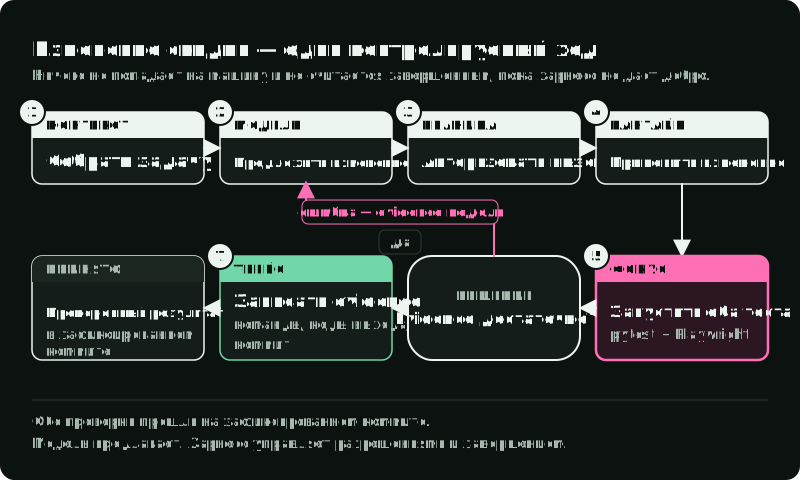
После шага 2 ни один файл ещё не изменён. Харнесс всё ещё может отклонить ../../secrets.env, потребовать одобрения деструктивной команды или остановить запуск, исчерпавший бюджет. После шага 5 харнесс сам считывает коды выхода, поэтому модель не может сама пометить своё изменение как успешное.
Запись о завершении для этой задачи должна содержать снапшот кандидата, обе команды и их коды выхода, а также версии тестового окружения и грейдера. Она должна быть сохранённой надолго и находиться вне контроля кандидата. Трейс может связать предложение, одобренный вызов, результат рантайма и запись о приёмке для диагностики. Сам по себе трейс не является решением о приёмке.
Трейс тоже не обязательно содержит запрос. Он может записать исходный документ или событие middleware, не показывая, что в итоге содержал собранный запрос. Если нужно установить, что получила модель, фиксируйте это в последней точке перед отправкой вызова, после всех преобразований.
Исследование случая OpenAI по харнесс-инжинирингу описывает запускаемое приложение для каждого worktree, а также доступ к браузеру, логам, метрикам и трейсам. Такая настройка позволила агенту проверять цель по латентности для пользовательского сценария. Она показывает предпосылку любого правила приёмки: нужное приложение и сигналы должны быть доступны в тестовом окружении. Lopopolo, автор этого исследования случая, ведёт практическое руководство по харнесс-инжинирингу с теми же двумя способами: зафиксировать модель и проектировать контекст и инструменты вокруг неё. Требования к качеству организации, процедуры и правила одобрения лежат за пределами того, что знает универсальная модель; харнесс передаёт их через инструкции репозитория, правила разрешений и проверки приёмки.
Рассмотрим три внешне похожих исхода:
| Свидетельства в конце запуска | Решение харнесса | Почему |
|---|---|---|
| Unit-тест прошёл; результата браузерного теста нет | Продолжить или остановить как незавершённый | У одной обязательной проверки нет результата |
| Оба теста прошли, затем агент изменил файл | Снова запустить обе проверки | Записанные успешные прогоны относятся к старому снапшоту |
| Оба теста прошли на одном идентифицированном снапшоте | Допускается к приёмке | Обязательные свидетельства соответствуют кандидату |
«Допускается» оставляет место для одобрения человеком или другого обязательного правила; это не позволяет модели сертифицировать собственную работу. Эвалуатор в свежем контексте может проверить визуальный результат по рубрике, когда код выхода не может выразить критерий. Сравните такого эвалуатора с ревью людей, прежде чем позволить ему решать о завершении. Он не может заменить обязательную детерминированную проверку.
Для исследовательского агента из этой серии предлагаемое детерминированное правило завершения проверяло бы схему отчёта и наличие запрошенных тикеров. Эти проверки не могут установить, что анализ фактически верен; для этого по-прежнему нужна проверка источников. Руководство Anthropic по эвалуации рекомендует для задач программирования стабильные окружения и тщательные тесты, а для модельных грейдеров — калибровку людьми.
Где применяется каждое правило
Требование, чтобы tests/checkout_discount.spec.ts проходил, относится к детерминированному коду, а не к промпту. Промпт может напомнить модели запустить тест. Он не может помешать модели объявить успех без свидетельств. Другие правила подходят для других мест:
| Где размещать правило | Подходящий случай | Пример |
|---|---|---|
| Промпт или skill | Порядок поиска, соглашения по коду и формат плана | Прочитать AGENTS.md перед изменением кода checkout |
| Граница инструмента | Валидация аргументов, разрешённые пути, одобрения и доступ к инструментам | Разрешать запись только в src/ |
| Детерминированный код | Бюджеты, таймауты, повторы, коды выхода тестов и требования к релизу | Оставлять запуск открытым, пока Playwright-тест не проходит |
| Эвалуатор в свежем контексте | Визуальная проверка или критерии, требующие суждения | Сравнить сгенерированную диаграмму с письменной рубрикой |
Каждая из предыдущих частей серии решает одну вещь внутри этого прохода:
| Предыдущая часть | Что она решает для этого хода | Где она действует в проходе |
|---|---|---|
| Часть 2 — память | Какое предыдущее состояние попадает в промпт | Шаг 1, сборщик контекста |
| Часть 3 — tool use | Какие действия существуют и как выглядит валидный результат | Валидация на шаге 3 и результат на шаге 4 |
| Часть 4 — безопасность | Можно ли выполнить этот конкретный вызов сейчас | Шаг 3, проверка пути и одобрение |
| Часть 6 — эта статья | Завершает ли полученное свидетельство запуск | Шаги 5–7, проверки приёмки |
Таблица распределяет обязанности, а не порядок выполнения. Части 3 и 4 делят шаг 3: тот же код харнесса, который отклоняет некорректный аргумент, отклоняет и разрешённый, но ещё не одобренный вызов. Если валидация и авторизация выполняются в разных сервисах, передавайте валидированные аргументы через эту границу, чтобы решение об авторизации относилось к вызову, который действительно будет выполнен.
Считайте таймаут неизвестным исходом
Изменение скидки локально, и его тесты можно перезапустить. Миграция платежей в том же вымышленном магазине создаёт другую проблему. Предположим, агент вызывает create_test_order у staging-сервиса, и вызов завершается по таймауту. Сервис мог создать заказ, хотя харнесс так и не получил ответ. Слепой повтор может создать второй заказ.
Названия действия или сгенерированного моделью ID tool call недостаточно, чтобы его восстановить. До отправки сохраните принадлежащий приложению ID операции вместе с одобренными аргументами. Сервис должен дедуплицировать повторы с этим ID или предоставлять проверку статуса, позволяющую сверить исход. Используйте тот же ID для того же заказа после рестарта; изменённый запрос на заказ требует нового решения. Руководство AWS по идемпотентным API описывает клиентский идентификатор и атомарность на стороне сервера, которые делают это безопасным. Проверьте, как долго провайдер хранит ключи: контракт Stripe, например, разрешает удалять их не раньше чем через 24 часа, поэтому более поздний повтор требует сверки, а не повторной отправки.
На рисунке один вызов create_test_order с таймаутом разобран дважды: при слепом повторе и при повторе с сохранённым ID операции.
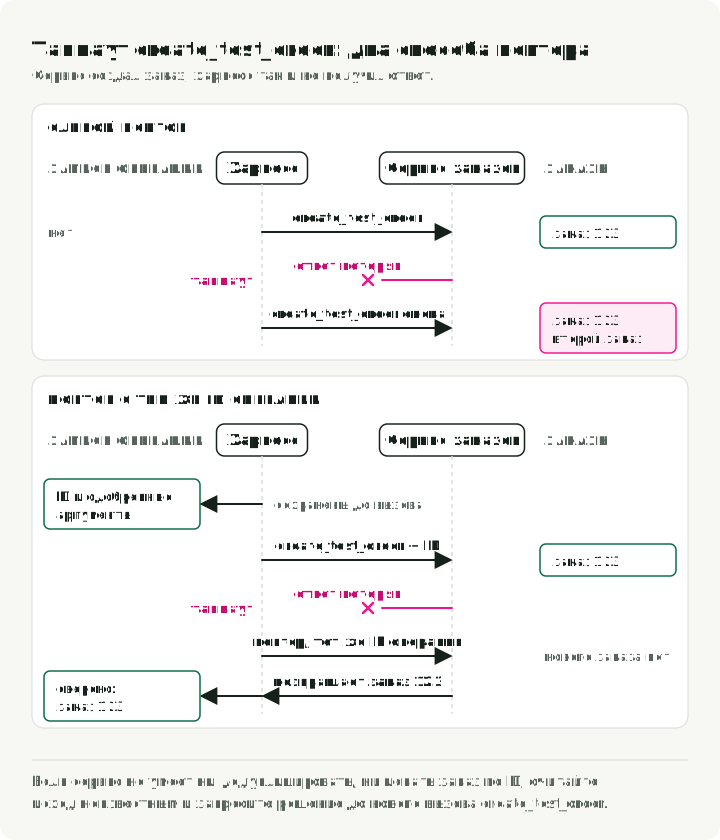
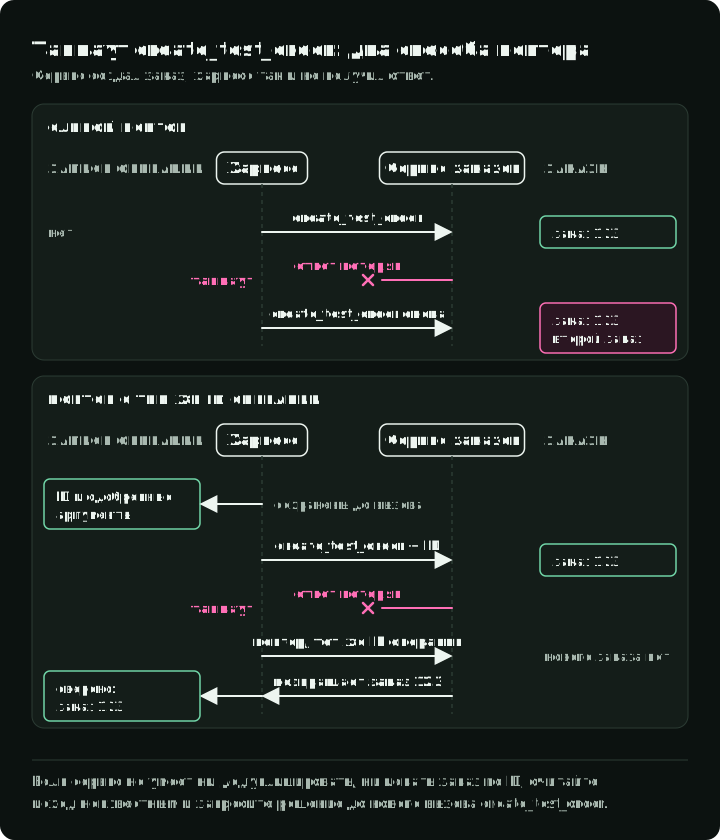
Харнесс может принимать эти решения без обращения к модели, только если у каждого инструмента есть явный контракт. Для create_test_order этот контракт включает:
- валидированные аргументы, чтобы некорректный ввод отклонялся до выполнения;
- структурированный результат, например
{ "order_id": "123", "created": true }, чтобы последующим проверкам не приходилось парсить свободный текст; - категорию эффекта: только ли читает вызов или изменяет файл, запись или внешний сервис, и безопасно ли его повторять;
- таймаут и политику повторов, чтобы потерянный ответ не запускал неограниченную последовательность вызовов;
- правило разрешений: чтение статуса заказа может выполняться автоматически, а создание заказа может требовать подтверждения.
| Результат, который видит харнесс | Следующее действие |
|---|---|
Вызов только для чтения get_order_status возвращает 503 | Повторить с ограничением, если эту проверку безопасно повторять |
create_test_order завершается по таймауту; проверка статуса находит заказ по его ID операции | Использовать существующий заказ и записать сверенный результат |
create_test_order завершается по таймауту; сервис не может дедуплицировать или проверить статус | Оставить исход неопределённым и запросить решение до нового создания |
Последнее состояние должно пережить сбой рабочего процесса. Назвать его «неуспешным» было бы неверно: заказ может существовать. Постоянная запись операции должна содержать одобренный payload, ID операции, статус отправки, результат сервера или проверку статуса и любое одобрение. Трейс помогает найти эту запись; транскрипт показывает только то, что видела модель.
Описание инструмента помогает модели выбрать действие. Оно не выдаёт разрешение и не доказывает, что повтор безопасен. Если сервис заказов доступен через MCP, клиент всё равно должен применять собственную валидацию и политику доверия, а сервер — обеспечивать контроль доступа. Спецификация инструментов MCP требует, чтобы клиенты считали аннотации поведения инструментов недоверенными, если они не получены от доверенного сервера. Сервер, описывающий create_test_order как только для чтения, не может сделать его таким. Спецификация не задаёт единую настройку доверия, поэтому напишите для своего деплоя явную политику, указывающую, какие метаданные сервера могут влиять на решения о разрешениях или повторах.
У MCP есть и стандартный способ не терять контроль над долгим вызовом. С официальным расширением Tasks сервер может ответить на tools/call хендлом задачи вместо итогового результата. Клиент затем опрашивает задачу через tasks/get или останавливает работу через tasks/cancel. Спецификация Tasks говорит, что клиентам следует сохранять ID задач, чтобы опрос можно было возобновить после сбоя, поэтому храните ID задачи в той же записи операции. Статус completed не означает, что инструмент отработал успешно: результат инструмента с isError: true тоже завершает задачу, а в failed её переводит только ошибка протокола. Клиент и сервер согласуют поддержку для каждого запроса, поэтому перед использованием убедитесь, что обе стороны её реализуют.
Передайте прогресс следующей сессии
Теперь вымышленный агент должен перенести checkout с платёжного адаптера v1 на v2. Он изменил обработчик и клиент, запустил локальный платёжный сэндбокс и оставил tests/payment_migration.spec.ts в неуспешном состоянии. Задача длиннее одной сессии модели. Сводка старого разговора может утверждать, что сэндбокс работает, даже после того как процесс завершился.
Следующей сессии нужны три разных вида состояния:
| Состояние | Что следующая сессия должна проверить |
|---|---|
| Разговор | Запрос, решения и релевантные результаты инструментов |
| Рабочее окружение и рантайм | Текущие файлы, ветку, процессы и тестовое окружение |
| Прогресс задачи | Выполненные проверки, ожидающее одобрение или неопределённую запись, следующий шаг |
Компактификация заменяет старые сообщения краткой сводкой, чтобы текущая сессия могла продолжиться. Передача прогресса — это документная память для следующей сессии. Если старый разговор содержит устаревшие предположения, харнесс может начать новую сессию с передачей прогресса и текущим рабочим окружением; замена рабочего процесса после сбоя и восстановление его процессов — отдельная задача рантайма.
Чекпоинт может сохранить состояние выполнения, но не доказывает, что внешняя платёжная операция зафиксирована или что процесс всё ещё жив. Передача прогресса помогает, когда в следующем контексте модели нет пригодного статуса задачи. Запишите ветку, изменённые файлы, последнюю команду и её результат, ожидающие ID операций и следующий нерешённый шаг. При возобновлении сверьте эти утверждения с текущим рабочим окружением и сервисом, прежде чем действовать. В экспериментах Anthropic с долгоживущими агентами для программирования история git и файл прогресса помогали последующим сессиям восстановить работу. Более поздний отчёт Anthropic о дизайне харнесса отмечает, что передача прогресса добавляет оркестрацию, токены и время выполнения.
Передача прогресса должна быть условной. Небольшому изменению, которое завершается за одну сессию, она не нужна. Даже длинной задаче может не понадобиться ещё один файл, если её чекпоинт уже содержит нужный прогресс и следующая сессия может им воспользоваться. Проверьте, повторяет ли возобновлённая сессия выполненную работу, пропускает ли ожидающую запись или действует ли в устаревшем окружении. Восполните недостающее состояние, а не добавляйте сводку по умолчанию.
Диагностируйте отказ, прежде чем добавлять компонент
Три случая выше дают разные трейсы: отсутствующий тест приёмки, неопределённая внешняя запись и повторная работа после возобновления. Их исправления находятся в разных местах. Отсутствие результата браузерного теста в записи о приёмке требует обязательной проверки завершения. Неопределённый заказ требует дедупликации или сверки на стороне сервера. Повторное изменение после новой сессии требует пригодного состояния прогресса.
Для следующего запуска записывайте задачу и версию харнесса, предложенное действие, одобрение, результат инструмента, протестированный снапшот, результат приёмки, латентность и стоимость. Учитывайте количество входных токенов отдельно от оплаченной стоимости входа, включая чтения из кэша: два харнесса, которые ведут себя одинаково, могут стоить по-разному в зависимости от того, как каждый собирает свой запрос и был ли кэш провайдера прогретым. Не допускайте в трейсы секреты и лишние персональные данные. Связывайте внешние записи операций по ID, поскольку таймаут на стороне клиента не может показать, что сделал сервер. Когда отказ повторяется, напишите регрессионный кейс, который его воспроизводит. Этот процесс превращения трейсов в тесты развивает статья Эвалуация ИИ-агентов в продакшене.
Каждый повторяющийся симптом подсказывает небольшое изменение и метрику, которая покажет, помогло ли оно:
| Повторяющийся симптом | Небольшое изменение для проверки | Что измерять |
|---|---|---|
| Проверки статуса только для чтения временно завершаются ошибкой | Ограниченный повтор с backoff | Доля восстановлений, дополнительные вызовы, время выполнения |
| Возобновлённые сессии повторяют выполненную работу | Структурированная передача прогресса | Дублирующие действия инструментов после возобновления |
| При завершении отсутствуют обязательные тесты | Отклонять завершение, пока не пройдут все обязательные проверки | Задачи, принятые без всех обязательных проверок |
| Визуальные дефекты переживают детерминированные проверки | Эвалуатор в свежем контексте с рубрикой | Найденные дефекты, ложные отклонения, время ревью |
| Агент изменяет файлы за пределами своей области | Более узкое разрешение инструмента | Заблокированные вызовы и ручные переопределения |
| Извлечённая память вытесняет текущую задачу | Ограничить число извлекаемых фактов; ранжировать перед добавлением | Токены на извлечение, выполненные задачи, стоимость |
| Заявленное правило или статус не доходит до модели | Фиксировать собранный запрос перед отправкой вызова | Запросы без правила; число раундов до его повторного появления |
Прежде чем добавлять политику повторов, передачу прогресса или эвалуатор, назовите отказ, который он должен изменить, и метрику, которая покажет улучшение. Учитывайте и стоимость: больше принятых задач бесполезно, если дополнительные вызовы удваивают время ревью или создают дублирующие заказы. Авторизация, изоляция, правила приватности и обязательные проверки приёмки — это требования; небольшой бенчмарк успеха не повод их убирать. Тестируйте эти ограничения явными запрещёнными кейсами.
Измеряйте по одному опциональному изменению за раз
Абляция сравнивает харнесс с одним компонентом и без него, оставляя остальной эксперимент фиксированным. Используйте следующий протокол:
- Зафиксируйте версию модели и эндпоинт провайдера, экземпляры задач, окружение и его лимиты вычислительных ресурсов, грейдер и промпты вне тестируемого компонента. Одни лишь лимиты ресурсов могут изменить результат агентного бенчмарка; статья об эвалуации агентов разбирает измерение Anthropic.
- Дайте обоим вариантам одинаковый общий бюджет токенов, времени и денег.
- До запуска сравнения выберите число испытаний или правило остановки.
- Запустите одни и те же экземпляры задач в обоих вариантах и повторите каждую задачу, потому что вывод модели варьируется.
- Сообщайте среднее значение вместе с разбросом или доверительным интервалом.
- Учитывайте каждое начатое испытание, включая таймауты, остановки по политике, падения харнесса и ошибки эвалуатора.
Для миграции платежей кандидатом служит опциональная передача прогресса. Начинайте каждую пару control–treatment с одного и того же коммита репозитория и подготовленного чекпоинта, где передача прогресса — единственный переключатель.
Основной метрикой могут быть дублирующие действия инструментов после возобновления: операция над артефактом, который предыдущая сессия уже завершила. Также сообщайте принятые задачи, пропущенные дефекты, время выполнения, стоимость модели и эвалуатора и минуты ревью. Выберите число испытаний и правило остановки заранее, затем сообщайте вариацию, а не только среднее. Если передача прогресса сокращает дубликаты, но стоит больше, чем экономит, это полезный отрицательный результат.
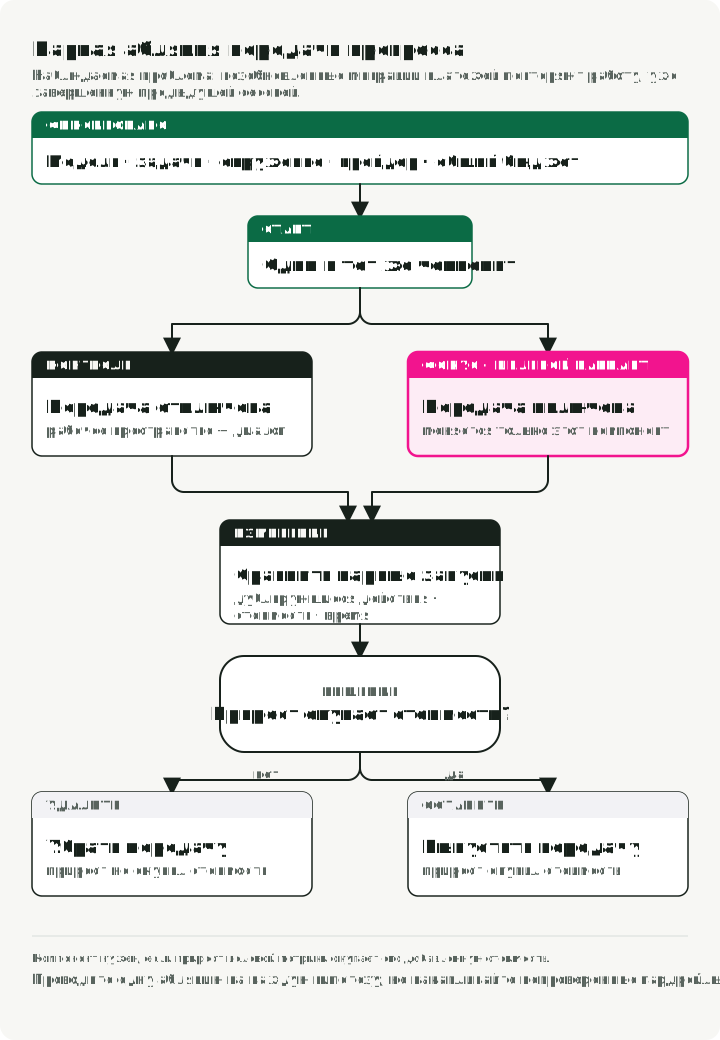
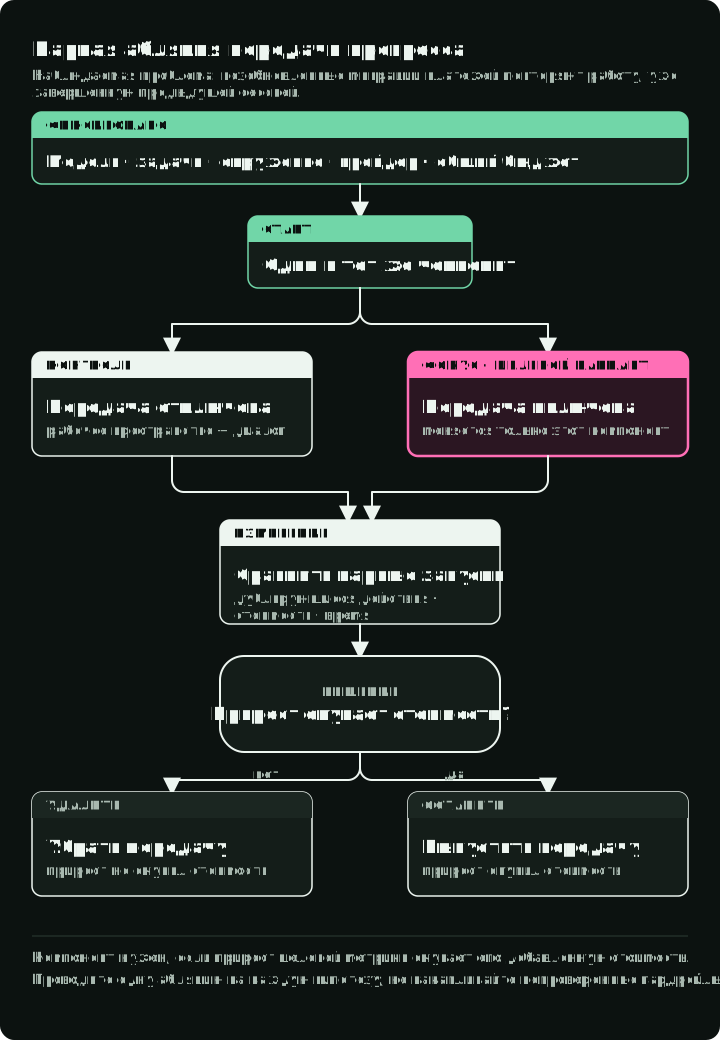
Статья SWE-agent даёт ограниченный пример абляции интерфейса. С GPT-4 Turbo на 300 задачах SWE-bench Lite и лимитом $4 на задачу в ней менялась одна функция интерфейса за раз:
| Изменение интерфейса | Решено |
|---|---|
| Полный интерфейс SWE-agent (эталон) | 18,0% |
| Редактор без линтинга | 15,0% |
| Полный файл вместо просмотра по 100 строк | 12,7% |
| Полная история наблюдений вместо последних пяти | 15,0% |
Это результаты для той модели и того бенчмарка, а не ожидаемый выигрыш для вымышленного магазина. Переносится метод: протестируйте названный выбор интерфейса в фиксированной настройке и сообщайте условия вместе с числом.
Объединённые сравнения встречаются часто, и они не могут назвать изменение, которое помогло. LangChain сообщает о росте deepagents-cli на Terminal-Bench 2.0 с 52,8% до 66,5% при фиксированной модели после одновременного изменения системного промпта, инструментов и middleware. Отчёт OpenAI об ARC-AGI-3 показывает обратный риск: оценка почти утроилась, когда харнесс сохранял ризонинг и использовал компактификацию, — две настройки API изменились одновременно. Записывайте API, сохранение ризонинга, политику компактификации и бюджеты вместе с ID модели; иначе кажущаяся регрессия модели может оказаться недостающей возможностью адаптера.
Тестирование по одному изменению ловит и те, что кажутся слишком мелкими, чтобы иметь значение. Постмортем Anthropic по Claude Code за апрель 2026 сообщает, что API не затронут, но качество снизили три изменения на уровне продукта: меньшее значение усилия ризонинга по умолчанию, баг, из-за которого после простоя сессии на каждом ходу стирался прежний ризонинг, и строка системного промпта, ограничивавшая текст между tool calls. Когда Anthropic провела абляцию этой одной строки на более широком наборе эвалуаций, одна из них показала падение на 3% и для Opus 4.6, и для Opus 4.7. Строка промпта или значение по умолчанию — это изменение харнесса; тестируйте его как таковое.
Заново проверяйте компоненты при смене модели. Отчёт Anthropic о долгоживущем приложении — качественное исследование случая: после выхода Opus 4.6 команда поочерёдно убирала компоненты харнесса и обнаружила, что вызовы эвалуатора стали накладными расходами на задачах, которые модель теперь выполняла сама, но всё ещё помогали на границе её возможностей.
Включите в набор отказов остановку по безопасности на стороне провайдера: она должна прекращать отправку и переводить запуск на ревью, а не на повтор. Подробности описаны в части 4.
Попробуйте сравнение в сопутствующей лаборатории
Проект harness-demo на коммите 517353f3 делает правило абляции запускаемым. Каждая из двенадцати универсальных синтетических задач, например fix-parser-edge-case, split-large-module и wire-browser-test, объявляет сложность и четыре условия: нестабильный инструмент, потерянный прогресс, пропущенный пробел в реализации и неоднозначное завершение. Для сложных задач, которым также нужен файл прогресса, симулятор выводит пятое: без context_reset компактификация сохраняет устаревшие предположения. Чистая функция помечает задачу как пройденную, когда выбранная конфигурация обрабатывает каждое применимое условие. Здесь нет модели, внешнего инструмента или реальной задачи программирования. Исходы и число токенов — симулированные учебные данные, а не свидетельство того, что харнесс из пяти компонентов улучшает работающего агента.
Клонируйте закреплённую ревизию и запустите проверки и симуляцию, установив uv:
git clone https://github.com/slavadubrov/harness-demo.git
cd harness-demo
git checkout 517353f3a47541d66099983170fe90812b6ef23b
make check
make run
make failures
make check запускает Ruff и семь unit-тестов, включая тест, который отклоняет сравнение с изменением двух компонентов. make run выводит накопительную учебную матрицу и пять пар leave-one-component-out. make failures называет каждый симулированный отказ; полная конфигурация завершается строкой all synthetic tasks pass.
| Компонент, возвращённый в полную конфигурацию | Без него | С ним |
|---|---|---|
| Политика повторов | 8/12 | 12/12 |
| Передача прогресса | 7/12 | 12/12 |
| Свежий эвалуатор | 8/12 | 12/12 |
| Fail-closed приёмка | 7/12 | 12/12 |
| Сброс контекста | 10/12 | 12/12 |
Эти строки — детерминированные следствия флагов задач и кода грейдера. Они не являются оценками размера эффекта в работающей системе. Предыдущая накопительная матрица добавляет несколько компонентов за один переход и не может определить, какой из них вызвал изменение.
model.py лаборатории защищает от того, чтобы называть объединённое изменение абляцией: он сравнивает каждое поле компонента в паре, а его регрессионный тест передаёт некорректную пару, в которой изменены и повторы, и эвалуатор. Эта самодостаточная версия защиты запускается на одной валидной паре с передачей прогресса:
from dataclasses import dataclass, fields

@dataclass(frozen=True)
class Config:
    progress_handoff: bool = False
    evaluator: bool = False
    retry_policy: bool = False
    fail_closed_acceptance: bool = False
    context_reset: bool = False

def changed_components(control: Config, treatment: Config) -> tuple[str, ...]:
    return tuple(
        field.name
        for field in fields(control)
        if getattr(control, field.name) != getattr(treatment, field.name)
    )

control = Config(progress_handoff=False, evaluator=True, retry_policy=True)
treatment = Config(progress_handoff=True, evaluator=True, retry_policy=True)
assert changed_components(control, treatment) == ("progress_handoff",)
Чтобы перенести метод в реальный проект, замените синтетические флаги задач версионированным набором задач, а симулированное число токенов — измерениями из трейсов. Держите правила приёмки вне контроля кандидата. Одна лишь фиксированная модель не делает сравнение контролируемым, если изменились также промпты, тестовые данные, разрешения или настройки ризонинга и компактификации в API.
Найдите код, отвечающий за поведение
Харнесс, прошедший свои абляции, всё равно может пережить модель, под которую его настраивали, а чтобы потом его изменить, нужен код, реализующий конкретное поведение. Запрос вроде «маскировать секреты в каждом пути захвата» называет поведение, а не файл. В харнессе в продакшене такое поведение может охватывать несколько этапов выполнения и общее состояние.
Препринт Wang et al. 2026 года предлагает для такого поиска Harness Handbook; статья называет этот поиск локализацией поведения. Статический анализ извлекает граф программы, LLM группирует его элементы по этапам выполнения, а мейнтейнер или агент для программирования спускается от обзора системы к привязанным к исходному коду записям для функции или файла. Каждая запись должна разрешаться в текущем репозитории и повторно синхронизируется после каждого изменения.
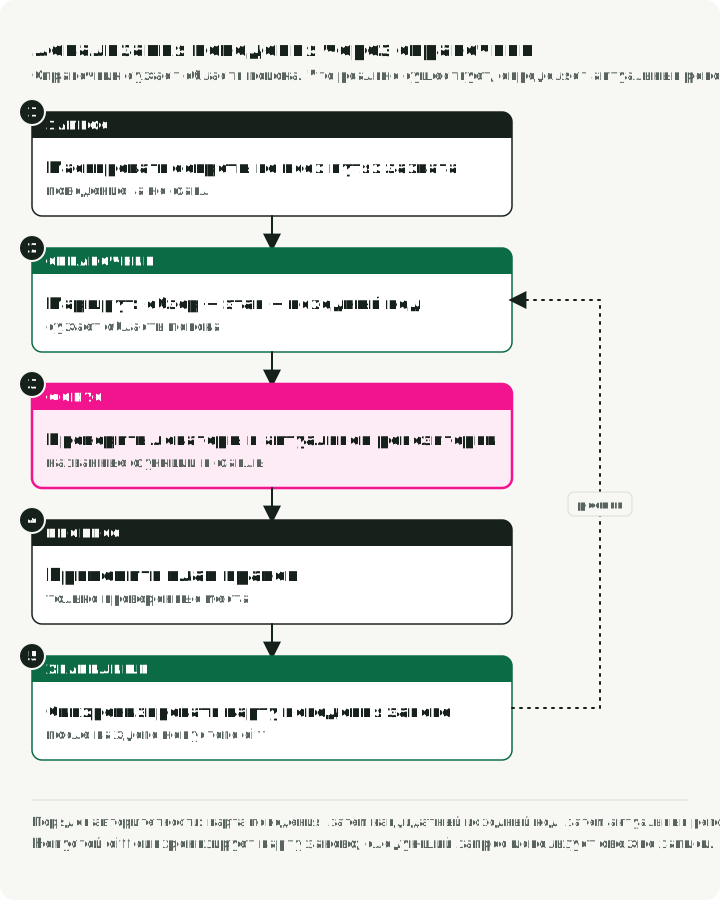
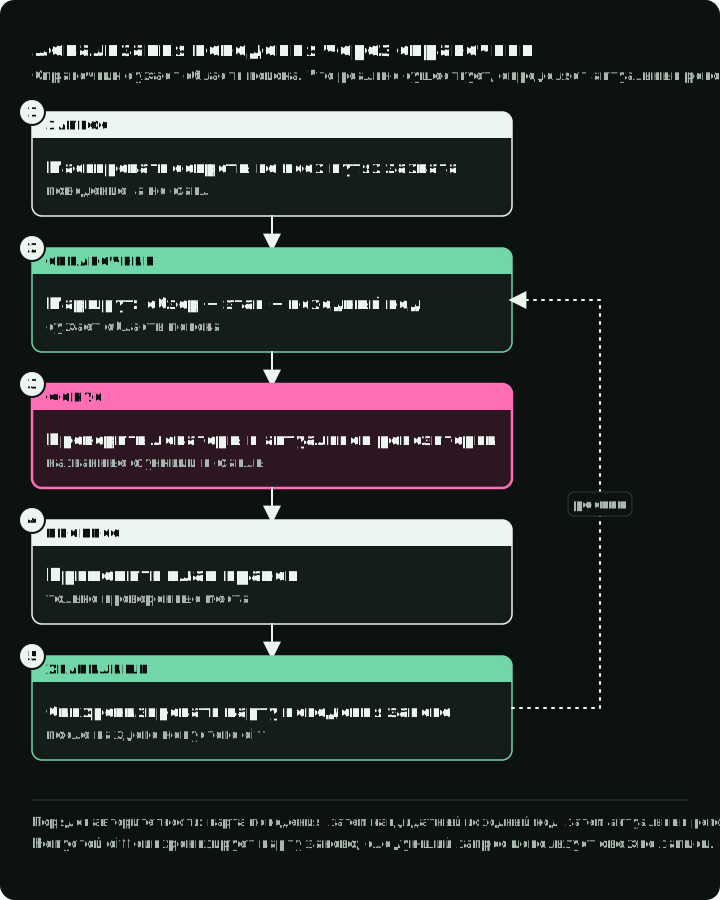
На двух open-source харнессах планировщик, работавший через справочник, создавал планы изменений, которые джаджи предпочитали чаще, и тратил меньше токенов. Исследование оценивало планы, а не выполненные изменения, и не сообщало о неопределённости, поэтому считайте его подходом на стадии исследования.
По отказу найдите ответственного
Серия двигалась от цикла ризонинга наружу. Когда запуск завершается неудачей, найдите первую обязанность, которая могла предотвратить или обнаружить отказ:
| Что произошло | Что исследовать |
|---|---|
| Плохой следующий шаг при наличии нужной информации | Модель и цикл ризонинга |
| Потеряно предыдущее решение или повторена выполненная работа | Сборку контекста и память |
| Не удалось выразить действие или прочитать его результат | Контракт инструмента |
| Выполнено запрещённое действие | Проверку разрешений и сервис, который её применяет |
| Рабочий процесс завершился аварийно, и его окружение исчезло | Рантайм и чекпоинт |
| Успех объявлен без обязательных свидетельств | Правило приёмки харнесса и протестированный снапшот |
Я бы начал с одной сильной модели, инструментов с ограниченной областью действия, сэндбокса и одной явной проверки приёмки. Запишите первый отказ, добавьте наименьший контроль, который его устраняет, и сравните с отключённым контролем. Держите правило и трейс вместе, чтобы следующий апгрейд модели дал вам основание сохранить или убрать компонент. Для каждого компонента записывайте, кто его поддерживает, сколько токенов или секунд он добавляет и какой регрессионный тест оправдал бы его удаление. Через шесть месяцев человек, увидевший progress_handoff=True, должен суметь найти неуспешные трейсы, которые оправдали его появление, и регрессионные кейсы, из-за которых он всё ещё остаётся.
Ссылки
- OpenAI, Unrolling the Codex agent loop.
- OpenAI, Harness engineering: leveraging Codex in an agent-first world.
- Anthropic Engineering, Demystifying evals for AI agents.
- Anthropic Engineering, Effective harnesses for long-running agents.
- Anthropic Engineering, Harness design for long-running application development.
- Lopopolo, Harness engineering: anthology, field guide, and agent context bundle.
- LangChain, Improving Deep Agents with harness engineering.
- OpenAI, How two settings tripled our ARC-AGI-3 scores.
- Wang et al., Harness Handbook: Making Evolving Agent Harnesses Readable, Navigable, and Editable, arXiv:2607.13285, 2026.
- Stripe, Idempotent requests.
- Yang et al., SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering.
- AWS, Making retries safe with idempotent APIs.
- Model Context Protocol, Tools specification.
- Model Context Protocol, Tasks extension и Tasks specification.
- Anthropic Engineering, An update on recent Claude Code quality reports.
Код Market Analyst Agent из этой серии находится на GitHub.