Harness engineering para agentes de AI: verificar la finalización

Traducción automática
Este artículo se tradujo automáticamente a partir de la versión original en inglés.
Un agente puede terminar su turno aunque el trabajo siga incompleto. Este artículo está dirigido a ingenieros que construyen o revisan coding agents y necesitan decidir cuándo aceptar un resultado, reintentar una operación incierta o reanudar el trabajo en otra sesión. También muestra cómo medir si un componente adicional del harness mejora esos resultados lo suficiente como para justificar su coste.
El harness es el código de aplicación que rodea al reasoning loop del modelo. Proporciona contexto, comprueba las acciones propuestas, registra lo que ha ocurrido y decide si la evidencia basta para terminar. El runtime ejecuta las acciones aceptadas y mantiene disponibles la sesión, el sandbox y el checkpoint. Los artículos anteriores explican el reasoning loop, la memoria, las herramientas y los permisos. Aquí la pregunta es qué hace el harness después de que el modelo proponga una acción o diga «hecho».
Los ejemplos de la tienda y de pagos que aparecen a continuación son casos didácticos ficticios. El laboratorio complementario es una simulación determinista; no mide un coding agent real.
Qué cuenta como terminado
Supongamos que se pide a un coding agent que baje de $100 a $75 el umbral de un descuento automático del 10 % en el repositorio de una tienda ficticia. El agente modifica src/checkout.py. Un carrito de $80 debería recibir ahora un descuento de $8. La tarea tiene dos checks obligatorios:
pytest tests/test_checkout.pycomprueba el cálculo.pnpm playwright test tests/checkout_discount.spec.tscomprueba el resultado visible del checkout en una tienda local con datos de prueba inicializados.
Una respuesta final plausible no es ninguno de esos checks. El harness solo debe aceptar un candidato cuyo snapshot completo probado esté identificado y cuyos dos checks obligatorios hayan pasado sobre ese mismo snapshot. Un commit limpio puede identificarlo; en caso contrario, usa un digest o un manifiesto que incluya los archivos untracked relevantes. Mantén los tests fuera del ámbito de escritura del agente, o aprueba de forma independiente cualquier cambio en ellos antes de evaluar.
Aquí el modelo, el harness y el runtime tienen funciones distintas. Las implementaciones pueden fusionar varias de ellas en un mismo proceso, pero sus límites de fallo siguen siendo diferentes:
| Componente | Función | Ejemplo en un coding agent |
|---|---|---|
| Modelo | Propone texto, un tool call o una respuesta final | Sugiere una edición en src/checkout.py |
| Reasoning loop | Elige el siguiente paso a partir del contexto disponible | Inspeccionar, editar, probar, volver a inspeccionar |
| Harness | Proporciona contexto, valida y autoriza propuestas, despacha los calls aceptados, registra resultados y comprueba la finalización | Permite editar bajo src/ y exige los dos tests indicados |
| Runtime | Ejecuta los calls aceptados y mantiene el estado vivo fuera del proceso worker | Log de sesión, sandbox, checkpoint store, trace backend |
El recorrido del bucle de Codex de OpenAI describe el ciclo: el harness compone un prompt, pide al modelo la siguiente acción, envía al runtime un tool call aceptado, añade el resultado y vuelve a preguntar hasta que acepta el resultado o devuelve el control al usuario. Para el cambio del descuento, una pasada tiene este aspecto:
- El constructor de contexto proporciona la tarea, las instrucciones del repositorio, los archivos relevantes, los tool results anteriores y el plan actual.
- El modelo propone un call
edit_filecon una ruta y el texto de sustitución. - El límite de la tool valida los argumentos, comprueba la ruta frente al ámbito permitido y pide aprobación si la operación la requiere.
- El runtime aplica la edición en el sandbox y devuelve un resultado estructurado.
- El harness ejecuta
pytest tests/test_checkout.pyy despuéspnpm playwright test tests/checkout_discount.spec.ts, y lee los dos códigos de salida. - Un check fallido se convierte en contexto nuevo para el siguiente turno del modelo; dos checks superados convierten el cambio en candidato a finalización.
- El harness registra de forma durable los comandos, los códigos de salida, el snapshot probado, el evaluador y las versiones del entorno; una trace puede enlazar con ese registro.
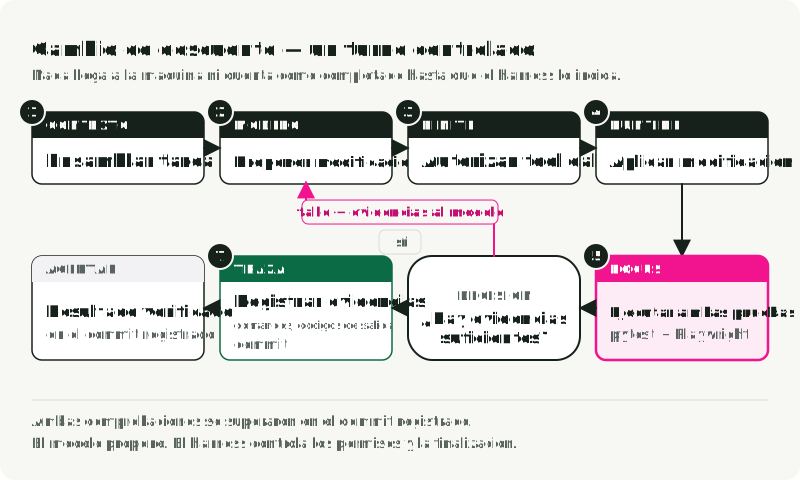
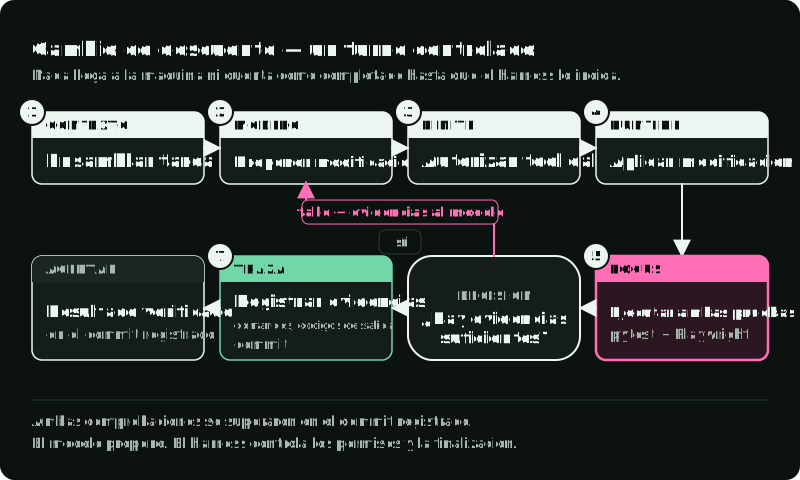
Después del paso 2, todavía no ha cambiado ningún archivo. El harness aún puede rechazar ../../secrets.env, exigir aprobación para un comando destructivo o detener una ejecución que ha agotado su presupuesto. Después del paso 5, el harness lee él mismo los códigos de salida, de modo que el modelo no puede marcar su propia edición como superada.
Un registro de finalización para esta tarea necesita el snapshot candidato, los dos comandos con sus códigos de salida, y las versiones del entorno de test y del evaluador. Debe ser durable y quedar fuera del control del candidato. Una trace puede enlazar la propuesta, el call aprobado, el resultado del runtime y el registro de aceptación para el diagnóstico. Una trace por sí sola no es la decisión de aceptación.
Una trace tampoco contiene necesariamente la solicitud. Puede registrar el documento de origen o un evento de middleware sin mostrar qué contenía finalmente la solicitud ensamblada. Si necesitas establecer qué recibió el modelo, captúralo en el último punto antes de que el call salga, después de cada transformación.
El caso de estudio de harness engineering de OpenAI describe una aplicación arrancable por worktree, además de acceso a navegador, logs, métricas y traces. Esa configuración permitió que el agente inspeccionara un objetivo de latency de un recorrido de usuario. Ilustra el requisito previo de una regla de aceptación: la aplicación y las señales relevantes deben estar disponibles en el entorno de test. Lopopolo, autor de ese caso de estudio, mantiene una guía práctica de harness engineering con las mismas dos palancas: mantener fijo el modelo y diseñar el contexto y las tools que lo rodean. El nivel de calidad de una organización, sus procedimientos y sus reglas de aprobación quedan fuera de lo que sabe un modelo general; el harness los aporta como instrucciones del repositorio, reglas de permisos y checks de aceptación.
Considera tres resultados que parecen similares:
| Evidencia al final de la ejecución | Decisión del harness | Motivo |
|---|---|---|
| El test unitario pasa; falta el resultado del navegador | Continuar o detener como incompleta | Un check obligatorio no tiene resultado |
| Los dos tests pasan y después el agente edita un archivo | Volver a ejecutar los dos checks | Los resultados registrados pertenecen a un snapshot anterior |
| Los dos tests pasan sobre el mismo snapshot identificado | Apta para aceptación | La evidencia requerida corresponde al candidato |
«Apta» deja margen para una aprobación humana u otra regla obligatoria; no permite que el modelo certifique su propio trabajo. Un evaluador con contexto nuevo puede revisar un resultado visual frente a una rúbrica cuando un código de salida no puede expresar el criterio. Compara ese evaluador con revisiones humanas antes de permitir que decida la finalización. No puede sustituir a un check determinista obligatorio.
Para el research agent de esta serie, una regla de finalización determinista propuesta comprobaría el schema del informe y confirmaría que aparecen los tickers solicitados. Esos checks no pueden establecer que el análisis sea correcto en los hechos; para eso sigue haciendo falta revisar las fuentes. La guía de evaluación de Anthropic recomienda entornos estables y tests exhaustivos para las tareas de coding, con calibración humana para los evaluadores basados en modelos.
Dónde se aplica cada regla
El requisito de que tests/checkout_discount.spec.ts pase pertenece al código determinista, no al prompt. Un prompt puede recordar al modelo que ejecute el test. No puede impedir que el modelo declare el éxito sin evidencia. Otras reglas encajan en otros lugares:
| Pon la regla en | Encaja bien | Ejemplo |
|---|---|---|
| Prompt o skill | Orden de búsqueda, convenciones de código y formato del plan | Leer AGENTS.md antes de editar el código de checkout |
| Límite de la tool | Validación de argumentos, rutas permitidas, aprobaciones y acceso a tools | Permitir escrituras solo bajo src/ |
| Código determinista | Presupuestos, timeouts, retries, códigos de salida de tests y requisitos de publicación | Mantener abierta la ejecución mientras falle el test de Playwright |
| Evaluador con contexto nuevo | Revisión visual o criterios que requieren juicio | Comparar un diagrama generado con una rúbrica escrita |
Cada una de las partes anteriores de esta serie decide una cosa dentro de ese recorrido:
| Parte anterior | Qué decide para este turno | Dónde actúa en el recorrido |
|---|---|---|
| Parte 2 — memoria | Qué estado anterior entra en el prompt | Paso 1, el constructor de contexto |
| Parte 3 — tool use | Qué acciones existen y cómo es un resultado validado | La validación del paso 3 y el resultado del paso 4 |
| Parte 4 — seguridad | Si este call concreto puede ejecutarse ahora | Paso 3, la comprobación de ruta y la aprobación |
| Parte 6 — este artículo | Si la evidencia resultante termina la ejecución | Pasos 5 a 7, los checks de aceptación |
La tabla representa responsabilidades, no el orden de ejecución. Las partes 3 y 4 comparten el paso 3: el mismo código del harness que rechaza un argumento mal formado también rechaza un call que está permitido pero aún no aprobado. Si la validación y la autorización se ejecutan en servicios separados, pasa los argumentos validados a través de ese límite para que la decisión de autorización se aplique al call que se va a ejecutar.
Trata un timeout como un resultado desconocido
La edición del descuento es local y sus tests pueden volver a ejecutarse. Una migración de pagos en la misma tienda ficticia plantea un problema distinto. Supongamos que el agente llama a create_test_order contra un servicio de staging y el call agota el tiempo de espera. El servicio puede haber creado el pedido aunque el harness nunca haya recibido su respuesta. Reintentar a ciegas puede crear un segundo pedido.
El nombre de la acción o un ID de tool call generado por el modelo no bastan para recuperarlo. Antes del envío, persiste un ID de operación propiedad de la aplicación junto con los argumentos aprobados. El servicio debe deduplicar los retries con ese ID o proporcionar una consulta de estado que permita conciliar el resultado. Reutiliza el mismo ID para el mismo pedido previsto después de un reinicio; una solicitud de pedido modificada necesita una decisión nueva. La guía de AWS sobre APIs idempotentes describe el identificador de cliente y la atomicidad en el servidor necesarios para que esto sea seguro. Comprueba durante cuánto tiempo conserva las claves el proveedor: el contrato de Stripe, por ejemplo, permite eliminarlas pasadas al menos 24 horas, así que un retry posterior necesita conciliación en lugar de un reenvío.
La figura sigue una misma llamada create_test_order con timeout dos veces: una reenviada a ciegas y otra reenviada con el ID de operación almacenado.
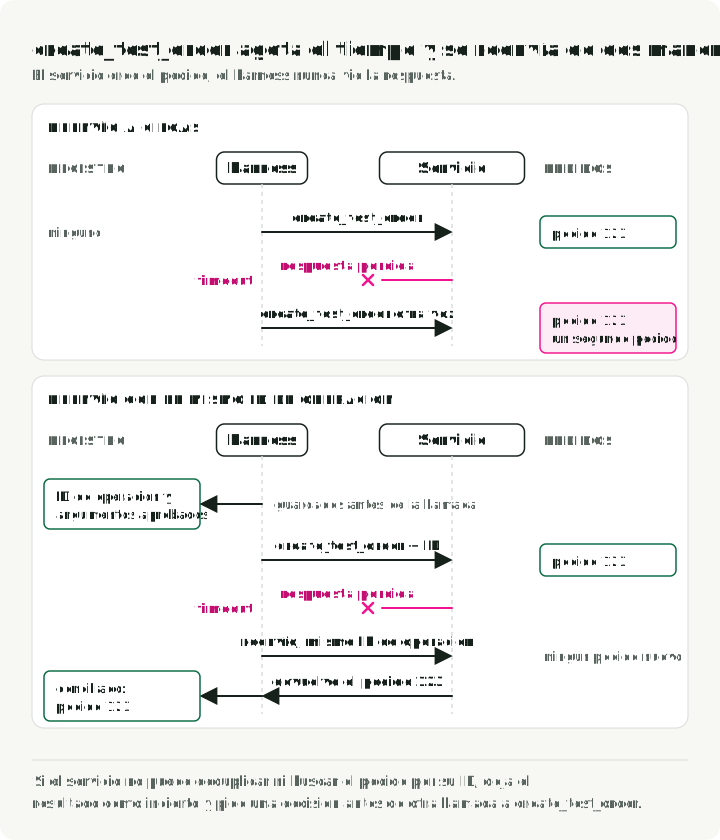
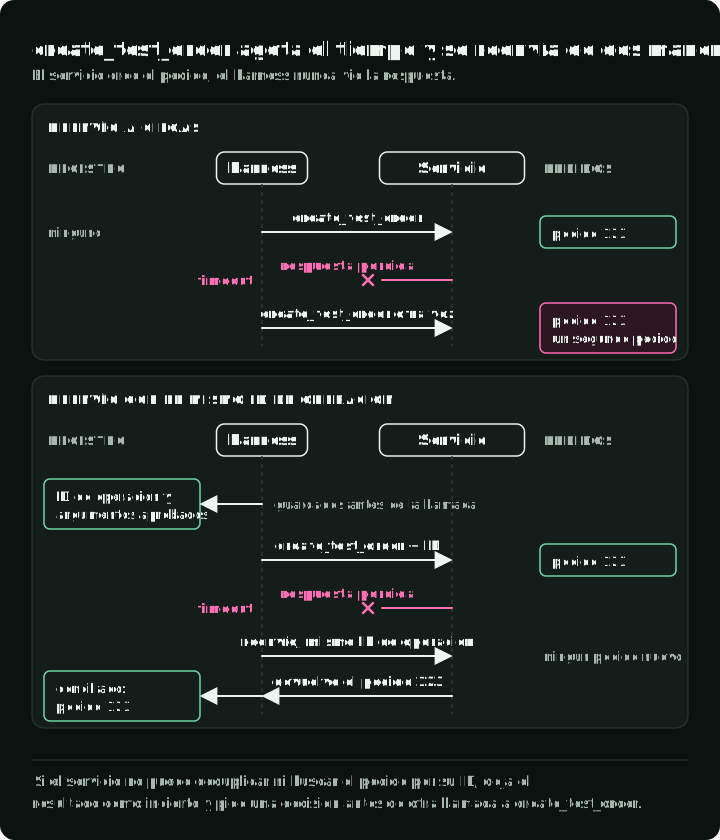
El harness solo puede tomar estas decisiones sin preguntar al modelo si cada tool tiene un contrato explícito. Para create_test_order, ese contrato incluye:
- argumentos validados, para rechazar la entrada mal formada antes de la ejecución;
- un resultado estructurado como
{ "order_id": "123", "created": true }, para que los checks posteriores no tengan que analizar texto libre; - una categoría de efecto: si el call solo lee o modifica un archivo, un registro o un servicio externo, y si repetirlo es seguro;
- una política de timeout y retry, para que una respuesta perdida no desencadene una secuencia ilimitada de calls;
- una regla de permisos: consultar el estado de un pedido puede ejecutarse automáticamente, mientras que crear un pedido puede requerir confirmación.
| Resultado que observa el harness | Siguiente acción |
|---|---|
Un call de solo lectura get_order_status devuelve 503 | Reintentar dentro de un límite si repetir esa consulta es seguro |
create_test_order agota el tiempo; la consulta encuentra el pedido con su ID de operación | Usar el pedido existente y registrar el resultado conciliado |
create_test_order agota el tiempo; el servicio no puede deduplicar ni consultar el estado | Dejar el resultado como incierto y pedir una decisión antes de otra creación |
Ese último estado debe sobrevivir a la caída de un worker. Llamarlo «fallido» sería falso: el pedido podría existir. El registro durable de la operación necesita el payload aprobado, el ID de operación, el estado del envío, el resultado del servidor o la consulta de estado, y cualquier aprobación. La trace ayuda a encontrar ese registro; el transcript solo muestra lo que vio el modelo.
La descripción de una tool ayuda al modelo a elegir una acción. No concede permisos ni demuestra que un retry sea seguro. Si el servicio de pedidos se expone mediante MCP, el cliente debe seguir aplicando su propia validación y política de confianza, y el servidor debe aplicar controles de acceso. La especificación de tools de MCP indica que los clientes deben tratar las anotaciones de comportamiento de las tools como no fiables salvo que procedan de un servidor de confianza. Un servidor que describe create_test_order como de solo lectura no la convierte en tal. La especificación no prescribe una única configuración de confianza, así que redacta una política explícita para tu despliegue que indique qué metadatos del servidor pueden influir en las decisiones de permisos o de retry.
MCP también tiene una forma estándar de conservar el control de un call de larga duración. Con la extensión Tasks oficial, un servidor puede responder a tools/call con un identificador de tarea en lugar de un resultado final. El cliente consulta entonces con tasks/get o detiene el trabajo con tasks/cancel. La especificación de Tasks indica que los clientes deberían persistir los IDs de tarea para poder reanudar la consulta tras una caída, así que guarda el ID de tarea en el mismo registro de la operación. Una tarea completed no significa que la tool haya tenido éxito: un tool result con isError: true también completa la tarea, y solo un error de protocolo la pasa a failed. Cliente y servidor negocian el soporte en cada petición, así que confirma que ambos lo implementan antes de depender de él.
Pasa el progreso a la siguiente sesión
Ahora el agente ficticio debe migrar el checkout del adaptador de pagos v1 al v2. Ha modificado el handler y el cliente, ha arrancado un sandbox de pagos local y ha dejado fallando tests/payment_migration.spec.ts. La tarea dura más que una sesión del modelo. Un resumen de la conversación anterior puede decir que el sandbox está en marcha aunque el proceso ya haya terminado.
La siguiente sesión necesita tres tipos de estado distintos:
| Estado | Qué debe comprobar la siguiente sesión |
|---|---|
| Conversación | La solicitud, las decisiones y los tool results relevantes |
| Espacio de trabajo y runtime | Archivos actuales, rama, procesos y entorno de test |
| Progreso de la tarea | Checks completados, aprobación pendiente o escritura incierta, y siguiente acción |
La compactación sustituye los mensajes antiguos por un resumen más corto para que la sesión actual pueda continuar. Un handoff de progreso es memoria documental para la siguiente sesión. Si la conversación anterior arrastra suposiciones obsoletas, el harness puede iniciar una sesión nueva con el handoff y el espacio de trabajo actual; sustituir un worker caído y restaurar sus procesos es una tarea aparte del runtime.
Un checkpoint puede conservar el estado de ejecución, pero no demuestra que una operación de pago externa se haya confirmado ni que un proceso siga vivo. Un handoff de progreso ayuda cuando el siguiente contexto del modelo carece de un estado de la tarea utilizable. Registra la rama, los archivos modificados, el último comando y su resultado, los IDs de operación pendientes y el siguiente paso sin resolver. Al reanudar, verifica esas afirmaciones frente al espacio de trabajo y el servicio en vivo antes de actuar. Los experimentos de Anthropic con coding agents de larga duración usaron el historial de git y un archivo de progreso para ayudar a las sesiones posteriores a recuperar el trabajo. El informe posterior de Anthropic sobre diseño de harness señala que los handoffs añaden orquestación, tokens y tiempo de ejecución.
El handoff debe ser condicional. Una edición pequeña que termina en una sola sesión no lo necesita. Incluso una tarea larga puede no necesitar otro archivo si su checkpoint ya contiene el progreso requerido y la siguiente sesión puede usarlo. Comprueba si una sesión reanudada repite trabajo completado, pasa por alto una escritura pendiente o actúa sobre un entorno obsoleto. Corrige el estado que falta en lugar de añadir un resumen por defecto.
Diagnostica el fallo antes de añadir un componente
Los tres casos anteriores producen traces distintas: un test de aceptación que falta, una escritura externa incierta y trabajo repetido tras reanudar. Sus soluciones pertenecen a lugares distintos. Un resultado de navegador que falta en el registro de aceptación requiere un check de finalización obligatorio. Un pedido incierto requiere deduplicación o conciliación en el servidor. Una edición repetida tras una sesión nueva requiere un estado de progreso utilizable.
Para la siguiente ejecución, registra la tarea y la versión del harness, la acción propuesta, la aprobación, el tool result, el snapshot probado, el resultado de aceptación, la latency y el coste. Anota los recuentos de tokens de entrada por separado del coste de entrada facturado, incluidas las lecturas en caché: dos harnesses que se comportan de forma idéntica pueden facturar de forma distinta según cómo ensambla cada uno su solicitud y si la caché del proveedor estaba caliente. Mantén los secretos y los datos personales innecesarios fuera de las traces. Enlaza los registros de operaciones externas por ID, ya que un timeout en el cliente no puede revelar lo que hizo el servidor. Cuando un fallo se repita, escribe un caso de regresión que lo reproduzca. Evaluación de AI Agents en producción desarrolla ese proceso de las traces a los tests.
Cada síntoma repetido sugiere un cambio pequeño y una medida que mostraría si ha ayudado:
| Síntoma repetido | Cambio pequeño que probar | Qué medir |
|---|---|---|
| Las consultas de solo lectura fallan de forma transitoria | Retry acotado con backoff | Tasa de recuperación, calls adicionales, tiempo de ejecución |
| Las sesiones reanudadas repiten trabajo completado | Handoff de progreso estructurado | Acciones de tools duplicadas tras reanudar |
| Faltan tests obligatorios al finalizar | Rechazar la finalización hasta que pasen todos los checks obligatorios | Tareas aceptadas sin todos los checks obligatorios |
| Los defectos visuales sobreviven a los checks deterministas | Evaluador con contexto nuevo y una rúbrica | Defectos encontrados, rechazos erróneos, tiempo de revisión |
| El agente edita fuera de su ámbito | Permiso de tool más restringido | Calls bloqueados y anulaciones manuales |
| La memoria recuperada desplaza a la tarea actual | Limitar los hechos recuperados; ordenarlos antes de inyectarlos | Tokens gastados en recuperación, tareas completadas, coste |
| Una regla o un estado indicados nunca llegan al modelo | Capturar la solicitud ensamblada antes de que el call salga | Solicitudes sin la regla; rondas hasta que vuelve a aparecer |
Antes de añadir una política de retry, un handoff o un evaluador, indica qué fallo debería cambiar y qué métrica mostraría la mejora. Cuenta también el coste: tener más tareas aceptadas no sirve de nada si los calls adicionales duplican el tiempo de revisión o crean pedidos duplicados. La autorización, el aislamiento, las reglas de privacidad y los checks de aceptación obligatorios son requisitos; un benchmark de éxito pequeño no es motivo para eliminarlos. Prueba esas restricciones con casos prohibidos explícitos.
Mide un cambio opcional cada vez
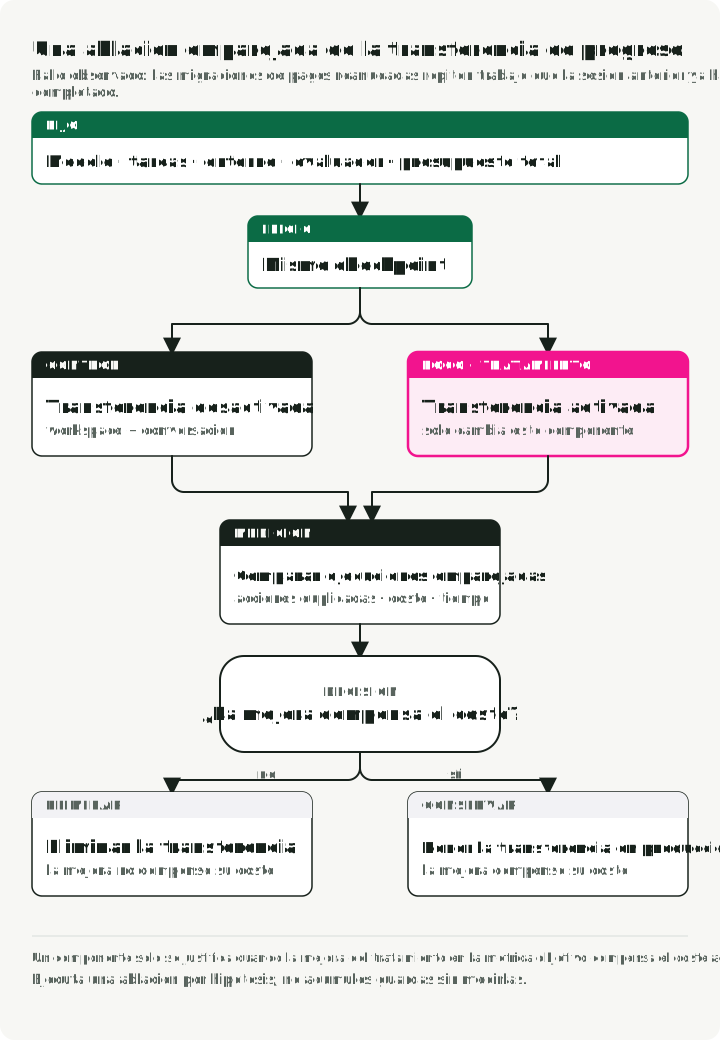
Una ablación compara un harness con y sin un componente, manteniendo fijo el resto del experimento. Usa este protocolo:
- Congela la versión del modelo y el endpoint del proveedor, las instancias de tareas, el entorno y sus límites de cómputo, el evaluador y los prompts fuera del componente que se prueba. Los límites de recursos por sí solos pueden cambiar la puntuación de un benchmark de agentes; el artículo sobre evals recoge la medición de Anthropic.
- Da a ambas variantes el mismo presupuesto total de tokens, tiempo y dinero.
- Elige el número de ensayos o la regla de parada antes de ejecutar la comparación.
- Ejecuta las mismas instancias de tareas en ambas variantes y repite cada tarea, porque la salida del modelo varía.
- Informa de la media con su dispersión o intervalo de confianza.
- Cuenta todos los ensayos iniciados, incluidos timeouts, paradas por política, caídas del harness y fallos del evaluador.
Para la migración de pagos, el handoff de progreso opcional es un candidato. Inicia cada par de control y tratamiento desde el mismo commit del repositorio y el mismo checkpoint inicializado, con el handoff como único cambio.
La medida principal podría ser las acciones de tools duplicadas tras reanudar: una operación sobre un artefacto que la sesión anterior ya había completado. Informa también de las tareas aceptadas, los defectos que se escapan, el tiempo de ejecución, el coste del modelo y del evaluador y los minutos de revisión. Elige de antemano el número de ensayos y la regla de parada, y después informa de la variación en lugar de solo la media. Si el handoff reduce los duplicados pero cuesta más de lo que ahorra, eso es un resultado negativo útil.
El paper de SWE-agent ofrece un ejemplo acotado de ablación de interfaz. Con GPT-4 Turbo sobre la partición SWE-bench Lite de 300 tareas y un límite de $4 por tarea, cambió una característica de la interfaz cada vez:
| Cambio de interfaz | Resueltas |
|---|---|
| Interfaz completa de SWE-agent (referencia) | 18.0% |
| Editor sin linting | 15.0% |
| Archivo completo en lugar de un visor de 100 líneas | 12.7% |
| Historial completo de observaciones en lugar de las cinco últimas | 15.0% |
Son resultados para ese modelo y ese benchmark, no mejoras esperadas para esta tienda ficticia. Lo que se traslada es el método: probar una decisión de interfaz concreta con una configuración fija y después informar de las condiciones junto con la cifra.
Las comparaciones agrupadas son habituales y no pueden identificar el cambio que ayudó. LangChain informa de una mejora en Terminal-Bench 2.0 para deepagents-cli del 52.8% al 66.5% con el modelo fijo, tras cambiar a la vez el system prompt, las tools y el middleware. El informe de ARC-AGI-3 de OpenAI muestra el riesgo inverso: una puntuación casi se triplicó cuando el harness conservó el reasoning y usó compactación, dos ajustes de la API cambiados a la vez. Registra la API, la retención del reasoning, la política de compactación y los presupuestos junto con el ID del modelo; de lo contrario, una aparente regresión del modelo puede ser una capacidad que falta en el adaptador.
Probar un cambio cada vez también detecta cambios que parecen demasiado pequeños para importar. El postmortem de Claude Code de abril de 2026 de Anthropic indica que la API no se vio afectada, pero tres cambios en la capa de producto redujeron la calidad: un esfuerzo de reasoning por defecto más bajo, un bug que borraba el reasoning anterior en cada turno tras una sesión inactiva y una línea del system prompt que limitaba el texto entre tool calls. Cuando Anthropic hizo una ablación de esa línea en un conjunto más amplio de evals, una de ellas mostró una caída del 3% tanto para Opus 4.6 como para Opus 4.7. Una línea de prompt o un ajuste por defecto es un cambio del harness; pruébalo como tal.
Vuelve a validar los componentes cuando cambie el modelo. El informe de Anthropic sobre aplicaciones de larga duración es un caso de estudio cualitativo: cuando salió Opus 4.6, el equipo eliminó componentes del harness uno a uno y descubrió que los calls al evaluador se habían convertido en sobrecarga en tareas que el modelo ya completaba solo, aunque seguían ayudando cerca de su límite.
Incluye una parada de seguridad del proveedor en la suite de fallos: debe detener el envío y pasar a revisión, no reintentar. La parte 4 cubre los detalles.
Prueba la comparación en el laboratorio complementario
El proyecto harness-demo en el commit 517353f3 hace ejecutable la regla de ablación. Sus doce tareas sintéticas genéricas, como fix-parser-edge-case, split-large-module y wire-browser-test, declaran cada una una dificultad y cuatro condiciones: una tool inestable, progreso perdido, una carencia de implementación no detectada y una finalización ambigua. El simulador deriva una quinta para las tareas difíciles que además necesitan un archivo de progreso: sin context_reset, la compactación conserva suposiciones obsoletas. Una función pura marca una tarea como superada cuando la configuración seleccionada gestiona todas las condiciones aplicables. No hay ningún modelo, tool externa ni tarea de coding real. Sus resultados y recuentos de tokens son datos didácticos simulados, no evidencia de que un harness de cinco componentes mejore un agente real.
Clona la revisión fijada y ejecuta los checks y la simulación con uv instalado:
git clone https://github.com/slavadubrov/harness-demo.git
cd harness-demo
git checkout 517353f3a47541d66099983170fe90812b6ef23b
make check
make run
make failures
make check ejecuta Ruff y siete tests unitarios, incluido uno que rechaza una comparación que cambia dos componentes. make run imprime una matriz didáctica acumulativa y cinco pares en los que se omite un componente cada vez. make failures nombra cada fallo simulado; la configuración completa termina con all synthetic tasks pass.
| Componente restaurado en la configuración completa | Sin él | Con él |
|---|---|---|
| Política de retry | 8/12 | 12/12 |
| Handoff de progreso | 7/12 | 12/12 |
| Evaluador nuevo | 8/12 | 12/12 |
| Aceptación fail-closed | 7/12 | 12/12 |
| Reinicio de contexto | 10/12 | 12/12 |
Las filas son consecuencias deterministas de los flags de las tareas y del código del evaluador. No son estimaciones del tamaño de un efecto en un sistema real. La matriz acumulativa anterior añade varios componentes en una sola transición y no puede identificar cuál causó su cambio.
El model.py del laboratorio evita que un cambio agrupado se presente como una ablación: compara todos los campos de componentes de un par, y su test de regresión proporciona un par no válido con el retry y el evaluador cambiados. Esta versión autónoma de la protección se ejecuta sobre un par válido de handoff de progreso:
from dataclasses import dataclass, fields

@dataclass(frozen=True)
class Config:
    progress_handoff: bool = False
    evaluator: bool = False
    retry_policy: bool = False
    fail_closed_acceptance: bool = False
    context_reset: bool = False

def changed_components(control: Config, treatment: Config) -> tuple[str, ...]:
    return tuple(
        field.name
        for field in fields(control)
        if getattr(control, field.name) != getattr(treatment, field.name)
    )

control = Config(progress_handoff=False, evaluator=True, retry_policy=True)
treatment = Config(progress_handoff=True, evaluator=True, retry_policy=True)
assert changed_components(control, treatment) == ("progress_handoff",)
Para llevar el método a un proyecto real, sustituye los flags sintéticos de las tareas por una suite de tareas versionada y los recuentos de tokens simulados por mediciones de traces. Mantén las reglas de aceptación fuera del control del candidato. Un modelo fijo por sí solo no es una comparación controlada si también cambiaron los prompts, los datos de test, los permisos o los ajustes de reasoning y compactación de la API.
Encuentra el código detrás de un comportamiento
Un harness que supera sus ablaciones puede seguir utilizándose cuando cambie el modelo para el que se ajustó, y cambiarlo más adelante requiere el código que implementa un comportamiento. Una solicitud como «enmascarar los secretos en todas las rutas de captura» nombra un comportamiento, no un archivo. En un harness de producción, ese comportamiento puede abarcar varias etapas de ejecución y estado compartido.
Un preprint de 2026 de Wang et al. propone un Harness Handbook para esta búsqueda, que el paper llama behavior localization. El análisis estático extrae un grafo del programa, un LLM agrupa sus unidades en etapas de ejecución y un mantenedor o un coding agent desciende desde una visión general del sistema hasta entradas basadas en el código fuente para una función o un archivo. Cada entrada debe resolverse frente al repositorio actual y se vuelve a sincronizar después de cada cambio.
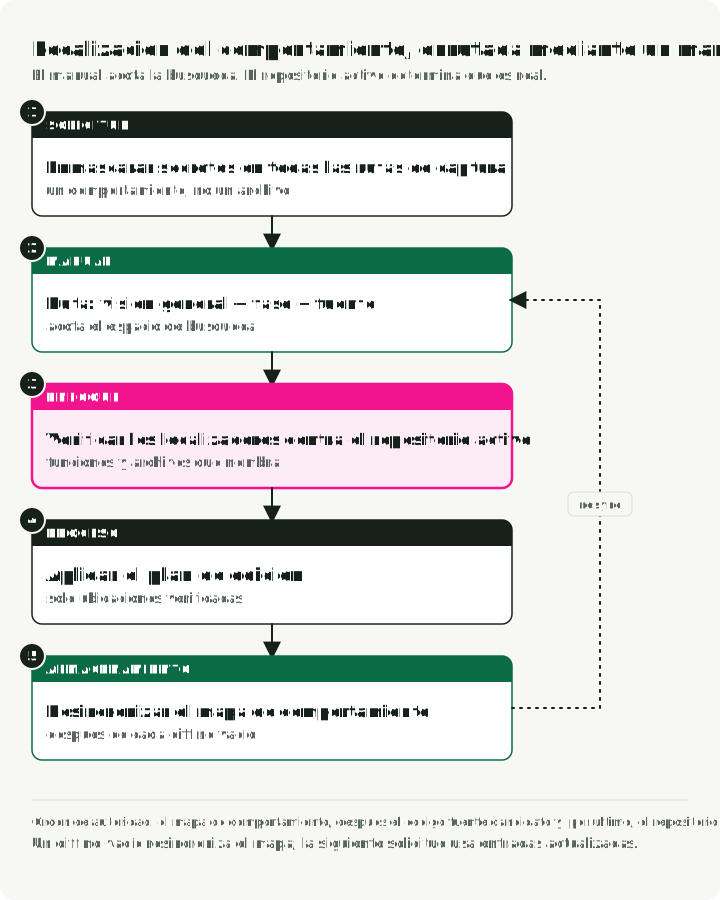
En dos sistemas harness de código abierto, un planner que pasaba por el handbook produjo planes de edición que los jueces preferían con más frecuencia, con menos tokens. El estudio puntuó planes en lugar de cambios ejecutados y no informó de la incertidumbre, así que conviene tratarlo como un enfoque en fase de investigación.
Usa el fallo para encontrar al responsable
Esta serie se ha construido hacia fuera a partir del reasoning loop. Cuando una ejecución falla, busca la primera responsabilidad que pueda evitarlo o detectarlo:
| Qué ocurrió | Investiga |
|---|---|
| Mal siguiente paso con la información correcta disponible | Modelo y reasoning loop |
| Perdió una decisión anterior o repitió trabajo completado | Ensamblado de contexto y memoria |
| No pudo expresar una acción o leer su resultado | Contrato de la tool |
| Ejecutó una acción prohibida | Comprobación de permisos y el servicio que la aplica |
| El worker falló y su entorno desapareció | Runtime y checkpoint |
| Declaró el éxito sin la evidencia requerida | Regla de aceptación del harness y snapshot probado |
Yo empezaría con un modelo capaz, tools restringidas, un sandbox y un check de aceptación explícito. Registra el primer fallo, añade el control más pequeño que lo resuelva y compara con ese control desactivado. Mantén juntas la regla y la trace para que la siguiente actualización del modelo te dé un motivo para conservar o eliminar el componente. Para cada componente, registra quién lo mantiene, cuántos tokens o segundos añade y qué test de regresión justificaría eliminarlo. Seis meses después, alguien que vea progress_handoff=True debería poder encontrar las traces fallidas que lo justificaron y los casos de regresión que todavía lo mantienen.
Referencias
- OpenAI, Unrolling the Codex agent loop.
- OpenAI, Harness engineering: leveraging Codex in an agent-first world.
- Anthropic Engineering, Demystifying evals for AI agents.
- Anthropic Engineering, Effective harnesses for long-running agents.
- Anthropic Engineering, Harness design for long-running application development.
- Lopopolo, Harness engineering: anthology, field guide, and agent context bundle.
- LangChain, Improving Deep Agents with harness engineering.
- OpenAI, How two settings tripled our ARC-AGI-3 scores.
- Wang et al., Harness Handbook: Making Evolving Agent Harnesses Readable, Navigable, and Editable, arXiv:2607.13285, 2026.
- Stripe, Idempotent requests.
- Yang et al., SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering.
- AWS, Making retries safe with idempotent APIs.
- Model Context Protocol, Tools specification.
- Model Context Protocol, Tasks extension y Tasks specification.
- Anthropic Engineering, An update on recent Claude Code quality reports.
El código del Market Analyst Agent de la serie está en GitHub.