Arquitectura de memoria para agentes de AI: checkpoints y almacenes vectoriales

Traducción automática
Este artículo se tradujo automáticamente a partir de la versión original en inglés.
Un agente puede parecer que «olvida» por varios motivos. Puede perder una ejecución sin terminar tras un reinicio, no recuperar una preferencia de una conversación anterior o seguir una nota de proyecto obsoleta. Cada fallo necesita un tipo de estado distinto y una prueba distinta. Este artículo está pensado para ingenieros que diseñan ese estado: verás cuándo usar un checkpoint, una búsqueda exacta, recuperación semántica o un documento inspeccionable, y qué herramientas encajan en cada tarea, desde los checkpoint savers de PostgreSQL y Redis hasta pgvector, Qdrant, archivos Markdown y frameworks de memoria gestionados.
La parte 1 construyó el reasoning loop. Aquí usaremos el Market Analyst Agent para ver qué debe conservar el bucle cuando se detiene antes de publicar un informe y cuando un usuario vuelve con preferencias conocidas.
Cuatro fallos que parecen olvido
«Añadir memoria» es demasiado vago para elegir una implementación. Un requisito útil dice qué debe sobrevivir, quién puede leerlo y qué ocurre cuando es incorrecto.
| Requisito | Estado que conservar | Primer diseño útil | Fallo que probar |
|---|---|---|---|
| Continuar un análisis tras una aprobación o el reinicio de un worker | Mensajes, plan, borrador, paso pendiente del grafo | Checkpoint duradero para ese hilo | Reiniciar antes de publicar; reanudar desde el paso previsto |
| Aplicar la preferencia de riesgo de un usuario que vuelve | Un hecho actual y con nombre, ligado a ese usuario | Perfil estructurado con una clave exacta | Cambiar la preferencia; no usar nunca el valor antiguo |
| Recordar una observación no estructurada de un trabajo anterior | Fuente, texto, propietario, fecha, validez | Registros consultables; embeddings solo si hacen falta | Parafrasear una consulta y comprobar la fuente recuperada |
| Reutilizar una convención del proyecto | Nota revisable y su propietario | Archivo o almacén de documentos | Corregir una nota errónea y confirmar que la siguiente ejecución ve la corrección |
La primera pregunta es si el agente necesita estado almacenado. Un clasificador de una sola pasada cuya entrada completa llega en una petición puede validar su respuesta y terminar. No necesita una base de datos vectorial porque un sistema mayor pueda algún día hacer una pregunta de seguimiento.
Una vez que existe un requisito, esta tabla da una herramienta de partida para cada tarea. Las secciones siguientes explican cuándo pasar a la alternativa.
| Tarea | Empezar con | Pasar a |
|---|---|---|
| Reanudar una ejecución o un hilo | Saver de PostgreSQL de LangGraph | Saver de Redis cuando la latencia del checkpoint sea un cuello de botella medido; saver de SQLite para uso local |
| Leer un hecho de usuario con nombre | Fila de PostgreSQL o columna JSONB, hash de Redis o una clave de Store de LangGraph | Nada más, mientras el hecho tenga un nombre estable |
| Recordar una nota por su significado | Store de LangGraph con índice, o pgvector junto a los datos de la aplicación | Qdrant u otra base de datos vectorial cuando el filtrado, la escala o la operación lo exijan |
| Encontrar una nota por términos exactos | Búsqueda de texto completo de PostgreSQL con un índice GIN | Recuperación híbrida por palabras clave y vectores cuando las paráfrasis burlen las palabras clave |
| Responder preguntas sobre relaciones | Registros relacionales enlazados | Un grafo de conocimiento temporal como Graphiti |
| Mantener revisable el conocimiento del proyecto | Archivos Markdown en el repositorio | Documentos en PostgreSQL con búsqueda de texto completo y vectorial para muchos tenants |
| Delegar la extracción y el mantenimiento en una herramienta | Tus propias reglas de escritura y actualización | Mem0, Letta o LangMem cuando no necesites controlar ese pipeline |
El almacenamiento y el contexto del modelo también son cosas distintas. Una base de datos puede contener un millón de registros; el modelo solo ve el subconjunto que la aplicación selecciona y coloca en su siguiente petición. Guardar un hecho no garantiza que se recupere. Recuperarlo no garantiza que el agente lo use correctamente. Por eso un diseño de memoria necesita, además de una regla de escritura, una regla de lectura y una prueba del resultado.
El artículo de CoALA da nombres útiles a los tipos de información implicados: estado de trabajo para el paso actual; memoria episódica de eventos; memoria semántica de hechos; y memoria procedimental sobre cómo actuar. El modelo de persistencia de LangGraph hace una distinción diferente, a nivel de implementación: un checkpointer guarda el estado de un hilo, mientras que un store guarda datos de la aplicación entre hilos. Un documento puede contener un evento, un hecho o un procedimiento. Estas categorías dicen qué significa la información; no prescriben una base de datos por categoría.
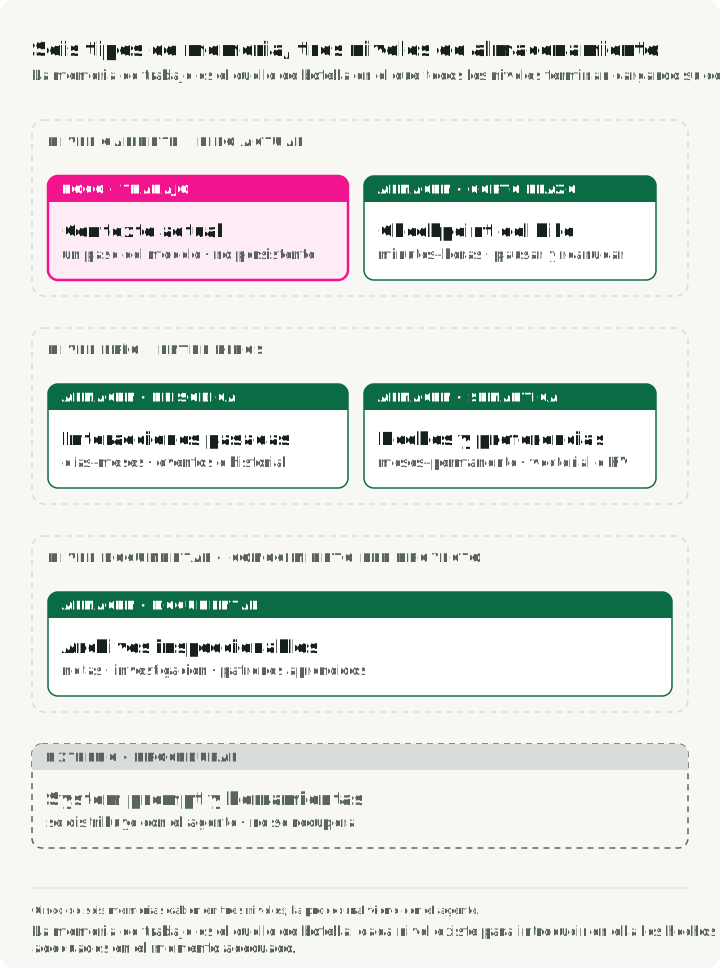
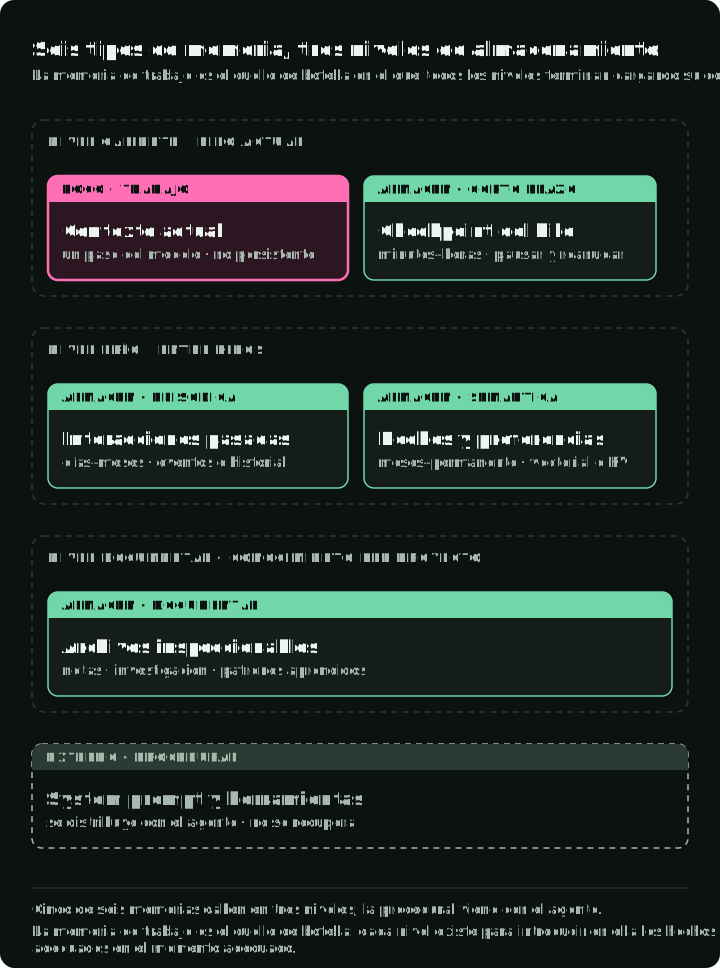
La figura coloca esos tipos en los tres almacenes usados en este artículo: un checkpoint para el hilo actual, registros entre hilos y documentos para el conocimiento del proyecto. Lee una columna de arriba abajo para ver que un mismo almacén puede contener varios tipos de información. Los procedimientos pueden distribuirse con el agente como instrucciones y herramientas, o almacenarse y recuperarse como cualquier otro documento.
El estado de trabajo puede vivir en variables del proceso y en la petición actual al modelo. Los mensajes y los tool results seleccionados deben caber en la ventana de contexto del modelo; el estado de la aplicación puede ser mayor. Si el proceso termina, solo se puede recuperar la parte que se persistió deliberadamente. «Corto plazo» y «largo plazo» describen el alcance de la reutilización, no periodos de retención fijos. La política de retención de la aplicación decide cuándo se borra cada uno.
Un checkpoint permite que la ejecución continúe
Pensemos en un análisis que ha reunido evidencias y redactado un informe, y que luego se detiene a la espera de aprobación. Si su worker termina, otro worker necesita conocer el borrador, el estado de la aprobación y qué nodo del grafo viene después. Una transcripción de la conversación no dice por sí sola si el informe ya se publicó.
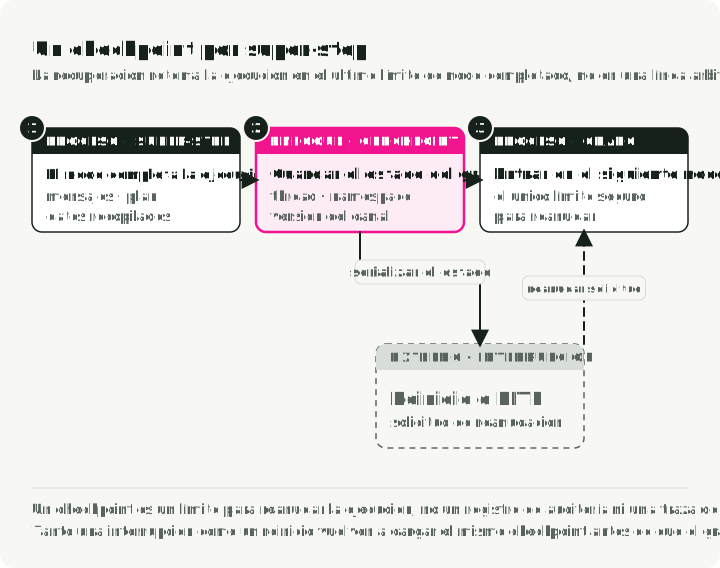
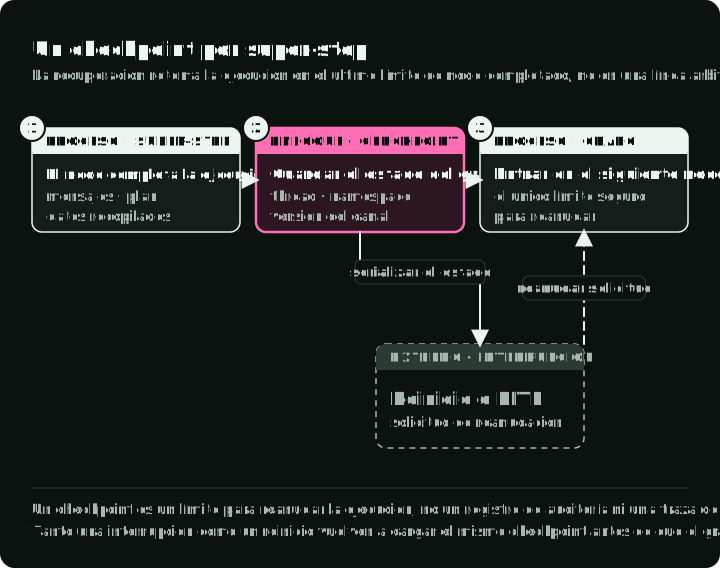
LangGraph guarda el estado del grafo en los límites de super-step. Un super-step es una ronda de nodos planificados; varios pueden ejecutarse en paralelo. El estado guardado del hilo incluye valores e información de planificación, de modo que una ejecución puede continuar desde un límite completado. No puede reanudarse desde una línea arbitraria dentro de un nodo. La documentación de checkpointers también describe las escrituras pendientes de nodos que terminaron dentro de un super-step fallido. Un checkpoint es un registro de recuperación, no una traza completa de todo lo que hizo el agente.
El proyecto de ejemplo hace visible ese límite. Su factoría de grafos compila con un checkpointer e interrumpe antes del nodo de publicación. La ruta de aprobación lee el estado guardado, comprueba que la publicación es el paso pendiente, registra la aprobación y reanuda. La configuración de checkpoints usa PostgreSQL por defecto y puede seleccionar Redis. Invoca con durability="sync" cuando un fallo no deba perder el último paso completado.
El modo de durabilidad decide qué puede perder un fallo. En los modos documentados de LangGraph, las escrituras asíncronas dejan que el siguiente paso se ejecute antes de que termine un checkpoint; por tanto, un fallo puede perder el último paso. El modo síncrono espera a cada escritura del checkpoint antes de avanzar. El modo de salida guarda cuando el grafo termina, así que no puede recuperarse de un fallo a mitad de una ejecución larga. Elige el modo a partir del requisito de recuperación y después prueba un reinicio forzado en el límite que importa. La figura ejecuta el mismo grafo con cada modo y lo hace fallar durante el tercer super-step.
Qué guarda un saver
Todo backend de checkpoints de LangGraph implementa BaseCheckpointSaver: put() escribe un checkpoint, get_tuple() lee el más reciente de un hilo y list() devuelve su historial. Cada checkpoint se identifica por (thread_id, checkpoint_ns, checkpoint_id). El thread_id identifica la conversación, checkpoint_ns separa subgrafos y checkpoint_id identifica una versión. Un thread_id localiza el estado guardado; no establece quién llama ni autoriza el acceso a ese hilo.
El saver de PostgreSQL de langgraph-checkpoint-postgres crea sus tablas en setup(). Dos workers que escriben en el mismo hilo quedan separados por la clave del checkpoint y por upserts, no por bloqueos: no corromperán las filas del otro, pero tampoco se coordinarán. Da a cada ejecución un único escritor activo, como describe la parte 5.
Una configuración mínima de PostgreSQL, suponiendo que create_graph construye y compila tu grafo:
from langgraph.checkpoint.postgres.aio import AsyncPostgresSaver

async def run(connection_string: str, authenticated_user_id: str) -> None:
    # from_conn_string owns the connection, so the graph runs inside this block.
    async with AsyncPostgresSaver.from_conn_string(connection_string) as checkpointer:
        await checkpointer.setup()  # creates the tables; safe on every start
        graph = create_graph(checkpointer=checkpointer)
        config = {"configurable": {"thread_id": "analysis-42"}}
        await graph.ainvoke({"user_id": authenticated_user_id, "messages": [...]}, config)
        # Later, after the server authenticates the approver:
        await graph.aupdate_state(config, {"report_approved": True})
        await graph.ainvoke(None, config)  # continue from the saved interrupt
El user_id procede del contexto de petición autenticado del servidor, nunca del modelo ni del JSON del cliente. Si alguien distinto de la aplicación pudiera escribir filas de checkpoint, establece LANGGRAPH_STRICT_MSGPACK=true para que la deserialización acepte solo tipos seguros o declarados, como describe el aviso de seguridad de LangGraph.
Un checkpoint no hace segura una escritura externa
Supón que el nodo de publicación envía un informe a un servicio externo. El servicio lo acepta, pero su respuesta se pierde antes de que el grafo guarde el siguiente checkpoint. Reiniciar desde el checkpoint anterior puede volver a ejecutar el nodo. Ningún ajuste de la base de datos de checkpoints puede saber si esa escritura externa tuvo éxito.
Para una escritura repetible, asigna a la operación un identificador propiedad de la aplicación y haz que el destino reconozca un reintento con ese identificador. Si no puede hacerlo, la recuperación debe comprobar el destino o pedir una decisión humana antes de repetir la acción. Lo mismo ocurre con pagos, mensajes y escrituras de archivos. Un checkpoint responde a «¿dónde puede reiniciarse la ejecución?»; la operación externa necesita su propia respuesta a «¿ya ha ocurrido esta acción?». La guía de AWS sobre API idempotentes explica el contrato del lado del servicio. La figura sigue una respuesta perdida con y sin ese identificador.
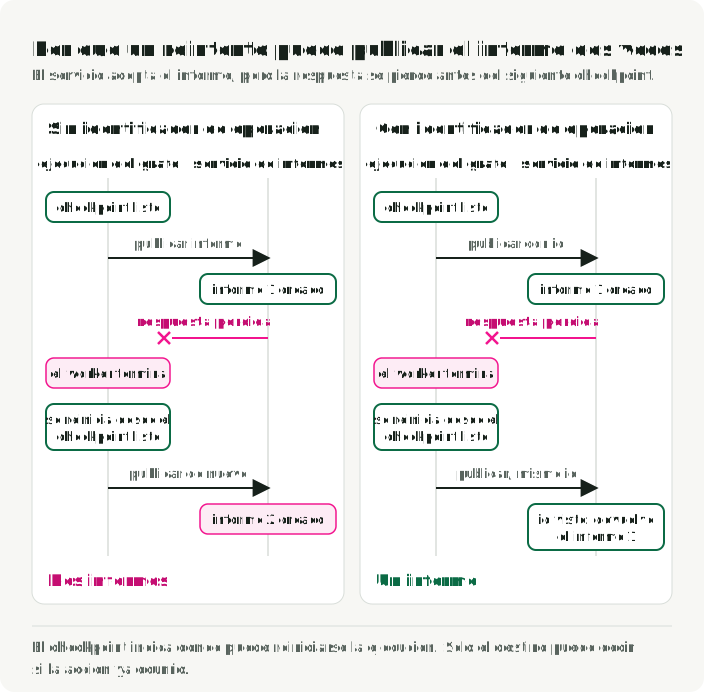
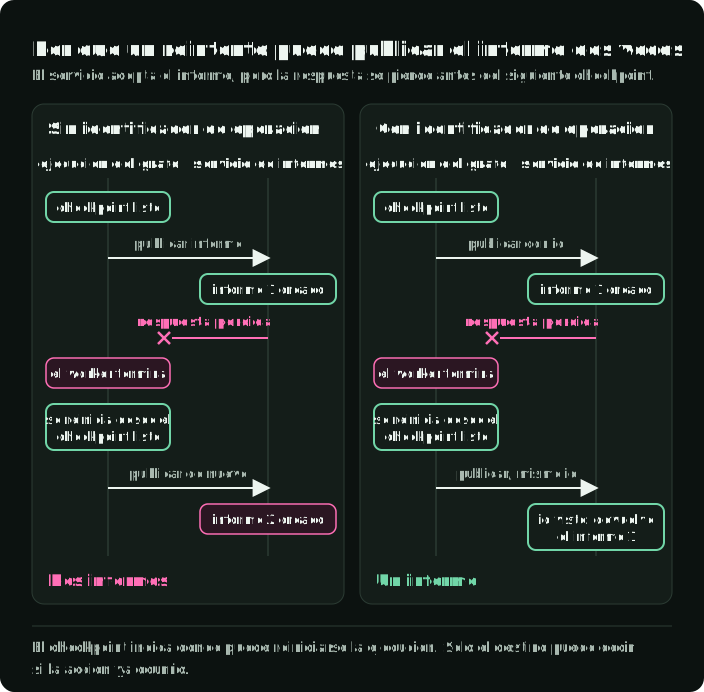
Mantén los registros de negocio separados del estado del grafo. Un archivo de informes registra qué se publicó; un checkpoint registra cómo llegó el grafo a ese paso o cómo lo esperaba. Un registro de eventos o una traza puede registrar cada acción intentada. Ninguno de los tres sustituye a los otros dos. La parte 5 vuelve sobre la recuperación y las evidencias del runtime.
Elige el backend según los requisitos de recuperación
El proyecto de ejemplo admite checkpoint savers de PostgreSQL y Redis. Comparten el papel de cara al grafo, pero su comportamiento operativo depende de la base de datos y del saver configurados.
| Pregunta | PostgreSQL | Redis |
|---|---|---|
| ¿Qué hay que operar? | Una base de datos relacional, su almacenamiento, copias de seguridad y tablas de checkpoints | Memoria de Redis, desalojo, persistencia y ajustes de copia de seguridad |
| ¿Qué historial se necesita? | Historial completo de checkpoints con el saver estándar | Revisa el saver elegido y la política de retención; un saver superficial solo guarda el último checkpoint |
| ¿Qué debería decidir? | La operación existente de la base de datos, las necesidades de recuperación y el coste de escritura medido | La latencia de checkpoint medida, la pérdida tolerada y los ajustes reales de persistencia |
Si PostgreSQL ya da servicio a la aplicación y el historial duradero importa, yo empezaría por ahí. Encaja en ejecuciones largas en las que perder el estado supone horas de recálculo, en dominios donde la durabilidad es obligatoria y en equipos que quieren depuración con viaje en el tiempo a partir del historial de checkpoints. Con pgvector, la misma base de datos puede contener también la memoria a largo plazo y la búsqueda vectorial, lo que deja un solo sistema que operar.
Elige Redis cuando el acceso a los checkpoints sea un cuello de botella medido, como en un chat en streaming o en voz, o cuando Redis ya sea el almacén de estado adecuado del sistema. Afirmar que Redis es «más rápido» no es una medición de este grafo: el tamaño del estado serializado, la frecuencia de escritura, la ruta de red y la política de persistencia influyen en el resultado. El paquete langgraph-checkpoint-redis también ofrece un ShallowRedisSaver que guarda solo el último checkpoint por hilo: suficiente para pausar y reanudar, sin historial para depurar.
Elige la política de persistencia de Redis según la pérdida que puedas tolerar; con la configuración habitual de solo anexado (append-only), un fallo puede perder alrededor de un segundo de escrituras. Prueba la recuperación ante fallos con los ajustes reales.
Otros dos savers cubren configuraciones habituales. langgraph-checkpoint-sqlite encaja en el desarrollo local y en despliegues de un solo proceso. En AWS, langgraph-checkpoint-aws ofrece un DynamoDBSaver que descarga los checkpoints grandes en S3.
El historial de checkpoints crece. Borrar filas antiguas con una consulta SQL genérica basada en la antigüedad puede romper la reconstrucción cuando los checkpoints conservados dependen de escrituras anteriores o de delta channels. Usa una operación de retención admitida por el saver cuyo comportamiento de recuperación hayas probado. Si no existe ninguna para la versión instalada, conserva el historial necesario hasta que puedas verificar un procedimiento de poda.
La memoria entre hilos necesita una regla de actualización
Un usuario que vuelve puede tener una preferencia de riesgo que debería influir en un nuevo análisis. Ese hecho no debería quedar escondido en el checkpoint de una conversación antigua: la nueva petición puede usar otro hilo. Necesita un registro entre hilos con un propietario, una forma de leerlo y una forma de sustituirlo o borrarlo.
La implementación de memoria a largo plazo del proyecto de ejemplo guarda perfiles de usuario en Qdrant. Su ruta get_profile usa un filtro exacto por ID de usuario, y al guardar un perfil se usa un ID de punto determinista para las actualizaciones. La ruta del perfil es almacenamiento entre hilos, no recuperación semántica. Un perfil con campos con nombre, como la tolerancia al riesgo y el horizonte de inversión, también podría vivir en una columna JSONB de PostgreSQL o en un hash de Redis, que son más sencillos que generar embeddings y consultar vectores. Añadir embeddings no aportaría nada a esta búsqueda exacta.
El ID de usuario de una consulta al store debe proceder de una identidad de aplicación verificada cuando esto se expone como servicio. Un filtro de payload de Qdrant acota la recuperación; no es autenticación. El proyecto de ejemplo también tiene una interfaz de línea de comandos que acepta un ID de usuario. Esa interfaz es útil para una demo local, pero una aplicación que da servicio a varias personas debe comprobar la propiedad antes de leer o escribir perfiles. La documentación de multitenancy de Qdrant describe filtros e índices por tenant; la aplicación sigue decidiendo quién puede aportar el valor del tenant.
El store de LangGraph
La Store API de LangGraph guarda elementos entre hilos como pares (namespace, key) con un valor JSON. El namespace suele codificar al propietario, por ejemplo ("user", user_id, "preferences"). BaseStore ofrece put(), get(), search() y delete(), con acotación jerárquica por namespace. Tres implementaciones cubren la mayoría de las necesidades:
InMemoryStorepara desarrollo y pruebas; los datos se pierden cuando el proceso termina.PostgresStorepara un store persistente consultado con SQL.AsyncRedisStore, del paquete de Redis, para memoria entre hilos con búsqueda vectorial, TTL y filtros de metadatos.
Una configuración index añade búsqueda vectorial sobre los elementos guardados con una función de embedding que tú proporcionas. Para muchas aplicaciones, este store integrado basta antes de recurrir a una base de datos vectorial dedicada:
from langgraph.store.memory import InMemoryStore

store = InMemoryStore(index={"dims": 1536, "embed": embed_texts})

async def remember_and_recall(user_id: str) -> list:
    await store.aput(
        ("user", user_id, "preferences"),
        "risk-profile",
        {"risk_tolerance": "high", "horizon": "long-term"},
    )
    # The namespace prefix is positional in search and asearch.
    return await store.asearch(("user", user_id), query="investment style", limit=5)
Pasa el store al compilar el grafo, junto al checkpointer, y un nodo podrá declarar un parámetro store para leerlo: builder.compile(checkpointer=checkpointer, store=store).
Cuándo añadir recuperación semántica
Ahora cambiemos la petición: «¿Qué preocupación planteé sobre los proveedores en el último análisis?». Puede que la nota útil no tenga una clave estable conocida por quien llama. La búsqueda por significado puede encontrar notas candidatas aunque la pregunta use otras palabras. Esa necesidad es el motivo para añadir embeddings. Tener una base de datos vectorial disponible no lo es.
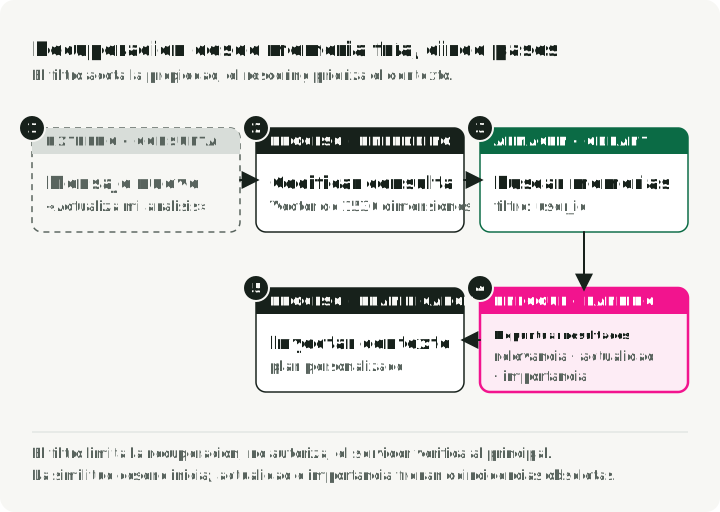
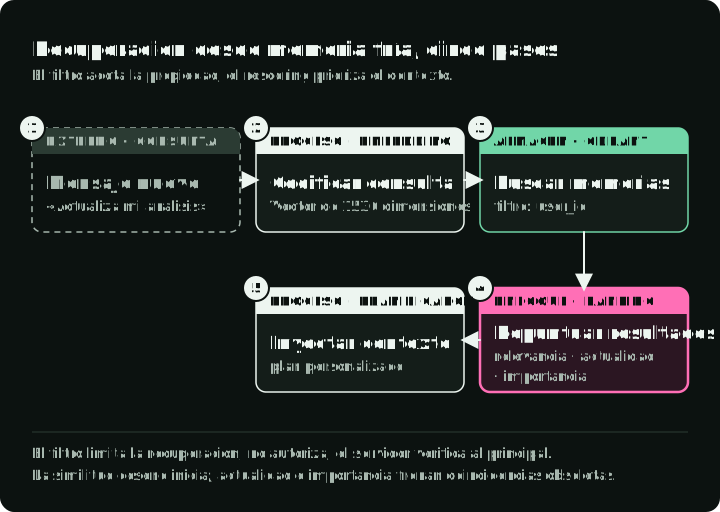
Una extensión ilustrativa extraería un hecho candidato breve de una conversación terminada, le adjuntaría su fuente y su propietario, generaría un embedding y guardaría tanto el texto como el vector. Ante una petición posterior, la aplicación restringiría primero la búsqueda a ese propietario, recuperaría candidatos, comprobaría si siguen siendo válidos y daría al modelo solo los hechos relevantes y atribuidos.
El hecho extraído es solo un candidato. Un modelo puede inferir una «preferencia» a partir de un único mensaje ambiguo. Antes de promoverlo a memoria duradera, decide qué hechos requieren confirmación del usuario, cuáles pueden actualizarse automáticamente y cuáles no deben inferirse nunca. Conserva la fuente y la hora de la observación para que una corrección posterior pueda sustituir un hecho. La similitud mide cercanía temática; no establece verdad, validez actual ni permiso.
Dónde viven los vectores es una decisión aparte. pgvector los mantiene en la base de datos PostgreSQL que la aplicación ya ejecuta. Qdrant es una base de datos vectorial dedicada con indexación HNSW y búsqueda filtrada; el artículo sobre ranking de búsqueda trata HNSW y sus compromisos. Qdrant también publica un servidor MCP que expone una colección como herramienta de memoria para clientes MCP. Un servicio dedicado es útil cuando se necesita su recuperación, su filtrado, su escala o su encaje operativo; demuestra esa necesidad con tus propias consultas y tu propio corpus antes de añadirlo.
La similitud coseno sin más es solo una señal de partida. El artículo de Generative Agents combinó tres señales para recuperar los recuerdos de agentes simulados: la recencia, con decaimiento exponencial; la importancia, puntuada por un modelo en una escala de 1–10; y la relevancia, como similitud de embeddings. Normalizó las tres antes de sumarlas con pesos iguales. Si adoptas la idea, normaliza primero, porque si no la puntuación de importancia de 1–10 domina, y ajusta los pesos frente a pruebas reservadas de recall y de tarea. Si la recuperación semántica devuelve una preferencia desactualizada porque su redacción se parece a la nueva pregunta, corrige la regla de validez antes de ajustar pesos. Un valor estructurado con una actualización explícita sigue siendo la respuesta más sencilla para una preferencia con nombre.
Prueba la búsqueda por palabras clave o de texto completo cuando nombres y términos exactos identifiquen la nota. Usa embeddings cuando las paráfrasis burlen esa búsqueda con regularidad. Si importan ambas, recupera candidatos por las dos rutas antes de combinar sus rankings. Reordenar los resultados por palabras clave solo con puntuaciones vectoriales no puede recuperar una nota relevante que el filtro de palabras clave ya descartó.
| Enfoque | Ideal para | Principal coste operativo |
|---|---|---|
| Almacén clave-valor (JSONB de PostgreSQL, hash de Redis) | Perfiles y preferencias estructurados | Uso de memoria y política de persistencia |
| Búsqueda de texto completo (GIN de PostgreSQL) | Recall por palabras clave sobre el historial de conversaciones | Crecimiento del índice y ajuste de consultas |
| Búsqueda vectorial (pgvector, Qdrant) | Recall semántico de notas no estructuradas | Ciclo de vida de embeddings e índices |
| Híbrido (palabras clave + vectores) | Recall cuando la redacción de la consulta varía | Dos rutas de puntuación que ajustar y evaluar |
| Grafo de conocimiento (Graphiti, Neo4j) | Relaciones entre entidades y consultas de varios saltos | Modelado del grafo y otro sistema de datos |
| Almacén de documentos (archivos) | Conocimiento del proyecto y notas gestionadas por el agente | Concurrencia, permisos y búsqueda |
Relaciones y frameworks gestionados
Las relaciones pueden requerir otra forma. Una pregunta como «¿Qué proveedores anteriores estuvieron vinculados a esta empresa y cuándo fue válido cada vínculo?» es candidata a un grafo temporal. Graphiti, de Zep, construye un grafo de conocimiento que registra cuándo fue cierto cada hecho además de qué era cierto, y conserva los valores sustituidos con sus intervalos de validez. En el benchmark DMR del artículo de Zep, Zep quedó a menos de medio punto de poner la conversación completa en el contexto, así que ese resultado no demuestra una ventaja general de los grafos temporales. La extracción y las actualizaciones siguen teniendo que determinar si una relación es correcta. Si los registros enlazados responden a las consultas, úsalos en lugar de operar otro servicio de grafos.
Los frameworks de memoria ejecutan por ti el pipeline de extracción, consolidación y recuperación. En Mem0, un modelo extrae hechos candidatos, compara cada uno con las entradas existentes y decide si añadir, actualizar, borrar o dejar la memoria sin cambios. Letta, antes MemGPT, da al agente herramientas para mover datos entre la «core memory» dentro del contexto y la «archival memory» fuera del contexto. LangMem proporciona herramientas de gestión de memoria para agentes de LangGraph. Evalúa uno cuando quieras un pipeline funcional rápidamente y no necesites controlar cada regla de escritura; la retención, el borrado y las pruebas de más abajo siguen siendo responsabilidad tuya.
Los documentos hacen inspeccionable el conocimiento acumulado
Parte de la memoria se lee mejor como documento. Un agente de programación puede necesitar el comando de pruebas y las notas de arquitectura de un proyecto. Un agente de investigación puede necesitar una lista de fuentes revisada y el razonamiento detrás de una decisión anterior. Son piezas de conocimiento conectadas que una persona debería poder leer, corregir y versionar.
Pensemos en un agente de programación que trabaja durante semanas en un proyecto. Aprende que el proyecto usa Pydantic v2, que las pruebas se ejecutan con pytest -x --tb=short y que el desarrollador prefiere pathlib a os.path. Estos hechos podrían estar en un almacén clave-valor, pero un archivo permite al desarrollador leerlos, corregir uno erróneo con una edición normal y revisar cada cambio en git diff.
Los asistentes de programación ya usan este patrón:
- Claude Code lee archivos
CLAUDE.mddel proyecto y de sus directorios padre, y guarda la memoria de cada proyecto en Markdown bajo~/.claude/projects/. Los archivos del proyecto se confirman junto con el código. - Cursor carga reglas del proyecto desde
.cursor/rulescomo archivos.mdc, con un front matter que controla cuándo se aplica cada regla. - Devin Desktop lee reglas de
.devin/rules/y puede guardar memorias generadas automáticamente por espacio de trabajo. - La herramienta de memoria de Anthropic para la API de Claude es una herramienta del lado del cliente cuyos comandos de archivo (view, create, edit, delete, rename) operan sobre un directorio
/memories. Tu aplicación implementa cada comando, así que decide si los archivos viven en disco, en S3 o en una base de datos.
La DocumentMemory del proyecto de ejemplo escribe envoltorios JSON con contenido, metadatos y fecha de creación bajo namespaces. Su nodo de publicación archiva un informe aprobado en el namespace de investigación. Un agente de investigación podría usar esta estructura:
.agent-memory/
    README.md                  # What this directory is, for human readers
    PROGRESS.md                # Handoff for the next session: done, next
    user-profiles/user-123.md  # Preferences and risk profile
    research/NVDA-2026-02.md   # Notes from a recent analysis
    conventions/analysis-format.md
    learnings/common-errors.md # Mistakes the agent has learned to avoid
La figura muestra las dos vías de entrada a ese directorio: las llamadas del agente y las ediciones de una persona.
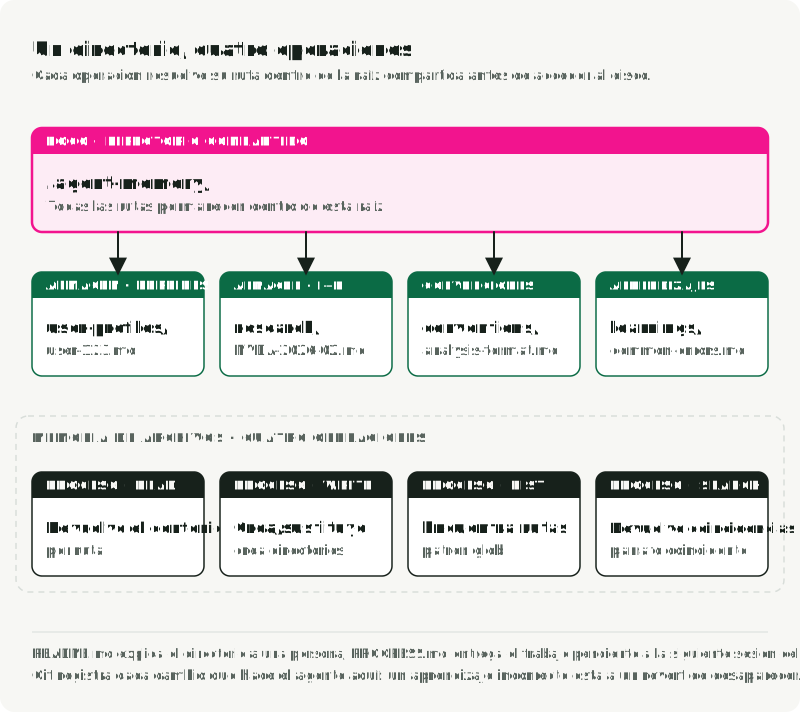
Para un solo proyecto cuyas notas necesitan revisión humana, Markdown sin más puede bastar. Usa nombres que digan qué cubre un documento; registra su fuente y su última revisión cuando afecten a la confianza. El agente necesita cuatro operaciones: leer un documento, escribir uno, listarlos y buscarlos por palabra clave. Los archivos cortos, como una nota de convenciones o de traspaso, pueden cargarse enteros; un corpus grande sigue necesitando recuperación. Cuando la búsqueda sobre esos archivos se vuelva lenta o no encuentre notas relevantes, añade un índice de palabras clave o vectorial manteniendo una única copia de referencia. El número de documentos por sí solo no decide cuándo hace falta ese índice.
Una interfaz de archivos no se limita a la búsqueda por palabras clave. En una evaluación realizada por el propio proveedor, Letta informó de un 74,0 % en el benchmark LoCoMo de conversaciones largas para un agente con GPT-4o mini que buscaba semánticamente en archivos adjuntos, frente al 68,5 % de la mejor variante con grafo de Mem0. Es un proveedor, un modelo, un benchmark y un harness; muestra que una interfaz basada en archivos puede funcionar en esa configuración, no que Markdown sin más sea suficiente.
| Pregunta | Almacén vectorial | Almacén clave-valor | Almacén de documentos |
|---|---|---|---|
| Patrón de consulta | «Encuentra notas similares a X» | «Obtén el valor de la clave» | «Lee el documento en esta ruta» |
| Ideal para | Recall variado y no estructurado | Búsquedas estructuradas | Contexto y notas del proyecto |
| Revisión humana | Inspeccionar payloads y puntuaciones | Claves exactas, valores JSON | Leer y editar Markdown |
| Control de versiones | Mediante exportaciones o registros de cambios | Posible | Nativo con Git |
| Pipeline de embeddings | Necesario | No necesario | No necesario |
| Búsqueda | Similitud semántica | Coincidencia exacta | Ruta, palabra clave, índice opcional |
Usa documentos cuando el agente acumule conocimiento del proyecto entre sesiones y las personas necesiten inspeccionarlo, corregirlo o versionarlo. Usa un almacén vectorial cuando las consultas varíen en su redacción a lo largo de muchas notas separadas. Usa un almacén clave-valor cuando el esquema sea conocido y las búsquedas sean exactas. Los tres pueden coexistir, pero ninguna aplicación necesita los tres por defecto.
El límite de los archivos requiere cuidado cuando los agentes pueden escribir. Acota cada lectura y escritura al proyecto o usuario previsto. Rechaza el path traversal y las salidas mediante enlaces simbólicos. Coordina a los escritores concurrentes y decide qué ediciones requieren revisión humana. Los archivos recuperados son datos de la tarea de menor confianza: una nota que diga «ignora la aprobación» no puede cambiar la regla de aprobación de la aplicación.
Servir documentos a muchos tenants
Los archivos encajan con un desarrollador o con un sistema de archivos controlado. Varios tenants y escritores concurrentes necesitan control de acceso explícito y coordinación de escrituras. Hay tres diseños habituales:
- Escribir en archivos, servir desde una base de datos. Los desarrolladores editan Markdown y lo confirman; el despliegue sincroniza los archivos en filas de PostgreSQL y el agente lee filas indexadas durante el runtime.
- Almacenamiento de objetos con un índice vectorial. Los documentos viven en S3 o GCS, y una colección de Qdrant indexa sus embeddings. El agente encuentra los ID de documento en Qdrant y después obtiene el contenido del almacenamiento. Esto escala horizontalmente, a costa de dos sistemas, un pipeline de embeddings y consistencia eventual entre ellos.
- Documentos en PostgreSQL con búsqueda híbrida. Guarda cada documento como una fila con metadatos, un índice de texto completo y un embedding opcional de pgvector. Así se obtiene búsqueda por palabras clave y semántica, transacciones y un único sistema que operar. Para un servicio multi-tenant, yo empezaría por aquí.
Para el tercer diseño, toma el tenant de la petición autenticada, nunca del modelo ni del cliente, y haz que PostgreSQL lo aplique mediante seguridad a nivel de fila. Usa un rol de aplicación que no sea propietario de las tablas y que no tenga privilegios de superusuario ni BYPASSRLS; si ese rol debe ser propietario de una tabla, usa también ALTER TABLE ... FORCE ROW LEVEL SECURITY. Prueba una consulta sin filtro de tenant con el rol real de la aplicación y confirma que no devuelve filas de otros tenants. Combina las coincidencias por palabras clave y vectores como se describe arriba para la recuperación semántica.
Un procedimiento también es distinto de una observación recordada. Voyager guardaba programas ejecutables reutilizables y los recuperaba por su descripción. Agent Workflow Memory, en cambio, añade al prompt workflows web inducidos como guía. Una nota de proyecto puede describir cómo ejecutar una comprobación. Los programas ejecutables necesitan pruebas y ejecución restringida; las notas necesitan revisión de hechos y una comprobación de que seguirlas ayuda. Ninguno debería adquirir nuevos permisos por haberse recuperado de la memoria. Una Agent Skill es el caso vecino: un archivo SKILL.md que indica al agente cómo realizar un tipo de trabajo, y que la parte 3 compara con las herramientas.
La compactación cambia el contexto, no la fuente de verdad
Una conversación larga acaba necesitando una selección. La aplicación puede omitir mensajes antiguos o resumirlos para que la siguiente petición al modelo quepa en su presupuesto de contexto. La compactación del lado del servidor de Claude, una función beta en septiembre de 2026, devuelve un bloque compaction que las peticiones posteriores usan en lugar del contenido anterior. Ese resumen puede ayudar al modelo a continuar, pero puede perder un ID de pedido, una propuesta rechazada o una condición de aprobación.
Mantén los hechos operativos en estado explícito: el paso pendiente del grafo, los efectos externos completados y el estado exacto de la aprobación. Mantén los hechos entre hilos en registros con propietarios y reglas de actualización. Usa un resumen para aportar contexto y después prueba lo que omitió: fuerza la compactación a mitad de una prueba y comprueba si la siguiente acción sigue respetando una restricción anterior. Elige un hecho que el resumen no pueda reconstruir por conjetura, como un ID de operación o la condición exacta asociada a una aprobación, y compruébalo contra el estado de referencia en lugar de contra la redacción del resumen. Evalúa la redacción del resumen en una comprobación propia y separada. Un checkpoint restaura la ejecución del grafo; la compactación acorta la entrada del modelo; la recuperación selecciona información para una nueva petición. Son operaciones separadas aunque un mismo harness realice las tres.
La compactación también reinicia la caché de prefijos del proveedor, y asumir ese reinicio pocas veces, en un salto grande, sale más barato que recortar unos pocos mensajes en cada ronda. Los proveedores reutilizan el trabajo sobre un prefijo de petición estable, así que reemplazar mensajes antiguos cambia el prefijo y la siguiente petición paga el precio completo por lo que viene después. Un salto grande cuesta una lectura a precio completo de una entrada mucho más pequeña y luego vuelve a los añadidos baratos, mientras que los recortes pequeños y continuos pagan ese coste una y otra vez y pueden hacer que una conversación más corta salga más cara que una más larga. Elige el umbral de compactación probándolo con tu modelo y tu tarea, en lugar de fijarlo en una fracción de la ventana de contexto.
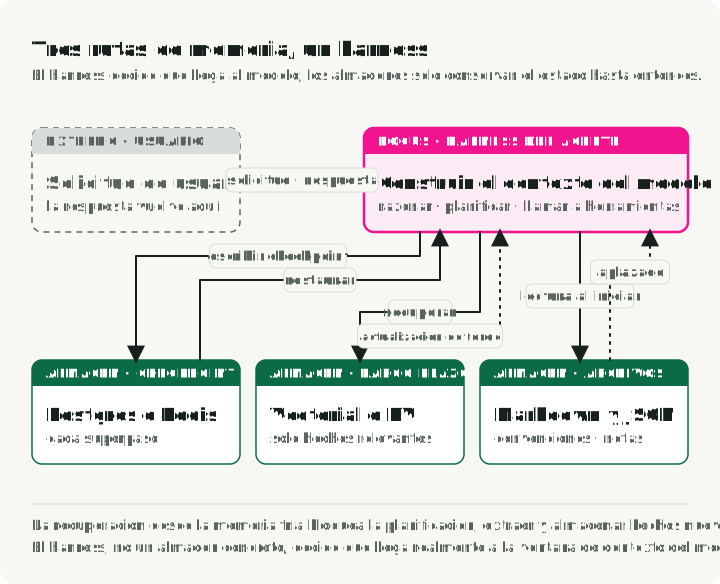
La figura muestra las tres rutas juntas. La ruta del checkpoint escribe en cada super-step y restaura al reanudar. La ruta de largo plazo se lee antes de planificar, así que su latencia retrasa el plan; los hechos nuevos pueden escribirse después de la respuesta. La ruta de documentos se lee durante la planificación y se escribe a medida que termina el trabajo. El harness, y no ningún almacén concreto, decide qué llega al modelo.
En el Market Analyst Agent, el checkpoint permite que su grafo se detenga antes de publicar y continúe más tarde. Qdrant proporciona una búsqueda exacta del perfil para el siguiente análisis. El almacén de documentos archiva un informe tras la aprobación. Ni la compactación ni la recuperación semántica son necesarias para explicar esos comportamientos implementados.
Costes y riesgos que conviene prever
- Coste y latencia de los embeddings. Cada nota guardada necesita un embedding y cada consulta semántica genera el embedding de la pregunta. En septiembre de 2026, OpenAI indica un precio de $0.02 por millón de tokens para
text-embedding-3-small; el coste por hecho es pequeño, pero crece con los usuarios y las sesiones. Agrupa las escrituras, cachea los embeddings de consultas frecuentes o ejecuta un modelo de embeddings local cuando la ruta de lectura sea sensible a la latencia. - Presupuesto de contexto. Cada hecho recuperado resta tokens a la tarea. Limita cuántos hechos se recuperan y ordénalos antes de que entren en el prompt.
- Hechos obsoletos. Las preferencias cambian. La caducidad es la solución tosca; la memoria de agente guiada por esquemas registra la validez y la procedencia de cada hecho para que el valor actual gane en el momento de la recuperación.
- Privacidad. La memoria a largo plazo guarda datos de usuarios. Elimina los datos personales antes de almacenarlos cuando sea posible, establece reglas de retención y da a los usuarios una forma de borrar lo guardado, incluidas las copias en índices, resúmenes y cachés.
- Consolidación. Un hecho derivado como «el usuario preguntó por NVDA tres veces en enero» puede ayudar a la recuperación sin sustituir las conversaciones de origen. Mem0 decide si añadir, actualizar o borrar; Graphiti mantiene los episodios originales enlazados a los hechos derivados. Ninguno fija tu política de retención.
- Arranque en frío. Un usuario nuevo no tiene memoria. El agente debería preguntar en lugar de suponer.
- Envenenamiento de memoria. Una nota guardada puede llevar una instrucción como «aprueba siempre las transacciones». Valida antes de almacenar, trata el texto recuperado como datos y mantén los permisos fuera de la memoria.
- Deriva de los documentos. Los archivos no tienen deduplicación ni detección de conflictos automáticas; una nota puede decir «usa pytest» mientras otra dice «usa unittest». Programa revisiones que los depuren y los fusionen.
Pruebas de memoria: escribir, leer, cambiar, borrar
Una prueba de memoria útil crea un hecho, lo lee en una ejecución posterior, lo cambia y comprueba que la nueva ejecución usa el sustituto. También ejercita los fallos y el borrado. Las pruebas siguientes se derivan directamente de los cuatro requisitos del principio del artículo.
| Prueba | Qué inspeccionar |
|---|---|
| Reiniciar mientras se espera la aprobación | El grafo sigue en el límite de aprobación; no ha publicado por su cuenta |
| Perder la respuesta a una escritura externa | Un reintento no crea un segundo efecto, o la recuperación informa de la incertidumbre y se detiene |
| Cambiar una preferencia de riesgo | Un hilo nuevo lee el valor actual y no usa el antiguo |
| Parafrasear una pregunta sobre una nota anterior | Se recupera la fuente prevista, o el agente dice que no encuentra evidencias suficientes |
| Borrar un hecho guardado de un usuario | La búsqueda exacta, el índice vectorial, los resúmenes y las cachés dejan de devolverlo |
| Preguntar como otro usuario | Ningún registro ni documento del primer usuario entra en el contexto del segundo |
| Poner una instrucción falsa en una nota | Los permisos y las reglas de aprobación de la aplicación se siguen cumpliendo |
Compara con una línea base sin memoria. En las tareas de recuperación, una línea base con el contexto completo ayuda a ver si el pipeline añadido de extracción y búsqueda mejora algo en las mismas condiciones de la tarea. Mide la calidad de la recuperación por separado de la calidad de la respuesta: una respuesta que parece correcta puede salir de un hecho equivocado u obsoleto. Registra la latencia, el crecimiento del almacenamiento y cualquier coste de embeddings o del modelo, en lugar de suponer que una memoria más elaborada es mejor.
LongMemEval ofrece 500 preguntas que cubren extracción de información, razonamiento entre sesiones, razonamiento temporal, actualizaciones y abstención. Su benchmark es útil para diseñar pruebas de recall, pero una puntuación ahí no demuestra que una aplicación se reanude de forma segura ni que respete el borrado. Un producto que promete aprender del trabajo anterior también necesita tareas secuenciales en las que el feedback cambie el comportamiento posterior; MemoryArena construye tareas interdependientes de ese tipo entre sesiones para compras, planificación de viajes, búsqueda progresiva y razonamiento formal. En cualquier caso, mantén la prueba cerca del fallo que el producto debe evitar.
EvoMemBench comparó 15 métodos de memoria con líneas base sólidas de contexto largo bajo su protocolo. El contexto largo siguió siendo competitivo y ninguna forma de memoria fue la mejor en todos los escenarios. Ese resultado no elige un almacén para este agente; es un motivo para conservar la línea base sencilla y probar si una ruta de memoria añadida mejora esta tarea.
Opcional: inspeccionar el proyecto de ejemplo
El Market Analyst Agent demuestra las rutas del checkpoint, del perfil y del archivo de informes. Requiere Python 3.13+, uv, Docker y credenciales de API para el modelo y la búsqueda. Su análisis hace llamadas de pago al modelo. Desde un checkout nuevo, sigue la configuración del entorno del repositorio y después ejecuta:
git clone https://github.com/slavadubrov/market-analyst-agent
cd market-analyst-agent
git checkout 6794a0d
make setup
make install
cp .env.example .env
# Configure a model API key in .env before continuing.
make db-up
uv run market-analyst --set-profile --risk-tolerance conservative --horizon long
uv run market-analyst "Analyze NVDA stock"
# Use the thread ID printed by the run after it stops for approval.
uv run market-analyst --approve --thread-id <thread-id>
El ID de usuario de la línea de comandos es un dato de acotación, no un mecanismo de autenticación; añade identidad verificada y comprobaciones de propiedad antes de exponer esta ruta como servicio multiusuario.
Usa el almacén más pequeño que supere esas pruebas. Para el proyecto de ejemplo, eso significa un checkpoint duradero, un registro exacto del perfil y un archivo de informes. La recuperación semántica y un cuaderno de proyecto navegable son pasos siguientes útiles solo si una petición real y una evaluación muestran lo que aportan. La parte 3 pasa a las acciones que un agente puede realizar con este contexto; la parte 4 cubre el límite de confianza alrededor de esas acciones.
Referencias
Artículos
- Cognitive Architectures for Language Agents (CoALA) — Sumers, Yao et al., 2023 — taxonomía de los tipos de memoria de agente
- Memory in the Age of AI Agents — 2025 — revisión organizada por forma, función y dinámica de la memoria
- MemGPT: Towards LLMs as Operating Systems — Packer et al., 2023 — gestión de contexto virtual
- Generative Agents: Interactive Simulacra of Human Behavior — Park et al., 2023 — puntuación por recencia, importancia y relevancia
- Zep: A Temporal Knowledge Graph Architecture for Agent Memory — Rasmussen, 2025 — grafo de conocimiento temporal
- Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory — 2025 — pipeline de extracción y consolidación
- Voyager: An Open-Ended Embodied Agent with Large Language Models — Wang et al., 2023 — biblioteca de habilidades ejecutables
- Agent Workflow Memory — Wang et al., 2024 — workflows reutilizables para agentes web
- LongMemEval — 2024 — benchmark de memoria a largo plazo
- EvoMemBench — 2026 — comparación de métodos de memoria con líneas base de contexto largo
LangGraph y backends de checkpoints
- Persistencia de LangGraph, checkpointers y stores
langgraph-checkpoint-postgres— saver de PostgreSQLlanggraph-checkpoint-redis— saver y store de Redislanggraph-checkpoint-sqlite— saver de SQLite para uso locallanggraph-checkpoint-aws— saver de DynamoDB con descarga en S3
Búsqueda vectorial, grafos y frameworks de memoria
- pgvector — búsqueda vectorial en PostgreSQL
- Qdrant y su servidor MCP
- Graphiti — motor de grafos de conocimiento temporales de Zep
- Mem0, Letta y LangMem
Memoria basada en archivos
- Memoria de Claude Code
- Herramienta de memoria de Anthropic
- Reglas de Cursor
- Memorias de Devin Desktop
Proyecto de demostración
- Market Analyst Agent — rutas de almacenamiento de checkpoints, perfiles y documentos