Memoria de agentes AI: estado guiado por esquema y procedencia

Traducción automática
Este artículo se tradujo automáticamente a partir de la versión original en inglés.
Este artículo es para ingenieros que desarrollan agentes de larga duración o multi-tenant. La memoria semántica convencional no tiene ninguna regla para decidir qué valor de un dato es el actual, así que los agentes devuelven datos obsoletos. Cuando un usuario cambia la fecha límite del pasaporte del 15 de julio al 30 de junio, la búsqueda vectorial puede recuperar ambas afirmaciones. Una capa de memoria con estado debe registrar que el valor del 30 de junio sustituye al anterior.
Aprenderás a guardar la memoria como registros tipados con ventanas de validez, ámbito de tenant y enlaces a la fuente, a escribir una corrección sin perder el historial y a probar lecturas del estado actual y de un instante concreto.
Por qué el contexto y la recuperación vectorial devuelven datos obsoletos
La ventana de contexto es la entrada disponible para una única llamada al modelo. Una aplicación puede trasladar mensajes a llamadas posteriores, pero la política de la aplicación debe decidir qué datos antiguos siguen siendo ciertos y quién puede verlos.
Los agentes de larga duración necesitan recordar preferencias, estado de tareas, datos de clientes, decisiones sobre herramientas, notas de cumplimiento normativo y errores anteriores. La versión fácil consiste en añadir resúmenes o volcar notas antiguas en un almacén vectorial. Funciona hasta que uno de los datos recordados cambia.
Entonces el agente tiene dos fechas límite de pasaporte, dos formatos preferidos o dos decisiones de proyecto. La búsqueda semántica puede recuperar ambas. Un resumen puede sobrescribir una. Un contexto largo puede incluir la obsoleta junto a la vigente. Estos diseños devuelven texto, pero no pueden decir qué valor es el actual.
El contrato de memoria debe responder a preguntas concretas:
- ¿Qué es cierto ahora?
- ¿Qué era cierto el 2 de junio?
- ¿Quién lo dijo?
- ¿A qué tenant pertenece?
- ¿Qué dato anterior sustituyó este dato?
- ¿Puedo eliminarlo o hacerlo caducar?
Schema-Guided Agent Memory (SGAM) almacena esas respuestas como campos y relaciones, en lugar de dejarlas implícitas en la prosa.
Qué significa SGAM
Dos ideas de investigación con nombres parecidos delimitan el alcance de SGAM.
Schema-Guided Memory (SGM) es el término de investigación que usan Mei et al. en According to Me: Long-Term Personalized Referential Memory QA. El artículo compara la Descriptive Memory (DM) en texto libre con elementos de memoria clave-valor de esquema fijo. Ambas representaciones contienen la misma información de origen con estructuras distintas. Un uso anterior del nombre, el dataset Schema-Guided Dialogue, realiza el seguimiento del estado del diálogo para las APIs de servicios y no guarda relación con la memoria a largo plazo.
En este artículo uso Schema-Guided Agent Memory (SGAM) para designar un patrón de ingeniería en el que los esquemas rigen las escrituras, las actualizaciones, la recuperación y el borrado. El esquema define el estado de la aplicación y su ciclo de vida.
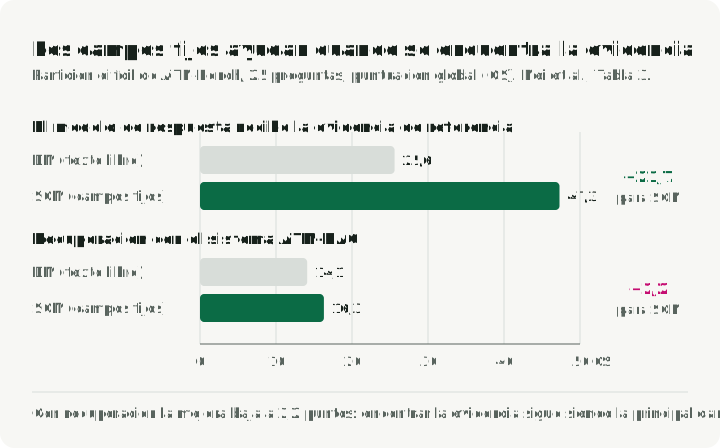
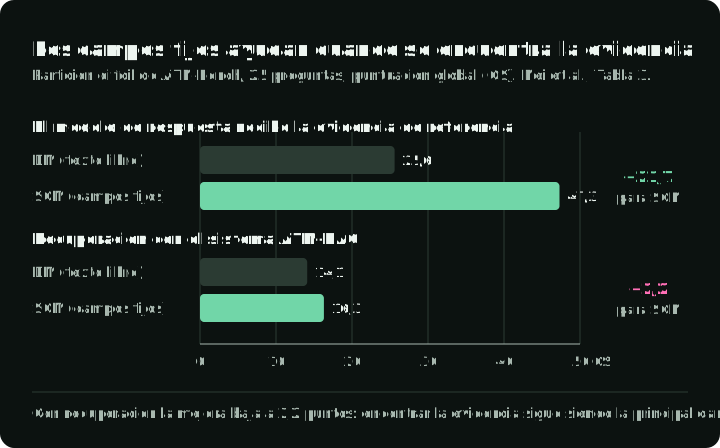
ATM-Bench muestra por qué importa la representación. Usa unos cuatro años de datos personales procedentes de correos, imágenes y vídeos. Las preguntas exigen referencias personales, ubicación, varias pruebas y actualizaciones a lo largo del tiempo. SGM expone en una representación fija campos como el momento, la fuente, la ubicación, las entidades y las etiquetas. En la partición difícil de 25 preguntas, la Tabla 3 del artículo indica que la puntuación global (QS) sube de 25,6 con DM a 47,3 con SGM cuando el modelo de respuesta recibe la evidencia de referencia. Con la recuperación del sistema ATM-RAG de los autores, la puntuación de la partición difícil solo sube de 14,1 a 16,3, de modo que encontrar la evidencia sigue siendo la principal carencia.
El gráfico pone las cuatro puntuaciones de la partición difícil una junto a otra. Compara la mejora de los campos fijos con la evidencia de referencia y con la recuperación.
SGM frente a DM responde a una pregunta de almacenamiento: ¿la memoria debe seguir siendo texto libre o debe usar campos con nombre? Un agente en producción tiene otro problema antes del almacenamiento. Debe convertir una conversación sin estructura en una propuesta de actualización de memoria. La siguiente sección muestra cómo Schema-Guided Reasoning (SGR) da forma a esa llamada al modelo y dónde toma el relevo SGAM.
Separa la extracción del modelo de la propiedad de la memoria
La escritura de memoria atraviesa tres capas. Structured Output (SO) impone la forma del objeto candidato. Schema-Guided Reasoning (SGR) hace que los campos previstos por el modelo y la intención de su decisión se puedan inspeccionar en una respuesta estructurada. Schema-Guided Agent Memory (SGAM) gestiona el candidato como estado persistente después de la llamada al modelo. Llamadas separadas, validadores y la política de la aplicación imponen las dependencias, el orden y las reglas del ciclo de vida.
Artículos anteriores aplican SGR a jueces estructurados, planificadores y routers y rúbricas de RAG. En todos ellos, un veredicto, una ruta o un plan suele caducar con la petición en curso. Otra ejecución puede leer un candidato de memoria días después o usarlo para elegir una tool call. Esa vida más larga exige reglas de almacenamiento que SGR no ofrece.
SGR dispone los campos de una respuesta del modelo en el orden en que el modelo debe rellenarlos. En una escritura de memoria, la respuesta podría incluir la evidencia de origen, un sujeto y un atributo normalizados, una comparación con el estado actual y una propuesta de actualización. Pydantic o JSON Schema describen esos campos. El structured output nativo del proveedor o un runtime de guided decoding como XGrammar mantiene la respuesta en esa forma. La forma no puede garantizar una conclusión correcta ni demostrar que el modelo usó esos campos en orden.
SGAM decide qué ocurre después de que ese objeto existe. ¿Debe almacenarse? ¿Sustituye a un dato anterior? ¿Qué tenant puede verlo? ¿Es vigente o histórico? ¿Qué episodio de origen lo respalda?
La tabla expone la responsabilidad y el modo de fallo de cada capa:
| Dimensión | SO | SGR | SGAM |
|---|---|---|---|
| Propósito | Devolver un objeto que cumple un esquema | Hacer inspeccionables los campos previstos y la intención de la decisión | Gestionar la memoria persistente después de la llamada al modelo |
| Alcance | Una respuesta generada | Una respuesta del modelo; la política entre pasos puede abarcar varias llamadas | Registros usados entre llamadas, sesiones y ejecuciones |
| Papel del esquema | Define los campos de salida, los tipos y los valores permitidos | Describe la evidencia, los campos intermedios y la decisión candidata | Define los registros almacenados, las relaciones y el ciclo de vida |
| Cumplimiento | El constrained decoding bloquea la salida no válida según esquema | Solo la forma; las llamadas separadas, los validadores y la política imponen las dependencias y el orden | La validación de la aplicación, las restricciones de la base de datos y las reglas de conflicto imponen el ciclo de vida |
| Duración | La llamada actual, salvo que la aplicación guarde el objeto | El rastro de razonamiento suele descartarse tras la decisión | Persiste hasta que se actualiza, caduca o se elimina |
| Modo de fallo | Forma válida con un significado erróneo | Los campos están presentes, pero el razonamiento o el manejo de dependencias aún puede ser erróneo | Estado obsoleto, contaminado, sin ámbito o no auditable |
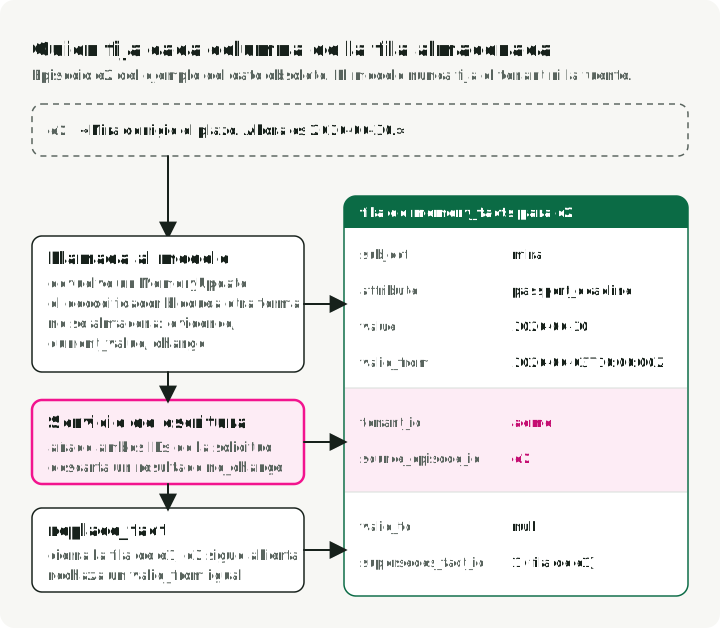
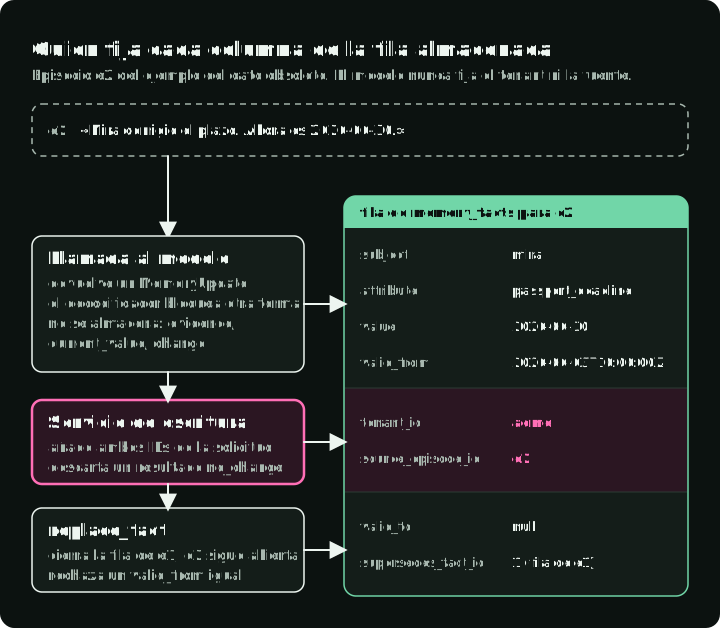
El diagrama sigue la corrección del ejemplo de más abajo hasta una fila almacenada y muestra quién fija cada columna: el modelo, el servicio de escritura a partir de la solicitud o replace_fact.
El siguiente esquema define el objeto que pasa de la extracción al servicio de escritura de SGAM. Requiere Pydantic. La aplicación incluye en el prompt el valor almacenado actualmente, para que el modelo pueda compararlo con la nueva evidencia:
from datetime import datetime
from typing import Literal

from pydantic import BaseModel, Field

class MemoryUpdate(BaseModel):
    evidence: str = Field(description="Exact quote from the episode")
    subject: str = Field(description="Normalized entity ID, e.g. mira")
    attribute: str = Field(description="Property being updated")
    current_value: str | None = Field(description="Stored value shown in the prompt")
    change: Literal["new", "update", "no_change"]
    value: str | None = Field(description="New value; None when change is no_change")
    valid_from: datetime = Field(description="When the new value starts to apply")
El servicio de escritura descarta los resultados no_change, añade tenant_id y source_episode_id a partir de la petición y pasa el resto a replace_fact en el ejemplo siguiente. El modelo nunca elige el tenant ni el episodio de origen.
Las rutas de escritura y de lectura tienen funciones distintas
Solo la ruta de escritura cambia el estado almacenado. La ruta de lectura selecciona registros para la petición en curso.
El flujo de ingesta es la ruta de escritura:
- Captura un episodio sin procesar a partir de mensajes, tool results o eventos de negocio. Registra su tenant y su clase de retención.
- Extrae candidatos tipados con structured output.
- Valida la carga con Pydantic o con la capa de esquemas que ya use tu stack, y rechaza las escrituras mal formadas.
- Resuelve los conflictos antes de insertar: decide si el nuevo registro sustituye a uno anterior y cierra el dato obsoleto.
- Conserva un puntero a la fuente: el episodio sin procesar, el tool result, el archivo, el ticket o la confirmación del usuario que produjo el registro.
- Confirma el registro en el almacén SGAM con su
schema_version, en lugar de dejar la versión solo en el código de la aplicación.
El flujo de petición es la ruta de lectura:
- Parte de la pregunta del usuario.
- Decide si la pregunta necesita el estado actual o el estado en un instante concreto.
- Filtra por tenant, tipo de memoria, sujeto, atributo y ventana de validez.
- Añade expansión vectorial o de grafo solo si la consulta exacta del estado no basta. Úsala para pruebas de apoyo, entidades relacionadas y ejemplos, no como autoridad sobre los datos actuales.
- Ensambla el contexto citado más pequeño posible para el modelo.
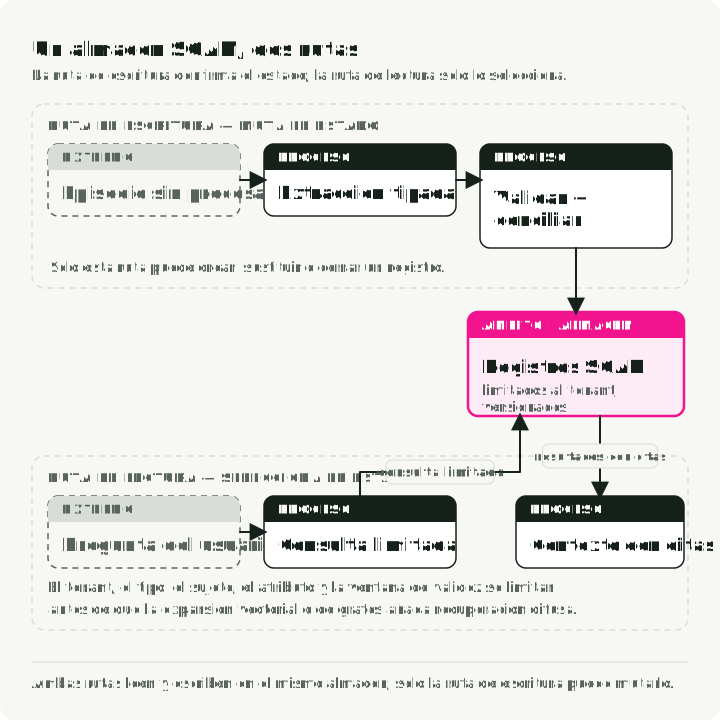
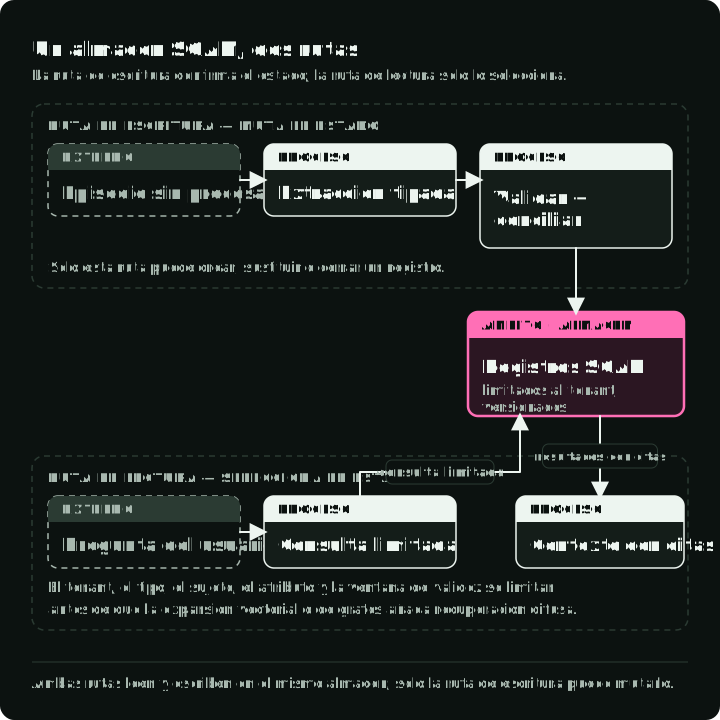
Lee ese diagrama de arriba abajo. La ruta de escritura cierra e1 e inserta e2 en un único almacén. La ruta de lectura elige un filtro de estado actual o de un instante concreto y después selecciona filas de ese mismo almacén.
Qué debe incluir un esquema de memoria
Un registro SGAM mínimo necesita algo más que text. Cada campo responde a una de las preguntas de la primera sección o cumple una función en el ciclo de vida:
| Campo | Pregunta a la que responde o función que cumple |
|---|---|
tenant_id | ¿A qué tenant pertenece? Todas las lecturas y escrituras filtran por él. |
memory_id | Un ID estable al que apuntan otros registros y los trabajos de borrado. |
subject, attribute | La clave: qué entidad y qué propiedad, como mira y passport_deadline. |
value | El valor almacenado. |
memory_type | El tipo de memoria: semántica (datos estables y perfiles), episódica (eventos pasados y trazas) o procedimental (instrucciones y reglas de prompt), tal como las describe LangGraph. |
schema_version | Qué esquema escribió el registro, para que una migración pueda encontrar y convertir los registros antiguos. |
valid_from, valid_to | ¿Qué es cierto ahora? valid_from <= now y (valid_to es null o now < valid_to). ¿Qué era cierto el 2 de junio? El intervalo contiene ese momento. |
supersedes_memory_id | ¿Qué dato anterior sustituyó este dato? |
source_episode_id | ¿Quién lo dijo? Apunta al episodio sin procesar. |
confidence | Una puntuación que el servicio de escritura compara con un umbral: promover el candidato a estado actual o pedir al usuario que lo confirme. |
retention_policy | ¿Puedo eliminarlo o hacerlo caducar? Indica a los trabajos de borrado qué más deben eliminar. |
Con estos campos, una nueva fecha límite de pasaporte puede cerrar la anterior sin borrar el historial. La misma tabla puede responder consultas del estado actual y de un instante concreto, y luego rastrear el resultado hasta su episodio de origen.
Usa RAG para recuperar documentos y SGAM para mantener estado mutable. La búsqueda vectorial sigue teniendo su lugar en el sistema para la recuperación difusa, el clustering y la expansión. El valor actual de mira.passport_deadline debe salir de un registro de memoria acotado a su ámbito, y no del fragmento que haya quedado primero en el ranking.
Un ejemplo de dato obsoleto
Consideremos una traza sintética de dos episodios, representada como una línea base DM y un libro de registro SGAM:
e1: Mira prefers concise answers. Her passport deadline is 2026-07-15.
e2: Mira corrected the deadline. It is now 2026-06-30.
Una línea base DM conserva ambos episodios como texto libre, así que la búsqueda de texto puede devolver e1 porque contiene las palabras adecuadas. SGAM extrae un dato tipado de cada episodio, con clave de tenant, sujeto y atributo. Debe devolver e2 como estado actual y conservar e1 para una consulta histórica.
El script siguiente responde a dos de las preguntas anteriores: qué es cierto ahora y qué era cierto el 2 de junio. Fíjate en replace_fact: cierra la fila antigua en lugar de borrarla y registra qué fila sustituye la nueva. Quien llama debe normalizar cada marca de tiempo almacenada o usada en una consulta a un único formato de cadena UTC con precisión fija de segundos: YYYY-MM-DDTHH:MM:SSZ. SQLite compara estos valores TEXT lexicográficamente, por lo que mezclar desfases horarios o precisiones puede ordenar los datos de forma incorrecta. Cada fila es válida desde valid_from hasta valid_to, sin incluir este último. La tabla rechaza intervalos no válidos y tiene un índice único parcial que permite un único dato abierto por tenant, sujeto y atributo. replace_fact gestiona una transacción y la inicia con BEGIN IMMEDIATE antes de leer ninguna fila. Llámala en una conexión sin una transacción activa. SQLite serializa los escritores concurrentes, así que quien llama debe reintentar la transacción completa tras un error de bloqueo o de unicidad. Al final, una coincidencia de palabras clave sustituye a la búsqueda vectorial. Cualquier ranking que no conozca la corrección puede devolver e1.
import sqlite3
from dataclasses import dataclass

@dataclass(frozen=True)
class MemoryFact:
    tenant_id: str
    subject: str
    attribute: str
    value: str
    valid_from: str
    source_episode_id: str

def open_db() -> sqlite3.Connection:
    db = sqlite3.connect(":memory:")
    db.row_factory = sqlite3.Row
    db.executescript(
        """
        create table memory_facts (
            fact_id integer primary key,
            tenant_id text not null,
            subject text not null,
            attribute text not null,
            value text not null,
            valid_from text not null,
            valid_to text,
            supersedes_fact_id integer references memory_facts (fact_id),
            source_episode_id text not null,
            check (valid_to is null or valid_from < valid_to)
        );
        create unique index one_open_fact
        on memory_facts (tenant_id, subject, attribute)
        where valid_to is null;
        """
    )
    return db

def replace_fact(db: sqlite3.Connection, fact: MemoryFact) -> None:
    with db:
        db.execute("BEGIN IMMEDIATE")
        exact = db.execute(
            """
            select fact_id
            from memory_facts
            where tenant_id = ? and subject = ? and attribute = ? and valid_from = ?
            """,
            (fact.tenant_id, fact.subject, fact.attribute, fact.valid_from),
        ).fetchone()
        if exact:
            raise ValueError("equal valid_from requires an application conflict policy")

        containing = db.execute(
            """
            select fact_id, valid_to
            from memory_facts
            where tenant_id = ?
              and subject = ?
              and attribute = ?
              and valid_from < ?
              and (valid_to is null or valid_to > ?)
            limit 1
            """,
            (
                fact.tenant_id,
                fact.subject,
                fact.attribute,
                fact.valid_from,
                fact.valid_from,
            ),
        ).fetchone()
        if containing:
            db.execute(
                "update memory_facts set valid_to = ? where fact_id = ?",
                (fact.valid_from, containing["fact_id"]),
            )
            successor_boundary = containing["valid_to"]
        else:
            successor = db.execute(
                """
                select valid_from
                from memory_facts
                where tenant_id = ? and subject = ? and attribute = ? and valid_from > ?
                order by valid_from
                limit 1
                """,
                (fact.tenant_id, fact.subject, fact.attribute, fact.valid_from),
            ).fetchone()
            successor_boundary = successor["valid_from"] if successor else None

        db.execute(
            """
            insert into memory_facts
                (tenant_id, subject, attribute, value, valid_from, valid_to,
                 supersedes_fact_id, source_episode_id)
            values (?, ?, ?, ?, ?, ?, ?, ?)
            """,
            (
                fact.tenant_id,
                fact.subject,
                fact.attribute,
                fact.value,
                fact.valid_from,
                successor_boundary,
                containing["fact_id"] if containing else None,
                fact.source_episode_id,
            ),
        )

def fact_at(
    db: sqlite3.Connection, tenant_id: str, subject: str, attribute: str, timestamp: str
) -> sqlite3.Row | None:
    return db.execute(
        """
        select fact_id, value, valid_from, supersedes_fact_id, source_episode_id
        from memory_facts
        where tenant_id = ?
          and subject = ?
          and attribute = ?
          and valid_from <= ?
          and (valid_to is null or valid_to > ?)
        limit 1
        """,
        (tenant_id, subject, attribute, timestamp, timestamp),
    ).fetchone()

KEY = ("acme", "mira", "passport_deadline")

db = open_db()
replace_fact(db, MemoryFact(*KEY, "2026-07-15", "2026-06-01T09:00:00Z", "e1"))
replace_fact(db, MemoryFact(*KEY, "2026-06-30", "2026-06-03T10:00:00Z", "e2"))
current = fact_at(db, *KEY, "2026-06-04T00:00:00Z")
assert (current["value"], current["source_episode_id"]) == ("2026-06-30", "e2")

historical = fact_at(db, *KEY, "2026-06-02T00:00:00Z")
assert (historical["value"], historical["source_episode_id"]) == ("2026-07-15", "e1")
assert current["supersedes_fact_id"] == historical["fact_id"]

# A delayed extraction predates e1. It ends at e1's existing boundary,
# rather than closing e2, which remains current.
replace_fact(db, MemoryFact(*KEY, "2026-08-01", "2026-05-30T08:00:00Z", "e0"))
delayed = fact_at(db, *KEY, "2026-05-31T00:00:00Z")
assert (delayed["value"], delayed["source_episode_id"]) == ("2026-08-01", "e0")
current = fact_at(db, *KEY, "2026-06-04T00:00:00Z")
assert (current["value"], current["source_episode_id"]) == ("2026-06-30", "e2")
intervals = db.execute("select valid_from, valid_to from memory_facts").fetchall()
assert all(row["valid_to"] is None or row["valid_from"] < row["valid_to"] for row in intervals)

episodes = (
    "e1: Mira prefers concise answers. Her passport deadline is 2026-07-15.",
    "e2: Mira corrected the deadline. It is now 2026-06-30.",
)
naive_match = next(episode for episode in episodes if "passport deadline" in episode)
assert naive_match.startswith("e1:")

print("Naive text memory:")
print(f"  returned episode: {naive_match}")
print()
print("SGAM current state:")
print(f"  mira.passport_deadline = {current['value']}")
print(f"  valid_from={current['valid_from']}, source={current['source_episode_id']}")
print()
print("SGAM point-in-time state:")
print(f"  on 2026-06-02, mira.passport_deadline = {historical['value']}")
Al ejecutar el script se imprime:
Naive text memory:
  returned episode: e1: Mira prefers concise answers. Her passport deadline is 2026-07-15.

SGAM current state:
  mira.passport_deadline = 2026-06-30
  valid_from=2026-06-03T10:00:00Z, source=e2

SGAM point-in-time state:
  on 2026-06-02, mira.passport_deadline = 2026-07-15
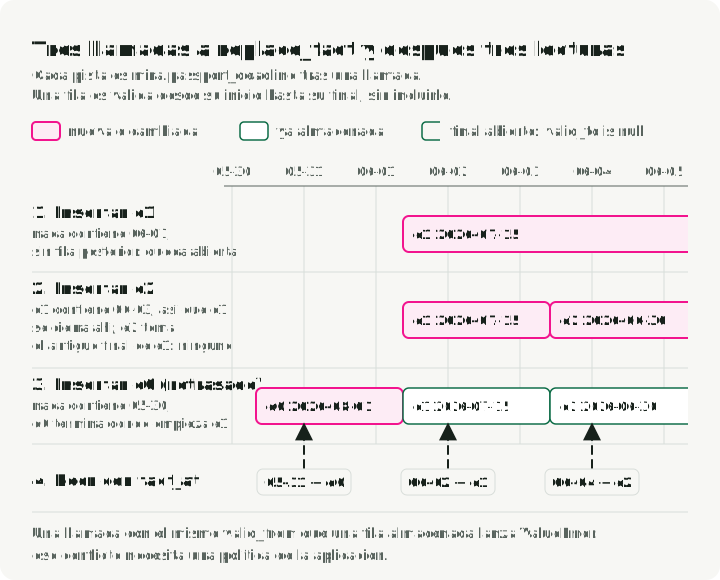
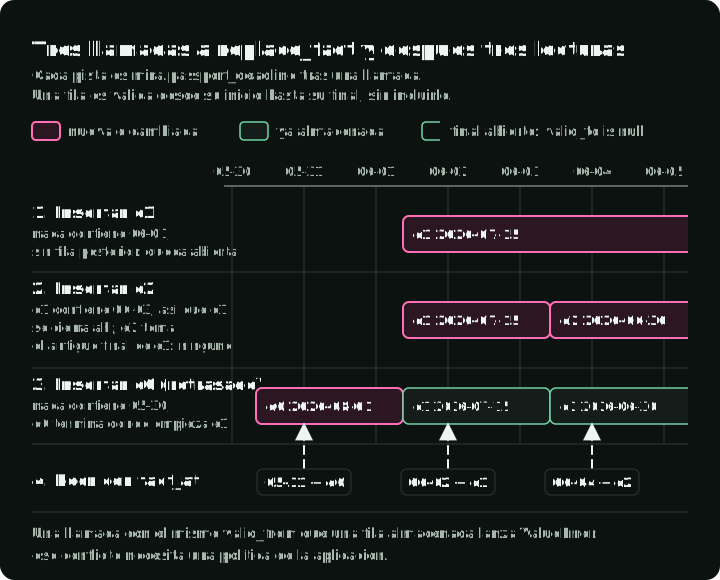
replace_fact rechaza primero un valid_from igual: ese conflicto necesita una política de la aplicación, como la precedencia de fuentes o una revisión confirmada por el usuario, en lugar de una sobrescritura silenciosa. Si no hay igualdad, busca el intervalo que contiene la marca de tiempo entrante. Si lo encuentra, cierra ese predecesor en el límite entrante, da a la fila insertada el final que tenía el predecesor y registra el predecesor en supersedes_fact_id. Si la marca de tiempo es anterior a todos los intervalos almacenados, usa el valid_from del siguiente intervalo como final de la nueva fila. Así, un dato retrasado anterior a e1 queda como [2026-05-30, 2026-06-01) y deja intactos e1 y el e2 actual. El índice único parcial es la protección de la base de datos para que haya una sola fila abierta. DM no tiene un paso de actualización equivalente, así que el texto antiguo todavía puede quedar por delante de la corrección.
La línea de tiempo muestra las filas tras cada llamada a replace_fact del script y después las tres lecturas. Fíjate en el paso 2, donde e2 cierra e1, y en el paso 3, donde el e0 retrasado termina donde empieza e1.
En producción, combina esta transacción con la extracción estructurada en la ruta de escritura. La transacción de la base de datos actualiza la validez temporal. El modelo extrae un dato candidato, pero no decide qué fila almacenada sigue siendo la vigente.
El almacenamiento depende del patrón de recuperación
Los proyectos usan varios nombres para partes de este patrón: almacenes de memoria, grafos de contexto, perfiles, almacenes a largo plazo, graph RAG y agentes con estado.
| Herramienta o framework | Capa principal de almacenamiento | Mecanismo de estado temporal | Mecanismo de esquema | Úsalo cuando |
|---|---|---|---|---|
| Graphiti | Neo4j, FalkorDB y Amazon Neptune; Kuzu está obsoleto | Intervalos de validez de los datos más procedencia del episodio de origen | Tipos de entidad y de arista con Pydantic, aristas temporales, procedencia | Necesitas intervalos de validez y recorrido de grafos, y vas a operar la base de datos de grafos |
| Zep | Context Graph Engine propietario | Context Graphs temporales gestionados que conservan los datos cambiantes | Tipos de entidad y de arista predeterminados y personalizados | Quieres el mismo modelo de grafo temporal como servicio gestionado |
| LangGraph / LangMem | Almacenes de LangGraph, almacenes respaldados por Postgres | Marcas de tiempo y campos propios de la aplicación en los registros del almacén | Almacenes JSON más extracción de perfiles o colecciones con Pydantic | Ya usas LangGraph y aceptas encargarte de las marcas de tiempo y las reglas de conflicto |
| Mem0 | Stack gestionado; backends Valkey / Redis / vectoriales en instalaciones OSS | Actualizaciones de memoria; la política temporal sigue a cargo de la aplicación | Tipos de memoria, categorías personalizadas, prompts de extracción | Quieres añadir, buscar, actualizar y borrar de forma gestionada, con ámbito por usuario, agente, aplicación o ejecución, y te encargarás de la política temporal |
| Letta / MemGPT | Estado del agente y bloques de memoria respaldados por una base de datos | Bloques editables sin intervalos de validez por campo | Bloques de memoria etiquetados y editables | El agente edita sus propios bloques de memoria, o varios agentes necesitan un bloque compartido que todos ven |
| Cognee | Grafo más backends vectoriales y relacionales | El historial depende de la ontología y del backend elegido | Extracción y validación orientadas a ontologías | Validas la extracción frente a una ontología del dominio |
| LlamaIndex property graph | Almacenes de grafos de propiedades más almacenes vectoriales | Los campos de tiempo dependen del esquema del grafo y del almacén | SchemaLLMPathExtractor con entidades y relaciones permitidas | Extraes un grafo de propiedades a partir de documentos o trazas |
LangGraph separa los checkpoints de hilo, que reanudan una conversación, de los almacenes entre hilos, que guardan datos que leen los hilos posteriores. El artículo de Zep informa de mejoras en Deep Memory Retrieval y LongMemEval, y el artículo de Mem0 informa de mejoras en LoCoMo. Cada proveedor escribió su propio artículo, así que interpreta las cifras como resultados del proveedor, no como garantías para tu carga de trabajo.
Empieza por el modelo de datos. Si la operación principal es la búsqueda exacta de datos, suele bastar una tabla relacional con cargas JSON, columnas de validez, índices por tenant y un complemento vectorial. Añade un grafo cuando las consultas del producto sigan relaciones.
Construye la ruta de escritura antes que el grafo
Primero decide qué puede recordar el producto. La elección entre grafo y vectores viene después.
Un agente de soporte podría recordar el nivel de la cuenta, los casos abiertos y las preferencias de contacto duraderas. No debería promover a estado del perfil cada comentario irritado. Un agente de programación podría recordar las convenciones del repositorio y las tareas pendientes. No debería conservar una nota privada para siempre solo porque se recuperó una vez.
El primer almacén SGAM puede ser una tabla relacional con una columna JSON y unos pocos índices, escrita mediante la ruta de escritura de seis pasos descrita arriba. Un grafo resulta útil cuando el producto necesita recorrer relaciones como cliente-cuenta, cuenta-política, tarea-artefacto o proyecto-decisión.
Ruta crítica y escrituras en segundo plano
Compensa extraer de inmediato cuando el siguiente turno depende de la nueva memoria. Si el usuario dice “recuerda que prefiero respuestas cortas”, el sistema no debería necesitar un trabajo nocturno para comportarse de otra manera.
La mayoría de los turnos no necesitan una escritura inmediata. Guarda el episodio sin procesar con metadatos de tenant, sesión y herramientas, y deja que un worker en segundo plano extraiga candidatos más tarde. Con la consolidación basada en recurrencia, el worker acumula señales débiles y promueve un dato solo cuando se repite evidencia similar o el usuario lo confirma. Esto añade retraso de actualización. Es aceptable para “el usuario suele pedir exportaciones CSV” y arriesgado para “el cliente cambió la dirección de entrega”.
Trata la migración de esquema como un cambio de producto, porque altera lo que el agente puede recordar, citar o eliminar. También puede cambiar qué datos históricos cuentan como vigentes. Planifica en la misma versión los scripts de migración, los backfills, las ventanas de doble lectura y el comportamiento del borrado.
Cuándo compensa la complejidad de SGAM
Usa SGAM cuando los datos pueden cambiar con el tiempo:
- preferencias del usuario que se pueden actualizar o revocar
- datos de clientes o cuentas con requisitos de auditoría
- estado de tareas de asistentes de larga duración
- memoria de proyecto de agentes de programación
- estado compartido multi-agent
- notas de cumplimiento normativo donde importa la procedencia
- preguntas temporales como “¿qué creíamos antes de la migración?”
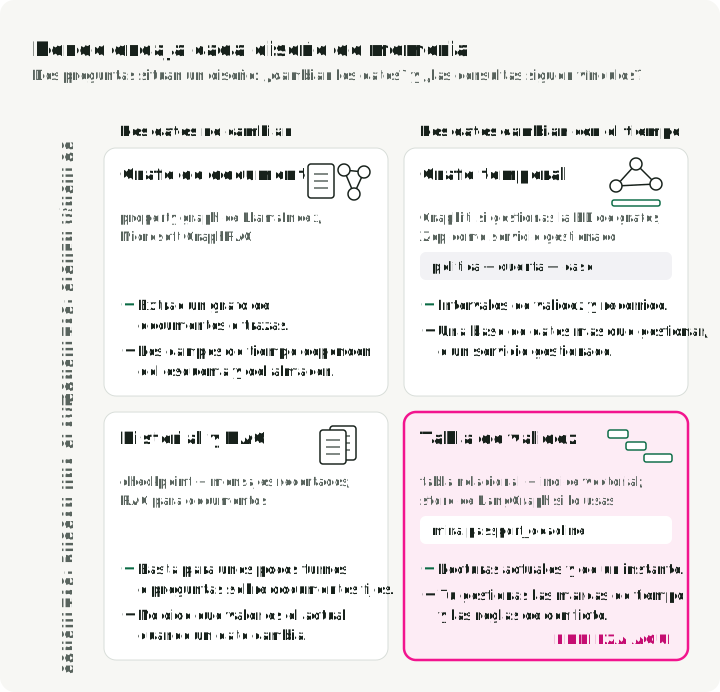
SGAM es excesivo cuando la memoria es de corta vida, exploratoria o barata de recalcular. Si el agente solo necesita continuidad durante unos pocos turnos, basta con un checkpoint y un historial de mensajes recortado. Las preguntas y respuestas sobre documentos estáticos pueden necesitar solo RAG. Y si el dominio es tan inestable que el esquema cambia cada día, la memoria tipada frenará al equipo.
La cuadrícula sitúa cada diseño según dos preguntas: ¿cambian tus datos? y ¿tus consultas siguen vínculos entre registros?
Lista de comprobación de evaluación
Evalúa el ciclo de vida de la memoria además de la respuesta final. Un sistema puede producir una respuesta verosímil después de escribir un dato erróneo, recuperar uno obsoleto o cruzar el límite de un tenant.
Uso la misma división por etapas que en mi artículo sobre evaluación de RAG. Mide la etapa en la que puede producirse un fallo, en lugar de limitar la evaluación al texto generado. La disciplina de trazas del artículo sobre evaluación de agentes también se aplica, porque un error de memoria suele aparecer en el historial de ejecución antes de llegar a la respuesta.
Probaría SGAM con repetición. Introduce en el escritor de memoria una secuencia fija de episodios e inspecciona el libro de registro después de cada turno relevante. Después, haz preguntas sobre el estado actual y sobre un instante concreto al almacén resultante.
| Capa | Fallo que buscas | Métricas |
|---|---|---|
| Extracción de escritura | El agente omitió un dato, inventó uno o produjo una forma no válida | Tasa de escrituras válidas según el esquema, precisión/recall de la extracción, cobertura de episodios de origen |
| Gestión de conflictos | Un dato obsoleto siguió siendo actual o se sobrescribió un dato antiguo válido | Corrección de la sustitución, tasa de duplicados, corrección de la invalidación de datos obsoletos |
| Aislamiento y política | La memoria se filtró entre usuarios o sobrevivió a su ventana de política | Fallos de aislamiento entre tenants, corrección del borrado, cumplimiento de la retención |
| Recuperación en lectura | El registro correcto existe pero el lector no lo recuperó | Precisión del estado actual, precisión en un instante concreto, recall@k sobre registros de memoria |
| Fundamentación de la respuesta | La respuesta usó memoria sin respaldo o citó la fuente equivocada | Respaldo de las afirmaciones en los episodios de origen, precisión de las citas, corrección en la resolución de conflictos |
| Operaciones | La ruta de memoria es demasiado lenta, está demasiado desactualizada o es demasiado cara | Latencia de escritura p95, retraso de actualización, latencia de lectura, coste por consulta |
Benchmarks como LoCoMo, LongMemEval y ATM-Bench ofrecen casos de prueba públicos. No sustituyen a un conjunto de pruebas del dominio. Un asistente de programación, un bot de atención al cliente y un copiloto de cumplimiento normativo necesitan esquemas, filtros, reglas de retención y pruebas de fallo distintos.
From traces to better memory ejecuta un bucle de mejora sobre una herramienta de memoria que almacena datos con un propietario, un evento de origen y un intervalo de validez, siguiendo estas reglas.
Salvedades
SGAM es mi etiqueta para un patrón, no un estándar. Las herramientas de la tabla anterior usan otros nombres para partes de él: almacenes de memoria, grafos de contexto temporales, bloques de memoria y grafos de conocimiento. Microsoft GraphRAG plantea una parte relacionada del problema como recuperación basada en grafos sobre documentos.
Un perfil de usuario, un registro de episodios, un grafo de documentos y un bloque de memoria editable por el agente resuelven problemas distintos de recuperación y de actualización. Reservo SGAM para la memoria persistente que representa el estado actual de la aplicación y que, por tanto, necesita esquema, validez, procedencia, gestión de conflictos, retención y migración.
La memoria tipada también puede ser errónea. Un esquema facilita la inspección de las escrituras incorrectas, pero no las hace fiables. Aun así, necesitas confianza en la fuente, confirmación del usuario para los datos sensibles, política de conflictos, borrado y monitorización.
Referencias
- According to Me: Long-Term Personalized Referential Memory QA - artículo de Mei et al. que presenta ATM-Bench y Schema-Guided Memory.
- Towards Scalable Multi-Domain Conversational Agents: The Schema-Guided Dialogue Dataset - artículo de Rastogi et al. sobre el dataset SGD.
- Evaluating Very Long-Term Conversational Memory of LLM Agents - artículo de Maharana et al. que presenta LoCoMo.
- LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory - benchmark de Wu et al. sobre capacidades de memoria a largo plazo.
- Graphiti: Build Temporal Context Graphs for AI Agents
- Zep: A Temporal Knowledge Graph Architecture for Agent Memory
- Mem0 Platform Overview
- Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory
- LangGraph Memory Overview
- LangGraph Persistence
- LangMem documentation
- Letta: Introduction to Stateful Agents
- Letta: Shared memory
- Microsoft GraphRAG documentation
- LlamaIndex: Using a Property Graph Index
- Cognee Documentation
- Pydantic model validation docs
- Python sqlite3 documentation