Meta-engineering de sistemas de AI: de las trazas a una memoria mejor

Traducción automática
Este artículo se tradujo automáticamente a partir de la versión original en inglés.
Este artículo es para ingenieros que quieren que un agente descubra por qué falla su sistema de AI y proponga una corrección. El ejemplo es una herramienta de memoria pequeña que responde a una pregunta sobre dónde vive un usuario, y la respuesta es errónea. Verás cómo se propone un cambio en esa herramienta, cómo se prueba en 20 escenarios preparados y cómo se juzga antes de que nadie lo adopte. Verás también cómo comprobar si un script sencillo que prueba todos los ajustes habría encontrado la misma corrección sin un LLM. En el experimento complementario, un LLM propuso los cambios y Python corriente los probó.
Uso meta-engineering para el diseño de ese proceso de mejora. Se reduce a cuatro decisiones. ¿Qué puede cambiar el proponente, la persona o el programa que sugiere los cambios? ¿Qué resultados cuentan como una mejora? ¿Cómo influye un resultado en la siguiente sugerencia? ¿Quién decide adoptar un cambio? Las mismas cuatro decisiones valen tanto si el proponente es un LLM como si es una persona o una búsqueda de parámetros.
El fallo de la ciudad equivocada
La herramienta de memoria guarda datos sobre una usuaria, Ada, y responde a preguntas sobre ella. Una prueba, el escenario del traslado futuro, le envía cuatro eventos:
- Guardar
city = Berlin, con efecto desde el 1 de enero. - Guardar
city = Paris, recibido el 3 de enero pero con efecto desde el 10 de enero. - Preguntar por la ciudad el 5 de enero. Se espera Berlín.
- Preguntar por la ciudad el 12 de enero. Se espera París.
La herramienta original responde París las dos veces. El 12 de enero es correcto. El 5 de enero es un error: Ada todavía no se ha mudado.
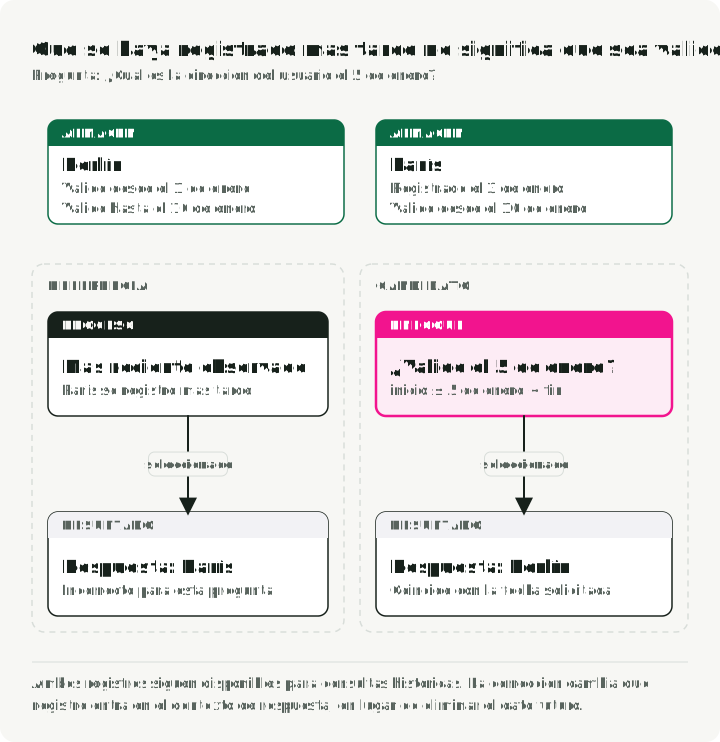
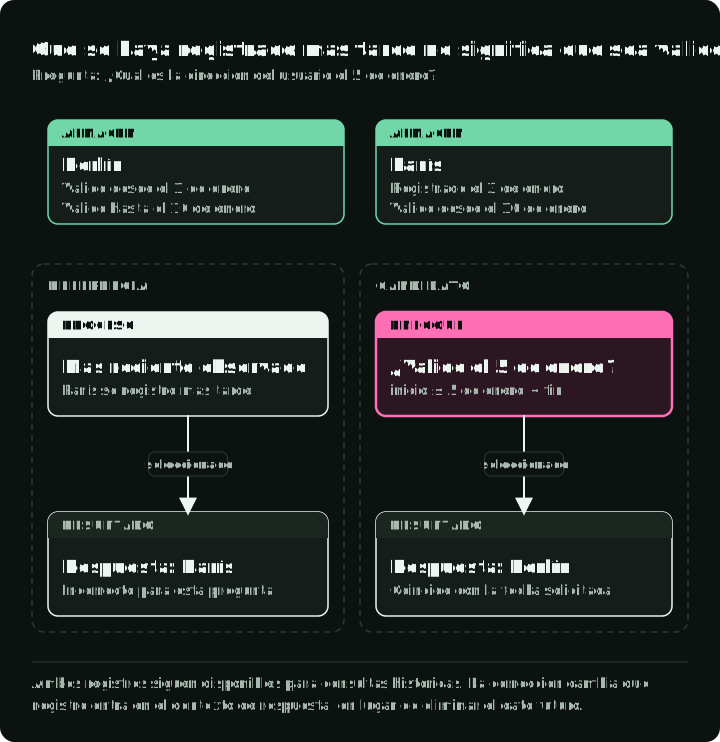
Cada ejecución de la prueba deja una traza: un registro guardado de cada evento enviado a la herramienta, de los registros que almacenó y de las respuestas que dio. La traza guardada de este escenario muestra que los dos registros tienen las fechas de validez correctas. Berlín es válida desde el 1 de enero hasta el 10 de enero, y París desde el 10 de enero sin fecha de fin. El fallo está en la recuperación: coloca el dato de París, recibido más tarde, por delante de Berlín sin comprobar cuál era válido en la fecha pedida. Guardar el traslado futuro fue correcto.
Así que el dato de París debe quedarse, y la recuperación necesita un filtro de fecha. Ese diagnóstico todavía no justifica adoptar un filtro. El mismo código de recuperación responde a preguntas sobre otros asuntos, gestiona borrados y debe mantener separados los registros de cada usuario. Un cambio que arregle el 5 de enero y rompa esos casos empeora la herramienta de memoria. El proceso de mejora tiene que detectarlo antes de que una versión nueva llegue a los usuarios.
Dos bucles
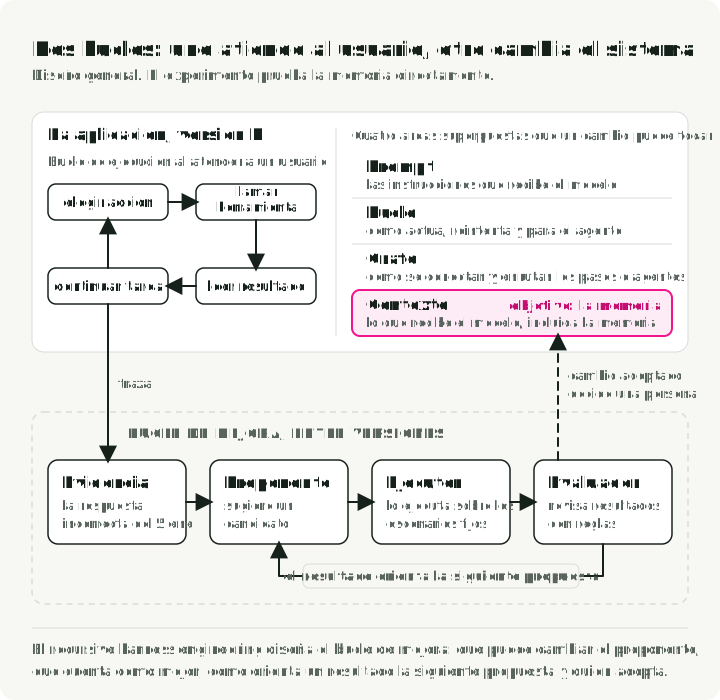
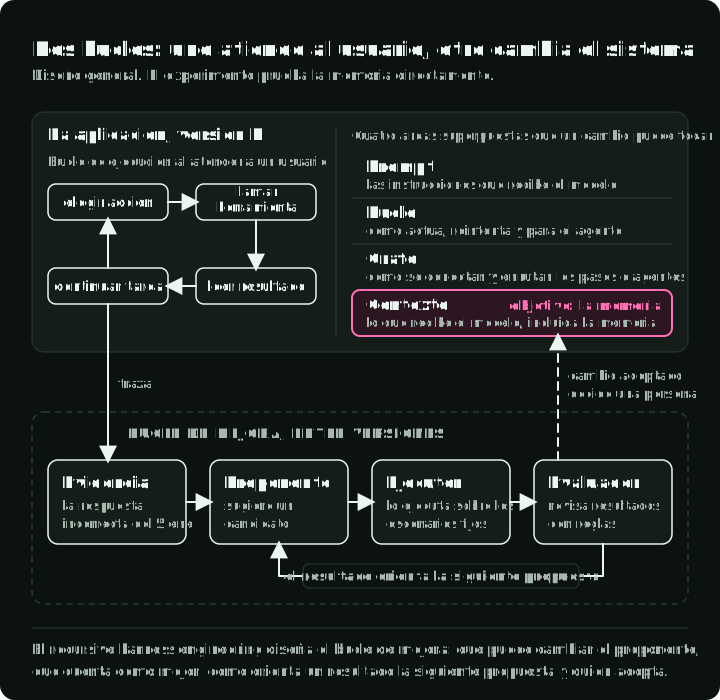
Una aplicación con agentes ejecuta un bucle mientras atiende a un usuario. En este bucle de ejecución elige una acción, llama a una herramienta, lee el resultado y continúa la tarea del usuario. Un agente que use la herramienta de memoria podría recibir ahí la respuesta con la ciudad equivocada. Este experimento llama directamente a la herramienta con eventos de prueba fijos.
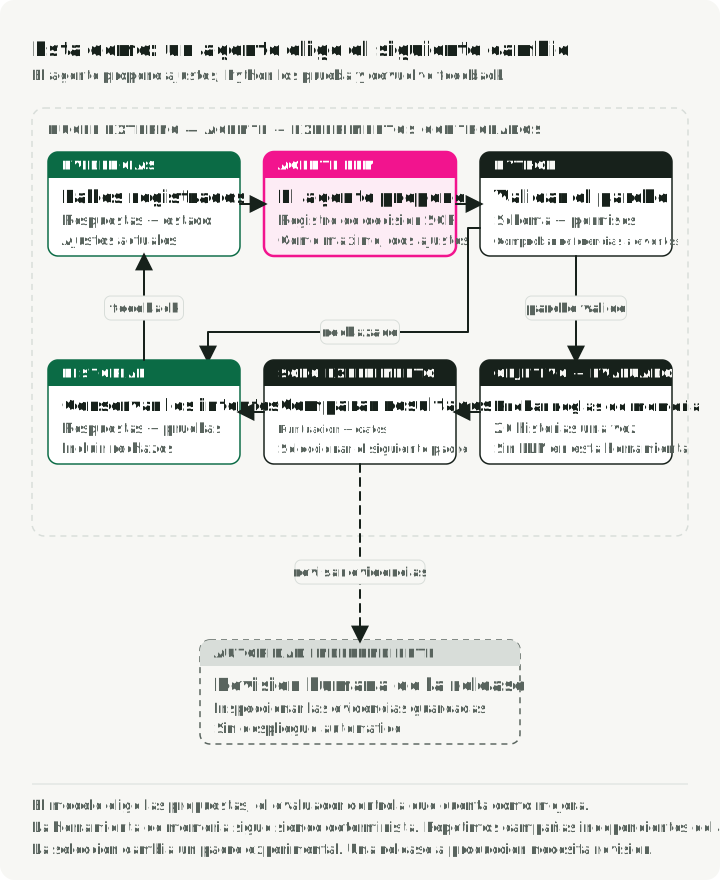
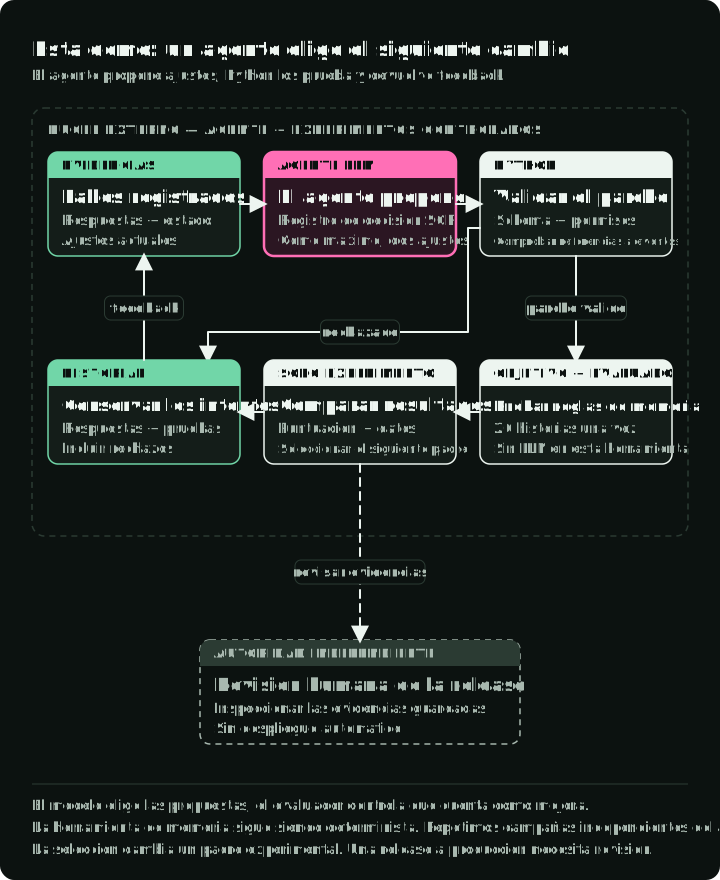
Corregir el fallo exige un segundo bucle, que se ejecuta entre versiones de la aplicación. Este bucle de mejora parte de evidencias de un fallo, como la respuesta del 5 de enero, un registro modificado cuando no debía o un coste demasiado alto. El proponente sugiere un candidato: una versión concreta de un cambio en el objetivo, la parte del sistema que se quiere mejorar. Aquí el objetivo es la herramienta de memoria, y un candidato es un nuevo conjunto de sus ajustes. Un ejecutor ejecuta el candidato sobre un conjunto fijo de escenarios de prueba, y un evaluador comprueba los resultados con las reglas que esos escenarios codifican. El bucle solo se completa cuando un resultado cambia la siguiente propuesta o la decisión de adoptar un cambio.
El diagrama muestra el diseño general de la aplicación, donde el objetivo puede ser cualquier parte de ella. Los ingenieros suelen agrupar esas partes en cuatro áreas que se solapan. El prompt engineering cambia las instrucciones. El context engineering cambia la información que recibe el modelo, memoria incluida. El loop engineering cambia cómo actúa, reintenta y se detiene el agente en su bucle de ejecución. El graph engineering cambia cómo se conectan los pasos o los agentes y cómo se reparte el trabajo entre ellos. El meta-engineering trata una decisión de cualquiera de las cuatro, como la redacción de un prompt o el número de reintentos, como un ajuste que un experimento puede cambiar. Juzga cada candidato por la calidad de respuesta, el coste y el comportamiento exigido del sistema completo, como no mostrar nunca los datos de un usuario a otro.
Dos proyectos recientes ya usan un agente de programación como proponente. En autoresearch, de Karpathy, el agente edita un único archivo de entrenamiento y lo ejecuta con un presupuesto de tiempo fijo. Cada intento se registra como conservado, descartado o fallido, y el código de evaluación está en un archivo aparte que el agente no edita. Meta-Harness, un preprint de marzo de 2026, permite que el proponente lea el código fuente, las puntuaciones y las trazas de candidatos anteriores. Los usa para mejorar el código con el que una aplicación con LLM decide qué guarda, qué recupera y qué muestra a su modelo. Este artículo usa un objetivo mucho más pequeño, la herramienta de memoria, para poder inspeccionar cada paso.
Limita lo que puede cambiar el proponente
El LLM nunca se ejecuta dentro de la herramienta de memoria. Lee las trazas fallidas y los resultados de la evaluación, y propone una nueva configuración: valores para los ajustes de la herramienta. Python prueba esa configuración.
La herramienta de memoria es Python corriente y determinista. Recibe hechos estructurados, los guarda o los rechaza y devuelve un valor para una consulta. No extrae hechos de una conversación ni redacta una respuesta en lenguaje natural, así que este bucle no puede corregir un fallo de extracción de hechos. Cada hecho guardado tiene un propietario, un evento de origen y un intervalo de validez, según las reglas de estado almacenado de Memoria de agentes AI: estado guiado por esquema y procedencia.
Cada hecho entrante lleva también una puntuación de confianza, escrita por el autor de la prueba. La herramienta guarda un hecho solo si su puntuación es como mínimo min_confidence. Las puntuaciones forman parte de los datos de prueba; no son probabilidades medidas con un modelo. Por ejemplo, un hecho incierto delivery = courier con puntuación 0.4 se rechaza con el umbral original de 0.7, pero se guarda con 0.2.
El registro de París tras la segunda escritura muestra cómo conserva un registro su historia. observed_at es el día en que la herramienta supo el hecho y valid_from es el día en que pasa a ser cierto (extracto):
{
    "id": "m002",
    "key": "city",
    "value": "Paris",
    "valid_from": "2026-01-10",
    "valid_to": null,
    "observed_at": "2026-01-03",
    "source_event_id": "future-move:event-2",
    "supersedes_memory_id": "m001"
}
source_event_id apunta al evento que aportó París, y supersedes_memory_id lo enlaza con el registro de Berlín m001. El escritor tiene además reglas fijas para los conflictos. Si una escritura posterior dice Roma, también con efecto desde el 10 de enero, el escritor la rechaza y deja París sin cambios. Un París repetido para la misma fecha reutiliza el registro, y una actualización con una fecha de efecto anterior se rechaza. El proponente no puede cambiar estas reglas.
El proponente puede cambiar cinco ajustes existentes:
| Ajuste | Qué hace cambiarlo |
|---|---|
min_confidence | Cambia la puntuación de confianza mínima necesaria para guardar un hecho. |
filter_entity | Limita la recuperación al asunto pedido, como la casa en lugar del trabajo. |
time_aware | Limita la recuperación a los hechos válidos en la fecha pedida. |
deduplicate | Reutiliza un hecho activo idéntico en lugar de guardar otra confirmación. |
top_k | Fija cuántos de los registros mejor clasificados considera la herramienta para responder. |
Una propuesta cambia como máximo dos ajustes; min_confidence va de 0 a 1 y top_k de 1 a 8. El agente no puede editar ningún código, prueba ni respuesta esperada, y no puede aprobar su propio cambio. Su salida son datos que Python valida, no código que ejecutar. El contrato de configuración y el validador de propuestas definen ese límite en código.
Como este proponente solo puede enviar ajustes, no puede cambiar el evaluador. Pero el evaluador sí se ejecuta dentro del mismo proceso de Python que la herramienta de memoria. Un agente al que se permitiera escribir y ejecutar su propio código podría por tanto cambiar las comprobaciones. Con un agente así, el evaluador debe estar en un proceso aparte, con sus propias reglas de acceso a archivos y a la red, antes de que se pueda confiar en sus resultados.
La regla de puntuación
Para la historia de la ciudad, la prueba debe hacer las dos preguntas: Berlín el 5 de enero y París el 12 de enero. Probar solo la primera respuesta premiaría a una herramienta que simplemente descarta el hecho futuro. En el experimento complementario, un escenario es una historia completa de eventos write, query y a veces delete, como los cuatro eventos de arriba. Cada candidato ejecuta los mismos 20 escenarios preparados, cada uno desde una memoria vacía. La configuración original supera 13.
Un escenario se supera solo cuando todas las respuestas esperadas son correctas y no se rompe ninguna regla de datos. El evaluador comprueba tres reglas de datos, llamadas comprobaciones obligatorias: un propietario nunca ve los hechos de otro, un hecho borrado desaparece y una entrada marcada como prohibida no se guarda. También cuenta los registros que guardó la herramienta.
Para elegir entre candidatos, la regla de selección descarta primero cualquier candidato que no pase una comprobación obligatoria. Entre el resto, prefiere el que supera más escenarios. Si dos superan el mismo número, prefiere el que guarda menos registros. Así, un cambio que solo reduce el almacenamiento puede ganar cuando las respuestas no varían, pero nunca frente a un cambio que responde correctamente a más escenarios.
Una sola cifra mejorada no basta para aceptar un cambio. Piensa en bajar min_confidence de 0.7 a 0.2. Se guardan más hechos útiles, como una preferencia que llegó con una puntuación baja. Se guarda también el hecho incierto delivery = courier, y este sustituye a un valor confirmado. En una comparación preparada a mano, este cambio arregló un escenario pero rompió cuatro, de modo que el éxito bajó de 19/20 a 16/20 aunque todas las comprobaciones obligatorias seguían pasando. La proporción de hechos útiles guardados subió y las respuestas finales empeoraron. Este candidato no fue una propuesta del agente en las campañas que siguen; muestra por qué la puntuación cuenta escenarios completos.
Las comprobaciones tienen límites. La prueba facilita directamente los ID de propietario, así que el aislamiento entre propietarios no es aquí una prueba de autenticación. La comprobación de escrituras prohibidas solo rechaza las entradas que la prueba ya marca como prohibidas; no puede encontrar una instrucción maliciosa escondida en un texto normal. Y el proponente ve los 20 escenarios, así que ninguno sirve como conjunto de prueba oculto. Superar la prueba indica qué ocurrió en estos casos, no cómo se comportará una aplicación desconocida.
Da a cada propuesta una razón comprobable
El experimento se ejecutó en campañas. Una campaña es un intento de mejorar la configuración original, que empieza con un historial de agente nuevo. Cada iteración es una llamada al modelo en la que el agente propone un cambio o decide detenerse. En la primera petición, el agente recibe los ajustes actuales y su significado, los resultados de la línea base, las trazas de los escenarios fallidos, los cambios que puede proponer y, en iteraciones posteriores, las propuestas anteriores y sus resultados.
Cada respuesta debe rellenar los mismos cinco campos. Este formato sigue el Schema-Guided Reasoning (SGR): la respuesta es un registro de decisión que un revisor puede comprobar campo por campo.
| Campo | Qué puede comprobar un revisor |
|---|---|
observations | ¿Qué escenario y qué evento de los aportados respaldan el cambio propuesto? |
hypothesis | ¿Qué regla parece causar el problema? |
predicted_effect | ¿Qué debería mejorar al probar el cambio? |
action | ¿El agente propone un cambio o se detiene? |
patch | ¿Qué ajustes permitidos deben cambiar? |
La petición impone esa forma con un JSON Schema estricto mediante Structured Outputs de OpenAI. El esquema restringe la forma de la respuesta; no demuestra la hipótesis. Después, Python comprueba si los eventos citados existen en las evidencias que aportó, si el parche se mantiene dentro de los ajustes permitidos y si esa configuración ya se había probado. Una respuesta puede ajustarse al esquema y aun así fallar estas comprobaciones.
En la primera iteración registrada, el agente citó el fallo del traslado futuro y un segundo fallo, en el que un dato sobre la dirección del trabajo de Ada respondía a una pregunta sobre su casa. Propuso activar a la vez el filtro de asunto y el filtro de fecha:
{ "filter_entity": true, "time_aware": true }En la implementación, estos ajustes eliminan los registros no elegibles antes de ordenar. El filtro de asunto descarta los hechos sobre otros asuntos, de modo que un hecho de work no puede responder a una pregunta de home. El filtro de fecha conserva solo los hechos válidos en la fecha de la pregunta. Un hecho es válido desde su fecha de inicio hasta su fecha de fin, sin incluirla:
def valid_at(item: dict, at: str) -> bool:
    return item["valid_from"] <= at and (
        item["valid_to"] is None or at < item["valid_to"]
    )
París empieza el 10 de enero, así que para la pregunta del 5 de enero solo queda Berlín. El 12 de enero, París es válida y Berlín no.
Python ejecutó esa configuración sobre los 20 escenarios. El éxito subió de 13/20 a 19/20 y las comprobaciones obligatorias pasaron. La campaña cambió los dos filtros en un solo paso, así que midió únicamente su efecto combinado; las repeticiones con un solo ajuste más abajo los separan. El ejecutor conservó esta configuración como punto de partida de la siguiente propuesta y devolvió sus resultados al agente.
Tras los filtros, un escenario seguía fallando y algunos escenarios guardaban dos veces la misma confirmación. La primera campaña tomó cuatro decisiones en total:
| Decisión | Evidencia y cambio propuesto | Resultado medido en los mismos 20 escenarios |
|---|---|---|
| 1 | Activar el filtrado por asunto y fecha tras respuestas con asunto o fecha equivocados | 13/20 → 19/20; conservado como siguiente punto de partida |
| 2 | Deduplicar las confirmaciones repetidas de language = German | 19/20; media de registros guardados 1.70 → 1.60 |
| 3 | Bajar min_confidence de 0.7 a 0.6 para una preferencia útil con puntuación 0.6 | 20/20; media de registros guardados 1.65 |
| 4 | Detenerse al no quedar ninguna propuesta más con respaldo | No se probó ninguna configuración nueva |
Con 0.6 se guarda la preferencia útil, mientras que el hecho incierto delivery = courier, con puntuación 0.4, queda por debajo del umbral. Eso explica el tercer cambio con estas entradas preparadas; las puntuaciones las aportó el autor de la prueba. La decisión de detenerse significa que el agente no encontró ningún otro cambio que pudiera respaldar con la información que vio. No demuestra que esta configuración sea la mejor posible.
La validación también ha rechazado una respuesta. En una ejecución de desarrollo aparte, un agente citó un ID de candidato como si fuera un evento de un escenario. La respuesta se ajustaba al JSON Schema, pero la referencia no existía en las evidencias de eventos aportadas. Python rechazó la propuesta antes de probarla y devolvió el error de validación. Ninguna de las tres campañas registradas más abajo tuvo un rechazo así.
Si un parche evaluado empeora la puntuación, el ejecutor conserva el punto de partida anterior y registra el intento fallido. Una prueba automatizada con respuestas predefinidas ejercita ese camino; las tres campañas reales no. Mantener el resultado rechazado en el historial da al proponente un motivo para elegir un cambio distinto en lugar de repetir la misma conjetura.
Repetición, coste y adopción
La herramienta de memoria es determinista: volver a ejecutar la misma configuración sobre el mismo escenario da la misma respuesta. La incertidumbre está en lo que elige el agente. Por eso el estudio ejecutó toda la búsqueda tres veces, cada una desde la línea base de 13/20, con un historial de agente nuevo y como máximo cuatro decisiones del modelo. Las tres campañas eligieron los mismos tres parches, llegaron a 20/20 en los mismos escenarios y luego se detuvieron. Son 12 llamadas al modelo, nueve propuestas evaluadas y tres decisiones de detenerse.
En el estudio del 11 de septiembre de 2026, el proponente fue gpt-5.6-luna con esfuerzo de razonamiento bajo. Con las tarifas publicadas del modelo, el uso de tokens registrado equivale a unos USD 0.04 por las 12 llamadas, frente a un presupuesto configurado de USD 0.50. Es una estimación a partir del uso registrado, no una factura, y no incluye el tiempo de desarrollo.
Estos resultados repetidos muestran que este modelo siguió un camino útil con este prompt, este objetivo y este conjunto de escenarios. No muestran que una carga de memoria nueva vaya a pasar. El informe congelado de las campañas del experimento complementario y su archivo de evidencias con suma de verificación contienen las peticiones, las respuestas, las validaciones y los resultados registrados.
Una configuración que conserva el ejecutor es solo el punto de partida del siguiente experimento. No es un lanzamiento. En los informes del experimento complementario, la adopción sigue esperando la revisión de una persona, y las campañas no desplegaron nada. Un revisor aún tendría que comprobar el cambio con su propia carga de trabajo, sus reglas de acceso, su objetivo de coste y su plan de reversión.
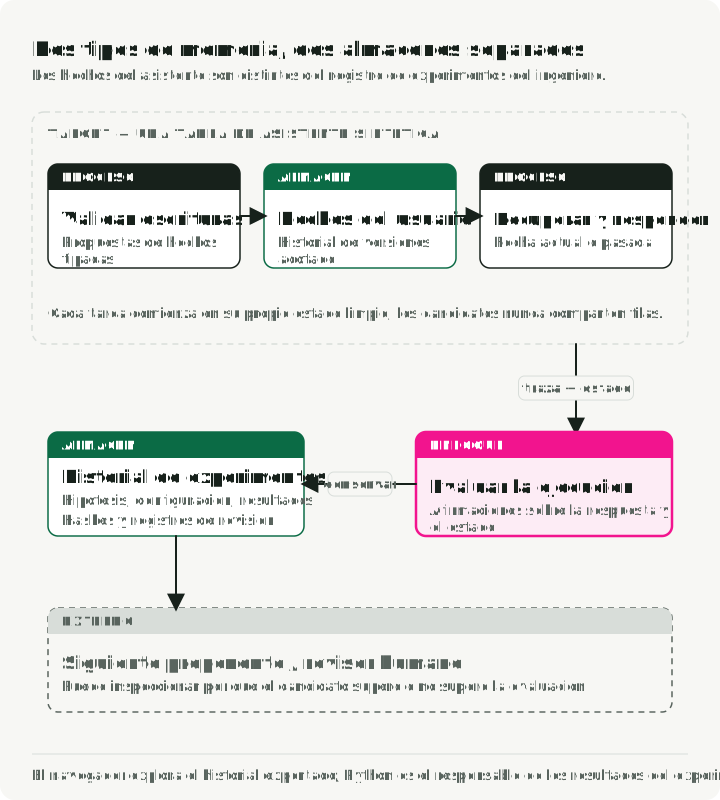
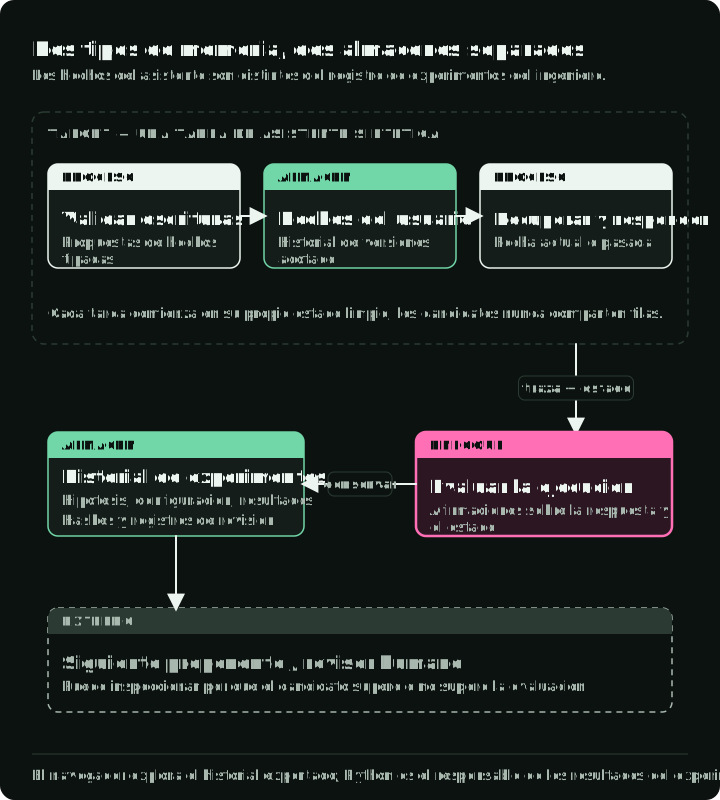
El experimento también produce registros propios, que requieren un tratamiento distinto del de los hechos de Ada. La herramienta de memoria guarda su ciudad. El historial de experimentos guarda cada petición, propuesta, resultado de validación, versión de prueba y resultado, con los hashes necesarios para explicar una elección más adelante. En este estudio sintético esos registros pueden ser públicos. En una aplicación real, borrar el hecho de un usuario del almacén de memoria activo no eliminaría las copias que hay en los registros de experimentos ni en las copias de seguridad. Una política de retención y borrado debe cubrir esos registros por separado.
¿Hacía falta un LLM para esta búsqueda?
Las campañas muestran que el bucle funciona: un LLM leyó trazas, propuso ajustes y cambió su siguiente propuesta tras recibir feedback. No muestran que un LLM fuera el proponente adecuado para este problema. Para comprobarlo, volví a ejecutar la herramienta de memoria sin cambios sobre los mismos 20 escenarios, cambiando un ajuste cada vez, con el script de la rejilla de ajustes del experimento complementario. Estas ejecuciones no hacen llamadas al modelo, y cada configuración necesita una sola ejecución porque la herramienta es determinista.
| Configuración | Escenarios superados |
|---|---|
| Línea base | 13/20 |
| Solo filtro de asunto | 16/20 |
| Solo filtro de fecha | 16/20 |
| Solo deduplicación | 13/20 |
Solo min_confidence = 0.6 | 14/20 |
| Ambos filtros | 19/20 |
Ambos filtros, deduplicación, min_confidence = 0.6 | 20/20 |
Cada filtro arregla tres escenarios por sí solo, y juntos arreglan seis. La deduplicación no cambia ninguna respuesta; solo reduce los registros guardados.
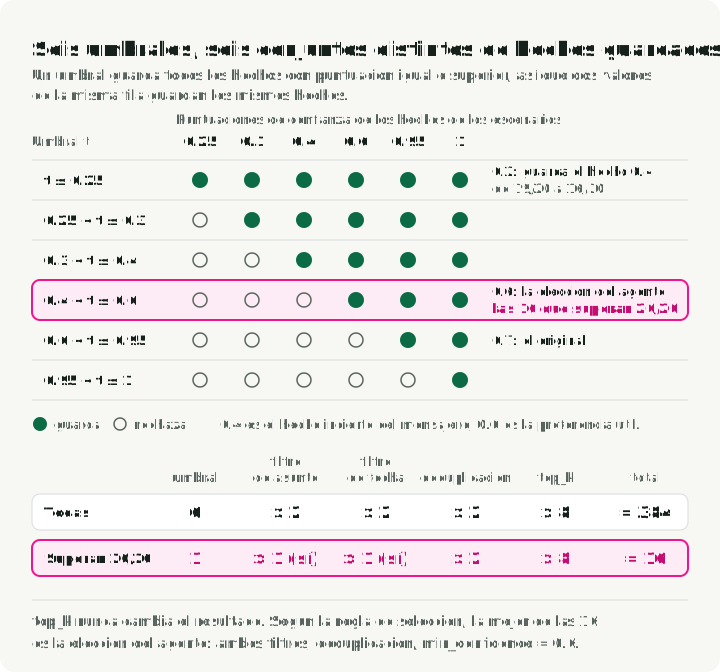
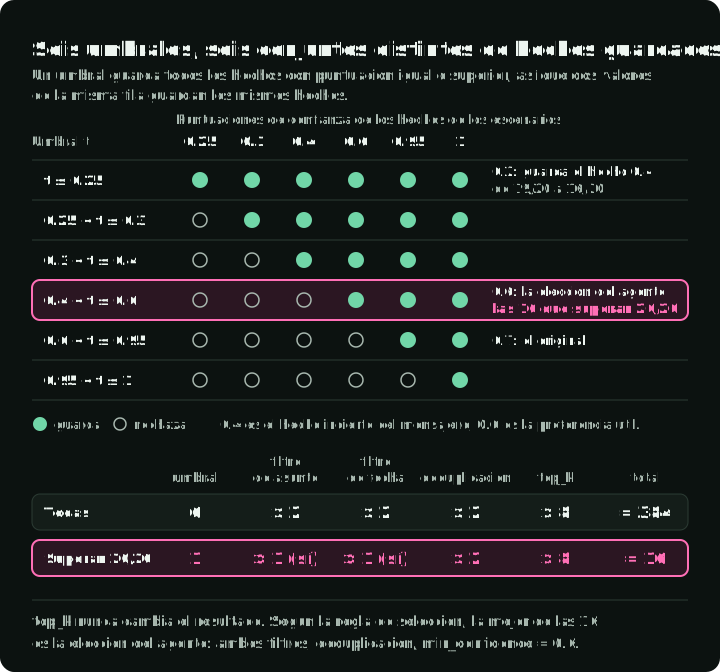
Después probé todas las combinaciones. Los hechos de los escenarios tienen seis puntuaciones de confianza: 0.25, 0.3, 0.4, 0.6, 0.95 y 1. Un umbral guarda todos los hechos con puntuación igual o superior, así que 0.45 y 0.55 guardan exactamente los mismos hechos. Basta con un valor de umbral por cada intervalo entre puntuaciones vecinas, y seis valores cubren todos los comportamientos de escritura distintos en estos escenarios.
Con esos seis umbrales, tres ajustes de activado/desactivado y ocho valores de top_k, hay 384 configuraciones. El script ejecuta cada una sobre los 20 escenarios y termina en menos de un segundo.
Dieciséis configuraciones superan 20/20. Todas activan los dos filtros y usan un umbral superior a 0.4 y de 0.6 como máximo; top_k nunca cambia el resultado. Según la regla de selección anterior, la mejor configuración es la que encontró el agente: los dos filtros, deduplicación y min_confidence = 0.6, con 1.65 registros guardados por escenario. El informe guardado enumera todos los resultados con el hash del código fuente.
En la figura, cada fila es un intervalo de umbrales, los puntos rellenos son los hechos que guarda, y la fila marcada contiene las 16 configuraciones que superan la prueba.
Esta rejilla no es una comparación justa con el agente. Usa mi conocimiento de las puntuaciones de confianza de los datos de prueba e ignora el límite de cuatro decisiones del agente. Solo muestra que este espacio de búsqueda es lo bastante pequeño para probarlo por completo, así que no necesitaba un proponente LLM.
La rejilla y el agente son dos de las cuatro formas de repartir la elección de experimentos entre las personas y el software:
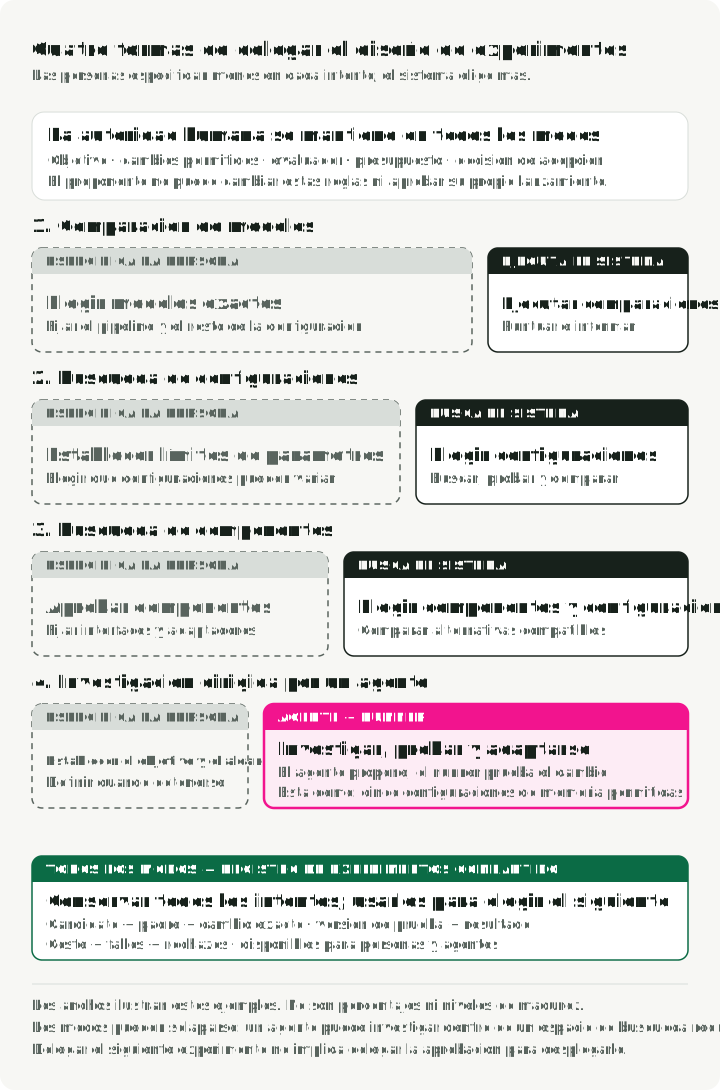
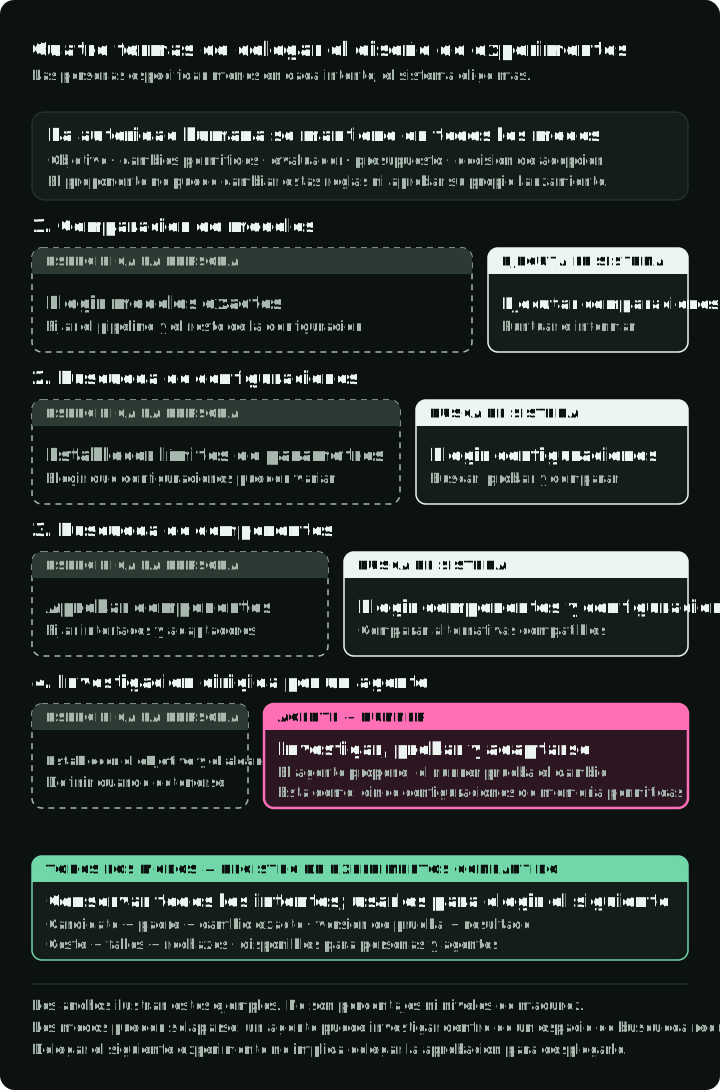
- Comparación de modelos. Tú eliges los modelos o variantes exactos; el sistema los ejecuta y los puntúa. No hace falta un proponente LLM.
- Búsqueda de configuraciones. Tú eliges qué ajustes pueden variar y sus límites; una rejilla, una búsqueda aleatoria o un optimizador como Optuna elige los valores. La rejilla de arriba es este modo.
- Búsqueda de componentes. Tú apruebas componentes intercambiables con interfaces fijas, y la búsqueda elige componentes y ajustes. La búsqueda de pipelines de Scikit-learn lo hace con una búsqueda en rejilla corriente, así que intercambiar componentes no hace por sí solo que el proceso sea agentic.
- Investigación dirigida por un agente. Un agente lee los fallos y los resultados anteriores, propone el siguiente cambio y se adapta tras cada prueba, como hicieron las campañas de arriba. Existen híbridos: MIPROv2 de DSPy hace que un modelo proponga instrucciones y usa optimización bayesiana para buscar sus combinaciones.
En todos los modos, las personas conservan el objetivo, los cambios permitidos, el evaluador, el presupuesto y la decisión de adopción. Todos los modos pueden escribir en el mismo historial de experimentos, que el diagrama llama registro: cada candidato y su padre, el cambio exacto y quién lo aportó, la versión de prueba, el resultado, el coste y cualquier rechazo. Con ese registro puedes pasar la siguiente propuesta a un agente, o recuperarla, sin perder evidencias. El ejecutor del experimento complementario también acepta un candidato aportado por una persona mediante lab evaluate.
Decide primero qué modo encaja con tu sistema. Si los cambios permitidos son unos pocos ajustes con rangos conocidos y cada prueba es barata, enuméralos o usa un optimizador estándar antes de añadir un LLM. Un proponente LLM puede ayudar cuando elegir un cambio exige leer trazas de fallos variadas, código fuente e interacciones entre componentes, y cuando los candidatos son demasiados o están demasiado poco estructurados para listarlos. Si ayuda de verdad en ese caso, es algo que hay que medir, no suponer.
Aplícalo a tu sistema
Elige una traza que muestre un fallo real. Antes de empezar ninguna búsqueda, escribe cuatro cosas:
- qué cambios se permiten;
- qué resultados de la tarea y qué efectos prohibidos comprueba el evaluador;
- cuánto puede costar cada intento;
- quién puede adoptar un candidato.
Prueba la búsqueda más sencilla que cubra los cambios permitidos. Después comprueba si el resultado cambia el siguiente experimento o una decisión de lanzamiento. Si no cambia ninguno de los dos, el bucle no ha mejorado nada.
Opcional: inspecciona y ejecuta el experimento complementario
Puedes inspeccionar el estudio registrado sin una clave de API. La etiqueta v0.2.3 contiene la herramienta de memoria, los estudios registrados y la rejilla de ajustes. Con uv instalado, clónala, restaura las evidencias registradas, verifícalas, vuelve a ejecutar la rejilla e inicia un visor local de las campañas registradas:
git clone --branch v0.2.3 --depth 1 https://github.com/slavadubrov/meta-engineering-ai-lab.git
cd meta-engineering-ai-lab
uv sync --frozen
uv run --frozen python scripts/fetch_evidence.py
uv run --frozen python -m lab verify artifacts/agent-study-03 --source
uv run --frozen python scripts/settings_grid.py --check
uv run --frozen python -m lab serve --port 8075
Abre http://127.0.0.1:8075/web/ para seguir una campaña registrada desde la propuesta hasta el feedback. La descarga se comprueba con una suma de verificación fijada, y nada de este bloque hace llamadas al modelo. La ejecución con --check recalcula la rejilla y falla si el informe guardado ya no coincide con el código.
Para ejecutar una campaña de propuestas nueva y de pago, guarda OPENAI_API_KEY en el archivo .env.local del repositorio, que Git ignora, y elige un directorio de salida nuevo:
uv run --frozen --env-file .env.local python -m lab campaign \
  --live --campaigns 3 --iterations 4 --budget-usd 0.50 \
  --output artifacts/my-agent-study
El indicador explícito --live activa las llamadas al proveedor. Consulta artifacts/my-agent-study/report.md para ver las propuestas y los costes resultantes. El modelo puede seguir un camino distinto aunque Python puntúe cualquier configuración dada de la misma manera. El recorrido por la herramienta de memoria muestra las entradas JSON preparadas, los registros guardados y cuatro configuraciones especificadas a mano, por si quieres entender el objetivo determinista sin ejecutar el agente.
Hacia dónde va la serie
La herramienta de memoria era pequeña a propósito: cinco ajustes y 20 escenarios permiten inspeccionar cada paso. Ese mismo tamaño es su límite. Un script puede probar todas las configuraciones, así que este ejemplo no puede mostrar cuándo compensa el coste de un proponente LLM.
Las siguientes partes de esta serie usan un objetivo mayor: el harness de atención al cliente de Diseñar un harness de agente: de la tarea a la arquitectura, la parte 1 de Building and Evaluating Agent Harnesses. Un agente de programación propondrá cambios en ese harness y se compararán sus resultados con los de una búsqueda más sencilla. El agente que mejora no se editará a sí mismo y una persona revisará cada adopción.
Ese harness necesita antes un evaluador más fuerte. Siete de sus doce tareas de atención al cliente no esperan ningún cambio en la base de datos, así que un agente que no hace nada ya supera 7 de las 12 comprobaciones de estado. Un agente de programación puntuado solo con esas comprobaciones podría superar más comprobaciones logrando que el agente de atención al cliente haga menos.