Meta-inżynieria systemów AI: od śladów do lepszej pamięci

Tłumaczenie automatyczne
Ten artykuł został automatycznie przetłumaczony z angielskiego oryginału.
Ten artykuł jest dla inżynierów, którzy chcą, żeby agent ustalał, dlaczego ich system AI zawodzi, i proponował poprawkę. Przykładem jest małe narzędzie pamięci, które odpowiada na pytanie, gdzie mieszka użytkownik, i odpowiada błędnie. Zobaczysz, jak zmiana tego narzędzia jest proponowana, testowana na 20 przygotowanych scenariuszach i oceniana, zanim ktokolwiek ją przyjmie. Zobaczysz też, jak sprawdzić, czy zwykły skrypt, który wypróbowuje każde ustawienie, znalazłby tę samą poprawkę bez LLM. W towarzyszącym eksperymencie LLM proponował zmiany, a zwykły kod w Pythonie je testował.
Meta-inżynierią nazywam projektowanie tego procesu usprawniania. Sprowadza się do czterech decyzji. Co może zmieniać proponujący, czyli osoba lub program, który sugeruje zmiany? Które wyniki liczą się jako usprawnienie? Jak wynik wpływa na kolejną propozycję? Kto decyduje o przyjęciu zmiany? Te same cztery decyzje obowiązują niezależnie od tego, czy proponującym jest LLM, człowiek czy przeszukiwanie parametrów.
Błąd złego miasta
Narzędzie pamięci przechowuje fakty o użytkowniczce Adzie i odpowiada na pytania o nią. Jeden test, scenariusz przyszłej przeprowadzki, wysyła do niego cztery zdarzenia:
- Zapisz
city = Berlinze skutkiem od 1 stycznia. - Zapisz
city = Paris, otrzymane 3 stycznia, ale ze skutkiem od 10 stycznia. - Zapytaj o miasto 5 stycznia. Oczekiwany wynik: Berlin.
- Zapytaj o miasto 12 stycznia. Oczekiwany wynik: Paryż.
Pierwotne narzędzie za każdym razem odpowiada: Paryż. 12 stycznia to poprawna odpowiedź. 5 stycznia jest błędna: Ada jeszcze się nie przeprowadziła.
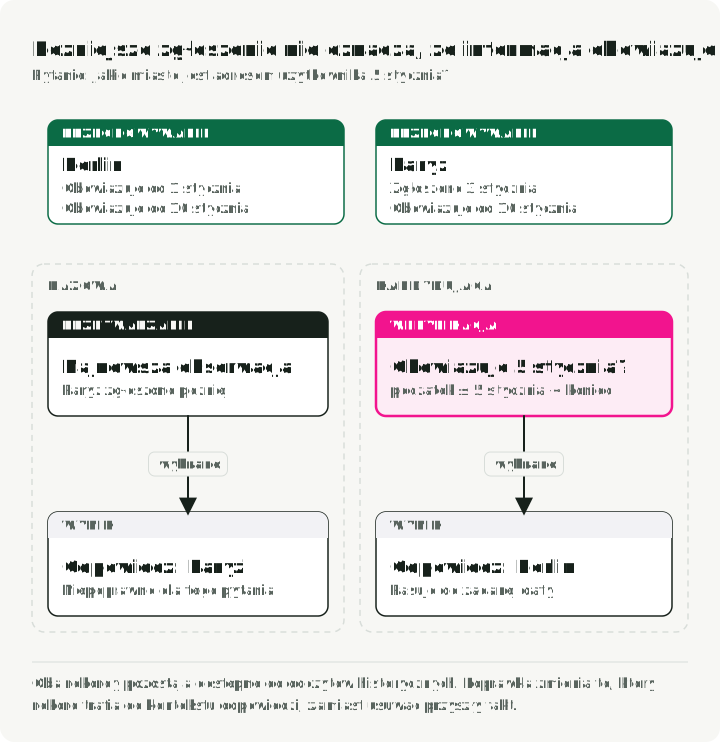
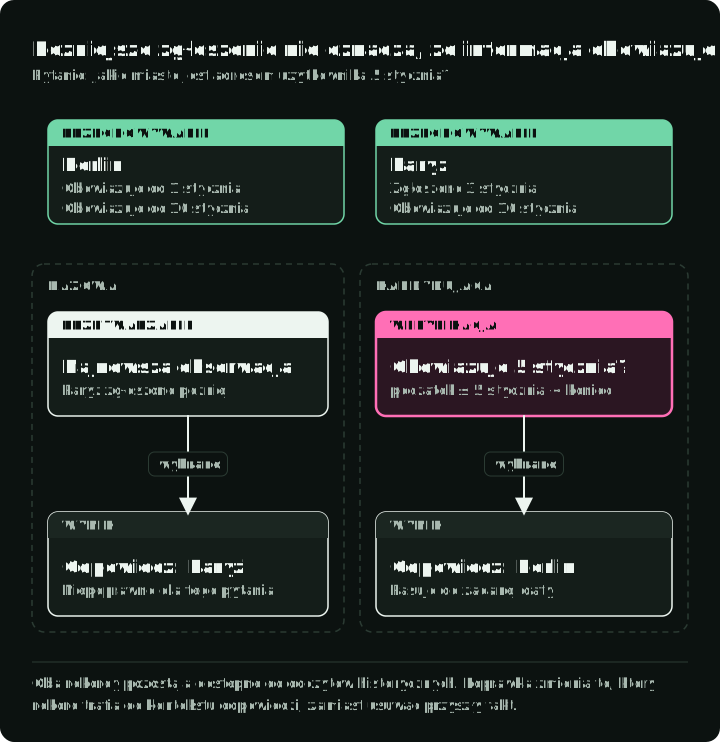
Każde uruchomienie testu zostawia ślad: zapisany rekord wszystkich zdarzeń wysłanych do narzędzia, rekordów, które zapisało, i odpowiedzi, których udzieliło. Zapisany ślad tego scenariusza pokazuje, że oba rekordy mają poprawne daty obowiązywania. Berlin obowiązuje od 1 do 10 stycznia, a Paryż od 10 stycznia bez daty końcowej. Błąd leży w wyszukiwaniu: stawia ono niedawno otrzymany fakt o Paryżu przed Berlinem, nie sprawdzając, który z nich obowiązywał w żądanym dniu. Zapisanie przyszłej przeprowadzki było poprawne.
Fakt o Paryżu musi więc zostać, a wyszukiwanie potrzebuje filtra daty. Ta diagnoza nie uzasadnia jeszcze przyjęcia filtra. Ten sam kod wyszukiwania odpowiada na pytania o inne tematy, obsługuje usuwanie i musi trzymać rekordy użytkowników osobno. Zmiana, która naprawia 5 stycznia, ale psuje te przypadki, pogarsza narzędzie pamięci. Proces usprawniania musi to wykryć, zanim nowa wersja trafi do użytkowników.
Dwie pętle
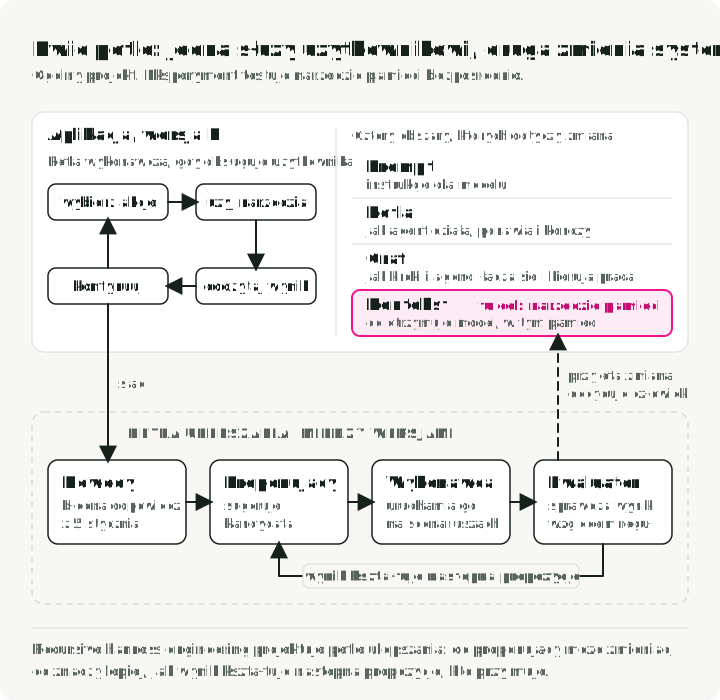
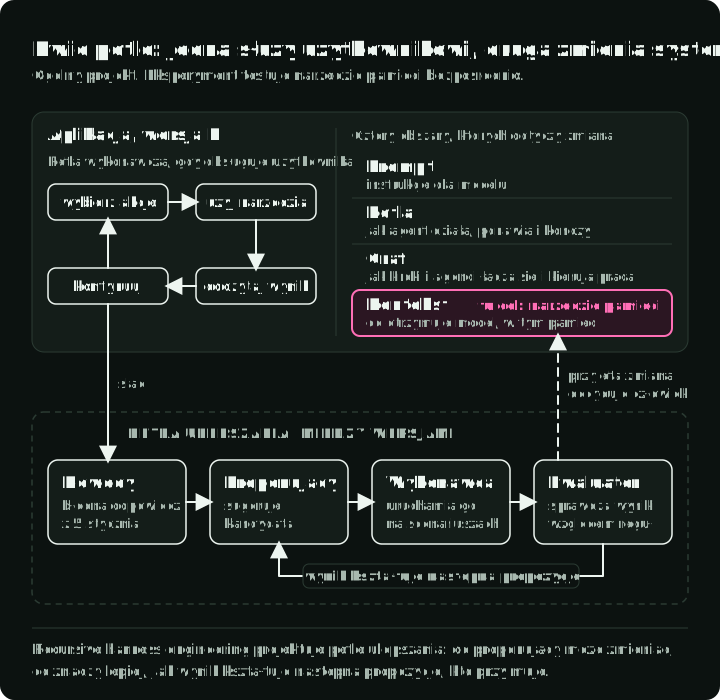
Aplikacja z agentem uruchamia pętlę, gdy obsługuje użytkownika. W tej pętli wykonania wybiera akcję, wywołuje narzędzie, czyta wynik i kontynuuje zadanie użytkownika. Agent korzystający z narzędzia pamięci mógłby otrzymać w niej błędną odpowiedź o mieście. Ten eksperyment wywołuje narzędzie bezpośrednio, używając stałych zdarzeń testowych.
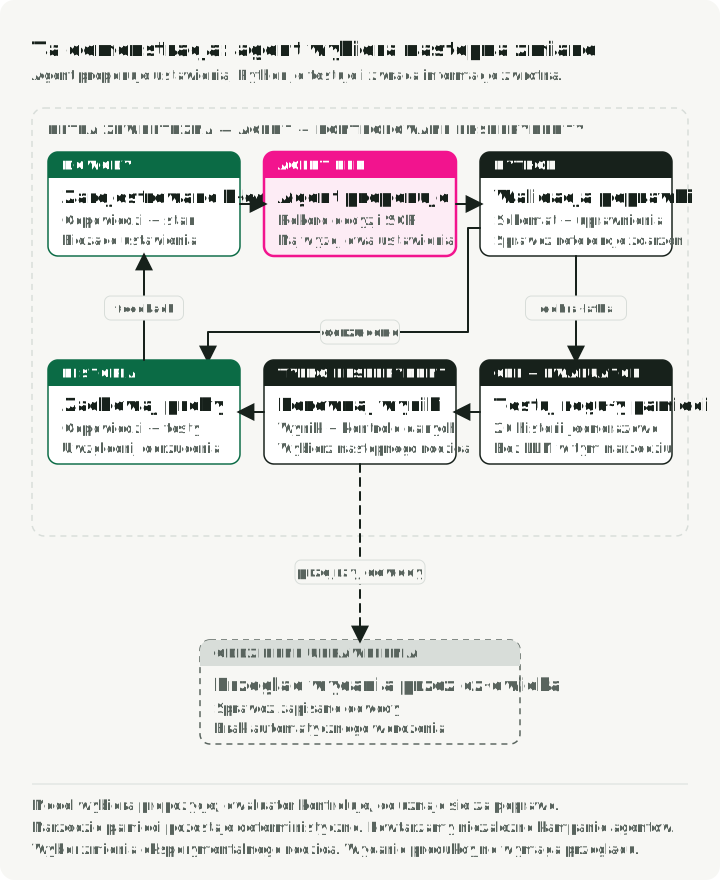
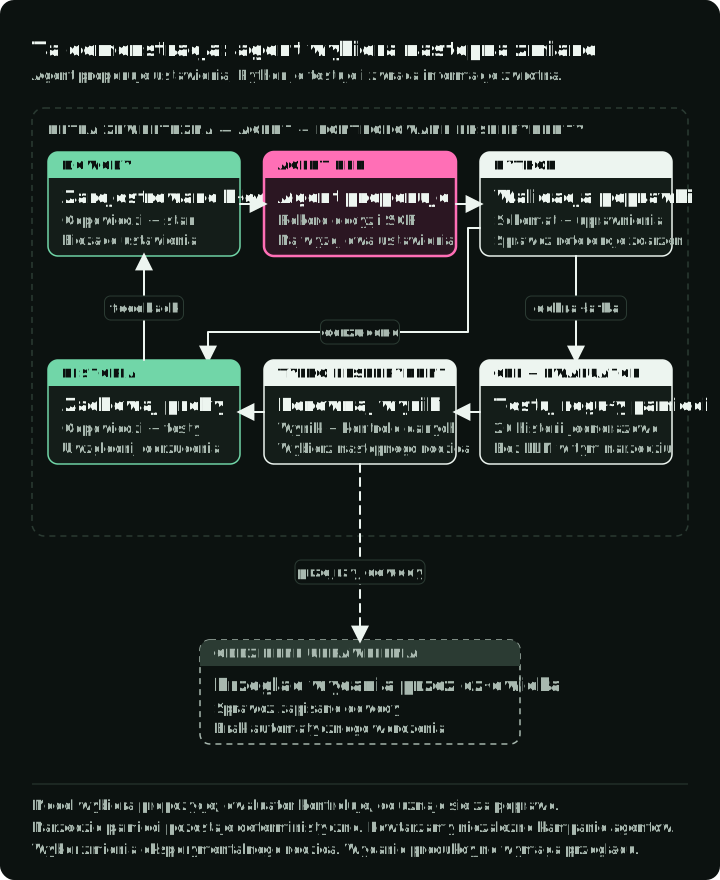
Naprawa błędu wymaga drugiej pętli, która działa między wersjami aplikacji. Ta pętla usprawnień zaczyna się od dowodu błędu, na przykład odpowiedzi z 5 stycznia, rekordu zmienionego wbrew regułom albo zbyt wysokiego kosztu. Proponujący sugeruje kandydata: jedną konkretną wersję zmiany w celu, czyli w tej części systemu, którą usprawniamy. Tutaj celem jest narzędzie pamięci, a kandydatem nowy zestaw jego ustawień. Moduł wykonawczy uruchamia kandydata na stałym zbiorze scenariuszy testowych, a ewaluator sprawdza wyniki względem reguł, które te scenariusze kodują. Pętla jest zamknięta dopiero wtedy, gdy wynik zmienia kolejną propozycję albo decyzję o przyjęciu zmiany.
Diagram przedstawia ogólny projekt aplikacji, w którym celem może być dowolna część aplikacji. Inżynierowie często grupują te części w cztery nakładające się obszary. Prompt engineering zmienia instrukcje. Context engineering zmienia informacje, które otrzymuje model, w tym pamięć. Inżynieria pętli zmienia sposób, w jaki agent działa, ponawia próby i się zatrzymuje w pętli wykonania. Inżynieria grafu zmienia sposób łączenia kroków lub agentów i kierowania między nimi pracy. Meta-inżynieria traktuje wybór w którymkolwiek z tych czterech obszarów, na przykład sposób sformułowania instrukcji prompt albo liczbę ponowień, jako ustawienie, które eksperyment może zmieniać. Każdego kandydata ocenia według jakości odpowiedzi całego systemu, kosztu i wymaganego zachowania, na przykład tego, że dane jednego użytkownika nigdy nie trafiają do innego.
Dwa niedawne projekty już używają agenta programistycznego jako proponującego. W autoresearch Karpathy’ego agent edytuje jeden plik treningowy i uruchamia go w stałym budżecie czasu. Każda próba jest zapisana jako zachowana, odrzucona albo zakończona awarią, a kod ewaluacji leży w osobnym pliku, którego agent nie edytuje. Meta-Harness, preprint z marca 2026 roku, pozwala proponującemu czytać kod źródłowy, wyniki i ślady wcześniejszych kandydatów. Używa ich do ulepszania kodu, który decyduje o tym, co aplikacja LLM zapisuje, pobiera i pokazuje swojemu modelowi. Ten artykuł używa znacznie mniejszego celu, narzędzia pamięci, żeby każdy krok dało się sprawdzić.
Ogranicz, co może zmieniać proponujący
LLM nigdy nie działa wewnątrz narzędzia pamięci. Czyta nieudane ślady i wyniki ewaluacji, a potem proponuje nową konfigurację: wartości ustawień narzędzia. Tę konfigurację testuje Python.
Samo narzędzie pamięci to zwykły, deterministyczny kod w Pythonie. Przyjmuje ustrukturyzowane fakty, zapisuje je lub odrzuca i zwraca wartość dla zapytania. Nie wyciąga faktów z rozmowy ani nie pisze odpowiedzi w języku naturalnym, więc ta pętla nie naprawi błędu w ekstrakcji faktów. Każdy zapisany fakt ma właściciela, zdarzenie źródłowe i przedział obowiązywania, zgodnie z regułami stanu zapisanego w tekście Schema-Guided Agent Memory.
Każdy przychodzący fakt niesie też ocenę pewności, którą wpisuje autor testu. Narzędzie zapisuje fakt tylko wtedy, gdy jego ocena wynosi co najmniej min_confidence. Oceny są częścią danych testowych, a nie prawdopodobieństwami zmierzonymi na modelu. Na przykład niepewny fakt delivery = courier z oceną 0.4 jest odrzucany przy pierwotnym progu 0.7, ale zapisany przy 0.2.
Rekord Paryża po drugim zapisie pokazuje, jak rekord zachowuje swoją historię. observed_at to dzień, w którym narzędzie dowiedziało się o fakcie, a valid_from to dzień, od którego fakt jest prawdziwy (fragment):
{
    "id": "m002",
    "key": "city",
    "value": "Paris",
    "valid_from": "2026-01-10",
    "valid_to": null,
    "observed_at": "2026-01-03",
    "source_event_id": "future-move:event-2",
    "supersedes_memory_id": "m001"
}
source_event_id wskazuje zdarzenie, które dostarczyło Paryż, a supersedes_memory_id łączy go z rekordem Berlina m001. Moduł zapisu ma też stałe reguły rozstrzygania konfliktów. Jeśli późniejszy zapis mówi Rzym, również ze skutkiem od 10 stycznia, moduł go odrzuca i zostawia Paryż bez zmian. Powtórzony Paryż z tą samą datą ponownie używa istniejącego rekordu, a aktualizacja z wcześniejszą datą skutku jest odrzucana. Proponujący nie może zmienić tych reguł.
Proponujący może zmienić pięć istniejących ustawień:
| Ustawienie | Co zmienia |
|---|---|
min_confidence | Zmienia minimalną ocenę pewności wymaganą do zapisania faktu. |
filter_entity | Ogranicza wyszukiwanie do żądanego tematu, na przykład domu, a nie pracy. |
time_aware | Ogranicza wyszukiwanie do faktów obowiązujących w żądanym dniu. |
deduplicate | Używa ponownie identycznego aktywnego faktu zamiast zapisywać kolejne potwierdzenie. |
top_k | Ustala, ile najwyżej ocenionych rekordów narzędzie bierze pod uwagę w odpowiedzi. |
Jedna propozycja zmienia najwyżej dwa ustawienia; min_confidence mieści się w zakresie od 0 do 1, a top_k od 1 do 8. Agent nie może edytować żadnego kodu, testu ani oczekiwanej odpowiedzi i nie może sam zatwierdzić swojej zmiany. Jego wynik to dane, które waliduje Python, a nie kod do wykonania. Kontrakt konfiguracji i walidator propozycji określają ten limit w kodzie.
Ponieważ ten proponujący może wysyłać tylko ustawienia, nie może zmienić ewaluatora. Ewaluator działa jednak w tym samym procesie Pythona co narzędzie pamięci. Agent, który mógłby pisać i uruchamiać własny kod, mógłby więc zmienić kontrole. Taki agent wymaga ewaluatora w osobnym procesie, z własnymi regułami dostępu do plików i sieci, zanim jego wynikom będzie można zaufać.
Reguła oceniania
W historii o mieście test musi zadać oba pytania: Berlin 5 stycznia i Paryż 12 stycznia. Testowanie tylko pierwszej odpowiedzi nagradzałoby narzędzie, które po prostu odrzuca przyszły fakt. W towarzyszącym projekcie scenariusz to jedna kompletna historia zdarzeń write, query i czasem delete, jak cztery zdarzenia powyżej. Każdy kandydat uruchamia te same 20 przygotowanych scenariuszy, każdy od pustej pamięci. Pierwotna konfiguracja zalicza 13 z nich.
Scenariusz jest zaliczony tylko wtedy, gdy każda oczekiwana odpowiedź jest poprawna i żadna reguła danych nie została złamana. Ewaluator sprawdza trzy reguły danych, zwane twardymi kontrolami: jeden właściciel nigdy nie widzi faktów innego, usunięty fakt znika, a dane oznaczone jako zabronione nie są zapisywane. Liczy też rekordy, które narzędzie zapisało.
Przy wyborze między kandydatami reguła wyboru najpierw odrzuca każdego, kto nie przechodzi twardej kontroli. Spośród pozostałych preferuje tego, który zalicza więcej scenariuszy. Jeśli dwóch zalicza tyle samo, preferuje tego, który zapisuje mniej rekordów. Zmiana, która tylko zmniejsza ilość danych, może więc wygrać, gdy odpowiedzi się nie zmieniają, ale nigdy nie wygra ze zmianą, która poprawnie odpowiada w większej liczbie scenariuszy.
Jedna poprawiona liczba nie wystarcza, żeby przyjąć zmianę. Weźmy obniżenie min_confidence z 0.7 do 0.2. Zapisuje się więcej przydatnych faktów, na przykład preferencja, która przyszła z niską oceną. Zapisuje się też niepewny fakt delivery = courier i zastępuje potwierdzoną wartość. W ręcznie przygotowanym porównaniu ta zmiana naprawiła jeden scenariusz, ale zepsuła cztery, więc skuteczność spadła z 19/20 do 16/20, mimo że wszystkie twarde kontrole nadal przechodziły. Odsetek zapisanych przydatnych faktów wzrósł, a końcowe odpowiedzi się pogorszyły. Ten kandydat nie był propozycją agenta w kampaniach poniżej; pokazuje, dlaczego wynik liczy kompletne scenariusze.
Kontrole mają ograniczenia. Test podaje identyfikatory właścicieli bezpośrednio, więc izolacja właścicieli nie jest tu testem uwierzytelniania. Kontrola zabronionych zapisów odrzuca tylko dane, które test już oznaczył jako zabronione; nie znajdzie złośliwej instrukcji ukrytej w zwykłym tekście. Proponujący widzi wszystkie 20 scenariuszy, więc żaden z nich nie działa jak ukryty zbiór testowy. Wynik zaliczenia mówi, co stało się w tych przypadkach, a nie jak zachowa się nieznana aplikacja.
Daj każdej propozycji powód, który można sprawdzić
Eksperyment przebiegał w kampaniach. Kampania to jedna próba usprawnienia pierwotnej konfiguracji, zaczynająca się od świeżej historii agenta. Każda iteracja to jedno wywołanie modelu, w którym agent proponuje zmianę albo decyduje o zatrzymaniu. W pierwszym żądaniu agent dostaje bieżące ustawienia i ich znaczenie, wyniki konfiguracji bazowej, ślady z nieudanych scenariuszy, zmiany, które może zaproponować, a w kolejnych iteracjach także wcześniejsze propozycje i ich wyniki.
Każda odpowiedź musi wypełnić te same pięć pól. Ten format wzorowany jest na Schema-Guided Reasoning (SGR): odpowiedź jest zapisem decyzji, który recenzent może sprawdzić pole po polu.
| Pole | Co może sprawdzić recenzent |
|---|---|
observations | Który dostarczony scenariusz i zdarzenie uzasadniają proponowaną zmianę? |
hypothesis | Jaka reguła wydaje się powodować problem? |
predicted_effect | Co powinno się poprawić po przetestowaniu zmiany? |
action | Czy agent proponuje zmianę, czy się zatrzymuje? |
patch | Które dozwolone ustawienia mają się zmienić? |
Żądanie wymusza ten kształt ścisłym JSON Schema przez OpenAI Structured Outputs. Schemat ogranicza kształt odpowiedzi; nie dowodzi hipotezy. Python sprawdza potem, czy cytowane zdarzenia istnieją w dostarczonych dowodach, czy poprawka mieści się w dozwolonych ustawieniach i czy ta konfiguracja była już testowana. Odpowiedź może zgadzać się ze schematem i mimo to nie przejść tych kontroli.
W pierwszej zapisanej iteracji agent powołał się na błąd przyszłej przeprowadzki i na drugi błąd, w którym fakt o adresie służbowym Ady odpowiedział na pytanie o jej dom. Zaproponował włączenie obu filtrów, tematu i daty:
{ "filter_entity": true, "time_aware": true }W implementacji te ustawienia usuwają nieodpowiednie rekordy przed rankingiem. Filtr tematu odrzuca fakty o innych tematach, więc fakt work nie może odpowiedzieć na pytanie home. Filtr daty zostawia tylko fakty obowiązujące w dniu pytania. Fakt obowiązuje od daty początkowej do daty końcowej, z wyłączeniem tej ostatniej:
def valid_at(item: dict, at: str) -> bool:
    return item["valid_from"] <= at and (
        item["valid_to"] is None or at < item["valid_to"]
    )
Paryż obowiązuje od 10 stycznia, więc na pytanie z 5 stycznia zostaje tylko Berlin. 12 stycznia obowiązuje Paryż, a Berlin nie.
Python uruchomił tę konfigurację na wszystkich 20 scenariuszach. Skuteczność wzrosła z 13/20 do 19/20, a twarde kontrole przeszły. Kampania zmieniła oba filtry w jednym kroku, więc zmierzyła tylko ich łączny efekt; uruchomienia z pojedynczymi ustawieniami poniżej je rozdzielają. Moduł wykonawczy zachował tę konfigurację jako punkt wyjścia dla kolejnej propozycji i zwrócił jej wyniki agentowi.
Po filtrach jeden scenariusz nadal zawodził, a niektóre historie zapisywały to samo potwierdzenie dwa razy. Pierwsza kampania podjęła łącznie cztery decyzje:
| Decyzja | Dowód i proponowana zmiana | Zmierzony wynik na tych samych 20 scenariuszach |
|---|---|---|
| 1 | Włącz filtrowanie według tematu i daty po odpowiedziach z błędnym tematem i błędną datą | 13/20 → 19/20; zachowane jako kolejny punkt wyjścia |
| 2 | Deduplikuj powtórzone potwierdzenia language = German | 19/20; średnia liczba zapisanych rekordów 1,70 → 1,60 |
| 3 | Obniż min_confidence z 0.7 do 0.6 dla przydatnej preferencji z oceną 0.6 | 20/20; średnia liczba zapisanych rekordów 1,65 |
| 4 | Zatrzymaj się, gdy nie ma już popartej dowodami propozycji | Nie przetestowano nowej konfiguracji |
Przy 0.6 przydatna preferencja jest zapisywana, a niepewny fakt o kurierze z oceną 0.4 zostaje poniżej progu. To wyjaśnia trzecią zmianę na tych przygotowanych danych; same oceny podał autor testu. Decyzja o zatrzymaniu oznacza, że agent nie znalazł kolejnej zmiany, którą mógłby poprzeć informacją zwrotną, jaką widział. Nie dowodzi, że ta konfiguracja jest najlepsza z możliwych.
Walidacja odrzuciła też jedną odpowiedź. W osobnym przebiegu roboczym agent powołał się na identyfikator kandydata tak, jakby był zdarzeniem scenariusza. Odpowiedź spełniała wymagania JSON Schema, ale tego odwołania nie było w dostarczonych dowodach zdarzeń. Python odrzucił propozycję przed jej przetestowaniem i zwrócił błąd walidacji. W żadnej z trzech zapisanych kampanii poniżej takiego odrzucenia nie było.
Jeśli oceniana poprawka pogarsza wynik, moduł wykonawczy zachowuje poprzedni punkt wyjścia i zapisuje nieudaną próbę. Tę ścieżkę sprawdza test z zaprogramowanymi odpowiedziami agenta; trzy kampanie na żywo jej nie wykorzystały. Zachowanie odrzuconego wyniku w historii daje proponującemu powód, by wybrać inną zmianę zamiast powtarzać to samo przypuszczenie.
Powtórzenia, koszt i przyjęcie
Narzędzie pamięci jest deterministyczne: ponowne uruchomienie tej samej konfiguracji na tym samym scenariuszu daje tę samą odpowiedź. Niepewność dotyczy wyborów agenta. Dlatego badanie uruchomiło całe wyszukiwanie trzy razy, każde od bazowych 13/20, ze świeżą historią agenta i najwyżej czterema decyzjami modelu. Wszystkie trzy kampanie wybrały te same trzy poprawki, osiągnęły 20/20 na tych samych scenariuszach, a potem się zatrzymały. To 12 wywołań modelu, dziewięć ocenionych propozycji i trzy decyzje o zatrzymaniu.
W badaniu z 11 września 2026 roku proponującym był gpt-5.6-luna przy niskim wysiłku rozumowania. Przy opublikowanych stawkach modelu zapisane zużycie mierzone w jednostkach token daje około USD 0.04 za 12 wywołań, przy skonfigurowanym budżecie USD 0.50. To szacunek z zapisanego zużycia, a nie faktura, i nie obejmuje czasu pracy nad projektem.
Te powtórzone wyniki pokazują, że ten model podążył jedną użyteczną ścieżką dla tej instrukcji prompt, tego celu i tego zbioru scenariuszy. Nie pokazują, że nowy przypadek użycia pamięci przejdzie testy. Zamrożony raport z kampanii i archiwum dowodów z sumą kontrolną towarzyszącego projektu zawierają zapisane żądania, odpowiedzi, walidacje i wyniki.
Konfiguracja, którą moduł wykonawczy zachowuje, jest tylko punktem wyjścia dla kolejnego eksperymentu. Nie jest wydaniem. W raportach towarzyszącego projektu przyjęcie nadal czeka na przegląd człowieka, a kampanie niczego nie wdrożyły. Recenzent musiałby jeszcze sprawdzić zmianę względem własnego przypadku użycia, reguł dostępu, celu kosztowego i planu wycofania.
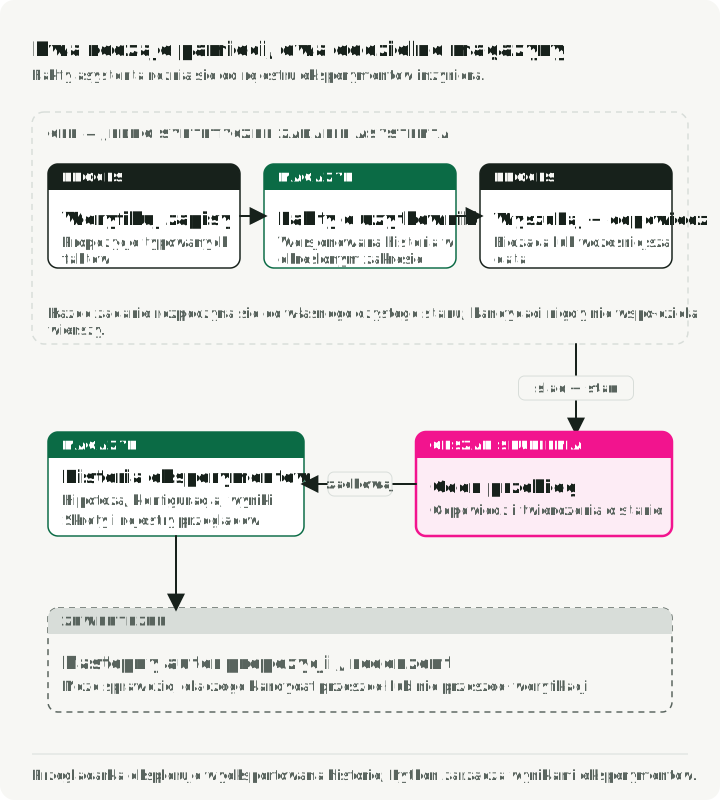
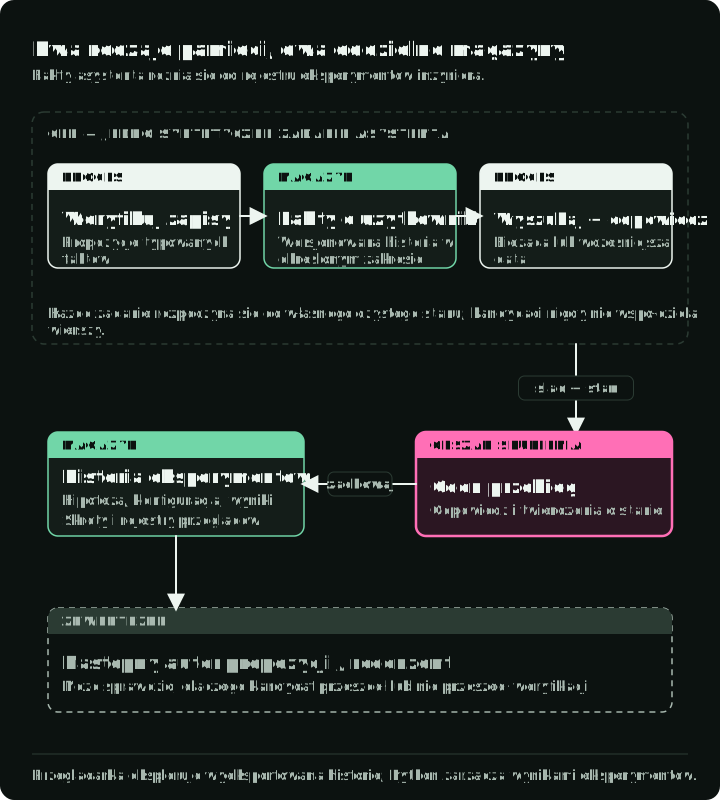
Eksperyment tworzy też własne rekordy, które trzeba traktować inaczej niż fakty o Adzie. Narzędzie pamięci przechowuje jej miasto. Historia eksperymentu przechowuje każde żądanie, propozycję, wynik walidacji, wersję testu i wynik, razem z hashami potrzebnymi, by później wyjaśnić wybór. W tym syntetycznym badaniu rekordy te mogą być publiczne. W prawdziwej aplikacji usunięcie faktu użytkownika z działającego magazynu pamięci nie usunęłoby kopii w logach eksperymentów ani w kopiach zapasowych. Polityka retencji i usuwania musi obejmować te rekordy osobno.
Czy to wyszukiwanie potrzebowało LLM?
Kampanie pokazują, że pętla działa: LLM przeczytał ślady, zaproponował ustawienia i zmienił kolejną propozycję po informacji zwrotnej. Nie pokazują, że LLM był właściwym proponującym dla tego problemu. Żeby to sprawdzić, uruchomiłem ponownie niezmienione narzędzie pamięci na tych samych 20 scenariuszach, zmieniając po jednym ustawieniu naraz, za pomocą skryptu siatki ustawień z projektu towarzyszącego. Te uruchomienia nie wywołują modelu, a każda konfiguracja wymaga tylko jednego przebiegu, bo narzędzie jest deterministyczne.
| Konfiguracja | Zaliczone scenariusze |
|---|---|
| Baza | 13/20 |
| Tylko filtr tematu | 16/20 |
| Tylko filtr daty | 16/20 |
| Tylko deduplikacja | 13/20 |
Tylko min_confidence = 0.6 | 14/20 |
| Oba filtry | 19/20 |
Oba filtry, deduplikacja, min_confidence = 0.6 | 20/20 |
Każdy filtr sam naprawia trzy scenariusze, a razem naprawiają sześć. Deduplikacja nie zmienia żadnej odpowiedzi; zmniejsza tylko liczbę zapisanych rekordów.
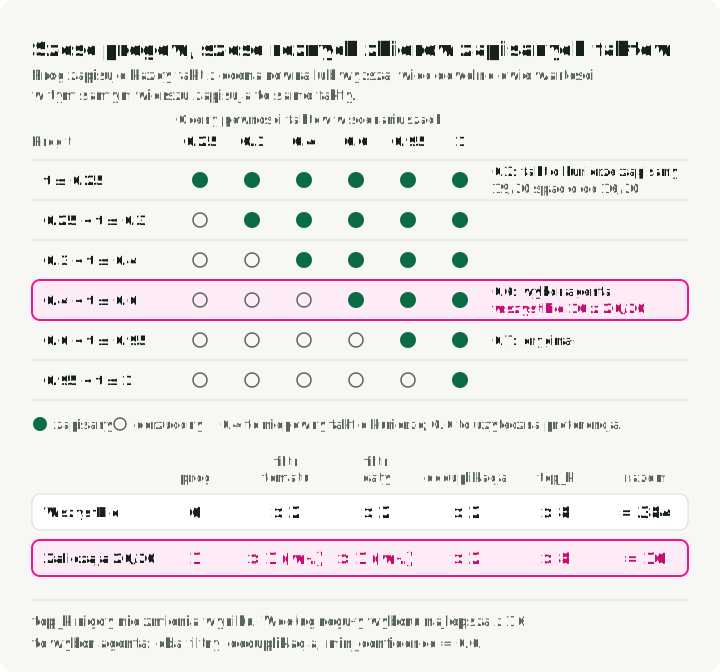
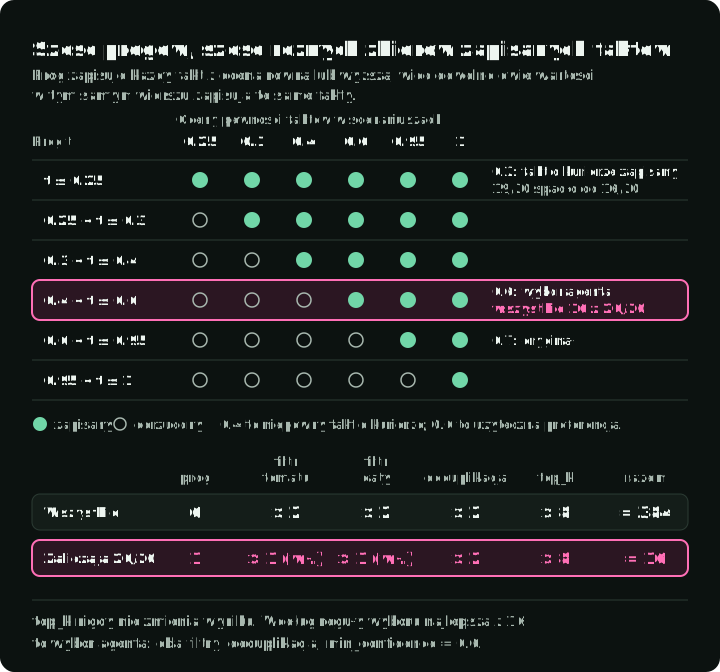
Potem przetestowałem każdą kombinację. Fakty w scenariuszach mają sześć ocen pewności: 0,25, 0,3, 0,4, 0,6, 0,95 i 1. Próg zapisuje każdy fakt z oceną równą progowi lub wyższą, więc 0,45 i 0,55 zapisują dokładnie te same fakty. Wystarczy jedna wartość progu na każdy odstęp między sąsiednimi ocenami, a sześć wartości obejmuje każde odrębne zachowanie zapisywania w tych scenariuszach.
Przy tych sześciu progach, trzech ustawieniach włącz/wyłącz i ośmiu wartościach top_k daje to 384 konfiguracje. Skrypt uruchamia każdą na 20 scenariuszach i kończy w mniej niż sekundę.
Szesnaście konfiguracji zalicza 20/20. Wszystkie włączają oba filtry i używają progu powyżej 0,4 i najwyżej 0,6; top_k nigdy nie zmienia wyniku. Uszeregowana według powyższej reguły wyboru najlepsza konfiguracja to ta, którą znalazł agent: oba filtry, deduplikacja i min_confidence = 0.6, z 1,65 zapisanego rekordu na scenariusz. Zapisany raport wymienia każdy wynik razem z hashem źródła.
Na rysunku każdy wiersz to jeden zakres progów, wypełnione kropki to fakty, które zapisuje, a zaznaczony wiersz zawiera wszystkie 16 konfiguracji, które przechodzą.
Ta siatka nie jest uczciwym porównaniem z agentem. Korzysta z mojej wiedzy o ocenach pewności w danych testowych i ignoruje limit czterech decyzji agenta. Pokazuje tylko, że ta przestrzeń wyszukiwania jest wystarczająco mała, by przetestować ją w całości, więc nie potrzebowała proponującego opartego na LLM.
Siatka i agent to dwa z czterech sposobów podziału wyboru eksperymentów między ludzi i oprogramowanie:
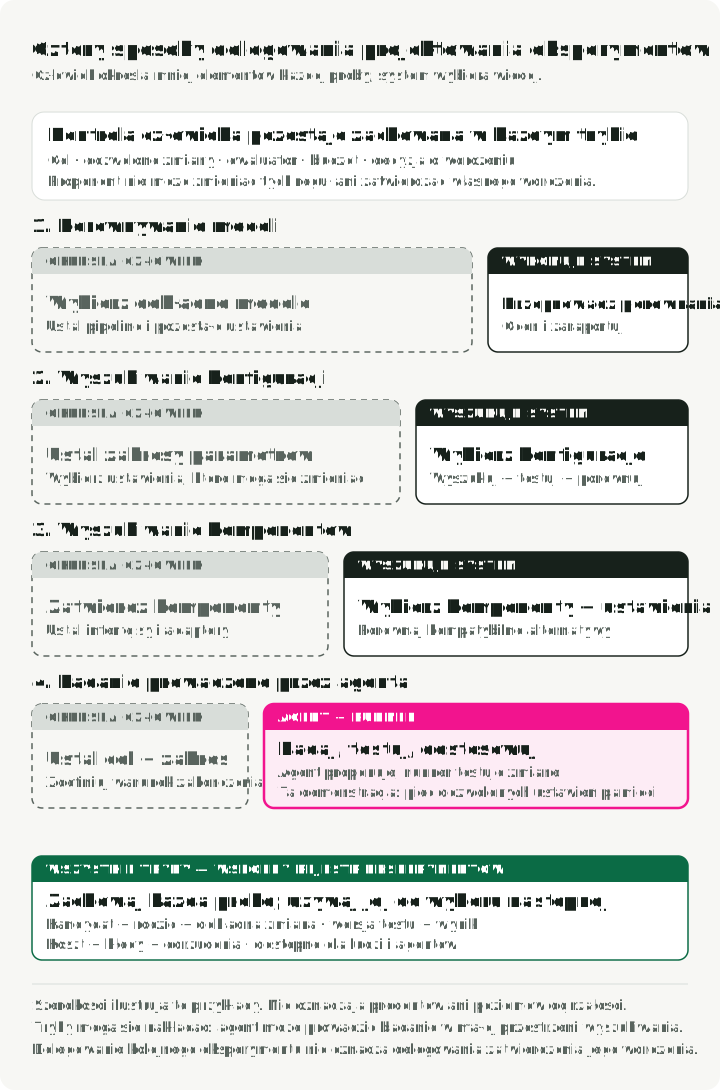
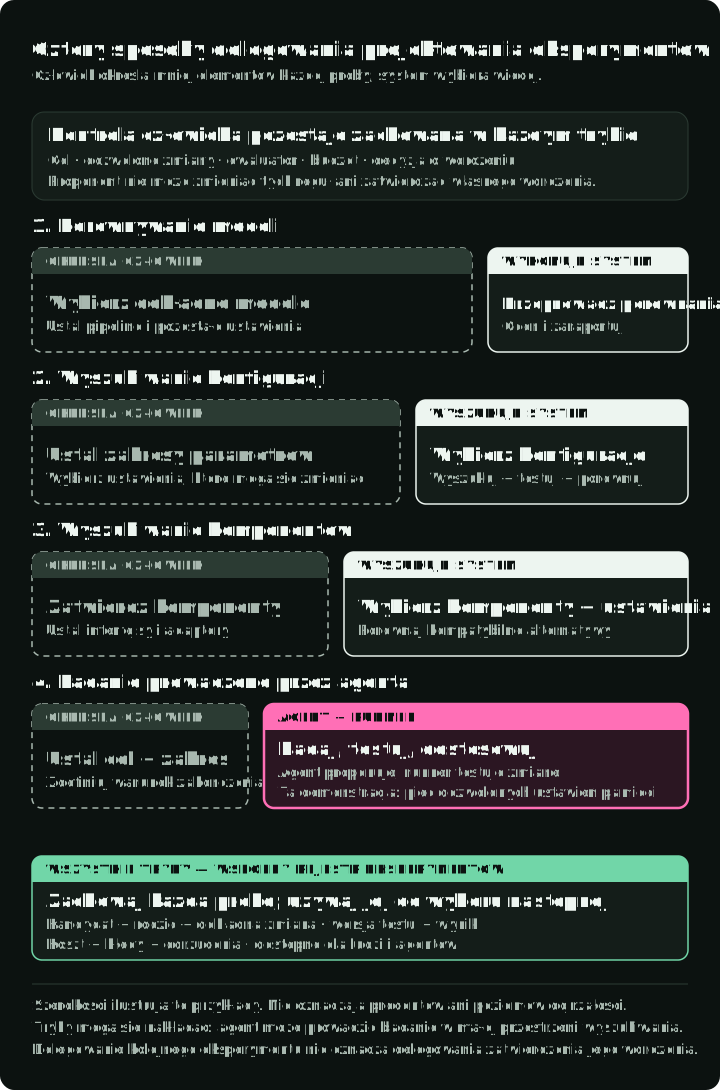
- Porównanie modeli. Wybierasz dokładne modele lub warianty; system je uruchamia i ocenia. Proponujący oparty na LLM nie jest potrzebny.
- Wyszukiwanie konfiguracji. Wybierasz, które ustawienia mogą się zmieniać, i ich granice; wartości wybiera siatka, wyszukiwanie losowe albo optymalizator, taki jak Optuna. Siatka powyżej to ten tryb.
- Wyszukiwanie komponentów. Zatwierdzasz wymienne komponenty ze stałymi interfejsami, a wyszukiwanie wybiera komponenty i ustawienia. Przeszukiwanie potoku w scikit-learn robi to zwykłym przeszukiwaniem siatki, więc sama wymiana komponentów nie sprawia, że proces jest agentowy.
- Badanie prowadzone przez agenta. Agent czyta błędy i wcześniejsze wyniki, proponuje następną zmianę i dostosowuje się po każdym teście, jak w kampaniach powyżej. Istnieją rozwiązania hybrydowe: w MIPROv2 z DSPy model proponuje instrukcje, a optymalizacja bayesowska przeszukuje ich kombinacje.
W każdym trybie ludzie zachowują cel, dozwolone zmiany, ewaluator, budżet i decyzję o przyjęciu. Wszystkie tryby mogą zapisywać do tej samej historii eksperymentu, którą diagram nazywa rejestrem: każdy kandydat i jego rodzic, dokładna zmiana i kto ją dostarczył, wersja testu, wynik, koszt i ewentualne odrzucenie. Dzięki temu zapisowi możesz przekazać kolejną propozycję agentowi albo przejąć ją z powrotem, nie tracąc dowodów. Moduł wykonawczy projektu towarzyszącego przyjmuje też kandydata dostarczonego przez człowieka przez lab evaluate.
Najpierw zdecyduj, który z tych trybów pasuje do twojego systemu. Jeśli dozwolone zmiany to kilka ustawień ze znanymi zakresami, a każdy test jest tani, wylicz je albo uruchom standardowy optymalizator, zanim dodasz LLM. Proponujący oparty na LLM może pomóc, gdy wybór zmiany wymaga czytania różnorodnych śladów błędów, kodu źródłowego i interakcji między komponentami oraz gdy kandydatów jest zbyt wielu lub są zbyt nieustrukturyzowani, by je wypisać. Czy tam pomaga, to pytanie do zmierzenia, a nie do założenia.
Zastosuj to w swoim systemie
Wybierz jeden ślad pokazujący prawdziwy błąd. Potem zapisz cztery rzeczy, zanim zacznie się jakiekolwiek wyszukiwanie:
- jakie zmiany są dozwolone;
- jakie wyniki zadań i zabronione skutki sprawdza ewaluator;
- ile może kosztować każda próba;
- kto może przyjąć kandydata.
Spróbuj najprostszego wyszukiwania, które obejmuje dozwolone zmiany. Potem sprawdź, czy wynik zmienia kolejny eksperyment albo decyzję o wydaniu. Jeśli nie zmienia żadnego z nich, pętla niczego nie usprawniła.
Opcjonalnie: sprawdź i uruchom projekt towarzyszący
Zapisane badanie możesz sprawdzić bez klucza API. Tag v0.2.3 zawiera narzędzie pamięci, zapisane badania i siatkę ustawień. Mając zainstalowane uv, sklonuj repozytorium, przywróć zapisane dowody, zweryfikuj je, uruchom ponownie siatkę i wystartuj lokalną przeglądarkę zapisanych kampanii:
git clone --branch v0.2.3 --depth 1 https://github.com/slavadubrov/meta-engineering-ai-lab.git
cd meta-engineering-ai-lab
uv sync --frozen
uv run --frozen python scripts/fetch_evidence.py
uv run --frozen python -m lab verify artifacts/agent-study-03 --source
uv run --frozen python scripts/settings_grid.py --check
uv run --frozen python -m lab serve --port 8075
Otwórz http://127.0.0.1:8075/web/, żeby prześledzić zapisaną kampanię od propozycji do informacji zwrotnej. Pobrane dane są sprawdzane względem przypiętej sumy kontrolnej, a nic w tym bloku nie wywołuje modelu. Uruchomienie z --check przelicza siatkę i kończy się błędem, jeśli zapisany raport nie zgadza się już z kodem.
Aby uruchomić nową, płatną kampanię propozycji, zapisz OPENAI_API_KEY w ignorowanym przez git pliku .env.local repozytorium i wybierz nowy katalog wyjściowy:
uv run --frozen --env-file .env.local python -m lab campaign \
  --live --campaigns 3 --iterations 4 --budget-usd 0.50 \
  --output artifacts/my-agent-study
Jawna flaga --live włącza wywołania dostawcy. Obejrzyj artifacts/my-agent-study/report.md, żeby zobaczyć powstałe propozycje i koszty. Model może pójść inną ścieżką, choć Python oceni każdą daną konfigurację tak samo. Opis narzędzia pamięci krok po kroku pokazuje przygotowane dane wejściowe JSON, zapisane rekordy i cztery ręcznie określone konfiguracje, jeśli chcesz zrozumieć deterministyczny cel bez uruchamiania agenta.
Dokąd zmierza seria
Narzędzie pamięci było celowo małe: pięć ustawień i 20 scenariuszy sprawiają, że każdy krok można sprawdzić. Ten sam rozmiar jest jego ograniczeniem. Skrypt może przetestować każdą konfigurację, więc ten przykład nie pokaże, kiedy proponujący oparty na LLM jest wart swojego kosztu.
Kolejne części serii używają większego celu: harnessu obsługi klienta z artykułu Projektowanie harnessu agenta: od zadania do architektury, części 1 serii Building and Evaluating Agent Harnesses. Agent programistyczny będzie proponował zmiany w tym harnessie, a jego wyniki zostaną porównane z prostszym wyszukiwaniem. Komponent usprawniający nie będzie edytował samego siebie, a każde przyjęcie sprawdzi człowiek.
Ten harness potrzebuje najpierw silniejszego ewaluatora. Siedem z jego dwunastu zadań obsługi nie oczekuje zmiany w bazie danych, więc agent, który nic nie robi, już zalicza 7 z 12 kontroli stanu. Agent programistyczny oceniany tylko tymi kontrolami mógłby zaliczyć ich więcej, sprawiając, że agent obsługi robi mniej.