Meta-engineering van AI-systemen: van traces naar beter geheugen

Automatische vertaling
Dit artikel is automatisch vertaald vanuit de oorspronkelijke Engelse versie.
Dit artikel is voor engineers die een agent willen laten uitzoeken waarom hun AI-systeem faalt en hem een oplossing willen laten voorstellen. Het voorbeeld is een kleine memory tool die een vraag beantwoordt over waar een gebruiker woont, en het antwoord is fout. Je ziet hoe een wijziging aan die tool wordt voorgesteld, getest op 20 voorbereide scenario’s en beoordeeld voordat iemand haar overneemt. Ook zie je hoe je controleert of een eenvoudig script dat elke instelling probeert dezelfde oplossing zonder LLM had gevonden. In het begeleidende experiment stelde een LLM de wijzigingen voor en testte gewone Python ze.
Ik gebruik meta-engineering voor het ontwerp van dat verbeterproces. Het komt neer op vier beslissingen. Wat mag de proposer, de persoon of het programma dat wijzigingen voorstelt, veranderen? Welke resultaten tellen als verbetering? Hoe stuurt een resultaat het volgende voorstel? Wie beslist om een wijziging over te nemen? Dezelfde vier beslissingen gelden of de proposer nu een LLM, een persoon of een parameterzoektocht is.
De fout met de verkeerde stad
De memory tool slaat feiten over een gebruiker, Ada, op en beantwoordt vragen daarover. Eén test, het scenario met de toekomstige verhuizing, stuurt vier events:
- Sla
city = Berlinop, geldig vanaf 1 januari. - Sla
city = Parisop, ontvangen op 3 januari maar geldig vanaf 10 januari. - Vraag naar de stad op 5 januari. Verwacht Berlin.
- Vraag naar de stad op 12 januari. Verwacht Paris.
De oorspronkelijke tool antwoordt beide keren Paris. Op 12 januari klopt dat. Op 5 januari is het fout: Ada is nog niet verhuisd.
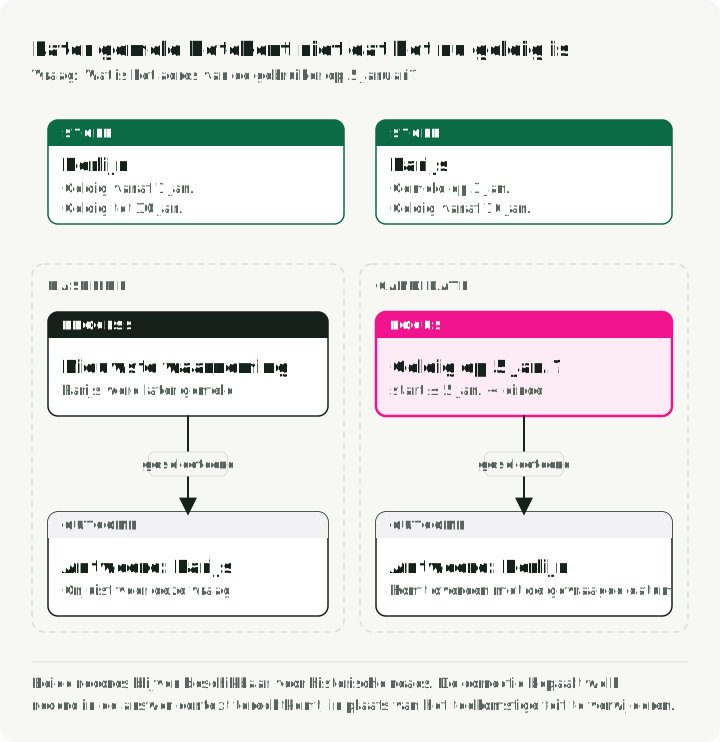
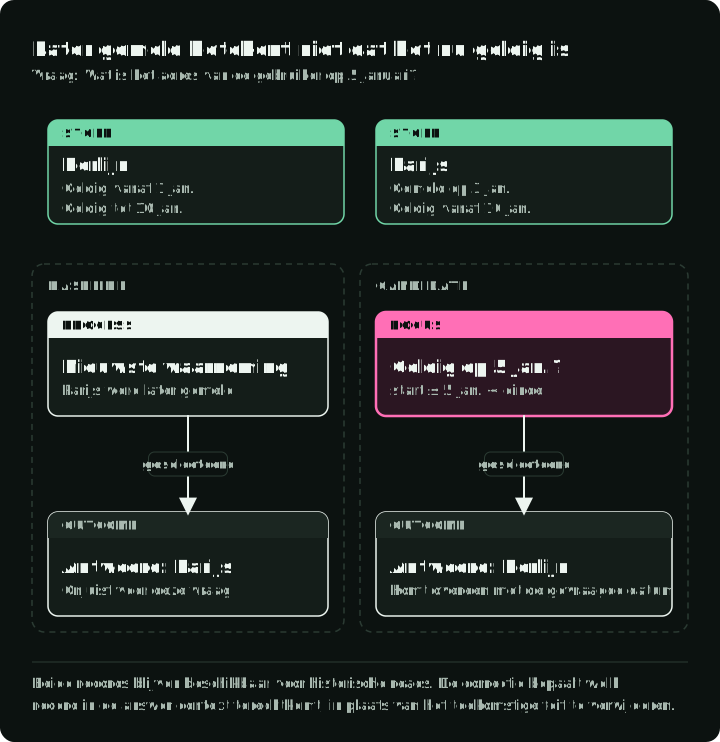
Elke testrun laat een trace achter: een opgeslagen overzicht van elk event dat naar de tool is gestuurd, de records die de tool opsloeg en de antwoorden die ze gaf. De opgeslagen trace van dit scenario laat zien dat beide records de juiste geldigheidsdatums hebben. Berlin is geldig van 1 januari tot 10 januari en Paris vanaf 10 januari zonder einddatum. De fout zit in de retrieval: die zet het later ontvangen feit over Paris boven Berlin, zonder te controleren welk feit geldig was op de gevraagde datum. Het opslaan van de toekomstige verhuizing was correct.
Het Paris-feit moet dus blijven, en de retrieval heeft een datumfilter nodig. Die diagnose is nog geen reden om een filter over te nemen. Dezelfde retrievalcode beantwoordt vragen over andere onderwerpen, verwerkt verwijderingen en moet de records van gebruikers gescheiden houden. Een wijziging die 5 januari oplost maar die gevallen breekt, maakt de memory tool slechter. Het verbeterproces moet dat opmerken voordat een nieuwe versie bij gebruikers komt.
Twee loops
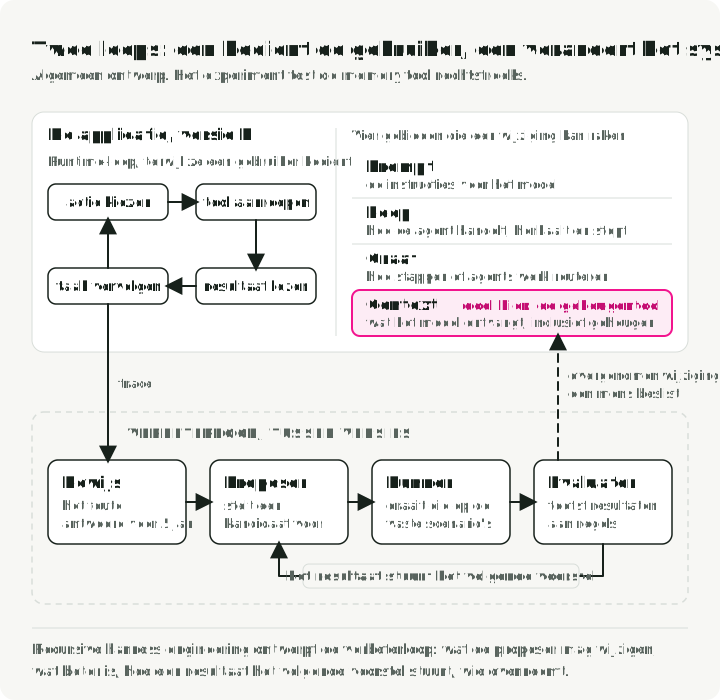
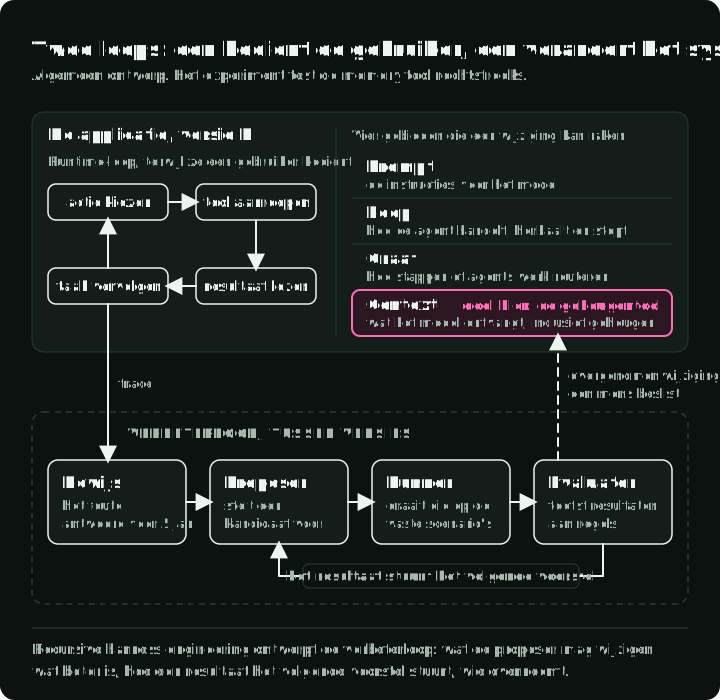
Een agent-applicatie draait een loop terwijl ze een gebruiker bedient. In deze runtime loop kiest ze een actie, roept ze een tool aan, leest ze het resultaat en gaat ze door met de taak van de gebruiker. Een agent die de memory tool gebruikt, zou daar het antwoord met de verkeerde stad kunnen krijgen. Dit experiment roept de tool rechtstreeks aan met vaste testevents.
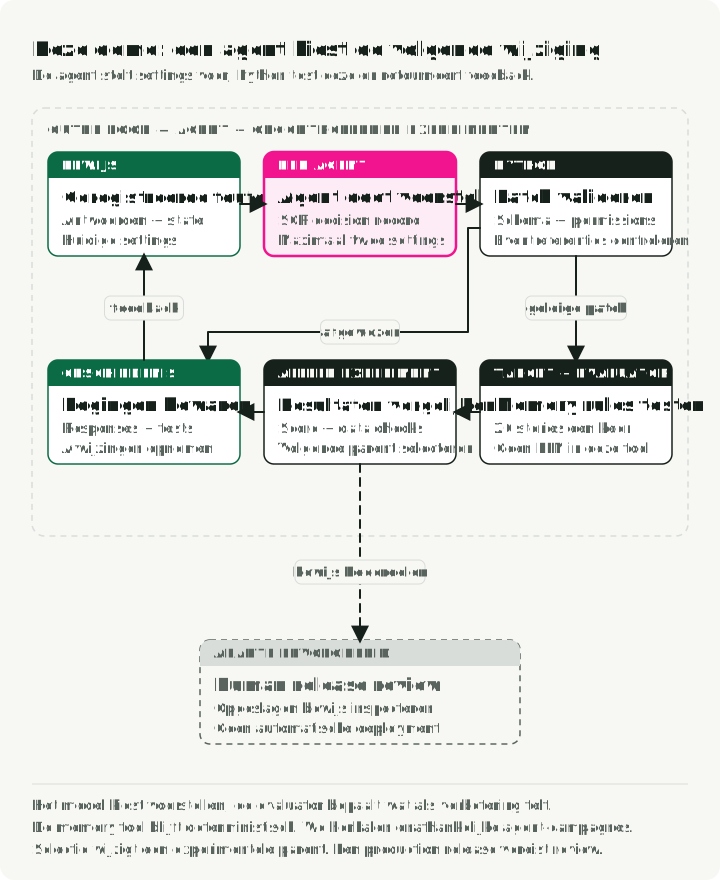
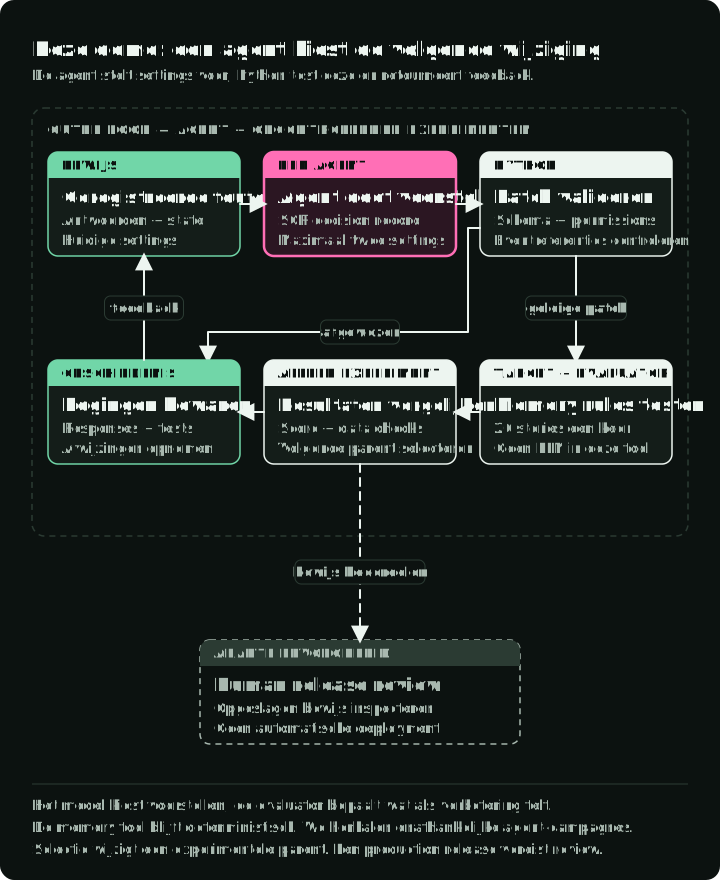
Om de fout op te lossen is een tweede loop nodig, die draait tussen versies van de applicatie. Deze verbeterloop begint bij bewijs van een fout, zoals het antwoord van 5 januari, een record dat is gewijzigd terwijl dat niet mocht, of te hoge kosten. De proposer stelt een kandidaat voor: één specifieke versie van een wijziging aan het target, het onderdeel van het systeem dat wordt verbeterd. Hier is het target de memory tool en is een kandidaat een nieuwe set instellingen. Een runner voert de kandidaat uit op een vaste set testscenario’s, en een evaluator controleert de resultaten tegen de regels die in die scenario’s zijn vastgelegd. De loop is pas rond wanneer een resultaat het volgende voorstel verandert of de beslissing om een wijziging over te nemen.
Het diagram toont het algemene applicatieontwerp, waarin het target elk onderdeel van de applicatie kan zijn. Engineers delen die onderdelen vaak in vier overlappende gebieden in. Prompt engineering verandert de instructies. Context engineering verandert welke informatie het model ontvangt, inclusief memory. Loop engineering verandert hoe de agent handelt, opnieuw probeert en stopt in zijn runtime loop. Graph engineering verandert hoe stappen of agents met elkaar verbonden zijn en hoe het werk wordt gerouteerd. Meta-engineering behandelt een keuze in elk van de vier, zoals de formulering van een prompt of het aantal nieuwe pogingen, als een instelling die een experiment kan wijzigen. Het beoordeelt elke kandidaat op de antwoordkwaliteit, de kosten en het vereiste gedrag van het hele systeem, bijvoorbeeld dat de gegevens van de ene gebruiker nooit aan een andere worden getoond.
Twee recente projecten gebruiken al een coding agent als proposer. In Karpathy’s autoresearch bewerkt de agent één trainingsbestand en draait het onder een vast tijdbudget. Elke poging wordt vastgelegd als behouden, verworpen of gecrasht, en de evaluatiecode staat in een apart bestand dat de agent niet bewerkt. Meta-Harness, een preprint van maart 2026, laat de proposer de broncode, scores en traces van eerdere kandidaten lezen. Daarmee verbetert hij de code die bepaalt wat een LLM-applicatie opslaat, ophaalt en aan haar model toont. Dit artikel gebruikt een veel kleiner target, de memory tool, zodat elke stap te controleren is.
Beperk wat de proposer mag veranderen
De LLM draait nooit binnen de memory tool. Hij leest mislukte traces en de evaluatieresultaten en stelt daarna een nieuwe configuratie voor: waarden voor de instellingen van de tool. Python test die configuratie.
De memory tool zelf is gewone, deterministische Python. Ze ontvangt gestructureerde feiten, slaat ze op of weigert ze, en geeft een waarde terug voor een query. Ze haalt geen feiten uit een gesprek en schrijft geen antwoord in natuurlijke taal, dus deze loop kan een fout in feitenextractie niet oplossen. Elk opgeslagen feit heeft een eigenaar, een bronevent en een geldigheidsinterval, volgens de regels voor opgeslagen state in Schema-Guided Agent Memory.
Elk binnenkomend feit heeft ook een confidence-score, geschreven door de auteur van de test. De tool slaat een feit alleen op als de score minstens min_confidence is. De scores zijn onderdeel van de testdata, geen kansen die uit een model zijn gemeten. Een onzeker feit delivery = courier met score 0.4 wordt bijvoorbeeld geweigerd bij de oorspronkelijke drempel van 0.7, maar opgeslagen bij 0.2.
Het Paris-record na de tweede schrijfactie laat zien hoe een record zijn geschiedenis bewaart. observed_at is de dag waarop de tool het feit leerde kennen en valid_from is de dag waarop het waar wordt (fragment):
{
    "id": "m002",
    "key": "city",
    "value": "Paris",
    "valid_from": "2026-01-10",
    "valid_to": null,
    "observed_at": "2026-01-03",
    "source_event_id": "future-move:event-2",
    "supersedes_memory_id": "m001"
}
source_event_id wijst naar het event dat Paris aanleverde en supersedes_memory_id koppelt het aan het Berlin-record m001. De writer heeft ook vaste regels voor conflicten. Als een latere schrijfactie Rome opgeeft, ook geldig vanaf 10 januari, weigert de writer die en blijft Paris ongewijzigd. Een herhaald Paris voor dezelfde datum hergebruikt het record, en een update met een eerdere ingangsdatum wordt geweigerd. De proposer kan deze regels niet veranderen.
De proposer kan vijf bestaande instellingen wijzigen:
| Instelling | Wat wijzigen ervan doet |
|---|---|
min_confidence | Wijzigt de minimale confidence-score die nodig is om een feit op te slaan. |
filter_entity | Beperkt retrieval tot het gevraagde onderwerp, zoals thuis in plaats van werk. |
time_aware | Beperkt retrieval tot feiten die geldig zijn op de gevraagde datum. |
deduplicate | Hergebruikt een identiek actief feit in plaats van nog een bevestiging op te slaan. |
top_k | Bepaalt hoeveel van de best gerangschikte records de tool voor het antwoord bekijkt. |
Eén voorstel wijzigt hooguit twee instellingen; min_confidence loopt van 0 tot 1 en top_k van 1 tot 8. De agent kan geen code, test of verwacht antwoord bewerken en kan zijn eigen wijziging niet goedkeuren. Zijn output is data die Python valideert, geen code om uit te voeren. Het configuratiecontract en de voorstelvalidator leggen die grens in code vast.
Omdat deze proposer alleen instellingen kan sturen, kan hij de evaluator niet wijzigen. De evaluator draait wel in hetzelfde Python-proces als de memory tool. Een agent die zijn eigen code mag schrijven en uitvoeren, zou dus de controles kunnen aanpassen. Voor zo’n agent moet de evaluator in een apart proces draaien, met eigen regels voor bestands- en netwerktoegang, voordat je zijn resultaten kunt vertrouwen.
De scoreregel
Voor het verhaal over de stad moet de test beide vragen stellen: Berlin op 5 januari en Paris op 12 januari. Alleen het eerste antwoord testen zou een tool belonen die het toekomstige feit gewoon weggooit. In het begeleidende experiment is een scenario één compleet verhaal van write-, query- en soms delete-events, zoals de vier events hierboven. Elke kandidaat draait dezelfde 20 voorbereide scenario’s, elk vanuit een leeg geheugen. De oorspronkelijke configuratie haalt er 13.
Een scenario slaagt alleen als elk verwacht antwoord klopt en geen enkele dataregel wordt geschonden. De evaluator controleert drie dataregels, de harde controles: één eigenaar ziet nooit de feiten van een andere eigenaar, een verwijderd feit is weg, en een invoer die als verboden is gemarkeerd, wordt niet opgeslagen. Ook telt hij de records die de tool opsloeg.
Om tussen kandidaten te kiezen, verwerpt de selectieregel eerst elke kandidaat die een harde controle niet haalt. Van de rest geeft ze de voorkeur aan de kandidaat die meer scenario’s haalt. Halen twee evenveel scenario’s, dan wint degene die minder records opslaat. Een wijziging die alleen de opslag verkleint, kan dus winnen als de antwoorden gelijk blijven, maar nooit van een wijziging die meer scenario’s correct beantwoordt.
Eén verbeterd getal is niet genoeg om een wijziging te accepteren. Neem het verlagen van min_confidence van 0.7 naar 0.2. Er worden meer nuttige feiten opgeslagen, zoals een voorkeur die met een lage score binnenkwam. Het onzekere feit delivery = courier wordt dan ook opgeslagen en vervangt een bevestigde waarde. In een met de hand voorbereide vergelijking loste deze wijziging één scenario op maar brak ze er vier, zodat het aantal geslaagde scenario’s daalde van 19/20 naar 16/20 terwijl alle harde controles nog slaagden. Er werden meer nuttige feiten opgeslagen, maar de eindantwoorden werden slechter. Deze kandidaat was in de onderstaande campagnes geen voorstel van de agent; hij laat zien waarom de score complete scenario’s telt.
De controles hebben grenzen. De test levert de eigenaar-ID’s rechtstreeks aan, dus eigenaarisolatie is hier geen authenticatietest. De controle op verboden schrijfacties weigert alleen invoer die de test al als verboden markeert; ze kan geen kwaadaardige instructie vinden die in gewone tekst is verstopt. En de proposer ziet alle 20 scenario’s, dus geen ervan werkt als verborgen testset. Een geslaagde score vertelt ons wat er op deze gevallen gebeurde, niet hoe een onbekende applicatie zich zal gedragen.
Geef elk voorstel een toetsbare reden
Het experiment liep als campagnes. Een campagne is één poging om de oorspronkelijke configuratie te verbeteren, die met een verse agentgeschiedenis begint. Elke iteratie is één modelaanroep waarin de agent een wijziging voorstelt of besluit te stoppen. In het eerste verzoek krijgt de agent de huidige instellingen en hun betekenis, de resultaten van de baseline, traces van de falende scenario’s en de wijzigingen die hij mag voorstellen, en in latere iteraties ook eerdere voorstellen en hun resultaten.
Elk antwoord moet dezelfde vijf velden invullen. Dit formaat volgt Schema-Guided Reasoning (SGR): het antwoord is een beslisrecord dat een reviewer veld voor veld kan controleren.
| Veld | Wat een reviewer kan controleren |
|---|---|
observations | Welk aangeleverd scenario en event onderbouwen de voorgestelde wijziging? |
hypothesis | Welke regel lijkt het probleem te veroorzaken? |
predicted_effect | Wat moet verbeteren wanneer de wijziging wordt getest? |
action | Stelt de agent een wijziging voor of stopt hij? |
patch | Welke toegestane instellingen moeten veranderen? |
Het verzoek dwingt die vorm af met een strikt JSON Schema via OpenAI Structured Outputs. Het schema beperkt de vorm van het antwoord; het bewijst de hypothese niet. Python controleert daarna of de genoemde events bestaan in het aangeleverde bewijs, of de patch binnen de toegestane instellingen blijft en of die configuratie al is getest. Een antwoord kan het schema volgen en toch deze controles niet halen.
In de eerste vastgelegde iteratie noemde de agent de fout met de toekomstige verhuizing en een tweede fout, waarbij een feit over Ada’s werkadres een vraag over haar thuis beantwoordde. Hij stelde voor om zowel het onderwerpfilter als het datumfilter in te schakelen:
{ "filter_entity": true, "time_aware": true }In de implementatie verwijderen deze instellingen ongeschikte records vóór het rangschikken. Het onderwerpfilter laat feiten over andere onderwerpen vallen, zodat een work-feit geen home-vraag kan beantwoorden. Het datumfilter houdt alleen feiten over die geldig zijn op de datum van de vraag. Een feit is geldig vanaf zijn startdatum tot aan, maar niet inclusief, zijn einddatum:
def valid_at(item: dict, at: str) -> bool:
    return item["valid_from"] <= at and (
        item["valid_to"] is None or at < item["valid_to"]
    )
Paris begint op 10 januari, dus voor de vraag van 5 januari blijft alleen Berlin over. Op 12 januari is Paris geldig en Berlin niet.
Python draaide die configuratie op alle 20 scenario’s. Het aantal geslaagde scenario’s steeg van 13/20 naar 19/20 en de harde controles slaagden. De campagne wijzigde beide filters in één stap, dus ze mat alleen hun gecombineerde effect; de herhalingen met één instelling hieronder scheiden ze. De runner hield deze configuratie aan als beginpunt voor het volgende voorstel en gaf de resultaten terug aan de agent.
Na de filters faalde nog één scenario en sloegen sommige verhalen dezelfde bevestiging twee keer op. De eerste campagne nam in totaal vier beslissingen:
| Beslissing | Bewijs en voorgestelde wijziging | Gemeten resultaat op dezelfde 20 scenario’s |
|---|---|---|
| 1 | Onderwerp- en datumfilter inschakelen na antwoorden met het verkeerde onderwerp en de verkeerde datum | 13/20 → 19/20; behouden als volgend beginpunt |
| 2 | Herhaalde bevestigingen language = German ontdubbelen | 19/20; gemiddeld aantal opgeslagen records 1,70 → 1,60 |
| 3 | min_confidence verlagen van 0.7 naar 0.6 voor een nuttige voorkeur met score 0.6 | 20/20; gemiddeld aantal opgeslagen records 1,65 |
| 4 | Stoppen omdat er geen onderbouwd voorstel meer was | Geen nieuwe configuratie getest |
Bij 0.6 wordt de nuttige voorkeur opgeslagen, terwijl het onzekere koeriersfeit met score 0.4 onder de drempel blijft. Dat verklaart de derde wijziging op deze voorbereide invoer; de scores zelf zijn door de auteur van de test bepaald. De stopbeslissing betekent dat de agent met de feedback die hij zag geen verdere wijziging kon onderbouwen. Ze bewijst niet dat deze configuratie de best mogelijke is.
Validatie heeft ook al eens een antwoord geweigerd. In een aparte ontwikkelrun noemde een agent een kandidaat-ID alsof het een scenario-event was. Het antwoord voldeed aan het JSON-schema, maar de verwijzing bestond niet in het aangeleverde eventbewijs. Python weigerde het voorstel vóór het testen en gaf de validatiefout terug. Geen van de drie vastgelegde campagnes hieronder had zo’n weigering.
Als een geëvalueerde patch de score verslechtert, houdt de runner het vorige beginpunt aan en legt hij de mislukte poging vast. Een gescripte test doorloopt dat pad, de drie live campagnes niet. Het bewaren van het geweigerde resultaat in de geschiedenis geeft de proposer een reden om een andere wijziging te kiezen in plaats van dezelfde gok te herhalen.
Herhaling, kosten en overname
De memory tool is deterministisch: dezelfde configuratie op hetzelfde scenario opnieuw draaien geeft hetzelfde antwoord. De onzekerheid zit in wat de agent kiest. De studie draaide daarom de hele zoektocht drie keer, elk vanaf de baseline van 13/20 met een verse agentgeschiedenis en hooguit vier modelbeslissingen. Alle drie de campagnes kozen dezelfde drie patches, haalden 20/20 op dezelfde scenario’s en stopten daarna. Dat zijn 12 modelaanroepen, negen geëvalueerde voorstellen en drie stopbeslissingen.
Voor de studie van 11 september 2026 was de proposer gpt-5.6-luna met een laag reasoning-niveau. Berekend met de gepubliceerde modeltarieven komt het vastgelegde tokenverbruik voor de 12 aanroepen op ongeveer USD 0.04, tegen een ingesteld budget van USD 0.50. Dat is een schatting op basis van het vastgelegde verbruik, geen factuur, en ze laat ontwikkeltijd buiten beschouwing.
Deze herhaalde resultaten laten zien dat dit model bij deze prompt, dit target en deze set scenario’s één nuttig pad volgde. Ze laten niet zien dat een nieuwe memory-workload zal slagen. Het vastgezette campagnerapport en het archief met bewijs en checksum van het begeleidende experiment bevatten de vastgelegde verzoeken, antwoorden, validaties en resultaten.
Een configuratie die de runner bewaart, is alleen het beginpunt voor het volgende experiment. Het is geen release. In de rapporten van het begeleidende experiment wacht de overname nog op review door een mens en hebben de campagnes niets uitgerold. Een reviewer zou de wijziging nog moeten toetsen aan zijn eigen workload, toegangsregels, kostendoel en terugdraaiplan.
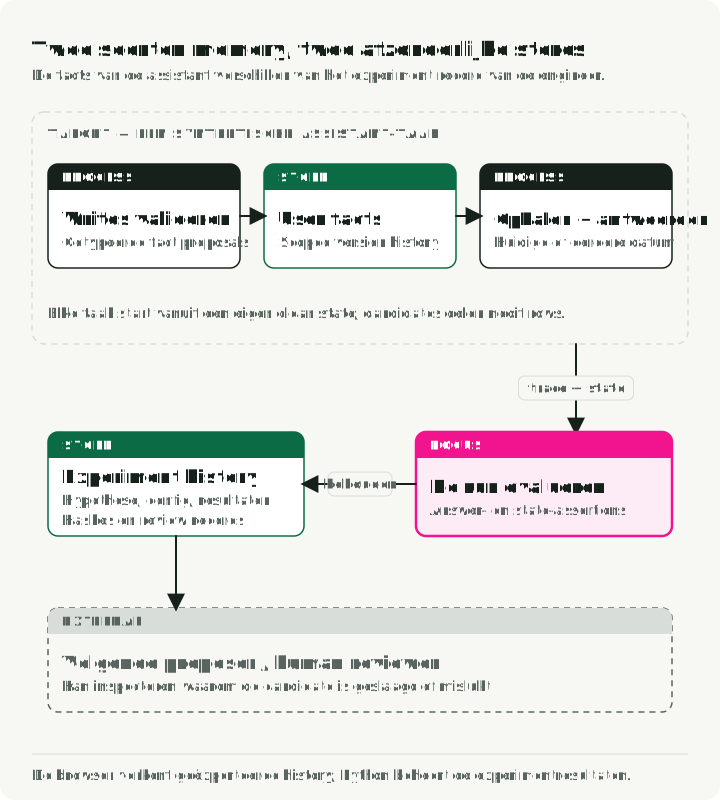
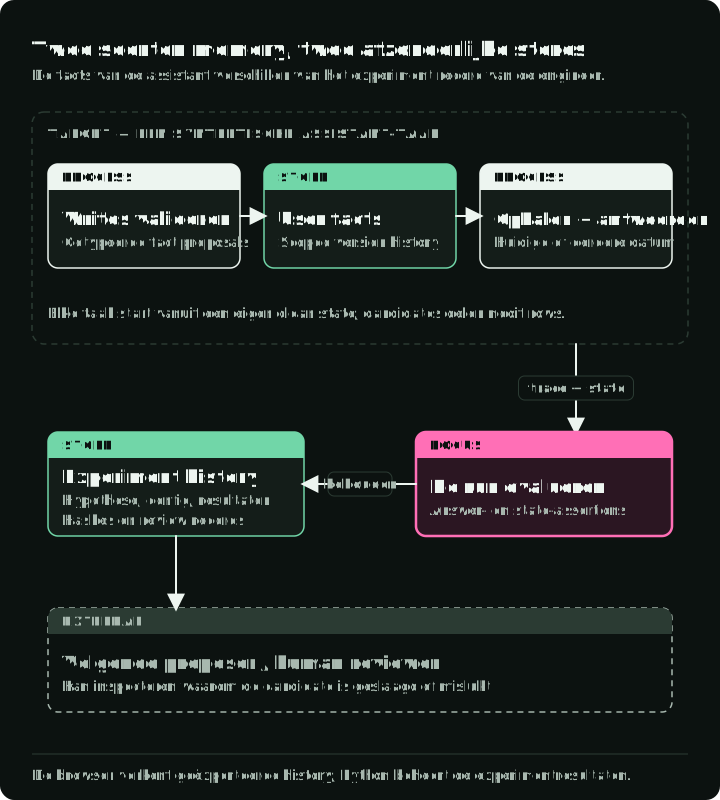
Het experiment levert ook eigen records op, en die vragen een andere behandeling dan Ada’s feiten. De memory tool slaat haar stad op. De experimentgeschiedenis slaat elk verzoek, voorstel, validatieresultaat, testversie en resultaat op, met de hashes die nodig zijn om een keuze later te verklaren. In deze synthetische studie mogen die records openbaar zijn. In een echte applicatie zou het verwijderen van het feit van een gebruiker uit de live memory store geen kopieën in experimentlogs of back-ups wissen. Een beleid voor bewaren en verwijderen moet die records apart afdekken.
Had deze zoektocht een LLM nodig?
De campagnes laten zien dat de loop werkt: een LLM las traces, stelde instellingen voor en paste zijn volgende voorstel aan na feedback. Ze laten niet zien dat een LLM de juiste proposer was voor dit probleem. Om dat te controleren draaide ik de ongewijzigde memory tool opnieuw op dezelfde 20 scenario’s, met telkens één gewijzigde instelling. Daarvoor gebruikte ik het settings-grid-script van het begeleidende experiment. Deze runs doen geen modelaanroepen, en elke configuratie heeft maar één run nodig omdat de tool deterministisch is.
| Configuratie | Geslaagde scenario’s |
|---|---|
| Baseline | 13/20 |
| Alleen onderwerpfilter | 16/20 |
| Alleen datumfilter | 16/20 |
| Alleen deduplicatie | 13/20 |
Alleen min_confidence = 0.6 | 14/20 |
| Beide filters | 19/20 |
Beide filters, deduplicatie, min_confidence = 0.6 | 20/20 |
Elk filter lost op zichzelf drie scenario’s op en samen lossen ze er zes op. Deduplicatie verandert geen enkel antwoord; ze verkleint alleen het aantal opgeslagen records.
Daarna testte ik elke combinatie. De feiten in de scenario’s hebben zes confidence-scores: 0,25, 0,3, 0,4, 0,6, 0,95 en 1. Een drempel slaat elk feit op met een score op of boven die drempel, dus 0,45 en 0,55 slaan precies dezelfde feiten op. Eén drempelwaarde per tussenruimte tussen naburige scores is genoeg, en zes waarden dekken elk verschillend schrijfgedrag op deze scenario’s.
Met die zes drempels, drie aan/uit-instellingen en acht top_k-waarden zijn er 384 configuraties. Het script draait elk ervan op de 20 scenario’s en is in minder dan een seconde klaar.
Zestien configuraties halen 20/20. Ze schakelen allemaal beide filters in en gebruiken een drempel boven 0,4 en hooguit 0,6; top_k verandert het resultaat nooit. Gerangschikt met de selectieregel hierboven is de beste configuratie degene die de agent vond: beide filters, deduplicatie en min_confidence = 0.6, met 1,65 opgeslagen records per scenario. Het opgeslagen rapport vermeldt elk resultaat met de hash van de bron.
In de figuur is elke rij één drempelbereik, de gevulde stippen zijn de feiten die het opslaat en de gemarkeerde rij bevat alle 16 geslaagde configuraties.
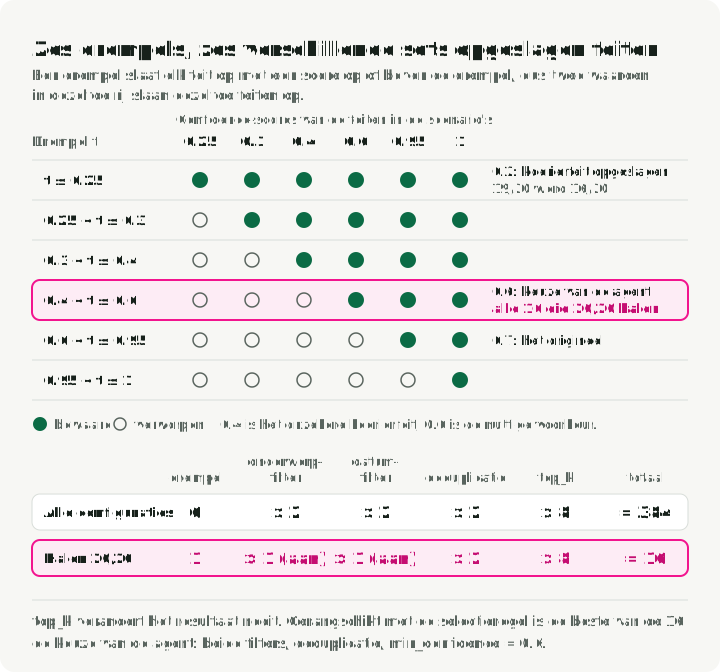
Deze gridzoektocht is geen eerlijke vergelijking met de agent. Ze gebruikt mijn kennis van de confidence-scores in de testdata en negeert de limiet van vier beslissingen voor de agent. Ze laat alleen zien dat deze zoekruimte klein genoeg is om volledig te testen, dus een LLM als proposer was niet nodig.
De grid en de agent zijn twee van vier manieren om de keuze van experimenten te verdelen tussen mensen en software:
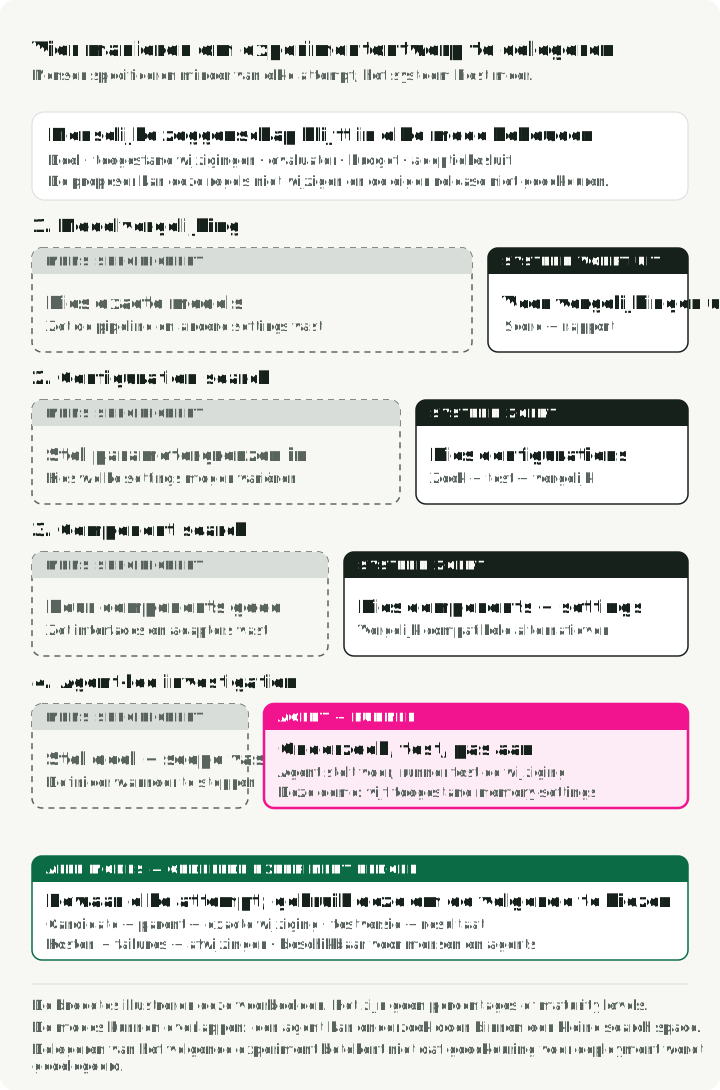
- Modelvergelijking. Jij kiest de exacte models of varianten; het systeem draait en scoort ze. Een LLM als proposer is niet nodig.
- Configuratiezoektocht. Jij kiest welke instellingen mogen variëren en hun grenzen; een grid, willekeurige zoektocht of een optimizer zoals Optuna kiest de waarden. De grid hierboven is deze werkwijze.
- Componentzoektocht. Jij keurt uitwisselbare componenten met vaste interfaces goed en de zoektocht kiest componenten en instellingen. De pipelinezoektocht van scikit-learn doet dit met gewone gridzoektocht, dus componenten verwisselen maakt het proces op zich niet agentic.
- Agentgestuurd onderzoek. Een agent leest fouten en eerdere resultaten, stelt de volgende wijziging voor en past zich na elke test aan, zoals de campagnes hierboven deden. Hybride vormen bestaan: bij DSPy’s MIPROv2 stelt een model instructies voor en doorzoekt Bayesiaanse optimalisatie hun combinaties.
In elke werkwijze houden mensen het doel, de toegestane wijzigingen, de evaluator, het budget en de overnamebeslissing. Alle werkwijzen kunnen naar dezelfde experimentgeschiedenis schrijven, die het diagram het logboek noemt: elke kandidaat en zijn parent, de exacte wijziging en wie haar aanleverde, de testversie, het resultaat, de kosten en elke weigering. Met dat record kun je het volgende voorstel aan een agent overdragen of terugnemen zonder bewijs te verliezen. De runner van het begeleidende experiment accepteert via lab evaluate ook een kandidaat die een persoon aanlevert.
Bepaal eerst welke van deze werkwijzen bij jouw systeem past. Als de toegestane wijzigingen een paar instellingen met bekende bereiken zijn en elke test goedkoop is, som ze dan op of draai een standaard optimizer voordat je een LLM toevoegt. Een LLM als proposer kan helpen wanneer het kiezen van een wijziging vraagt om het lezen van uiteenlopende foutentraces, broncode en wisselwerking tussen componenten, en wanneer er te veel of te ongestructureerde kandidaten zijn om op te sommen. Of hij daar helpt, moet je meten en niet aannemen.
Pas het toe op jouw systeem
Kies één trace die een echte fout laat zien. Schrijf dan vier dingen op voordat een zoektocht begint:
- welke wijzigingen zijn toegestaan;
- welke taakuitkomsten en verboden effecten de evaluator controleert;
- wat elke poging mag kosten;
- wie een kandidaat mag overnemen.
Probeer de eenvoudigste zoektocht die de toegestane wijzigingen dekt. Controleer daarna of het resultaat het volgende experiment of een releasebeslissing verandert. Verandert het geen van beide, dan heeft de loop niets verbeterd.
Optioneel: het begeleidende experiment bekijken en draaien
Je kunt de vastgelegde studie bekijken zonder API-sleutel. Tag v0.2.3 bevat de memory tool, de vastgelegde studies en de settings grid. Als uv is geïnstalleerd, clone je de repository, herstel je het vastgelegde bewijs, verifieer je het, draai je de grid opnieuw en start je een lokale viewer voor de vastgelegde campagnes:
git clone --branch v0.2.3 --depth 1 https://github.com/slavadubrov/meta-engineering-ai-lab.git
cd meta-engineering-ai-lab
uv sync --frozen
uv run --frozen python scripts/fetch_evidence.py
uv run --frozen python -m lab verify artifacts/agent-study-03 --source
uv run --frozen python scripts/settings_grid.py --check
uv run --frozen python -m lab serve --port 8075
Open http://127.0.0.1:8075/web/ om een vastgelegde campagne van voorstel tot feedback te volgen. De download wordt gecontroleerd tegen een vastgezette checksum en niets in dit blok doet een modelaanroep. De --check-run berekent de grid opnieuw en faalt als het opgeslagen rapport niet meer bij de code past.
Om een nieuwe, betaalde voorstelcampagne te draaien, sla je OPENAI_API_KEY op in het genegeerde bestand .env.local van de repository en kies je een nieuwe uitvoermap:
uv run --frozen --env-file .env.local python -m lab campaign \
  --live --campaigns 3 --iterations 4 --budget-usd 0.50 \
  --output artifacts/my-agent-study
De expliciete vlag --live schakelt aanroepen naar de provider in. Bekijk artifacts/my-agent-study/report.md voor de resulterende voorstellen en kosten. Het model kan een ander pad nemen, ook al scoort Python elke gegeven configuratie op dezelfde manier. De walkthrough van de memory tool toont de voorbereide JSON-invoer, opgeslagen records en vier met de hand bepaalde configuraties, als je het deterministische target wilt begrijpen zonder de agent te draaien.
Waar de serie heen gaat
De memory tool was met opzet klein: vijf instellingen en 20 scenario’s maken elke stap controleerbaar. Dezelfde omvang is ook haar grens. Een script kan elke configuratie testen, dus dit voorbeeld kan niet laten zien wanneer een LLM als proposer zijn kosten waard is.
Latere delen van deze serie gebruiken een groter target: de customer-support harness uit Een agent harness ontwerpen: van taak naar architectuur, deel 1 van Building and Evaluating Agent Harnesses. Een coding agent zal wijzigingen aan die harness voorstellen en zijn resultaten worden vergeleken met eenvoudiger zoeken. De verbeteraar bewerkt zichzelf niet en een persoon beoordeelt elke overname.
Die harness heeft eerst een sterkere evaluator nodig. Zeven van de twaalf supporttaken verwachten geen databasewijziging, dus een agent die niets doet, haalt al 7 van de 12 statecontroles. Een coding agent die alleen op die controles wordt gescoord, kan er meer halen door de supportagent minder te laten doen.