Méta-ingénierie des systèmes AI : des traces à une meilleure mémoire

Traduction automatique
Cet article a été traduit automatiquement depuis la version originale en anglais.
Cet article s’adresse aux ingénieurs qui veulent qu’un agent découvre pourquoi leur système AI échoue et propose un correctif. L’exemple est un petit outil de mémoire qui répond à une question sur le lieu de résidence d’un utilisateur, et la réponse est fausse. Vous verrez comment une modification de cet outil est proposée, testée sur 20 scénarios préparés, puis jugée avant que quiconque l’adopte. Vous verrez aussi comment vérifier si un simple script qui essaie tous les réglages aurait trouvé le même correctif sans LLM. Dans l’expérience associée, un LLM a proposé les modifications et du Python ordinaire les a testées.
J’emploie méta-ingénierie pour désigner la conception de ce processus d’amélioration. Elle se résume à quatre décisions. Que peut modifier le proposeur, la personne ou le programme qui suggère des changements ? Quels résultats comptent comme une amélioration ? Comment un résultat oriente-t-il la suggestion suivante ? Qui décide d’adopter un changement ? Ces quatre décisions s’appliquent de la même façon, que le proposeur soit un LLM, une personne ou une recherche de paramètres.
L’échec de la mauvaise ville
L’outil de mémoire stocke des faits sur une utilisatrice, Ada, et répond aux questions à son sujet. Un test, le scénario du déménagement futur, lui envoie quatre événements :
- Enregistrer
city = Berlin, effectif le 1er janvier. - Enregistrer
city = Paris, reçu le 3 janvier mais effectif le 10 janvier. - Demander la ville au 5 janvier. Attendu : Berlin.
- Demander la ville au 12 janvier. Attendu : Paris.
L’outil d’origine répond Paris les deux fois. Le 12 janvier, c’est correct. Le 5 janvier, c’est faux : Ada n’a pas encore déménagé.
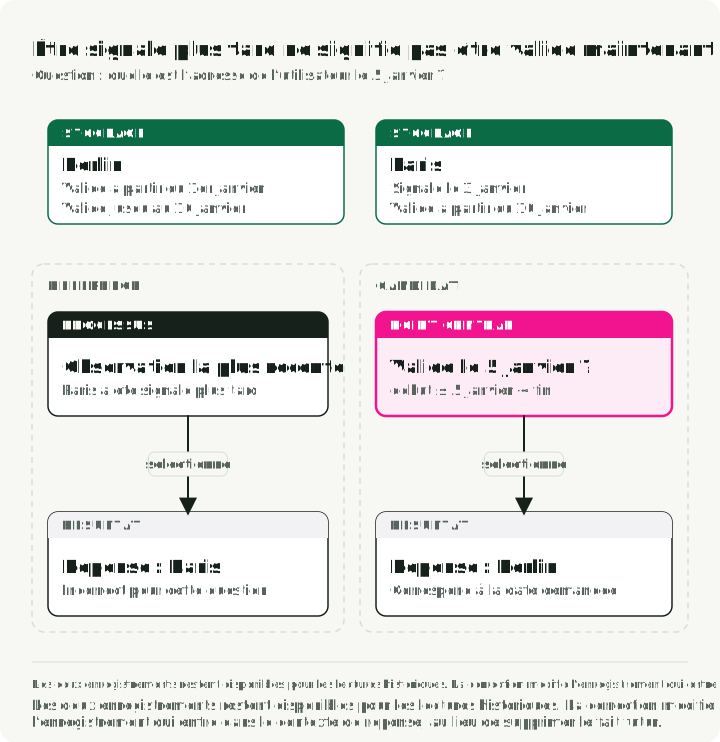
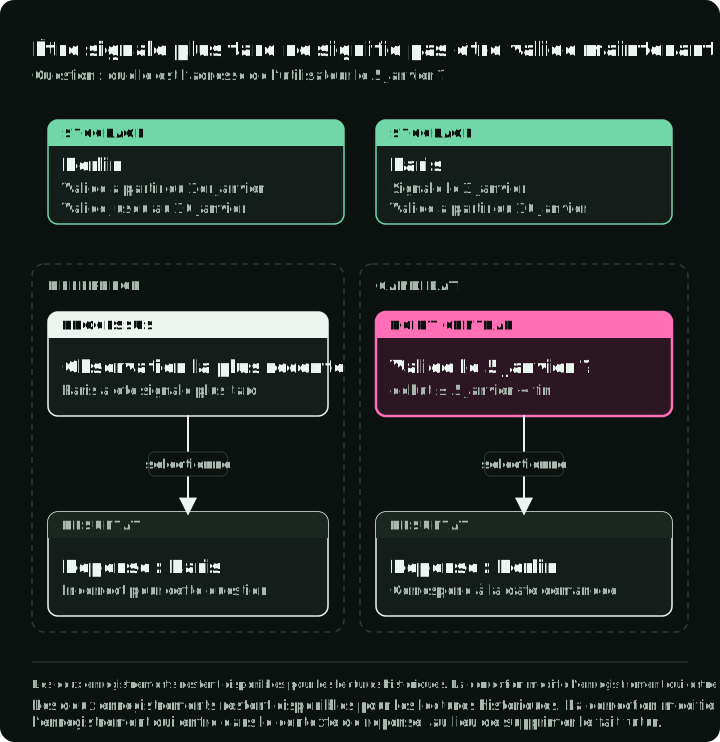
Chaque exécution de test laisse une trace : un enregistrement de chaque événement envoyé à l’outil, des enregistrements qu’il a stockés et des réponses qu’il a données. La trace sauvegardée de ce scénario montre que les deux enregistrements ont les bonnes dates de validité. Berlin est valide du 1er au 10 janvier, et Paris à partir du 10 janvier sans date de fin. Le défaut se trouve dans la recherche : elle classe le fait Paris, reçu plus récemment, avant Berlin sans vérifier lequel était valide à la date demandée. Le stockage du déménagement futur était correct.
Le fait Paris doit donc rester, et la recherche a besoin d’un filtre de date. Ce diagnostic ne suffit pas encore à justifier l’adoption d’un filtre. Le même code de recherche répond à des questions sur d’autres sujets, gère les suppressions et doit garder les enregistrements des utilisateurs séparés. Un changement qui corrige le 5 janvier en cassant ces cas dégrade l’outil de mémoire. Le processus d’amélioration doit le détecter avant qu’une nouvelle version n’atteigne les utilisateurs.
Deux boucles
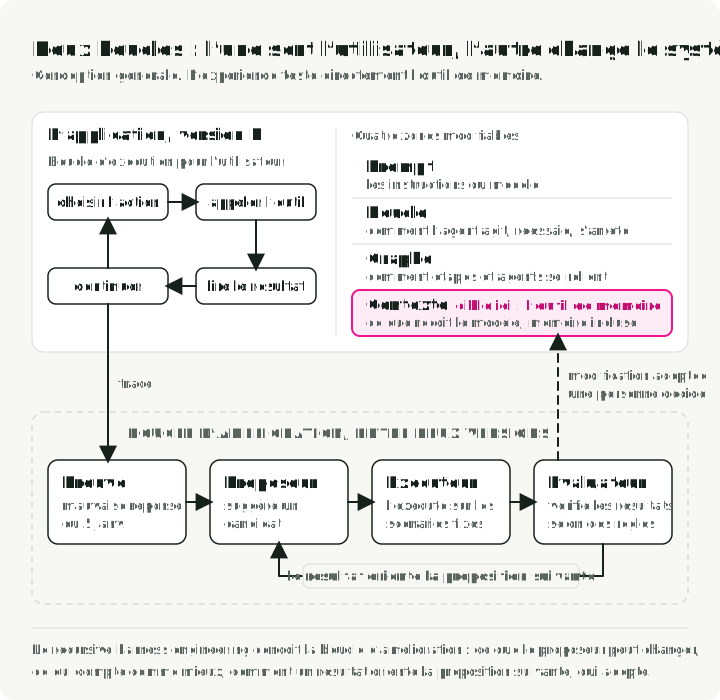
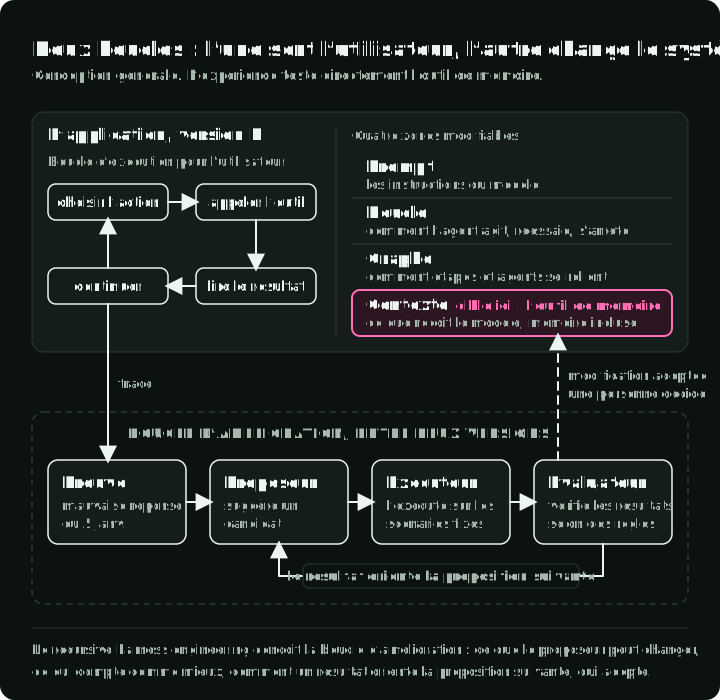
Une application d’agent exécute une boucle pendant qu’elle sert un utilisateur. Dans cette boucle d’exécution, elle choisit une action, appelle un outil, lit le résultat et poursuit la tâche de l’utilisateur. Un agent utilisant l’outil de mémoire pourrait y recevoir la mauvaise réponse sur la ville. Cette expérience appelle directement l’outil avec des événements de test fixes.
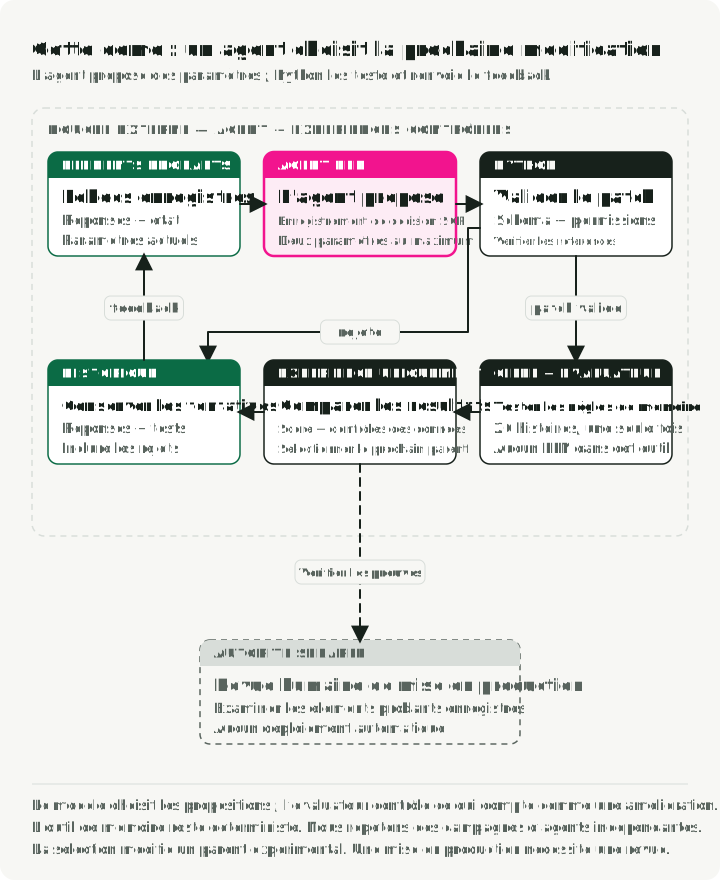
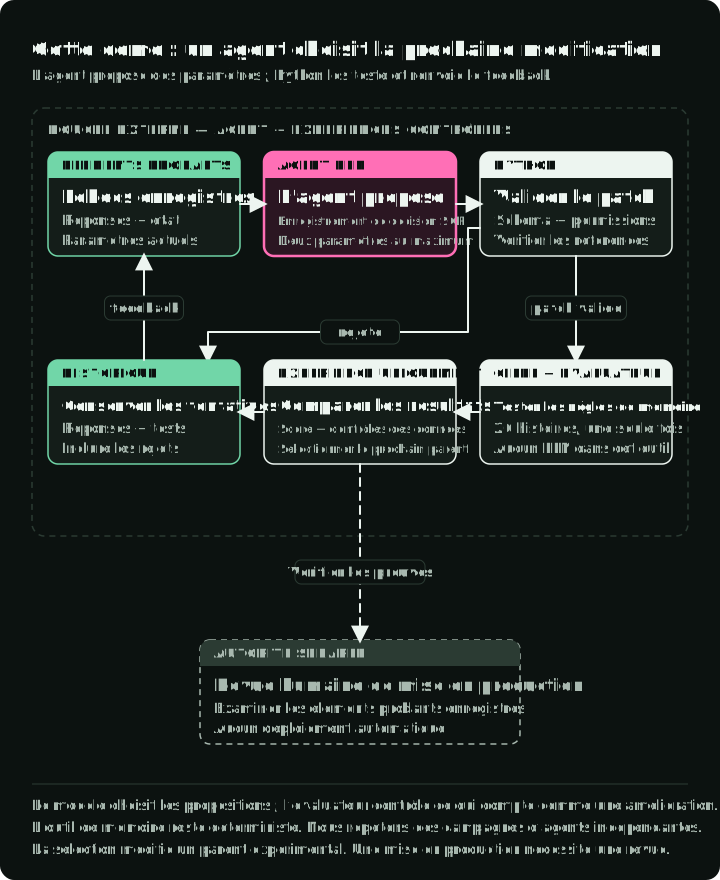
Corriger l’échec demande une seconde boucle, qui tourne entre les versions de l’application. Cette boucle d’amélioration part d’une preuve d’échec, comme la réponse du 5 janvier, un enregistrement modifié alors qu’il ne devait pas l’être, ou un coût trop élevé. Le proposeur suggère un candidat : une version précise d’un changement apporté à la cible, la partie du système que l’on améliore. Ici, la cible est l’outil de mémoire, et un candidat est un nouvel ensemble de ses réglages. Un exécuteur lance le candidat sur un ensemble fixe de scénarios de test, et un évaluateur vérifie les résultats par rapport aux règles que ces scénarios encodent. La boucle n’est complète que lorsqu’un résultat modifie la proposition suivante ou la décision d’adopter un changement.
Le diagramme montre la conception générale de l’application, où la cible peut être n’importe quelle partie de celle-ci. Les ingénieurs regroupent souvent ces parties en quatre domaines qui se recoupent. Le prompt engineering modifie les instructions. Le context engineering modifie les informations que reçoit le modèle, mémoire comprise. Le loop engineering modifie la façon dont l’agent agit, réessaie et s’arrête dans sa boucle d’exécution. Le graph engineering modifie la façon dont les étapes ou les agents se connectent et se répartissent le travail. La méta-ingénierie traite un choix dans l’un de ces quatre domaines, comme la formulation d’un prompt ou le nombre de nouvelles tentatives, comme un réglage qu’une expérience peut modifier. Elle juge chaque candidat selon la qualité des réponses du système entier, son coût et les comportements exigés, comme ne jamais montrer les données d’un utilisateur à un autre.
Deux projets récents utilisent déjà un agent de code comme proposeur. Dans autoresearch de Karpathy, l’agent modifie un seul fichier d’entraînement et l’exécute avec un budget de temps fixe. Chaque tentative est consignée comme conservée, abandonnée ou plantée, et le code d’évaluation reste dans un fichier séparé que l’agent ne modifie pas. Meta-Harness, un preprint de mars 2026, laisse le proposeur lire le code source, les scores et les traces des candidats précédents. Il s’en sert pour améliorer le code qui décide ce qu’une application LLM stocke, retrouve et montre à son modèle. Cet article prend une cible bien plus petite, l’outil de mémoire, afin que chaque étape puisse être inspectée.
Limiter ce que le proposeur peut changer
Le LLM ne s’exécute jamais dans l’outil de mémoire. Il lit les traces des échecs et les résultats d’évaluation, puis propose une nouvelle configuration : des valeurs pour les réglages de l’outil. Du Python teste cette configuration.
L’outil de mémoire lui-même est du Python ordinaire et déterministe. Il reçoit des faits structurés, les stocke ou les rejette, et renvoie une valeur pour une requête. Il n’extrait pas de faits d’une conversation et n’écrit pas de réponse en langage naturel : cette boucle ne peut donc pas corriger un échec d’extraction de faits. Chaque fait stocké a un propriétaire, un événement source et un intervalle de validité, selon les règles d’état stocké de Schema-Guided Agent Memory.
Chaque fait entrant porte aussi un score de confiance, écrit par l’auteur du test. L’outil ne stocke un fait que si son score atteint au moins min_confidence. Les scores font partie des données de test ; ce ne sont pas des probabilités mesurées sur un modèle. Par exemple, un fait incertain delivery = courier noté 0.4 est rejeté au seuil d’origine de 0.7, mais stocké à 0.2.
L’enregistrement Paris après la deuxième écriture montre comment un enregistrement conserve son historique. observed_at est le jour où l’outil a appris le fait, et valid_from le jour où il devient vrai (extrait) :
{
    "id": "m002",
    "key": "city",
    "value": "Paris",
    "valid_from": "2026-01-10",
    "valid_to": null,
    "observed_at": "2026-01-03",
    "source_event_id": "future-move:event-2",
    "supersedes_memory_id": "m001"
}
source_event_id désigne l’événement qui a fourni Paris, et supersedes_memory_id le relie à l’enregistrement Berlin m001. Le composant d’écriture applique aussi des règles fixes en cas de conflit. Si une écriture ultérieure indique Rome, également effective le 10 janvier, l’outil la rejette et laisse Paris inchangé. Un Paris répété pour la même date réutilise l’enregistrement, et une mise à jour avec une date d’effet antérieure est rejetée. Le proposeur ne peut pas modifier ces règles.
Le proposeur peut modifier cinq réglages existants :
| Réglage | Effet de la modification |
|---|---|
min_confidence | Modifie le score de confiance minimal requis pour stocker un fait. |
filter_entity | Limite la recherche au sujet demandé, par exemple le domicile plutôt que le travail. |
time_aware | Limite la recherche aux faits valides à la date demandée. |
deduplicate | Réutilise un fait actif identique au lieu de stocker une confirmation de plus. |
top_k | Fixe combien d’enregistrements les mieux classés l’outil examine pour répondre. |
Une proposition modifie au plus deux réglages ; min_confidence va de 0 à 1 et top_k de 1 à 8. L’agent ne peut modifier aucun code, aucun test ni aucune réponse attendue, et il ne peut pas approuver son propre changement. Sa sortie est une donnée que Python valide, pas du code à exécuter. Le contrat de configuration et le validateur de propositions définissent cette limite dans le code.
Comme ce proposeur ne peut envoyer que des réglages, il ne peut pas modifier l’évaluateur. L’évaluateur s’exécute pourtant dans le même processus Python que l’outil de mémoire. Un agent autorisé à écrire et à exécuter son propre code pourrait donc modifier les vérifications. Il faudrait alors placer l’évaluateur dans un processus séparé, avec ses propres règles d’accès aux fichiers et au réseau, avant de pouvoir se fier aux résultats.
La règle de notation
Pour l’histoire de la ville, le test doit poser les deux questions : Berlin au 5 janvier et Paris au 12 janvier. Ne tester que la première réponse récompenserait un outil qui écarte simplement le fait futur. Dans l’expérience associée, un scénario est une histoire complète d’événements write, query et parfois delete, comme les quatre événements ci-dessus. Chaque candidat exécute les mêmes 20 scénarios préparés, chacun à partir d’une mémoire vide. La configuration d’origine en réussit 13.
Un scénario réussit seulement si chaque réponse attendue est correcte et qu’aucune règle sur les données n’est violée. L’évaluateur contrôle trois règles sur les données, appelées vérifications strictes : un propriétaire ne voit jamais les faits d’un autre, un fait supprimé a disparu, et une entrée marquée comme interdite n’est pas stockée. Il compte aussi les enregistrements que l’outil a stockés.
Pour départager les candidats, la règle de sélection écarte d’abord tout candidat qui échoue à une vérification stricte. Parmi les autres, elle préfère celui qui réussit le plus de scénarios. Si deux candidats en réussissent autant, elle préfère celui qui stocke le moins d’enregistrements. Un changement qui ne fait que réduire le stockage peut donc l’emporter quand les réponses restent les mêmes, mais jamais face à un changement qui répond correctement à davantage de scénarios.
Un seul chiffre qui s’améliore ne suffit pas pour accepter un changement. Prenons le cas où l’on abaisse min_confidence de 0.7 à 0.2. Davantage de faits utiles sont stockés, comme une préférence arrivée avec un score faible. Le fait incertain delivery = courier est stocké lui aussi, et il remplace une valeur confirmée. Dans une comparaison préparée à la main, ce changement a corrigé un scénario mais en a cassé quatre : le taux de réussite est passé de 19/20 à 16/20, alors que toutes les vérifications strictes passaient encore. La part de faits utiles stockés a augmenté, et les réponses finales sont devenues moins bonnes. Ce candidat n’était pas une proposition de l’agent dans les campagnes ci-dessous ; il montre pourquoi le score compte des scénarios complets.
Les vérifications ont des limites. Le test fournit directement les identifiants de propriétaire, donc l’isolation des propriétaires n’est pas ici un test d’authentification. La vérification des écritures interdites rejette seulement les entrées que le test marque déjà comme interdites ; elle ne peut pas détecter une instruction malveillante cachée dans un texte ordinaire. Et le proposeur voit les 20 scénarios, donc aucun ne sert de jeu de test caché. Un score de réussite dit ce qui s’est passé sur ces cas, pas comment se comportera une application inconnue.
Donner à chaque proposition une raison testable
L’expérience s’est déroulée en campagnes. Une campagne est une tentative d’amélioration de la configuration d’origine, qui commence avec un historique d’agent vierge. Chaque itération est un appel au modèle dans lequel l’agent propose un changement ou décide de s’arrêter. Dans la première requête, l’agent reçoit les réglages actuels et leur signification, les résultats de la référence, les traces des scénarios en échec, les changements qu’il peut proposer et, dans les itérations suivantes, les propositions précédentes et leurs résultats.
Chaque réponse doit remplir les mêmes cinq champs. Ce format suit le Schema-Guided Reasoning (SGR) : la réponse est une fiche de décision qu’un relecteur peut vérifier champ par champ.
| Champ | Ce qu’un relecteur peut vérifier |
|---|---|
observations | Quel scénario et quel événement fournis appuient le changement proposé ? |
hypothesis | Quelle règle semble causer le problème ? |
predicted_effect | Qu’est-ce qui devrait s’améliorer quand le changement sera testé ? |
action | L’agent propose-t-il un changement ou s’arrête-t-il ? |
patch | Quels réglages autorisés faut-il modifier ? |
La requête impose cette forme avec un JSON Schema strict, via les Structured Outputs d’OpenAI. Le schéma contraint la forme de la réponse ; il ne prouve pas l’hypothèse. Python vérifie ensuite si les événements cités existent dans les preuves qu’il a fournies, si le patch reste dans les réglages autorisés, et si cette configuration a déjà été testée. Une réponse peut respecter le schéma et échouer à ces vérifications.
Dans la première itération enregistrée, l’agent a cité l’échec du déménagement futur et un second échec, où un fait sur l’adresse professionnelle d’Ada répondait à une question sur son domicile. Il a proposé d’activer à la fois le filtre de sujet et le filtre de date :
{ "filter_entity": true, "time_aware": true }Dans l’implémentation, ces réglages retirent les enregistrements non éligibles avant le classement. Le filtre de sujet élimine les faits sur d’autres sujets : un fait work ne peut donc pas répondre à une question sur home. Le filtre de date ne garde que les faits valides à la date de la question. Un fait est valide depuis sa date de début jusqu’à sa date de fin, celle-ci exclue :
def valid_at(item: dict, at: str) -> bool:
    return item["valid_from"] <= at and (
        item["valid_to"] is None or at < item["valid_to"]
    )
Paris commence le 10 janvier : pour la question du 5 janvier, il ne reste donc que Berlin. Le 12 janvier, Paris est valide et Berlin ne l’est pas.
Python a exécuté cette configuration sur les 20 scénarios. Le taux de réussite est passé de 13/20 à 19/20, et les vérifications strictes ont été réussies. La campagne a modifié les deux filtres en une seule étape et n’a donc mesuré que leur effet combiné ; les réexécutions avec un seul réglage plus bas les séparent. L’exécuteur a gardé cette configuration comme point de départ de la proposition suivante et a renvoyé ses résultats à l’agent.
Après les filtres, un scénario échouait encore, et certaines histoires stockaient deux fois la même confirmation. La première campagne a pris quatre décisions au total :
| Décision | Preuve et changement proposé | Résultat mesuré sur les mêmes 20 scénarios |
|---|---|---|
| 1 | Activer le filtrage par sujet et par date après des réponses sur le mauvais sujet et à la mauvaise date | 13/20 → 19/20 ; conservé comme point de départ suivant |
| 2 | Dédupliquer les confirmations répétées language = German | 19/20 ; enregistrements stockés en moyenne 1,70 → 1,60 |
| 3 | Abaisser min_confidence de 0.7 à 0.6 pour une préférence utile notée 0.6 | 20/20 ; enregistrements stockés en moyenne 1,65 |
| 4 | S’arrêter faute de nouvelle proposition étayée | Aucune nouvelle configuration testée |
À 0.6, la préférence utile est stockée alors que le fait incertain sur le coursier, noté 0.4, reste sous le seuil. Cela explique le troisième changement sur ces entrées préparées ; les scores eux-mêmes ont été fournis par l’auteur du test. La décision de s’arrêter signifie que l’agent n’a trouvé aucun autre changement qu’il pouvait étayer avec les retours qu’il avait vus. Elle ne prouve pas que cette configuration soit la meilleure possible.
La validation a aussi déjà rejeté une réponse. Lors d’une exécution de développement distincte, un agent a cité l’identifiant d’un candidat comme s’il s’agissait d’un événement de scénario. La réponse respectait le JSON Schema, mais la référence n’existait pas dans les preuves d’événements fournies. Python a rejeté la proposition avant de la tester et a renvoyé l’erreur de validation. Aucune des trois campagnes enregistrées ci-dessous n’a connu un tel rejet.
Si un patch évalué fait baisser le score, l’exécuteur garde le point de départ précédent et consigne la tentative ratée. Un test scripté exerce ce chemin ; les trois campagnes réelles ne l’ont pas fait. Garder le résultat rejeté dans l’historique donne au proposeur une raison de choisir un autre changement plutôt que de répéter la même hypothèse.
Répétition, coût et adoption
L’outil de mémoire est déterministe : réexécuter la même configuration sur le même scénario donne la même réponse. L’incertitude vient de ce que l’agent choisit. L’étude a donc exécuté la recherche entière trois fois, chacune à partir de la référence à 13/20, avec un historique d’agent vierge et au plus quatre décisions du modèle. Les trois campagnes ont choisi les trois mêmes patchs, atteint 20/20 sur les mêmes scénarios, puis se sont arrêtées. Cela fait 12 appels au modèle, neuf propositions évaluées et trois décisions d’arrêt.
Pour l’étude du 11 septembre 2026, le proposeur était gpt-5.6-luna avec un faible effort de raisonnement. Au tarif publié du modèle, la consommation de tokens enregistrée revient à environ USD 0.04 pour les 12 appels, pour un budget configuré de USD 0.50. C’est une estimation fondée sur la consommation enregistrée, pas une facture, et elle exclut le temps de développement.
Ces résultats répétés montrent que ce modèle a suivi un chemin utile avec ce prompt, cette cible et cet ensemble de scénarios. Ils ne montrent pas qu’une nouvelle charge de travail de mémoire réussira. Le rapport de campagne figé de l’expérience associée et son archive de preuves avec somme de contrôle contiennent les requêtes, les réponses, les validations et les résultats enregistrés.
Une configuration que l’exécuteur conserve n’est que le point de départ de l’expérience suivante. Ce n’est pas une version livrée. Dans les rapports de l’expérience associée, l’adoption attend toujours une revue humaine, et les campagnes n’ont rien déployé. Un relecteur devrait encore vérifier le changement par rapport à sa propre charge de travail, à ses règles d’accès, à son objectif de coût et à son plan de retour arrière.
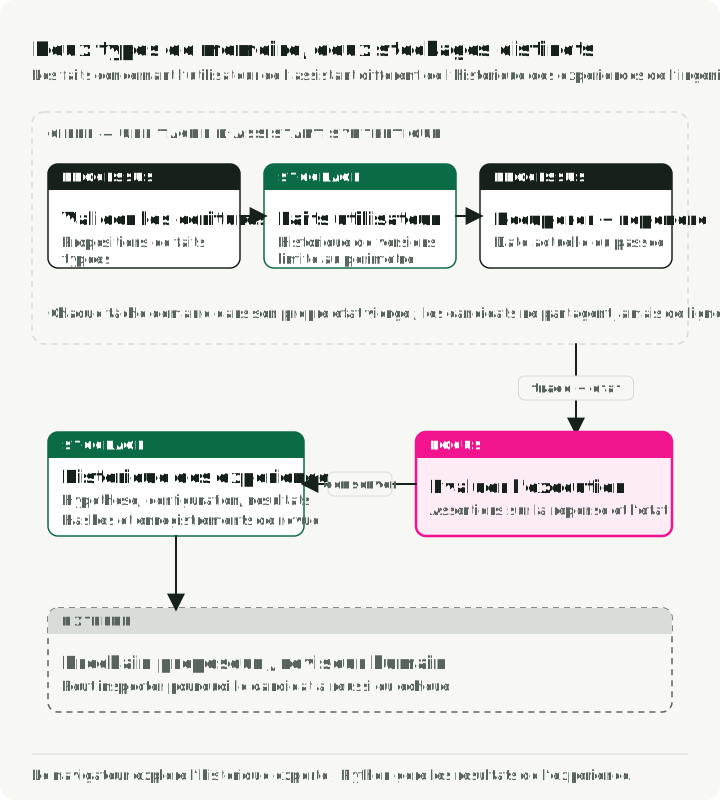
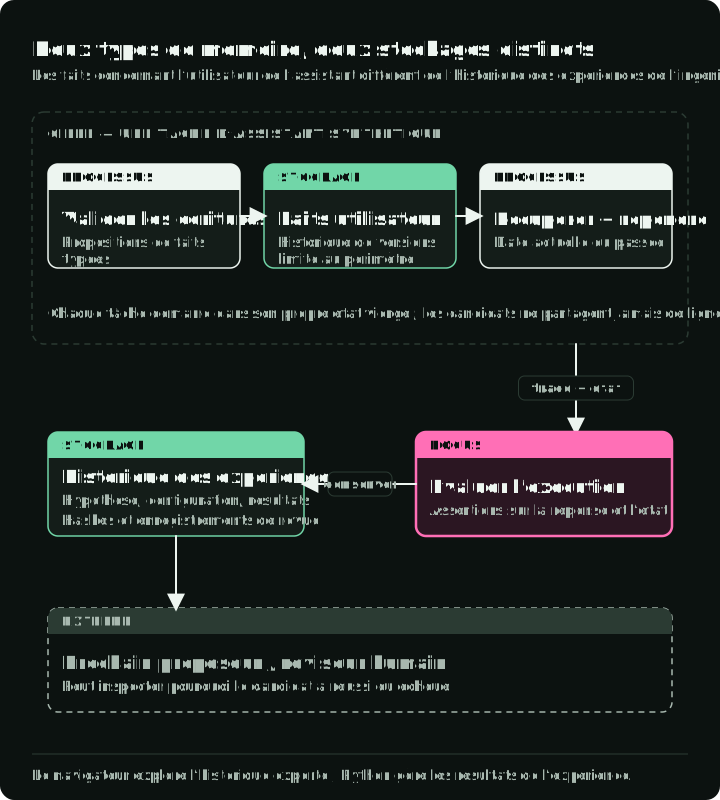
L’expérience produit aussi ses propres enregistrements, qui demandent un traitement différent de celui des faits d’Ada. L’outil de mémoire stocke sa ville. L’historique d’expérience stocke chaque requête, proposition, résultat de validation, version de test et résultat, avec les empreintes nécessaires pour expliquer un choix plus tard. Dans cette étude synthétique, ces enregistrements peuvent être publics. Dans une application réelle, supprimer le fait d’un utilisateur du stockage mémoire actif n’effacerait pas les copies présentes dans les journaux d’expérience ou les sauvegardes. Une politique de conservation et de suppression doit couvrir ces enregistrements séparément.
Cette recherche avait-elle besoin d’un LLM ?
Les campagnes montrent que la boucle fonctionne : un LLM a lu des traces, proposé des réglages et modifié sa proposition suivante après avoir reçu un retour. Elles ne montrent pas qu’un LLM était le bon proposeur pour ce problème. Pour le vérifier, j’ai réexécuté l’outil de mémoire inchangé sur les mêmes 20 scénarios en modifiant un réglage à la fois, avec le script de grille de réglages de l’expérience associée. Ces exécutions n’appellent aucun modèle, et chaque configuration n’a besoin que d’une exécution parce que l’outil est déterministe.
| Configuration | Scénarios réussis |
|---|---|
| Référence | 13/20 |
| Filtre de sujet seul | 16/20 |
| Filtre de date seul | 16/20 |
| Déduplication seule | 13/20 |
min_confidence = 0.6 seul | 14/20 |
| Les deux filtres | 19/20 |
Les deux filtres, déduplication, min_confidence = 0.6 | 20/20 |
Chaque filtre corrige trois scénarios à lui seul, et ensemble ils en corrigent six. La déduplication ne change aucune réponse ; elle ne fait que réduire les enregistrements stockés.
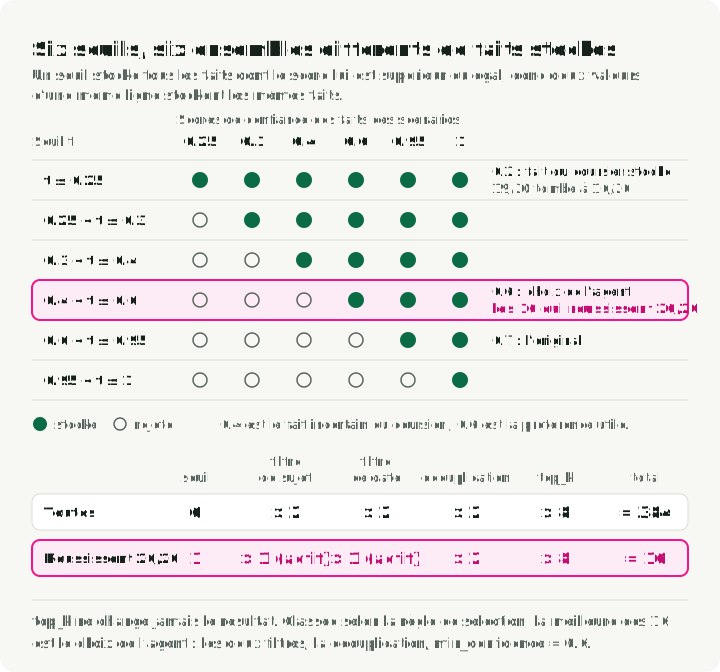
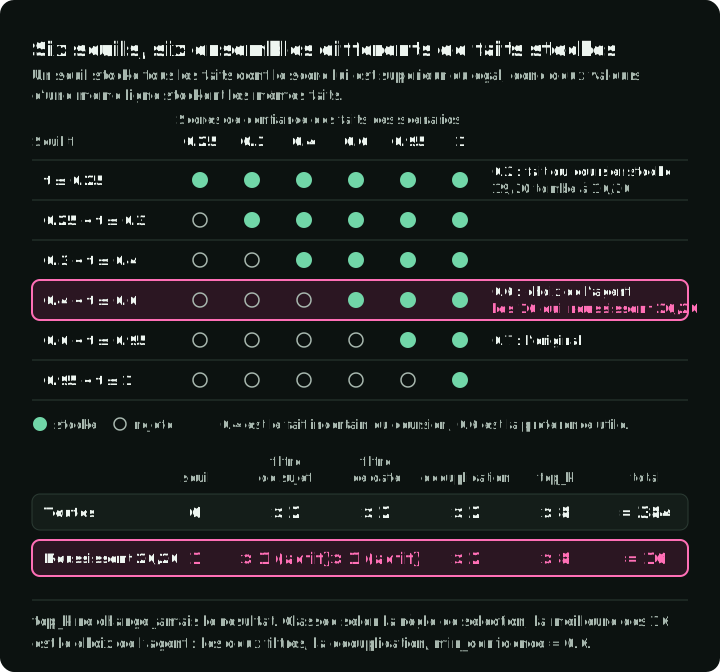
J’ai ensuite testé toutes les combinaisons. Les faits des scénarios portent six scores de confiance : 0,25, 0,3, 0,4, 0,6, 0,95 et 1. Un seuil stocke tous les faits dont le score lui est supérieur ou égal, donc 0,45 et 0,55 stockent exactement les mêmes faits. Une valeur de seuil par intervalle entre scores voisins suffit, et six valeurs couvrent tous les comportements d’écriture distincts sur ces scénarios.
Avec ces six seuils, trois réglages activés/désactivés et huit valeurs de top_k, on obtient 384 configurations. Le script exécute chacune sur les 20 scénarios et termine en moins d’une seconde.
Seize configurations réussissent 20/20. Toutes activent les deux filtres et utilisent un seuil supérieur à 0,4 et au plus égal à 0,6 ; top_k ne change jamais le résultat. Classée selon la règle de sélection ci-dessus, la meilleure configuration est celle que l’agent a trouvée : les deux filtres, la déduplication et min_confidence = 0.6, avec 1,65 enregistrement stocké par scénario. Le rapport sauvegardé liste chaque résultat avec l’empreinte de la source.
Dans la figure, chaque ligne est une plage de seuils, les points pleins sont les faits qu’elle stocke, et la ligne marquée contient les 16 configurations qui réussissent.
Cette grille n’est pas une comparaison équitable avec l’agent. Elle s’appuie sur ma connaissance des scores de confiance dans les données de test, et elle ignore la limite de quatre décisions de l’agent. Elle montre seulement que cet espace de recherche est assez petit pour être testé entièrement : il n’avait pas besoin d’un proposeur LLM.
La grille et l’agent sont deux des quatre façons de répartir le choix des expériences entre les personnes et le logiciel :
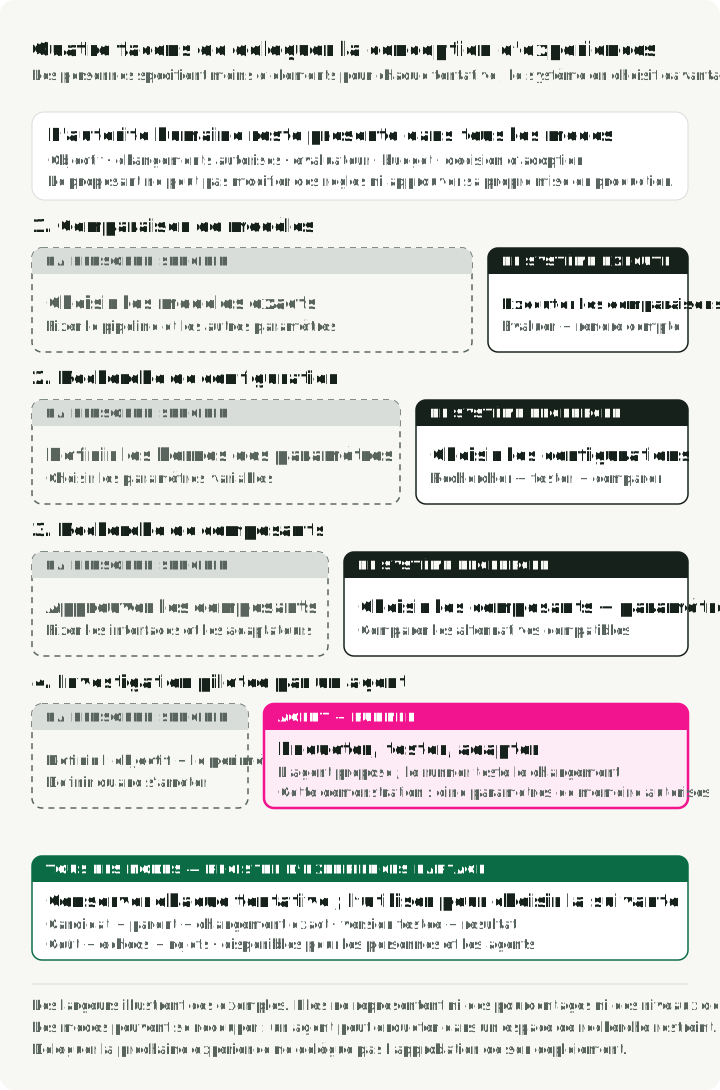
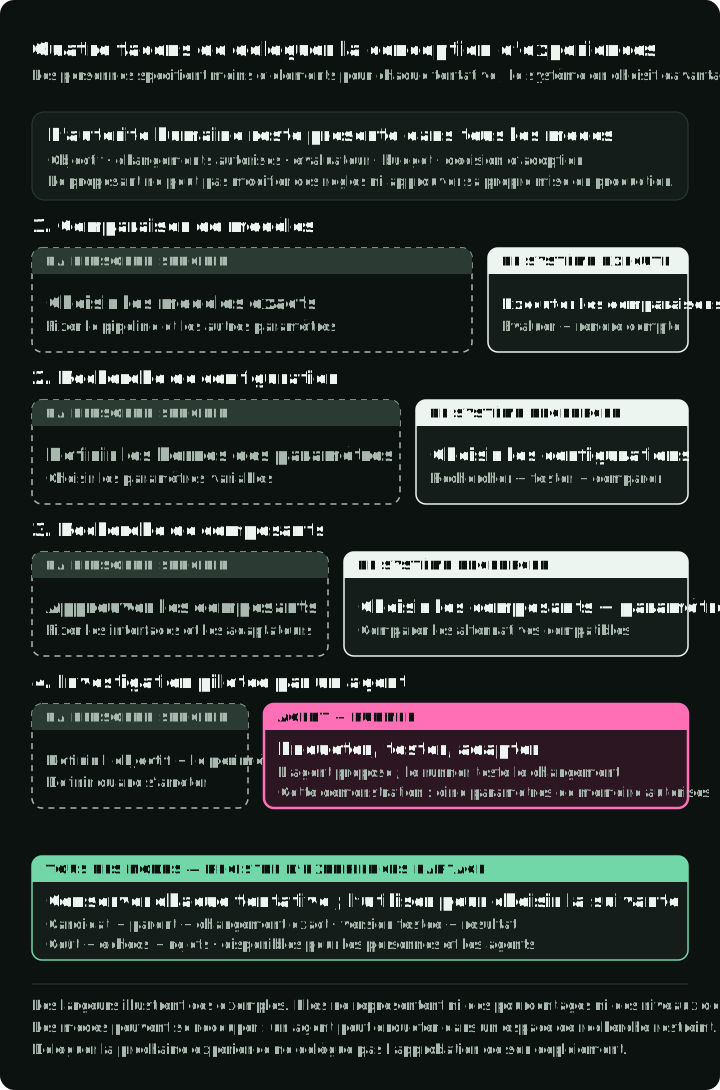
- Comparaison de modèles. Vous choisissez les modèles ou variantes exacts ; le système les exécute et les note. Aucun proposeur LLM n’est nécessaire.
- Recherche de configuration. Vous choisissez quels réglages peuvent varier et leurs bornes ; une grille, une recherche aléatoire ou un optimiseur comme Optuna choisit les valeurs. La grille ci-dessus est de ce type.
- Recherche de composants. Vous approuvez des composants interchangeables aux interfaces fixes, et la recherche choisit les composants et les réglages. La recherche de pipeline de scikit-learn le fait avec une recherche par grille ordinaire : échanger des composants ne rend donc pas à lui seul le processus agentic.
- Investigation menée par un agent. Un agent lit les échecs et les résultats précédents, propose le changement suivant et s’adapte après chaque test, comme l’ont fait les campagnes ci-dessus. Des modes hybrides existent : MIPROv2 de DSPy fait proposer des instructions par un modèle et utilise l’optimisation bayésienne pour chercher leurs combinaisons.
Dans tous les modes, les personnes gardent l’objectif, les changements autorisés, l’évaluateur, le budget et la décision d’adoption. Tous les modes peuvent écrire dans le même historique d’expérience, que le schéma appelle le registre : chaque candidat et son parent, le changement exact et qui l’a fourni, la version du test, le résultat, le coût et tout rejet. Avec cet enregistrement, vous pouvez confier la proposition suivante à un agent, ou la reprendre, sans perdre de preuves. L’exécuteur de l’expérience associée accepte aussi un candidat fourni par une personne via lab evaluate.
Décidez d’abord lequel de ces modes convient à votre système. Si les changements autorisés se résument à quelques réglages aux plages connues et que chaque test est bon marché, énumérez-les ou lancez un optimiseur standard avant d’ajouter un LLM. Un proposeur LLM peut aider quand choisir un changement exige de lire des traces d’échec variées, du code source et des interactions entre composants, et quand les candidats sont trop nombreux ou trop peu structurés pour être listés. Savoir s’il aide dans ce cas est une question à mesurer, pas à présumer.
Appliquer cela à votre système
Choisissez une trace qui montre un échec réel. Notez ensuite quatre choses avant de lancer la moindre recherche :
- les changements autorisés ;
- les résultats de tâche et les effets interdits que l’évaluateur vérifie ;
- ce que chaque tentative peut coûter ;
- qui peut adopter un candidat.
Essayez la recherche la plus simple qui couvre les changements autorisés. Vérifiez ensuite si le résultat modifie l’expérience suivante ou une décision de mise en production. S’il ne modifie ni l’une ni l’autre, la boucle n’a rien amélioré.
Facultatif : inspecter et exécuter l’expérience associée
Vous pouvez inspecter l’étude enregistrée sans clé d’API. Le tag v0.2.3 contient l’outil de mémoire, les études enregistrées et la grille de réglages. Avec uv installé, clonez-le, restaurez les preuves enregistrées, vérifiez-les, réexécutez la grille et lancez un visualiseur local pour les campagnes enregistrées :
git clone --branch v0.2.3 --depth 1 https://github.com/slavadubrov/meta-engineering-ai-lab.git
cd meta-engineering-ai-lab
uv sync --frozen
uv run --frozen python scripts/fetch_evidence.py
uv run --frozen python -m lab verify artifacts/agent-study-03 --source
uv run --frozen python scripts/settings_grid.py --check
uv run --frozen python -m lab serve --port 8075
Ouvrez http://127.0.0.1:8075/web/ pour suivre une campagne enregistrée de la proposition jusqu’au retour. Le téléchargement est vérifié par rapport à une somme de contrôle fixée, et rien dans ce bloc n’appelle de modèle. L’exécution avec --check recalcule la grille et échoue si le rapport sauvegardé ne correspond plus au code.
Pour lancer une nouvelle campagne de propositions payante, enregistrez OPENAI_API_KEY dans le fichier .env.local ignoré du dépôt et choisissez un nouveau répertoire de sortie :
uv run --frozen --env-file .env.local python -m lab campaign \
  --live --campaigns 3 --iterations 4 --budget-usd 0.50 \
  --output artifacts/my-agent-study
Le drapeau explicite --live active les appels au fournisseur. Consultez artifacts/my-agent-study/report.md pour voir les propositions et les coûts obtenus. Le modèle peut suivre un autre chemin, même si Python notera toute configuration donnée de la même façon. Le guide pas à pas de l’outil de mémoire présente les entrées JSON préparées, les enregistrements stockés et quatre configurations spécifiées à la main, si vous voulez comprendre la cible déterministe sans exécuter l’agent.
La suite de la série
L’outil de mémoire était petit volontairement : cinq réglages et 20 scénarios rendent chaque étape inspectable. Cette même taille est sa limite. Un script peut tester toutes les configurations, donc cet exemple ne peut pas montrer quand un proposeur LLM vaut son coût.
Les prochaines parties de cette série utilisent une cible plus grande : le harness de support client de Concevoir un harness d’agent, partie 1 de Building and Evaluating Agent Harnesses. Un agent de code proposera des changements à ce harness, et ses résultats seront comparés à ceux d’une recherche plus simple. Le dispositif d’amélioration ne se modifiera pas lui-même, et une personne examinera chaque adoption.
Ce harness a d’abord besoin d’un évaluateur plus solide. Sept de ses douze tâches de support n’attendent aucune modification de la base de données : un agent qui ne fait rien réussit donc déjà 7 des 12 vérifications d’état. Un agent de code noté uniquement sur ces vérifications pourrait en réussir davantage en faisant faire moins à l’agent de support.