Meta-Engineering von AI-Systemen: von Traces zu besserem Gedächtnis

Automatische Übersetzung
Dieser Artikel wurde automatisch aus der englischen Originalversion übersetzt.
Dieser Artikel richtet sich an Ingenieure, die einen Agent untersuchen lassen wollen, warum ihr AI-System fehlschlägt, und ihn eine Korrektur vorschlagen lassen wollen. Das Beispiel ist ein kleines Memory-Tool, das die Frage beantwortet, wo ein Nutzer wohnt, und dabei falsch antwortet. Sie sehen, wie eine Änderung an diesem Tool vorgeschlagen, an 20 vorbereiteten Szenarien getestet und bewertet wird, bevor jemand sie übernimmt. Außerdem sehen Sie, wie Sie prüfen, ob ein einfaches Skript, das jede Einstellung durchprobiert, dieselbe Korrektur auch ohne LLM gefunden hätte. Im begleitenden Experiment schlug ein LLM die Änderungen vor, und gewöhnlicher Python-Code testete sie.
Ich nenne den Entwurf dieses Verbesserungsprozesses Meta-Engineering. Er besteht aus vier Entscheidungen. Was darf der Vorschlagsgeber ändern, also die Person oder das Programm, das Änderungen vorschlägt? Welche Ergebnisse gelten als Verbesserung? Wie beeinflusst ein Ergebnis den nächsten Vorschlag? Wer entscheidet, eine Änderung zu übernehmen? Dieselben vier Entscheidungen gelten, egal ob der Vorschlagsgeber ein LLM, eine Person oder eine Parametersuche ist.
Der Fehler mit der falschen Stadt
Das Memory-Tool speichert Fakten über eine Nutzerin namens Ada und beantwortet Fragen dazu. Ein Test, das Szenario „zukünftiger Umzug“, sendet ihm vier Ereignisse:
city = Berlinspeichern, gültig ab dem 1. Januar.city = Parisspeichern, am 3. Januar eingegangen, aber gültig ab dem 10. Januar.- Die Stadt am 5. Januar abfragen. Erwartet wird Berlin.
- Die Stadt am 12. Januar abfragen. Erwartet wird Paris.
Das ursprüngliche Tool antwortet beide Male mit Paris. Am 12. Januar ist das richtig. Am 5. Januar ist es falsch: Ada ist noch nicht umgezogen.
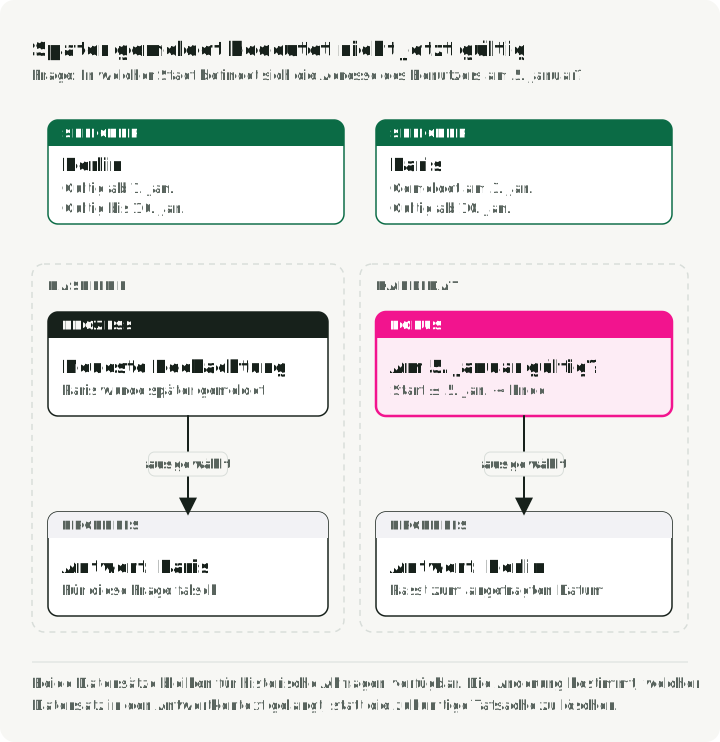
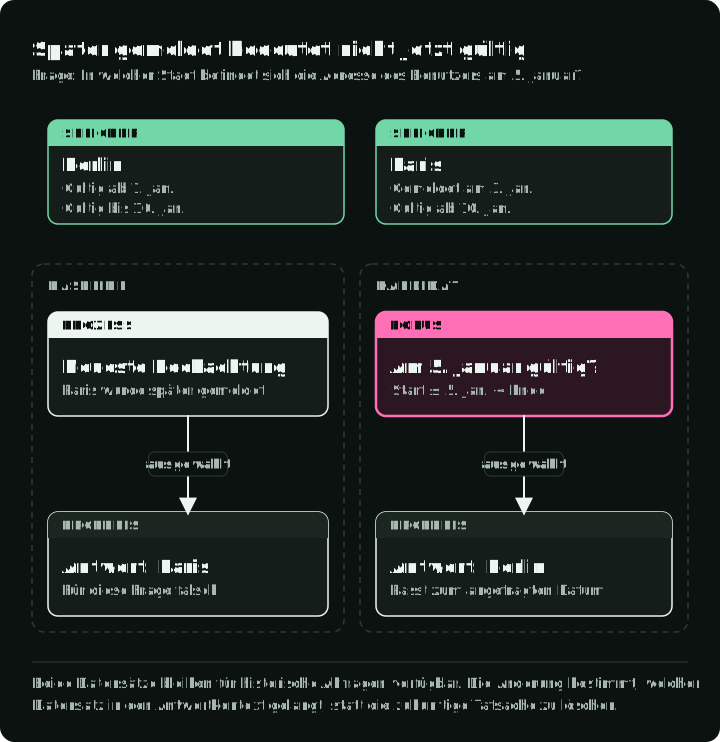
Jeder Testlauf hinterlässt einen Trace: eine gespeicherte Aufzeichnung aller Ereignisse, die an das Tool gesendet wurden, der Datensätze, die es gespeichert hat, und der Antworten, die es gegeben hat. Der gespeicherte Trace zu diesem Szenario zeigt, dass beide Datensätze die richtigen Gültigkeitsdaten haben. Berlin gilt vom 1. bis zum 10. Januar, Paris ab dem 10. Januar ohne Enddatum. Der Fehler liegt im Retrieval: Es reiht den später eingegangenen Paris-Fakt vor Berlin ein, ohne zu prüfen, welcher am abgefragten Datum gültig war. Den zukünftigen Umzug zu speichern war richtig.
Der Paris-Fakt muss also bleiben, und das Retrieval braucht einen Datumsfilter. Diese Diagnose rechtfertigt noch nicht, einen Filter zu übernehmen. Derselbe Retrieval-Code beantwortet Fragen zu anderen Themen, verarbeitet Löschungen und muss die Datensätze verschiedener Nutzer getrennt halten. Eine Änderung, die den 5. Januar repariert und diese Fälle kaputt macht, verschlechtert das Memory-Tool. Der Verbesserungsprozess muss das erkennen, bevor eine neue Version die Nutzer erreicht.
Zwei Loops
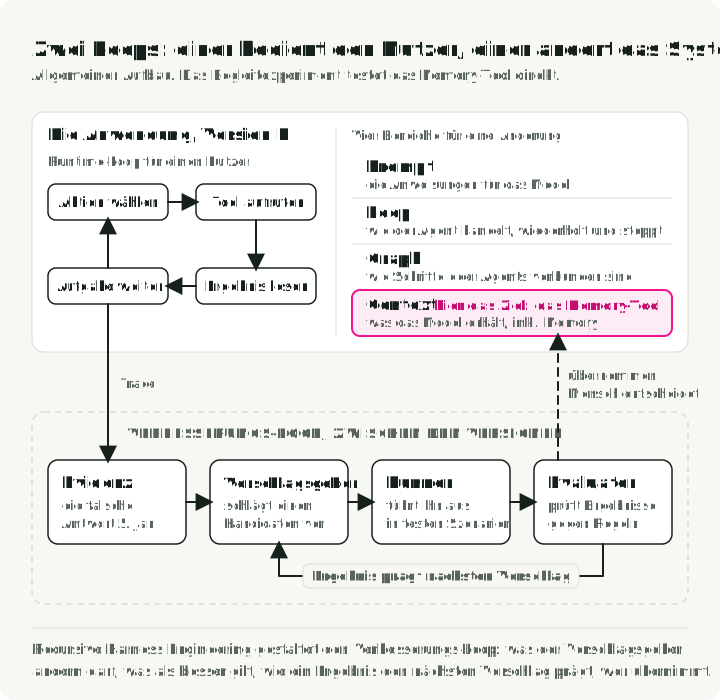
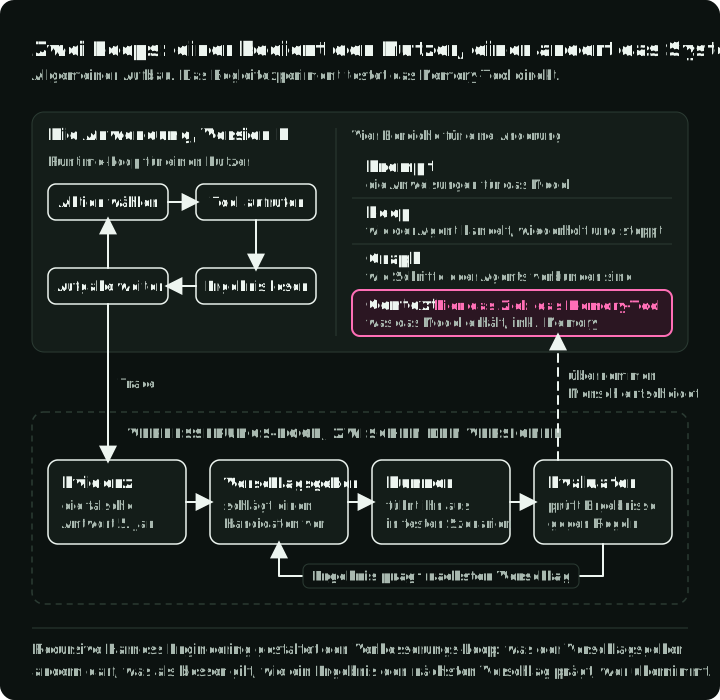
Eine Agent-Anwendung führt einen Loop aus, während sie einen Nutzer bedient. In diesem Runtime Loop wählt sie eine Aktion, ruft ein Tool auf, liest das Ergebnis und setzt die Aufgabe des Nutzers fort. Ein Agent, der das Memory-Tool verwendet, könnte dabei die Antwort mit der falschen Stadt erhalten. Dieses Experiment ruft das Tool direkt mit festen Testereignissen auf.
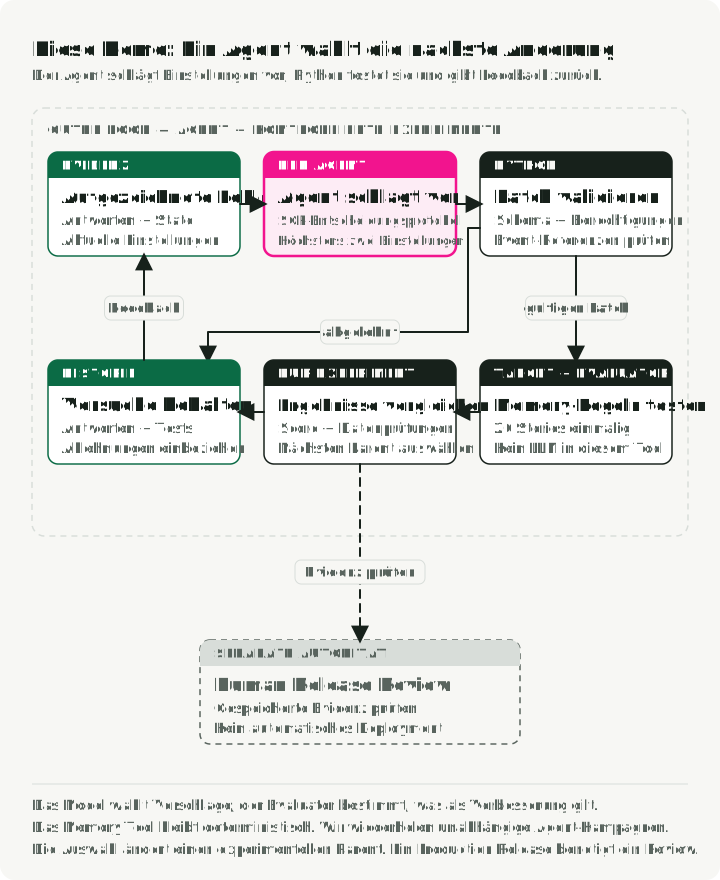
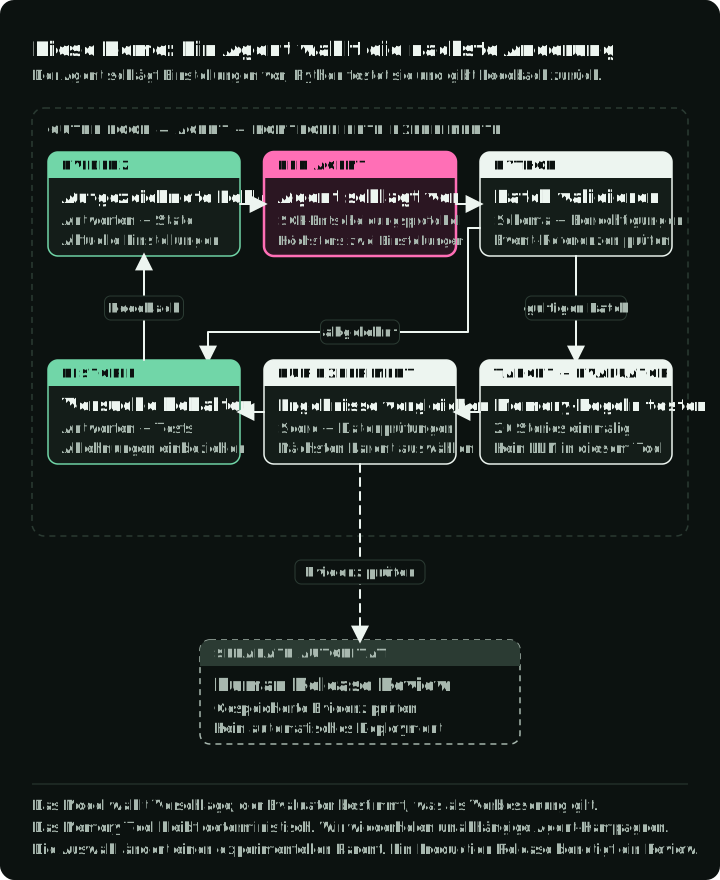
Den Fehler zu beheben erfordert einen zweiten Loop, der zwischen den Versionen der Anwendung läuft. Dieser Improvement Loop beginnt mit Evidenz für einen Fehler, etwa der Antwort vom 5. Januar, einem Datensatz, der geändert wurde, obwohl er unverändert bleiben sollte, oder zu hohen Kosten. Der Vorschlagsgeber schlägt einen Kandidaten vor: eine konkrete Version einer Änderung am Zielobjekt, dem Teil des Systems, der verbessert wird. Hier ist das Zielobjekt das Memory-Tool, und ein Kandidat ist ein neuer Satz seiner Einstellungen. Ein Runner führt den Kandidaten auf einer festen Menge von Testszenarien aus, und ein Evaluator prüft die Ergebnisse gegen die Regeln, die diese Szenarien enthalten. Der Loop ist erst abgeschlossen, wenn ein Ergebnis den nächsten Vorschlag oder die Entscheidung über die Übernahme einer Änderung beeinflusst.
Das Diagramm zeigt den allgemeinen Aufbau einer Anwendung, in dem das Zielobjekt jeder Teil der Anwendung sein kann. Ingenieure fassen diese Teile oft in vier sich überschneidende Bereiche zusammen. Prompt Engineering ändert die Anweisungen. Context Engineering ändert, welche Informationen das Model erhält, einschließlich Memory. Loop Engineering ändert, wie der Agent in seinem Runtime Loop handelt, es erneut versucht und anhält. Graph Engineering ändert, wie Schritte oder Agents verbunden sind und Arbeit weiterreichen. Meta-Engineering behandelt eine Entscheidung in jedem dieser vier Bereiche, etwa die Formulierung eines Prompts oder die Anzahl der Wiederholungen, als Einstellung, die ein Experiment ändern kann. Es beurteilt jeden Kandidaten nach Antwortqualität, Kosten und erforderlichem Verhalten des Gesamtsystems, zum Beispiel danach, die Daten eines Nutzers nie einem anderen zu zeigen.
Zwei aktuelle Projekte setzen bereits einen Coding Agent als Vorschlagsgeber ein. In Karpathys autoresearch bearbeitet der Agent eine Trainingsdatei und führt sie mit einem festen Zeitbudget aus. Jeder Versuch wird als behalten, verworfen oder abgestürzt festgehalten, und der Evaluationscode liegt in einer separaten Datei, die der Agent nicht bearbeitet. Meta-Harness, ein Preprint vom März 2026, lässt den Vorschlagsgeber den Quellcode, die Scores und die Traces früherer Kandidaten lesen. Damit verbessert er den Code, der festlegt, was eine LLM-Anwendung speichert, abruft und ihrem Model zeigt. Dieser Artikel nutzt ein deutlich kleineres Zielobjekt, das Memory-Tool, damit sich jeder Schritt nachvollziehen lässt.
Begrenzen, was der Vorschlagsgeber ändern darf
Das LLM läuft nie im Memory-Tool. Es liest fehlgeschlagene Traces und die Evaluationsergebnisse und schlägt dann eine neue Konfiguration vor: Werte für die Einstellungen des Tools. Python-Code testet diese Konfiguration.
Das Memory-Tool selbst ist gewöhnlicher, deterministischer Python-Code. Es erhält strukturierte Fakten, speichert oder verwirft sie und gibt für eine Abfrage einen Wert zurück. Es extrahiert keine Fakten aus Gesprächen und schreibt keine Antwort in natürlicher Sprache, daher kann dieser Loop einen Fehler bei der Faktenextraktion nicht beheben. Jeder gespeicherte Fakt hat einen Besitzer, ein Quellereignis und ein Gültigkeitsintervall, nach den Regeln für gespeicherten Zustand aus Schema-Guided Agent Memory.
Jeder eingehende Fakt trägt außerdem einen Confidence-Score, den der Testautor festgelegt hat. Das Tool speichert einen Fakt nur, wenn sein Score mindestens min_confidence beträgt. Die Scores sind Teil der Testdaten und keine Wahrscheinlichkeiten, die an einem Model gemessen wurden. Ein unsicherer Fakt delivery = courier mit dem Score 0.4 wird zum Beispiel beim ursprünglichen Schwellenwert von 0.7 verworfen, bei 0.2 aber gespeichert.
Der Paris-Datensatz nach dem zweiten Schreibvorgang zeigt, wie ein Datensatz seine Historie behält. observed_at ist der Tag, an dem das Tool den Fakt erfuhr, und valid_from der Tag, an dem er wahr wird (Auszug):
{
    "id": "m002",
    "key": "city",
    "value": "Paris",
    "valid_from": "2026-01-10",
    "valid_to": null,
    "observed_at": "2026-01-03",
    "source_event_id": "future-move:event-2",
    "supersedes_memory_id": "m001"
}
source_event_id verweist auf das Ereignis, das Paris lieferte, und supersedes_memory_id verknüpft den Datensatz mit dem Berlin-Datensatz m001. Der Writer hat außerdem feste Regeln für Konflikte. Wenn ein späterer Schreibvorgang Rom meldet, ebenfalls gültig ab dem 10. Januar, lehnt der Writer ihn ab und lässt Paris unverändert. Ein wiederholtes Paris für dasselbe Datum verwendet den Datensatz weiter, und ein Update mit früherem Gültigkeitsdatum wird abgelehnt. Der Vorschlagsgeber kann diese Regeln nicht ändern.
Der Vorschlagsgeber kann fünf vorhandene Einstellungen ändern:
| Einstellung | Was eine Änderung bewirkt |
|---|---|
min_confidence | Ändert den Mindest-Confidence-Score, der zum Speichern eines Fakts nötig ist. |
filter_entity | Beschränkt das Retrieval auf das abgefragte Thema, etwa Wohnort statt Arbeitsort. |
time_aware | Beschränkt das Retrieval auf Fakten, die am abgefragten Datum gültig sind. |
deduplicate | Verwendet einen identischen aktiven Fakt weiter, statt eine weitere Bestätigung zu speichern. |
top_k | Legt fest, wie viele der bestplatzierten Datensätze das Tool für die Antwort berücksichtigt. |
Ein Vorschlag ändert höchstens zwei Einstellungen; min_confidence reicht von 0 bis 1 und top_k von 1 bis 8. Der Agent kann weder Code noch Tests oder erwartete Antworten bearbeiten, und er kann seine eigene Änderung nicht freigeben. Seine Ausgabe sind Daten, die Python validiert, kein Code, der ausgeführt wird. Der Konfigurationsvertrag und der Proposal-Validator legen diese Grenze im Code fest.
Weil dieser Vorschlagsgeber nur Einstellungen senden kann, kann er den Evaluator nicht ändern. Der Evaluator läuft allerdings im selben Python-Prozess wie das Memory-Tool. Ein Agent, der eigenen Code schreiben und ausführen darf, könnte deshalb die Prüfungen ändern. Für einen solchen Agent muss der Evaluator in einem separaten Prozess mit eigenen Regeln für Datei- und Netzwerkzugriff laufen, bevor man seinen Ergebnissen trauen kann.
Die Bewertungsregel
Bei der Stadtgeschichte muss der Test beide Fragen stellen: Berlin am 5. Januar und Paris am 12. Januar. Würde er nur die erste Antwort prüfen, belohnte er ein Tool, das den zukünftigen Fakt einfach verwirft. Im Begleitprojekt ist ein Szenario eine vollständige Geschichte aus write-, query- und manchmal delete-Ereignissen, wie die vier Ereignisse oben. Jeder Kandidat durchläuft dieselben 20 vorbereiteten Szenarien, jeweils mit leerer Memory. Die ursprüngliche Konfiguration besteht 13 davon.
Ein Szenario besteht nur, wenn jede erwartete Antwort stimmt und keine Datenregel verletzt wird. Der Evaluator prüft drei Datenregeln, die Hard Checks heißen: Ein Besitzer sieht nie die Fakten eines anderen Besitzers, ein gelöschter Fakt ist weg, und eine als verboten markierte Eingabe wird nicht gespeichert. Außerdem zählt er die Datensätze, die das Tool gespeichert hat.
Um zwischen Kandidaten zu wählen, verwirft die Auswahlregel zuerst jeden Kandidaten, der einen Hard Check nicht besteht. Unter den übrigen bevorzugt sie den, der mehr Szenarien besteht. Bestehen zwei gleich viele, bevorzugt sie den, der weniger Datensätze speichert. Eine Änderung, die nur den Speicherbedarf senkt, kann also gewinnen, wenn die Antworten gleich bleiben, aber nie gegen eine Änderung, die mehr Szenarien richtig beantwortet.
Eine einzelne verbesserte Zahl genügt nicht, um eine Änderung zu akzeptieren. Nehmen wir an, min_confidence sinkt von 0.7 auf 0.2. Es werden mehr nützliche Fakten gespeichert, etwa eine Präferenz, die mit niedrigem Score eintraf. Aber auch der unsichere Fakt delivery = courier wird gespeichert und ersetzt einen bestätigten Wert. In einem von Hand vorbereiteten Vergleich reparierte diese Änderung ein Szenario, machte aber vier kaputt: Die Erfolgsquote fiel von 19/20 auf 16/20, obwohl jeder Hard Check weiter bestand. Der Anteil gespeicherter nützlicher Fakten stieg, und die endgültigen Antworten wurden schlechter. Dieser Kandidat war in den folgenden Kampagnen kein Vorschlag des Agents; er zeigt, warum der Score vollständige Szenarien zählt.
Die Prüfungen haben Grenzen. Der Test liefert Besitzer-IDs direkt, daher ist die Besitzer-Isolation hier kein Authentifizierungstest. Die Prüfung auf verbotene Schreibvorgänge lehnt nur Eingaben ab, die der Test bereits als verboten markiert; sie kann keine bösartige Anweisung finden, die in gewöhnlichem Text versteckt ist. Und der Vorschlagsgeber sieht alle 20 Szenarien, daher dient keines davon als verdeckter Testsatz. Ein bestandener Score sagt uns, was in diesen Fällen geschah, nicht, wie sich eine unbekannte Anwendung verhalten wird.
Jedem Vorschlag eine prüfbare Begründung geben
Das Experiment lief als Kampagnen. Eine Kampagne ist ein Versuch, die ursprüngliche Konfiguration zu verbessern, und beginnt mit einer frischen Agent-Historie. Jede Iteration ist ein Model-Aufruf, in dem der Agent eine Änderung vorschlägt oder beschließt aufzuhören. In der ersten Anfrage erhält der Agent die aktuellen Einstellungen samt ihrer Bedeutung, die Ergebnisse der Baseline, Traces der fehlgeschlagenen Szenarien und die Änderungen, die er vorschlagen darf; in späteren Iterationen kommen frühere Vorschläge und deren Ergebnisse hinzu.
Jede Antwort muss dieselben fünf Felder ausfüllen. Dieses Format folgt Schema-Guided Reasoning (SGR): Die Antwort ist ein Entscheidungsprotokoll, das ein Reviewer Feld für Feld prüfen kann.
| Feld | Was ein Reviewer prüfen kann |
|---|---|
observations | Welches gelieferte Szenario und welches Ereignis stützen die vorgeschlagene Änderung? |
hypothesis | Welche Regel scheint das Problem zu verursachen? |
predicted_effect | Was sollte sich verbessern, wenn die Änderung getestet wird? |
action | Schlägt der Agent eine Änderung vor oder hört er auf? |
patch | Welche erlaubten Einstellungen sollen sich ändern? |
Die Anfrage erzwingt diese Form mit einem strikten JSON Schema über OpenAI Structured Outputs. Das Schema begrenzt die Form der Antwort; es beweist die Hypothese nicht. Python-Code prüft dann, ob die zitierten Ereignisse in der gelieferten Evidenz vorkommen, ob der Patch innerhalb der erlaubten Einstellungen bleibt und ob diese Konfiguration schon getestet wurde. Eine Antwort kann dem Schema entsprechen und diese Prüfungen trotzdem nicht bestehen.
In der ersten aufgezeichneten Iteration zitierte der Agent den Fehler beim zukünftigen Umzug und einen zweiten Fehler, bei dem ein Fakt über Adas Arbeitsadresse eine Frage zu ihrem Wohnort beantwortete. Er schlug vor, sowohl den Themenfilter als auch den Datumsfilter zu aktivieren:
{ "filter_entity": true, "time_aware": true }In der Implementierung entfernen diese Einstellungen ungeeignete Datensätze vor dem Ranking. Der Themenfilter verwirft Fakten über andere Themen, sodass ein work-Fakt keine home-Frage beantworten kann. Der Datumsfilter behält nur Fakten, die am Datum der Frage gültig sind. Ein Fakt ist ab seinem Startdatum gültig, bis zu seinem Enddatum, dieses nicht eingeschlossen:
def valid_at(item: dict, at: str) -> bool:
    return item["valid_from"] <= at and (
        item["valid_to"] is None or at < item["valid_to"]
    )
Paris beginnt am 10. Januar, daher bleibt für die Frage vom 5. Januar nur Berlin übrig. Am 12. Januar ist Paris gültig und Berlin nicht.
Python-Code führte diese Konfiguration auf allen 20 Szenarien aus. Die Erfolgsquote stieg von 13/20 auf 19/20, und die Hard Checks bestanden. Die Kampagne änderte beide Filter in einem Schritt und maß daher nur ihre gemeinsame Wirkung; die Wiederholungen mit einzelnen Einstellungen weiter unten trennen sie. Der Runner behielt diese Konfiguration als Ausgangspunkt für den nächsten Vorschlag und gab ihre Ergebnisse an den Agent zurück.
Nach den Filtern schlug noch ein Szenario fehl, und einige Geschichten speicherten dieselbe Bestätigung doppelt. Die erste Kampagne traf insgesamt vier Entscheidungen:
| Entscheidung | Evidenz und vorgeschlagene Änderung | Gemessenes Ergebnis auf denselben 20 Szenarien |
|---|---|---|
| 1 | Themen- und Datumsfilter aktivieren, nach Antworten mit falschem Thema und falschem Datum | 13/20 → 19/20; als nächster Ausgangspunkt behalten |
| 2 | Wiederholte Bestätigungen language = German deduplizieren | 19/20; durchschnittlich gespeicherte Datensätze 1.70 → 1.60 |
| 3 | min_confidence von 0.7 auf 0.6 senken, für eine nützliche Präferenz mit Score 0.6 | 20/20; durchschnittlich gespeicherte Datensätze 1.65 |
| 4 | Aufhören, weil kein weiterer begründeter Vorschlag blieb | Keine neue Konfiguration getestet |
Bei 0.6 wird die nützliche Präferenz gespeichert, während der unsichere Courier-Fakt mit Score 0.4 unter dem Schwellenwert bleibt. Das erklärt die dritte Änderung bei diesen vorbereiteten Eingaben; die Scores selbst stammen vom Testautor. Die Entscheidung aufzuhören bedeutet, dass der Agent anhand des Feedbacks, das er sah, keine weitere Änderung begründen konnte. Sie beweist nicht, dass diese Konfiguration die bestmögliche ist.
Die Validierung hat auch schon eine Antwort abgelehnt. In einem separaten Entwicklungslauf zitierte ein Agent eine Kandidaten-ID, als wäre sie ein Szenario-Ereignis. Die Antwort entsprach dem JSON Schema, aber der Verweis existierte in der gelieferten Ereignis-Evidenz nicht. Python-Code lehnte den Vorschlag ab, bevor er ihn testete, und gab den Validierungsfehler zurück. Keine der drei aufgezeichneten Kampagnen unten hatte eine solche Ablehnung.
Wenn ein ausgewerteter Patch den Score verschlechtert, behält der Runner den vorherigen Ausgangspunkt und hält den gescheiterten Versuch fest. Ein skriptgesteuerter Test deckt diesen Pfad ab; die drei Live-Kampagnen deckten ihn nicht ab. Das abgelehnte Ergebnis in der Historie zu behalten gibt dem Vorschlagsgeber einen Grund, als Nächstes eine andere Änderung zu wählen, statt dieselbe Vermutung zu wiederholen.
Wiederholung, Kosten und Übernahme
Das Memory-Tool ist deterministisch: Dieselbe Konfiguration auf demselben Szenario liefert dieselbe Antwort. Die Unsicherheit liegt darin, was der Agent wählt. Die Studie führte die gesamte Suche deshalb dreimal aus, jeweils ab der Baseline mit 13/20, mit frischer Agent-Historie und höchstens vier Model-Entscheidungen. Alle drei Kampagnen wählten dieselben drei Patches, erreichten 20/20 auf denselben Szenarien und hörten dann auf. Das sind 12 Model-Aufrufe, neun ausgewertete Vorschläge und drei Stopp-Entscheidungen.
In der Studie vom 11. September 2026 war der Vorschlagsgeber gpt-5.6-luna mit niedrigem Reasoning-Aufwand. Mit den veröffentlichten Model-Preisen bewertet, ergibt der aufgezeichnete Token-Verbrauch etwa USD 0.04 für die 12 Aufrufe, bei einem konfigurierten Budget von USD 0.50. Das ist eine Schätzung aus dem aufgezeichneten Verbrauch und keine Rechnung, und sie enthält keine Entwicklungszeit.
Diese wiederholten Ergebnisse zeigen, dass dieses Model bei diesem Prompt, diesem Zielobjekt und dieser Menge von Szenarien einem nützlichen Pfad folgte. Sie zeigen nicht, dass ein neuer Memory-Workload bestehen wird. Der eingefrorene Kampagnenbericht und das Evidenzarchiv mit Prüfsumme des Begleitprojekts enthalten die aufgezeichneten Anfragen, Antworten, Validierungen und Ergebnisse.
Eine Konfiguration, die der Runner behält, ist nur der Ausgangspunkt für das nächste Experiment. Sie ist kein Release. In den Berichten des Begleitprojekts wartet die Übernahme noch auf ein Review durch einen Menschen, und die Kampagnen haben nichts deployt. Ein Reviewer müsste die Änderung weiterhin gegen die eigene Last, die eigenen Zugriffsregeln, das eigene Kostenziel und den eigenen Rollback-Plan prüfen.
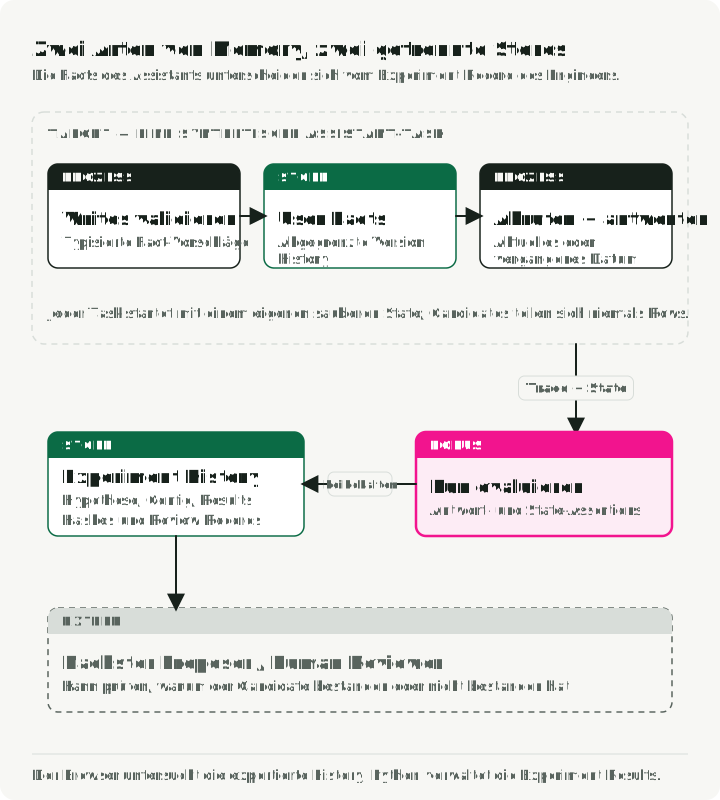
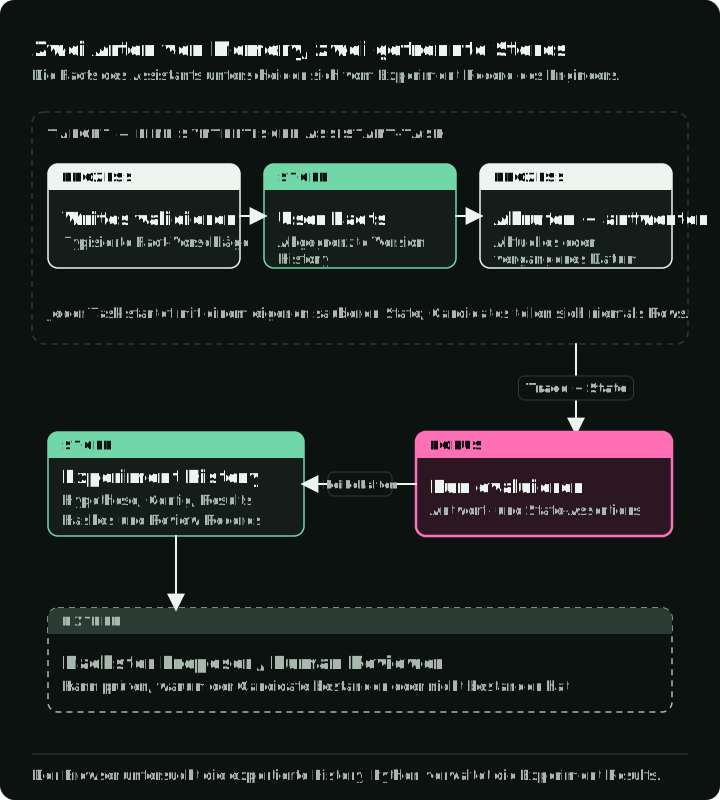
Das Experiment erzeugt außerdem eigene Datensätze, und sie brauchen eine andere Behandlung als Adas Fakten. Das Memory-Tool speichert ihre Stadt. Die Experimenthistorie speichert jede Anfrage, jeden Vorschlag, jedes Validierungsergebnis, jede Testversion und jedes Ergebnis, mit den Hashes, die nötig sind, um eine Entscheidung später zu erklären. In dieser synthetischen Studie können diese Datensätze öffentlich sein. In einer echten Anwendung würde das Löschen eines Nutzerfakts aus dem Live-Memory-Store Kopien in Experiment-Logs oder Backups nicht entfernen. Eine Richtlinie zu Aufbewahrung und Löschung muss diese Datensätze getrennt abdecken.
Brauchte diese Suche ein LLM?
Die Kampagnen zeigen, dass der Loop funktioniert: Ein LLM las Traces, schlug Einstellungen vor und änderte seinen nächsten Vorschlag nach dem Feedback. Sie zeigen nicht, dass ein LLM für dieses Problem der richtige Vorschlagsgeber war. Um das zu prüfen, habe ich das unveränderte Memory-Tool auf denselben 20 Szenarien erneut ausgeführt und dabei jeweils eine Einstellung geändert, mit dem Skript für das Einstellungsraster des Begleitprojekts. Diese Läufe machen keine Model-Aufrufe, und jede Konfiguration braucht nur einen Lauf, weil das Tool deterministisch ist.
| Konfiguration | Bestandene Szenarien |
|---|---|
| Baseline | 13/20 |
| Nur Themenfilter | 16/20 |
| Nur Datumsfilter | 16/20 |
| Nur Deduplizierung | 13/20 |
Nur min_confidence = 0.6 | 14/20 |
| Beide Filter | 19/20 |
Beide Filter, Deduplizierung, min_confidence = 0.6 | 20/20 |
Jeder Filter behebt allein drei Szenarien, zusammen beheben sie sechs. Deduplizierung ändert keine Antwort; sie reduziert nur die gespeicherten Datensätze.
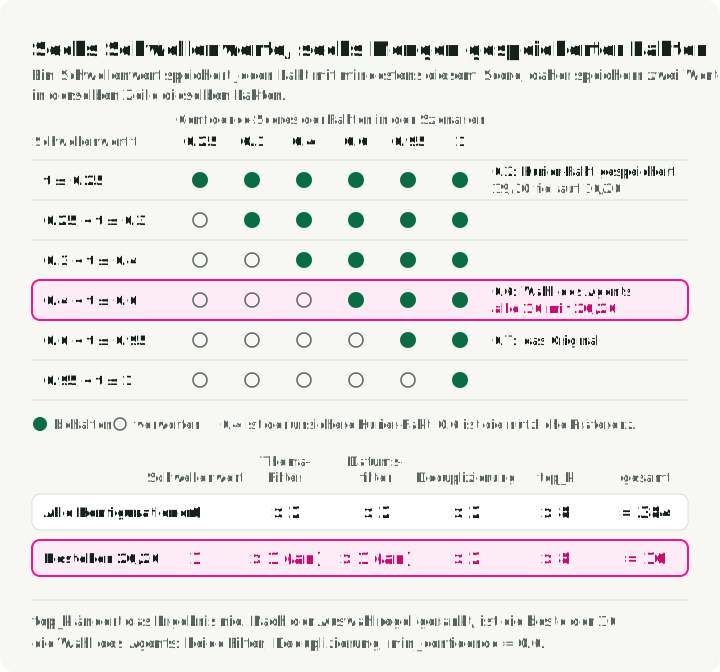
Danach habe ich jede Kombination getestet. Die Fakten in den Szenarien haben sechs Confidence-Scores: 0.25, 0.3, 0.4, 0.6, 0.95 und 1. Ein Schwellenwert speichert jeden Fakt, dessen Score mindestens so hoch ist, daher speichern 0.45 und 0.55 genau dieselben Fakten. Ein Schwellenwert pro Lücke zwischen benachbarten Scores genügt, und sechs Werte decken jedes unterschiedliche Schreibverhalten in diesen Szenarien ab.
Mit diesen sechs Schwellenwerten, drei Ein/Aus-Einstellungen und acht top_k-Werten ergeben sich 384 Konfigurationen. Das Skript führt jede davon auf den 20 Szenarien aus und ist in weniger als einer Sekunde fertig.
Sechzehn Konfigurationen bestehen 20/20. Alle aktivieren beide Filter und verwenden einen Schwellenwert über 0.4 und höchstens 0.6; top_k ändert das Ergebnis nie. Nach der oben genannten Auswahlregel gerankt, ist die beste Konfiguration die, die der Agent gefunden hat: beide Filter, Deduplizierung und min_confidence = 0.6, mit 1.65 gespeicherten Datensätzen pro Szenario. Der gespeicherte Bericht listet jedes Ergebnis mit dem Hash des Quellcodes auf.
Im Bild ist jede Zeile ein Bereich von Schwellenwerten, die ausgefüllten Punkte sind die Fakten, die er speichert, und die markierte Zeile enthält alle 16 bestandenen Konfigurationen.
Dieses Raster ist kein fairer Vergleich mit dem Agent. Es nutzt mein Wissen über die Confidence-Scores in den Testdaten und ignoriert das Limit des Agents von vier Entscheidungen. Es zeigt nur, dass dieser Suchraum klein genug ist, um ihn vollständig zu testen, und deshalb keinen LLM-Vorschlagsgeber brauchte.
Das Raster und der Agent sind zwei von vier Möglichkeiten, die Auswahl der Experimente zwischen Menschen und Software aufzuteilen:
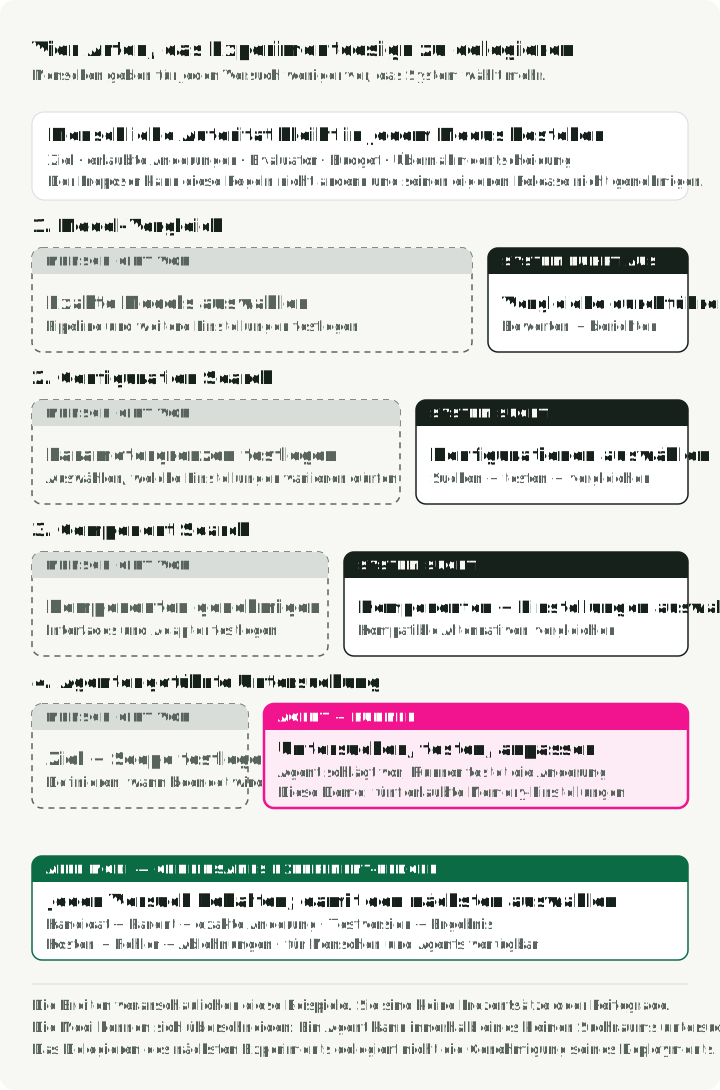
- Model-Vergleich. Sie wählen die genauen Models oder Varianten; das System führt sie aus und bewertet sie. Ein LLM-Vorschlagsgeber ist nicht nötig.
- Konfigurationssuche. Sie wählen, welche Einstellungen variieren dürfen und in welchen Grenzen; ein Raster, eine Zufallssuche oder ein Optimizer wie Optuna wählt die Werte. Das Raster oben ist dieser Modus.
- Komponentensuche. Sie genehmigen austauschbare Komponenten mit festen Schnittstellen, und die Suche wählt Komponenten und Einstellungen. Die Pipeline-Suche von Scikit-learn macht das mit gewöhnlicher Rastersuche, daher macht das Austauschen von Komponenten den Prozess allein noch nicht agentic.
- Agent-geführte Untersuchung. Ein Agent liest Fehler und frühere Ergebnisse, schlägt die nächste Änderung vor und passt sich nach jedem Test an, wie die Kampagnen oben. Hybride gibt es auch: MIPROv2 von DSPy lässt ein Model Anweisungen vorschlagen und durchsucht deren Kombinationen mit Bayesscher Optimierung.
In jedem Modus behalten die Menschen das Ziel, die erlaubten Änderungen, den Evaluator, das Budget und die Entscheidung über die Übernahme. Alle Modi können in dieselbe Experimenthistorie schreiben, die das Diagramm Ledger nennt: jeden Kandidaten und seinen Vorgänger, die genaue Änderung und wer sie geliefert hat, die Testversion, das Ergebnis, die Kosten und jede Ablehnung. Mit diesem Datensatz können Sie den nächsten Vorschlag an einen Agent übergeben oder zurücknehmen, ohne Evidenz zu verlieren. Der Runner des Begleitprojekts akzeptiert über lab evaluate auch einen Kandidaten, den eine Person liefert.
Entscheiden Sie zuerst, welcher dieser Modi zu Ihrem System passt. Wenn die erlaubten Änderungen aus wenigen Einstellungen mit bekannten Bereichen bestehen und jeder Test günstig ist, zählen Sie sie auf oder nutzen Sie einen Standard-Optimizer, bevor Sie ein LLM hinzunehmen. Ein LLM-Vorschlagsgeber kann helfen, wenn die Wahl einer Änderung erfordert, unterschiedliche Fehler-Traces, Quellcode und Wechselwirkungen zwischen Komponenten zu lesen, und wenn die Kandidaten zu zahlreich oder zu unstrukturiert zum Auflisten sind. Ob es dort hilft, sollten Sie messen, nicht annehmen.
Auf Ihr System anwenden
Wählen Sie einen Trace, der einen echten Fehler zeigt. Halten Sie dann vier Dinge schriftlich fest, bevor eine Suche beginnt:
- welche Änderungen erlaubt sind;
- welche Aufgabenergebnisse und verbotenen Effekte der Evaluator prüft;
- was jeder Versuch kosten darf;
- wer einen Kandidaten übernehmen darf.
Probieren Sie die einfachste Suche, die die erlaubten Änderungen abdeckt. Prüfen Sie dann, ob das Ergebnis das nächste Experiment oder eine Release-Entscheidung ändert. Ändert es keins von beiden, hat der Loop nichts verbessert.
Optional: das Begleitprojekt untersuchen und ausführen
Sie können die aufgezeichnete Studie ohne API-Schlüssel untersuchen. Der Tag v0.2.3 enthält das Memory-Tool, die aufgezeichneten Studien und das Einstellungsraster. Mit installiertem uv klonen Sie das Repository, stellen die aufgezeichnete Evidenz wieder her, verifizieren sie, führen das Raster erneut aus und starten einen lokalen Viewer für die aufgezeichneten Kampagnen:
git clone --branch v0.2.3 --depth 1 https://github.com/slavadubrov/meta-engineering-ai-lab.git
cd meta-engineering-ai-lab
uv sync --frozen
uv run --frozen python scripts/fetch_evidence.py
uv run --frozen python -m lab verify artifacts/agent-study-03 --source
uv run --frozen python scripts/settings_grid.py --check
uv run --frozen python -m lab serve --port 8075
Öffnen Sie http://127.0.0.1:8075/web/, um eine aufgezeichnete Kampagne vom Vorschlag bis zum Feedback zu verfolgen. Der Download wird gegen eine festgelegte Prüfsumme geprüft, und nichts in diesem Block macht einen Model-Aufruf. Der Lauf mit --check berechnet das Raster neu und schlägt fehl, wenn der gespeicherte Bericht nicht mehr zum Code passt.
Um eine neue, kostenpflichtige Vorschlagskampagne auszuführen, speichern Sie OPENAI_API_KEY in der ignorierten Datei .env.local des Repositorys und wählen ein neues Ausgabeverzeichnis:
uv run --frozen --env-file .env.local python -m lab campaign \
  --live --campaigns 3 --iterations 4 --budget-usd 0.50 \
  --output artifacts/my-agent-study
Das ausdrückliche Flag --live aktiviert Aufrufe beim Anbieter. Sehen Sie sich artifacts/my-agent-study/report.md für die entstandenen Vorschläge und Kosten an. Das Model kann einen anderen Weg nehmen, auch wenn Python jede gegebene Konfiguration gleich bewertet. Die Anleitung zum Memory-Tool zeigt die vorbereiteten JSON-Eingaben, gespeicherte Datensätze und vier von Hand festgelegte Konfigurationen, wenn Sie das deterministische Zielobjekt verstehen möchten, ohne den Agent auszuführen.
Wie die Serie weitergeht
Das Memory-Tool war absichtlich klein: Fünf Einstellungen und 20 Szenarien machen jeden Schritt nachvollziehbar. Dieselbe Größe ist zugleich seine Grenze. Ein Skript kann jede Konfiguration testen, daher kann dieses Beispiel nicht zeigen, wann sich ein LLM-Vorschlagsgeber lohnt.
Spätere Teile dieser Serie nutzen ein größeres Zielobjekt: den Customer-Support-Harness aus Einen Agent-Harness entwerfen, Teil 1 von Building and Evaluating Agent Harnesses. Ein Coding Agent wird Änderungen an diesem Harness vorschlagen, und seine Ergebnisse werden mit einfacherer Suche verglichen. Der Improver bearbeitet sich nicht selbst, und eine Person prüft jede Übernahme.
Dieser Harness braucht zuerst einen stärkeren Evaluator. Sieben seiner zwölf Support-Aufgaben erwarten keine Datenbankänderung, daher besteht ein Agent, der nichts tut, bereits 7 von 12 Zustandsprüfungen. Ein Coding Agent, der nur nach diesen Prüfungen bewertet wird, könnte mehr davon bestehen, indem er den Support-Agent weniger tun lässt.