Мета-инжиниринг AI-систем: от трейсов к улучшению памяти

Автоматический перевод
Эта статья была автоматически переведена с оригинальной английской версии.
Эта статья для инженеров, которые хотят, чтобы агент выяснял, почему их AI-система даёт сбои, и предлагал исправления. Пример: небольшой инструмент памяти отвечает на вопрос, где живёт пользователь, и отвечает неверно. Вы увидите, как предлагают изменение этого инструмента, проверяют его на 20 подготовленных сценариях и оценивают до того, как кто-то его примет. Вы также увидите, как проверить, нашёл бы тот же вариант без LLM обычный скрипт, который перебирает все настройки. В сопутствующем эксперименте изменения предлагал LLM, а проверял их обычный Python.
Мета-инжинирингом я называю проектирование этого процесса улучшения. Оно сводится к четырём решениям. Что может менять генератор предложений, то есть человек или программа, которые предлагают изменения? Какие результаты считаются улучшением? Как результат влияет на следующее предложение? Кто решает принять изменение? Эти четыре решения одинаковы, кто бы ни был генератором предложений: LLM, человек или перебор параметров.
Сбой с неверным городом
Инструмент памяти хранит факты о пользователе Аде и отвечает на вопросы о ней. Один тест, сценарий с будущим переездом, отправляет ему четыре события:
- Сохранить
city = Berlin, действует с 1 января. - Сохранить
city = Paris, получено 3 января, но действует с 10 января. - Спросить город на 5 января. Ожидается Berlin.
- Спросить город на 12 января. Ожидается Paris.
Исходный инструмент оба раза отвечает Paris. На 12 января это верно. На 5 января это ошибка: Ада ещё не переехала.
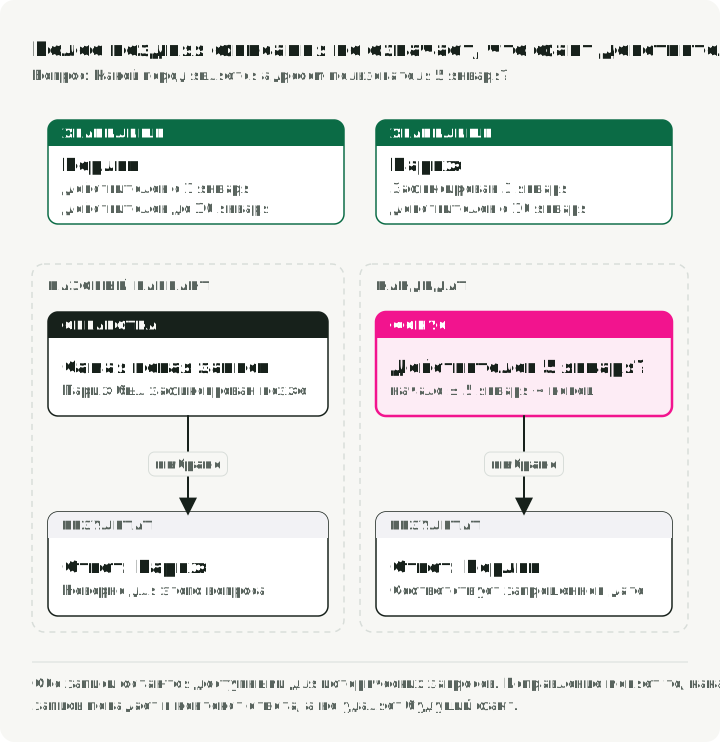
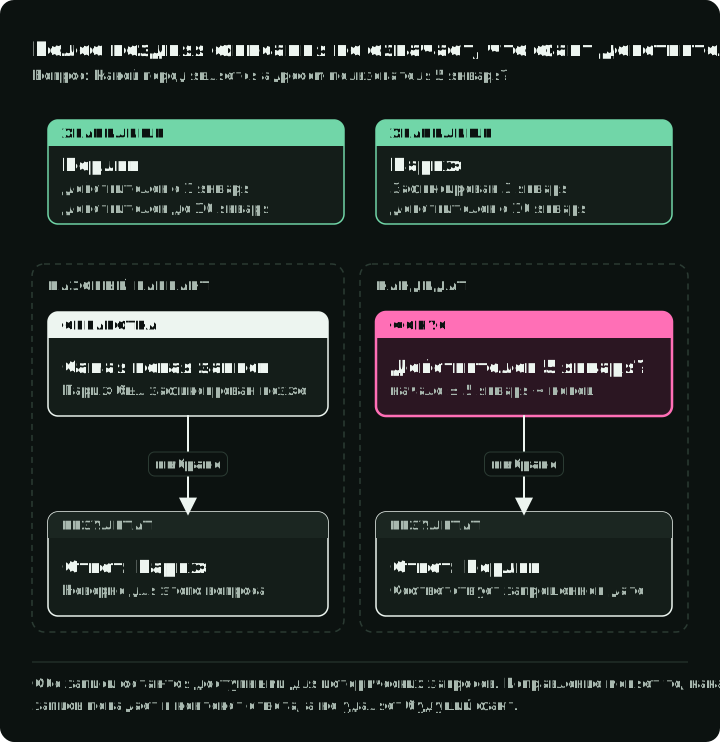
Каждый запуск теста оставляет трейс: сохранённую запись всех событий, отправленных инструменту, записей, которые он сохранил, и ответов, которые он дал. Сохранённый трейс этого сценария показывает, что у обеих записей правильные даты действия. Berlin действует с 1 по 10 января, Paris с 10 января без даты окончания. Ошибка в retrieval: он ставит Paris, полученный позже, выше Berlin и не проверяет, какой факт действовал на запрошенную дату. Сохранить будущий переезд было правильно.
Значит, запись про Paris нужно оставить, а для retrieval нужен фильтр по дате. Этот диагноз ещё не оправдывает принятие фильтра. Тот же код retrieval отвечает на вопросы о других субъектах, обрабатывает удаления и обязан разделять записи разных пользователей. Изменение, которое исправляет 5 января, но ломает эти случаи, делает инструмент памяти хуже. Процесс улучшения должен заметить это раньше, чем новая версия дойдёт до пользователей.
Два цикла
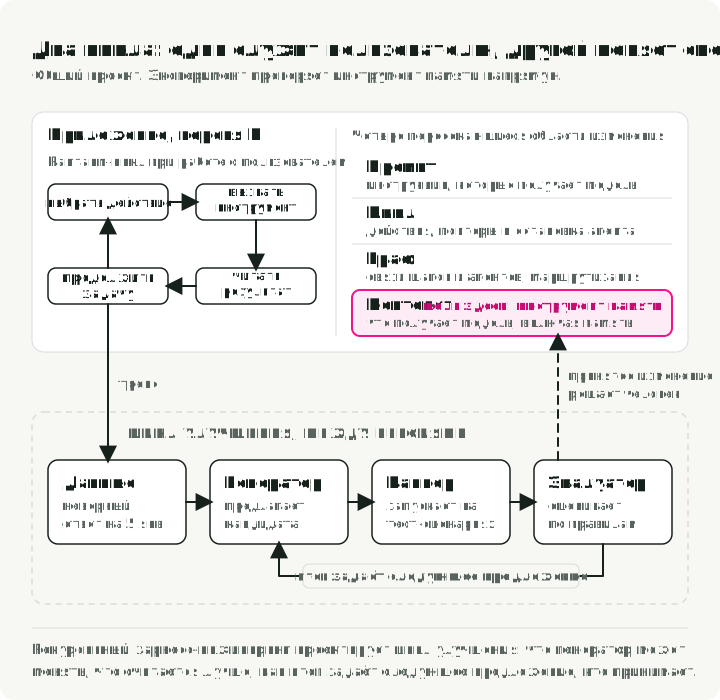
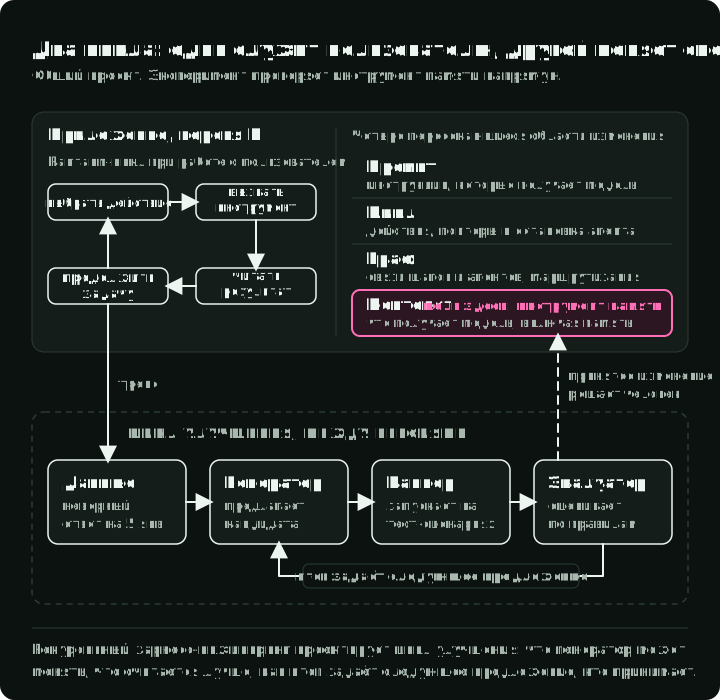
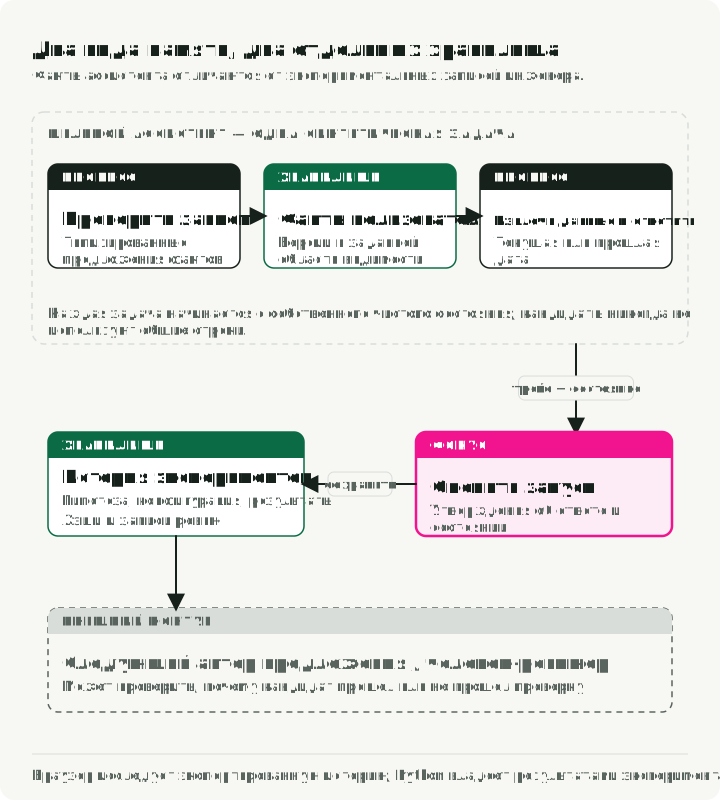
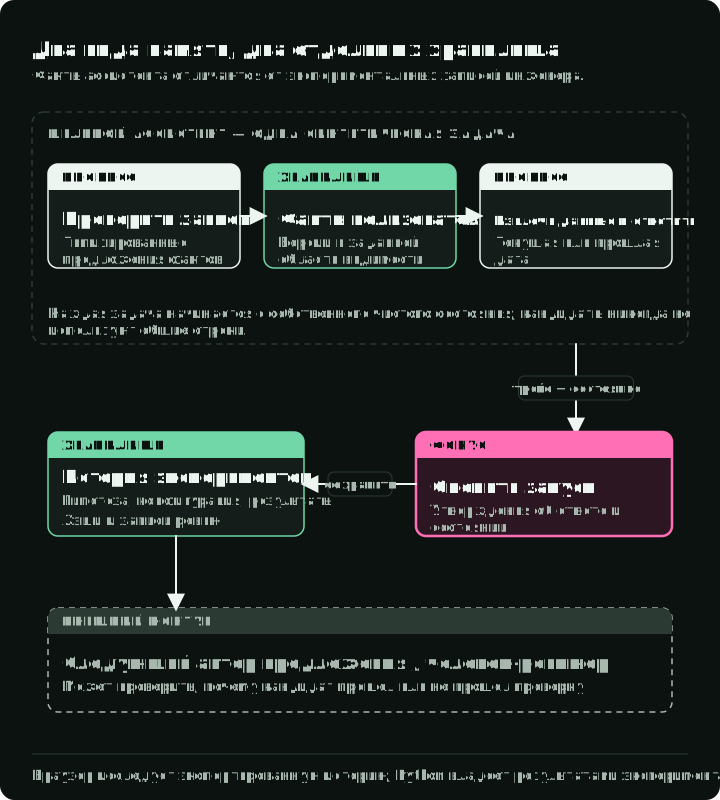
Агентное приложение выполняет цикл, пока обслуживает пользователя. В этом цикле выполнения оно выбирает действие, вызывает инструмент, читает результат и продолжает задачу пользователя. Агент, использующий инструмент памяти, мог бы получить в этом цикле неверный ответ про город. Этот эксперимент вызывает инструмент напрямую с фиксированными тестовыми событиями.
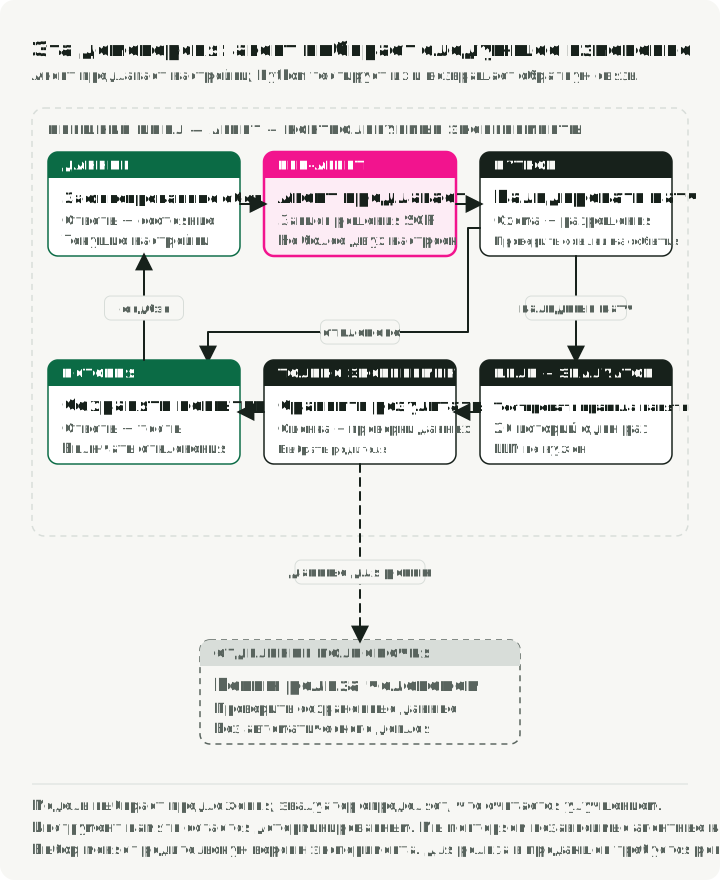
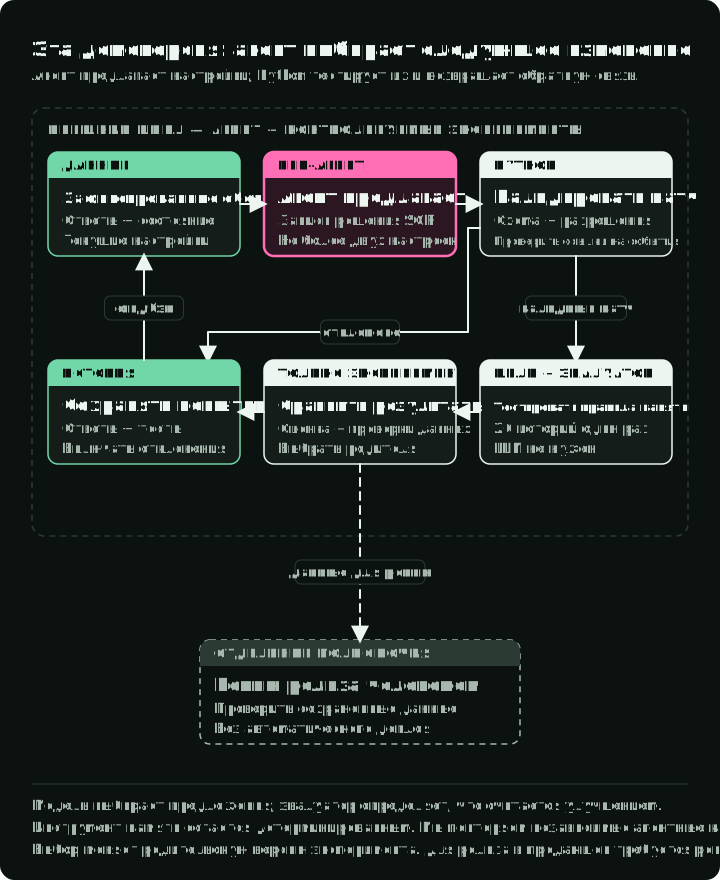
Чтобы исправить сбой, нужен второй цикл, который работает между версиями приложения. Этот цикл улучшения начинается с доказательства сбоя: ответа на 5 января, записи, которую изменили, хотя менять её было нельзя, или слишком высокой стоимости. Генератор предложений предлагает кандидата: одну конкретную версию изменения цели, то есть той части системы, которую улучшают. Здесь цель — инструмент памяти, а кандидат — новый набор его настроек. Раннер запускает кандидата на фиксированном наборе тестовых сценариев, а эвалуатор проверяет результаты по правилам, которые заложены в эти сценарии. Цикл замкнут только тогда, когда результат меняет следующее предложение или решение о принятии изменения.
Диаграмма показывает общий проект приложения, где целью может быть любая его часть. Инженеры часто делят эти части на четыре пересекающиеся области. Промпт-инжиниринг меняет инструкции. Контекст-инжиниринг меняет то, какую информацию получает модель, включая память. Инжиниринг цикла меняет то, как агент действует, повторяет попытки и останавливается в цикле выполнения. Инжиниринг графа меняет то, как связаны шаги или агенты и как между ними распределяется работа. Мета-инжиниринг считает выбор в любой из этих четырёх областей, например формулировку промпта или число повторов, настройкой, которую может менять эксперимент. Он оценивает каждого кандидата по качеству ответов всей системы, стоимости и обязательному поведению, например по тому, что данные одного пользователя никогда не показываются другому.
Два недавних проекта уже используют агента-программиста как генератора предложений. В autoresearch Карпати агент редактирует один файл обучения и запускает его с фиксированным бюджетом времени. Каждая попытка записывается как сохранённая, отброшенная или завершившаяся падением, а код оценки лежит в отдельном файле, который агент не редактирует. Meta-Harness, препринт марта 2026 года, позволяет генератору предложений читать исходный код, оценки и трейсы прежних кандидатов. С их помощью он улучшает код, который решает, что LLM-приложение сохраняет, извлекает и показывает своей модели. В этой статье цель гораздо меньше: инструмент памяти, чтобы каждый шаг можно было проверить.
Ограничьте то, что может менять генератор предложений
LLM никогда не работает внутри инструмента памяти. Он читает неудачные трейсы и результаты оценки, а затем предлагает новую конфигурацию: значения настроек инструмента. Эту конфигурацию проверяет Python.
Сам инструмент памяти — обычный детерминированный Python. Он получает структурированные факты, сохраняет или отклоняет их и возвращает значение по запросу. Он не извлекает факты из разговора и не пишет ответ на естественном языке, поэтому этот цикл не исправит сбой извлечения фактов. У каждого сохранённого факта есть владелец, исходное событие и интервал действия, по правилам хранимого состояния из Schema-Guided Agent Memory.
У каждого входящего факта есть также оценка уверенности, которую задал автор теста. Инструмент сохраняет факт, только если оценка не ниже min_confidence. Оценки входят в тестовые данные и не являются вероятностями, измеренными у модели. Например, неуверенный факт delivery = courier с оценкой 0.4 отклоняется при исходном пороге 0.7, но сохраняется при 0.2.
Запись Paris после второй записи показывает, как запись хранит свою историю. observed_at — день, когда инструмент узнал факт, а valid_from — день, когда он становится верным (фрагмент):
{
    "id": "m002",
    "key": "city",
    "value": "Paris",
    "valid_from": "2026-01-10",
    "valid_to": null,
    "observed_at": "2026-01-03",
    "source_event_id": "future-move:event-2",
    "supersedes_memory_id": "m001"
}
source_event_id указывает на событие, которое принесло Paris, а supersedes_memory_id связывает запись с записью Berlin m001. Для конфликтов у инструмента есть фиксированные правила записи. Если более позднее событие сообщает Rome, тоже с 10 января, инструмент отклоняет его, и Paris остаётся без изменений. Повторный Paris на ту же дату использует существующую запись, а обновление с более ранней датой вступления в силу отклоняется. Генератор предложений не может менять эти правила.
Генератор предложений может менять пять существующих настроек:
| Настройка | Что даёт её изменение |
|---|---|
min_confidence | Меняет минимальную оценку уверенности, нужную для сохранения факта. |
filter_entity | Ограничивает retrieval запрошенным субъектом, например домом, а не работой. |
time_aware | Ограничивает retrieval фактами, действующими на запрошенную дату. |
deduplicate | Использует существующий активный факт вместо сохранения ещё одного подтверждения. |
top_k | Задаёт, сколько лучших по рангу записей инструмент учитывает при ответе. |
Одно предложение меняет не более двух настроек; min_confidence лежит в диапазоне от 0 до 1, top_k — от 1 до 8. Агент не может редактировать код, тесты или ожидаемые ответы и не может сам одобрить своё изменение. Его вывод — данные, которые проверяет Python, а не код для запуска. Это ограничение задают в коде контракт конфигурации и валидатор предложений.
Поскольку этот генератор предложений может присылать только настройки, он не может изменить эвалуатор. Однако эвалуатор работает в том же процессе Python, что и инструмент памяти. Поэтому агент, которому разрешено писать и запускать собственный код, мог бы изменить проверки. Такому агенту нужен эвалуатор в отдельном процессе со своими правилами доступа к файлам и сети, прежде чем его результатам можно будет доверять.
Правило оценки
Для истории с городом тест должен задавать оба вопроса: Berlin на 5 января и Paris на 12 января. Если проверять только первый ответ, получит награду инструмент, который просто выбрасывает будущий факт. В сопутствующем проекте сценарий — это одна полная история из событий write, query и иногда delete, как четыре события выше. Каждый кандидат проходит одни и те же 20 подготовленных сценариев, каждый с пустой памятью. Исходная конфигурация проходит 13 из них.
Сценарий проходит, только если каждый ожидаемый ответ верен и ни одно правило данных не нарушено. Эвалуатор проверяет три правила данных, которые называются жёсткими проверками: один владелец никогда не видит факты другого, удалённый факт исчезает, и вход, помеченный как запрещённый, не сохраняется. Он также считает записи, которые сохранил инструмент.
Чтобы выбрать между кандидатами, правило выбора сначала отбрасывает любого кандидата, который не прошёл жёсткую проверку. Из оставшихся оно предпочитает того, кто проходит больше сценариев. Если проходят поровну, оно предпочитает того, кто хранит меньше записей. Поэтому изменение, которое только сокращает хранилище, может победить при тех же ответах, но никогда не победит изменение, дающее верные ответы в большем числе сценариев.
Одного улучшившегося числа недостаточно, чтобы принять изменение. Возьмём снижение min_confidence с 0.7 до 0.2. Сохраняется больше полезных фактов, например предпочтение, пришедшее с низкой оценкой. Сохраняется и неуверенный факт delivery = courier, и он заменяет подтверждённое значение. В подготовленном вручную сравнении это изменение исправило один сценарий, но сломало четыре, поэтому успешность упала с 19/20 до 16/20, хотя все жёсткие проверки прошли. Доля сохранённых полезных фактов выросла, а итоговые ответы стали хуже. Этого кандидата агент не предлагал ни в одной из кампаний ниже; он показывает, почему оценка считает полные сценарии.
У проверок есть пределы. Тест передаёт идентификаторы владельцев напрямую, поэтому изоляция владельцев здесь не проверяет аутентификацию. Проверка запрещённой записи отклоняет только входы, которые тест уже пометил как запрещённые; она не найдёт вредоносную инструкцию, спрятанную в обычном тексте. И генератор предложений видит все 20 сценариев, поэтому ни один из них не работает как скрытая тестовая выборка. Проходной балл говорит нам, что произошло на этих случаях, а не как поведёт себя неизвестное приложение.
Дайте каждому предложению проверяемую причину
Эксперимент шёл кампаниями. Кампания — это одна попытка улучшить исходную конфигурацию, которая начинается с чистой истории агента. Каждая итерация — это один вызов модели, в котором агент предлагает изменение или решает остановиться. В первом запросе агент получает текущие настройки и их смысл, результаты базовой конфигурации, трейсы проваленных сценариев, допустимые изменения, а в поздних итерациях ещё и прежние предложения с их результатами.
Каждый ответ должен заполнять одни и те же пять полей. Этот формат следует Schema-Guided Reasoning (SGR): ответ — это запись решения, которую ревьюер может проверить по полям.
| Поле | Что может проверить ревьюер |
|---|---|
observations | Какой сценарий и какое событие из предоставленных подтверждают предлагаемое изменение? |
hypothesis | Какое правило, судя по всему, вызывает проблему? |
predicted_effect | Что должно улучшиться при проверке изменения? |
action | Агент предлагает изменение или останавливается? |
patch | Какие разрешённые настройки нужно изменить? |
Запрос задаёт эту структуру строгой JSON Schema через OpenAI Structured Outputs. Схема ограничивает форму ответа; она не доказывает гипотезу. Затем Python проверяет, существуют ли процитированные события в предоставленных ему доказательствах, укладывается ли патч в разрешённые настройки и не проверялась ли уже такая конфигурация. Ответ может соответствовать схеме и всё равно не пройти эти проверки.
В первой записанной итерации агент сослался на сбой с будущим переездом и на второй сбой, где факт о рабочем адресе Ады ответил на вопрос о домашнем. Он предложил включить оба фильтра, по субъекту и по дате:
{ "filter_entity": true, "time_aware": true }В реализации эти настройки убирают неподходящие записи до ранжирования. Фильтр по субъекту отбрасывает факты о других субъектах, поэтому факт work не ответит на вопрос про home. Фильтр по дате оставляет только факты, действовавшие на дату вопроса. Факт действует от даты начала до даты окончания, не включая её:
def valid_at(item: dict, at: str) -> bool:
    return item["valid_from"] <= at and (
        item["valid_to"] is None or at < item["valid_to"]
    )
Paris начинается 10 января, поэтому на вопрос про 5 января остаётся только Berlin. На 12 января действует Paris, а Berlin уже нет.
Python прогнал эту конфигурацию на всех 20 сценариях. Успешность выросла с 13/20 до 19/20, жёсткие проверки прошли. Кампания изменила оба фильтра за один шаг, поэтому измерила только их совместный эффект; перезапуски с одной настройкой ниже разделяют их вклад. Раннер оставил эту конфигурацию отправной точкой для следующего предложения и вернул агенту её результаты.
После фильтров один сценарий всё ещё не проходил, а в некоторых историях одно и то же подтверждение сохранялось дважды. Первая кампания приняла четыре решения:
| Решение | Доказательство и предложенное изменение | Измеренный результат на тех же 20 сценариях |
|---|---|---|
| 1 | Включить фильтры по субъекту и дате после ответов с неверным субъектом и неверной датой | 13/20 → 19/20; оставлено как следующая отправная точка |
| 2 | Убрать дубли повторных подтверждений language = German | 19/20; среднее число сохранённых записей 1,70 → 1,60 |
| 3 | Снизить min_confidence с 0.7 до 0.6 ради полезного предпочтения с оценкой 0.6 | 20/20; среднее число сохранённых записей 1,65 |
| 4 | Остановиться, когда нет больше обоснованных предложений | Новая конфигурация не проверялась |
При 0.6 полезное предпочтение сохраняется, а неуверенный факт о курьере с оценкой 0.4 остаётся ниже порога. Это объясняет третье изменение на этих подготовленных входах; сами оценки задал автор теста. Решение остановиться значит, что агент не нашёл больше изменений, которые мог бы обосновать увиденной обратной связью. Оно не доказывает, что эта конфигурация лучшая из возможных.
Валидация однажды уже отклоняла ответ. В отдельном запуске при разработке агент сослался на идентификатор кандидата так, будто это событие сценария. Ответ соответствовал требованиям JSON Schema, но такой ссылки в предоставленных данных о событиях не было. Python отклонил предложение до проверки и вернул ошибку валидации. Ни в одной из трёх записанных кампаний ниже таких отклонений не было.
Если проверенный патч ухудшает оценку, раннер сохраняет прежнюю отправную точку и записывает неудачную попытку. Эту ветку проверяет скриптовый тест; три кампании с реальными вызовами модели её не проходили. Отклонённый результат остаётся в истории, и у генератора предложений появляется причина выбрать другое изменение, а не повторять ту же догадку.
Повторяемость, стоимость и принятие
Инструмент памяти детерминирован: повторный запуск той же конфигурации на том же сценарии даёт тот же ответ. Неопределённость в том, что выберет агент. Поэтому исследование трижды прогнало весь поиск, каждый раз от базовой конфигурации 13/20, со свежей историей агента и не более чем четырьмя решениями модели. Все три кампании выбрали одни и те же три патча, достигли 20/20 на тех же сценариях и остановились. Это 12 вызовов модели, девять проверенных предложений и три решения остановиться.
В исследовании от 11 сентября 2026 года генератором предложений был gpt-5.6-luna с низким уровнем ризонинга. По опубликованным тарифам модели записанный расход токенов обходится примерно в USD 0.04 за 12 вызовов при настроенном бюджете USD 0.50. Это оценка по записанному расходу, а не счёт, и она не включает время разработки.
Эти повторные результаты показывают лишь, что модель на этом промпте, цели и наборе сценариев шла по одному полезному пути. Они не показывают, что новая нагрузка на память пройдёт. Замороженный отчёт о кампаниях и архив доказательств с контрольной суммой сопутствующего проекта содержат записанные запросы, ответы, проверки и результаты.
Конфигурация, которую оставил раннер, — лишь отправная точка следующего эксперимента. Это не релиз. В отчётах сопутствующего проекта принятие по-прежнему ждёт ревью человеком, а кампании ничего не деплоили. Ревьюеру всё равно пришлось бы проверить изменение на своей нагрузке, правилах доступа, целевой стоимости и плане отката.
Эксперимент также порождает собственные записи, и обращаться с ними нужно иначе, чем с фактами Ады. Инструмент памяти хранит её город. История экспериментов хранит каждый запрос, предложение, результат проверки, версию теста и результат вместе с хэшами, которые позже помогут объяснить выбор. В этом синтетическом исследовании такие записи могут быть публичными. В реальном приложении удаление факта пользователя из рабочего хранилища памяти не сотрёт копии в логах экспериментов или резервных копиях. Политика хранения и удаления должна охватывать эти записи отдельно.
Нужен ли был поиску LLM?
Кампании показывают, что цикл работает: LLM прочитал трейсы, предложил настройки и изменил следующее предложение после обратной связи. Они не показывают, что LLM был подходящим генератором предложений для этой задачи. Чтобы проверить, я перезапустил неизменённый инструмент памяти на тех же 20 сценариях, меняя по одной настройке, с помощью скрипта перебора настроек из сопутствующего проекта. Эти запуски не вызывают модель, а каждой конфигурации нужен один запуск, потому что инструмент детерминирован.
| Конфигурация | Пройдено сценариев |
|---|---|
| Базовая | 13/20 |
| Только фильтр по субъекту | 16/20 |
| Только фильтр по дате | 16/20 |
| Только дедупликация | 13/20 |
Только min_confidence = 0.6 | 14/20 |
| Оба фильтра | 19/20 |
Оба фильтра, дедупликация, min_confidence = 0.6 | 20/20 |
Каждый фильтр в одиночку исправляет три сценария, а вместе они исправляют шесть. Дедупликация не меняет ни одного ответа; она только сокращает число сохранённых записей.
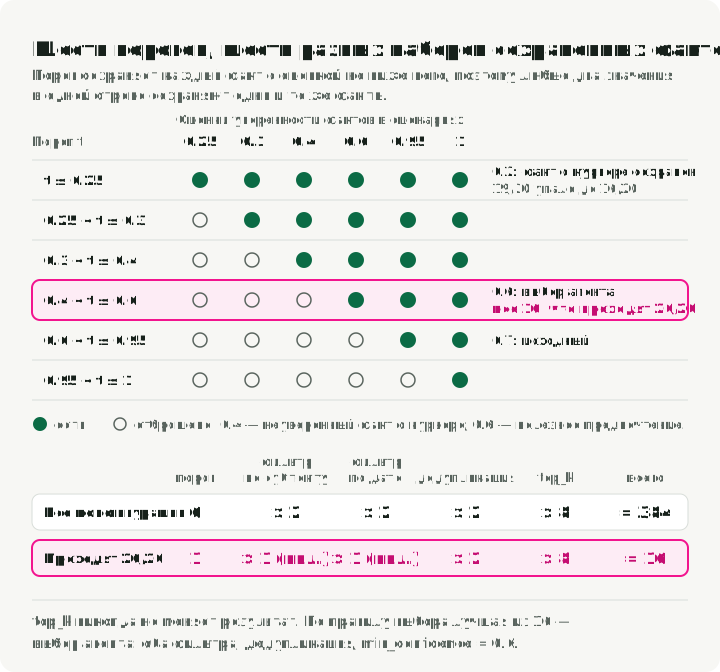
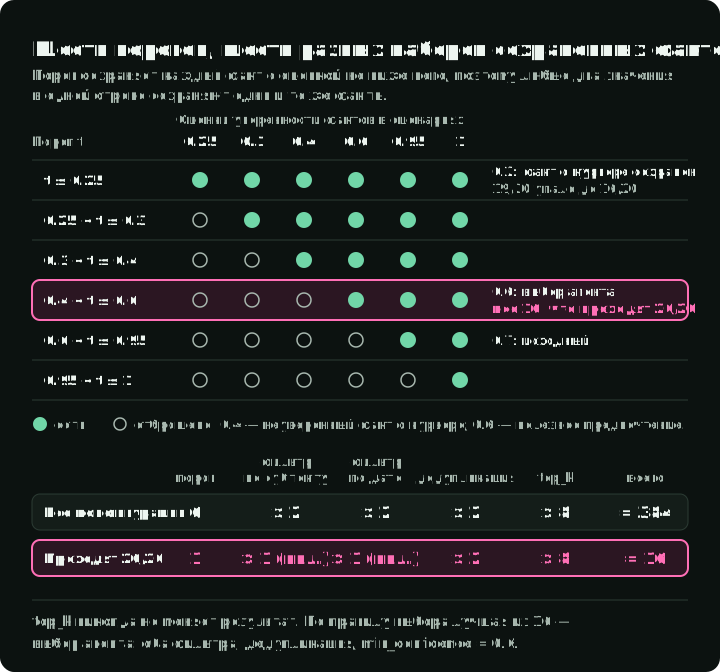
Затем я проверил все комбинации. В сценариях шесть значений оценки уверенности: 0.25, 0.3, 0.4, 0.6, 0.95 и 1. Порог сохраняет каждый факт с оценкой не ниже него, поэтому 0.45 и 0.55 сохраняют ровно одни и те же факты. Достаточно одного значения порога на каждый промежуток между соседними оценками, и шести значений хватает для всех различимых вариантов записи на этих сценариях.
С этими шестью порогами, тремя переключателями и восемью значениями top_k получается 384 конфигурации. Скрипт прогоняет каждую на 20 сценариях и заканчивает меньше чем за секунду.
Шестнадцать конфигураций проходят 20/20. Все они включают оба фильтра и используют порог выше 0.4 и не выше 0.6; top_k никогда не меняет результат. Если ранжировать по правилу выбора выше, лучшая конфигурация та же, что нашёл агент: оба фильтра, дедупликация и min_confidence = 0.6, по 1,65 сохранённой записи на сценарий. Сохранённый отчёт перечисляет все результаты с хэшем исходников.
На рисунке каждая строка — один диапазон порогов, закрашенные точки — факты, которые он сохраняет, а выделенная строка содержит все 16 проходящих конфигураций.
Это сравнение с агентом нельзя считать честным. Оно использует моё знание оценок уверенности в тестовых данных и игнорирует ограничение агента в четыре решения. Оно показывает лишь, что это пространство поиска достаточно мало, чтобы проверить его целиком, и LLM-генератор предложений здесь не был нужен.
Перебор и агент — два из четырёх способов разделить выбор экспериментов между людьми и программами:
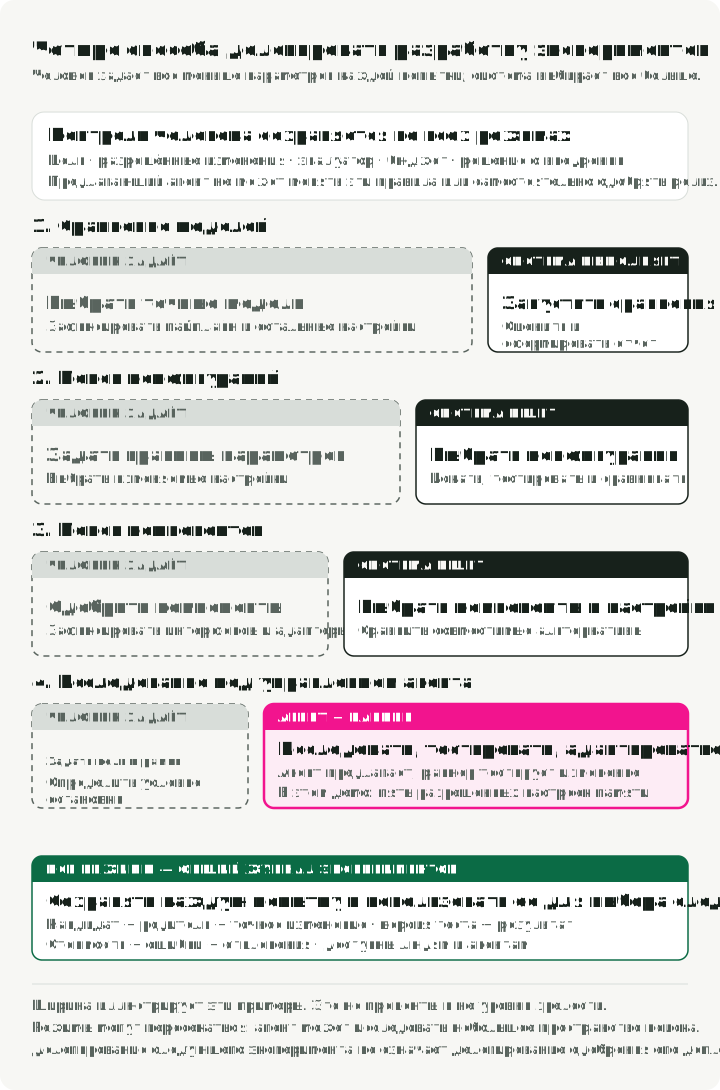
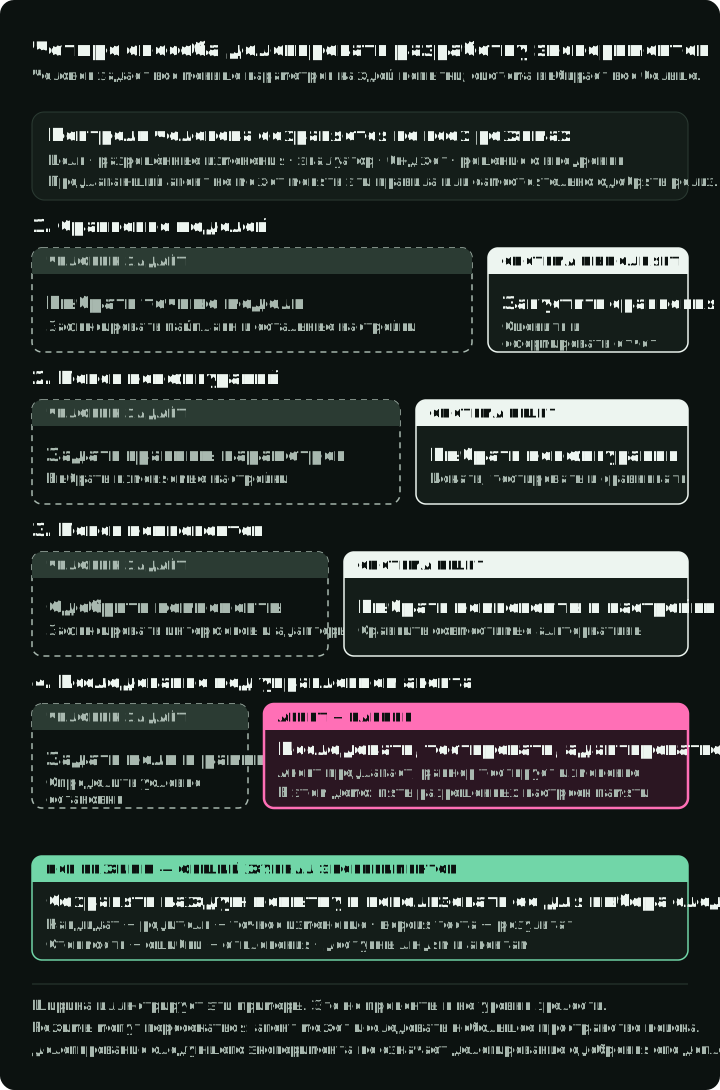
- Сравнение моделей. Вы выбираете точные модели или варианты; система запускает и оценивает их. LLM-генератор предложений не нужен.
- Поиск конфигурации. Вы выбираете, какие настройки можно менять, и их границы; значения подбирает перебор, случайный поиск или оптимизатор вроде Optuna. Перебор выше — именно этот режим.
- Поиск компонентов. Вы одобряете взаимозаменяемые компоненты с фиксированными интерфейсами, а поиск выбирает компоненты и настройки. Поиск по пайплайну в Scikit-learn делает это обычным перебором по сетке, поэтому замена компонентов сама по себе не делает процесс агентным.
- Исследование под управлением агента. Агент читает сбои и прежние результаты, предлагает следующее изменение и подстраивается после каждой проверки, как в кампаниях выше. Бывают и гибриды: в MIPROv2 из DSPy модель предлагает инструкции, а байесовская оптимизация ищет их комбинации.
В каждом режиме люди сохраняют цель, допустимые изменения, эвалуатор, бюджет и решение о принятии. Все режимы могут писать в одну историю экспериментов, которую диаграмма называет журналом. Она хранит каждого кандидата и его родителя, точное изменение и того, кто его предложил, версию теста, результат, стоимость и все отклонения. С такой записью вы можете передать следующее предложение агенту или забрать его обратно, не потеряв доказательства. Раннер сопутствующего проекта также принимает кандидата, предложенного человеком, через lab evaluate.
Сначала решите, какой из этих режимов подходит вашей системе. Если допустимые изменения — это несколько настроек с известными диапазонами и каждая проверка дешёвая, перечислите их или запустите стандартный оптимизатор, прежде чем добавлять LLM. LLM-генератор предложений может помочь, когда для выбора изменения нужно читать разнообразные трейсы сбоев, исходный код и взаимодействия между компонентами, а кандидатов слишком много или они слишком неструктурированы, чтобы их перечислить. Помогает ли он там, нужно измерять, а не предполагать.
Применяем к вашей системе
Выберите один трейс, который показывает реальный сбой. Затем запишите четыре вещи до начала любого поиска:
- какие изменения разрешены;
- какие результаты задач и запрещённые эффекты проверяет эвалуатор;
- сколько может стоить каждая попытка;
- кто может принять кандидата.
Попробуйте самый простой поиск, который покрывает разрешённые изменения. Затем проверьте, меняет ли результат следующий эксперимент или решение о релизе. Если не меняет ни то ни другое, цикл ничего не улучшил.
Необязательно: изучите и запустите сопутствующий проект
Записанное исследование можно изучить без ключа API. Тег v0.2.3 содержит инструмент памяти, записанные исследования и скрипт перебора настроек. Если установлен uv, склонируйте репозиторий, восстановите записанные доказательства, проверьте их, перезапустите перебор и запустите локальный просмотрщик записанных кампаний:
git clone --branch v0.2.3 --depth 1 https://github.com/slavadubrov/meta-engineering-ai-lab.git
cd meta-engineering-ai-lab
uv sync --frozen
uv run --frozen python scripts/fetch_evidence.py
uv run --frozen python -m lab verify artifacts/agent-study-03 --source
uv run --frozen python scripts/settings_grid.py --check
uv run --frozen python -m lab serve --port 8075
Откройте http://127.0.0.1:8075/web/, чтобы пройти записанную кампанию от предложения до обратной связи. Загрузка проверяется по закреплённой контрольной сумме, и ничто в этом блоке не вызывает модель. Запуск с --check пересчитывает перебор и завершается ошибкой, если сохранённый отчёт больше не соответствует коду.
Чтобы запустить новую платную кампанию предложений, сохраните OPENAI_API_KEY в игнорируемом файле .env.local репозитория и выберите новый каталог вывода:
uv run --frozen --env-file .env.local python -m lab campaign \
  --live --campaigns 3 --iterations 4 --budget-usd 0.50 \
  --output artifacts/my-agent-study
Явный флаг --live включает вызовы провайдера. Посмотрите artifacts/my-agent-study/report.md: там предложения и стоимость. Модель может пойти другим путём, хотя Python оценит любую конкретную конфигурацию одинаково. Разбор инструмента памяти показывает подготовленные входные JSON, сохранённые записи и четыре конфигурации, заданные вручную, если вы хотите понять детерминированную цель без запуска агента.
Что дальше в серии
Инструмент памяти намеренно мал: пять настроек и 20 сценариев позволяют проверить каждый шаг. Тот же размер — его предел. Скрипт может проверить каждую конфигурацию, поэтому этот пример не показывает, когда LLM-генератор предложений стоит своих затрат.
В следующих частях серии цель крупнее: харнесс службы поддержки из статьи Проектирование харнесса агента: от задачи к архитектуре, часть 1 серии Building and Evaluating Agent Harnesses. Агент-программист будет предлагать изменения этого харнесса, а его результаты сравнят с более простым поиском. Агент-улучшатель не будет редактировать самого себя, а каждое принятие проверит человек.
Сначала этому харнессу нужен более сильный эвалуатор. Семь из двенадцати задач поддержки не ждут изменения в базе данных, поэтому агент, который ничего не делает, уже проходит 7 из 12 проверок состояния. Агент-программист, которого оценивают только по этим проверкам, мог бы пройти больше из них, заставив агента поддержки делать меньше.