Meta-engineering de sistemas de AI: dos traces a uma memória melhor

Tradução automática
Este artigo foi traduzido automaticamente a partir da versão original em inglês.
Este artigo é para engenheiros que querem que um agente descubra porque falha o seu sistema de AI e proponha uma correção. O exemplo é uma pequena ferramenta de memória que responde a uma pergunta sobre onde vive um utilizador, e a resposta está errada. Vai ver como se propõe uma alteração a essa ferramenta, como se testa em 20 cenários preparados e como se avalia antes de alguém a adotar. Vai ver também como verificar se um script simples que experimenta todas as definições teria encontrado a mesma correção sem um LLM. Na experiência de acompanhamento, um LLM propôs as alterações e Python comum testou-as.
Uso meta-engineering para o desenho desse processo de melhoria. Resume-se a quatro decisões. O que pode alterar o proponente, a pessoa ou o programa que sugere alterações? Que resultados contam como melhoria? Como é que um resultado influencia a sugestão seguinte? Quem decide adotar uma alteração? As mesmas quatro decisões aplicam-se quer o proponente seja um LLM, uma pessoa ou uma pesquisa de parâmetros.
A falha da cidade errada
A ferramenta de memória guarda factos sobre uma utilizadora, a Ada, e responde a perguntas sobre ela. Um teste, o cenário da mudança futura, envia-lhe quatro eventos:
- Guardar
city = Berlin, com efeito a 1 de janeiro. - Guardar
city = Paris, recebido a 3 de janeiro mas com efeito a 10 de janeiro. - Perguntar a cidade a 5 de janeiro. Esperado: Berlim.
- Perguntar a cidade a 12 de janeiro. Esperado: Paris.
A ferramenta original responde Paris nas duas vezes. A 12 de janeiro está certo. A 5 de janeiro está errado: a Ada ainda não se mudou.
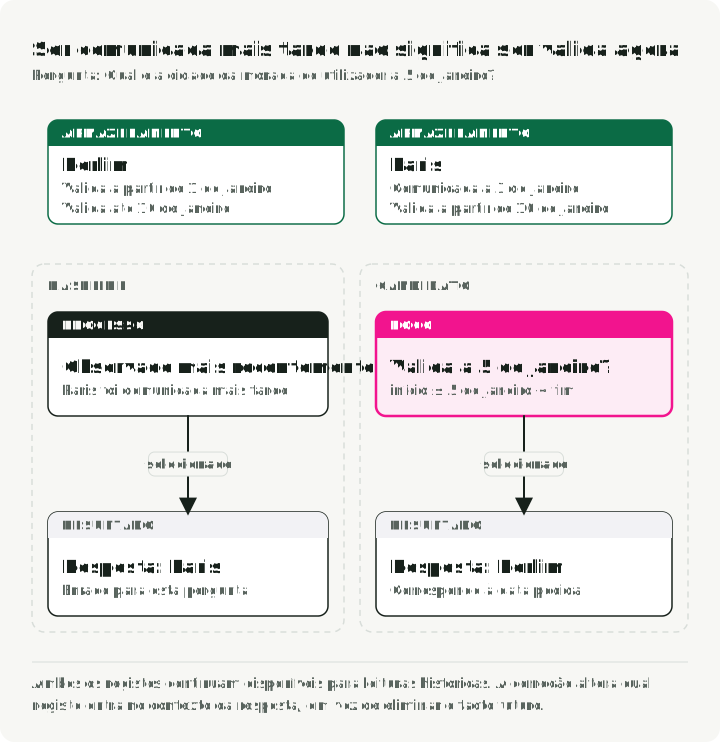
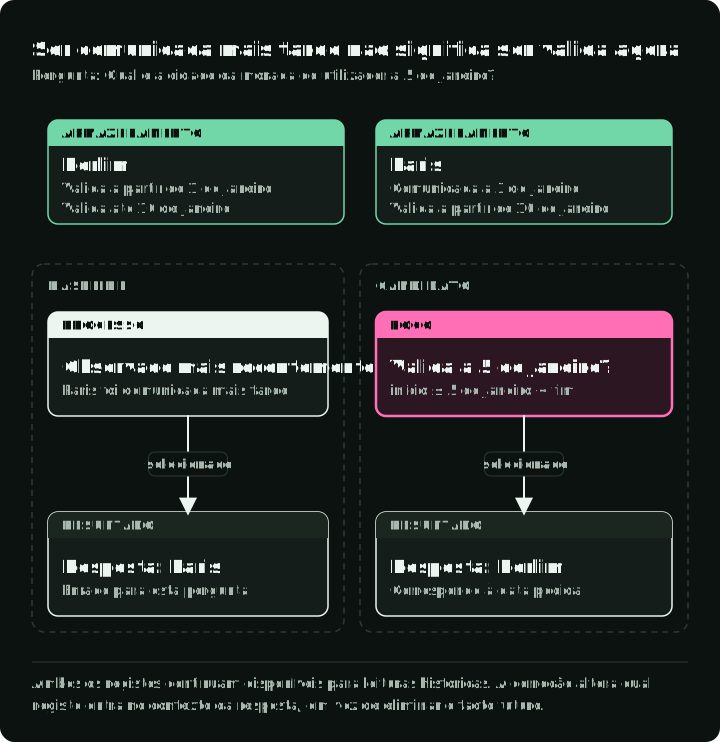
Cada execução de um teste deixa um trace: um registo guardado de todos os eventos enviados à ferramenta, dos registos que ela guardou e das respostas que deu. O trace guardado deste cenário mostra que os dois registos têm as datas de validade certas. Berlim é válida de 1 a 10 de janeiro e Paris a partir de 10 de janeiro, sem data de fim. A falha está na recuperação: coloca o facto de Paris, recebido mais recentemente, à frente de Berlim sem verificar qual deles era válido na data pedida. Guardar a mudança futura estava correto.
Portanto, o facto de Paris tem de ficar, e a recuperação precisa de um filtro de datas. Este diagnóstico ainda não justifica adotar um filtro. O mesmo código de recuperação responde a perguntas sobre outros assuntos, trata eliminações e tem de manter separados os registos dos utilizadores. Uma alteração que corrige o dia 5 de janeiro mas estraga esses casos piora a ferramenta de memória. O processo de melhoria tem de detetar isso antes de uma nova versão chegar aos utilizadores.
Dois loops
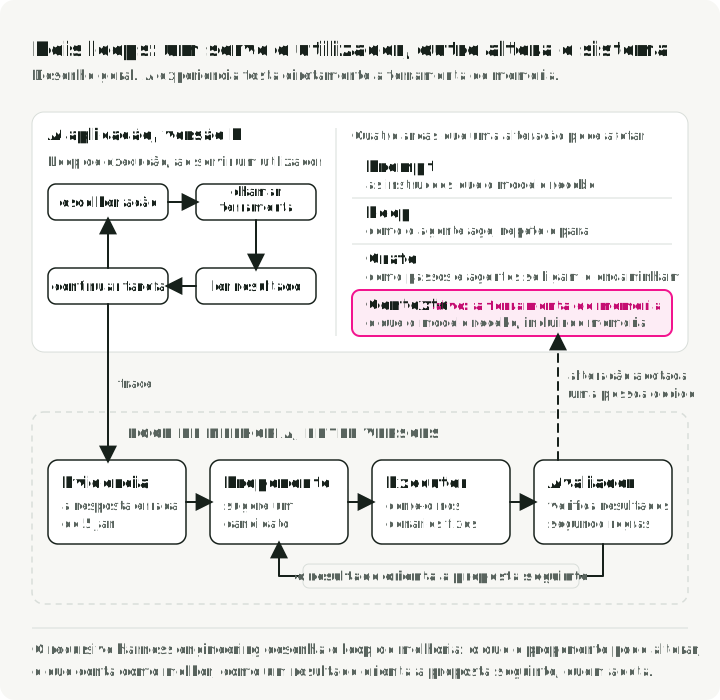
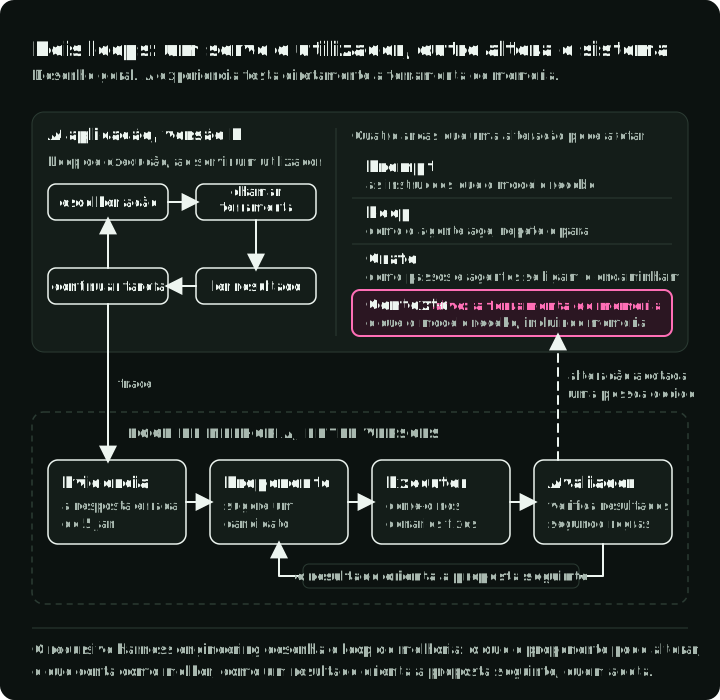
Uma aplicação com agentes executa um loop enquanto serve um utilizador. Neste loop de execução, escolhe uma ação, chama uma ferramenta, lê o resultado e continua a tarefa do utilizador. Um agente que use a ferramenta de memória poderia receber aí a resposta com a cidade errada. Esta experiência chama diretamente a ferramenta com eventos de teste fixos.
Corrigir a falha exige um segundo loop, que corre entre versões da aplicação. Este loop de melhoria parte de uma evidência de falha, como a resposta de 5 de janeiro, um registo alterado quando não devia, ou um custo demasiado alto. O proponente sugere um candidato: uma versão concreta de uma alteração ao alvo, a parte do sistema que está a ser melhorada. Aqui o alvo é a ferramenta de memória e um candidato é um novo conjunto das suas definições. Um executor corre o candidato num conjunto fixo de cenários de teste, e um avaliador verifica os resultados face às regras que esses cenários codificam. O loop só fica completo quando um resultado muda a proposta seguinte ou a decisão de adotar uma alteração.
O diagrama mostra o desenho geral da aplicação, onde o alvo pode ser qualquer parte da aplicação. Os engenheiros costumam agrupar essas partes em quatro áreas que se sobrepõem. O prompt engineering altera as instruções. O context engineering altera a informação que o modelo recebe, incluindo a memória. O loop engineering altera como o agente age, repete e para no seu loop de execução. O graph engineering altera como os passos ou os agentes se ligam e encaminham o trabalho. O meta-engineering trata uma escolha em qualquer das quatro, como a redação de um prompt ou o número de repetições, como uma definição que uma experiência pode alterar. Avalia cada candidato pela qualidade das respostas, pelo custo e pelo comportamento exigido do sistema inteiro, como nunca mostrar os dados de um utilizador a outro.
Dois projetos recentes já usam um coding agent como proponente. No autoresearch de Karpathy, o agente edita um ficheiro de treino e executa-o com um orçamento de tempo fixo. Cada tentativa fica registada como mantida, descartada ou falhada, e o código de avaliação fica noutro ficheiro que o agente não edita. O Meta-Harness, um preprint de março de 2026, deixa o proponente ler o código-fonte, as pontuações e os traces de candidatos anteriores. Usa-os para melhorar o código que decide o que uma aplicação com LLM guarda, recupera e mostra ao seu modelo. Este artigo usa um alvo muito menor, a ferramenta de memória, para que cada passo possa ser inspecionado.
Limitar o que o proponente pode alterar
O LLM nunca corre dentro da ferramenta de memória. Lê traces de falhas e os resultados da avaliação e depois propõe uma nova configuração: valores para as definições da ferramenta. Python testa essa configuração.
A própria ferramenta de memória é Python comum e determinístico. Recebe factos estruturados, guarda-os ou rejeita-os e devolve um valor para uma consulta. Não extrai factos de conversas nem escreve uma resposta em linguagem natural, por isso este loop não consegue corrigir uma falha na extração de factos. Cada facto guardado tem um proprietário, um evento de origem e um intervalo de validade, seguindo as regras de estado guardado de Schema-Guided Agent Memory.
Cada facto recebido traz também uma pontuação de confiança, escrita pelo autor do teste. A ferramenta só guarda um facto se a sua pontuação for pelo menos min_confidence. As pontuações fazem parte dos dados de teste, não são probabilidades medidas a partir de um modelo. Por exemplo, um facto incerto delivery = courier com pontuação 0.4 é rejeitado no limiar original de 0.7, mas guardado com 0.2.
O registo de Paris depois da segunda escrita mostra como um registo mantém o seu histórico. observed_at é o dia em que a ferramenta soube do facto e valid_from é o dia em que passa a ser verdadeiro (excerto):
{
    "id": "m002",
    "key": "city",
    "value": "Paris",
    "valid_from": "2026-01-10",
    "valid_to": null,
    "observed_at": "2026-01-03",
    "source_event_id": "future-move:event-2",
    "supersedes_memory_id": "m001"
}
source_event_id aponta para o evento que forneceu Paris e supersedes_memory_id liga-o ao registo de Berlim m001. O escritor também tem regras fixas para conflitos. Se uma escrita posterior disser Roma, também com efeito a 10 de janeiro, o escritor rejeita-a e deixa Paris inalterada. Repetir Paris para a mesma data reutiliza o registo, e uma atualização com uma data de efeito anterior é rejeitada. O proponente não pode alterar estas regras.
O proponente pode alterar cinco definições existentes:
| Definição | O que muda ao alterá-la |
|---|---|
min_confidence | Altera a pontuação de confiança mínima exigida para guardar um facto. |
filter_entity | Restringe a recuperação ao assunto pedido, como a casa em vez do trabalho. |
time_aware | Restringe a recuperação aos factos válidos na data pedida. |
deduplicate | Reutiliza um facto ativo idêntico em vez de guardar outra confirmação. |
top_k | Define quantos dos registos mais bem classificados a ferramenta usa na resposta. |
Uma proposta altera no máximo duas definições; min_confidence varia de 0 a 1 e top_k de 1 a 8. O agente não pode editar código, testes nem respostas esperadas, e não pode aprovar a sua própria alteração. A sua saída são dados que o Python valida, não código para executar. O contrato de configuração e o validador de propostas definem esse limite em código.
Como este proponente só pode enviar definições, não consegue alterar o avaliador. No entanto, o avaliador corre no mesmo processo Python que a ferramenta de memória. Um agente autorizado a escrever e executar o seu próprio código poderia, por isso, alterar as verificações. Esse agente precisa do avaliador num processo separado, com as suas próprias regras de acesso a ficheiros e à rede, antes de se poder confiar nos seus resultados.
A regra de pontuação
Para a história da cidade, o teste tem de fazer as duas perguntas: Berlim a 5 de janeiro e Paris a 12 de janeiro. Testar só a primeira resposta recompensaria uma ferramenta que simplesmente descarta o facto futuro. No projeto de acompanhamento, um cenário é uma história completa de eventos write, query e, por vezes, delete, como os quatro eventos acima. Cada candidato corre os mesmos 20 cenários preparados, cada um a partir de uma memória vazia. A configuração original passa em 13 deles.
Um cenário só passa quando todas as respostas esperadas estão corretas e nenhuma regra de dados é violada. O avaliador verifica três regras de dados, chamadas verificações obrigatórias: um proprietário nunca vê os factos de outro, um facto eliminado desaparece e uma entrada marcada como proibida não é guardada. Conta também os registos que a ferramenta guardou.
Para escolher entre candidatos, a regra de seleção começa por descartar qualquer candidato que falhe uma verificação obrigatória. Entre os restantes, prefere o que passa em mais cenários. Se dois passarem o mesmo número, prefere o que guarda menos registos. Assim, uma alteração que só reduz o armazenamento pode ganhar quando as respostas se mantêm, mas nunca contra uma alteração que responde corretamente a mais cenários.
Um só número melhorado não chega para aceitar uma alteração. Considere baixar min_confidence de 0.7 para 0.2. Passam a ser guardados mais factos úteis, como uma preferência que chegou com uma pontuação baixa. O facto incerto delivery = courier também passa a ser guardado e substitui um valor confirmado. Numa comparação preparada à mão, esta alteração corrigiu um cenário mas estragou quatro, pelo que a taxa de sucesso desceu de 19/20 para 16/20 apesar de todas as verificações obrigatórias continuarem a passar. A proporção de factos úteis guardados subiu e as respostas finais pioraram. Este candidato não foi uma proposta do agente nas campanhas abaixo; mostra porque é que a pontuação conta cenários completos.
As verificações têm limites. O teste fornece diretamente os IDs dos proprietários, por isso o isolamento entre proprietários aqui não é um teste de autenticação. A verificação de escritas proibidas só rejeita entradas que o teste já marca como proibidas; não consegue encontrar uma instrução maliciosa escondida em texto normal. E o proponente vê os 20 cenários, por isso nenhum deles funciona como conjunto de teste oculto. Uma pontuação positiva diz-nos o que aconteceu nestes casos, não como se comportará uma aplicação desconhecida.
Dar a cada proposta uma razão testável
A experiência decorreu em campanhas. Uma campanha é uma tentativa de melhorar a configuração original, começando com um histórico de agente novo. Cada iteração é uma chamada ao modelo em que o agente propõe uma alteração ou decide parar. No primeiro pedido, o agente recebe as definições atuais e o seu significado, os resultados da linha de base, os traces dos cenários que falham, as alterações que pode propor e, nas iterações seguintes, as propostas anteriores e os seus resultados.
Cada resposta tem de preencher os mesmos cinco campos. Este formato segue o Schema-Guided Reasoning (SGR): a resposta é um registo de decisão que um revisor pode verificar campo a campo.
| Campo | O que um revisor pode verificar |
|---|---|
observations | Que cenário e evento fornecidos sustentam a alteração proposta? |
hypothesis | Que regra parece causar o problema? |
predicted_effect | O que deve melhorar quando a alteração for testada? |
action | O agente está a propor uma alteração ou a parar? |
patch | Que definições permitidas devem mudar? |
O pedido impõe essa forma com um JSON Schema estrito, através dos Structured Outputs da OpenAI. O schema restringe a forma da resposta; não prova a hipótese. Depois o Python verifica se os eventos citados existem na evidência que forneceu, se o patch se mantém dentro das definições permitidas e se essa configuração já foi testada. Uma resposta pode cumprir o schema e mesmo assim falhar estas verificações.
Na primeira iteração registada, o agente citou a falha da mudança futura e uma segunda falha, em que um facto sobre a morada de trabalho da Ada respondia a uma pergunta sobre a sua casa. Propôs ativar o filtro de assunto e o filtro de datas:
{ "filter_entity": true, "time_aware": true }Na implementação, estas definições removem os registos não elegíveis antes da classificação. O filtro de assunto descarta factos sobre outros assuntos, pelo que um facto work não pode responder a uma pergunta home. O filtro de datas mantém apenas os factos válidos na data da pergunta. Um facto é válido desde a sua data de início até à data de fim, sem a incluir:
def valid_at(item: dict, at: str) -> bool:
    return item["valid_from"] <= at and (
        item["valid_to"] is None or at < item["valid_to"]
    )
Paris começa a 10 de janeiro, por isso, para a pergunta de 5 de janeiro, só Berlim fica. A 12 de janeiro, Paris é válida e Berlim não.
O Python correu essa configuração nos 20 cenários. A taxa de sucesso subiu de 13/20 para 19/20 e as verificações obrigatórias passaram. A campanha alterou os dois filtros num só passo, por isso mediu apenas o efeito combinado; as repetições com uma só definição mais abaixo separam-nos. O executor manteve esta configuração como ponto de partida da proposta seguinte e devolveu os resultados ao agente.
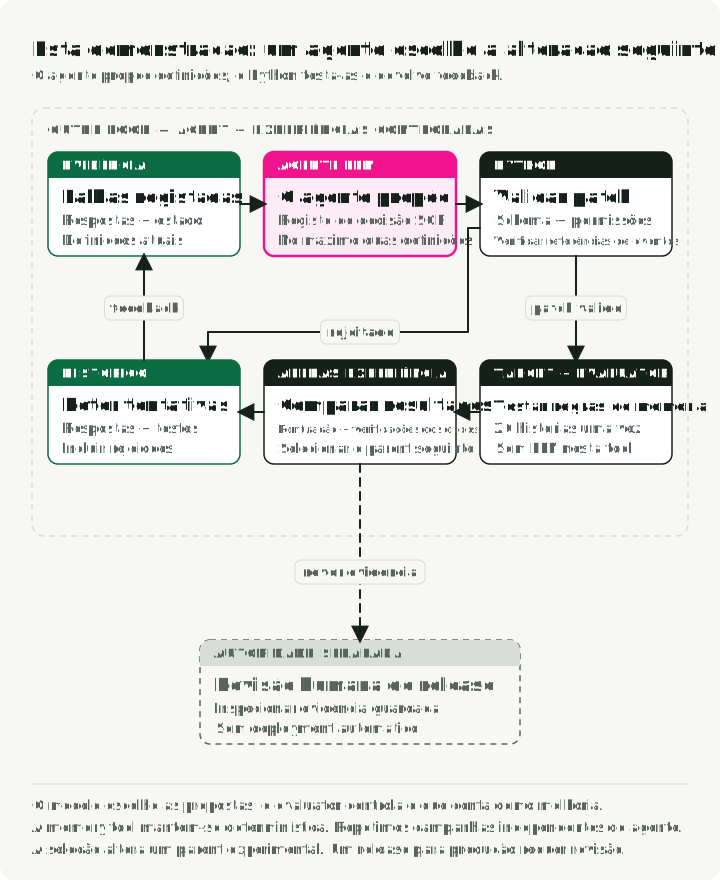
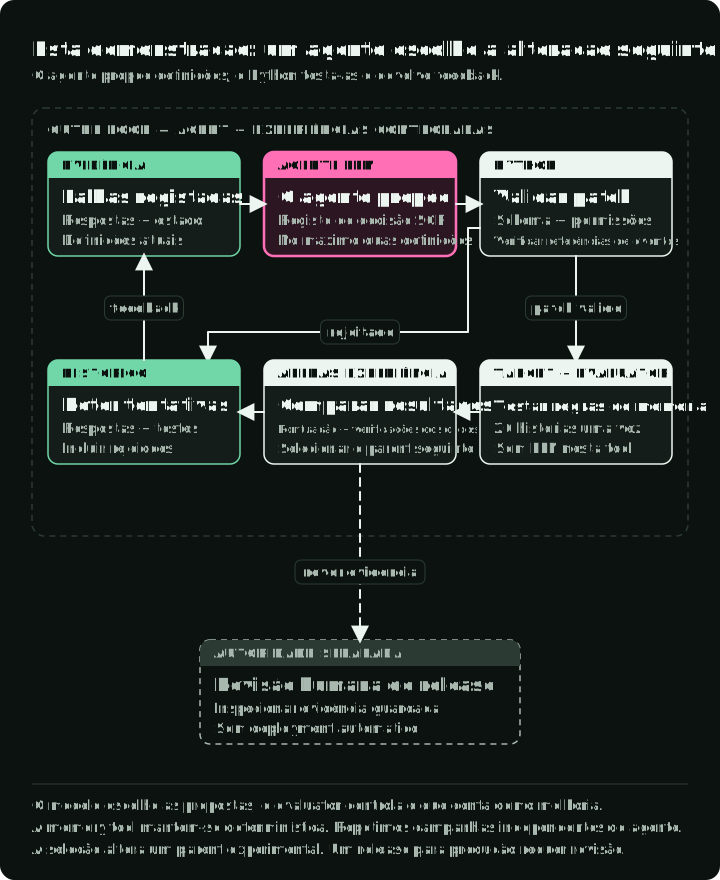
Depois dos filtros, um cenário continuava a falhar e algumas histórias guardavam a mesma confirmação duas vezes. A primeira campanha tomou quatro decisões no total:
| Decisão | Evidência e alteração proposta | Resultado medido nos mesmos 20 cenários |
|---|---|---|
| 1 | Ativar a filtragem por assunto e por data após respostas com assunto e data errados | 13/20 → 19/20; mantida como o ponto de partida seguinte |
| 2 | Deduplicar confirmações repetidas de language = German | 19/20; média de registos guardados 1.70 → 1.60 |
| 3 | Baixar min_confidence de 0.7 para 0.6 por uma preferência útil com pontuação 0.6 | 20/20; média de registos guardados 1.65 |
| 4 | Parar quando não houver mais nenhuma proposta fundamentada | Nenhuma configuração nova testada |
Com 0.6, a preferência útil é guardada e o facto incerto delivery = courier, com pontuação 0.4, fica abaixo do limiar. Isso explica a terceira alteração nestas entradas preparadas; as próprias pontuações foram fornecidas pelo autor do teste. A decisão de parar significa que o agente não encontrou nenhuma outra alteração que conseguisse sustentar com o feedback que viu. Não mostra que esta configuração seja a melhor possível.
A validação também já rejeitou uma resposta. Numa execução de desenvolvimento separada, um agente citou o ID de um candidato como se fosse um evento de um cenário. A resposta cumpria o JSON Schema, mas a referência não existia na evidência de eventos fornecida. O Python rejeitou a proposta antes de a testar e devolveu o erro de validação. Nenhuma das três campanhas registadas abaixo teve uma rejeição destas.
Se um patch avaliado piorar a pontuação, o executor mantém o ponto de partida anterior e regista a tentativa falhada. Um teste com respostas simuladas do agente exercita esse caminho; as três campanhas reais não. Manter o resultado rejeitado no histórico dá ao proponente um motivo para escolher uma alteração diferente a seguir, em vez de repetir o mesmo palpite.
Repetição, custo e adoção
A ferramenta de memória é determinística: voltar a correr a mesma configuração no mesmo cenário dá a mesma resposta. A incerteza está no que o agente escolhe. Por isso, o estudo correu a pesquisa inteira três vezes, cada uma a partir da linha de base de 13/20, com histórico de agente novo e no máximo quatro decisões do modelo. As três campanhas escolheram os mesmos três patches, chegaram a 20/20 nos mesmos cenários e depois pararam. São 12 chamadas ao modelo, nove propostas avaliadas e três decisões de parar.
No estudo de 11 de setembro de 2026, o proponente foi o gpt-5.6-luna com esforço de raciocínio baixo. Calculado com as tarifas publicadas do modelo, o consumo de tokens registado dá cerca de USD 0.04 pelas 12 chamadas, contra um orçamento configurado de USD 0.50. É uma estimativa feita a partir do consumo registado, não uma fatura, e exclui o tempo de desenvolvimento.
Estes resultados repetidos mostram que este modelo seguiu um caminho útil com este prompt, este alvo e este conjunto de cenários. Não mostram que uma nova carga de trabalho de memória vá passar. O relatório congelado das campanhas e o arquivo de evidência com checksum do projeto de acompanhamento contêm os pedidos, as respostas, as validações e os resultados registados.
Uma configuração que o executor mantém é apenas o ponto de partida da experiência seguinte. Não é uma versão para lançar. Nos relatórios do projeto de acompanhamento, a adoção continua a aguardar revisão humana, e as campanhas não colocaram nada em produção. Um revisor teria ainda de verificar a alteração face à sua própria carga de trabalho, regras de acesso, meta de custo e plano de reversão.
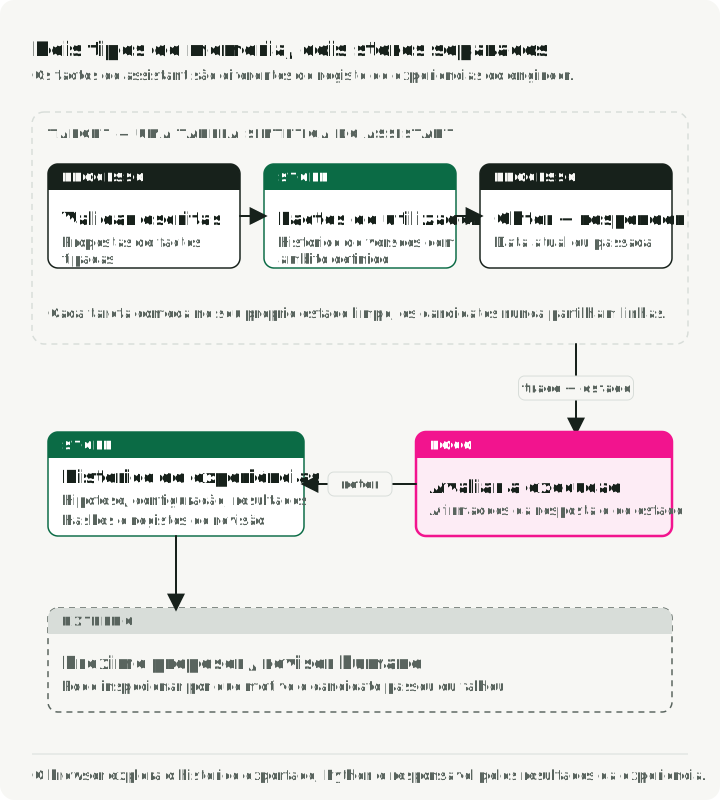
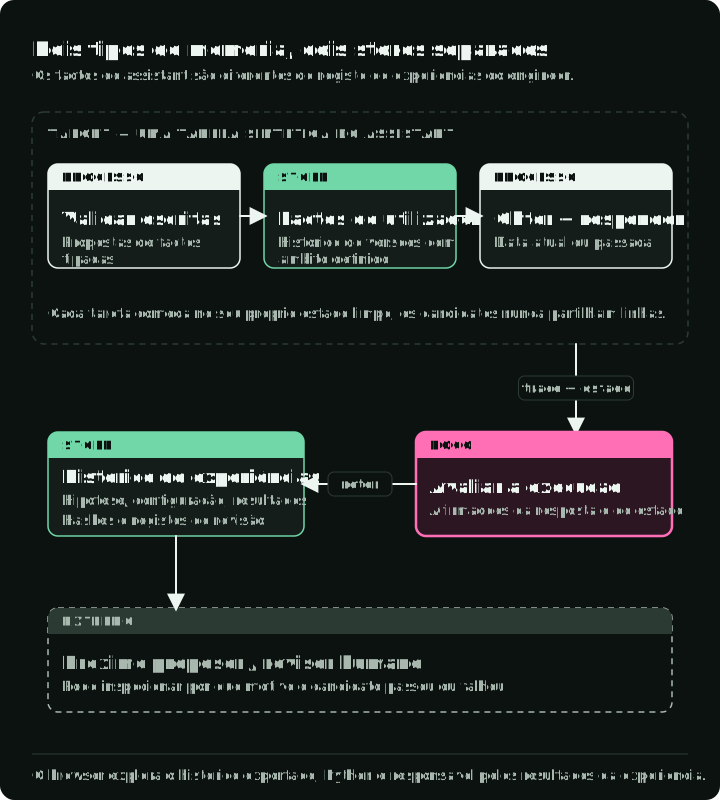
A experiência produz também registos próprios, que exigem um tratamento diferente dos factos da Ada. A ferramenta de memória guarda a cidade dela. O histórico da experiência guarda cada pedido, proposta, resultado de validação, versão do teste e resultado, com os hashes necessários para explicar mais tarde uma escolha. Neste estudo sintético, esses registos podem ser públicos. Numa aplicação real, eliminar o facto de um utilizador do armazenamento de memória ativo não apagaria as cópias nos logs da experiência nem nas cópias de segurança. Uma política de retenção e eliminação tem de abranger esses registos em separado.
Esta pesquisa precisava de um LLM?
As campanhas mostram que o loop funciona: um LLM leu traces, propôs definições e mudou a proposta seguinte depois do feedback. Não mostram que um LLM era o proponente certo para este problema. Para verificar, voltei a correr a ferramenta de memória inalterada nos mesmos 20 cenários, alterando uma definição de cada vez, com o script de grelha de definições do projeto de acompanhamento. Estas execuções não fazem chamadas ao modelo e cada configuração precisa de uma só execução porque a ferramenta é determinística.
| Configuração | Cenários aprovados |
|---|---|
| Linha de base | 13/20 |
| Só filtro de assunto | 16/20 |
| Só filtro de datas | 16/20 |
| Só deduplicação | 13/20 |
Só min_confidence = 0.6 | 14/20 |
| Ambos os filtros | 19/20 |
Ambos os filtros, deduplicação, min_confidence = 0.6 | 20/20 |
Cada filtro corrige três cenários por si só e, juntos, corrigem seis. A deduplicação não muda nenhuma resposta; só reduz os registos guardados.
Depois testei todas as combinações. Os factos dos cenários têm seis pontuações de confiança: 0.25, 0.3, 0.4, 0.6, 0.95 e 1. Um limiar guarda todos os factos com pontuação igual ou superior, pelo que 0.45 e 0.55 guardam exatamente os mesmos factos. Basta um valor de limiar por intervalo entre pontuações vizinhas, e seis valores cobrem todos os comportamentos de escrita distintos nestes cenários.
Com esses seis limiares, três definições ligadas/desligadas e oito valores de top_k, há 384 configurações. O script executa cada uma nos 20 cenários e termina em menos de um segundo.
Dezasseis configurações passam 20/20. Todas ativam os dois filtros e usam um limiar acima de 0.4 e no máximo 0.6; top_k nunca altera o resultado. Ordenada pela regra de seleção acima, a melhor configuração é a que o agente encontrou: os dois filtros, deduplicação e min_confidence = 0.6, com 1.65 registos guardados por cenário. O relatório guardado lista todos os resultados com o hash do código-fonte.
Na figura, cada linha é um intervalo de limiares, os pontos preenchidos são os factos que ele guarda e a linha marcada contém as 16 configurações que passam.
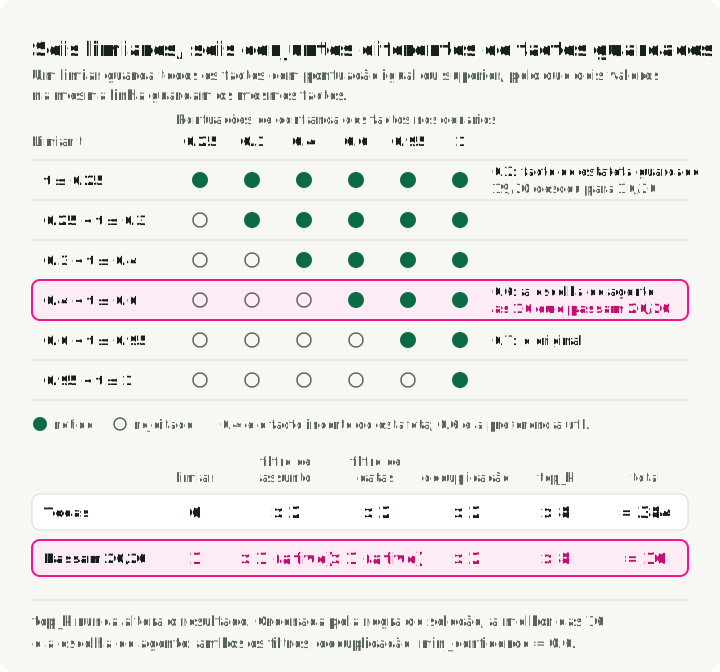
Esta grelha não é uma comparação justa com o agente. Usa o meu conhecimento das pontuações de confiança nos dados de teste e ignora o limite de quatro decisões do agente. Mostra apenas que este espaço de pesquisa é pequeno o suficiente para ser testado por completo, pelo que não precisava de um proponente LLM.
A grelha e o agente são dois de quatro modos de dividir a escolha das experiências entre pessoas e software:
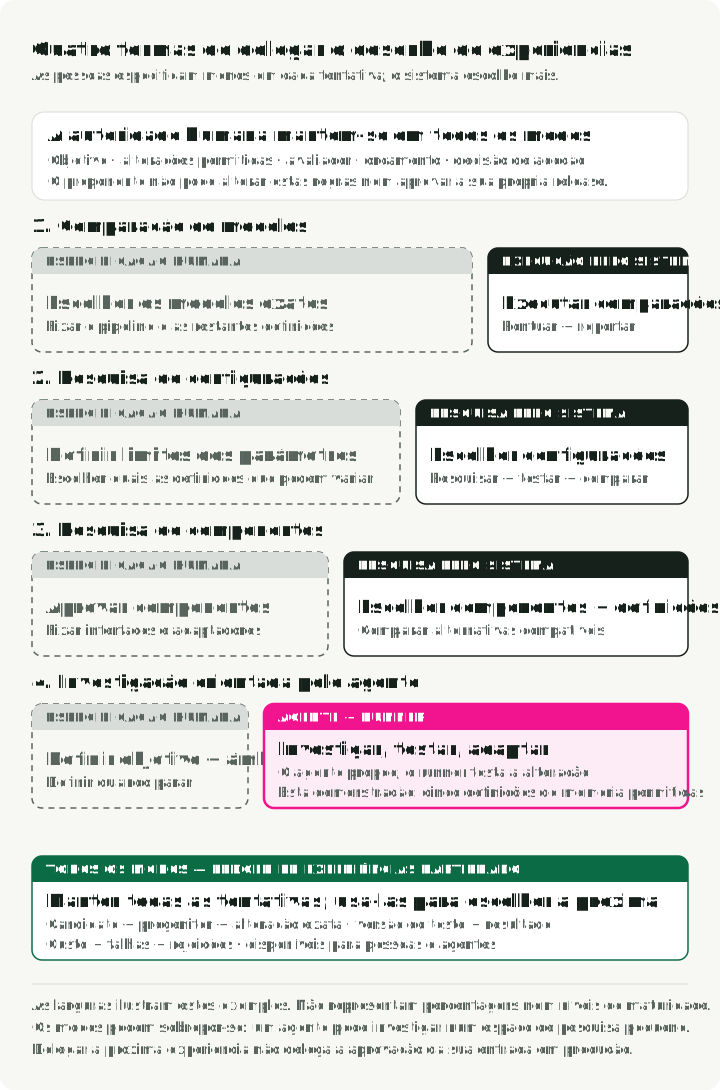
- Comparação de modelos. Escolhem-se os modelos ou variantes exatos; o sistema executa-os e pontua-os. Não é preciso um proponente LLM.
- Pesquisa de configurações. Escolhe-se que definições podem variar e quais os seus limites; uma grelha, uma pesquisa aleatória ou um otimizador como o Optuna escolhe os valores. A grelha acima é este modo.
- Pesquisa de componentes. Aprovam-se componentes intermutáveis com interfaces fixas e a pesquisa escolhe componentes e definições. A pesquisa de pipelines do scikit-learn faz isto com uma pesquisa em grelha normal, pelo que trocar componentes não torna, por si só, o processo agentic.
- Investigação conduzida por agentes. Um agente lê as falhas e os resultados anteriores, propõe a alteração seguinte e adapta-se após cada teste, como fizeram as campanhas acima. Existem híbridos: o MIPROv2 do DSPy faz um modelo propor instruções e usa otimização bayesiana para pesquisar as suas combinações.
Em todos os modos, as pessoas mantêm o objetivo, as alterações permitidas, o avaliador, o orçamento e a decisão de adoção. Todos os modos podem escrever no mesmo histórico da experiência, a que o diagrama chama registo: cada candidato e o seu antecessor, a alteração exata e quem a forneceu, a versão do teste, o resultado, o custo e qualquer rejeição. Com esse registo, pode entregar a proposta seguinte a um agente, ou retomá-la, sem perder evidência. O executor do projeto de acompanhamento também aceita um candidato fornecido por uma pessoa através de lab evaluate.
Decida primeiro qual destes modos se adequa ao seu sistema. Se as alterações permitidas forem poucas definições com intervalos conhecidos e cada teste for barato, enumere-as ou use um otimizador padrão antes de acrescentar um LLM. Um proponente LLM pode ajudar quando escolher uma alteração exige ler traces de falhas variados, código-fonte e interações entre componentes, e quando os candidatos são demasiados ou demasiado desestruturados para os listar. Se ajuda nesse caso é uma questão a medir, não a presumir.
Aplicar ao seu sistema
Escolha um trace que mostre uma falha real. Depois, escreva quatro coisas antes de começar qualquer pesquisa:
- que alterações são permitidas;
- que resultados de tarefa e efeitos proibidos o avaliador verifica;
- quanto pode custar cada tentativa;
- quem pode adotar um candidato.
Experimente a pesquisa mais simples que cubra as alterações permitidas. Depois verifique se o resultado muda a experiência seguinte ou uma decisão de lançamento. Se não mudar nenhuma, o loop não melhorou nada.
Opcional: inspecionar e executar o projeto de acompanhamento
Pode inspecionar o estudo registado sem uma chave de API. A tag v0.2.3 contém a ferramenta de memória, os estudos registados e a grelha de definições. Com o uv instalado, clone o repositório, restaure a evidência registada, verifique-a, volte a executar a grelha e inicie um visualizador local para as campanhas registadas:
git clone --branch v0.2.3 --depth 1 https://github.com/slavadubrov/meta-engineering-ai-lab.git
cd meta-engineering-ai-lab
uv sync --frozen
uv run --frozen python scripts/fetch_evidence.py
uv run --frozen python -m lab verify artifacts/agent-study-03 --source
uv run --frozen python scripts/settings_grid.py --check
uv run --frozen python -m lab serve --port 8075
Abra http://127.0.0.1:8075/web/ para seguir uma campanha registada desde a proposta até ao feedback. A transferência é verificada com um checksum fixo e nada neste bloco faz uma chamada ao modelo. A execução com --check recalcula a grelha e falha se o relatório guardado deixar de corresponder ao código.
Para executar uma campanha de propostas nova e paga, guarde OPENAI_API_KEY no ficheiro .env.local do repositório, que é ignorado, e escolha um novo diretório de saída:
uv run --frozen --env-file .env.local python -m lab campaign \
  --live --campaigns 3 --iterations 4 --budget-usd 0.50 \
  --output artifacts/my-agent-study
A opção explícita --live ativa as chamadas ao fornecedor. Inspecione artifacts/my-agent-study/report.md para ver as propostas e os custos resultantes. O modelo pode seguir um caminho diferente, embora o Python pontue qualquer configuração dada da mesma forma. O guia da ferramenta de memória mostra as entradas JSON preparadas, os registos guardados e quatro configurações especificadas à mão, se quiser perceber o alvo determinístico sem executar o agente.
Para onde vai a série
A ferramenta de memória era pequena de propósito: cinco definições e 20 cenários tornam cada passo inspecionável. O mesmo tamanho é o seu limite. Um script consegue testar todas as configurações, por isso este exemplo não consegue mostrar quando um proponente LLM compensa o seu custo.
As partes seguintes desta série usam um alvo maior: o harness de apoio ao cliente de Desenhar um agent harness: da tarefa à arquitetura, a Parte 1 de Building and Evaluating Agent Harnesses. Um coding agent proporá alterações a esse harness e os seus resultados serão comparados com uma pesquisa mais simples. O sistema de melhoria não se editará a si próprio e uma pessoa reverá cada adoção.
Esse harness precisa primeiro de um avaliador mais forte. Sete das suas doze tarefas de apoio não esperam nenhuma alteração na base de dados, pelo que um agente que não faz nada já passa 7 de 12 verificações de estado. Um coding agent pontuado apenas por essas verificações poderia passar mais delas levando o agente de apoio a fazer menos.