Memória de agentes AI: estado orientado por esquema e proveniência

Tradução automática
Este artigo foi traduzido automaticamente a partir da versão original em inglês.
Este artigo destina-se a engenheiros que constroem agentes de longa duração ou multi-tenant. A memória semântica simples não tem uma regra que diga qual é o valor atual de um facto, por isso os agentes devolvem factos desatualizados. Quando um utilizador altera o prazo do passaporte de 15 de julho para 30 de junho, a pesquisa vetorial pode recuperar as duas afirmações. Uma camada de memória com estado tem de registar que o valor de 30 de junho substitui o anterior.
Vai aprender a guardar a memória como registos tipados com janelas de validade, âmbito de tenant e ligações às fontes, a escrever uma correção sem perder o histórico e a testar leituras do estado atual e do estado num momento passado.
Porque é que o contexto e a recuperação vetorial devolvem factos desatualizados
A janela de contexto é a entrada disponível para uma chamada ao modelo. Uma aplicação pode transportar mensagens para chamadas posteriores, mas a política da aplicação tem de decidir quais dos factos antigos continuam verdadeiros e quem os pode ver.
Os agentes de longa duração precisam de se lembrar de preferências, estado de tarefas, factos sobre clientes, decisões sobre ferramentas, notas de conformidade e erros anteriores. A versão fácil consiste em acrescentar resumos ou despejar notas antigas num armazenamento vetorial. Isso funciona até um dos factos memorizados mudar.
Nesse momento, o agente tem dois prazos de passaporte, dois formatos preferidos ou duas decisões de projeto. A pesquisa semântica pode recuperar ambos. Um resumo pode sobrescrever um deles. Um contexto longo pode incluir o facto desatualizado junto ao ativo. Estas abordagens devolvem texto, mas não conseguem dizer qual é o valor atual.
O contrato da memória tem de responder a perguntas concretas:
- O que é verdade agora?
- O que era verdade a 2 de junho?
- Quem o disse?
- A que tenant pertence?
- Que facto anterior foi substituído por este?
- Posso eliminá-lo ou fazê-lo expirar?
A Schema-Guided Agent Memory (SGAM) guarda estas respostas como campos e relações, em vez de as deixar implícitas na prosa.
O que significa SGAM
Duas ideias de investigação com nomes semelhantes definem o âmbito da SGAM.
Schema-Guided Memory (SGM) é o termo de investigação usado por Mei et al. em According to Me: Long-Term Personalized Referential Memory QA. O artigo compara a Descriptive Memory (DM) em texto livre com itens de memória chave-valor de esquema fixo. Ambas as representações contêm a mesma informação de origem, em estruturas diferentes. Um uso anterior do nome, o dataset Schema-Guided Dialogue, acompanha o estado do diálogo para APIs de serviços e não tem relação com a memória de longo prazo.
Neste artigo, uso Schema-Guided Agent Memory (SGAM) para designar um padrão de engenharia em que os esquemas regem as escritas, as atualizações, a recuperação e a eliminação. O esquema define o estado da aplicação e o seu ciclo de vida.
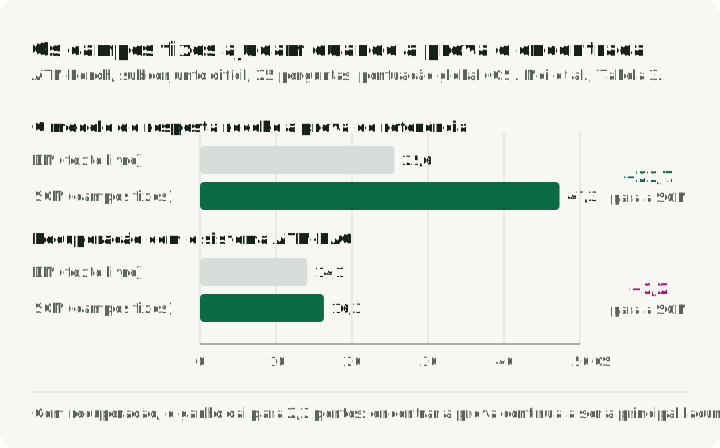
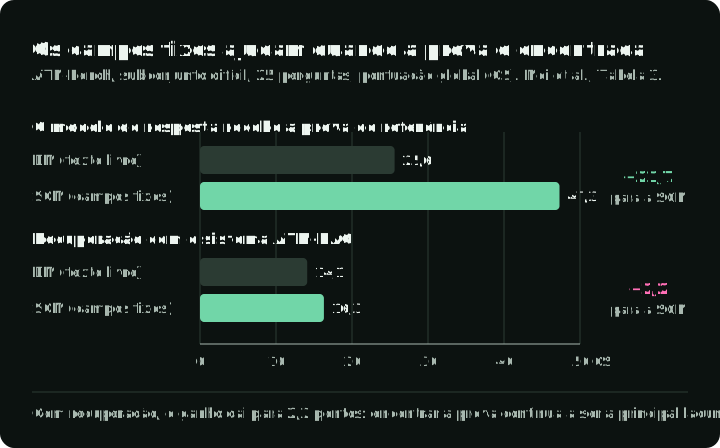
O ATM-Bench mostra por que razão a representação importa. Usa cerca de quatro anos de dados pessoais, vindos de emails, imagens e vídeos. As perguntas exigem referências pessoais, localização, várias provas e atualizações ao longo do tempo. A SGM expõe campos como tempo, fonte, localização, entidades e etiquetas numa representação fixa. No subconjunto difícil de 25 perguntas, a Tabela 3 do artigo regista que a pontuação global (QS) sobe de 25,6 com DM para 47,3 com SGM quando o modelo de resposta recebe a prova de referência (gold evidence). Com a recuperação do sistema ATM-RAG dos autores, a pontuação no subconjunto difícil sobe apenas de 14,1 para 16,3, pelo que encontrar a prova continua a ser a principal lacuna.
O gráfico põe lado a lado as quatro pontuações do subconjunto difícil. Compare o ganho dos campos fixos com a prova de referência e com a recuperação.
SGM versus DM responde a uma questão de armazenamento: a memória deve continuar em texto livre ou usar campos nomeados? Um agente em produção tem outro problema antes do armazenamento. Tem de transformar uma conversa não estruturada numa proposta de atualização da memória. A secção seguinte mostra como o Schema-Guided Reasoning (SGR) molda essa chamada ao modelo e onde a SGAM assume o controlo.
Separar a extração pelo modelo da propriedade da memória
A escrita na memória atravessa três camadas. O Structured Output (SO) impõe a forma do objeto candidato. O Schema-Guided Reasoning (SGR) torna inspecionáveis, numa resposta estruturada, os campos previstos e a intenção da decisão do modelo. A Schema-Guided Agent Memory (SGAM) gere o candidato como estado durável depois da chamada ao modelo. Chamadas separadas, validadores e a política da aplicação impõem as dependências, a ordem e as regras do ciclo de vida.
Artigos anteriores aplicam o SGR a juízes estruturados, a planeadores e routers e a rubricas de RAG. Em cada um deles, um veredito, uma rota ou um plano costuma expirar com o pedido atual. Outra execução pode ler um candidato a memória dias depois, ou usá-lo para escolher um tool call. Esse tempo de vida mais longo exige regras de armazenamento que o SGR não fornece.
O SGR dispõe os campos de uma resposta do modelo pela ordem em que o modelo os deve preencher. Numa escrita na memória, a resposta pode incluir a prova de origem, um sujeito e um atributo normalizados, uma comparação com o estado atual e uma atualização proposta. Pydantic ou JSON Schema descrevem esses campos. O Structured Output nativo do fornecedor, ou um runtime de descodificação guiada como o XGrammar, mantém a resposta nessa forma. A forma não garante uma conclusão correta nem prova que o modelo usou esses campos pela ordem prevista.
A SGAM decide o que acontece depois de esse objeto existir. Deve ser guardado? Substitui um facto mais antigo? Que tenant o pode ver? É atual ou histórico? Que episódio de origem o sustenta?
A tabela apresenta a responsabilidade e o modo de falha de cada camada:
| Dimensão | SO | SGR | SGAM |
|---|---|---|---|
| Objetivo | Devolver um objeto conforme com um esquema | Tornar inspecionáveis os campos previstos e a intenção da decisão | Gerir a memória durável depois da chamada ao modelo |
| Âmbito | Uma resposta gerada | Uma resposta do modelo; a política entre passos pode abranger várias chamadas | Registos usados entre chamadas, sessões e execuções |
| Papel do esquema | Define os campos de saída, os tipos e os valores permitidos | Descreve a prova, os campos intermédios e a decisão candidata | Define os registos guardados, as relações e o ciclo de vida |
| Imposição | O constrained decoding bloqueia saídas inválidas para o esquema | Apenas a forma; chamadas separadas, validadores e política impõem as dependências e a ordem | A validação da aplicação, as restrições da base de dados e as regras de conflito impõem o ciclo de vida |
| Tempo de vida | A chamada atual, a menos que a aplicação guarde o objeto | O rasto de raciocínio costuma ser descartado depois da decisão | Persiste até ser atualizado, expirar ou ser eliminado |
| Modo de falha | Forma válida com o significado errado | Os campos estão presentes, mas o raciocínio ou o tratamento das dependências pode continuar errado | Estado desatualizado, poluído, sem âmbito ou sem possibilidade de auditoria |
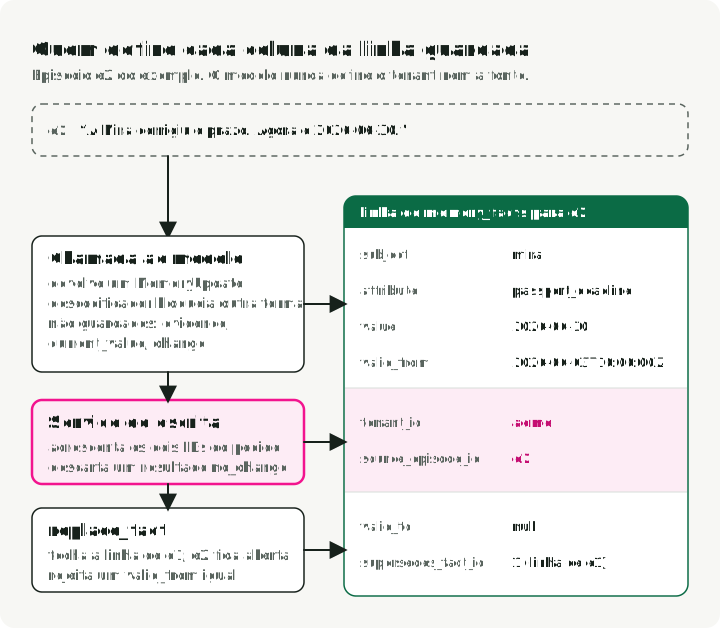
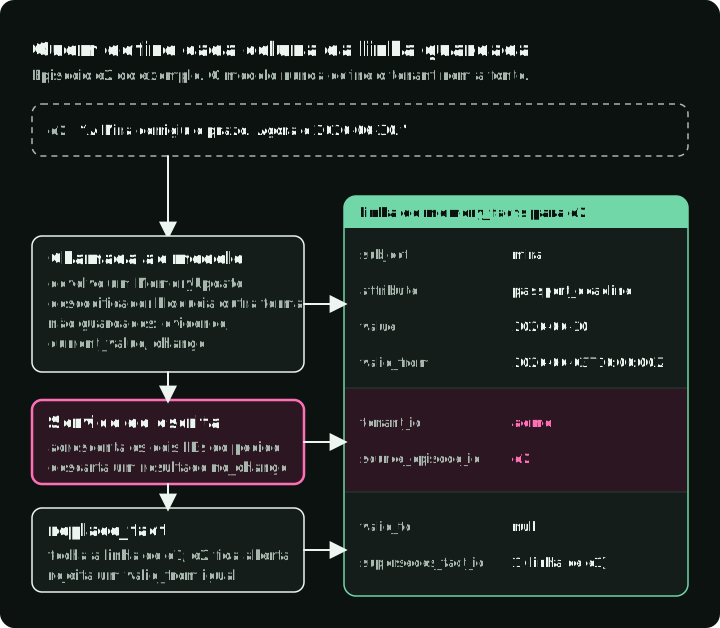
O diagrama segue a correção do exemplo abaixo até uma linha guardada e mostra quem define cada coluna: o modelo, o serviço de escrita a partir do pedido, ou replace_fact.
O esquema seguinte define o objeto passado da extração para o serviço de escrita da SGAM. Requer Pydantic. A aplicação coloca o valor atualmente guardado no prompt, para que o modelo o possa comparar com a nova prova:
from datetime import datetime
from typing import Literal

from pydantic import BaseModel, Field

class MemoryUpdate(BaseModel):
    evidence: str = Field(description="Exact quote from the episode")
    subject: str = Field(description="Normalized entity ID, e.g. mira")
    attribute: str = Field(description="Property being updated")
    current_value: str | None = Field(description="Stored value shown in the prompt")
    change: Literal["new", "update", "no_change"]
    value: str | None = Field(description="New value; None when change is no_change")
    valid_from: datetime = Field(description="When the new value starts to apply")
O serviço de escrita descarta os resultados no_change, acrescenta tenant_id e source_episode_id a partir do pedido e passa o resto a replace_fact, no exemplo abaixo. O modelo nunca escolhe o tenant nem o episódio de origem.
Os caminhos de escrita e de leitura têm funções diferentes
Só o caminho de escrita altera o estado guardado. O caminho de leitura seleciona registos para o pedido atual.
O fluxo de ingestão é o caminho de escrita:
- Capture um episódio em bruto a partir de mensagens, tool results ou eventos de negócio. Registe o seu tenant e a sua classe de retenção.
- Extraia candidatos tipados com structured output.
- Valide o payload com Pydantic ou com a camada de esquema que a sua stack já usa, e rejeite escritas malformadas.
- Resolva os conflitos antes de inserir: decida se o novo registo substitui um antigo e feche o facto desatualizado.
- Mantenha um ponteiro de origem para o episódio em bruto, o tool result, o ficheiro, o ticket ou a confirmação do utilizador que produziu o registo.
- Grave o registo no armazenamento da SGAM com a sua
schema_version, em vez de deixar a versão só no código da aplicação.
O fluxo de pedido é o caminho de leitura:
- Comece pela pergunta do utilizador.
- Decida se a pergunta precisa do estado atual ou do estado num momento passado.
- Filtre por tenant, tipo de memória, sujeito, atributo e janela de validade.
- Acrescente expansão vetorial ou em grafo apenas se a consulta exata do estado não bastar. Use-a para prova de apoio, entidades relacionadas e exemplos, não como autoridade para os factos atuais.
- Monte o menor contexto citado possível para o modelo.
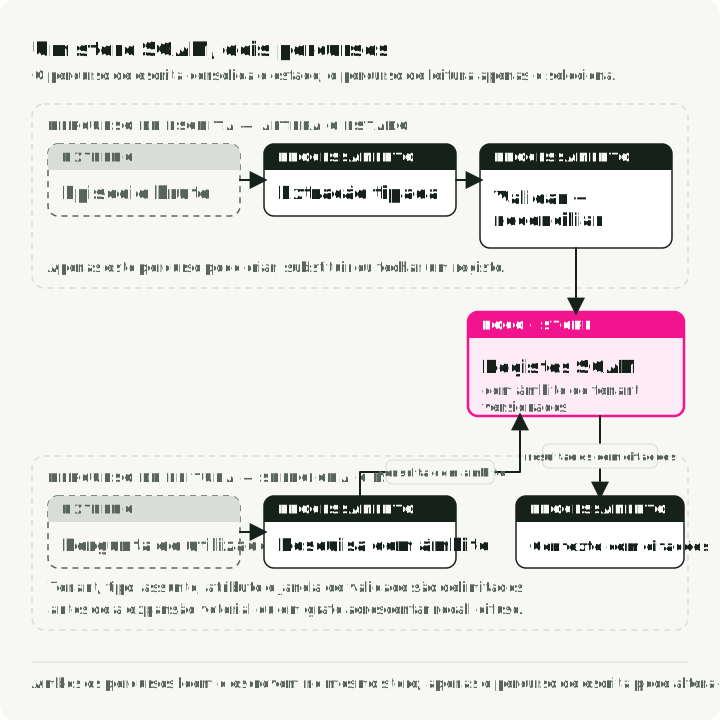
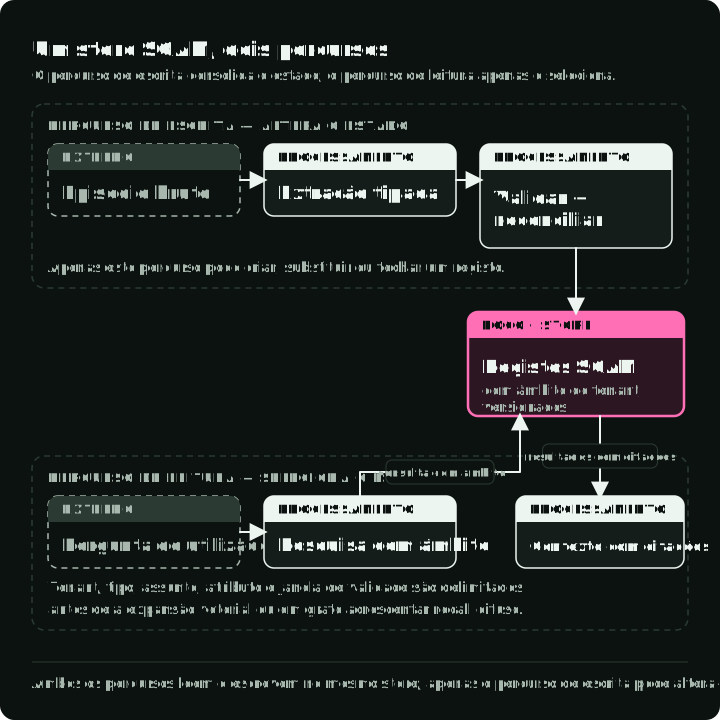
Leia esse diagrama de cima para baixo. O caminho de escrita fecha e1 e insere e2 num único armazenamento. O caminho de leitura escolhe um filtro de estado atual ou de um momento passado e depois seleciona linhas desse mesmo armazenamento.
O que pertence a um esquema de memória
Um registo SGAM mínimo precisa de mais do que text. Cada campo responde a uma das perguntas da primeira secção ou cumpre uma função no ciclo de vida:
| Campo | Pergunta a que responde ou função que cumpre |
|---|---|
tenant_id | A que tenant pertence? Todas as leituras e escritas filtram por ele. |
memory_id | Um ID estável, para que outros registos e tarefas de eliminação possam apontar para ele. |
subject, attribute | A chave: que entidade e que propriedade, como mira e passport_deadline. |
value | O valor guardado. |
memory_type | O tipo de memória: semântica (factos estáveis e perfis), episódica (eventos passados e rastos) ou procedimental (instruções e regras de prompt), como o LangGraph as descreve. |
schema_version | Que esquema escreveu o registo, para que uma migração consiga encontrar e converter registos antigos. |
valid_from, valid_to | O que é verdade agora? valid_from <= now e (valid_to é null ou now < valid_to). O que era verdade a 2 de junho? O intervalo contém esse instante. |
supersedes_memory_id | Que facto anterior foi substituído por este? |
source_episode_id | Quem o disse? Aponta para o episódio em bruto. |
confidence | Uma pontuação que o serviço de escrita compara com um limiar: promover o candidato a estado atual ou pedir ao utilizador que o confirme. |
retention_policy | Posso eliminá-lo ou fazê-lo expirar? Indica às tarefas de eliminação o que mais têm de remover. |
Com estes campos, um novo prazo de passaporte pode fechar o prazo anterior sem apagar o histórico. A mesma tabela consegue responder a consultas do estado atual e do estado num momento passado, e depois rastrear o resultado até ao episódio de origem.
Use RAG para recuperar documentos e a SGAM para manter estado mutável. A pesquisa vetorial continua a ter lugar no sistema para recuperação aproximada, clustering e expansão. O valor atual de mira.passport_deadline deve vir de um registo de memória com o âmbito certo, e não do chunk que por acaso ficou em primeiro lugar.
Um exemplo de facto desatualizado
Considere um rasto sintético de dois episódios, representado como uma baseline DM e como um registo SGAM:
e1: Mira prefers concise answers. Her passport deadline is 2026-07-15.
e2: Mira corrected the deadline. It is now 2026-06-30.
Uma baseline DM guarda os dois episódios como texto livre, por isso a pesquisa de texto pode devolver e1 porque contém as palavras certas. A SGAM extrai um facto tipado de cada episódio, identificado por tenant, sujeito e atributo. Deve devolver e2 como estado atual e manter e1 para uma consulta histórica.
O script abaixo responde a duas das perguntas anteriores: o que é verdade agora e o que era verdade a 2 de junho. Veja replace_fact: fecha a linha antiga em vez de a eliminar e regista que linha a nova substitui. Quem chama deve normalizar cada marca temporal armazenada ou usada numa consulta para um único formato de cadeia UTC com precisão fixa de segundos: YYYY-MM-DDTHH:MM:SSZ. O SQLite compara estes valores TEXT lexicograficamente, pelo que misturar desvios de fuso horário ou precisões pode ordenar os factos incorretamente. Cada linha é válida desde valid_from até valid_to, exclusive. A tabela rejeita intervalos inválidos e tem um índice único parcial para um único facto aberto por tenant, sujeito e atributo. replace_fact gere uma transação e inicia-a com BEGIN IMMEDIATE antes de ler qualquer linha. Chame-a numa ligação sem transação ativa. O SQLite serializa as escritas concorrentes, por isso quem chama deve repetir a transação inteira depois de um erro de bloqueio ou de unicidade. No fim, uma correspondência por palavra-chave faz as vezes da pesquisa vetorial. Qualquer ordenação que desconheça a correção pode devolver e1.
import sqlite3
from dataclasses import dataclass

@dataclass(frozen=True)
class MemoryFact:
    tenant_id: str
    subject: str
    attribute: str
    value: str
    valid_from: str
    source_episode_id: str

def open_db() -> sqlite3.Connection:
    db = sqlite3.connect(":memory:")
    db.row_factory = sqlite3.Row
    db.executescript(
        """
        create table memory_facts (
            fact_id integer primary key,
            tenant_id text not null,
            subject text not null,
            attribute text not null,
            value text not null,
            valid_from text not null,
            valid_to text,
            supersedes_fact_id integer references memory_facts (fact_id),
            source_episode_id text not null,
            check (valid_to is null or valid_from < valid_to)
        );
        create unique index one_open_fact
        on memory_facts (tenant_id, subject, attribute)
        where valid_to is null;
        """
    )
    return db

def replace_fact(db: sqlite3.Connection, fact: MemoryFact) -> None:
    with db:
        db.execute("BEGIN IMMEDIATE")
        exact = db.execute(
            """
            select fact_id
            from memory_facts
            where tenant_id = ? and subject = ? and attribute = ? and valid_from = ?
            """,
            (fact.tenant_id, fact.subject, fact.attribute, fact.valid_from),
        ).fetchone()
        if exact:
            raise ValueError("equal valid_from requires an application conflict policy")

        containing = db.execute(
            """
            select fact_id, valid_to
            from memory_facts
            where tenant_id = ?
              and subject = ?
              and attribute = ?
              and valid_from < ?
              and (valid_to is null or valid_to > ?)
            limit 1
            """,
            (
                fact.tenant_id,
                fact.subject,
                fact.attribute,
                fact.valid_from,
                fact.valid_from,
            ),
        ).fetchone()
        if containing:
            db.execute(
                "update memory_facts set valid_to = ? where fact_id = ?",
                (fact.valid_from, containing["fact_id"]),
            )
            successor_boundary = containing["valid_to"]
        else:
            successor = db.execute(
                """
                select valid_from
                from memory_facts
                where tenant_id = ? and subject = ? and attribute = ? and valid_from > ?
                order by valid_from
                limit 1
                """,
                (fact.tenant_id, fact.subject, fact.attribute, fact.valid_from),
            ).fetchone()
            successor_boundary = successor["valid_from"] if successor else None

        db.execute(
            """
            insert into memory_facts
                (tenant_id, subject, attribute, value, valid_from, valid_to,
                 supersedes_fact_id, source_episode_id)
            values (?, ?, ?, ?, ?, ?, ?, ?)
            """,
            (
                fact.tenant_id,
                fact.subject,
                fact.attribute,
                fact.value,
                fact.valid_from,
                successor_boundary,
                containing["fact_id"] if containing else None,
                fact.source_episode_id,
            ),
        )

def fact_at(
    db: sqlite3.Connection, tenant_id: str, subject: str, attribute: str, timestamp: str
) -> sqlite3.Row | None:
    return db.execute(
        """
        select fact_id, value, valid_from, supersedes_fact_id, source_episode_id
        from memory_facts
        where tenant_id = ?
          and subject = ?
          and attribute = ?
          and valid_from <= ?
          and (valid_to is null or valid_to > ?)
        limit 1
        """,
        (tenant_id, subject, attribute, timestamp, timestamp),
    ).fetchone()

KEY = ("acme", "mira", "passport_deadline")

db = open_db()
replace_fact(db, MemoryFact(*KEY, "2026-07-15", "2026-06-01T09:00:00Z", "e1"))
replace_fact(db, MemoryFact(*KEY, "2026-06-30", "2026-06-03T10:00:00Z", "e2"))
current = fact_at(db, *KEY, "2026-06-04T00:00:00Z")
assert (current["value"], current["source_episode_id"]) == ("2026-06-30", "e2")

historical = fact_at(db, *KEY, "2026-06-02T00:00:00Z")
assert (historical["value"], historical["source_episode_id"]) == ("2026-07-15", "e1")
assert current["supersedes_fact_id"] == historical["fact_id"]

# A delayed extraction predates e1. It ends at e1's existing boundary,
# rather than closing e2, which remains current.
replace_fact(db, MemoryFact(*KEY, "2026-08-01", "2026-05-30T08:00:00Z", "e0"))
delayed = fact_at(db, *KEY, "2026-05-31T00:00:00Z")
assert (delayed["value"], delayed["source_episode_id"]) == ("2026-08-01", "e0")
current = fact_at(db, *KEY, "2026-06-04T00:00:00Z")
assert (current["value"], current["source_episode_id"]) == ("2026-06-30", "e2")
intervals = db.execute("select valid_from, valid_to from memory_facts").fetchall()
assert all(row["valid_to"] is None or row["valid_from"] < row["valid_to"] for row in intervals)

episodes = (
    "e1: Mira prefers concise answers. Her passport deadline is 2026-07-15.",
    "e2: Mira corrected the deadline. It is now 2026-06-30.",
)
naive_match = next(episode for episode in episodes if "passport deadline" in episode)
assert naive_match.startswith("e1:")

print("Naive text memory:")
print(f"  returned episode: {naive_match}")
print()
print("SGAM current state:")
print(f"  mira.passport_deadline = {current['value']}")
print(f"  valid_from={current['valid_from']}, source={current['source_episode_id']}")
print()
print("SGAM point-in-time state:")
print(f"  on 2026-06-02, mira.passport_deadline = {historical['value']}")
Ao executar o script, é impresso:
Naive text memory:
  returned episode: e1: Mira prefers concise answers. Her passport deadline is 2026-07-15.

SGAM current state:
  mira.passport_deadline = 2026-06-30
  valid_from=2026-06-03T10:00:00Z, source=e2

SGAM point-in-time state:
  on 2026-06-02, mira.passport_deadline = 2026-07-15
replace_fact começa por rejeitar um valid_from igual: esse conflito exige uma política da aplicação, como a precedência da fonte ou uma revisão confirmada pelo utilizador, e não uma sobrescrita silenciosa. Caso contrário, procura o intervalo que contém o carimbo temporal recebido. Se o encontrar, fecha esse predecessor na fronteira recebida, dá à linha inserida o antigo fim do predecessor e regista o predecessor em supersedes_fact_id. Se o carimbo temporal for anterior a todos os intervalos guardados, usa o valid_from do intervalo seguinte como fim da nova linha. Assim, um facto atrasado anterior a e1 passa a ser [2026-05-30, 2026-06-01) e deixa e1 e o e2 atual intactos. O índice único parcial é a salvaguarda da base de dados para uma única linha aberta. A DM não tem um passo de atualização equivalente, por isso o texto antigo ainda pode ficar à frente da correção.
A linha temporal mostra as linhas depois de cada chamada a replace_fact no script e, a seguir, as três leituras. Veja o passo 2, em que e2 fecha e1, e o passo 3, em que o e0 atrasado termina onde e1 começa.
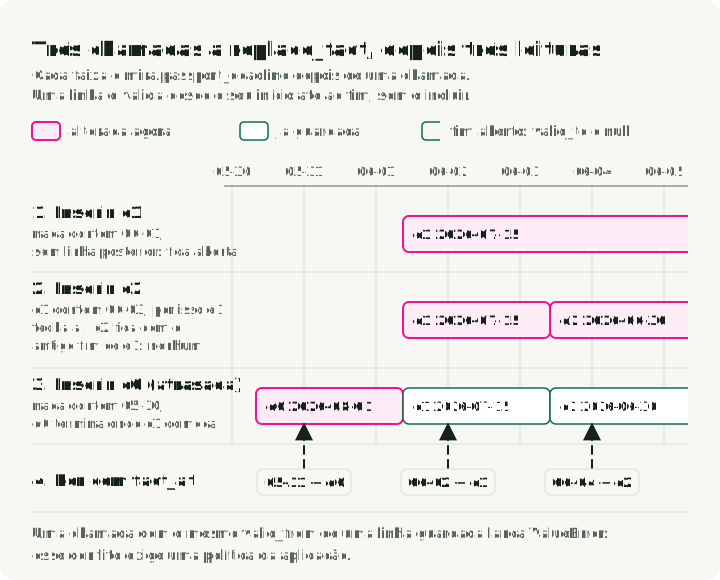
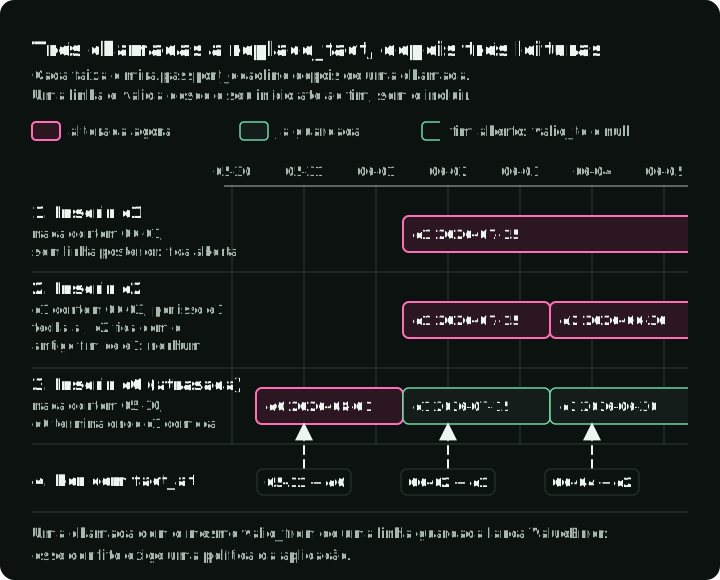
Em produção, combine esta transação com extração estruturada no caminho de escrita. A transação da base de dados atualiza a validade temporal. O modelo extrai um facto candidato, mas não decide que linha guardada continua atual.
As escolhas de armazenamento seguem o padrão de recuperação
Os projetos usam vários nomes para partes deste padrão: memory stores, context graphs, perfis, armazenamentos de longo prazo, graph RAG e agentes com estado.
| Ferramenta ou framework | Camada principal de armazenamento | Mecanismo de estado temporal | Mecanismo de esquema | Use quando |
|---|---|---|---|---|
| Graphiti | Neo4j, FalkorDB e Amazon Neptune; o Kuzu está descontinuado | Intervalos de validade dos factos mais proveniência do episódio de origem | Tipos Pydantic de entidades e arestas, arestas temporais, proveniência | Precisa de intervalos de validade e de travessia de grafos, e vai operar a base de dados de grafos |
| Zep | Context Graph Engine proprietário | Context Graphs temporais geridos que retêm factos em mudança | Tipos de entidades e arestas por omissão e personalizados | Quer o mesmo modelo de grafo temporal como serviço gerido |
| LangGraph / LangMem | Stores do LangGraph, stores com suporte em Postgres | Carimbos temporais e campos geridos pela aplicação nos registos do store | Stores JSON mais extração de perfis ou coleções com Pydantic | Já usa o LangGraph e aceita gerir os carimbos temporais e as regras de conflito |
| Mem0 | Stack gerida, Valkey / Redis / backends vetoriais em configurações OSS | Atualizações de memória; a política temporal continua a cargo da aplicação | Tipos de memória, categorias personalizadas, prompts de extração | Quer add, search, update e delete geridos, com âmbito por utilizador, agente, aplicação ou execução, e vai gerir a política temporal |
| Letta / MemGPT | Estado do agente e blocos de memória com suporte em base de dados | Blocos editáveis sem intervalos de validade ao nível do campo | Blocos de memória editáveis e etiquetados | O agente edita os seus próprios blocos de memória, ou vários agentes precisam de um bloco partilhado que todos vejam |
| Cognee | Grafo mais backends vetoriais e relacionais | O histórico depende da ontologia e do backend escolhido | Extração e validação orientadas por ontologia | Valida a extração contra uma ontologia do domínio |
| LlamaIndex property graph | Stores de property graph mais stores vetoriais | Os campos de tempo dependem do esquema e do store do grafo | SchemaLLMPathExtractor com entidades e relações permitidas | Extrai um property graph a partir de documentos ou rastos |
O LangGraph separa os checkpoints de thread, que retomam uma conversa, dos stores entre threads, que guardam dados que threads posteriores leem. O artigo do Zep relata ganhos em Deep Memory Retrieval e LongMemEval, e o artigo do Mem0 relata ganhos em LoCoMo. Cada fornecedor escreveu o seu próprio artigo, por isso leia os números como resultados do fornecedor, não como garantias para a sua carga de trabalho.
Comece pelo modelo de dados. Se a consulta exata de factos for a operação principal, normalmente basta uma tabela relacional com payloads JSON, colunas de validade, índices por tenant e um sidecar vetorial. Acrescente um grafo quando as consultas do produto seguirem relações.
Construa o caminho de escrita antes do grafo
Primeiro, decida o que o produto pode memorizar. A escolha entre grafo e vetores vem depois.
Um agente de suporte pode memorizar o escalão da conta, os casos abertos e as preferências de contacto duradouras. Não deve promover para estado do perfil cada comentário frustrado. Um agente de programação pode memorizar as convenções do repositório e as tarefas por resolver. Não deve guardar uma nota privada para sempre só porque essa nota foi recuperada uma vez.
O primeiro armazenamento SGAM pode ser uma tabela relacional com uma coluna JSON e alguns índices, escrita pelo caminho de escrita de seis passos acima. Um grafo passa a ser útil quando o produto precisa de percorrer relações como cliente-conta, conta-política, tarefa-artefacto ou projeto-decisão.
Escritas no caminho crítico e em segundo plano
A extração imediata compensa quando o turno seguinte depende da nova memória. Se o utilizador disser “lembra-te de que prefiro respostas curtas”, o sistema não deve precisar de uma tarefa noturna para se comportar de forma diferente.
A maioria dos turnos não precisa de uma escrita imediata. Guarde o episódio em bruto com metadados de tenant, sessão e ferramentas e deixe um worker em segundo plano extrair os candidatos mais tarde. Com a consolidação por recorrência, o worker põe em buffer os sinais fracos e só promove um facto depois de uma prova semelhante se repetir ou de o utilizador o confirmar. Isto acrescenta atraso de atualização. É aceitável para “o utilizador pede muitas vezes exportações em CSV” e arriscado para “o cliente mudou a morada de entrega”.
Trate a migração de esquema como uma alteração de produto, porque altera o que o agente pode recordar, citar ou eliminar. Também pode alterar que factos históricos contam como atuais. Planeie scripts de migração, backfills, janelas de leitura dupla e o comportamento de eliminação na mesma versão.
Quando a SGAM compensa a complexidade
Use a SGAM quando os factos podem mudar ao longo do tempo:
- preferências do utilizador que podem ser atualizadas ou revogadas
- factos de clientes ou contas com requisitos de auditoria
- estado de tarefas de assistentes de longa duração
- memória de projeto de agentes de programação
- estado partilhado multi-agent
- notas de conformidade em que a proveniência importa
- perguntas temporais como “em que acreditávamos antes da migração?”
A SGAM é um exagero quando a memória é de curta duração, exploratória ou barata de recalcular. Se o agente só precisa de alguns turnos de continuidade, um checkpoint e um histórico de mensagens reduzido bastam. O QA sobre documentos estáticos pode precisar apenas de RAG. E se o domínio for tão instável que o esquema muda todos os dias, a memória tipada vai atrasar a equipa.
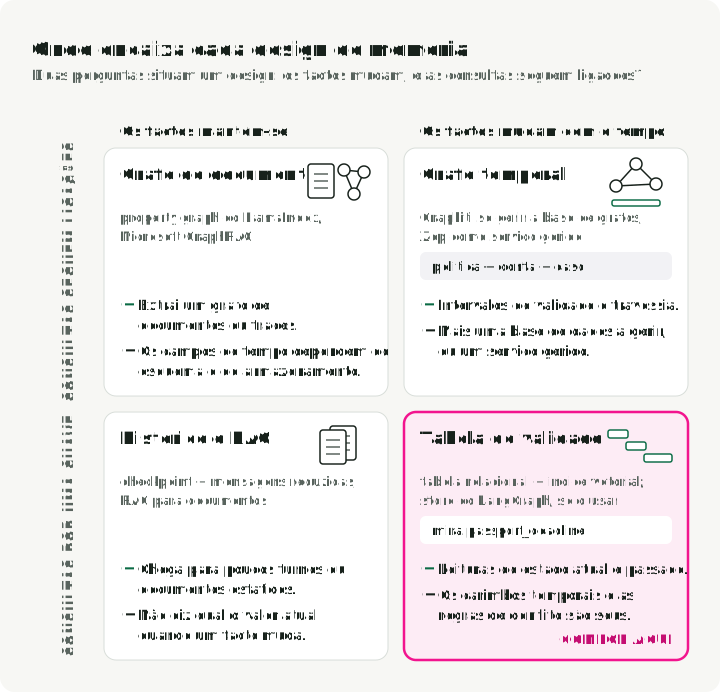
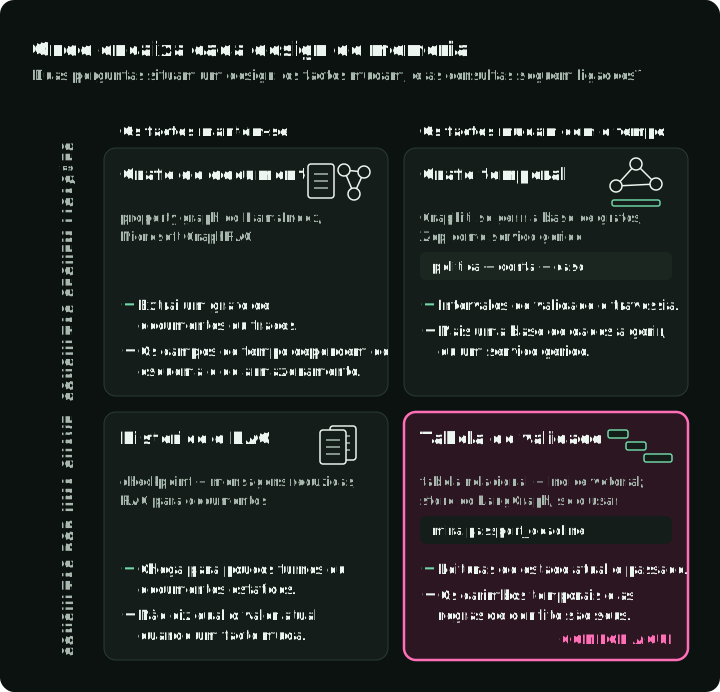
A grelha situa cada design segundo duas perguntas: os seus factos mudam, e as suas consultas seguem ligações entre registos?
Checklist de avaliação
Avalie o ciclo de vida da memória e não apenas a resposta final. Um sistema pode produzir uma resposta plausível depois de ter escrito o facto errado, recuperado um facto desatualizado ou atravessado a fronteira de um tenant.
Uso a mesma divisão por fases do meu artigo sobre avaliação de RAG. Meça a fase em que uma falha pode acontecer, em vez de limitar a avaliação ao texto gerado. A disciplina de rastos do artigo sobre avaliação de agentes também se aplica, porque um bug de memória costuma aparecer no histórico de execução antes de chegar à resposta.
Eu testaria a SGAM com replay. Alimente o serviço de escrita da memória com uma sequência fixa de episódios e inspecione o registo depois de cada turno relevante. Depois, faça perguntas sobre o estado atual e sobre o estado num momento passado ao armazenamento resultante.
| Camada | Falha que procura | Métricas |
|---|---|---|
| Extração na escrita | O agente falhou um facto, inventou um ou produziu uma forma inválida | Taxa de escritas válidas para o esquema, precisão/recall da extração, cobertura de episódios de origem |
| Tratamento de conflitos | Um facto desatualizado continuou atual ou um facto antigo válido foi sobrescrito | Correção da substituição, taxa de duplicados, correção da invalidação de factos desatualizados |
| Isolamento e política | A memória foi exposta entre utilizadores ou sobreviveu à sua janela de política | Falhas de isolamento de tenants, correção da eliminação, conformidade da retenção |
| Recuperação na leitura | O registo certo existe, mas o leitor não o obteve | Precisão do estado atual, precisão do estado num momento passado, recall@k sobre registos de memória |
| Fundamentação da resposta | A resposta usou memória sem suporte ou citou a fonte errada | Suporte das afirmações face aos episódios de origem, precisão das citações, correção da resolução de conflitos |
| Operações | O caminho da memória é demasiado lento, demasiado desatualizado ou demasiado caro | Latência de escrita p95, atraso de atualização, latência de leitura, custo por consulta |
Benchmarks como o LoCoMo, o LongMemEval e o ATM-Bench fornecem casos de teste públicos. Não substituem um conjunto de testes do domínio. Um assistente de programação, um bot de suporte ao cliente e um copilot de conformidade precisam de esquemas, filtros, regras de retenção e testes de falha diferentes.
Dos rastos a uma melhor memória executa um ciclo de melhoria numa ferramenta de memória que guarda factos com um dono, um evento de origem e um intervalo de validade, seguindo estas regras.
Ressalvas
SGAM é a minha etiqueta para um padrão, não um standard. As ferramentas da tabela acima usam outros nomes para partes dele: memory stores, grafos de contexto temporais, blocos de memória e grafos de conhecimento. O Microsoft GraphRAG enquadra uma parte relacionada do problema como recuperação baseada em grafos sobre documentos.
Um perfil de utilizador, um registo de episódios, um grafo de documentos e um bloco de memória editável pelo agente resolvem problemas diferentes de recuperação e de atualização. Reservo a SGAM para memória durável que representa o estado atual da aplicação e que, por isso, precisa de esquema, validade, proveniência, tratamento de conflitos, retenção e migração.
A memória tipada também pode estar errada. Um esquema torna as escritas más mais fáceis de inspecionar; não as torna fiáveis. Continua a precisar de confiança na fonte, de confirmação do utilizador para factos sensíveis, de política de conflitos, de eliminação e de monitorização.
Referências
- According to Me: Long-Term Personalized Referential Memory QA - artigo de Mei et al. que introduz o ATM-Bench e a Schema-Guided Memory.
- Towards Scalable Multi-Domain Conversational Agents: The Schema-Guided Dialogue Dataset - artigo de Rastogi et al. sobre o dataset SGD.
- Evaluating Very Long-Term Conversational Memory of LLM Agents - artigo de Maharana et al. que introduz o LoCoMo.
- LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory - benchmark de Wu et al. para capacidades de memória de longo prazo.
- Graphiti: Build Temporal Context Graphs for AI Agents
- Zep: A Temporal Knowledge Graph Architecture for Agent Memory
- Mem0 Platform Overview
- Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory
- LangGraph Memory Overview
- LangGraph Persistence
- LangMem documentation
- Letta: Introduction to Stateful Agents
- Letta: Shared memory
- Microsoft GraphRAG documentation
- LlamaIndex: Using a Property Graph Index
- Cognee Documentation
- Pydantic model validation docs
- Python sqlite3 documentation